O que é OCR?
Como o Reconhecimento Óptico de Caracteres Funciona de Verdade
OCR — Reconhecimento Óptico de Caracteres — é a tecnologia que converte imagens de texto digitado, manuscrito ou impresso em caracteres legíveis por máquina. Ela pega o que o olho humano vê em uma página digitalizada ou foto e transforma no que um computador pode editar, pesquisar e armazenar. Mas há uma distinção crítica que a maioria das explicações ignora: o OCR digitaliza caracteres, mas não entende o que esses caracteres significam. Essa lacuna determina se você obtém um PDF pesquisável ou uma planilha estruturada.
Principais Conclusões
- O OCR lê cada palavra em uma página digitalizada com 99% de precisão de caracteres — e ainda assim não consegue distinguir um número de fatura de um CEP, porque lê formas de caracteres, não o significado do documento.
- Três gerações de mecanismos de OCR passaram 40 anos resolvendo o problema errado: melhor reconhecimento de caracteres. Nenhuma aprendeu que uma sequência de dígitos poderia ser um número de pedido de compra — a saída continuou sendo texto indiferenciado que ainda exigia copiar e colar manualmente em cada coluna de planilha.
- A IA de visão de terceira geração lê documentos como um humano — de forma holística, pelo significado — e mapeia campos em colunas rotuladas antes mesmo de você abrir uma planilha.
O que o OCR realmente faz — e o que ele nunca fez
O OCR faz uma coisa: lê texto de uma imagem e gera uma sequência de caracteres. Uma página digitalizada entra; texto bruto sai, organizado aproximadamente em ordem de leitura — da esquerda para a direita, de cima para baixo. O mecanismo não tenta entender o que o texto significa, a que tipo de documento pertence ou quais partes são importantes e quais são texto padrão. Ele lê formas e produz caracteres. Essa é a transação completa.
Para entender por que isso importa, considere o que acontece quando você passa uma fatura padrão pelo OCR. O mecanismo processa cada caractere visível — o texto do logotipo da empresa, o número da fatura, a data, as descrições dos itens, os preços unitários, o total — e os organiza em um fluxo contínuo de texto. A saída informará que a página contém a string "$1.234,56", mas não conseguirá dizer se esse é o total da fatura, o subtotal de um item, o valor do imposto ou a taxa de envio. Ele não tem o conceito de "total da fatura" como categoria. Não sabe o que "item de linha" significa. Ele lê, mas não compreende.
É por isso que OCR não é extração de documentos, e OCR não é automação de entrada de dados. É a primeira camada de um pipeline — a camada que converte pixels em caracteres. Tudo depois disso — identificar quais caracteres pertencem a qual campo, validar formatos, estruturar a saída em linhas e colunas — exige inteligência adicional aplicada por cima.
O OCR responde à pergunta "quais caracteres estão nesta página?" Ele não responde "quais dados este documento contém?" A diferença entre essas duas perguntas é a diferença entre um arquivo de texto e uma planilha.
Como o OCR funciona: o pipeline de quatro etapas
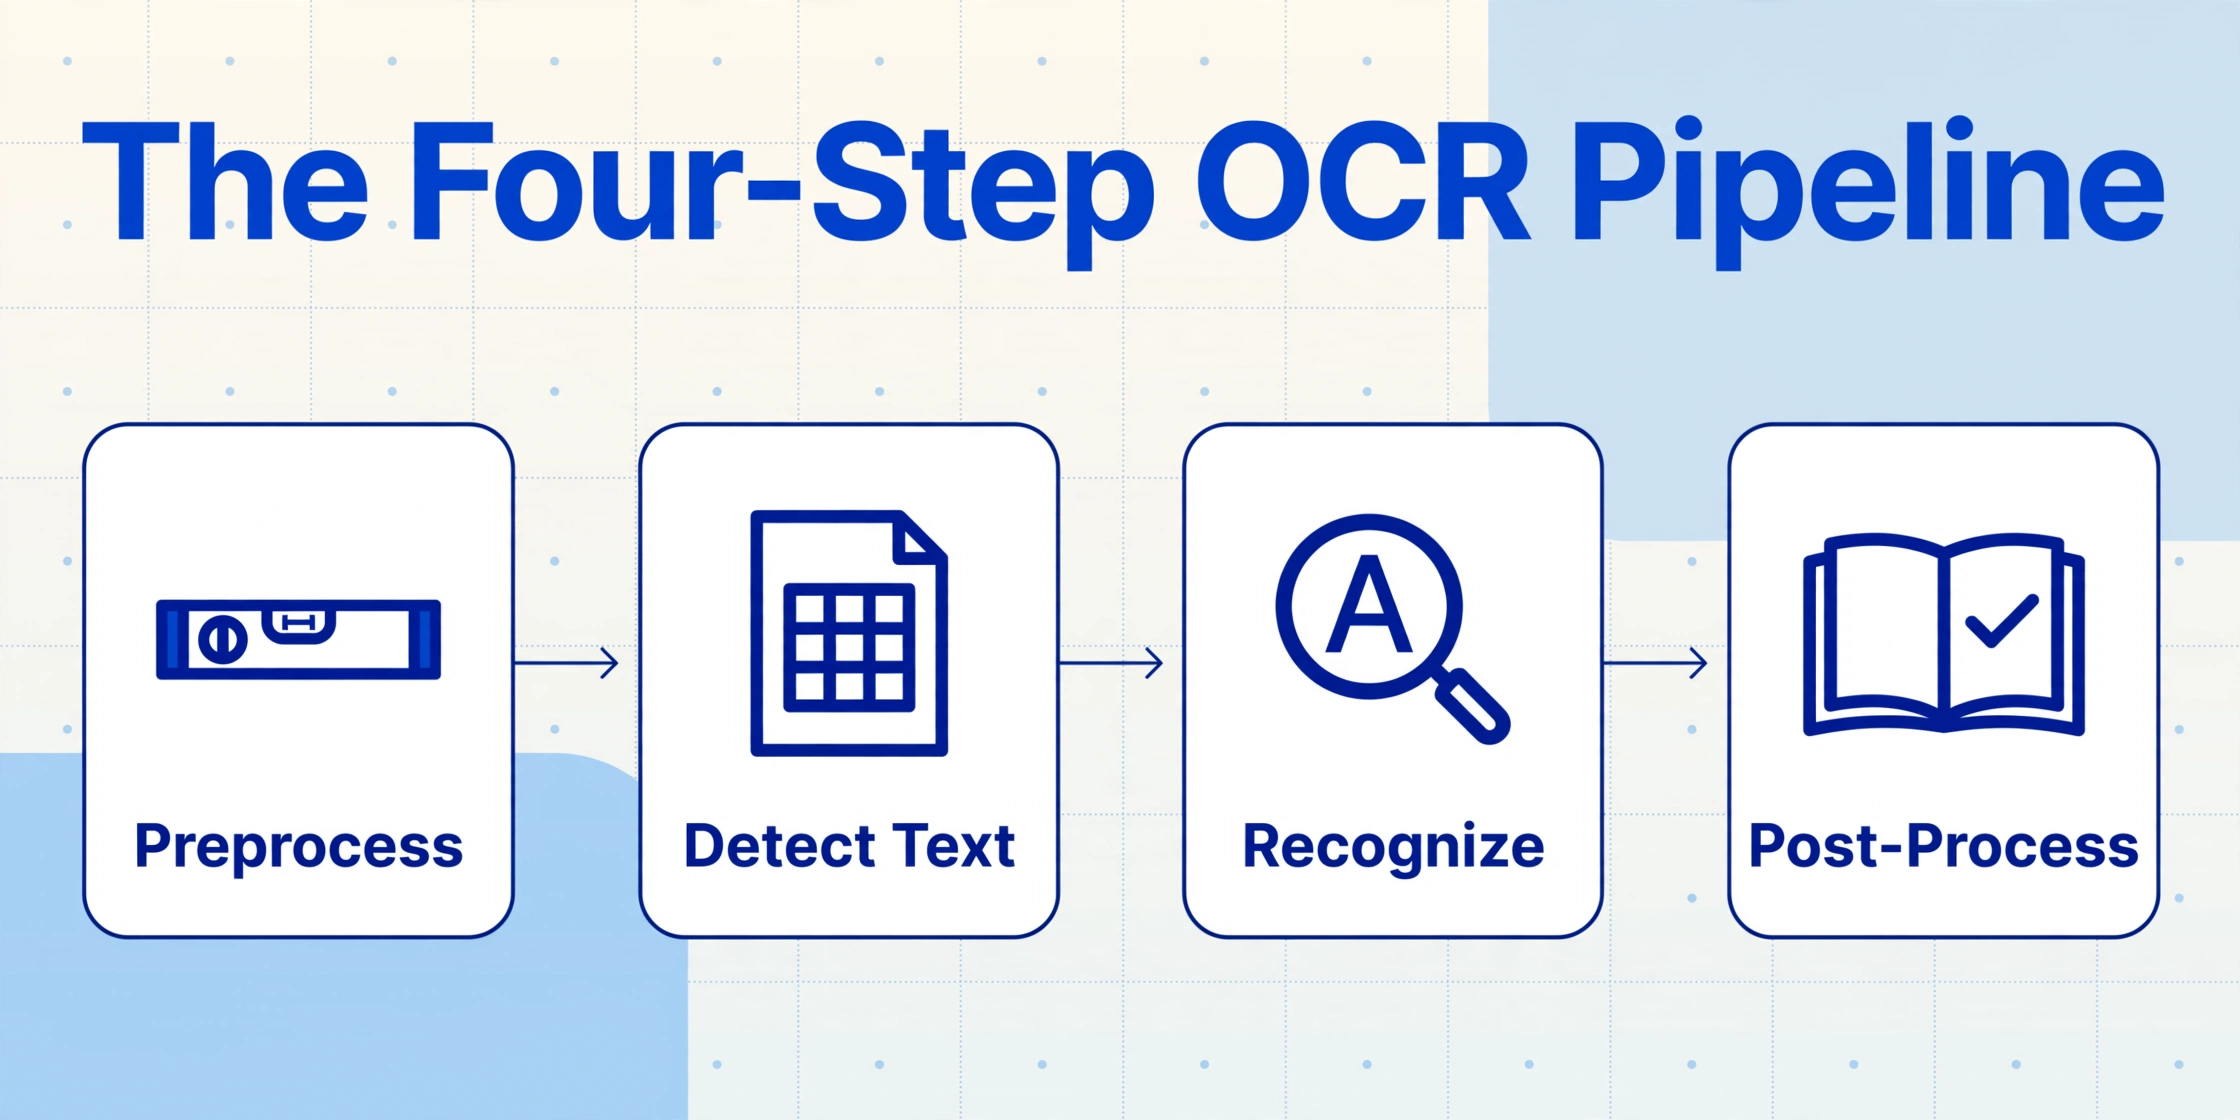
Apesar dos avanços significativos em precisão, o pipeline central do OCR permanece estruturalmente consistente há décadas. Entender essas quatro etapas explica por que algumas limitações do OCR não podem ser corrigidas por "algoritmos melhores" — elas estão incorporadas à arquitetura.
Pré-processamento
A imagem bruta é limpa antes de qualquer reconhecimento. Isso inclui endireitar (corrigir um escaneamento torto), remover ruídos (manchas de uma linha de fax), binarizar (converter para preto e branco puro) e ajustar iluminação e contraste. A qualidade dessa etapa determina tudo o que vem depois — um pré-processamento ruim garante reconhecimento ruim.
Detecção de Texto (Análise de Layout)
O mecanismo identifica quais regiões da imagem contêm texto em vez de imagens, logotipos, espaços em branco ou decorações de página. Ele divide a página em blocos, linhas e caracteres individuais. Esta etapa determina a ordem de leitura — mas não tem compreensão da estrutura do documento. Um cabeçalho de página e um cabeçalho de tabela parecem iguais para a camada de detecção.
Reconhecimento de Caracteres
A etapa de OCR em si. Historicamente feita por correspondência de modelo (comparando o formato de cada caractere com uma biblioteca de glifos conhecidos), os mecanismos modernos usam redes neurais treinadas com milhões de exemplos de caracteres. Cada caractere é classificado pelo formato — a letra "O", o dígito "0" e um ícone de círculo são padrões diferentes que o mecanismo deve distinguir.
Pós-processamento
Os caracteres reconhecidos são agrupados em palavras e verificados contra dicionários e modelos de linguagem. "Recognition" pode ser corrigido para "recognition". Regras sensíveis ao contexto podem resolver caracteres ambíguos — por exemplo, usar o contexto ao redor para decidir se "1" é um dígito ou um "l" minúsculo.
A observação principal é que cada etapa opera de baixo para cima: começando pelos pixels, construindo caracteres, agrupando em palavras e organizando em linhas. O mecanismo nunca vê a página inteira como um documento significativo. Ele processa uma pequena região por vez e costura os resultados seguindo a ordem de leitura. Pense nisso como ler um livro através de um buraco de agulha — você eventualmente consegue reconstruir cada palavra, mas não tem ideia se está lendo um romance, um formulário de imposto ou uma lista de compras.
As Três Gerações da Tecnologia de OCR
O OCR evoluiu através de três gerações tecnológicas distintas. Cada uma representa uma abordagem fundamentalmente diferente para o problema do reconhecimento de caracteres, e cada uma deixou um conjunto diferente de limitações.
Geração 1 — Correspondência de Padrões e OCR por Modelo (1974–2014). Os primeiros sistemas comerciais de OCR usavam correspondência de modelos: escaneando um caractere capturado e comparando-o pixel por pixel contra uma biblioteca de padrões de glifos armazenados. O exemplo mais famoso é o Tesseract, originalmente desenvolvido nos laboratórios da HP em 1974 e agora mantido pelo Google como o principal mecanismo de OCR de código aberto. Esses sistemas tinham bom desempenho em texto limpo e digitado em fontes conhecidas (alcançando 80–95% de precisão de caracteres), mas degradavam-se acentuadamente em tipografias incomuns, escrita manual ou digitalizações ruidosas (frequentemente abaixo de 50%). Cada nova fonte ou layout de documento exigia ajuste manual — não existia compreensão semântica em nenhum nível.
Geração 2 — OCR por Aprendizado de Máquina (2015–2022). A introdução de redes neurais convolucionais (CNNs) e, posteriormente, redes neurais recorrentes (RNNs) transformou a precisão do reconhecimento de caracteres. Os principais provedores de nuvem — Google Cloud Vision, Amazon Textract, Azure Document Intelligence — implantaram OCR baseado em aprendizado de máquina que aprendia formas de caracteres a partir de milhões de exemplos de treinamento, em vez de corresponder a modelos fixos. A precisão dos caracteres em documentos limpos subiu acima de 99%. Mas a saída permanecia como texto indiferenciado. Um melhor reconhecimento de caracteres não produzia melhor compreensão dos dados. Um mecanismo de OCR baseado em aprendizado de máquina podia informar o peso da fonte e a pontuação de confiança do caractere de cada letra na página — mas ainda não conseguia dizer se uma sequência de dígitos era um número de fatura ou um CEP.
Geração 3 — OCR por IA de Visão (2023+). A geração mais recente substitui o pipeline de baixo para cima por uma abordagem holística de cima para baixo. Em vez de processar caractere por caractere, um modelo de visão-linguagem (VLM) recebe a página inteira como uma imagem visual e raciocina sobre o que cada região, rótulo e valor significa no contexto. Treinados em bilhões de pares de imagem-texto, esses modelos podem identificar o tipo de documento, interpretar layouts espaciais, ler texto em seu contexto visual e mapear valores para campos de dados por significado — não por posição. Essa é a tecnologia por trás de ferramentas como o ImageToTable.ai. Para uma comparação detalhada de precisão entre gerações, veja nossa análise sobre precisão de IA OCR vs OCR tradicional.
| Geração 1: Correspondência de Padrões | Geração 2: OCR com ML | Geração 3: IA de Visão | |
|---|---|---|---|
| Abordagem | Comparação com modelos de glifos | Classificação neural de caracteres | Compreensão visual da página inteira |
| Precisão em texto limpo | 80–95% | 99%+ | 98–99% |
| Lida com layouts variados | Falha — exige modelos por layout | Limitado — melhores caracteres, mesma cegueira estrutural | Nativo — entende o layout via contexto visual |
| Escrita manual | Abaixo de 50% | 50–70% | 75–93% |
| Saída | String de texto bruto | Texto bruto com pontuações de confiança | Dados estruturados, mapeados por campo |
OCR vs Extração de Documentos — Por que essa diferença importa
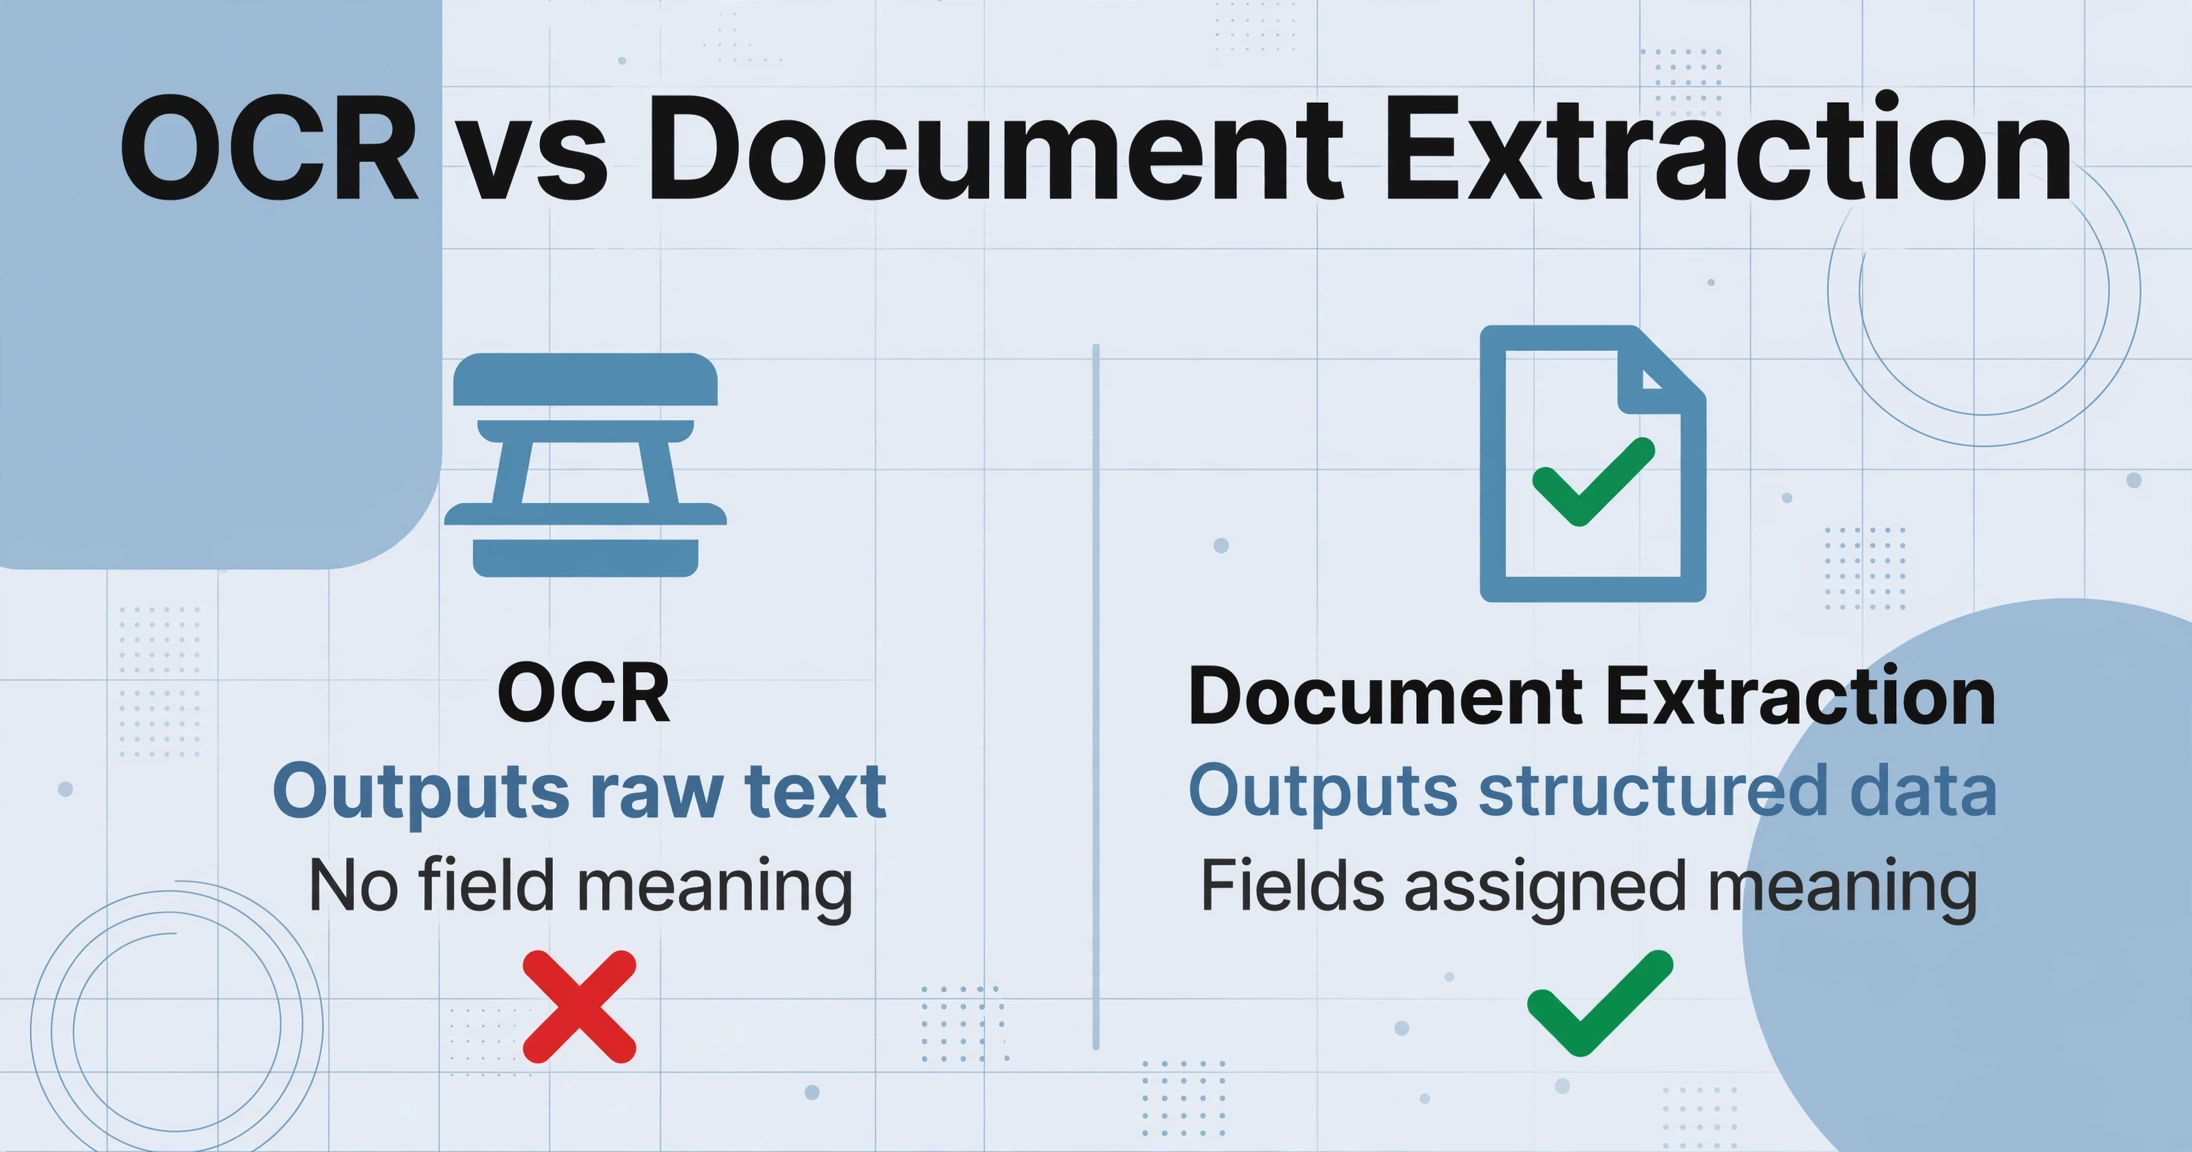
Essa distinção é o conceito mais importante no setor de processamento de documentos — e é justamente o que a maioria das explicações de "o que é OCR" ignora.
O OCR responde: "Quais caracteres estão nesta página?"
A extração de documentos responde: "Quais dados este documento contém?"
A diferença parece acadêmica até você processar seu primeiro lote de faturas de vários fornecedores apenas com OCR. Veja o que você obtém ao executar uma ordem de compra em um mecanismo de OCR tradicional:
PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR ATLAS FASTENERS QTY 500 DESC M8 HEX BOLT UNIT $0.42 TOTAL $210.00
Uma parede de texto, aproximadamente em ordem de leitura. O mecanismo de OCR extraiu todos os caracteres corretamente — provavelmente com mais de 99% de precisão de caracteres. Mas você ainda precisa destacar cada campo, encontrar a coluna correta na sua planilha e copiar e colar o valor. O OCR digitalizou os caracteres. Ele não fez a entrada de dados.
Agora execute a mesma ordem de compra em uma ferramenta de extração de documentos com IA, como o ImageToTable.ai. A saída é uma tabela estruturada:
| Nº do Pedido | Data | Fornecedor | Qtd | Descrição | Preço Unitário | Total |
|---|---|---|---|---|---|---|
| PO-2026-0412 | 12/04/2026 | Atlas Fasteners | 500 | M8 Hex Bolt | $0.42 | $210.00 |
A diferença não é a velocidade do reconhecimento de caracteres. É a presença ou ausência de compreensão semântica. O mecanismo de extração lê os mesmos pixels que o mecanismo de OCR — mas também entende que "PO-2026-0412" é um número de ordem de compra, "12/04/2026" é a data de emissão e "$0.42" é um preço unitário que pertence a uma coluna específica. Ele atribui significado durante a etapa de leitura, não depois.
Isso importa porque a extração de documentos elimina o gargalo pós-OCR — a etapa manual de copiar e colar, onde a maioria dos erros realmente ocorre. A entrada de dados humana tem uma taxa de erro consistente de 1–4% por campo. Para um documento de 10 campos processado em volume, isso se traduz em 100–400 erros por 1.000 registros. E como a saída do OCR é indiferenciada, esses erros são difíceis de detectar programaticamente — um dígito errado que parece plausível passa para o seu ERP sem acionar nenhum alerta. Para uma análise completa de como a extração resolve isso, consulte nosso guia sobre o que realmente é a extração de documentos com IA.
Quando o OCR é a ferramenta certa (e quando não é)
O OCR não está obsoleto — ele é a solução certa para problemas específicos. O segredo é saber quais são esses problemas e ser honesto sobre onde ele fica aquém.
O OCR é a ferramenta certa quando:
1. Você precisa que documentos digitalizados sejam pesquisáveis. Este é o caso de uso original e mais natural do OCR. Converter um PDF digitalizado em um documento pesquisável — onde você pode usar Ctrl+F para encontrar um termo — exige OCR. Nenhuma camada de extração é necessária.
2. Você está digitalizando arquivos de texto. Livros, registros históricos, correspondências datilografadas — quando o objetivo é preservação e pesquisa por palavras-chave, em vez de extração de dados estruturados — o OCR é suficiente.
3. Você precisa de saída de texto-para-fala ou acessibilidade. Os leitores de tela para usuários com deficiência visual dependem do OCR para converter imagens de documentos em texto legível. A estrutura do documento importa menos do que a reprodução precisa dos caracteres.
O OCR não é suficiente quando:
1. Você precisa de dados estruturados em uma planilha. Se o seu objetivo final é uma tabela com colunas e linhas — números de nota fiscal em uma coluna, datas em outra, totais em uma terceira — o OCR sozinho não consegue produzir isso. Você precisa de uma camada de extração que atribua significado aos caracteres que ele lê.
2. Você processa documentos de várias fontes com layouts diferentes. Cada fornecedor ou cliente que envia uma nota fiscal com formato diferente cria um novo problema de análise para os fluxos de trabalho tradicionais de OCR. Sem compreensão semântica, cada variação de layout exige um modelo separado ou mapeamento manual.
3. A precisão importa no nível do campo, não no nível do caractere. Um índice de precisão de 99% no nível do caractere pode mascarar uma taxa de erro de 20% no nível do campo. Quando um dígito errado em um número de pedido ou ID fiscal cria um problema de conciliação que leva semanas para aparecer, a precisão no nível do caractere é a métrica errada. Isso não é apenas uma questão de produtividade — sob estruturas regulatórias como SOX (Lei Sarbanes-Oxley) e HIPAA, registros financeiros e médicos digitalizados devem manter precisão e integridade demonstráveis (veja a Receita Federal dos EUA, Procedimento 97-22 §3.02, para padrões de retenção de documentos digitalizados).
A resposta honesta é que a maioria das empresas que procuram OCR não está procurando OCR de forma alguma. Elas estão procurando uma maneira de extrair dados de documentos e colocá-los em seus sistemas — um problema que o OCR nunca foi projetado para resolver. O OCR converte páginas em pixels e pixels em caracteres. A extração de documentos converte caracteres em significado e significado em planilhas. As duas tecnologias são complementares, mas servem a trabalhos fundamentalmente diferentes.
Perguntas Frequentes
O OCR funciona com escrita à mão?
Os mecanismos tradicionais de OCR têm dificuldade com escrita à mão — a precisão normalmente fica entre 50% e 70% para letra de forma e abaixo de 50% para cursiva. O motivo é arquitetural: o OCR identifica caracteres pela forma, e a escrita à mão tem muito mais variação de forma do que o texto impresso. Os sistemas de visão de IA de terceira geração têm desempenho significativamente melhor (75–93%) porque leem palavras em contexto, em vez de comparar formas de caracteres isoladamente.
Qual é a precisão do OCR para texto impresso?
Em documentos digitados e limpos, escaneados a 300 DPI, os mecanismos modernos de OCR alcançam 95–99% de precisão de caracteres. Esse número cai significativamente em digitalizações degradadas, documentos enviados por fax, fontes incomuns ou originais de baixo contraste. Mais importante: a precisão de caracteres não é a precisão de campos — 99% de precisão de caracteres ainda pode significar que 15–40% dos campos que você precisa contêm erros. Sempre teste a precisão do OCR nos seus documentos reais, não em referências idealizadas.
O OCR pode extrair dados de PDFs escaneados?
O OCR pode converter o conteúdo de imagem de um PDF escaneado em texto, tornando-o pesquisável e selecionável. Mas extrair campos de dados específicos — números de nota fiscal, datas, valores — e colocá-los em uma planilha exige uma camada adicional de extração. O OCR produz o texto; a extração o organiza. Um PDF escaneado apenas com OCR resulta em um documento pesquisável. Um PDF escaneado com extração resulta em dados estruturados em linhas e colunas.
OCR é o mesmo que digitalização de documentos?
Não. A digitalização de documentos é a etapa de hardware — converter uma página física de papel em uma imagem digital (uma digitalização ou foto). O OCR é a etapa de software que vem em seguida — converter essa imagem digital em texto legível por máquina. Digitalizar sem OCR produz uma imagem do seu documento. Digitalizar com OCR produz um documento no qual você pode pesquisar, editar e copiar texto. Digitalizar com OCR e extração produz dados estruturados que você pode analisar.
Quais formatos de arquivo o OCR suporta?
Os mecanismos de OCR aceitam qualquer formato baseado em imagem: JPG, PNG, TIFF e PDF (tanto escaneado quanto nativo). Os formatos de saída normalmente incluem texto simples, PDF pesquisável, documento do Microsoft Word e, em alguns casos, formatos estruturados como CSV ou JSON — embora a saída estruturada exija uma camada de extração sobre o mecanismo central de OCR.
Preciso de OCR ou de extração de documentos com IA?
Se o seu objetivo é tornar documentos pesquisáveis ou editáveis — digitalizar um contrato escaneado, criar um arquivo de PDF pesquisável, habilitar texto-para-fala — o OCR é suficiente. Se o seu objetivo é obter dados estruturados (números de nota fiscal, datas, itens de linha) em uma planilha ou sistema contábil sem entrada manual, você precisa de extração de documentos com IA. A pergunta decisiva é: você quer um documento pesquisável ou quer dados utilizáveis?
O OCR dá aos seus documentos uma voz digital. O próximo passo é fazer essa voz falar em colunas e linhas. Veja como a extração de documentos com IA lê o significado — não apenas caracteres.