Was ist OCR?
Wie optische Zeichenerkennung tatsächlich funktioniert
OCR – optische Zeichenerkennung – ist die Technologie, die Bilder von getipptem, handgeschriebenem oder gedrucktem Text in maschinenlesbare Zeichen umwandelt. Sie nimmt, was das menschliche Auge auf einer gescannten Seite oder einem Foto sieht, und macht daraus etwas, das ein Computer bearbeiten, durchsuchen und speichern kann. Doch es gibt einen entscheidenden Unterschied, den die meisten Erklärungen überspringen: OCR digitalisiert Zeichen, versteht aber nicht, was diese Zeichen bedeuten. Diese Lücke entscheidet darüber, ob Sie ein durchsuchbares PDF oder eine strukturierte Tabelle erhalten.
Die wichtigsten Erkenntnisse
- OCR liest jedes Wort auf einer gescannten Seite mit 99 % Zeichengenauigkeit – und kann dennoch eine Rechnungsnummer nicht von einer Postleitzahl unterscheiden, weil es Zeichenformen liest, nicht die Bedeutung des Dokuments.
- Drei Generationen von OCR-Engines haben 40 Jahre lang das falsche Problem gelöst: bessere Zeichenerkennung. Keine von ihnen lernte, dass eine Ziffernfolge eine Bestellnummer sein könnte – die Ausgabe blieb undifferenzierter Text, der weiterhin manuell in jede Tabellenspalte kopiert werden musste.
- KI der dritten Generation mit visueller Wahrnehmung liest Dokumente so, wie es ein Mensch tut – ganzheitlich, nach Bedeutung – und ordnet Felder in beschriftete Spalten ein, bevor Sie überhaupt eine Tabelle öffnen.
Was OCR tatsächlich tut – und was es nie getan hat
OCR tut eines: Es liest Text aus einem Bild und gibt eine Zeichenkette aus. Eine gescannte Seite geht hinein; roher Text kommt heraus, grob in Lesereihenfolge organisiert – von links nach rechts, von oben nach unten. Die Engine versucht nicht zu verstehen, was der Text bedeutet, zu welcher Dokumentart er gehört oder welche Teile wichtig und welche Standardbausteine sind. Sie liest Formen und erzeugt Zeichen. Das ist die vollständige Transaktion.
Um zu verstehen, warum das wichtig ist, betrachten Sie, was passiert, wenn Sie eine Standardrechnung durch OCR schicken. Die Engine verarbeitet jedes sichtbare Zeichen – den Firmenlogo-Text, die Rechnungsnummer, das Datum, die Positionsbeschreibungen, die Einzelpreise, die Summe – und setzt sie zu einem kontinuierlichen Textstrom zusammen. Die Ausgabe sagt Ihnen, dass die Seite die Zeichenfolge „$1.234,56" enthält, aber sie kann Ihnen nicht sagen, ob das die Rechnungssumme, eine Positionszwischensumme, der Steuerbetrag oder die Versandkosten sind. Sie hat kein Konzept von „Rechnungssumme" als Kategorie. Sie weiß nicht, was „Position" bedeutet. Sie liest, aber sie versteht nicht.
Deshalb ist OCR keine Dokumentextraktion, und OCR ist keine Dateneingabeautomatisierung. Es ist die erste Schicht einer Pipeline – die Schicht, die Pixel in Zeichen umwandelt. Alles danach – das Identifizieren, welche Zeichen zu welchem Feld gehören, das Validieren von Formaten, das Strukturieren der Ausgabe in Zeilen und Spalten – erfordert zusätzliche Intelligenz, die darübergelegt wird.
OCR beantwortet die Frage „Welche Zeichen sind auf dieser Seite?" Es beantwortet nicht „Welche Daten enthält dieses Dokument?" Der Unterschied zwischen diesen beiden Fragen ist der Unterschied zwischen einer Textdatei und einer Tabellenkalkulation.
Wie OCR funktioniert: Die Vier-Schritte-Pipeline
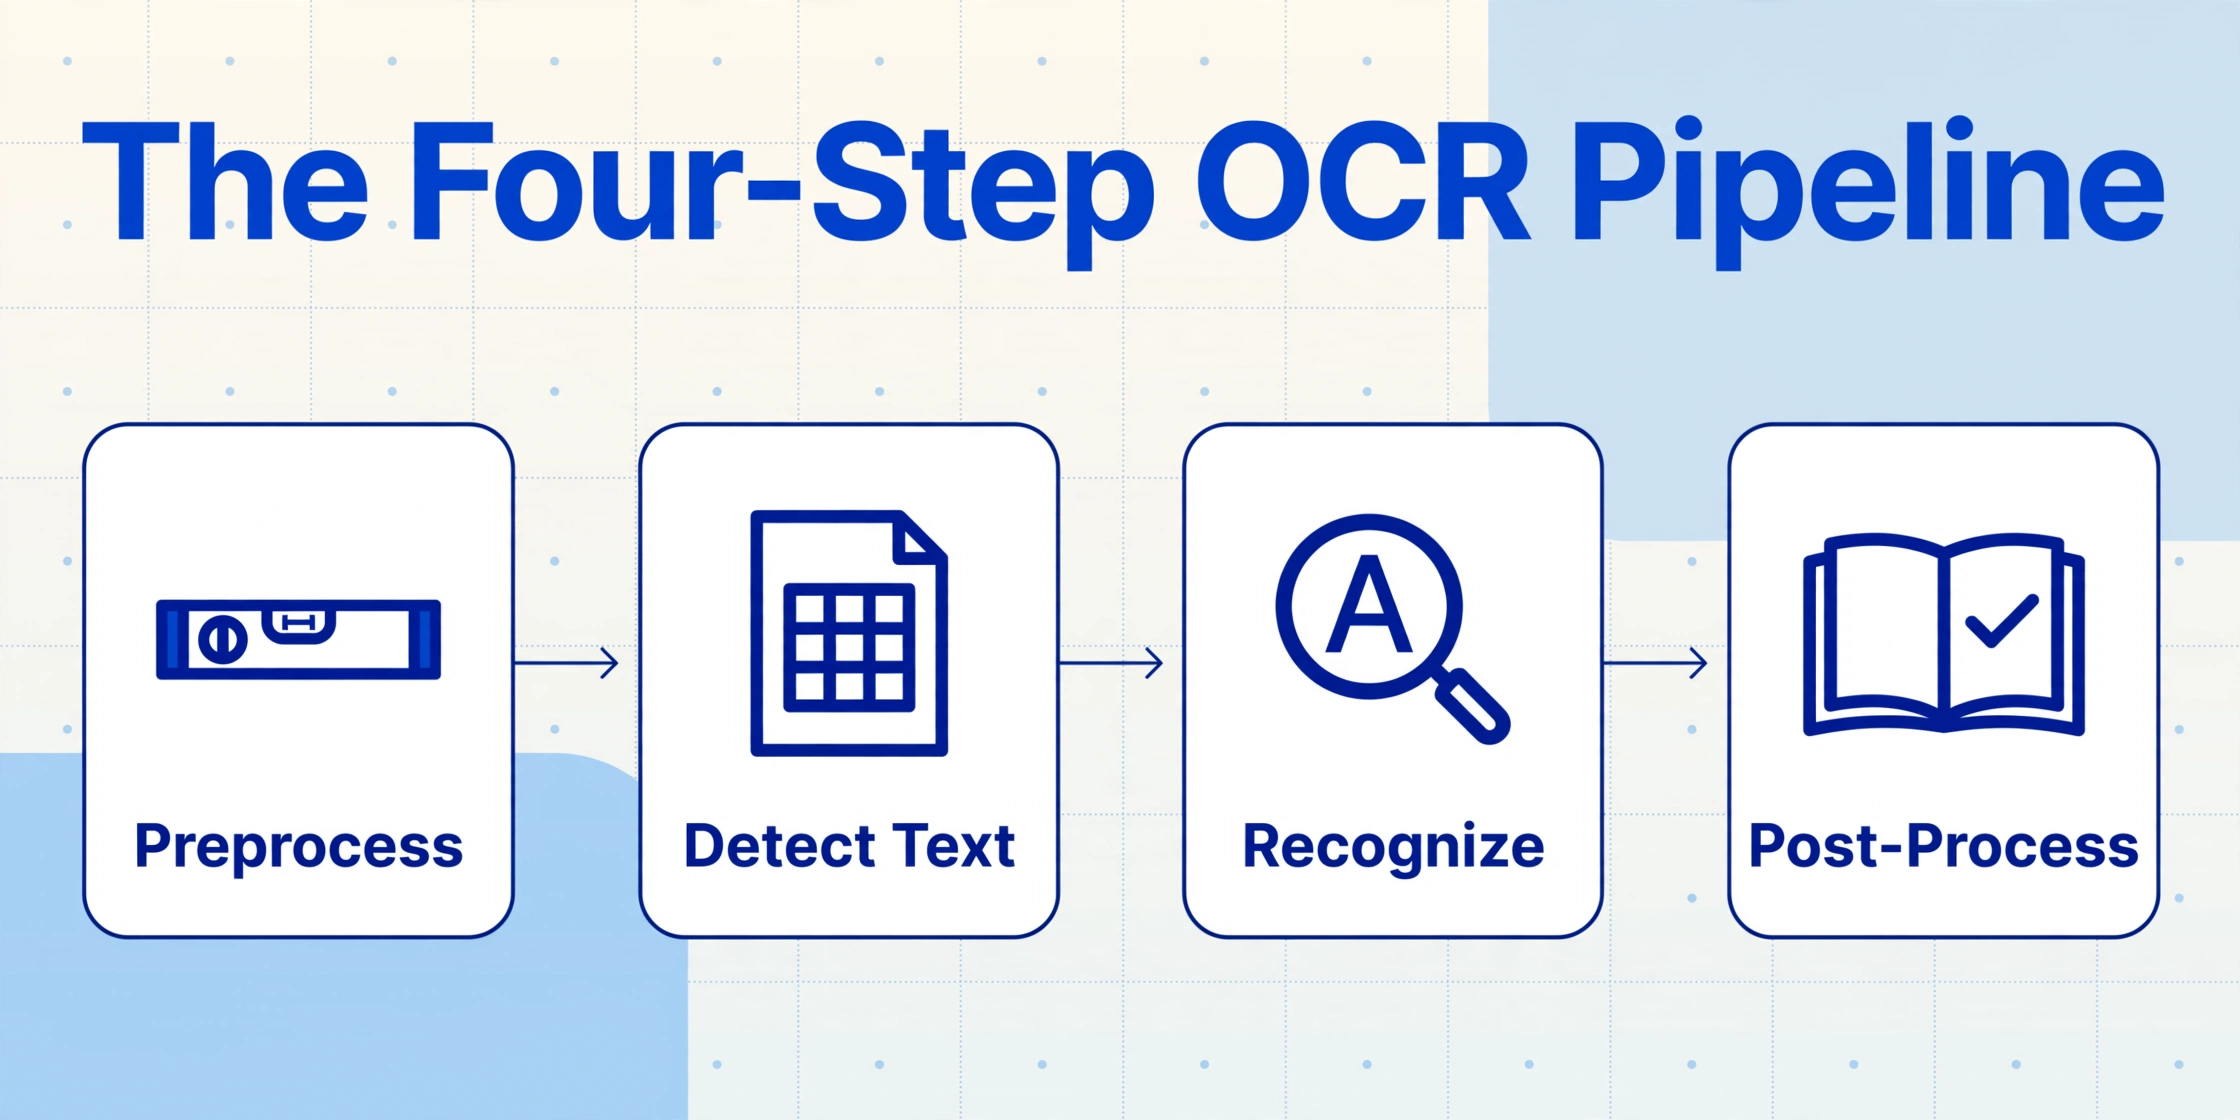
Trotz erheblicher Fortschritte bei der Genauigkeit ist die Kern-OCR-Pipeline seit Jahrzehnten strukturell konsistent geblieben. Das Verständnis dieser vier Schritte erklärt, warum einige OCR-Einschränkungen nicht durch „bessere Algorithmen" behebbar sind – sie sind in die Architektur eingebaut.
Vorverarbeitung
Das Rohbild wird bereinigt, bevor eine Erkennung stattfindet. Dazu gehören das Entzerren (Begradigen eines schiefen Scans), das Entfernen von Rauschen (Flecken durch eine Faxleitung), das Binarisieren (Umwandeln in reines Schwarz-Weiß) sowie das Anpassen von Beleuchtung und Kontrast. Die Qualität dieses Schritts bestimmt alles Weitere – eine schlechte Vorverarbeitung führt garantiert zu einer schlechten Erkennung.
Texterkennung (Layout-Analyse)
Die Engine ermittelt, welche Bereiche des Bildes Text enthalten und welche Bilder, Logos, Leerraum oder Seitendekorationen. Sie zerlegt die Seite in Blöcke, Zeilen und einzelne Zeichen. Dieser Schritt bestimmt die Lesereihenfolge – er hat jedoch kein Verständnis für die Dokumentstruktur. Ein Seitenkopf und eine Tabellenüberschrift sehen für die Erkennungsebene gleich aus.
Zeichenerkennung
Der eigentliche OCR-Schritt. Historisch wurde dies per Vorlagenabgleich durchgeführt (Vergleich jeder Zeichenform mit einer Bibliothek bekannter Glyphen); moderne Engines verwenden neuronale Netze, die mit Millionen von Zeichenbeispielen trainiert wurden. Jedes Zeichen wird nach seiner Form klassifiziert – der Buchstabe „O“, die Ziffer „0“ und ein Kreis-Symbol sind unterschiedliche Muster, die die Engine unterscheiden muss.
Nachbearbeitung
Die erkannten Zeichen werden zu Wörtern zusammengesetzt und mit Wörterbüchern und Sprachmodellen abgeglichen. „Recognition“ könnte zu „recognition“ korrigiert werden. Kontextsensitive Regeln können mehrdeutige Zeichen auflösen – beispielsweise wird anhand des umgebenden Kontexts entschieden, ob „1“ eine Ziffer oder ein kleines „l“ ist.
Die entscheidende Beobachtung ist, dass jeder Schritt bottom-up arbeitet: von Pixeln zu Zeichen, von Zeichen zu Wörtern, gruppiert zu Zeilen. Die Engine sieht die gesamte Seite nie als bedeutungsvolles Dokument. Sie verarbeitet jeweils eine kleine Region und fügt die Ergebnisse in der Lesereihenfolge zusammen. Stellen Sie sich das wie das Lesen eines Buches durch ein Nadelöhr vor – Sie können letztlich jedes Wort rekonstruieren, haben aber keine Ahnung, ob Sie einen Roman, ein Steuerformular oder eine Einkaufsliste lesen.
Die drei Generationen der OCR-Technologie
OCR hat sich über drei verschiedene technologische Generationen entwickelt. Jede stellt einen grundlegend anderen Ansatz für das Problem der Zeichenerkennung dar, und jede hinterließ eine andere Reihe von Einschränkungen.
Generation 1 — Musterabgleich und Template-OCR (1974–2014). Die ersten kommerziellen OCR-Systeme verwendeten den Musterabgleich: Sie scannten ein erfasstes Zeichen und verglichen es Pixel für Pixel mit einer Bibliothek gespeicherter Glyphenmuster. Das bekannteste Beispiel ist Tesseract, ursprünglich 1974 bei HP Labs entwickelt und heute von Google als führende Open-Source-OCR-Engine gepflegt. Diese Systeme funktionierten gut bei sauberem, getipptem Text in bekannten Schriftarten (mit 80–95 % Zeichengenauigkeit), verschlechterten sich jedoch stark bei ungewöhnlichen Schrifttypen, Handschrift oder verrauschten Scans (oft unter 50 %). Jede neue Schriftart oder jedes neue Dokumentlayout erforderte manuelle Anpassungen — auf keiner Ebene existierte semantisches Verständnis.
Generation 2 — Machine-Learning-OCR (2015–2022). Die Einführung von Convolutional Neural Networks (CNNs) und später Recurrent Neural Networks (RNNs) veränderte die Genauigkeit der Zeichenerkennung grundlegend. Große Cloud-Anbieter — Google Cloud Vision, Amazon Textract, Azure Document Intelligence — setzten ML-gestützte OCR ein, die Zeichenformen aus Millionen von Trainingsbeispielen lernte, anstatt feste Vorlagen abzugleichen. Die Zeichengenauigkeit bei sauberen Dokumenten stieg auf über 99 %. Aber die Ausgabe blieb undifferenzierter Text. Bessere Zeichenerkennung führte nicht zu besserem Datenverständnis. Eine ML-basierte OCR-Engine konnte Ihnen die Schriftstärke und den Zeichen-Konfidenzwert jedes Buchstabens auf der Seite nennen — aber sie konnte Ihnen dennoch nicht sagen, ob eine Ziffernfolge eine Rechnungsnummer oder eine Postleitzahl war.
Generation 3 — Vision-AI-OCR (2023+). Die neueste Generation ersetzt die Bottom-up-Pipeline durch einen Top-down-Ansatz, der das Ganze betrachtet. Anstatt Zeichen für Zeichen zu verarbeiten, nimmt ein Vision-Language-Modell (VLM) die gesamte Seite als visuelles Bild auf und überlegt, was jede Region, jedes Label und jeder Wert im Kontext bedeutet. Diese Modelle, die mit Milliarden von Bild-Text-Paaren trainiert wurden, können den Dokumenttyp identifizieren, räumliche Layouts analysieren, Text in seinem visuellen Kontext lesen und Werte nach Bedeutung — nicht nach Position — Datenfeldern zuordnen. Dies ist die Technologie hinter Tools wie ImageToTable.ai. Für einen detaillierten Genauigkeitsvergleich über die Generationen hinweg lesen Sie unsere Aufschlüsselung zu AI-OCR im Vergleich zur Genauigkeit traditioneller OCR.
| Gen 1: Musterabgleich | Gen 2: ML-OCR | Gen 3: Vision-KI | |
|---|---|---|---|
| Ansatz | Glyphen-Vorlagenvergleich | Neuronale Zeichenklassifizierung | Visuelles Verständnis der gesamten Seite |
| Genauigkeit bei sauberem Text | 80–95 % | 99 %+ | 98–99 % |
| Umgang mit unterschiedlichen Layouts | Scheitert – erfordert layoutspezifische Vorlagen | Begrenzt – bessere Zeichen, gleiche Strukturblindheit | Nativ – versteht Layout über visuellen Kontext |
| Handschrift | Unter 50 % | 50–70 % | 75–93 % |
| Ausgabe | Roher Textstring | Roher Text mit Konfidenzwerten | Strukturierte, feldzugeordnete Daten |
OCR vs. Dokumentextraktion – Warum der Unterschied wichtig ist
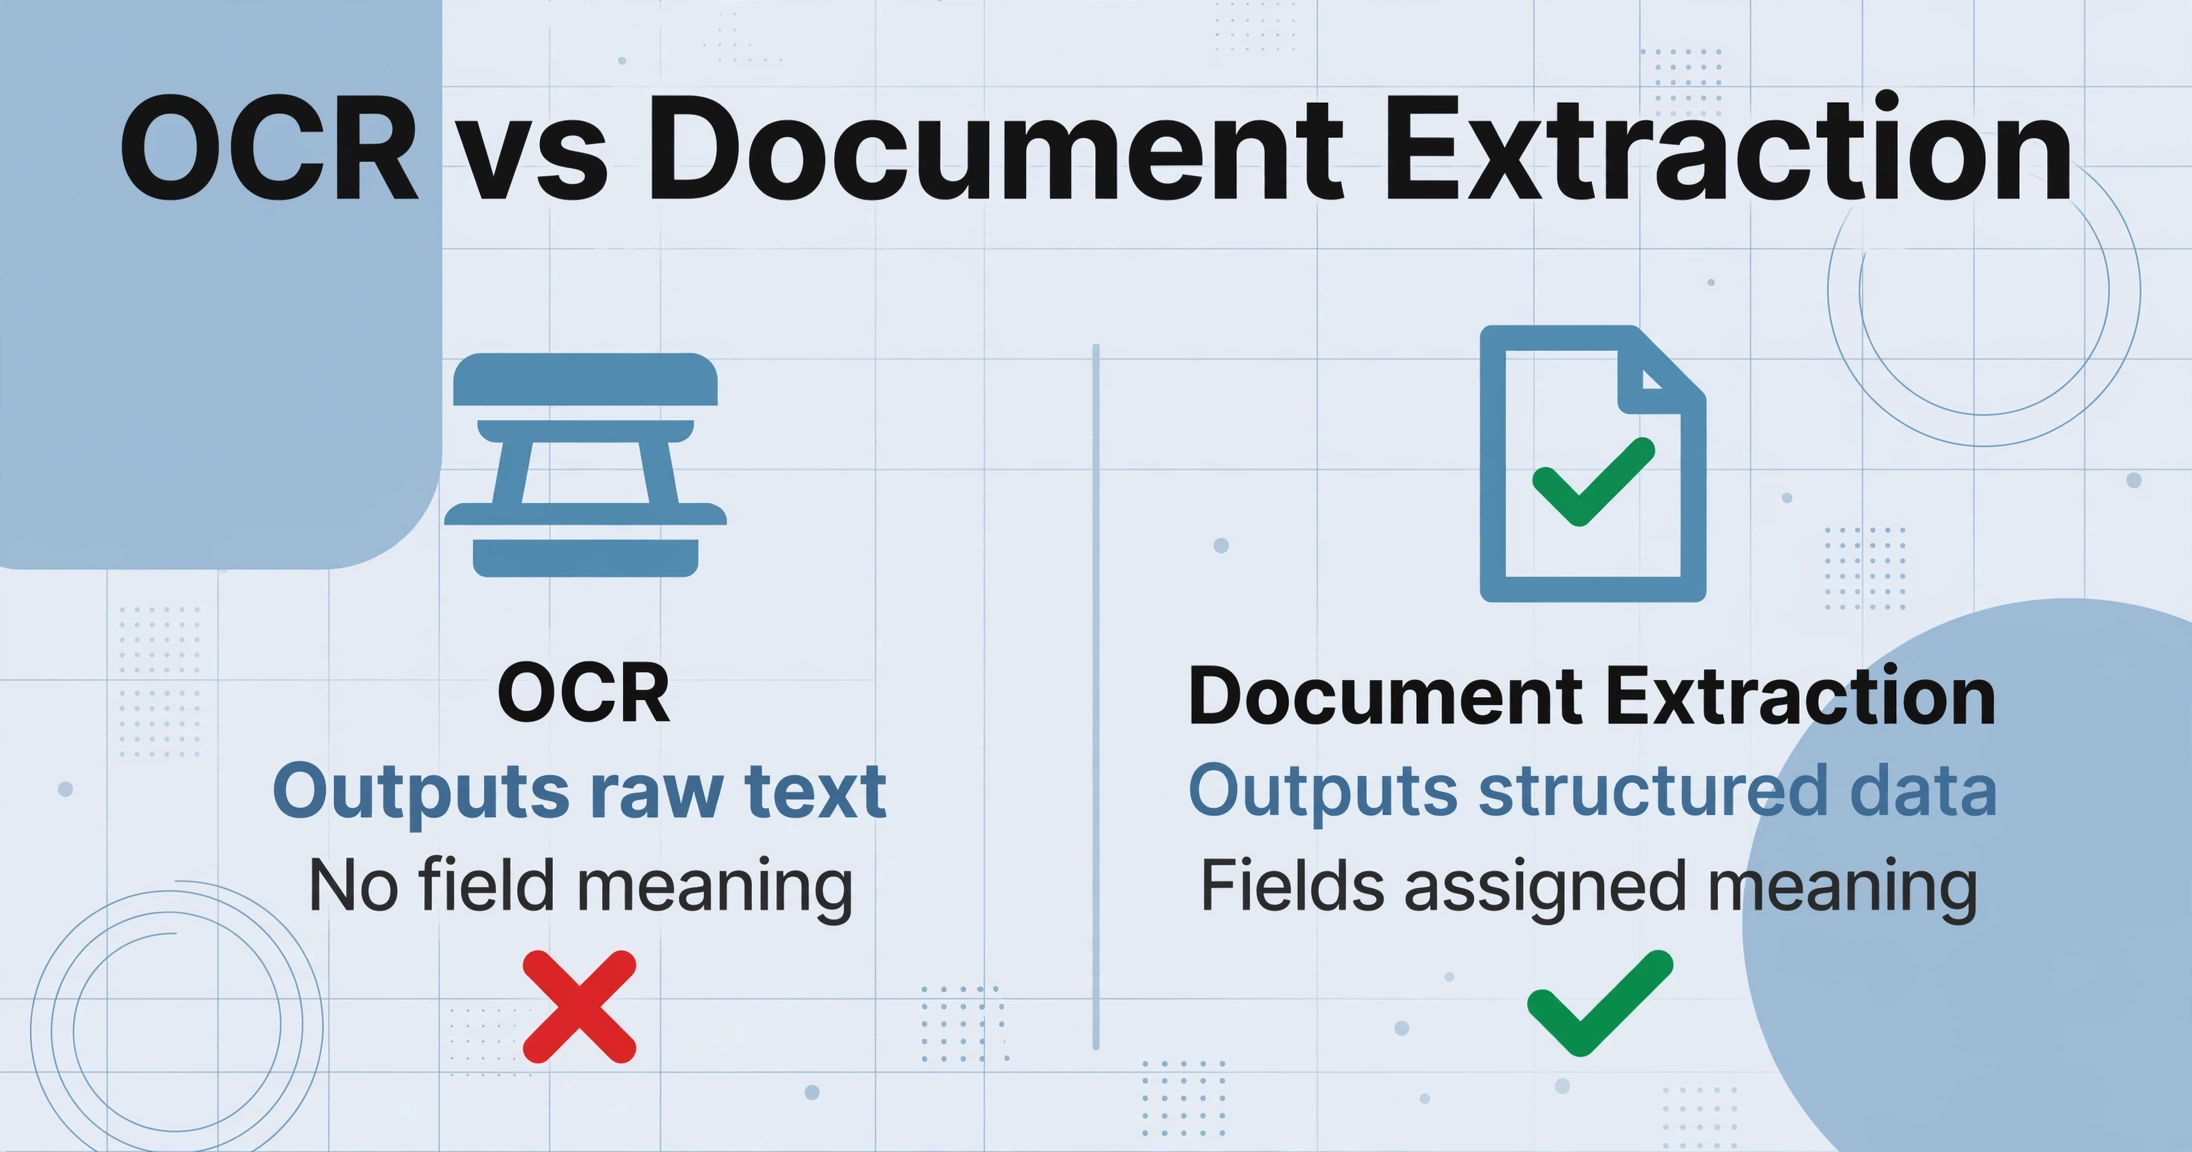
Diese Unterscheidung ist das wichtigste Konzept in der Dokumentverarbeitungsbranche – und genau das, was die meisten Erklärungen zu „Was ist OCR?" übersehen.
OCR beantwortet: „Welche Zeichen sind auf dieser Seite?"
Dokumentextraktion beantwortet: „Welche Daten enthält dieses Dokument?"
Der Unterschied wirkt akademisch, bis Sie Ihren ersten Batch mit Rechnungen mehrerer Anbieter allein mit OCR verarbeiten. Hier ist, was Sie erhalten, wenn Sie einen Bestellschein durch eine herkömmliche OCR-Engine laufen lassen:
PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR ATLAS FASTENERS QTY 500 DESC M8 HEX BOLT UNIT $0.42 TOTAL $210.00
Eine Textwand, ungefähr in Lesereihenfolge. Die OCR-Engine hat jedes Zeichen korrekt extrahiert – wahrscheinlich mit einer Zeichengenauigkeit von über 99 %. Aber Sie müssen trotzdem jedes Feld markieren, die richtige Spalte in Ihrer Tabelle finden und den Wert per Kopieren und Einfügen übertragen. Die OCR hat die Zeichen digitalisiert. Sie hat die Dateneingabe nicht übernommen.
Lassen Sie nun denselben Bestellschein durch ein KI-Dokumentextraktionstool wie ImageToTable.ai laufen. Die Ausgabe ist eine strukturierte Tabelle:
| Bestellnummer | Datum | Anbieter | Menge | Beschreibung | Einzelpreis | Gesamt |
|---|---|---|---|---|---|---|
| PO-2026-0412 | 12/04/2026 | Atlas Fasteners | 500 | M8 Hex Bolt | $0.42 | $210.00 |
Der Unterschied liegt nicht in der Geschwindigkeit der Zeichenerkennung. Er liegt im Vorhandensein oder Fehlen von semantischem Verständnis. Die Extraktions-Engine liest dieselben Pixel wie die OCR-Engine – aber sie versteht auch, dass „PO-2026-0412" eine Bestellnummer ist, „12/04/2026" das Ausstellungsdatum und „$0.42" ein Einzelpreis, der in eine bestimmte Spalte gehört. Sie weist die Bedeutung während des Leseschritts zu, nicht danach.
Das ist wichtig, weil die Dokumentextraktion den Engpass nach der OCR beseitigt – den manuellen Schritt des Kopierens und Einfügens, bei dem die meisten Fehler tatsächlich auftreten. Die manuelle Dateneingabe hat eine konstante Fehlerrate von 1–4 % pro Feld. Bei einem Dokument mit 10 Feldern, das in großen Mengen verarbeitet wird, bedeutet das 100–400 Fehler pro 1.000 Datensätze. Und da die OCR-Ausgabe undifferenziert ist, sind diese Fehler nur schwer programmatisch zu erkennen – eine falsche Ziffer, die plausibel aussieht, gelangt ohne Warnung in Ihr ERP-System. Eine vollständige Aufschlüsselung, wie die Extraktion dieses Problem löst, finden Sie in unserem Leitfaden zu was KI-Dokumentextraktion tatsächlich ist.
Wann OCR das richtige Werkzeug ist (und wann nicht)
OCR ist nicht veraltet – es ist die richtige Lösung für bestimmte Probleme. Entscheidend ist zu wissen, um welche Probleme es sich handelt, und ehrlich zu sein, wo die Grenzen liegen.
OCR ist das richtige Werkzeug, wenn:
1. Sie gescannte Dokumente durchsuchbar machen müssen. Dies ist der ursprüngliche und natürlichste Anwendungsfall von OCR. Um ein gescanntes PDF in ein durchsuchbares Dokument zu verwandeln – in dem Sie mit Strg+F einen Begriff finden können – ist OCR erforderlich. Keine Extraktionsebene nötig.
2. Sie Textarchive digitalisieren. Bücher, historische Aufzeichnungen, getippte Korrespondenz – wenn das Ziel Erhaltung und Stichwortsuche ist und nicht strukturierte Datenextraktion – ist OCR ausreichend.
3. Sie Text-to-Speech- oder Barrierefreiheitsausgaben benötigen. Screenreader für sehbehinderte Nutzer verlassen sich auf OCR, um Dokumentbilder in lesbaren Text umzuwandeln. Die Dokumentstruktur ist weniger wichtig als die genaue Zeichenwiedergabe.
OCR reicht nicht aus, wenn:
1. Sie strukturierte Daten in einer Tabellenkalkulation benötigen. Wenn Ihr Endziel eine Tabelle mit Spalten und Zeilen ist – Rechnungsnummern in einer Spalte, Daten in einer anderen, Summen in einer dritten – kann OCR allein das nicht liefern. Sie benötigen eine Extraktionsebene, die den gelesenen Zeichen eine Bedeutung zuweist.
2. Sie Dokumente aus mehreren Quellen mit unterschiedlichen Layouts verarbeiten. Jeder Lieferant oder Kunde, der eine anders formatierte Rechnung sendet, erzeugt für herkömmliche OCR-Workflows ein neues Parsing-Problem. Ohne semantisches Verständnis erfordert jede Layoutvariation eine separate Vorlage oder manuelle Zuordnung.
3. Genauigkeit auf Feldebene zählt, nicht auf Zeichenebene. Eine Zeichengenauigkeit von 99 % kann eine Fehlerrate von 20 % auf Feldebene verschleiern. Wenn eine falsche Ziffer in einer Bestellnummer oder Steuer-ID ein Abstimmungsproblem verursacht, das erst nach Wochen sichtbar wird, ist die Genauigkeit auf Zeichenebene die falsche Kennzahl. Dies ist nicht nur ein Produktivitätsproblem – unter Regulierungsrahmen wie SOX (Sarbanes-Oxley Act) und HIPAA müssen digitalisierte Finanz- und Krankenakten nachweisbare Genauigkeit und Vollständigkeit aufweisen (siehe IRS Revenue Procedure 97-22 §3.02 für Aufbewahrungsstandards gescannter Dokumente).
Die ehrliche Antwort ist, dass die meisten Unternehmen, die nach OCR suchen, eigentlich gar nicht nach OCR suchen. Sie suchen nach einer Möglichkeit, Daten aus Dokumenten in ihre Systeme zu bringen – ein Problem, das OCR nie lösen sollte. OCR wandelt Seiten in Pixel und Pixel in Zeichen um. Dokumentextraktion wandelt Zeichen in Bedeutung und Bedeutung in Tabellen um. Die beiden Technologien ergänzen sich, erfüllen aber grundlegend unterschiedliche Aufgaben.
Häufig gestellte Fragen
Funktioniert OCR mit Handschrift?
Herkömmliche OCR-Engines haben bei Handschrift Probleme – die Genauigkeit liegt bei Blockschrift typischerweise zwischen 50 % und 70 % und bei Schreibschrift unter 50 %. Der Grund ist architektonischer Natur: OCR erkennt Zeichen anhand ihrer Form, und Handschrift weist weitaus mehr Formvarianten auf als gedruckter Text. KI-Systeme der dritten Generation mit visueller Erkennung schneiden deutlich besser ab (75–93 %), da sie Wörter im Kontext lesen, statt Zeichenformen isoliert abzugleichen.
Wie genau ist OCR bei gedrucktem Text?
Bei sauberen, getippten Dokumenten, die mit 300 DPI gescannt wurden, erreichen moderne OCR-Engines eine Zeichengenauigkeit von 95–99 %. Dieser Wert sinkt deutlich bei minderwertigen Scans, Faxdokumenten, ungewöhnlichen Schriftarten oder Originalen mit geringem Kontrast. Wichtiger noch: Zeichengenauigkeit ist nicht Feldgenauigkeit – 99 % Zeichengenauigkeit können dennoch bedeuten, dass 15–40 % der für Sie relevanten Felder Fehler enthalten. Testen Sie die OCR-Genauigkeit immer an Ihren tatsächlichen Dokumenten, nicht an idealisierten Benchmarks.
Kann OCR Daten aus gescannten PDFs extrahieren?
OCR kann den Bildinhalt eines gescannten PDFs in Text umwandeln und ihn damit durchsuchbar und auswählbar machen. Um jedoch bestimmte Datenfelder – Rechnungsnummern, Daten, Beträge – zu extrahieren und in einer Tabelle abzulegen, ist eine zusätzliche Extraktionsebene erforderlich. OCR erzeugt den Text; die Extraktion organisiert ihn. Ein gescanntes PDF allein mit OCR ergibt ein durchsuchbares Dokument. Ein gescanntes PDF mit Extraktion ergibt strukturierte Daten in Zeilen und Spalten.
Ist OCR dasselbe wie Dokumentenscanning?
Nein. Dokumentenscanning ist der Hardwareschritt – die Umwandlung einer physischen Papierseite in ein digitales Bild (Scan oder Foto). OCR ist der darauffolgende Softwareschritt – die Umwandlung dieses digitalen Bildes in maschinenlesbaren Text. Scannen ohne OCR erzeugt ein Bild Ihres Dokuments. Scannen mit OCR erzeugt ein Dokument, in dem Sie suchen, das Sie bearbeiten und aus dem Sie Text kopieren können. Scannen mit OCR plus Extraktion erzeugt strukturierte Daten, die Sie analysieren können.
Welche Dateiformate unterstützt OCR?
OCR-Engines akzeptieren jedes bildbasierte Format: JPG, PNG, TIFF und PDF (sowohl gescannt als auch nativ). Zu den Ausgabeformaten gehören typischerweise Klartext, durchsuchbares PDF, Microsoft-Word-Dokument und in einigen Fällen strukturierte Formate wie CSV oder JSON – wobei die strukturierte Ausgabe eine Extraktionsebene über der eigentlichen OCR-Engine erfordert.
Brauche ich OCR oder KI-Dokumentextraktion?
Wenn Ihr Ziel darin besteht, Dokumente durchsuchbar oder bearbeitbar zu machen – etwa ein gescanntes Dokument zu digitalisieren, ein durchsuchbares PDF-Archiv zu erstellen oder Text-to-Speech zu ermöglichen –, ist OCR ausreichend. Wenn Ihr Ziel darin besteht, strukturierte Daten (Rechnungsnummern, Daten, Positionszeilen) ohne manuelle Eingabe in eine Tabelle oder ein Buchhaltungssystem zu überführen, benötigen Sie KI-Dokumentextraktion. Die entscheidende Frage lautet: Möchten Sie ein durchsuchbares Dokument oder möchten Sie nutzbare Daten?
OCR verleiht Ihren Dokumenten eine digitale Stimme. Der nächste Schritt besteht darin, diese Stimme in Spalten und Zeilen sprechen zu lassen. Erfahren Sie, wie die KI-Dokumentextraktion Bedeutung liest – nicht nur Zeichen.