OCRとは?
光学文字認識の仕組みを徹底解説
OCR(光学文字認識)とは、タイプされた文字、手書き文字、印刷された文字の画像を、機械が読み取れる文字に変換する技術です。スキャンしたページや写真に人間の目が見るものを、コンピューターが編集・検索・保存できるものに変換します。しかし、ほとんどの解説が省略している重要な違いがあります。OCRは文字をデジタル化しますが、その文字の意味を理解するわけではありません。この違いによって、検索可能なPDFになるか、構造化されたスプレッドシートになるかが決まります。
重要なポイント
- OCRはスキャンしたページのすべての単語を99%の文字精度で読み取りますが、それでも請求書番号と郵便番号を区別することはできません。文字の形を読み取るだけで、文書の意味を理解しないからです。
- 3世代にわたるOCRエンジンは、40年間も間違った問題を解決してきました。それは文字認識の向上です。数字の連なりが発注番号になり得ることを学習したエンジンはなく、出力は未分類のテキストのままで、スプレッドシートの各列への手動コピー&ペーストが依然として必要でした。
- 第3世代のビジョンAIは、人間と同じように文書を全体的に、意味によって読み取り、スプレッドシートを開く前からフィールドをラベル付きの列にマッピングします。
OCRが実際に行うこと — そしてこれまで一度も行ってこなかったこと
OCRが行うことは一つだけです。画像からテキストを読み取り、文字列として出力することです。 スキャンされたページが入力され、生のテキストが出力されます。おおよそ読む順序(左から右、上から下)で整理されます。エンジンはテキストの意味、属するドキュメントの種類、重要な部分と定型文の区別を理解しようとは一切しません。形状を読み取り、文字を生成する。それが取引のすべてです。
これが重要である理由を理解するには、標準的な請求書をOCRに通したときに何が起こるかを考えてみてください。エンジンは表示されているすべての文字(会社ロゴのテキスト、請求書番号、日付、明細項目の説明、単価、合計)を処理し、それらを連続したテキストストリームにまとめます。出力は、ページに「$1,234.56」という文字列が含まれていることを示しますが、それが請求書の合計なのか、明細項目の小計なのか、税額なのか、送料なのかを判断することはできません。 「請求書合計」というカテゴリの概念はありません。「明細項目」の意味も理解しません。読み取ることはできても、理解することはできないのです。
これが、OCRはドキュメント抽出ではなく、OCRはデータ入力の自動化でもない理由です。これはパイプラインの最初のレイヤーであり、ピクセルを文字に変換するレイヤーです。その後のすべて — どの文字がどのフィールドに属するかの識別、形式の検証、行と列への構造化 — には、その上に重ねる追加のインテリジェンスが必要です。
OCRは「このページにはどのような文字があるか?」という問いに答えます。「このドキュメントにはどのようなデータが含まれているか?」には答えません。この2つの問いの違いは、テキストファイルとスプレッドシートの違いです。
OCRの仕組み:4ステップのパイプライン
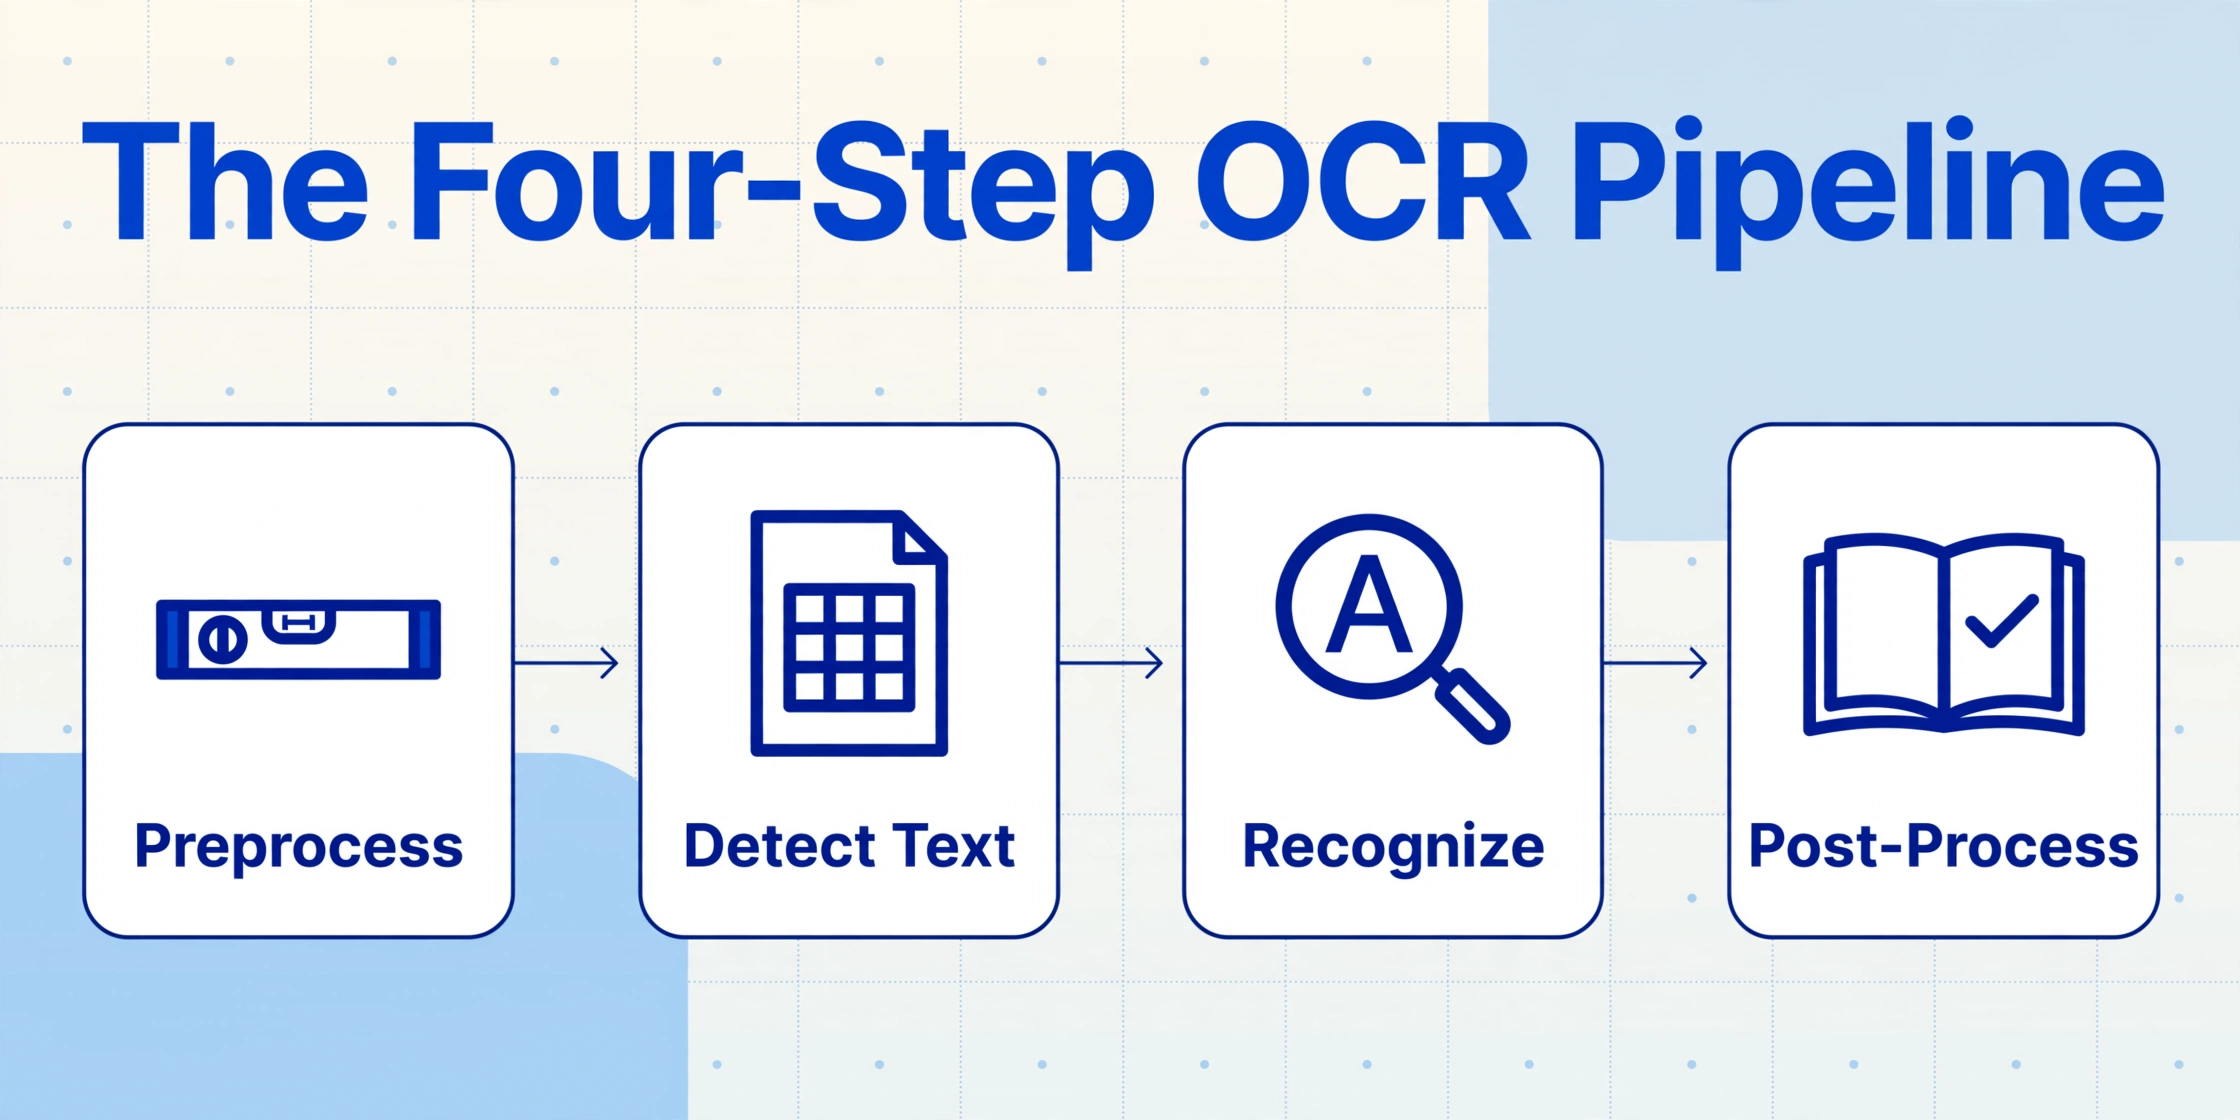
精度の大幅な向上にもかかわらず、中核となるOCRパイプラインは数十年にわたり構造的に一貫しています。この4つのステップを理解することで、一部のOCRの限界が「より優れたアルゴリズム」では修正できない理由が説明できます。それらはアーキテクチャに組み込まれているからです。
前処理
認識が始まる前に、生の画像をクリーンアップします。これには、傾き補正(傾いたスキャンの修正)、ノイズ除去(ファックスの線による斑点の除去)、二値化(純粋な白黒への変換)、照明とコントラストの調整が含まれます。このステップの品質がその後のすべてを左右します。前処理が不十分だと、認識結果も確実に不十分になります。
テキスト検出(レイアウト解析)
エンジンは、画像内のどの領域がテキストで、どの領域が画像、ロゴ、空白、ページ装飾であるかを識別します。ページをブロック、行、個々の文字に分割します。このステップで読み取り順序が決まりますが、ドキュメント構造の理解は伴いません。ページのヘッダーとテーブルのヘッダーは、検出レイヤーにとっては同じように見えます。
文字認識
実際のOCRステップです。歴史的にはテンプレートマッチング(既知のグリフのライブラリと各文字の形状を比較する)で行われていましたが、現代のエンジンは数百万の文字例でトレーニングされたニューラルネットワークを使用します。各文字は形状によって分類されます。文字「O」、数字「0」、丸アイコンはすべて、エンジンが区別しなければならない異なるパターンです。
後処理
認識された文字は単語に組み立てられ、辞書と言語モデルと照合されます。「Recognition」は「recognition」に修正されるかもしれません。文脈依存のルールがあいまいな文字を解決する場合があります。たとえば、周囲の文脈を使用して「1」が数字なのか小文字の「l」なのかを判断します。
重要なのは、すべてのステップがボトムアップで動作することです。ピクセルから始まり、文字を構築し、単語に組み立て、行にグループ化します。エンジンはページ全体を意味のあるドキュメントとして見ることはありません。一度に小さな領域を処理し、読み取り順序に従って結果をつなぎ合わせます。ピンホールを通して本を読むようなものだと考えてください。すべての単語を最終的に再構築することはできますが、自分が小説、税務フォーム、買い物リストのどれを読んでいるのかはわかりません。
OCR技術の3世代
OCRは、技術的に異なる3つの世代を経て進化してきました。それぞれが文字認識問題への根本的に異なるアプローチを表しており、それぞれが異なる限界を残してきました。
第1世代 — パターンマッチングとテンプレートOCR(1974〜2014年)。 最初の商用OCRシステムはテンプレートマッチングを使用していました。取り込んだ文字をスキャンし、保存されたグリフパターンのライブラリとピクセル単位で比較する方法です。最も有名な例はTesseractで、1974年にHP Labsで開発され、現在はGoogleが主要なオープンソースOCRエンジンとして保守しています。これらのシステムは、既知のフォントでクリーンなタイプ文字に対しては良好な性能(文字精度80〜95%)を発揮しましたが、珍しい書体、手書き、ノイズの多いスキャンでは急激に精度が低下しました(しばしば50%未満)。新しいフォントや文書レイアウトごとに手動調整が必要で、どのレベルにも意味理解は存在しませんでした。
第2世代 — 機械学習OCR(2015〜2022年)。 畳み込みニューラルネットワーク(CNN)と、その後のリカレントニューラルネットワーク(RNN)の導入により、文字認識の精度は一変しました。主要なクラウドプロバイダー(Google Cloud Vision、Amazon Textract、Azure Document Intelligence)は、固定テンプレートのマッチングではなく、数百万のトレーニング例から文字形状を学習するMLベースのOCRを導入しました。クリーンな文書での文字精度は99%以上に向上しました。しかし、出力は依然として未分化なテキストのままでした。文字認識の向上は、データ理解の向上にはつながりませんでした。 MLベースのOCRエンジンは、ページ上のすべての文字のフォントの太さと文字信頼度スコアを教えてくれましたが、数字の文字列が請求書番号なのか郵便番号なのかは依然として判断できませんでした。
第3世代 — ビジョンAI OCR(2023年以降)。 最新世代は、ボトムアップのパイプラインをトップダウンの全体論的アプローチに置き換えました。文字単位で処理する代わりに、ビジョン言語モデル(VLM)がページ全体を視覚画像として取り込み、各領域、ラベル、値が文脈上何を意味するかを推論します。何億もの画像とテキストのペアでトレーニングされたこれらのモデルは、文書タイプを識別し、空間レイアウトを解析し、視覚的文脈でテキストを読み取り、位置ではなく意味によって値をデータフィールドにマッピングできます。これはImageToTable.aiのようなツールの背後にある技術です。世代間の詳細な精度比較については、AI OCRと従来のOCR精度の比較をご覧ください。
| 第1世代: パターンマッチング | 第2世代: ML OCR | 第3世代: Vision AI | |
|---|---|---|---|
| アプローチ | グリフテンプレート比較 | ニューラル文字分類 | ページ全体の視覚的理解 |
| クリーンテキスト精度 | 80〜95% | 99%以上 | 98〜99% |
| 多様なレイアウトへの対応 | 不可 — レイアウトごとのテンプレートが必要 | 限定的 — 文字認識は向上するが、構造認識は同じく不可 | ネイティブ — 視覚的文脈でレイアウトを理解 |
| 手書き文字 | 50%未満 | 50〜70% | 75〜93% |
| 出力 | 生のテキスト文字列 | 信頼スコア付きの生テキスト | フィールドマッピングされた構造化データ |
OCRとドキュメント抽出の違い — なぜこの違いが重要なのか
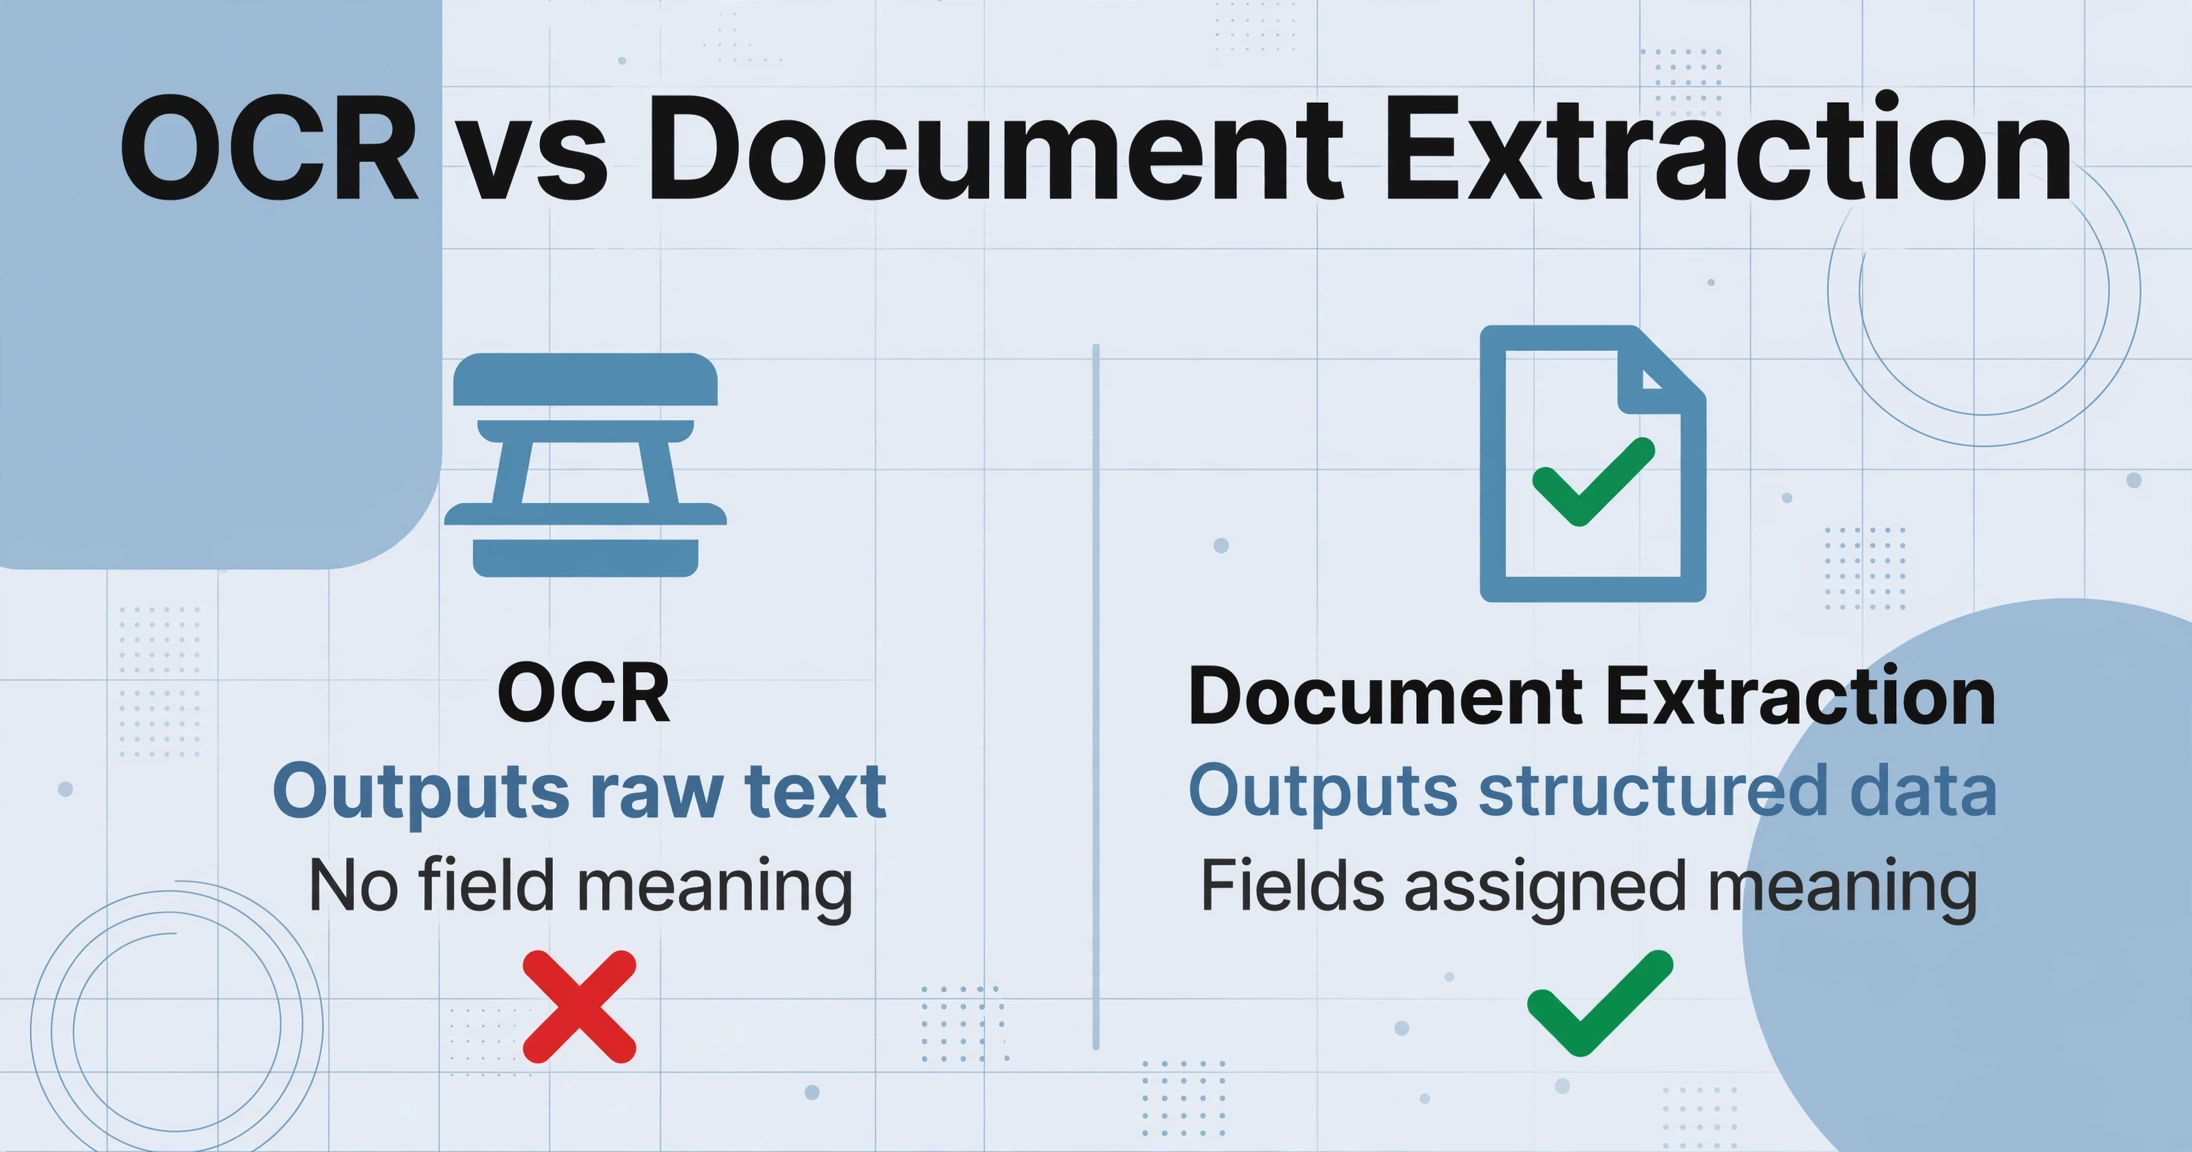
この違いは、ドキュメント処理業界で最も重要な概念です — そして、ほとんどの「OCRとは何か」という説明が見落としている点でもあります。
OCRが答えること:「このページにはどのような文字があるか?」
ドキュメント抽出が答えること:「このドキュメントにはどのようなデータが含まれているか?」
この違いは、OCRだけで最初の複数ベンダーの請求書バッチを処理するまでは学術的に見えるかもしれません。従来のOCRエンジンに発注書を通すと、次のような結果が得られます:
PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR ATLAS FASTENERS QTY 500 DESC M8 HEX BOLT UNIT $0.42 TOTAL $210.00
おおよそ読み順に並んだテキストの壁です。OCRエンジンはすべての文字を正しく抽出しました — おそらく99%以上の文字精度で。しかし、各フィールドをハイライトし、スプレッドシートの正しい列を見つけ、値をコピー&ペーストする必要は依然としてあります。OCRは文字をデジタル化しましたが、データ入力は行いませんでした。
次に、同じ発注書をImageToTable.aiのようなAIドキュメント抽出ツールに通してみましょう。出力は構造化されたテーブルです:
| PO番号 | 日付 | ベンダー | 数量 | 説明 | 単価 | 合計 |
|---|---|---|---|---|---|---|
| PO-2026-0412 | 12/04/2026 | Atlas Fasteners | 500 | M8 Hex Bolt | $0.42 | $210.00 |
違いは文字認識の速度ではありません。意味理解の有無です。 抽出エンジンはOCRエンジンと同じピクセルを読み取ります — しかし、「PO-2026-0412」が発注書番号であり、「12/04/2026」が発行日であり、「$0.42」が特定の列に属する単価であることも理解します。読み取りの段階で意味を割り当てるのです。後からではありません。
これが重要なのは、ドキュメント抽出がOCR後のボトルネック — 実際にほとんどのエラーが発生する手動コピー&ペーストの段階 — を排除するからです。人間のデータ入力には、フィールドあたり1〜4%の一貫したエラー率があります。10フィールドのドキュメントを大量に処理する場合、1,000レコードあたり100〜400件のエラーに相当します。そしてOCR出力は未分化であるため、これらのエラーはプログラム的に検出するのが困難です — もっともらしく見える誤った数字は、アラートを発動させることなくERPに通過してしまいます。抽出がこれをどのように解決するかの完全な内訳については、AIドキュメント抽出とは実際には何かに関するガイドをご覧ください。
OCRが適している場合(そして適していない場合)
OCRは時代遅れではありません。特定の問題に対しては正しい解決策です。重要なのは、どのような問題に適しているかを知り、その限界を正直に見極めることです。
OCRが適しているケース:
1. スキャンしたドキュメントを検索可能にする必要がある場合。 これはOCRの本来の用途であり、最も自然な使い方です。スキャンしたPDFを、Ctrl+Fで用語を検索できる検索可能なドキュメントに変換するには、OCRが必要です。抽出レイヤーは不要です。
2. テキストアーカイブをデジタル化する場合。 書籍、歴史的記録、タイプされた書簡など、目的が保存とキーワード検索であり、構造化データの抽出ではない場合、OCRで十分です。
3. テキスト読み上げやアクセシビリティ出力が必要な場合。 視覚障碍者向けのスクリーンリーダーは、OCRを使用してドキュメント画像を読み取り可能なテキストに変換します。ドキュメントの構造よりも、正確な文字再現が重要です。
OCRでは不十分なケース:
1. スプレッドシートで構造化データが必要な場合。 最終目標が列と行を持つテーブル(請求書番号を1つの列に、日付を別の列に、合計を3つ目の列に)である場合、OCRだけではそれを生成できません。読み取った文字に意味を割り当てる抽出レイヤーが必要です。
2. 異なるレイアウトの複数のソースからドキュメントを処理する場合。 異なる形式の請求書を送ってくるサプライヤーや顧客がいるたびに、従来のOCRワークフローでは新たな解析問題が発生します。意味論的な理解がなければ、レイアウトのバリエーションごとに個別のテンプレートや手動マッピングが必要になります。
3. 文字レベルではなくフィールドレベルで精度が重要な場合。 文字精度99%という数字は、フィールドエラー率20%を隠している可能性があります。PO番号や税IDの1桁の誤りが、数週間後に表面化する照合問題を引き起こす場合、文字レベルの精度は誤った指標です。これは単なる生産性の問題ではありません。SOX(Sarbanes-Oxley法)やHIPAAなどの規制枠組みの下では、デジタル化された財務記録や医療記録は、実証可能な正確性と完全性を維持する必要があります(スキャン文書の保存基準については、IRS Revenue Procedure 97-22 §3.02を参照)。
正直な答えは、OCRを探しているほとんどの企業は、実際にはOCRを探しているわけではないということです。彼らが求めているのは、ドキュメントからデータを取り出して自社のシステムに取り込む方法であり、それはOCRが解決するように設計された問題ではありません。OCRはページをピクセルに、ピクセルを文字に変換します。ドキュメント抽出は文字を意味に、意味をスプレッドシートに変換します。この2つの技術は補完的ですが、根本的に異なる役割を果たします。
よくある質問
OCRは手書き文字に対応していますか?
従来のOCRエンジンは手書き文字の認識が苦手で、ブロック体で50〜70%、筆記体では50%未満の精度にとどまることが一般的です。その理由は構造にあります。OCRは文字の形状で識別するため、手書き文字は印刷文字よりも形状のばらつきがはるかに大きいのです。第3世代のビジョンAIシステムは、文字の形状を単独で照合するのではなく文脈で単語を読むため、75〜93%と大幅に高い精度を達成します。
印刷文字に対するOCRの精度はどのくらいですか?
300 DPIでスキャンしたきれいなタイプ文書では、最新のOCRエンジンは95〜99%の文字精度を達成します。ただし、画質の劣化したスキャン、ファックス文書、特殊なフォント、コントラストの低い原本では、その数値は大幅に低下します。さらに重要なのは、文字精度はフィールド精度ではないということです。文字精度99%でも、対象となるフィールドの15〜40%にエラーが含まれる可能性があります。理想化されたベンチマークではなく、実際の文書でOCR精度を必ずテストしてください。
OCRはスキャンしたPDFからデータを抽出できますか?
OCRはスキャンしたPDFの画像コンテンツをテキストに変換し、検索可能かつ選択可能にします。しかし、請求書番号、日付、金額などの特定のデータフィールドを抽出してスプレッドシートに配置するには、追加の抽出レイヤーが必要です。OCRはテキストを生成し、抽出はそれを整理します。OCRのみを適用したスキャンPDFは検索可能なドキュメントになります。抽出を適用したスキャンPDFは、行と列に整理された構造化データになります。
OCRとドキュメントスキャンは同じものですか?
いいえ。ドキュメントスキャンはハードウェアのステップで、物理的な紙をデジタル画像(スキャンまたは写真)に変換します。OCRはその後に続くソフトウェアのステップで、デジタル画像を機械可読なテキストに変換します。スキャンだけでは文書の画像が生成されるだけです。OCRを組み合わせると、検索・編集・テキストコピーが可能なドキュメントになります。さらに抽出を加えると、分析可能な構造化データが得られます。
OCRはどのファイル形式に対応していますか?
OCRエンジンは、JPG、PNG、TIFF、PDF(スキャンおよびネイティブの両方)など、あらゆる画像ベースの形式を受け入れます。出力形式は通常、プレーンテキスト、検索可能なPDF、Microsoft Wordドキュメント、場合によってはCSVやJSONなどの構造化形式を含みます。ただし、構造化出力にはコアのOCRエンジンの上に抽出レイヤーが必要です。
OCRとAIドキュメント抽出のどちらが必要ですか?
文書を検索可能または編集可能にすることが目的の場合(スキャンした契約書のデジタル化、検索可能なPDFアーカイブの作成、テキスト読み上げの有効化など)は、OCRで十分です。請求書番号、日付、明細項目などの構造化データを手入力なしでスプレッドシートや会計システムに取り込むことが目的の場合は、AIドキュメント抽出が必要です。判断のポイントは、検索可能な文書が欲しいのか、それとも利用可能なデータが欲しいのかということです。
OCRはドキュメントにデジタルの声を与えます。次のステップは、その声を列と行で語らせることです。AIドキュメント抽出が文字だけでなく意味を読み取る仕組みをご覧ください。