Qu'est-ce que l'OCR ?
Comment fonctionne réellement la reconnaissance optique de caractères
L'OCR — Reconnaissance optique de caractères — est la technologie qui convertit des images de texte tapé, manuscrit ou imprimé en caractères lisibles par machine. Elle prend ce que l'œil humain voit sur une page scannée ou une photo et le transforme en ce qu'un ordinateur peut modifier, rechercher et stocker. Mais il existe une distinction cruciale que la plupart des explications omettent : l'OCR numérise les caractères, mais ne comprend pas leur signification. Cet écart détermine si vous obtenez un PDF consultable ou une feuille de calcul structurée.
Points clés à retenir
- L'OCR lit chaque mot d'une page scannée avec une précision de 99 % sur les caractères — et ne peut toujours pas distinguer un numéro de facture d'un code postal, car il lit les formes des caractères, pas le sens du document.
- Trois générations de moteurs OCR ont passé 40 ans à résoudre le mauvais problème : une meilleure reconnaissance des caractères. Aucune n'a appris qu'une chaîne de chiffres pouvait être un numéro de bon de commande — la sortie restait un texte indifférencié qui exigeait toujours un copier-coller manuel dans chaque colonne de feuille de calcul.
- L'IA de vision de troisième génération lit les documents comme le ferait un humain — de manière holistique, par le sens — et mappe les champs dans des colonnes étiquetées avant même que vous n'ouvriez une feuille de calcul.
Ce que fait réellement l'OCR — et ce qu'il n'a jamais fait
L'OCR fait une seule chose : il lit le texte d'une image et produit une chaîne de caractères. Une page scannée entre ; du texte brut sort, organisé approximativement dans l'ordre de lecture — de gauche à droite, de haut en bas. Le moteur ne tente pas de comprendre ce que signifie le texte, à quel type de document il appartient, ni quelles parties sont importantes et lesquelles sont du texte standard. Il lit des formes et produit des caractères. C'est toute la transaction.
Pour comprendre pourquoi cela compte, voyons ce qui se passe lorsque vous faites passer une facture standard dans un OCR. Le moteur traite chaque caractère visible — le texte du logo de l'entreprise, le numéro de facture, la date, les descriptions des lignes d'articles, les prix unitaires, le total — et les assemble en un flux de texte continu. La sortie vous indiquera que la page contient la chaîne « 1 234,56 $ », mais elle ne peut pas vous dire s'il s'agit du total de la facture, d'un sous-total de ligne d'article, du montant de la taxe ou des frais d'expédition. Elle n'a aucun concept de « total de facture » en tant que catégorie. Elle ne sait pas ce que signifie « ligne d'article ». Elle lit, mais elle ne comprend pas.
C'est pourquoi l'OCR n'est pas de l'extraction de documents, et l'OCR n'est pas de l'automatisation de la saisie de données. C'est la première couche d'un pipeline — la couche qui convertit les pixels en caractères. Tout ce qui vient après — identifier à quel champ appartiennent quels caractères, valider les formats, structurer la sortie en lignes et colonnes — nécessite une intelligence supplémentaire superposée par-dessus.
L'OCR répond à la question « quels caractères se trouvent sur cette page ? » Il ne répond pas à « quelles données ce document contient-il ? » La différence entre ces deux questions est la différence entre un fichier texte et une feuille de calcul.
Comment fonctionne l'OCR : le pipeline en quatre étapes
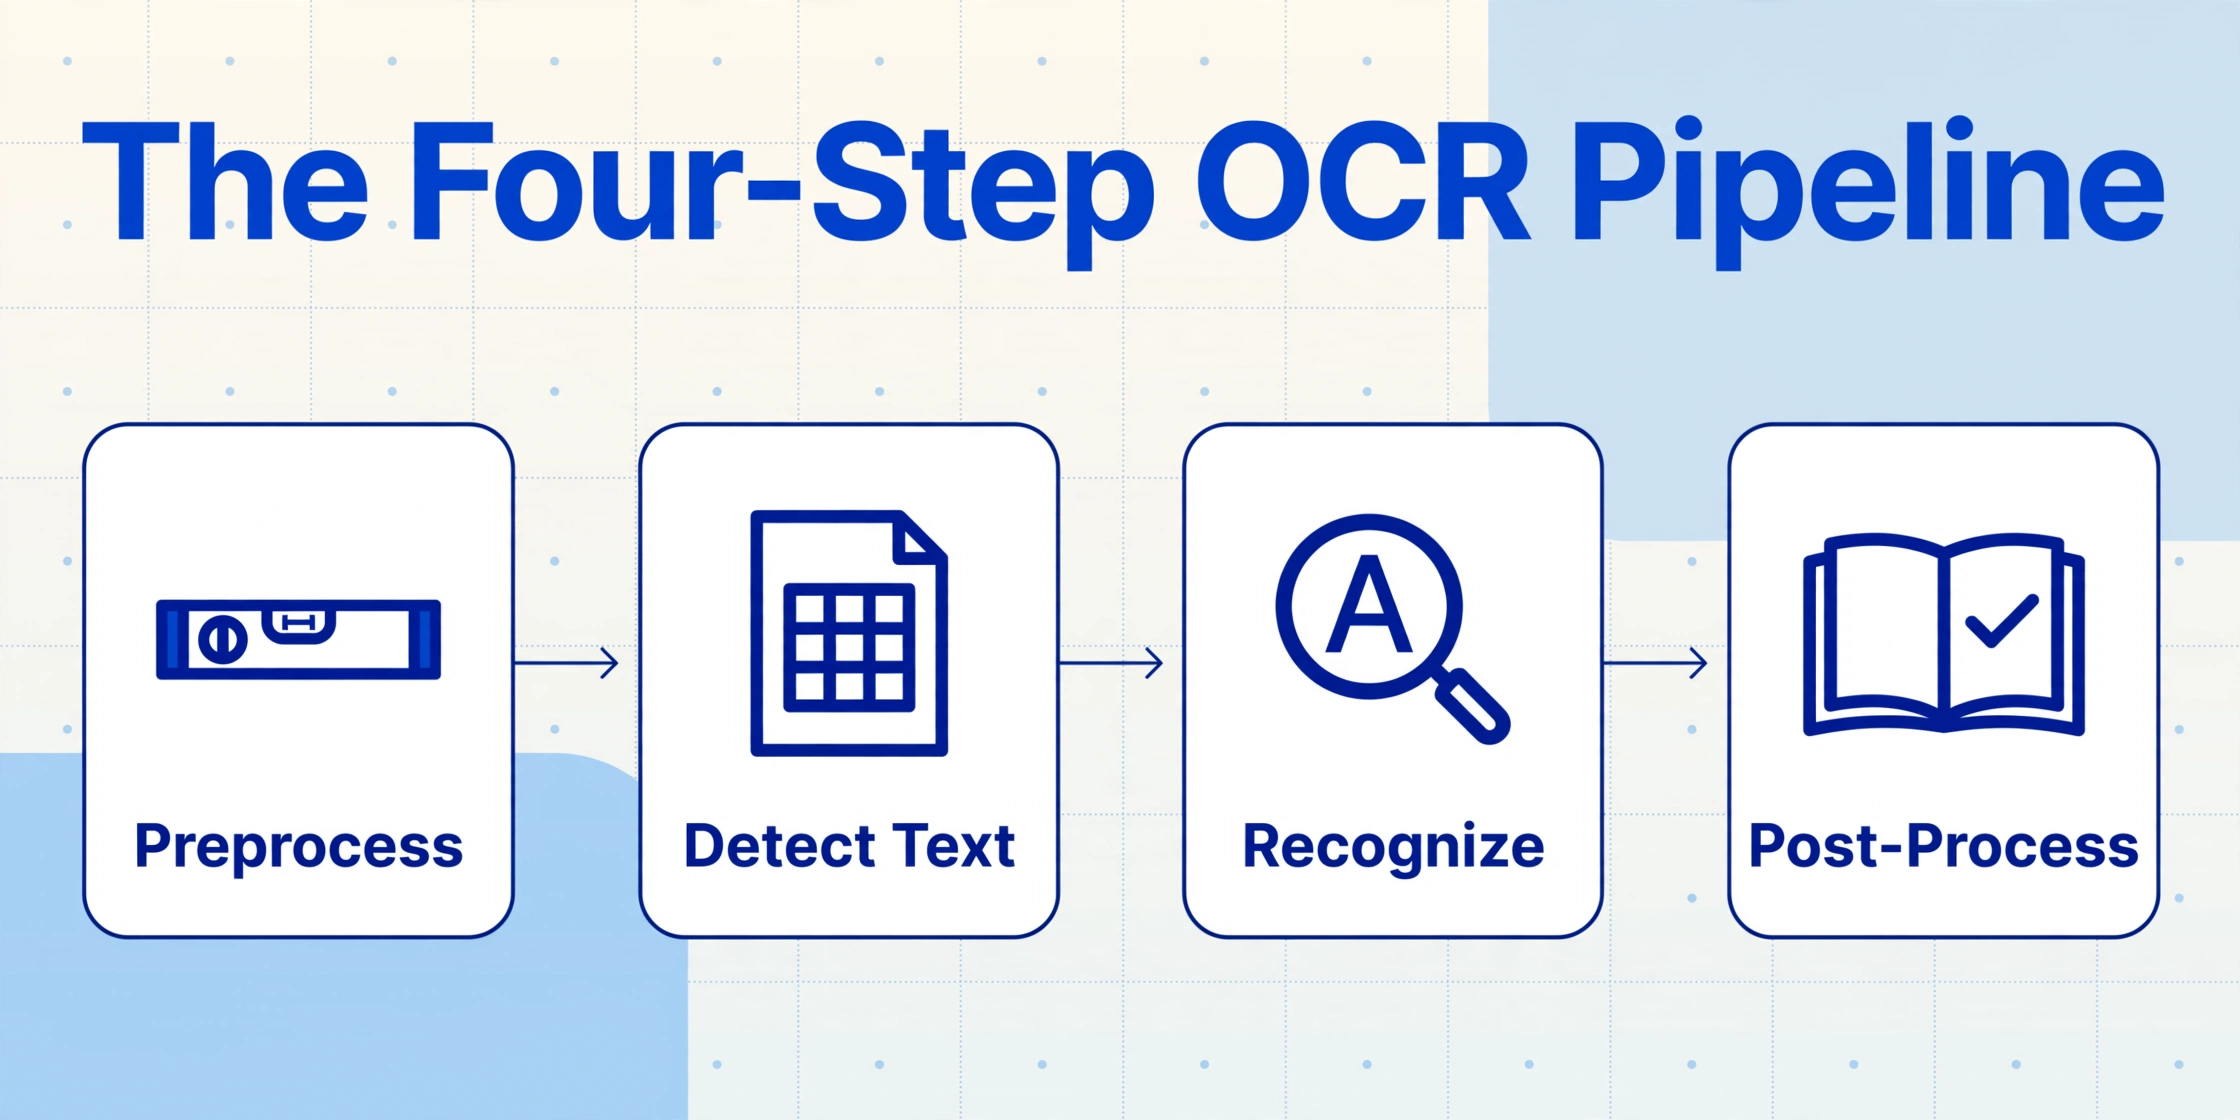
Malgré des avancées significatives en matière de précision, le pipeline OCR de base est resté structurellement cohérent pendant des décennies. Comprendre ces quatre étapes explique pourquoi certaines limites de l'OCR ne peuvent pas être corrigées par de « meilleurs algorithmes » — elles sont intégrées à l'architecture.
Prétraitement
L'image brute est nettoyée avant toute reconnaissance. Cela comprend la redressement (redressement d'un scan incliné), la suppression du bruit (taches provenant d'une ligne de fax), la binarisation (conversion en noir et blanc pur) et l'ajustement de la luminosité et du contraste. La qualité de cette étape détermine tout ce qui suit — un mauvais prétraitement garantit une mauvaise reconnaissance.
Détection de texte (analyse de mise en page)
Le moteur identifie les régions de l'image qui contiennent du texte par rapport aux images, logos, espaces vides ou décorations de page. Il divise la page en blocs, lignes et caractères individuels. Cette étape détermine l'ordre de lecture — mais elle n'a aucune compréhension de la structure du document. Un en-tête de page et un en-tête de tableau semblent identiques à la couche de détection.
Reconnaissance de caractères
L'étape OCR proprement dite. Historiquement réalisée par correspondance de modèles (comparaison de chaque forme de caractère à une bibliothèque de glyphes connus), les moteurs modernes utilisent des réseaux neuronaux entraînés sur des millions d'exemples de caractères. Chaque caractère est classé par forme — la lettre « O », le chiffre « 0 » et une icône de cercle sont tous des motifs différents que le moteur doit distinguer.
Post-traitement
Les caractères reconnus sont assemblés en mots et vérifiés par rapport aux dictionnaires et modèles linguistiques. « Recognition » peut être corrigé en « recognition ». Des règles sensibles au contexte peuvent résoudre les caractères ambigus — par exemple, utiliser le contexte environnant pour décider si « 1 » est un chiffre ou un « l » minuscule.
Le point clé est que chaque étape fonctionne de bas en haut : partir des pixels, construire des caractères, assembler des mots, regrouper en lignes. Le moteur ne voit jamais la page entière comme un document significatif. Il traite une petite région à la fois et assemble les résultats selon l'ordre de lecture. Imaginez lire un livre à travers un trou d'épingle — vous pouvez éventuellement reconstituer chaque mot, mais vous n'avez aucune idée si vous lisez un roman, un formulaire fiscal ou une liste de courses.
Les trois générations de la technologie OCR
L'OCR a évolué à travers trois générations technologiques distinctes. Chacune représente une approche fondamentalement différente du problème de la reconnaissance de caractères, et chacune a laissé derrière elle un ensemble de limitations différentes.
Génération 1 — Correspondance de motifs et OCR par modèle (1974–2014). Les premiers systèmes OCR commerciaux utilisaient la correspondance de modèles : numérisation d'un caractère capturé et comparaison pixel par pixel avec une bibliothèque de motifs de glyphes stockés. L'exemple le plus célèbre est Tesseract, développé à l'origine chez HP Labs en 1974 et désormais maintenu par Google comme moteur OCR open source de référence. Ces systèmes fonctionnaient bien sur du texte dactylographié propre dans des polices connues (atteignant 80 à 95 % de précision de caractères), mais se dégradaient fortement sur les polices inhabituelles, l'écriture manuscrite ou les scans bruités (souvent en dessous de 50 %). Chaque nouvelle police ou mise en page de document nécessitait un réglage manuel — aucune compréhension sémantique n'existait à aucun niveau.
Génération 2 — OCR par apprentissage automatique (2015–2022). L'introduction des réseaux de neurones convolutifs (CNN) puis des réseaux de neurones récurrents (RNN) a transformé la précision de la reconnaissance de caractères. Les principaux fournisseurs de cloud — Google Cloud Vision, Amazon Textract, Azure Document Intelligence — ont déployé un OCR basé sur l'apprentissage automatique qui apprenait les formes de caractères à partir de millions d'exemples d'entraînement plutôt que de correspondre à des modèles fixes. La précision des caractères sur les documents propres est passée au-dessus de 99 %. Mais la sortie restait un texte indifférencié. Une meilleure reconnaissance de caractères n'a pas produit une meilleure compréhension des données. Un moteur OCR basé sur l'apprentissage automatique pouvait indiquer le poids de police et le score de confiance de chaque lettre de la page — mais il ne pouvait toujours pas dire si une chaîne de chiffres était un numéro de facture ou un code postal.
Génération 3 — OCR par IA de vision (2023+). La dernière génération remplace le pipeline ascendant par une approche descendante et holistique. Au lieu de traiter caractère par caractère, un modèle de vision-langage (VLM) prend la page entière comme image visuelle et raisonne sur ce que chaque région, étiquette et valeur signifie en contexte. Entraînés sur des milliards de paires image-texte, ces modèles peuvent identifier le type de document, analyser les mises en page spatiales, lire le texte dans son contexte visuel et mapper les valeurs aux champs de données par signification — et non par position. C'est la technologie derrière des outils comme ImageToTable.ai. Pour une comparaison détaillée de la précision entre les générations, consultez notre analyse de la précision de l'IA OCR par rapport à l'OCR traditionnel.
| Gén 1 : Correspondance de motifs | Gén 2 : OCR ML | Gén 3 : IA Vision | |
|---|---|---|---|
| Approche | Comparaison de modèles de glyphes | Classification neuronale des caractères | Compréhension visuelle de la page entière |
| Précision sur texte propre | 80–95 % | 99 %+ | 98–99 % |
| Gestion des mises en page variées | Échec — nécessite des modèles par mise en page | Limitée — meilleurs caractères, même cécité structurelle | Native — comprend la mise en page via le contexte visuel |
| Écriture manuscrite | Moins de 50 % | 50–70 % | 75–93 % |
| Sortie | Chaîne de texte brut | Texte brut avec scores de confiance | Données structurées, mappées par champ |
OCR vs Extraction de documents — pourquoi cette différence est importante
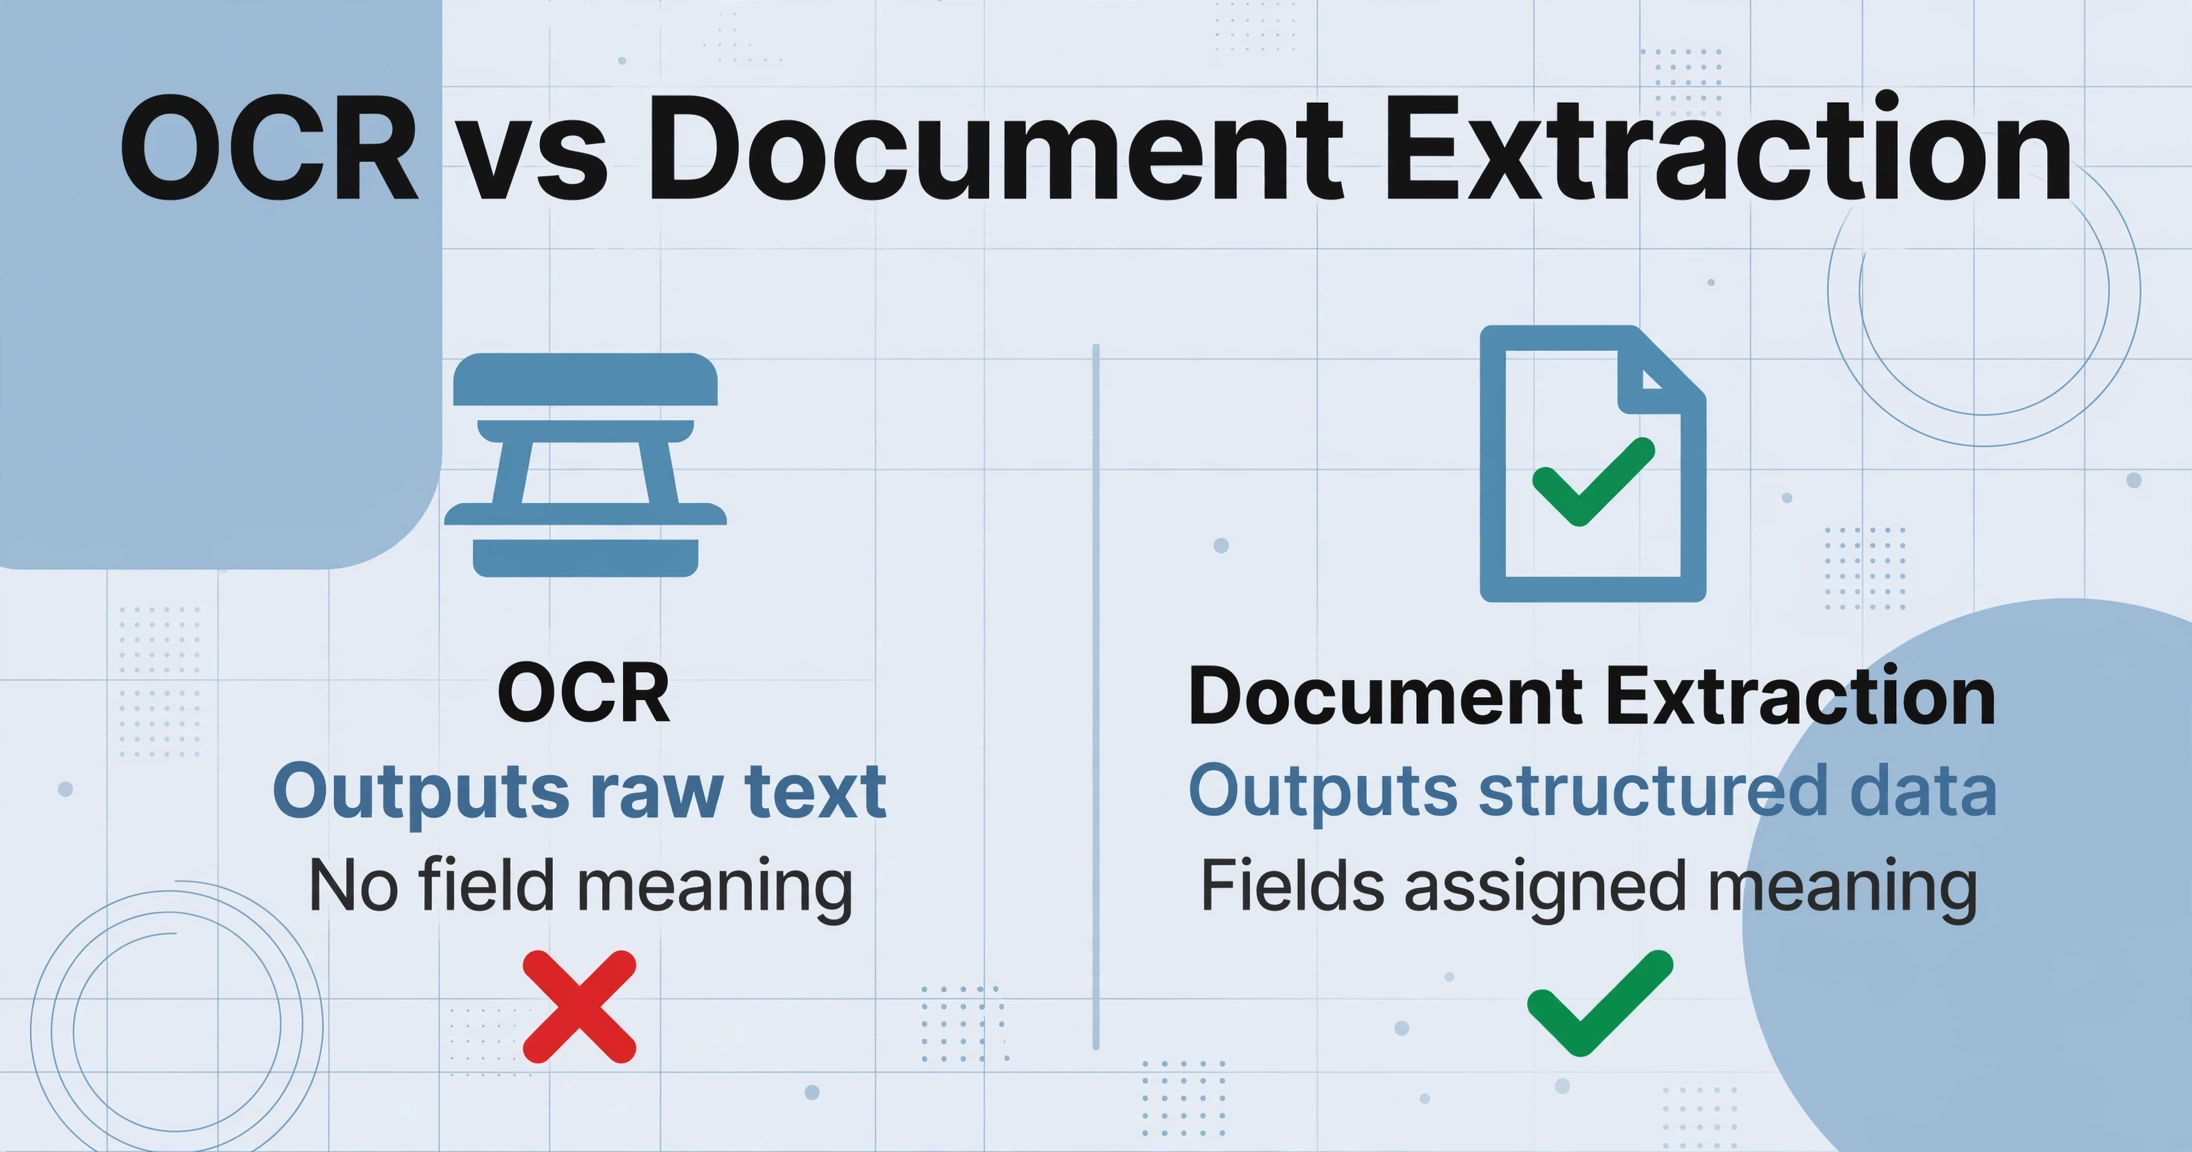
Cette distinction est le concept le plus important du secteur du traitement de documents — et celui que la plupart des explications « qu'est-ce que l'OCR » passent sous silence.
L'OCR répond : « Quels caractères figurent sur cette page ? »
L'extraction de documents répond : « Quelles données ce document contient-il ? »
La différence semble théorique jusqu'à ce que vous traitiez votre premier lot de factures multi-fournisseurs avec l'OCR seul. Voici ce que vous obtenez lorsque vous faites passer un bon de commande dans un moteur OCR traditionnel :
PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR ATLAS FASTENERS QTY 500 DESC M8 HEX BOLT UNIT $0.42 TOTAL $210.00
Un mur de texte, à peu près dans l'ordre de lecture. Le moteur OCR a extrait chaque caractère correctement — probablement avec une précision de caractères supérieure à 99 %. Mais vous devez toujours surligner chaque champ, trouver la bonne colonne dans votre feuille de calcul et copier-coller la valeur. L'OCR a numérisé les caractères. Il n'a pas effectué la saisie des données.
Faites maintenant passer le même bon de commande dans un outil d'extraction de documents par IA comme ImageToTable.ai. Le résultat est un tableau structuré :
| N° de bon de commande | Date | Fournisseur | Qté | Description | Prix unitaire | Total |
|---|---|---|---|---|---|---|
| PO-2026-0412 | 12/04/2026 | Atlas Fasteners | 500 | M8 Hex Bolt | $0.42 | $210.00 |
La différence ne réside pas dans la vitesse de reconnaissance des caractères. Elle réside dans la présence ou l'absence de compréhension sémantique. Le moteur d'extraction lit les mêmes pixels que le moteur OCR — mais il comprend aussi que « PO-2026-0412 » est un numéro de bon de commande, que « 12/04/2026 » est la date d'émission et que « $0.42 » est un prix unitaire qui appartient à une colonne spécifique. Il attribue un sens pendant l'étape de lecture, et non après.
Cela compte parce que l'extraction de documents élimine le goulot d'étranglement post-OCR — l'étape de copier-coller manuel où surviennent la plupart des erreurs. La saisie manuelle des données a un taux d'erreur constant de 1 à 4 % par champ. Pour un document à 10 champs traité en volume, cela se traduit par 100 à 400 erreurs pour 1 000 enregistrements. Et comme la sortie de l'OCR n'est pas différenciée, ces erreurs sont difficiles à détecter par programmation — un chiffre erroné qui semble plausible passe dans votre ERP sans déclencher aucune alerte. Pour une analyse complète de la façon dont l'extraction résout ce problème, consultez notre guide sur ce qu'est réellement l'extraction de documents par IA.
Quand l'OCR est le bon outil (et quand il ne l'est pas)
L'OCR n'est pas obsolète — c'est la bonne solution pour des problèmes spécifiques. La clé est de savoir quels sont ces problèmes, et d'être honnête sur ses limites.
L'OCR est le bon outil quand :
1. Vous avez besoin que les documents scannés soient consultables. C'est le cas d'usage d'origine et le plus naturel de l'OCR. Convertir un PDF scanné en document consultable — où vous pouvez faire Ctrl+F pour trouver un terme — nécessite l'OCR. Aucune couche d'extraction n'est requise.
2. Vous numérisez des archives textuelles. Livres, documents historiques, correspondance dactylographiée — lorsque l'objectif est la préservation et la recherche par mots-clés plutôt que l'extraction de données structurées — l'OCR est suffisant.
3. Vous avez besoin d'une sortie de synthèse vocale ou d'accessibilité. Les lecteurs d'écran pour les utilisateurs malvoyants s'appuient sur l'OCR pour convertir les images de documents en texte lisible. La structure du document importe moins que la reproduction précise des caractères.
L'OCR ne suffit pas quand :
1. Vous avez besoin de données structurées dans un tableur. Si votre objectif final est un tableau avec des colonnes et des lignes — numéros de facture dans une colonne, dates dans une autre, totaux dans une troisième — l'OCR seul ne peut pas le produire. Vous avez besoin d'une couche d'extraction qui attribue un sens aux caractères qu'il lit.
2. Vous traitez des documents provenant de plusieurs sources avec des mises en page différentes. Chaque fournisseur ou client qui envoie une facture au format différent crée un nouveau problème d'analyse pour les flux de travail OCR traditionnels. Sans compréhension sémantique, chaque variation de mise en page nécessite un modèle séparé ou un mappage manuel.
3. La précision compte au niveau du champ, pas au niveau du caractère. Un taux de précision de 99 % au niveau des caractères peut masquer un taux d'erreur de 20 % au niveau des champs. Lorsqu'un seul chiffre erroné dans un numéro de bon de commande ou un numéro d'identification fiscale crée un problème de rapprochement qui met des semaines à apparaître, la précision au niveau des caractères est la mauvaise mesure. Ce n'est pas seulement un problème de productivité — dans le cadre de réglementations comme SOX (Sarbanes-Oxley Act) et HIPAA, les dossiers financiers et médicaux numérisés doivent maintenir une précision et une exhaustivité démontrables (voir la Revenue Procedure 97-22 §3.02 de l'IRS pour les normes de conservation des documents scannés).
La réponse honnête est que la plupart des entreprises qui recherchent l'OCR ne cherchent pas l'OCR du tout. Elles cherchent un moyen d'extraire des données des documents et de les intégrer dans leurs systèmes — un problème que l'OCR n'a jamais été conçu pour résoudre. L'OCR convertit les pages en pixels puis en caractères. L'extraction de documents convertit les caractères en sens puis en feuilles de calcul. Les deux technologies sont complémentaires, mais elles servent des tâches fondamentalement différentes.
Questions fréquemment posées
L'OCR fonctionne-t-il avec l'écriture manuscrite ?
Les moteurs OCR traditionnels peinent avec l'écriture manuscrite — la précision se situe généralement entre 50 % et 70 % pour l'écriture en lettres moulées et sous 50 % pour l'écriture cursive. La raison est architecturale : l'OCR identifie les caractères par leur forme, et l'écriture manuscrite présente bien plus de variations de forme que le texte imprimé. Les systèmes d'IA de vision de troisième génération performent nettement mieux (75–93 %) car ils lisent les mots en contexte plutôt que de faire correspondre des formes de caractères isolées.
Quelle est la précision de l'OCR pour le texte imprimé ?
Sur des documents dactylographiés propres numérisés à 300 DPI, les moteurs OCR modernes atteignent une précision de caractères de 95 à 99 %. Ce chiffre chute considérablement sur les numérisations dégradées, les documents faxés, les polices inhabituelles ou les originaux à faible contraste. Plus important encore, la précision des caractères n'est pas la précision des champs — une précision de caractères de 99 % peut encore signifier que 15 à 40 % des champs qui vous intéressent contiennent des erreurs. Testez toujours la précision de l'OCR sur vos documents réels, pas sur des benchmarks idéalisés.
L'OCR peut-il extraire des données de PDF numérisés ?
L'OCR peut convertir le contenu image d'un PDF numérisé en texte, le rendant consultable et sélectionnable. Mais extraire des champs de données spécifiques — numéros de facture, dates, montants — et les placer dans un tableur nécessite une couche d'extraction supplémentaire. L'OCR produit le texte ; l'extraction l'organise. Un PDF numérisé via l'OCR seul vous donne un document consultable. Un PDF numérisé via l'extraction vous donne des données structurées en lignes et colonnes.
L'OCR est-il la même chose que la numérisation de documents ?
Non. La numérisation de documents est l'étape matérielle — convertir une page papier physique en image numérique (un scan ou une photo). L'OCR est l'étape logicielle qui suit — convertir cette image numérique en texte lisible par machine. La numérisation sans OCR produit une image de votre document. La numérisation avec OCR produit un document que vous pouvez rechercher, modifier et copier. La numérisation avec OCR plus extraction produit des données structurées que vous pouvez analyser.
Quels formats de fichiers l'OCR prend-il en charge ?
Les moteurs OCR acceptent tout format basé sur l'image : JPG, PNG, TIFF et PDF (numérisé et natif). Les formats de sortie incluent généralement le texte brut, le PDF consultable, le document Microsoft Word et, dans certains cas, des formats structurés comme CSV ou JSON — bien que la sortie structurée nécessite une couche d'extraction par-dessus le moteur OCR de base.
Ai-je besoin de l'OCR ou de l'extraction de documents par IA ?
Si votre objectif est de rendre les documents consultables ou modifiables — numériser un contrat scanné, créer une archive PDF consultable, activer la synthèse vocale — l'OCR suffit. Si votre objectif est d'obtenir des données structurées (numéros de facture, dates, lignes d'articles) dans un tableur ou un système comptable sans saisie manuelle, vous avez besoin de l'extraction de documents par IA. La question décisive est : voulez-vous un document consultable, ou voulez-vous des données exploitables ?
L'OCR donne une voix numérique à vos documents. La prochaine étape consiste à faire parler cette voix en colonnes et en lignes. Découvrez comment l'extraction de documents par IA lit le sens — pas seulement les caractères.