¿Qué es el OCR?
Cómo funciona realmente el reconocimiento óptico de caracteres
El OCR — reconocimiento óptico de caracteres — es la tecnología que convierte imágenes de texto mecanografiado, manuscrito o impreso en caracteres legibles por máquina. Toma lo que el ojo humano ve en una página escaneada o en una foto y lo convierte en algo que una computadora puede editar, buscar y almacenar. Pero hay una distinción crítica que la mayoría de las explicaciones omiten: el OCR digitaliza caracteres, pero no comprende lo que significan. Esa brecha determina si usted obtiene un PDF con capacidad de búsqueda o una hoja de cálculo estructurada.
Conclusiones clave
- El OCR lee cada palabra de una página escaneada con una precisión de caracteres del 99 % y, aun así, no puede distinguir un número de factura de un código postal, porque lee formas de caracteres, no el significado del documento.
- Tres generaciones de motores de OCR dedicaron 40 años a resolver el problema equivocado: mejorar el reconocimiento de caracteres. Ninguna aprendió que una cadena de dígitos podía ser un número de orden de compra: el resultado seguía siendo texto indiferenciado que aún requería copiar y pegar manualmente en cada columna de la hoja de cálculo.
- La IA de visión de tercera generación lee documentos como lo haría un ser humano — de forma integral, por significado — y asigna campos a columnas etiquetadas antes de que usted siquiera abra una hoja de cálculo.
Qué hace realmente el OCR — y qué nunca ha hecho
El OCR hace una sola cosa: lee texto de una imagen y genera una cadena de caracteres. Una página escaneada entra; sale texto sin procesar, organizado aproximadamente en orden de lectura — de izquierda a derecha, de arriba hacia abajo. El motor no intenta comprender qué significa el texto, a qué tipo de documento pertenece, ni qué partes son importantes y cuáles son texto estándar. Lee formas y produce caracteres. Esa es la transacción completa.
Para entender por qué esto importa, considere qué sucede cuando pasa una factura estándar por el OCR. El motor procesa cada carácter visible — el texto del logotipo de la empresa, el número de factura, la fecha, las descripciones de las partidas, los precios unitarios, el total — y los ensambla en un flujo de texto continuo. La salida le dirá que la página contiene la cadena "$1,234.56", pero no puede decirle si ese es el total de la factura, el subtotal de una partida, el monto de impuestos o el cargo de envío. No tiene concepto de "total de factura" como categoría. No sabe qué significa "partida". Lee, pero no comprende.
Por eso el OCR no es extracción de documentos, y el OCR no es automatización de ingreso de datos. Es la primera capa de un proceso — la capa que convierte píxeles en caracteres. Todo lo que viene después — identificar qué caracteres pertenecen a qué campo, validar formatos, estructurar la salida en filas y columnas — requiere inteligencia adicional superpuesta.
El OCR responde la pregunta "¿qué caracteres hay en esta página?" No responde "¿qué datos contiene este documento?" La diferencia entre esas dos preguntas es la diferencia entre un archivo de texto y una hoja de cálculo.
Cómo funciona el OCR: el proceso de cuatro pasos
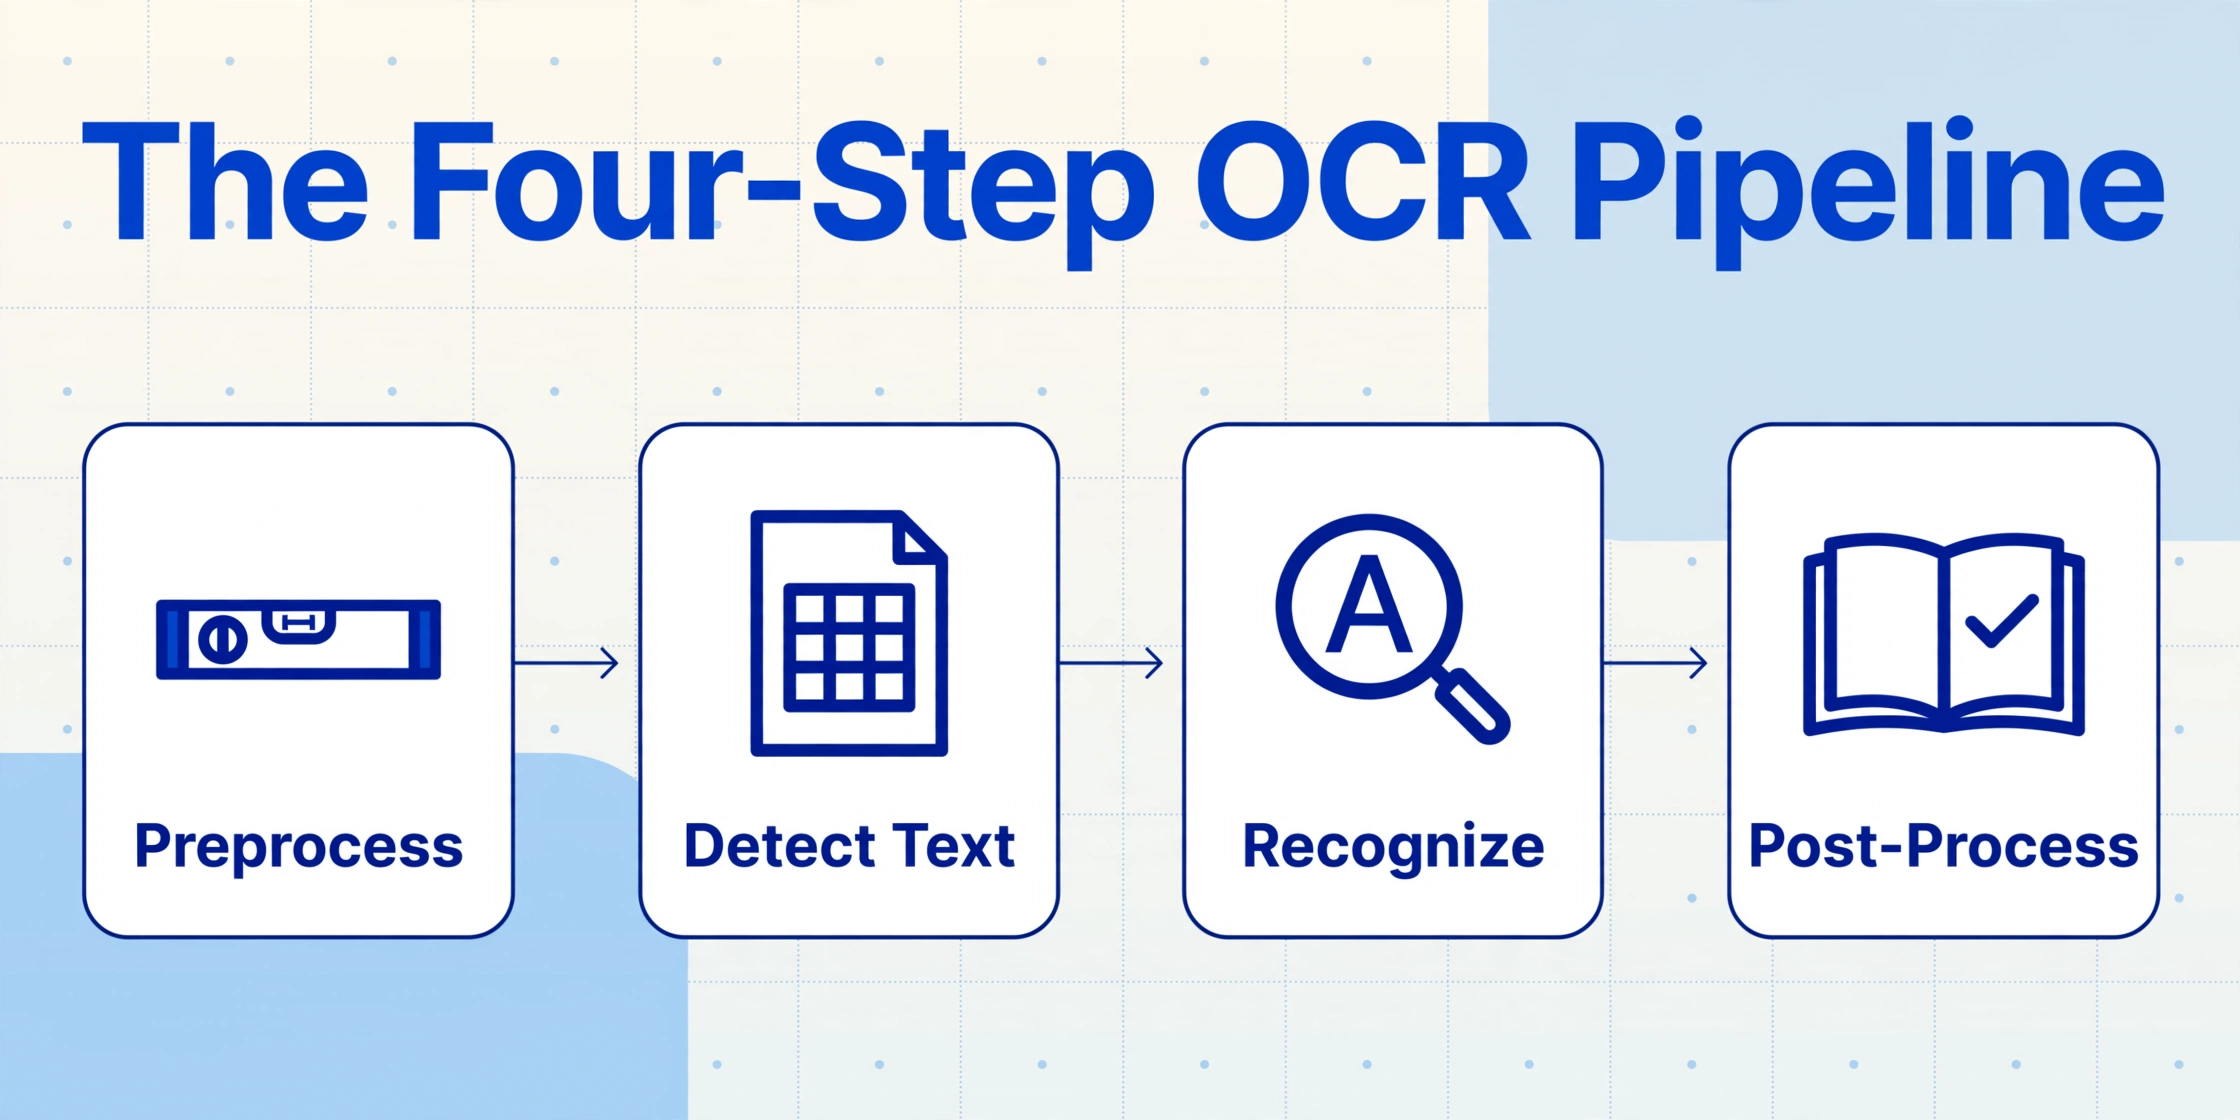
A pesar de los avances significativos en precisión, el proceso central del OCR se ha mantenido estructuralmente consistente durante décadas. Comprender estos cuatro pasos explica por qué algunas limitaciones del OCR no se pueden corregir con "mejores algoritmos" — están integradas en la arquitectura.
Preprocesamiento
La imagen en bruto se limpia antes de que ocurra cualquier reconocimiento. Esto incluye enderezar (corregir un escaneo torcido), eliminar el ruido (motas de una línea de fax), binarizar (convertir a blanco y negro puro) y ajustar la iluminación y el contraste. La calidad de este paso determina todo lo que sigue: un mal preprocesamiento garantiza un mal reconocimiento.
Detección de texto (análisis de diseño)
El motor identifica qué regiones de la imagen contienen texto frente a imágenes, logotipos, espacios en blanco o decoraciones de página. Divide la página en bloques, líneas y caracteres individuales. Este paso determina el orden de lectura, pero no tiene comprensión de la estructura del documento. Un encabezado de página y un encabezado de tabla se ven iguales para la capa de detección.
Reconocimiento de caracteres
El paso real de OCR. Históricamente se hacía mediante coincidencia de plantillas (comparando la forma de cada carácter con una biblioteca de glifos conocidos); los motores modernos usan redes neuronales entrenadas con millones de ejemplos de caracteres. Cada carácter se clasifica por su forma: la letra "O", el dígito "0" y un icono de círculo son patrones diferentes que el motor debe distinguir.
Postprocesamiento
Los caracteres reconocidos se ensamblan en palabras y se verifican contra diccionarios y modelos de lenguaje. "Recognition" podría corregirse a "recognition". Las reglas sensibles al contexto pueden resolver caracteres ambiguos; por ejemplo, usar el contexto circundante para decidir si "1" es un dígito o una "l" minúscula.
La observación clave es que cada paso opera de abajo hacia arriba: comenzar desde los píxeles, construir caracteres, ensamblar palabras y agrupar en líneas. El motor nunca ve la página completa como un documento significativo. Procesa una pequeña región a la vez y une los resultados según el orden de lectura. Piense en ello como leer un libro a través de un agujero de alfiler: eventualmente puede reconstruir cada palabra, pero no tiene idea de si está leyendo una novela, un formulario de impuestos o una lista de compras.
Las tres generaciones de la tecnología de OCR
El OCR ha evolucionado a través de tres generaciones tecnológicas distintas. Cada una representa un enfoque fundamentalmente diferente al problema del reconocimiento de caracteres, y cada una dejó un conjunto diferente de limitaciones.
Generación 1: coincidencia de patrones y OCR con plantillas (1974–2014). Los primeros sistemas comerciales de OCR usaban coincidencia de plantillas: escaneaban un carácter capturado y lo comparaban píxel por píxel contra una biblioteca de glifos almacenados. El ejemplo más famoso es Tesseract, desarrollado originalmente en HP Labs en 1974 y ahora mantenido por Google como el motor de OCR de código abierto líder. Estos sistemas funcionaban bien con texto limpio y mecanografiado en fuentes conocidas (logrando una precisión de caracteres del 80–95 %), pero se degradaban drásticamente con tipografías inusuales, escritura a mano o escaneos con ruido (a menudo por debajo del 50 %). Cada fuente o diseño de documento nuevo requería ajustes manuales; no existía comprensión semántica en ningún nivel.
Generación 2: OCR con aprendizaje automático (2015–2022). La introducción de las redes neuronales convolucionales (CNN) y, más tarde, de las redes neuronales recurrentes (RNN) transformó la precisión del reconocimiento de caracteres. Los principales proveedores de la nube — Google Cloud Vision, Amazon Textract, Azure Document Intelligence — implementaron OCR impulsado por aprendizaje automático que aprendía las formas de los caracteres a partir de millones de ejemplos de entrenamiento en lugar de coincidir con plantillas fijas. La precisión de caracteres en documentos limpios superó el 99 %. Pero el resultado seguía siendo texto indiferenciado. Un mejor reconocimiento de caracteres no producía una mejor comprensión de los datos. Un motor de OCR basado en aprendizaje automático podía decirle el peso de la fuente y la puntuación de confianza de cada letra en la página, pero aún así no podía decirle si una cadena de dígitos era un número de factura o un código postal.
Generación 3: OCR con IA de visión (2023+). La generación más reciente reemplaza el flujo ascendente por un enfoque holístico de arriba hacia abajo. En lugar de procesar carácter por carácter, un modelo de visión y lenguaje (VLM) toma la página completa como una imagen visual y razona sobre qué significa cada región, etiqueta y valor en su contexto. Entrenados con miles de millones de pares de imagen y texto, estos modelos pueden identificar el tipo de documento, analizar diseños espaciales, leer texto en su contexto visual y asignar valores a campos de datos por significado — no por posición. Esta es la tecnología detrás de herramientas como ImageToTable.ai. Para una comparación detallada de precisión entre generaciones, consulte nuestro análisis de IA de OCR frente a precisión de OCR tradicional.
| Gen 1: Coincidencia de patrones | Gen 2: OCR con ML | Gen 3: IA de visión | |
|---|---|---|---|
| Enfoque | Comparación de plantillas de glifos | Clasificación neuronal de caracteres | Comprensión visual de la página completa |
| Precisión en texto limpio | 80–95% | 99%+ | 98–99% |
| Manejo de diseños variados | Falla: requiere plantillas por diseño | Limitado: mejores caracteres, misma ceguera estructural | Nativo: comprende el diseño mediante el contexto visual |
| Escritura a mano | Por debajo del 50% | 50–70% | 75–93% |
| Resultado | Cadena de texto sin procesar | Texto sin procesar con puntuaciones de confianza | Datos estructurados, asignados a campos |
OCR frente a extracción de documentos: por qué la diferencia importa
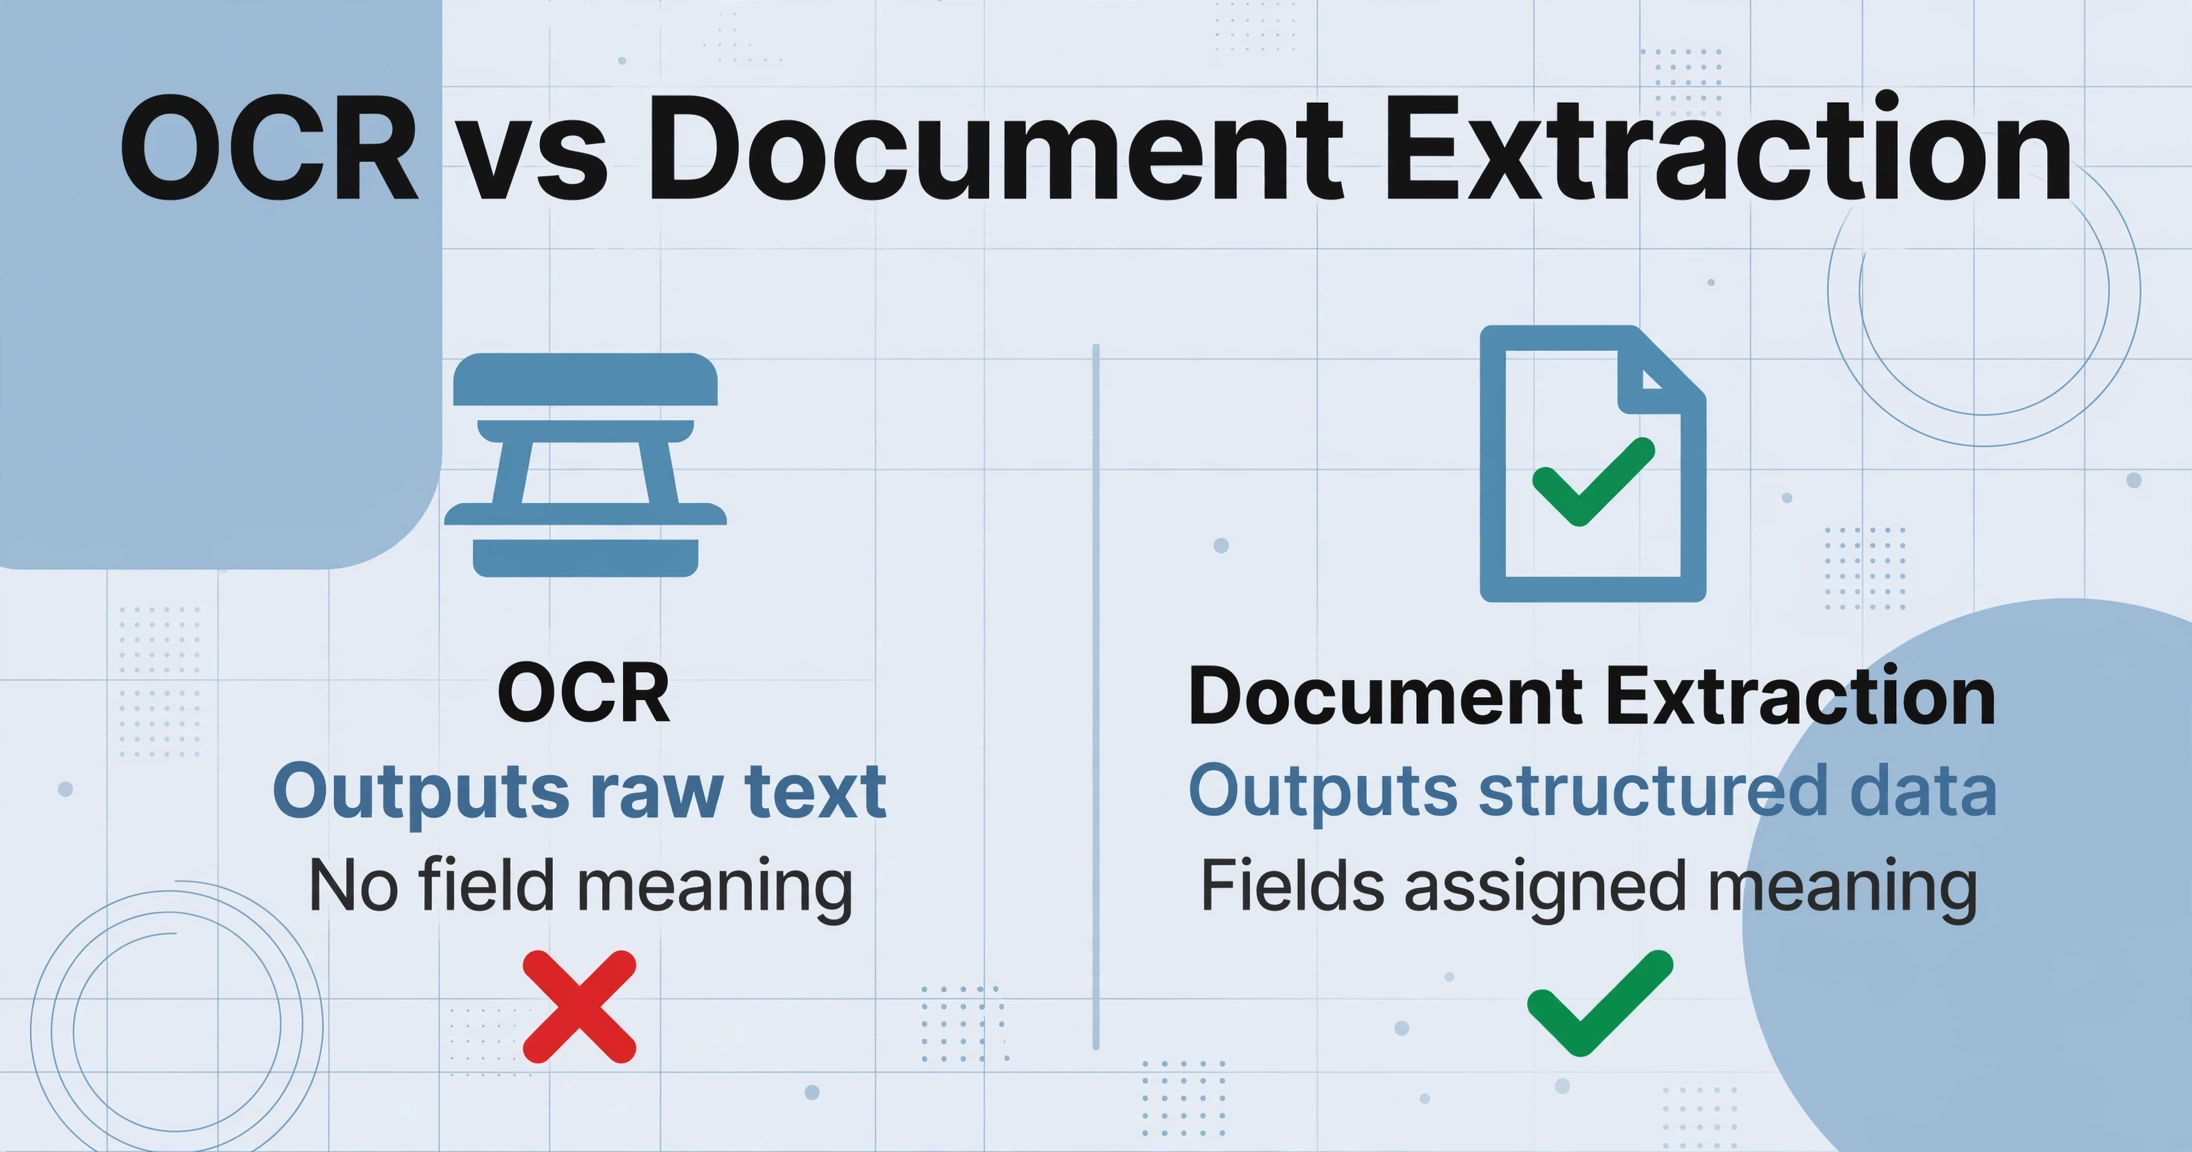
Esta distinción es el concepto más importante en la industria del procesamiento de documentos, y es el que la mayoría de las explicaciones de "qué es OCR" pasan por alto.
OCR responde: "¿Qué caracteres hay en esta página?"
La extracción de documentos responde: "¿Qué datos contiene este documento?"
La diferencia parece académica hasta que procesa su primer lote de facturas de múltiples proveedores solo con OCR. Esto es lo que obtiene cuando ejecuta una orden de compra a través de un motor de OCR tradicional:
PURCHASE ORDER PO-2026-0412 DATE 12/04/2026 VENDOR ATLAS FASTENERS QTY 500 DESC M8 HEX BOLT UNIT $0.42 TOTAL $210.00
Un muro de texto, aproximadamente en orden de lectura. El motor de OCR extrajo cada carácter correctamente, probablemente con una precisión de caracteres superior al 99 %. Pero aún tiene que resaltar cada campo, encontrar la columna correcta en su hoja de cálculo y copiar y pegar el valor. El OCR digitalizó los caracteres. No hizo la entrada de datos.
Ahora ejecute la misma orden de compra a través de una herramienta de extracción de documentos con IA como ImageToTable.ai. El resultado es una tabla estructurada:
| N.º de orden de compra | Fecha | Proveedor | Cant. | Descripción | Precio unitario | Total |
|---|---|---|---|---|---|---|
| PO-2026-0412 | 12/04/2026 | Atlas Fasteners | 500 | M8 Hex Bolt | $0.42 | $210.00 |
La diferencia no es la velocidad del reconocimiento de caracteres. Es la presencia o ausencia de comprensión semántica. El motor de extracción lee los mismos píxeles que el motor de OCR, pero también entiende que "PO-2026-0412" es un número de orden de compra, "12/04/2026" es la fecha de emisión y "$0.42" es un precio unitario que pertenece a una columna específica. Asigna significado durante el paso de lectura, no después.
Esto importa porque la extracción de documentos elimina el cuello de botella posterior al OCR: el paso manual de copiar y pegar donde ocurren la mayoría de los errores. La entrada de datos humana tiene una tasa de error constante del 1 al 4 % por campo. Para un documento de 10 campos procesado a gran volumen, eso se traduce en 100 a 400 errores por cada 1.000 registros. Y como la salida del OCR no está diferenciada, esos errores son difíciles de detectar programáticamente: un dígito incorrecto que parece plausible pasa a su ERP sin activar ninguna alerta. Para un desglose completo de cómo la extracción resuelve esto, consulte nuestra guía sobre qué es realmente la extracción de documentos con IA.
Cuándo el OCR es la herramienta adecuada (y cuándo no lo es)
El OCR no está obsoleto: es la solución adecuada para problemas específicos. La clave está en saber cuáles son esos problemas y ser honesto acerca de dónde se queda corto.
El OCR es la herramienta adecuada cuando:
1. Necesita que los documentos escaneados sean buscables. Este es el caso de uso original y más natural del OCR. Convertir un PDF escaneado en un documento buscable — donde pueda usar Ctrl+F para encontrar un término — requiere OCR. No se necesita ninguna capa de extracción.
2. Está digitalizando archivos de texto. Libros, registros históricos, correspondencia mecanografiada — cuando el objetivo es la preservación y la búsqueda por palabras clave en lugar de la extracción de datos estructurados — el OCR es suficiente.
3. Necesita salida de texto a voz o accesibilidad. Los lectores de pantalla para usuarios con discapacidad visual dependen del OCR para convertir imágenes de documentos en texto legible. La estructura del documento importa menos que la reproducción precisa de los caracteres.
El OCR no es suficiente cuando:
1. Necesita datos estructurados en una hoja de cálculo. Si su objetivo final es una tabla con columnas y filas — números de factura en una columna, fechas en otra, totales en una tercera — el OCR por sí solo no puede producirlo. Necesita una capa de extracción que asigne significado a los caracteres que lee.
2. Procesa documentos de múltiples fuentes con diferentes diseños. Cada proveedor o cliente que envía una factura con un formato diferente crea un nuevo problema de análisis para los flujos de trabajo tradicionales de OCR. Sin comprensión semántica, cada variación de diseño requiere una plantilla separada o un mapeo manual.
3. La precisión importa a nivel de campo, no a nivel de carácter. Una precisión de caracteres del 99 % puede enmascarar una tasa de error de campo del 20 %. Cuando un dígito incorrecto en un número de orden de compra o un ID fiscal crea un problema de conciliación que tarda semanas en salir a la luz, la precisión a nivel de carácter es la métrica equivocada. Esto no es solo un problema de productividad: bajo marcos regulatorios como SOX (Ley Sarbanes-Oxley) e HIPAA, los registros financieros y médicos digitalizados deben mantener una precisión e integridad demostrables (consulte la Revenue Procedure 97-22 §3.02 del IRS para los estándares de retención de documentos escaneados).
La respuesta honesta es que la mayoría de las empresas que buscan OCR no buscan OCR en absoluto. Buscan una manera de extraer datos de los documentos e incorporarlos a sus sistemas — un problema que el OCR nunca fue diseñado para resolver. El OCR convierte páginas en píxeles y luego en caracteres. La extracción de documentos convierte caracteres en significado y luego en hojas de cálculo. Las dos tecnologías son complementarias, pero cumplen trabajos fundamentalmente diferentes.
Preguntas frecuentes
¿Funciona el OCR con escritura a mano?
Los motores de OCR tradicionales tienen dificultades con la escritura a mano: la precisión suele situarse entre el 50% y el 70% para la letra de imprenta y por debajo del 50% para la cursiva. La razón es arquitectónica: el OCR identifica caracteres por su forma, y la escritura a mano presenta mucha más variación de formas que el texto impreso. Los sistemas de visión artificial de tercera generación rinden significativamente mejor (75–93%) porque leen palabras en contexto en lugar de comparar formas de caracteres de forma aislada.
¿Qué precisión tiene el OCR para texto impreso?
En documentos mecanografiados limpios escaneados a 300 DPI, los motores de OCR modernos alcanzan una precisión de caracteres del 95–99%. Esa cifra disminuye considerablemente en escaneos degradados, documentos por fax, fuentes inusuales o originales de bajo contraste. Más importante aún: la precisión de caracteres no es la precisión de campos: una precisión de caracteres del 99% puede significar que entre el 15% y el 40% de los campos que le interesan contengan errores. Pruebe siempre la precisión del OCR con sus documentos reales, no con puntos de referencia idealizados.
¿Puede el OCR extraer datos de PDF escaneados?
El OCR puede convertir el contenido de imagen de un PDF escaneado en texto, haciéndolo buscable y seleccionable. Pero extraer campos de datos específicos — números de factura, fechas, importes — y colocarlos en una hoja de cálculo requiere una capa de extracción adicional. El OCR produce el texto; la extracción lo organiza. Un PDF escaneado solo con OCR le ofrece un documento buscable. Un PDF escaneado con extracción le ofrece datos estructurados en filas y columnas.
¿Es el OCR lo mismo que el escaneo de documentos?
No. El escaneo de documentos es el paso de hardware: convertir una página de papel físico en una imagen digital (un escaneo o una foto). El OCR es el paso de software que sigue: convertir esa imagen digital en texto legible por máquina. Escanear sin OCR produce una imagen de su documento. Escanear con OCR produce un documento del que puede buscar, editar y copiar texto. Escanear con OCR más extracción produce datos estructurados que puede analizar.
¿Qué formatos de archivo admite el OCR?
Los motores de OCR aceptan cualquier formato basado en imágenes: JPG, PNG, TIFF y PDF (tanto escaneados como nativos). Los formatos de salida suelen incluir texto sin formato, PDF buscable, documento de Microsoft Word y, en algunos casos, formatos estructurados como CSV o JSON — aunque la salida estructurada requiere una capa de extracción sobre el motor de OCR principal.
¿Necesito OCR o extracción de documentos con IA?
Si su objetivo es hacer que los documentos sean buscables o editables — digitalizar un contrato escaneado, crear un archivo PDF buscable, habilitar texto a voz — el OCR es suficiente. Si su objetivo es obtener datos estructurados (números de factura, fechas, partidas) en una hoja de cálculo o sistema contable sin entrada manual, necesita extracción de documentos con IA. La pregunta decisiva es: ¿quiere un documento buscable o quiere datos utilizables?
El OCR le da a sus documentos una voz digital. El siguiente paso es hacer que esa voz hable en columnas y filas. Vea cómo la extracción de documentos con IA lee el significado, no solo los caracteres.