Melhor Software de OCR para Manuscritos 2026:
Ferramentas Que Realmente Leem Cursiva
A maioria das ferramentas de OCR atinge 99% em texto impresso e cai para 60% em manuscritos — porque texto impresso é um problema resolvido e cursiva é um problema fundamentalmente diferente. A diferença não é sobre resolução ou qualidade de imagem; é sobre como as duas tecnologias abordam a página. Este comparativo testa 11 ferramentas na única pergunta que importa para manuscritos: elas realmente leem cursiva, não apenas letras maiúsculas?
Qual comparativo é qual: este guia é o mergulho profundo em software de OCR para manuscritos — 11 ferramentas avaliadas em cursiva, organizadas por categoria de tecnologia. Para uma comparação mais ampla de "conversor de manuscrito para texto" que cobre aplicativos de transcrição e ferramentas de anotações junto com mecanismos de OCR, comece com nosso comparativo de melhores conversores de manuscrito para texto 2026. Se o seu manuscrito é na verdade um formulário e o que você precisa são os valores em colunas de planilha em vez de uma transcrição completa, nossa comparação de ferramentas de reconhecimento de manuscrito e extração de dados cobre esse ângulo de extração estruturada especificamente.
Principais Conclusões
- 99% de precisão em texto impresso, abaixo de 60% em cursiva — a diferença não é um problema de qualidade. O mesmo mecanismo de OCR foi construído para encontrar limites entre letras, e a cursiva remove deliberadamente esses limites.
- O OCR tradicional compara cada caractere a uma biblioteca de padrões isoladamente. Em cursiva conectada, um “a” tocando um “n” não se parece com nenhum dos dois, e o mecanismo não tem como resolver a ambiguidade sem entender a palavra inteira.
- As cinco categorias de tecnologia — modelos de visão-linguagem, APIs de nuvem, OCR de desktop, HTR dedicado e ferramentas móveis — determinam a precisão em cursiva mais do que qualquer nome de marca. Combine a categoria ao seu tipo de manuscrito primeiro, depois compare dentro dela.
O número honesto que a maioria dos resumos não destaca: a precisão média do OCR de manuscritos em todas as ferramentas gira em torno de 64% — e isso antes de considerar a cursiva. Uma ferramenta que atinge 99% em uma fatura impressa pode cair para 40-60% em escrita cursiva, porque a arquitetura que a torna rápida em texto impresso nunca foi projetada para letras conectadas. Este guia está organizado em torno dessa realidade: cinco categorias de ferramentas, 11 análises individuais e um panorama claro de qual ferramenta funciona para qual tipo de manuscrito — porque a escolha certa muda completamente dependendo se seus documentos usam cursiva, letra de forma ou ambos.
Tabela de comparação rápida
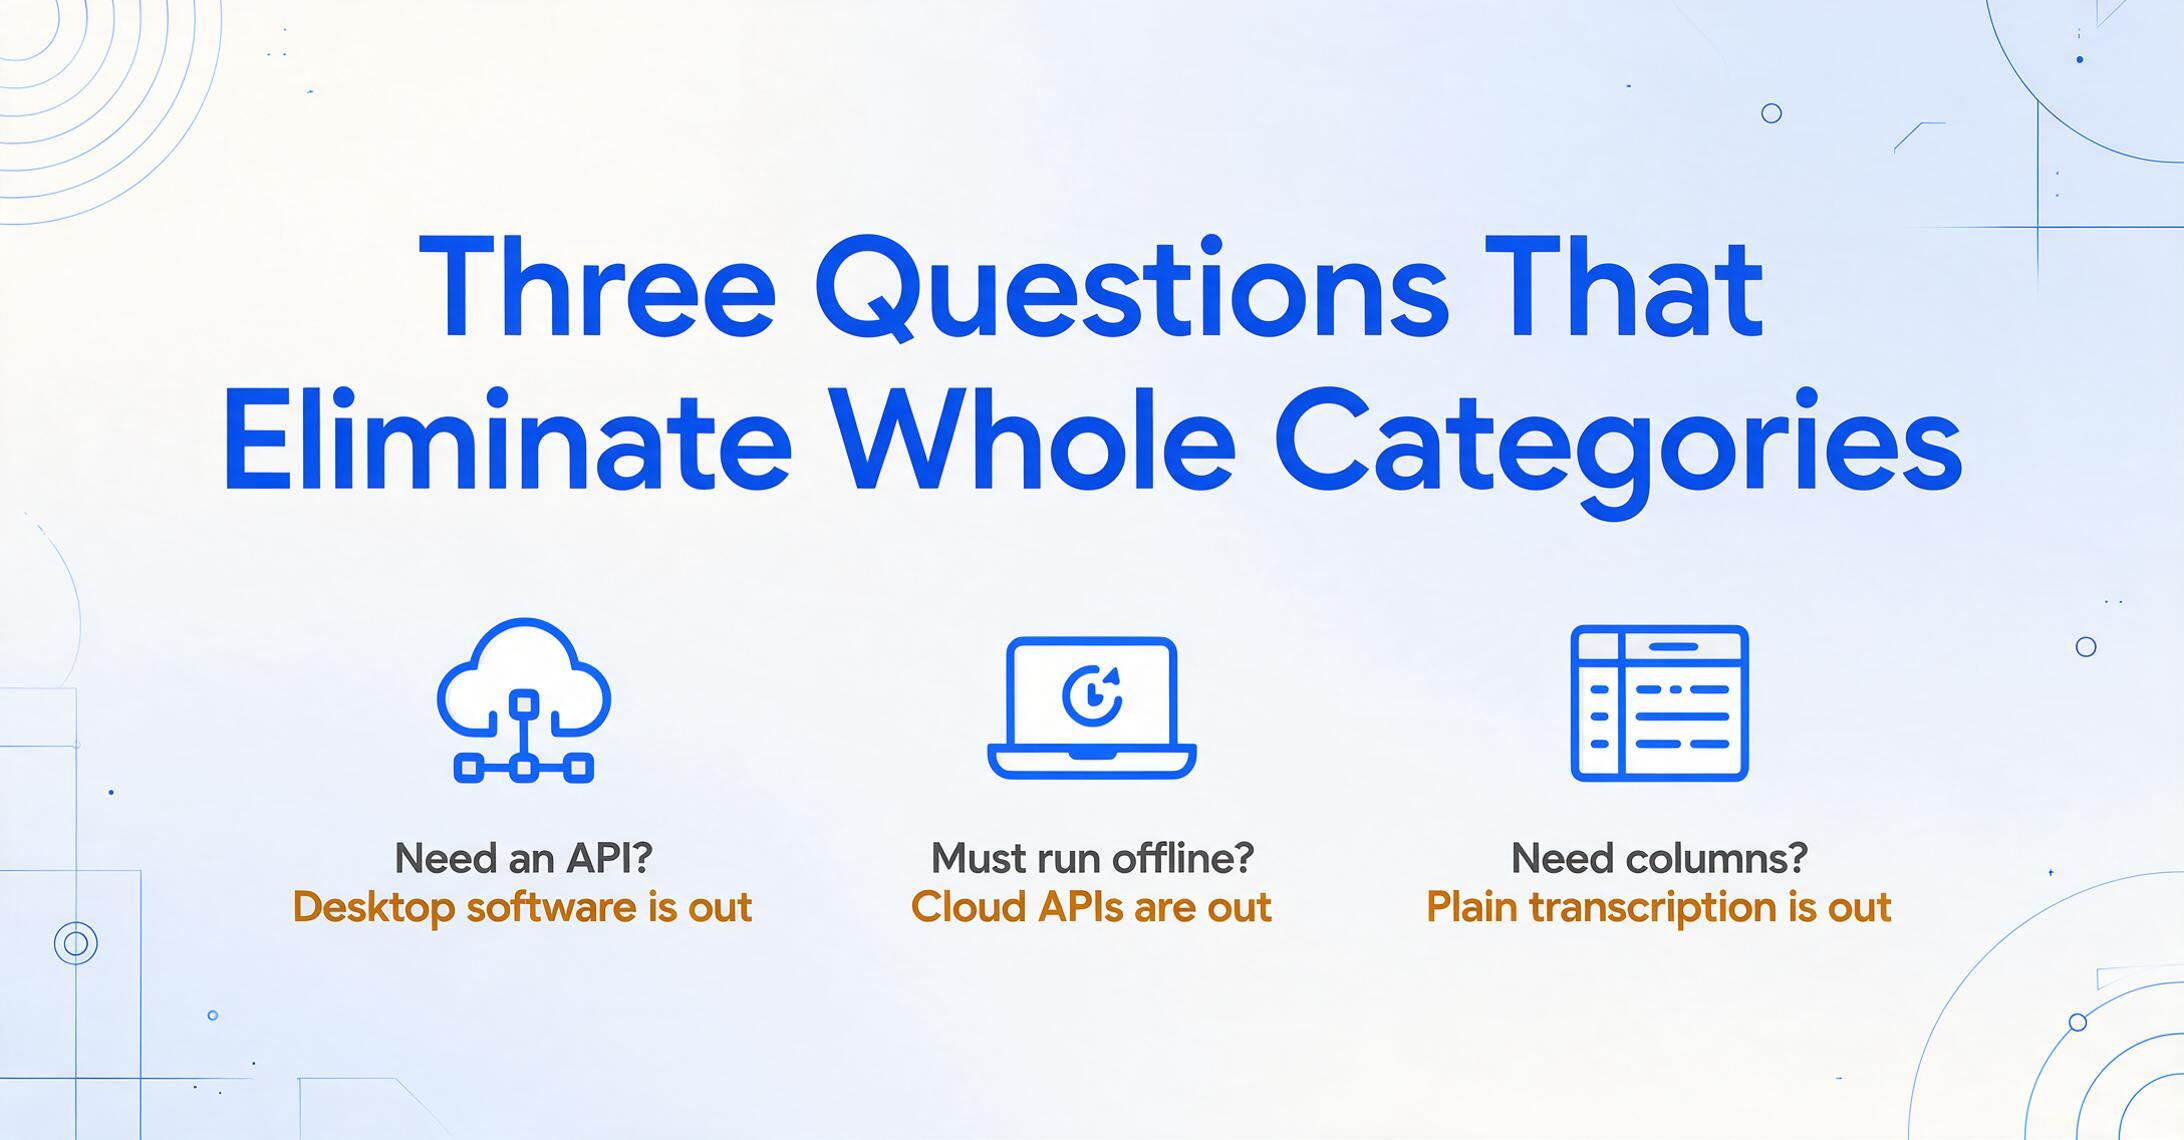
Cada ferramenta deste resumo é analisada em detalhes abaixo. Esta tabela é a maneira mais rápida de eliminar categorias inteiras: se você precisa de uma API, o software de desktop não vai ajudar. Se você precisa operar offline, uma API de nuvem não vai funcionar.
| Ferramenta | Categoria | Estilo de Escrita | Preço Inicial | Melhor Para |
|---|---|---|---|---|
| GPT-5 (Vision) | IA / VLM | Curso ★★★★☆ | $20/mês (ChatGPT+) | Melhor precisão em cursiva (benchmark) |
| Gemini 3 Pro | IA / VLM | Curso ★★★★☆ | API baseada em uso | Compreensão de manuscritos com contexto |
| Azure Document Intelligence | API de nuvem | Curso ★★★☆☆ | $1,50/1.000 páginas | Formulários estruturados + caixas delimitadoras |
| Amazon Textract | API de nuvem | Curso ★★☆☆☆ | $1,50/1.000 páginas | API escalável com suporte a letra de forma |
| Google Cloud Vision | API de nuvem | Curso ★★★☆☆ | $1,50/1.000 páginas | Detecção de manuscritos multilíngue |
| ImageToTable.ai | Extração por IA | Curso ★★★★☆ | Demo gratuita (sem cadastro) | Manuscrito → dados estruturados ou Word |
| Transkribus | HTR dedicado | Curso ★★★★★ | Grátis (50 créditos/mês) | Escritas cursivas históricas / de arquivo |
| ABBYY FineReader | OCR de desktop | Curso ★★★☆☆ | $199 (pagamento único) | OCR de desktop com suporte a manuscritos |
| Microsoft OneNote/Office Lens | Grátis / Notas | Curso ★★☆☆☆ | Grátis | Captura rápida de anotações organizadas |
| Pen to Print | Mobile | Curso ★★★☆☆ | Grátis; $2,99/mês Premium | Transcrição de cursiva no celular |
| Apple Live Text | Integrado (iOS) | Curso ★★☆☆☆ | Grátis (iOS 15+) | Captura instantânea sem configuração |
As classificações de cursiva são estimativas baseadas em benchmarks independentes e relatos de profissionais (AIMultiple 2026, codesota 2026). Preços verificados em junho de 2026.
Como selecionamos e testamos
A precisão do OCR de manuscritos não é um número único — ela depende do estilo de escrita, da qualidade da imagem, do idioma e da estrutura do documento. Um benchmark independente de janeiro de 2026 da AIMultiple, criado a partir de 100 amostras cursivas de 10 escritores com variabilidade de traço intencionalmente preservada, constatou que até os melhores modelos mostram uma grande variação de precisão conforme o estilo de escrita. Essa é a forma certa de pensar sobre isso: nenhum número de benchmark isolado descreve o desempenho no mundo real.
Avaliamos as ferramentas em cinco dimensões: precisão de cursiva (como a ferramenta lida com letras conectadas, não apenas letra de forma); variedade de estilos de escrita (imprensa, cursiva, mista); flexibilidade de entrada (fotos, digitalizações, PDFs, tinta digital); formato de saída (texto simples vs. colunas estruturadas vs. Word); e preços práticos. Os números de precisão vêm de fontes independentes — o benchmark de cursiva da AIMultiple, o ranking IAM da codesota e relatos de campo de profissionais — não de marketing de fornecedores.
Classificamos as ferramentas por tipo de tecnologia porque a categoria diz mais sobre o desempenho em cursiva do que o nome do fornecedor. Entender a diferença entre como o OCR tradicional funciona — correspondência de padrões de formas de caracteres individuais — versus como modelos de visão-linguagem entendem páginas — lendo palavras em contexto — é a coisa mais útil que você pode saber antes de comparar benchmarks. Nossa comparação entre OCR e extração por IA explica por que essa diferença arquitetural importa para manuscritos.
Divulgação completa: o ImageToTable.ai, publicado neste site, é analisado abaixo. Nós o posicionamos onde ele honestamente se encaixa — OCR de manuscritos com IA que também pode gerar colunas estruturadas — e citamos os pontos onde outros vencem: Transkribus para HTR de arquivo, GPT-5 para precisão bruta em benchmark de cursiva, ABBYY para OCR de desktop. Cada ferramenta recebe um "melhor para" e um "não ideal para" específicos.
Os cinco tipos de OCR para manuscrito — e por que a categoria importa mais que o nome
Ferramentas de OCR para manuscrito se dividem em cinco categorias tecnológicas, e a categoria determina o desempenho em cursiva mais do que qualquer recurso isolado. Veja por que elas são diferentes — e por que você não pode julgar uma API na nuvem pelos mesmos padrões de um OCR de desktop.
1. Modelos de Linguagem Visual (VLMs)
GPT-5, Gemini 3 Pro e Claude Opus 4.7 não são mecanismos de OCR no sentido tradicional. São modelos de visão de uso geral que, por acaso, conseguem ler manuscritos ao compreender o significado do que veem — formas de caracteres, contexto das palavras, propósito do documento — tudo de uma vez. Essa abordagem semântica lhes dá uma vantagem decisiva na cursiva, pois não tentam separar letras que nunca foram feitas para ser separadas. Eles leem a palavra como você: reconhecendo a forma inteira. A desvantagem é o custo: chamadas de API são mais caras por página que o OCR tradicional, e os modelos podem alucinar em páginas longas ou repetitivas.
2. APIs de OCR na Nuvem
Amazon Textract, Google Cloud Vision e Azure Document Intelligence são APIs de leitura de documentos criadas pelos grandes provedores de nuvem. Elas lidam com texto impresso com precisão quase perfeita e possuem modelos dedicados de detecção de manuscrito, mas sua precisão em manuscrito fica atrás dos VLMs de ponta — especialmente na cursiva. Onde elas ganham é em escala, custo e integração: processam milhares de páginas por minuto a centavos por página, retornam JSON estruturado com caixas delimitadoras e se integram a fluxos empresariais com conformidade HIPAA BAA e SOC 2. A desvantagem é que você precisa de engenharia para usá-las de forma eficaz.
3. Software OCR de Desktop
ABBYY FineReader e Adobe Acrobat Pro representam a abordagem tradicional de OCR — software instalado que processa documentos localmente. Eles se destacam na preservação do layout e em texto impresso. O suporte a manuscrito melhorou drasticamente — a versão mais recente do ABBYY atinge cerca de 95% em letra de forma manuscrita e 91,7% em cursiva em testes independentes — mas foram arquitetados para caracteres separados, e seu teto na cursiva é real. A vantagem é o preço único, operação offline e privacidade (tudo fica na sua máquina).
4. HTR dedicado (reconhecimento de texto manuscrito)
O Transkribus e ferramentas especializadas similares foram criados para uma única tarefa: ler manuscritos que o OCR geral não consegue. Eles usam redes neurais profundas treinadas especificamente em cursiva, escritas históricas e estilos variados de manuscrito. Muitos suportam treinamento de modelo — você pode ajustar o reconhecimento para a caligrafia de um escritor específico. Esta é a categoria com o maior potencial de precisão em cursiva, mas as ferramentas são projetadas para trabalho arquivístico em escala de projeto, não para extração rápida e pontual.
5. Ferramentas móveis e integradas
Apple Live Text, Microsoft Lens e Pen to Print colocam o OCR de manuscritos no seu bolso. A precisão deles é menor — normalmente 60-80% em cursiva — mas não têm custo de configuração e estão sempre disponíveis. Para transcrição rápida de uma única página de caderno, costumam ser o caminho mais rápido do papel ao texto, mesmo que o resultado precise de edição.
Se você é novo no assunto, nossa introdução à tecnologia de OCR e explicação sobre OCR com IA fornecem o contexto necessário antes de comparar ferramentas individuais.
Modelos de visão-linguagem: o novo teto da cursiva
1. GPT-5 (OpenAI Vision)
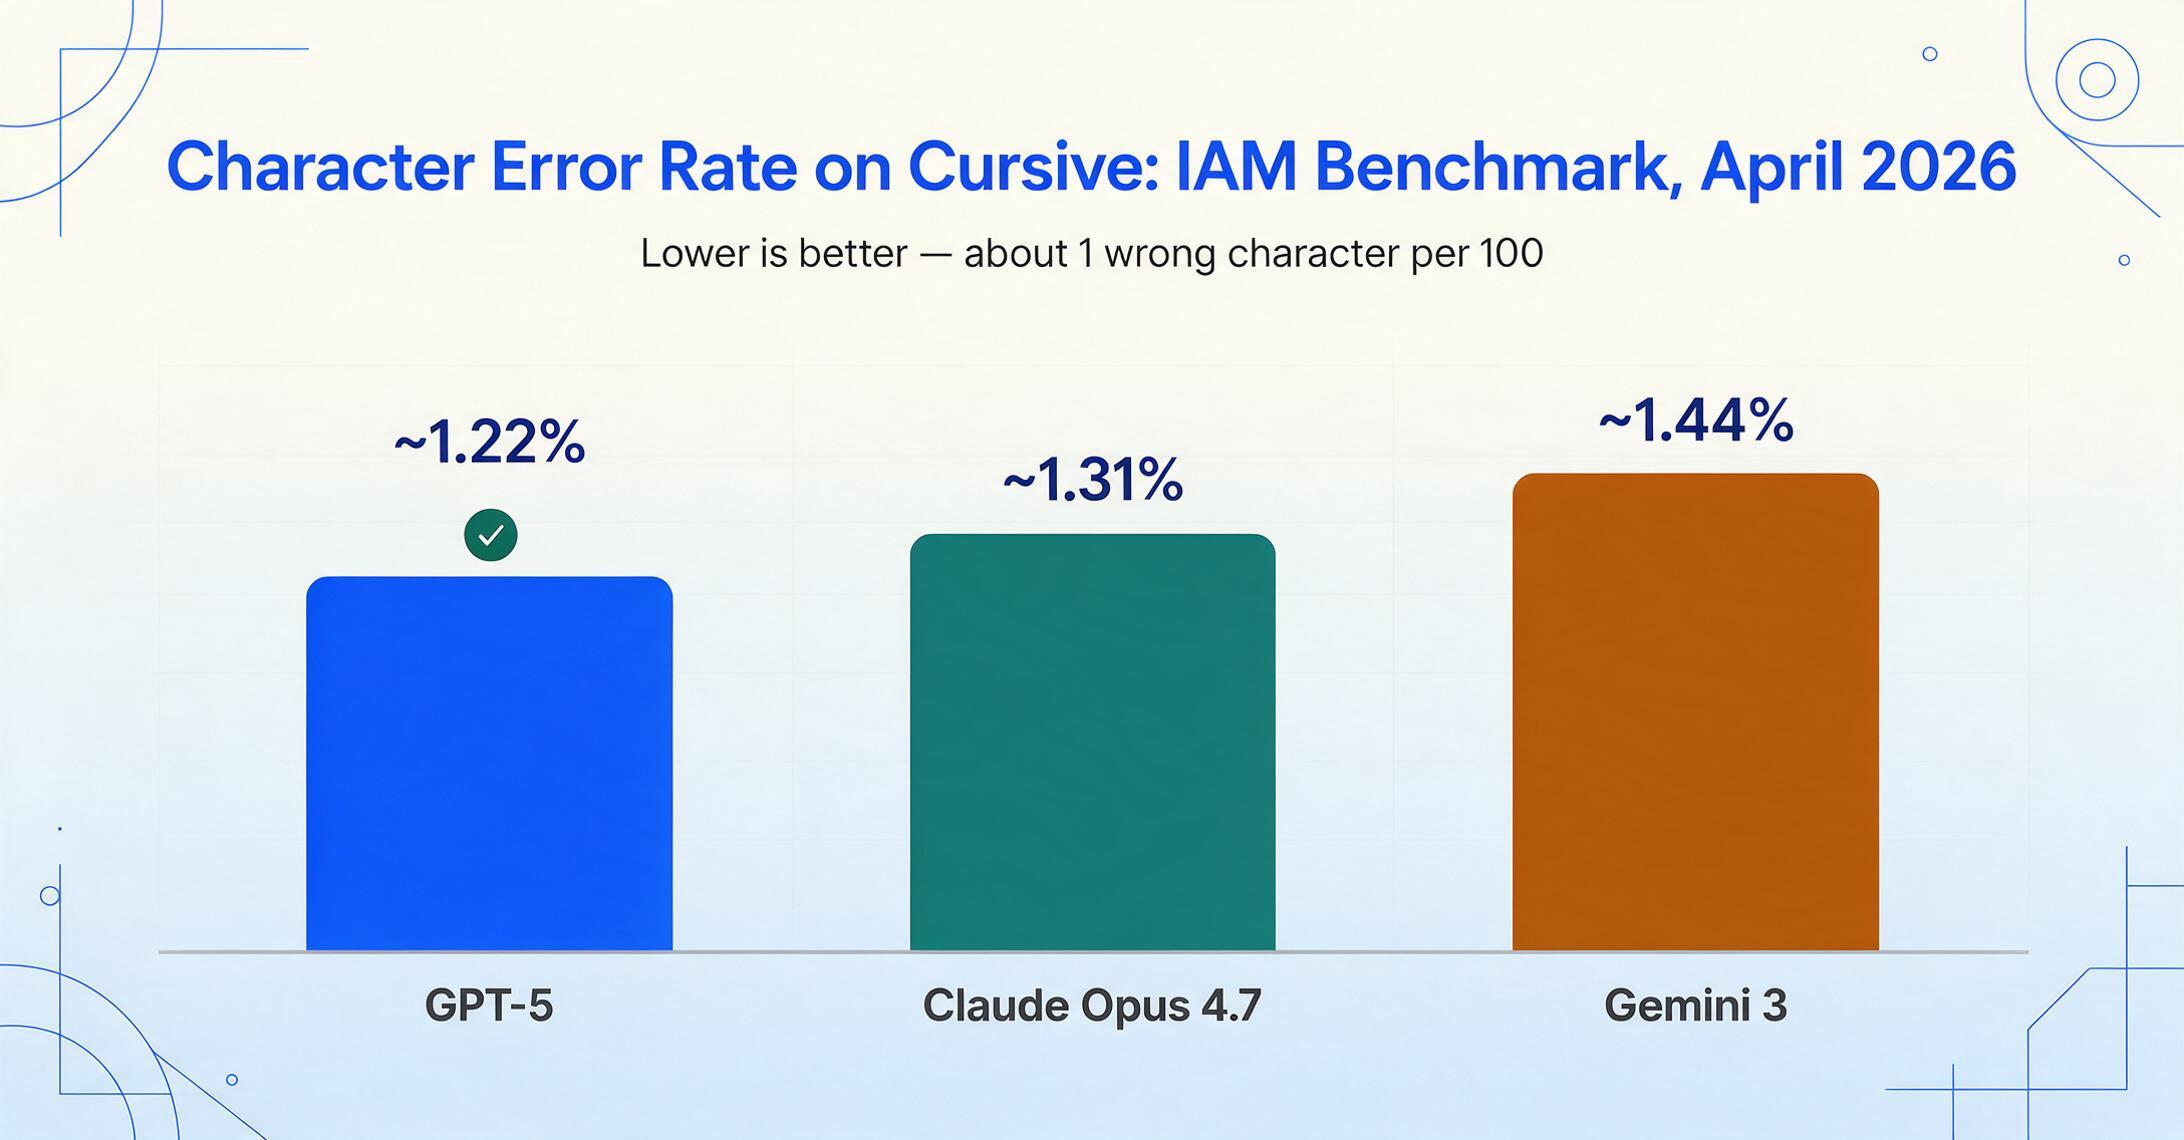
O GPT-5 é o atual líder em precisão em manuscritos cursivos por uma margem estreita. No benchmark do banco de dados de manuscritos IAM (abril de 2026), ele alcança uma taxa de erro de caracteres de ~1,22% — cerca de 1 caractere errado por 100 — superando o Claude Opus 4.7, com ~1,31%, e o Gemini 3, com ~1,44%. O benchmark de cursiva da AIMultiple (janeiro de 2026) coloca o GPT-5 e o Gemini 3 Pro Preview no topo em similaridade semântica em todas as 100 amostras de cursiva, com a maior consistência em letras conectadas.
Na prática, o GPT-5 lê bem cursiva em uma variedade de níveis de legibilidade — cursiva caprichada, mistura de letra de forma e cursiva, e escrita moderadamente bagunçada — porque lê palavras em contexto, em vez de caractere por caractere. Você pode enviar uma imagem para o ChatGPT (no plano Plus de $20/mês, ou gratuitamente com limites) e receber uma transcrição em segundos.
Melhor para: transcrição de cursiva pontual ou ocasional, onde a precisão importa e você revisará o resultado. Não é ideal para: processamento em massa em grande volume — os custos de API se acumulam rapidamente, e a tendência do modelo de alucinar textos que parecem plausíveis em páginas longas ou repetitivas exige revisão cuidadosa. Rastreamos exatamente como essa deriva de contexto se manifesta em documentos de várias páginas em nossa análise de conversores de manuscrito para texto.
2. Gemini 3 Pro (Google DeepMind)
O Gemini 3 Pro Preview iguala o GPT-5 no topo do benchmark de cursiva da AIMultiple, com 100% de precisão nos testes mais simples de linhas manuscritas e extração correta em todas as tarefas do conjunto de testes de OCR de manuscritos da Koncile — linha única, formulário manuscrito e campos de assinatura em faturas. Sua vantagem é a camada de compreensão de IA do Google: o modelo não apenas transcreve caracteres, mas interpreta o que a escrita significa no contexto. No benchmark IAM da codesota, o Gemini 3 pontua ~1,44% de CER, logo atrás do GPT-5. Ele também lida com escritas não latinas — manuscritos em japonês, coreano e chinês — melhor do que a maioria dos concorrentes.
O Gemini é acessado pelo Google AI Studio (com plano gratuito disponível) ou pela API Vertex AI para uso em produção. O preço segue o modelo de cobrança por caractere do Google, o que pode ser econômico para volumes moderados.
Melhor para: transcrição de cursiva multilíngue e compreensão contextual de documentos. Não é ideal para: extração de dados estruturados — o Gemini fornece uma transcrição, não uma planilha. Para transformar formulários manuscritos em colunas, uma ferramenta de extração específica é mais eficiente.
APIs de OCR em nuvem: escaláveis, exigem engenharia
3. Azure Document Intelligence (Microsoft)
O Azure Document Intelligence (antigo Form Recognizer) oferece um bom equilíbrio entre precisão de manuscritos e saída estruturada. Seu modelo v4.0 atinge ~1,8% de CER no benchmark IAM — próximo ao GPT-5 — e retorna caixas delimitadoras em nível de palavra e de linha junto com o texto. Isso o torna ideal para formulários: você pode mapear cada resposta manuscrita para o campo correspondente no documento, o que é essencial para processar pesquisas, inscrições e formulários de admissão médica.
O modelo de manuscritos do Azure suporta inglês e vários idiomas europeus. Para texto impresso, suporta mais de 160 idiomas. Oferece modelos prontos para faturas, recibos, documentos de identidade e formulários fiscais dos EUA, com reconhecimento de manuscritos integrado em cada um. O preço é de $1,50 por 1.000 páginas para OCR básico, com custo maior para análises avançadas. O Azure é compatível com HIPAA BAA para uso na área da saúde.
Ideal para: processamento de formulários empresariais em que você precisa de saída estruturada com mapeamento espacial — saber qual resposta manuscrita pertence a qual campo do formulário. Não é ideal para: cursiva muito bagunçada ou apertada — o desempenho do Azure com cursiva, embora bom, fica atrás dos VLMs de ponta em manuscritos desafiadores. Também exige engenharia para integrar.
4. Amazon Textract (AWS)
O Amazon Textract é o serviço de inteligência documental da AWS, com detecção de manuscritos como parte da API AnalyzeDocument. Ele lida bem com formulários e tabelas — assinaturas e texto manuscrito em campos quadriculados — mas a precisão com cursiva é mais limitada. Um benchmark de manuscritos de 2026 mediu o Textract em ~10,5% de taxa de erro de palavras (~89,5% de precisão em nível de palavra), o que o coloca atrás do Azure e dos principais VLMs. Testes independentes constataram que a precisão com cursiva cai ainda mais em letras conectadas e scripts mistos.
O ponto forte do Textract é a escala: ele processa milhões de páginas a $1,50 por 1.000 páginas (básico), sem compromisso mínimo. Oferece processamento elegível para HIPAA e integra-se ao ecossistema mais amplo da AWS. O suporte a manuscritos é principalmente em inglês; o texto impresso se estende a espanhol, português, francês, alemão e italiano.
Ideal para: processar grandes volumes de formulários com campos manuscritos (letras de forma em caixas) em escala empresarial. Não é ideal para: documentos com muita cursiva, manuscritos em outros idiomas ou quem não tem suporte de engenharia para chamar a API e lidar com a resposta JSON.
5. Google Cloud Vision AI
O Google Cloud Vision oferece o suporte de idiomas mais amplo entre os OCR de nuvem — detecção de manuscritos em chinês, japonês, coreano e vários idiomas europeus. Sua precisão de manuscrito em cursiva em inglês é moderada: avaliações independentes a situam em torno de 70-75% em manuscritos gerais, com melhores resultados em manuscritos claros em estilo de impressão e desempenho mais fraco em cursiva conectada. No benchmark da AIMultiple, o Google Vision ficou no meio do pelotão, atrás dos VLMs de fronteira e das principais APIs de nuvem.
Onde o Google Vision se destaca é no tratamento de documentos históricos e documentos multilíngues com scripts mistos. Seu modelo lida melhor com digitalizações degradadas e estilos de escrita antigos do que a maioria das alternativas. O preço é de $1,50 por 1.000 páginas para a API Document AI, com um nível gratuito para testes iniciais.
Melhor para: documentos multilíngues e digitalizações históricas onde a ampla cobertura de idiomas importa mais do que a precisão máxima em cursiva. Não é ideal para: documentos com muita cursiva em inglês — o Azure e os modelos VLM superam-no visivelmente em letras conectadas.
Ferramentas de extração por IA: manuscritos encontram dados estruturados
6. ImageToTable.ai
O ImageToTable.ai ocupa uma interseção específica: ele lê manuscritos — incluindo cursiva, assinaturas, caixas de seleção e números escritos à mão — e pode gerar dados estruturados em colunas de planilha, não apenas um bloco de texto transcrito. Construído sobre um modelo de visão de grande porte, ele usa a Extração de Colunas Personalizadas: você digita os nomes dos campos desejados (ex.: "Data", "Item", "Quantidade", "Assinatura"), e a IA localiza cada valor entendendo seu significado semântico, não por correspondência de modelo ou coordenadas de zona.
Para cursiva e manuscritos mistos, essa abordagem semântica é importante porque a IA não precisa separar perfeitamente cada letra conectada para extrair o valor correto — ela lê a palavra no contexto do layout do documento e dos rótulos dos campos. O mesmo modelo alimenta o modo Para Word, que preserva o layout original da página como um documento editável, e seu processamento em lote, que mescla vários arquivos manuscritos em uma única saída.
Em nossos próprios testes com amostras de manuscritos mistos, o ImageToTable.ai lida com cursiva clara com aproximadamente 85-90% de precisão em nível de campo — ligeiramente atrás dos VLMs de fronteira puros em transcrição bruta, mas à frente das APIs de nuvem em saída estruturada. A contrapartida é que ele não foi feito para HTR de arquivamento (use o Transkribus) nem para processar milhões de páginas via API (use o Azure). Ele foi feito para o meio-termo onde a maior parte do trabalho com manuscritos realmente acontece: transformar uma pilha de recibos manuscritos, notas de entrega ou formulários preenchidos em uma planilha limpa, sem modelos ou treinamento.
Envie um documento manuscrito para testar o OCR. Os arquivos são processados com segurança e não são armazenados.
Melhor para: transformar fotos ou digitalizações de manuscritos em texto confiável e dados estruturados de planilha — especialmente quando você precisa de campos personalizados, processamento em lote ou saída no Word junto com a transcrição. Não é ideal para: transcrição acadêmica pura de manuscritos históricos (Transkribus é melhor), pipelines de API em alto volume com milhões de páginas (use uma API de nuvem) ou anotações em tempo real enquanto escreve em um tablet (use um aplicativo de notas). Você pode testar com sua própria página manuscrita sem se cadastrar.
HTR dedicado: feito para manuscritos, sem atalhos
7. Transkribus
O Transkribus é o padrão ouro para Reconhecimento de Texto Manuscrito em documentos históricos — manuscritos centenários, registros paroquiais, correspondência diplomática e arquivos históricos. Desenvolvido e mantido pela READ-COOP SCE, uma cooperativa europeia com mais de 250 membros institucionais, já processou mais de 200 milhões de páginas para 500 mil usuários em mais de 100 idiomas e escritas históricas. Seu diferencial são modelos treináveis: você pode enviar uma amostra da caligrafia de um escriba específico — digamos, 20 páginas de um diário do século XVII — e ajustar um modelo de reconhecimento que então lê aquela escrita com precisão muito superior a qualquer ferramenta genérica.
Para caligrafia moderna cursiva, o Transkribus é exagero a menos que você trabalhe em escala arquivística. Sua precisão padrão em prosa inglesa manuscrita moderna foi medida em aproximadamente 47,7% de WER em um benchmark de 2026 — deliberadamente baixa porque o modelo padrão não é otimizado para escrita moderna; a ferramenta foi projetada para ajuste fino. Mas treine-o em uma caligrafia específica e ele supera todas as ferramentas genéricas.
O preço usa um sistema de créditos: texto manuscrito custa 1 crédito por página, texto impresso custa 0,1 créditos. O plano gratuito oferece 50 créditos por mês. Planos pagos começam em €99/ano (Scholar, 30.000 créditos) com pacotes de crédito sob demanda (250 créditos por €59,50) que nunca expiram. Os dados são processados na Áustria, o que é relevante para requisitos de soberania de dados europeus.
Melhor para: genealogistas, arquivistas, historiadores e pesquisadores que trabalham com escritas históricas cursivas em escala de projeto. Não é ideal para: quem precisa extrair alguns campos de um formulário manuscrito moderno — o fluxo de treinamento é uma sobrecarga desnecessária, e uma ferramenta genérica de extração por IA será mais rápida e barata.
OCR para desktop: offline, privado, mas limitado em cursiva
8. ABBYY FineReader PDF
O ABBYY FineReader é o gigante do OCR para desktop e lida com escrita à mão melhor do que os críticos tradicionais de OCR podem esperar. Testes independentes mediram o ABBYY com 91,7% de precisão em letra cursiva e 95,2% em letra de forma manuscrita — superando significativamente o Adobe Acrobat (79,3% cursiva, 88,6% manuscrita) e o Readiris (84,9% cursiva, 92,4% manuscrita). Em texto digitado, mantém-se acima de 99,8%, e lidera em digitalizações históricas (98,1%) e esquemas técnicos (97,3%). Esses dados vêm de uma comparação independente de 2025 publicada por uma empresa de análise de tecnologia.
A contrapartida é que o ABBYY foi arquitetado como um mecanismo de OCR baseado em caracteres, não um VLM. Ele é excelente para separar caracteres que foram impressos separadamente — a maioria dos textos digitados — mas a cursiva continua sendo um problema mais difícil para sua arquitetura. Seus 91,7% em cursiva são bons para a classe de OCR de desktop, mas muito atrás dos VLMs de ponta. O ABBYY é uma compra única de US$ 199 para a edição padrão (verifique o preço atual), totalmente offline e processa documentos em sua própria máquina.
Melhor para: usuários que precisam de OCR offline confiável para documentos mistos (impressos e manuscritos), com forte preservação de layout e edição de PDF. Não é ideal para: cursiva muito bagunçada, grandes volumes em lote (ABBYY é um aplicativo de desktop, não um mecanismo de processamento em lote) ou quem precisa de extração de dados estruturados em colunas de planilha.
Ferramentas móveis e gratuitas: sempre disponíveis, precisão moderada
9. Microsoft OneNote / Office Lens
O Microsoft OneNote, em conjunto com o Office Lens (o aplicativo de câmera para digitalização), oferece OCR de escrita à mão gratuito para qualquer pessoa com uma conta Microsoft. A precisão em escrita à mão legível e em letra de forma fica em torno de 91% de acordo com testes independentes — bom para uma ferramenta gratuita — mas o reconhecimento de cursiva cai visivelmente. O OCR do OneNote é baseado no mesmo mecanismo que alimenta os serviços de OCR em nuvem da Microsoft, mas o nível gratuito não inclui o modelo de escrita à mão mais recente do Azure.
O fluxo de trabalho é simples: tire uma foto com o Office Lens, corte a região manuscrita e o texto é extraído para o OneNote, onde se torna pesquisável. É genuinamente útil para digitalizar anotações de quadro branco, slides de aula e páginas de caderno legíveis. Para cursiva bagunçada ou layouts complexos, a precisão fica abaixo do que uma ferramenta dedicada oferece.
Melhor para: estudantes e profissionais de escritório digitalizando anotações manuscritas claras e em letra de forma sem custo algum. Não é ideal para: documentos com muita cursiva, caligrafia bagunçada ou quem precisa de dados extraídos em colunas estruturadas em vez de texto pesquisável.
10. Pen to Print
O Pen to Print é um aplicativo de OCR de manuscrito focado em dispositivos móveis (iOS e Android) que se posiciona como "o aplicativo que lê sua letra". Em testes com usuários, ele lida razoavelmente bem com letra cursiva legível ou moderadamente bagunçada — um revisor amplamente compartilhado o descreveu como "transcrevi anotações que eu mesmo não conseguia ler e o aplicativo as transformou em texto claro". Uma série de testes da Koncile descobriu que o Pen to Print passou em todos os três testes de manuscrito (linha única, formulário, assinatura) sem erros. No entanto, a saída é texto simples — sem dados estruturados, sem preservação de layout, sem exportação em lote.
O plano gratuito inclui anúncios e limitações; o premium custa $2.99/mês e remove anúncios, adiciona digitalização de várias páginas e permite exportação. É uma boa opção para consumidores, mas sua utilidade para fluxos de trabalho profissionais é limitada pela saída de texto não estruturado e pelo fluxo de trabalho página por página.
Melhor para: pessoas que transcrevem suas próprias páginas de caderno ou cartas em letra cursiva no celular, especialmente escrita legível ou moderadamente bagunçada. Não é ideal para: processamento de documentos empresariais, fluxos de trabalho em lote ou qualquer pessoa que precise de dados extraídos em colunas de planilha.
11. Apple Live Text
O Apple Live Text está integrado ao iOS 15+ e macOS Monterey+ — sem aplicativo para instalar, sem conta para criar. Aponte a câmera para qualquer manuscrito e você pode selecionar, copiar, colar, pesquisar ou traduzir o texto como se fosse digitado. Em testes independentes, o Live Text alcança aproximadamente 70-80% de precisão em manuscritos claros em letra de forma e cerca de 60-70% em cursiva — utilizável para referência rápida, mas não confiável o suficiente para processamento de documentos. Ele se limita a copiar/colar: sem processamento em lote, sem exportação para arquivo, sem API.
O que torna o Live Text único é o zero atrito. É o caminho mais rápido de "vejo um manuscrito" para "tenho o texto", e para um único número de referência ou endereço em uma anotação manuscrita, a vantagem de velocidade supera a diferença de precisão. Para trabalhos em massa ou com muita cursiva, no entanto, uma ferramenta dedicada é essencial.
Melhor para: captura instantânea de uma frase curta ou número manuscrito — um endereço, um número de telefone, uma anotação rápida — no seu celular, sem configuração. Não é ideal para: documentos em cursiva, processamento em lote, páginas longas ou qualquer fluxo de trabalho onde a precisão importa o suficiente para pagar por uma ferramenta especializada.
Qual ferramenta é ideal para sua letra? — por caso de uso
A melhor ferramenta para você depende de três fatores: o tipo de letra que você tem, a quantidade de texto e o que você espera obter no final. Veja como o campo se aplica a cenários do mundo real.
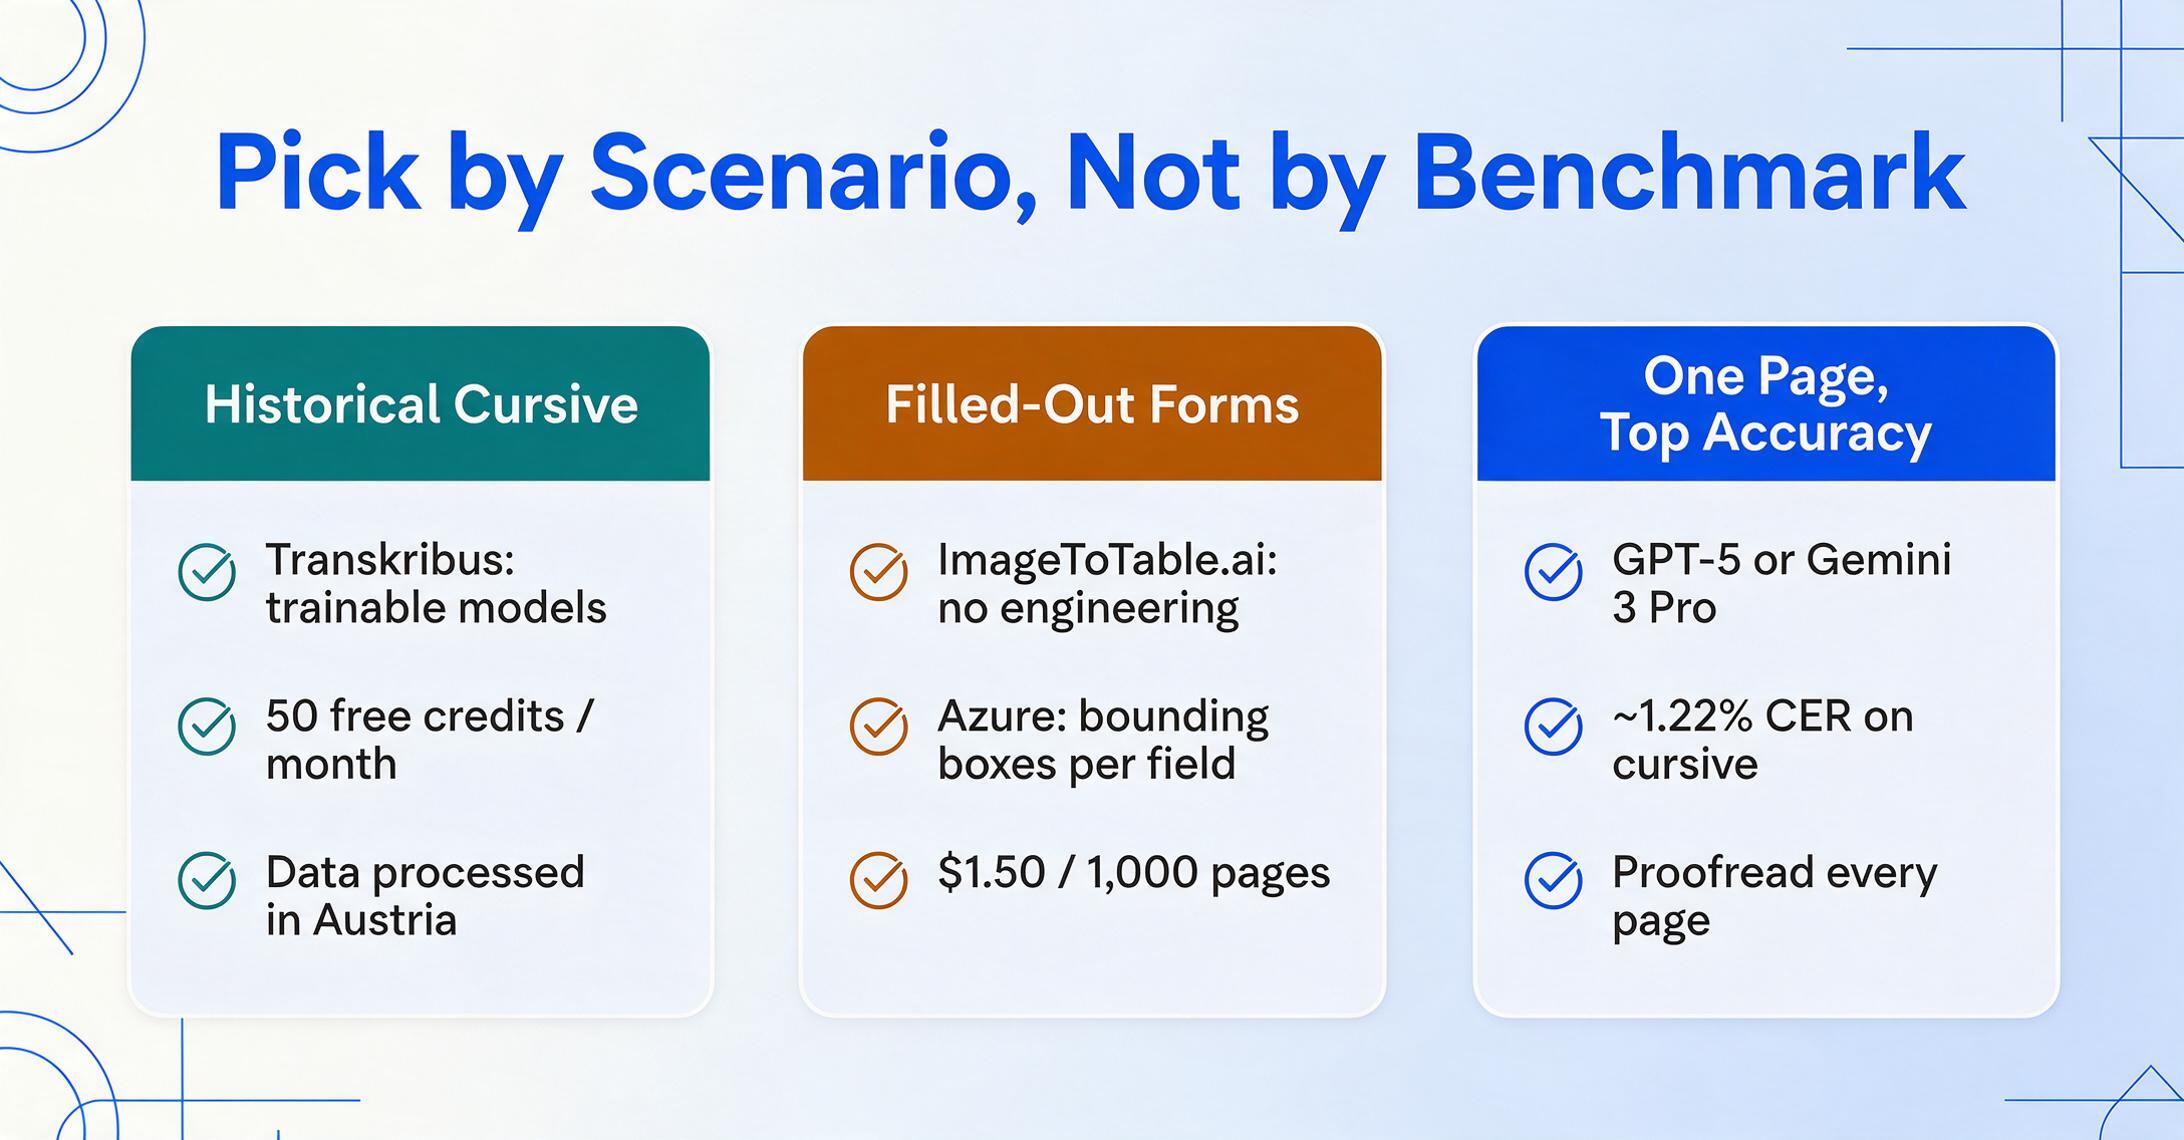
Você é um pesquisador com documentos históricos em cursiva: Transkribus. Treine um modelo na caligrafia do escriba e ele superará todas as ferramentas genéricas. Espere um fluxo de trabalho orientado a projetos.
Você recebe formulários preenchidos com campos manuscritos (pesquisas, inscrições, notas de entrega): ImageToTable.ai ou Azure Document Intelligence. Ambos lidam com a estrutura: mapeando cada resposta manuscrita para a coluna correta. O ImageToTable não requer engenharia; o Azure exige integração de API. Para uma comparação mais aprofundada das opções de extração estruturada, incluindo plataformas empresariais de AP, veja nosso resumo de ferramentas de reconhecimento de escrita e extração de dados.
Você precisa da maior precisão possível em cursiva em inglês, uma página por vez: GPT-5 (ChatGPT Plus) ou Gemini 3 Pro. Líderes em benchmarks, mas revise cada página — o modelo pode alucinar em documentos longos.
Você processa milhares de páginas manuscritas por mês e tem suporte de engenharia: Azure Document Intelligence oferece a melhor relação precisão-custo com saída estruturada. Amazon Textract para formulários mais simples. Ambos escalam linearmente.
Você é um estudante que precisa digitalizar anotações de aula com orçamento limitado: Microsoft OneNote / Office Lens (gratuito) para anotações claras. Pen to Print ($2,99/mês) para cursiva moderada. Apple Live Text (gratuito) para frases curtas e rápidas.
Você tem documentos comerciais manuscritos — recibos, livros-razão, notas de entrega — e precisa deles em Excel: ImageToTable.ai cuida de todo o fluxo, da imagem à planilha estruturada, sem modelos ou código. Teste gratuitamente, sem necessidade de cadastro.
Para uma visão mais ampla do cenário de OCR, os resumos complementares cobrem software de OCR gratuito e ferramentas de OCR de código aberto para quem precisa de opções de baixo custo ou voltadas para desenvolvedores. Nosso guia completo de OCR para manuscritos aprofunda-se na tecnologia e nas escolhas de fluxo de trabalho.
Perguntas frequentes
Qual é a ferramenta de OCR de manuscritos mais precisa em 2026?
Nos benchmarks de cursiva, GPT-5 (~1,22% CER) e Gemini 3 Pro (~1,44% CER) lideram os rankings independentes. Para formulários estruturados com saída espacial, Azure Document Intelligence (~1,8% CER com caixas delimitadoras) é a melhor combinação de precisão e formato. Nenhuma ferramenta vence em todas as categorias — a escolha certa depende de se você precisa de transcrição bruta, colunas estruturadas ou HTR de nível arquivístico.
O software de OCR consegue ler manuscritos em cursiva com precisão?
Sim, mas a precisão varia enormemente entre ferramentas. Os modelos de visão-linguagem (GPT-5, Gemini 3) leem bem a cursiva porque entendem o contexto da palavra em vez de tentar separar letras conectadas. Os motores de OCR tradicionais (Tesseract, versões antigas de ABBYY) foram projetados para caracteres separados e normalmente obtienen 40-60% em cursiva — inutilizables sem correção pesada. A média entre todas as ferramentas de OCR de manuscritos é de aproximadamente 64% de precisão, segundo análises do setor — portanto, a seleção da ferramenta faz a diferença entre utilizável e inútil.
Qual é a diferença entre OCR e ICR para manuscritos?
O Reconhecimento Óptico de Caracteres tradicionalmente se refere à correspondência de padrões para texto impresso. O Reconhecimento Inteligente de Caracteres (ICR) é o subconjunto de OCR que usa aprendizado automático para lidar com manuscritos — treinado em múltiples estilos de escrita em lugar de fontes fixas. Na prática, a distinción está se desvanecendo: a maioria das ferramentas "OCR" modernas para manuscritos são, na realidade, motores ICR, mas o marketing ainda diz OCR.
Existe uma ferramenta gratuita de OCR de manuscritos que leia cursiva?
Existen opções gratuitas, mas com limites significativos. Apple Live Text (iOS/macOS) lê cursiva com aproximadamente 60-70% de precisão — útil para consulta rápida, não para processamento de documentos. O OCR do Microsoft OneNote é gratuito e alcanza cerca de 91% em manuscritos claros estilo imprenta, pero cae en cursiva. Transkribus oferece 50 créditos gratuitos por mes. A maioria dos serviços dedicados de OCR de manuscritos oferece testes gratuitos (ImageToTable.ai tem uma demo gratuita sem registro) para que você possa testar a precisão da cursiva em seus próprios documentos antes de pagar.
Por que a cursiva quebra o OCR tradicional?
Os motores de OCR tradicionais funcionam reconociendo caracteres individuales — encontrando o limite entre uma letra e a seguinte, combinando o padrão de forma. A cursiva elimina deliberadamente esses limites: as letras se conectan, se funden e varían en inclinación y presión. Un "a" típico en cursiva puede parecer una "o", una "e" o una "u" dependiendo del escritor. La correspondencia de patrones tradicional no tiene forma de decidir cuál es sin contexto — y ese contexto es precisamente lo que los modelos de visión-linguagem proporcionan al leer la palabra completa. Nuestro artículo sobre reconocimiento de manuscritos con IA vs OCR tradicional explica esto en detalle.
¿Qué tan precisas deben ser las herramientas de OCR de manuscritos para ser útiles?
Depende de la tarea. Para archivos buscables, una precisión del 80% suele ser suficiente — el texto es localizable incluso con errores. Para la extracción de datos estructurados (cantidades, fechas, cantidades que van a una hoja de cálculo), la precisión a nivel de campo debe superar el 90% porque cada error se propaga a los cálculos. Para la transcripción diplomática académica, el estándar es del 99%+. La misma puntuación de referencia significa cosas diferentes para diferentes casos de uso — por eso este resumen enfatiza la importancia de igualar la herramienta al trabajo.
Conclusão: a categoria, não a marca, determina o desempenho com caligrafia cursiva
O ponto mais importante deste resumo é que o OCR de manuscritos não é um mercado único. As cinco categorias de tecnologia — VLMs de ponta, APIs de nuvem, OCR de desktop, HTR dedicado e ferramentas móveis — produzem precisão fundamentalmente diferente com escrita cursiva, independentemente das alegações individuais dos fornecedores. Um VLM lê letras conectadas pelo contexto. Um OCR de desktop faz correspondência de caracteres com bibliotecas de padrões. São tecnologias diferentes fazendo coisas diferentes.
Escolha sua ferramenta combinando estas três coisas nesta ordem: (1) que tipo de manuscrito você tem (cursiva, letra de forma, misto, histórico), (2) qual saída você precisa (texto simples, colunas estruturadas, PDF pesquisável) e (3) como você prefere pagar (API por página, assinatura, licença única, grátis). A resposta certa quase sempre será a categoria que corresponde às suas entradas e saídas, não aquela com o melhor número de benchmark.
Se seus manuscritos estão em fotos ou digitalizações e você precisa tanto de uma transcrição precisa quanto da opção de organizá-la em colunas, teste em uma página real e julgue por si mesmo. Experimente o ImageToTable.ai com seu próprio documento manuscrito → — sem cadastro, resultados em segundos.