O que é Agentic OCR?
A evolução da leitura de documentos em 2026
Agentic OCR — reconhecimento óptico de caracteres agêntico — é uma tecnologia de leitura de documentos que usa modelos visão-linguagem para não apenas reconhecer texto, mas raciocinar sobre a estrutura do documento, decidir quais informações importam e gerá-las como dados estruturados — tudo sem modelos, treinamento ou configuração por formato. O termo entrou no mainstream no início de 2025, quando Andrew Ng apresentou a extração agêntica de documentos como a próxima fronteira além do OCR tradicional. Em meados de 2026, tornou-se um termo de busca em rápido crescimento — não porque a tecnologia seja nova, mas porque o rótulo finalmente nomeia algo que vem mudando silenciosamente a forma como as máquinas leem documentos.
Principais Conclusões
- Você gasta horas organizando os dados extraídos depois que a ferramenta diz que terminou e assume que só precisa de um OCR melhor.
- 60-80% de processamento direto não é configuração ruim — é o teto de ferramentas que leem caracteres, mas nunca decidem o que significam.
- Seu papel muda de revisar cada célula extraída para revisar apenas as exceções que o sistema sinalizou como genuinamente incertas.
Por que o Agentic OCR é importante agora
A cada poucos anos, surge um termo que reclassifica o que antes era chamado de "bom o suficiente" como "legado". O Agentic OCR é esse termo para leitura de documentos em 2026.
Para entender por que essa mudança está acontecendo agora, ajuda ver a trajetória. O OCR tradicional surgiu na década de 1970 e resolveu um problema: converter texto impresso em caracteres digitais. O OCR com IA, que chegou nos anos 2020 com modelos visão-linguagem, resolveu um segundo: entender o que esses caracteres significam. Ambos são essenciais e amplamente implantados. Mas compartilham uma limitação fundamental: param na compreensão. Nenhum deles dá o próximo passo — decidir o que fazer com o que leem e agir com base nessa decisão.
Esse próximo passo é o que "agentic" acrescenta. Um sistema agentic não espera que um humano diga "coloque o número da fatura aqui e o total ali". Ele decide. Ele encaminha os dados certos para o campo de saída certo. Ele detecta inconsistências e as sinaliza. Ele aprende com correções sem exigir um ciclo de retreinamento.
Essa distinção importa agora porque o volume de documentos que as empresas processam superou a etapa de classificação manual que o OCR tradicional e até mesmo o OCR com IA ainda deixam para trás. Processar 50 faturas de 50 fornecedores não é mais um problema de 50 documentos — é um problema de 50 formatos. O Agentic OCR reduz isso a uma única passagem ao tratar cada documento como algo sobre o qual o sistema pode raciocinar, não apenas ler.
Os dados confirmam o padrão. Em implantações empresariais, o OCR tradicional e os sistemas de IDP baseados em modelos alcançam taxas de processamento direto de 60-80% em documentos para os quais foram configurados. Os sistemas Agentic OCR alcançam consistentemente 90-95%+ porque o ciclo de autocorreção captura casos extremos que, de outra forma, exigiriam revisão humana. Para uma análise detalhada de como o Agentic OCR se compara ao reconhecimento tradicional de caracteres, consulte nosso guia sobre o que é OCR e como funciona.
O Agentic OCR não substitui o OCR ou o OCR com IA — ele os estende. O OCR responde "quais caracteres estão nesta página?" O OCR com IA responde "quais dados este documento contém?" O Agentic OCR responde "o que deve acontecer com esses dados, e está correto?"
O Que Realmente Mudou — Da Leitura ao Raciocínio
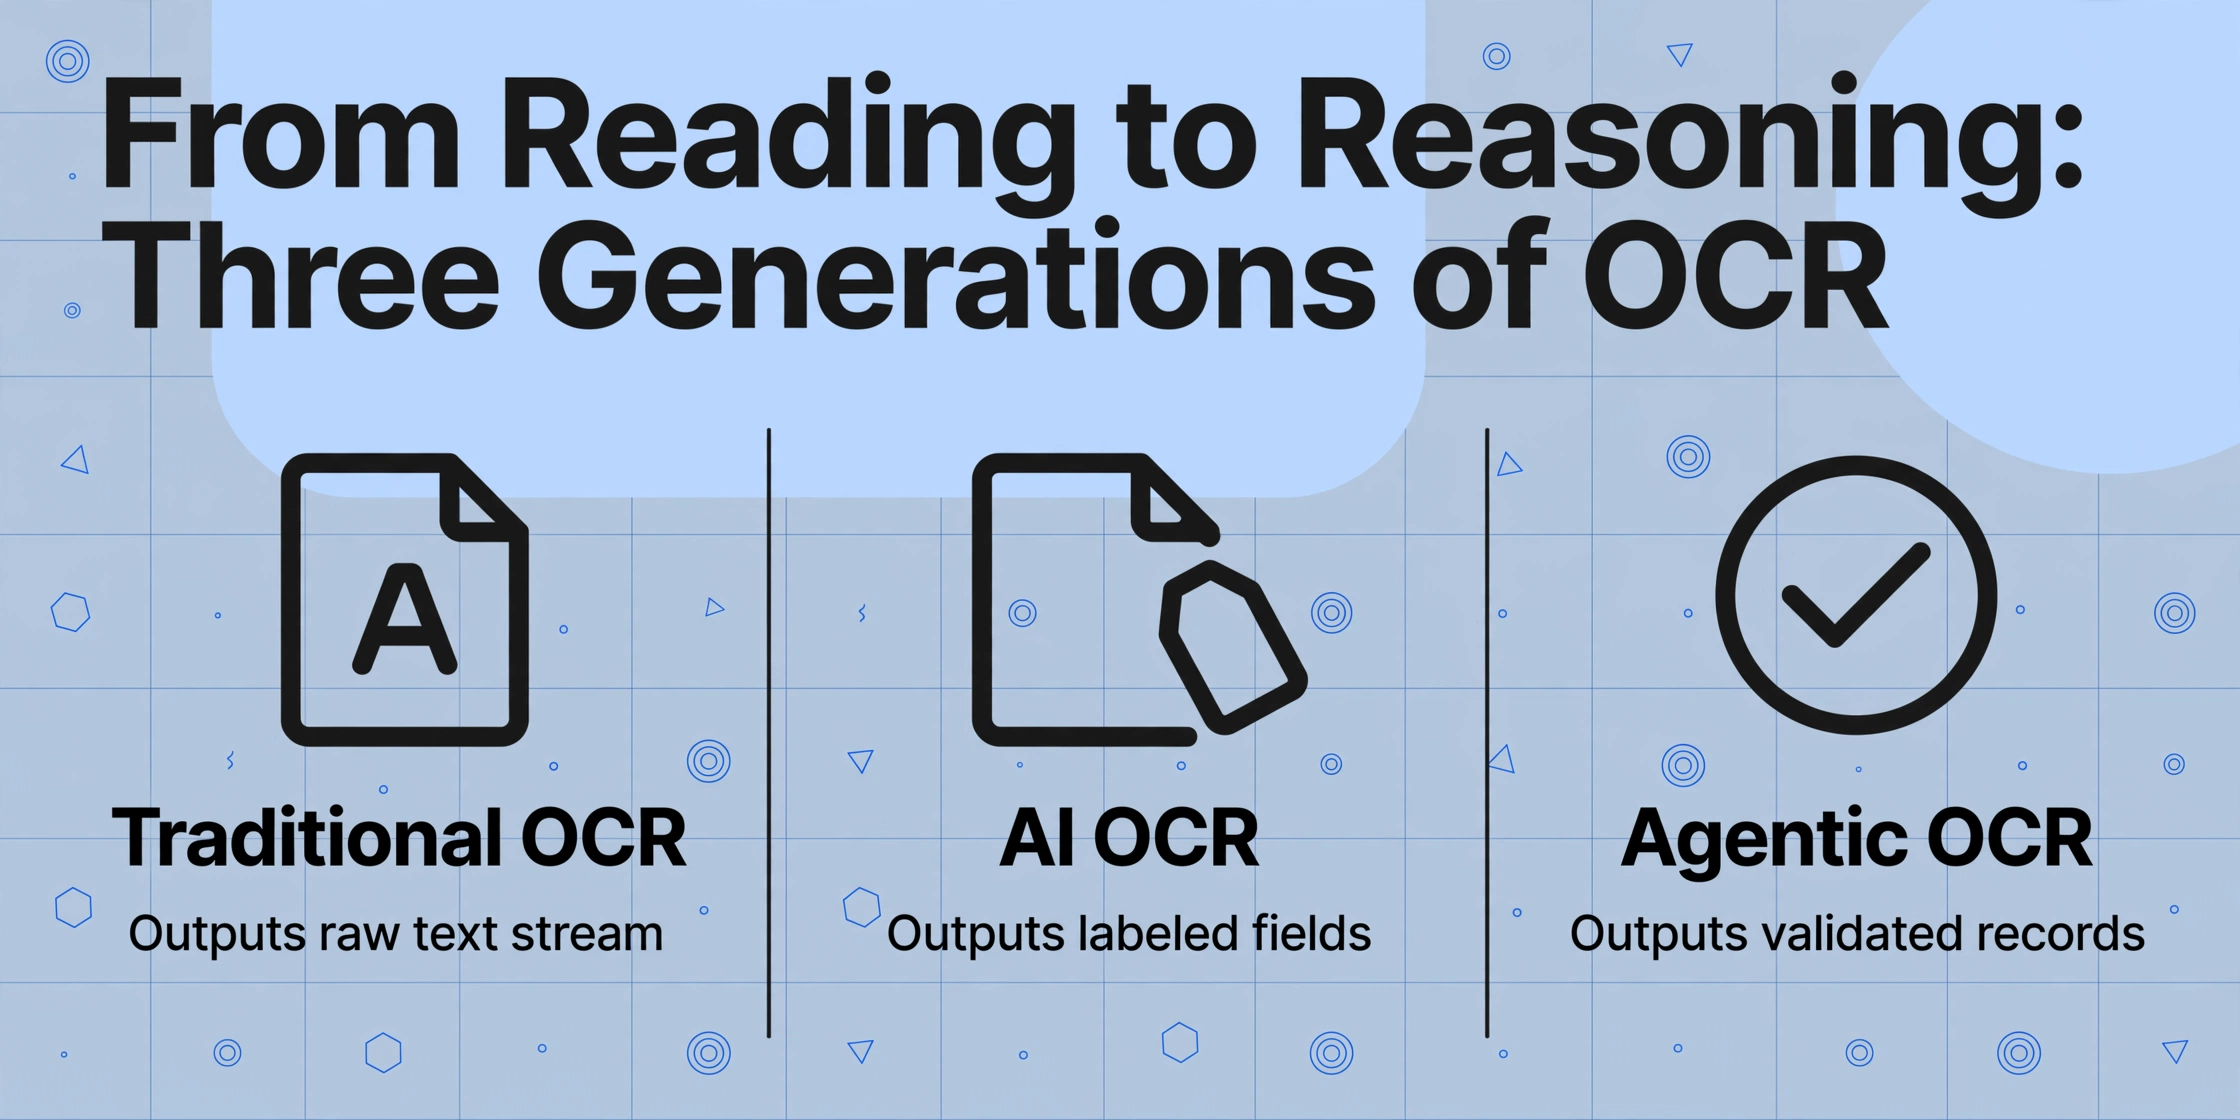
A mudança não está na capacidade de leitura. Está no que acontece depois que a leitura é concluída.
Para ver a diferença, considere como um único elemento de documento — a string "INV-2026-0842" — passa por cada geração de tecnologia:
OCR Tradicional lê a página e gera: INV-2026-0842 em algum lugar de um fluxo de texto contínuo. Um humano precisa encontrá-lo, reconhecê-lo como número de fatura e copiá-lo para a célula correta. O mecanismo de OCR não consegue distingui-lo do CEP ou do número de referência do cliente que por acaso compartilham o mesmo formato. Isso é discutido em detalhes em nosso guia passo a passo sobre como o OCR funciona.
OCR com IA lê a mesma página e gera: Número da Fatura: INV-2026-0842. Ele entende a relação rótulo-valor e mapeia o texto para o campo semântico correto. A etapa de classificação é parcialmente automatizada. Mas o OCR com IA ainda depende dos rótulos e da estrutura do próprio documento. Se o número da fatura aparecer em um local incomum — embutido em um gráfico de cabeçalho ou escrito à mão ao lado de um rótulo diferente — o OCR com IA pode não detectá-lo porque as pistas semânticas esperadas estão ausentes. Abordamos isso em profundidade em nosso artigo sobre o que é OCR com IA e como ele difere do OCR tradicional.
OCR Agêntico lê a página e gera um registro estruturado: { "document_type": "invoice", "invoice_number": "INV-2026-0842", "vendor": "Acme Supply", "total": 1247.50, "confidence": 0.97 } — mas somente após raciocinar sobre alternativas. Essa string provavelmente é um número de fatura? Ela segue padrões conhecidos? Se a confiança for baixa, ele não adivinha — ele sinaliza o campo para revisão ou tenta uma segunda passagem. A parte "agêntica" é o ciclo: ler, decidir, validar, corrigir.
Essa camada de raciocínio é o que separa o OCR agêntico de toda tecnologia de leitura de documentos que veio antes. O OCR tradicional lê e para. O OCR com IA lê e entende. O OCR agêntico lê, entende, decide, valida e se adapta. Não é uma esteira mais rápida — é um processo completamente diferente.
Como o Agentic OCR Funciona nos Bastidores
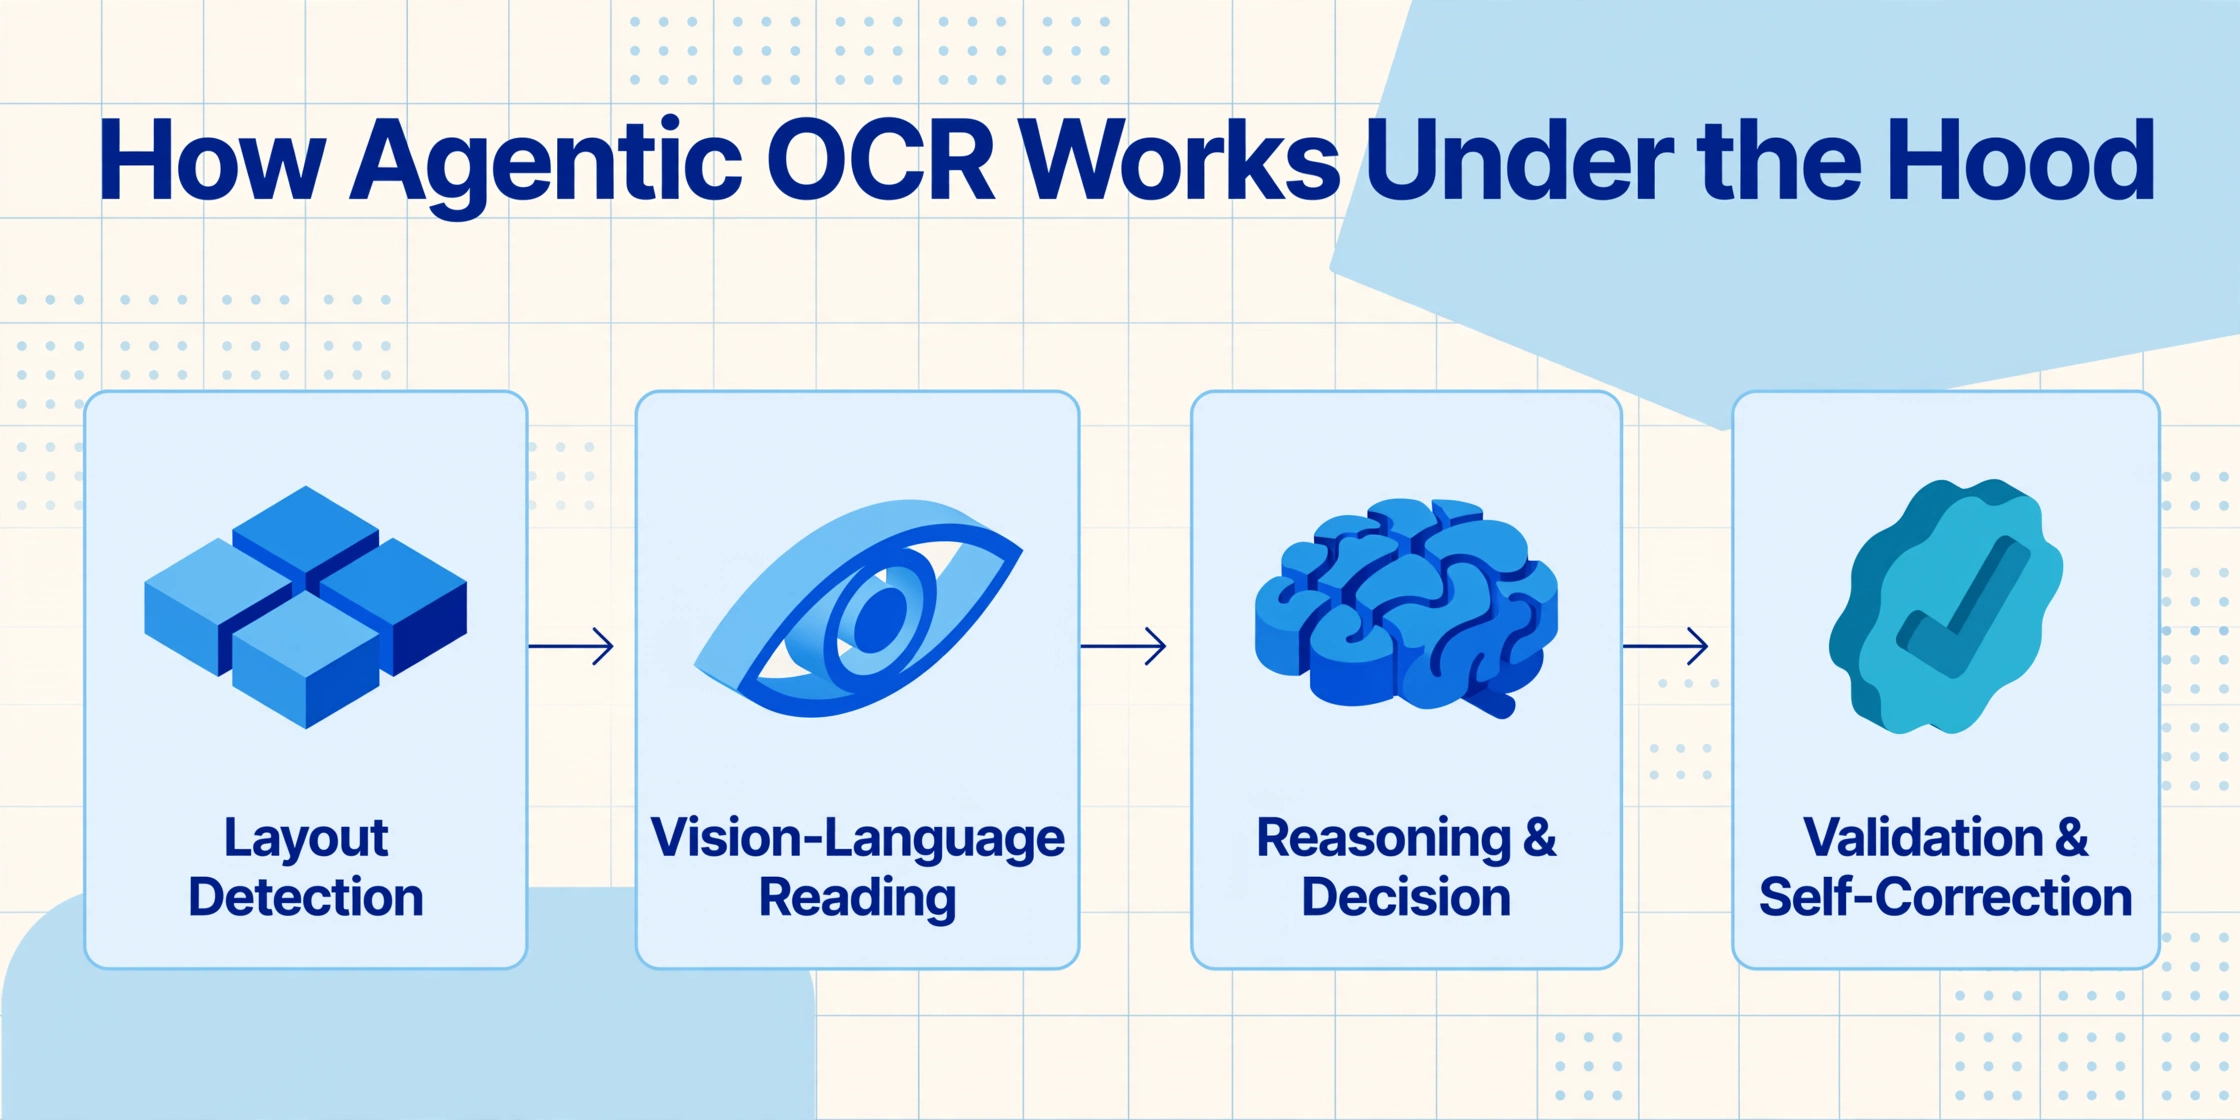
Agentic OCR não é um único modelo ou algoritmo. É um pipeline orquestrado de componentes especializados que trabalham juntos como uma equipe de especialistas em documentos.
Embora a arquitetura exata varie entre implementações, o design central segue quatro camadas funcionais:
Detecção de Layout
O sistema examina a página e identifica regiões estruturais: cabeçalhos, áreas de tabela, blocos de assinatura, rodapés. Isso é raciocínio espacial — o modelo aprende como é uma "tabela" versus um "parágrafo", independentemente do conteúdo. Esta camada responde "onde estou nesta página e que tipo de conteúdo há aqui?"
Leitura Visão-Linguagem
Um modelo visão-linguagem lê cada região com consciência de contexto. Diferentemente do OCR caractere por caractere, o VLM processa blocos visuais inteiros simultaneamente. Ele reconhece que um número em negrito em uma célula inferior direita significa "total", mesmo sem um rótulo explícito próximo. Ele preserva a ordem de leitura em layouts de múltiplas colunas e células mescladas de tabela — as relações estruturais que o OCR tradicional descarta.
Raciocínio e Decisão
Este é o núcleo agêntico. O sistema avalia o que leu e decide: quais valores extraídos correspondem a quais campos de saída? O "total" extraído reconcilia com a soma dos itens de linha? Se um valor for ambíguo — um número que pode ser um número de pedido ou um ID de cliente — o sistema aplica contexto do tipo de documento e padrões de campo para resolver antes de gerar a saída.
Validação e Autocorreção
Os dados extraídos são verificados contra padrões conhecidos, relações de campo e regras de negócio. Um total que não corresponde à soma dos itens de linha é sinalizado. Um número de fatura fora do formato esperado aciona uma segunda passada de leitura. O sistema não assume que sua primeira resposta está correta — ele verifica e só gera a saída quando os limites de confiança são atingidos. Pontuações de confiança por campo permitem que revisores foquem em casos incertos em vez de reverificar cada campo.
Pense nisso como a diferença entre uma fotocopiadora e um contador treinado. A fotocopiadora (OCR tradicional) produz uma cópia exata de cada caractere. O contador (Agentic OCR) lê o documento, entende que é uma fatura, verifica os cálculos, insere os dados nas contas corretas e inicializa quaisquer itens de linha que pareçam incomuns. A fotocopiadora é mais rápida por página. O contador produz trabalho pronto para uso.
Como Diferentes Funções Usam o Agentic OCR
O valor do Agentic OCR não é abstrato — ele se manifesta de forma diferente dependendo de quem o utiliza e do que essa pessoa está tentando alcançar.
Contadores e Profissionais de Contabilidade
Você recebe faturas de mais de 30 fornecedores — algumas como PDFs por e-mail, outras como fotos enviadas pela equipe de campo. Cada fornecedor usa um layout diferente, e vários mudam o formato sem aviso prévio. Com OCR baseado em modelo, cada mudança de layout exige a reconstrução de um modelo. Com Agentic OCR, você insere todos os 30 em um único lote, define as colunas de saída necessárias — Número da Fatura, Data, Fornecedor, Total — e recebe uma única tabela estruturada. O sistema lida automaticamente com a variação de layout porque lê pelo significado, não pela posição. Quando um total parece incorreto em relação aos itens de linha, ele sinaliza a linha em vez de passar dados errados para seus registros.
Pequenos Empresários
Você tira fotos de recibos no celular e ocasionalmente recebe notas de entrega manuscritas. Sua necessidade é simples: colocar os dados em uma planilha sem digitar. O Agentic OCR lida com o caos de formatos — recibos amassados, reflexos, fotos em ângulo, caligrafia mista — porque sua camada de raciocínio ajusta a estratégia de leitura por documento. Um recibo amassado aciona uma etapa de pré-processamento diferente de um scan limpo; o sistema decide qual estratégia usar e valida a saída sem que você precise intervir.
Desenvolvedores Criando Pipelines de Documentos
Você está integrando o processamento de documentos a um aplicativo personalizado — um sistema de gestão de despesas, um portal de integração de fornecedores. O OCR tradicional força você a lidar com cada caso extremo: variações de layout, campos ausentes, incompatibilidades de formato. Cada variação adiciona código. O Agentic OCR elimina essa complexidade porque a camada de extração lida com a variação. Você define o esquema de saída; o sistema descobre como preenchê-lo. A autocorreção reduz a lógica de tratamento de exceções que você precisa manter. Para uma visão geral da categoria tecnológica mais ampla, consulte nosso guia sobre extração de documentos com IA e como ela funciona.
Principais Capacidades a Considerar
Nem toda ferramenta que afirma ter capacidades "agênticas" realmente adiciona raciocínio e autocorreção ao processo. Veja o que diferencia o OCR agêntico genuíno das ferramentas que são apenas OCR com IA com um novo rótulo.
Primeiro, a extração sem modelo é o ponto de partida. Se uma ferramenta exige que você defina zonas, desenhe caixas ou crie modelos para cada formato de documento, ela não é agêntica — é OCR baseado em modelo com uma interface moderna. O OCR agêntico decide como abordar cada documento com base no que vê, não em um mapa de campos pré-configurado. Este é o indicador mais confiável de se a tecnologia subjacente mudou.
Segundo, mapeamento semântico de campos com contexto. Um sistema agêntico genuíno não apenas extrai texto e espera que os rótulos coincidam. Ele avalia as relações entre os campos. Se extrai uma tabela de itens de linha, verifica se os itens somam ao subtotal. Se os valores conflitam, não adivinha — sinaliza, relê ou aplica regras de negócio. O resultado não são dados brutos extraídos; é uma saída validada com indicadores de confiança nos quais você pode agir.
Terceiro, autocorreção sem retreinamento. Os sistemas tradicionais de ML melhoram por meio de retreinamento. Os sistemas agênticos melhoram em tempo real — quando um humano corrige uma extração sinalizada, essa correção alimenta a camada de raciocínio para documentos semelhantes. Isso é fundamentalmente diferente da abordagem de "amostra mínima de 10" que algumas ferramentas ainda exigem.
Quarto, processamento em lote que mantém a integridade dos dados. O verdadeiro teste de um sistema de OCR agêntico não é como ele lida com um PDF perfeito, mas como lida com 50 documentos desordenados de diferentes tipos em um único lote. As relações entre os campos se mantêm em todos os 50? As pontuações de confiança são consistentes? O sistema sinaliza os documentos discrepantes em vez de gerar silenciosamente dados incorretos? É no lote que a agência importa mais, porque é onde o sistema opera sem supervisão humana por documento.
O ImageToTable.ai implementa essas capacidades por meio de sua abordagem de Extração de Colunas Personalizadas: você nomeia as colunas que deseja, e a IA localiza e extrai dados correspondentes de qualquer documento ao entender o que cada campo significa — não onde ele está na página. A mesma tecnologia está disponível por meio da nossa ferramenta de software OCR com IA para processar documentos em escala.
Primeiros Passos com a Leitura de Documentos com Agentic OCR
Uma das vantagens do Agentic OCR em relação às tecnologias anteriores é que você não precisa configurar nada antes de experimentá-lo. Sem modelos para criar, sem amostras de treinamento para rotular, sem zonas para definir. O sistema se adapta a qualquer documento que você fornecer.
A maneira mais simples de experimentar a diferença é pegar um documento que você processa manualmente hoje — uma fatura de um novo fornecedor, um recibo que ainda não foi lançado, um contrato do qual você precisa extrair datas importantes — e executá-lo em uma ferramenta de Agentic OCR sem alterar nenhuma configuração. Se a ferramenta extrair os campos corretos no formato correto na primeira tentativa, sem configuração por documento, você acabou de testemunhar a diferença do Agentic OCR. Se ela pedir para você desenhar caixas ou selecionar um modelo, não é Agentic OCR.
Para uma demonstração prática, tente enviar qualquer documento abaixo. Defina as colunas que você deseja — os nomes dos campos que você normalmente digitaria em uma planilha — e veja como o sistema raciocina sobre a estrutura do seu documento, localiza cada valor e gera dados estruturados prontos para uso.
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
OCR agentico é o mesmo que OCR com IA?
Não. O OCR com IA adiciona compreensão ao reconhecimento de caracteres — ele pode ler um documento e identificar que um número é o total de uma fatura, em vez de apenas uma sequência de dígitos. O OCR agentico adiciona raciocínio e ação a essa compreensão. Um sistema de OCR com IA lê e rotula. Um sistema de OCR agentico lê, rotula, decide se os dados extraídos são internamente consistentes, sinaliza o que não se encaixa e adapta sua abordagem quando a confiança é baixa. O OCR com IA é um pré-requisito para o OCR agentico, mas o OCR agentico adiciona a camada de tomada de decisão que o OCR com IA sozinho não oferece.
Preciso treinar ou configurar o OCR agentico antes de usá-lo?
Não — e essa é a característica definidora da categoria. Os sistemas de OCR agentico são projetados para funcionar no primeiro uso, sem amostras de treinamento, modelos ou configuração por formato. Você envia um documento, define os campos de saída desejados e o sistema raciocina sobre a estrutura do documento para localizar e extrair cada valor. Se uma ferramenta pedir que você envie 10 documentos de amostra para treinamento ou desenhe zonas em um modelo, não é OCR agentico — é um sistema baseado em modelo com recursos de IA.
O OCR agentico pode lidar com documentos manuscritos?
Sim, mas com as mesmas ressalvas que se aplicam ao OCR com IA em geral. O OCR agentico lida melhor com manuscritos do que o OCR tradicional porque o modelo de visão-linguagem lê padrões visuais em vez de comparar formas de caracteres com um banco de dados fixo. A camada agentica adiciona uma vantagem específica: se o sistema ler um valor manuscrito com baixa confiança, ele pode sinalizar esse campo para revisão em vez de gerar um valor incorreto silenciosamente. Em documentos estruturados com texto impresso e manuscrito misturados — como notas de entrega ou formulários de inspeção — o OCR agentico atinge precisão de campo de 85-93% na prática.
Qual é a precisão do OCR agentico em comparação com o OCR tradicional?
Na precisão em nível de caractere, ambos alcançam altas taxas em texto impresso limpo (95-99%). A diferença significativa está na precisão em nível de campo e nas taxas de processamento direto: sistemas tradicionais de OCR e IDP baseados em modelo alcançam 60-80% de STP em documentos para os quais foram configurados, caindo drasticamente quando os formatos mudam. Os sistemas de OCR agentico alcançam 90-95%+ de STP em formatos variados, porque a camada de autocorreção captura erros que, de outra forma, exigiriam revisão manual. O resultado prático é que o OCR agentico requer significativamente menos intervenção humana por lote de documentos, especialmente quando os documentos vêm de múltiplas fontes.
O OCR agêntico já está disponível hoje ou ainda é um conceito de pesquisa?
Já está disponível hoje, embora o termo ainda esteja sendo adotado pelo setor. Muitas ferramentas de processamento de documentos lançadas como "OCR com IA" ou "extração de documentos com IA" já incluem capacidades agênticas — autocorreção, raciocínio semântico, extração sem modelo — sem usar o rótulo. Se uma ferramenta lê qualquer layout de documento sem configuração por formato, valida dados extraídos com base em regras de negócio e sinaliza campos de baixa confiança para revisão, ela está funcionando como um sistema OCR agêntico, independentemente de usar o termo. O rótulo está alcançando capacidades que já existem em produção.