Agentic OCRとは?
2026年のドキュメント読み取りの進化
Agentic OCR(エージェンティック光学文字認識)は、Vision-Language Modelを使用してテキストを認識するだけでなく、ドキュメントの構造を推論し、重要な情報を判断し、テンプレートやトレーニング、フォーマットごとの設定なしで構造化データとして出力するドキュメント読み取り技術です。この用語は2025年初頭にAndrew Ngが従来のOCRを超える次のフロンティアとしてエージェンティックなドキュメント抽出を紹介したことで主流になりました。2026年半ばまでに急速に成長している検索語となっています。技術自体が新しいからではなく、このラベルが機械がドキュメントを読む方法を静かに変えてきたものをようやく名付けたからです。
重要なポイント
- ツールが完了したと言った後に抽出データの整理に何時間も費やし、より良いOCRが必要だと思い込んでいる。
- 60〜80%のストレートスルー処理は設定の問題ではなく、文字を読んでもその意味を判断できないツールの限界です。
- あなたの役割は抽出されたすべてのセルを校正することから、システムが本当に不確実だとフラグを立てた例外だけをレビューすることに変わります。
Agentic OCRが今重要な理由
数年ごとに、「これで十分」とされていたものを「レガシー」と位置づけ直す用語が登場します。2026年のドキュメント読み取りにおいて、Agentic OCRこそがその用語です。
なぜ今この変化が起きているのかを理解するには、その軌跡を見るとわかりやすいでしょう。 従来のOCRは1970年代に登場し、印刷されたテキストをデジタル文字に変換するという一つの課題を解決しました。2020年代にVision-Language Modelとともに登場したAI OCRは、それらの文字が何を意味するのかを理解するという第二の課題を解決しました。どちらも不可欠であり、広く導入されています。しかし、両者には根本的な限界があります。それは「理解したところで止まる」ことです。どちらも次のステップ——読んだ内容をどう処理するかを決定し、その決定に基づいて行動する——を踏み出しません。
その次のステップこそが、「エージェンティック」が加える価値です。エージェンティックシステムは、人間が「請求書番号はここに、合計はあそこに入れて」と指示するのを待ちません。自ら決定します。正しいデータを正しい出力フィールドに振り分けます。不整合を検出してフラグを立てます。再トレーニングのサイクルを必要とせずに、修正から学習します。
この違いが今重要である理由は、企業が処理するドキュメントの量が、従来のOCRやAI OCRが依然として残している手動仕分けのステップを超えて増大しているからです。50社のベンダーから50件の請求書を処理することは、もはや50ドキュメントの問題ではありません——50フォーマットの問題です。Agentic OCRは、すべてのドキュメントを単に読み取るだけでなく推論できる対象として扱うことで、これを一回の処理に集約します。
データもこの傾向を裏付けています。エンタープライズ導入において、従来のOCRやテンプレートベースのIDPシステムは、設定されたドキュメントに対して60〜80%のストレートスルー処理率を達成します。Agentic OCRシステムは、自己修正ループが人手によるレビューを必要とするエッジケースを捕捉するため、一貫して90〜95%以上に達します。Agentic OCRと従来の文字認識の詳細な比較については、OCRとは何か、その仕組みに関するガイドをご覧ください。
Agentic OCRはOCRやAI OCRを置き換えるものではなく、それらを拡張するものです。OCRは「このページにどのような文字があるか」に答え、AI OCRは「このドキュメントにどのようなデータが含まれているか」に答えます。Agentic OCRは「そのデータをどう処理すべきか、そしてそれは正しいか」に答えます。
実際に変わったこと — 読み取りから推論へ
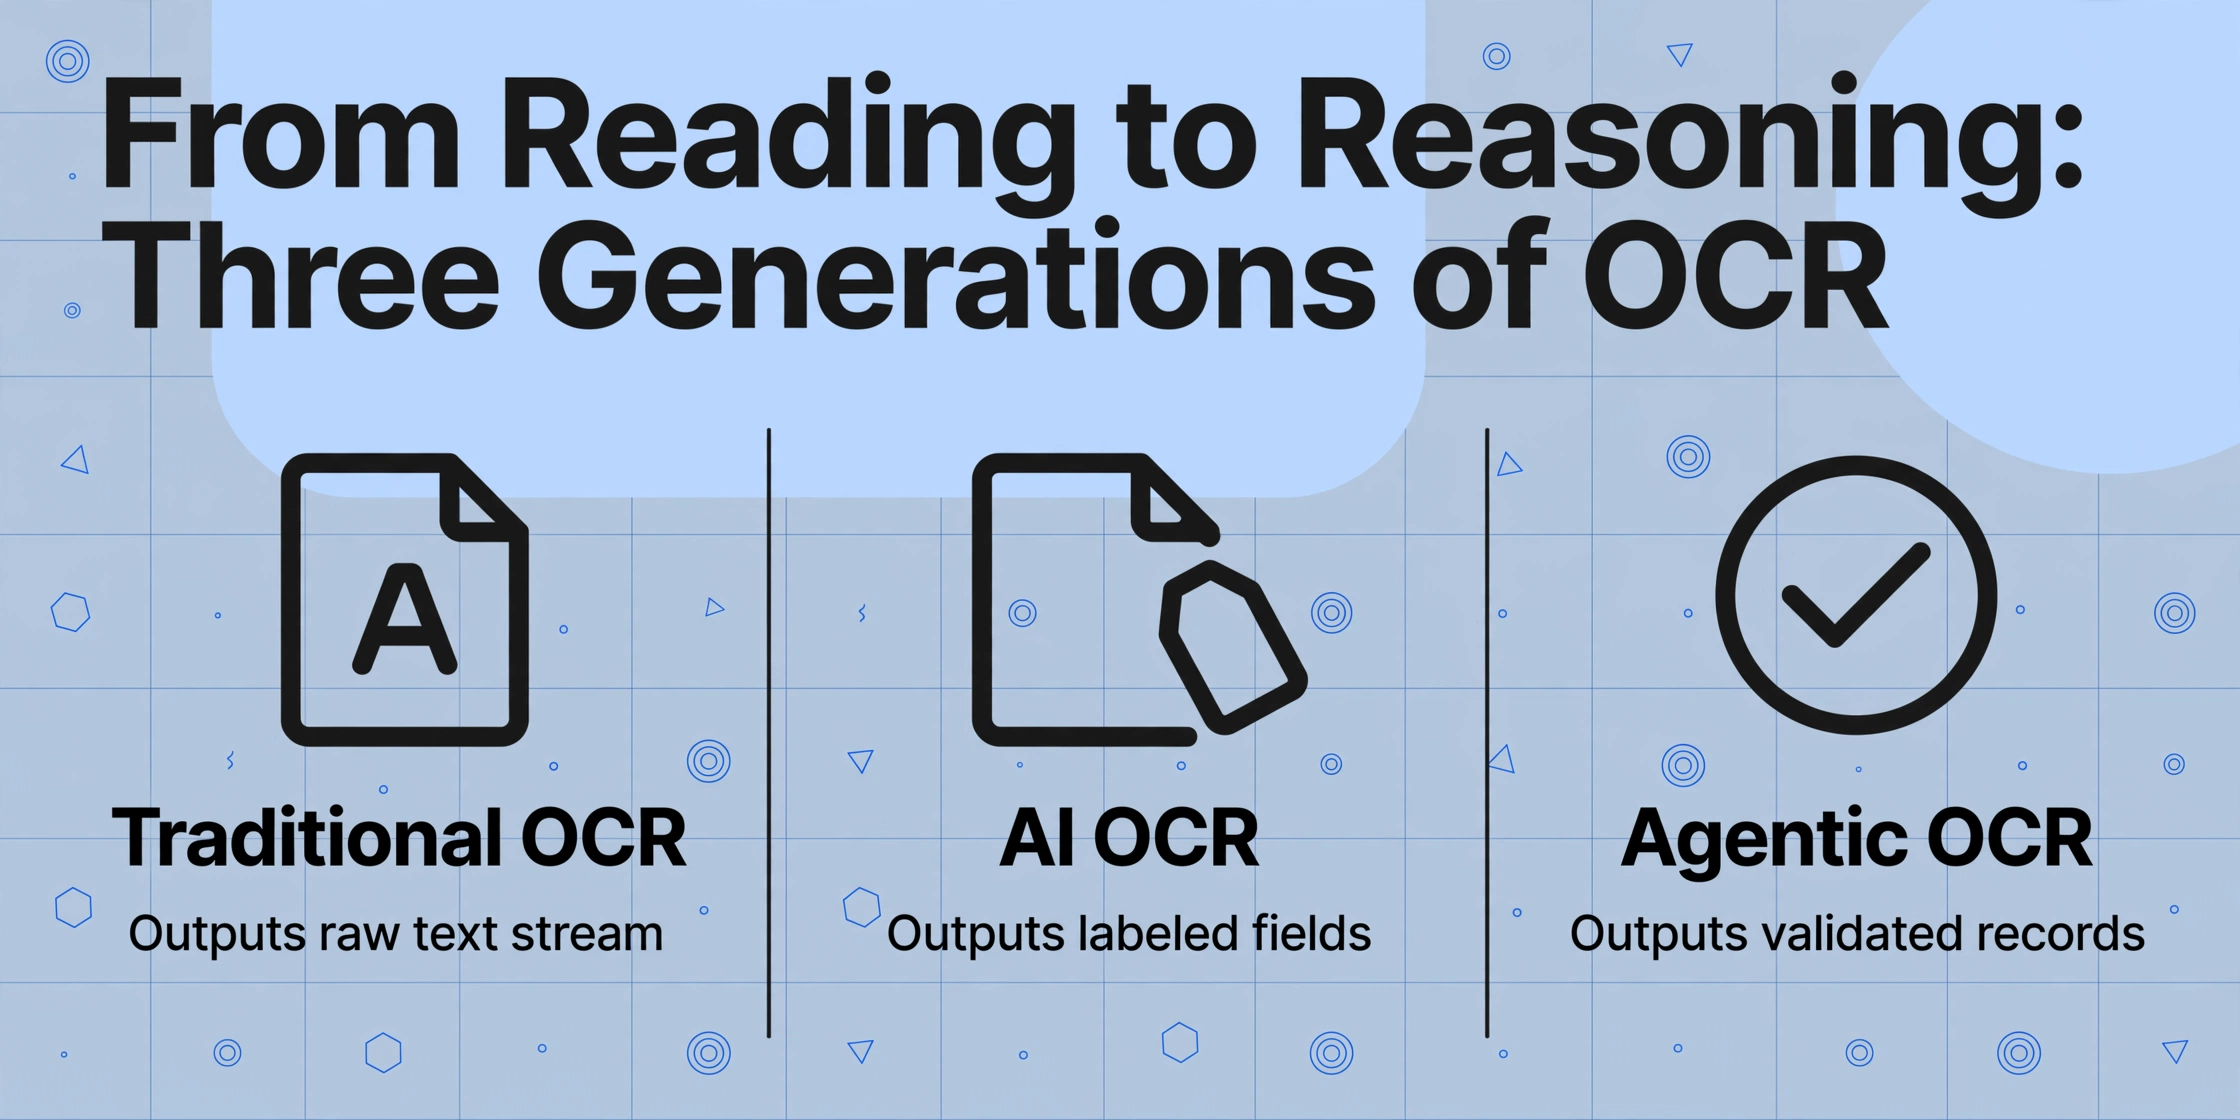
変化は読み取り能力にあるのではありません。読み取りが完了した後に何が起こるかにあります。
その違いを理解するために、単一のドキュメント要素 — 文字列「INV-2026-0842」— が各世代のテクノロジーをどのように通過するかを考えてみましょう。
従来のOCRはページを読み取り、実行中のテキストストリームのどこかに INV-2026-0842 を出力します。人間がそれを見つけ、請求書番号であると認識し、正しいセルにコピーする必要があります。OCRエンジンは、同じ形式を共有する郵便番号や顧客参照番号と区別することはできません。これについては、OCRの仕組みに関するステップバイステップガイドで詳しく説明しています。
AI OCRは同じページを読み取り、Invoice Number: INV-2026-0842 を出力します。ラベルと値の関係を理解し、テキストを正しいセマンティックフィールドにマッピングします。仕分けステップは部分的に自動化されています。しかし、AI OCRは依然としてドキュメント自体のラベルと構造に依存しています。請求書番号が通常とは異なる場所 — ヘッダーグラフィックに埋め込まれていたり、別のラベルの横に手書きで書かれていたりする場合 — AI OCRは期待されるセマンティックな手がかりが存在しないため、それを見逃す可能性があります。これについては、AI OCRとは何か、従来のOCRとどう違うのかに関する記事で詳しく取り上げました。
Agentic OCRはページを読み取り、構造化されたレコードを出力します: { "document_type": "invoice", "invoice_number": "INV-2026-0842", "vendor": "Acme Supply", "total": 1247.50, "confidence": 0.97 } — ただし、それは代替案を推論した後にのみ行われます。この文字列は請求書番号である可能性が高いですか?既知のパターンに従っていますか?信頼度が低い場合、推測はせず、フィールドをレビュー用にフラグ付けするか、2回目のパスを試みます。「エージェンティック」の部分はループです: 読み取り、判断、検証、修正。
この推論レイヤーこそが、agentic OCRをそれ以前のすべてのドキュメント読み取りテクノロジーから区別するものです。従来のOCRは読み取って停止します。AI OCRは読み取って理解します。Agentic OCRは読み取り、理解し、判断し、検証し、適応します。それはより速いコンベヤーベルトではありません — それはまったく異なるプロセスです。
Agentic OCRの内部動作の仕組み
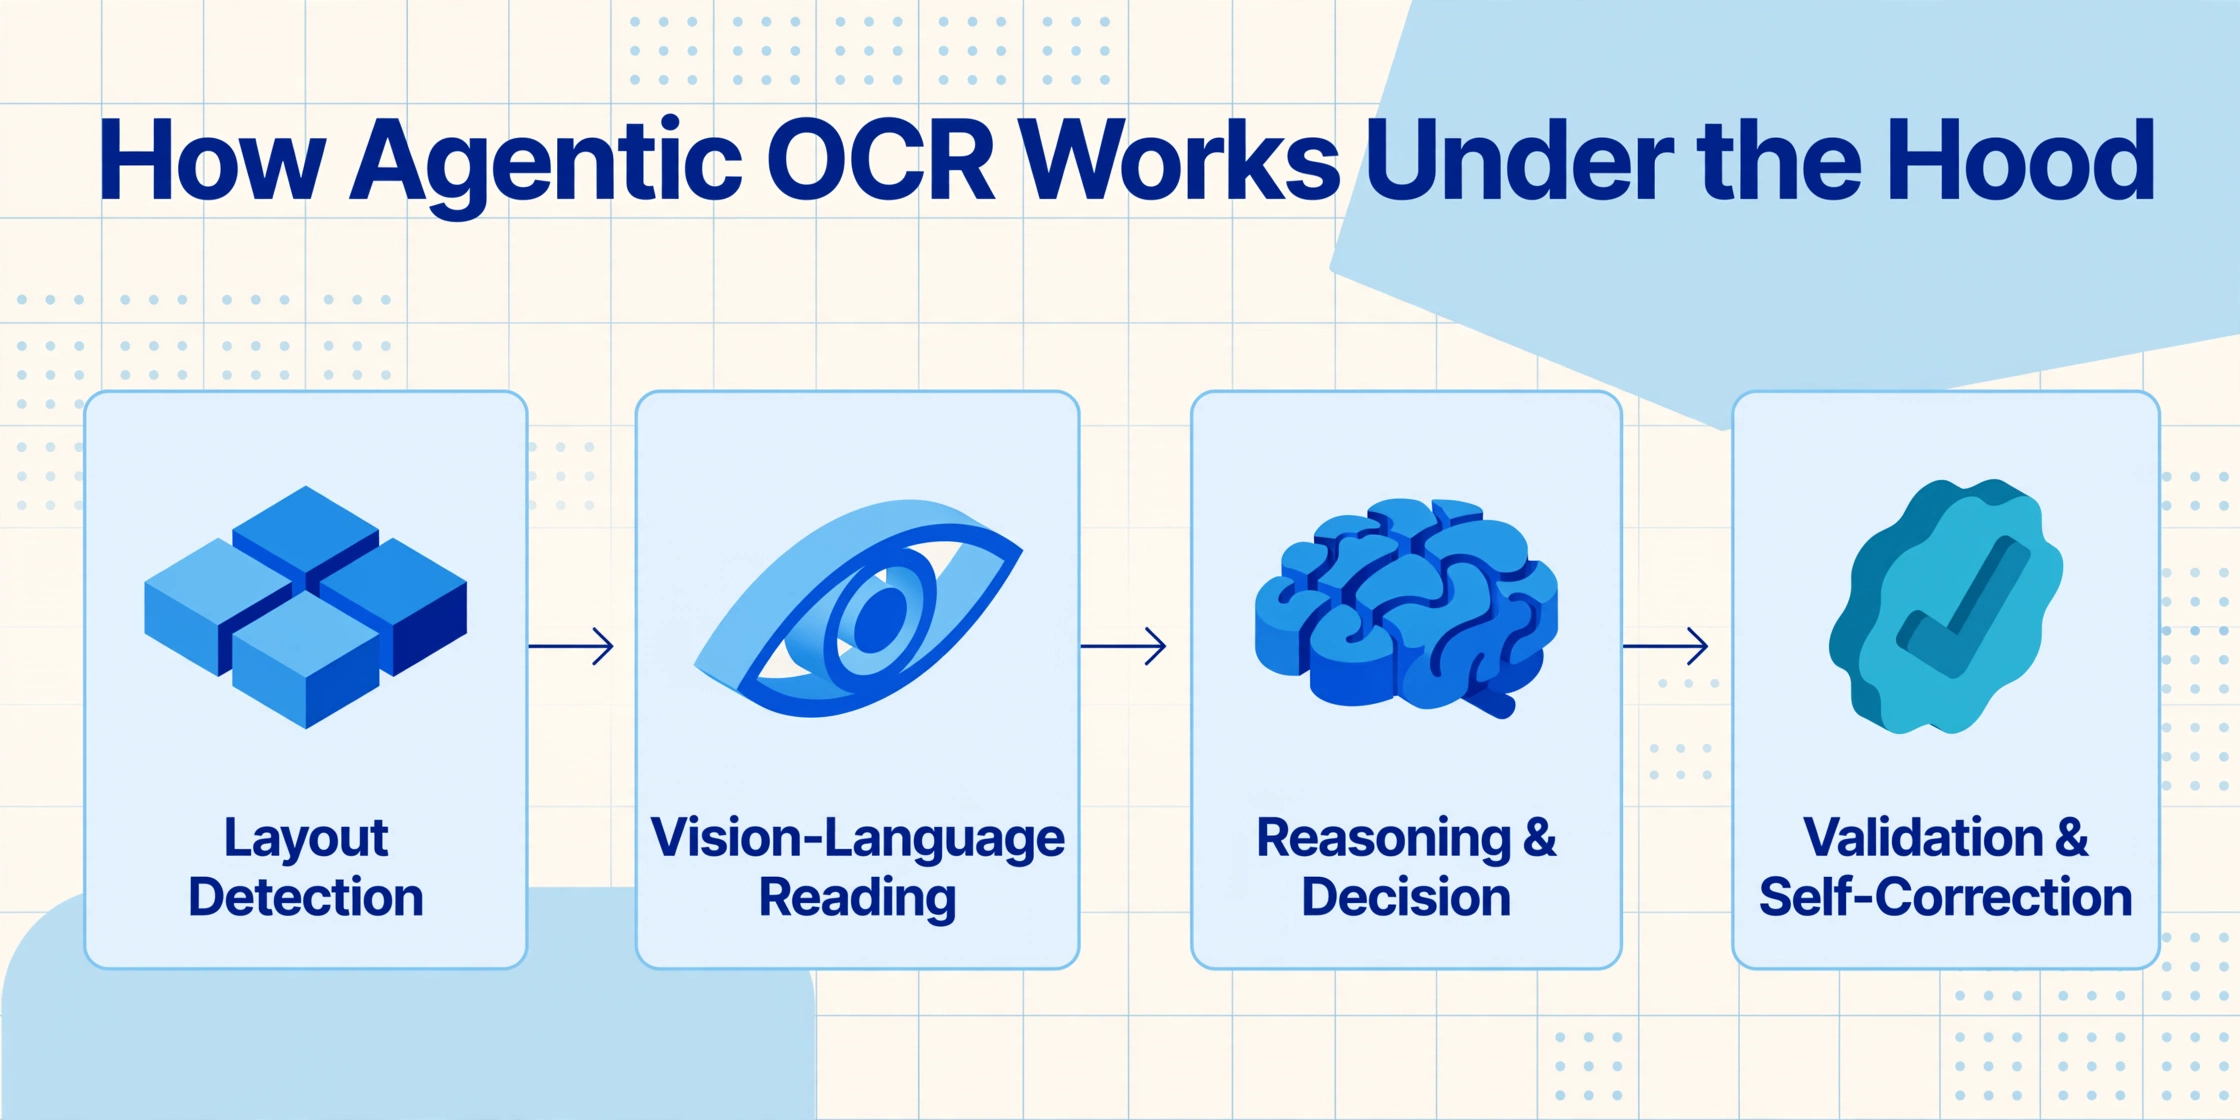
Agentic OCRは単一のモデルやアルゴリズムではありません。文書の専門家チームのように連携して動作する、専門コンポーネントのオーケストレーションされたパイプラインです。
正確なアーキテクチャは実装によって異なりますが、中核となる設計は次の4つの機能レイヤーに従います。
レイアウト検出
システムはページをスキャンし、ヘッダー、テーブル領域、署名ブロック、フッターなどの構造領域を特定します。これは空間推論です。モデルはコンテンツに関係なく、「テーブル」と「段落」の見た目の違いを学習します。このレイヤーは「このページのどこにいて、ここにはどのようなコンテンツがあるのか」という問いに答えます。
視覚言語による読み取り
視覚言語モデルが、コンテキスト認識を備えて各領域を読み取ります。文字単位のOCRとは異なり、VLMは視覚ブロック全体を同時に処理します。近くに明示的なラベルがなくても、右下のセルにある太字の数字が「合計」を意味することを認識します。また、従来のOCRが破棄していた構造的関係、つまり複数列レイアウトや結合されたテーブルセルをまたいだ読み順を保持します。
推論と判断
ここがエージェントの中核です。システムは読み取った内容を評価し、判断します。抽出されたどの値がどの出力フィールドに対応するのか。抽出された「合計」は明細項目の合計と一致するか。値が曖昧な場合(注文番号か顧客IDのどちらにも見える数字など)、システムは文書タイプとフィールドパターンからのコンテキストを適用して、出力前に解決します。
検証と自己修正
抽出されたデータは、既知のパターン、フィールド間の関係、ビジネスルールと照合してチェックされます。明細項目の合計と一致しない合計はフラグが立てられます。期待される形式から外れた請求書番号は、2回目の読み取りパスをトリガーします。システムは最初の回答が正しいとは想定せず、検証し、信頼度のしきい値を満たした場合にのみ出力します。フィールドレベルの信頼度スコアにより、レビュー担当者はすべてのフィールドを再チェックするのではなく、不確実なケースに集中できます。
これは、コピー機と訓練された経理係の違いのように考えてください。コピー機(従来のOCR)はすべての文字を正確にコピーします。経理係(Agentic OCR)はドキュメントを読み、それが請求書であることを理解し、計算を検証し、データを正しい勘定科目に入力し、異常と思われる明細項目にイニシャルを記入します。コピー機は1ページあたりの処理が速いです。経理係はすぐに使える成果物を作り出します。
役割別に見るAgentic OCRの活用方法
Agentic OCRの価値は抽象的なものではなく、誰がどのような目的で使うかによって具体的に異なります。
簿記担当者および会計士
30社以上のベンダーから請求書を受け取る場合、メールで送られてくるPDFもあれば、現場スタッフが撮影した写真もあります。ベンダーごとにレイアウトが異なり、予告なくフォーマットを変更する業者も少なくありません。テンプレートベースのOCRでは、レイアウトが変わるたびにテンプレートの再構築が必要です。Agentic OCRなら、30件すべてを1つのバッチに投入し、必要な出力列(請求番号、日付、ベンダー、合計)を定義するだけで、単一の構造化テーブルが得られます。位置ではなく意味で読み取るため、レイアウトのばらつきはシステムが自動的に処理します。明細項目に対して合計が不自然な場合は、帳簿に不正なデータを渡す代わりに、その行にフラグを立てます。
中小企業の経営者
スマートフォンでレシートの写真を撮り、手書きの納品書を受け取ることもあります。必要なのはシンプルで、タイピングせずにデータをスプレッドシートに入力することです。Agentic OCRは、しわくちゃのレシート、ぎらつき、斜めからの撮影、混在する手書き文字など、フォーマットの混乱を処理します。理由付けレイヤーがドキュメントごとに読み取り戦略を調整するからです。しわくちゃのレシートには、きれいなスキャンとは異なる前処理ステップが適用され、システムがどの戦略を使うかを決定し、ユーザーが介入しなくても出力を検証します。
ドキュメントパイプラインを構築する開発者
経費管理システムやサプライヤーオンボーディングポータルなど、カスタムアプリケーションにドキュメント処理を統合している場合、従来のOCRではレイアウトのバリエーション、欠落フィールド、フォーマットの不一致など、あらゆるエッジケースを自分で処理する必要があり、バリエーションごとにコードが増えます。Agentic OCRは、抽出レイヤーがバリエーションを処理するため、その複雑さを解消します。出力スキーマを定義すれば、システムがそれをどのように埋めるかを判断します。自己補正により、維持すべき例外処理ロジックが減ります。より広範なテクノロジーカテゴリの概要については、AIドキュメント抽出とその仕組みに関するガイドをご覧ください。
注目すべき主要機能
「エージェンティック」な機能を謳うツールのすべてが、実際に推論と自己修正をパイプラインに組み込んでいるわけではありません。ここでは、真のAgentic OCRと、単に新しいラベルを付けたAI OCRを区別するポイントを説明します。
第一に、テンプレート不要の抽出が基本です。ツールが各ドキュメント形式に対して領域の定義、ボックスの描画、テンプレートの作成を要求する場合、それはAgentic OCRではなく、モダンなインターフェースを備えたテンプレートベースのOCRです。Agentic OCRは、事前設定されたフィールドマップではなく、目にした内容に基づいて各ドキュメントへのアプローチ方法を決定します。これは、基盤となる技術が実際に変わったかどうかの最も信頼できる指標です。
第二に、コンテキストを考慮した意味的フィールドマッピングです。真のエージェンティックシステムは、テキストを抽出してラベルが一致することを期待するだけではありません。フィールド間の関係性を評価します。明細テーブルを抽出した場合、明細項目の合計が小計と一致するかを確認します。値に矛盾がある場合、推測はせずにフラグを立て、再読込するか、ビジネスルールを適用します。結果は生の抽出データではなく、信頼性インジケータ付きの検証済み出力であり、それに基づいて行動できます。
第三に、再トレーニングなしの自己修正です。従来のMLシステムは再トレーニングによって改善されます。エージェンティックシステムはその場で改善されます。人間がフラグ付きの抽出結果を修正すると、その修正は類似ドキュメントの推論レイヤーにフィードバックされます。これは、一部のツールが依然として必要とする「最低10サンプル」アプローチとは根本的に異なります。
第四に、データ整合性を維持するバッチ処理です。Agentic OCRシステムの真の試練は、完璧なPDFを1つ処理することではなく、異なるタイプの50件の乱雑なドキュメントを単一のバッチで処理することです。フィールド間の関係は50件すべてで維持されていますか?信頼性スコアは一貫していますか?システムは不良データを黙って出力するのではなく、外れ値のドキュメントにフラグを立てますか?バッチ処理こそ、エージェンシーが最も重要となる場面です。なぜなら、そこではシステムがドキュメントごとの人間の監視なしで動作するからです。
ImageToTable.aiは、カスタム列抽出アプローチを通じてこれらの機能を実装しています。必要な列に名前を付けると、AIが各フィールドの意味を理解して、ページ上の位置ではなく、あらゆるドキュメントから一致するデータを特定して抽出します。同じ技術は、大規模なドキュメント処理のためのAI OCRソフトウェアツールでも利用できます。
Agenticドキュメント読み取り入門
従来技術に対するagentic OCRの利点の1つは、試す前に何も設定する必要がないことです。テンプレートの作成も、トレーニングサンプルへのラベル付けも、領域の定義も不要です。システムは、渡されたあらゆるドキュメントに適応します。
その違いを実感する最も簡単な方法は、現在手動で処理しているドキュメント(新しい取引先からの請求書、まだ入力していない領収書、重要な日付を抽出する必要がある契約書など)を、設定を一切変更せずにagentic OCRツールで処理してみることです。ドキュメントごとの設定なしで、ツールが初回で正しい形式の正しいフィールドを抽出できれば、それがagenticの違いです。ボックスを描いたりテンプレートを選択したりするよう求められたら、それはagenticではありません。
実際に体験するには、以下のドキュメントをアップロードしてみてください。抽出したい列(通常スプレッドシートに入力するフィールド名)を定義すると、システムがドキュメント構造を推論し、各値を特定して、すぐに使える構造化データを出力する様子を確認できます。
ファイルは安全に処理され、保存されません。
よくある質問
エージェンティックOCRとAI OCRは同じものですか?
いいえ。AI OCRは文字認識に理解を加えたもので、書類を読み取り、数字が単なる数字列ではなく請求書の合計額であることを識別できます。エージェンティックOCRは、その理解に推論と行動を追加します。AI OCRシステムは読み取りとラベル付けを行います。エージェンティックOCRシステムは、読み取り、ラベル付け、抽出データの内部整合性の判断、矛盾点の指摘、信頼度が低い場合のアプローチの適応を行います。AI OCRはエージェンティックOCRの前提条件ですが、エージェンティックOCRはAI OCR単独では提供できない意思決定層を追加します。
エージェンティックOCRを使用する前に、トレーニングや設定は必要ですか?
いいえ — それがこのカテゴリの決定的な特徴です。エージェンティックOCRシステムは、トレーニングサンプル、テンプレート、フォーマットごとの設定を必要とせず、初回使用時から動作するように設計されています。ドキュメントをアップロードし、必要な出力フィールドを定義するだけで、システムがドキュメント構造を推論して各値を特定・抽出します。ツールがトレーニング用に10個のサンプルドキュメントのアップロードやテンプレートへのゾーン描画を要求する場合、それはエージェンティックOCRではなく、AI機能を備えたテンプレートベースのシステムです。
エージェンティックOCRは手書き文書を処理できますか?
はい、ただしAI OCR全般に当てはまる注意点があります。エージェンティックOCRは、視覚言語モデルが固定データベースに対する文字形状のマッチングではなく視覚パターンを読み取るため、従来のOCRよりも手書きの処理に優れています。エージェンティック層には特有の利点があります。システムが手書きの値を低い信頼度で読み取った場合、誤った値を黙って出力するのではなく、そのフィールドをレビュー対象としてフラグ付けできます。配送伝票や検査フォームなど、印刷と手書きが混在する構造化文書では、エージェンティックOCRは実際に85〜93%のフィールド精度を達成します。
エージェンティックOCRの精度は従来のOCRと比べてどうですか?
文字レベルの精度では、どちらもクリーンな印刷テキストで高い率(95〜99%)を達成します。意味のある違いはフィールドレベルの精度とストレートスルー処理率にあります。従来のOCRやテンプレートベースのIDPシステムは、設定された文書では60〜80%のSTPを達成しますが、フォーマットが変わると急激に低下します。エージェンティックOCRシステムは、自己修正層が手動レビューを必要とするエラーを捕捉するため、様々なフォーマットで90〜95%以上のSTPを達成します。実用的な結果として、エージェンティックOCRは、特に複数のソースから文書が来る場合、文書バッチあたりの人的介入を大幅に削減します。
エージェンティックOCRは現在利用可能ですか、それともまだ研究段階の概念ですか?
現在利用可能です。ただし、この用語は業界でまだ普及途上にあります。「AI OCR」や「AI文書抽出」としてリリースされた多くの文書処理ツールは、すでにエージェンティックな機能(自己補正、意味推論、テンプレート不要の抽出)を備えていますが、そのラベルを使用していません。ツールがフォーマットごとの設定なしにあらゆる文書レイアウトを読み取り、抽出データをビジネスルールに照らして検証し、信頼度の低いフィールドを確認用にフラグ付けする場合、それはエージェンティックOCRシステムとして機能しています。ラベルは、すでに実運用で存在する機能に追いついているのです。