¿Qué es Agentic OCR?
La evolución de 2026 de la lectura de documentos
Agentic OCR — OCR agéntico — es una tecnología de lectura de documentos que utiliza modelos lenguaje-visual no solo para reconocer texto, sino para razonar sobre la estructura del documento, decidir qué información es relevante y generarla como datos estructurados, todo sin plantillas, entrenamiento ni configuración por formato. El término se popularizó a principios de 2025, cuando Andrew Ng presentó la extracción agéntica de documentos como la nueva frontera más allá del OCR tradicional. A mediados de 2026 se ha convertido en un término de búsqueda en rápido crecimiento, no porque la tecnología sea nueva, sino porque la etiqueta por fin nombra algo que ha estado cambiando silenciosamente la forma en que las máquinas leen documentos.
Puntos clave
- Usted pasa horas clasificando los datos extraídos después de que la herramienta dice que ha terminado, y asume que solo necesita un mejor OCR.
- Un procesamiento directo del 60-80% no es una mala configuración: es el techo de las herramientas que leen caracteres pero nunca deciden qué significan.
- Su rol cambia: de revisar cada celda extraída a revisar solo las excepciones que el sistema marcó como realmente inciertas.
Por qué Agentic OCR importa ahora
Cada pocos años aparece un término que reclasifica lo que antes se consideraba "suficientemente bueno" como "heredado". Agentic OCR es ese término para la lectura de documentos en 2026.
Para entender por qué el cambio ocurre ahora, conviene ver la trayectoria. El OCR tradicional surgió en la década de 1970 y resolvió un problema: convertir texto impreso en caracteres digitales. El OCR con IA, que llegó en la década de 2020 con los modelos lenguaje-visual, resolvió un segundo: entender qué significan esos caracteres. Ambos son esenciales y ampliamente desplegados. Pero comparten una limitación fundamental: se detienen en la comprensión. Ninguno da el siguiente paso: decidir qué hacer con lo que leen y actuar en consecuencia.
Ese siguiente paso es lo que aporta "agentic". Un sistema agentic no espera a que un humano le diga "pon el número de factura aquí y el total allí". Decide. Dirige los datos correctos al campo de salida correcto. Detecta inconsistencias y las señala. Aprende de las correcciones sin requerir un ciclo de reentrenamiento.
Esta distinción importa ahora porque el volumen de documentos que las empresas procesan ha superado el paso de clasificación manual que el OCR tradicional e incluso el OCR con IA todavía dejan atrás. Procesar 50 facturas de 50 proveedores ya no es un problema de 50 documentos: es un problema de 50 formatos. Agentic OCR lo reduce a una sola pasada al tratar cada documento como algo sobre lo que el sistema puede razonar, no solo leer.
Los datos respaldan el patrón. En despliegues empresariales, los sistemas de OCR tradicional y de IDP basados en plantillas alcanzan tasas de procesamiento directo del 60-80% en los documentos para los que fueron configurados. Los sistemas de Agentic OCR alcanzan de forma consistente el 90-95%+ porque el bucle de autocorrección captura casos límite que de otro modo requerirían revisión humana. Para un desglose detallado de cómo se compara el OCR agentic con el reconocimiento de caracteres tradicional, consulte nuestra guía sobre qué es el OCR y cómo funciona.
Agentic OCR no reemplaza al OCR ni al OCR con IA: los amplía. El OCR responde "¿qué caracteres hay en esta página?". El OCR con IA responde "¿qué datos contiene este documento?". Agentic OCR responde "¿qué debería pasar con esos datos y son correctos?".
Qué cambió realmente: de leer a razonar
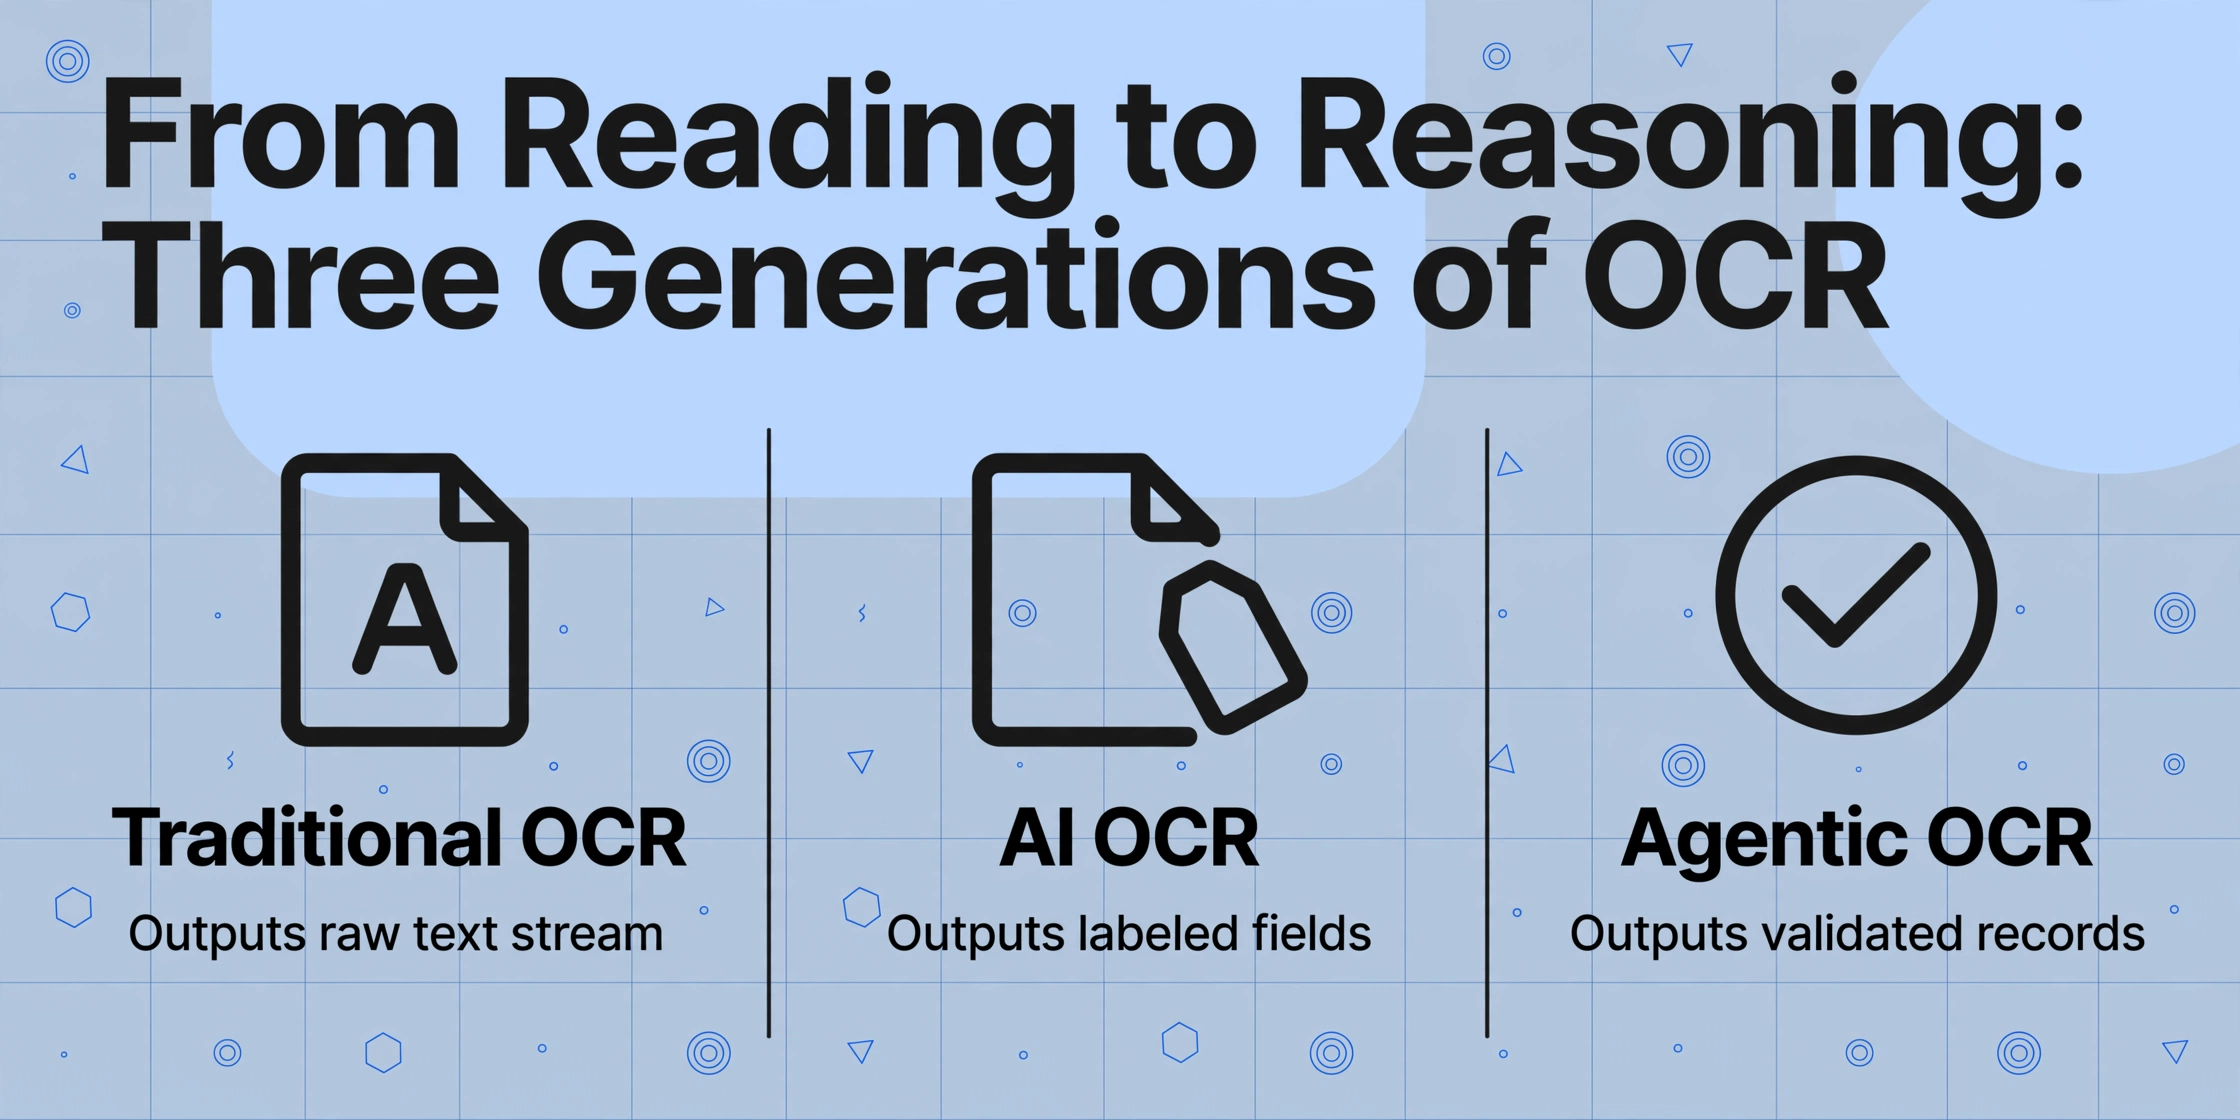
El cambio no está en la capacidad de lectura. Está en lo que ocurre después de terminar de leer.
Para ver la diferencia, considere cómo un solo elemento del documento —la cadena "INV-2026-0842"— atraviesa cada generación de tecnología:
El OCR tradicional lee la página y genera: INV-2026-0842 en algún lugar de un flujo de texto continuo. Una persona debe encontrarlo, reconocerlo como número de factura y copiarlo en la celda correcta. El motor de OCR no puede distinguirlo del código postal o del número de referencia del cliente que casualmente comparten el mismo formato. Esto se analiza en detalle en nuestra guía paso a paso sobre cómo funciona el OCR.
El OCR con IA lee la misma página y genera: Invoice Number: INV-2026-0842. Comprende la relación entre etiqueta y valor, y asigna el texto al campo semántico correcto. El paso de clasificación está parcialmente automatizado. Pero el OCR con IA aún depende de las etiquetas y la estructura del propio documento. Si el número de factura aparece en una ubicación inusual —incrustado en un gráfico de encabezado o escrito a mano junto a una etiqueta diferente—, el OCR con IA puede pasarlo por alto porque faltan las señales semánticas esperadas. Abordamos esto en profundidad en nuestro artículo sobre qué es el OCR con IA y en qué se diferencia del OCR tradicional.
El Agentic OCR lee la página y genera un registro estructurado: { "document_type": "invoice", "invoice_number": "INV-2026-0842", "vendor": "Acme Supply", "total": 1247.50, "confidence": 0.97 }, pero solo después de razonar entre alternativas. ¿Es probable que esta cadena sea un número de factura? ¿Sigue patrones conocidos? Si la confianza es baja, no adivina: marca el campo para revisión o intenta una segunda pasada. La parte "agentic" es el bucle: leer, decidir, validar, corregir.
Esta capa de razonamiento es lo que separa el Agentic OCR de toda tecnología de lectura de documentos anterior. El OCR tradicional lee y se detiene. El OCR con IA lee y comprende. El Agentic OCR lee, comprende, decide, valida y se adapta. No es una cinta transportadora más rápida: es un proceso completamente distinto.
Cómo funciona Agentic OCR en profundidad
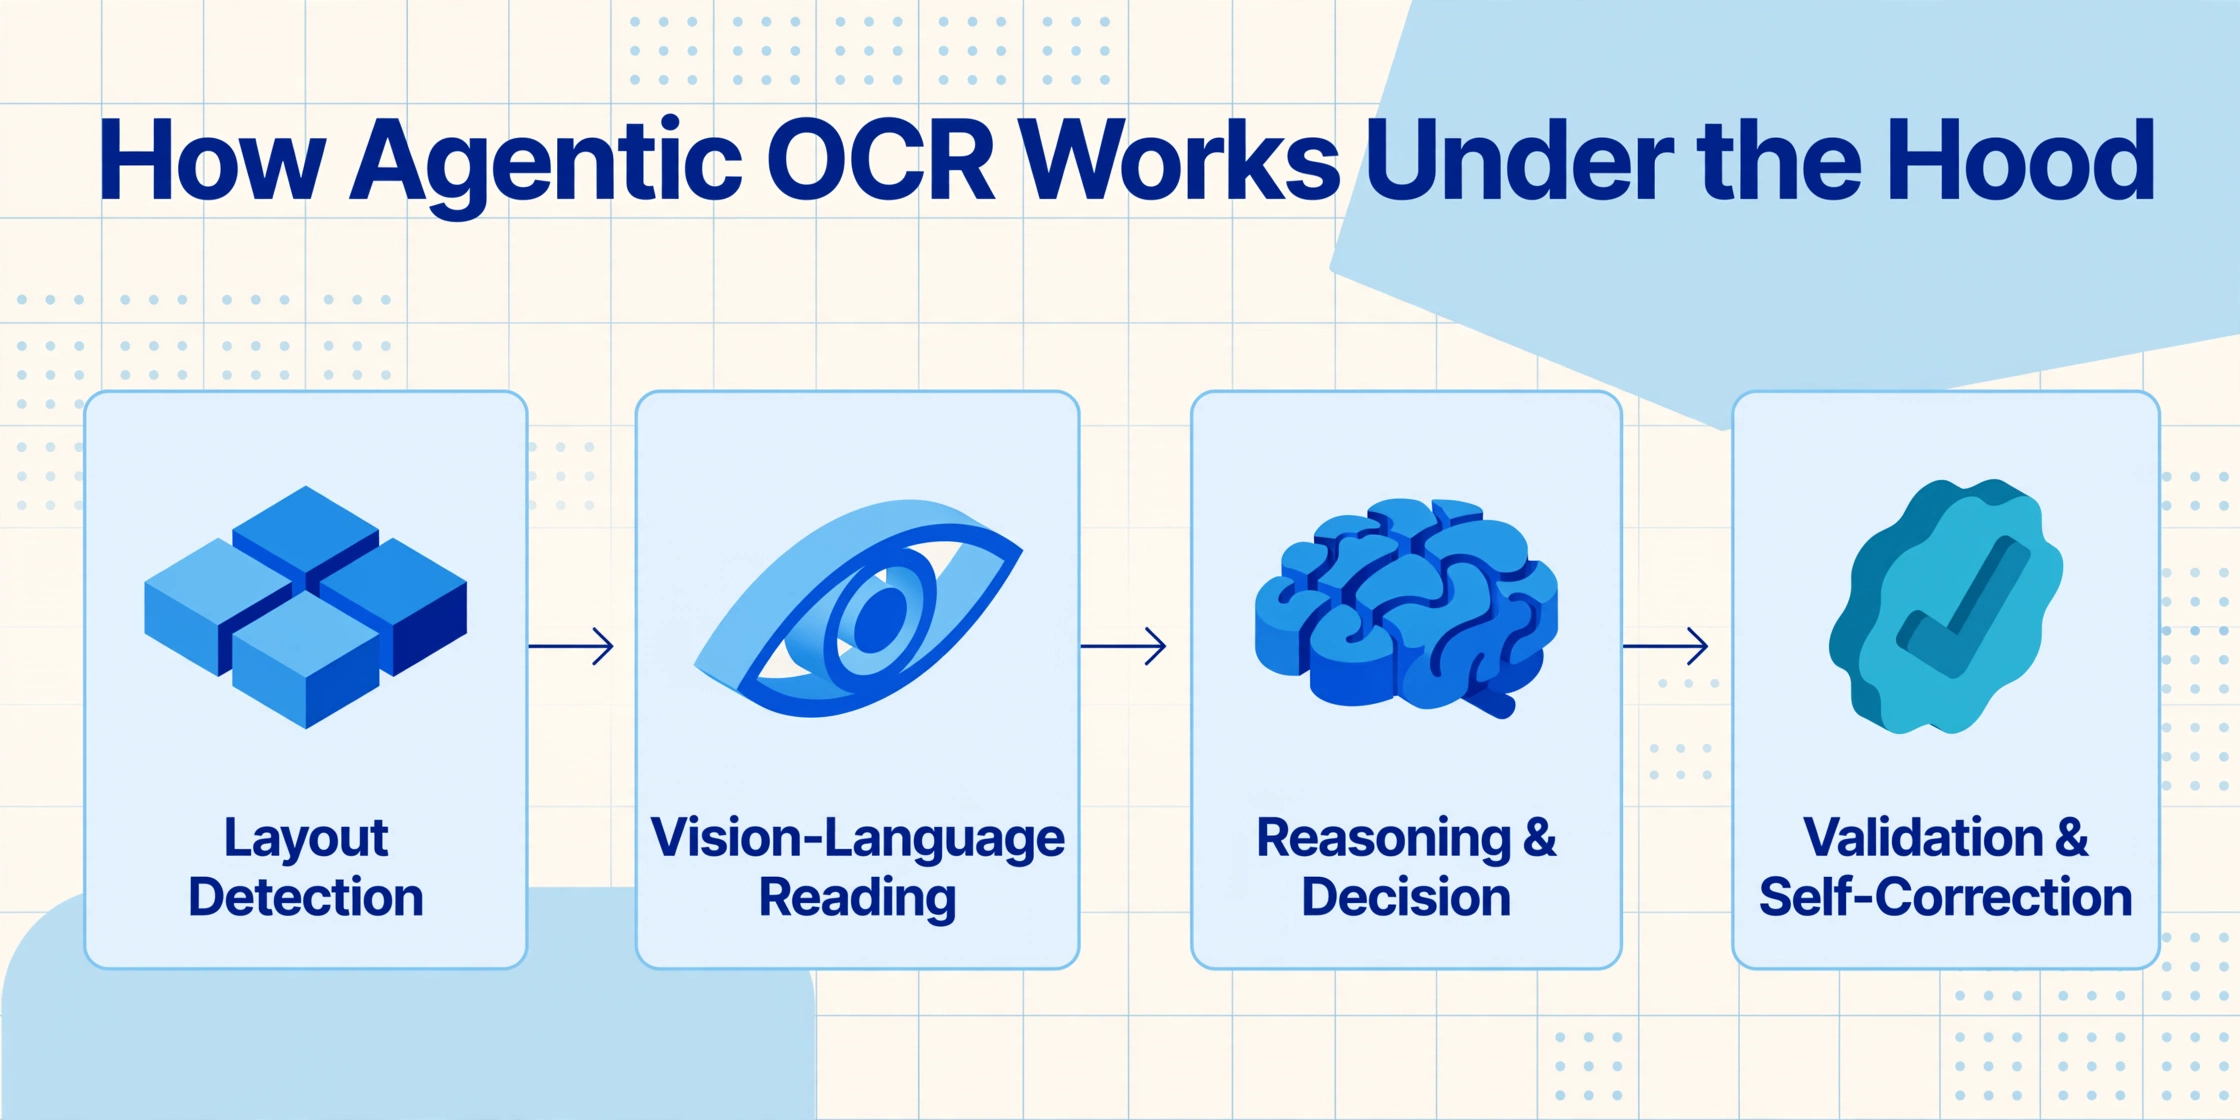
Agentic OCR no es un único modelo ni algoritmo. Es un pipeline orquestado de componentes especializados que trabajan juntos como un equipo de especialistas en documentos.
Aunque la arquitectura exacta varía entre implementaciones, el diseño central sigue cuatro capas funcionales:
Detección de diseño
El sistema escanea la página e identifica regiones estructurales: encabezados, áreas de tablas, bloques de firmas, pies de página. Esto es razonamiento espacial: el modelo aprende cómo se ve una "tabla" frente a un "párrafo" independientemente del contenido. Esta capa responde "¿dónde estoy en esta página y qué tipo de contenido hay aquí?".
Lectura de modelo lenguaje-visual
Un modelo lenguaje-visual lee cada región con conciencia del contexto. A diferencia del OCR carácter por carácter, el VLM procesa bloques visuales completos simultáneamente. Reconoce que un número en negrita en una celda inferior derecha significa "total" incluso sin una etiqueta explícita cerca. Preserva el orden de lectura en diseños de varias columnas y celdas de tabla combinadas, las relaciones estructurales que el OCR tradicional descarta.
Razonamiento y decisión
Este es el núcleo agéntico. El sistema evalúa lo que ha leído y decide: ¿qué valores extraídos corresponden a qué campos de salida? ¿El "total" extraído concuerda con la suma de las partidas? Si un valor es ambiguo —un número que podría ser un número de pedido o un ID de cliente—, el sistema aplica el contexto del tipo de documento y los patrones de campo para resolverlo antes de generar la salida.
Validación y autocorrección
Los datos extraídos se verifican contra patrones conocidos, relaciones entre campos y reglas de negocio. Un total que no coincide con la suma de las partidas se marca. Un número de factura fuera del formato esperado activa una segunda pasada de lectura. El sistema no asume que su primera respuesta sea correcta: verifica y solo genera la salida cuando se cumplen los umbrales de confianza. Las puntuaciones de confianza a nivel de campo permiten a los revisores centrarse en los casos inciertos en lugar de volver a comprobar cada campo.
Piense en ello como la diferencia entre una fotocopiadora y un auxiliar contable capacitado. La fotocopiadora (OCR tradicional) produce una copia exacta de cada carácter. El auxiliar (Agentic OCR) lee el documento, entiende que es una factura, verifica los cálculos, introduce los datos en las cuentas correctas y marca cualquier línea que parezca inusual. La fotocopiadora es más rápida por página. El auxiliar produce trabajo listo para usar.
Cómo usan Agentic OCR los distintos roles
El valor de Agentic OCR no es abstracto: se manifiesta de forma distinta según quién lo use y qué intente lograr.
Auxiliares contables y contadores
Usted recibe facturas de más de 30 proveedores: algunas como PDF adjuntos en correos, otras como fotos del personal de campo. Cada proveedor usa un diseño diferente y varios cambian su formato sin avisar. Con el OCR basado en plantillas, cada cambio de diseño implica rehacer una plantilla. Con Agentic OCR, usted carga las 30 en un solo lote, define las columnas de salida que necesita —Número de factura, Fecha, Proveedor, Total— y obtiene una única tabla estructurada. El sistema gestiona la variación de diseño automáticamente porque lee por significado, no por posición. Cuando un total parece incorrecto respecto a las líneas, marca la fila en lugar de introducir datos erróneos en su contabilidad.
Propietarios de pequeñas empresas
Usted toma fotos de recibos con su teléfono y, ocasionalmente, recibe albaranes manuscritos. Su necesidad es sencilla: pasar los datos a una hoja de cálculo sin teclear. Agentic OCR gestiona el caos de formatos —recibos arrugados, reflejos, fotos en ángulo, escritura mixta— porque su capa de razonamiento ajusta la estrategia de lectura según el documento. Un recibo arrugado activa un paso de preprocesamiento distinto al de un escaneo limpio; el sistema decide qué estrategia usar y valida la salida sin que usted tenga que intervenir.
Desarrolladores que crean flujos de trabajo con documentos
Usted integra el procesamiento de documentos en una aplicación personalizada: un sistema de gestión de gastos, un portal de alta de proveedores. El OCR tradicional le obliga a gestionar cada caso límite: variantes de diseño, campos faltantes, discrepancias de formato. Cada variante añade código. Agentic OCR reduce esa complejidad porque la capa de extracción gestiona la variación. Usted define el esquema de salida; el sistema determina cómo rellenarlo. La autocorrección reduce la lógica de gestión de excepciones que debe mantener. Para una visión general de la categoría tecnológica más amplia, consulte nuestra guía sobre extracción de documentos con IA y cómo funciona.
Capacidades clave que debe buscar
No todas las herramientas que afirman tener capacidades "agénticas" realmente añaden razonamiento y autocorrección al flujo de trabajo. Esto es lo que separa el Agentic OCR genuino de las herramientas que son simplemente OCR con IA con una nueva etiqueta.
Primero, la extracción sin plantilla es la base. Si una herramienta requiere que usted defina zonas, dibuje cuadros o cree plantillas para cada formato de documento, no es agéntica: es OCR basado en plantillas con una interfaz moderna. El Agentic OCR decide cómo abordar cada documento según lo que ve, no según un mapa de campos preconfigurado. Este es el indicador más fiable de si la tecnología subyacente ha cambiado.
Segundo, mapeo semántico de campos con contexto. Un sistema agéntico genuino no se limita a extraer texto y esperar que las etiquetas coincidan. Evalúa las relaciones entre campos. Si extrae una tabla de partidas, comprueba que las partidas sumen el subtotal. Si los valores entran en conflicto, no adivina: los marca, vuelve a leer o aplica reglas de negocio. El resultado no son datos extraídos en bruto; es una salida validada con indicadores de confianza sobre los que usted puede actuar.
Tercero, autocorrección sin reentrenamiento. Los sistemas de ML tradicionales mejoran mediante reentrenamiento. Los sistemas agénticos mejoran sobre la marcha: cuando una persona corrige una extracción marcada, esa corrección retroalimenta la capa de razonamiento para documentos similares. Esto es fundamentalmente distinto del enfoque de "mínimo de 10 muestras" que algunas herramientas todavía exigen.
Cuarto, procesamiento por lotes que mantiene la integridad de los datos. La verdadera prueba de un sistema de Agentic OCR no es cómo maneja un PDF perfecto, sino cómo maneja 50 documentos desordenados de distintos tipos en un solo lote. ¿Se mantienen las relaciones entre campos en los 50? ¿Son coherentes las puntuaciones de confianza? ¿Marca el sistema los documentos atípicos en lugar de emitir silenciosamente datos erróneos? El lote es donde la capacidad agéntica importa más, porque es donde el sistema opera sin supervisión humana documento por documento.
ImageToTable.ai implementa estas capacidades mediante su enfoque de Extracción de Columnas Personalizadas: usted nombra las columnas que desea, y la IA localiza y extrae los datos coincidentes de cualquier documento comprendiendo qué significa cada campo, no dónde se sitúa en la página. La misma tecnología está disponible a través de nuestra herramienta de software de OCR con IA para procesar documentos a escala.
Primeros pasos con la lectura agéntica de documentos
Una de las ventajas del Agentic OCR sobre tecnologías anteriores es que no necesita configurar nada antes de probarlo. Sin plantillas que crear, sin muestras de entrenamiento que etiquetar, sin zonas que definir. El sistema se adapta al documento que le entregue.
La forma más sencilla de experimentar la diferencia es tomar un documento que actualmente procesa de forma manual —una factura de un proveedor nuevo, un recibo que aún no ha registrado, un contrato del que necesita extraer fechas clave— y pasarlo por una herramienta de Agentic OCR sin cambiar ningún ajuste. Si la herramienta extrae los campos correctos en el formato correcto al primer intento y sin configuración por documento, acaba de presenciar la diferencia agéntica. Si le pide dibujar cuadros o seleccionar una plantilla, no es agéntica.
Para una demostración práctica, pruebe a subir cualquier documento a continuación. Defina las columnas que desee —los nombres de campo que normalmente escribiría en una hoja de cálculo— y observe cómo el sistema razona sobre la estructura de su documento, localiza cada valor y genera datos estructurados listos para usar.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas frecuentes
¿Agentic OCR es lo mismo que OCR con IA?
No. El OCR con IA añade comprensión al reconocimiento de caracteres: puede leer un documento e identificar que un número es el total de una factura en lugar de una simple cadena de dígitos. Agentic OCR añade razonamiento y acción sobre esa comprensión. Un sistema de OCR con IA lee y etiqueta. Un sistema de Agentic OCR lee, etiqueta, decide si los datos extraídos son internamente coherentes, señala lo que no cuadra y adapta su enfoque cuando la confianza es baja. El OCR con IA es un requisito previo para Agentic OCR, pero Agentic OCR añade la capa de toma de decisiones que el OCR con IA por sí solo no ofrece.
¿Necesito entrenar o configurar Agentic OCR antes de usarlo?
No, y esa es la característica que define la categoría. Los sistemas de Agentic OCR están diseñados para funcionar desde el primer uso sin muestras de entrenamiento, sin plantillas y sin configuración por formato. Usted carga un documento, define los campos de salida que desea y el sistema razona sobre la estructura del documento para localizar y extraer cada valor. Si una herramienta le pide cargar 10 documentos de muestra para entrenamiento o dibujar zonas sobre una plantilla, no es Agentic OCR: es un sistema basado en plantillas con funciones de IA.
¿Puede Agentic OCR procesar documentos manuscritos?
Sí, pero con las mismas salvedades que se aplican al OCR con IA en general. Agentic OCR maneja la escritura a mano mejor que el OCR tradicional porque el modelo lenguaje-visual lee patrones visuales en lugar de comparar formas de caracteres con una base de datos fija. La capa agéntica añade una ventaja específica: si el sistema lee un valor manuscrito con baja confianza, puede señalar ese campo para revisión en lugar de emitir un valor incorrecto de forma silenciosa. En documentos estructurados con texto impreso y escritura a mano combinados —como albaranes o formularios de inspección— Agentic OCR alcanza una precisión a nivel de campo del 85-93% en la práctica.
¿Qué precisión tiene Agentic OCR en comparación con el OCR tradicional?
En precisión a nivel de carácter, ambos alcanzan tasas altas en texto impreso limpio (95-99%). La diferencia significativa está en la precisión a nivel de campo y en las tasas de procesamiento directo: el OCR tradicional y los sistemas IDP basados en plantillas alcanzan un 60-80% de STP en los documentos para los que fueron configurados, y caen drásticamente cuando los formatos cambian. Los sistemas de Agentic OCR alcanzan un 90-95%+ de STP en formatos variados, porque la capa de autocorrección detecta errores que de otro modo requerirían revisión manual. El resultado práctico es que Agentic OCR requiere mucha menos intervención humana por lote de documentos, especialmente cuando los documentos provienen de múltiples fuentes.
¿El Agentic OCR está disponible hoy o sigue siendo un concepto de investigación?
Está disponible hoy, aunque el término aún se está adoptando en toda la industria. Muchas herramientas de procesamiento de documentos que se lanzaron como "AI OCR" o "AI document extraction" ya incluyen capacidades agénticas —autocorrección, razonamiento semántico, extracción sin plantilla— sin usar la etiqueta. Si una herramienta lee cualquier diseño de documento sin configuración por formato, valida los datos extraídos contra reglas de negocio y marca los campos de baja confianza para su revisión, está funcionando como un sistema de Agentic OCR, use o no el término. La etiqueta se está poniendo al día con capacidades que ya existen en producción.