Qu'est-ce que l'Agentic OCR ?
L'évolution 2026 de la lecture de documents
L'Agentic OCR — reconnaissance optique de caractères agentique — est une technologie de lecture de documents qui utilise des modèles vision-langage pour non seulement reconnaître le texte, mais aussi raisonner sur la structure du document, décider quelles informations sont importantes et les restituer sous forme de données structurées — le tout sans modèles, sans formation ni configuration par format. Le terme est entré dans le courant dominant début 2025 lorsqu'Andrew Ng a présenté l'extraction documentaire agentique comme la prochaine frontière au-delà de l'OCR traditionnel. À la mi-2026, il est devenu un terme de recherche en forte croissance — non pas parce que la technologie est entièrement nouvelle, mais parce que le label nomme enfin ce qui changeait silencieusement la façon dont les machines lisent les documents.
Points clés à retenir
- Vous passez des heures à trier les données extraites après que l'outil affirme avoir terminé, et vous supposez qu'il vous faut simplement un meilleur OCR.
- Un taux de traitement direct de 60 à 80 % n'est pas une mauvaise configuration — c'est le plafond des outils qui lisent les caractères sans jamais décider de leur signification.
- Votre rôle évolue : au lieu de vérifier chaque cellule extraite, vous ne révisez que les exceptions que le système a signalées comme réellement incertaines.
Pourquoi l'Agentic OCR est important aujourd'hui
Chaque quelques années, un terme apparaît et reclasse ce qu'on appelait « assez bon » en « hérité ». L'Agentic OCR est ce terme pour la lecture de documents en 2026.
Pour comprendre pourquoi ce changement se produit maintenant, il aide de voir la trajectoire. L'OCR traditionnel a émergé dans les années 1970 et a résolu un problème : convertir le texte imprimé en caractères numériques. L'OCR IA, arrivé dans les années 2020 avec les modèles vision-langage, en a résolu un second : comprendre ce que ces caractères signifient. Les deux sont essentiels et largement déployés. Mais ils partagent une limitation fondamentale : ils s'arrêtent à la compréhension. Aucun ne fait le pas suivant — décider quoi faire avec ce qu'ils lisent et agir sur cette décision.
Ce pas suivant est ce que « agentique » ajoute. Un système agentique n'attend pas qu'un humain lui dise « mets le numéro de facture ici et le total là ». Il décide. Il achemine les bonnes données vers le bon champ de sortie. Il détecte les incohérences et les signale. Il apprend des corrections sans nécessiter un cycle de réentraînement.
Cette distinction importe maintenant parce que le volume de documents que les entreprises traitent a dépassé l'étape de tri manuel que l'OCR traditionnel et même l'OCR IA laissent encore derrière eux. Traiter 50 factures de 50 fournisseurs n'est plus un problème de 50 documents — c'est un problème de 50 formats. L'Agentic OCR réduit cela à un seul passage en traitant chaque document comme quelque chose que le système peut raisonner, pas seulement lire.
Les données soutiennent ce schéma. Dans les déploiements en entreprise, l'OCR traditionnel et les systèmes IDP basés sur des modèles atteignent des taux de traitement direct de 60 à 80 % sur les documents pour lesquels ils ont été configurés. Les systèmes Agentic OCR atteignent systématiquement 90 à 95 %+ parce que la boucle d'auto-correction capture les cas limites qui nécessiteraient autrement une revue humaine. Pour une analyse détaillée de la façon dont l'Agentic OCR se compare à la reconnaissance de caractères traditionnelle, consultez notre guide sur ce qu'est l'OCR et comment il fonctionne.
L'Agentic OCR ne remplace pas l'OCR ou l'OCR IA — il les étend. L'OCR répond « quels caractères sont sur cette page ? » L'OCR IA répond « quelles données ce document contient-il ? » L'Agentic OCR répond « que devrait-il se passer avec ces données, et est-ce correct ? »
Ce qui a réellement changé — de la lecture au raisonnement
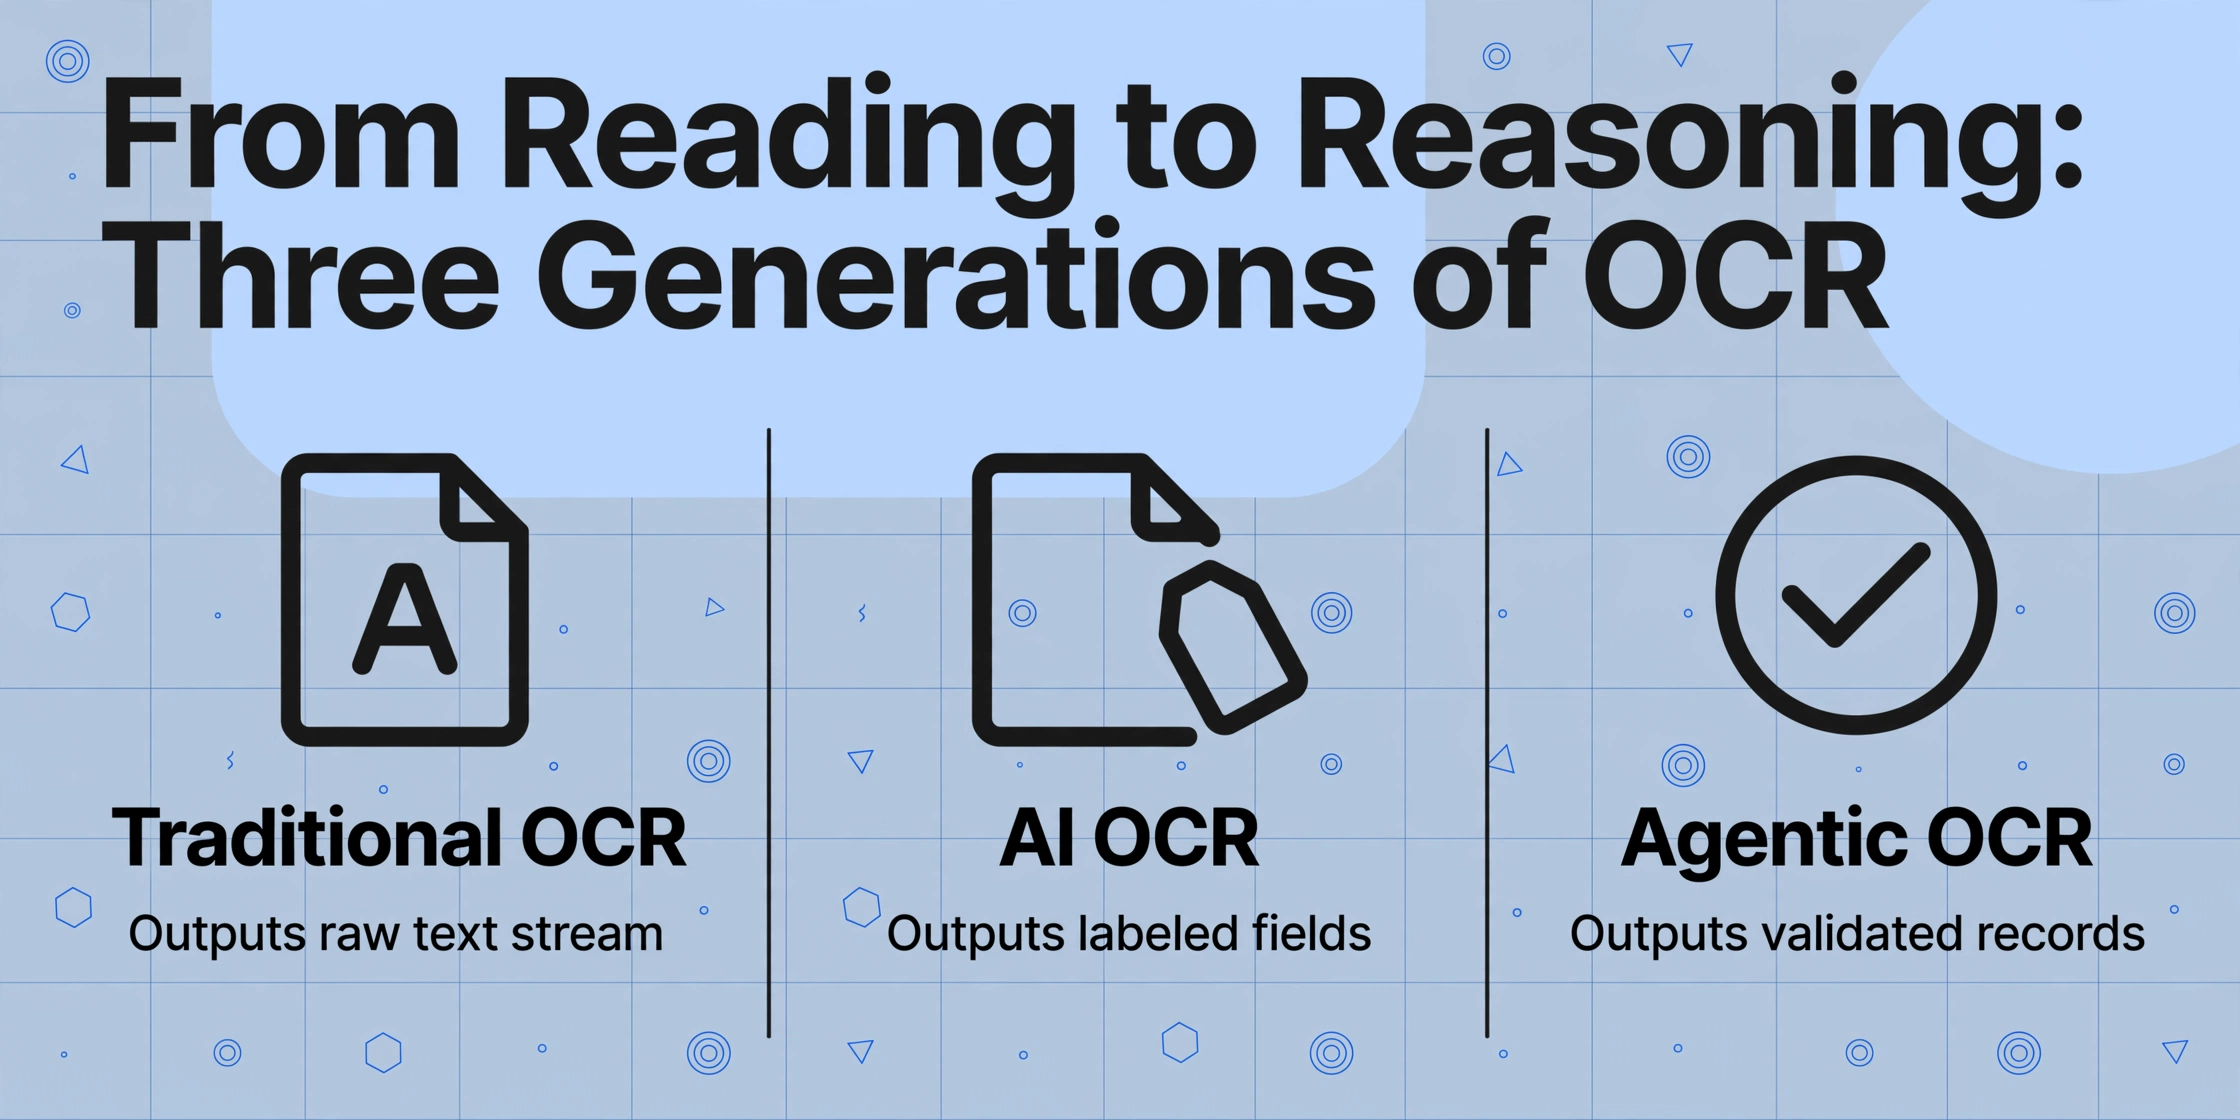
Le changement ne réside pas dans la capacité de lecture. Il se situe dans ce qui se passe après la lecture.
Pour saisir la différence, considérons comment un élément de document unique — la chaîne « INV-2026-0842 » — traverse chaque génération de technologie :
OCR traditionnel lit la page et génère : INV-2026-0842 quelque part dans un flux de texte continu. Un humain doit le trouver, le reconnaître comme un numéro de facture et le copier dans la cellule appropriée. Le moteur d'OCR ne peut pas le distinguer du code postal ou de la référence client qui partagent le même format. Ce point est abordé en détail dans notre guide pas à pas sur le fonctionnement de l'OCR.
OCR IA lit la même page et génère : Numéro de facture : INV-2026-0842. Il comprend la relation étiquette-valeur et mappe le texte au champ sémantique correct. L'étape de tri est partiellement automatisée. Mais l'OCR IA dépend toujours des étiquettes et de la structure propres au document. Si le numéro de facture apparaît à un emplacement inhabituel — intégré dans un graphique d'en-tête ou écrit à la main à côté d'une étiquette différente — l'OCR IA peut le manquer, car les indices sémantiques attendus sont absents. Nous avons traité ce sujet en profondeur dans notre article sur ce qu'est l'OCR IA et en quoi il diffère de l'OCR traditionnel.
Agentic OCR lit la page et génère un enregistrement structuré : { "document_type": "invoice", "invoice_number": "INV-2026-0842", "vendor": "Acme Supply", "total": 1247.50, "confidence": 0.97 } — mais seulement après avoir raisonné sur les alternatives. Cette chaîne est-elle probablement un numéro de facture ? Suit-elle des schémas connus ? Si la confiance est faible, il ne devine pas — il signale le champ pour examen ou tente une seconde passe. La partie « agentique » est la boucle : lire, décider, valider, corriger.
Cette couche de raisonnement est ce qui distingue l'Agentic OCR de toute technologie de lecture de documents qui l'a précédé. L'OCR traditionnel lit et s'arrête. L'OCR IA lit et comprend. L'Agentic OCR lit, comprend, décide, valide et s'adapte. Ce n'est pas un tapis roulant plus rapide — c'est un processus entièrement différent.
Comment fonctionne l'Agentic OCR en coulisses
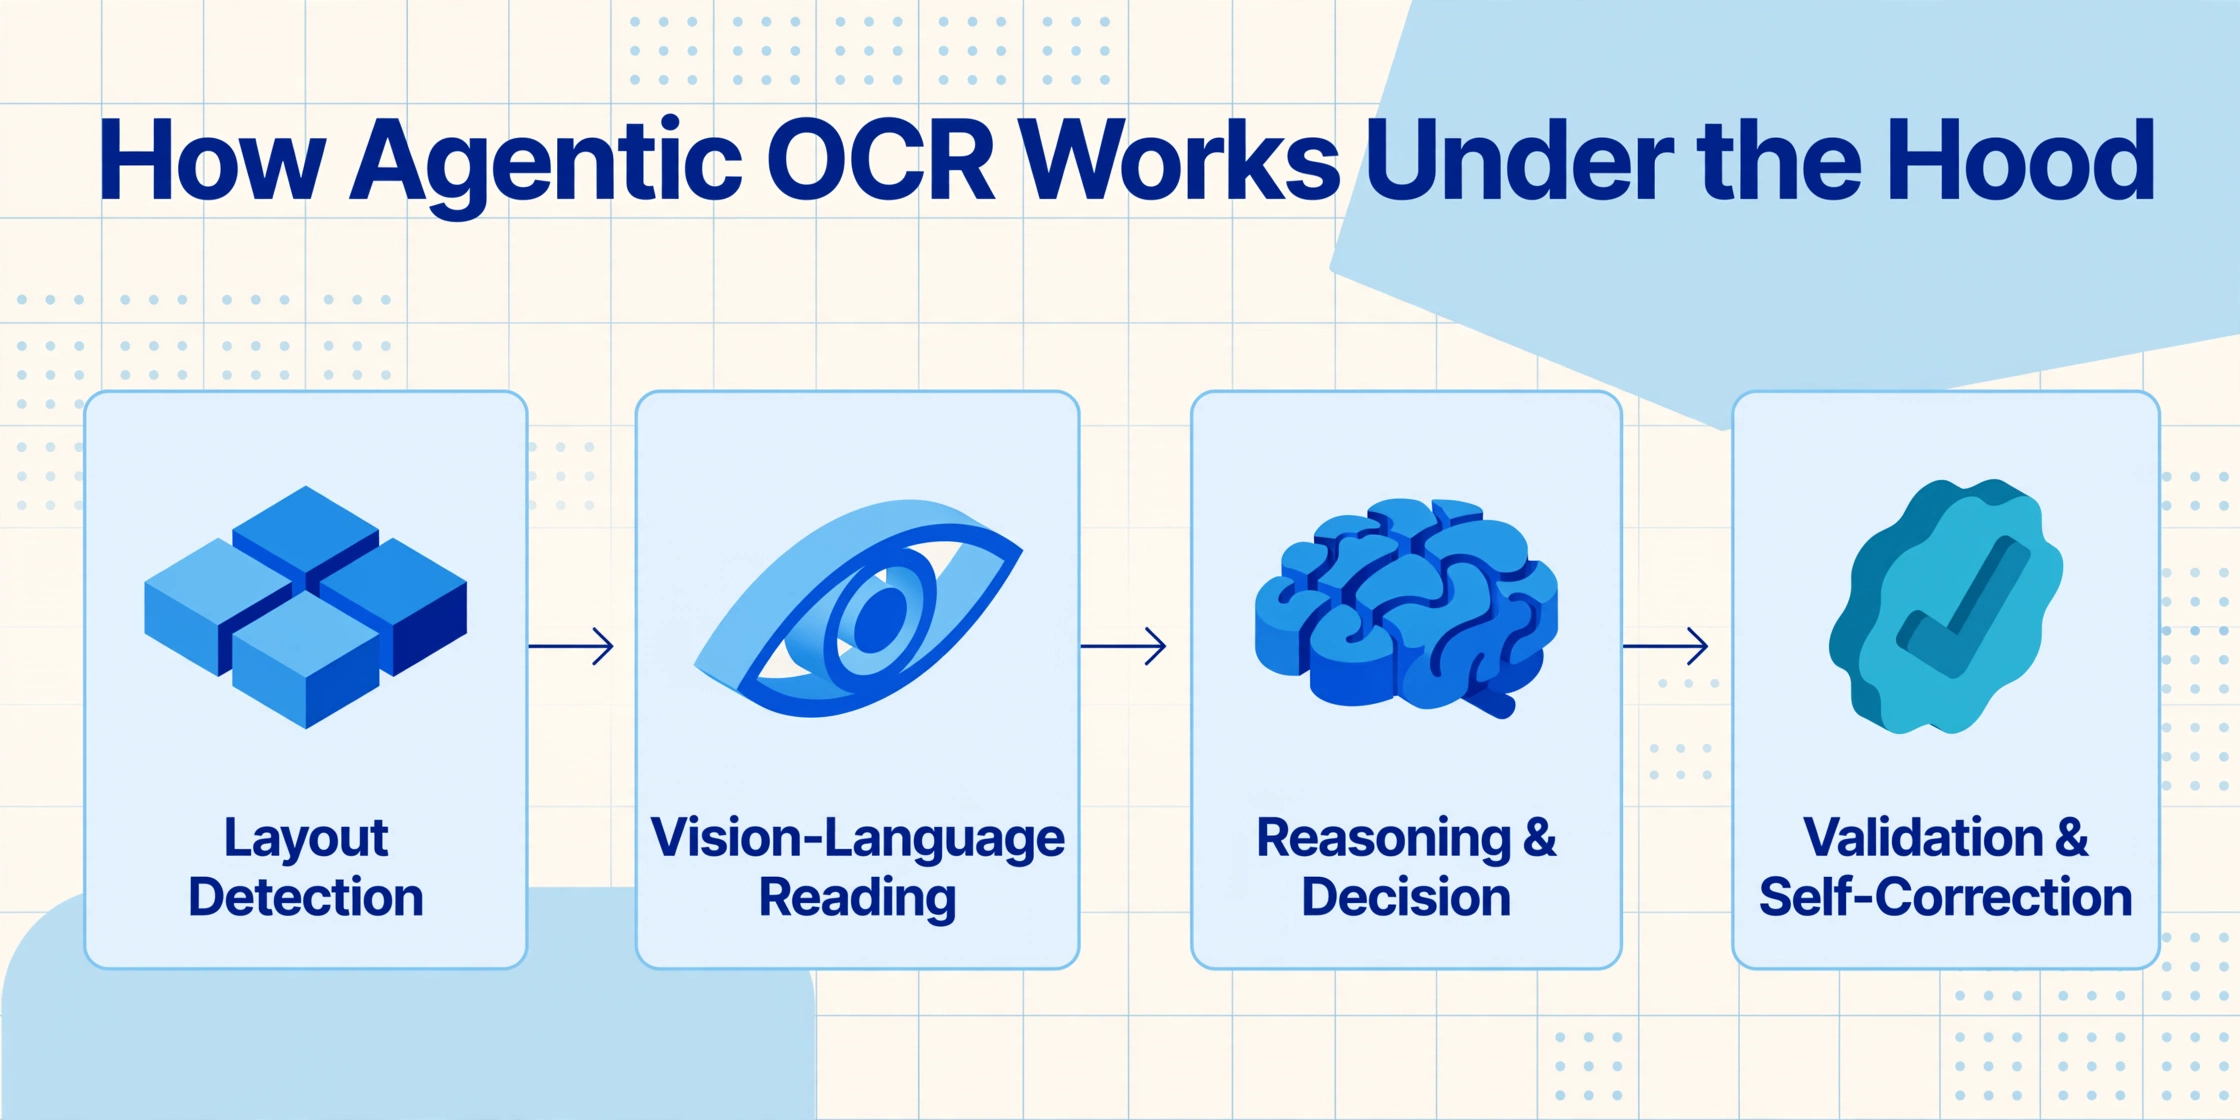
L'Agentic OCR n'est pas un modèle ou un algorithme unique. C'est un pipeline orchestré de composants spécialisés qui travaillent ensemble comme une équipe de spécialistes documentaires.
Bien que l'architecture exacte varie selon les implémentations, la conception de base suit quatre couches fonctionnelles :
Détection de la mise en page
Le système analyse la page et identifie les zones structurelles : en-têtes, zones de tableau, blocs de signature, pieds de page. C'est un raisonnement spatial — le modèle apprend à quoi ressemble un « tableau » par rapport à un « paragraphe », indépendamment du contenu. Cette couche répond à la question « où suis-je sur cette page et quel type de contenu s'y trouve ? »
Lecture par modèle vision-langage
Un modèle vision-langage lit chaque zone avec une conscience du contexte. Contrairement à l'OCR caractère par caractère, le VLM traite des blocs visuels entiers simultanément. Il reconnaît qu'un nombre en gras dans une cellule en bas à droite signifie « total », même sans étiquette explicite à proximité. Il préserve l'ordre de lecture dans les mises en page multi-colonnes et les cellules de tableau fusionnées — les relations structurelles que l'OCR traditionnel perd.
Raisonnement et décision
C'est le cœur agentique. Le système évalue ce qu'il a lu et décide : quelles valeurs extraites correspondent à quels champs de sortie ? Le « total » extrait correspond-il à la somme des lignes ? Si une valeur est ambiguë — un nombre qui pourrait être un numéro de bon de commande ou un identifiant client — le système applique le contexte du type de document et les modèles de champs pour la résoudre avant de produire la sortie.
Validation et autocorrection
Les données extraites sont vérifiées par rapport à des modèles connus, des relations entre champs et des règles métier. Un total qui ne correspond pas à la somme des lignes est signalé. Un numéro de facture hors du format attendu déclenche une seconde passe de lecture. Le système ne suppose pas que sa première réponse est correcte — il vérifie et ne produit une sortie que lorsque les seuils de confiance sont atteints. Les scores de confiance au niveau des champs permettent aux réviseurs de se concentrer sur les cas incertains plutôt que de revérifier chaque champ.
Considérez cela comme la différence entre un photocopieur et un comptable formé. Le photocopieur (OCR traditionnel) produit une copie exacte de chaque caractère. Le comptable (Agentic OCR) lit le document, comprend qu'il s'agit d'une facture, vérifie les calculs, saisit les données dans les bons comptes et signale les lignes inhabituelles. Le photocopieur est plus rapide par page. Le comptable produit un travail prêt à l'emploi.
Comment les différents rôles utilisent l'Agentic OCR
La valeur de l'Agentic OCR n'est pas abstraite — elle se manifeste différemment selon l'utilisateur et son objectif.
Comptables et teneurs de livres
Vous recevez des factures de plus de 30 fournisseurs — certaines par e-mail en PDF, d'autres sous forme de photos prises par le personnel terrain. Chaque fournisseur utilise une mise en page différente, et plusieurs changent de format sans préavis. Avec l'OCR basé sur des modèles, chaque changement de mise en page implique de reconstruire un modèle. Avec l'Agentic OCR, vous déposez les 30 documents dans un seul lot, définissez les colonnes de sortie nécessaires — Numéro de facture, Date, Fournisseur, Total — et obtenez un tableau structuré unique. Le système gère automatiquement les variations de mise en page car il lit par le sens, non par la position. Lorsqu'un total semble incohérent par rapport aux lignes, il signale la ligne au lieu de transmettre des données erronées dans vos livres comptables.
Propriétaires de petites entreprises
Vous prenez des photos de reçus avec votre téléphone et recevez occasionnellement des bons de livraison manuscrits. Votre besoin est simple : transférer les données dans un tableur sans les saisir manuellement. L'Agentic OCR gère le chaos des formats — reçus froissés, reflets, photos inclinées, écritures mixtes — car sa couche de raisonnement adapte la stratégie de lecture à chaque document. Un reçu froissé déclenche une étape de prétraitement différente de celle d'un scan propre ; le système décide de la stratégie à utiliser et valide le résultat sans que vous ayez à intervenir.
Développeurs créant des pipelines documentaires
Vous intégrez le traitement documentaire dans une application personnalisée — un système de gestion des dépenses, un portail d'intégration fournisseurs. L'OCR traditionnel vous oblige à gérer chaque cas limite : variantes de mise en page, champs manquants, écarts de format. Chaque variante ajoute du code. L'Agentic OCR réduit cette complexité car la couche d'extraction gère la variance. Vous définissez le schéma de sortie ; le système détermine comment le remplir. L'auto-correction réduit la logique de gestion des exceptions à maintenir. Pour une vue d'ensemble de la catégorie technologique plus large, consultez notre guide sur l'extraction documentaire par IA et son fonctionnement.
Fonctionnalités clés à rechercher
Tous les outils qui se prétendent « agentiques » n'ajoutent pas réellement du raisonnement et de l'auto-correction au pipeline. Voici ce qui distingue un véritable OCR agentique des outils qui ne sont que de l'OCR IA avec une nouvelle étiquette.
Premièrement, l'extraction sans modèle est la base. Si un outil exige de définir des zones, de dessiner des cadres ou de créer des modèles pour chaque format de document, il n'est pas agentique — c'est de l'OCR basé sur des modèles avec une interface moderne. L'OCR agentique décide comment aborder chaque document en fonction de ce qu'il voit, et non d'une carte de champs préconfigurée. C'est l'indicateur le plus fiable pour savoir si la technologie sous-jacente a réellement changé.
Deuxièmement, le mappage sémantique des champs avec contexte. Un véritable système agentique ne se contente pas d'extraire du texte en espérant que les étiquettes correspondent. Il évalue les relations entre les champs. S'il extrait un tableau de lignes, il vérifie que les lignes correspondent au sous-total. Si les valeurs sont en conflit, il ne devine pas — il signale, relit ou applique des règles métier. Le résultat n'est pas des données brutes extraites ; c'est une sortie validée avec des indicateurs de confiance sur lesquels vous pouvez agir.
Troisièmement, l'auto-correction sans réentraînement. Les systèmes ML traditionnels s'améliorent par réentraînement. Les systèmes agentiques s'améliorent à la volée — lorsqu'un humain corrige une extraction signalée, cette correction est réinjectée dans la couche de raisonnement pour les documents similaires. C'est fondamentalement différent de l'approche « minimum de 10 échantillons » que certains outils exigent encore.
Quatrièmement, le traitement par lots qui maintient l'intégrité des données. Le véritable test d'un système OCR agentique n'est pas de savoir comment il traite un PDF parfait, mais comment il gère 50 documents hétérogènes de différents types en un seul lot. Les relations entre les champs sont-elles maintenues sur les 50 ? Les scores de confiance sont-ils cohérents ? Le système signale-t-il les documents aberrants plutôt que de produire silencieusement des données erronées ? C'est dans le lot que l'agence compte le plus, car c'est là que le système opère sans supervision humaine par document.
ImageToTable.ai implémente ces fonctionnalités grâce à son approche d'Extraction de colonnes personnalisées : vous nommez les colonnes souhaitées, et l'IA localise et extrait les données correspondantes de tout document en comprenant ce que chaque champ signifie — et non où il se trouve sur la page. La même technologie est disponible via notre outil logiciel OCR IA pour le traitement de documents à grande échelle.
Premiers pas avec la lecture agentique de documents
L'un des avantages de l'OCR agentique par rapport aux technologies antérieures est que vous n'avez besoin de configurer rien avant de l'essayer. Pas de modèles à créer, pas d'échantillons d'entraînement à étiqueter, pas de zones à définir. Le système s'adapte à tout document que vous lui fournissez.
La façon la plus simple de constater la différence est de prendre un document que vous traitez actuellement manuellement — une facture d'un nouveau fournisseur, un reçu que vous n'avez pas encore saisi, un contrat dont vous devez extraire les dates clés — et de le faire passer par un outil d'OCR agentique sans modifier aucun paramètre. Si l'outil extrait les bons champs dans le bon format du premier coup, sans configuration par document, vous venez de constater la différence agentique. S'il vous demande de dessiner des zones ou de sélectionner un modèle, ce n'est pas agentique.
Pour une démonstration pratique, essayez de téléverser un document ci-dessous. Définissez les colonnes souhaitées — les noms de champs que vous saisiriez normalement dans un tableur — et observez comment le système raisonne sur la structure de votre document, localise chaque valeur et produit des données structurées prêtes à l'emploi.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Questions fréquentes
La ROC agentique est-elle identique à la ROC IA ?
Non. La ROC IA ajoute de la compréhension à la reconnaissance de caractères — elle peut lire un document et identifier qu'un nombre est un total de facture plutôt qu'une simple chaîne de chiffres. La ROC agentique ajoute du raisonnement et de l'action à cette compréhension. Un système de ROC IA lit et étiquette. Un système de ROC agentique lit, étiquette, décide si les données extraites sont cohérentes, signale ce qui ne correspond pas et adapte son approche en cas de faible confiance. La ROC IA est un prérequis à la ROC agentique, mais la ROC agentique ajoute la couche décisionnelle que la ROC IA seule ne fournit pas.
Dois-je former ou configurer la ROC agentique avant de l'utiliser ?
Non — et c'est la caractéristique déterminante de cette catégorie. Les systèmes de ROC agentique sont conçus pour fonctionner dès la première utilisation, sans échantillons d'apprentissage, sans modèles et sans configuration par format. Vous téléchargez un document, définissez les champs de sortie souhaités, et le système raisonne sur la structure du document pour localiser et extraire chaque valeur. Si un outil vous demande de télécharger 10 documents d'exemple pour l'apprentissage ou de dessiner des zones sur un modèle, ce n'est pas de la ROC agentique — c'est un système basé sur des modèles avec des fonctionnalités d'IA.
La ROC agentique peut-elle traiter des documents manuscrits ?
Oui, mais avec les mêmes réserves que pour la ROC IA en général. La ROC agentique traite mieux l'écriture manuscrite que la ROC traditionnelle car le modèle de vision-langage lit les motifs visuels plutôt que de comparer des formes de caractères à une base de données fixe. La couche agentique apporte un avantage spécifique : si le système lit une valeur manuscrite avec une faible confiance, il peut signaler ce champ pour révision plutôt que de produire une valeur incorrecte en silence. Sur des documents structurés mélangeant texte imprimé et manuscrit — comme des bons de livraison ou des formulaires d'inspection — la ROC agentique atteint en pratique une précision de champ de 85 à 93 %.
Quelle est la précision de la ROC agentique par rapport à la ROC traditionnelle ?
Au niveau des caractères, les deux atteignent des taux élevés sur du texte imprimé propre (95-99 %). La différence significative réside dans la précision au niveau des champs et les taux de traitement direct : les systèmes ROC traditionnels et IDP basés sur des modèles atteignent 60-80 % de STP sur les documents pour lesquels ils ont été configurés, avec une forte baisse lors des changements de format. Les systèmes de ROC agentique atteignent 90-95 %+ de STP sur des formats variés, car la couche d'autocorrection détecte les erreurs qui nécessiteraient autrement une révision manuelle. Le résultat pratique est que la ROC agentique nécessite nettement moins d'intervention humaine par lot de documents, surtout lorsque les documents proviennent de sources multiples.
L'OCR agentique est-il disponible aujourd'hui ou s'agit-il encore d'un concept de recherche ?
Il est disponible aujourd'hui, bien que le terme soit encore en cours d'adoption dans l'industrie. De nombreux outils de traitement de documents lancés sous le nom d'« OCR IA » ou d'« extraction de documents par IA » incluent déjà des capacités agentiques — autocorrection, raisonnement sémantique, extraction sans modèle — sans utiliser l'étiquette. Si un outil lit n'importe quelle mise en page de document sans configuration préalable, valide les données extraites par rapport à des règles métier et signale les champs à faible confiance pour révision, il fonctionne comme un système OCR agentique, qu'il utilise ou non le terme. L'étiquette rattrape les capacités qui existent déjà en production.