Was ist Agentic OCR?
Die Evolution des Dokumentenlesens 2026
Agentic OCR – agentische optische Zeichenerkennung – ist eine Dokumentlesetechnologie, die Vision-Language-Modelle nutzt, um nicht nur Text zu erkennen, sondern auch die Dokumentstruktur zu analysieren, zu entscheiden, welche Informationen wichtig sind, und diese als strukturierte Daten auszugeben – ganz ohne Vorlagen, Training oder formatspezifische Einrichtung. Der Begriff hielt Anfang 2025 Einzug in den Mainstream, als Andrew Ng die agentische Dokumentextraktion als nächste Grenze jenseits der traditionellen OCR vorstellte. Bis Mitte 2026 ist er zu einem schnell wachsenden Suchbegriff geworden – nicht weil die Technologie brandneu ist, sondern weil die Bezeichnung endlich etwas benennt, das stillschweigend verändert hat, wie Maschinen Dokumente lesen.
Wichtigste Erkenntnisse
- Sie verbringen Stunden damit, extrahierte Daten zu sortieren, nachdem das Tool sagt, es sei fertig, und gehen davon aus, dass Sie einfach eine bessere OCR benötigen.
- 60–80 % Straight-Through-Processing ist keine schlechte Konfiguration – es ist die Obergrenze von Tools, die Zeichen lesen, aber nie entscheiden, was sie bedeuten.
- Ihre Rolle verschiebt sich vom Korrekturlesen jeder extrahierten Zelle hin zur Prüfung nur der Ausnahmen, die das System als wirklich unsicher markiert hat.
Warum Agentic OCR jetzt wichtig ist
Alle paar Jahre taucht ein Begriff auf, der das, was zuvor als „gut genug" galt, als „veraltet" einstuft. Agentic OCR ist dieser Begriff für das Dokumentlesen im Jahr 2026.
Um zu verstehen, warum der Wandel jetzt stattfindet, hilft es, die Entwicklung zu betrachten. Traditionelle OCR entstand in den 1970er-Jahren und löste ein Problem: die Umwandlung von gedrucktem Text in digitale Zeichen. KI-OCR, das in den 2020er-Jahren mit Vision-Language-Modellen aufkam, löste ein zweites: zu verstehen, was diese Zeichen bedeuten. Beides ist essenziell und weit verbreitet. Doch beide teilen eine grundlegende Einschränkung: Sie enden beim Verstehen. Keiner von beiden geht den nächsten Schritt — zu entscheiden, was mit dem Gelesenen geschehen soll, und diese Entscheidung umzusetzen.
Dieser nächste Schritt ist es, den „agentic" hinzufügt. Ein agentisches System wartet nicht darauf, dass ein Mensch ihm sagt: „Setze die Rechnungsnummer hierher und die Summe dorthin." Es entscheidet selbst. Es leitet die richtigen Daten an das richtige Ausgabefeld weiter. Es erkennt Inkonsistenzen und markiert sie. Es lernt aus Korrekturen, ohne einen erneuten Trainingszyklus zu benötigen.
Diese Unterscheidung ist jetzt wichtig, weil die Menge der Dokumente, die Unternehmen verarbeiten, den manuellen Sortierschritt überholt hat, den traditionelle und sogar KI-OCR weiterhin hinterlassen. Die Verarbeitung von 50 Rechnungen von 50 Lieferanten ist kein Problem mit 50 Dokumenten mehr — es ist ein Problem mit 50 Formaten. Agentic OCR reduziert das auf einen einzigen Durchgang, indem es jedes Dokument als etwas behandelt, über das das System nachdenken kann, statt es nur zu lesen.
Die Daten stützen dieses Muster. In Unternehmensbereitstellungen erreichen traditionelle OCR- und vorlagenbasierte IDP-Systeme 60-80 % Straight-Through-Processing-Raten bei Dokumenten, für die sie konfiguriert wurden. Agentic-OCR-Systeme erreichen durchgängig 90-95 %+, weil die Selbstkorrekturschleife Randfälle abfängt, die andernfalls eine manuelle Prüfung erfordern würden. Eine detaillierte Aufschlüsselung, wie sich Agentic OCR von der traditionellen Zeichenerkennung unterscheidet, finden Sie in unserem Leitfaden zu was OCR ist und wie es funktioniert.
Agentic OCR ersetzt weder OCR noch KI-OCR — es erweitert sie. OCR beantwortet die Frage: „Welche Zeichen sind auf dieser Seite?" KI-OCR beantwortet: „Welche Daten enthält dieses Dokument?" Agentic OCR beantwortet: „Was sollte mit diesen Daten geschehen, und stimmen sie?"
Was sich tatsächlich geändert hat – vom Lesen zum Denken
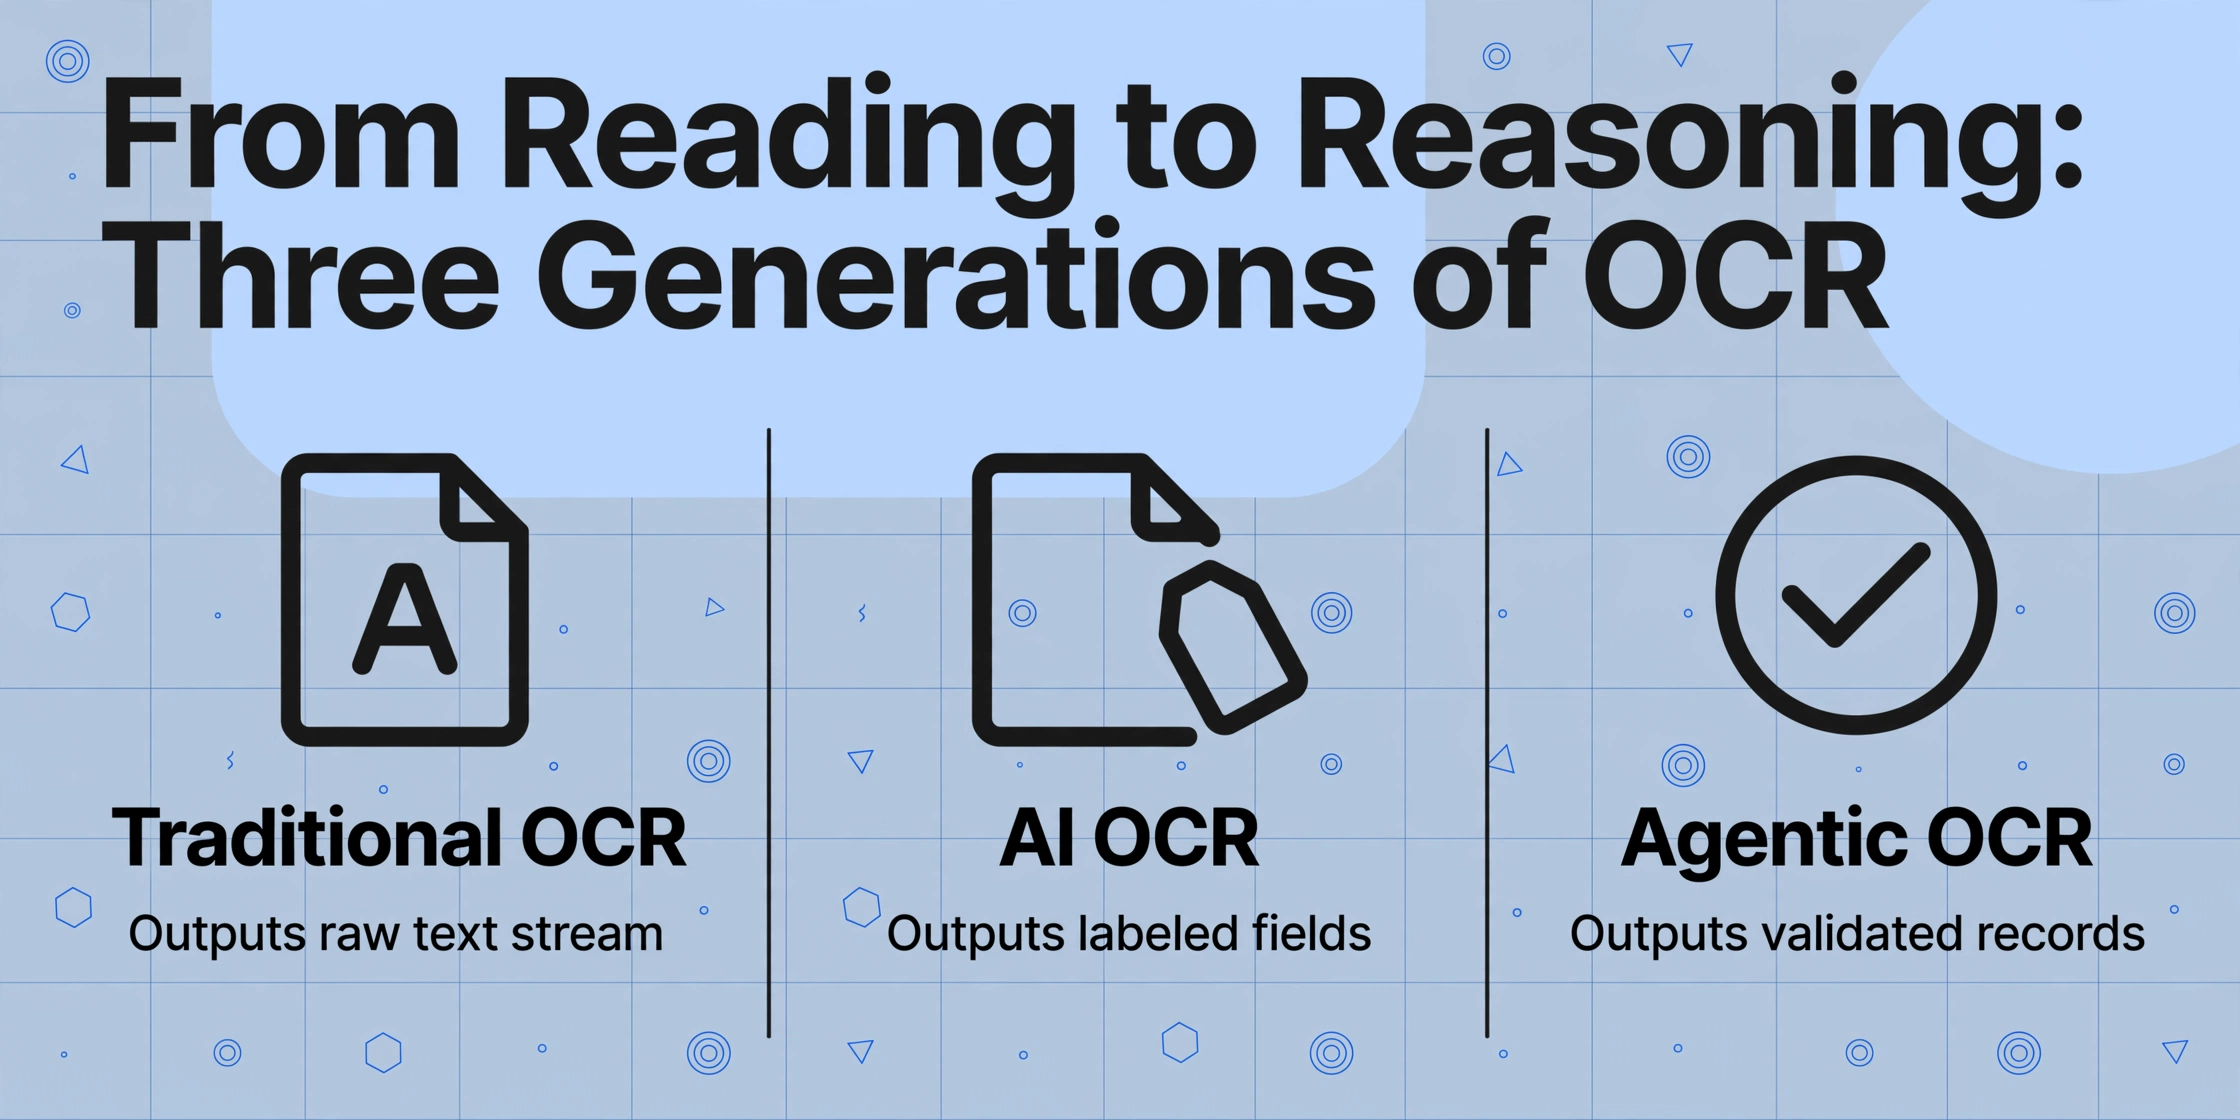
Die Veränderung liegt nicht in der Lesefähigkeit. Sie liegt darin, was nach dem Lesen geschieht.
Um den Unterschied zu erkennen, betrachten Sie, wie ein einzelnes Dokumentelement – die Zeichenfolge „INV-2026-0842“ – jede Technologiegeneration durchläuft:
Traditionelle OCR liest die Seite und gibt INV-2026-0842 irgendwo in einem laufenden Textstrom aus. Ein Mensch muss es finden, als Rechnungsnummer erkennen und in die richtige Zelle kopieren. Die OCR-Engine kann es nicht von der Postleitzahl oder der Kundennummer unterscheiden, die zufällig dasselbe Format haben. Dies wird ausführlich in unserer Schritt-für-Schritt-Anleitung zur Funktionsweise von OCR behandelt.
KI-OCR liest dieselbe Seite und gibt aus: Rechnungsnummer: INV-2026-0842. Sie versteht die Beziehung zwischen Beschriftung und Wert und ordnet Text dem richtigen semantischen Feld zu. Der Sortierschritt ist teilweise automatisiert. Aber KI-OCR hängt weiterhin von den eigenen Beschriftungen und der Struktur des Dokuments ab. Wenn die Rechnungsnummer an einer ungewöhnlichen Stelle erscheint – eingebettet in eine Kopfzeilengrafik oder handschriftlich neben einer anderen Beschriftung – kann KI-OCR sie übersehen, weil die erwarteten semantischen Hinweise fehlen. Wir haben dies ausführlich in unserem Artikel darüber behandelt, was KI-OCR ist und wie es sich von traditioneller OCR unterscheidet.
Agentic OCR liest die Seite und gibt einen strukturierten Datensatz aus: { "document_type": "invoice", "invoice_number": "INV-2026-0842", "vendor": "Acme Supply", "total": 1247.50, "confidence": 0.97 } – aber erst nachdem Alternativen durchdacht wurden. Ist diese Zeichenfolge wahrscheinlich eine Rechnungsnummer? Folgt sie bekannten Mustern? Bei geringer Konfidenz rät sie nicht – sie markiert das Feld zur Überprüfung oder versucht einen zweiten Durchlauf. Der „agentische“ Teil ist die Schleife: lesen, entscheiden, validieren, korrigieren.
Diese Denkschicht unterscheidet Agentic OCR von jeder zuvor entwickelten Dokumentlesetechnologie. Traditionelle OCR liest und stoppt. KI-OCR liest und versteht. Agentic OCR liest, versteht, entscheidet, validiert und passt sich an. Es ist kein schnelleres Förderband – es ist ein völlig anderer Prozess.
So funktioniert Agentic OCR im Detail
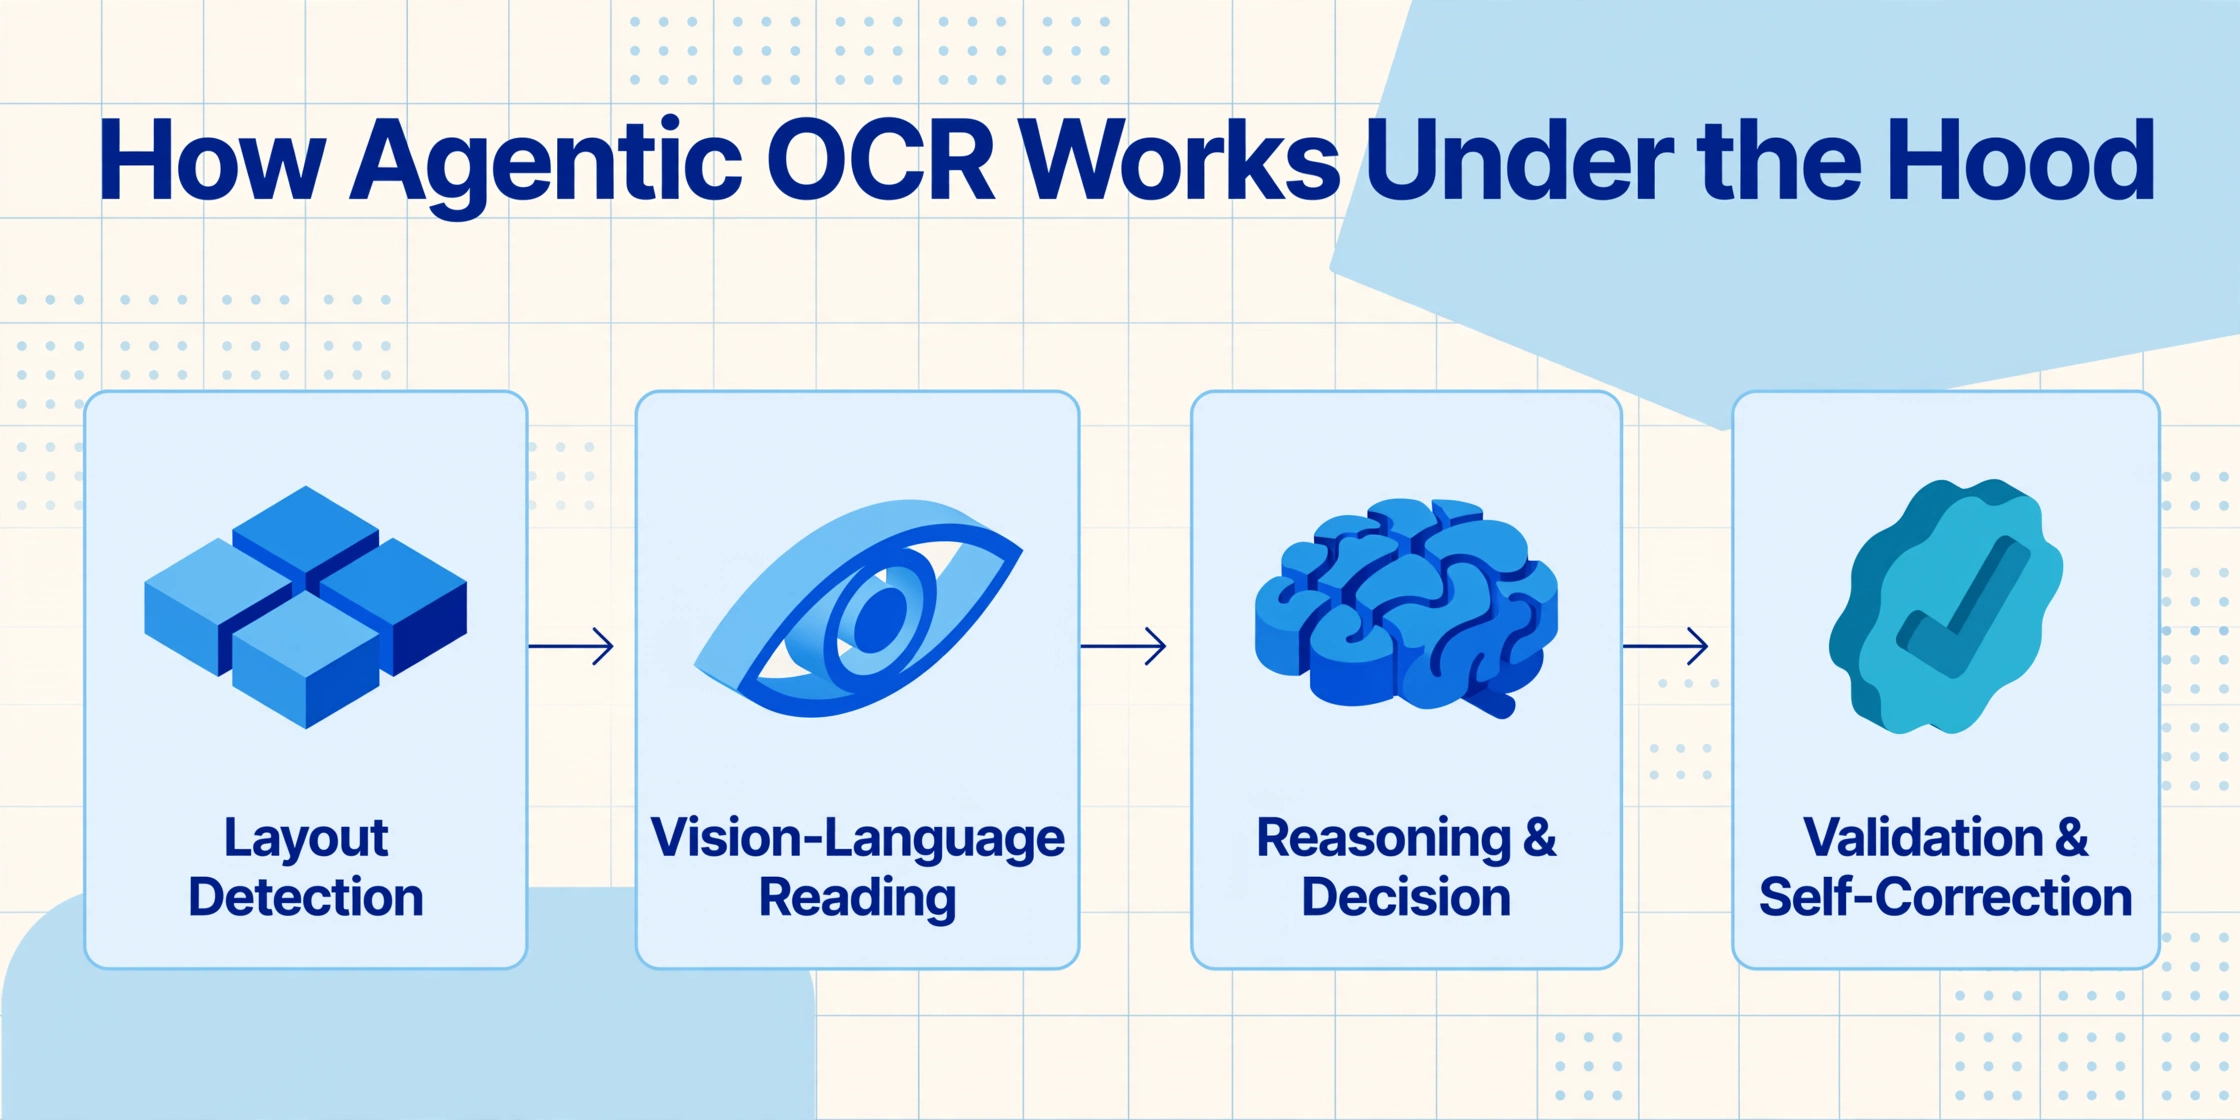
Agentic OCR ist kein einzelnes Modell oder Algorithmus. Es ist eine orchestrierte Pipeline spezialisierter Komponenten, die wie ein Team aus Dokumentexperten zusammenarbeiten.
Während die genaue Architektur zwischen den Implementierungen variiert, folgt das Kerndesign vier funktionalen Ebenen:
Layout-Erkennung
Das System scannt die Seite und identifiziert strukturelle Bereiche: Kopfzeilen, Tabellenbereiche, Signaturblöcke, Fußzeilen. Dies ist räumliches Denken – das Modell lernt, wie eine „Tabelle" im Vergleich zu einem „Absatz" aussieht, unabhängig vom Inhalt. Diese Ebene beantwortet die Frage „Wo bin ich auf dieser Seite und welche Art von Inhalt befindet sich hier?"
Vision-Language-Lesen
Ein Vision-Language-Modell liest jede Region kontextbewusst. Im Gegensatz zur zeichenweisen OCR verarbeitet das VLM ganze visuelle Blöcke gleichzeitig. Es erkennt, dass eine fette Zahl in einer Zelle unten rechts „Summe" bedeutet, selbst wenn keine explizite Beschriftung in der Nähe ist. Es bewahrt die Lesereihenfolge über mehrspaltige Layouts und zusammengeführte Tabellenzellen hinweg – die strukturellen Beziehungen, die herkömmliche OCR verwirft.
Reasoning & Entscheidung
Dies ist der agentische Kern. Das System bewertet, was es gelesen hat, und entscheidet: Welche extrahierten Werte werden welchen Ausgabefeldern zugeordnet? Stimmt die extrahierte „Summe" mit der Summe der Positionszeilen überein? Wenn ein Wert mehrdeutig ist – eine Zahl, die eine Bestellnummer oder eine Kundennummer sein könnte – wendet das System Kontext aus Dokumenttyp und Feldmustern an, um ihn vor der Ausgabe aufzulösen.
Validierung & Selbstkorrektur
Extrahierte Daten werden gegen bekannte Muster, Feldbeziehungen und Geschäftsregeln geprüft. Eine Summe, die nicht mit der Summe der Positionszeilen übereinstimmt, wird markiert. Eine Rechnungsnummer außerhalb des erwarteten Formats löst einen zweiten Lesedurchgang aus. Das System geht nicht davon aus, dass seine erste Antwort korrekt ist – es verifiziert und gibt nur aus, wenn Konfidenzschwellen erreicht sind. Feldbezogene Konfidenzwerte ermöglichen es Prüfern, sich auf unsichere Fälle zu konzentrieren, anstatt jedes Feld erneut zu prüfen.
Man kann es sich wie den Unterschied zwischen einem Fotokopierer und einem geschulten Buchhalter vorstellen. Der Fotokopierer (traditionelle OCR) erzeugt eine exakte Kopie jedes Zeichens. Der Buchhalter (Agentic OCR) liest das Dokument, erkennt, dass es sich um eine Rechnung handelt, prüft die Mathematik, trägt die Daten in die richtigen Konten ein und zeichnet Positionen ab, die ungewöhnlich wirken. Der Fotokopierer ist pro Seite schneller. Der Buchhalter liefert Arbeit, die sofort verwendbar ist.
Wie verschiedene Rollen Agentic OCR nutzen
Der Wert von Agentic OCR ist nicht abstrakt – er zeigt sich je nach Anwender und Ziel unterschiedlich.
Buchhalter und Buchprüfer
Sie erhalten Rechnungen von über 30 Lieferanten – einige als E-Mail-PDFs, andere als Fotos von Außendienstmitarbeitern. Jeder Lieferant verwendet ein anderes Layout, und mehrere ändern ihr Format ohne Vorankündigung. Mit vorlagenbasierter OCR bedeutet jede Layoutänderung, dass eine Vorlage neu erstellt werden muss. Mit Agentic OCR legen Sie alle 30 in einem Batch ab, definieren die benötigten Ausgabespalten – Rechnungsnummer, Datum, Lieferant, Gesamtbetrag – und erhalten eine einzige strukturierte Tabelle. Das System verarbeitet Layoutabweichungen automatisch, weil es nach Bedeutung statt nach Position liest. Wenn eine Summe im Verhältnis zu den Positionen falsch erscheint, markiert es die Zeile, statt fehlerhafte Daten in Ihre Buchhaltung zu übernehmen.
Kleinunternehmer
Sie fotografieren Belege mit Ihrem Telefon und erhalten gelegentlich handschriftliche Lieferscheine. Ihr Bedarf ist klar: Daten ohne Abtippen in eine Tabellenkalkulation bringen. Agentic OCR bewältigt das Format-Chaos – zerknitterte Belege, Blendung, schräge Aufnahmen, gemischte Handschrift – weil die Reasoning-Ebene die Lesestrategie pro Dokument anpasst. Ein zerknitterter Beleg löst einen anderen Vorverarbeitungsschritt aus als ein sauberer Scan; das System entscheidet, welche Strategie verwendet wird, und validiert die Ausgabe, ohne dass Sie eingreifen müssen.
Entwickler, die Dokument-Pipelines erstellen
Sie integrieren Dokumentenverarbeitung in eine kundenspezifische Anwendung – ein Spesenverwaltungssystem, ein Lieferanten-Onboarding-Portal. Traditionelle OCR zwingt Sie, jeden Randfall zu behandeln: Layoutvarianten, fehlende Felder, Formatabweichungen. Jede Variante fügt Code hinzu. Agentic OCR reduziert diese Komplexität, weil die Extraktionsebene die Abweichungen übernimmt. Sie definieren das Ausgabeschema; das System findet heraus, wie es befüllt wird. Selbstkorrektur reduziert die Ausnahmebehandlungslogik, die Sie pflegen müssen. Für einen Überblick über die breitere Technologiekategorie siehe unseren Leitfaden zu KI-Dokumentenextraktion und wie sie funktioniert.
Wichtige Funktionen, auf die Sie achten sollten
Nicht jedes Tool, das „agentische“ Funktionen beansprucht, fügt der Pipeline tatsächlich Reasoning und Selbstkorrektur hinzu. Hier zeigt sich, was echte Agentic OCR von Tools unterscheidet, die lediglich KI-OCR mit einem neuen Etikett sind.
Erstens ist die Extraktion ohne Vorlage die Grundvoraussetzung. Wenn ein Tool verlangt, dass Sie Zonen definieren, Boxen zeichnen oder für jedes Dokumentformat Vorlagen erstellen, ist es nicht agentisch – es ist vorlagenbasierte OCR mit einer modernen Oberfläche. Agentic OCR entscheidet anhand dessen, was es sieht, wie es an jedes Dokument herangeht – nicht anhand einer vorkonfigurierten Feldzuordnung. Dies ist der zuverlässigste Indikator dafür, ob sich die zugrunde liegende Technologie tatsächlich geändert hat.
Zweitens: semantische Feldzuordnung mit Kontext. Ein echtes agentisches System extrahiert nicht nur Text und hofft, dass die Beschriftungen übereinstimmen. Es bewertet die Beziehungen zwischen Feldern. Wenn es eine Positionstabelle extrahiert, prüft es, ob die Positionen in der Summe der Zwischensumme entsprechen. Bei widersprüchlichen Werten rät es nicht – es kennzeichnet, liest erneut oder wendet Geschäftsregeln an. Das Ergebnis sind keine rohen extrahierten Daten, sondern validierte Ausgaben mit Konfidenzindikatoren, auf die Sie sich stützen können.
Drittens: Selbstkorrektur ohne erneutes Training. Traditionelle ML-Systeme verbessern sich durch erneutes Training. Agentische Systeme verbessern sich im laufenden Betrieb – wenn ein Mensch eine gekennzeichnete Extraktion korrigiert, fließt diese Korrektur in die Reasoning-Ebene für ähnliche Dokumente ein. Dies unterscheidet sich grundlegend vom Ansatz „Mindeststichprobe von 10“, den einige Tools immer noch verlangen.
Viertens: Batch-Verarbeitung, die die Datenintegrität wahrt. Der wahre Test eines Agentic-OCR-Systems ist nicht, wie es ein perfektes PDF verarbeitet, sondern wie es 50 unübersichtliche Dokumente unterschiedlicher Typen in einem einzigen Batch verarbeitet. Halten die Beziehungen zwischen den Feldern über alle 50 hinweg? Sind die Konfidenzwerte konsistent? Kennzeichnet das System die Ausreißerdokumente, anstatt stillschweigend fehlerhafte Daten auszugeben? Der Batch ist der Ort, an dem Agentik am wichtigsten ist, denn dort arbeitet das System ohne menschliche Aufsicht pro Dokument.
ImageToTable.ai setzt diese Funktionen über seinen Ansatz der Benutzerdefinierten Spaltenextraktion um: Sie benennen die gewünschten Spalten, und die KI lokalisiert und extrahiert passende Daten aus jedem Dokument, indem sie versteht, was jedes Feld bedeutet – nicht, wo es auf der Seite steht. Dieselbe Technologie ist über unser KI-OCR-Softwaretool für die Verarbeitung von Dokumenten in großem Umfang verfügbar.
Erste Schritte mit agentischem Dokumentlesen
Einer der Vorteile von Agentic OCR gegenüber früheren Technologien ist, dass Sie vor dem Ausprobieren nichts konfigurieren müssen. Keine Vorlagen zu erstellen, keine Trainingsbeispiele zu beschriften, keine Zonen zu definieren. Das System passt sich jedem Dokument an, das Sie ihm geben.
Der einfachste Weg, den Unterschied zu erleben, besteht darin, ein Dokument zu nehmen, das Sie derzeit manuell verarbeiten — eine Rechnung von einem neuen Lieferanten, eine Quittung, die Sie noch nicht erfasst haben, einen Vertrag, aus dem Sie wichtige Daten extrahieren müssen — und es ohne Änderung der Einstellungen durch ein Agentic-OCR-Tool laufen zu lassen. Wenn das Tool die richtigen Felder im richtigen Format beim ersten Versuch ohne dokumentenspezifische Einrichtung extrahiert, haben Sie gerade den Agentic-Unterschied erlebt. Wenn es Sie auffordert, Felder zu markieren oder eine Vorlage auszuwählen, ist es nicht agentisch.
Für eine praktische Demonstration laden Sie einfach ein Dokument unten hoch. Definieren Sie die Spalten, die Sie möchten — die Feldnamen, die Sie normalerweise in eine Tabellenkalkulation eingeben würden — und sehen Sie, wie das System Ihre Dokumentstruktur analysiert, jeden Wert lokalisiert und strukturierte, gebrauchsfertige Daten ausgibt.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Ist agentische OCR dasselbe wie KI-OCR?
Nein. KI-OCR fügt der Zeichenerkennung Verständnis hinzu – es kann ein Dokument lesen und erkennen, dass eine Zahl der Rechnungsbetrag ist und nicht nur eine Ziffernfolge. Agentische OCR fügt diesem Verständnis Logik und Handlung hinzu. Ein KI-OCR-System liest und beschriftet. Ein agentisches OCR-System liest, beschriftet, entscheidet, ob die extrahierten Daten konsistent sind, markiert Unstimmigkeiten und passt seine Vorgehensweise bei geringer Konfidenz an. KI-OCR ist eine Voraussetzung für agentische OCR, aber agentische OCR fügt die Entscheidungsebene hinzu, die KI-OCR allein nicht bietet.
Muss ich agentische OCR vor der Nutzung trainieren oder konfigurieren?
Nein – und das ist das entscheidende Merkmal dieser Kategorie. Agentische OCR-Systeme sind so konzipiert, dass sie ohne Trainingsbeispiele, Vorlagen oder formatspezifische Konfiguration sofort einsatzbereit sind. Sie laden ein Dokument hoch, definieren die gewünschten Ausgabefelder, und das System analysiert die Dokumentstruktur, um jeden Wert zu lokalisieren und zu extrahieren. Wenn ein Tool Sie auffordert, 10 Beispieldokumente zum Training hochzuladen oder Zonen auf einer Vorlage zu zeichnen, handelt es sich nicht um agentische OCR – sondern um ein vorlagenbasiertes System mit KI-Funktionen.
Kann agentische OCR handschriftliche Dokumente verarbeiten?
Ja, jedoch mit denselben Einschränkungen wie bei KI-OCR allgemein. Agentische OCR verarbeitet Handschrift besser als herkömmliche OCR, da das Vision-Language-Modell visuelle Muster liest, anstatt Zeichenformen mit einer festen Datenbank abzugleichen. Die agentische Ebene bietet einen spezifischen Vorteil: Liest das System einen handschriftlichen Wert mit geringer Konfidenz, kann es dieses Feld zur Überprüfung markieren, anstatt stillschweigend einen falschen Wert auszugeben. Bei strukturierten Dokumenten mit gemischtem Druck und Handschrift – wie Lieferscheinen oder Prüfprotokollen – erreicht agentische OCR in der Praxis eine Feldgenauigkeit von 85-93%.
Wie genau ist agentische OCR im Vergleich zu herkömmlicher OCR?
Auf Zeichenebene erzielen beide hohe Raten bei sauberen gedruckten Texten (95-99%). Der wesentliche Unterschied liegt in der Feldgenauigkeit und der Durchlaufrate (Straight-Through Processing, STP): Herkömmliche OCR und vorlagenbasierte IDP-Systeme erreichen 60-80% STP bei Dokumenten, für die sie konfiguriert wurden, mit starkem Abfall bei Formatwechseln. Agentische OCR-Systeme erreichen 90-95%+ STP über verschiedene Formate hinweg, da die Selbstkorrekturschicht Fehler abfängt, die sonst manuelle Prüfung erfordern würden. Praktisch bedeutet dies, dass agentische OCR deutlich weniger manuelle Eingriffe pro Dokumentenstapel benötigt, insbesondere wenn Dokumente aus mehreren Quellen stammen.
Ist agentische OCR heute verfügbar oder noch ein Forschungskonzept?
Sie ist heute verfügbar, auch wenn der Begriff in der Branche noch nicht vollständig etabliert ist. Viele Dokumentenverarbeitungstools, die als „KI-OCR“ oder „KI-Dokumentenextraktion“ gestartet sind, verfügen bereits über agentische Fähigkeiten – Selbstkorrektur, semantisches Verständnis, vorlagenfreie Extraktion – ohne diese Bezeichnung zu verwenden. Wenn ein Tool jedes Dokumentenlayout ohne formatspezifische Einrichtung liest, extrahierte Daten anhand von Geschäftsregeln validiert und Felder mit geringer Konfidenz zur Überprüfung kennzeichnet, funktioniert es als agentisches OCR-System – unabhängig von der verwendeten Bezeichnung. Der Begriff holt lediglich Fähigkeiten ein, die bereits in der Praxis existieren.