Melhores Ferramentas de OCR Open Source 2026:
Tesseract, EasyOCR, PaddleOCR e Além
O OCR open source em 2026 se divide em duas eras distintas: motores de pipeline tradicionais (detectam regiões de texto, reconhecem caracteres um a um e depois reconstroem a página) e modelos de visão-linguagem (um único modelo analisa o documento inteiro e o lê como um humano faria). A maioria dos comparativos trata essas opções como alternativas intercambiáveis. Elas não são. A escolha certa depende dos seus tipos de documento, do seu orçamento de hardware e de você precisar de texto bruto ou de saída estruturada. Este guia cobre sete ferramentas totalmente open source — sem produtos comerciais, sem níveis freemium — com os detalhes de fluxo de trabalho para desenvolvedores que realmente importam quando você está construindo um pipeline, não apenas executando um teste isolado. Se você é novo nos fundamentos, nossos guias sobre o que é OCR, como o OCR com IA difere e como o OCR funciona na prática cobrem o básico antes deste aprofundamento. Divulgação: não tenho afiliação com nenhuma ferramenta desta lista. Cada link externo leva à página do projeto da própria ferramenta ou a um benchmark independente, para que você possa verificar as afirmações antes de se comprometer com uma stack.
Principais Conclusões
- Sete ferramentas de OCR open source atingem entre 95 e 97 por cento de precisão de caracteres em texto em inglês limpo — números quase idênticos que fazem a escolha parecer um cara ou coroa.
- A precisão de caracteres é uma métrica enganosa, porque uma pontuação de 97 por cento em uma tabela de dez colunas colapsada ainda deixa você reconstruindo colunas a partir de células embaralhadas manualmente.
- A divisão real em 2026 não é entre ferramentas, mas entre eras — motores tradicionais que detectam caracteres versus VLMs que leem documentos e geram markdown estruturado com tabelas já intactas.
Tabela de Comparação Rápida
Sete ferramentas, duas eras arquiteturais. A tabela abaixo mostra as principais diferenças. As seções seguintes aprofundam o comportamento real de cada ferramenta — incluindo tempo de configuração, modos de falha e peculiaridades de integração em pipeline que nenhuma tabela de benchmark captura.
| Ferramenta | Arquitetura | Idiomas | GPU Necessária? | Manipulação de Layout | Melhor Para |
|---|---|---|---|---|---|
| Tesseract | LSTM Tradicional | 100+ | Não (apenas CPU) | Fraca — perde tabelas, colunas | Texto impresso limpo, lote em CPU |
| EasyOCR | CRNN Tradicional | 80+ | Opcional (GPU acelera) | Fraca — saída de texto plano | Prototipagem rápida, texto de cena |
| PaddleOCR | Pipeline DL Tradicional | 80+ (forte CJK) | Recomendado para velocidade | Boa — tabelas, colunas, formulários | Produção multilíngue, layouts complexos |
| Surya OCR | VLM (650M parâmetros) | 90+ | Sim (ideal), CPU possível | Excelente — layout + tabela + ordem de leitura | Análise de layout de documento + OCR em um modelo |
| Docling | Conjunto (VLM + layout) | Múltiplos (via backend EasyOCR) | Recomendado | Excelente — estrutura completa do documento | Pipelines RAG, conversão estruturada de documentos |
| olmOCR | VLM (7B parâmetros) | Múltiplos | Sim (GPU NVIDIA) | Excelente — múltiplas colunas, tabelas, equações | Conversão de PDF em larga escala, documentos científicos |
| Qwen2.5-VL | VLM (3B/7B/72B) | Múltiplos (forte CJK) | Sim | Excelente — leitura VLM flexível | OCR baseado em VLM geral, tarefas de extração personalizadas |
Como Avaliamos
Esta não é uma avaliação de laboratório. Números de precisão publicados por terceiros são citados quando disponíveis (comparação da GigaGPU de abril de 2026 para Tesseract/EasyOCR/PaddleOCR; pontuação do Surya no olmOCR-bench; benchmarks publicados do olmOCR), mas os critérios de avaliação principais aqui são os que importam na hora de escolher uma stack:
Quando possível, também cruzamos com nosso próprio benchmark de OCR proprietário — 8 mecanismos open-source rodando na mesma RTX 4090, mesmos recibos (SROIE 2019 + CORD v2), mesmo protocolo congelado, reportando CER/WER, F1 de extração de campos, latência e custo por 1.000 páginas, com cada número rastreável a uma linha publicada em CSV. Dois achados dessa execução influenciam diretamente as escolhas abaixo: em precisão de caracteres, o melhor mecanismo tradicional (docTR, CER 0,197) empata com o melhor VLM (Surya2, 0,191) — então "VLM é inerentemente mais preciso" não se sustenta em texto impresso limpo — e, uma vez adicionado um pós-processador com LLM, seis dos oito mecanismos convergem para uma faixa de F1 de campos entre 0,57 e 0,62, independentemente da família. Veja o benchmark de custo e o benchmark de latência para os números operacionais por mecanismo. Essas são nossas medições em um tipo de documento; os números de terceiros abaixo cobrem uma mistura de entradas mais ampla.
- Superfície de integração — quão limpa é a API Python, ela retorna dados estruturados ou texto bruto, exige código auxiliar
- Requisitos mínimos de hardware — qual hardware você precisa ter antes de a ferramenta funcionar (somente CPU vs GPU obrigatória)
- Inteligência de layout — ela consegue distinguir um cabeçalho de tabela de um número de página, ou apenas emite fluxos de caracteres
- Saúde da comunidade — commits recentes, número de issues abertas, resposta a pull requests, ecossistema estabelecido
- Superfície de treinamento personalizado — você consegue fazer fine-tuning nos seus próprios tipos de documento, e quanta experiência isso exige
Cada link de ferramenta abaixo leva ao repositório oficial no GitHub do projeto. Todas as referências externas estão linkadas para que você mesmo possa verificar as afirmações.
As Duas Eras do OCR de Código Aberto
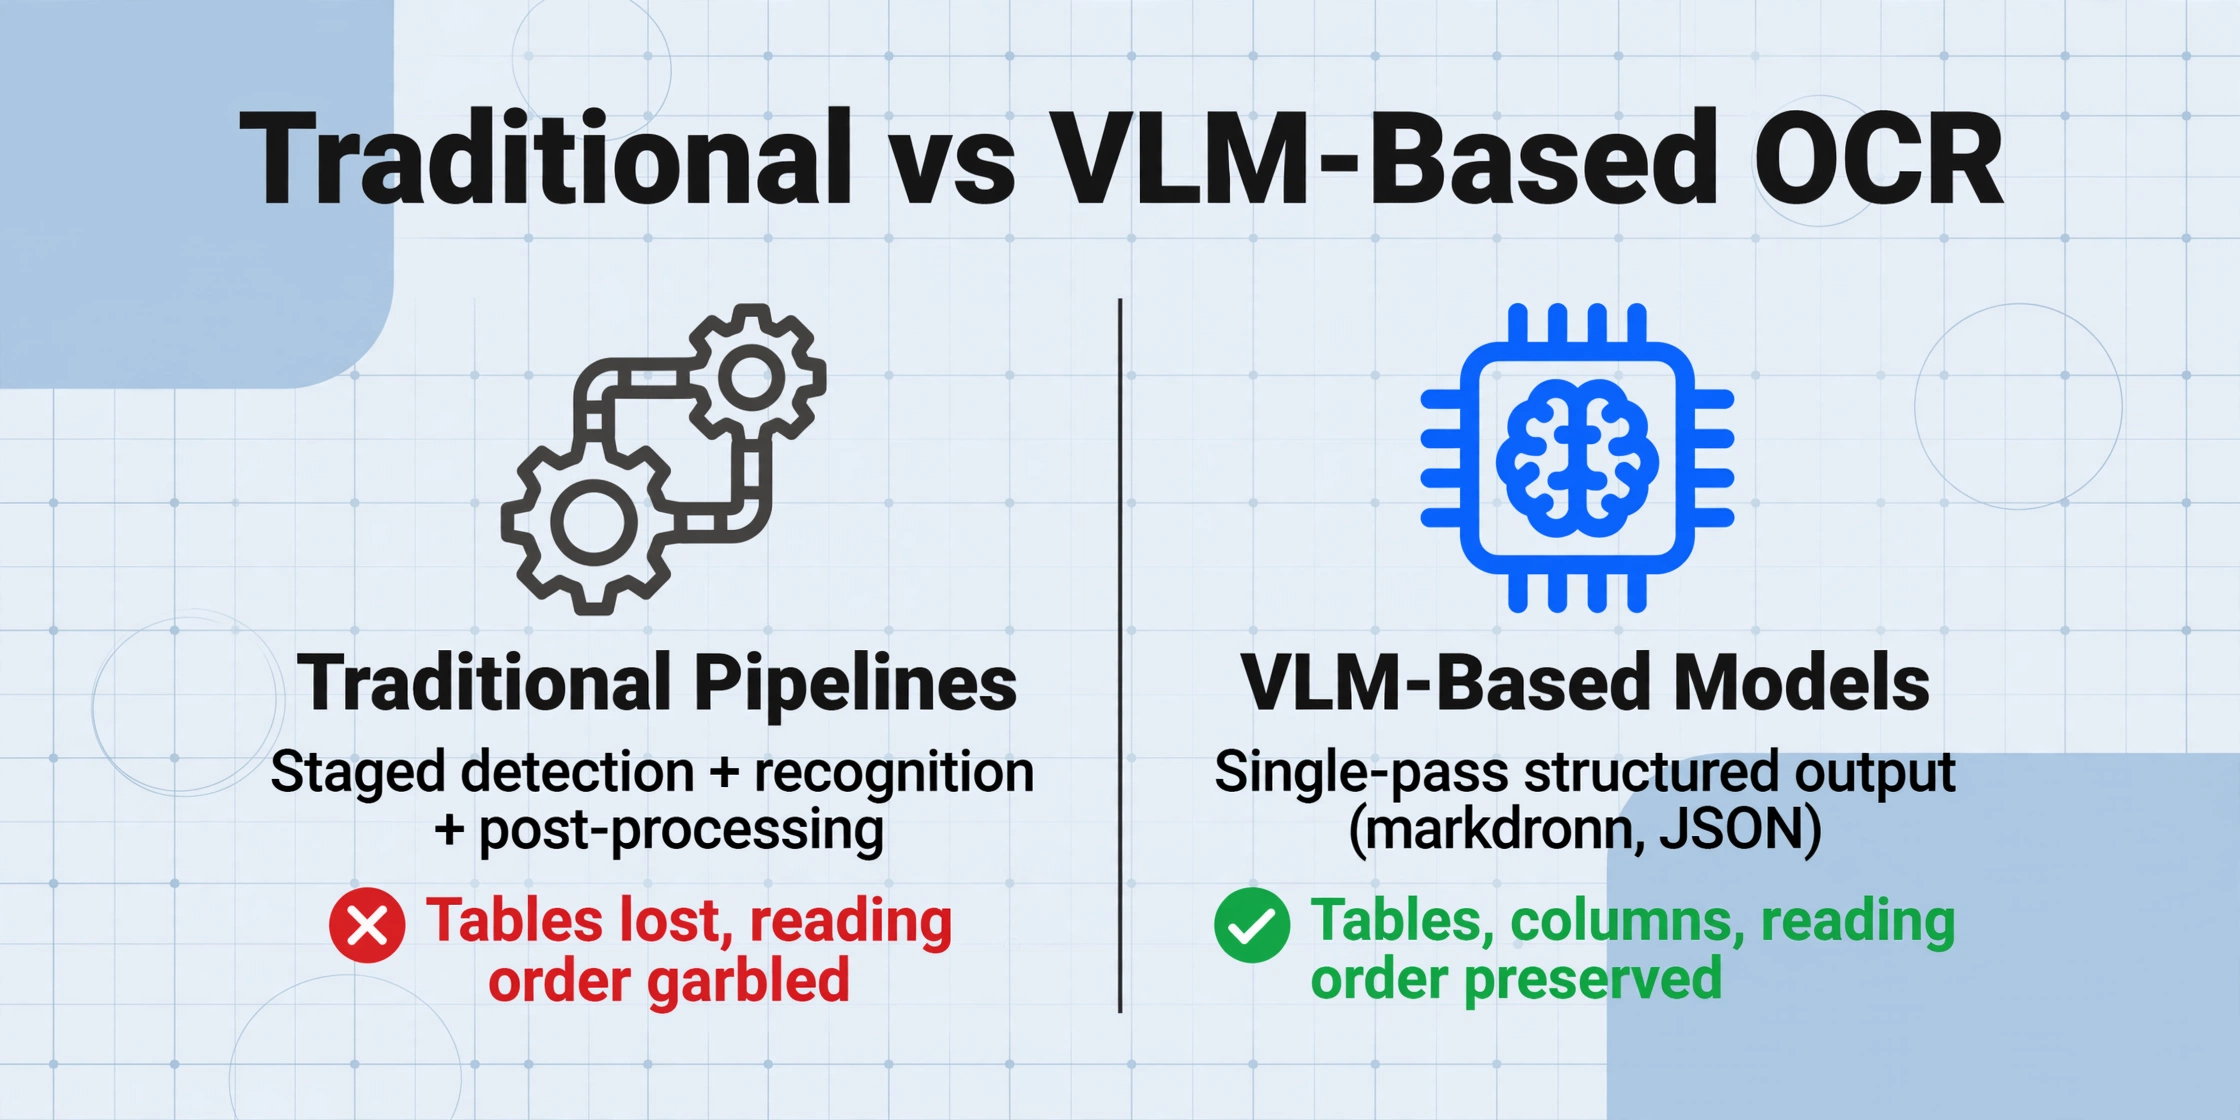
Antes de entrar nas ferramentas individuais, é útil entender a divisão arquitetural que faz de 2026 um ano particularmente interessante para OCR de código aberto.
Pipelines tradicionais de OCR (Tesseract, EasyOCR, PaddleOCR) funcionam em etapas: um modelo de detecção de texto encontra regiões de texto, um modelo de reconhecimento lê cada região caractere por caractere, e uma etapa de pós-processamento tenta reconstruir a estrutura da página. Cada etapa é um modelo ou algoritmo separado, e erros se acumulam — uma detecção perdida significa que o reconhecedor nunca vê aquele texto.
OCR baseado em VLM (Surya, olmOCR, Qwen2.5-VL) trata a leitura de documentos como uma única tarefa multimodal. Um modelo de visão-linguagem olha para a imagem da página inteira e gera saída estruturada — markdown, JSON ou HTML — em uma única passada. O Docling fica no meio: usa pipelines de conjunto construídos sobre modelos especializados, mas oferece uma API unificada que parece baseada em VLM.
A diferença prática: pipelines tradicionais são mais baratos de executar (amigáveis à CPU, modelos pequenos), mas exigem muito código de colagem de pós-processamento para reconstruir tabelas e ordem de leitura. OCR baseado em VLM consome muita GPU, mas entrega saída estruturada diretamente — sem surpresas de "tabela perdida" ou "coluna A mesclada na coluna B". Se você processa texto impresso limpo em volume com layouts simples, mecanismos tradicionais ainda vencem em custo. Se seus documentos têm tabelas, layouts multicoluna ou formatação mista, uma abordagem baseada em VLM vai economizar mais tempo de engenharia do que o custo de GPU.
1. Tesseract OCR — O Trabalhador Incansável de CPU
O Tesseract é o mecanismo de OCR de código aberto mais antigo e testado em batalha desta lista. Originalmente desenvolvido na Hewlett-Packard nos anos 1980 e mantido pelo Google desde 2006, ele suporta mais de 100 idiomas e roda em todos os principais sistemas operacionais. Ele usa uma rede neural baseada em LSTM (desde a versão 4) para reconhecimento de caracteres e um algoritmo tradicional de segmentação de página para análise de layout.
Início Rápido
pip install pytesseract
# Ou via gerenciador de pacotes do sistema: sudo apt install tesseract-ocr

# Uso em Python
import pytesseract
from PIL import Image
text = pytesseract.image_to_string(Image.open("invoice.png"), lang="eng")
print(text)
O ponto forte do Tesseract é sua operação gratuita apenas com CPU e seu ecossistema massivo. Em texto impresso limpo e de alta resolução a 300 DPI, ele entrega aproximadamente 96-97% de precisão de caracteres em benchmarks publicados. Ele processa cerca de 25 páginas por minuto em uma CPU moderna, sem necessidade de GPU — tornando-o a opção mais econômica para digitalização em massa de texto impresso. Novo no mecanismo? Nosso guia passo a passo de configuração do Tesseract aborda a instalação no Windows, Mac e Linux, além das armadilhas para iniciantes (incluindo o problema de PATH no Windows) em cerca de 15 minutos.
As limitações são bem documentadas. O Tesseract não tem conceito nativo de estrutura de documento — ele gera texto plano com quebras de linha que aproximam o layout original. Tabelas são colapsadas em células de texto sequenciais, sem associação de linha/coluna. Documentos com várias colunas produzem ordem de leitura confusa. Em entradas desafiadoras, como fotos de celular, a precisão cai para aproximadamente 84% em testes independentes. O reconhecimento de escrita manual é ruim, com cerca de 45% de precisão — funcionalmente inutilizável para documentos cursivos ou com escrita mista.
Melhor para: processamento em lote apenas com CPU de documentos impressos limpos, onde a saída pode tolerar texto plano — pense em digitalizar páginas de livros, busca em arquivos documentais ou pré-processamento para pipelines de NLP.
Não é ideal para: documentos com tabelas, layouts de várias colunas, escrita manual, fotos de baixa resolução ou qualquer cenário que exija saída estruturada (em nível de campo). Também não é ideal se você quiser uma API — o Tesseract é uma ferramenta de linha de comando com um wrapper Python, não um serviço.
2. EasyOCR — O Caminho Mais Rápido para um Demo Funcional
O EasyOCR, construído sobre PyTorch pela Jaided AI, foi projetado para uma coisa: fazer o OCR funcionar com o mínimo de atrito. Um script Python de quatro linhas processa uma imagem e retorna texto reconhecido com pontuações de confiança por caractere. Ele suporta cerca de 80 idiomas, incluindo alfabetos latino, CJK, árabe e devanágari — uma cobertura mais ampla do que seu tamanho de modelo sugere, porque roteia diferentes alfabetos por cabeçotes de reconhecimento dedicados.
Início rápido
pip install easyocr

# Uso em Python
import easyocr
reader = easyocr.Reader(["en", "fr"])  # especifique os idiomas
results = reader.readtext("receipt.jpg")
for bbox, text, confidence in results:
    print(f"{text} ({confidence:.2f})")
A conveniência do EasyOCR é seu principal recurso e sua principal limitação. Em texto impresso em inglês limpo, benchmarks independentes mostram aproximadamente 95% de precisão de caracteres — ligeiramente abaixo do Tesseract para entradas ideais. Mas o EasyOCR lida significativamente melhor com texto curvo e rotacionado (82% vs. 52% do Tesseract nos benchmarks da GigaGPU), tornando-o mais útil para fotos do mundo real onde o documento não está perfeitamente alinhado.
A compensação de desempenho é real. Na CPU, o EasyOCR é cerca de 2 a 3 vezes mais lento que o Tesseract, a aproximadamente 8 páginas por minuto. Aceleração por GPU (em uma RTX 3090) o leva a aproximadamente 60 páginas por minuto — um ganho de 7,5x. As dependências do modelo também são mais pesadas, cerca de 500 MB contra ~10 MB do Tesseract. Ele lida com escrita manual com aproximadamente 62% de precisão — melhor que o Tesseract, mas ainda não utilizável em produção para a maioria dos fluxos de trabalho com documentos manuscritos.
A comunidade do Reddit r/LocalLLaMA discute com frequência o EasyOCR como o "macarrão instantâneo do OCR" — resultados rápidos com esforço mínimo, mas não a ferramenta que você procura quando precisão ou throughput importam mais. Suas falhas tendem a ser previsíveis (substituições de caracteres para glifos de aparência semelhante) em vez do ruído irrecuperável que o Tesseract produz, o que significa que o pós-processamento baseado em regex pode salvar muitos resultados.
Melhor para: desenvolvedores Python que precisam de um protótipo de OCR funcionando em menos de cinco minutos, especialmente para texto de cena multilíngue ou texto curvo/rotacionado em fotos do mundo real.
Não é ideal para: processamento em lote de alto volume em hardware somente com CPU, layouts de documentos complexos (tabelas, formulários, múltiplas colunas) ou implantações em produção que exigem extração estruturada de campos.
Se você está escolhendo especificamente entre Tesseract e EasyOCR, nosso Tesseract vs EasyOCR frente a frente aprofunda as diferenças que importam em um pipeline real — recuperação de erros, precisão por tipo de documento e peso de instalação.
3. PaddleOCR — OCR Multilíngue de Nível de Produção
Desenvolvido pela Baidu sob o framework PaddlePaddle, o PaddleOCR é o mecanismo de pipeline tradicional mais completo desta lista. Diferente do Tesseract e EasyOCR, que focam exclusivamente no reconhecimento de texto, o PaddleOCR oferece detecção de texto, reconhecimento, extração de tabelas, análise de layout (PP-Structure) e saída estruturada em um único código-fonte. Acumulou mais de 76.000 estrelas no GitHub e é o concorrente open-source mais próximo do Tesseract em maturidade de ecossistema.
Início Rápido
pip install paddlepaddle paddleocr

# Uso em Python
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_angle_cls=True, lang="en")
resultado = ocr.ocr("invoice.png")
for linha in resultado[0]:
    print(f"{linha[1][0]} (confiança: {linha[1][1]:.2f})")
O PaddleOCR lidera todas as categorias de precisão em benchmarks publicados entre mecanismos tradicionais: 97,2% em inglês impresso limpo, 91,5% em documentos digitalizados ruidosos, 88,7% em texto curvo/rotacionado e 72,8% em escrita à mão. Seu suporte a CJK é particularmente forte — esperado dada sua origem chinesa — o que o torna a escolha padrão para equipes que processam documentos mistos inglês-chinês ou qualquer fluxo de trabalho envolvendo scripts do Leste Asiático.
As atualizações mais recentes em 2026 foram significativas. O PP-OCRv6 foi lançado em maio de 2026, melhorando ainda mais a precisão e a velocidade. O modelo PaddleOCR-VL-1.5 (janeiro de 2026) introduz capacidades de visão-linguagem que elevam a precisão para 94,5% no benchmark OmniDocBench v1.5 — preenchendo a lacuna entre pipelines tradicionais e abordagens baseadas em VLM. O desempenho é impressionante: em uma RTX 3090, o PaddleOCR processa cerca de 120 páginas por minuto, comparado às 25 páginas por minuto limitadas pela CPU do Tesseract.
Melhor para: Pipelines de OCR multilíngue de produção, especialmente aqueles que envolvem scripts CJK, layouts complexos com tabelas ou documentos digitalizados ruidosos. A extração de tabelas via PP-Structure é genuinamente útil e não está disponível em nenhum outro mecanismo open-source tradicional.
Não ideal para: OCR rápido e pontual (a configuração de dependências é complexa), implantações apenas em CPU (o desempenho cai significativamente) ou equipes que desejam evitar a dependência do framework PaddlePaddle — é um bloqueio de framework substancial em comparação com alternativas mais portáteis baseadas em PyTorch.
4. Surya OCR — Inteligência de Layout de Documentos em Menos de 1 Bilhão de Parâmetros
O Surya OCR, desenvolvido pela Datalab, é um dos lançamentos open-source mais impressionantes de 2025-2026. Com apenas 650 milhões de parâmetros, ele alcança 83,3% no benchmark olmOCR-bench — o melhor resultado para qualquer modelo com menos de 3 bilhões de parâmetros. Ele combina OCR, análise de layout, detecção de ordem de leitura e reconhecimento de tabelas em um único modelo. Os pesos do modelo estão disponíveis sob a licença OpenRAIL-M (gratuito para pesquisa, uso pessoal e startups com financiamento inferior a US$ 5 milhões), e o código é licenciado sob Apache 2.0.
Início Rápido
pip install surya-ocr

# Uso em Python
from surya import OCR
from PIL import Image
ocr = OCR()
result = ocr.recognize([Image.open("invoice.png")])
for text_line in result[0].text_lines:
    print(text_line.text)
O que torna o Surya arquiteturalmente interessante é sua abordagem unificada. Diferente de pipelines tradicionais que encadeiam detecção → reconhecimento → análise de layout como modelos separados, o Surya usa um modelo de linguagem visual como backend de inferência (servido por vLLM em GPU ou llama.cpp em CPU/Apple Silicon). Isso lhe confere uma compreensão estrutural que mecanismos tradicionais não possuem. O SuryaInferenceManager inicia automaticamente o backend correto, e a API retorna JSON ricamente anotado com caixas delimitadoras, pontuações de confiança e rótulos de região semântica (cabeçalhos, tabelas, imagens, blocos de texto).
O desempenho é competitivo: o Surya processa aproximadamente 5 páginas por segundo em uma RTX 5090 (42 páginas/min para cargas de trabalho típicas) e pode rodar em Apple Silicon via Metal a cerca de 0,1 páginas por segundo — utilizável para documentos ocasionais, mas não para processamento em lote. Ele suporta 91 idiomas, incluindo boa cobertura de scripts asiáticos. A principal limitação é que o Surya foi projetado para documentos, não para fotos gerais — ele tem dificuldades com imagens que não são de documentos e pode ignorar regiões semelhantes a anúncios que seu modelo de detecção foi treinado para pular.
Melhor para: Equipes que precisam de análise de layout de documentos e OCR em um único modelo, sem a complexidade de pipelines de múltiplos estágios. A saída com consciência de layout (JSON com caixas delimitadoras, tipos de região e ordem de leitura) a torna ideal para fluxos de trabalho de inteligência documental downstream.
Não é ideal para: OCR de fotos gerais (é especializado em documentos), ambientes com pouca GPU (desempenho em CPU é significativamente mais lento) ou cenários que exigem licenciamento comercial permissivo dos pesos do modelo.
5. Docling — Conversão de Documentos para Pipelines RAG
Docling, desenvolvido pela IBM Research e contribuído para a LF AI & Data Foundation, não é um mecanismo de OCR no sentido tradicional. É um kit de ferramentas de conversão de documentos que recebe PDFs, DOCX, PPTX e imagens e gera JSON estruturado, Markdown ou DocTags — um formato de marcação universal que captura layout, tabelas, fórmulas e ordem de leitura. Cresceu para mais de 20.000 estrelas no GitHub e é usado em produção pela NVIDIA (otimizado para PCs RTX) e na plataforma Watsonx da IBM.
Início Rápido
pip install docling

# Uso em Python
from docling.document_converter import DocumentConverter
converter = DocumentConverter()
doc = converter.convert("document.pdf")
print(doc.export_to_markdown())  # Saída Markdown estruturada
print(doc.export_to_dict())      # Representação JSON completa
A arquitetura do Docling combina dois modelos especializados da IBM: um Modelo de Análise de Layout treinado em ~81.000 páginas rotuladas manualmente (patentes, manuais, arquivamentos 10-K) para identificar elementos do documento, e o TableFormer para recuperar a estrutura de tabelas. Para documentos digitalizados, integra o EasyOCR como backend de OCR. O pipeline gera um DoclingDocument — uma representação baseada em Pydantic que preserva a hierarquia de páginas, células de tabela com índices de linha/coluna, localizações de imagens com legendas e fórmulas matemáticas em LaTeX.
A verdadeira força do Docling é seu ecossistema de integração. Ele se conecta diretamente ao LlamaIndex e LangChain para pipelines RAG, e a NVIDIA documentou melhorias de desempenho de 4x ao executar Docling em PCs RTX versus CPU. A IBM também lançou o Granite-Docling-258M (Apache 2.0) em 2026 — um VLM único de 258M parâmetros que faz compreensão de documentos ponta a ponta em uma única etapa, complementando a abordagem de pipeline ensemble.
Melhor para: Equipes construindo pipelines RAG que precisam converter diversos formatos de documentos em dados estruturados prontos para LLM. A combinação de preservação de layout, recuperação de estrutura de tabelas e integração direta com LangChain/LlamaIndex é única entre ferramentas de código aberto.
Não ideal para: Cenários que exigem saída de texto OCR bruta sem estrutura de documento, ou equipes que precisam de uma dependência leve — o Docling carrega pesos de modelo significativos e tem uma configuração complexa para implantação em GPU.
6. olmOCR — Conversão de PDF em Grande Escala Industrial
A olmOCR, desenvolvida pelo Allen Institute for AI (Ai2), é um VLM de 7 bilhões de parâmetros ajustado especificamente para OCR de documentos. Ela é baseada no Qwen2-VL-7B e treinada no conjunto de dados olmOCR-mix-0225 — 250.000 páginas rotuladas usando GPT-4o com uma técnica chamada Document Anchoring, que melhora a qualidade da extração ao aproveitar texto e metadados incorporados ao PDF. O modelo e o código são totalmente open-source, e a Ai2 publicou documentação transparente sobre os dados de treinamento e a metodologia.
Início Rápido
pip install olmocr

# Uso em Python
from olmocr.data.renderpdf import render_pdf_to_base64png
from olmocr.prompts import build_finetuning_prompt
# Processa uma página de PDF — a ferramenta cuida da renderização e do prompt
image_b64 = render_pdf_to_base64png("documento.pdf", page=1)
# Alimenta o modelo via seu servidor vLLM ou SGLang preferido
O número que destaca a olmOCR é seu custo de inferência: a Ai2 relata que a olmOCR pode converter um milhão de páginas de PDF por aproximadamente US$ 190 usando inferência SGLang otimizada — cerca de 1/32 do custo de usar GPT-4o para a mesma tarefa. Isso a torna a opção mais econômica para projetos de digitalização de documentos em larga escala, desde que você tenha a infraestrutura de GPU para executar um modelo de 7B.
O desempenho no benchmark olmOCR-bench atinge 82,4% no geral (para a versão olmOCR-2-7B-1025, lançada em outubro de 2025), com resultados fortes em equações matemáticas, tabelas densas e layouts de múltiplas colunas. O modelo suporta renderização automática de páginas, correção de rotação e lógica de repetição através do kit de ferramentas olmOCR, tornando-o adequado para processar milhões de documentos heterogêneos sem intervenção manual.
A limitação prática é o hardware. A olmOCR requer uma GPU NVIDIA recente com pelo menos 16 GB de VRAM para o modelo de 7B em precisão bfloat16. Ela não funciona em CPU ou Apple Silicon (embora existam quantizações GGUF da comunidade para o modelo Qwen base). Os pesos do modelo têm aproximadamente 14 GB, e a taxa de inferência é de cerca de 2 a 3 páginas por segundo em uma RTX 4090 — rápido o suficiente para processamento em lote, mas não em tempo real.
Melhor para: Projetos de digitalização de PDF em larga escala — pense em digitalizar milhões de artigos acadêmicos, arquivos governamentais ou documentos históricos. A eficiência de custo (US$ 190/milhão de páginas) e o pipeline automatizado fazem dela a campeã em escala industrial.
Não é ideal para: Equipes sem infraestrutura de GPU NVIDIA, aplicações de OCR em tempo real ou interativas, ou casos de uso que exigem implantação leve. O modelo de 7B é exagerado para extração simples de texto de documentos limpos.
7. Qwen2.5-VL — O VLM de Propósito Geral que se Destaca em OCR
O Qwen2.5-VL, desenvolvido pela equipe Qwen da Alibaba, é uma família de modelos de visão-linguagem (3B, 7B e 72B parâmetros) com forte desempenho em tarefas de compreensão visual — incluindo OCR. Embora não seja construído especificamente para processamento de documentos como olmOCR ou Surya, é um VLM de propósito geral com excelente capacidade de reconhecimento de texto e extração de informações. Isso o torna excepcionalmente flexível: você pode instruí-lo a extrair campos específicos de um documento, resumir uma página ou transcrever texto em um formato específico, tudo com o mesmo modelo.
Início Rápido
pip install transformers qwen-vl-utils torch

# Uso em Python — utilizando a biblioteca Hugging Face Transformers
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
model = Qwen2VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-7B-Instruct", torch_dtype="bfloat16"
)
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-7B-Instruct")
# Use o modelo com prompts de texto + imagem
# "Extraia todo o texto desta fatura e retorne como campos estruturados"
As capacidades de OCR do Qwen2.5-VL foram significativamente aprimoradas em relação ao seu predecessor, com melhor reconhecimento de texto em múltiplos cenários, idiomas e orientações. Ele lida com texto vertical, texto curvo e páginas com idiomas mistos que quebrariam mecanismos tradicionais. A versão de 72B compete com modelos comerciais como GPT-4o em benchmarks de compreensão de documentos, enquanto a variante de 3B é pequena o suficiente para rodar em GPUs de consumo (aproximadamente 6 GB de VRAM).
A principal vantagem do Qwen2.5-VL sobre ferramentas de OCR especializadas é a flexibilidade. Você não está limitado a um formato de saída ou pipeline — pode instruir o modelo a retornar JSON com campos específicos, extrair tabelas como markdown ou descrever a estrutura do documento em linguagem natural. Isso o torna ideal para tarefas de extração de informações de documentos onde você precisa segmentar pontos de dados específicos em vez de transcrever a página inteira. A comunidade r/LocalLLaMA frequentemente discute o Qwen2.5-VL como o modelo de propósito geral preferido para tarefas de OCR, com usuários relatando que sua precisão em layouts complexos frequentemente supera ferramentas de OCR especializadas, especialmente quando instruído com comandos de extração explícitos.
A contrapartida é latência e custo. Mesmo a versão de 7B requer recursos significativos de GPU, e a versão de 72B precisa de múltiplas GPUs. Diferente de mecanismos de OCR tradicionais que processam uma página em milissegundos, a inferência baseada em VLM leva de 2 a 5 segundos por página, dependendo do tamanho do modelo e do hardware. Para transcrição de texto em massa, ferramentas de OCR especializadas continuam sendo mais eficientes. Para extração direcionada de informações de documentos complexos, a flexibilidade do Qwen2.5-VL é incomparável.
Melhor para: Extração direcionada de informações de documentos complexos — instruir o modelo a extrair campos específicos em um formato específico. Também ideal para equipes que desejam um único modelo para OCR, compreensão de documentos e QA visual geral.
Não é ideal para: OCR em lote de alto rendimento onde a velocidade de transcrição bruta é importante, implantações apenas em CPU ou cenários onde você precisa de uma biblioteca leve e autossuficiente em vez de uma infraestrutura de serviço de modelo baseada em GPU.
Qual Ferramenta Você Deve Escolher?
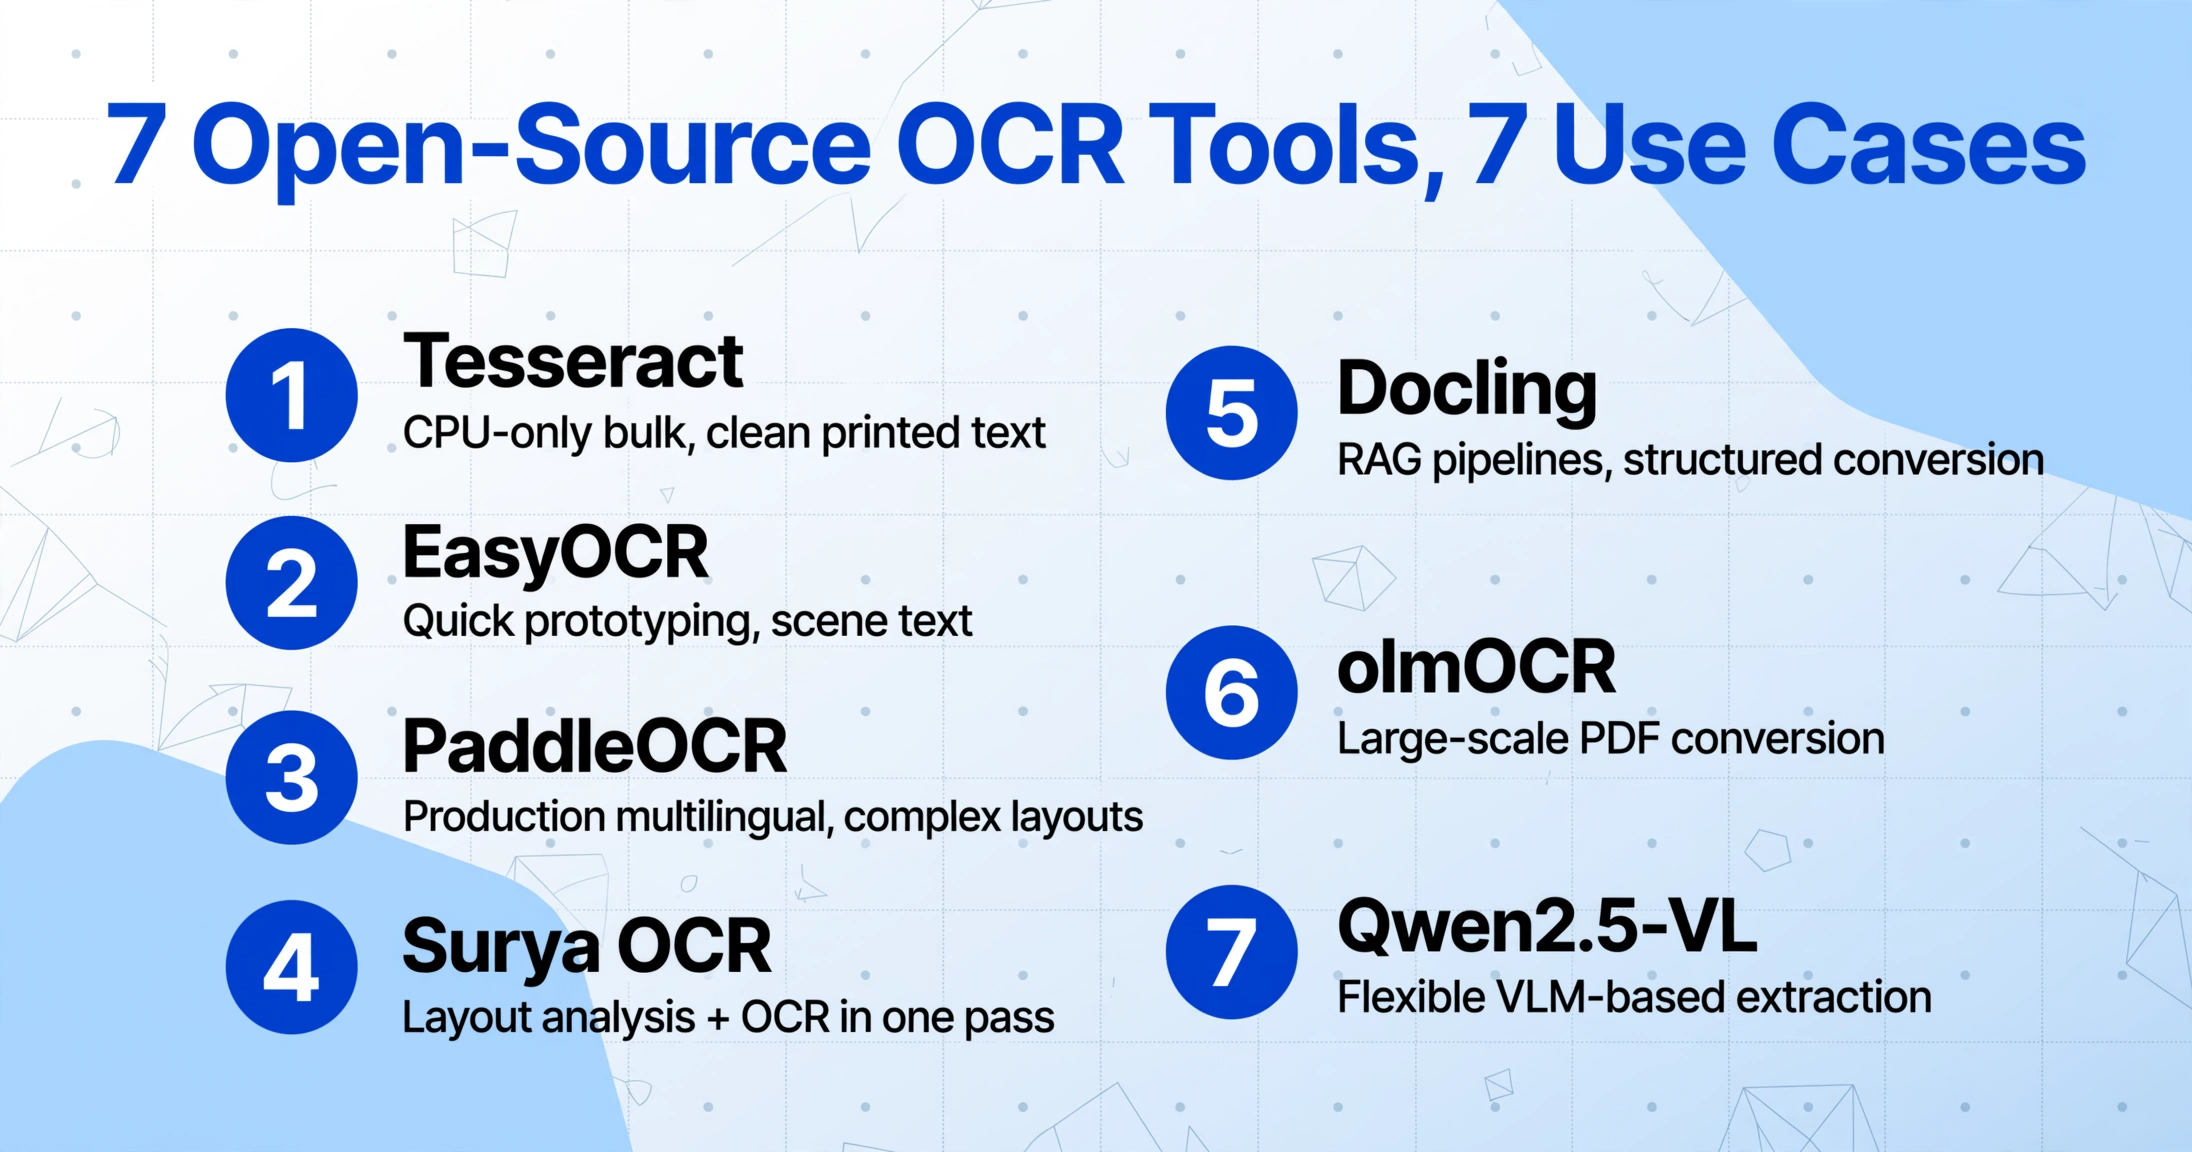
Se seus documentos são texto impresso limpo e você precisa de processamento em lote apenas com CPU a custo zero: Tesseract. É a única opção que funciona bem sem GPU e em qualquer hardware.
Se você precisa de um protótipo rápido para texto de cena multilíngue ou texto curvo em fotos: EasyOCR. A configuração leva cinco minutos e os escores de confiança tornam o pós-processamento viável.
Se você está construindo um pipeline multilíngue de produção com layouts complexos e tem acesso a GPU: PaddleOCR. Sua extração de tabelas, suporte a CJK e throughput (120 páginas/min na GPU) fazem dele o mecanismo tradicional mais capaz.
Se você precisa de análise de layout de documentos e OCR em uma única passada com um modelo leve: Surya OCR. Com 650M de parâmetros e saída ciente de layout, é o melhor equilíbrio entre custo e precisão entre as opções baseadas em VLM.
Se você está construindo pipelines de RAG e precisa de conversão estruturada de documentos: Docling. A integração com LlamaIndex/LangChain e a recuperação de estrutura de tabelas são únicas.
Se você tem um projeto de digitalização de PDFs em larga escala (milhões de páginas) e infraestrutura de GPU: olmOCR. A eficiência de custo de $190/milhão de páginas é incomparável.
Se você quer extração flexível baseada em VLM, onde você instrui o modelo para campos específicos em formatos específicos: Qwen2.5-VL. A variante de 3B roda em GPUs de consumo e a variante de 72B compete com a compreensão de nível GPT-4o.
A visão honesta: Se você tem acesso a GPU, pule os mecanismos tradicionais para qualquer documento com tabelas, layouts de múltiplas colunas ou formatação mista. Uma abordagem baseada em VLM (Surya, olmOCR ou Qwen2.5-VL) entrega saída estruturada diretamente e economizará mais tempo de engenharia em código de colagem de pós-processamento do que custará em computação de GPU. Mantenha Tesseract e PaddleOCR na sua caixa de ferramentas para os casos específicos em que eles se saem bem — texto limpo em lote e CJK de alto throughput, respectivamente — mas não os use por padrão para OCR geral de documentos em 2026.
Perguntas Frequentes
O Tesseract ainda é relevante em 2026?
Sim, mas apenas para um caso de uso específico: processamento em massa de texto impresso limpo, onde você pode tolerar saída plana (não estruturada). Para qualquer documento com tabelas, colunas ou manuscritos, alternativas modernas superam significativamente. O principal motivo para ainda escolher o Tesseract em 2026 é o requisito de hardware — é a única ferramenta desta lista que roda com eficiência em CPU sem GPU.
Qual é a diferença entre "OCR gratuito" e "OCR de código aberto"?
OCR gratuito (abordado no nosso guia Melhor Software de OCR Gratuito 2026) inclui serviços online gratuitos e níveis gratuitos comerciais — Google Drive OCR, PDF24, OCR.space e ferramentas freemium como Parseur e Nanonets. OCR de código aberto refere-se a software auto-hospedado com código-fonte que você pode inspecionar e modificar. As ferramentas neste artigo são todas de código aberto, ou seja, você as hospeda na sua própria infraestrutura, o que oferece processamento ilimitado ao custo de configuração e manutenção.
Preciso de uma GPU para essas ferramentas?
O Tesseract é apenas CPU e roda bem em qualquer processador moderno. EasyOCR e PaddleOCR se beneficiam da aceleração por GPU, mas podem rodar em CPU (lentamente). O Surya pode rodar em CPU ou Apple Silicon via llama.cpp, mas o desempenho é aproximadamente 50x mais lento que com GPU. olmOCR e Qwen2.5-VL exigem uma GPU NVIDIA — os modelos de 7B precisam de pelo menos 16 GB de VRAM. O pipeline de conjunto do Docling se beneficia de GPU, mas pode processar documentos mais simples em CPU.
Qual ferramenta de OCR de código aberto lida melhor com manuscritos?
Entre as ferramentas analisadas, o PaddleOCR lidera em manuscritos com aproximadamente 73% de precisão em benchmarks independentes (vs 45% do Tesseract e 62% do EasyOCR). As ferramentas baseadas em VLM (Surya, olmOCR, Qwen2.5-VL) mostram melhor reconhecimento de manuscritos na prática, embora os benchmarks publicados sejam limitados. Para processamento sério de documentos manuscritos, serviços comerciais de IA dedicados geralmente superam as ferramentas de código aberto por uma margem significativa.
Posso treinar ou ajustar essas ferramentas com meus próprios documentos?
O Tesseract oferece suporte a treinamento personalizado por meio do pipeline de ajuste fino LSTM, mas o processo é complexo e exige a geração de arquivos box para cada imagem de treinamento. O EasyOCR permite treinamento com dados personalizados usando a arquitetura CRNN. O PaddleOCR possui o pipeline de ajuste fino mais acessível, com exemplos documentados para conjuntos de dados personalizados. O Surya e o Docling atualmente não oferecem suporte a ajuste fino de modelos — eles são usados como estão. O olmOCR e o Qwen2.5-VL podem ser ajustados usando as ferramentas padrão do Hugging Face Transformers, mas o ajuste fino eficaz exige conhecimento substancial, dados e recursos de GPU.
Qual ferramenta preserva melhor a estrutura de tabelas?
Docling tem a melhor preservação de estrutura de tabelas graças ao seu modelo dedicado TableFormer, que recupera estrutura de linhas/colunas, células mescladas e cabeçalhos. O módulo PP-Structure do PaddleOCR também lida bem com extração de tabelas. Entre as ferramentas baseadas em VLM, Surya e olmOCR produzem tabelas em markdown que preservam a estrutura para a maioria dos layouts comuns de tabelas.
Posso usar essas ferramentas comercialmente?
Os termos de licença variam por ferramenta. Tesseract (Apache 2.0), EasyOCR (Apache 2.0), PaddleOCR (Apache 2.0) e Docling (MIT/Apache 2.0) são totalmente permissivos para uso comercial. O código do Surya é Apache 2.0, mas os pesos do modelo usam uma licença OpenRAIL-M modificada (gratuito para startups com menos de US$ 5 milhões em financiamento/receita — uso comercial mais amplo exige licença paga). olmOCR (Apache 2.0) e Qwen2.5-VL (Apache 2.0 para 7B/72B, personalizada para variante 3B) são permissivos. Sempre verifique a licença específica da versão que pretende implantar — as licenças dos modelos podem diferir das licenças do código.
Quando devo considerar uma ferramenta comercial de OCR?
OCR de código aberto é excelente para prototipagem e ferramentas internas. Mas se você precisa de extração de dados em nível de campo (não apenas transcrição de texto), reconhecimento confiável de escrita manual ou um fluxo de trabalho sem configuração para membros da equipe não técnicos, ferramentas comerciais de extração com IA geralmente oferecem maior precisão e saída estruturada melhor. Se você está atualmente avaliando opções comerciais, tente executar seus documentos reais em uma ferramenta antes de se comprometer — soluções de código aberto e comerciais diferem mais nos documentos que importam para seu fluxo de trabalho específico, não em benchmarks padronizados.
A melhor avaliação de OCR é aquela que você executa nos seus próprios documentos. Os dados de benchmark dão um ponto de partida — os resultados reais dependem da qualidade dos seus documentos, da complexidade do layout e do formato de saída desejado.
Experimente a Extração de Documentos com IASem necessidade de cadastro. Envie um documento e veja o que a extração moderna com IA pode fazer.