2026년 최고의 오픈소스 OCR 도구:
Tesseract, EasyOCR, PaddleOCR 그 이상
2026년의 오픈소스 OCR은 두 가지 뚜렷한 시대(era)로 나뉩니다: 전통적인 파이프라인 엔진과 비전-언어 모델입니다. 대부분의 리뷰는 이 둘을 서로 대체 가능한 대안으로 취급합니다. 하지만 그렇지 않습니다. 올바른 선택은 문서 유형, 하드웨어 예산, 그리고 원시 텍스트가 필요한지 구조화된 출력이 필요한지에 따라 달라집니다. 이 가이드는 일회성 테스트가 아니라 파이프라인을 구축할 때 중요한 개발자 워크플로 세부 사항과 함께, 상용 제품도 프리미엄 티어도 없는 순수 오픈소스 도구 일곱 가지를 다룹니다. 기본 개념이 처음이라면, 이 심층 분석 전에 OCR이란 무엇인가, AI OCR의 차이점, OCR이 실제로 작동하는 방식에 대한 가이드를 먼저 읽어보세요. 공지: 저는 이 목록의 어떤 도구와도 관련이 없습니다. 모든 외부 링크는 도구의 공식 프로젝트 페이지 또는 독립적인 벤치마크로 연결되므로, 스택을 결정하기 전에 주장을 직접 확인할 수 있습니다.
핵심 요점
- 일곱 가지 오픈소스 OCR 도구 모두 깨끗한 영어 텍스트에서 95~97%의 문자 정확도를 기록하는데, 이는 선택을 동전 던지기처럼 느끼게 하는 거의 동일한 수치입니다.
- 문자 정확도는 현혹적인 지표입니다. 10열짜리 붕괴된 표에서 97% 점수를 받아도 여전히 뒤섞인 셀에서 열을 손으로 재구성해야 하기 때문입니다.
- 2026년의 진짜 분기점은 도구 간이 아니라 시대 간의 차이입니다 — 문자를 감지하는 전통적인 엔진과 문서를 읽고 표가 이미 온전히 포함된 구조화된 마크다운을 출력하는 VLM의 차이입니다.
빠른 비교 표
일곱 가지 도구, 두 가지 아키텍처 시대. 아래 표는 주요 차이점을 보여줍니다. 이후 섹션에서는 각 도구의 실제 동작 방식을 더 깊이 다룹니다.
| 도구 | 아키텍처 | 지원 언어 | GPU 필요? | 레이아웃 처리 | 최적 용도 |
|---|---|---|---|---|---|
| Tesseract | 전통적 LSTM | 100+ | 아니요 | 약함 — 표, 열 손실 | 깨끗한 인쇄 텍스트, CPU 전용 대량 처리 |
| EasyOCR | 전통적 CRNN | 80+ | 선택 사항 | 약함 — 평문 출력 | 빠른 프로토타이핑, 현장 텍스트 |
| PaddleOCR | 전통적 DL 파이프라인 | 80+ | 속도 향상 권장 | 좋음 — 표, 열, 양식 | 프로덕션 다국어, 복잡한 레이아웃 |
| Surya OCR | VLM | 90+ | 예, CPU 가능 | 우수 — 레이아웃 + 표 + 읽기 순서 | 문서 레이아웃 분석 + OCR 단일 모델 |
| Docling | 앙상블 | 다중 | 권장 | 우수 — 전체 문서 구조 | RAG 파이프라인, 구조화된 문서 변환 |
| olmOCR | VLM | 다중 | 예 (NVIDIA GPU) | 우수 — 다중 열, 표, 수식 | 대규모 PDF 변환, 과학 문서 |
| Qwen2.5-VL | VLM (3B/7B/72B) | 다중 | 예 | 우수 — 유연한 VLM 읽기 | 일반 VLM 기반 OCR, 맞춤형 추출 작업 |
평가 방법
이는 실험실 벤치마크가 아닙니다. 공개된 제3자 정확도 수치는 가능한 경우 인용했습니다. 그러나 여기서의 주요 평가 기준은 스택을 선택할 때 실제로 중요한 것들입니다:
가능한 경우, 당사의 자체 OCR 벤치마크와도 교차 검증했습니다 — 동일한 RTX 4090에서 실행된 8개의 오픈소스 엔진, 동일한 영수증(SROIE 2019 + CORD v2), 동일한 고정 프로토콜로 CER/WER, 필드 추출 F1, 지연 시간, 페이지 1,000장당 비용을 보고하며, 모든 수치는 공개된 CSV 행에 추적 가능합니다. 해당 실행에서 얻은 두 가지 결과가 아래 선택에 직접적인 영향을 미칩니다: 문자 정확도에서 최고의 전통 엔진(docTR, CER 0.197)이 최고의 VLM(Surya2, 0.191)과 동률을 기록했습니다 — 따라서 "VLM이 본질적으로 더 정확하다"는 깨끗한 인쇄 텍스트에서는 성립하지 않으며, LLM 후처리기가 추가되면 8개 엔진 중 6개가 계열과 무관하게 0.57–0.62 필드 F1 범위로 수렴합니다. 엔진별 운영 수치는 비용 벤치마크와 지연 시간 벤치마크를 참조하세요. 이는 한 문서 유형에 대한 당사의 측정값이며, 아래의 제3자 수치는 더 다양한 입력 구성을 다룹니다.
- 통합 표면 — Python API가 얼마나 깔끔한지, 구조화된 데이터를 반환하는지 원시 텍스트를 반환하는지, 접착 코드가 필요한지
- 하드웨어 요구사항 — 도구가 작동하기 전에 어떤 하드웨어를 제공해야 하는지
- 레이아웃 인식 — 표 머리글과 페이지 번호를 구분할 수 있는지, 아니면 단순히 문자 스트림만 출력하는지
- 커뮤니티 활성도 — 최근 커밋, 미해결 이슈 수, 풀 리퀘스트 대응, 확립된 생태계
- 맞춤 학습 표면 — 자체 문서 유형으로 미세 조정이 가능한지, 그리고 그에 필요한 전문 지식 수준
아래의 모든 도구 링크는 프로젝트의 공식 GitHub 저장소로 연결됩니다. 모든 외부 참조는 링크되어 있으므로 직접 주장을 확인할 수 있습니다.
오픈소스 OCR의 두 시대
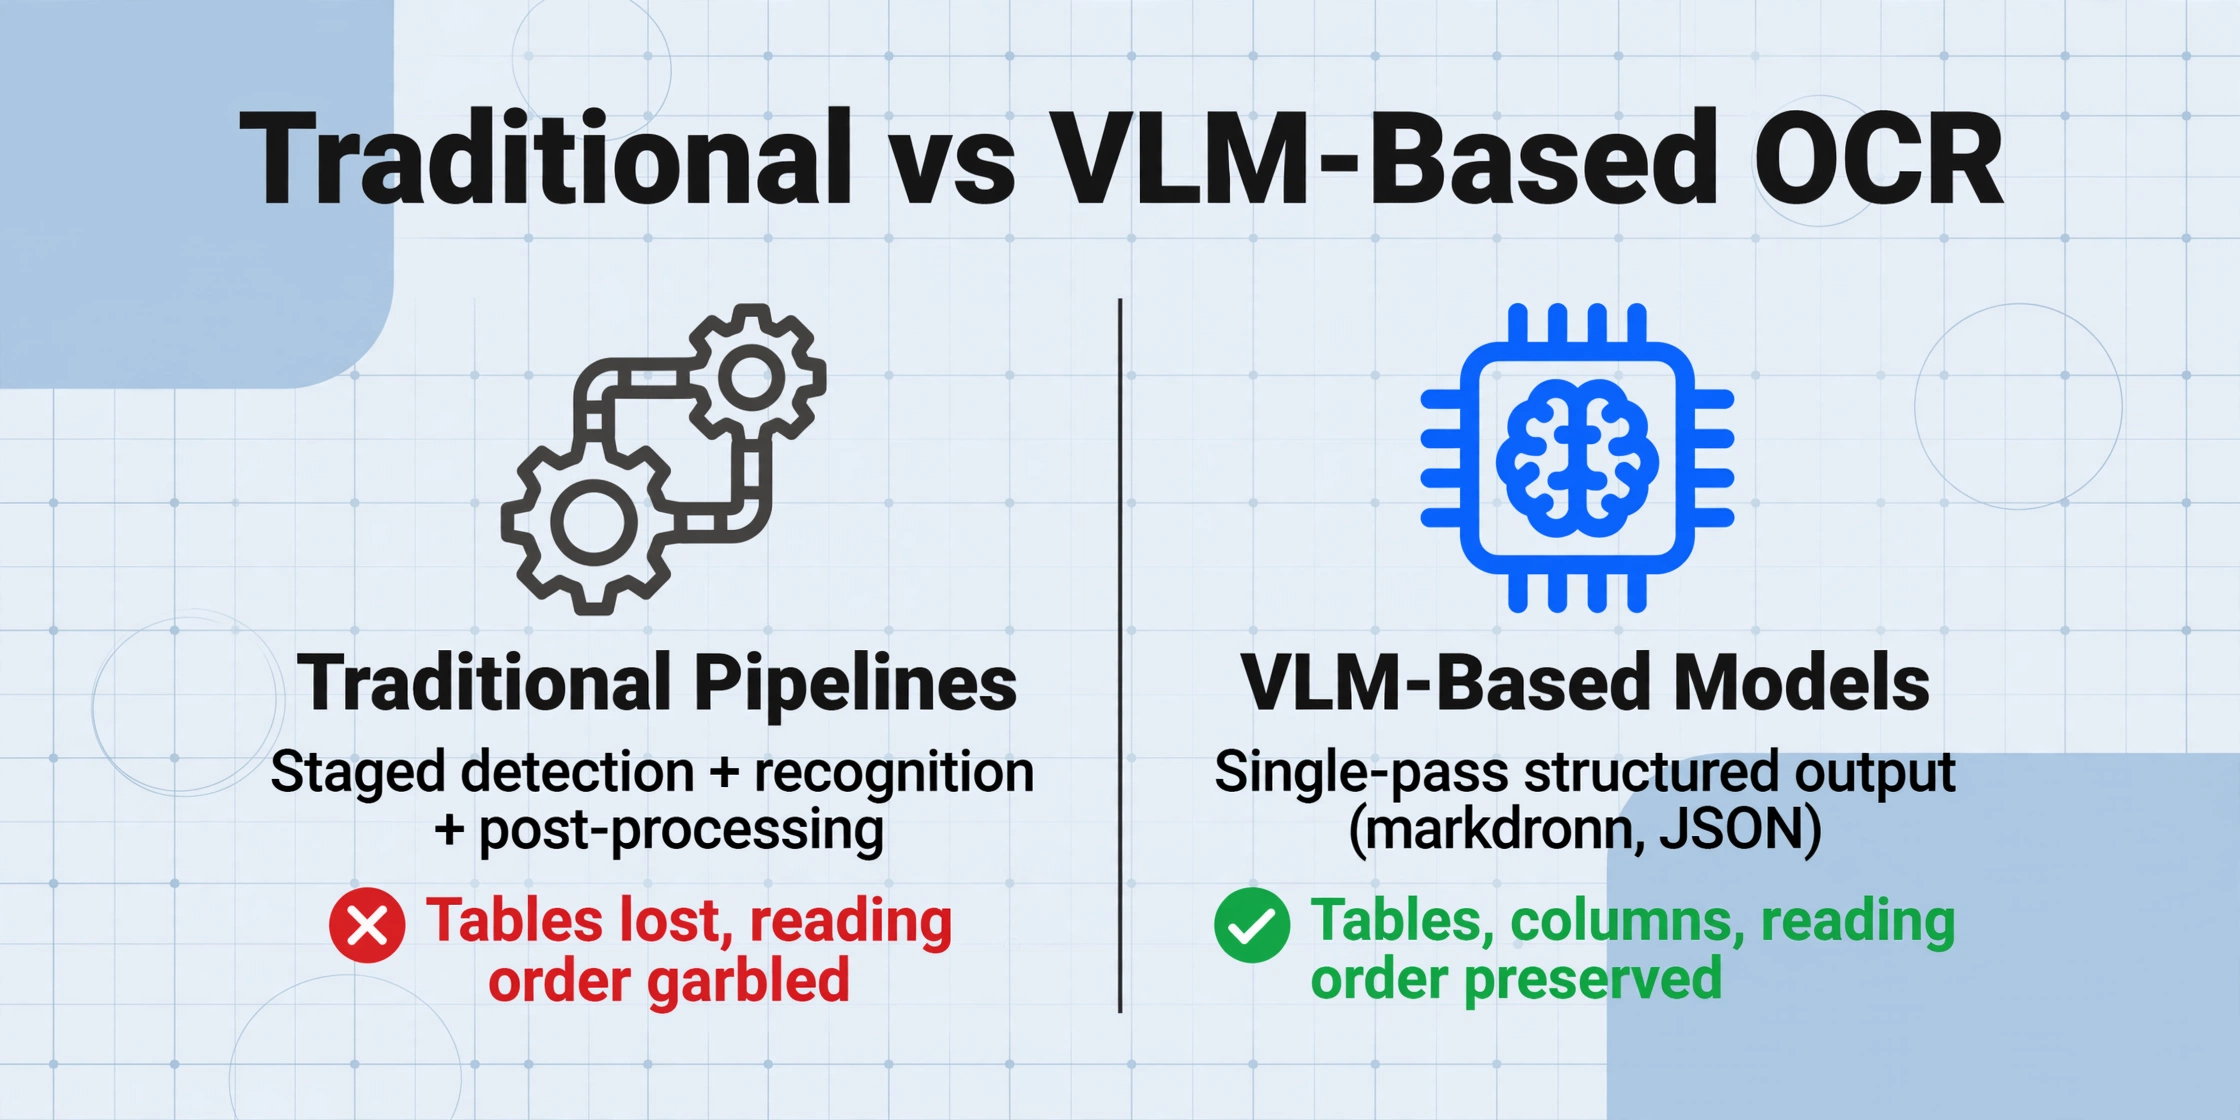
개별 도구를 살펴보기 전에, 2026년을 오픈소스 OCR에 특별히 흥미로운 해로 만드는 아키텍처적 분기를 이해하는 것이 도움이 됩니다.
전통적 OCR 파이프라인(Tesseract, EasyOCR, PaddleOCR)은 단계적으로 작동합니다. 텍스트 감지 모델이 텍스트 영역을 찾고, 인식 모델이 각 영역을 문자 단위로 읽으며, 후처리 단계에서 페이지 구조를 재구성합니다. 각 단계는 별도의 모델 또는 알고리즘이며, 오류가 연쇄적으로 발생합니다. 감지 누락이 발생하면 인식기가 해당 텍스트를 볼 수 없습니다.
VLM 기반 OCR(Surya, olmOCR, Qwen2.5-VL)은 문서 읽기를 단일 멀티모달 작업으로 처리합니다. 비전-언어 모델이 전체 페이지 이미지를 보고 마크다운, JSON 또는 HTML과 같은 구조화된 출력을 한 번에 생성합니다. Docling은 그 중간에 위치합니다. 특화된 모델 기반의 앙상블 파이프라인을 사용하지만 VLM처럼 느껴지는 통합 API를 제공합니다.
실질적인 차이점: 전통적 파이프라인은 실행 비용이 더 저렴하지만, 테이블과 읽기 순서를 재구성하기 위해 광범위한 후처리 접착 코드가 필요합니다. VLM 기반 OCR은 GPU를 많이 사용하지만 구조화된 출력을 직접 제공하므로 "테이블 손실"이나 "A열이 B열로 병합됨"과 같은 문제가 없습니다. 단순한 레이아웃의 깨끗한 인쇄 텍스트를 대량으로 처리한다면 전통적 엔진이 비용 면에서 여전히 우세합니다. 테이블, 다중 컬럼 레이아웃 또는 혼합 형식의 문서가 있다면 VLM 기반 접근 방식이 GPU 비용보다 더 많은 엔지니어링 시간을 절약해 줍니다.
1. Tesseract OCR — CPU 성능의 핵심
Tesseract는 이 목록에서 가장 오래되고 가장 검증된 오픈소스 OCR 엔진입니다. 1980년대 Hewlett-Packard에서 처음 개발되었고 2006년부터 Google이 유지 관리하며, 100개 이상의 언어를 지원하고 모든 주요 OS에서 실행됩니다. 문자 인식에는 LSTM 기반 신경망을 사용하고 레이아웃 분석에는 기존 페이지 분할 알고리즘을 사용합니다.
빠른 시작
pip install pytesseract
# 또는 시스템 패키지 관리자로 설치: sudo apt install tesseract-ocr

# Python 사용법
import pytesseract
from PIL import Image
text = pytesseract.image_to_string(Image.open("invoice.png"), lang="eng")
print(text)
Tesseract의 강점은 무료로 CPU만으로 작동한다는 점과 방대한 생태계입니다. 300 DPI의 깨끗하고 고해상도 인쇄 텍스트에서 공개된 벤치마크 기준 약 96-97%의 문자 정확도를 제공합니다. 최신 CPU에서 GPU 없이 분당 약 25페이지를 처리하므로 대량 인쇄 텍스트 디지털화에 가장 비용 효율적인 옵션입니다. 이 엔진이 처음이신가요? 저희의 단계별 Tesseract 설정 가이드에서 Windows, Mac, Linux 설치 방법과 초보자들이 흔히 겪는 문제를 약 15분 만에 안내해 드립니다.
한계점도 잘 문서화되어 있습니다. Tesseract는 문서 구조에 대한 기본 개념이 없어 원본 레이아웃을 대략적으로 반영한 줄바꿈이 있는 평문 텍스트만 출력합니다. 표는 행/열 연관성 없이 순차적인 텍스트 셀로 붕괴됩니다. 다단 문서는 잘못된 읽기 순서를 생성합니다. 모바일 폰 사진 같은 까다로운 입력에서는 독립 테스트에서 정확도가 약 84%로 떨어집니다. 필기 인식은 약 45%의 정확도로 성능이 낮아 필기체나 혼합 필기 문서에는 사실상 사용할 수 없습니다.
적합한 용도: 평문 출력을 허용하는 깨끗한 인쇄 문서의 CPU 전용 대량 처리 — 책 페이지 디지털화, 아카이브 문서 검색, NLP 파이프라인 전처리 등을 생각하면 됩니다.
부적합한 용도: 표, 다단 레이아웃, 필기, 저해상도 사진이 포함된 문서 또는 구조화된 출력이 필요한 모든 시나리오. API가 필요할 때도 적합하지 않습니다. Tesseract는 Python 래퍼가 있는 명령줄 도구이지 서비스가 아니기 때문입니다.
2. EasyOCR — 작동하는 데모로 가는 가장 빠른 길
Jaided AI가 PyTorch 기반으로 만든 EasyOCR은 한 가지 목표를 위해 설계되었습니다. 최소한의 마찰로 OCR을 실행하는 것입니다. 네 줄짜리 Python 스크립트가 이미지를 처리하고 문자별 신뢰도 점수와 함께 인식된 텍스트를 반환합니다. 라틴어, CJK, 아랍어, 데바나가리 문자를 포함해 약 80개 언어를 지원합니다. 모델 크기로 예상되는 것보다 더 넓은 범위인데, 서로 다른 문자 체계를 전용 인식 헤드로 라우팅하기 때문입니다.
빠른 시작
pip install easyocr

# Python 사용법
import easyocr
reader = easyocr.Reader(["en", "fr"])  # 언어 지정
results = reader.readtext("receipt.jpg")
for bbox, text, confidence in results:
    print(f"{text} ({confidence:.2f})")
EasyOCR의 편의성은 주요 장점이자 주요 한계입니다. 깨끗한 영어 인쇄 텍스트의 경우 독립 벤치마크에서 약 95%의 문자 정확도를 보여줍니다. 이상적인 입력에서는 Tesseract보다 약간 낮은 수준입니다. 그러나 EasyOCR은 곡선 및 회전 텍스트를 훨씬 더 잘 처리하므로, 문서가 완벽하게 정렬되지 않은 실제 사진에 더 유용합니다.
성능 트레이드오프는 실재합니다. CPU에서 EasyOCR은 분당 약 8페이지로 Tesseract보다 약 2-3배 느립니다. GPU 가속을 사용하면 분당 약 60페이지로 약 7.5배 빨라집니다. 모델 의존성도 약 500MB로 Tesseract의 약 10MB보다 훨씬 무겁습니다. 필기 인식 정확도는 약 62%로 Tesseract보다 낫지만 대부분의 필기 문서 워크플로우에서 여전히 프로덕션에서 사용할 수준은 아닙니다.
Reddit의 r/LocalLLaMA 커뮤니티는 EasyOCR을 "OCR의 인스턴트 라면"으로 자주 언급합니다. 최소한의 노력으로 빠른 결과를 얻을 수 있지만 정확도나 처리량이 가장 중요할 때 선택하는 도구는 아닙니다. EasyOCR의 실패는 Tesseract가 생성하는 복구 불가능한 노이즈보다는 예측 가능한 경향이 있어서 정규식 기반 후처리로 많은 결과를 살릴 수 있습니다.
적합한 경우: 5분 안에 작동하는 OCR 프로토타입이 필요한 Python 개발자, 특히 다국어 장면 텍스트나 실제 사진의 곡선/회전 텍스트를 처리해야 하는 경우.
부적합한 경우: CPU 전용 하드웨어에서의 대용량 일괄 처리, 복잡한 문서 레이아웃, 또는 구조화된 필드 추출이 필요한 프로덕션 배포.
Tesseract와 EasyOCR 사이에서 구체적으로 선택하고 있다면, Tesseract vs EasyOCR 정면 비교에서 실제 파이프라인에서 중요한 차이점을 더 자세히 다룹니다.
3. PaddleOCR — 프로덕션 수준의 다국어 OCR
바이두가 PaddlePaddle 프레임워크 기반으로 개발한 PaddleOCR은 이 목록에서 가장 기능이 풍부한 전통적인 파이프라인 엔진입니다. 텍스트 인식에만 집중하는 Tesseract나 EasyOCR과 달리, PaddleOCR은 텍스트 감지, 인식, 표 추출, 레이아웃 분석(PP-Structure), 구조화된 출력을 단일 코드베이스에서 제공합니다. GitHub에서 76,000개 이상의 스타를 보유하고 있으며, 생태계 성숙도 측면에서 Tesseract에 가장 근접한 오픈소스 경쟁자입니다.
빠른 시작
pip install paddlepaddle paddleocr

# Python 사용법
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_angle_cls=True, lang="en")
result = ocr.ocr("invoice.png")
for line in result[0]:
    print(f"{line[1][0]} (신뢰도: {line[1][1]:.2f})")
PaddleOCR은 기존 엔진 중 공개된 벤치마크의 모든 정확도 범주에서 선두를 차지합니다: 깨끗한 인쇄 영어 97.2%, 노이즈가 있는 스캔 문서 91.5%, 곡선/회전 텍스트 88.7%, 필기체 72.8%입니다. 특히 중국어, 일본어, 한국어(CJK) 지원이 매우 뛰어나며 — 중국에서 개발된 점을 고려하면 당연합니다 — 영어-중국어 혼합 문서나 동아시아 문자를 포함하는 모든 워크플로우를 처리하는 팀에게 기본 선택입니다.
2026년의 최신 업데이트는 상당했습니다. PP-OCRv6가 2026년 5월에 출시되어 정확도와 속도가 더욱 향상되었습니다. PaddleOCR-VL-1.5 모델은 비전-언어 기능을 도입하여 OmniDocBench v1.5 벤치마크에서 정확도를 94.5%까지 끌어올렸습니다 — 이는 전통적인 파이프라인과 VLM 기반 접근 방식 간의 격차를 해소합니다. 성능도 인상적입니다: RTX 3090에서 PaddleOCR은 분당 약 120페이지를 처리하는 반면, Tesseract는 CPU에 종속되어 분당 25페이지를 처리합니다.
최적 대상: 특히 CJK 문자, 표가 있는 복잡한 레이아웃, 또는 노이즈가 있는 스캔 문서를 포함하는 프로덕션 다국어 OCR 파이프라인. PP-Structure를 통한 표 추출은 실질적으로 유용하며 다른 기존 오픈소스 엔진에서는 사용할 수 없습니다.
부적합한 경우: 빠른 일회성 OCR, CPU 전용 배포, 또는 PaddlePaddle 프레임워크 의존성을 피하려는 팀 — 더 이식성이 좋은 PyTorch 기반 대안에 비해 상당한 프레임워크 종속성입니다.
4. Surya OCR — 10억 파라미터 미만의 문서 레이아웃 인텔리전스
Datalab이 개발한 Surya OCR은 2025-2026년에 공개된 가장 인상적인 오픈소스 중 하나입니다. 단 6억 5천만 개의 파라미터로 olmOCR-bench 벤치마크에서 83.3%의 점수를 기록하며 30억 파라미터 미만 모델 중 최고 성능을 달성했습니다. OCR, 레이아웃 분석, 읽기 순서 감지, 표 인식을 하나의 모델로 통합했습니다. 모델 가중치는 OpenRAIL-M 라이선스로 제공되며, 코드는 Apache 2.0 라이선스입니다.
빠른 시작
pip install surya-ocr

# Python 사용법
from surya import OCR
from PIL import Image
ocr = OCR()
result = ocr.recognize([Image.open("invoice.png")])
for text_line in result[0].text_lines:
    print(text_line.text)
Surya의 아키텍처적 특징은 통합된 접근 방식입니다. 기존 파이프라인이 감지 → 인식 → 레이아웃 분석을 별도 모델로 연결하는 반면, Surya는 비전-언어 모델을 추론 백엔드로 사용합니다. 이를 통해 기존 엔진이 부족한 구조적 이해가 가능합니다. SuryaInferenceManager가 자동으로 적절한 백엔드를 실행하며, API는 바운딩 박스, 신뢰도 점수, 의미적 영역 레이블이 포함된 풍부한 주석 JSON을 반환합니다.
성능은 경쟁력 있습니다. Surya는 RTX 5090에서 초당 약 5페이지를 처리하며, Apple Silicon에서는 Metal을 통해 초당 약 0.1페이지로 처리 가능합니다. 가끔 문서를 처리하기에는 충분하지만 배치 처리에는 적합하지 않습니다. 91개 언어를 지원하며 아시아 스크립트에 대한 강력한 커버리지를 제공합니다. 주요 제한 사항은 Surya가 문서용으로 설계되었으며 일반 사진에는 적합하지 않다는 점입니다. 비문서 이미지에서는 어려움을 겪을 수 있으며, 감지 모델이 건너뛰도록 훈련된 광고 같은 영역을 무시할 수 있습니다.
적합한 경우: 다단계 파이프라인의 복잡성 없이 문서 레이아웃 분석과 OCR을 하나의 모델로 필요로 하는 팀. 레이아웃 인식 출력은 다운스트림 문서 인텔리전스 워크플로우에 이상적입니다.
부적합한 경우: 일반 사진 OCR, GPU 환경이 열악한 경우, 또는 모델 가중치의 허용적인 상업적 라이선싱이 필요한 시나리오.
5. Docling — RAG 파이프라인을 위한 문서 변환 도구
IBM Research에서 개발하고 LF AI & Data Foundation에 기여한 Docling은 전통적인 의미의 OCR 엔진이 아닙니다. PDF, DOCX, PPTX, 이미지를 입력받아 구조화된 JSON, Markdown 또는 DocTags로 출력하는 문서 변환 툴킷입니다. GitHub에서 20,000개 이상의 별을 받았으며, NVIDIA와 IBM의 Watsonx 플랫폼에서 프로덕션 환경에 사용되고 있습니다.
빠른 시작
pip install docling

# Python 사용법
from docling.document_converter import DocumentConverter
converter = DocumentConverter()
doc = converter.convert("document.pdf")
print(doc.export_to_markdown())  # 구조화된 마크다운 출력
print(doc.export_to_dict())      # 전체 JSON 표현
Docling의 아키텍처는 두 가지 특화된 IBM 모델을 결합합니다: 약 81,000개의 수동 레이블링된 페이지로 학습된 레이아웃 분석 모델과 표 구조 복원을 위한 TableFormer입니다. 스캔된 문서의 경우 EasyOCR을 OCR 백엔드로 통합합니다. 파이프라인은 페이지 계층, 행/열 인덱스가 있는 표 셀, 캡션이 있는 그림 위치, LaTeX 수학 공식을 보존하는 Pydantic 기반 표현인 DoclingDocument를 출력합니다.
Docling의 진정한 강점은 통합 생태계입니다. LlamaIndex 및 LangChain에 직접 연결되어 RAG 파이프라인을 구축할 수 있으며, NVIDIA는 RTX PC에서 Docling을 실행할 때 CPU 대비 4배 성능 향상을 문서화했습니다. IBM은 또한 2026년에 Granite-Docling-258M(Apache 2.0)을 출시했습니다. 이는 2억 5800만 개의 파라미터를 가진 단일 VLM으로, 앙상블 파이프라인 방식을 보완하여 한 번에 종단간 문서 이해를 수행합니다.
적합한 대상: 다양한 문서 형식을 LLM에 적합한 구조화된 데이터로 변환해야 하는 RAG 파이프라인 구축 팀. 레이아웃 보존, 표 구조 복원, LangChain/LlamaIndex 직접 통합의 조합은 오픈소스 도구 중에서 독보적입니다.
부적합한 대상: 문서 구조 없이 원시 OCR 텍스트 출력만 필요한 시나리오, 또는 가벼운 의존성이 필요한 팀 — Docling은 상당한 모델 가중치를 필요로 하며 GPU 배포를 위한 복잡한 설정이 필요합니다.
6. olmOCR — 대규모 PDF 변환을 위한 산업용 솔루션
olmOCR은 Allen Institute for AI(Ai2)가 개발한, 문서 OCR에 특화된 70억 파라미터 VLM입니다. Qwen2-VL-7B를 기반으로 하며, GPT-4o로 레이블링된 25만 페이지 분량의 olmOCR-mix-0225 데이터셋으로 학습되었습니다. 이 과정에서 PDF 내장 텍스트와 메타데이터를 활용해 추출 품질을 높이는 Document Anchoring 기법이 사용되었습니다. 모델과 코드는 완전히 오픈소스이며, Ai2는 학습 데이터와 방법론에 대한 투명한 문서를 공개했습니다.
빠른 시작
pip install olmocr

# Python 사용법
from olmocr.data.renderpdf import render_pdf_to_base64png
from olmocr.prompts import build_finetuning_prompt
# PDF 페이지 처리 — 툴킷이 렌더링과 프롬프트 생성을 처리합니다
image_b64 = render_pdf_to_base64png("document.pdf", page=1)
# 선호하는 vLLM 또는 SGLang 서버를 통해 모델에 입력
olmOCR의 가장 큰 장점은 추론 비용입니다. Ai2에 따르면, 최적화된 SGLang 추론을 사용할 경우 olmOCR로 100만 페이지의 PDF를 약 190달러에 변환할 수 있습니다. 이는 동일 작업에 GPT-4o를 사용할 때의 약 1/32 수준입니다. 7B 모델을 구동할 GPU 인프라만 갖춰진다면, 대규모 문서 디지털화 프로젝트에 가장 비용 효율적인 선택입니다.
olmOCR-bench 벤치마크 성능은 전체 82.4%를 기록했습니다. 수학 방정식, 복잡한 표, 다단 레이아웃에서 특히 강력한 결과를 보여줍니다. 이 모델은 olmOCR 툴킷을 통해 자동 페이지 렌더링, 회전 보정, 재시도 로직을 지원하므로, 수백만 건의 다양한 문서를 수동 개입 없이 처리하는 데 적합합니다.
실질적인 제한은 하드웨어입니다. olmOCR 7B 모델을 bfloat16 정밀도로 구동하려면 최소 16GB VRAM을 갖춘 최신 NVIDIA GPU가 필요합니다. CPU나 Apple Silicon에서는 실행할 수 없습니다. 모델 가중치는 약 14GB이며, RTX 4090에서 추론 처리량은 초당 약 2-3페이지로 배치 처리에는 충분하지만 실시간 처리에는 부족합니다.
적합한 용도: 대규모 PDF 디지털화 프로젝트 — 수백만 건의 학술 논문, 정부 서류, 역사 문서 디지털화. 비용 효율성과 자동화된 파이프라인으로 산업 규모의 최강자입니다.
부적합한 용도: NVIDIA GPU 인프라가 없는 팀, 실시간 또는 대화형 OCR 애플리케이션, 경량 배포가 필요한 경우. 깔끔한 문서에서 단순 텍스트를 추출하는 데 7B 모델은 과도합니다.
7. Qwen2.5-VL — OCR에 강한 범용 VLM
알리바바 Qwen 팀이 개발한 Qwen2.5-VL은 시각-언어 모델 제품군으로, OCR을 포함한 다양한 시각 이해 작업에서 뛰어난 성능을 보입니다. olmOCR이나 Surya처럼 문서 처리에 특화되지는 않았지만, 텍스트 인식 및 정보 추출 능력이 탁월한 범용 VLM입니다. 따라서 하나의 모델로 문서에서 특정 필드를 추출하거나, 페이지를 요약하거나, 특정 형식으로 텍스트를 변환하도록 지시할 수 있는 유연성을 제공합니다.
빠른 시작
pip install transformers qwen-vl-utils torch

# Python 사용법 — Hugging Face Transformers 라이브러리 활용
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
model = Qwen2VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-7B-Instruct", torch_dtype="bfloat16"
)
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-7B-Instruct")
# 텍스트 + 이미지 프롬프트로 모델 사용
# "이 송장에서 모든 텍스트를 추출하여 구조화된 필드로 반환해줘"
Qwen2.5-VL의 OCR 성능은 이전 버전보다 크게 향상되어, 다양한 시나리오, 다국어, 다양한 방향의 텍스트 인식이 개선되었습니다. 세로쓰기, 곡선 텍스트, 혼합 언어 페이지도 기존 엔진이 어려워하는 부분을 잘 처리합니다. 72B 버전은 문서 이해 벤치마크에서 GPT-4o 같은 상용 모델과 경쟁하며, 3B 변형은 소비자용 GPU에서도 실행될 만큼 가볍습니다.
Qwen2.5-VL이 특화된 OCR 도구보다 가진 핵심 장점은 유연성입니다. 하나의 출력 형식이나 파이프라인에 제한되지 않고, 특정 필드를 JSON으로 반환하거나, 테이블을 마크다운으로 추출하거나, 문서 구조를 자연어로 설명하도록 모델에 지시할 수 있습니다. 따라서 전체 페이지를 전사하는 대신 특정 데이터 포인트를 타겟팅해야 하는 문서 정보 추출 작업에 이상적입니다. r/LocalLLaMA 커뮤니티에서는 Qwen2.5-VL을 OCR 작업을 위한 선호 범용 모델로 자주 언급하며, 특히 명시적인 추출 지침과 함께 사용할 때 복잡한 레이아웃에서의 정확도가 특화된 OCR 도구를 능가하는 경우가 많다고 보고합니다.
단점은 지연 시간과 비용입니다. 7B 버전도 상당한 GPU 리소스가 필요하며, 72B 버전은 여러 GPU가 필요합니다. 페이지를 밀리초 단위로 처리하는 기존 OCR 엔진과 달리, VLM 기반 추론은 모델 크기와 하드웨어에 따라 페이지당 2~5초가 소요됩니다. 대량 텍스트 전사에는 특화된 OCR 도구가 여전히 더 효율적입니다. 복잡한 문서에서의 타겟 정보 추출에는 Qwen2.5-VL의 유연성이 따라올 수 없습니다.
적합한 용도: 복잡한 문서에서 특정 형식의 특정 필드를 추출하는 타겟 정보 추출. 또한 OCR, 문서 이해, 일반 시각 QA를 하나의 모델로 처리하려는 팀에 이상적입니다.
부적합한 용도: 원시 전사 속도가 중요한 고처리량 대량 OCR, CPU 전용 배포, 또는 GPU 기반 모델 서빙 인프라 대신 가벼운 자체 포함 라이브러리가 필요한 시나리오.
어떤 도구를 선택해야 할까요?
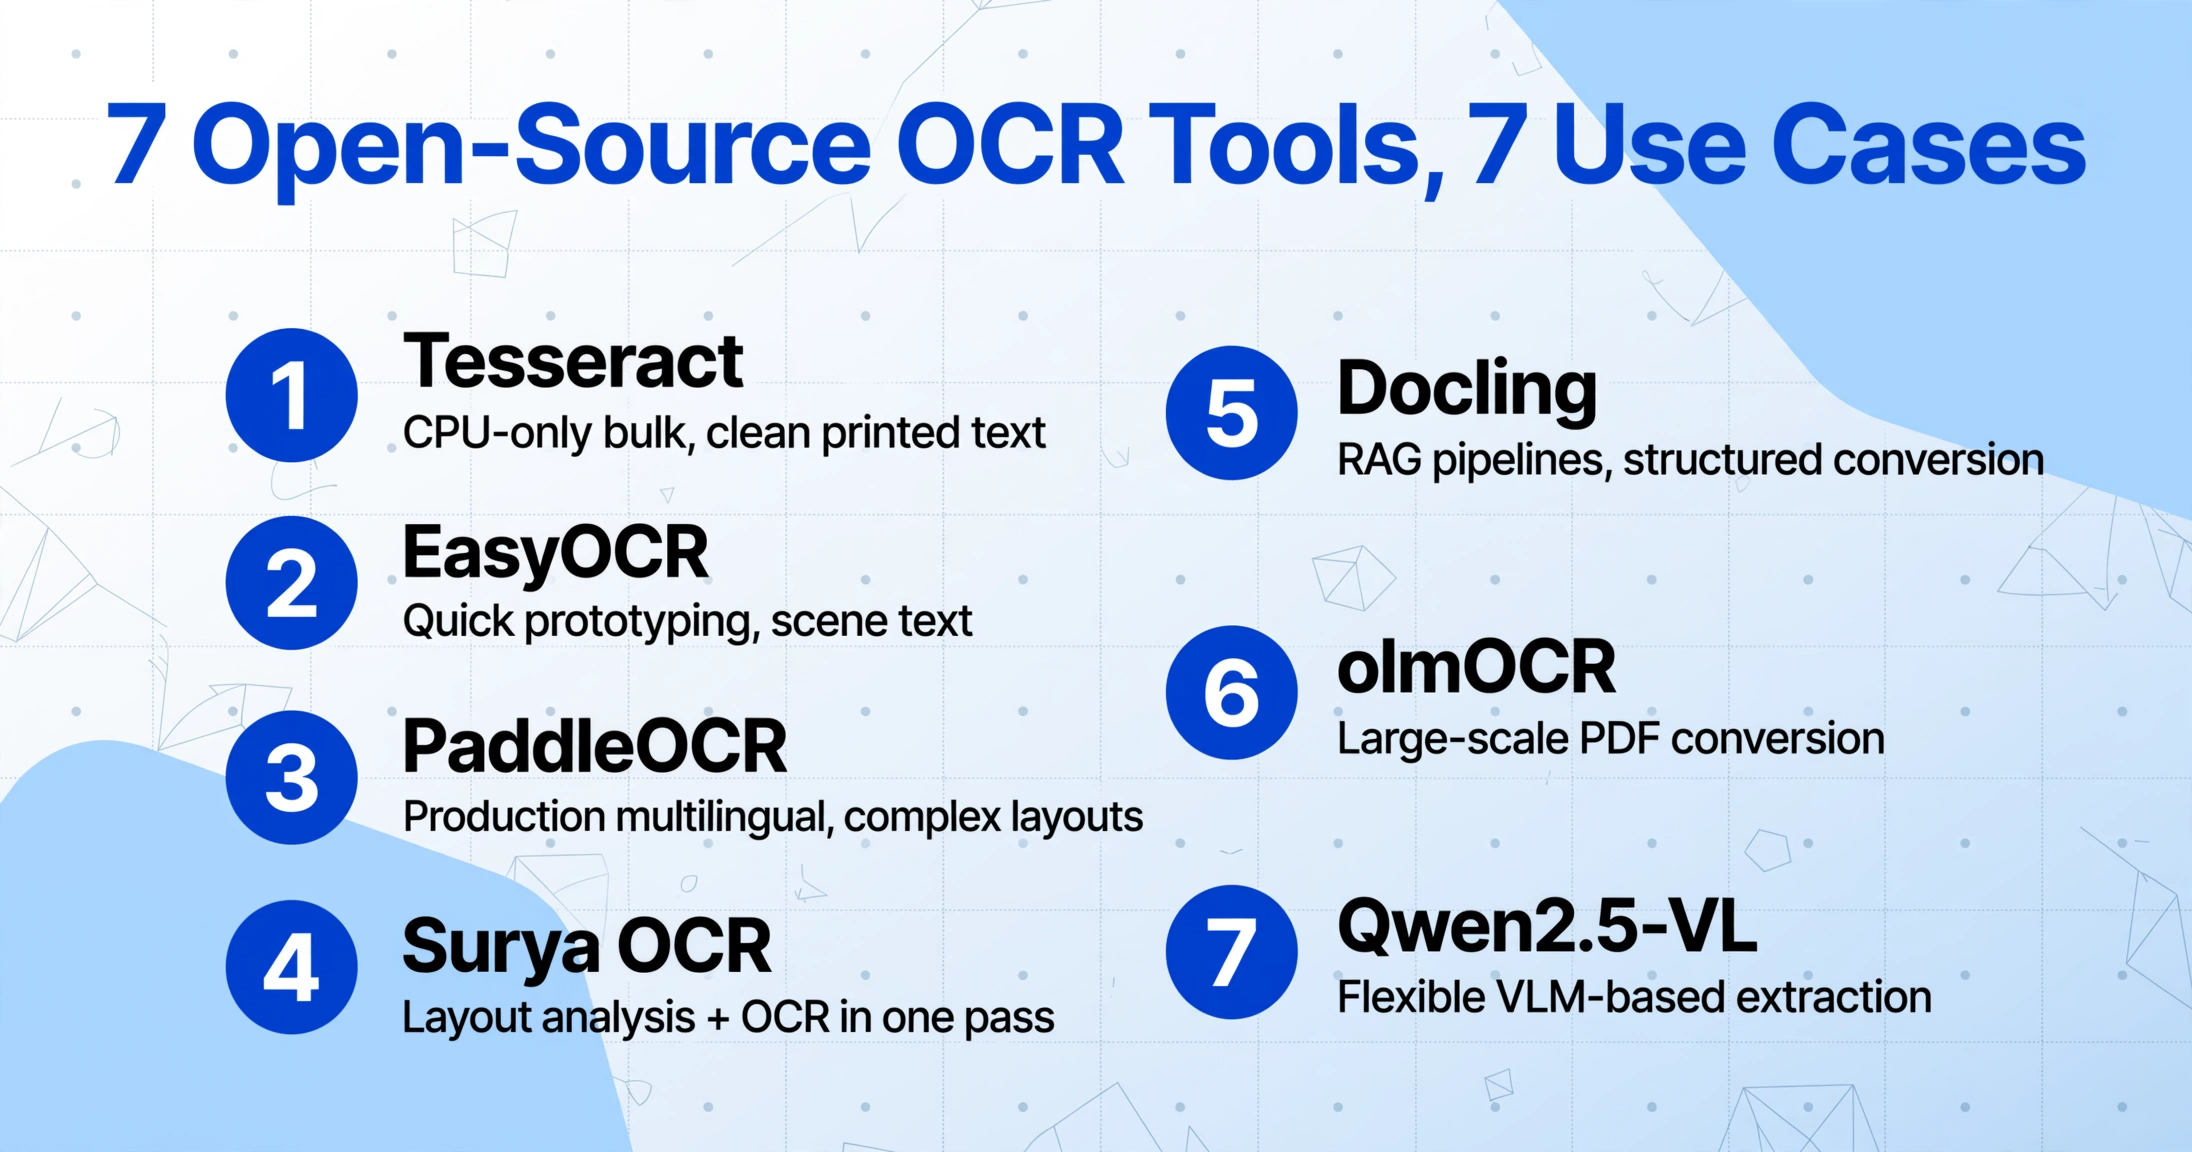
문서가 깨끗한 인쇄 텍스트이고 GPU 없이 대량 처리를 무료로 해야 한다면: Tesseract를 선택하세요. GPU 없이도 모든 하드웨어에서 잘 작동하는 유일한 옵션입니다.
사진 속 다국어 장면 텍스트나 곡선 텍스트에 대한 빠른 프로토타입이 필요하다면: EasyOCR을 선택하세요. 설정은 5분이면 끝나고, 신뢰도 점수 덕분에 후처리가 수월합니다.
GPU에 접근할 수 있고 복잡한 레이아웃을 가진 프로덕션용 다국어 파이프라인을 구축 중이라면: PaddleOCR을 선택하세요. 표 추출, CJK 지원, 처리량 덕분에 가장 강력한 전통적 엔진입니다.
가벼운 모델로 문서 레이아웃 분석과 OCR을 한 번에 처리해야 한다면: Surya OCR을 선택하세요. 650M 파라미터에 레이아웃 인식 출력을 제공하여 VLM 기반 옵션 중 비용 대비 정확도가 가장 우수합니다.
RAG 파이프라인을 구축 중이고 구조화된 문서 변환이 필요하다면: Docling을 선택하세요. LlamaIndex/LangChain 통합과 표 구조 복원 기능이 독보적입니다.
대규모 PDF 디지털화 프로젝트와 GPU 인프라가 있다면: olmOCR을 선택하세요. 페이지당 $190의 비용 효율성은 따라올 자가 없습니다.
특정 필드를 특정 형식으로 모델에 지시하는 유연한 VLM 기반 추출을 원한다면: Qwen2.5-VL을 선택하세요. 3B 변형은 소비자용 GPU에서 실행되고, 72B 변형은 GPT-4o 수준의 이해력과 견줍니다.
솔직한 조언: GPU에 접근할 수 있다면 표, 다단 레이아웃, 혼합 형식이 포함된 문서에는 전통적 엔진을 사용하지 마세요. VLM 기반 접근 방식(Surya, olmOCR, Qwen2.5-VL)이 구조화된 출력을 직접 제공하며, 후처리 글루 코드에 드는 엔지니어링 시간을 GPU 컴퓨팅 비용보다 더 많이 절약해 줍니다. Tesseract와 PaddleOCR은 각각 잘 처리하는 특정 사례를 위해 도구 상자에 보관하되, 2026년 일반 문서 OCR의 기본값으로 삼지는 마세요.
자주 묻는 질문
2026년에도 Tesseract가 여전히 유용한가요?
네, 하지만 특정 용도에 한해서입니다. 구조화되지 않은 출력을 허용하면서 깨끗한 인쇄 텍스트를 대량 처리하는 경우가 해당됩니다. 표, 열, 필기체가 포함된 문서의 경우 최신 대안 도구들이 훨씬 뛰어난 성능을 보입니다. 2026년에도 Tesseract를 선택하는 주된 이유는 하드웨어 요구 사항입니다. 이 목록에서 GPU 없이 CPU에서 효율적으로 실행되는 유일한 도구이기 때문입니다.
"무료 OCR"과 "오픈소스 OCR"의 차이점은 무엇인가요?
무료 OCR(2026년 최고의 무료 OCR 소프트웨어 가이드에서 다룸)에는 무료 온라인 서비스와 상용 무료 티어가 포함됩니다. Google Drive OCR, PDF24, OCR.space, 그리고 Parseur 및 Nanonets 같은 프리미엄(freemium) 도구가 여기에 해당합니다. 오픈소스 OCR은 소스 코드를 직접 확인하고 수정할 수 있는 자체 호스팅 소프트웨어를 의미합니다. 이 글에서 다루는 도구는 모두 오픈소스이며, 자체 인프라에 직접 호스팅하여 설정과 유지보수 비용을 감수하는 대신 무제한 처리가 가능합니다.
이 도구들을 사용하려면 GPU가 필요한가요?
Tesseract는 CPU 전용이며 최신 프로세서에서 원활하게 실행됩니다. EasyOCR과 PaddleOCR은 GPU 가속의 이점을 얻을 수 있지만 CPU에서도 실행됩니다. Surya는 llama.cpp를 통해 CPU 또는 Apple Silicon에서 실행할 수 있지만 성능은 GPU 대비 약 50배 느립니다. olmOCR과 Qwen2.5-VL은 NVIDIA GPU가 필요하며, 7B 모델은 최소 16GB VRAM이 필요합니다. Docling의 앙상블 파이프라인은 GPU의 이점을 얻지만 CPU에서도 간단한 문서를 처리할 수 있습니다.
필기체 인식에 가장 뛰어난 오픈소스 OCR 도구는 무엇인가요?
검토된 도구 중에서 PaddleOCR이 독립 벤치마크에서 약 73%의 정확도로 필기체 인식 분야를 선도합니다. VLM 기반 도구(Surya, olmOCR, Qwen2.5-VL)는 실제 사용에서 더 나은 필기체 인식 성능을 보여주지만, 공개된 벤치마크는 제한적입니다. 심각한 수준의 필기 문서 처리를 위해서는 전용 상용 AI 서비스가 일반적으로 오픈소스 도구보다 훨씬 뛰어난 성능을 제공합니다.
이 도구들을 내 문서로 학습하거나 미세 조정할 수 있나요?
Tesseract는 LSTM 미세 조정 파이프라인을 통한 커스텀 학습을 지원하지만, 각 학습 이미지에 대한 박스 파일 생성이 필요해 과정이 복잡합니다. EasyOCR은 CRNN 아키텍처를 사용한 커스텀 데이터 학습을 지원합니다. PaddleOCR은 가장 접근하기 쉬운 미세 조정 파이프라인을 제공하며, 커스텀 데이터셋에 대한 문서화된 예제가 있습니다. Surya와 Docling은 현재 모델 미세 조정을 지원하지 않으며, 있는 그대로 사용됩니다. olmOCR과 Qwen2.5-VL은 표준 Hugging Face Transformers 도구를 사용하여 미세 조정할 수 있지만, 효과적인 미세 조정에는 상당한 전문성, 데이터 및 GPU 리소스가 필요합니다.
어떤 도구가 표 구조를 가장 잘 보존하나요?
Docling은 전용 TableFormer 모델 덕분에 표 구조 보존에 가장 뛰어나며, 행/열 구조, 병합된 셀, 헤더를 복원합니다. PaddleOCR의 PP-Structure 모듈도 표 추출을 잘 처리합니다. VLM 기반 도구 중에서는 Surya와 olmOCR이 대부분의 일반적인 표 레이아웃에 대해 구조를 보존하는 마크다운 표를 생성합니다.
이 도구들을 상업적으로 사용할 수 있나요?
라이선스 조건은 도구마다 다릅니다. Tesseract(Apache 2.0), EasyOCR(Apache 2.0), PaddleOCR(Apache 2.0), Docling(MIT/Apache 2.0)은 상업적 사용에 완전히 허용적입니다. Surya의 코드는 Apache 2.0이지만, 모델 가중치는 수정된 OpenRAIL-M 라이선스를 사용합니다. olmOCR(Apache 2.0)과 Qwen2.5-VL은 허용적입니다. 배포하려는 버전의 특정 라이선스를 항상 확인하세요 — 모델 라이선스는 코드 라이선스와 다를 수 있습니다.
상용 OCR 도구를 고려해야 하는 경우는 언제인가요?
오픈소스 OCR은 프로토타입 제작과 내부 도구에 탁월합니다. 하지만 필드 수준 데이터 추출, 신뢰할 수 있는 필기 인식, 또는 비기술적 팀원을 위한 설정 없는 워크플로가 필요하다면, 상용 AI 추출 도구가 일반적으로 더 높은 정확도와 더 나은 구조화된 출력을 제공합니다. 현재 상용 옵션을 평가 중이라면, 결정하기 전에 실제 문서를 도구에 실행해 보세요. 오픈소스와 상용 솔루션은 표준화된 벤치마크보다 여러분의 특정 워크플로에 중요한 문서에서 가장 큰 차이를 보입니다.
가장 좋은 OCR 평가는 여러분이 자신의 문서로 직접 실행하는 것입니다. 벤치마크 데이터는 출발점을 제공할 뿐입니다 — 실제 결과는 문서 품질, 레이아웃 복잡성, 목표 출력 형식에 따라 달라집니다.
AI 기반 문서 추출 사용해 보기회원가입이 필요 없습니다. 문서를 업로드하고 최신 AI 추출이 어떤 결과를 만들어내는지 확인하세요.