Die besten Open-Source-OCR-Tools 2026:
Tesseract, EasyOCR, PaddleOCR & mehr
Open-Source-OCR spaltet sich 2026 in zwei getrennte Epochen: traditionelle Pipeline-Engines (Textbereiche erkennen, Zeichen einzeln erkennen, dann die Seite rekonstruieren) und Vision-Language-Modelle (ein Modell betrachtet das gesamte Dokument und liest es wie ein Mensch). Die meisten Übersichten behandeln sie als austauschbare Alternativen. Das sind sie nicht. Die richtige Wahl hängt von deinen Dokumenttypen, deinem Hardware-Budget und davon ab, ob du Rohtext oder strukturierte Ausgabe brauchst. Dieser Leitfaden behandelt sieben reine Open-Source-Tools – keine kommerziellen Produkte, keine Freemium-Stufen – mit den Entwickler-Workflow-Details, die zählen, wenn du eine Pipeline baust und nicht nur einen einmaligen Test ausführst. Wenn du mit den Grundlagen neu bist, behandeln unsere Leitfäden zu was OCR ist, wie sich KI-OCR unterscheidet und wie OCR tatsächlich funktioniert die Grundlagen vor diesem Deep-Dive. Offenlegung: Ich habe keine Verbindung zu einem Tool auf dieser Liste. Jeder externe Link führt zur eigenen Projektseite des Tools oder zu einem unabhängigen Benchmark, damit du Behauptungen überprüfen kannst, bevor du dich für einen Stack entscheidest.
Wichtigste Erkenntnisse
- Sieben Open-Source-OCR-Tools erreichen alle zwischen 95 und 97 Prozent Zeichengenauigkeit bei sauberem englischem Text – fast identische Zahlen, die die Wahl wie einen Münzwurf erscheinen lassen.
- Zeichengenauigkeit ist eine Ablenkungs-Metrik, denn ein 97-Prozent-Ergebnis bei einer zusammengefallenen Tabelle mit zehn Spalten lässt dich die Spalten trotzdem von Hand aus durcheinandergewürfelten Zellen rekonstruieren.
- Die eigentliche Trennung im Jahr 2026 verläuft nicht zwischen Tools, sondern zwischen Epochen – traditionelle Engines, die Zeichen erkennen, versus VLMs, die Dokumente lesen und strukturiertes Markdown mit intakten Tabellen ausgeben.
Schnellvergleichstabelle
Sieben Tools, zwei Architektur-Ären. Die folgende Tabelle zeigt die wichtigsten Unterschiede. In den anschließenden Abschnitten wird das tatsächliche Verhalten jedes Tools detailliert beschrieben – einschließlich Einrichtungszeit, Fehlermodi und Besonderheiten bei der Pipeline-Integration, die in keiner Benchmark-Tabelle erfasst werden.
| Tool | Architektur | Sprachen | GPU nötig? | Layout-Verarbeitung | Am besten geeignet für |
|---|---|---|---|---|---|
| Tesseract | Traditionelles LSTM | 100+ | Nein (nur CPU) | Schwach — verliert Tabellen, Spalten | Sauberer Drucktext, CPU-only Stapelverarbeitung |
| EasyOCR | Traditionelles CRNN | 80+ | Optional (GPU beschleunigt) | Schwach — flache Textausgabe | Schnelles Prototyping, Szenentext |
| PaddleOCR | Traditionelle DL-Pipeline | 80+ (starkes CJK) | Empfohlen für Geschwindigkeit | Gut — Tabellen, Spalten, Formulare | Produktionsreif mehrsprachig, komplexe Layouts |
| Surya OCR | VLM (650M Parameter) | 90+ | Ja (optimal), CPU möglich | Hervorragend — Layout + Tabelle + Lesereihenfolge | Dokument-Layout-Analyse + OCR in einem Modell |
| Docling | Ensemble (VLM + Layout) | Multi (über EasyOCR-Backend) | Empfohlen | Hervorragend — vollständige Dokumentstruktur | RAG-Pipelines, strukturierte Dokumentkonvertierung |
| olmOCR | VLM (7B Parameter) | Multi | Ja (NVIDIA GPU) | Hervorragend — mehrspaltig, Tabellen, Gleichungen | Großflächige PDF-Konvertierung, wissenschaftliche Dokumente |
| Qwen2.5-VL | VLM (3B/7B/72B) | Multi (starkes CJK) | Ja | Hervorragend — flexibles VLM-Lesen | Allgemeine VLM-basierte OCR, benutzerdefinierte Extraktionsaufgaben |
So haben wir bewertet
Dies ist kein Labor-Benchmark. Veröffentlichte Genauigkeitszahlen von Drittanbietern werden zitiert, wo verfügbar (GigaGPUs Vergleich vom April 2026 für Tesseract/EasyOCR/PaddleOCR; Suryas olmOCR-bench-Wert; olmOCRs veröffentlichte Benchmarks), aber die primären Bewertungskriterien hier sind die, die zählen, wenn du einen Stack auswählst:
Wo möglich, gleichen wir auch mit unserem eigenen First-Party-OCR-Benchmark ab — 8 Open-Source-Engines auf derselben RTX 4090, dieselben Belege (SROIE 2019 + CORD v2), dasselbe eingefrorene Protokoll, mit CER/WER, Feld-Extraktions-F1, Latenz und Kosten pro 1.000 Seiten, wobei jede Zahl auf eine veröffentlichte CSV-Zeile zurückgeführt wird. Zwei Erkenntnisse aus diesem Lauf fließen direkt in die folgenden Entscheidungen ein: Bei Zeichengenauigkeit liegt die beste traditionelle Engine (docTR, CER 0,197) gleichauf mit dem besten VLM (Surya2, 0,191) — „VLM ist von Natur aus genauer“ gilt also nicht für sauberen gedruckten Text — und sobald ein LLM-Postprozessor hinzugefügt wird, konvergieren sechs der acht Engines unabhängig von der Familie auf ein Feld-F1-Band von 0,57–0,62. Siehe den Kosten-Benchmark und den Latenz-Benchmark für die Betriebszahlen pro Engine. Das sind unsere Messungen für einen Dokumenttyp; die Zahlen von Drittanbietern unten decken eine breitere Eingabemischung ab.
- Integrationsfläche — wie sauber ist die Python-API, liefert sie strukturierte Daten oder Rohtext, erfordert sie Klebecode
- Hardwall-Anforderungen — welche Hardware musst du bereitstellen, bevor das Tool überhaupt funktioniert (nur CPU vs. GPU-Pflicht)
- Layout-Intelligenz — kann es den Unterschied zwischen einer Tabellenüberschrift und einer Seitenzahl erkennen oder gibt es nur Zeichenströme aus
- Community-Gesundheit — aktuelle Commits, Anzahl offener Issues, Reaktion auf Pull Requests, etabliertes Ökosystem
- Fläche für benutzerdefiniertes Training — kannst du es auf deine eigenen Dokumenttypen feinabstimmen und wie viel Fachwissen erfordert das
Jeder Tool-Link unten führt zum offiziellen GitHub-Repository des Projekts. Alle externen Referenzen sind verlinkt, damit du die Behauptungen selbst überprüfen kannst.
Die zwei Ären der Open-Source-OCR
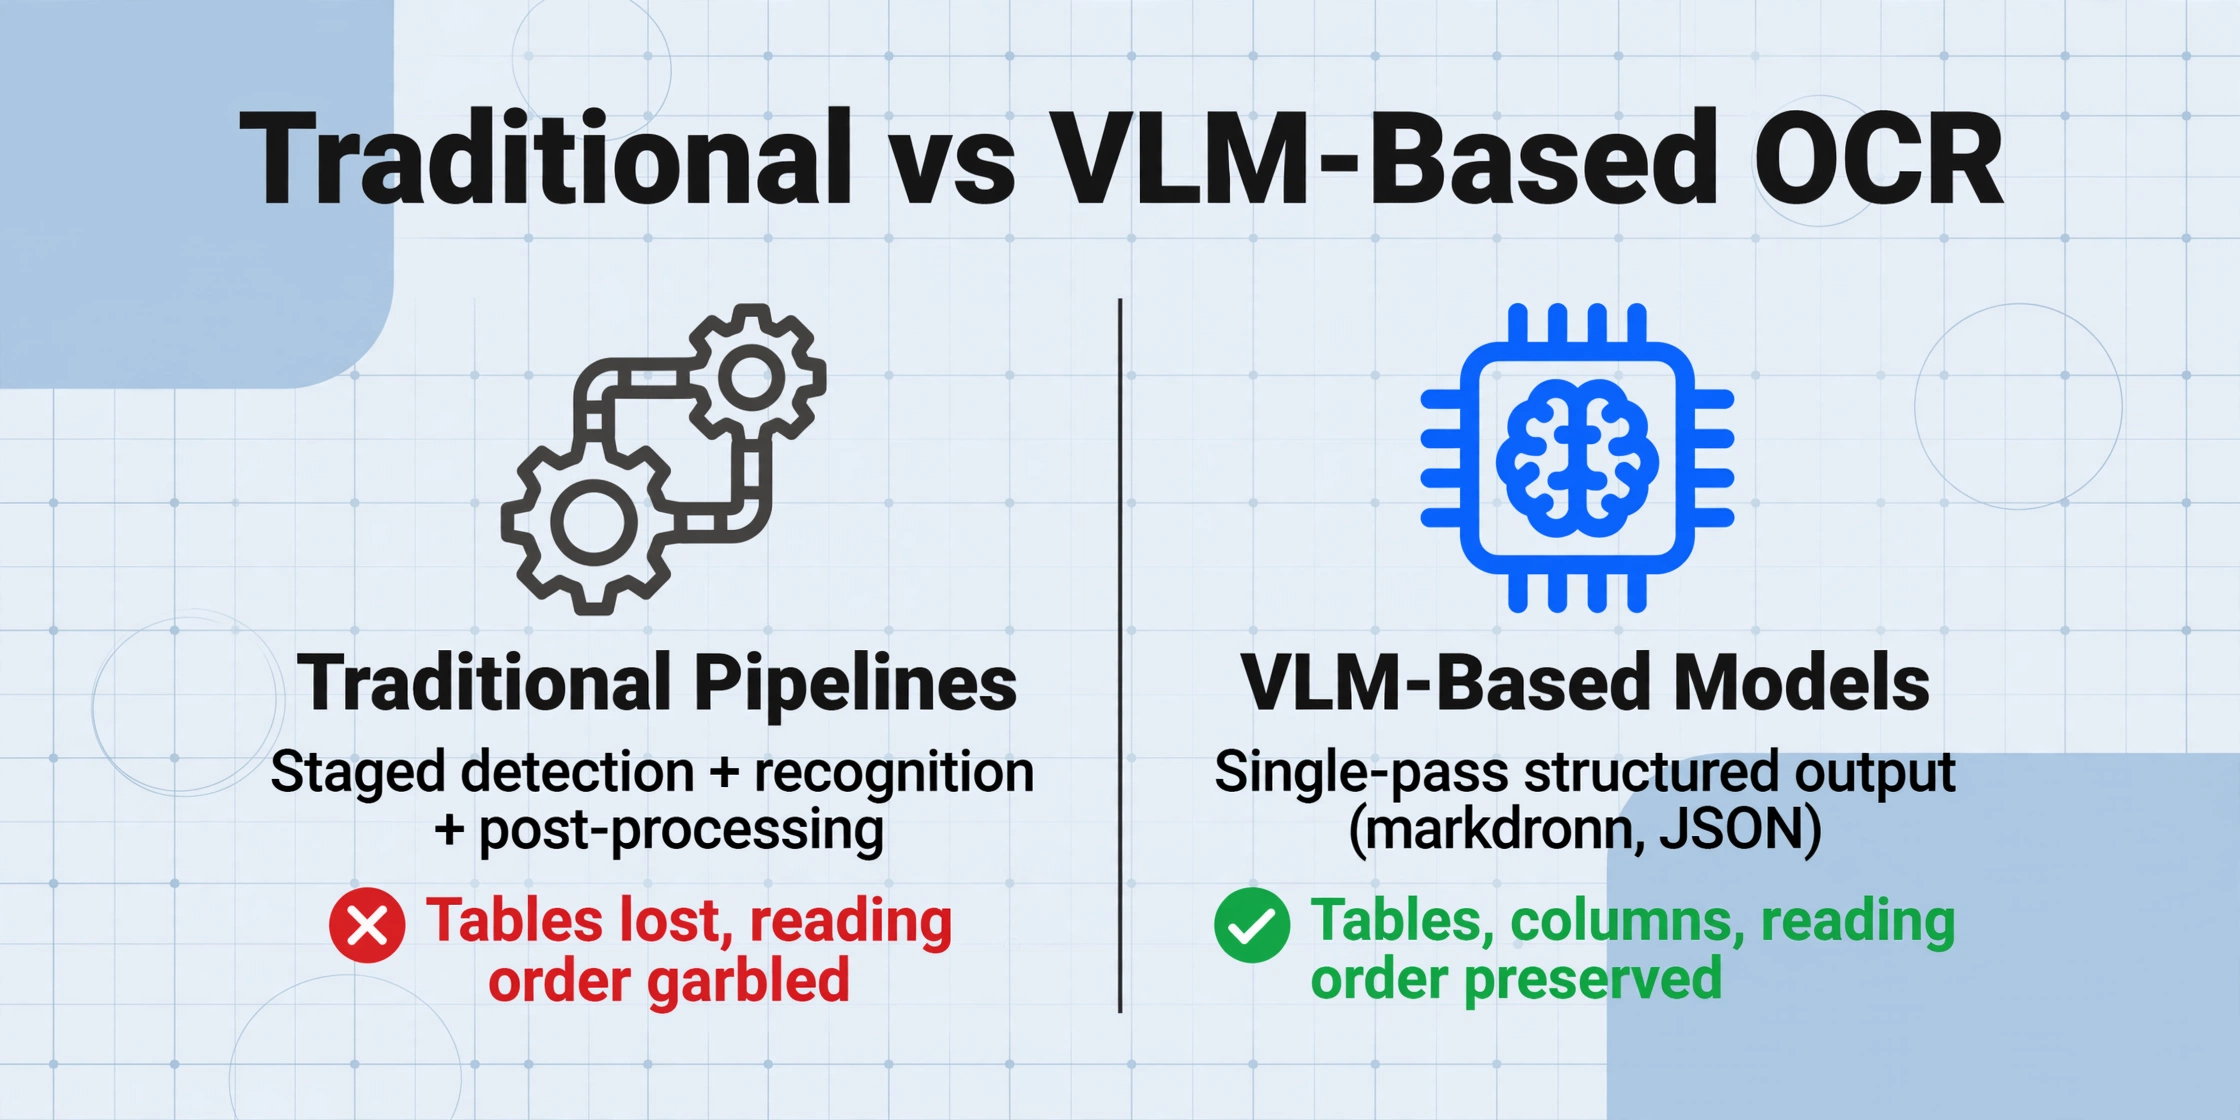
Bevor wir uns einzelnen Tools widmen, hilft es, den architektonischen Bruch zu verstehen, der 2026 zu einem besonders interessanten Jahr für Open-Source-OCR macht.
Traditionelle OCR-Pipelines (Tesseract, EasyOCR, PaddleOCR) arbeiten in Stufen: Ein Texterkennungsmodell findet Textregionen, ein Erkennungsmodell liest jede Region Zeichen für Zeichen, und ein Nachbearbeitungsschritt versucht, die Seitenstruktur zu rekonstruieren. Jede Stufe ist ein separates Modell oder ein separater Algorithmus, und Fehler pflanzen sich fort – eine übersehene Erkennung bedeutet, dass der Recognizer diesen Text nie sieht.
VLM-basierte OCR (Surya, olmOCR, Qwen2.5-VL) behandelt das Lesen von Dokumenten als eine einzige multimodale Aufgabe. Ein Vision-Language-Modell betrachtet das gesamte Seitenbild und erzeugt in einem Durchgang strukturierte Ausgabe – Markdown, JSON oder HTML. Docling liegt dazwischen: Es verwendet Ensemble-Pipelines, die auf spezialisierten Modellen aufbauen, bietet aber eine einheitliche API, die sich VLM-artig anfühlt.
Der praktische Unterschied: Traditionelle Pipelines sind günstiger im Betrieb (CPU-freundlich, kleine Modelle), erfordern aber umfangreichen Nachbearbeitungs-Code, um Tabellen und Lesereihenfolge zu rekonstruieren. VLM-basierte OCR ist GPU-hungrig, liefert aber direkt strukturierte Ausgabe – keine Überraschungen wie „Tabelle verloren“ oder „Spalte A in Spalte B verschmolzen“. Wenn du große Mengen sauberen, gedruckten Texts mit einfachen Layouts verarbeitest, gewinnen traditionelle Engines weiterhin bei den Kosten. Wenn deine Dokumente Tabellen, mehrspaltige Layouts oder gemischte Formatierungen enthalten, spart dir ein VLM-basierter Ansatz mehr Entwicklungszeit, als seine GPU-Kosten ausmachen.
1. Tesseract OCR — Der CPU-Arbeiter
Tesseract ist die älteste und am härtesten getestete Open-Source-OCR-Engine auf dieser Liste. Ursprünglich in den 1980er-Jahren bei Hewlett-Packard entwickelt und seit 2006 von Google gepflegt, unterstützt sie über 100 Sprachen und läuft auf jedem gängigen Betriebssystem. Sie verwendet ein LSTM-basiertes neuronales Netz (seit Version 4) für die Zeichenerkennung und einen traditionellen Seitenzerlegungsalgorithmus für die Layoutanalyse.
Schnellstart
pip install pytesseract
# Oder über den Systempaketmanager: sudo apt install tesseract-ocr

# Python-Nutzung
import pytesseract
from PIL import Image
text = pytesseract.image_to_string(Image.open("invoice.png"), lang="eng")
print(text)
Tesseracts Stärke liegt im kostenlosen CPU-only-Betrieb und im riesigen Ökosystem. Bei sauberem, hochauflösendem Drucktext mit 300 DPI erreicht sie in veröffentlichten Benchmarks etwa 96–97 % Zeichengenauigkeit. Sie verarbeitet auf einer modernen CPU etwa 25 Seiten pro Minute – ganz ohne GPU. Damit ist sie die kosteneffizienteste Option für die Massendigitalisierung von Drucktext. Neu bei der Engine? Unsere Schritt-für-Schritt-Tesseract-Einrichtungsanleitung führt dich in etwa 15 Minuten durch die Installation auf Windows, Mac und Linux sowie durch die typischen Anfängerfallen (inklusive des Windows-PATH-Problems).
Die Einschränkungen sind gut dokumentiert. Tesseract hat kein natives Konzept für Dokumentstruktur – sie gibt flachen Text mit Zeilenumbrüchen aus, die das ursprüngliche Layout nur annähern. Tabellen zerfallen in sequenzielle Textzellen ohne Zeilen-/Spaltenzuordnung. Mehrspaltige Dokumente erzeugen eine verstümmelte Lesereihenfolge. Bei anspruchsvollen Eingaben wie Handyfotos sinkt die Genauigkeit in unabhängigen Tests auf etwa 84 %. Die Handschrifterkennung ist mit rund 45 % Genauigkeit schwach – für Schreibschrift oder gemischte Handschrift praktisch unbrauchbar.
Am besten geeignet für: CPU-only-Massenverarbeitung sauberer Druckdokumente, bei denen flacher Text als Ausgabe tolerierbar ist – etwa für die Digitalisierung von Buchseiten, Archivsuche oder als Vorverarbeitung für NLP-Pipelines.
Nicht ideal für: Dokumente mit Tabellen, mehrspaltigen Layouts, Handschrift, niedrig aufgelösten Fotos oder jedes Szenario, das strukturierte (feldebene) Ausgabe erfordert. Auch nicht ideal, wenn du eine API möchtest – Tesseract ist ein Kommandozeilentool mit einem Python-Wrapper, kein Dienst.
2. EasyOCR – der schnellste Weg zu einer funktionierenden Demo
EasyOCR, entwickelt von Jaided AI auf Basis von PyTorch, ist auf eine Sache ausgelegt: OCR mit minimalem Aufwand zum Laufen zu bringen. Ein Python-Skript mit vier Zeilen verarbeitet ein Bild und liefert erkannten Text mit Konfidenzwerten pro Zeichen. Es unterstützt rund 80 Sprachen, darunter lateinische, CJK-, arabische und Devanagari-Schriften – eine breitere Abdeckung, als die Modellgröße vermuten lässt, weil verschiedene Schriften über eigene Erkennungsköpfe laufen.
Schnellstart
pip install easyocr

# Python usage
import easyocr
reader = easyocr.Reader(["en", "fr"])  # specify languages
results = reader.readtext("receipt.jpg")
for bbox, text, confidence in results:
    print(f"{text} ({confidence:.2f})")
Die Bequemlichkeit von EasyOCR ist sein Hauptvorteil und seine Hauptbeschränkung zugleich. Bei sauberem englischem Drucktext zeigen unabhängige Benchmarks eine Zeichengenauigkeit von etwa 95 % – bei idealen Eingaben leicht unter Tesseract. Aber EasyOCR verarbeitet gekrümmten und rotierten Text deutlich besser (82 % gegenüber 52 % bei Tesseract in den Benchmarks von GigaGPU), was es für reale Fotos nützlicher macht, bei denen das Dokument nicht perfekt ausgerichtet ist.
Der Leistungskompromiss ist real. Auf der CPU ist EasyOCR mit etwa 8 Seiten pro Minute ungefähr 2-3x langsamer als Tesseract. GPU-Beschleunigung (auf einer RTX 3090) bringt es auf etwa 60 Seiten pro Minute – eine 7,5-fache Beschleunigung. Die Modellabhängigkeiten sind mit rund 500 MB ebenfalls schwergewichtiger als die ~10 MB von Tesseract. Handschrift verarbeitet es mit etwa 62 % Genauigkeit – besser als Tesseract, aber für die meisten Handschrift-Workflows immer noch nicht produktionsreif.
Die Reddit-Community r/LocalLLaMA diskutiert EasyOCR häufig als „Instantnudeln der OCR“ – schnelle Ergebnisse mit minimalem Aufwand, aber nicht das Werkzeug, zu dem man greift, wenn Genauigkeit oder Durchsatz am wichtigsten sind. Seine Fehler sind tendenziell vorhersehbar (Zeichensubstitutionen bei ähnlich aussehenden Glyphen) statt des nicht wiederherstellbaren Rauschens, das Tesseract produziert – das bedeutet, dass regex-basierte Nachbearbeitung viele Ergebnisse retten kann.
Am besten geeignet für: Python-Entwickler, die in unter fünf Minuten einen funktionierenden OCR-Prototypen brauchen, besonders für mehrsprachigen Szenentext oder gekrümmten/rotierten Text auf realen Fotos.
Nicht ideal für: Hochvolumige Batch-Verarbeitung auf CPU-only-Hardware, komplexe Dokumentlayouts (Tabellen, Formulare, mehrspaltig) oder Produktionsumgebungen, die strukturierte Feldextraktion erfordern.
Wenn du dich speziell zwischen Tesseract und EasyOCR entscheidest, geht unser Tesseract vs. EasyOCR im direkten Vergleich tiefer auf die Unterschiede ein, die in einer echten Pipeline zählen – Fehlerbehebung, Genauigkeit pro Dokumenttyp und Installationsgewicht.
3. PaddleOCR — Produktionsreife mehrsprachige Texterkennung
Entwickelt von Baidu auf Basis des PaddlePaddle-Frameworks, ist PaddleOCR die funktionsreichste traditionelle Pipeline-Engine in dieser Liste. Im Gegensatz zu Tesseract und EasyOCR, die sich ausschließlich auf die Texterkennung konzentrieren, bietet PaddleOCR Texterkennung, -erkennung, Tabellenextraktion, Layoutanalyse (PP-Structure) und strukturierte Ausgabe in einer einzigen Codebasis. Es hat über 76.000 GitHub-Sterne gesammelt und ist der engste Open-Source-Konkurrent von Tesseract in Bezug auf die Ökosystem-Reife.
Schnellstart
pip install paddlepaddle paddleocr

# Python-Nutzung
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_angle_cls=True, lang="en")
result = ocr.ocr("invoice.png")
for line in result[0]:
    print(f"{line[1][0]} (Konfidenz: {line[1][1]:.2f})")
PaddleOCR führt in allen veröffentlichten Benchmarks für traditionelle Engines in puncto Genauigkeit: 97,2 % bei sauberem gedrucktem Englisch, 91,5 % bei verrauschten gescannten Dokumenten, 88,7 % bei gekrümmtem/rotiertem Text und 72,8 % bei Handschrift. Die CJK-Unterstützung ist besonders stark – angesichts des chinesischen Ursprungs erwartbar – was es zur Standardwahl für Teams macht, die gemischte englisch-chinesische Dokumente oder Workflows mit ostasiatischen Schriften verarbeiten.
Die neuesten Updates im Jahr 2026 waren bedeutend. PP-OCRv6 wurde im Mai 2026 veröffentlicht und verbessert Genauigkeit und Geschwindigkeit weiter. Das PaddleOCR-VL-1.5-Modell (Januar 2026) führt Vision-Language-Fähigkeiten ein, die die Genauigkeit auf 94,5 % im OmniDocBench v1.5-Benchmark steigern – und damit die Lücke zwischen traditionellen Pipelines und VLM-basierten Ansätzen schließen. Die Leistung ist beeindruckend: Auf einer RTX 3090 verarbeitet PaddleOCR etwa 120 Seiten pro Minute, verglichen mit Tesseracts CPU-gebundenen 25 Seiten pro Minute.
Am besten geeignet für: Produktive mehrsprachige OCR-Pipelines, insbesondere solche mit CJK-Schriften, komplexen Layouts mit Tabellen oder verrauschten gescannten Dokumenten. Die Tabellenextraktion via PP-Structure ist wirklich nützlich und in keiner anderen traditionellen Open-Source-Engine verfügbar.
Weniger geeignet für: Schnelle einmalige OCR (die Einrichtung der Abhängigkeiten ist aufwendig), reine CPU-Bereitstellungen (die Leistung sinkt erheblich) oder Teams, die die PaddlePaddle-Framework-Abhängigkeit vermeiden möchten – es handelt sich um eine erhebliche Framework-Bindung im Vergleich zu den portableren PyTorch-basierten Alternativen.
4. Surya OCR — Dokument-Layout-Intelligenz mit unter 1 Mrd. Parametern
Surya OCR, entwickelt von Datalab, ist eine der beeindruckendsten Open-Source-Veröffentlichungen der Jahre 2025–2026. Mit nur 650 Millionen Parametern erreicht es 83,3 % im olmOCR-bench-Benchmark – das beste Ergebnis aller Modelle unter 3 Milliarden Parametern. Es vereint OCR, Layoutanalyse, Lesereihenfolge-Erkennung und Tabellenerkennung in einem einzigen Modell. Die Modellgewichte sind unter der OpenRAIL-M-Lizenz verfügbar (kostenlos für Forschung, private Nutzung und Start-ups mit unter 5 Mio. USD Finanzierung), der Code unterliegt der Apache-2.0-Lizenz.
Schnellstart
pip install surya-ocr

# Python-Nutzung
from surya import OCR
from PIL import Image
ocr = OCR()
result = ocr.recognize([Image.open("rechnung.png")])
for text_line in result[0].text_lines:
    print(text_line.text)
Architektonisch interessant an Surya ist der einheitliche Ansatz. Anders als klassische Pipelines, die Erkennung → Texterkennung → Layoutanalyse als separate Modelle verketten, nutzt Surya ein Vision-Language-Modell als Inferenz-Backend (bereitgestellt über vLLM auf GPU oder llama.cpp auf CPU/Apple Silicon). Dadurch erhält es ein strukturelles Verständnis, das herkömmlichen Engines fehlt. Der SuryaInferenceManager startet automatisch das passende Backend, und die API liefert reich annotiertes JSON mit Bounding-Boxen, Konfidenzwerten und semantischen Bereichsbezeichnern (Kopfzeilen, Tabellen, Bilder, Textblöcke).
Die Leistung ist konkurrenzfähig: Surya verarbeitet etwa 5 Seiten pro Sekunde auf einer RTX 5090 (42 Seiten/min bei typischen Workloads) und läuft auf Apple Silicon via Metal mit etwa 0,1 Seiten pro Sekunde – brauchbar für gelegentliche Dokumente, aber nicht für Stapelverarbeitung. Es unterstützt 91 Sprachen, darunter eine starke Abdeckung asiatischer Schriften. Die Hauptbeschränkung: Surya ist für Dokumente konzipiert, nicht für allgemeine Fotos – es tut sich schwer mit Nicht-Dokument-Bildern und ignoriert möglicherweise werbeähnliche Bereiche, die sein Erkennungsmodell zu überspringen gelernt hat.
Am besten geeignet für: Teams, die Dokument-Layoutanalyse und OCR in einem Modell benötigen, ohne die Komplexität mehrstufiger Pipelines. Die layoutbewusste Ausgabe (JSON mit Bounding-Boxen, Bereichstypen und Lesereihenfolge) ist ideal für nachgelagerte Dokumenten-Intelligenz-Workflows.
Nicht ideal für: Allgemeine Foto-OCR (spezialisiert auf Dokumente), GPU-arme Umgebungen (CPU-Leistung ist deutlich langsamer) oder Szenarien, die eine großzügige kommerzielle Lizenzierung der Modellgewichte erfordern.
5. Docling – Dokumentenkonvertierung für RAG-Pipelines
Docling, entwickelt von IBM Research und zur LF AI & Data Foundation beigetragen, ist keine OCR-Engine im herkömmlichen Sinne. Es ist ein Dokumentenkonvertierungs-Toolkit, das PDFs, DOCX, PPTX und Bilder verarbeitet und strukturiertes JSON, Markdown oder DocTags ausgibt – ein universelles Auszeichnungsformat, das Layout, Tabellen, Formeln und Lesereihenfolge erfasst. Es hat über 20.000 GitHub-Sterne erreicht und wird produktiv von NVIDIA (optimiert für RTX-PCs) sowie innerhalb der IBM Watsonx-Plattform eingesetzt.
Schnellstart
pip install docling

# Python-Nutzung
from docling.document_converter import DocumentConverter
converter = DocumentConverter()
doc = converter.convert("document.pdf")
print(doc.export_to_markdown())  # Strukturierte Markdown-Ausgabe
print(doc.export_to_dict())      # Vollständige JSON-Darstellung
Doclings Architektur kombiniert zwei spezialisierte IBM-Modelle: ein Layout-Analyse-Modell, trainiert auf ~81.000 manuell annotierten Seiten (Patente, Handbücher, 10-K-Einreichungen) zur Identifizierung von Dokumentelementen, und TableFormer zur Wiederherstellung der Tabellenstruktur. Für gescannte Dokumente integriert es EasyOCR als OCR-Backend. Die Pipeline gibt ein DoclingDocument aus – eine Pydantic-basierte Darstellung, die Seitenhierarchie, Tabellenzellen mit Zeilen-/Spaltenindizes, Bildpositionen mit Bildunterschriften und mathematische Formeln in LaTeX bewahrt.
Doclings wahre Stärke liegt im Integrations-Ökosystem. Es lässt sich direkt in LlamaIndex und LangChain für RAG-Pipelines einbinden, und NVIDIA dokumentiert 4-fache Leistungssteigerungen beim Ausführen von Docling auf RTX-PCs im Vergleich zur CPU. IBM veröffentlichte 2026 zudem Granite-Docling-258M (Apache 2.0) – ein einzelnes VLM mit 258M Parametern, das End-to-End-Dokumentenverständnis in einem Durchlauf ermöglicht und den Ensemble-Pipeline-Ansatz ergänzt.
Am besten geeignet für: Teams, die RAG-Pipelines aufbauen und verschiedene Dokumentformate in LLM-bereite, strukturierte Daten konvertieren müssen. Die Kombination aus Layouterhaltung, Tabellenstruktur-Wiederherstellung und direkter LangChain/LlamaIndex-Integration ist unter Open-Source-Tools einzigartig.
Weniger geeignet für: Szenarien, die reine OCR-Textausgabe ohne Dokumentstruktur erfordern, oder Teams, die eine schlanke Abhängigkeit benötigen – Docling bringt erhebliche Modellgewichte mit sich und erfordert einen aufwändigen Setup für GPU-Einsatz.
6. olmOCR — Hochvolumige PDF-Konvertierung im Industriemaßstab
olmOCR, entwickelt vom Allen Institute for AI (Ai2), ist ein auf 7 Milliarden Parametern basierendes VLM, das speziell für die Dokumenten-OCR optimiert wurde. Es baut auf Qwen2-VL-7B auf und wurde mit dem Datensatz olmOCR-mix-0225 trainiert — 250.000 Seiten, die mit GPT-4o und einer Technik namens Document Anchoring annotiert wurden, welche die Extraktionsqualität durch die Nutzung von eingebettetem PDF-Text und Metadaten verbessert. Das Modell und der Code sind vollständig quelloffen, und Ai2 hat eine transparente Dokumentation der Trainingsdaten und Methodik veröffentlicht.
Schnellstart
pip install olmocr

# Python-Nutzung
from olmocr.data.renderpdf import render_pdf_to_base64png
from olmocr.prompts import build_finetuning_prompt
# PDF-Seite verarbeiten – das Toolkit übernimmt Rendering und Prompting
image_b64 = render_pdf_to_base64png("document.pdf", page=1)
# An das Modell über den bevorzugten vLLM- oder SGLang-Server übergeben
Die herausragende Kennzahl von olmOCR sind die Inferenzkosten: Ai2 gibt an, dass olmOCR eine Million PDF-Seiten für etwa 190 US-Dollar konvertieren kann – bei optimierter SGLang-Inferenz –, was etwa 1/32 der Kosten für die gleiche Aufgabe mit GPT-4o entspricht. Damit ist es die kosteneffizienteste Option für groß angelegte Digitalisierungsprojekte, sofern die GPU-Infrastruktur für ein 7B-Modell vorhanden ist.
Die Leistung im olmOCR-bench-Benchmark erreicht insgesamt 82,4 % (für die Version olmOCR-2-7B-1025, veröffentlicht im Oktober 2025), mit starken Ergebnissen bei mathematischen Gleichungen, dichten Tabellen und mehrspaltigen Layouts. Das Modell unterstützt automatisches Seiten-Rendering, Rotationskorrektur und Wiederholungslogik über das olmOCR-Toolkit und eignet sich daher für die Verarbeitung von Millionen heterogener Dokumente ohne manuellen Eingriff.
Die praktische Einschränkung ist die Hardware. olmOCR benötigt eine aktuelle NVIDIA-GPU mit mindestens 16 GB VRAM für das 7B-Modell in bfloat16-Genauigkeit. Es läuft weder auf der CPU noch auf Apple Silicon (obwohl Community-GGUF-Quantisierungen für das Basis-Qwen-Modell existieren). Die Modellgewichte betragen etwa 14 GB, und der Inferenzdurchsatz liegt bei etwa 2-3 Seiten pro Sekunde auf einer RTX 4090 – schnell genug für die Stapelverarbeitung, aber nicht für Echtzeitanwendungen.
Am besten geeignet für: Groß angelegte PDF-Digitalisierungsprojekte – denken Sie an die Digitalisierung von Millionen wissenschaftlicher Arbeiten, behördlicher Einreichungen oder historischer Dokumente. Die Kosteneffizienz (190 $/Million Seiten) und die automatisierte Pipeline machen es zum Champion im Industriemaßstab.
Nicht ideal für: Teams ohne NVIDIA-GPU-Infrastruktur, Echtzeit- oder interaktive OCR-Anwendungen oder Anwendungsfälle, die eine schlanke Bereitstellung erfordern. Das 7B-Modell ist für die einfache Textextraktion aus sauberen Dokumenten überdimensioniert.
7. Qwen2.5-VL — Das universelle VLM mit exzellenter OCR
Qwen2.5-VL, entwickelt vom Qwen-Team bei Alibaba, ist eine Familie von Vision-Language-Modellen (3B, 7B und 72B Parameter), die bei visuellen Verständnisaufgaben – inklusive OCR – starke Leistungen zeigt. Obwohl es nicht speziell für die Dokumentenverarbeitung wie olmOCR oder Surya entwickelt wurde, ist es ein universelles VLM mit hervorragender Texterkennung und Informationsextraktion. Das macht es besonders flexibel: Mit demselben Modell können Sie bestimmte Felder aus einem Dokument extrahieren, eine Seite zusammenfassen oder Text in einem bestimmten Format transkribieren.
Schnellstart
pip install transformers qwen-vl-utils torch

# Python-Nutzung – mit der Hugging Face Transformers Bibliothek
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
model = Qwen2VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-7B-Instruct", torch_dtype="bfloat16"
)
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-7B-Instruct")
# Modell mit Text- und Bild-Prompts verwenden
# "Extrahiere den gesamten Text aus dieser Rechnung und gib ihn als strukturierte Felder zurück"
Die OCR-Fähigkeiten von Qwen2.5-VL wurden gegenüber dem Vorgänger deutlich verbessert, mit besserer Texterkennung in verschiedenen Szenarien, Sprachen und Ausrichtungen. Es verarbeitet vertikalen Text, gebogenen Text und Seiten mit gemischten Sprachen, an denen traditionelle Engines scheitern. Die 72B-Version konkurriert mit kommerziellen Modellen wie GPT-4o bei Dokumentenverständnis-Benchmarks, während die 3B-Variante klein genug ist, um auf Consumer-GPUs (ca. 6 GB VRAM) zu laufen.
Der Hauptvorteil von Qwen2.5-VL gegenüber spezialisierten OCR-Tools ist die Flexibilität. Sie sind nicht auf ein Ausgabeformat oder eine Pipeline beschränkt – Sie können das Modell anweisen, JSON mit bestimmten Feldern zurückzugeben, Tabellen als Markdown zu extrahieren oder die Dokumentstruktur in natürlicher Sprache zu beschreiben. Das macht es ideal für die Extraktion von Informationen aus Dokumenten, bei der Sie gezielt bestimmte Datenpunkte abfragen möchten, anstatt die gesamte Seite zu transkribieren. Die r/LocalLLaMA-Community diskutiert Qwen2.5-VL häufig als bevorzugtes universelles Modell für OCR-Aufgaben, wobei Nutzer berichten, dass seine Genauigkeit bei komplexen Layouts oft spezialisierte OCR-Tools übertrifft, insbesondere bei expliziten Extraktionsanweisungen.
Der Nachteil sind Latenz und Kosten. Selbst die 7B-Version benötigt erhebliche GPU-Ressourcen, und die 72B-Version erfordert mehrere GPUs. Im Gegensatz zu traditionellen OCR-Engines, die eine Seite in Millisekunden verarbeiten, dauert die VLM-basierte Inferenz 2–5 Sekunden pro Seite, abhängig von Modellgröße und Hardware. Für die Massentexttranskription bleiben spezialisierte OCR-Tools effizienter. Für die gezielte Informationsextraktion aus komplexen Dokumenten ist die Flexibilität von Qwen2.5-VL unübertroffen.
Am besten geeignet für: Gezielte Informationsextraktion aus komplexen Dokumenten – das Modell wird angewiesen, bestimmte Felder in einem bestimmten Format zu extrahieren. Auch ideal für Teams, die ein Modell für OCR, Dokumentenverständnis und allgemeine visuelle Fragen/Antworten benötigen.
Nicht ideal für: Hochdurchsatz-Bulk-OCR, bei dem die reine Transkriptionsgeschwindigkeit zählt, reine CPU-Bereitstellungen oder Szenarien, in denen eine leichte, eigenständige Bibliothek statt einer GPU-gestützten Modell-Serving-Infrastruktur benötigt wird.
Welches Tool solltest du wählen?
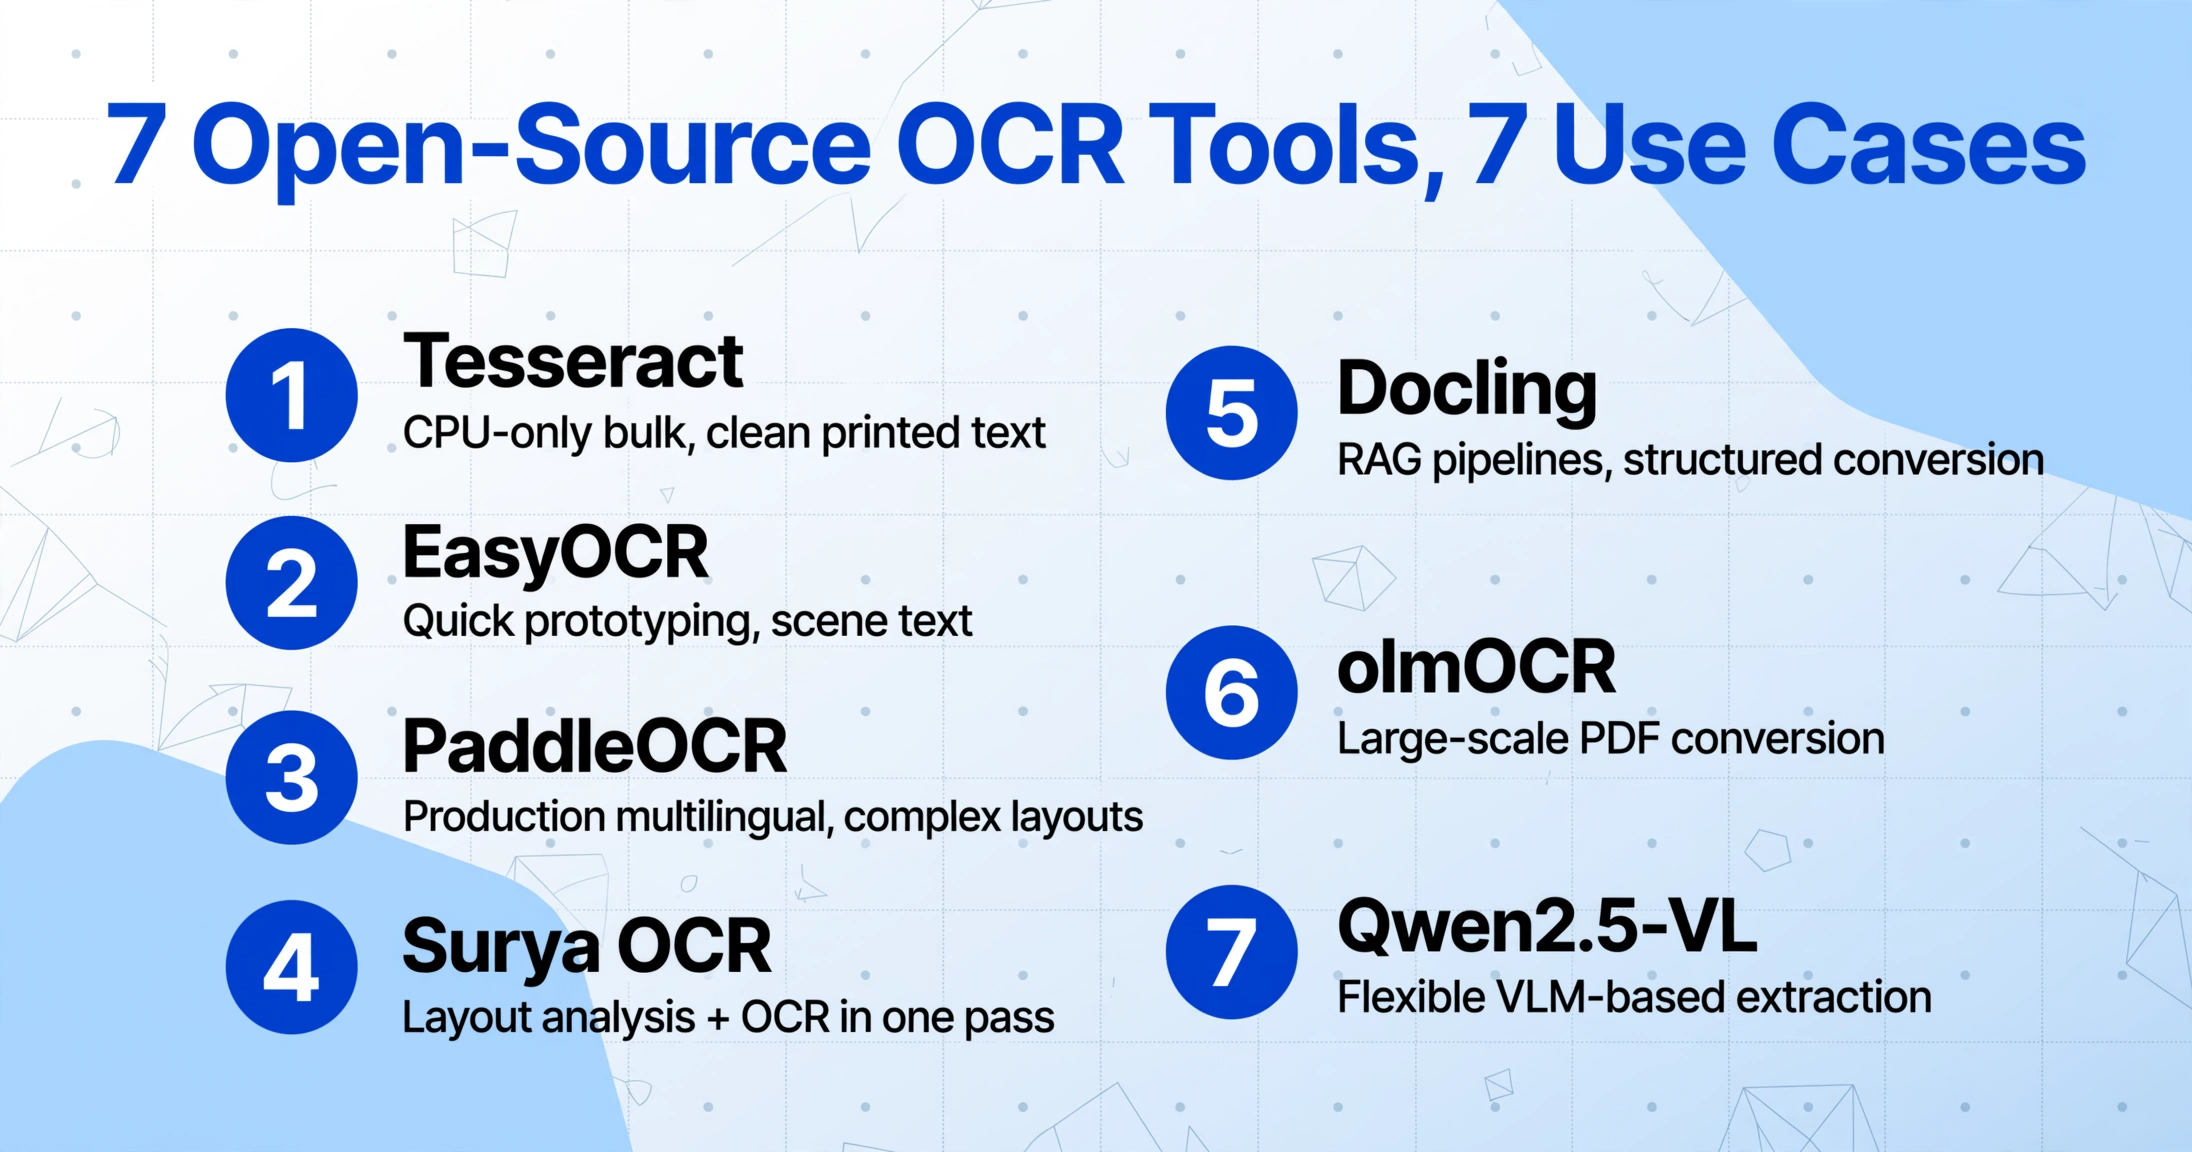
Wenn deine Dokumente sauberer gedruckter Text sind und du eine reine CPU-Batch-Verarbeitung zu null Kosten benötigst: Tesseract. Es ist die einzige Option, die ohne GPU und auf jeder Hardware gut funktioniert.
Wenn du einen schnellen Prototypen für mehrsprachigen Szenentext oder gekrümmten Text aus Fotos benötigst: EasyOCR. Die Einrichtung dauert fünf Minuten und die Konfidenzwerte machen die Nachbearbeitung handhabbar.
Wenn du eine produktionsreife mehrsprachige Pipeline mit komplexen Layouts aufbaust und Zugriff auf eine GPU hast: PaddleOCR. Seine Tabellenextraktion, CJK-Unterstützung und der Durchsatz (120 Seiten/min auf der GPU) machen es zur leistungsfähigsten traditionellen Engine.
Wenn du Dokument-Layout-Analyse und OCR in einem Durchgang mit einem leichtgewichtigen Modell benötigst: Surya OCR. Mit 650M Parametern und layoutbewusster Ausgabe ist es der beste Kompromiss aus Kosten und Genauigkeit unter den VLM-basierten Optionen.
Wenn du RAG-Pipelines aufbaust und eine strukturierte Dokumentkonvertierung benötigst: Docling. Die LlamaIndex/LangChain-Integration und die Wiederherstellung der Tabellenstruktur sind einzigartig.
Wenn du ein groß angelegtes PDF-Digitalisierungsprojekt (Millionen von Seiten) und GPU-Infrastruktur hast: olmOCR. Die Kosteneffizienz von $190/Millionen Seiten ist unübertroffen.
Wenn du eine flexible VLM-basierte Extraktion wünschst, bei der du das Modell nach bestimmten Feldern in bestimmten Formaten fragst: Qwen2.5-VL. Die 3B-Variante läuft auf Consumer-GPUs und die 72B-Variante konkurriert mit dem Verständnis auf GPT-4o-Niveau.
Die ehrliche Einschätzung: Wenn du Zugriff auf eine GPU hast, überspringe traditionelle Engines für jedes Dokument mit Tabellen, mehrspaltigen Layouts oder gemischter Formatierung. Ein VLM-basierter Ansatz (Surya, olmOCR oder Qwen2.5-VL) liefert direkt strukturierte Ausgaben und spart mehr Entwicklungszeit bei der Nachbearbeitung als er an GPU-Rechenleistung kostet. Behalte Tesseract und PaddleOCR in deinem Werkzeugkasten für die engen Fälle, die sie gut abdecken – sauberer Massentext bzw. Hochdurchsatz-CJK – aber setze sie im Jahr 2026 nicht standardmäßig für allgemeine Dokumenten-OCR ein.
Häufig gestellte Fragen
Ist Tesseract im Jahr 2026 noch relevant?
Ja, aber nur für einen bestimmten Anwendungsfall: Massenverarbeitung von sauberem, gedrucktem Text, bei dem du flache (unstrukturierte) Ausgaben tolerieren kannst. Bei Dokumenten mit Tabellen, Spalten oder Handschrift sind moderne Alternativen deutlich leistungsfähiger. Der Hauptgrund, 2026 weiterhin Tesseract zu wählen, ist die Hardware-Anforderung — es ist das einzige Tool auf dieser Liste, das effizient auf der CPU ohne GPU läuft.
Was ist der Unterschied zwischen „kostenloser OCR“ und „Open-Source-OCR“?
Kostenlose OCR (behandelt in unserem Best Free OCR Software 2026-Leitfaden) umfasst kostenlose Online-Dienste und kommerzielle Free-Tiers — Google Drive OCR, PDF24, OCR.space sowie Freemium-Tools wie Parseur und Nanonets. Open-Source-OCR bezeichnet selbst gehostete Software mit Quellcode, den du einsehen und ändern kannst. Die Tools in diesem Artikel sind alle Open-Source, das heißt, du hostest sie auf deiner eigenen Infrastruktur, was dir unbegrenzte Verarbeitung zum Preis von Einrichtung und Wartung bietet.
Brauche ich eine GPU für diese Tools?
Tesseract ist CPU-only und läuft gut auf jedem modernen Prozessor. EasyOCR und PaddleOCR profitieren von GPU-Beschleunigung, können aber auch auf der CPU laufen (langsam). Surya läuft auf CPU oder Apple Silicon über llama.cpp, ist aber etwa 50x langsamer als mit GPU. olmOCR und Qwen2.5-VL benötigen eine NVIDIA-GPU — die 7B-Modelle brauchen mindestens 16 GB VRAM. Doclings Ensemble-Pipeline profitiert von einer GPU, kann aber einfachere Dokumente auch auf der CPU verarbeiten.
Welches Open-Source-OCR-Tool verarbeitet Handschrift am besten?
Unter den getesteten Tools liegt PaddleOCR bei der Handschrifterkennung mit etwa 73 % Genauigkeit in unabhängigen Benchmarks vorn (vs. 45 % bei Tesseract und 62 % bei EasyOCR). Die VLM-basierten Tools (Surya, olmOCR, Qwen2.5-VL) zeigen in der Praxis eine bessere Handschrifterkennung, auch wenn veröffentlichte Benchmarks begrenzt sind. Für die ernsthafte Verarbeitung handschriftlicher Dokumente übertreffen spezialisierte kommerzielle KI-Dienste Open-Source-Tools in der Regel deutlich.
Kann ich diese Tools mit eigenen Dokumenten trainieren oder verfeinern?
Tesseract unterstützt benutzerdefiniertes Training über die LSTM-Feinabstimmungspipeline, der Prozess ist jedoch aufwendig und erfordert die Erstellung von Box-Dateien für jedes Trainingsbild. EasyOCR ermöglicht Training mit benutzerdefinierten Daten unter Verwendung der CRNN-Architektur. PaddleOCR bietet die zugänglichste Feinabstimmungspipeline mit dokumentierten Beispielen für benutzerdefinierte Datensätze. Surya und Docling unterstützen derzeit keine Modellfeinabstimmung – sie werden unverändert verwendet. olmOCR und Qwen2.5-VL können mit den Standard-Tools von Hugging Face Transformers feinabgestimmt werden, was jedoch umfangreiches Fachwissen, Daten und GPU-Ressourcen erfordert.
Welches Tool bewahrt die Tabellenstruktur am besten?
Docling bietet die beste Tabellenstrukturerhaltung dank seines speziellen TableFormer-Modells, das Zeilen-/Spaltenstruktur, verbundene Zellen und Kopfzeilen wiederherstellt. Das PP-Structure-Modul von PaddleOCR verarbeitet Tabellenextraktion ebenfalls gut. Unter den VLM-basierten Tools erzeugen Surya und olmOCR Markdown-Tabellen, die die Struktur für die gängigsten Tabellenlayouts bewahren.
Kann ich diese Tools kommerziell nutzen?
Die Lizenzbedingungen variieren je nach Tool. Tesseract (Apache 2.0), EasyOCR (Apache 2.0), PaddleOCR (Apache 2.0) und Docling (MIT/Apache 2.0) sind vollständig für die kommerzielle Nutzung freigegeben. Der Code von Surya ist Apache 2.0, aber die Modellgewichte verwenden eine modifizierte OpenRAIL-M-Lizenz (kostenlos für Startups mit weniger als 5 Mio. USD Finanzierung/Umsatz – eine breitere kommerzielle Nutzung erfordert eine kostenpflichtige Lizenz). olmOCR (Apache 2.0) und Qwen2.5-VL (Apache 2.0 für die 7B/72B-Varianten, benutzerdefiniert für die 3B-Variante) sind freizügig. Überprüfen Sie stets die spezifische Lizenz der Version, die Sie einsetzen möchten – Modelllizenzen können von Codelizenzen abweichen.
Wann sollte ich stattdessen ein kommerzielles OCR-Tool in Betracht ziehen?
Open-Source-OCR eignet sich hervorragend für Prototypen und interne Tools. Wenn Sie jedoch eine Extraktion auf Feldebene (nicht nur Texttranskription), zuverlässige Handschrifterkennung oder einen Workflow ohne Einrichtungsaufwand für nicht-technische Teammitglieder benötigen, liefern kommerzielle KI-Extraktionstools in der Regel höhere Genauigkeit und besser strukturierte Ausgaben. Wenn Sie derzeit kommerzielle Optionen evaluieren, testen Sie Ihre tatsächlichen Dokumente mit einem Tool, bevor Sie sich festlegen – Open-Source- und kommerzielle Lösungen unterscheiden sich am meisten bei den Dokumenten, die für Ihren spezifischen Workflow wichtig sind, nicht bei standardisierten Benchmarks.
Die beste OCR-Bewertung ist die, die du mit deinen eigenen Dokumenten durchführst. Benchmark-Daten geben dir einen Ausgangspunkt – die tatsächlichen Ergebnisse hängen von deiner Dokumentqualität, der Layout-Komplexität und dem gewünschten Ausgabeformat ab.
KI-gestützte Dokumentextraktion ausprobierenKeine Anmeldung erforderlich. Lade ein Dokument hoch und sieh, was moderne KI-Extraktion leisten kann.