Meilleurs outils OCR open source 2026 :
Tesseract, EasyOCR, PaddleOCR et au-delà
L'OCR open source en 2026 se divise en deux époques distinctes : les moteurs de pipeline traditionnels (détectent les zones de texte, reconnaissent les caractères un par un, puis reconstruisent la page) et les modèles vision-langage (un seul modèle regarde le document entier et le lit comme le ferait un humain). La plupart des comparatifs les traitent comme des alternatives interchangeables. Ils ne le sont pas. Le bon choix dépend de vos types de documents, de votre budget matériel, et de si vous avez besoin de texte brut ou de sortie structurée. Ce guide couvre sept outils open source purs — aucun produit commercial, aucun palier freemium — avec les détails de workflow développeur qui comptent quand vous construisez un pipeline, pas seulement quand vous lancez un test ponctuel. Si vous débutez sur les fondamentaux, nos guides sur ce qu'est l'OCR, en quoi l'OCR par IA diffère, et comment l'OCR fonctionne réellement couvrent les bases avant cette analyse approfondie. Divulgation : je n'ai aucune affiliation avec aucun outil de cette liste. Chaque lien externe mène à la page du projet de l'outil ou à un benchmark indépendant pour que vous puissiez vérifier les affirmations avant de vous engager sur une pile technique.
Points clés à retenir
- Sept outils OCR open source obtiennent tous entre 95 et 97 pour cent de précision de caractères sur du texte anglais propre — des chiffres quasi identiques qui rendent le choix comparable à un pile ou face.
- La précision de caractères est une métrique trompeuse car un score de 97 pour cent sur un tableau à dix colonnes effondré vous laisse quand même reconstruire les colonnes à partir de cellules mélangées à la main.
- La vraie division en 2026 n'est pas entre les outils mais entre les époques — les moteurs traditionnels qui détectent les caractères versus les VLM qui lisent les documents et produisent du markdown structuré avec les tableaux déjà intacts.
Tableau de comparaison rapide
Sept outils, deux ères architecturales. Le tableau ci-dessous présente les différences principales. Les sections suivantes détaillent le comportement réel de chaque outil — temps d'installation, modes de défaillance et particularités d'intégration de pipeline qu'aucun tableau de référence ne capture.
| Outil | Architecture | Langues | GPU requis ? | Gestion de la mise en page | Idéal pour |
|---|---|---|---|---|---|
| Tesseract | LSTM traditionnel | 100+ | Non (CPU uniquement) | Faible — perd tableaux, colonnes | Texte imprimé propre, traitement CPU en masse |
| EasyOCR | CRNN traditionnel | 80+ | Optionnel (GPU accélère) | Faible — sortie texte plat | Prototypage rapide, texte de scène |
| PaddleOCR | Pipeline DL traditionnel | 80+ (CJK fort) | Recommandé pour la vitesse | Bon — tableaux, colonnes, formulaires | Production multilingue, mises en page complexes |
| Surya OCR | VLM (650M paramètres) | 90+ | Oui (optimal), CPU possible | Excellent — mise en page + tableau + ordre de lecture | Analyse de mise en page document + OCR en un modèle |
| Docling | Ensemble (VLM + mise en page) | Multi (via backend EasyOCR) | Recommandé | Excellent — structure document complète | Pipelines RAG, conversion structurée de documents |
| olmOCR | VLM (7B paramètres) | Multi | Oui (GPU NVIDIA) | Excellent — multi-colonnes, tableaux, équations | Conversion PDF à grande échelle, documents scientifiques |
| Qwen2.5-VL | VLM (3B/7B/72B) | Multi (CJK fort) | Oui | Excellent — lecture VLM flexible | OCR général basé sur VLM, tâches d'extraction personnalisées |
Comment nous avons évalué
Ceci n'est pas un benchmark de laboratoire. Les chiffres de précision publiés par des tiers sont cités lorsqu'ils sont disponibles (comparaison GigaGPU d'avril 2026 pour Tesseract/EasyOCR/PaddleOCR ; score olmOCR-bench de Surya ; benchmarks publiés d'olmOCR), mais les critères d'évaluation principaux ici sont ceux qui comptent quand tu choisis une stack :
Quand c'est possible, nous recoupons aussi avec notre propre benchmark OCR propriétaire — 8 moteurs open-source exécutés sur la même RTX 4090, les mêmes reçus (SROIE 2019 + CORD v2), le même protocole figé, rapportant CER/WER, F1 d'extraction de champs, latence et coût pour 1 000 pages, chaque chiffre étant tracé jusqu'à une ligne CSV publiée. Deux conclusions de cette exécution éclairent directement les choix ci-dessous : sur la précision des caractères, le meilleur moteur traditionnel (docTR, CER 0,197) fait jeu égal avec le meilleur VLM (Surya2, 0,191) — donc « le VLM est intrinsèquement plus précis » ne tient pas sur du texte imprimé propre — et une fois qu'un postprocesseur LLM est ajouté, six des huit moteurs convergent vers une bande de F1-champs de 0,57–0,62, quelle que soit la famille. Vois le benchmark de coût et le benchmark de latence pour les chiffres opérationnels par moteur. Ce sont nos mesures sur un type de document ; les chiffres tiers ci-dessous couvrent un éventail d'entrées plus large.
- Surface d'intégration — l'API Python est-elle propre, renvoie-t-elle des données structurées ou du texte brut, nécessite-t-elle du code de collage
- Exigences matérielles strictes — quel matériel dois-tu fournir avant que l'outil fonctionne (CPU seul vs GPU obligatoire)
- Intelligence de mise en page — peut-il distinguer un en-tête de tableau d'un numéro de page, ou se contente-t-il d'émettre des flux de caractères
- Santé de la communauté — commits récents, nombre de problèmes ouverts, réactivité aux pull requests, écosystème établi
- Surface d'entraînement personnalisé — peux-tu l'affiner sur tes propres types de documents, et quel niveau d'expertise cela exige-t-il
Chaque lien d'outil ci-dessous mène au dépôt GitHub officiel du projet. Toutes les références externes sont liées pour que tu puisses vérifier les affirmations toi-même.
Les deux ères de l'OCR open source
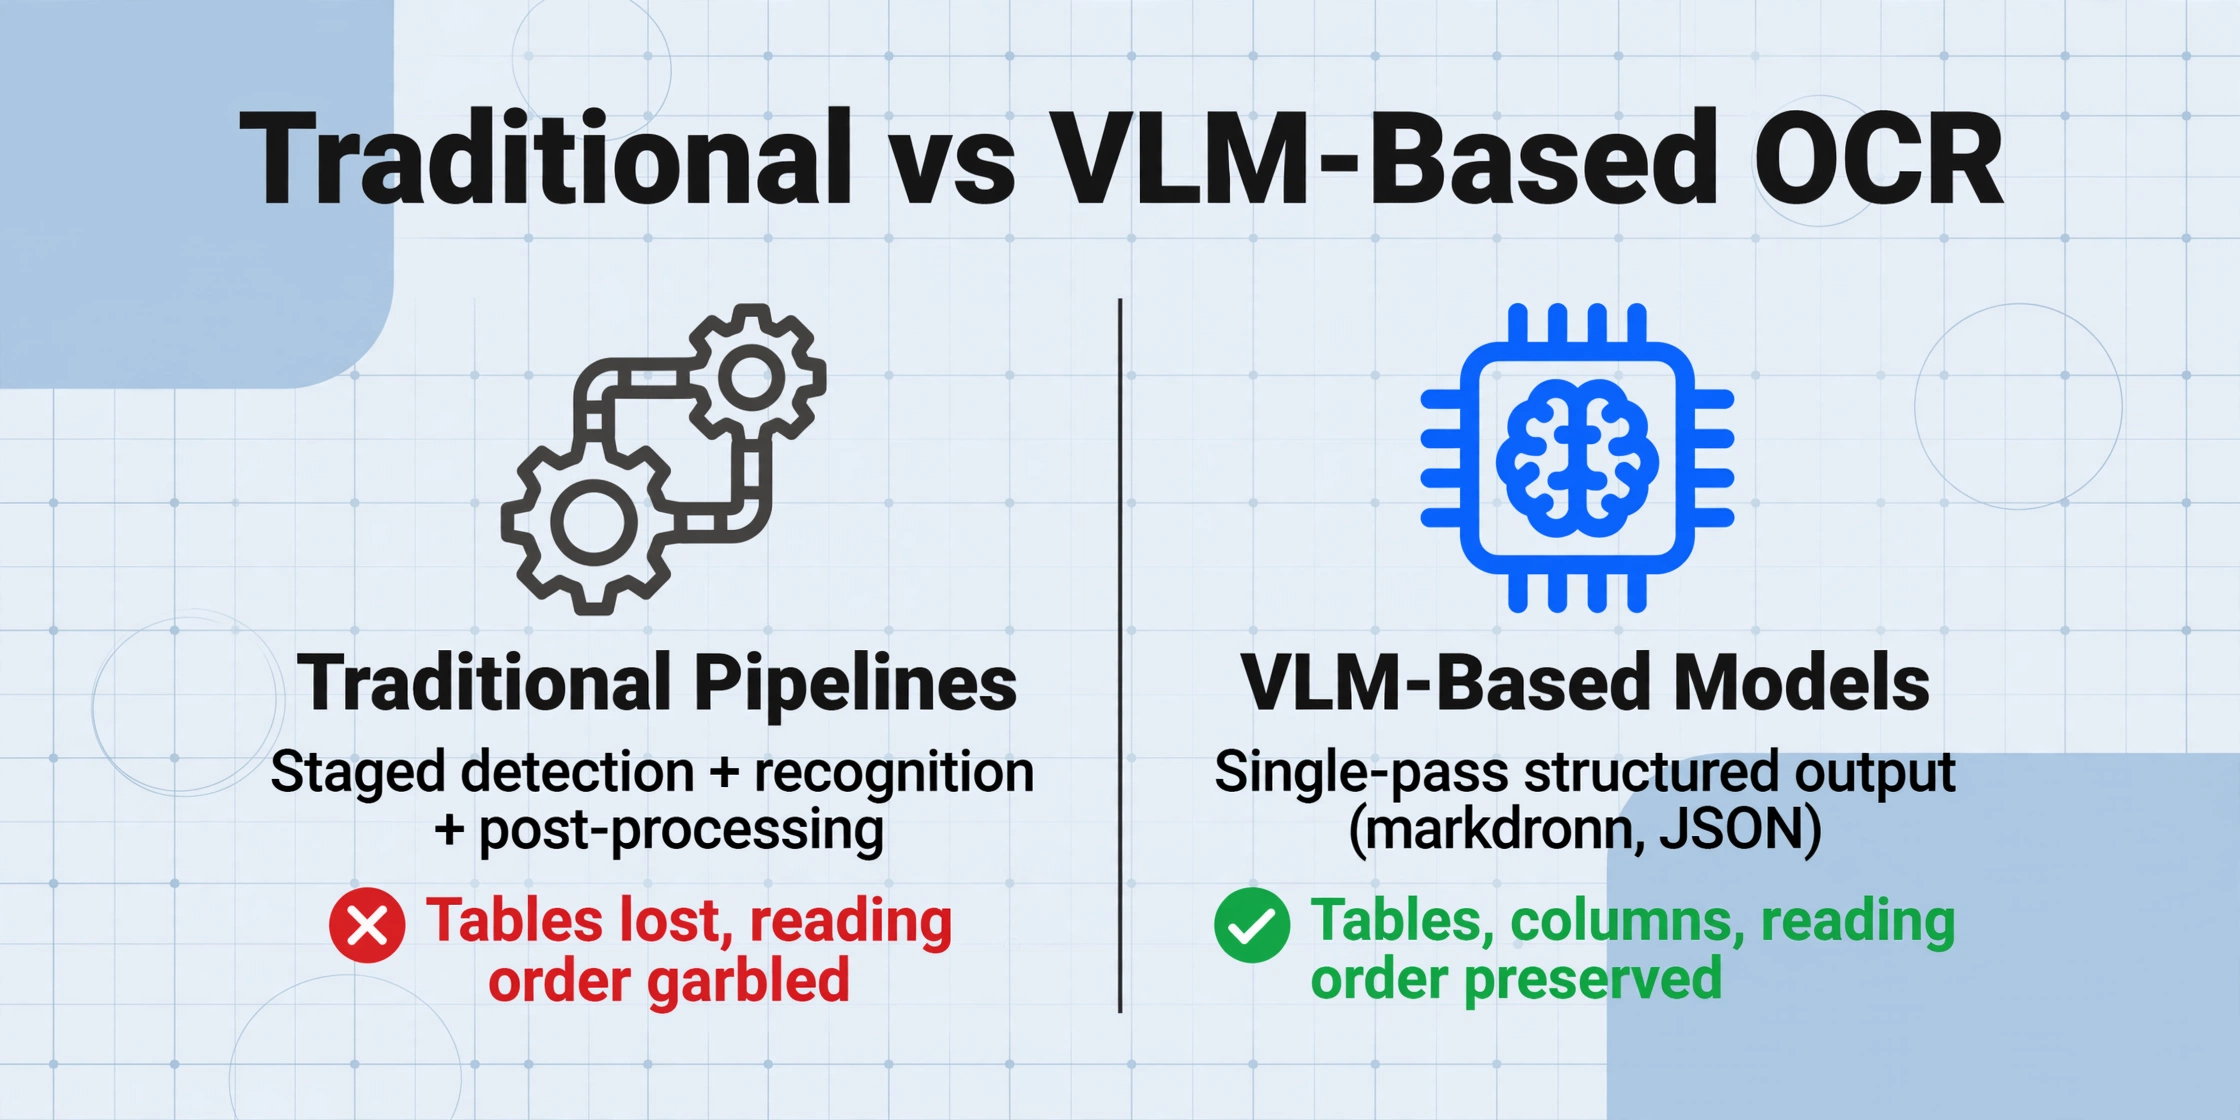
Avant d'entrer dans le détail des outils, il est utile de comprendre la fracture architecturale qui fait de 2026 une année particulièrement intéressante pour l'OCR open source.
Les pipelines OCR traditionnels (Tesseract, EasyOCR, PaddleOCR) fonctionnent par étapes : un modèle de détection de texte repère les zones de texte, un modèle de reconnaissance lit chaque zone caractère par caractère, et une étape de post-traitement tente de reconstruire la structure de la page. Chaque étape est un modèle ou un algorithme distinct, et les erreurs se propagent — une détection manquée signifie que le reconnaisseur ne verra jamais ce texte.
L'OCR basé sur VLM (Surya, olmOCR, Qwen2.5-VL) traite la lecture de documents comme une seule tâche multimodale. Un modèle vision-langage examine l'image de la page entière et génère une sortie structurée — markdown, JSON ou HTML — en une seule passe. Docling se situe entre les deux : il utilise des pipelines ensemblistes construits sur des modèles spécialisés mais fournit une API unifiée qui semble proche d'un VLM.
La différence pratique : les pipelines traditionnels sont moins chers à exécuter (compatibles CPU, petits modèles) mais nécessitent beaucoup de code de post-traitement pour reconstruire les tableaux et l'ordre de lecture. L'OCR basé sur VLM est gourmand en GPU mais fournit directement une sortie structurée — pas de surprises du type « tableau perdu » ou « colonne A fusionnée dans la colonne B ». Si tu traites en masse du texte imprimé propre avec des mises en page simples, les moteurs traditionnels restent gagnants sur le coût. Si tes documents contiennent des tableaux, des mises en page multi-colonnes ou un formatage mixte, une approche basée sur VLM te fera gagner plus de temps d'ingénierie que ne coûte son utilisation de GPU.
1. Tesseract OCR — le cheval de trait CPU
Tesseract est le moteur OCR open-source le plus ancien et le plus éprouvé de cette liste. Développé à l'origine chez Hewlett-Packard dans les années 1980 et maintenu par Google depuis 2006, il prend en charge plus de 100 langues et fonctionne sur tous les principaux systèmes d'exploitation. Il utilise un réseau neuronal basé sur LSTM (depuis la version 4) pour la reconnaissance de caractères et un algorithme traditionnel de segmentation de page pour l'analyse de la mise en page.
Démarrage rapide
pip install pytesseract
# Ou via le gestionnaire de paquets système : sudo apt install tesseract-ocr

# Utilisation en Python
import pytesseract
from PIL import Image
text = pytesseract.image_to_string(Image.open("invoice.png"), lang="eng")
print(text)
La force de Tesseract réside dans son fonctionnement CPU sans coût et son écosystème massif. Sur du texte imprimé propre et haute résolution à 300 DPI, il atteint environ 96-97 % de précision de caractères dans les benchmarks publiés. Il traite environ 25 pages par minute sur un CPU moderne, sans GPU requis — ce qui en fait l'option la plus rentable pour la numérisation en masse de texte imprimé. Nouveau sur ce moteur ? Notre guide d'installation de Tesseract pas à pas vous accompagne dans l'installation sur Windows, Mac et Linux, ainsi que dans les pièges de débutant (dont le problème de PATH sous Windows), en environ 15 minutes.
Les limites sont bien documentées. Tesseract n'a aucun concept natif de structure de document — il produit du texte plat avec des sauts de ligne approximant la mise en page d'origine. Les tableaux se réduisent en cellules de texte séquentielles sans association ligne/colonne. Les documents multi-colonnes produisent un ordre de lecture brouillé. Sur des entrées difficiles comme les photos prises au téléphone, la précision chute à environ 84 % dans les tests indépendants. La reconnaissance de l'écriture manuscrite est médiocre, à environ 45 % de précision — fonctionnellement inutilisable pour les documents cursifs ou mixtes.
Idéal pour : le traitement en masse CPU uniquement de documents imprimés propres où la sortie peut tolérer du texte plat — pensez à la numérisation de pages de livres, à la recherche dans des documents d'archives, ou au prétraitement pour des pipelines NLP.
Pas idéal pour : les documents avec tableaux, mises en page multi-colonnes, écriture manuscrite, photos basse résolution, ou tout scénario nécessitant une sortie structurée (au niveau des champs). Pas idéal non plus si vous voulez une API — Tesseract est un outil en ligne de commande avec un wrapper Python, pas un service.
2. EasyOCR — Le chemin le plus rapide vers une démo fonctionnelle
EasyOCR, développé sur PyTorch par Jaided AI, est conçu pour une seule chose : faire fonctionner l'OCR avec un minimum de friction. Un script Python de quatre lignes traite une image et renvoie le texte reconnu avec des scores de confiance par caractère. Il prend en charge environ 80 langues, dont les écritures latines, CJK, arabes et devanagari — une couverture plus large que ce que laisserait supposer la taille de son modèle, car il achemine les différentes écritures vers des têtes de reconnaissance dédiées.
Démarrage rapide
pip install easyocr

# Utilisation en Python
import easyocr
reader = easyocr.Reader(["en", "fr"])  # spécifier les langues
results = reader.readtext("receipt.jpg")
for bbox, text, confidence in results:
    print(f"{text} ({confidence:.2f})")
La commodité d'EasyOCR est à la fois sa principale force et sa principale limite. Sur du texte anglais imprimé propre, les benchmarks indépendants montrent une précision d'environ 95 % au niveau des caractères — légèrement en dessous de Tesseract pour des entrées idéales. Mais EasyOCR gère nettement mieux le texte incurvé et pivoté (82 % contre 52 % pour Tesseract dans les benchmarks de GigaGPU), ce qui le rend plus utile pour les photos du monde réel où le document n'est pas parfaitement aligné.
Le compromis de performance est réel. Sur CPU, EasyOCR est environ 2 à 3 fois plus lent que Tesseract, à environ 8 pages par minute. L'accélération GPU (sur une RTX 3090) le porte à environ 60 pages par minute — un gain de 7,5x. Les dépendances du modèle sont également plus lourdes, à environ 500 Mo contre ~10 Mo pour Tesseract. Il gère l'écriture manuscrite avec une précision d'environ 62 % — mieux que Tesseract mais toujours pas utilisable en production pour la plupart des flux de documents manuscrits.
La communauté Reddit r/LocalLLaMA évoque souvent EasyOCR comme le « nouilles instantanées de l'OCR » — des résultats rapides avec un minimum d'effort, mais pas l'outil vers lequel se tourner quand la précision ou le débit comptent vraiment. Ses échecs ont tendance à être prévisibles (substitutions de caractères pour des glyphes visuellement similaires) plutôt que le bruit irrécupérable que produit Tesseract, ce qui signifie qu'un post-traitement basé sur des expressions régulières peut sauver de nombreux résultats.
Idéal pour : les développeurs Python qui ont besoin d'un prototype OCR fonctionnel en moins de cinq minutes, en particulier pour le texte de scène multilingue ou le texte incurvé/pivoté sur des photos du monde réel.
Pas idéal pour : le traitement par lots à volume élevé sur du matériel CPU uniquement, les mises en page de documents complexes (tableaux, formulaires, multi-colonnes) ou les déploiements en production nécessitant une extraction structurée de champs.
Si tu hésites spécifiquement entre Tesseract et EasyOCR, notre comparatif Tesseract vs EasyOCR approfondit les différences qui comptent dans un pipeline réel — récupération d'erreurs, précision par type de document et poids d'installation.
3. PaddleOCR — OCR multilingue de qualité production
Développé par Baidu sous le framework PaddlePaddle, PaddleOCR est le moteur traditionnel le plus complet de cette liste. Contrairement à Tesseract et EasyOCR, qui se concentrent uniquement sur la reconnaissance de texte, PaddleOCR intègre détection, reconnaissance, extraction de tableaux, analyse de mise en page (PP-Structure) et sortie structurée dans un seul codebase. Il cumule plus de 76 000 étoiles GitHub et est le concurrent open-source le plus proche de Tesseract en termes de maturité d'écosystème.
Démarrage rapide
pip install paddlepaddle paddleocr

# Utilisation Python
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_angle_cls=True, lang="fr")
result = ocr.ocr("facture.png")
for line in result[0]:
    print(f"{line[1][0]} (confiance : {line[1][1]:.2f})")
PaddleOCR domine toutes les catégories de précision dans les benchmarks publiés parmi les moteurs traditionnels : 97,2 % sur du texte anglais imprimé propre, 91,5 % sur des documents scannés bruités, 88,7 % sur du texte courbe/rotaté, et 72,8 % sur l'écriture manuscrite. Son support CJK est particulièrement solide — logique vu son origine chinoise — ce qui en fait le choix par défaut pour les équipes traitant des documents mixtes anglais-chinois ou tout flux impliquant des écritures est-asiatiques.
Les mises à jour récentes de 2026 sont significatives. PP-OCRv6 est sorti en mai 2026, améliorant encore précision et vitesse. Le modèle PaddleOCR-VL-1.5 (janvier 2026) introduit des capacités vision-langage qui portent la précision à 94,5 % sur le benchmark OmniDocBench v1.5 — comblant l'écart entre pipelines traditionnels et approches VLM. Les performances sont impressionnantes : sur une RTX 3090, PaddleOCR traite environ 120 pages par minute, contre 25 pages par minute pour Tesseract limité par le CPU.
Idéal pour : Pipelines OCR multilingues en production, surtout ceux impliquant des écritures CJK, des mises en page complexes avec tableaux, ou des documents scannés bruités. L'extraction de tableaux via PP-Structure est réellement utile et indisponible dans tout autre moteur open-source traditionnel.
Moins adapté pour : OCR ponctuel rapide (l'installation des dépendances est lourde), déploiements sans GPU (les performances chutent significativement), ou les équipes souhaitant éviter la dépendance au framework PaddlePaddle — c'est un verrouillage framework important comparé aux alternatives PyTorch plus portables.
4. Surya OCR — Intelligence de mise en page documentaire en moins d’1 milliard de paramètres
Surya OCR, développé par Datalab, est l’une des sorties open source les plus impressionnantes de 2025-2026. Avec seulement 650 millions de paramètres, il atteint un score de 83,3 % sur le benchmark olmOCR-bench — le meilleur résultat pour tout modèle de moins de 3 milliards de paramètres. Il combine OCR, analyse de mise en page, détection de l’ordre de lecture et reconnaissance de tableaux en un seul modèle. Les poids du modèle sont disponibles sous licence OpenRAIL-M (gratuit pour la recherche, l’usage personnel et les startups de moins de 5 M$ de financement), et le code est sous licence Apache 2.0.
Démarrage rapide
pip install surya-ocr

# Utilisation en Python
from surya import OCR
from PIL import Image
ocr = OCR()
result = ocr.recognize([Image.open("facture.png")])
for text_line in result[0].text_lines:
    print(text_line.text)
Ce qui rend Surya architecturalement intéressant, c’est son approche unifiée. Contrairement aux pipelines traditionnels qui enchaînent détection → reconnaissance → analyse de mise en page avec des modèles séparés, Surya utilise un modèle vision-langage comme moteur d’inférence (servi par vLLM sur GPU ou llama.cpp sur CPU/Apple Silicon). Cela lui confère une compréhension structurelle que les moteurs classiques n’ont pas. Le SuryaInferenceManager lance automatiquement le bon backend, et l’API renvoie un JSON richement annoté avec des boîtes englobantes, des scores de confiance et des étiquettes de régions sémantiques (en-têtes, tableaux, images, blocs de texte).
Les performances sont compétitives : Surya traite environ 5 pages par seconde sur une RTX 5090 (42 pages/min pour des charges typiques) et peut fonctionner sur Apple Silicon via Metal à environ 0,1 page par seconde — utilisable pour des documents occasionnels mais pas pour du traitement par lots. Il prend en charge 91 langues, dont une bonne couverture des écritures asiatiques. La principale limitation est que Surya est conçu pour les documents, pas pour les photos générales — il peine avec les images non documentaires et peut ignorer les zones ressemblant à des publicités que son modèle de détection a appris à sauter.
Idéal pour : Les équipes qui ont besoin d’analyse de mise en page documentaire et d’OCR en un seul modèle, sans la complexité des pipelines multi-étapes. La sortie consciente de la mise en page (JSON avec boîtes englobantes, types de régions et ordre de lecture) la rend parfaite pour les workflows d’intelligence documentaire en aval.
Pas idéal pour : L’OCR de photos générales (spécialisé pour les documents), les environnements pauvres en GPU (les performances CPU sont nettement plus lentes), ou les scénarios nécessitant une licence commerciale permissive des poids du modèle.
5. Docling — Conversion de documents pour pipelines RAG
Docling, développé par IBM Research et contribué à la LF AI & Data Foundation, n'est pas un moteur OCR classique. C'est une boîte à outils de conversion de documents qui prend en charge les PDF, DOCX, PPTX et images, et produit du JSON structuré, du Markdown ou des DocTags — un format de balisage universel qui capture la mise en page, les tableaux, les formules et l'ordre de lecture. Il a dépassé les 20 000 étoiles GitHub et est utilisé en production par NVIDIA (optimisé pour les PC RTX) et au sein de la plateforme Watsonx d'IBM.
Démarrage rapide
pip install docling

# Utilisation Python
from docling.document_converter import DocumentConverter
converter = DocumentConverter()
doc = converter.convert("document.pdf")
print(doc.export_to_markdown())  # Sortie Markdown structurée
print(doc.export_to_dict())      # Représentation JSON complète
L'architecture de Docling combine deux modèles IBM spécialisés : un modèle d'analyse de mise en page entraîné sur environ 81 000 pages annotées manuellement (brevets, manuels, rapports 10-K) pour identifier les éléments du document, et TableFormer pour reconstituer la structure des tableaux. Pour les documents scannés, il intègre EasyOCR comme moteur OCR. Le pipeline produit un DoclingDocument — une représentation basée sur Pydantic qui préserve la hiérarchie des pages, les cellules de tableau avec indices de lignes/colonnes, les emplacements d'images avec légendes et les formules mathématiques en LaTeX.
La vraie force de Docling réside dans son écosystème d'intégration. Il se branche directement sur LlamaIndex et LangChain pour les pipelines RAG, et NVIDIA a documenté des améliorations de performances de 4x lors de l'exécution de Docling sur des PC RTX par rapport au CPU. IBM a également publié Granite-Docling-258M (Apache 2.0) en 2026 — un VLM unique de 258M paramètres qui effectue une compréhension de bout en bout des documents en une seule passe, complétant l'approche par pipeline ensembliste.
Idéal pour : Les équipes construisant des pipelines RAG qui doivent convertir divers formats de documents en données structurées prêtes pour les LLM. La combinaison de la préservation de la mise en page, de la récupération de la structure des tableaux et de l'intégration directe avec LangChain/LlamaIndex est unique parmi les outils open-source.
Moins adapté pour : Les scénarios nécessitant une sortie texte OCR brute sans structure de document, ou les équipes ayant besoin d'une dépendance légère — Docling embarque des poids de modèles importants et nécessite une configuration complexe pour le déploiement GPU.
6. olmOCR — Conversion de PDF à grande échelle
olmOCR, développé par l'Allen Institute for AI (Ai2), est un VLM de 7 milliards de paramètres, finement ajusté pour l'OCR documentaire. Il est basé sur Qwen2-VL-7B et entraîné sur l'ensemble de données olmOCR-mix-0225 — 250 000 pages annotées avec GPT-4o via une technique appelée Document Anchoring, qui améliore la qualité d'extraction en exploitant le texte et les métadonnées intégrés au PDF. Le modèle et le code sont entièrement open source, et Ai2 a publié une documentation transparente sur les données d'entraînement et la méthodologie.
Démarrage rapide
pip install olmocr

# Utilisation en Python
from olmocr.data.renderpdf import render_pdf_to_base64png
from olmocr.prompts import build_finetuning_prompt
# Traiter une page PDF — la boîte à outils gère le rendu et les invites
image_b64 = render_pdf_to_base64png("document.pdf", page=1)
# Envoyer au modèle via votre serveur vLLM ou SGLang préféré
Le chiffre clé qui distingue olmOCR est son coût d'inférence : Ai2 indique qu'olmOCR peut convertir un million de pages PDF pour environ 190 $ en utilisant une inférence SGLang optimisée — soit environ 1/32e du coût de GPT-4o pour la même tâche. Cela en fait l'option la plus rentable pour les projets de numérisation documentaire à grande échelle, à condition de disposer de l'infrastructure GPU nécessaire pour exécuter un modèle de 7B.
Les performances sur le benchmark olmOCR-bench atteignent 82,4 % au global (pour la version olmOCR-2-7B-1025, publiée en octobre 2025), avec d'excellents résultats sur les équations mathématiques, les tableaux denses et les mises en page multi-colonnes. Le modèle prend en charge le rendu automatique des pages, la correction de rotation et la logique de nouvelle tentative via la boîte à outils olmOCR, ce qui le rend adapté au traitement de millions de documents hétérogènes sans intervention manuelle.
La limite pratique est le matériel. olmOCR nécessite un GPU NVIDIA récent avec au moins 16 Go de VRAM pour le modèle 7B en précision bfloat16. Il ne fonctionne pas sur CPU ou Apple Silicon (bien qu'il existe des quantifications GGUF communautaires pour le modèle Qwen de base). Les poids du modèle pèsent environ 14 Go, et le débit d'inférence est d'environ 2 à 3 pages par seconde sur un RTX 4090 — assez rapide pour le traitement par lots, mais pas pour le temps réel.
Idéal pour : Les projets de numérisation PDF à grande échelle — pensez à la numérisation de millions d'articles académiques, de documents gouvernementaux ou de documents historiques. L'efficacité économique (190 $/million de pages) et le pipeline automatisé en font le champion de l'échelle industrielle.
Moins adapté pour : Les équipes sans infrastructure GPU NVIDIA, les applications OCR temps réel ou interactives, ou les cas d'usage nécessitant un déploiement léger. Le modèle 7B est excessif pour une simple extraction de texte à partir de documents propres.
7. Qwen2.5-VL — Le VLM polyvalent qui excelle en OCR
Qwen2.5-VL, développé par l'équipe Qwen d'Alibaba, est une famille de modèles vision-langage (3B, 7B et 72B paramètres) qui performe remarquablement dans les tâches de compréhension visuelle — y compris l'OCR. Bien qu'il ne soit pas spécialement conçu pour le traitement de documents comme olmOCR ou Surya, c'est un VLM polyvalent doté d'excellentes capacités de reconnaissance de texte et d'extraction d'informations. Cela le rend particulièrement flexible : vous pouvez lui demander d'extraire des champs spécifiques d'un document, de résumer une page ou de transcrire du texte dans un format précis, le tout avec le même modèle.
Démarrage rapide
pip install transformers qwen-vl-utils torch

# Utilisation Python — avec la bibliothèque Hugging Face Transformers
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
model = Qwen2VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2.5-VL-7B-Instruct", torch_dtype="bfloat16"
)
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-7B-Instruct")
# Utiliser le modèle avec des invites texte + image
# "Extrais tout le texte de cette facture et retourne-le sous forme de champs structurés"
Les capacités OCR de Qwen2.5-VL ont été considérablement améliorées par rapport à son prédécesseur, avec une reconnaissance de texte multi-scénario, multilingue et multi-orientation renforcée. Il gère le texte vertical, le texte courbe et les pages multilingues qui feraient échouer les moteurs traditionnels. La version 72B rivalise avec des modèles commerciaux comme GPT-4o sur les benchmarks de compréhension de documents, tandis que la variante 3B est suffisamment légère pour fonctionner sur des GPU grand public (environ 6 Go de VRAM).
Le principal avantage de Qwen2.5-VL par rapport aux outils OCR spécialisés est sa flexibilité. Vous n'êtes pas limité à un seul format ou pipeline de sortie — vous pouvez demander au modèle de retourner du JSON avec des champs spécifiques, d'extraire des tableaux en markdown, ou de décrire la structure d'un document en langage naturel. Cela le rend idéal pour les tâches d'extraction d'informations où vous devez cibler des données précises plutôt que de transcrire l'intégralité de la page. La communauté r/LocalLLaMA discute fréquemment de Qwen2.5-VL comme modèle polyvalent de référence pour les tâches OCR, les utilisateurs rapportant que sa précision sur les mises en page complexes dépasse souvent celle des outils OCR spécialisés, surtout avec des instructions d'extraction explicites.
Le compromis est la latence et le coût. Même la version 7B nécessite des ressources GPU importantes, et la version 72B requiert plusieurs GPU. Contrairement aux moteurs OCR traditionnels qui traitent une page en millisecondes, l'inférence basée sur VLM prend 2 à 5 secondes par page selon la taille du modèle et le matériel. Pour la transcription de texte en masse, les outils OCR spécialisés restent plus efficaces. Pour l'extraction ciblée d'informations à partir de documents complexes, la flexibilité de Qwen2.5-VL est inégalée.
Idéal pour : Extraction ciblée d'informations à partir de documents complexes — demander au modèle d'extraire des champs spécifiques dans un format précis. Également idéal pour les équipes qui souhaitent un seul modèle pour l'OCR, la compréhension de documents et le Q&A visuel général.
Moins adapté pour : L'OCR en masse à haut débit où la vitesse de transcription brute compte, les déploiements sans GPU, ou les scénarios nécessitant une bibliothèque légère autonome plutôt qu'une infrastructure de service basée sur GPU.
Quel outil choisir ?
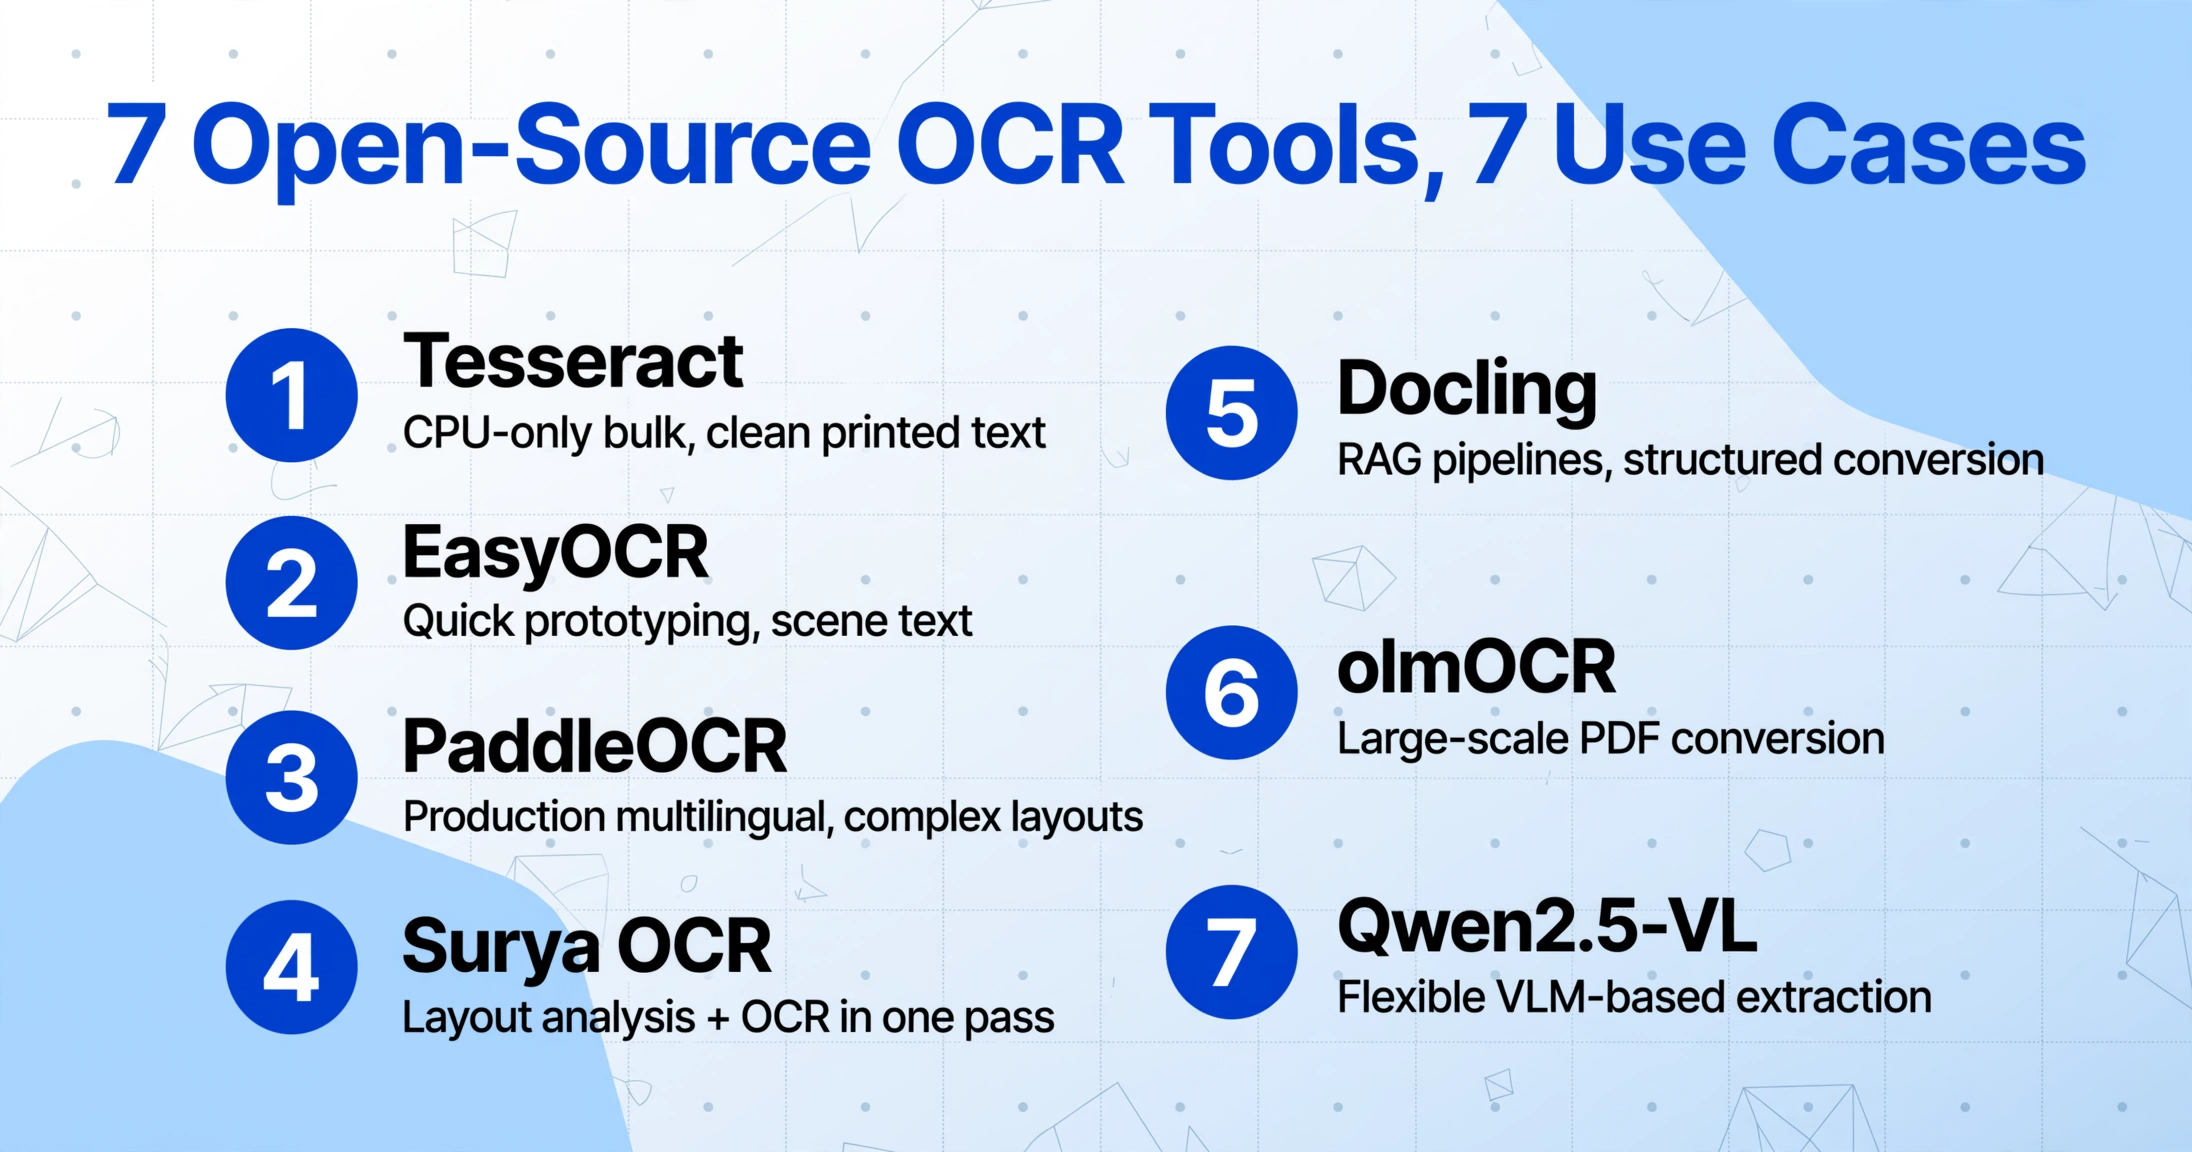
Si tes documents sont du texte imprimé propre et que tu as besoin d'un traitement en masse sur CPU à coût nul : Tesseract. C'est la seule option qui fonctionne bien sans GPU et sur n'importe quel matériel.
Si tu as besoin d'un prototype rapide pour du texte de scène multilingue ou du texte incurvé issu de photos : EasyOCR. L'installation prend cinq minutes et les scores de confiance rendent le post-traitement gérable.
Si tu construis un pipeline multilingue de production avec des mises en page complexes et que tu as accès à un GPU : PaddleOCR. Son extraction de tableaux, sa prise en charge du CJK et son débit (120 pages/min sur GPU) en font le moteur traditionnel le plus performant.
Si tu as besoin d'une analyse de mise en page et d'une OCR en une seule passe avec un modèle léger : Surya OCR. Avec ses 650M de paramètres et sa sortie sensible à la mise en page, c'est le meilleur compromis coût-précision parmi les options basées sur VLM.
Si tu construis des pipelines RAG et que tu as besoin d'une conversion documentaire structurée : Docling. L'intégration LlamaIndex/LangChain et la récupération de la structure des tableaux sont uniques.
Si tu as un projet de numérisation PDF à grande échelle (des millions de pages) et une infrastructure GPU : olmOCR. Son coût de $190/million de pages est inégalé.
Si tu veux une extraction flexible basée sur VLM où tu invites le modèle à extraire des champs spécifiques dans des formats spécifiques : Qwen2.5-VL. La variante 3B tourne sur des GPU grand public et la variante 72B rivalise avec une compréhension de niveau GPT-4o.
Le verdict honnête : Si tu as accès à un GPU, évite les moteurs traditionnels pour tout document contenant des tableaux, des mises en page multi-colonnes ou un formatage mixte. Une approche basée sur VLM (Surya, olmOCR ou Qwen2.5-VL) fournit directement une sortie structurée et te fera gagner plus de temps d'ingénierie sur le code de collage du post-traitement qu'elle n'en coûte en calcul GPU. Garde Tesseract et PaddleOCR dans ta boîte à outils pour les cas précis qu'ils gèrent bien — le texte propre en masse et le CJK à haut débit respectivement — mais n'en fais pas ton choix par défaut pour l'OCR documentaire général en 2026.
Questions fréquentes
Tesseract est-il toujours pertinent en 2026 ?
Oui, mais uniquement pour un cas d'usage précis : le traitement en masse de textes imprimés propres où un résultat plat (non structuré) est acceptable. Pour tout document contenant des tableaux, des colonnes ou de l'écriture manuscrite, les alternatives modernes le surpassent nettement. La principale raison de choisir encore Tesseract en 2026 est l'exigence matérielle — c'est le seul outil de cette liste qui fonctionne efficacement sur CPU sans GPU.
Quelle est la différence entre « OCR gratuit » et « OCR open-source » ?
L'OCR gratuit (couvert dans notre guide Meilleur logiciel OCR gratuit 2026) inclut les services en ligne gratuits et les offres commerciales freemium — Google Drive OCR, PDF24, OCR.space, et des outils freemium comme Parseur et Nanonets. L'OCR open-source désigne des logiciels auto-hébergés dont le code source est inspectable et modifiable. Les outils de cet article sont tous open-source, ce qui signifie que vous les hébergez sur votre propre infrastructure, vous offrant un traitement illimité au prix de la configuration et de la maintenance.
Ai-je besoin d'un GPU pour ces outils ?
Tesseract est uniquement CPU et fonctionne bien sur n'importe quel processeur moderne. EasyOCR et PaddleOCR bénéficient de l'accélération GPU mais peuvent fonctionner sur CPU (lentement). Surya peut fonctionner sur CPU ou Apple Silicon via llama.cpp, mais les performances sont environ 50 fois plus lentes qu'avec un GPU. olmOCR et Qwen2.5-VL nécessitent un GPU NVIDIA — les modèles 7B ont besoin d'au moins 16 Go de VRAM. Le pipeline d'ensemble de Docling bénéficie du GPU mais peut traiter des documents plus simples sur CPU.
Quel outil OCR open-source gère le mieux l'écriture manuscrite ?
Parmi les outils examinés, PaddleOCR est en tête pour l'écriture manuscrite avec environ 73 % de précision dans les benchmarks indépendants (contre 45 % pour Tesseract et 62 % pour EasyOCR). Les outils basés sur VLM (Surya, olmOCR, Qwen2.5-VL) montrent une meilleure reconnaissance de l'écriture manuscrite en pratique, bien que les benchmarks publiés soient limités. Pour le traitement sérieux de documents manuscrits, les services commerciaux d'IA dédiés surpassent généralement les outils open-source d'une marge significative.
Puis-je entraîner ou affiner ces outils sur mes propres documents ?
Tesseract prend en charge l'entraînement personnalisé via son pipeline de réglage fin LSTM, mais le processus est complexe et nécessite de générer des fichiers box pour chaque image d'entraînement. EasyOCR permet l'entraînement sur des données personnalisées avec l'architecture CRNN. PaddleOCR propose le pipeline de réglage fin le plus accessible, avec des exemples documentés pour des jeux de données personnalisés. Surya et Docling ne prennent actuellement pas en charge le réglage fin des modèles — ils sont utilisés tels quels. olmOCR et Qwen2.5-VL peuvent être affinés avec les outils standard Hugging Face Transformers, mais un réglage fin efficace nécessite une expertise, des données et des ressources GPU importantes.
Quel outil préserve le mieux la structure des tableaux ?
Docling offre la meilleure préservation de la structure des tableaux grâce à son modèle dédié TableFormer, qui reconstitue la structure des lignes/colonnes, les cellules fusionnées et les en-têtes. Le module PP-Structure de PaddleOCR gère également bien l'extraction de tableaux. Parmi les outils basés sur VLM, Surya et olmOCR produisent des tableaux en Markdown qui préservent la structure pour la plupart des mises en page courantes.
Puis-je utiliser ces outils à des fins commerciales ?
Les conditions de licence varient selon l'outil. Tesseract (Apache 2.0), EasyOCR (Apache 2.0), PaddleOCR (Apache 2.0) et Docling (MIT/Apache 2.0) sont entièrement permissifs pour un usage commercial. Le code de Surya est sous licence Apache 2.0, mais les poids du modèle utilisent une licence modifiée OpenRAIL-M (gratuite pour les startups de moins de 5 M$ de financement/chiffre d'affaires — un usage commercial plus large nécessite une licence payante). olmOCR (Apache 2.0) et Qwen2.5-VL (Apache 2.0 pour les variantes 7B/72B, licence personnalisée pour la variante 3B) sont permissifs. Vérifiez toujours la licence spécifique de la version que vous comptez déployer — les licences des modèles peuvent différer de celles du code.
Quand devrais-je envisager un outil OCR commercial ?
L'OCR open-source est excellent pour le prototypage et les outils internes. Mais si tu as besoin d'une extraction de données au niveau des champs (pas seulement d'une transcription de texte), d'une reconnaissance fiable de l'écriture manuscrite, ou d'un flux de travail sans configuration pour les membres non techniques de l'équipe, les outils d'extraction IA commerciaux offrent généralement une meilleure précision et une sortie structurée de meilleure qualité. Si tu es actuellement en train d'évaluer des options commerciales, essaie de faire passer tes documents réels dans un outil avant de t'engager — les solutions open-source et commerciales diffèrent le plus sur les documents qui comptent pour ton flux de travail spécifique, pas sur des benchmarks standardisés.
La meilleure évaluation d'OCR est celle que vous lancez sur vos propres documents. Les données de benchmark vous donnent un point de départ — les résultats réels dépendent de la qualité de vos documents, de la complexité de la mise en page et du format de sortie cible.
Essayez l'extraction de documents par IAAucune inscription requise. Téléversez un document et voyez ce que l'extraction IA moderne peut faire.