2026년 최고의 무료 OCR 소프트웨어:
실제로 작동하는 무료 및 오픈소스 옵션
이 글을 쓰기 전에 읽었던 모든 "최고의 무료 OCR" 목록은 똑같은 형태였습니다. 도구에 대한 짧은 문단, 일반적인 정확도 주장, 그리고 추천으로 위장한 가격 페이지. 정말 중요한 질문 — 내가 매주 처리하는 문서에 실제로 작동하는 무료 옵션은 무엇이고, 어떤 것이 내 오후를 낭비하게 만들까 — 을 묻고 있다면 그런 글은 도움이 되지 않습니다. OCR이 무엇인지, 그 뒤의 기술이 왜 중요한지 확실하지 않다면 OCR이란 무엇인가, 2026년 AI OCR의 의미, OCR이 실제로 작동하는 방식에 대한 가이드에서 기초를 다룹니다. 이 가이드는 기본은 알고 있고 도구를 고르려는 분을 위한 것입니다. 세 가지 실제 카테고리 — 완전 무료 오픈소스, 무료 온라인 서비스, 의미 있는 무료 티어가 있는 상용 도구 — 에 걸쳐 열한 개의 무료 OCR 도구를 구체적인 한도, 실제 정확도 제약, 솔직한 "최적 용도" 추천과 함께 다룹니다. 고지: 상용 AI 추출 도구인 ImageToTable.ai가 이 목록에 포함되어 있습니다. 여기서 리뷰한 다른 도구와는 아무런 관계가 없으며, 필요한 모든 도구는 가격 페이지로 직접 연결되어 있어 직접 확인할 수 있습니다.
핵심 요약
- 십여 개의 무료 OCR 도구가 깨끗하게 스캔한 인쇄 텍스트를 비용 없이 화면의 문자로 바꿔줍니다.
- 무료 OCR은 페이지의 모든 단어를 읽지만 어느 것이 청구서 합계인지는 알 수 없습니다 — 그 부분은 여전히 직접 해야 합니다.
- AI 추출 도구는 청구서 합계와 페이지 번호가 각각 무엇을 의미하는지 이해하여 구분합니다 — 모든 공급업체의 문서 형식을 스프레드시트와 무관하게 만드는 메커니즘입니다.
빠른 비교표
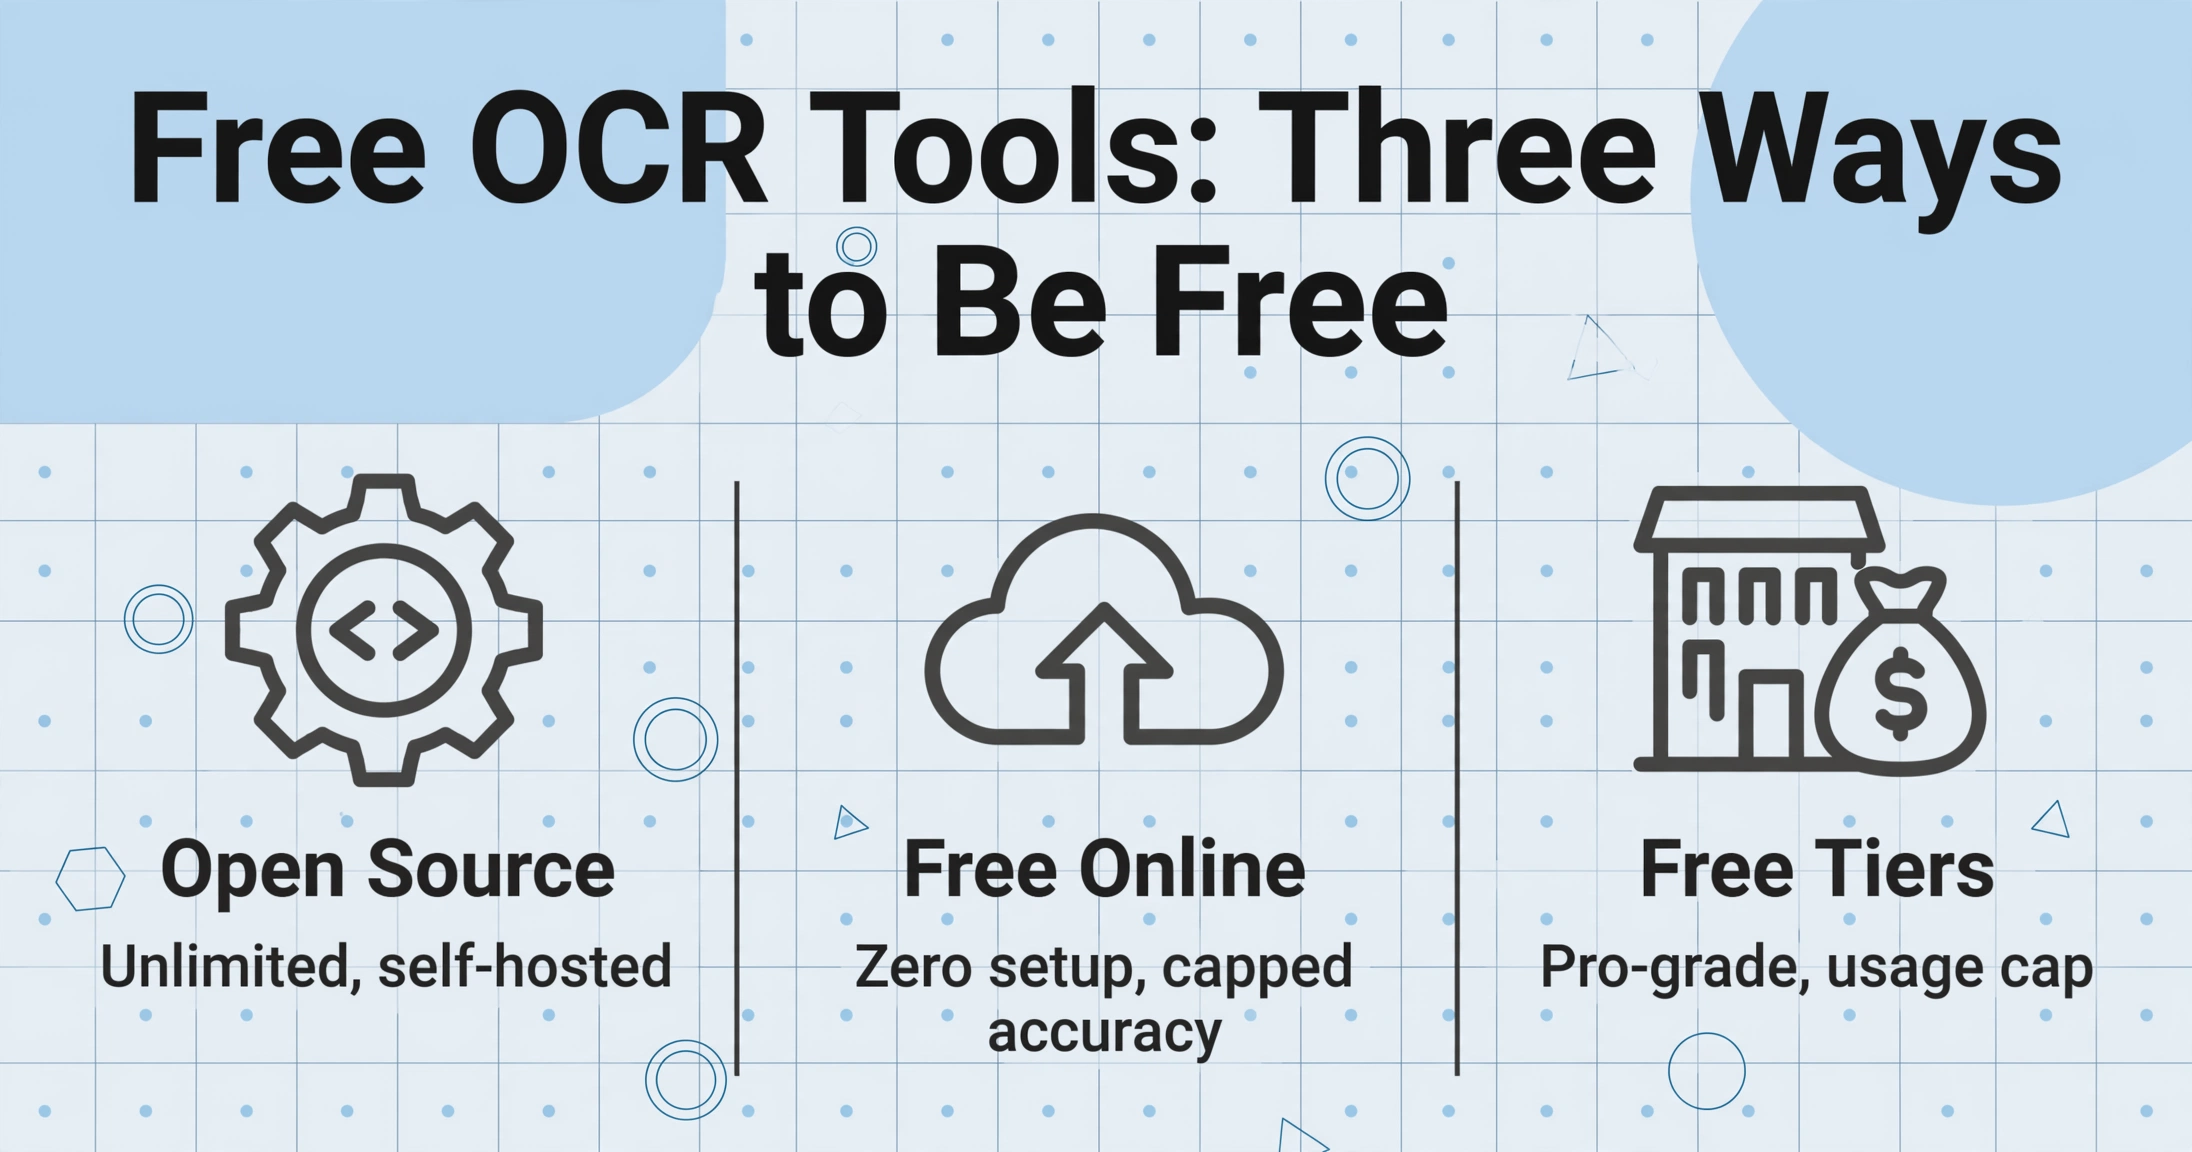
여기 있는 모든 도구는 진입 단계에서는 정말 무료입니다. 차이는 어떻게 무료인지 — 무제한 자체 호스팅인지, 온라인 사용량 제한인지, 기간 제한 체험판인지 — 그리고 정확도나 편의성에서 무엇을 포기해야 하는지입니다.
| 도구 | 카테고리 | 무료 한도 | 추천 용도 | 정확도(인쇄물) |
|---|---|---|---|---|
| Tesseract OCR | 오픈 소스 | 무제한(자체 호스팅) | 개발자, 깔끔한 인쇄 텍스트 | 85~99% * |
| EasyOCR | 오픈 소스 | 무제한(자체 호스팅) | 빠른 Python 프로토타이핑 | 93~97% |
| PaddleOCR | 오픈 소스 | 무제한(자체 호스팅) | 복잡한 레이아웃, 다국어 | 90~98% |
| Google Drive OCR | 무료 온라인 | 무제한 | 빠른 텍스트 추출, 무료 다국어 | 94~96% |
| PDF24 OCR | 무료 온라인 | 무제한(가입 불필요) | 영어 검색 가능 PDF | 90~94% |
| PowerToys Text Extractor | 무료(Windows) | 무제한(내장) | 화면 텍스트 캡처 | 90~95% |
| OCR.space | 프리미엄 API | 월 25,000회 호출 | 개발자 통합, 가벼운 사용 | 90~95% |
| Parseur | 상용(무료 등급) | 월 20페이지 | 문서 파싱 워크플로 | 95~98% |
| Nanonets | 상용(무료 체험) | $200 무료 크레딧 | 엔터프라이즈 AP 자동화 | 95~99% |
| Adobe Acrobat Online | 상용(무료 등급) | 1일 1파일 | 간헐적 검색 가능 PDF | 95~97% |
| ImageToTable.ai | 상용 (무료 데모) | 무료 데모, 카드 불필요 | 구조화 데이터 추출 | 97~99% ** |
* Tesseract 정확도는 문서 품질, 전처리, 언어에 따라 크게 달라집니다.
** ImageToTable.ai는 전통적인 텍스트 OCR 엔진이 아니라 AI 추출 도구이므로, 정확도는 문자 인식이 아닌 구조화된 필드 추출 기준으로 측정했습니다.
무료 OCR 도구를 분류한 기준
"무료"는 한 가지 의미가 아닙니다. 비용은 0원이지만 Python 설정에 이틀이 걸리는 도구는 파일을 업로드하는 웹 페이지와 같은 의미의 "무료"가 아닙니다. 이 목록을 실제 환경 기준 세 가지로 나눴습니다:
- 완전 무료 & 오픈 소스 — 라이선스 비용 0원, 자체 호스팅, 사용량 제한 없음. 대신 설정 시간, 하드웨어, 기술 역량을 지불합니다.
- 무료 온라인 & 내장 도구 — 설정도 비용도 0이지만 정확도, 형식 지원, 언어 범위가 제한적입니다. 가끔 쓰기엔 충분합니다.
- 무료 티어가 있는 상용 도구 — 무료 사용 한도나 체험 기간 뒤에 전문가급 정확도가 있습니다. 예산이 적은 실제 업무에 가장 적합합니다.
모든 도구를 최소 세 가지 문서 유형으로 테스트했습니다: 깨끗한 영어 인보이스(300 DPI 스캔), 영수증을 휴대폰으로 찍은 사진, 밀도 높게 서식이 지정된 PDF 페이지. 표의 정확도 백분율은 공개된 제3자 벤치마크가 있으면 이를 기준으로 하고, 자체 테스트로 보완했습니다. 모든 도구 링크는 해당 도구의 자체 사이트로 연결됩니다 — 어떤 도구에든 시간을 투자하기 전에 직접 확인하시길 바랍니다.
완전 무료 & 오픈 소스: 자체 호스팅 OCR 엔진
주된 제약이 비용이고 Python 환경을 설정하거나 명령줄 도구를 실행할 기술적 능력이 있다면, 오픈 소스 OCR은 라이선스 비용 없이 무제한 처리를 제공합니다. 대가는 깔끔하게 인쇄된 텍스트가 아닌 경우의 정확도 — 그리고 그 격차를 직접 해결하는 데 드는 엔지니어링 시간입니다. 아래 세 가지 엔진의 아키텍처, GPU 요구 사항, 파이프라인 통합은 최고의 오픈 소스 OCR 도구 비교에서 자세히 다루며, 이 섹션에서는 각 도구에서 "무료"가 실제로 무엇을 의미하는지에 초점을 맞춥니다.
1. Tesseract OCR — 믿음직한 원조
Tesseract는 거의 모든 다른 무료 OCR 도구가 감싸고 있는 엔진입니다. 1980년대 Hewlett-Packard가 처음 개발했고 현재는 Google이 유지 관리하며, 100개 이상의 언어를 지원하고 모든 주요 운영 체제에서 실행됩니다. 대부분의 오픈 소스 OCR 프로젝트의 출발점이며, 그럴 만한 이유가 있습니다 — 깔끔하게 잘 스캔된 인쇄 텍스트에서는 무료로 견고한 결과를 제공합니다. 설치에 관한 완전한 초보자 안내 — 대부분의 초보자가 걸려 넘어지는 Windows PATH 문제 포함 — 는 단계별 Tesseract 설정 가이드를 참조하세요.
문서가 완벽하지 않으면 한계가 바로 드러납니다. 저해상도 모바일 사진, 기울어진 페이지, 다단 레이아웃, 그리고 어떤 정도의 필기든 Tesseract의 출력을 크게 저하시킵니다. 실제 OCR 사용 사례에서 가장 흔한 영수증 모바일 사진의 경우, 타사 벤치마크에서 정확도가 약 70~80%로 떨어집니다. 또한 명령줄에 익숙해야 합니다: tesseract image.png output 실행은 간단하지만, OpenCV로 전처리하거나 ocrmypdf로 검색 가능한 PDF를 출력하려면 추가 도구와 지식이 필요합니다.
적합한 경우: 깔끔하게 인쇄된 문서, 특히 대량 문서에 오프라인 OCR이 필요하고 전처리 파이프라인 작성에 익숙한 개발자. 적합하지 않은 경우: 모바일 사진, 필기, 명령줄을 다루고 싶지 않은 사람.
2. EasyOCR — 작동하는 데모를 가장 빠르게 만드는 방법
PyTorch 기반으로 구축된 EasyOCR은 실행 가능한 가장 간단한 딥러닝 OCR 라이브러리입니다. 5줄짜리 Python 스크립트로 이미지를 처리하고 신뢰도 점수와 함께 인식된 텍스트를 반환할 수 있습니다. 라틴 문자, CJK, 아랍어, 데바나가리 문자를 포함해 약 80개 언어를 기본 지원합니다.
편리함에는 성능 비용이 따릅니다. EasyOCR은 CPU에서 Tesseract보다 눈에 띄게 느리고(CodeSOTA 벤치마크 기준 페이지당 약 2~3배 느림), 모델 의존성 용량도 약 500MB로 Tesseract의 약 10MB에 비해 큽니다. GPU 가속을 사용하면 도움이 됩니다. RTX 3090에서는 EasyOCR이 분당 약 60페이지를 처리하는 반면, Tesseract는 CPU에서 분당 25페이지를 처리합니다. 하지만 이는 해당 하드웨어가 있다는 전제하의 이야기입니다. 일반 노트북 CPU에서는 페이지당 3~5초가 걸립니다.
추천 대상: 10분 이내에 작동하는 OCR 데모를 원하는 Python 개발자, 특히 다국어 장면 텍스트에 적합합니다. 비추천 대상: CPU만 있는 하드웨어에서의 대용량 배치 처리, 복잡한 레이아웃 이해가 필요한 문서.
3. PaddleOCR — 복잡한 레이아웃에 강함
Baidu가 PaddlePaddle 프레임워크로 개발한 PaddleOCR은 이 카테고리에서 가장 기능이 풍부한 오픈소스 OCR 엔진입니다. 텍스트 감지, 인식, 테이블 추출, 구조화된 출력을 하나의 파이프라인에 포함하고 있습니다. Tesseract와 EasyOCR이 별도 애드온으로 구현해야 하는 기능들입니다. 80개 이상의 언어를 지원하며, 특히 복잡한 다단 문서와 혼합 언어 페이지에서 뛰어난 성능을 보입니다.
단점은 설정 복잡성입니다. GPU가 없는 시스템에서 PaddleOCR 설치가 까다로울 수 있습니다. Reddit r/LocalLLaMA 커뮤니티에서는 특히 최신 GPU 아키텍처에서 의존성 관리가 다른 대안보다 더 고통스럽다고 자주 지적합니다. 일단 실행되면 빠릅니다. RTX 3090에서 PaddleOCR은 분당 약 120페이지를 처리하며, CPU 전용 처리량보다 약 8배 빠릅니다. 하지만 이러한 하드웨어 요구사항 때문에 간편하게 설치할 수 있는 것은 아닙니다.
추천 대상: GPU를 사용할 수 있고 복잡한 문서 레이아웃, 테이블, 다국어 콘텐츠를 다루는 개발자. 비추천 대상: 간단한 일회성 OCR, CPU 전용 배포, 플러그 앤 플레이 솔루션을 원하는 사람.
무료 온라인 및 내장 도구: 설정 없이 사용, 현실적인 한계
이 도구들은 설치도, 기술적 능력도 필요하지 않습니다. 파일을 업로드하면 텍스트가 나옵니다. 대신 서비스가 제공하는 정확도와 형식 지원을 그대로 받아들여야 하며, 대부분은 깔끔한 영어 문서 외에는 어려움을 겪습니다.
4. Google Drive OCR — 최고의 무료 다국어 텍스트 추출
가장 간단하고 접근하기 쉬운 무료 OCR 옵션입니다. 이미지나 PDF를 Google Drive에 업로드하고 마우스 오른쪽 버튼을 클릭해 Google Docs로 열면 됩니다. Google의 클라우드 OCR 엔진이 텍스트를 추출해 새 문서에 삽입합니다. 수십 개 언어를 지원하며 아랍어, 히브리어, 중국어를 대부분의 전용 무료 도구보다 잘 처리합니다. FastOCR의 비교 벤치마크에서 Google Drive는 영어 문서 96%, 아랍어 88%, 우르두어 82%의 정확도를 기록했습니다. 완전 무료에 설정이 필요 없는 서비스로서는 훌륭한 수치입니다.
큰 문제는 워크플로와 출력 형식입니다. Google Drive OCR은 검색 가능한 PDF를 생성하지 않고 텍스트를 Google Doc으로 추출하기 때문에 원본 페이지 레이아웃이 파괴됩니다. 표, 열, 서식이 사라집니다. 순수한 텍스트 추출에는 괜찮습니다. 원본 레이아웃을 유지해야 하는 상황에는 맞지 않는 도구입니다.
적합한 용도: 레이아웃이 중요하지 않은 빠른 다국어 텍스트 추출. 부적합한 용도: 검색 가능한 PDF 출력, 표 보존, 배치 처리, 민감한 문서(파일이 Google 서버에서 처리됨).
5. PDF24 OCR — 무제한 검색 가능 PDF, 가입 불필요
PDF24는 OCR 기능을 포함한 독일산 무료 PDF 도구 모음입니다. 계정도, 일일 제한도, 파일 크기 제한도 없습니다(일반적인 사용 범위 내에서). 내부적으로 Tesseract를 실행하므로 정확도 특성은 Tesseract의 강점과 약점을 그대로 반영합니다. 깔끔한 영어 인쇄 텍스트에는 안정적이지만, 저품질 스캔, 비라틴 문자, 손글씨에는 신뢰할 수 없습니다. Google Drive OCR이 할 수 없는 제대로 된 검색 가능 PDF를 출력합니다.
이 도구는 완전히 브라우저 기반입니다. 파일이 PDF24 서버에 업로드되어 처리된 후 짧은 시간 내에 삭제됩니다. 문서에 민감한 정보가 포함되어 있다면 우려될 수 있습니다. 로컬/오프라인 옵션은 없습니다.
적합한 용도: 계정 생성이나 제한 없이 영어 전용 검색 가능 PDF 생성. 부적합한 용도: 비라틴 문자, 손글씨, 기밀 문서.
6. Microsoft PowerToys Text Extractor — 화면 텍스트에 최적
Windows 10/11을 사용 중이라면 Microsoft PowerToys에 포함된 Text Extractor 도구(Shift+Win+T로 실행)를 사용해 화면의 아무 영역이나 선택하면 인식된 텍스트가 즉시 클립보드에 복사됩니다. Windows 내장 OCR 엔진을 사용하며 오프라인에서도 작동합니다. 문서 처리를 위한 도구는 아니고, 선택할 수 없는 이미지·오류 메시지·동영상 등 화면 속 텍스트를 긁어오는 용도입니다.
정확도는 글꼴 선명도와 배경 대비에 크게 좌우됩니다. 선명한 UI 텍스트와 조명이 좋은 스크린샷에는 훌륭하고 빠릅니다. 하지만 실제 문서에 가까운 것 — 작은 글씨, 여러 열, 노이즈 있는 배경 — 에는 신뢰할 수 없습니다.
추천 용도: 화면(UI 대화상자, 동영상 프레임, 웹 이미지)에서 텍스트를 빠르게 복사할 때. 비추천 용도: 문서 디지털화, 스캔한 PDF, 배치 처리, 구조화된 출력이 필요한 모든 경우.
7. OCR.space — 개발자를 위한 넉넉한 무료 API
OCR.space는 웹 인터페이스와 무료 REST API를 모두 제공합니다. 무료 요금제는 Engine 1과 2에서 월 25,000회 요청(하루 약 500회), 정확도가 더 높은 Engine 3에서 2,500회 요청을 제공합니다. 이는 모든 OCR 서비스 중 가장 넉넉한 무료 API 할당량입니다. 가입 시 신용카드가 필요하지 않습니다.
정확도는 중간 수준으로, 독립 테스트에 따르면 깨끗한 영어 문서에서 약 90~95%이며 품질이 낮은 입력에서는 떨어집니다. 무료 요금제는 파일 크기 제한이 1MB라서 큰 스캔 PDF는 먼저 분할하지 않으면 작동하지 않습니다. 가끔 OCR이 필요한 내부 도구를 만드는 개발자에게는 이 정도 볼륨을 따라가기 어렵습니다. 프로덕션급 문서 처리에는 상용 클라우드 API(Google Vision, AWS Textract)와의 정확도 차이가 눈에 띕니다.
추천 용도: 중간 볼륨의 영어 텍스트 추출을 위한 무료 OCR API가 필요한 개발자. 비추천 용도: 높은 정확도 요구, 대용량 PDF, 민감한 데이터(원격 서버에서 처리됨).
무료 티어가 있는 상용 도구: 비용 없이 누리는 전문 OCR — 단, 어느 선까지
이 섹션의 도구들은 상용 제품으로, 유료 구독으로 수익을 냅니다. 하지만 각각 실제로 쓸 수 있는 무료 진입점을 제공합니다. 무료 티어를 넘어서면 비용을 내고, 한도 안에 머무르면 계속 무료로 쓸 수 있습니다(또는 의미 있는 체험 기간 동안). 이들은 위의 무료 옵션보다 정확도가 높고 출력 구조도 더 잘 갖춰져 있는데, 판매를 목적으로 만들어졌기 때문입니다.
8. Parseur — 월 20페이지, 모든 기능 포함
Parseur는 AI를 사용해 문서에서 특정 필드를 추출하는 문서 파싱 플랫폼입니다. 무료 티어는 모든 기능이 열린 월 20페이지이며 신용카드가 필요 없습니다. 매달 소수의 인보이스나 영수증을 처리하기에 충분합니다. 유료 요금제는 100페이지 기준 월 $39부터 시작합니다.
Parseur의 강점은 파싱 및 워크플로 엔진입니다. 템플릿을 정의하거나 AI가 필드를 자동 감지하게 하고, 출력 대상(Google Sheets, QuickBooks, Zapier)을 설정하고 예외를 처리할 수 있습니다. 무료 티어는 소량 문서 처리에 실제로 유용하지만, 어느 정도 꾸준히 인보이스를 처리한다면 월 20페이지는 금방 사라집니다.
적합한 용도: 자동 출력이 포함된 소량 문서 파싱 워크플로. 적합하지 않은 용도: 대량 처리, 일회성 텍스트 추출(파일 하나에는 과함), 비업무용 문서.
9. Nanonets — 무료 Credits $200
Nanonets는 기업 AP 팀을 위한 AI 문서 처리 플랫폼입니다. Parseur의 영구 무료 티어와 달리 Nanonets는 무료 Credits $200을 제공하며, 문서 유형에 따라 약 500페이지를 처리할 수 있습니다. 시작하는 데 신용카드는 필요 없습니다. Credits를 다 쓰면 유료 요금제가 월 $499 정도부터 시작합니다.
$200 Credits 풀은 비용 없이 자신의 문서로 플랫폼을 평가하기에 유용합니다. 수백 건의 인보이스를 돌려보고 정확도를 확인한 뒤 결정할 수 있습니다. 하지만 이는 체험이지 지속적인 처리에 쓸 수 있는 무료 티어가 아닙니다. Credits가 소진되면 페이지당 비용이 상당해집니다.
적합한 용도: 실제 문서로 엔터프라이즈급 문서 AI를 구매 전에 평가하기. 적합하지 않은 용도: 지속적인 무료 처리, 예산이 제한된 소규모 사업체(체험 후 가격이 가파름).
10. Adobe Acrobat Online OCR — 1일 1파일
Adobe의 온라인 OCR 도구는 스캔한 PDF와 이미지를 검색 가능한 PDF로 변환합니다. 무료 요금제는 1일 1파일로 제한되어 빡빡하지만 가끔 사용하기에는 충분합니다. 깨끗한 영어 문서에서 정확도는 뛰어나 독립 테스트 기준 약 97%에 달하지만, 비라틴 문자에서는 떨어집니다(공개 벤치마크에서 아랍어 91%).
진짜 한계는 일일 한도입니다. 1일 1파일로는 송장 20장을 한 번에 처리할 수 없습니다. 그러려면 월 $19.99의 Acrobat Pro 정식 구독이 필요합니다. 또한 Adobe의 OCR은 구조화된 데이터를 추출하지 않습니다. 검색 가능한 PDF나 편집 가능한 텍스트를 만들 뿐, 스프레드시트에 바로 쓸 수 있는 필드를 제공하지는 않습니다.
추천 대상: 깨끗한 영어 문서에서 하루에 검색 가능한 PDF 하나를 가끔 만들 때. 비추천 대상: 배치 처리, 비영어 문서, 구조화된 데이터 추출, 하루 한 파일을 넘는 모든 물량.
11. ImageToTable.ai — 무료 데모, 상용 AI 추출
참고: 저는 ImageToTable.ai에서 일하고 있으므로 이 섹션은 그것이 무엇인지 투명하게 밝힙니다 — 무료 OCR 유틸리티가 아니라 상용 AI 추출 도구입니다. 무료 데모가 정말 유용하기에 이 목록에 포함되지만, 전동 드릴이 드라이버를 대체하지 않는 것처럼 Tesseract나 Google Drive OCR을 대체하지는 않습니다.
ImageToTable.ai는 비전 언어 모델 기반의 AI 문서 추출 도구로, 에이전트형 OCR이라고 불리는 범주에 속합니다. 문자를 인식하는 전통적 OCR 엔진과 달리 문서를 의미적으로 읽습니다 — 원하는 필드(예: "Invoice Number", "Total", "Due Date")를 알려주면 페이지 어디에 있는지가 아니라 그 의미를 이해하여 해당 값을 찾아 추출합니다. 이는 위의 1, 2번 범주에 있는 모든 도구가 사용하는 텍스트 인식 방식과 근본적으로 다릅니다.
무료 데모에서는 파일을 업로드하고 열을 정의한 뒤 추출 결과를 즉시 확인할 수 있습니다 — 계정도, 신용카드도, 세션당 시간 제한도 필요 없습니다. PDF, JPG, PNG, WebP 입력을 지원하며 Excel, CSV, JSON, Word로 출력합니다. 무료 데모는 직접 시험해 보는 테스트 드라이브로 이해하면 좋습니다: 특정 파일 유형에서 정확도를 평가하기 위해 몇 개의 문서를 처리해 볼 수 있습니다. 지속적인 사용에는 유료 구독이 필요하며, 요금제는 합리적인 월 요금부터 시작합니다.
ImageToTable.ai와 위의 무료 도구들 사이의 실질적 차이는 간단합니다: 페이지의 모든 텍스트를 인식하는 것이 아니라 특정 데이터 필드(송장 합계, 날짜, 항목)를 추출해야 한다면, 전통적 OCR 도구는 원시 텍스트를 수동으로 복사·붙여넣기하거나 파싱하게 만듭니다. AI 추출 도구는 그 단계를 대신 처리합니다. 오래된 책을 디지털화하거나 PDF를 검색 가능하게 만들고 싶을 뿐이라면, 위의 무료 도구 중 아무거나 써도 됩니다.
파일은 안전하게 처리되며 저장되지 않습니다.
추천 대상: 문서에서 구조화된 데이터(필드, 합계, 항목)를 추출해야 하는 분 — 특히 인보이스, 영수증, 은행 명세서, 양식에서 복사-붙여넣기 없이 처리하고 싶은 경우에 적합합니다. 비추천 대상: 단순 텍스트 디지털화, 검색 가능한 PDF 생성, 책 페이지 대량 OCR, 또는 오프라인 처리가 필요한 경우.
어떤 무료 OCR 도구가 나에게 맞을까요?
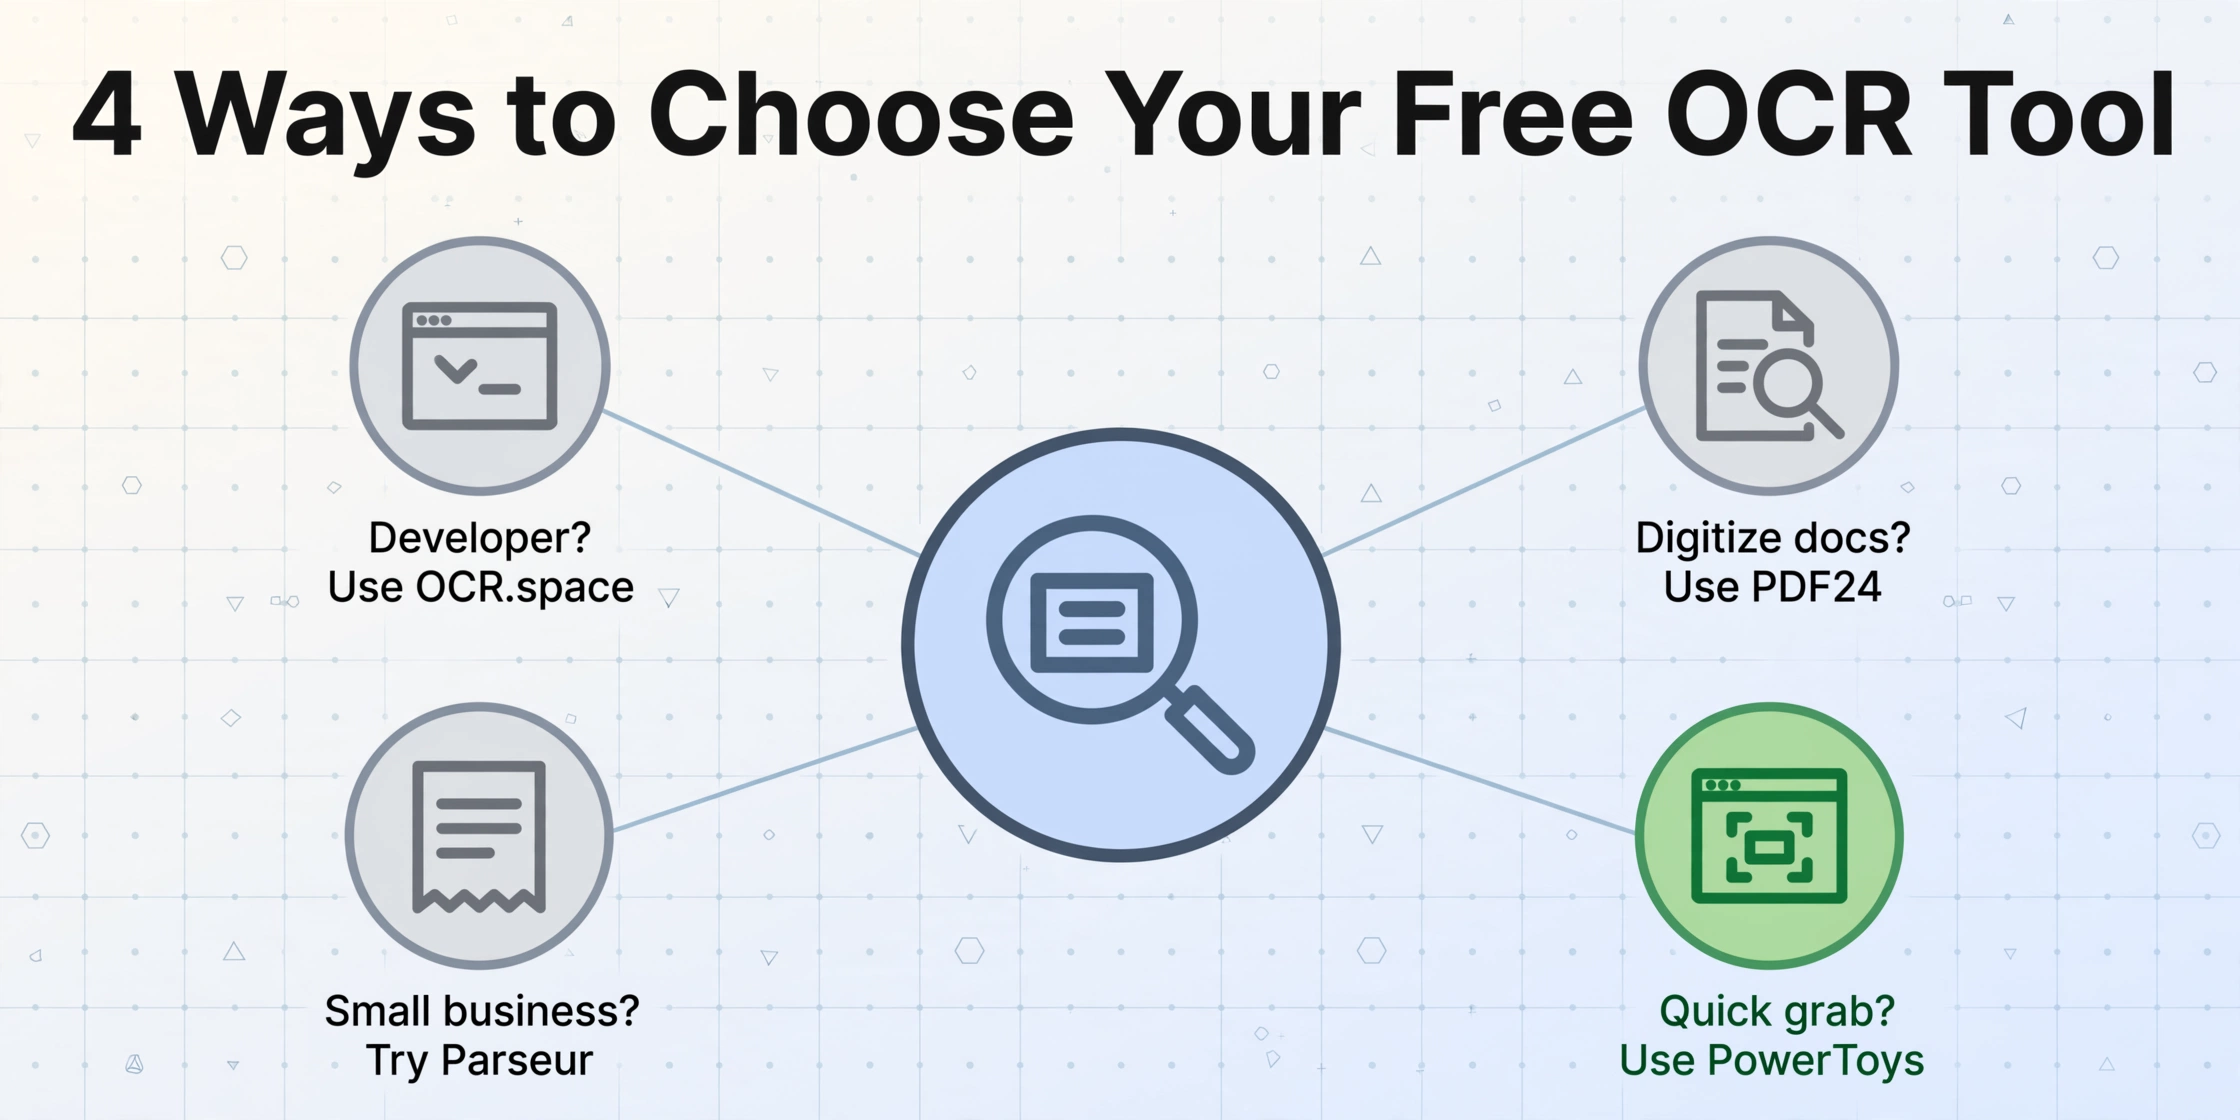
정답은 전적으로 무엇을 하려는지에 달려 있습니다. 전통적인 OCR과 AI 기반 추출 중 어느 접근 방식이 적합한지 아직 고민 중이라면, OCR vs AI 추출 비교에서 그 차이를 자세히 설명합니다. 각 카테고리에서 무료 도구를 선택하는 가장 일반적인 시나리오는 다음과 같습니다:
앱에 OCR을 통합하려는 개발자
빠른 API 통합을 원한다면 OCR.space로 시작하세요(월 25,000회 무료 요청). 로컬/오프라인 처리가 필요하다면 CPU 부담이 적은 텍스트 인식을 위해 Tesseract를, 문서 레이아웃이 복잡하고 GPU를 사용할 수 있다면 PaddleOCR을 사용하세요.
검색을 위해 오래된 문서 더미를 디지털화해야 하는 경우
PDF24를 사용하세요(무료, 제한 없음, 검색 가능한 PDF 출력). 문서가 여러 언어로 되어 있다면 Google Drive OCR을 사용하세요 — 출력 품질은 낮지만 언어 지원 범위가 훨씬 넓습니다.
월 10~30건의 인보이스를 처리하는 소규모 비즈니스
Parseur의 무료 요금제는 월 20페이지를 지원합니다. 인보이스 형식이 매우 다양하다면 자동 필드 추출을 위한 최고의 무료 선택입니다. 파싱 템플릿을 설정하지 않고 지금 바로 스프레드시트로 필드를 추출해야 한다면 ImageToTable.ai 데모를 사용해 보세요.
스크린샷이나 이미지에서 가끔 텍스트를 추출해야 하는 경우
Windows에서는 PowerToys를 설치하고 Shift+Win+T를 사용하세요 — 화면 텍스트를 캡처하는 가장 빠른 방법입니다. 어떤 플랫폼에서든 Google Drive OCR이 대안으로 작동합니다.
주목할 만한 패턴: 무료 온라인 도구는 텍스트 인식(이미지를 문자로 변환)에 탁월합니다. 실제로 필요한 것이 구조화된 데이터 추출 — 인식된 텍스트의 바다에서 인보이스 총액, 납기일, 공급업체 이름을 찾는 것 — 이라면, 무료 도구는 소프트웨어 비용을 수동 정리 시간으로 전환시킵니다. 이것이 중요한 트레이드오프입니다.
어느 범주에 속하는지 잘 모르겠다면 가장 간단한 도구(Google Drive OCR 또는 PDF24 — 언어와 출력 요구에 맞는 쪽)로 시작해 어디까지 되는지 확인해 보세요. OCR 결과를 정리하는 데 데이터를 직접 입력하는 것보다 더 많은 시간이 걸린다면, 그것이 바로 상용 무료 티어를 살펴볼 신호입니다. 사용량이 그 한도를 넘어서면, 그 도구에 비용을 지불할 가치가 있다는 것을 알게 될 것입니다.
자주 묻는 질문
가장 좋은 완전 무료 OCR 소프트웨어는 무엇인가요?
깔끔한 문서에서 영어 텍스트를 추출하는 경우, Google Drive OCR이 가장 좋은 완전 무료 옵션입니다: 파일 수 무제한, 가입 비용 없음, 인쇄 텍스트에서 94~96% 정확도, 놀라울 정도로 좋은 다국어 지원을 제공합니다. 제한 없이 검색 가능한 PDF 출력을 원한다면 PDF24가 가장 좋은 무료 선택입니다(가입 불필요, 일일 한도 없음). 개발자로서 API가 필요하다면 OCR.space에서 월 25,000회 무료 요청을 제공합니다.
Tesseract vs EasyOCR vs PaddleOCR — 어떤 오픈소스 OCR을 사용해야 하나요?
깔끔한 인쇄 텍스트를 위한 가벼운 CPU 전용 엔진이 필요하다면 Tesseract를 사용하세요 — 가장 작은 의존성(약 10MB)이며 CPU에서 가장 빠르게 실행됩니다. 5분 만에 작동하는 Python 데모를 원하고 문서가 어느 정도 깔끔하다면 EasyOCR을 사용하세요. 문서에 복잡한 레이아웃, 표 또는 혼합 언어가 있고 GPU가 있다면 PaddleOCR을 사용하세요 — 다른 두 가지보다 어려운 레이아웃을 더 잘 처리하지만 설정에 가장 많은 노력이 필요합니다.
무료 OCR 소프트웨어로 스캔한 PDF를 편집 가능한 Word나 Excel로 변환할 수 있나요?
네, 하지만 주의할 점이 있습니다. PDF24와 Adobe Acrobat Online(1일 1파일 무료)은 검색 가능한 PDF를 만들고 Word로 내보낼 수 있지만, 표 서식과 열 레이아웃은 종종 손실됩니다. Google Drive OCR은 Google Docs로 출력되므로 원본 레이아웃을 완전히 잃게 됩니다. 구조화된 Excel 출력(특정 열에 특정 필드)의 경우, 무료 텍스트 OCR 도구 중 이를 잘 처리하는 것은 없습니다. ImageToTable.ai나 Parseur 같은 데이터 추출 도구가 필요합니다.
무료 OCR 소프트웨어 중 필기를 처리하는 것이 있나요?
안정적으로는 아닙니다. Tesseract는 LSTM 모델을 사용하고 특정 필기체 스타일에 학습시키면 어느 정도 필기 인식이 가능하지만, 기본 상태에서 필기 인식 정확도는 낮습니다(실제 필기체에서 대략 30~50%). EasyOCR과 PaddleOCR은 인쇄된 필기체에서 조금 더 나은 성능을 보이지만, 대부분의 사용자가 "작동한다"고 여길 수준에는 여전히 크게 못 미칩니다. 무료 온라인 도구(Google Drive, PDF24)는 필기 인식 기능이 사실상 없습니다. 필기의 경우 무료 OCR은 실행 가능한 해결책이 아닙니다. 상용 AI 추출 도구나 전용 필기 OCR 서비스가 필요합니다.
무료 OCR 소프트웨어의 숨은 비용은 무엇인가요?
가장 흔한 숨은 비용은 정리 시간입니다. 200페이지 문서에서 90% 정확도의 결과를 내는 무료 OCR 도구는 20페이지의 오류를 수동으로 수정해야 한다는 뜻이며, 이는 몇 시간이 걸릴 수 있습니다. 두 번째 숨은 비용은 오픈소스 도구의 설정 시간입니다. Tesseract나 PaddleOCR을 프로덕션 파이프라인에서 실행하려면 일반적으로 며칠간의 엔지니어링 작업이 필요합니다. 온라인 도구의 경우 숨은 비용은 데이터 프라이버시입니다. 문서가 원격 서버에서 처리되며, 대부분의 서비스가 파일을 자동 삭제하더라도 전송 중 및 처리 중인 데이터는 사용자의 통제 밖에 있습니다.
무료 OCR을 언제 그만 찾고 유료 도구를 써야 할까요?
세 가지 신호가 있습니다. (1) OCR 오류를 직접 수정하는 데 데이터를 직접 입력하는 것보다 더 많은 시간을 쓰고 있을 때, (2) 단순한 텍스트가 아니라 구조화된 데이터(특정 열에 담긴 특정 필드)가 필요할 때, (3) 매달 꾸준히 50~100개 이상의 문서를 처리할 때입니다. 이 중 하나라도 해당한다면 유료 도구의 비용이 무료 도구에 쏟는 시간보다 적게 듭니다.
2026년 무료 OCR의 결론
2026년의 무료 OCR 환경은 그 어느 때보다 넓어졌지만, 언제나 그랬던 것처럼 한 가지 진실은 그대로입니다. 무료 OCR은 한 가지 특정 작업, 즉 깨끗한 텍스트 이미지를 복사할 수 있는 문자로 바꾸는 일에는 탁월하지만 그 외의 모든 일에는 평범합니다. 바로 그 한 가지가 필요하다면 훌륭한 선택지가 넘칩니다. Google Drive OCR, PDF24, OCR.space는 진정한 무료로 가벼운 사용자부터 개발자까지 아우릅니다. Tesseract, EasyOCR, PaddleOCR은 설정 시간을 투자할 의향이 있는 개발자에게 무제한 처리를 제공합니다.
정말로 필요한 것이 텍스트가 아니라 데이터, 즉 특정 열에 담긴 특정 값이라면, 무료 텍스트 OCR은 여러분의 시간을 어떤 소프트웨어 구독료보다도 커 보이는 비용으로 바꿔 놓을 것입니다. 상용 무료 티어(Parseur의 월 20페이지, Nanonets의 $200 체험, ImageToTable.ai의 무료 데모)가 존재하는 이유는 바로 그 간극이 실제로 존재하기 때문이며, 무료로 충분한지 결정하기 전에 실제 문서로 시험해 볼 가치가 있습니다.
올바른 도구는 가장 높은 정확도 수치를 가진 도구가 아니라, 여러분의 문서가 필요한 정보를 전달하도록 만들고 그 총비용(여러분의 시간 포함)이 그 정보의 가치에 맞는 도구입니다. 가장 단순한 선택지부터 시작해 정리 시간을 측정하고, 그 숫자가 무료로 충분한지 알려주도록 하세요.