Melhor software de OCR em 2026:
9 ferramentas para todos os orçamentos comparadas
O mercado de reconhecimento óptico de caracteres deve crescer de cerca de US$ 10,6 bilhões em 2022 para US$ 32,9 bilhões até 2030, segundo a Grand View Research — e a maior parte desse crescimento está indo para ferramentas que, tecnicamente, não estão fazendo OCR clássico. A palavra "OCR" ainda significa uma coisa na cabeça da maioria das pessoas (transformar uma imagem de texto em caracteres), mas o software que está vencendo a categoria em 2026 faz algo diferente: lê um documento como uma pessoa leria, entende o que os números significam e devolve dados estruturados. Este guia compara nove ferramentas de OCR em todo esse espectro — scanners de desktop, conversores online gratuitos, APIs em nuvem e extração com IA — para você ver onde cada uma se encaixa e, igualmente importante, onde não se encaixa.
Principais Conclusões
- US$ 32,9 bilhões estão sendo investidos em software "OCR" até 2030 — mas a maior parte compra ferramentas que não estão realmente fazendo OCR (transformar imagens de texto em caracteres).
- O OCR tradicional lê onde o texto está na página; o OCR com IA lê o que o texto significa — um nome, dois trabalhos opostos.
- A verdadeira pergunta nunca foi "qual é o melhor OCR", mas "eu preciso de texto ou dados" — responda isso e o grupo certo se escolhe sozinho para você.
O que "OCR" significa em 2026: tradicional vs IA
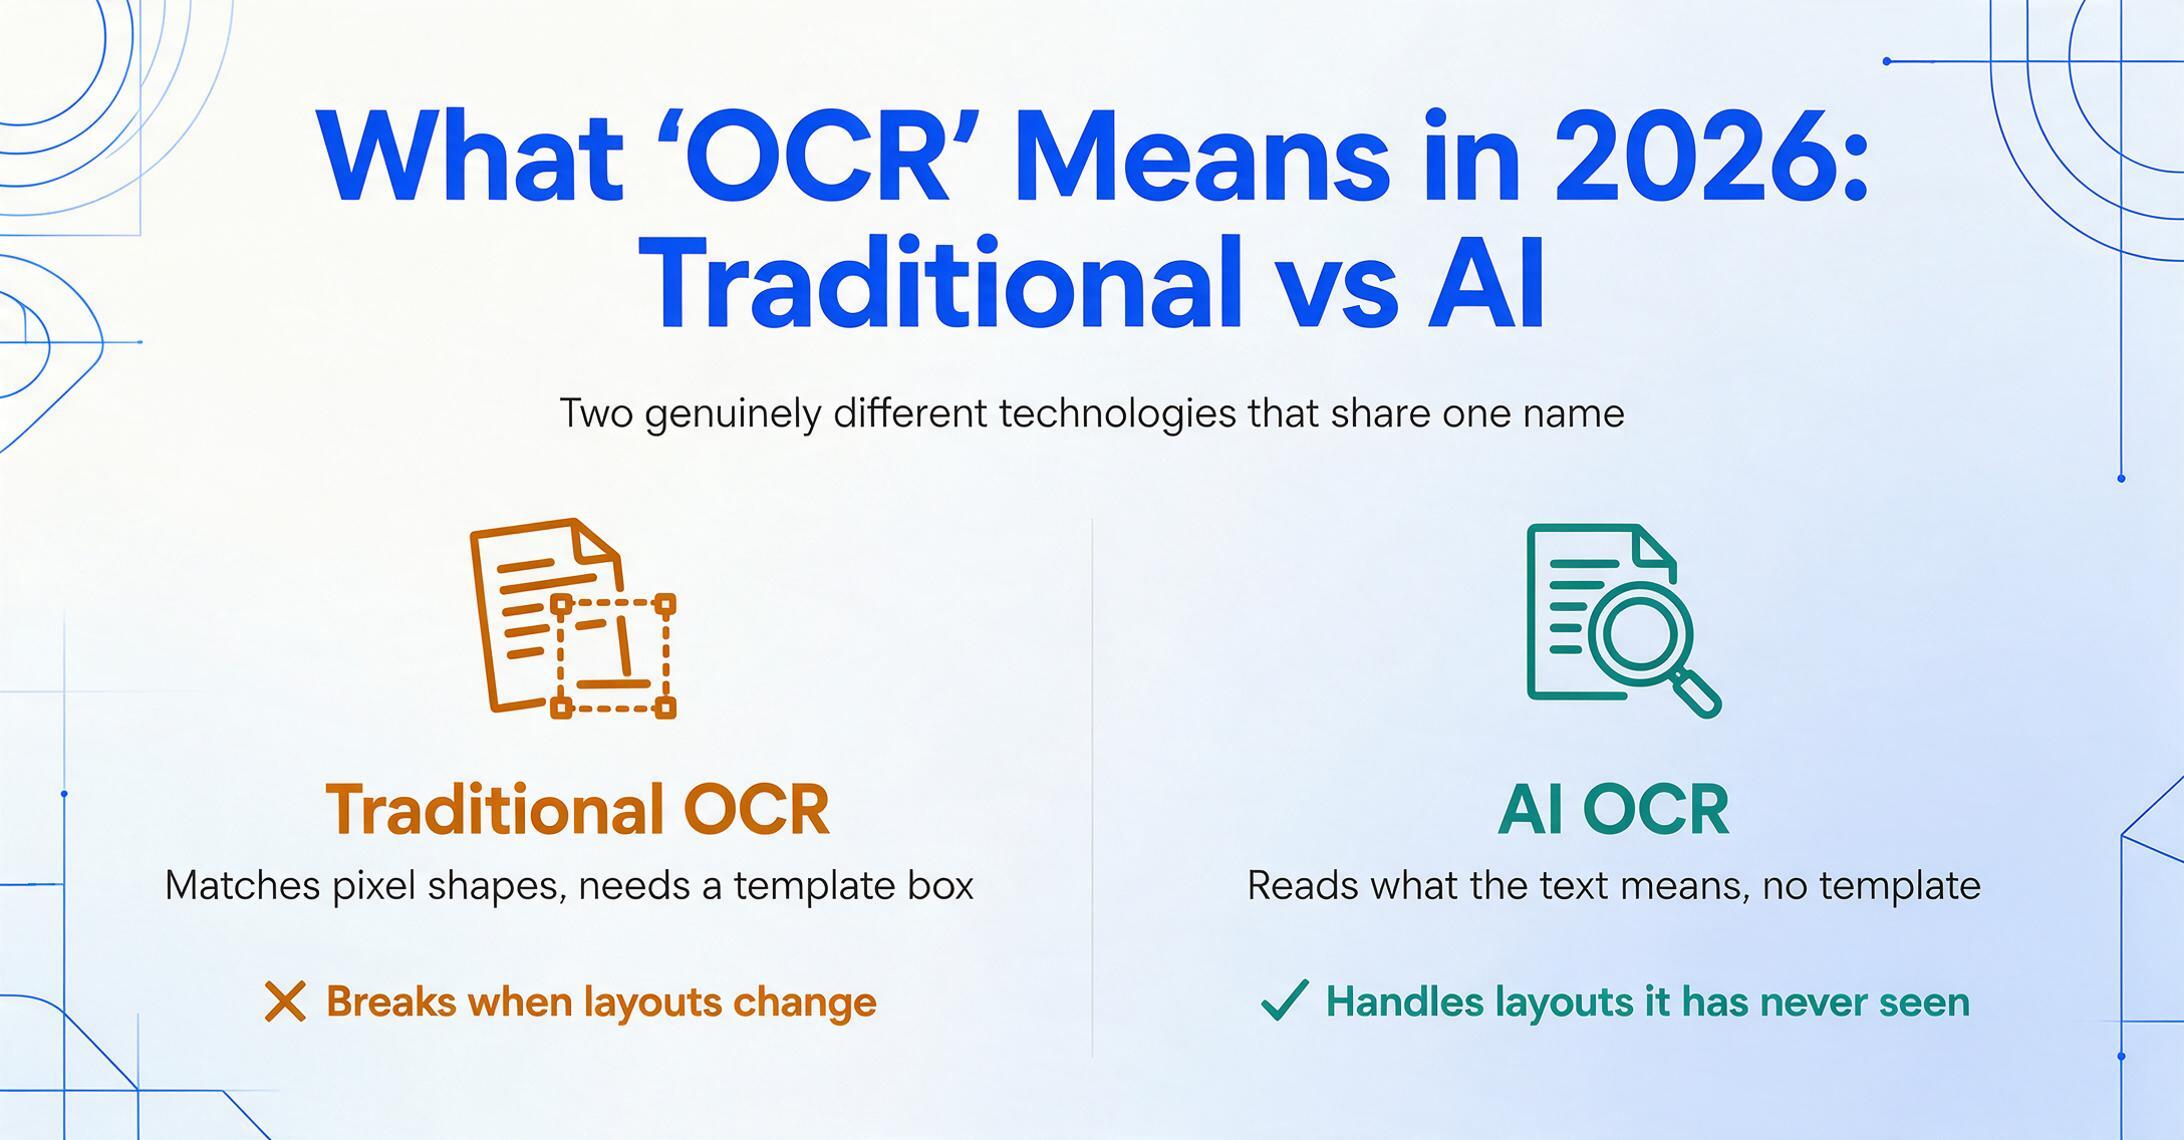
"Software de OCR" hoje se divide em duas tecnologias genuinamente diferentes que compartilham o mesmo nome, e escolher a errada é o motivo mais comum de decepção. Antes de comparar ferramentas, vale dez segundos para traçar essa linha com clareza — porque é ela que decide em qual metade desta lista você deveria estar olhando.
OCR tradicional é reconhecimento de padrões. Ele escaneia uma imagem, compara formas de pixels com uma biblioteca de caracteres e gera texto. É excelente em uma tarefa: transformar uma página escaneada limpa em caracteres pesquisáveis e copiáveis. O que ele não faz é entender. Ele não tem ideia se "1200" é o total de uma fatura ou um CEP — só sabe que são os caracteres que viu. Para extrair um campo específico, as ferramentas tradicionais dependem de modelos (também chamados de OCR zonal): você desenha uma caixa ao redor de onde "Número da Fatura" fica, e a ferramenta copia o que aparecer naquelas coordenadas em cada documento. Mova o campo, mude o fornecedor, envie um escaneamento levemente torto, e a caixa aponta para o lugar errado.
O OCR tradicional lê onde o texto está na página. O OCR com IA lê o que o texto significa. Essa única diferença é o motivo pelo qual o OCR tradicional quebra quando o layout muda, e pelo qual o OCR com IA consegue distinguir a data de uma fatura da data de vencimento sem que ninguém diga onde cada uma está.
OCR com IA (também chamado de OCR inteligente ou baseado em visão) é construído sobre um modelo de linguagem visual. Além de reconhecer caracteres, ele raciocina sobre a página inteira: entende que um valor em dólar pertence a um cabeçalho de coluna específico, infere uma palavra ambígua pelo contexto e se adapta a um layout que nunca viu — sem precisar criar modelo. O ganho prático é que ele consegue devolver dados estruturados, não apenas um bloco de texto. É essa capacidade que um usuário do Reddit em r/automation estava buscando quando descreveu seu problema com PDF escaneado: o OCR bruto "só precisava me deixar perto, e a automação cuidava do resto", mas ele alertou outros a "procurar primeiro uma ferramenta de OCR com melhor retenção de layout." A distância entre "caracteres em uma página" e "dados utilizáveis" é exatamente o que o OCR com IA elimina.
Então a primeira pergunta de verdade não é "qual ferramenta de OCR é a melhor?" — é "eu preciso de texto ou de dados?" Se você só precisa que um PDF escaneado vire pesquisável e editável, uma ferramenta tradicional de desktop ou online é mais rápida e barata. Se você precisa que o conteúdo vire uma planilha com suas próprias colunas, isso é trabalho de extração com IA. Este guia cobre os dois lados. Se você já decidiu que quer só o lado da IA, nosso resumo das melhores ferramentas de OCR com IA analisa ferramenta por ferramenta esse campo mais restrito; aqui, o objetivo é mapear o cenário inteiro.
A linha entre "texto" e "dados" é mensurable. No nosso benchmark de OCR de primeira parte, o melhor motor tradicional e o melhor modelo de visão-linguagem empataram em precisão bruta de caracteres em recibos limpos (docTR CER 0,197 vs Surya2 0,191 no SROIE 2019), mas seu comportamento divergiu na extração de campos: sob regras regex fixas, o VLM extraiu 0,318 de F1 de campo contra 0,077 do docTR — porque o texto bruto do motor tradicional precisa de estruturação downstream, enquanto o VLM já emite texto compreendido. Adicionar um pós-processador LLM elevou ambos a ~0,61–0,62. A conclusão para compradores: se você consome campos, o pipeline de pós-processamento importa mais que o motor de OCR; se você consome texto, o motor tradicional é mais barato e igualmente preciso. Nossa análise de justiça de CER explica por que os números brutos de precisão entre as duas famílias precisam dessa ressalva.
Como Selecionamos e Testamos
Nove ferramentas entraram nesta lista porque juntas representam o verdadeiro espectro do mercado de OCR, não porque sejam fáceis de elogiar. Partimos do que os compradores realmente buscan e do que resúmenes neutros e plataformas de avaliação incluyen consistentemente: os veteranos de OCR de desktop (ABBYY, Adobe), os conversores online gratuitos que todos experimentan primeiro (iLovePDF, SmallPDF, OnlineOCR.net), as APIs cloud para desenvolvedores (Google, AWS) e as ferramentas de extração com IA (Nanonets e nossa própria ImageToTable.ai). Deixamos motores de código aberto como Tesseract fora da lista puntuada — são potentes e gratuitos, mas são uma biblioteca para desenvolvedores, não uma ferramenta que se "usa", então responden a uma pregunta diferente (e os comparamos separadamente em nosso guía de mejores herramientas de OCR de código abierto).
Cada ferramenta foi avaliada em quatro aspectos: o que realmente produz (texto pesquisable ou dados estruturados?), precio real (a cifra publicada más baja, não "a partir de"), quien la opera (un individuo o un desarrollador/equipo?) e ajuste honesto — os trabalhos onde realmente vence e os que não. Os precios foram extraídos da página de precios pública de cada fornecedor e verificados contra plataformas neutras (Capterra, G2, TrustRadius, SoftwareAdvice). Todas as cifras estão atualizadas a Precios verificados em junho de 2026; quando um fornecedor só cotiza precios empresariales sob pedido, o dizemos em lugar de adivinar.
Uma divulgación desde o início: ImageToTable.ai — o produto a que pertence este site — é uma das nove ferramentas revisadas abaixo. O colocamos onde honestamente encaja (extracción de IA sin código para equipos pequeños) e nomeamos os escenarios onde Adobe, ABBYY, Google ou AWS são a melhor opción. Uma recopilación que ocultara sua própria afiliación, ou que pretendiera que uma ferramenta vence em todos os casos de uso, não valdría seu tempo.
Os 9 Melores OCR Tools de Relance
A tabela abaixo é a resposta rápida, agrupada pelos quatro cantos do panorama OCR. "Preço Inicial" é a menor tarifa mensal publicada para cada ferramenta (APIs baseadas em uso são mostradas à sua tarifa por página, já que não têm mínimo mensal). "Preços verificados em junho de 2026."
| Ferramenta | Preço Inicial | Modelo de Preço | Ideal Para | Limitação Principal | Teste Gratuito? |
|---|---|---|---|---|---|
| ABBYY FineReader | $16/mês (ou $199 pagamento único) | Assinatura por usuário / licença vitalícia | Crítico para precisão, offline, 198 idiomas | Foco em desktop; IDP empresarial é liderado por vendas | Sim |
| Adobe Acrobat Pro | $19.99/mês | Assinatura | Edição de PDF com OCR integrado | OCR é um recurso, não extração de dados em massa | Teste de 7 dias |
| iLovePDF | $7/mês (anual) | Assinatura + plano gratuito | Conversões rápidas de PDF/OCR avulsas | A saída é texto/PDF, sem extração de campos | Plano gratuito |
| SmallPDF | $12/mês | Assinatura + plano gratuito | PDF no navegador para pesquisável/Word | Sem campos personalizados, sem tabela de dados mesclada | Plano gratuito |
| OnlineOCR.net | Grátis (15 págs/hora) | Grátis + planos semanais/mensais (a partir de $9.95/semana) | OCR ocasional sem custo, sem instalação | Com limite de uso; sem saída estruturada | Grátis (convidado) |
| Google Document AI | $1.50 / 1.000 páginas | Baseado no uso (por página) | OCR em nuvem de alto volume, para desenvolvedores | Exige configuração de dev; a saída bruta precisa de ajustes | Plano gratuito (GCP) |
| AWS Textract | $1,50 / 1.000 páginas | Baseado em uso (por chamada de API/página) | OCR de alto volume em stacks AWS | Só para desenvolvedores; formulários/tabelas custam 10–33x mais | Camada gratuita (1k págs/mês, 3 meses) |
| Nanonets | $499/mês (Pro) | Créditos por execução ($0,30/extração) | Automação de AP de médio porte a enterprise | Muitas vezes precisa de treinamento com amostras; caro para PMEs | Camada gratuita/teste |
| ImageToTable.ai | $9/mês | Assinatura + PAYG (baseado em créditos) | Extração de IA sem código para planilhas | Sem sincronização nativa com ERP, sem SOC 2/HIPAA | Camada gratuita |
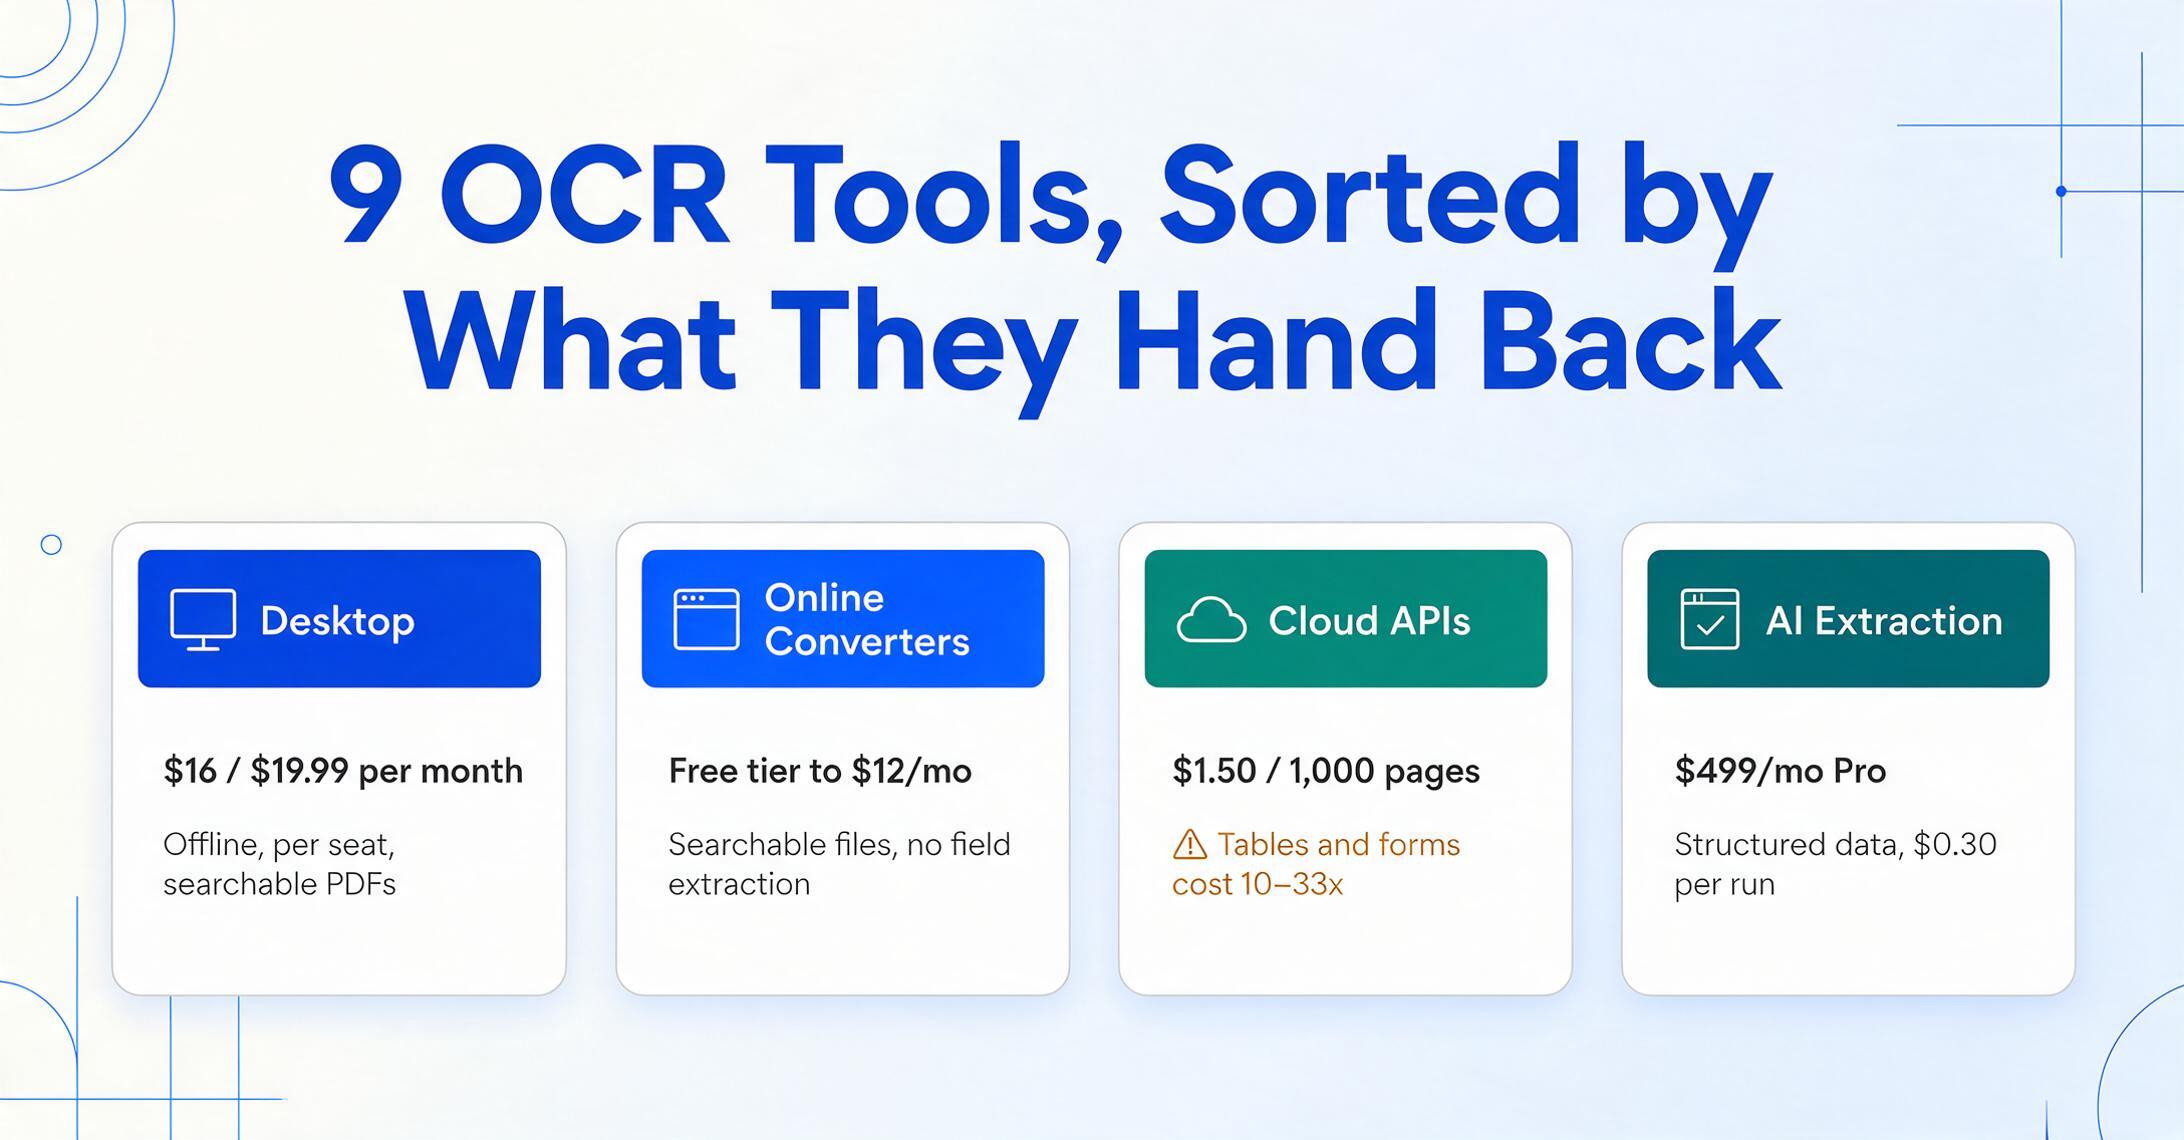
Vale a pena mencionar um padrão antes de ir ferramenta por ferramenta: o preço quase não te diz nada sobre a qualidade de leitura aqui, e quase tudo sobre o que rodea a leitura. Um conversor online de $7/mês e uma plataforma de IA de $499/mês podem ambos transformar uma fatura limpa em texto preciso. A diferença de 70x compra saída estruturada, pipelines em lote, integraciones e suporte — capacidades que ou você precisa ou não. O resto deste guia trata de descobrir qual.
Potências de OCR para desktop: ABBYY FineReader & Adobe Acrobat Pro
Se o seu objetivo é o trabalho clássico de OCR — transformar um documento escaneado em um arquivo limpo, pesquisável e editável na sua própria máquina — os dois veteranos de desktop ainda são a referência. Ambos são maduros, funcionam offline e são construídos em torno do PDF, não da planilha.
ABBYY FineReader PDF
A ABBYY é a veterana do OCR e ainda a referência em precisão, com comparações independentes citando até 99,8% em 198 idiomas. O FineReader PDF é uma ferramenta de OCR e PDF para desktop a partir de $16/mês na edição Standard para Windows (a Corporate custa $24/mês), ou aproximadamente $199 como licença única — uma vantagem real se você não gosta de assinaturas. Os pontos fortes são fidelidade de layout, arquivos multilíngues e processamento totalmente offline, o que importa para trabalhos que exigem privacidade. A ABBYY também vende produtos de IDP empresarial (Vantage, FlexiCapture) com preço por página por meio de cotações personalizadas.
Ideal para: OCR com precisão crítica, arquivos de documentos multilíngues, trabalho on-premise/offline e fluxos de PDF sérios. Não é ideal para: quem quer um app na nuvem que devolve uma planilha pronta — o FineReader desktop não foi feito para automação de API em lote, e o nível empresarial é conduzido por vendas, com uma fase real de implementação. Veja o comparativo direto na nossa comparação com ABBYY FineReader. Ver preços do ABBYY FineReader →
Adobe Acrobat Pro
O Adobe Acrobat Pro inclui um OCR competente na ferramenta de PDF que milhões de escritórios já usam, por $19,99/mês (Pro para Pessoas Físicas, cobrança anual mensal; Standard é $14,99, Studio $24,99). O recurso "scan para PDF editável" transforma documentos escaneados em arquivos pesquisáveis e editáveis em alguns cliques e, como faz parte do pacote completo do Acrobat, o OCR fica ao lado de edição, assinatura, comparação e exportação. Para a maioria das pessoas, o apelo é simples: elas já têm o programa.
Ideal para: profissionais que vivem em PDFs e querem um OCR sólido como um recurso entre muitos — editar, assinar, converter e tornar scans pesquisáveis num só lugar. Não é ideal para: trabalhos de alto volume ou dados estruturados — o OCR do Acrobat torna o documento pesquisável, mas não vai extrair "cada item de 50 notas fiscais para uma planilha". Para essa conversão especificamente, veja como um PDF escaneado vira uma tabela no Excel e a nossa comparação com o Adobe Acrobat para os prós e contras. Ver preços do Adobe Acrobat →
Conversores de OCR gratuitos e online: iLovePDF, SmallPDF e OnlineOCR.net
Para uma conversão pontual, o OCR mais rápido e barato está em uma aba do navegador — sem instalação, geralmente gratuito. Essas ferramentas ganham em conveniência e perdem em tudo que exige repetibilidade ou estrutura, que é exatamente a troca certa para uso ocasional.
iLovePDF
O iLovePDF é um conjunto de ferramentas de PDF baseadas em navegador — mesclar, dividir, compactar, converter e OCR — com um plano gratuito generoso e Premium a partir de $7/mês no plano anual (cerca de $9 por mês). O recurso de OCR torna PDFs escaneados pesquisáveis e os converte em formatos editáveis, e a interface é praticamente sem atrito.
Ideal para: pessoas que precisam fazer OCR ou converter um PDF ocasional sem pagar por um pacote de desktop. Não é ideal para: extração estruturada ou volume — a saída é texto pesquisável ou um arquivo Word/Excel que espelha a página, não dados mapeados para colunas que você escolhe, e os planos gratuitos limitam o tamanho do arquivo e as tarefas diárias. Ver preços do iLovePDF →
SmallPDF
O SmallPDF cobre o mesmo território de PDF no navegador — converter, compactar, editar e fazer OCR de arquivos escaneados em documentos pesquisáveis e editáveis — com um plano gratuito e Pro por $12/mês ($108/ano). Ele recebe consistentemente altas avaliações de facilidade de uso, e o Smallpdf Desktop adiciona acesso offline para usuários pagantes.
Ideal para: usuários que querem um aplicativo web limpo e confiável para tornar escaneamentos pesquisáveis e converter PDFs em layouts do Word ou Excel de vez em quando. Não é ideal para: trabalhos em lote que mesclam muitos documentos em uma tabela consistente, ou qualquer fluxo de trabalho que precise de campos personalizados — como seus concorrentes, ele converte um documento, não modela seus dados. Ver preços do SmallPDF →
OnlineOCR.net
OnlineOCR.net é a opção mais básica e genuinamente gratuita: no modo Convidado (sem registro), ele converte até 15 páginas por hora para Word, Excel ou texto. Se você precisar de mais, os planos pagos começam em $9,95/semana (2.000 páginas) ou $29,95/mês (10.000 páginas). Não há nada para instalar e nenhuma conta é necessária para começar.
Melhor para: uma conversão rápida, gratuita e sem cadastro quando você tem algumas páginas e não se importa com acabamento. Não é ideal para: documentos sensíveis, grandes volumes ou qualquer saída estruturada — o limite de taxa, o tratamento básico de layout e a falta de extração em nível de campo fazem dele uma utilidade, não uma ferramenta de fluxo de trabalho. Ver preços do OnlineOCR.net →
Todos os três compartilham o mesmo teto: eles entregam um documento, não dados. No momento em que "preciso que isso seja pesquisável" vira "preciso desses campos de 200 deles em uma planilha", você saiu da categoria de conversores — e está escolhendo entre uma API para desenvolvedores e uma ferramenta de extração com IA. Se você está avaliando as opções mais novas de imagem para texto (incluindo chatbots como ChatGPT e Claude), nosso guia de melhores conversores de imagem para texto com IA os compara lado a lado.
APIs de OCR em Nuvem para Desenvolvedores: Google Document AI & AWS Textract
Se você tem recursos de engenharia e um volume alto e constante, as APIs de OCR dos hyperscalers são imbatíveis em custo bruto por página. Elas não são aplicativos que você "usa" — são serviços sobre os quais você constrói, o que é tanto a força quanto a pegadinha.
Google Document AI
Google Document AI é uma plataforma em nuvem com uma família de processadores: um processador geral de OCR Enterprise Document, além de Form Parser e Custom Extractor para campos estruturados. O OCR básico custa $1,50 por 1.000 páginas (caindo para $0,60 acima de 5 milhões de páginas/mês), enquanto Custom Extractor e Form Parser custam $30 por 1.000 páginas. O suporte a escrita à mão é forte em formulários estruturados.
Melhor para: equipes de desenvolvimento que precisam de reconhecimento escalável baseado em API em alto volume, especialmente aquelas que já usam Google Cloud. Não é ideal para: não desenvolvedores — não há aplicativo clicável, e o OCR retorna blocos de texto brutos que precisam de pós-processamento antes de estarem prontos para planilhas. O custo também aumenta rápido quando você passa do OCR básico para a extração estruturada. Ver preços do Google Document AI →
AWS Textract
AWS Textract é o serviço de OCR de documentos da Amazon, exposto através de várias APIs (Detect Document Text, Analyze Document, Analyze Expense, Analyze ID). Detect Document Text custa $1,50 por 1.000 páginas ($0,0015/página, caindo a $0,0006 acima de 1M de páginas), mas os recursos estruturados são muito mais caros — tabelas custam cerca de $15 por 1.000 páginas e formulários cerca de $50 por 1.000 páginas. Um nível gratuito cobre 1.000 páginas/mês durante os três primeiros meses.
Ideal para: equipes que já estão dentro do ecossistema AWS e que querem OCR como um bloco de construção em um pipeline maior. Não é ideal para: qualquer pessoa sem desenvolvedores, ou cargas de trabalho dominadas por formulários e tabelas, onde o custo por página é de 10 a 33 vezes a tarifa base. Analizamos os trade-offs em nossa comparação AWS Textract. Ver precios de AWS Textract →
Ambas as APIs compartilham o mesmo limite para compradores não técnicos: leem bem os documentos, mas transformar sua saída em uma planilha final — com seus nomes de colunas, seus formatos, seus cálculos — é um projeto, não um recurso. Essa é exatamente a lacuna que as ferramentas de extração com IA preenchem.
Extração de Dados com IA: Nanonets & ImageToTable.ai
No extremo oposto do espectro estão as ferramentas onde "OCR" é apenas o primeiro passo — elas leem o documento, depois o entendem e devolvem dados estruturados, sem necessidade de modelo. Este é o grupo que está impulsionando o crescimento do mercado, e vai desde plataformas de workflow pesadas até aplicações no-code leves.
Nanonets
Nanonets é uma plataforma de automação de workflows e IA de documentos voltada diretamente a equipes de contas a pagar. Tem um nível gratuito Starter, mas o plano Pro de produção começa em $499/mês, com extração cobrada a $0,30 por execução em um sistema de créditos. É rica em integraciones (QuickBooks, Sage, Xero) e construida para executar um pipeline de documentos de ponta a ponta — e os hilos de Reddit sobre extração de recibos a mencionam regularmente entre as opções mais fortes.
Ideal para: automação de AP de mid-market a enterprise, onde os workflows de aprobación e as integraciones contables justifican o preço. Não é ideal para: equipes pequenas ou qualquer pessoa que queira zero configuração — Nanonets muitas vezes implica cargar muestras e entrenar modelos para tipos de documentos complexos, o que agrega uma curva de onboarding. Nuestra comparación Nanonets cubre onde essa configuração vale a pena. Ver precios de Nanonets →
ImageToTable.ai
ImageToTable.ai — o produto por trás deste site, e uma das nove ferramentas nesta comparação — é uma ferramenta de extração de dados com IA construída sobre um modelo de visão de grande porte, voltada para quem quer dados estruturados sem código, modelos ou fase de treinamento. Seu mecanismo central é a Extração de Colunas Personalizadas: em vez de desenhar zonas, você digita os nomes das colunas que deseja — "Número da Fatura", "Data de Vencimento", "Total" — e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa. Por ser sem modelo, um novo layout de fornecedor não exige configuração. Ela adiciona duas coisas que conversores e OCR básico não têm: colunas calculadas (defina "Total da Linha (Qtd × Preço Unitário)" e a IA faz a matemática durante a extração) e colunas inferidas (uma coluna "Categoria" que a IA preenche mesmo quando o documento não tem esse campo). A saída vai direto para Excel, CSV, JSON ou Word, com um complemento nativo do Google Sheets. O preço começa com um plano gratuito, depois $9/mês, com créditos pré-pagos que não expiram.
Ideal para: freelancers, contadores e equipes pequenas a médias que querem extração sem código e sem modelo para uma planilha a baixo custo por documento — incluindo documentos manuscritos e fotos de celular. Não é ideal para: empresas que precisam de sincronização nativa com ERP em um clique, implantação on-premise ou conformidade com SOC 2 / HIPAA — para essas, ABBYY, Google ou AWS é a escolha certa. É uma ferramenta de extração, não uma plataforma de AP com roteamento de aprovações. Você pode ver a abordagem sem código na nossa página de extração OCR, ou comparar o campo mais amplo no nosso resumo de ferramentas de extração de dados de documentos. Experimente o ImageToTable.ai grátis →
Vale uma nota rápida sobre as ferramentas que as pessoas costumam usar aqui: chatbots de propósito geral como ChatGPT e Gemini leem documentos de forma impressionante e servem para um uso pontual, mas não têm um esquema de saída obrigatório nem um pipeline em lote, então o mesmo prompt pode retornar estruturas de coluna diferentes entre execuções. Para um processo repetível, uma ferramenta especializada vence. Se seu interesse é estritamente o lado da IA no OCR, nosso guia de melhores softwares de OCR com IA compara nove dessas ferramentas em profundidade.
Como escolher: pelo que você realmente precisa
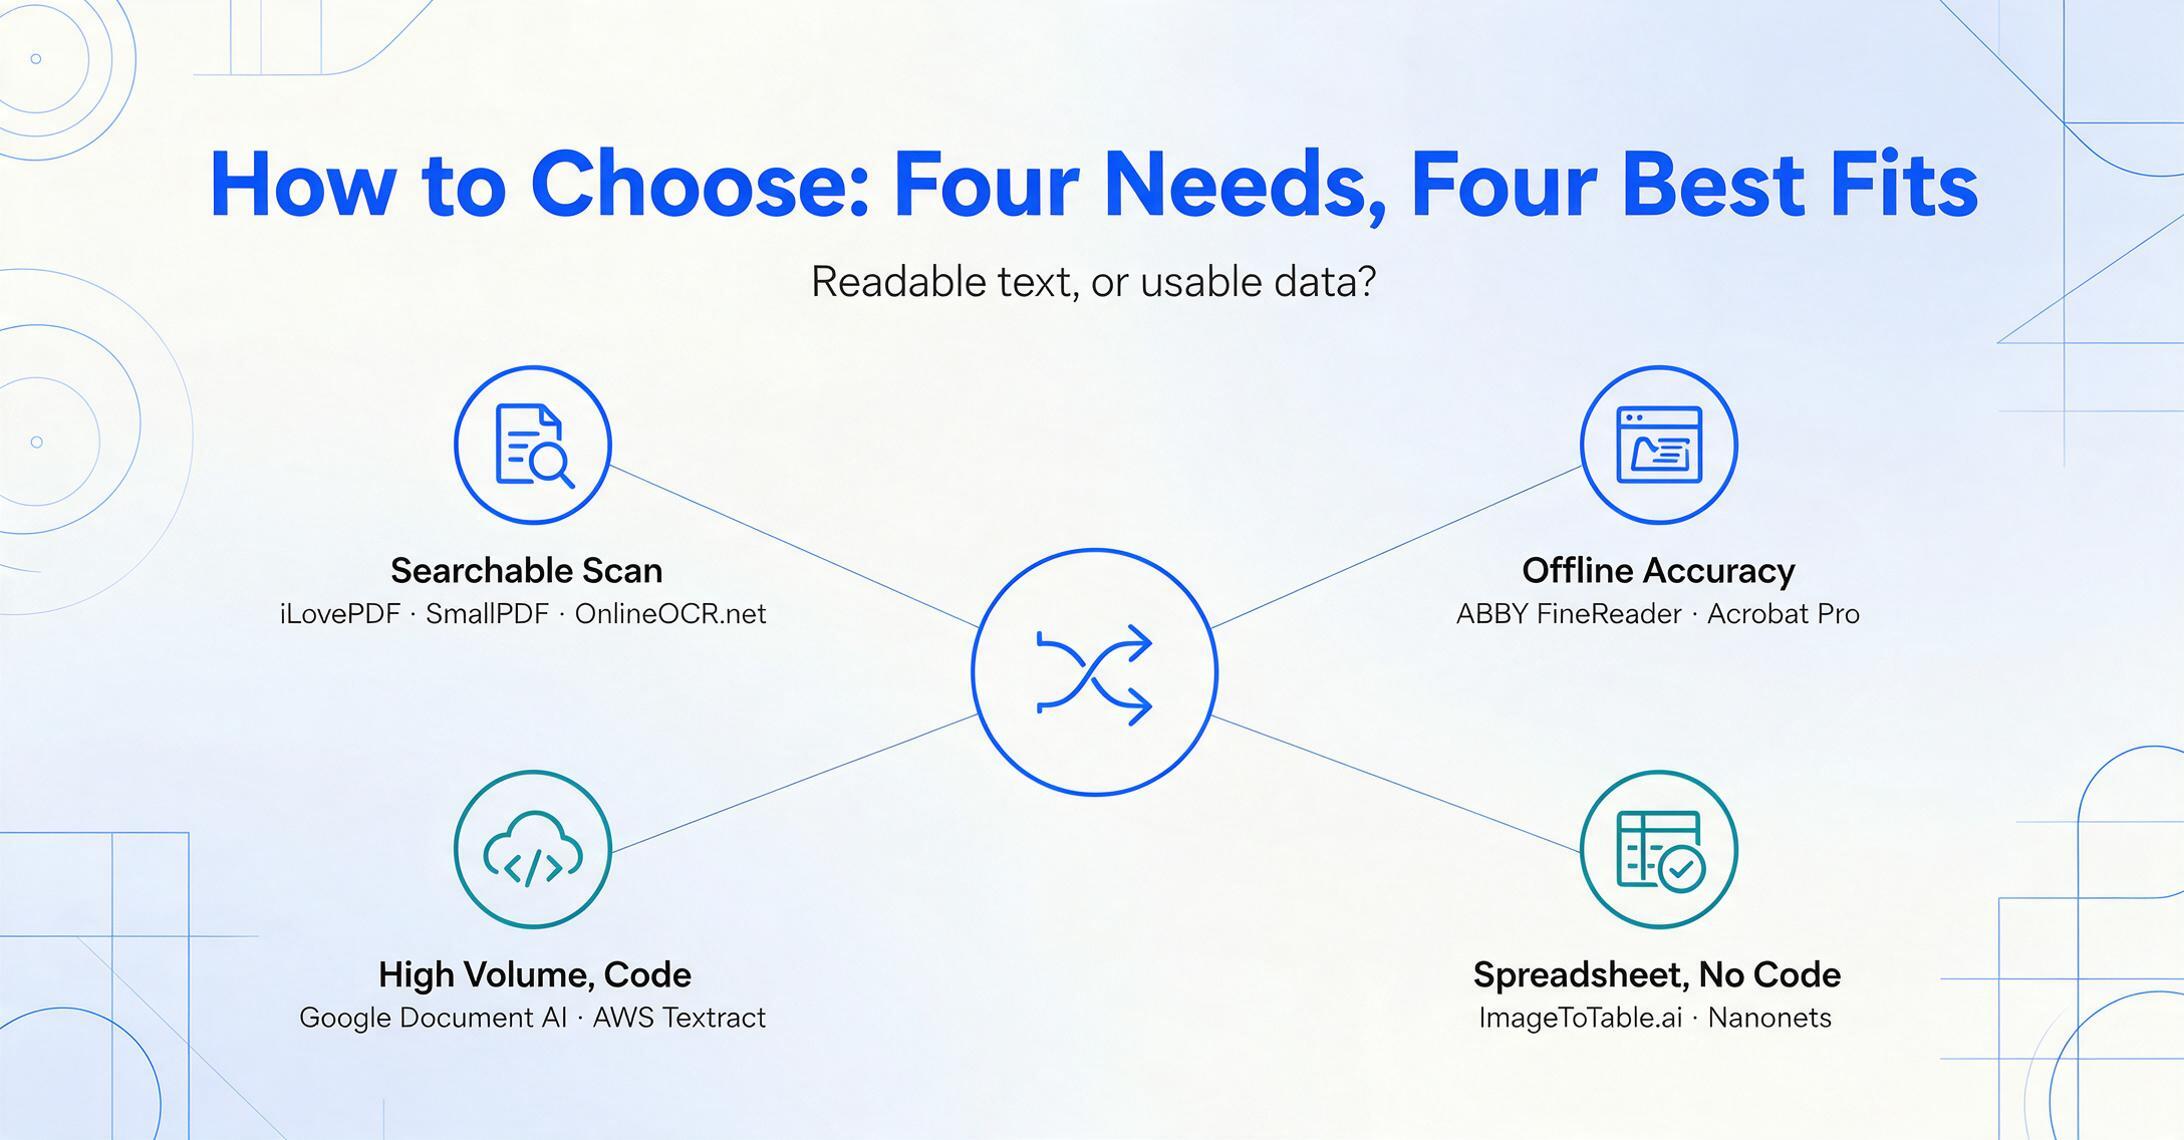
A ferramenta de OCR certa depende de uma pergunta direta — você precisa de texto legível ou dados utilizáveis? — e depois do seu volume e de quem vai operar. Aqui está a decisão em quatro situações comuns.
"Só preciso que este scan seja pesquisável"
Melhor opção: iLovePDF, SmallPDF ou OnlineOCR.net
Poucos documentos, necessidade ocasional, e a saída é um arquivo pesquisável ou editável. Comece grátis no navegador; só pague se atingir os limites de volume ou tamanho de arquivo. Não faz sentido comprar uma plataforma para isso.
"Trabalho com PDFs o dia todo / preciso de precisão offline"
Melhor opção: Adobe Acrobat Pro ou ABBYY FineReader
Controle no desktop, precisão de primeira linha, arquivos multilíngues ou sensíveis à privacidade, e OCR ao lado da edição completa de PDF. Escolha Adobe pela suíte familiar, ABBYY pela máxima precisão e uso offline.
"Tenho desenvolvedores e volume alto e constante"
Melhor opção: Google Document AI ou AWS Textract
Menor custo por página em escala, e você pode transformar a saída bruta em dados estruturados via código. Escolha pela nuvem que você já usa e reserve orçamento para o salto quando formulários e tabelas entrarem na jogada.
"Preciso de dados em uma planilha, sem código"
Melhor opção: ImageToTable.ai (times pequenos) ou Nanonets (AP em escala)
Este é o trabalho de extração com IA. Para usuários individuais e times enxutos que querem colunas que você define, comece sem código e barato. Para um pipeline de AP de médio porte com aprovações e integrações, uma plataforma como Nanonets justifica o preço.
Se a sua situação pende para dados estruturados em vez de texto pesquisável, o lado de IA desta lista é onde está o valor — e vale a pena ler os comparativos mais aprofundados por segmento: a comparação ampla de software de OCR com IA, opções feitas para pequenas empresas e usuários individuais, e ferramentas que funcionam nativamente no Google Sheets. Se você precisa principalmente de Word editável a partir de um scan, o nosso comparativo de conversores de PDF para Word cobre esse caso.
Perguntas Frequentes
Qual é a diferença entre OCR tradicional e OCR com IA?
O OCR tradicional converte imagens de texto em caracteres comparando formatos de pixels — ele lê onde o texto está, mas não entende o que significa, então depende de modelos e falha quando o layout muda. O OCR com IA usa um modelo de linguagem visual para entender a estrutura e o contexto do documento: ele sabe que um valor pertence a uma coluna específica, distingue a data da fatura da data de vencimento, lida com layouts que nunca viu e pode retornar dados estruturados em vez de apenas texto pesquisável — sem precisar de modelo.
Qual é o melhor software de OCR gratuito?
Para conversões ocasionais, o OnlineOCR.net é realmente gratuito e sem cadastro (15 páginas/hora), e o iLovePDF e o SmallPDF têm planos gratuitos para tornar PDFs pesquisáveis. Para extração gratuita com IA para uma planilha, o ImageToTable.ai tem um plano gratuito, e as APIs em nuvem (Google, AWS) oferecem níveis gratuitos se você tiver desenvolvedores. Os planos gratuitos limitam volume e tamanho de arquivo, então servem para trabalhos pontuais, não para um fluxo contínuo.
Qual software de OCR é o mais preciso?
Em documentos impressos limpos, as melhores ferramentas chegam aos 90% — o ABBYY FineReader é amplamente citado com até 99,8% em 198 idiomas, e ferramentas modernas de IA relatam até 99% em dados de tabelas impressas. A precisão diverge em entradas reais bagunçadas: layouts variados, digitalizações ruins e principalmente manuscritos, onde até os melhores modelos ficam bem abaixo da precisão de texto impresso. A questão prática não é a precisão máxima, mas com que frequência seus documentos fogem do caso "limpo e previsível".
Preciso de software de OCR ou extração de dados com IA?
Escolha pelo seu resultado. Se você precisa que um documento digitalizado vire texto pesquisável, editável ou PDF, o OCR tradicional (conversor de desktop ou online) é mais rápido e barato. Se você precisa transformar o conteúdo em linhas e colunas estruturadas — por exemplo, itens de muitas faturas unidos em uma planilha — isso é trabalho de extração de dados com IA, e um conversor não vai te levar lá, por mais precisa que seja a precisão do OCR dele.
O software de OCR consegue ler escrita à mano?
O OCR baseado em IA/visão lee escrita à mano muito melhor que o OCR tradicional de correspondência de padrões, porque interpreta letras usando contexto. Dito isso, a escrita à mano continua sendo o caso mais difícil — a precisão cae notoriamente em cursiva e notas desordenadas até para modelos líderes —, por isso, para trabalhos com muita escrita à mano, vale a pena testar seus documentos reais em um nível gratuito antes de se comprometer.
O OCR do Adobe Acrobat é bom o suficiente para negócios?
Para tornar PDFs escaneados pesquisables e editables dentro de um fluxo de trabalho PDF, sí — Adobe Acrobat Pro ($19.99/mês) é sólido e conveniente se você já usa Acrobat. Onde ele fica aquí é na extração estruturada em volume: ele torna um documento pesquisable, mas não vai extraer campos específicos de centenas de documentos em uma única planilha. Para isso, uma API de nube ou uma herramienta de extração com IA é a opção mais adequada.
A Conclusão Final
A coisa mais útil que você pode levar desta comparação é que "software de OCR" não é uma única categoria — é um espectro, e sua posição nele é decidida por uma única pregunta: texto ou dados? Herramientas de escritorio (Adobe, ABBYY) e conversores online (iLovePDF, SmallPDF, OnlineOCR.net) fazen documentos legibles. APIs de nube (Google, AWS) e herramientas de extração com IA (Nanonets, ImageToTable.ai) fazen documentos estruturados. Todos "fazen OCR"; diferem completamente no que devolvem e em quem se espera que os opere.
Não escolha a herramienta de OCR mais potente — escolha aquella cuja saída corresponda à sua necessidade. Se você quer um escaneo pesquisable, o conversor mais barato o faz. Se você quer uma planilha, nenhuna quantidade de precisão de OCR tradicional vai te levar até lá; isso é trabalho de extração com IA.
Se você se deu conta de que precisa de dados e não só texto — colunas que você nomea, preenchidas, em uma pilha de documentos —, o extremo de IA sem código desta lista não custa nada para experimentar, e alguns segundos te dirán se lee seus documentos específicos corretamente. Sube um, escreba as colunas que você quer e veja como aparecen preenchidas.
Divulgación: Este guía é publicado por ImageToTable.ai, que é uma das nueve herramientas revisadas acima. Buscamos uma avaliação justa e técnica — incluindo nomear os escenarios onde herramientas competidoras são a melhor opção. Os precios dos competidores foram tomados de páginas de precios públicas e plataformas de revisión neutras e estão atualizados até junho de 2026; verifique as cifras más recentes no site de cada fornecedor antes de comprar.