Melhores conversores de imagem a texto com inteligência artificial em 2026:
7 ferramentas comparadas
Um chatbot de IA geral consegue ler uma imagem de forma confiável, ou você precisa de uma ferramenta dedicada? Essa única pergunta é o que separa as sete ferramentas deste guia — e a maioria das listas de "melhores conversores de imagem a texto" nunca a responde. Elas colocam Google Lens, ChatGPT e um site gratuito de reconhecimento óptico de caracteres (OCR) no mesmo ranking de 5 estrelas como se fizessem o mesmo trabalho. Não é o caso. Uma é um utilitário de celular para uma captura rápida, uma é um modelo brilhante mas não determinístico, e uma é feita para ler o mesmo tipo de documento cem vezes e te dar o mesmo resultado exportável cada vez. Esta é uma comparativa técnica das três categorias: quanto custa cada ferramenta, em que é realmente boa e — a parte que mais importa — onde falha silenciosamente.
Principais conclusões
- ChatGPT consegue ler texto manuscrito de uma foto com cerca de 85% de precisão e zero configuração — exatamente por isso as pessoas pararam de abrir apps de OCR.
- O verdadeiro risco não são os caracteres que ele deixa passar — é o valor errado, limpo e confiante que ele inventa silenciosamente, e um diferente que ele te entrega na próxima execução.
- Uma ferramenta dedicada lê a milésima imagem da mesma forma que a primeira e te dá um arquivo finalizado e exportável — para que você pare de revisar manualmente uma centena de capturas.
O que "Image to Text" realmente significa em 2026
"Image to text" agora abarca três categorias fundamentalmente diferentes de ferramentas, e escolher bem começa por saber qual delas sua tarefa precisa. A frase costumava significar uma coisa: reconhecimento óptico de caracteres (OCR) — software que olha uma imagem de palavras e digita os caracteres. Ese fluxo de trabalho original de image to text ainda é o núcleo de todas as ferramentas abaixo. Em 2026, abarca um espectro que vai desde um botão gratuito no celular até um modelo de linguagem de grande escala que raciocina sobre o que vê, e as diferenças de confiabilidade entre eles são maiores do que os números de precisão sugerem.
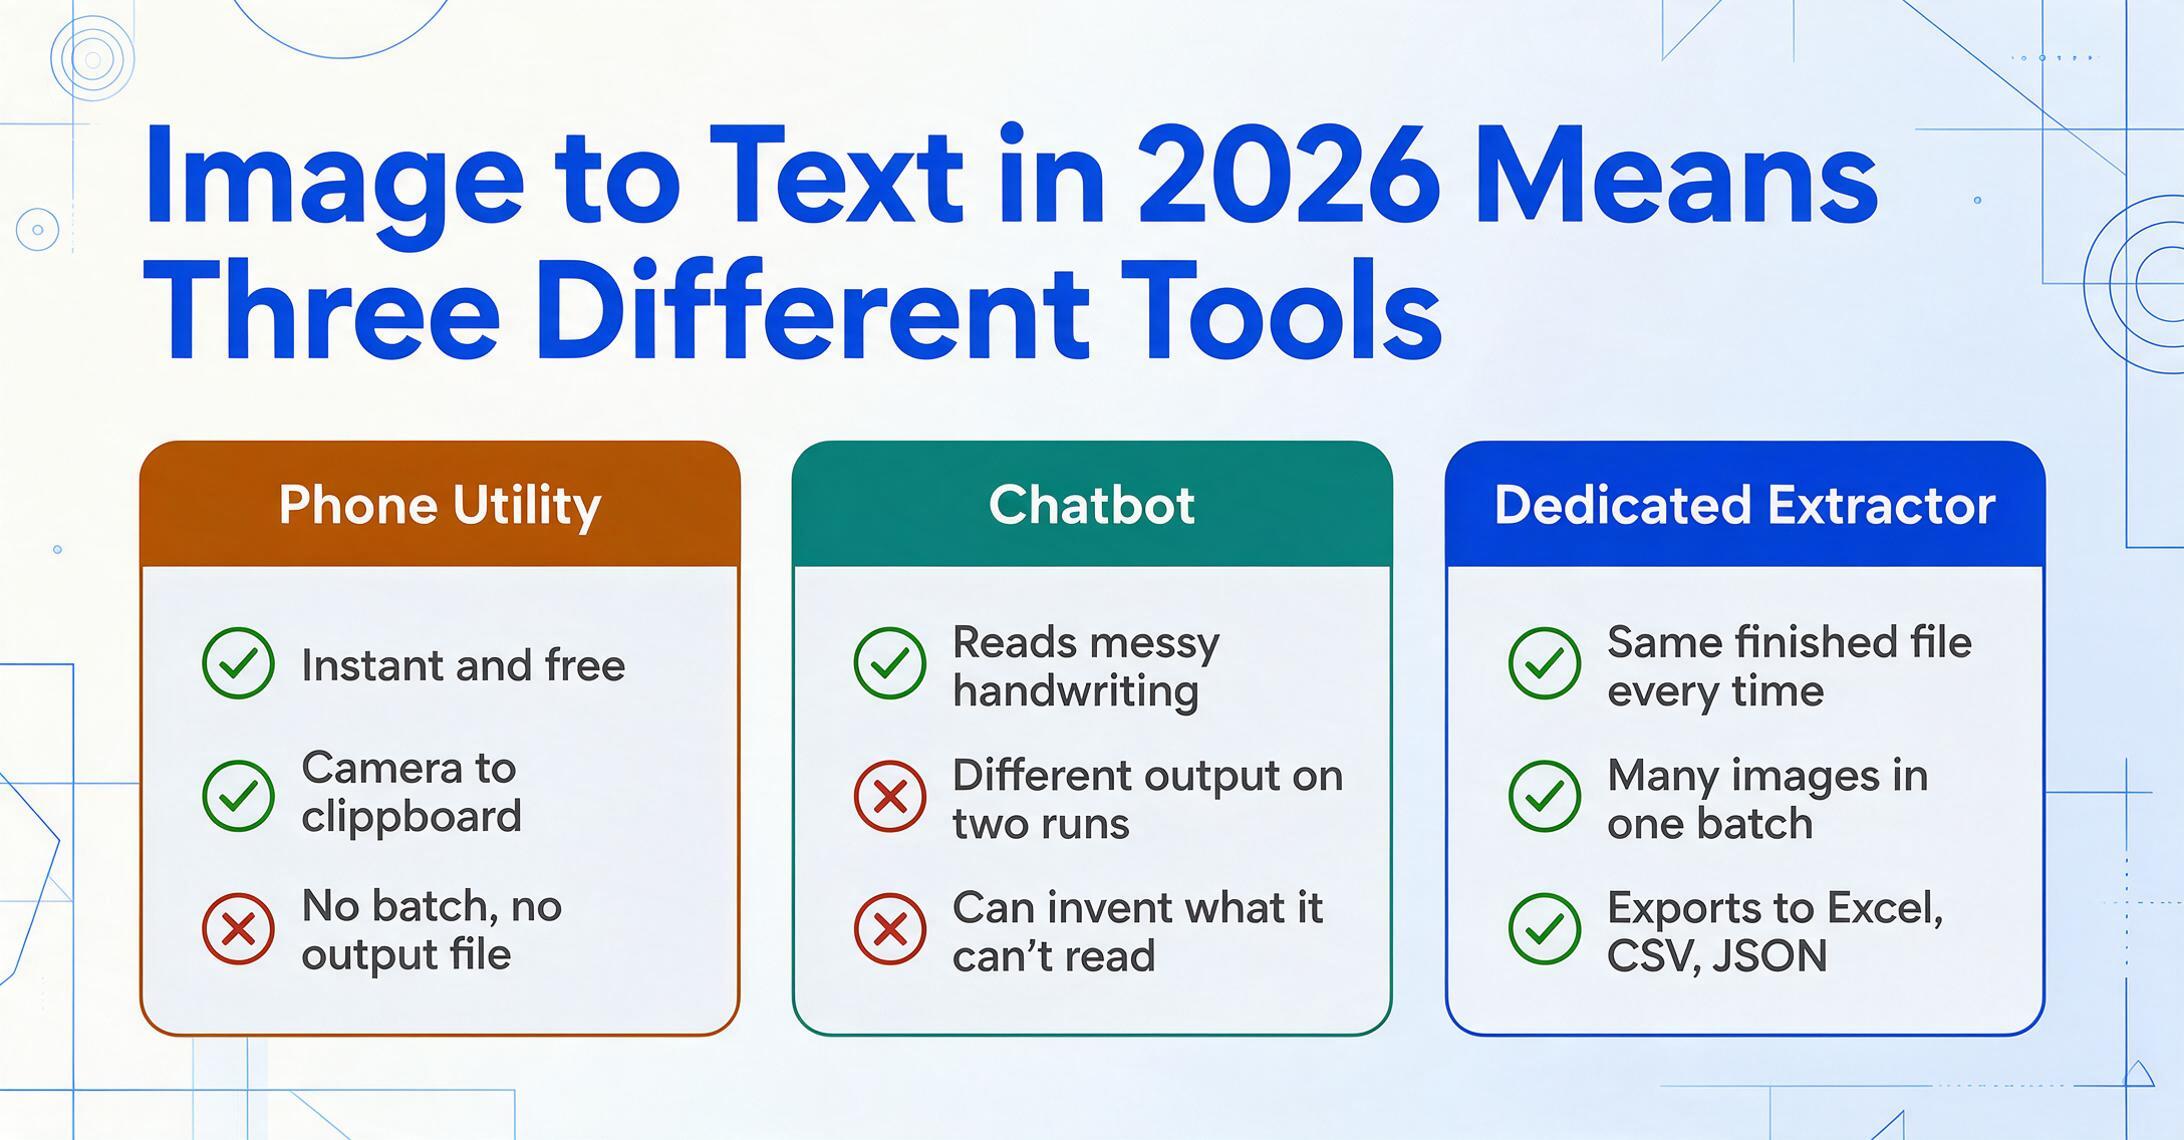
No primeiro extremo estão ferramentas de OCR de telefone e utilidade como Google Lens. Você apunta a cámara a um letrero ou uma página, e o texto se torna seleccionable em um segundo. Estas estão feitas para capturas instantáneas e únicas — pegar uma contraseña de Wi-Fi, copiar um parágrafo, traduzir um menú. São gratuitas, rápidas e sem fricción, e não têm conceito de um trabalho repetible: não há fila de lote, nem arquivo de saída consistente, nem forma de processar cinquenta imágenes em um documento limpo.
No meio estão LLMs multimodales de propósito geral — ChatGPT, Claude, Gemini. Cola uma imagem no chat e eles a leem, muitas vezes de forma impressionante, e também podem explicar, resumir ou reformatar o que encontram. O problema é que são não determinísticos: a mesma imagem e o mesmo prompt podem produzir uma saída ligeramente diferente em duas execuções, e o modelo às vezes "preenche" um valor que parece plausível em vez de admitir que um carácter é ilegible. Não há um pipeline integrado para alimentar cem imágenes e mesclar os resultados em um único arquivo estruturado.
No terceiro extremo estão ferramentas de extração dedicadas construídas para produzir uma saída confiable, repetible e exportable — Google Document AI e AWS Textract para desenvolvedores, e aplicações no-code como ImageToTable.ai para todos os demais. O objetivo destas ferramentas não é que leam uma única imagem melhor que ChatGPT; é que leam a milésima imagem da mesma forma que a primeira, entreguem um arquivo final (TXT, Word, CSV, Excel) e o façam sem que você tenha que supervisionar cada execução.
A diferença entre estas três categorias não é a precisão — é a confiabilidade e a escala. Uma utilidade de telefone vence para uma captura rápida, um chatbot vence para uma conversa única, e uma ferramenta dedicada vence no momento em que você precisa do mesmo resultado, em um arquivo exportable, repetido em muitas imágenes.
Este guía trata de convertir uma imagem em texto editável — transcripción e saída legible. Se o que você realmente precisa é que os dados sejam extraídos em colunas de planilha (os totais de uma factura, as filas de uma tabela), isso é um trabalho relacionado mas separado, e nosso resumen de software de extracción de datos é um melhor ponto de partida. Aquí, a pregunta é mais simples: imagem entra, palavras saem — e em qual destas sete ferramentas você deve confiar para fazer isso.
Como Selecionamos e Testamos
Estas sete ferramentas foram escolhidas para representar a verdadeira variedade de como as pessoas convertem imagens em texto em 2026 — não é a lista mais fácil de classificar. Partimos das ferramentas que os compradores realmente usam e que o SERP mostra consistentemente para "imagem para texto": o utilitário de telefone (Google Lens), um serviço gratuito representativo de OCR online (OCR.space), os dois LLMs (modelos de linguagem de grande escala) que as pessoas usam cada vez mais como OCR (ChatGPT, Claude), as APIs de nível de desenvolvedor (Google Document AI, AWS Textract) e um extrator dedicado no-code (nosso próprio ImageToTable.ai).
Cada ferramenta foi avaliada em quatro aspectos: para o que realmente serve (uma captura única, uma conversa ou um trabalho repetible), precio real (a menor cifra publicada, não "a partir de"), confiabilidade em volume (dá o mesmo resultado duas vezes e pode alucinar?) e ajuste honesto — os cenários onde realmente vence e os que não. Onde citamos dados de precisão ou falha, vêm de benchmarks independentes e testes de profissionais, não de demos de fornecedores. Os precios foram extraídos da página pública de cada fornecedor e são atuais a partir de Precios verificados em junho de 2026.
Uma divulgação desde o início: ImageToTable.ai — o produto deste site — é uma das sete ferramentas analizadas. O posicionamos onde honestamente se encaja (extração no-code, repetible e exportable) e nomeamos os casos onde Google Lens, ChatGPT ou uma API de nube é a melhor opção. Para uma captura rápida, Lens nos supera; fingir o contrário tornaría esta lista inútil.
As 7 Melores Ferramentas de Imagem para Texto de un Vistazo
A tabela abaixo é a resposta rápida, com o ponto de entrada mais barato para cada ferramenta e a única limitação que provavelmente te morderá. "Precios verificados em junho de 2026."
| Ferramenta | Precio Inicial | Modelo de Precio | Melhor Para | Limitação Principal | Prova Gratuita? |
|---|---|---|---|---|---|
| Google Lens | Grátis | Grátis (app Google / Chrome / Fotos) | Captura única instantânea pelo celular | Sem lote, sem arquivo de exportação, sem tarefa repetível | Grátis |
| OCR.space | Grátis | API gratuita + planos PRO pagos | OCR rápido ou automatizado de texto simples | Apenas texto simples; fraco em caligrafia confusa | Plano gratuito |
| ChatGPT | Grátis / US$ 20/mês (Plus) | Assinatura (consumidor) | Leitura única conversacional + raciocínio | Não determinístico; sem lote; pode inventar | Plano gratuito |
| Claude | Grátis / US$ 20/mês (Pro) | Assinatura (consumidor) | Leitura cuidadosa única de documentos longos | Mesmas ressalvas de LLM; sem lote/esquema de exportação | Plano gratuito |
| Google Document AI | US$ 1,50 / 1.000 páginas | Por uso (por página) | OCR em nuvem de alto volume para desenvolvedores | Configuração para devs; saída bruta precisa de pós-processamento | Plano gratuito (GCP) |
| AWS Textract | US$ 1,50 / 1.000 páginas | Por uso (por página) | OCR em nuvem de alto volume dentro da AWS | Apenas para desenvolvedores; formulários/tabelas custam muito mais | Plano gratuito (3 meses) |
| ImageToTable.ai | Grátis / US$ 9/mês | Assinatura + créditos PAYG | Sem código, repetível, dados/texto exportáveis | Sem sincronização nativa com ERP, sem SOC 2/HIPAA | Plano gratuito |
Un padrão explica toda a tabela: o preço segue o que rodea a leitura, não o quão bem a ferramenta lee. Lens e OCR.space são gratuitos porque te dão texto cru e param — uma ferramenta gratuita de imagem para texto sem fluxo de trabalho. Os chatbots custam $20/mês porque pagas por um modelo de raciocinio, não por um motor de OCR. As APIs de nube cobran por página porque são infraestructura sobre a que construis. E o extrator dedicado cobra uma pequena subscrição porque envolve a leitura num fluxo de trabalho repetible e exportable. Iguala o envoltorio ao teu trabalho e a elección correcta se torna óbvia.
OCR utilitário gratuito para celular: Google Lens e OCR.space
Para uma captura rápida e única, o OCR utilitário gratuito não é apenas "bom o suficiente" — é a resposta certa, e nada nesta lista o supera em velocidade. Essas ferramentas existem para tirar texto de uma tela ou página e colocá-lo na sua área de transferência sem nenhuma configuração. No momento em que sua tarefa se repete ou precisa de um arquivo de saída estruturado, elas se esgotam.
Google Lens
O Google Lens é o OCR integrado ao app do Google, ao Chrome e ao Google Fotos: aponte a câmera (ou abra qualquer imagem), toque, e o texto se torna selecionável, copiável e traduzível em tempo real. Ele é genuinamente excelente no que faz — copiar um parágrafo de um livro, extrair um número de série de um rótulo, ler um cardápio estrangeiro — e não custa nada.
Melhor para: capturas únicas e instantâneas pelo celular, especialmente quando a tradução faz parte do trabalho. Não é ideal para: qualquer fluxo de trabalho repetível — não há processamento em lote, nenhuma forma de exportar um arquivo limpo de resultados de várias imagens e nenhum controle sobre a estrutura da saída. É um utilitário, não um pipeline de documentos. Abrir Google Lens →
OCR.space
O OCR.space é um serviço de OCR online gratuito, sem cadastro, com uma interface de programação pública, útil quando você quer texto simples de uma imagem ou PDF enviado — ou quer integrar OCR básico a um script. O plano gratuito é generoso para uso leve, e os planos PRO pagos adicionam limites maiores, arquivos maiores e melhores mecanismos.
Melhor para: extração rápida e gratuita de texto simples no navegador, ou OCR automatizado leve via API. Não é ideal para: letra ilegível, layouts complexos ou quem precisa que o texto seja reorganizado em campos nomeados — ele retorna um bloco plano de caracteres, e você faz a limpeza. Para ter uma ideia de como uma ferramenta consciente de layout lida com a mesma tarefa, veja nossa página de extração de OCR com IA. Ver preços do OCR.space →
Ambas as ferramentas compartilham o mesmo teto: elas leem e depois devolvem o problema para você. Isso é aceitável para uma imagem. É o formato errado para cinquenta — que é exatamente onde as pessoas começam a recorrer ao ChatGPT.
O ChatGPT ou o Claude conseguem ler uma imagem de forma confiável?
Sim — e não, e essa distinção é a coisa mais importante neste guia. Modelos multimodais de uso geral leem imagens muito bem para uma consulta única, mas são a ferramenta errada para transcrição repetível e de alto risco, porque podem inventar silenciosamente o que não conseguem ler.
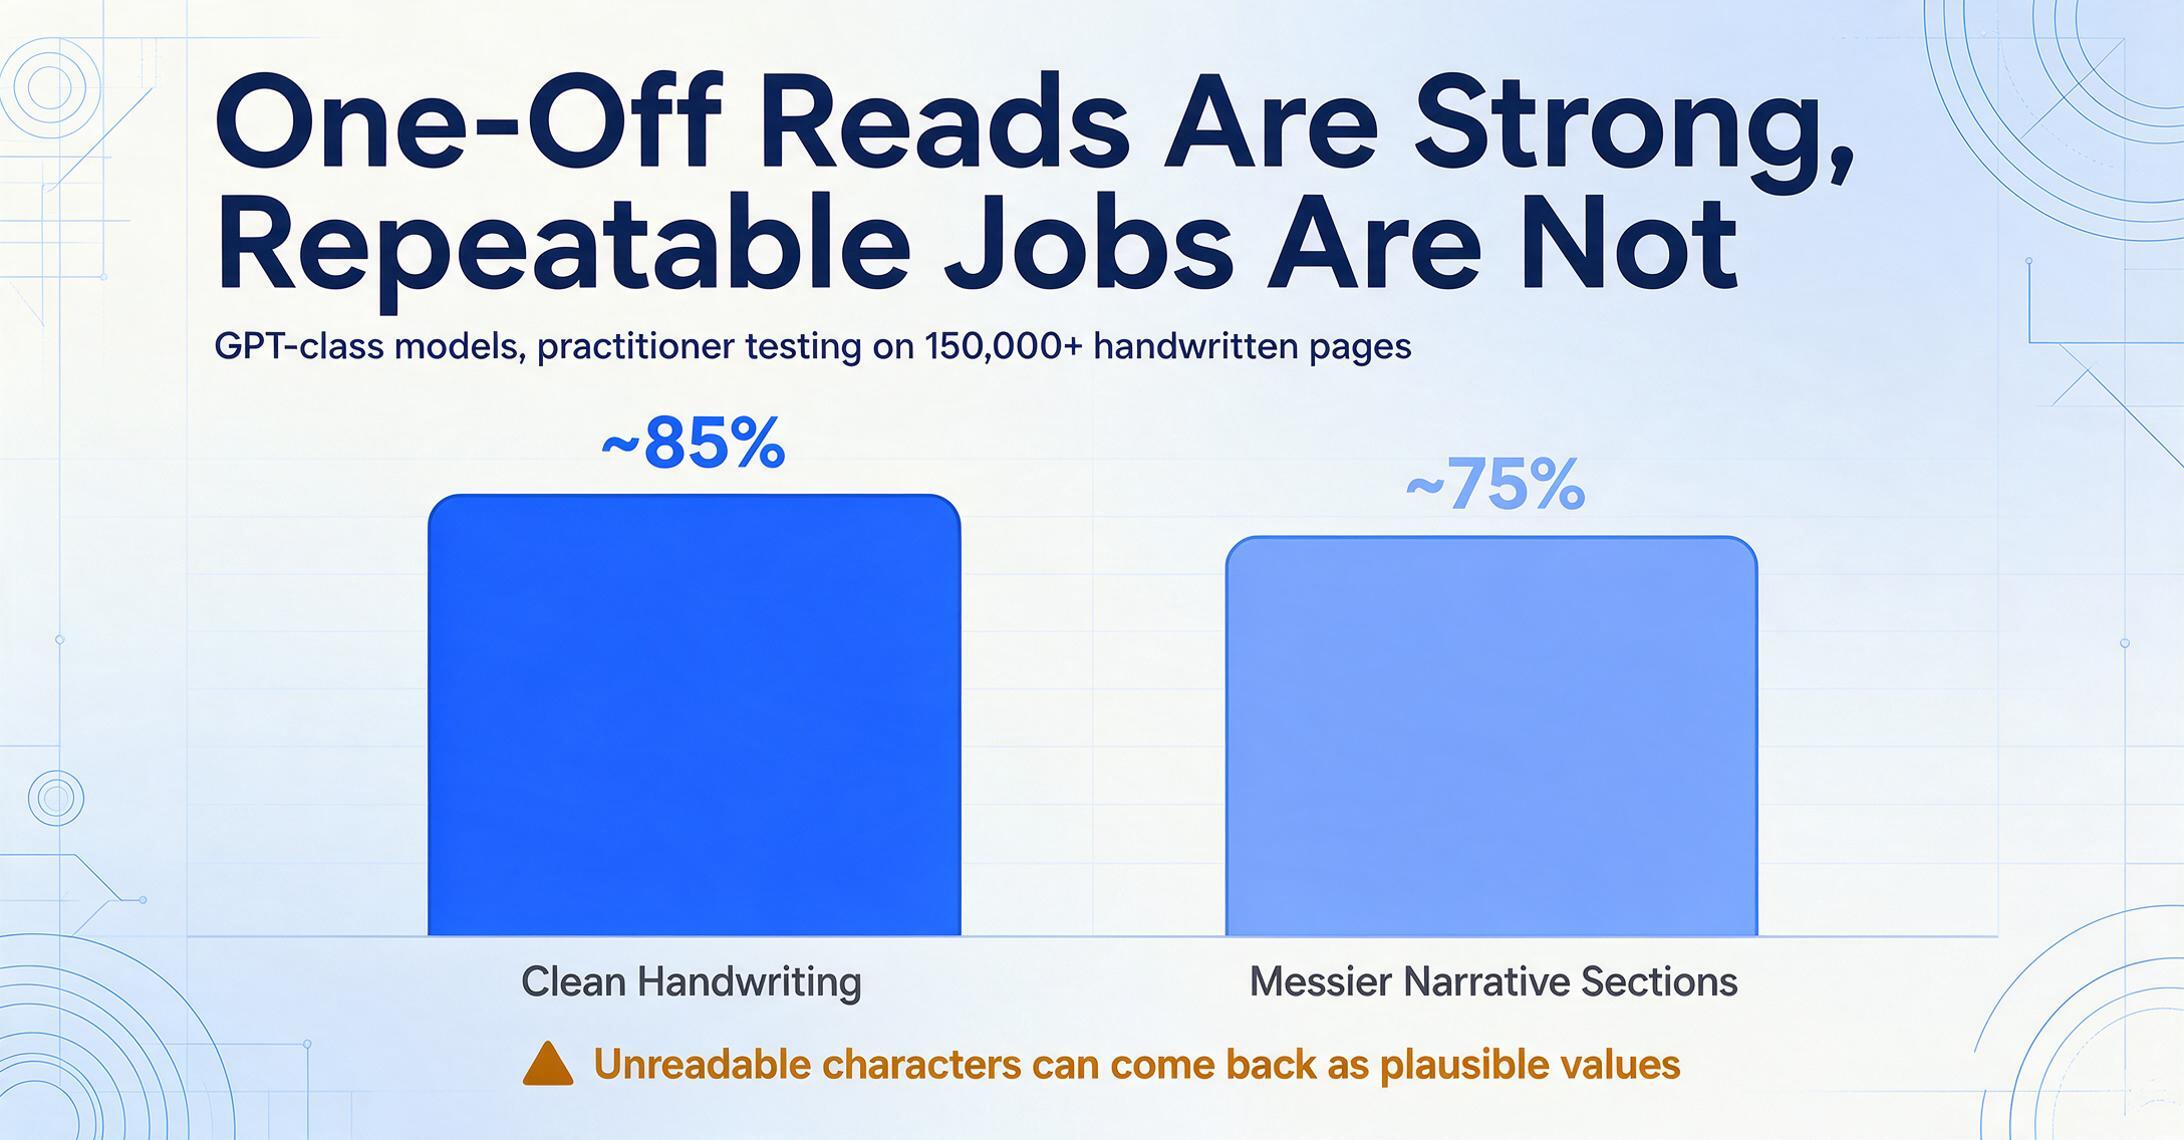
O "sim" é real. No r/OpenAI, a reação recorrente aos modelos de visão é pura surpresa por um chatbot "conseguir simplesmente ler texto direto das imagens", e as pessoas agora rotineiramente colam uma foto no ChatGPT e pedem as palavras. Uma análise de 2025 de um profissional no r/computervision — de alguém que processou mais de 150.000 páginas manuscritas em produção — constatou que modelos da classe GPT atingem "~85% de precisão em escrita clara", o que é forte para uma ferramenta que não exige configuração.
O "não" é igualmente real, e é estrutural. A mesma análise observou que a precisão "cai para ~75% em seções narrativas mais bagunçadas", e o problema mais profundo não é a porcentagem — é o modo de falha. Um benchmark de OCR open-source independente comparando modelos de visão com OCR tradicional gerou uma discussão técnica amplamente lida em que um profissional foi direto: modelos de visão "são tão suscetíveis quanto ao problema (não resolvido) de alucinação", e "os modos de falha são totalmente ilimitados (diferente do OCR comum)". A literatura acadêmica concorda — um artigo da NeurIPS 2025, "Seeing is Believing? Mitigating OCR Hallucinations in Multimodal LLMs," mede exatamente isso: sob desfoque, brilho ou oclusão parcial, um LLM pode produzir com confiança um valor plausível que nunca esteve na página.
Um mecanismo de OCR tradicional que não consegue ler um caractere retorna lixo que você consegue identificar. Um modelo de linguagem que não consegue ler um caractere pode retornar uma resposta limpa, confiante e errada — e dar uma resposta ligeiramente diferente na próxima execução. Esse comportamento não determinístico é o motivo pelo qual chatbots são excelentes para um documento e arriscados para cem.
Também há uma lacuna no fluxo de trabalho. Nem o ChatGPT (Free, ou Plus por $20/mês) nem o Claude (Free, ou Pro por $20/mês) têm uma forma integrada de processar cinquenta imagens de uma vez e mesclá-las em um único arquivo consistente, e o mesmo prompt pode retornar ordens de colunas ou formatos diferentes entre execuções. Para uma consulta única — ler este recibo, transcrever esta anotação — eles são uma escolha legítima e rápida. Para um processo, você quer a leitura do mesmo modelo envolvida em salvaguardas. Nos aprofundamos nos detalhes na nossa comparação do ChatGPT; a versão resumida é: use um chatbot para um documento, use uma ferramenta específica para um procedimento. Ver preços do ChatGPT → Ver preços do Claude →
APIs de OCR em Nuvem para Desenvolvedores: Google Document AI e AWS Textract
Se você tem recursos de engenharia e volume alto e constante, as duas APIs de OCR dos hyperscalers são a forma mais barata e confiável de transformar imagens em texto em escala. Elas não são aplicativos que você "usa" — são serviços sobre os quais você desenvolve, o que é tanto sua força quanto sua barreira.
Google Document AI
O Document AI do Google é uma plataforma em nuvem cujo processador Enterprise Document OCR custa $1,50 por 1.000 páginas (caindo acima de 5 milhões de páginas/mês), com forte cobertura multilíngue e de caligrafia, além de uma camada de revisão com intervenção humana para trabalhos de maior risco. A saída é confiável e determinística, ao contrário do chat com LLM.
Ideal para: equipes de desenvolvimento que precisam de reconhecimento escalável baseado em API para volume alto e constante — especialmente aquelas já no Google Cloud. Não é ideal para: não desenvolvedores; não há aplicativo de apontar e clicar, e o OCR retorna blocos de texto bruto que precisam de pós-processamento antes de serem utilizáveis. Ver preços do Google Document AI →
AWS Textract
O Textract é o serviço de OCR de documentos da Amazon, exposto por várias APIs; sua chamada base Detect Document Text custa $1,50 por 1.000 páginas, com um nível gratuito cobrindo 1.000 páginas/mês nos primeiros três meses. Os recursos estruturados (formulários, tabelas) custam consideravelmente mais por página, então é mais barato quando você precisa principalmente de texto simples.
Ideal para: equipes já dentro do ecossistema AWS que querem OCR como um bloco de construção em um pipeline maior. Não é ideal para: qualquer pessoa sem desenvolvedores, ou cargas de trabalho dominadas por formulários e tabelas, onde o custo por página aumenta acentuadamente. Detalhamos as compensações em nossa comparação do AWS Textract. Ver preços do AWS Textract →
Ambas as APIs leem documentos de forma confiável e com baixo custo por página — mas transformar sua saída bruta em um arquivo estruturado e finalizado é um projeto de desenvolvimento, não um recurso. Essa é exatamente a lacuna que a ferramenta dedicada no-code preenche.
Extração Dedicada e Exportável: ImageToTable.ai
Quando a conversão de imagem em texto vira uma tarefa recorrente e você não quer escrever código, um extrator no-code dedicado oferece a leitura do LLM com a confiabilidade e a exportação que os chatbots não têm. É aqui que entra o ImageToTable.ai — o produto por trás deste site, e uma das sete ferramentas listadas aqui.
O ImageToTable.ai é construído sobre um modelo de visão de grande escala, então ele lê texto impresso, manuscrito, cursivo, tabelas e caixas de seleção com o mesmo entendimento contextual que torna os LLMs eficazes em documentos bagunçados. A diferença está no que envolve a leitura. O modo Para Word pega uma imagem de documento e devolve um arquivo Word editável com o layout original preservado — útil quando você quer a página inteira como texto editável, não apenas um despejo de caracteres. O modo Para Tabela usa a Extração de Colunas Personalizadas: você digita os campos desejados — "Data", "Total", "Referência" — e a IA encontra cada valor pelo significado, gerando uma tabela consistente em Excel, CSV ou JSON. De qualquer forma, você recebe um arquivo finalizado, sempre do mesmo jeito, e pode processar várias imagens em um único lote em vez de um chat por vez. O preço começa com um plano gratuito e depois $9/mês.
Ideal para: freelancers, equipes de operações, contadores e pequenas empresas que precisam converter imagens em texto ou dados editáveis e exportáveis repetidamente — incluindo manuscritos e fotos de celular — sem programação, treinamento de modelo ou supervisão de cada execução. Não é ideal para: uma captura rápida única (o Google Lens é mais rápido e gratuito), uma leitura conversacional em que você também queira discutir o conteúdo (um chatbot se encaixa melhor), ou empresas que precisam de integração nativa com ERP, implantação on-premise ou conformidade com SOC 2 / HIPAA. Você pode ver a abordagem no-code na nossa página de conversão de imagem em Word ou na nossa página de manuscrito em texto, e ela aparece ao lado de outras opções leves no nosso resumo de IA documental no-code. Experimente o ImageToTable.ai grátis →
Como Escolher: Único, em Lote, Manuscrito ou Desenvolvedor
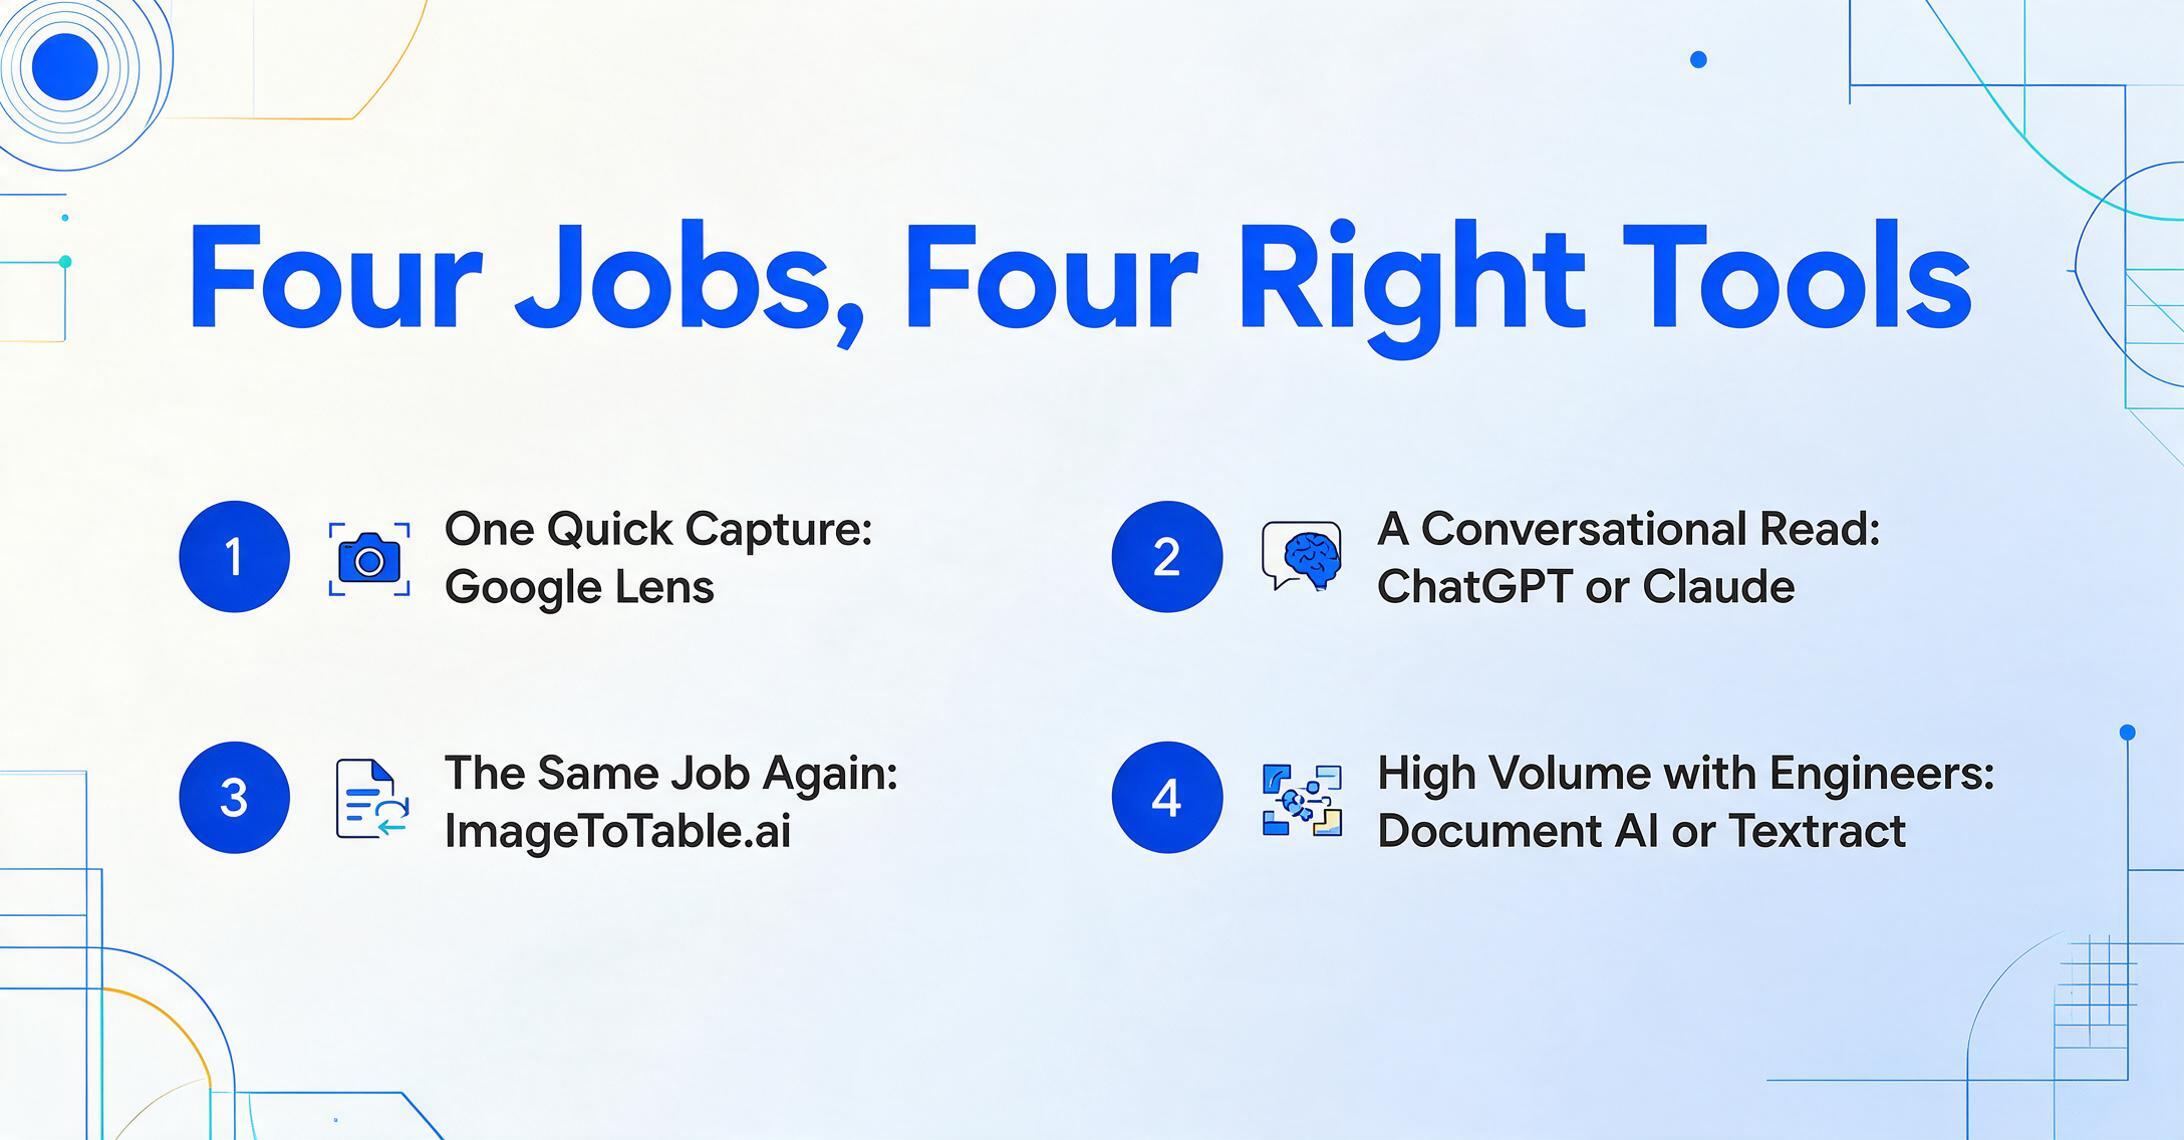
A ferramenta certa de imagem para texto é aquela cujo formato corresponde à sua tarefa, não a que tem mais estrelas. Aqui está a decisão em quatro cenários comuns.
Captura rápida única
Melhor opção: Google Lens (ou OCR.space)
Precisa capturar um parágrafo, um código ou um menu? Use o utilitário gratuito do celular — é instantâneo e não há nada para configurar. Uma ferramenta paga aqui é exagero. Um screenshot PNG que precisa virar um documento editável é outra tarefa — converter PNG para Word exige consciência de layout que as ferramentas utilitárias não oferecem.
Leitura conversacional ou raciocínio
Melhor opção: ChatGPT ou Claude
Quer ler um documento e fazer perguntas sobre ele? Um chatbot é ideal — apenas verifique qualquer coisa que importe e não confie nele para obter saída idêntica duas vezes.
Muitas imagens, repetível, exportável
Melhor opção: ImageToTable.ai
Converter o mesmo tipo de documento repetidamente em texto editável ou planilha, sem código, com um arquivo de saída consistente? Este é o ponto ideal no-code. Comece no plano gratuito.
Alto volume com engenheiros
Melhor opção: Google Document AI ou AWS Textract
Alto volume constante e uma equipe de desenvolvimento para construir em cima disso? As APIs de nuvem são as mais baratas por página. Escolha com base na nuvem em que você já está.
Se a sua tarefa se sobrepõe ao lado de dados estruturados — extraindo campos e linhas para uma planilha em vez de apenas transcrever texto — leia os guias complementares que aprofundam esse assunto: nosso resumo de softwares de OCR com IA e nosso resumo de ferramentas de extração de dados de documentos.
Perguntas Frequentes
Qual é o melhor conversor gratuito de imagem para texto com IA?
Para uso rápido e esporádico, o Google Lens é a melhor opção gratuita — está integrado ao app Google, Chrome e Google Fotos, lê texto de qualquer imagem instantaneamente e não custa nada. Para OCR gratuito de texto simples no navegador ou via API, o OCR.space é uma escolha sólida. Se você precisa do texto repetidamente e em um arquivo exportável, o ImageToTable.ai tem um plano gratuito que vai além de uma simples extração de texto, gerando um arquivo editável no Word ou uma planilha estruturada.
Posso usar o ChatGPT para converter uma imagem em texto?
Para um único documento, sim — cole a imagem no ChatGPT (Gratuito ou Plus por US$ 20/mês) ou no Claude e peça o texto. Geralmente, ele lê bem, com cerca de 85% de precisão em caligrafia limpa, de acordo com testes de profissionais independentes. O problema é a confiabilidade em volume: os modelos de linguagem são não determinísticos (a mesma imagem pode produzir resultados diferentes em execuções distintas) e podem "alucinar" um valor plausível quando um caractere é ilegível, com modos de falha difíceis de detectar. Use um chatbot para uma tarefa pontual; use uma ferramenta dedicada quando precisar do mesmo resultado repetidamente.
As ferramentas de IA de imagem para texto são precisas para caligrafia?
Ferramentas baseadas em modelos de visão leem caligrafia muito melhor que o OCR tradicional porque usam contexto, mas a precisão ainda cai em textos bagunçados ou cursivos — testes de profissionais mostram que os principais modelos têm cerca de 85% de precisão em caligrafia limpa, caindo para aproximadamente 75% em seções mais confusas. Para trabalhos com muita caligrafia, teste seus documentos reais em um plano gratuito primeiro e prefira ferramentas que permitam revisar e corrigir a saída, em vez daquelas que devolvem um bloco de texto simples.
Qual é a diferença entre OCR e uma ferramenta de IA de imagem para texto?
O OCR tradicional compara formas de pixels com caracteres e gera texto sem entendê-lo — é rápido e determinístico, mas falha em digitalizações ruins, caligrafia e layouts incomuns. Ferramentas de IA de imagem para texto usam um modelo de linguagem de visão que lê a página em contexto, lidando muito melhor com imagens bagunçadas do mundo real. A desvantagem é que modelos de IA podem ocasionalmente fabricar informações, por isso ferramentas dedicadas os envolvem em estrutura e controles de exportação, em vez de deixá-lo com uma saída de chat bruta.
Como converto uma imagem em texto editável que posso editar no Word?
Utilitários gratuitos como Google Lens e OCR.space fornecem texto simples copiável, mas não preservam o layout. Para obter um documento editável que mantenha a formatação original, use uma ferramenta com modo sensível ao layout: o modo Para Word do ImageToTable.ai lê uma imagem de documento e exporta um arquivo Word editável com o layout original intacto, para que títulos, parágrafos e tabelas fiquem onde deveriam, em vez de um único parágrafo achatado. Uma página fotografada também segue esse caminho: o fluxo de trabalho JPG para Word exporta um documento editável com títulos e tabelas no lugar, não um único bloco de texto.
Qual ferramenta de imagem para texto é melhor para processar muitas imagens de uma vez?
Utilitários de celular e chatbots não têm um fluxo de trabalho em lote real, então para muitas imagens você quer uma interface de programação em nuvem para desenvolvedores (Google Document AI ou AWS Textract, se você tiver engenheiros) ou uma ferramenta no-code criada para lote. O ImageToTable.ai processa várias imagens em uma única passada e as mescla em um único arquivo exportável, que é a lacuna que ferramentas de uma por vez, como Lens e ChatGPT, não conseguem fechar.
Conclusão
O mais útil desta comparação é entender que "imagem para texto" não é uma categoria — são três, e elas falham de maneiras diferentes. Um utilitário de celular (Lens, OCR.space) é perfeito para uma captura e inútil para cem. Um chatbot (ChatGPT, Claude) lê brilhantemente para um caso único, mas é não determinístico e pode fabricar informações, o que o torna arriscado como processo repetível. Uma ferramenta dedicada (as APIs em nuvem para desenvolvedores, ImageToTable.ai para todos os outros) troca um pouco de flexibilidade de uso único pela coisa que as outras não têm — o mesmo resultado confiável e exportável, toda vez, em muitas imagens.
Não escolha a ferramenta que lê melhor uma imagem. Escolha aquela cujo formato corresponde ao seu trabalho: um utilitário para uma captura, um chatbot para uma conversa e um extrator dedicado para um processo repetível e exportável.
Se o seu trabalho de imagem para texto passou de "de vez em quando" para "repetidamente", esse é o sinal para sair do utilitário gratuito e da janela de chat. Envie algumas das suas próprias imagens, diga o que você quer extrair e veja se um arquivo final e consistente em segundos vale mais do que uma área de transferência cheia de texto que você precisa revisar manualmente.
Divulgação: Este guia é publicado pelo ImageToTable.ai, que é uma das sete ferramentas analisadas acima. Buscamos uma avaliação justa e técnica — incluindo citar os cenários em que Google Lens, ChatGPT, Claude ou as APIs de OCR em nuvem são a melhor escolha. Os preços foram retirados das páginas públicas de preços de cada fornecedor e estão atualizados até junho de 2026; verifique os valores mais recentes no site de cada fornecedor antes de comprar.