Meilleurs convertisseurs IA d'image en texte en 2026 :
7 outils comparés
Un chatbot IA généraliste peut-il lire une image de façon fiable, ou faut-il un outil dédié ? C'est cette question qui distingue les sept outils de ce guide — et la plupart des listes de « meilleurs convertisseurs d'image en texte » n'y répondent jamais. Elles classent Google Lens, ChatGPT et un site OCR gratuit en ligne dans le même classement cinq étoiles, comme s'ils faisaient le même travail. Ce n'est pas le cas. L'un est un utilitaire de téléphone pour une capture rapide, l'autre est un modèle brillant mais non déterministe, et le troisième est conçu pour lire le même type de document cent fois et vous donner le même résultat exportable à chaque fois. C'est une comparaison technique de ces trois catégories : le coût de chaque outil, ce dans quoi il excelle vraiment, et — le point le plus important — là où il échoue discrètement.
Points clés à retenir
- ChatGPT peut lire une écriture manuscrite sur une photo avec environ 85 % de précision sans aucune configuration — c'est exactement pour cela que les gens ont cessé d'ouvrir les applications OCR.
- Le vrai risque n'est pas les caractères qu'il manque — c'est la valeur fausse, propre et assurée qu'il invente discrètement, et la valeur différente qu'il vous donne à la prochaine exécution.
- Un outil dédié lit la millième image de la même manière que la première et vous donne un fichier fini et exportable — vous cessez donc de revérifier visuellement des centaines de captures.
Ce que « Image to Text » signifie réellement en 2026
« Image to text » couvre désormais trois catégories d'outils fondamentalement différentes, et bien choisir commence par savoir laquelle correspond à votre tâche. L'expression signifiait autrefois une seule chose : la reconnaissance optique de caractères — un logiciel qui examine une image de mots et tape les caractères. Ce flux de travail image to text d'origine reste le cœur de chaque outil ci-dessous. En 2026, il s'étend d'un bouton gratuit sur téléphone à un modèle de langage visuel qui raisonne sur ce qu'il voit, et les compromis de fiabilité entre eux sont plus importants que ne le suggèrent les chiffres de précision.
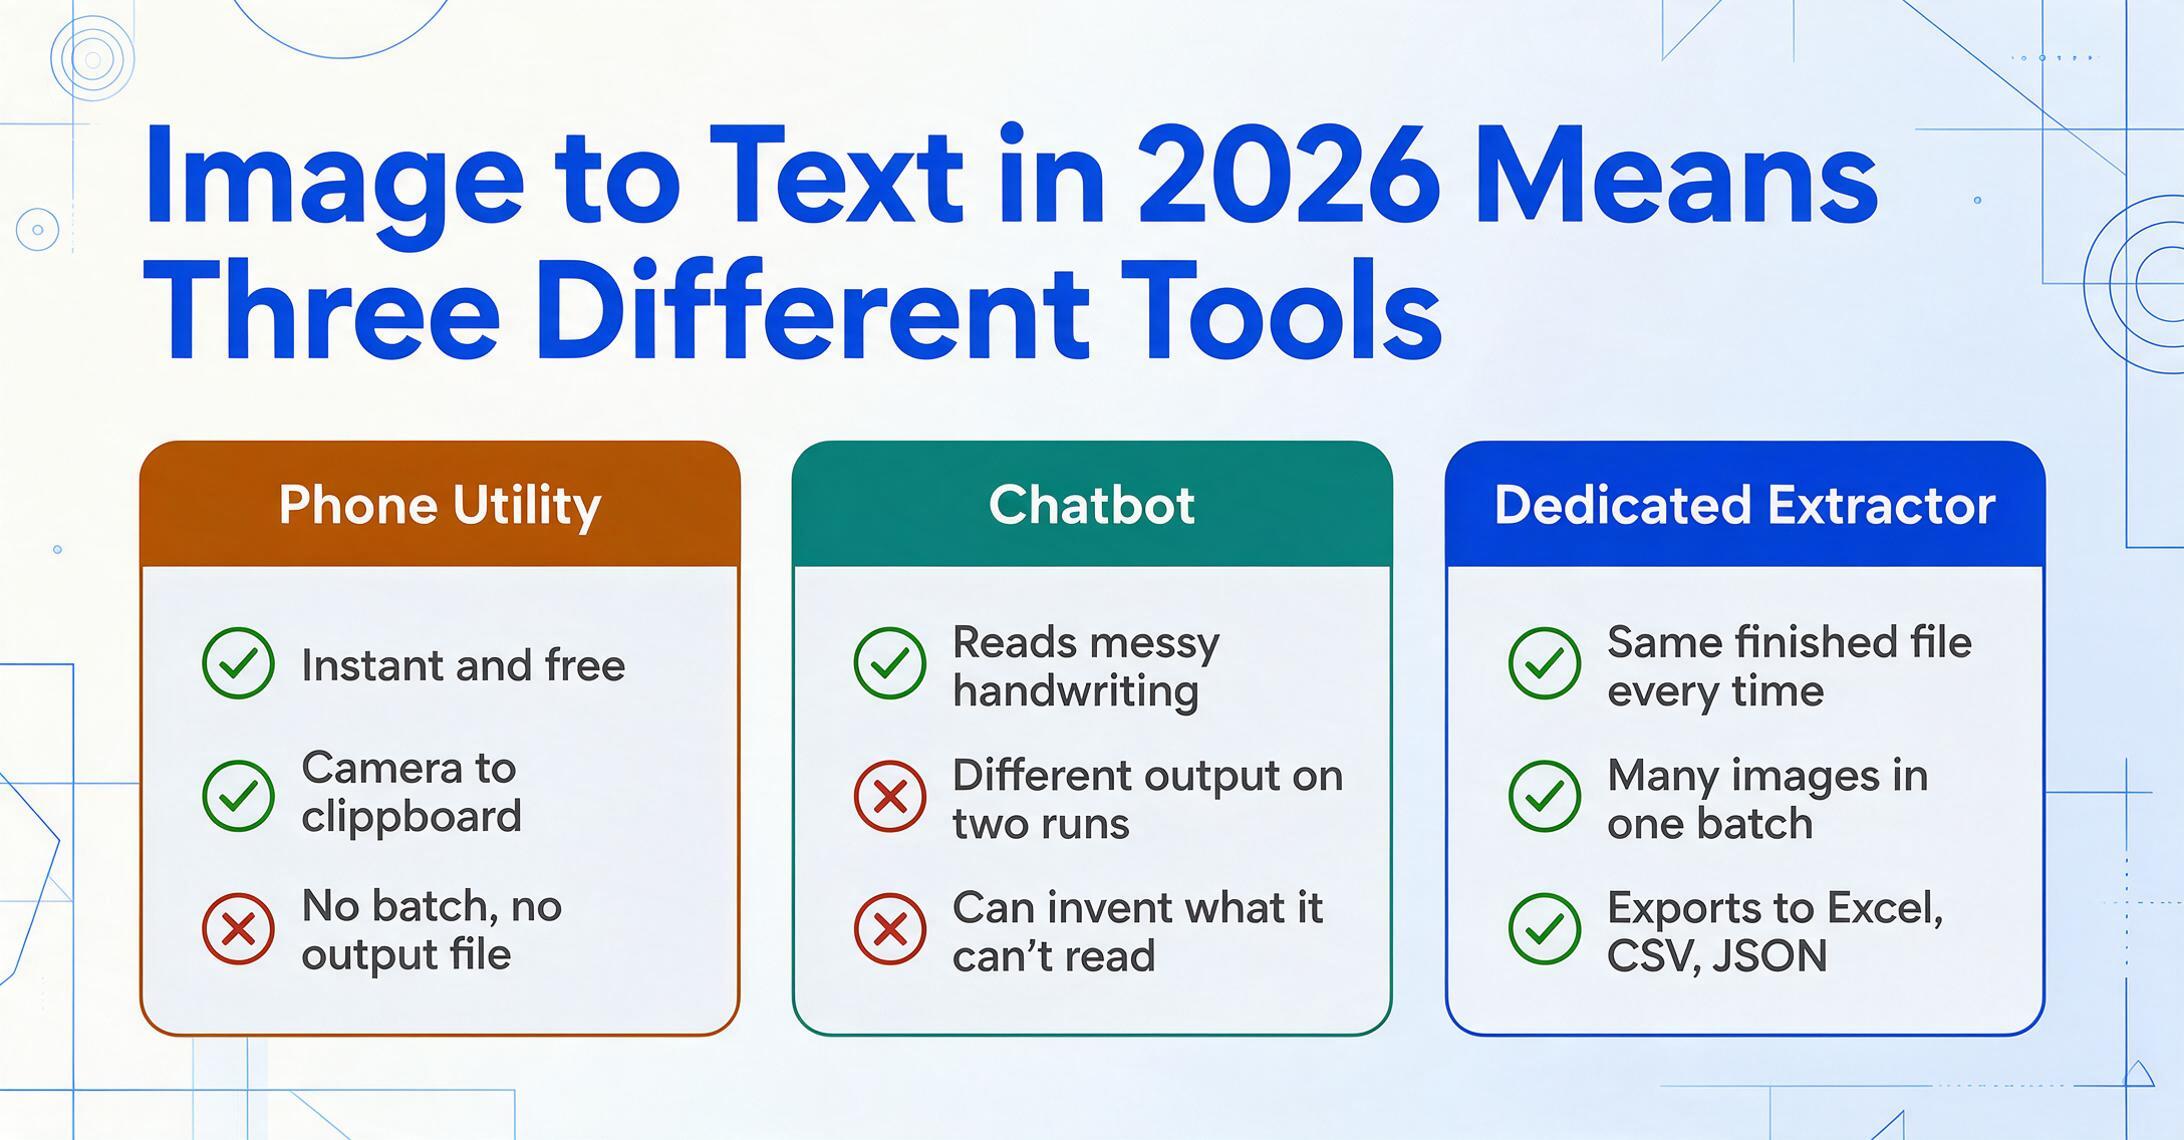
À la première extrémité se trouvent les outils OCR utilitaires pour téléphone comme Google Lens. Vous pointez votre appareil photo vers un panneau ou une page, et le texte devient sélectionnable en une seconde. Ils sont conçus pour des captures instantanées et ponctuelles — récupérer un mot de passe Wi-Fi, copier un paragraphe, traduire un menu. Ils sont gratuits, rapides et sans friction, mais ils n'ont aucune notion de tâche répétable : pas de file de traitement par lots, pas de fichier de sortie cohérent, aucun moyen de traiter cinquante images en un seul document propre.
Au milieu se trouvent les grands modèles de langage multimodaux à usage général — ChatGPT, Claude, Gemini. Collez une image dans la conversation et ils la lisent, souvent de manière impressionnante, et peuvent aussi expliquer, résumer ou reformater ce qu'ils trouvent. Le problème est qu'ils sont non déterministes : la même image et la même invite peuvent produire un résultat légèrement différent à deux exécutions, et le modèle « comblera » parfois une valeur plausible plutôt que d'admettre qu'un caractère est illisible. Il n'existe pas de pipeline intégré pour lui fournir cent images et fusionner les résultats en un seul fichier structuré.
À la troisième extrémité se trouvent les outils d'extraction dédiés conçus pour produire une sortie fiable, répétable et exportable — Google Document AI et AWS Textract pour les développeurs, et des applications no-code comme ImageToTable.ai pour tout le monde. L'intérêt de ces outils n'est pas qu'ils lisent une seule image mieux que ChatGPT ; c'est qu'ils lisent la millième image de la même manière que la première, vous remettent un fichier final (TXT, Word, CSV, Excel), et ce sans que vous ayez à superviser chaque exécution.
La différence entre ces trois catégories n'est pas la précision — c'est la fiabilité et l'échelle. Un utilitaire téléphone gagne pour une capture rapide, un chatbot gagne pour un échange ponctuel, et un outil dédié gagne dès que vous avez besoin du même résultat, dans un fichier exportable, répété sur de nombreuses images.
Ce guide porte sur la conversion d'une image en texte modifiable — transcription et sortie lisible. Si ce dont vous avez réellement besoin, c'est que les données soient extraites dans des colonnes de feuille de calcul (les totaux d'une facture, les lignes d'un tableau), c'est une tâche connexe mais distincte, et notre tour d'horizon des logiciels d'extraction de données est un meilleur point de départ. Ici, la question est plus simple : image en entrée, mots en sortie — et lequel de ces sept outils vous devriez utiliser en toute confiance.
Comment nous avons sélectionné et testé
Ces sept outils ont été choisis pour représenter la véritable diversité des façons de convertir des images en texte en 2026 — pas la liste la plus facile à classer proprement. Nous sommes partis des outils que les acheteurs utilisent réellement et que le SERP remonte systématiquement pour « image to text » : l'utilitaire de téléphone (Google Lens), un service OCR en ligne gratuit représentatif (OCR.space), les deux grands modèles de langage (LLM) généraux que les gens utilisent de plus en plus comme OCR (ChatGPT, Claude), les API cloud de niveau développeur (Google Document AI, AWS Textract), et un extracteur dédié no-code (notre propre ImageToTable.ai).
Chaque outil a été évalué sur quatre critères : sa véritable utilité (une capture ponctuelle, une conversation ou une tâche récurrente), le prix réel (le chiffre publié le plus bas, pas « à partir de »), la fiabilité à grande échelle (donne-t-il le même résultat deux fois, et peut-il fabriquer des données ?), et l'adéquation honnête — les scénarios où il gagne vraiment et ceux où il ne gagne pas. Lorsque nous citons des données de précision ou d'échec, elles proviennent de benchmarks indépendants et de tests de praticiens, pas de démos de fournisseurs. Les prix ont été extraits de la page de tarification publique de chaque fournisseur et sont à jour au Prix vérifiés en juin 2026.
Une divulgation d'emblée : ImageToTable.ai — le produit auquel appartient ce site — est l'un des sept outils examinés. Nous l'avons positionné là où il s'intègre honnêtement (extraction no-code, récurrente et exportable) et avons nommé les cas où Google Lens, ChatGPT ou une API cloud est le meilleur choix. Pour une capture rapide unique, Lens nous bat nettement ; prétendre le contraire rendrait cette liste sans valeur.
Les 7 meilleurs outils image-texte en un coup d'œil
Le tableau ci-dessous est la réponse rapide, avec le point d'entrée le moins cher pour chaque outil et la limite la plus susceptible de vous poser problème. « Prix vérifiés en juin 2026. »
| Outil | Prix de départ | Modèle de tarification | Idéal pour | Limite principale | Essai gratuit ? |
|---|---|---|---|---|---|
| Google Lens | Gratuit | Gratuit (appli Google / Chrome / Photos) | Capture unique instantanée depuis un téléphone | Pas de lot, pas de fichier d'export, pas de tâche récurrente | Gratuit |
| OCR.space | Gratuit | API gratuite + offres PRO payantes | OCR rapide ou automatisé en texte brut | Texte brut uniquement ; moins efficace sur écriture manuscrite complexe | Niveau gratuit |
| ChatGPT | Gratuit / 20 $/mois (Plus) | Abonnement (grand public) | Lecture unique conversationnelle + raisonnement | Non déterministe ; pas de lot ; peut inventer | Niveau gratuit |
| Claude | Gratuit / 20 $/mois (Pro) | Abonnement (grand public) | Lecture unique minutieuse de longs documents | Mêmes limites des LLM ; pas de lot/schéma d'export | Niveau gratuit |
| Google Document AI | 1,50 $ / 1 000 pages | À l'usage (par page) | OCR cloud haut volume pour développeurs | Configuration technique ; sortie brute nécessite post-traitement | Niveau gratuit (GCP) |
| AWS Textract | 1,50 $ / 1 000 pages | À l'usage (par page) | OCR cloud haut volume dans AWS | Développeurs uniquement ; formulaires/tableaux coûtent bien plus | Niveau gratuit (3 mois) |
| ImageToTable.ai | Gratuit / 9 $/mois | Abonnement + crédits à l'utilisation | Sans code, reproductible, texte/données exportables | Pas de synchronisation ERP native, ni SOC 2/HIPAA | Offre gratuite |
Un schéma explique tout le tableau : le prix suit ce qui entoure la lecture, pas la qualité de lecture de l'outil. Lens et OCR.space sont gratuits parce qu'ils vous donnent le texte brut et s'arrêtent là — un outil gratuit de conversion image en texte sans flux de travail autour. Les chatbots coûtent 20 $/mois parce que vous payez pour un modèle de raisonnement, pas pour un moteur OCR. Les API cloud facturent par page parce que ce sont des infrastructures sur lesquelles vous construisez. Et l'extracteur dédié facture un petit abonnement parce qu'il enveloppe la lecture dans un flux de travail récurrent et exportable. Faites correspondre l'enveloppe à votre tâche et le bon choix devient évident.
OCR utilitaire gratuit pour téléphone : Google Lens et OCR.space
Pour une capture unique et rapide, l'OCR utilitaire gratuit n'est pas seulement « assez bon » — c'est la bonne réponse, et rien dans cette liste ne le bat en vitesse. Ces outils existent pour extraire du texte d'un écran ou d'une page et le mettre dans votre presse-papiers sans aucune configuration. Dès que votre tâche se répète ou nécessite un fichier de sortie structuré, ils atteignent leurs limites.
Google Lens
Google Lens est l'OCR intégré à l'application Google, Chrome et Google Photos : visez avec votre appareil photo (ou ouvrez une image), touchez, et le texte devient sélectionnable, copiable et traduisible en temps réel. C'est vraiment excellent pour ce à quoi il sert — copier un paragraphe d'un livre, relever un numéro de série sur une étiquette, lire un menu étranger — et c'est gratuit.
Idéal pour : les captures uniques instantanées depuis votre téléphone, surtout lorsque la traduction fait partie du travail. Pas idéal pour : tout flux de travail répétable — il n'y a pas de traitement par lots, aucun moyen d'exporter un fichier propre de résultats sur plusieurs images, et aucun contrôle sur la structure de sortie. C'est un utilitaire, pas un pipeline documentaire. Ouvrir Google Lens →
OCR.space
OCR.space est un service OCR en ligne gratuit, sans inscription, avec une interface de programmation publique, pratique lorsque vous voulez du texte brut à partir d'une image ou d'un PDF téléchargé — ou que vous voulez intégrer de l'OCR de base dans un script. Le niveau gratuit est généreux pour une utilisation légère, et les niveaux PRO payants ajoutent des limites plus élevées, des fichiers plus volumineux et de meilleurs moteurs.
Idéal pour : une extraction de texte brut rapide et gratuite dans le navigateur, ou une OCR automatisée légère via son API. Pas idéal pour : les écritures manuscrites difficiles, les mises en page complexes, ou quiconque a besoin que le texte soit réorganisé en champs nommés — il renvoie un bloc plat de caractères, et c'est vous qui faites le nettoyage. Pour voir comment un outil sensible à la mise en page gère la même tâche, consultez notre page d'extraction OCR par IA. Voir les tarifs OCR.space →
Ces deux outils partagent le même plafond : ils lisent, puis vous rendent le problème. C'est très bien pour une image. C'est la mauvaise forme pour cinquante — c'est exactement là que les gens commencent à se tourner vers ChatGPT.
ChatGPT ou Claude peuvent-ils lire une image de manière fiable ?
Oui — et non, et cette distinction est le point le plus important de ce guide. Les modèles multimodaux polyvalents lisent remarquablement bien les images pour un usage ponctuel, mais ils sont le mauvais outil pour une transcription répétable et à fort enjeu, car ils peuvent silencieusement inventer ce qu'ils ne peuvent pas lire.
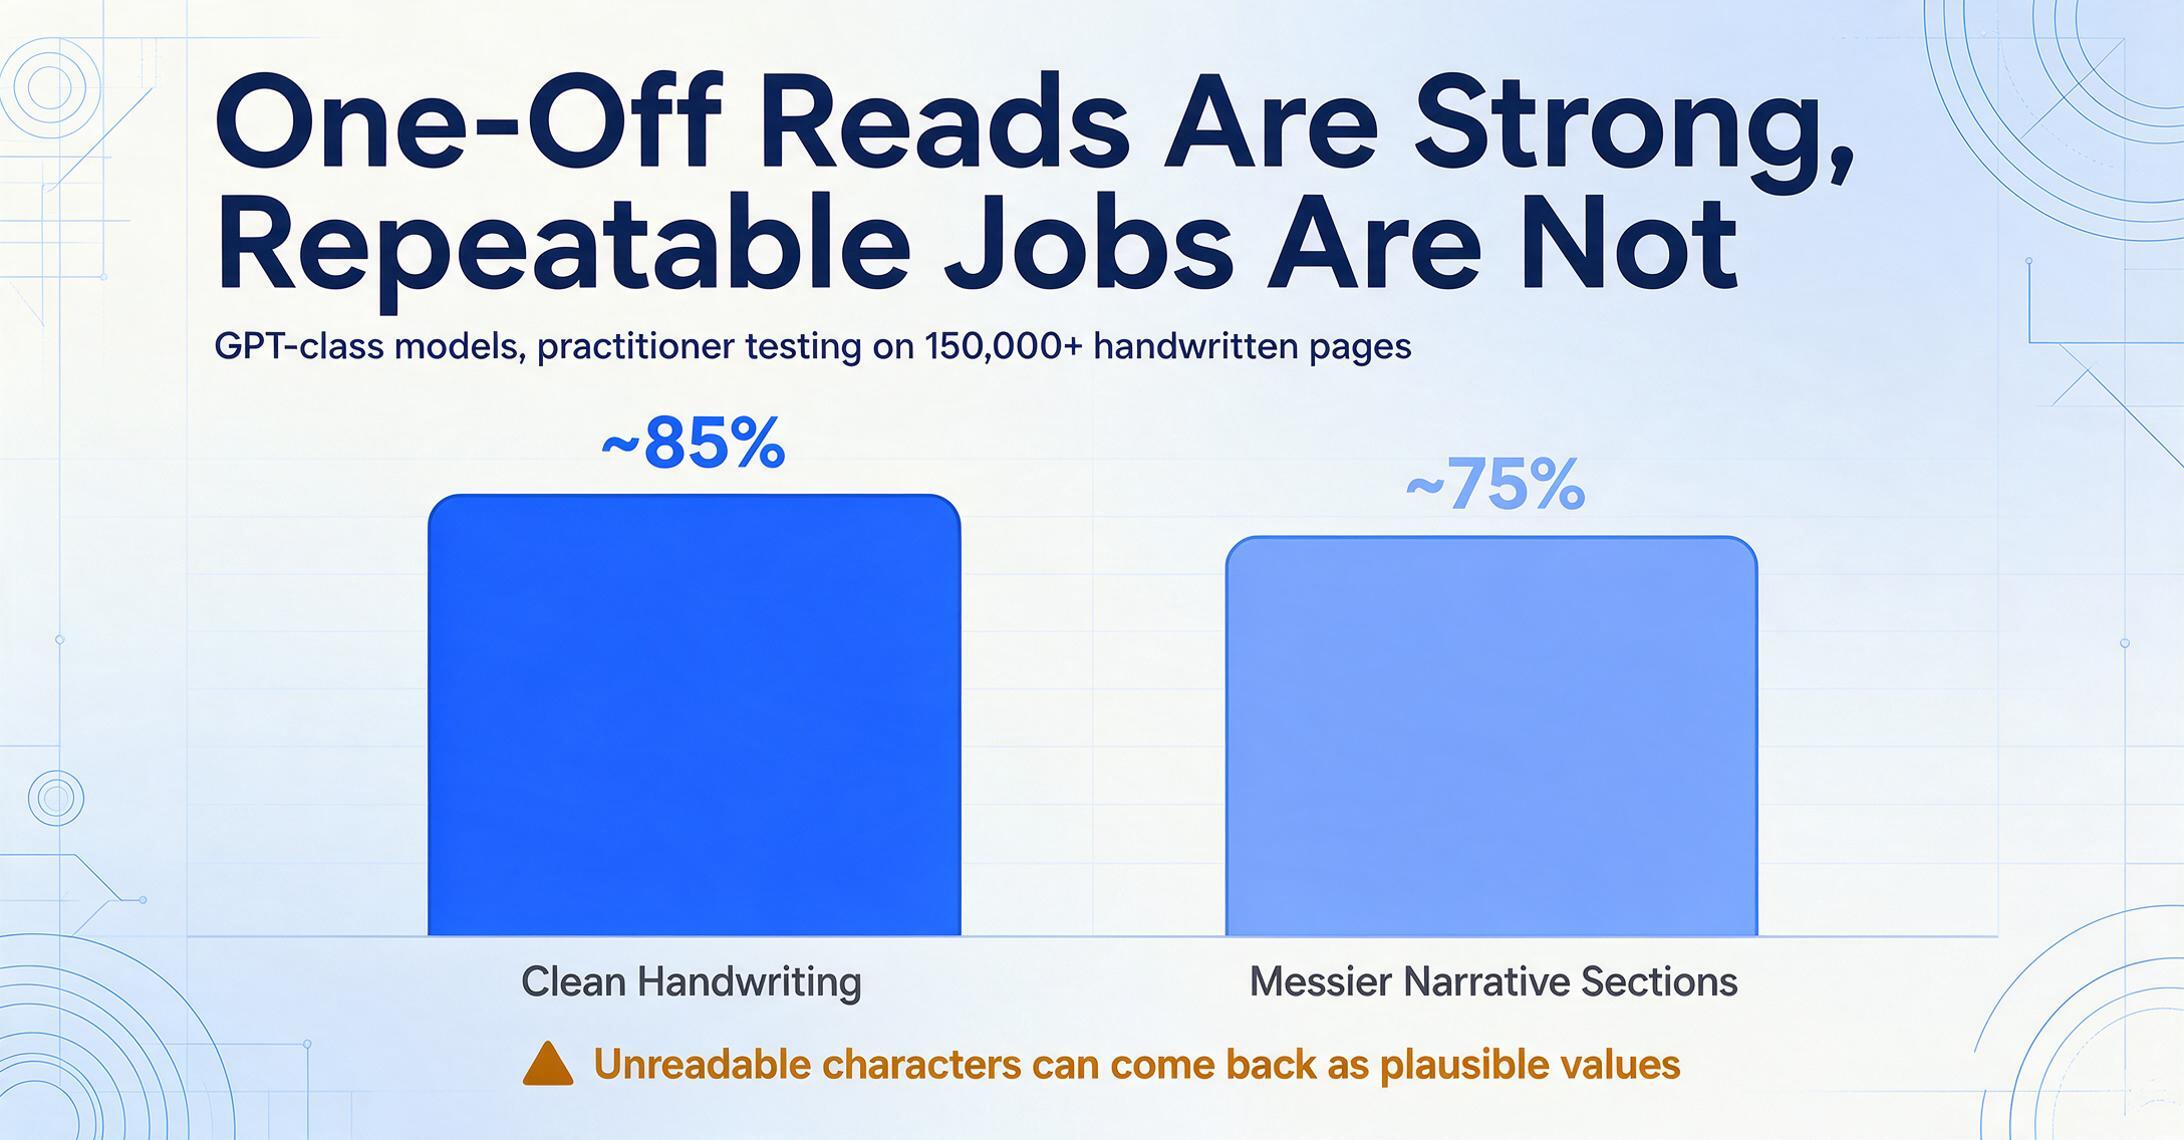
Le « oui » est réel. Sur r/OpenAI, la réaction récurrente aux modèles de vision est une stupéfaction pure devant le fait qu'un chatbot « peut simplement lire le texte directement sur les images », et les gens collent désormais couramment une photo dans ChatGPT pour en demander les mots. Une revue pratique 2025 sur r/computervision — rédigée par quelqu'un qui a traité plus de 150 000 pages manuscrites en production — a constaté que les modèles de type GPT atteignent « ~85 % de précision sur une écriture propre », ce qui est solide pour un outil qui ne nécessite aucune configuration.
Le « non » est tout aussi réel, et il est structurel. Cette même revue notait une précision « tombant à ~75 % sur les sections narratives plus désordonnées », et le problème profond n'est pas le pourcentage — c'est le mode de défaillance. Un benchmark OCR open source indépendant comparant les modèles de vision à l'OCR traditionnel a déclenché une discussion d'ingénierie largement lue où un praticien s'est exprimé sans détour : les modèles de vision « sont tout aussi sensibles au problème (non résolu) de l'hallucination », et « les modes de défaillance sont totalement illimités (contrairement à l'OCR classique) ». Les travaux académiques concordent — un article NeurIPS 2025, « Seeing is Believing? Mitigating OCR Hallucinations in Multimodal LLMs », mesure précisément cela : sous flou, éblouissement ou occlusion partielle, un LLM peut produire avec assurance une valeur plausible qui n'a jamais été sur la page.
Un moteur d'OCR traditionnel qui ne peut pas lire un caractère renvoie un résultat aberrant que vous pouvez repérer. Un modèle de langage qui ne peut pas lire un caractère peut renvoyer une réponse propre, assurée et fausse — et vous en donner une légèrement différente à l'exécution suivante. Cette non-détermination explique pourquoi les chatbots sont excellents pour un document et risqués pour une centaine.
Il y a aussi un écart de flux de travail. Ni ChatGPT (gratuit, ou Plus à 20 $/mois) ni Claude (gratuit, ou Pro à 20 $/mois) n'offrent de moyen intégré de traiter cinquante images en une seule passe et de les fusionner en un fichier unique cohérent, et la même invite peut renvoyer des ordres de colonnes ou des formats différents d'une exécution à l'autre. Pour un usage ponctuel — lire ce reçu, transcrire cette note — ils constituent un choix légitime et rapide. Pour un processus, vous voulez la lecture du même modèle enveloppée de garde-fous. Nous détaillons les spécificités dans notre comparaison ChatGPT ; en bref, utilisez un chatbot pour un document, et un outil dédié pour une procédure. Voir les tarifs ChatGPT → Voir les tarifs Claude →
API OCR cloud pour développeurs : Google Document AI et AWS Textract
Si vous disposez de ressources en ingénierie et d'un volume élevé et régulier, les deux API OCR des hyperscalers sont le moyen fiable le moins cher de transformer des images en texte à grande échelle. Ce ne sont pas des applications que l'on « utilise » — ce sont des services sur lesquels on construit, ce qui est à la fois leur force et leur barrière.
Google Document AI
Le Document AI de Google est une plateforme cloud dont le processeur OCR Enterprise Document OCR fonctionne à 1,50 $ pour 1 000 pages (tarif dégressif au-delà de 5 millions de pages/mois), avec une couverture multilingue et manuscrite solide et une couche de révision humaine pour les tâches à plus fort enjeu. La sortie est fiable et déterministe, contrairement aux conversations avec un LLM.
Idéal pour : les équipes de développement ayant besoin d'une reconnaissance évolutive basée sur API pour un volume élevé et régulier — en particulier celles déjà sur Google Cloud. Pas idéal pour : les non-développeurs ; il n'y a pas d'application cliquable, et l'OCR renvoie des blocs de texte bruts qui nécessitent un post-traitement avant d'être utilisables. Voir les tarifs de Google Document AI →
AWS Textract
Textract est le service OCR de documents d'Amazon, exposé via plusieurs API ; son appel de base Detect Document Text coûte 1,50 $ pour 1 000 pages, avec un niveau gratuit couvrant 1 000 pages/mois pendant les trois premiers mois. Les fonctionnalités structurées (formulaires, tableaux) coûtent considérablement plus cher par page, c'est donc le moins cher lorsque vous avez surtout besoin de texte brut.
Idéal pour : les équipes déjà dans l'écosystème AWS qui veulent l'OCR comme brique dans un pipeline plus large. Pas idéal pour : ceux qui n'ont pas de développeurs, ou les charges de travail dominées par les formulaires et les tableaux, où le coût par page grimpe fortement. Nous détaillons les compromis dans notre comparaison AWS Textract. Voir les tarifs AWS Textract →
Les deux API lisent les documents de manière fiable et à faible coût par page — mais transformer leur sortie brute en un fichier structuré et finalisé est un projet de développement, pas une fonctionnalité. C'est exactement l'écart que l'outil dédié no-code comble.
Extraction dédiée et exportable : ImageToTable.ai
Lorsque la conversion d'image en texte devient une tâche récurrente et que vous ne voulez pas écrire de code, un extracteur no-code dédié vous offre la lecture du LLM, enveloppée dans la fiabilité et l'export que les chatbots n'ont pas. C'est là que se situe ImageToTable.ai — le produit derrière ce site, et l'un des sept outils présentés ici.
ImageToTable.ai est basé sur un grand modèle de vision, il lit donc le texte imprimé, l'écriture manuscrite, l'écriture cursive, les tableaux et les cases à cocher avec la même compréhension contextuelle qui rend les LLM performants sur les documents complexes. La différence réside dans ce qui entoure la lecture. Son mode Vers Word prend une image de document et renvoie un fichier Word modifiable avec la mise en page d'origine préservée — utile lorsque vous voulez toute la page sous forme de texte modifiable, et pas seulement un simple dump de caractères. Son mode Vers Tableau utilise l'Extraction de colonnes personnalisées : vous saisissez les champs souhaités — « Date », « Total », « Référence » — et l'IA trouve chaque valeur par signification, puis génère un tableau cohérent vers Excel, CSV ou JSON. Dans les deux cas, vous obtenez un fichier final, identique à chaque fois, et vous pouvez traiter plusieurs images en un seul lot plutôt qu'une conversation à la fois. La tarification commence avec un niveau gratuit, puis 9 $/mois.
Idéal pour : les freelances, les équipes opérationnelles, les comptables et les petites entreprises qui ont besoin de convertir des images en texte ou données modifiables et exportables de manière répétée — y compris l'écriture manuscrite et les photos de téléphone — sans coder, sans entraîner de modèle, ni surveiller chaque exécution. Pas idéal pour : une simple capture unique (Google Lens est plus rapide et gratuit), une lecture conversationnelle où vous souhaitez également discuter du contenu (un chatbot convient mieux), ou les entreprises nécessitant une synchronisation ERP native, un déploiement sur site, ou la conformité SOC 2 / HIPAA. Vous pouvez voir l'approche no-code sur notre page de conversion image vers Word ou notre page d'écriture manuscrite vers texte, et elle côtoie d'autres options légères dans notre tour d'horizon de l'IA documentaire no-code. Essayez ImageToTable.ai gratuitement →
Comment choisir : ponctuel, en volume, manuscrit ou développeur
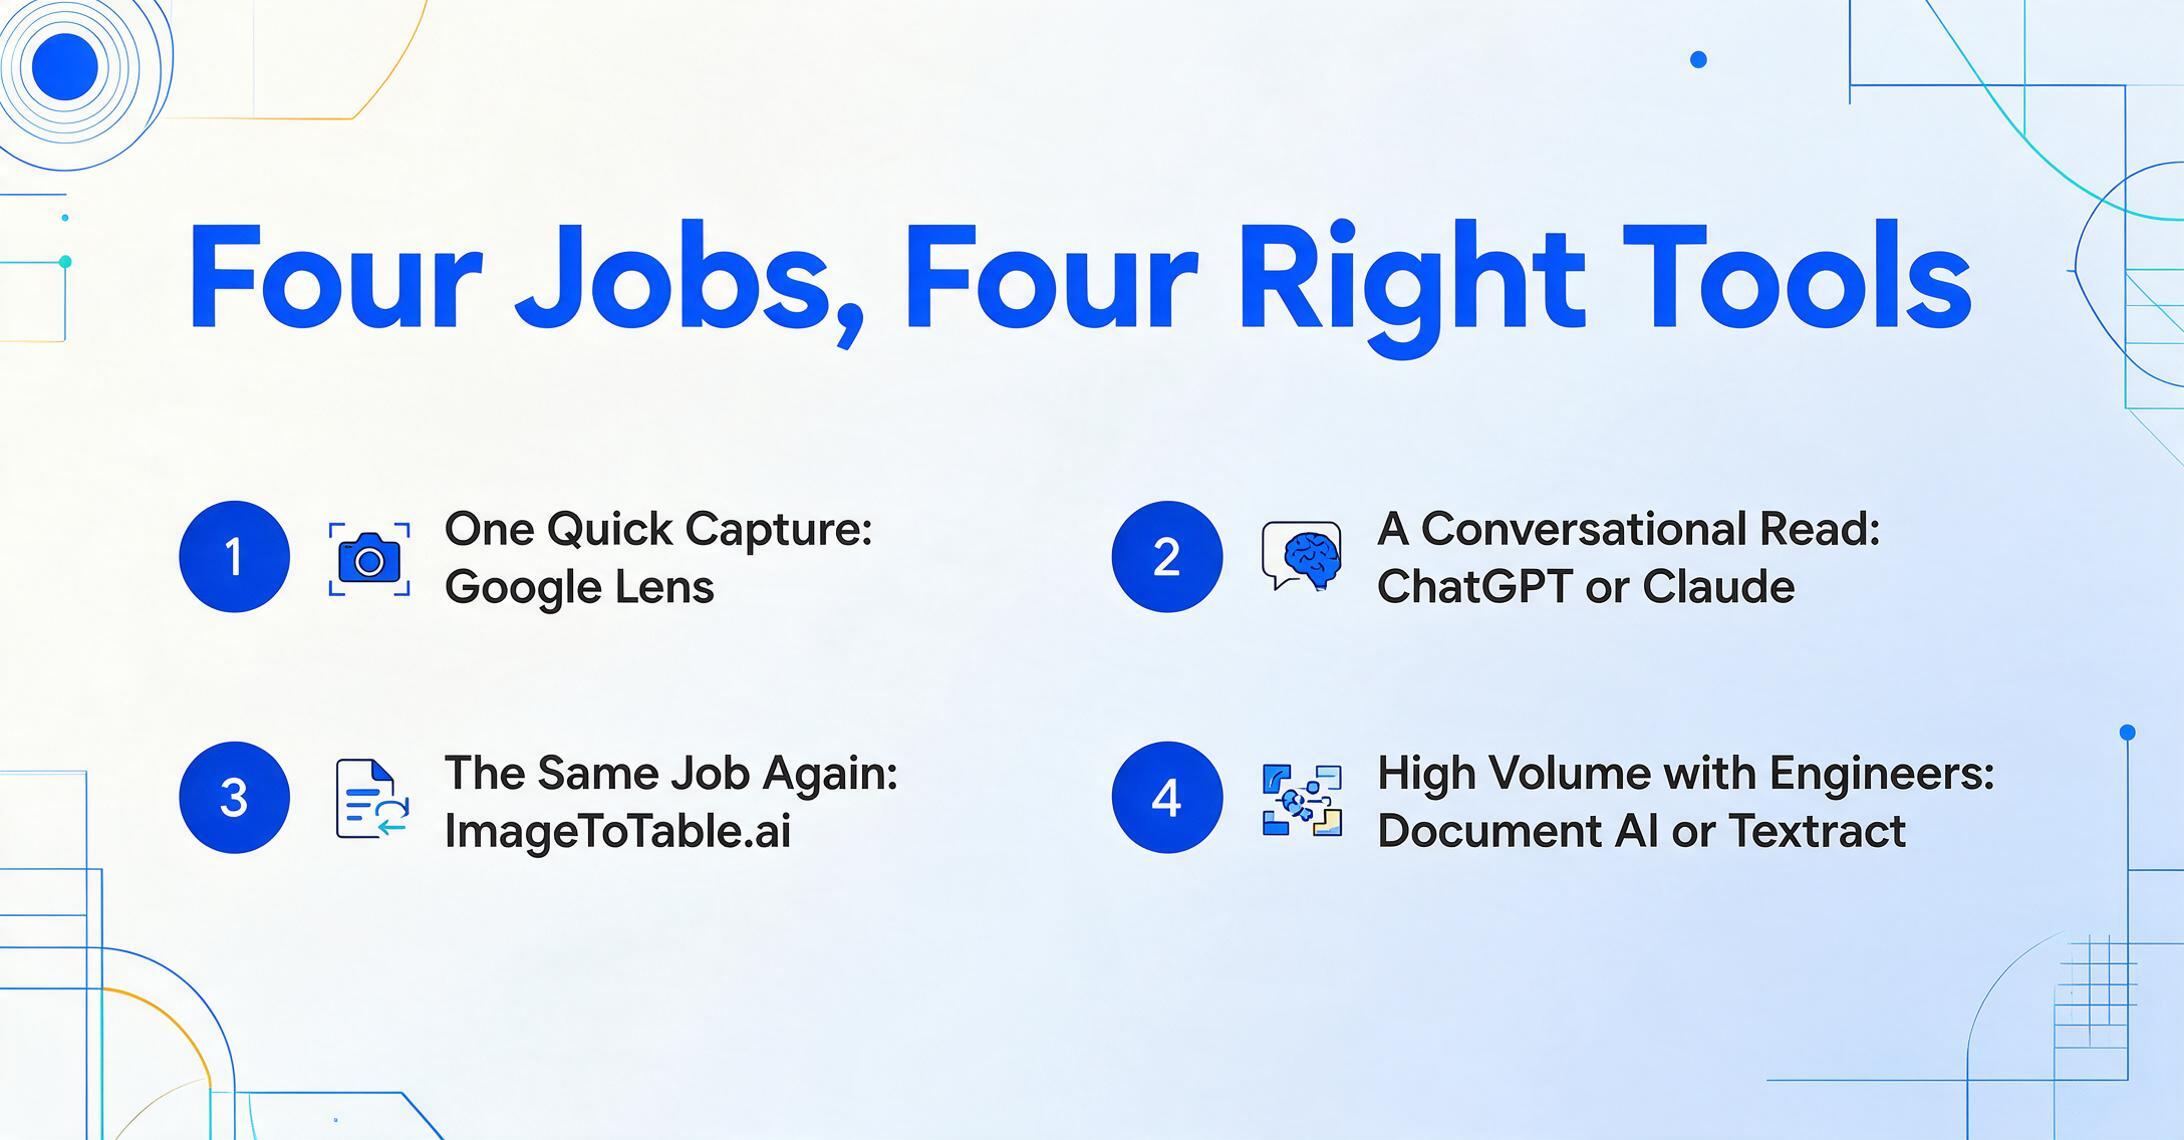
Le bon outil de conversion d'image en texte est celui dont la forme correspond à votre tâche, pas celui qui a le plus d'étoiles. Voici la décision dans quatre scénarios courants.
Une capture rapide
Meilleur choix : Google Lens (ou OCR.space)
Vous voulez saisir un paragraphe, un code ou un menu ? Utilisez l'utilitaire gratuit du téléphone — c'est instantané et il n'y a rien à configurer. Un outil payant ici est superflu. Une capture d'écran PNG qui doit devenir un document modifiable est une autre tâche — convertir un PNG en Word nécessite une conscience de la mise en page que les utilitaires ne fournissent pas.
Une lecture conversationnelle ou un raisonnement
Meilleur choix : ChatGPT ou Claude
Vous voulez lire un document et poser des questions à son sujet ? Un chatbot est idéal — vérifiez simplement tout ce qui compte, et ne comptez pas sur lui pour un résultat identique deux fois.
De nombreuses images, répétables, exportables
Meilleur choix : ImageToTable.ai
Convertir le même type de document encore et encore en texte modifiable ou en feuille de calcul, sans code, avec un fichier de sortie cohérent ? C'est le point idéal du no-code. Commencez avec le niveau gratuit.
Volume élevé avec des ingénieurs
Meilleur choix : Google Document AI ou AWS Textract
Un volume élevé constant et une équipe de développement pour construire dessus ? Les API cloud sont les moins chères par page. Choisissez selon le cloud dans lequel vous vivez déjà.
Si votre tâche chevauche le côté des données structurées — extraire des champs et des lignes dans une feuille de calcul plutôt que de simplement transcrire du texte — lisez les guides complémentaires qui approfondissent ce sujet : notre tour d'horizon des logiciels d'OCR IA et notre tour d'horizon des outils d'extraction de données documentaires.
Questions fréquentes
Quel est le meilleur convertisseur gratuit d'image en texte par IA ?
Pour un usage ponctuel, Google Lens est la meilleure option gratuite — intégré à l'appli Google, Chrome et Google Photos, il lit le texte de n'importe quelle image instantanément et sans frais. Pour une OCR gratuite dans le navigateur ou via une API, OCR.space est un bon choix. Si vous avez besoin du texte de façon répétée et dans un fichier exportable, ImageToTable.ai propose un niveau gratuit qui va au-delà d'un simple texte brut pour fournir un document Word modifiable ou un tableau structuré.
Puis-je simplement utiliser ChatGPT pour convertir une image en texte ?
Pour un document unique, oui — collez l'image dans ChatGPT (version gratuite ou Plus à 20 $/mois) ou Claude et demandez le texte, il le lit généralement bien, avec environ 85 % de précision sur une écriture manuscrite propre selon des tests indépendants. L'inconvénient est la fiabilité en volume : les modèles de langage sont non déterministes (la même image peut produire des résultats différents à chaque exécution) et peuvent « halluciner » une valeur plausible lorsqu'un caractère est illisible, avec des modes de défaillance difficiles à détecter. Utilisez un chatbot pour un usage unique ; utilisez un outil dédié lorsque vous avez besoin du même résultat de façon répétée.
Les outils de conversion d'image en texte par IA sont-ils précis sur l'écriture manuscrite ?
Les outils basés sur des modèles de vision lisent l'écriture manuscrite bien mieux que l'OCR traditionnelle car ils utilisent le contexte, mais la précision diminue encore sur une écriture brouillonne ou cursive — les tests montrent environ 85 % sur une écriture propre et environ 75 % sur des sections plus brouillonnes. Pour un travail intensif sur l'écriture manuscrite, testez d'abord vos documents réels sur un niveau gratuit, et privilégiez les outils qui permettent de vérifier et corriger le résultat plutôt que ceux qui renvoient un bloc de texte brut.
Quelle est la différence entre l'OCR et un outil de conversion d'image en texte par IA ?
L'OCR traditionnelle fait correspondre les formes de pixels aux caractères et produit du texte sans le comprendre — rapide et déterministe, mais elle échoue sur les mauvais scans, l'écriture manuscrite et les mises en page inhabituelles. Les outils de conversion d'image en texte par IA utilisent un modèle de langage visuel qui lit la page en contexte, ce qui leur permet de bien mieux gérer les images réelles brouillonnes. L'inconvénient est que les modèles d'IA peuvent parfois fabriquer des informations, c'est pourquoi les outils dédiés les intègrent dans une structure avec des contrôles d'exportation plutôt que de vous laisser avec un résultat brut de chat.
Comment convertir une image en texte modifiable dans Word ?
Les utilitaires gratuits comme Google Lens et OCR.space vous donnent du texte brut copiable, mais ils ne préservent pas la mise en page. Pour obtenir un document modifiable qui conserve la mise en forme d'origine, utilisez un outil doté d'un mode sensible à la mise en page : le mode Vers Word d'ImageToTable.ai lit une image de document et exporte un fichier Word modifiable avec la mise en page d'origine intacte, de sorte que les titres, les paragraphes et les tableaux se placent là où ils doivent être, au lieu d'un seul paragraphe plat. Une page photographiée suit également ce chemin : le flux de travail JPG vers Word exporte un document modifiable avec les titres et les tableaux en place, et non un bloc de texte unique.
Quel outil de conversion image-texte est le meilleur pour traiter plusieurs images à la fois ?
Les utilitaires pour téléphone et les chatbots n'ont pas de véritable flux de traitement par lots, donc pour de nombreuses images, vous voulez soit une API cloud pour développeurs (Google Document AI ou AWS Textract, si vous avez des ingénieurs), soit un outil no-code conçu pour le traitement par lots. ImageToTable.ai traite plusieurs images en une seule passe et les fusionne en un seul fichier exportable, ce qui comble l'écart que les outils de traitement un par un comme Lens et ChatGPT ne peuvent pas combler.
En résumé
La chose la plus utile à retenir de cette comparaison est que « image vers texte » n'est pas une seule catégorie — c'en est trois, et elles échouent de manières différentes. Un utilitaire pour téléphone (Lens, OCR.space) est parfait pour une capture et inutile pour une centaine. Un chatbot (ChatGPT, Claude) lit brillamment pour un cas ponctuel, mais il est non déterministe et peut fabriquer des informations, ce qui le rend risqué comme processus reproductible. Un outil dédié (les API cloud pour développeurs, ImageToTable.ai pour tous les autres) échange un peu de flexibilité ponctuelle contre ce qui manque aux autres — le même résultat fiable et exportable, à chaque fois, sur de nombreuses images.
Ne choisissez pas l'outil qui lit le mieux une image. Choisissez celui dont la forme correspond à votre tâche : un utilitaire pour une capture, un chatbot pour une conversation, et un extracteur dédié pour un processus reproductible et exportable.
Si votre travail de conversion image-texte est passé de « de temps en temps » à « encore et encore », c'est le signal pour passer de l'utilitaire gratuit et de la fenêtre de discussion. Téléchargez quelques-unes de vos propres images, indiquez ce que vous voulez en sortie, et voyez si un fichier fini et cohérent en quelques secondes vaut plus qu'un presse-papiers plein de texte à revérifier à la main.
Divulgation : Ce guide est publié par ImageToTable.ai, qui est l'un des sept outils examinés ci-dessus. Nous avons visé une évaluation juste et technique — y compris en nommant les scénarios où Google Lens, ChatGPT, Claude ou les API OCR cloud sont le meilleur choix. Les prix ont été tirés des pages de tarification publiques de chaque fournisseur et sont à jour en juin 2026 ; vérifiez les chiffres les plus récents sur le site de chaque fournisseur avant d'acheter.