Best AI Image to Text Converters in 2026:
7 Tools Compared
一般的なAIチャットボットが画像を確実に読み取れるのでしょうか、それとも専用ツールが必要なのでしょうか?この一点が、このガイドで紹介する7つのツールを分ける分岐点です。そして、ほとんどの「ベスト画像テキスト変換」リストはこの問いに答えていません。Google Lens、ChatGPT、無料のオンラインOCRサイトを、まるで同じ仕事をするとばかりに同じ5つ星ランキングに入れています。しかし、それらは同じ仕事をするわけではありません。1つは素早く取り込むためのスマホ用ツール、1つは優秀だが非決定論的なモデル、もう1つは同じ種類のドキュメントを100回読んでも毎回同じエクスポート可能な結果を返すように作られたものです。これは、3つのカテゴリーすべてを技術顧問の視点で比較したものです:各ツールのコスト、本当に得意なこと、そして最も重要な部分 — 静かに失敗する箇所について。
重要なポイント
- ChatGPTはセットアップ不要で写真の手書き文字を約85%の精度で読み取れます — だからこそ、人々はOCRアプリを開かなくなったのです。
- 本当のリスクは見逃す文字ではなく、自信満々に静かに捏造されるきれいな誤った値と、次回の実行で違う結果を返すことです。
- 専用ツールは1000枚目の画像も1枚目と同じように読み取り、完成したエクスポート可能なファイルを返します — だから、100枚のキャプチャを目視で再確認する必要がなくなります。
2026年に「画像からテキスト」が実際に意味するもの
「画像からテキスト」は現在、根本的に異なる3つのカテゴリのツールを指しており、適切な選択は、自分のタスクにどのカテゴリが必要かを知ることから始まります。このフレーズはかつて一つのことを意味していました:オプティカルキャラクタリコグニション(OCR)— 文字の画像を見て文字をタイプアウトするソフトウェアです。その元々の画像からテキストワークフローは、今でも以下のすべてのツールの中核です。2026年には、無料のスマホボタンから、見たものを推論するビジョン言語モデルまで、スペクトラムが広がっており、それらの間の信頼性のトレードオフは、精度の数字が示すよりも大きいです。
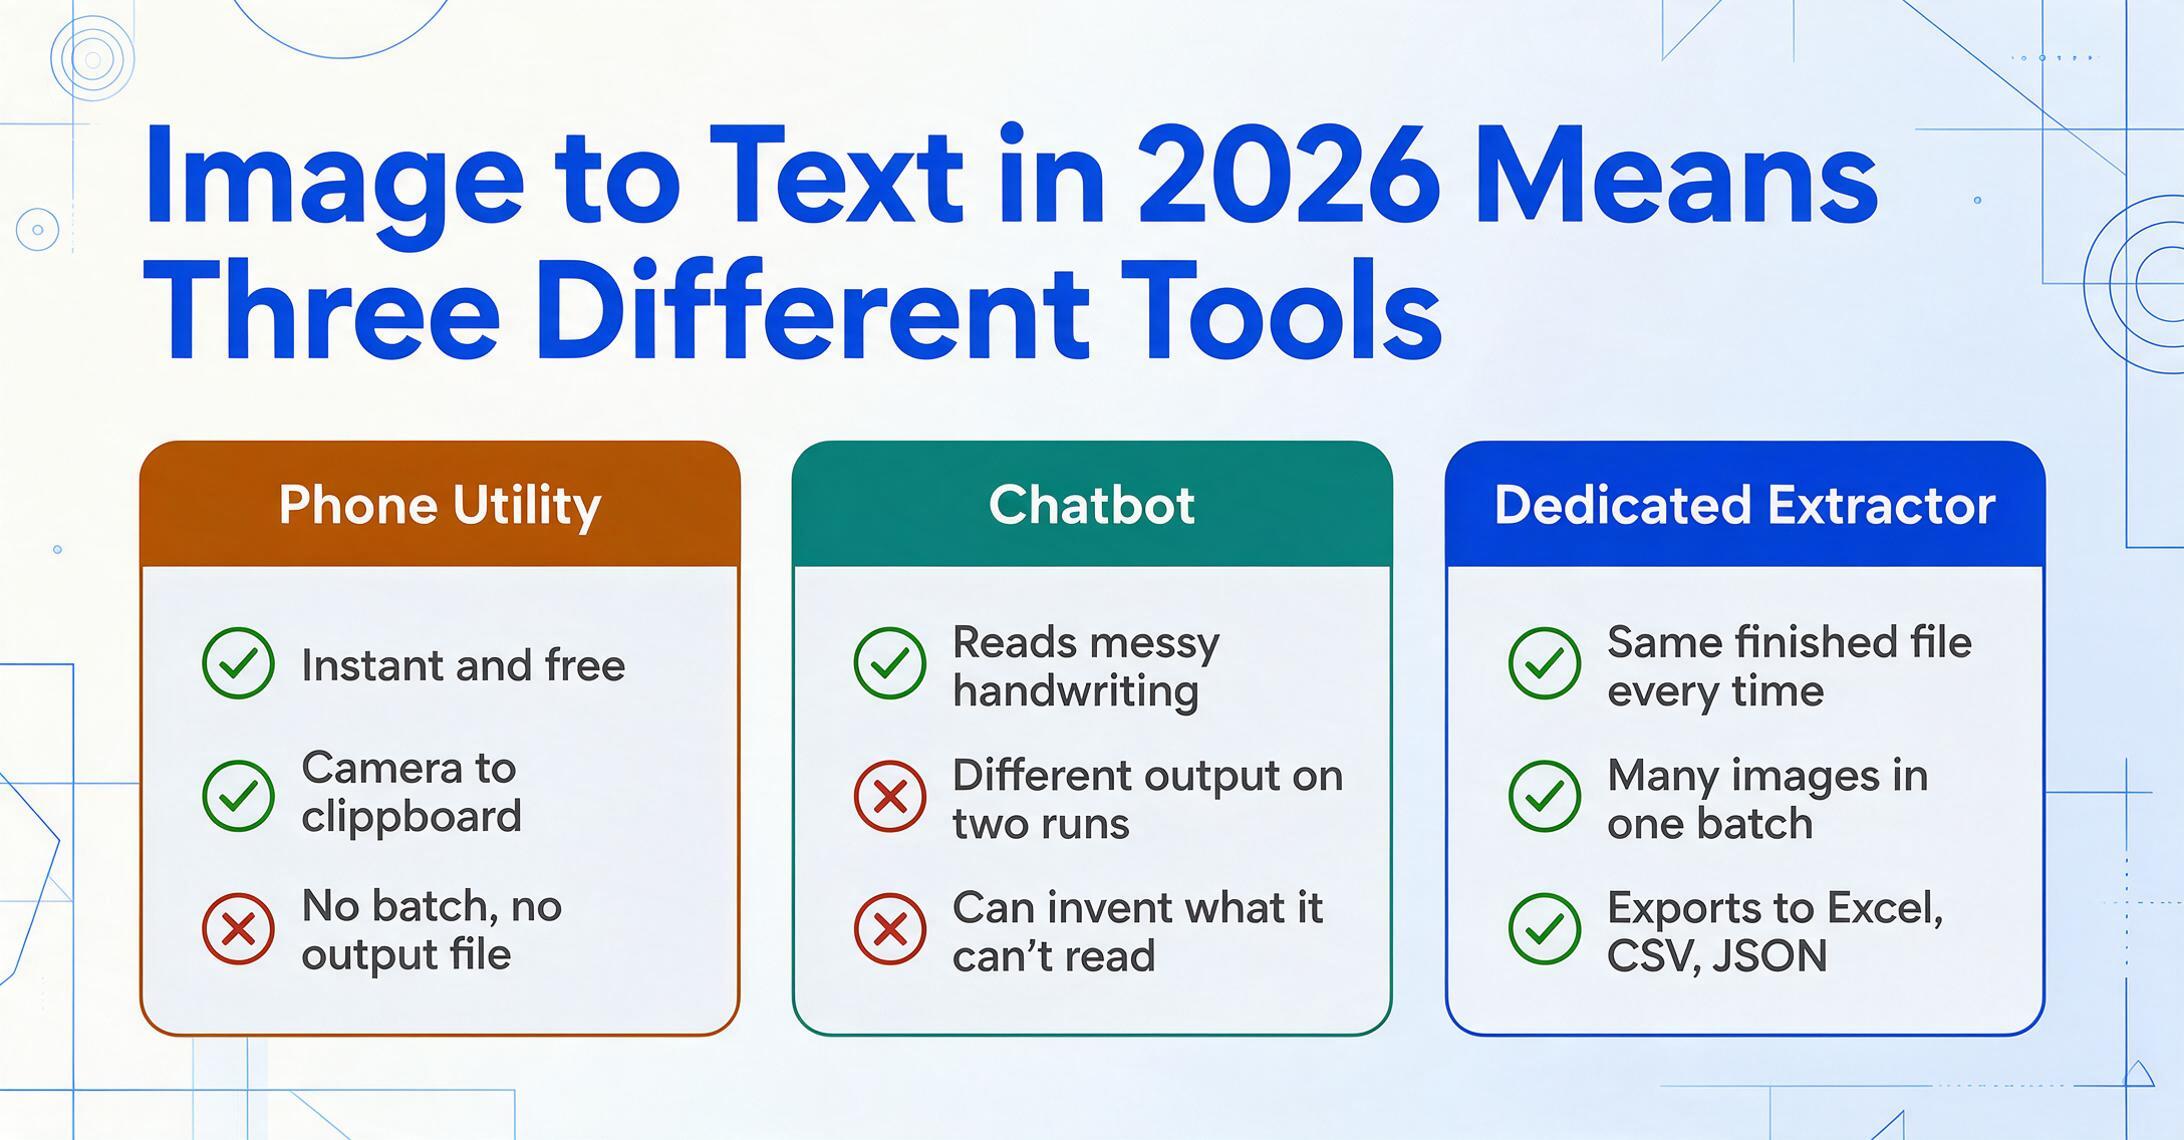
最初の端にはスマホおよびユーティリティOCRツール(Google Lensなど)があります。カメラを看板やページに向けると、テキストが1秒で選択可能になります。これらは即時の一回限りのキャプチャ用に作られています — Wi-Fiパスワードを取得する、段落をコピーする、メニューを翻訳するなどです。無料で、速く、摩擦がなく、繰り返し可能なジョブという概念はありません:バッチキューも、一貫した出力ファイルも、50枚の画像を1つのクリーンなドキュメントに処理する方法もありません。
中間には汎用マルチモーダル大規模言語モデル(LLM) — ChatGPT、Claude、Geminiがあります。画像をチャットに貼り付けると、それらはしばしば印象的に読み取り、見つけたものを説明、要約、再フォーマットすることもできます。欠点は、それらが非決定論的であることです:同じ画像と同じプロンプトでも、2回の実行でわずかに異なる出力が生成されることがあり、モデルは文字が読めないことを認める代わりに、もっともらしい値を「埋める」ことがあります。100枚の画像をフィードして結果を1つの構造化ファイルにマージする組み込みパイプラインはありません。
3番目の端には、信頼性が高く、繰り返し可能で、エクスポート可能な出力を生成するために作られた専用抽出ツールがあります — 開発者向けのGoogle Document AIやAWS Textract、そして他のすべての人のためのノーコードアプリ(ImageToTable.aiなど)です。これらのツールのポイントは、ChatGPTよりも単一の画像をより良く読むことではなく、1000枚目の画像を最初の画像と同じように読み、完成したファイル(TXT、Word、CSV、Excel)を渡し、毎回の実行を見守る必要がないことです。
これら3つのカテゴリの違いは精度ではなく、信頼性とスケールです。スマホユーティリティは1回のクイックキャプチャに勝り、チャットボットは会話的な一回限りに勝り、専用ツールは、多くの画像にわたって同じ結果をエクスポート可能なファイルで繰り返し必要とする瞬間に勝ります。
このガイドは、画像を編集可能なテキストにすること — 文字起こしと読み取り可能な出力についてです。実際に必要なのが、データをスプレッドシートの列に引き出すこと(請求書の合計、テーブルの行)であれば、それは関連しているが別のジョブであり、当社のデータ抽出ソフトウェアまとめがより良い出発点です。ここでの質問はよりシンプルです:画像を入れて、言葉を出す — そして、これら7つのツールのどれを信頼すべきかということです。
選定方法とテスト方法
この7つのツールは、2026年において人々が画像をテキストに変換する実際の方法の幅を代表するように選ばれました。単純にランク付けできるリストではありません。私たちは、購入者が実際に手に取るツールと、SERPで「画像からテキストへ」の検索で一貫して表示されるツールから始めました。スマホ向けユーティリティ(Google Lens)、代表的な無料オンラインOCRサービス(OCR.space)、OCRとしてますます利用される汎用の大規模言語モデル2つ(ChatGPT、Claude)、開発者向けクラウドAPI(Google Document AI、AWS Textract)、そしてノーコード専用抽出ツール(当社のImageToTable.ai)です。
各ツールは4つの観点で評価しました。実際の用途(一度きりの取得、会話、または反復可能な作業)、実際の価格(「〜から」ではなく、公開されている最低価格)、大量処理時の信頼性(同じ出力を2回返すか、捏造する可能性があるか)、そして正直な適合性 — 本当に優れているシナリオと、そうでないシナリオです。精度や失敗データを引用する場合、それはベンダーのデモではなく、独立したベンチマークと実務者のテストに基づいています。価格は各ベンダーの公開価格ページから取得し、2026年6月時点のものです。
最初に1つ開示します。このサイトが属する製品であるImageToTable.aiは、レビュー対象の7つのツールの1つです。私たちは、正直に適合する位置(ノーコード、反復可能、エクスポート可能な抽出)に配置し、Google Lens、ChatGPT、またはクラウドAPIがより適切なケースを明記しました。1回の簡単なキャプチャでは、Lensが私たちを完全に上回ります。そうでないと偽ることは、このリストの価値を損なうことになります。
画像からテキストへの変換ツール ベスト7 早見表
以下の表は簡潔な回答です。各ツールの最安エントリーポイントと、最も注意が必要な制限事項を示しています。「価格は2026年6月時点のものです。」
| ツール | 開始価格 | 価格モデル | 最適な用途 | 主な制限 | 無料トライアル |
|---|---|---|---|---|---|
| Google Lens | 無料 | 無料(Googleアプリ/Chrome/フォト) | スマホでその場撮影 | バッチ不可、エクスポート不可、繰り返しジョブ不可 | 無料 |
| OCR.space | 無料 | 無料API+有料PROプラン | 高速または自動のプレーンテキストOCR | プレーンテキストのみ、乱雑な手書きに弱い | 無料枠あり |
| ChatGPT | 無料 / 月額$20(Plus) | サブスクリプション(消費者向け) | 会話形式の1回読み取り+推論 | 非決定的、バッチ不可、捏造の可能性 | 無料枠あり |
| Claude | 無料 / 月額$20(Pro) | サブスクリプション(消費者向け) | 長文ドキュメントの慎重な1回読み取り | LLM特有の注意点あり、バッチ/エクスポート不可 | 無料枠あり |
| Google Document AI | 1,000ページあたり$1.50 | 従量課金(ページ単位) | 開発者向け大量クラウドOCR | 開発環境が必要、生出力を後処理 | 無料枠あり(GCP) |
| AWS Textract | 1,000ページあたり$1.50 | 従量課金(ページ単位) | AWS内での大量クラウドOCR | 開発者専用、フォーム/表は高額 | 無料枠あり(3ヶ月) |
| ImageToTable.ai | 無料 / 月額$9 | サブスクリプション + PAYGクレジット | ノーコード、繰り返し利用可能、テキスト/データのエクスポート | ネイティブERP連携なし、SOC 2/HIPAA非対応 | 無料枠あり |
表全体を説明する1つのパターンがあります。価格は、ツールがどれだけうまく読み取るかではなく、読み取りの周囲にあるものに連動します。LensとOCR.spaceは、生のテキストを渡して終了するため無料です。つまり、ワークフローが組み込まれていない無料の画像からテキストへの変換ツールです。チャットボットは月額$20かかります。これは、OCRエンジンではなく推論モデルに対して支払っているためです。クラウドAPIは、構築するインフラストラクチャであるため、ページ単位で請求されます。そして、専用抽出ツールは、読み取りを反復可能でエクスポート可能なワークフローで包み込むため、少額のサブスクリプションを請求します。ラッパーを自分の作業に合わせれば、正しい選択は明らかになります。
電話&無料ユーティリティOCR:Google Lens&OCR.space
1回の簡単なキャプチャには、無料のユーティリティOCRは「十分」なだけでなく、正しい答えであり、スピードではこのリストの何にも負けません。これらのツールは、画面やページからテキストを取得して、セットアップなしでクリップボードに入れるために存在します。タスクが繰り返しになったり、構造化された出力ファイルが必要になった瞬間に、これらのツールは限界に達します。
Google Lens
Google Lensは、Googleアプリ、Chrome、Googleフォトに組み込まれているOCRです。カメラを向ける(または任意の画像を開く)だけで、テキストがリアルタイムで選択、コピー、翻訳可能になります。本から段落をコピーする、ラベルからシリアル番号を読み取る、外国のメニューを読むなど、本来の用途には本当に優れており、費用はかかりません。
最適な用途:スマートフォンでの即時・外出先での単発キャプチャ。特に翻訳が作業の一部である場合に最適です。不向きな用途:繰り返し行うワークフロー全般。バッチ処理がなく、多数の画像にわたるクリーンな結果ファイルをエクスポートする方法もなく、出力構造を制御することもできません。これはユーティリティであり、ドキュメントパイプラインではありません。 Google Lensを開く →
OCR.space
OCR.spaceは、無料でサインアップ不要のオンラインOCRサービスで、公開APIを備えており、アップロードした画像やPDFからプレーンテキストを取得したい場合や、基本的なOCRをスクリプトに組み込みたい場合に便利です。無料ティアは軽い使用には十分で、有料のPROティアでは、より高い制限、より大きなファイル、より優れたエンジンが追加されます。
最適な用途:ブラウザでの迅速な無料プレーンテキスト抽出、またはAPIを介した軽量な自動OCR。不向きな用途:読みにくい手書き文字、複雑なレイアウト、またはテキストを名前付きフィールドに再編成する必要がある人。フラットな文字ブロックが返され、後処理はユーザー側で行うことになります。レイアウトを認識するツールが同じ作業をどのように処理するかについては、AI OCR抽出ページをご覧ください。 OCR.spaceの料金を見る →
どちらのツールも同じ限界を共有しています。読み取って、その後は問題をユーザーに返します。1枚の画像にはそれで十分です。しかし、50枚には適していません。まさにそこで人々がChatGPTを使い始めるのです。
ChatGPTやClaudeは画像を確実に読み取れますか?
はい——そして、いいえ。その違いこそがこのガイドで最も重要なポイントです。汎用マルチモーダルモデルは、一回限りの用途では画像を驚くほど正確に読み取りますが、反復的で高い精度が求められる文字起こしには不向きです。なぜなら、読み取れない内容を静かに捏造してしまうことがあるからです。
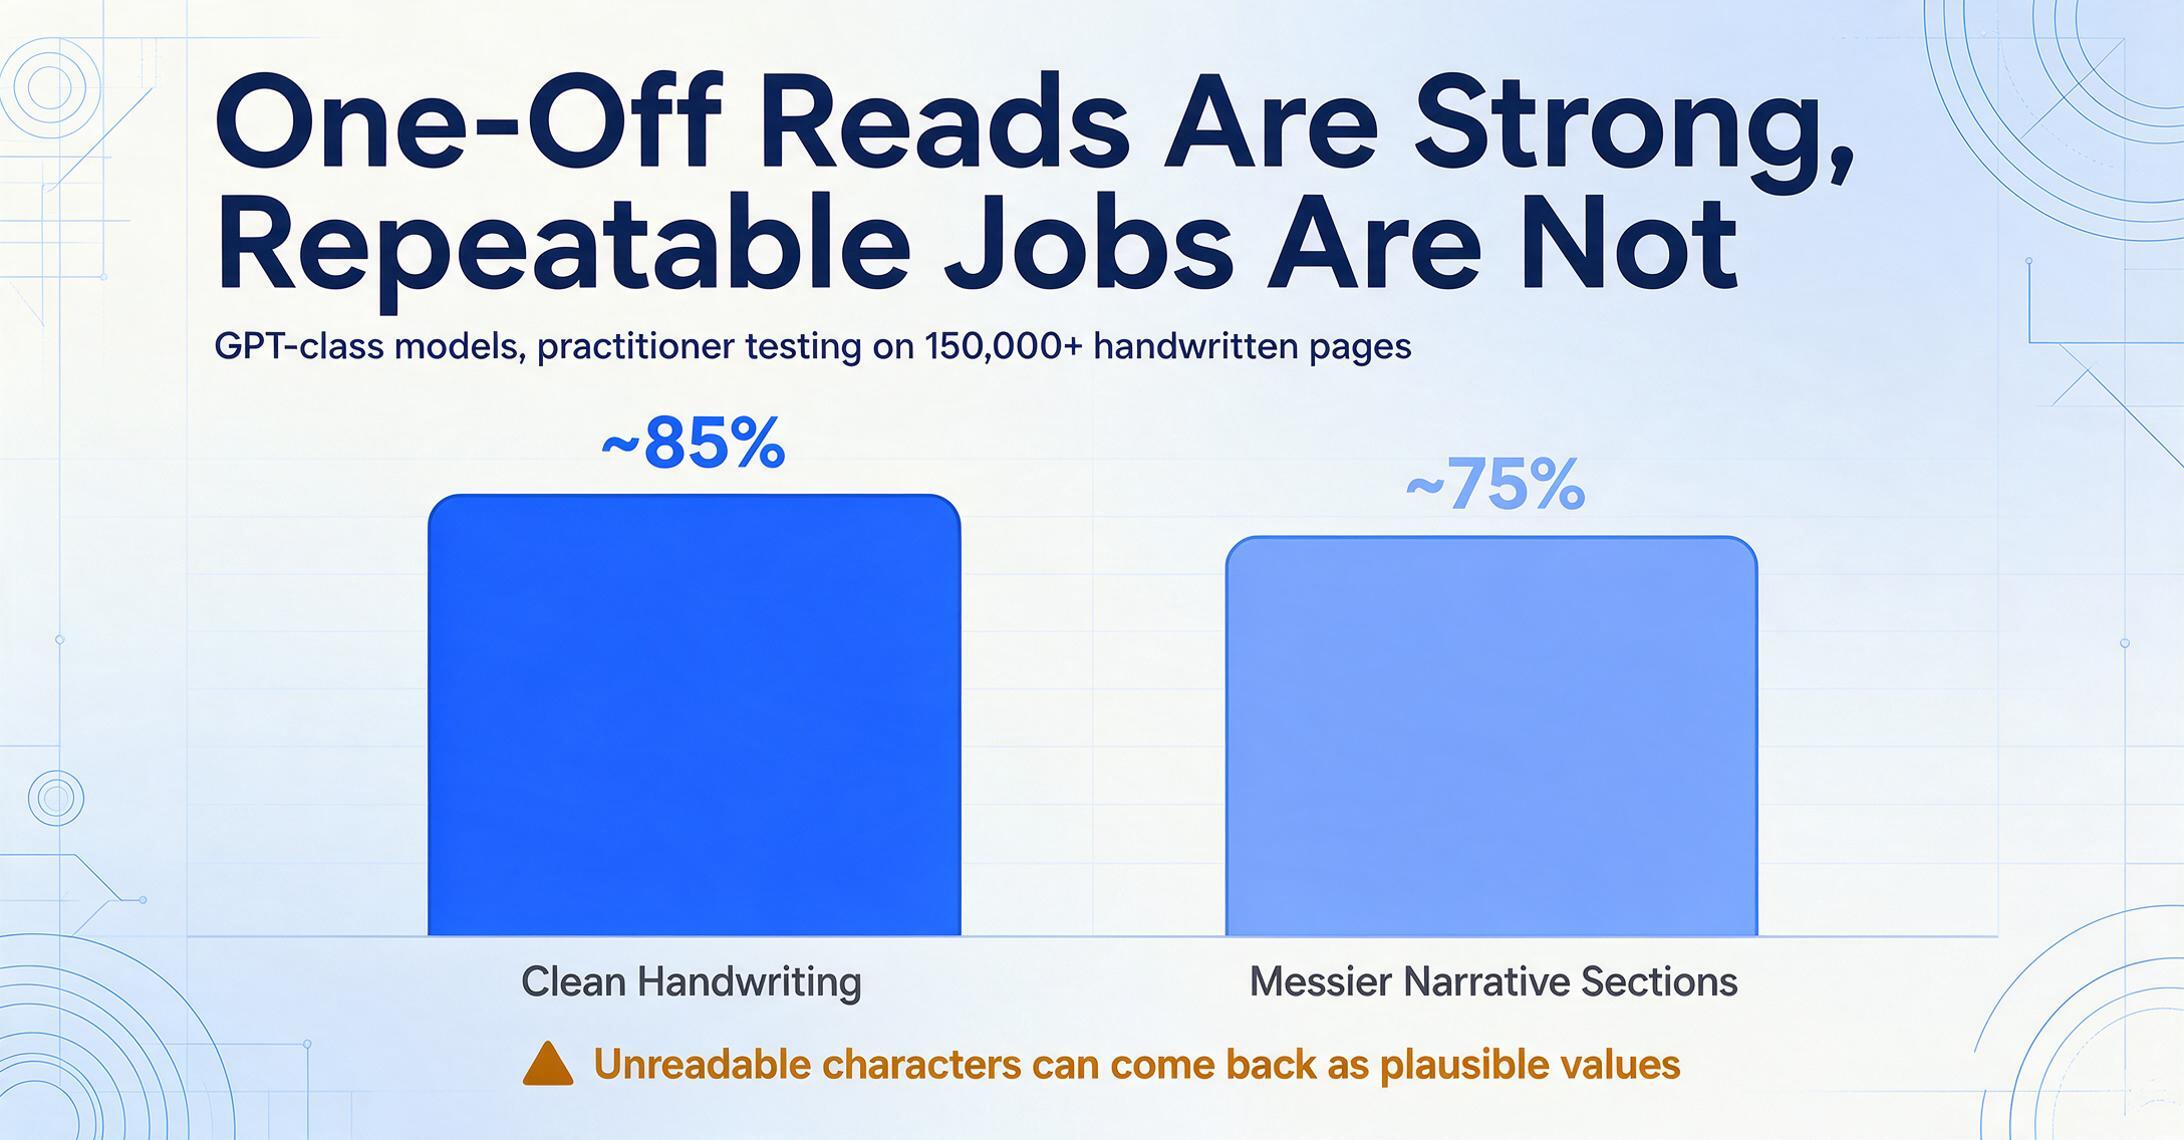
「はい」は現実です。r/OpenAIでは、ビジョンモデルに対する定番の反応は、チャットボットが「画像からテキストをそのまま読み取れる」ことへの素直な驚きであり、今では写真をChatGPTに貼り付けて文字を尋ねるのが日常的になっています。r/computervisionでの2025年の実務者レビュー——本番環境で15万ページ以上の手書き文書を処理した人物によるもの——では、GPTクラスのモデルが「きれいな手書き文字で約85%の精度」を達成したと報告されています。これはセットアップ不要のツールとしては非常に優秀です。
「いいえ」も同じく現実であり、それは構造的な問題です。同じレビューでは、精度が「乱雑な文章セクションでは約75%に低下する」と指摘されており、より深い問題はパーセンテージではなく、失敗の仕方にあります。独立したオープンソースのOCRベンチマークがビジョンモデルと従来のOCRを比較したところ、広く読まれたエンジニアリング議論が巻き起こり、ある実務者は率直にこう述べています。ビジョンモデルは「(未解決の)ハルシネーション問題に従来のOCRと同様に影響を受けやすく」、「失敗の仕方は(従来のOCRとは異なり)まったく予測不能です」。学術研究も同意見です。2025年のNeurIPS論文、「Seeing is Believing? Mitigating OCR Hallucinations in Multimodal LLMs」はまさにこの問題を測定しています。ぼやけ、グレア、部分的な遮蔽があると、LLMはページ上に存在しなかったもっともらしい値を自信を持って出力することがあります。
読み取れない文字があると、従来のOCRエンジンは一目でわかるゴミを返します。一方、言語モデルは読み取れない文字があっても、きれいで自信に満ちた誤った答えを返すことがあり、次回の実行では少し違う答えを返すこともあります。この非決定論的な性質こそが、チャットボットが1枚の文書には優れている一方で、100枚の文書にはリスクが伴う理由です。
また、ワークフローのギャップもあります。ChatGPT(無料版、または月額$20のPlus)もClaude(無料版、または月額$20のPro)も、50枚の画像を一度に処理して1つの一貫したファイルに統合する組み込み機能はなく、同じプロンプトでも実行ごとに列の順序や形式が変わることがあります。一回限りの用途——このレシートを読む、このメモを書き起こす——には、これらは正当で迅速な選択肢です。しかしプロセスとして使うなら、同じモデルの読み取りをガードレールで保護する必要があります。詳細はChatGPT比較で掘り下げています。要約すると、文書にはチャットボットを、手順には専用ツールを使うということです。 ChatGPTの料金を見る → Claudeの料金を見る →
開発者向けクラウドOCR API:Google Document AI と AWS Textract
エンジニアリングリソースと安定した大量処理があるなら、この2つのハイパースケーラーOCR APIが、画像をテキストに大規模変換する最も安価で信頼できる方法です。これらは「使う」アプリではなく、その上に構築するサービスであり、それが強みであると同時に障壁でもあります。
Google Document AI
GoogleのDocument AIは、Enterprise Document OCRプロセッサが1,000ページあたり$1.50(月間500万ページを超えると割引)で動作するクラウドプラットフォームで、多言語・手書き文字への対応が強く、重要度の高い作業には人間が介在するレビュー層も備えています。出力は、LLMチャットとは異なり、信頼性が高く決定論的です。
最適なケース:高く安定したボリュームに対して、スケーラブルでAPIベースの認識を必要とする開発チーム、特にすでにGoogle Cloudを利用しているチーム。 不向きなケース:開発者ではない方。クリック操作だけで使えるアプリはなく、OCRは後処理が必要な生のテキストブロックを返すためです。 Google Document AIの料金を見る →
AWS Textract
TextractはAmazonのドキュメントOCRサービスで、複数のAPIを通じて提供されています。基本のDetect Document Text呼び出しは1,000ページあたり$1.50で、最初の3ヶ月間は月1,000ページ分の無料枠があります。構造化機能(フォーム、テーブル)はページあたりのコストがかなり高くなるため、主にプレーンテキストが必要な場合に最も安価です。
最適なケース:すでにAWSエコシステム内で、より大規模なパイプラインの構成要素としてOCRを利用したいチーム。 不向きなケース:開発者がいない場合、またはフォームやテーブルが中心のワークロードで、ページあたりのコストが急上昇する場合。トレードオフの詳細はAWS Textract比較で解説しています。 AWS Textractの料金を見る →
どちらのAPIもドキュメントを確実に、低コストで読み取ります。しかし、その生の出力を完成された構造化ファイルに変換することは、機能ではなく開発プロジェクトです。ノーコード専用ツールがまさにそのギャップを埋めます。
専用・エクスポート可能な抽出: ImageToTable.ai
画像からテキストへの変換が繰り返し発生する作業になり、コードを書きたくない場合、専用のノーコード抽出ツールを使えば、LLMの読み取り結果を、チャットボットにはない信頼性とエクスポート機能で包んで提供できます。ここが、このサイトの背景にある製品であり、ここで紹介する7つのツールの1つでもあるImageToTable.aiの立ち位置です。
ImageToTable.aiは視覚大規模モデルを基盤としているため、印刷テキスト、手書き文字、筆記体、表、チェックボックスを、LLMが複雑な文書を処理する際の強みとなる文脈理解と同様の精度で読み取ります。違いは、読み取り機能を囲む部分にあります。Wordに変換モードは、文書画像を受け取り、元のレイアウトを保持した編集可能なWordファイルを返します。ページ全体を、単なる文字の羅列ではなく、編集可能なテキストとして取得したい場合に便利です。テーブルに変換モードはカスタム列抽出を使用します。「日付」「合計」「参照」など、必要なフィールドを入力すると、人工知能が意味に基づいて各値を特定し、一貫性のある表をExcel、CSV、またはJSONに出力します。どちらの方法でも、毎回同じ方法で、完成したファイルを受け取れます。また、一度に1つのチャットで処理するのではなく、1つのバッチで多数の画像を処理できます。料金は無料枠から始まり、その後月額$9です。
最適な用途:コーディング、モデルトレーニング、または毎回の処理の監視なしに、画像を編集・エクスポート可能なテキストやデータに繰り返し変換する必要があるフリーランサー、オペレーションチーム、簿記担当者、中小企業。適さない用途:1回だけの簡単な撮影、コンテンツについても議論したい対話型の読み取り、またはネイティブなERP同期、オンプレミス展開、SOC 2 / HIPAAコンプライアンスを必要とする企業。ノーコードのアプローチは、画像からWordへの変換ページまたは手書き文字からテキストへのページでご覧いただけます。また、ノーコード文書AIまとめでは、他の軽量な選択肢とともに紹介しています。 ImageToTable.aiを無料で試す →
選び方:単発、大量、手書き、または開発者向け
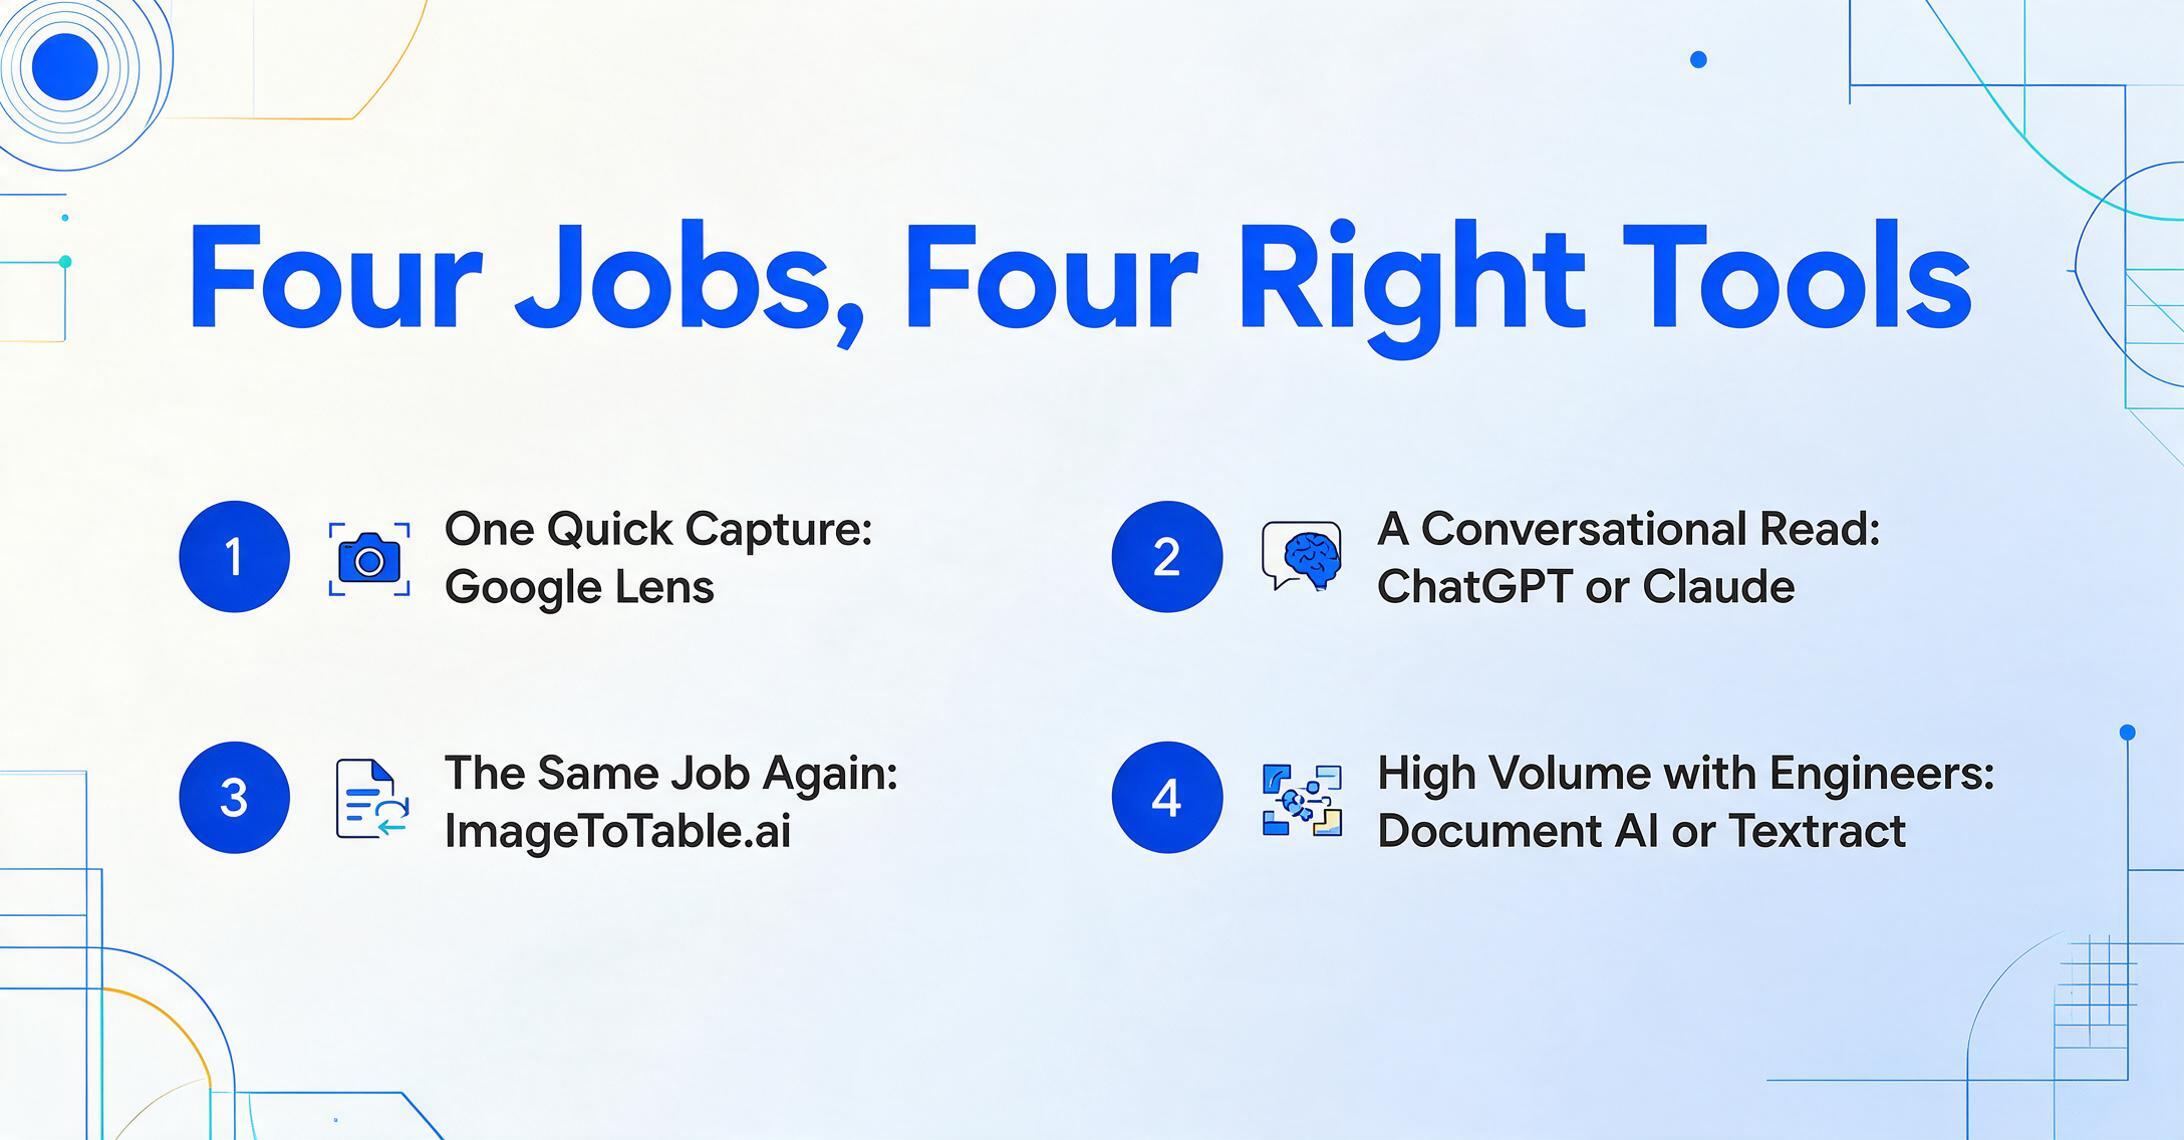
適切な画像からテキストへの変換ツールとは、星の数が最も多いものではなく、あなたの作業内容に合ったものです。ここでは、4つの一般的なシナリオでの判断基準をご紹介します。
素早い1回の取り込み
最適なツール: Google Lens(またはOCR.space)
段落、コード、メニューを取得しますか?無料のスマホユーティリティを使いましょう。即座に処理でき、設定も不要です。ここで有料ツールを使うのは過剰です。編集可能なドキュメントにする必要があるPNGスクリーンショットは別の作業です — PNGをWordに変換するには、ユーティリティツールにはないレイアウト認識が必要です。
会話型の読み取りや推論
最適なツール: ChatGPTまたはClaude
ドキュメントを読んで、それについて質問したいですか?チャットボットが最適です。重要なことは必ず確認し、毎回同じ出力に依存しないようにしましょう。
多数の画像、反復的、エクスポート可能
最適なツール: ImageToTable.ai
同じ種類のドキュメントを繰り返し編集可能なテキストやスプレッドシートに変換し、コード不要で一貫した出力ファイルを得たい場合?これはノーコードの最適な領域です。無料プランから始めましょう。
エンジニアによる高ボリューム処理
最適なツール: Google Document AIまたはAWS Textract
安定した高ボリュームと、それを基に構築する開発チームがありますか?クラウドAPIが1ページあたり最も安価です。既に利用しているクラウドに基づいて選択しましょう。
作業が構造化データ側と重なる場合 — テキストを単に書き起こすだけでなく、フィールドや行をスプレッドシートに取り込む場合 — より深く掘り下げた関連ガイドをご覧ください:AI OCRソフトウェア総まとめとドキュメントデータ抽出ツール総まとめです。
よくある質問
無料で使える最高のAI画像テキスト変換ツールは?
一回限りの利用なら、Googleレンズが最適な無料オプションです。Googleアプリ、Chrome、Googleフォトに組み込まれており、画像から瞬時にテキストを読み取り、費用は一切かかりません。ブラウザ上またはAPI経由で無料のプレーンテキストOCRを利用するなら、OCR.spaceが確実な選択肢です。テキストを繰り返し取得し、エクスポート可能なファイルとして必要な場合は、ImageToTable.aiの無料プランが、単なるテキストダンプを超えて、編集可能なWordや構造化されたスプレッドシートを提供します。
画像をテキストに変換するのにChatGPTを使えますか?
単一の文書であれば、はい。画像をChatGPT(無料版または月額20ドルのPlus版)やClaudeに貼り付けてテキストを依頼すれば、通常は問題なく読み取ってくれます。独立した実務者によるテストでは、きれいな手書き文字で約85%の精度です。問題は大量処理における信頼性です。言語モデルは非決定的であり(同じ画像でも実行ごとに異なる出力が生じる可能性があります)、判読不能な文字に対してもっともらしい値を「幻覚」することがあり、その失敗モードは発見が困難です。一回限りの使用にはチャットボットを、同じ結果を繰り返し必要とする場合には専用ツールを使用してください。
AI画像テキスト変換ツールは手書き文字に正確ですか?
ビジョンモデルベースのツールは、文脈を利用するため、従来のOCRよりもはるかに手書き文字を読み取れますが、乱雑な文字や筆記体では精度は依然として低下します。実務者によるテストでは、主要モデルはきれいな手書き文字で約85%ですが、乱雑な部分では約75%に低下します。手書き文字が多い作業では、まず無料プランで実際の文書をテストし、フラットなテキストブロックを返すツールよりも、出力を確認・修正できるツールを選びましょう。
OCRとAI画像テキスト変換ツールの違いは何ですか?
従来のOCRは、ピクセルの形状を文字にマッチングし、理解せずにテキストを出力します。高速で決定的ですが、スキャン不良、手書き文字、変則的なレイアウトでは機能しません。AI画像テキスト変換ツールは、ビジョン言語モデルを使用してページを文脈ごと読み取るため、乱雑な実世界の画像をはるかによく処理できます。トレードオフとして、AIモデルは時折捏造を行う可能性があるため、専用ツールは生のチャット出力をそのまま提供するのではなく、それらを構造とエクスポート制御でラップします。
画像をWordで編集できるテキストに変換するにはどうすればよいですか?
Google LensやOCR.spaceのような無料ツールはコピー可能なプレーンテキストを提供しますが、レイアウトは保持されません。元の書式を維持した編集可能なドキュメントを得るには、レイアウト認識モードを備えたツールを使用してください。ImageToTable.aiのWordに変換モードは、ドキュメント画像を読み取り、元のレイアウトを維持した編集可能なWordファイルをエクスポートします。見出し、段落、テーブルは、単一のフラットな段落としてではなく、本来あるべき場所に配置されます。撮影したページも同じ経路をたどります。JPGからWordへのワークフローは、見出しとテーブルが所定の位置にある編集可能なドキュメントをエクスポートし、単一のテキストブロックにはなりません。
多くの画像を一度に処理するのに最適な画像からテキストへのツールはどれですか?
電話ユーティリティやチャットボットには実際のバッチワークフローがないため、多くの画像を処理するには、開発者向けクラウドAPI(エンジニアがいる場合はGoogle Document AIやAWS Textract)か、バッチ処理用に構築されたノーコードツールのいずれかが必要です。ImageToTable.aiは複数の画像を1回のパスで処理し、それらを単一のエクスポート可能なファイルにマージします。これは、LensやChatGPTのような一度に1つずつ処理するツールでは埋められないギャップです。
結論
この比較から得られる最も有用な点は、「画像からテキストへ」が単一のカテゴリではなく、3つの異なるカテゴリであり、それぞれ異なる方法で失敗するということです。電話ユーティリティ(Lens、OCR.space)は1回のキャプチャには最適ですが、100回の処理には役に立ちません。チャットボット(ChatGPT、Claude)は1回限りの使用には優れた読み取りを提供しますが、非決定論的であり、ハルシネーションを起こす可能性があるため、反復可能なプロセスとしてはリスクがあります。専用ツール(開発者向けクラウドAPI、その他のユーザー向けImageToTable.ai)は、多少の単発的な柔軟性と引き換えに、他のツールに欠けているもの、つまり多くの画像に対して毎回同じ信頼性の高いエクスポート可能な結果を提供します。
1枚の画像を最もよく読むツールを選ばないでください。仕事の形に合ったツールを選んでください。キャプチャにはユーティリティ、会話にはチャットボット、反復可能でエクスポート可能なプロセスには専用の抽出ツールを選んでください。
画像からテキストへの作業が「たまに」から「繰り返し」に変わったなら、それは無料ユーティリティとチャットウィンドウから移行する合図です。ご自身の画像をいくつかアップロードし、必要な出力を指定して、数秒で完成した一貫性のあるファイルが、手で再確認する必要のあるクリップボードのテキストよりも価値があるかどうかを確認してください。
開示: このガイドは、上記でレビューした7つのツールの1つであるImageToTable.aiによって公開されています。公正で技術的な評価を目指しています。Google Lens、ChatGPT、Claude、またはクラウドOCR APIがより適切な選択となるシナリオも含めて明記しています。価格は各ベンダーの公開価格ページから取得し、2026年6月時点のものです。購入前に各ベンダーのサイトで最新の数値をご確認ください。