Best OCR API
2026: 10 Developer APIs Compared for Accuracy & Price
この比較では、印刷テキストと手書きテキストの精度、複数のボリューム層でのページ単価、SDKの言語サポート、出力形式の品質、レイテンシープロファイル、クラウドエコシステム統合という6つの側面で10のOCR APIを評価し、次のプロジェクトに向けた情報に基づいた意思決定を支援します。各APIは、公開されている仕様、公式の価格ページ、開発者コミュニティのフィードバックに基づいて評価されました。 開示:この記事には、9つのAPIに加えて1つのノーコードツールが文脈のために含まれています。すべての価格データは2026年6月時点の公式情報源で検証済みです。第三者のサービスへのリンクにはnofollowを使用しています。
重要なポイント
- 1,000ページあたり$1.50という見出しレートには33倍のコスト乗数が隠れています — Textractでフォーム抽出を有効にすると、テーブルを1つも処理する前に、請求額は1,000ページあたり$51.50に跳ね上がります。
- 主要なOCR APIはすべて、クリーンなドキュメントで97〜99%の精度を実現します — ベンチマークスコアにこだわるのは、取り戻せないリソース、つまりチームがSDK統合、IAM設定、パイプラインプラミングに費やすエンジニアリング週数を無駄にするだけです。
- 「最高のOCR API」という問いは間違いです — すでに支払っているクラウド、チームが熟知しているSDK、実際に受け取るドキュメントタイプから始めて、統合の摩擦を最小限に抑えるAPIを選びましょう。
クイック比較:主要10のOCR APIを一目で
以下の表は、各APIの代表的な強み、初期価格、対応文書タイプ、そして自然に連携できるエコシステムをまとめたものです。まずはこの表で絞り込み、気になるAPIの詳細セクションをご確認ください。
| API | 最適な用途 | 初期価格 | 対応ドキュメント | クラウドエコシステム |
|---|---|---|---|---|
| Google Cloud Vision | 一般的なOCR+シーン文字認識 | 無料: 月1K件、以降 $1.50/1K | あらゆる形式(画像、PDF) | Google Cloud(Doc AI、Storage、BigQuery) |
| AWS Textract | フォーム、表、構造化ドキュメント | 無料: 月1K件(3ヶ月)、以降 $1.50/1K | フォーム、表、請求書、領収書、身分証明書 | AWS(S3、Lambda、Comprehend、SQS) |
| Azure Document Intelligence | プリビルトモデル+Microsoftスタック | 無料: 月500件、以降 Read $1.50/1K | 請求書、領収書、身分証明書、健康保険証、契約書 | Azure(Logic Apps、Power Automate、Purview) |
| Tesseract | 無料のセルフホスト型OCR | 無料(コンピューティング費用のみ) | 鮮明な印刷ドキュメント | セルフホスト(Linux、Windows、macOS) |
| ABBYY Cloud OCR SDK | エンタープライズ向け高精度OCR | $99/月(5Kページ) | あらゆる形式(200以上の言語、手書き文字) | Azureホスト型、オンプレミス対応 |
| Mindee | 開発者向けDX+プリトレーニングモデル | 無料: 月250件、以降 €44/月(500クレジット) | 請求書、領収書、身分証明書、パスポート、履歴書 | スタンドアロンAPI(エコシステム非依存) |
| Nanonets | カスタムモデルトレーニング+ワークフロー | $499/月(10Kページ) | カスタムドキュメントタイプ、請求書、領収書 | スタンドアロン+連携(Zapier、QuickBooks) |
| Veryfi | 領収書、請求書、財務ドキュメント | 無料: 100件、$500/月〜(Starter) | 領収書、請求書、銀行明細書、小切手 | スタンドアロン+QuickBooks、Xero連携 |
| OCR.space | 大量処理向け無料予算OCR | 無料: 月25Kリクエスト、$30/月(PRO) | 鮮明なテキストドキュメント、複数ページPDF | スタンドアロンAPI(シンプル設計) |
| Base64.ai | あらゆるドキュメントタイプを1つのAPIで | カスタム価格(ページ単位課金) | 100以上のドキュメントタイプ、手書き文字、表 | スタンドアロンAPI+Slack、Zapier |
選定方法と評価基準
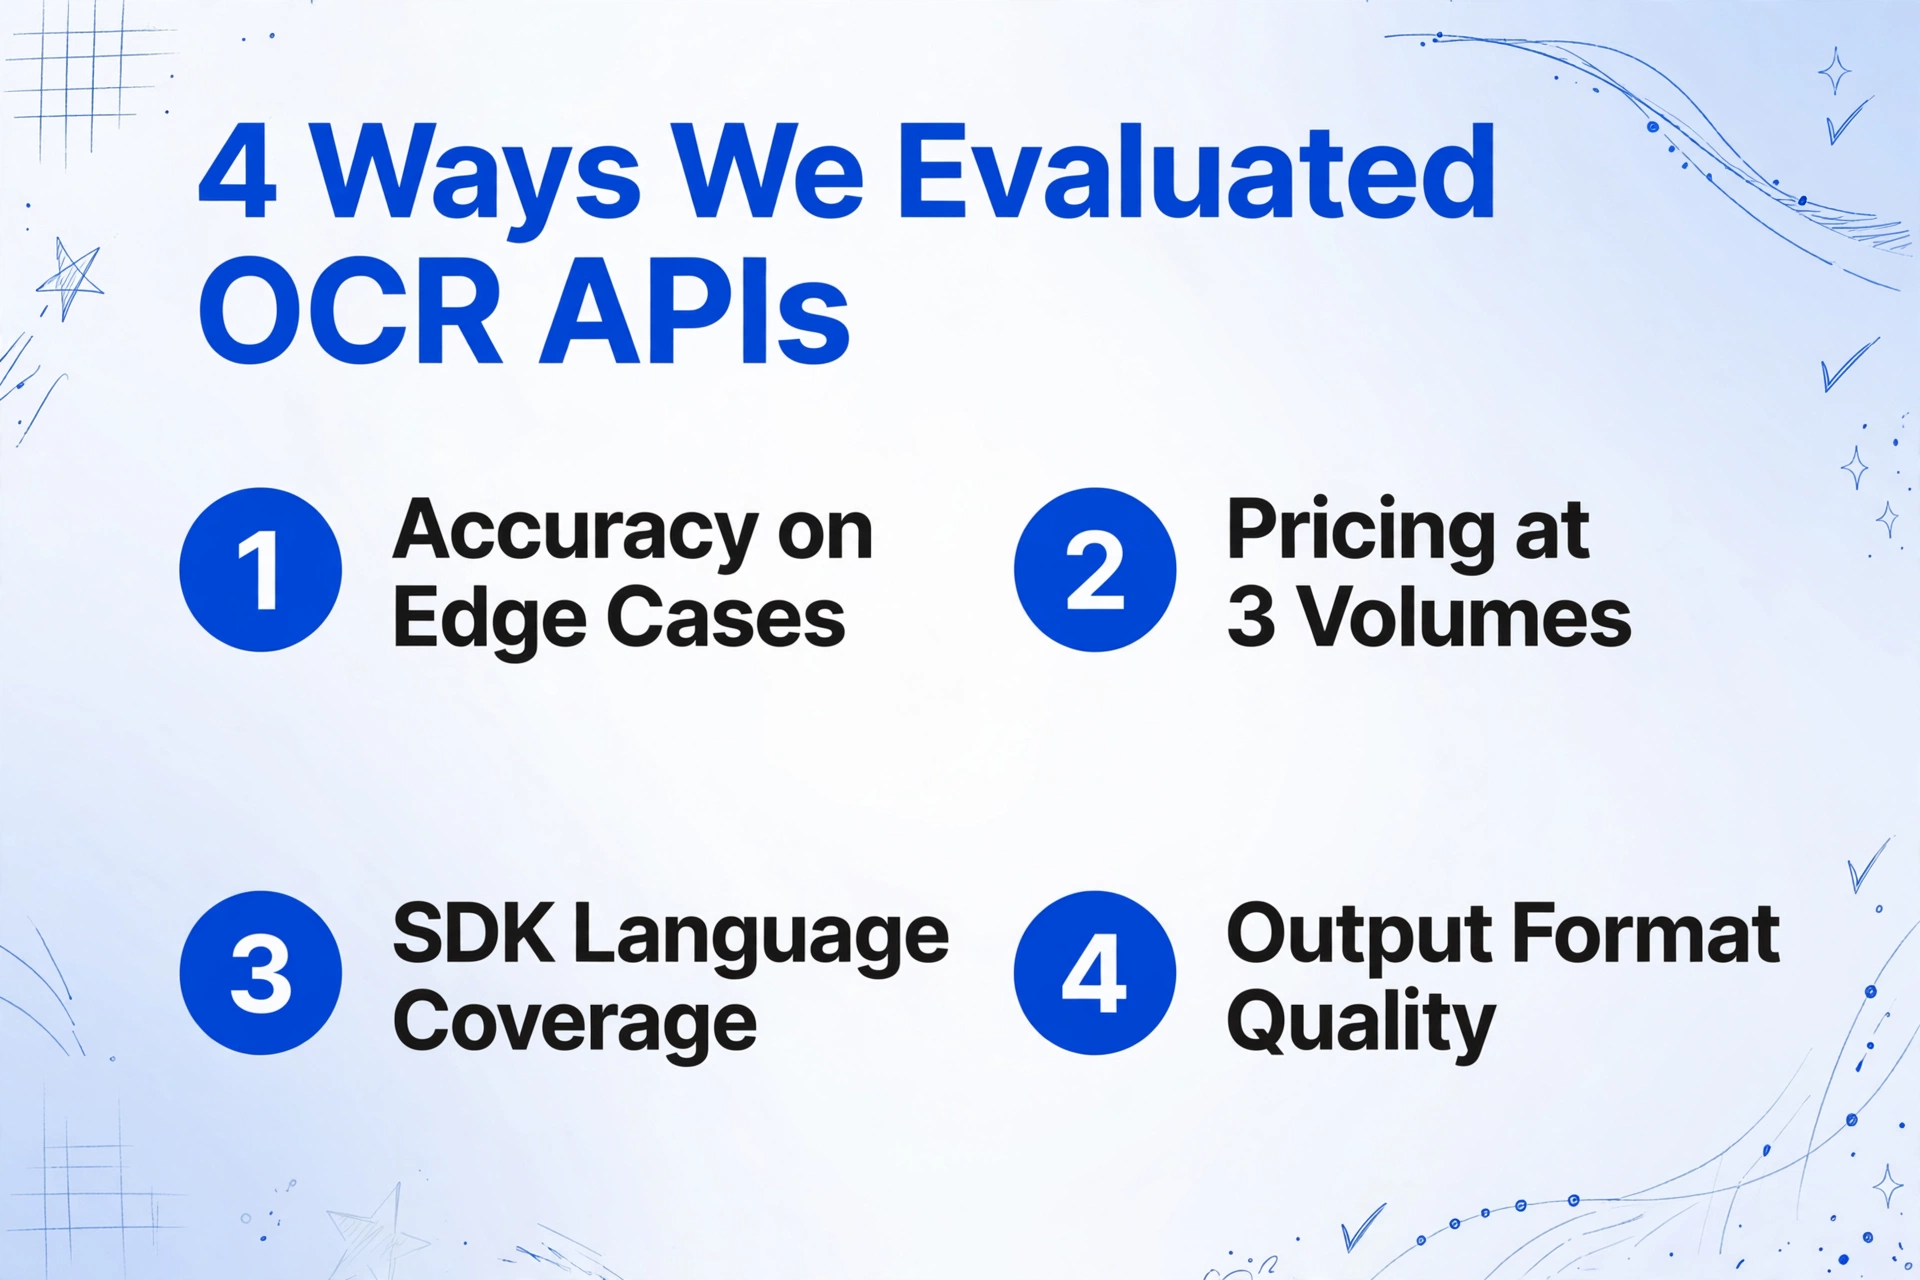
以下の各評価項目は、公式ドキュメント、公開価格ページ、開発者向けSDKリポジトリで検証しました。独立したベンチマーク(olmOCR benchmark、OmniDocBench、IDP Leaderboard)が存在する場合は、Stack OverflowやRedditコミュニティの開発者による実地レポートと照合しました。
1. 精度 — 印刷テキスト、手書き文字、表、フォーム
クリーンな文書の印刷テキストでは、主要なクラウドAPIはすべて通常条件下で97〜99%の精度を実現します。差が出るのは、手書き文字、低品質スキャン、複雑な表、多言語文書です。これらのエッジケースについて各APIの公称精度範囲を評価し、実世界のパフォーマンスに関するコミュニティの検証結果を考慮しました。
2. 価格 — 1ページあたり、1,000ページあたり、隠れたコスト
OCR APIの価格は一見シンプルに見えます。ほとんどのプロバイダーは1,000ページあたり$1.50という基本料金を提示しています。実際のコストは、使用するAPIエンドポイント(基本テキスト、フォーム分析、カスタムクエリ)と、最初の価格帯内に収まるかどうかによって決まります。月間1,000ページ、10,000ページ、100,000ページの3つのボリュームレベルで総コストを計算しました。
3. SDKと言語サポート
優れたSDKがあるかどうかで、1日で統合が完了するか、1週間かかるかが決まります。バックエンドとデータ処理のユースケースの大半をカバーする7言語(Python、Node.js、Java、Go、.NET、Ruby、PHP)について、公式SDKの有無を確認しました。
4. 出力形式の品質
生のテキストは最低限の要件です。差別化要因は、APIが単語または行ごとのバウンディングボックス座標を返すか、階層的なテーブル構造を保持するか、フォームからキーと値のペアを抽出するか、信頼スコアを出力するかです。各APIのJSONレスポンスの豊富さを評価しました。
5. レイテンシとスループット
インタラクティブなアプリケーションには、2秒未満の同期レスポンスが不可欠です。バックグラウンド処理パイプラインでは、バッチスループット(スケール時の1分あたりのページ数)が重要です。各APIのドキュメントに記載されたレイテンシ特性を確認しました。
6. クラウドエコシステムとネイティブ統合
S3、Cloud Storage、Blob Storageに直接接続し、抽出したデータをデータウェアハウスやERPに送り込めるAPIは、パイプライン構築の数週間の作業を節約できます。各APIの親クラウドプラットフォームおよびサードパーティサービスとの統合の深さを評価しました。
Google Cloud Vision API
Google Cloud Visionは、市場で最も幅広いOCR APIです。あらゆる文書タイプに対して最も正確だからではなく、単一のエンドポイントで街中の標識から密集した契約書ページまでを処理できるからです。OCRを2つの呼び出しに分割しています: シーン内テキスト(標識、ラベル、写真)用のTEXT_DETECTIONと、密集した文書ページ用のDOCUMENT_TEXT_DETECTIONで、後者はGoogleのDocument AIパイプラインを通じて最適化されています。
料金。 各機能あたり月間最初の1,000ユニットは無料です。その後、テキスト検出は5百万画像まで1,000画像あたり$1.50、それを超えると$0.60に下がります。文書テキスト検出も同じ段階に従います。Document AIを通じて、専門プロセッサ(請求書パーサー、経費パーサー)は10ページあたり$0.10で、財務文書のフォーム分析におけるTextractよりも大幅に安価です。
SDKサポート。 Python、Node.js、Java、Go、C#、PHP、Ruby — すべてファーストパーティ製で、すべてメンテナンスされています。Googleのクライアントライブラリは、クラウドOCR分野で最も成熟したものの一つです。
出力品質。 JSONレスポンスには、単語ごとのバウンディングボックス、信頼スコア、ページレベルのレイアウトブロックが含まれます。Document AIプロセッサはキーと値のペアとテーブル構造を追加しますが、テーブル再構築にはTextractのネイティブなテーブル出力と比較して後処理が必要です。
最適なケース すでにGoogle Cloudを利用しているチーム、1つのSDKでシーン内テキストOCRと文書OCRの両方を必要とするアプリケーション、そして将来的にVertex AIやBigQueryとの統合の恩恵を受けるプロジェクト向けです。
不向きなケース 大規模なテーブル抽出(Textractの方が安価で構造化されています)や、クラウドに依存しないワークフローが必要な場合です。
AWS Textract
Amazon Textractは、一般的な画像分析ではなく、文書理解のために特別に構築されており、その実力は明らかです。AnalyzeDocument APIは、テーブル、フォーム、クエリ、署名用に個別の機能フラグを公開しており、必要な抽出深度に対してのみ支払うことができます。テーブル機能は、セルごとの信頼度付きのネイティブな行と列の構造を返し、フォーム機能はテンプレート設定なしでキーと値のペアを抽出します。
料金。 基本のDetectDocumentTextは、1,000ページあたり$1.50(最初の100万ページ)、以降は$0.60です。テーブルは1,000ページあたり$15、フォームは1,000ページあたり$50、クエリは1,000ページあたり$15が追加されます。請求書処理の場合、AnalyzeExpense APIは1,000ページあたり$8〜$10で、財務文書専用に設計されており、一般的なフォーム分析よりも概して正確です。無料枠には、最初の3か月間、毎月1,000ページのDetectDocumentTextが含まれます。
SDKサポート。 Python、Node.js、Java、Go、.NET、PHP、Ruby — すべてファーストパーティのAWS SDKです。Textractのページネーションと非同期APIは、各言語の実用的な例を含めて十分に文書化されています。
出力品質。 Textractのテーブル出力は、構造化抽出の業界ベンチマークです。JSONレスポンスは、行スパン、列スパン、結合セル、セルごとの信頼度を保持します。フォーム抽出は、バウンディングボックスと関係性を持つキーと値のペアを返します。クエリは、文書に対する自然言語での質問をサポートします — アドホックなフィールド抽出のための独自の機能です。
最適な用途 AWSネイティブスタック、高忠実度のテーブルまたはフォーム抽出を必要とするあらゆるプロジェクト、およびOCRをLambda、S3イベントトリガー、またはStep Functionsと組み合わせて文書処理パイプラインを構築したいチーム。
不向きな用途 一般的なシーンテキストOCR(Vision APIの方が優れています)、または機能ベースの料金階層なしで予測可能なコストを望むチーム。
Azure Document Intelligence
Azure Document Intelligence(旧Azure Form Recognizer)は、Microsoftエコシステム(Logic Apps、Power Automate、Power BI、SharePoint)との最も緊密な統合を提供します。プリビルトモデルは、請求書、領収書、身分証明書、健康保険証、W-2フォーム、1098税務フォーム、契約書をカバーしています。Layoutモデルは、構造を保持したまま表とテキストを抽出します。
料金。 Readモデル(基本OCR+レイアウト)は1,000ページあたり$1.50で、月500ページが無料です。プリビルト文書分析は約1,000ページあたり$10です。カスタム抽出は、トレーニングと推論で1,000ページあたり$30から始まります。無料枠の月500ページはGoogleの1,000ページより少ないですが、プロトタイピングには十分です。
SDKサポート。 Python、Node.js、Java、.NET(C#)、Go — 強力なファーストパーティサポート。.NET SDKは特にメンテナンスが行き届いており、Azureのエンタープライズ向け.NET顧客基盤を反映しています。
出力品質。 Layoutモデルは、表、選択マーク(チェックボックス)、段落構造を、バウンディングボックスと信頼度スコア付きで返します。プリビルトモデルは、文書固有のフィールド抽出(例:請求書の明細項目、領収書の店名)を追加します。JSON出力は構造化されていますが、複雑な表シナリオではTextractほどセル単位の粒度は細かくありません。
最適な用途 既にMicrosoft 365またはAzureを利用している組織、Power Automateワークフローが必要なシナリオ、プリビルトのコンプライアンス文書(SOC 2、HIPAA、GDPR)を重視するチーム。
不向きな用途 OCR.spaceやTesseractの方が安価な大量の基本OCR、またはGoogleやAWSのSDK成熟度を好むチーム。
Tesseract(セルフホスト型オープンソース)
Tesseractは、元々HPが開発し現在はGoogleがメンテナンスしており、OCRパイプラインを完全に制御したい開発者にとって今もデフォルトの出発点です。100以上の言語をサポートし、任意のプラットフォームで動作し、コンピューティング以外のコストはかかりません。しかし「無料」は「安い」と同じではありません — Tesseractを本番運用するためのエンジニアリング時間は、数週間以内にクラウドAPIサブスクリプションのコストを超える可能性があります。
料金。 無料。唯一のコストはインフラストラクチャです:控えめなVMまたはコンテナ。大量処理(月100万ページ以上)の場合、CPUインスタンス上のセルフホスト型Tesseractは、文書の複雑さにもよりますが、通常月10万〜13万ページでクラウドAPIと損益分岐点に達します。
SDKサポート。 Python(pytesseract)、C++(ネイティブ)、Java(Tess4J)、Node.js(tesseract.js)。Pythonラッパーが最も広く使用されており、コミュニティのドキュメントとStack Overflowの情報が豊富です。ただし、SDKの成熟度は大きく異なります — tesseract.jsはブラウザ内で完全に動作しますが、ネイティブビルドより遅いです。
出力品質。 解像度が良く背景が均一なきれいな印刷文書では、Tesseractは単語レベルの精度95〜99%を達成します。低品質のスキャン、傾いたページ、装飾的なフォントの文書では、精度が急激に低下します。表構造のネイティブサポートは最小限で、出力は空白で位置決めされたフラットテキストです。手書き認識は、追加のモデルトレーニングなしでは信頼できません。hocrおよびALTO出力形式はバウンディングボックスを提供しますが、フィールドの意味的理解はありません。
最適な用途 データ主権(データがサーバーから出ないこと)を必要とするチーム、インフラコストがAPIのページ単価よりも低い大量処理、前処理パイプライン(傾き補正、二値化、ページ分割)の調整に慣れた開発者向け。
不向きな用途 数週間ではなく数日で本番レベルの抽出を必要とするチーム、複雑なレイアウトや手書き文字を含むドキュメント、メンテナンス負担を最小限に抑えたいあらゆるシナリオ。
Tesseractと最新の抽出アプローチの詳細な比較については、OCRとAI抽出の比較に関する記事をご覧ください。
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDKは30年以上にわたりOCRビジネスに携わっており、そのCloud OCR SDKには成熟した技術が反映されています。200以上の認識言語(手書き言語126言語を含む)に対応し、ドキュメントレイアウトを高い忠実度で保持し、ゾーン指定抽出と全ページOCRの両方を処理します。ABBYYの強みは、入力品質がばらつく状況でも一貫した結果を出すことです。Tesseractがわずかに傾いたスキャンで苦戦する場合でも、ABBYYの前処理エンジンが補正します。
価格。 Cloud OCR SDKは月額$99(5,000ページ分)から始まります。エンタープライズ向け(年間100万ページ以上)では、通常、年間契約で1ページあたり$0.02〜$0.10のレートを交渉し、初期費用は約$15,000からです。完全無料のティアはなく、トライアルのみです。小規模チームにとって、ABBYYはクラウドハイパースケーラーAPIよりも大幅に高価です。
SDKサポート。 Python、Java、.NET(C#)、C++に対応しており、堅牢ですがクラウド3社よりは狭い範囲です。REST APIは完全にドキュメント化されており、対応するすべての言語でコードサンプルが利用可能です。
出力品質。 ABBYYのレイアウト保持は業界最高水準で、列、表、ヘッダー、フッターを含む元のドキュメント構造を再構築します。XML出力(FineReaderエンジン経由)は、下流のドキュメント処理に利用できる最もリッチな形式です。126言語の手書き文字認識は、ごく一部のAPIだけが実現できる差別化要因です。
最適な用途 レイアウト忠実度が重要なエンタープライズドキュメントデジタル化プロジェクト、オンプレミス展開オプションを必要とする規制産業(金融、医療、政府)、印刷物と手書きの両方にわたる多言語OCRを大規模に行う場合。
不向きな用途 予算が限られたスタートアップや小規模チーム、迅速なプロトタイピング、1ページあたりのコストを$0.01未満に抑える必要があるプロジェクト。
Mindee
Mindeeは、現在利用可能なOCR APIの中でも、開発者にとって最も使いやすいものの一つです。ドキュメントは明確で、APIレスポンスは一貫性があり、事前学習済みモデル(請求書、領収書、パスポート、運転免許証、履歴書など)はトレーニング不要ですぐに使えます。Mindeeは意図的な設計選択をしています。汎用のOCRエンドポイントを提供して抽出ロジックをユーザーに任せるのではなく、データモデルに直接マッピングできるフィールドレベルのJSONを返すのです。
料金。Developerプランは月250ページまで無料(クレジットカード不要)。有料プランは年払いで月500ページ、€44/月(約$47)から始まり、追加ページは1ページあたり€0.05です。Proプラン(€179/月)には2,500ページが含まれ、追加ページは1ページあたり€0.04です。エンタープライズ価格は、大量利用の場合1ページあたり€0.01程度まで下がります。これはOCR API分野で最も透明性の高い料金体系の一つです。隠れた階層や予期しない機能コストはありません。
SDKサポート。Python、Node.js、Java、Go、Ruby、PHP、.NET — 主要クラウド3社以外では最も幅広いSDKカバレッジです。すべてのSDKはOpenAPI仕様から自動生成されるため、APIとの整合性が保たれます。Redditのr/programmingやr/MachineLearningでは、MindeeのPython SDKは迅速なプロトタイピングに最も直感的だと頻繁に評価されています。
出力品質。Mindeeのフィールドレベル抽出は、フィールドごとの信頼スコア付きの構造化JSONを返します。請求書の場合、説明、数量、単価、合計を含む明細項目の配列が返されます。自分で解析する必要のある生テキストではありません。トレードオフとして、Mindeeは任意のドキュメントではなく特定のドキュメントタイプに最適化されています。カスタムフィールドを持つ汎用フォームの場合は、カスタムモデルのトレーニングが必要です。
最適な用途は、すぐに使えるフィールドレベルJSON(正規表現による後処理不要)を求める開発者、ドキュメント品質とSDKの成熟度を重視するチーム、標準的なドキュメントタイプ(請求書、領収書、ID、パスポート、履歴書)を処理するプロジェクトです。
不向きな用途は、事前定義モデルのない任意のドキュメントレイアウト、シーンテキストOCR(街の標識、ホワイトボード)、またはオンプレミス展開が必須のユースケースです。
Nanonets
Nanonetsは、OCR APIとAIワークフロープラットフォームの中間に位置づけられます。その中核となる差別化要因はカスタムモデルのトレーニングです。サンプル文書をアップロードすると、抽出ルールを書かなくても、Nanonetsがあなたの関心のあるフィールドを学習して抽出します。標準的でない文書を処理するチームにとって、このトレーニングベースのアプローチは、一般的な事前トレーニング済みモデルよりも高い精度を達成することがよくあります。
料金。Nanonetsは月額499ドルからで、最大10,000ページまで対応します。これはクラウドAPIの料金からすると大幅な跳ね上がりです。追加の抽出は1ページあたり約0.30ドルで、その他にフォーマット処理、ルックアップ、プレミアム統合のための別途料金がかかります。G2やRedditの開発者レビューでは、ボリュームが増えるにつれてコストの予測不能性が懸念点として頻繁に挙げられています。無料枠はクレジットカード登録で500ページまで利用できます。
SDKサポート。Python、Node.js、Java、Go — この4つでほとんどのユースケースをカバーできます。Python SDKが最も機能が充実しており、バッチ処理、カスタムモデルのトレーニング、ワークフロー自動化の例が用意されています。
出力品質。トレーニングセットに一致する文書については、Nanonetsは高いフィールドレベルの精度を達成します。最近のNanonets OCR-3モデル(2026年4月リリース)は、olmOCRベンチマークで93.1、OmniDocBenchで90.5を記録し、商用OCRモデルのトップ層に位置しています。JSON出力にはフィールドごとの信頼度とバウンディングボックスが含まれます。
最適な用途は、標準的でない文書からカスタムフィールドを抽出する必要があるチーム、組み込みのワークフローエンジン(承認、検証、Slack通知)を活用できる組織、そしてOCRとワークフローを1つのプラットフォームで実現したい中堅企業です。
不向きな用途は、予算が限られているチーム(料金が急速に高騰します)、TesseractやOCR.spaceで十分な単純なテキスト抽出、またはクラウドプロバイダー固有の統合が必要なプロジェクトです。
Veryfi
Veryfiは、領収書、請求書、銀行明細書、小切手、W-2フォームなどの財務文書のOCRに特化しています。生のテキストを返し、フィールドの識別をあなたに任せる一般的なOCR APIとは異なり、Veryfiは会計士がそのまま使えるJSONを返します。店舗名、日付、合計金額、税額、明細項目、支払い方法、カテゴリなどです。この特化により、スキャンした領収書から簿記の仕訳までの最速の経路を実現します。
料金。 Veryfiは、合計100ドキュメント(月間ではなく)の無料枠を提供しています。スタータープランは月額最低$500のコミットメントが必要で、これにより、1領収書あたり$0.08、1請求書あたり$0.16で、約5,000枚の領収書または3,125枚の請求書を処理できます。この料金体系は大量処理には適していますが、小規模プロジェクトにとっては参入障壁が高くなります。GrowthプランとEnterpriseプランはカスタム見積もりです。
SDKサポート。 Python、Node.js、Java、Go、C#、PHP — バックエンド言語を幅広くカバーしています。SDKには、URLからのファイルアップロード、ローカルファイル、base64エンコードされた画像のサポートが組み込まれています。Veryfiは、iOSおよびAndroid向けのドキュメントキャプチャ用モバイルSDKも提供しています。
出力品質。 Veryfiの金融文書抽出は、そのニッチ分野で最も正確なものの一つです。マルチモーダルLLM API(AnyDocs)は、同じアプローチを任意のドキュメントタイプに拡張します。レスポンスには、38以上の言語、91以上の通貨、カテゴリ、正規化された明細項目が含まれます。Redditのr/bookkeepingとr/accountingでは、Veryfiは領収書中心のワークフローで頼りになるAPIとして頻繁に言及されています。
最適な用途 経費管理アプリケーション、領収書や請求書を大規模に処理するフィンテック製品、自動データ取り込みパイプラインを構築する会計事務所。
不向きな用途 一般的なOCRニーズ(単純なテキスト抽出には過剰)、小規模な評価(プロトタイピングには$500の最低額は正当化しにくい)、金融以外のドキュメントタイプ。
OCR.space
OCR.spaceは、大量処理・予算重視のプロジェクトに最適な無料OCR APIです。無料枠(月25,000リクエスト、クレジットカード不要)は、他の商用APIにはない魅力です。クラウド大手3社と比べると精度や機能は劣りますが、90〜95%の精度で十分なクリーンな印刷文書であれば、コスト面でOCR.spaceに勝るものはありません。
料金。無料枠は月25,000リクエスト(1日500件の制限)、ファイルサイズ1MBまでです。PROプランは月額$29.99で30万リクエスト、ファイルサイズ5MB、処理速度も向上します。PRO PDFプラン(月額$59.99)では、マルチページPDF(最大999ページ)に対応します。エンタープライズプランは専用サーバーで月額$999からです。クラウドAPIが1,000ページあたり$1.50であるのに対し、OCR.spaceの無料枠は低容量プロジェクトには事実上無制限です。
SDKサポート。 OCR.spaceは言語別のSDKを提供しておらず、REST APIでの通信になります。ただし、Python、JavaScript、PHP、Java用のコミュニティ保守のラッパーが存在します。APIは単語ごとのバウンディングボックスと信頼度スコアを含むJSONを返します。
出力品質。 クリーンでコントラストの高い印刷テキストでは、OCR.spaceは約90〜95%の文字精度を達成します。検索可能なPDFや単純なフォームからのデータ抽出に十分です。小さなフォント、特殊なレイアウト、手書き文字、低解像度の画像では精度が低下します。ネイティブのテーブル抽出機能はなく、テーブルデータは位置座標付きのテキストとして返されますが、行・列の構造はありません。
最適な用途は、予算が最優先されるプロトタイピングやMVP、クリーンな印刷文書を処理する内部ツール、有料プロバイダーに契約する前にOCR統合パターンをテストするためのコミットメント不要のAPIを必要とする開発者です。
不向きな用途は、99%以上の精度を必要とする本番システム、複雑なレイアウト(テーブル、フォーム)、手書き文字認識、文書ごとの精度がビジネス成果に直接影響するシナリオです。
Base64.ai
Base64.aiは、あまり知られていないものの技術的に優れたOCR APIで、「あらゆる文書に対応する単一API」を謳っています。医療記録や保険書類からパスポート、契約書、請求書まで100以上の文書タイプに対応し、各タイプに特化した深層学習モデルを採用しています。その名声は、回転ページ、折り畳まれた文書、手書き注釈、混在レイアウトページといったエッジケースを処理できる点にあります。
価格。Base64.aiは文書タイプとボリュームに基づくカスタムのページ単位価格を採用しており、公開された標準プランはありません。利用を検討しているユーザーは見積もりのために営業に連絡する必要があり、パイロットなしではコスト評価が難しいのが実情です。価格帯はエンタープライズクラスのAPI(ABBYY層)とクラウドハイパースケーラーの中間と想定されます。
SDKサポート。REST APIと、PythonおよびJavaScript用のコミュニティラッパーを提供。コア統合はJSONペイロードを使用した直接HTTPリクエストによるものです。Base64.aiはワークフロー自動化のためZapierやSlackとも連携します。
出力品質。Base64.aiの抽出品質は、対応する文書タイプ全体で強力であり、特にID文書、財務フォーム、医療記録で優れています。JSONレスポンスには、フィールドごとの信頼度、バウンディングボックス、文書分類ラベルが含まれます。フォーム上の手書き文字については、TesseractやOCR.spaceより優れていますが、ABBYYの専用手書き文字認識には及びません。
最適な用途単一の統合で多様な文書タイプを処理する文書集約型業界(保険、医療、法務)、セットアップ専任のアカウントマネージャーを必要とするチーム、文書分類と抽出を1つのAPIで行うことでアーキテクチャの複雑さを軽減するシナリオ。
不向きな用途予算重視のチーム(セルフサービス価格なし)、営業との会話なしでの迅速なプロトタイピング、クラウドプロバイダー固有のインフラストラクチャを必要とするプロジェクト。
その他の注目API:知っておく価値のあるサービス
上記で紹介した10のAPI以外にも、特定のユースケースで言及に値するサービスがいくつかあります。
LlamaParseは、RAGパイプラインとドキュメントエージェント専用に構築されています。セマンティック構造を保持し、マークダウンを出力するため、検索拡張生成システムを構築するAIエンジニアにとって有力な選択肢です。料金は無料枠(1日1,000ページ)から始まり、その後は1ページあたり$0.003です。
Clarifaiは、ドキュメント理解モデルを通じてOCR機能を備えたフルスタックAIプラットフォームを提供しています。従量課金制プラン(デフォルトで月額最大$100)とデベロッパープラン(初年度月額$1)は、同じプラットフォームで画像認識とモデルトレーニングも必要なチームにとって、最も手頃な選択肢の一つです。
Rossumは、大規模な請求書処理に最適化されたエンタープライズIDPプラットフォームです。料金は年間$18,000からで、ABBYYと並んで明確にエンタープライズ層に位置付けられます。Rossumの強みは、AI搭載の検証エンジンとERP統合(SAP、Coupa、Workday)ですが、ほとんどの開発者のユースケースでは、初期費用が高すぎます。
これらのプラットフォームが主要な比較に含まれなかったのは、そのターゲット層(RAGパイプライン構築者、フルスタックAIプラットフォーム利用者、エンタープライズAPチーム)が、このガイドの開発者向け汎用OCRの範囲よりも狭いためです。
あなたのユースケースに最適なAPIは?
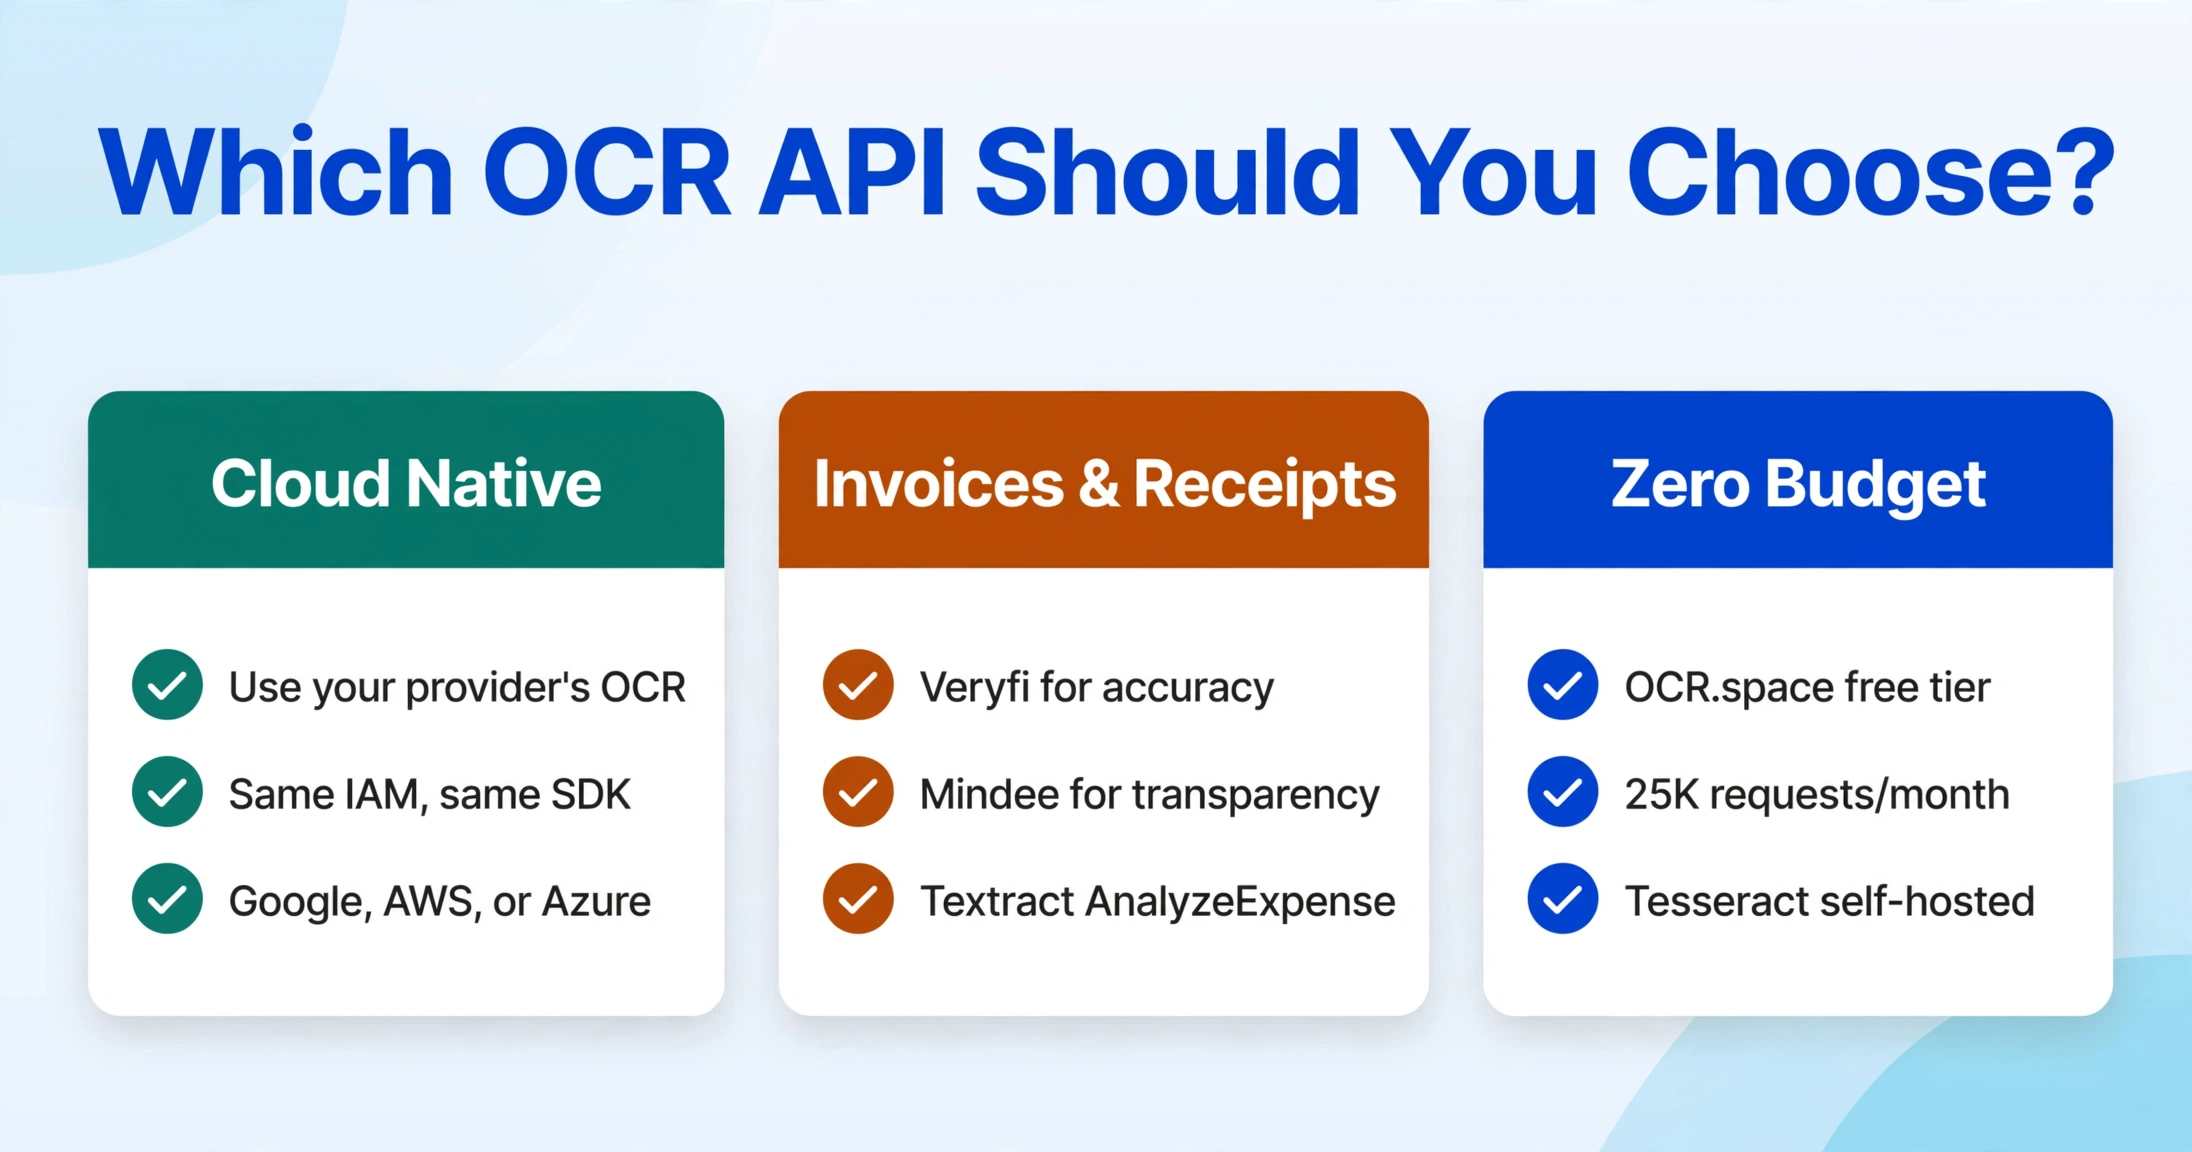
答えは、ドキュメントの種類、予算、スケジュール、エコシステムによって異なります。単一の「最高のOCR API」は存在しません。正しい選択とは、特定のシナリオにおける統合、運用、保守の総コストを最小化するものです。ここでは、6つの一般的な状況と、それぞれに最適なAPIを紹介します:
汎用OCR機能を構築中で、すでにGoogle Cloud、AWS、Azureを利用している場合
クラウドプロバイダーのOCR APIを使用してください。統合コストの削減(同じIAM、同じSDK、同じネットワーク)だけで、精度のエッジケースを上回るメリットがあります。シーン文字とドキュメントOCRにはGoogle Cloud Vision、フォームとテーブルが必要ならAWS Textract、Microsoftスタックを利用しているならAzure Document Intelligenceが適しています。
請求書と領収書を大規模に処理する場合
Veryfiはこの用途に特化しており、財務ドキュメントの精度が最も高いです。Mindeeは、価格の透明性が高く、月額500ドルの下限がない、有力な第2の選択肢です。すでにAWSを利用している場合は、AWS TextractのAnalyzeExpense API(1Kページあたり8〜10ドル)も有力な代替手段です。
忠実度の高いテーブルとフォームの抽出が必要な場合
AWS TextractのTables機能は、JSONでのネイティブなテーブル構造のゴールドスタンダードであり続けています。Azure Document IntelligenceのLayoutモデルはそれに続き、チェックボックスと選択マークの抽出に優れています。エンタープライズのコンプライアンスとレイアウト保存のためには、ABBYYのSDKが最も実績のあるオプションです。
予算がほぼゼロで、ドキュメントがクリーンな印刷ページの場合
OCR.spaceの無料枠(月25,000リクエスト)が最適なオプションです。より高い精度が必要で、エンジニアリングの時間を投資できるなら、適切な前処理を施したTesseractは、セットアップの手間はかかりますが、OCR.spaceよりも精度で勝ります。セルフホスト型とクラウドOCRの経済性の比較については、オープンソースOCRツールガイドをご覧ください。
標準的でないドキュメントからカスタムフィールドを抽出する必要がある場合
Nanonetsは、最もアクセスしやすいカスタムモデルトレーニングパイプラインを提供しています。サンプルをアップロードし、フィールドを定義して、コーディングなしでトレーニングできます。Mindeeのカスタムモデルも同様のワークフローで、より低い導入価格です。Google Document AIのCustom ExtractorとAzureのCustom Extractionも機能しますが、よりクラウドプラットフォームへの習熟が必要です。
統合コードを一切書かずにドキュメント抽出を行いたい場合
チームにAPI統合、認証、エラーハンドリング、結果解析を管理する余裕がない場合、ImageToTable.aiのようなノーコードツールが、WebインターフェースやGoogle Sheetsアドオンを通じて同じ抽出機能を提供します — APIキーもSDKもデプロイパイプラインも不要です。ファイルやPDFをアップロードし、列を定義するだけで、数秒で構造化データが得られます。トレードオフはスループットです。APIは自動化スケールで優れていますが、アドホックなドキュメントセットや専任のエンジニアリングリソースがないチームには、ノーコードアプローチの方が迅速に価値を実現できます。このアプローチが従来のOCRとどう違うかを理解するには、AI OCRとは?をお読みください。
よくある質問
本番アプリケーションを構築する開発者に最適なOCR APIはどれですか?
Mindeeは、開発者体験、ドキュメントの品質、SDKカバレッジ(7言語)、そして月間10,000ページ未満の本番ワークロードに対する透明な価格設定のバランスに優れています。AWSネイティブなスタックにはTextractが論理的な選択肢です。Google CloudネイティブなスタックにはCloud VisionとDocument AIが適しています。「最適な」APIは、生のOCR精度よりも既存のインフラに依存します。主要なクラウドAPIはすべて、クリーンなドキュメントで97%以上の精度を提供するためです。
大量処理に最適な最も安いOCR APIは何ですか?
セルフホストの場合、Tesseractは無料ですが、本番化にはエンジニアリングの時間が必要です。スケールしたマネージドAPIには、AWS TextractのDetectDocumentTextが$1.50/1Kページ(100万ページを超えると$0.60/1K)で、ページあたりのコストが最も安い部類です。OCR.spaceのPROプランは、月額$29.99で30万リクエストが可能で、低中ボリュームで最もコストパフォーマンスに優れています。非常に高ボリューム(月間100万ページ以上)の場合、主要プロバイダーとカスタムレートを交渉するのが通常、ページあたりのコストを最も抑える方法です。
OCR APIは手書き文字を処理できますか?
はい、ただし品質は大きく異なります。ABBYY Cloud OCR SDKは最も成熟した手書き文字認識機能を持ち、ゾーンベースのICRモードで126の手書き言語をサポートしています。Google Cloud Visionの手書きサポートは、活字体の手書きをかなりうまく処理します。筆記体や混在した手書きドキュメントの場合、新しいビジョン言語モデルアプローチ(Gemini、GPT-5、クラウドAPI経由でアクセスするMistral OCR 3)が従来のOCRエンジンを上回ることがよくありますが、ページあたりのコストは高くなります。より詳しい比較は、手書きOCRガイドをご覧ください。
OCR APIはテーブル構造を保持しますか?
AWS Textractは、セル信頼度スコア付きのネイティブな行と列のテーブルJSONを返します。これは、利用可能な中で最も開発者向けのテーブル出力です。Azure Document IntelligenceのLayoutモデルも、バウンディングボックス付きでテーブル構造を保持します。Google Cloud VisionのDocument AIはテーブルブロックを返しますが、信頼性の高い構造再構築には追加の後処理が必要です。TesseractとOCR.spaceは位置データ付きのテキストを返しますが、テーブル構造の推論は行いません。
最も多くのプログラミング言語をサポートしているOCR APIはどれですか?
Google Cloud Vision、AWS Textract、Mindeeはすべて、Python、Node.js、Java、Go、および少なくとも3つの追加言語向けのファーストパーティSDKを提供しています。Azure Document Intelligenceの.NET SDKは特に強力です。ロングテール言語(PHP、Ruby)のサポートについては、GoogleとAWSが全SDKにわたって最も広いカバレッジを持っています。
2026年に利用可能な無料OCR APIティアは何ですか?
OCR.spaceは月25,000リクエストという最も寛大な無料ティアを提供しています。Google Cloud Visionは月1,000ユニット無料です。AWS Textractは最初の3か月間、月1,000ページを提供します。Azure Document Intelligenceは月500ページを提供します。MindeeのDeveloperプランには、クレジットカード不要で月250ページの無料利用が含まれています。Veryfiには100ドキュメントの無料利用(繰り返しなし)が含まれています。Tesseractは無料ですが、セルフホスト型です。
同期処理と非同期処理をサポートしているAPIはどれですか?
Google Cloud Vision、AWS Textract、Azure Document Intelligenceはすべて、同期(単一ページ、サブ秒レイテンシ)と非同期(マルチページバッチ)の両モードをサポートしています。Mindee、Veryfi、Nanonetsはデフォルトで同期処理を使用し、バッチワークロード向けに非同期オプションを提供しています。OCR.spaceは同期のみです。インタラクティブなアプリケーションでは、選択するAPIが2秒未満の同期レスポンスを提供することを確認してください。
OCR APIをオンプレミスまたはプライベートクラウドで実行できますか?
Tesseractやその他のオープンソースエンジン(PaddleOCR、EasyOCR)はどこでも実行できます。ABBYYはFlexiCaptureプラットフォームのオンプレミス展開を提供しています。AWS Textract、Google Cloud Vision、Azure Document Intelligenceはクラウド専用ですが、Azureは一部のDocument Intelligence機能に対して接続されたコンテナ展開を提供しています。機密データ(PII、PHI)については、ローカル前処理を伴うTesseractと、その後のクラウドAPI呼び出し(データマスキング付き)を組み合わせたハイブリッドパターンが一般的です。
OCR APIをまったく統合したくない場合はどうすればよいですか?
OCR APIは、スケールでのプログラムによるアクセスが必要な場合に適した選択肢です。しかし、ドキュメントを時折処理するだけの場合、またはチームにAPI統合のためのエンジニアリングリソースがない場合は、ノーコード抽出ツールが構造化データへのより速い道を提供します。ImageToTable.aiを使用すると、ドキュメントをアップロードし、列に名前を付け、コードを書かずに構造化テーブル出力を得ることができます。Google Sheetsアドオンはこれをさらに進めます:スプレッドシートから直接アップロードし、アクティブなシートにデータを追加できます — APIキー、SDK、管理するサーバーは不要です。これはOCR APIとは異なるトレードオフ(自動化は少ないが、セットアップはゼロ)ですが、適切なユースケースでは、より速い答えです。
最も多くの言語をサポートしているOCR APIはどれですか?
ABBYY Cloud OCR SDKは、200以上の活字言語と126の手書き言語をサポートしており、トップクラスです。Google Cloud VisionはDocument AIパイプラインを通じて200以上の言語をサポートしています。Tesseractは100以上の言語をサポートしており、ほとんどの文字体系に対応する言語パックが用意されています。Azure Document IntelligenceとAWS Textractはそれぞれ約100以上の言語をサポートしています。東アジア言語(中国語、日本語、韓国語)の場合、Google Cloud VisionとABBYYが一般的に最も高い精度を提供します。ヨーロッパ言語の場合、主要なクラウドAPIはすべて同様のパフォーマンスを発揮します。
OCR APIの精度を比較する独立したベンチマークはありますか?
OCRモデルの精度を追跡する独立したベンチマークがいくつかあります。Allen Institute for AIによるolmOCRベンチマークは、文書理解と構造保持を評価します。OmniDocBenchはマルチフォーマットの文書抽出品質をカバーしています。IDPリーダーボードは、請求書、領収書、身分証明書の種類にわたる抽出精度を追跡しています。2026年初頭の時点で、Nanonets OCR-3はolmOCRで93.1を獲得し、GPT-5.2とGemini 3 Proは、総合精度とフォーム理解の点でVLMベースのアプローチをリードしています。これらのベンチマークは頻繁に更新されるため、最新のランキングはソースを確認してください。