최고의 OCR API
2026: 정확도와 가격으로 비교한 개발자용 API 10선
이 비교는 인쇄 및 필기 텍스트 정확도, 여러 볼륨 구간의 페이지당 가격, SDK 언어 지원, 출력 형식 품질, 지연 시간 프로필, 클라우드 생태계 통합 등 6가지 기준으로 10개의 OCR API를 평가하여 다음 프로젝트를 위한 현명한 결정을 내리는 데 도움을 드립니다. 각 API는 공개 문서, 공식 가격 페이지, 개발자 커뮤니티 피드백을 기준으로 평가되었습니다. 공지: 이 기사에는 맥락 제공을 위해 9개의 API와 함께 노코드 도구 1개가 포함되어 있습니다. 모든 가격 데이터는 2026년 6월 기준 공식 출처에서 검증되었습니다. 타사 서비스 링크는 nofollow를 사용합니다.
핵심 요점
- 1,000페이지당 $1.50의 표면 요금 뒤에는 33배의 비용 배수가 숨어 있습니다 — Textract에서 양식 추출을 켜면 표를 하나 처리하기 전에 청구액이 1,000페이지당 $51.50로 뛰어오릅니다.
- 모든 주요 OCR API는 깨끗한 문서에서 97–99%의 정확도를 제공합니다 — 벤치마크 점수에 집착하는 것은 되살릴 수 없는 자원, 즉 팀이 SDK 통합, IAM 구성, 파이프라인 구축에 쓸 엔지니어링 주간을 낭비하는 것입니다.
- "최고의 OCR API"라는 질문은 잘못된 질문입니다 — 이미 비용을 지불하고 있는 클라우드, 팀이 잘 아는 SDK, 실제로 받는 문서 유형부터 시작한 다음 통합 마찰을 최소화하는 API를 선택하세요.
빠른 비교: 10가지 OCR API 한눈에 보기
아래 표는 각 API의 핵심 강점, 시작 가격, 문서 유형 특화 분야, 그리고 자연스럽게 통합되는 에코시스템을 요약합니다. 1차 필터로 활용한 후, 관심 있는 API의 전체 섹션을 자세히 살펴보세요.
| API | 최적 용도 | 시작 가격 | 문서 유형 | 클라우드 생태계 |
|---|---|---|---|---|
| Google Cloud Vision | 일반 OCR + 장면 텍스트 | 무료: 월 1K건, 이후 $1.50/1K | 모든 유형 | Google Cloud (Doc AI, Storage, BigQuery) |
| AWS Textract | 양식, 표, 정형 문서 | 무료: 월 1K건, 이후 $1.50/1K | 양식, 표, 청구서, 영수증, 신분증 | AWS (S3, Lambda, Comprehend, SQS) |
| Azure Document Intelligence | 사전 구축 모델 + Microsoft 스택 | 무료: 월 500건, 이후 $1.50/1K Read | 청구서, 영수증, 신분증, 건강보험증, 계약서 | Azure (Logic Apps, Power Automate, Purview) |
| Tesseract | 무료 자체 호스팅 OCR | 무료 | 깨끗한 인쇄 문서 | 자체 호스팅 (Linux, Windows, macOS) |
| ABBYY Cloud OCR SDK | 엔터프라이즈 고정밀 OCR | $99/월 | 모든 유형 | Azure 호스팅, 온프레미스 지원 |
| Mindee | 개발자 DX + 사전 학습 모델 | 무료: 월 250건, 이후 €44/월 | 청구서, 영수증, 신분증, 여권, 이력서 | 독립형 API |
| Nanonets | 맞춤 모델 학습 + 워크플로우 | $499/월 | 맞춤 문서 유형, 청구서, 영수증 | 독립형 + 통합 (Zapier, QuickBooks) |
| Veryfi | 영수증, 청구서, 금융 문서 | 무료: 100건, $500/월 최소 (Starter) | 영수증, 청구서, 은행 거래 내역서, 수표 | 독립형 + QuickBooks, Xero 통합 |
| OCR.space | 대량 처리용 무료 예산 OCR | 무료: 월 25K 요청, $30/월 (PRO) | 깨끗한 텍스트 문서, 다중 페이지 PDF | 독립형 API |
| Base64.ai | 모든 문서 유형, 단일 API | 맞춤 가격 | 100개 이상 문서 유형, 필기체, 표 | 독립형 API + Slack, Zapier |
API 선정 및 평가 방법
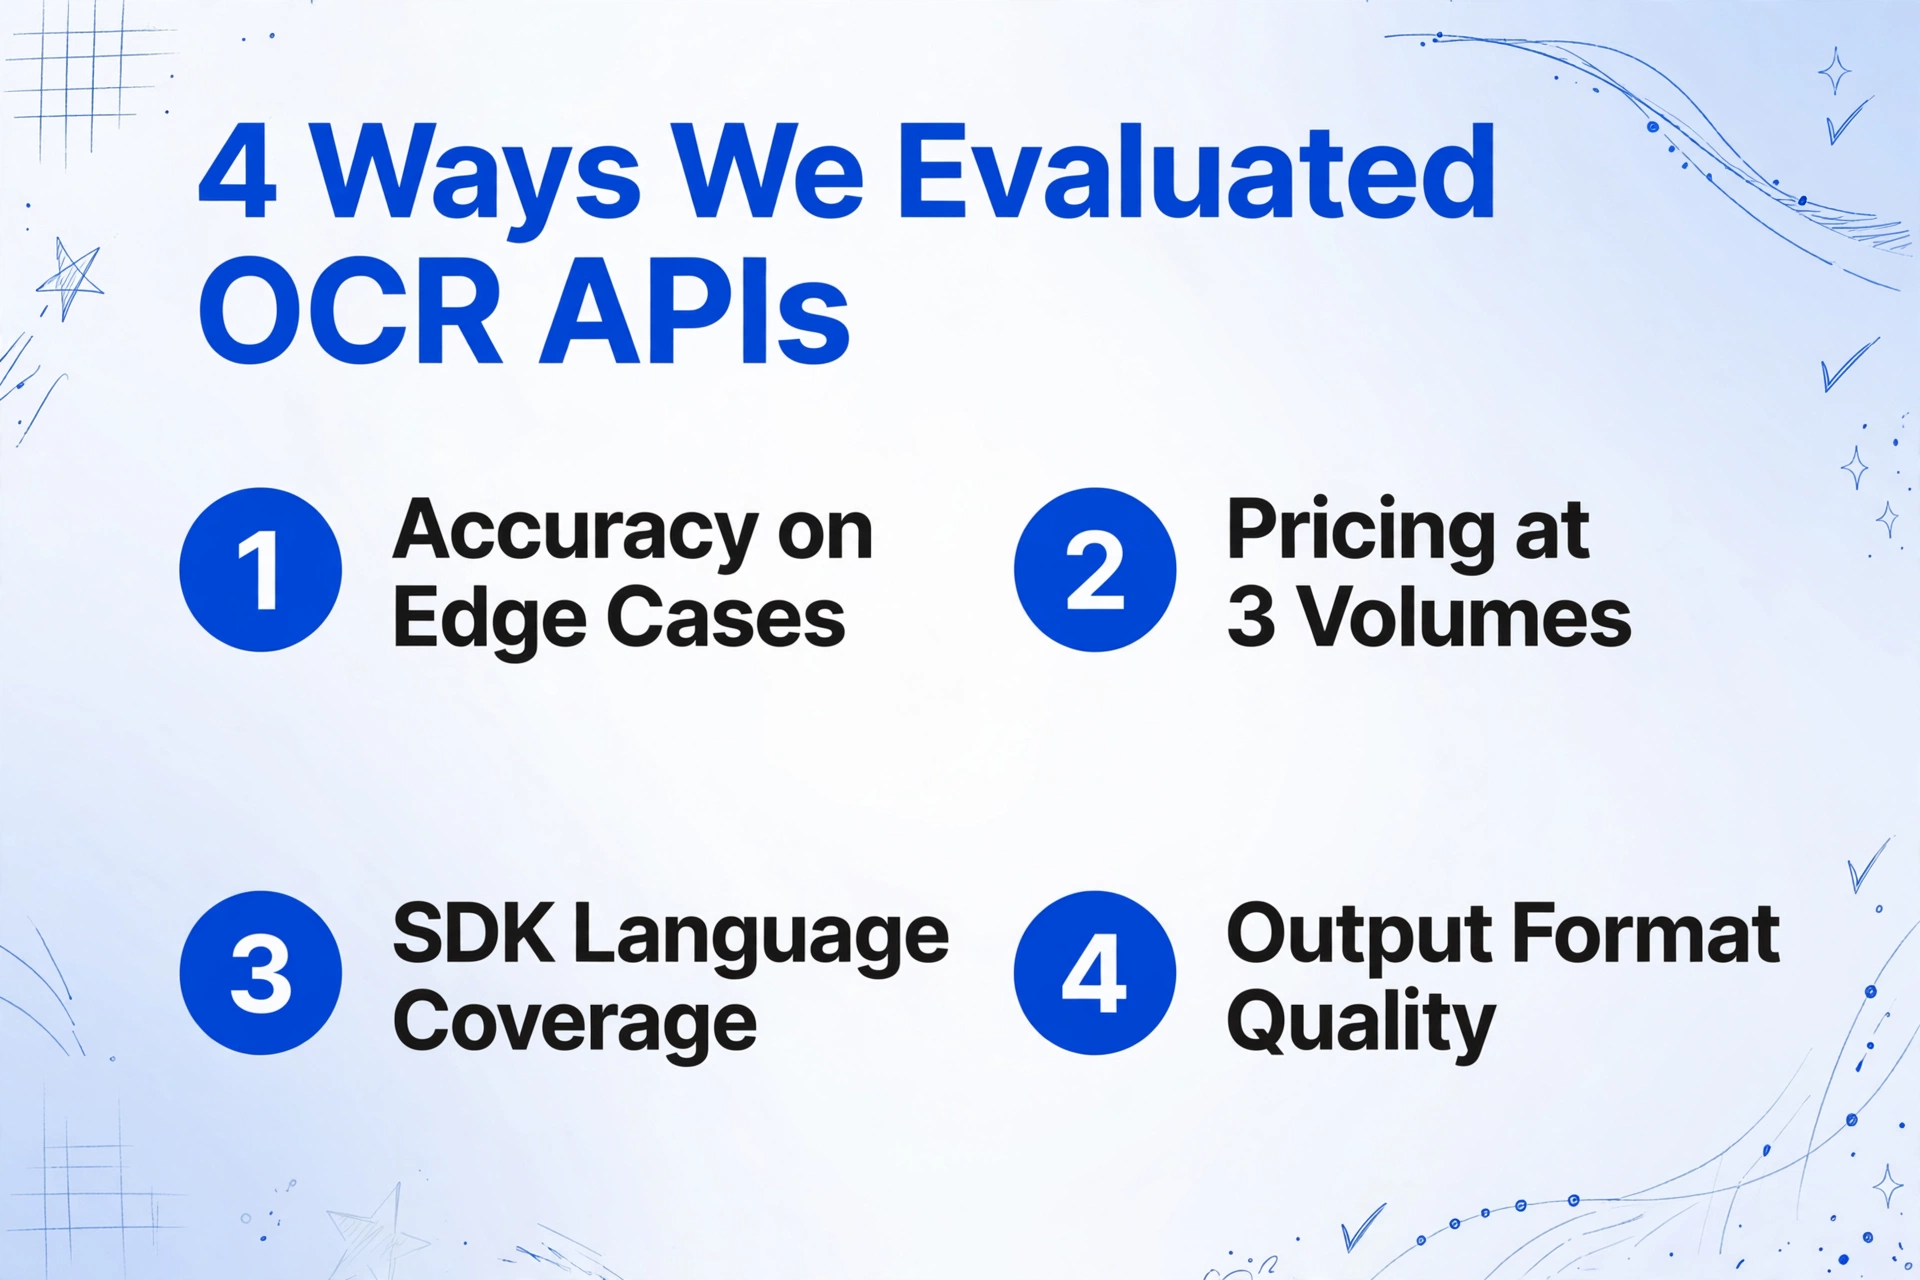
아래의 모든 평가 기준은 공식 문서, 게시된 가격 페이지, 개발자 SDK 저장소를 통해 검증되었습니다. 독립적인 벤치마크(olmOCR benchmark, OmniDocBench, IDP Leaderboard)가 존재하는 경우, Stack Overflow 및 Reddit 커뮤니티의 실무 개발자 보고서와 교차 검증했습니다.
1. 정확성 — 인쇄 텍스트, 필기, 표, 양식
깨끗한 문서의 인쇄 텍스트의 경우, 주요 클라우드 API는 일반적인 조건에서 97–99%의 정확도를 제공합니다. 차이는 필기, 저품질 스캔, 복잡한 표, 다국어 문서에서 나타납니다. 이러한 엣지 케이스에 대한 각 API의 명시된 정확도 범위를 평가하고 실제 성능에 대한 커뮤니티 검증을 검토했습니다.
2. 가격 — 페이지당, 1,000페이지당, 숨은 비용
OCR API 가격은 언뜻 보기에는 단순해 보입니다. 대부분의 공급업체는 1,000페이지당 $1.50의 대표 요금을 제시합니다. 실제 비용은 사용하는 API 엔드포인트와 첫 번째 가격 등급 내에 머무는지 여부에 따라 달라집니다. 월 1,000페이지, 10,000페이지, 100,000페이지의 세 가지 규모에서 총비용을 계산했습니다.
3. SDK 및 언어 지원
좋은 SDK는 하루 만에 통합을 끝내는 것과 일주일 동안 고생하는 것의 차이를 만듭니다. 백엔드 및 데이터 처리 사용 사례의 대부분을涵盖하는 7개 언어인 Python, Node.js, Java, Go, .NET, Ruby, PHP에 대한 공식 SDK 제공 여부를 확인했습니다.
4. 출력 형식 품질
원시 텍스트는 기본에 불과합니다. 차별화 요소는 API가 단어 또는 줄 단위로 경계 상자 좌표를 반환하는지, 계층적 테이블 구조를 보존하는지, 양식에서 키-값 쌍을 추출하는지, 신뢰 점수를 출력하는지 여부입니다. 각 API의 JSON 응답 풍부성을 기준으로 점수를 매겼습니다.
5. 지연 시간 및 처리량
대화형 애플리케이션에는 2초 미만의 동기 응답이 필수적입니다. 대규모 배치 처리량은 백그라운드 처리 파이프라인에 중요합니다. 각 API의 문서화된 지연 시간 특성을 기록했습니다.
6. 클라우드 생태계 및 기본 통합
S3, Cloud Storage 또는 Blob Storage에 직접 연결하고 추출된 데이터를 데이터 웨어하우스나 ERP에 공급하는 API는 파이프라인 엔지니어링 수 주를 절약해 줍니다. 각 API의 상위 클라우드 플랫폼 및 타사 서비스와의 통합 깊이를 평가했습니다.
Google Cloud Vision API
Google Cloud Vision은 시장에서 가장 광범위한 OCR API입니다. 모든 문서 유형에 가장 정확해서가 아니라 거리 표지판부터 조밀한 계약서 페이지까지 단일 엔드포인트로 처리하기 때문입니다. OCR을 두 가지 호출로 분할합니다: 장면 텍스트용 TEXT_DETECTION과 조밀한 문서 페이지용 DOCUMENT_TEXT_DETECTION이며, 후자는 Google의 Document AI 파이프라인을 통해 최적화됩니다.
가격. 기능별 월 첫 1,000단위는 무료입니다. 이후 텍스트 감지는 이미지 1,000개당 $1.50이며 최대 500만 개까지 적용되고, 그 이상은 $0.60으로 인하됩니다. 문서 텍스트 감지도 동일한 등급을 따릅니다. Document AI를 통해 특수 프로세서는 10페이지당 $0.10이 부과됩니다. 이는 금융 문서의 양식 분석에 대한 Textract보다 현저히 저렴합니다.
SDK 지원. Python, Node.js, Java, Go, C#, PHP, Ruby — 모두 자사 제품이며 모두 유지 관리됩니다. Google의 클라이언트 라이브러리는 클라우드 OCR 분야에서 가장 성숙한 라이브러리 중 하나입니다.
출력 품질. JSON 응답에는 단어별 경계 상자, 신뢰 점수 및 페이지 수준 레이아웃 블록이 포함됩니다. Document AI 프로세서는 키-값 쌍과 테이블 구조를 추가하지만, 테이블 재구성은 Textract의 기본 테이블 출력에 비해 후처리가 필요합니다.
적합한 경우 이미 Google Cloud를 사용하는 팀, 하나의 SDK로 장면 텍스트 OCR과 문서 OCR이 모두 필요한 애플리케이션, 향후 Vertex AI 또는 BigQuery 통합의 이점을 활용할 프로젝트에 적합합니다.
부적합한 경우 대규모 테이블 추출 또는 클라우드에 구애받지 않아야 하는 워크플로우에는 적합하지 않습니다.
AWS Textract
Amazon Textract는 일반 이미지 분석이 아닌 문서 이해를 위해 특별히 구축되었으며, 그 성능이 확실히 드러납니다. AnalyzeDocument API는 Tables, Forms, Queries, Signatures에 대한 별도의 기능 플래그를 제공하여 필요한 추출 수준에 대해서만 비용을 지불할 수 있습니다. Tables 기능은 셀별 신뢰도와 함께 기본 행·열 구조를 반환하고, Forms 기능은 템플릿 구성 없이 키-값 쌍을 추출합니다.
가격. 기본 DetectDocumentText는 페이지 1,000장당 $1.50이며 이후에는 $0.60입니다. Tables는 1,000장당 $15, Forms는 1,000장당 $50, Queries는 1,000장당 $15가 추가됩니다. 송장 처리를 위한 AnalyzeExpense API는 1,000장당 $8~10이며, 금융 문서에 특화되어 일반 Forms 분석보다 일반적으로 더 정확합니다. 무료 티어에는 최초 3개월 동안 매월 DetectDocumentText 1,000장이 포함됩니다.
SDK 지원. Python, Node.js, Java, Go, .NET, PHP, Ruby 등 모든 AWS 공식 SDK를 지원합니다. Textract의 페이지네이션 및 비동기 API는 각 언어별 작동 예제와 함께 잘 문서화되어 있습니다.
출력 품질. Textract의 테이블 출력은 구조화된 추출 분야의 업계 기준입니다. JSON 응답은 행 병합, 열 병합, 셀 병합 및 셀별 신뢰도를 보존합니다. Forms 추출은 경계 상자와 관계 정보를 포함한 키-값 쌍을 반환합니다. Queries는 문서에 대한 자연어 질문을 지원하며, 임시 필드 추출에 유용한 고유한 기능입니다.
적합한 경우 AWS 네이티브 스택, 고충실도 테이블 또는 폼 추출이 필요한 모든 프로젝트, 그리고 Lambda, S3 이벤트 트리거 또는 Step Functions와 결합하여 문서 처리 파이프라인을 구축하려는 팀에 적합합니다.
부적합한 경우 일반 장면 텍스트 OCR 또는 기능별 가격 체계 없이 예측 가능한 비용을 원하는 팀에는 적합하지 않습니다.
Azure Document Intelligence
Azure Document Intelligence는 Logic Apps, Power Automate, Power BI, SharePoint 등 Microsoft 생태계와 가장 긴밀한 통합을 제공합니다. 사전 구축 모델은 송장, 영수증, 신분증, 건강보험 카드, W-2 양식, 1098 세금 양식, 계약서를 지원합니다. Layout 모델은 구조를 보존하면서 표와 텍스트를 추출합니다.
가격. Read 모델은 1,000페이지당 $1.50이며, 월 500페이지가 무료입니다. 사전 구축 문서 분석은 1,000페이지당 약 $10입니다. 맞춤 추출은 학습 및 추론에 1,000페이지당 $30부터 시작합니다. 무료 등급의 월 500페이지는 Google의 1,000페이지보다 적지만 프로토타입 제작에는 충분합니다.
SDK 지원. Python, Node.js, Java, .NET(C#), Go — 강력한 자사 지원을 제공합니다. .NET SDK는 특히 잘 관리되며, 이는 Azure의 엔터프라이즈 .NET 고객 기반을 반영합니다.
출력 품질. Layout 모델은 테이블, 선택 표시, 문단 구조를 경계 상자 및 신뢰도 점수와 함께 반환합니다. 사전 구축 모델은 문서별 필드 추출을 추가합니다. JSON 출력은 구조가 잘 정리되어 있지만 복잡한 테이블 시나리오의 경우 Textract보다 셀 단위 세분화 수준이 낮습니다.
적합한 경우 이미 Microsoft 365 또는 Azure를 사용 중인 조직, Power Automate 워크플로가 필요한 시나리오, 사전 구축된 규정 준수 문서(SOC 2, HIPAA, GDPR)를 중시하는 팀에 적합합니다.
부적합한 경우 OCR.space 또는 Tesseract가 더 저렴한 대용량 기본 OCR, 또는 Google이나 AWS의 SDK 성숙도를 선호하는 팀에는 적합하지 않습니다.
Tesseract
Tesseract는 원래 HP가 개발하고 현재 Google이 유지 관리하며, OCR 파이프라인을 완전히 제어하려는 개발자에게 여전히 기본적인 출발점입니다. 100개 이상의 언어를 지원하고 모든 플랫폼에서 실행되며 컴퓨팅 비용 외에는 비용이 들지 않습니다. 그러나 "무료"가 "저렴"과 같은 것은 아닙니다. Tesseract를 프로덕션 환경에 적용하는 데 필요한 엔지니어링 시간은 몇 주 안에 클라우드 API 구독 비용을 초과할 수 있습니다.
가격. 무료. 유일한 비용은 인프라입니다: 적당한 VM 또는 컨테이너. 대용량 처리의 경우 CPU 인스턴스에서 자체 호스팅하는 Tesseract는 문서 복잡도에 따라 월 100,000~130,000페이지에서 일반적으로 클라우드 API와 손익분기점에 도달합니다.
SDK 지원. Python(pytesseract), C++(네이티브), Java(Tess4J), Node.js(tesseract.js). Python 래퍼가 가장 널리 사용되며 방대한 커뮤니티 문서와 Stack Overflow 자료가 있습니다. 그러나 SDK 성숙도는 크게 다릅니다. tesseract.js는 브라우저에서 완전히 실행되지만 네이티브 빌드보다 느립니다.
출력 품질. 해상도가 좋고 배경이 균일한 깨끗한 인쇄 문서에서 Tesseract는 단어 수준 정확도 95~99%를 달성합니다. 저품질 스캔, 기울어진 페이지 또는 장식용 글꼴이 있는 문서에서는 정확도가 급격히 떨어집니다. 테이블 구조에 대한 기본 지원은 최소화되어 있으며 출력은 공백으로 위치가 지정된 일반 텍스트입니다. 필기 인식은 추가 모델 학습 없이는 신뢰할 수 없습니다. hocr 및 ALTO 출력 형식은 경계 상자를 제공하지만 필드에 대한 의미론적 이해는 제공하지 않습니다.
적합한 대상 데이터 주권이 필요한 팀, 인프라 비용이 API 페이지당 수수료보다 낮은 대용량 처리 환경, 전처리 파이프라인 튜닝에 익숙한 개발자에게 적합합니다.
부적합한 대상 몇 주가 아닌 며칠 내에 실전 준비가 된 추출이 필요한 팀, 복잡한 레이아웃이나 필기체가 포함된 문서, 유지보수 부담을 최소화해야 하는 모든 시나리오에는 적합하지 않습니다.
Tesseract와 최신 추출 방식의 더 깊은 비교는 OCR vs AI 추출 문서를 참조하세요.
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDK는 30년 이상 OCR 사업을 해왔으며, Cloud OCR SDK에 그 성숙도가 반영되어 있습니다. 200개 이상의 인식 언어를 지원하고, 문서 레이아웃을 높은 충실도로 보존하며, 전체 페이지 OCR과 함께 영역 기반 추출을 처리합니다. ABBYY의 강점은 다양한 입력 품질에서의 일관성입니다. Tesseract가 약간 기울어진 스캔에서 어려움을 겪을 수 있는 반면, ABBYY의 전처리 엔진이 이를 보정합니다.
가격. Cloud OCR SDK는 월 5,000페이지 기준 월 $99부터 시작합니다. 엔터프라이즈 배포는 일반적으로 페이지당 $0.02–$0.10 범위의 요율을 협상하며, 연간 계약은 약 $15,000부터 시작합니다. 영구 무료 티어는 없으며 체험판만 제공됩니다. 소규모 팀에게 ABBYY는 클라우드 하이퍼스케일러 API보다 상당히 비쌉니다.
SDK 지원. Python, Java, .NET(C#), C++ — 견고하지만 클라우드 3사보다는 범위가 좁습니다. REST API는 완전히 문서화되어 있으며, 지원되는 모든 언어에 대한 코드 샘플이 제공됩니다.
출력 품질. ABBYY의 레이아웃 보존은 업계 최고 수준입니다. 열, 표, 머리글, 바닥글을 포함한 원본 문서 구조를 재구성합니다. FineReader 엔진을 통한 XML 출력은 다운스트림 문서 처리에 사용할 수 있는 가장 풍부한 형식입니다. 126개 언어의 필기체 인식은 소수의 API만이 제공하는 차별화 요소입니다.
적합한 대상 레이아웃 충실도가 중요한 엔터프라이즈 문서 디지털화 프로젝트, 온프레미스 배포 옵션이 필요한 규제 산업, 인쇄물과 필기체 모두에 걸친 대규모 다국어 OCR에 적합합니다.
부적합한 대상 예산이 제한된 스타트업이나 소규모 팀, 빠른 프로토타이핑, 페이지당 비용이 $0.01 미만으로 유지되어야 하는 프로젝트에는 적합하지 않습니다.
Mindee
Mindee는 현재 사용 가능한 OCR API 중 개발자 친화성이 가장 높은 서비스 중 하나입니다. 문서화가 명확하고, API 응답이 일관되며, 사전 학습된 모델이 별도의 학습 과정 없이 바로 작동합니다. Mindee는 의도적인 설계 선택을 합니다: 일반적인 OCR 엔드포인트를 제공하고 추출 로직을 사용자에게 맡기는 대신, 데이터 모델에 직접 매핑되는 필드 수준의 JSON을 반환합니다.
가격. Developer 플랜은 월 250페이지 무료입니다. 유료 플랜은 연간 청구 기준 월 €44로 500페이지를 제공하며, 추가 페이지는 각 €0.05입니다. Pro 플랜은 2,500페이지를 포함하고 추가 페이지당 €0.04입니다. Enterprise 가격은 대량 사용 시 페이지당 €0.01 수준으로 낮아집니다. 이는 OCR API 분야에서 가장 투명한 가격 구조 중 하나입니다 — 숨겨진 등급이나 예상치 못한 기능 비용이 없습니다.
SDK 지원. Python, Node.js, Java, Go, Ruby, PHP, .NET — 상위 3대 클라우드 제공업체를 제외하면 가장 광범위한 SDK 지원 범위입니다. 모든 SDK는 OpenAPI 사양에서 자동 생성되므로 API와 최신 상태를 유지합니다. Reddit의 r/programming과 r/MachineLearning에서 Mindee의 Python SDK는 빠른 프로토타이핑에 가장 직관적인 도구로 자주 언급됩니다.
출력 품질. Mindee의 필드 수준 추출은 필드별 신뢰도 점수가 포함된 구조화된 JSON을 반환합니다. 청구서의 경우 설명, 수량, 단가, 합계가 포함된 라인 항목 배열을 제공합니다 — 직접 파싱해야 하는 원시 텍스트가 아닙니다. 단점은 Mindee가 임의 문서보다 특정 문서 유형에 최적화되어 있다는 점입니다. 사용자 정의 필드가 있는 일반 양식의 경우 사용자 정의 모델을 학습해야 합니다.
적합한 경우 추가 처리 없이 필드 수준 JSON을 바로 원하는 개발자, 문서화 품질과 SDK 성숙도를 중시하는 팀, 표준 문서 유형을 처리하는 프로젝트에 적합합니다.
부적합한 경우 사전 정의된 모델이 없는 임의 문서 레이아웃, 장면 텍스트 OCR, 또는 온프레미스 배포가 필수인 사용 사례에는 적합하지 않습니다.
Nanonets
Nanonets는 OCR API와 AI 워크플로우 플랫폼 사이에 위치합니다. 핵심 차별점은 맞춤 모델 학습입니다. 샘플 문서를 업로드하면 Nanonets가 추출 규칙을 작성하지 않고도 원하는 필드를 학습합니다. 비표준 문서를 처리하는 팀의 경우, 이 학습 기반 접근 방식은 일반 사전 학습 모델보다 더 나은 정확도를 제공하는 경우가 많습니다.
가격. Nanonets는 월 10,000페이지 기준 월 $499부터 시작하며, 이는 클라우드 API 가격 대비 큰 차이입니다. 추가 추출은 페이지당 약 $0.30이며, 서식, 조회, 프리미엄 통합에 대한 별도 요금이 부과됩니다. G2와 Reddit의 개발자 리뷰에서는 볼륨이 증가함에 따라 비용 예측 불가능성이 문제로 자주 언급됩니다. 무료 티어는 신용카드 등록 시 500페이지를 제공합니다.
SDK 지원. Python, Node.js, Java, Go — 이 네 가지가 대부분의 사용 사례를 충족합니다. Python SDK가 가장 기능이 완전하며, 일괄 처리, 맞춤 모델 학습, 워크플로우 자동화 예제를 제공합니다.
출력 품질. 학습 데이터와 일치하는 문서의 경우 Nanonets는 높은 필드 수준 정확도를 달성합니다. 최근 출시된 Nanonets OCR-3 모델은 olmOCR 벤치마크에서 93.1점, OmniDocBench에서 90.5점을 기록하여 상용 OCR 모델 중 최상위권에 속합니다. JSON 출력에는 필드별 신뢰도와 경계 상자가 포함됩니다.
적합한 대상 비표준 문서에서 맞춤 필드를 추출해야 하는 팀, 내장 워크플로우 엔진의 혜택을 받는 조직, OCR과 워크플로우를 하나의 플랫폼에서 원하는 중견 기업입니다.
부적합한 대상 예산이 빠듯한 팀, Tesseract나 OCR.space로 충분한 단순 텍스트 추출, 또는 클라우드 공급자 네이티브 통합이 필요한 프로젝트입니다.
Veryfi
Veryfi는 금융 문서 OCR에 특화되어 있습니다. 영수증, 청구서, 은행 명세서, 수표, W-2 양식 등을 처리합니다. 일반적인 OCR API가 원시 텍스트를 반환하고 필드 식별을 사용자에게 맡기는 것과 달리, Veryfi는 회계에 바로 사용할 수 있는 JSON을 반환합니다. 상점 이름, 날짜, 합계, 세금, 품목별 내역, 결제 수단, 카테고리가 포함됩니다. 이러한 특화 덕분에 스캔한 영수증을 부기 항목으로 변환하는 가장 빠른 경로를 제공합니다.
가격. Veryfi는 총 100개 문서에 대한 무료 티어를 제공합니다. Starter 플랜은 월 최소 $500 약정이 필요하며, 이 비용으로 영수증 약 5,000건 또는 청구서 약 3,125건을 처리할 수 있습니다. 영수증은 건당 $0.08, 청구서는 건당 $0.16입니다. 이 가격 구조는 대량 처리에 적합하지만 소규모 프로젝트에는 진입 장벽이 높습니다. Growth 및 Enterprise 플랜은 맞춤 견적입니다.
SDK 지원. Python, Node.js, Java, Go, C#, PHP를 지원하여 백엔드 언어 전반에 걸쳐 탄탄한 커버리지를 제공합니다. SDK에는 URL, 로컬 파일, base64 인코딩 이미지 업로드 기능이 내장되어 있습니다. Veryfi는 iOS 및 Android 문서 캡처용 모바일 SDK도 제공합니다.
출력 품질. Veryfi의 금융 문서 추출은 해당 분야에서 가장 정확한 수준입니다. 멀티모달 LLM API(AnyDocs)는 동일한 접근 방식을 다양한 문서 유형으로 확장합니다. 응답은 38개 이상의 언어, 91개 이상의 통화, 카테고리, 정규화된 품목 내역을 지원합니다. Reddit의 r/bookkeeping 및 r/accounting 커뮤니티에서는 영수증 중심 워크플로우를 위한 표준 API로 자주 언급됩니다.
적합한 용도 비용 관리 애플리케이션, 영수증과 청구서를 대규모로 처리하는 핀테크 제품, 자동 데이터 수집 파이프라인을 구축하는 회계 법인입니다.
부적합한 용도 일반 목적의 OCR, 소규모 평가, 비금융 문서 유형입니다.
OCR.space
OCR.space는 대용량 처리와 예산이 제한된 프로젝트에 가장 적합한 무료 OCR API입니다. 무료 티어는 신용카드 없이 월 25,000건의 요청을 제공하며, 이는 다른 상용 API와 비교할 수 없을 정도로 뛰어납니다. 클라우드 3사에 비해 정확도와 기능이 다소 떨어지지만, 90~95% 정확도로 충분한 깨끗한 인쇄 문서의 경우 비용 측면에서 OCR.space를 따라올 수 없습니다.
가격. 무료 티어는 월 25,000건의 요청과 1MB 파일 크기 제한을 포함합니다. PRO 요금제는 월 $29.99로 300,000건의 요청, 5MB 파일 크기, 더 빠른 처리를 제공합니다. PRO PDF 요금제는 최대 999페이지의 다중 페이지 PDF 지원을 추가합니다. 엔터프라이즈 요금제는 전용 서버 기준 월 $999부터 시작합니다. 1,000페이지당 $1.50인 클라우드 API와 비교할 때, OCR.space의 무료 티어는 소규모 프로젝트에 사실상 무제한입니다.
SDK 지원. OCR.space는 언어별 SDK를 제공하지 않으며 REST API를 통해 통신합니다. 그러나 Python, JavaScript, PHP, Java용 커뮤니티 유지 래퍼가 존재합니다. API는 단어별 경계 상자와 신뢰도 점수가 포함된 JSON을 반환합니다.
출력 품질. 깨끗하고 대비가 높은 인쇄 텍스트에서 OCR.space는 약 90~95%의 문자 정확도를 달성합니다. 이는 검색 가능한 PDF와 간단한 양식의 데이터 추출에 충분합니다. 작은 글꼴, 비정형 레이아웃, 필기체 또는 저해상도 이미지에서는 정확도가 떨어집니다. 기본 테이블 추출 기능은 없으며, 테이블 데이터는 위치 좌표가 포함된 텍스트로 반환되지만 행/열 구조는 없습니다.
적합한 경우 예산이 가장 중요한 제약 조건인 프로토타입 및 MVP, 깨끗한 인쇄 문서를 처리하는 내부 도구, 유료 제공업체를 선택하기 전에 OCR 통합 패턴을 테스트할 수 있는 부담 없는 API가 필요한 개발자에게 적합합니다.
부적합한 경우 99% 이상의 정확도가 필요한 프로덕션 시스템, 복잡한 레이아웃, 필기체 인식, 또는 문서별 정확도가 비즈니스 결과에 직접 영향을 미치는 모든 시나리오에는 적합하지 않습니다.
Base64.ai
Base64.ai는 덜 알려졌지만 기술적으로 인상적인 OCR API로, "모든 문서를 위한 하나의 API"를 표방합니다. 의료 기록, 보험 양식부터 여권, 계약서, 인보이스까지 100가지 이상의 문서 유형을 지원하며, 각 유형별로 학습된 딥러닝 모델을 사용합니다. 회전된 페이지, 접힌 문서, 손으로 쓴 주석, 혼합 레이아웃 페이지 등 예외적인 경우를 처리하는 것이 강점입니다.
가격. Base64.ai는 문서 유형과 볼륨에 따라 페이지당 맞춤 가격을 적용하며, 공개된 표준 요금제는 없습니다. 잠재 고객은 견적을 위해 영업팀에 문의해야 하므로, 파일럿 없이 비용을 평가하기 어렵습니다. 가격은 엔터프라이즈급 API와 클라우드 하이퍼스케일러 사이의 수준으로 예상됩니다.
SDK 지원. Python 및 JavaScript용 커뮤니티 래퍼가 있는 REST API입니다. 핵심 통합은 JSON 페이로드를 사용한 직접 HTTP 요청을 통해 이루어집니다. Base64.ai는 또한 워크플로 자동화를 위해 Zapier 및 Slack과 통합됩니다.
출력 품질. Base64.ai의 추출 품질은 지원되는 문서 유형 전반에 걸쳐 우수하며, 특히 신분증, 금융 양식, 의료 기록에서 두드러집니다. JSON 응답에는 필드별 신뢰도, 경계 상자, 문서 분류 레이블이 포함됩니다. 양식의 손글씨 처리에서는 Tesseract나 OCR.space보다 우수하지만, ABBYY의 전용 필기 인식에는 뒤처집니다.
적합한 경우 단일 통합으로 다양한 문서 유형을 처리하는 문서 중심 산업, 설정을 위한 전담 계정 관리자가 필요한 팀, 문서 분류와 추출을 하나의 API로 통합하여 아키텍처 복잡성을 줄이고자 하는 시나리오에 적합합니다.
부적합한 경우 예산에 민감한 팀, 영업 상담 없이 빠른 프로토타이핑이 필요한 경우, 또는 클라우드 공급업체 네이티브 인프라가 필요한 프로젝트에는 적합하지 않습니다.
그 외 주목할 만한 API: 알아두면 유용한 서비스
위에서 다룬 10가지 API 외에도 특정 용도에 따라 살펴볼 만한 서비스가 몇 가지 더 있습니다.
LlamaParse는 RAG 파이프라인과 문서 에이전트를 위해 특별히 구축되었습니다. 의미 구조를 보존하고 마크다운을 출력하므로, 검색 증강 생성 시스템을 구축하는 AI 엔지니어에게 강력한 선택지입니다. 가격은 하루 1,000페이지 무료 티어에서 시작하며, 이후 페이지당 $0.003입니다.
Clarifai는 문서 이해 모델을 통해 OCR 기능을 제공하는 풀스택 AI 플랫폼입니다. 종량제 플랜과 개발자 플랜은 이미지 인식과 모델 학습을 같은 플랫폼에서 필요로 하는 팀에게 가장 경제적인 옵션 중 하나입니다.
Rossum은 대규모 인보이스 처리를 위해 최적화된 엔터프라이즈 IDP 플랫폼입니다. 가격은 연 $18,000부터 시작하여 ABBYY와 함께 확실히 엔터프라이즈 등급에 속합니다. Rossum의 강점은 AI 기반 검증 엔진과 ERP 통합(SAP, Coupa, Workday)이지만, 대부분의 개발자 사용 사례에서는 초기 비용이 부담스럽습니다.
이 플랫폼들은 주요 비교 대상에서 제외되었습니다. 그 이유는 대상 사용자가 이 가이드의 개발자 중심 OCR 범위보다 더 좁기 때문입니다.
사용 사례에 맞는 API는 무엇인가요?
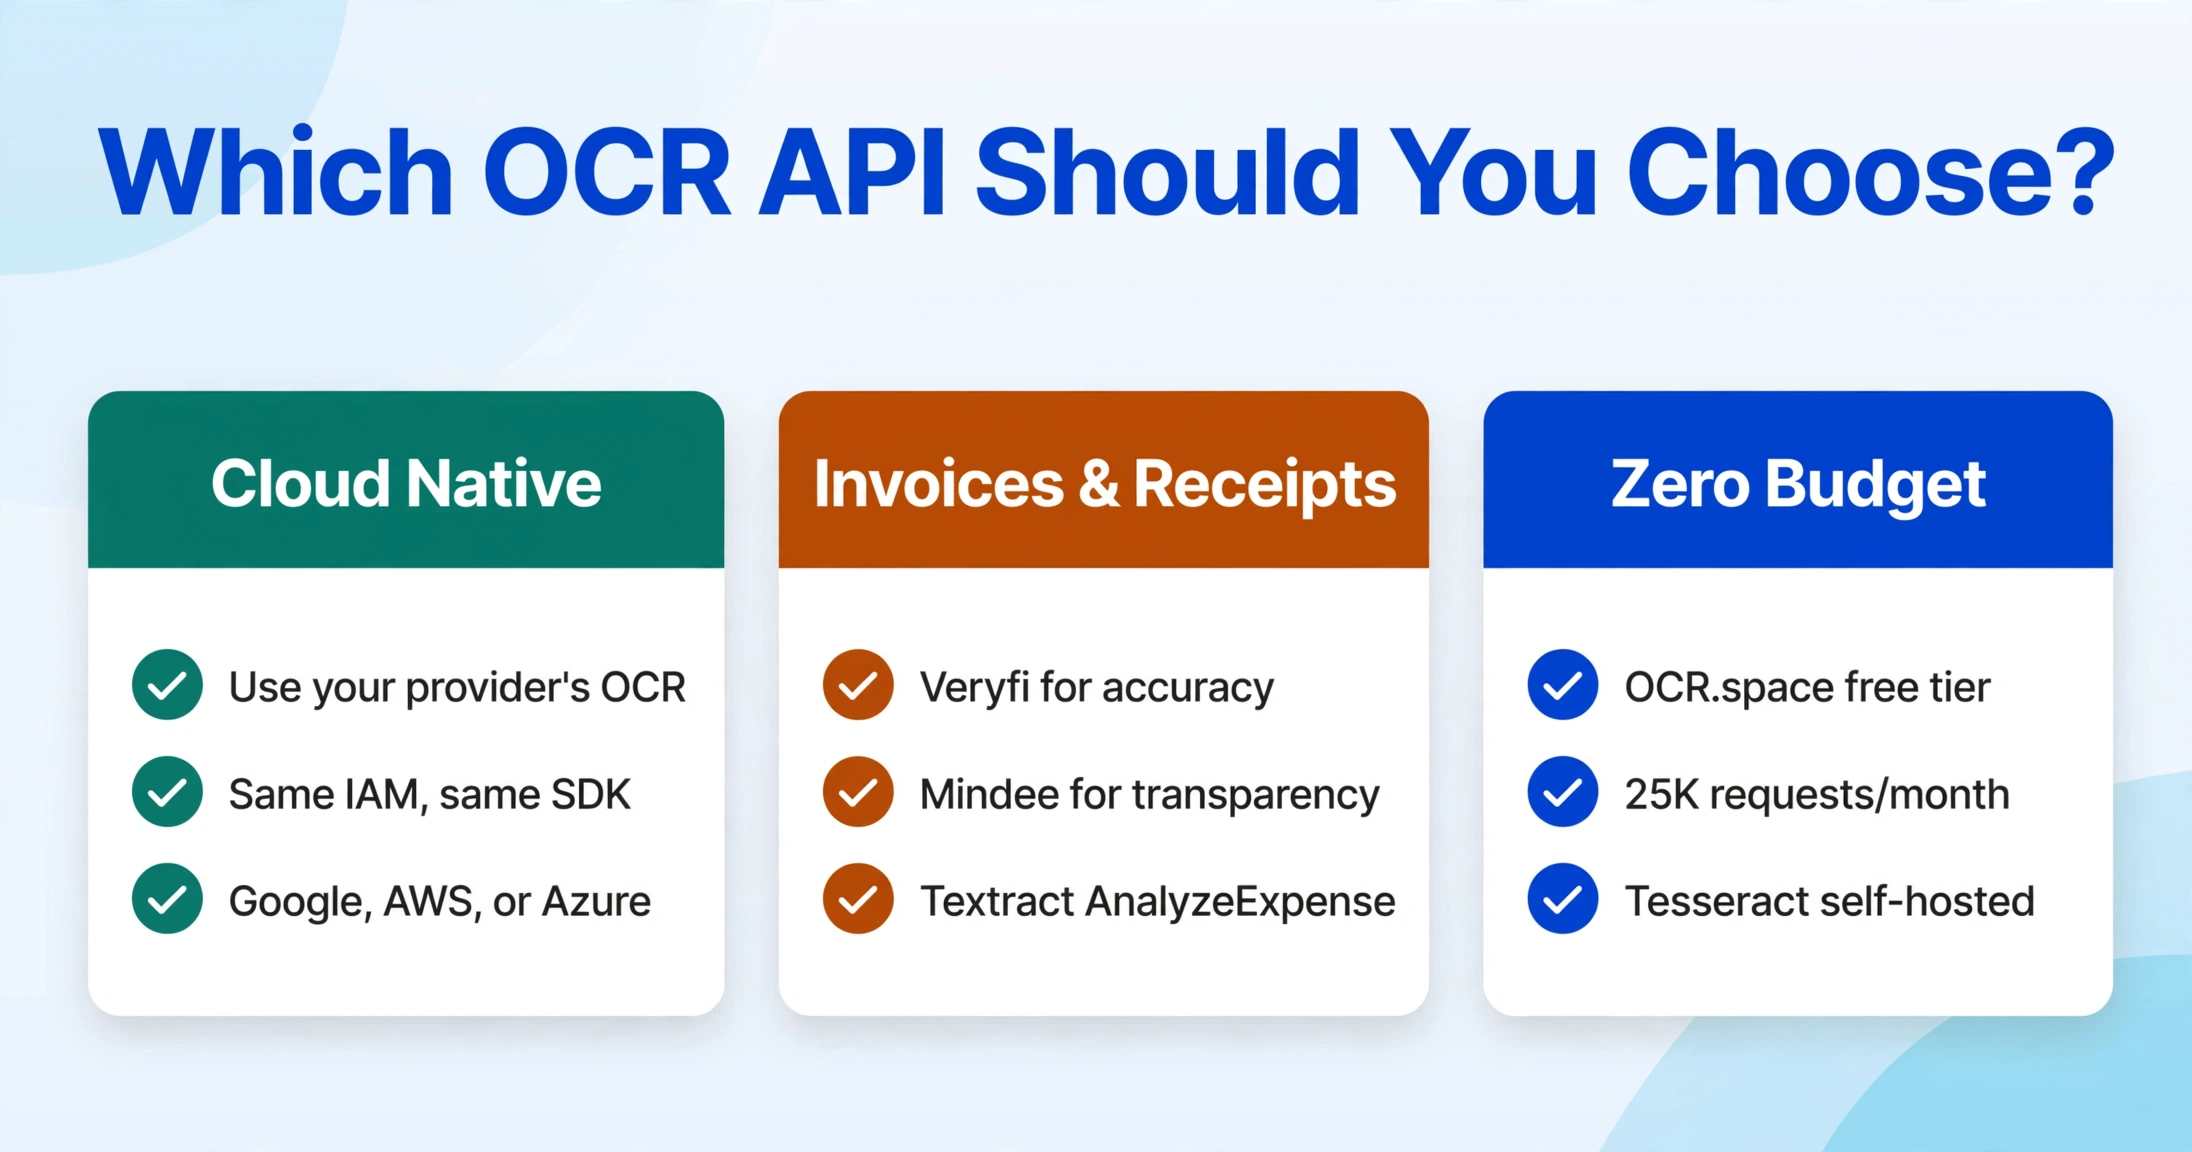
정답은 문서 유형, 예산, 일정, 에코시스템에 따라 달라집니다. 단일한 "최고의 OCR API"는 없습니다. 올바른 선택은 특정 시나리오에 대한 통합, 운영, 유지보수의 총비용을 최소화하는 API입니다. 다음은 여섯 가지 일반적인 상황과 가장 적합한 API입니다:
일반 OCR 기능을 구축 중이고 이미 Google Cloud, AWS, Azure를 사용 중인 경우
클라우드 제공업체의 OCR API를 사용하세요. 통합 비용 절감 효과만으로도 정확도 차이를 상쇄합니다. 장면 텍스트 및 문서 OCR에는 Google Cloud Vision, 양식과 표가 필요하면 AWS Textract, Microsoft 스택을 사용 중이라면 Azure Document Intelligence를 선택하세요.
인보이스와 영수증을 대규모로 처리하는 경우
Veryfi는 이 용도에 특화되어 있으며 금융 문서 정확도가 가장 뛰어납니다. Mindee는 가격 투명성이 더 좋고 월 $500 최소 요금이 없는 강력한 차선책입니다. AWS Textract의 AnalyzeExpense API는 이미 AWS를 사용 중이라면 실행 가능한 대안입니다.
고충실도의 표 및 양식 추출이 필요한 경우
AWS Textract의 Tables 기능은 JSON에서 기본 표 구조를 처리하는 표준으로 여전히 인정받고 있습니다. Azure Document Intelligence의 Layout 모델은 체크박스/선택 표시 추출에서 더 우수하며 근접한 성능을 보입니다. 엔터프라이즈 규정 준수 및 레이아웃 보존이 필요하다면 ABBYY의 SDK가 가장 검증된 옵션입니다.
예산이 거의 없고 문서가 깨끗한 인쇄 페이지인 경우
OCR.space의 무료 티어가 최선의 선택입니다. 더 높은 정확도가 필요하고 엔지니어링 시간을 투자할 수 있다면, 적절한 전처리를 갖춘 Tesseract가 설정 노력의 대가로 OCR.space보다 정확도에서 앞섭니다. 자체 호스팅과 클라우드 OCR 경제성 비교는 오픈소스 OCR 도구 가이드를 참조하세요.
비표준 문서에서 맞춤 필드 추출이 필요한 경우
Nanonets는 샘플 업로드, 필드 정의, 코딩 없이 학습이 가능한 가장 접근하기 쉬운 맞춤 모델 학습 파이프라인을 제공합니다. Mindee의 맞춤 모델도 유사한 워크플로우를 따르며 진입 가격이 더 낮습니다. Google Document AI의 Custom Extractor와 Azure의 Custom Extraction도 작동하지만 클라우드 플랫폼에 대한 더 많은 이해가 필요합니다.
통합 코드를 작성하지 않고 문서 추출을 원하는 경우
팀에 API 통합, 인증, 오류 처리, 결과 파싱을 관리할 여력이 없다면, ImageToTable.ai와 같은 노코드 도구가 웹 인터페이스나 Google Sheets 애드온을 통해 동일한 추출 기능을 제공합니다 — API 키, SDK, 배포 파이프라인이 필요 없습니다. 파일이나 PDF를 업로드하고 열을 정의하면 몇 초 안에 구조화된 데이터를 받을 수 있습니다. 단점은 처리량입니다. API는 자동화 규모에서 우위를 점하지만, 임시 문서 세트나 전담 엔지니어링 리소스가 없는 팀에게는 노코드 방식이 더 빠른 가치 실현을 제공합니다. 이 접근 방식이 기존 OCR과 어떻게 다른지 알아보려면 AI OCR이란?를 읽어보세요.
자주 묻는 질문
프로덕션 애플리케이션을 구축하는 개발자에게 가장 적합한 OCR API는 무엇인가요?
Mindee는 개발자 경험, 문서 품질, SDK 지원, 월 10,000페이지 미만의 프로덕션 워크로드에 대한 투명한 가격 책정 측면에서 가장 균형 잡힌 선택입니다. AWS 네이티브 스택에는 Textract가 논리적인 선택입니다. Google Cloud 네이티브 스택에는 Cloud Vision + Document AI가 적합합니다. "최적"의 API는 원시 OCR 정확도보다는 기존 인프라에 더 많이 의존합니다. 모든 주요 클라우드 API는 깨끗한 문서에서 97% 이상의 정확도를 제공하기 때문입니다.
대용량 처리를 위한 가장 저렴한 OCR API는 무엇인가요?
자체 호스팅의 경우 Tesseract는 무료이지만 프로덕션화에 엔지니어링 시간이 필요합니다. 대규모 관리형 API의 경우 AWS Textract의 DetectDocumentText는 페이지당 $1.50/1K로 가장 저렴한 페이지당 요금 중 하나입니다. OCR.space의 PRO 요금제는 월 $29.99에 300,000건의 요청을 제공하여 중저용량에서 최고의 가성비를 제공합니다. 매우 높은 볼륨에서는 주요 제공업체와 맞춤 요금을 협상하는 것이 일반적으로 페이지당 최저 비용을 제공합니다.
OCR API가 필기체를 처리할 수 있나요?
네, 하지만 품질은 크게 다릅니다. ABBYY Cloud OCR SDK는 가장 성숙한 필기체 인식 기능을 갖추고 있으며, 영역 기반 ICR 모드에서 126개의 필기 언어를 지원합니다. Google Cloud Vision의 필기체 지원은 인쇄된 필기체를 비교적 잘 처리합니다. 필기체 또는 혼합 필기 문서의 경우, 최신 비전-언어 모델 접근 방식이 기존 OCR 엔진보다 성능이 뛰어난 경우가 많지만 페이지당 비용은 더 높습니다. 자세한 비교는 필기체 OCR 가이드를 참조하세요.
OCR API가 표 구조를 보존하나요?
AWS Textract는 셀 신뢰도 점수가 포함된 기본 행-열 테이블 JSON을 반환하며, 이는 개발자에게 가장 친숙한 테이블 출력입니다. Azure Document Intelligence의 Layout 모델도 경계 상자와 함께 표 구조를 보존합니다. Google Cloud Vision의 Document AI는 테이블 블록을 반환하지만 안정적인 구조 재구성을 위해 더 많은 후처리가 필요합니다. Tesseract와 OCR.space는 위치 데이터가 포함된 텍스트를 반환하지만 표 구조 추론은 제공하지 않습니다.
어떤 OCR API가 가장 많은 프로그래밍 언어를 지원하나요?
Google Cloud Vision, AWS Textract, Mindee는 모두 Python, Node.js, Java, Go 및 최소 3개 이상의 추가 언어용 자사 SDK를 제공합니다. Azure Document Intelligence의 .NET SDK는 특히 강력합니다. 긴 꼬리 언어 지원(PHP, Ruby)의 경우 Google과 AWS가 모든 SDK에서 가장 광범위한 범위를 제공합니다.
2026년에 이용 가능한 무료 OCR API 등급은 무엇인가요?
OCR.space는 월 25,000건 요청으로 가장 넉넉한 무료 등급을 제공합니다. Google Cloud Vision은 월 1,000유닛을 무료로 제공합니다. AWS Textract는 처음 3개월 동안 월 1,000페이지를 제공합니다. Azure Document Intelligence는 월 500페이지를 제공합니다. Mindee의 Developer 플랜은 신용카드 없이 월 250페이지를 무료로 포함합니다. Veryfi는 문서 100건을 무료로 포함합니다. Tesseract는 무료이지만 자체 호스팅이 필요합니다.
어떤 API가 동기식 및 비동기식 처리를 지원하나요?
Google Cloud Vision, AWS Textract, Azure Document Intelligence는 모두 동기식 및 비동기식 모드를 지원합니다. Mindee, Veryfi, Nanonets는 기본적으로 동기식 처리를 사용하며 배치 워크로드에 대한 비동기 옵션을 제공합니다. OCR.space는 동기식 전용입니다. 대화형 애플리케이션의 경우 선택한 API가 2초 미만의 동기 응답을 제공하는지 확인하세요.
OCR API를 온프레미스 또는 프라이빗 클라우드에서 실행할 수 있나요?
Tesseract 및 기타 오픈소스 엔진(PaddleOCR, EasyOCR)은 어디서나 실행됩니다. ABBYY는 FlexiCapture 플랫폼에 대한 온프레미스 배포를 제공합니다. AWS Textract, Google Cloud Vision, Azure Document Intelligence는 클라우드 전용이지만, Azure는 일부 Document Intelligence 기능에 대해 연결된 컨테이너 배포를 제공합니다. 민감한 데이터(PII, PHI)의 경우 로컬 전처리 후 데이터 마스킹과 함께 클라우드 API 호출을 사용하는 Tesseract가 일반적인 하이브리드 패턴입니다.
OCR API를 전혀 통합하고 싶지 않다면 어떻게 해야 하나요?
OCR API는 규모에 맞는 프로그래밍 방식 액세스가 필요할 때 올바른 선택입니다. 하지만 문서를 가끔 처리하거나 팀에 API 통합을 위한 엔지니어링 역량이 없다면, 코드 없는 추출 도구가 구조화된 데이터로 가는 더 빠른 경로를 제공합니다. ImageToTable.ai를 사용하면 코드를 작성하지 않고도 문서를 업로드하고, 열 이름을 지정하고, 구조화된 테이블 출력을 얻을 수 있습니다. Google Sheets 애드온은 여기서 더 나아가 스프레드시트에서 직접 업로드하고 활성 시트에 데이터를 추가할 수 있습니다 — API 키, SDK, 관리할 서버가 필요 없습니다. OCR API와는 다른 트레이드오프이지만, 적절한 사용 사례에서는 더 빠른 해결책입니다.
가장 많은 언어를 지원하는 OCR API는 무엇인가요?
ABBYY Cloud OCR SDK는 인쇄체 200개 이상, 필기체 126개 언어를 지원하며 선두를 달리고 있습니다. Google Cloud Vision은 Document AI 파이프라인을 통해 200개 이상의 언어를 지원합니다. Tesseract는 대부분의 문자 체계에 대한 언어 팩을 제공하며 100개 이상의 언어를 지원합니다. Azure Document Intelligence와 AWS Textract는 각각 약 100개 이상의 언어를 지원합니다. 동아시아 언어의 경우 Google Cloud Vision과 ABBYY가 일반적으로 가장 높은 정확도를 제공합니다. 유럽 언어의 경우 모든 주요 클라우드 API가 비슷한 성능을 보입니다.
OCR API 정확도를 비교하는 독립적인 벤치마크가 있나요?
여러 독립 벤치마크가 OCR 모델 정확도를 추적하고 있습니다. Allen Institute for AI의 olmOCR 벤치마크는 문서 이해 및 구조 보존을 평가합니다. OmniDocBench는 다중 형식 문서 추출 품질을 다룹니다. IDP Leaderboard는 인보이스, 영수증, 신분증 문서 유형에 대한 추출 정확도를 추적합니다. 2026년 초 기준으로 Nanonets OCR-3는 olmOCR에서 93.1점을 기록했으며, GPT-5.2와 Gemini 3 Pro는 결합 정확도와 양식 이해에서 VLM 기반 접근 방식을 선도하고 있습니다. 이러한 벤치마크는 자주 업데이트되므로 최신 순위는 출처를 확인하세요.