Meilleure OCR API
2026 : 10 API pour développeurs comparées pour la précision et le prix
Cette comparaison évalue 10 OCR API selon six dimensions — la précision sur texte imprimé et manuscrit, la tarification par page à plusieurs niveaux de volume, la prise en charge des langages SDK, la qualité du format de sortie, le profil de latence et l'intégration à l'écosystème cloud — pour vous aider à prendre une décision éclairée pour votre prochain projet. Chaque API a été évaluée sur la base de spécifications publiquement documentées, de pages de tarification officielles et des retours de la communauté des développeurs. Avertissement : cet article inclut un outil sans code aux côtés de neuf API pour le contexte. Toutes les données de tarification ont été vérifiées auprès de sources officielles en juin 2026. Les liens vers des services tiers utilisent nofollow.
Points clés
- Un tarif annoncé de 1,50 $ pour 1 000 pages cache un multiplicateur de coût de 33× — activez l'extraction de formulaires dans Textract et votre facture passe à 51,50 $ pour 1 000 pages avant même d'avoir traité un seul tableau.
- Chaque grande OCR API atteint une précision de 97 à 99 % sur des documents propres — s'obséder sur les scores de benchmark gaspille la seule ressource que vous ne pouvez pas racheter : les semaines d'ingénierie que votre équipe passera sur l'intégration SDK, la configuration IAM et le câblage du pipeline.
- « La meilleure OCR API » est la mauvaise question — commencez par le cloud que vous payez déjà, le SDK que votre équipe connaît et les types de documents que vous recevez réellement, puis choisissez l'API qui minimise les frictions d'intégration.
Comparaison rapide : 10 API OCR en un coup d'œil
Le tableau ci-dessous résume chaque API en mettant en avant son principal atout, son prix de départ, sa spécialité en matière de types de documents et les écosystèmes avec lesquels elle s'intègre naturellement. Utilisez-le comme premier filtre, puis consultez la section complète pour l'API qui vous intéresse.
| API | Idéal pour | Prix de départ | Documents | Écosystème cloud |
|---|---|---|---|---|
| Google Cloud Vision | OCR général + texte de scène | Gratuit : 1K/mois ; puis $1.50/1K | Tout (images, PDF) | Google Cloud (Doc AI, Storage, BigQuery) |
| AWS Textract | Formulaires, tableaux, documents structurés | Gratuit : 1K/mois (3 mois) ; puis $1.50/1K | Formulaires, tableaux, factures, reçus, pièces d'identité | AWS (S3, Lambda, Comprehend, SQS) |
| Azure Document Intelligence | Modèles pré-entraînés + pile Microsoft | Gratuit : 500/mois ; puis $1.50/1K Read | Factures, reçus, pièces d'identité, cartes de santé, contrats | Azure (Logic Apps, Power Automate, Purview) |
| Tesseract | OCR auto-hébergé gratuit | Gratuit (coût de calcul uniquement) | Documents imprimés propres | Auto-hébergé (Linux, Windows, macOS) |
| ABBYY Cloud OCR SDK | OCR d'entreprise haute précision | $99/mois (5K pages) | Tout (200+ langues, écriture manuscrite) | Hébergé sur Azure, sur site disponible |
| Mindee | Expérience développeur + modèles pré-entraînés | Gratuit : 250/mois ; à partir de €44/mois (500 crédits) | Factures, reçus, pièces d'identité, passeports, CV | API autonome (aucun verrouillage d'écosystème) |
| Nanonets | Entraînement de modèles personnalisés + workflows | $499/mois (10K pages) | Types de documents personnalisés, factures, reçus | Autonome + intégrations (Zapier, QuickBooks) |
| Veryfi | Reçus, factures, documents financiers | Gratuit : 100 documents ; $500/mois min (Starter) | Reçus, factures, relevés bancaires, chèques | Autonome + intégrations QuickBooks, Xero |
| OCR.space | OCR budgétaire gratuit en volume | Gratuit : 25K requêtes/mois ; $30/mois (PRO) | Documents texte propres, PDF multipages | API autonome (sans fioritures) |
| Base64.ai | Tout type de document, une seule API | Tarification personnalisée (paiement par page) | 100+ types de documents, écriture manuscrite, tableaux | API autonome + Slack, Zapier |
Comment nous avons sélectionné et évalué ces API
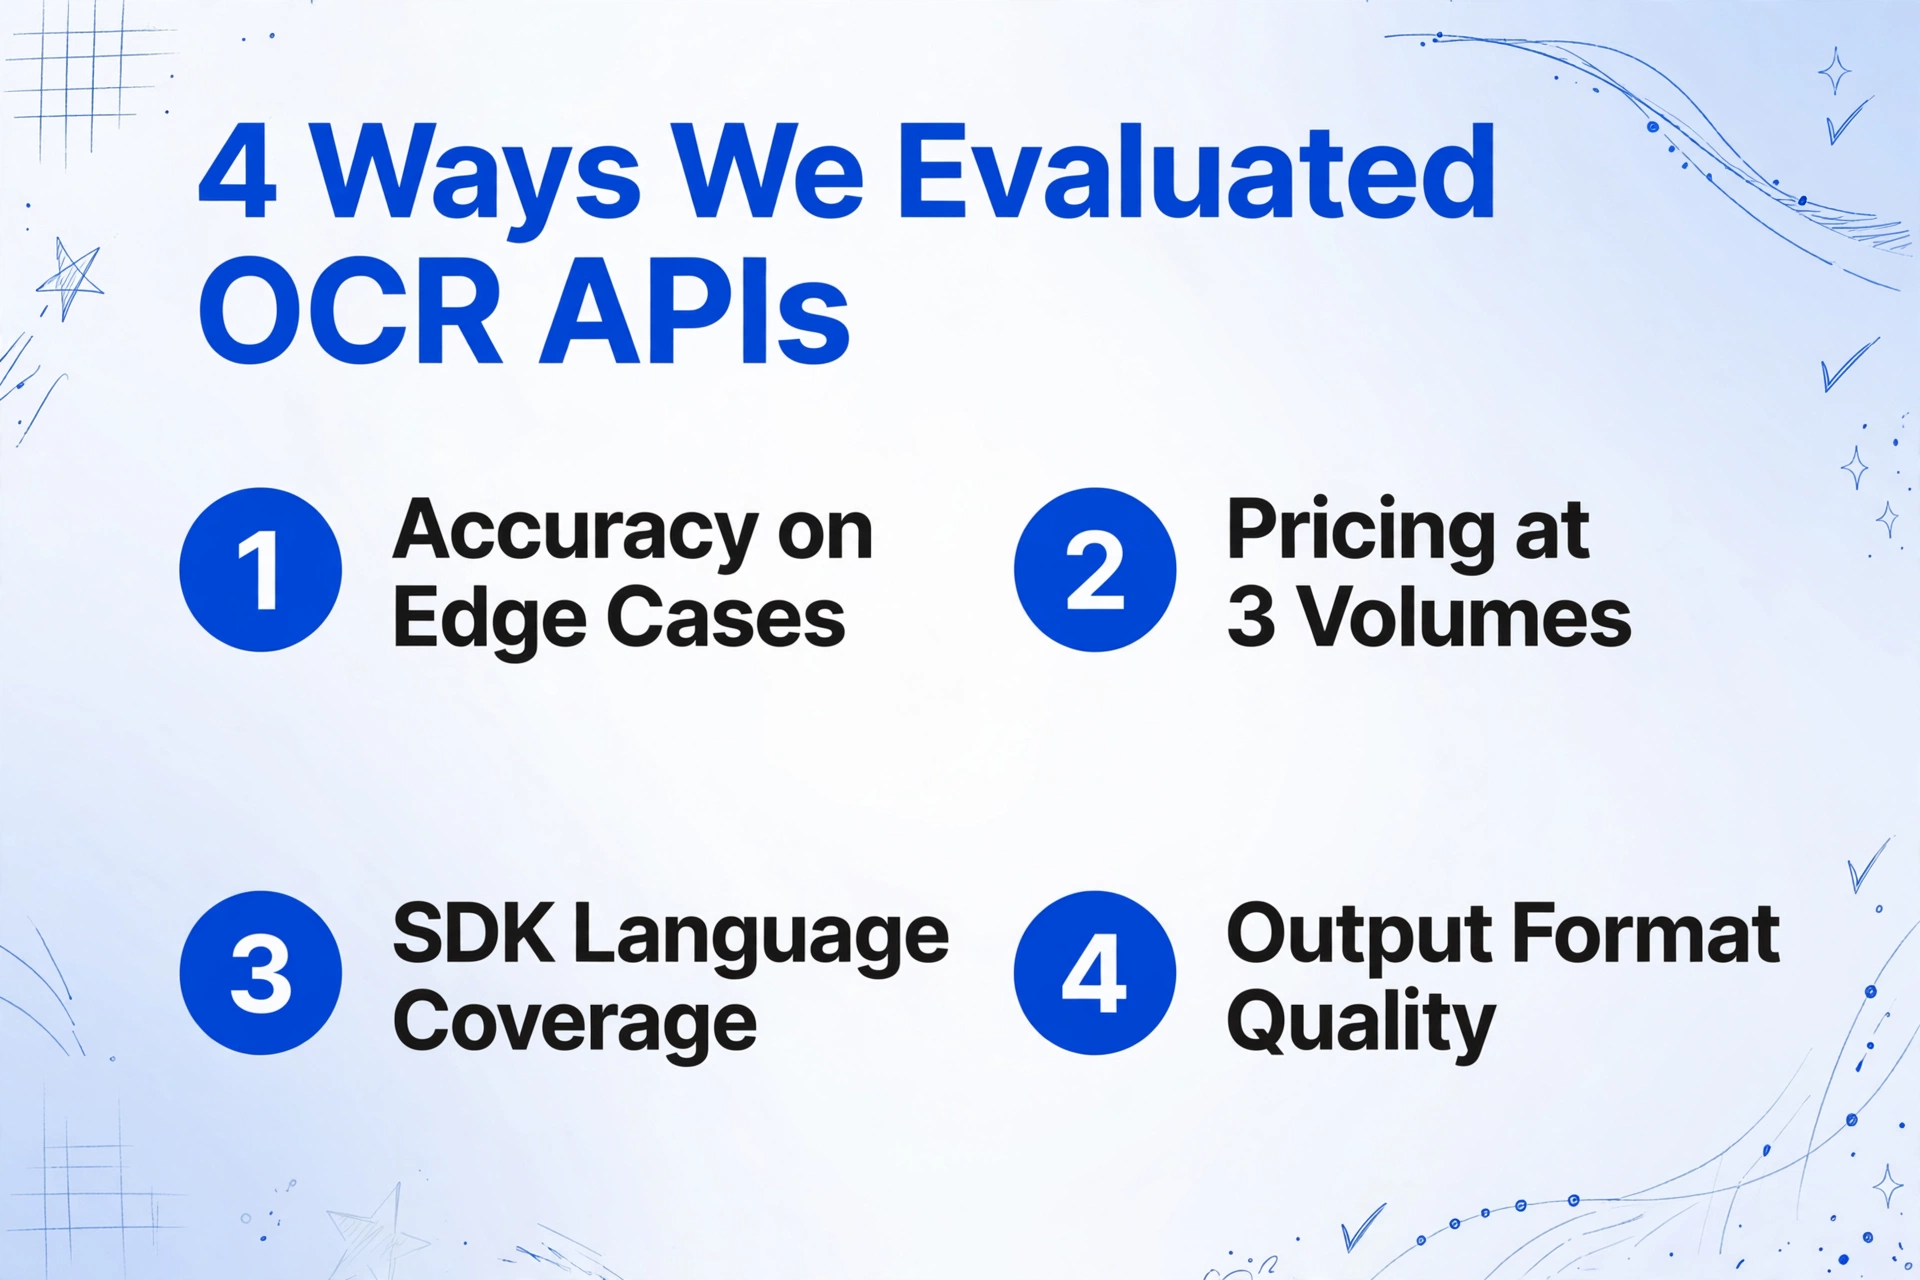
Chaque dimension d'évaluation ci-dessous a été vérifiée à partir de la documentation officielle, des pages de tarification publiées et des référentiels SDK pour développeurs. Lorsque des benchmarks indépendants existaient (benchmark olmOCR, OmniDocBench, IDP Leaderboard), ils ont été recoupés avec les retours d'expérience de développeurs sur Stack Overflow et les communautés Reddit.
1. Précision — texte imprimé, écriture manuscrite, tableaux et formulaires
Pour le texte imprimé sur des documents propres, toutes les principales API cloud offrent une précision de 97 à 99 % dans des conditions normales. Les écarts apparaissent sur l'écriture manuscrite, les scans de faible qualité, les tableaux complexes et les documents multilingues. Nous avons évalué les plages de précision annoncées par chaque API pour ces cas limites et pris en compte la validation par la communauté des performances réelles.
2. Tarification — par page, par 1 000 pages et coûts cachés
La tarification des API OCR semble simple à première vue : la plupart des fournisseurs affichent un tarif de base de 1,50 $ pour 1 000 pages. Le coût réel dépend du point de terminaison API utilisé (texte de base, analyse de formulaires ou requêtes personnalisées) et du fait que vous restiez ou non dans le premier palier de tarification. Nous avons calculé le coût total à trois niveaux de volume : 1 000 pages, 10 000 pages et 100 000 pages par mois.
3. Prise en charge des SDK et des langages
Un bon SDK fait la différence entre une intégration d'une journée et une épreuve d'une semaine. Nous avons vérifié la disponibilité des SDK officiels pour Python, Node.js, Java, Go, .NET, Ruby et PHP — les sept langages qui couvrent la grande majorité des cas d'utilisation backend et de traitement de données.
4. Qualité du format de sortie
Le texte brut est la base. Ce qui fait la différence, c'est de savoir si l'API renvoie des coordonnées de boîtes englobantes par mot ou par ligne, préserve la structure hiérarchique des tableaux, extrait les paires clé-valeur des formulaires et fournit des scores de confiance. Nous avons évalué chaque API sur la richesse de sa réponse JSON.
5. Latence et débit
Des réponses synchrones en moins de deux secondes sont essentielles pour les applications interactives. Le débit par lots (pages par minute à grande échelle) compte pour les pipelines de traitement en arrière-plan. Nous avons noté les caractéristiques de latence documentées de chaque API.
6. Écosystème cloud et intégrations natives
Une API qui se connecte directement à S3, Cloud Storage ou Blob Storage — et qui alimente un entrepôt de données ou un ERP avec les données extraites — permet d'économiser des semaines d'ingénierie de pipeline. Nous avons évalué la profondeur d'intégration de chaque API avec sa plateforme cloud parente et les services tiers.
API Google Cloud Vision
Google Cloud Vision est l'API OCR la plus complète du marché — non pas parce qu'elle est la plus précise pour chaque type de document, mais parce qu'elle gère tout, des panneaux de signalisation aux pages de contrats denses, via un seul point d'accès. Elle divise l'OCR en deux appels : TEXT_DETECTION pour le texte de scène (panneaux, étiquettes, photos) et DOCUMENT_TEXT_DETECTION pour les pages de documents denses, ce dernier étant optimisé via le pipeline Document AI de Google.
Tarification. Les 1 000 premières unités par mois et par fonctionnalité sont gratuites. Ensuite, la détection de texte coûte $1.50 pour 1 000 images jusqu'à 5 millions, puis $0.60 au-delà. La détection de texte de document suit le même palier. Via Document AI, les processeurs spécialisés (Invoice Parser, Expense Parser) facturent $0.10 pour 10 pages — nettement moins cher que l'analyse de formulaires de Textract pour les documents financiers.
Support SDK. Python, Node.js, Java, Go, C#, PHP et Ruby — tous officiels, tous maintenus. Les bibliothèques clientes de Google comptent parmi les plus matures dans le domaine de l'OCR cloud.
Qualité de sortie. La réponse JSON inclut des boîtes englobantes par mot, des scores de confiance et des blocs de mise en page au niveau de la page. Les processeurs Document AI ajoutent des paires clé-valeur et des structures de tableaux, bien que la reconstruction des tableaux nécessite un post-traitement par rapport à la sortie de tableaux native de Textract.
Idéal pour les équipes déjà sur Google Cloud, les applications qui ont besoin à la fois d'OCR de texte de scène et d'OCR de documents via un seul SDK, et les projets qui bénéficieront d'intégrations Vertex AI ou BigQuery à l'avenir.
Moins adapté pour l'extraction intensive de tableaux à grande échelle (Textract est moins cher et plus structuré) ou les flux de travail qui doivent rester agnostiques au cloud.
AWS Textract
Amazon Textract a été conçu spécifiquement pour la compréhension de documents plutôt que pour l'analyse d'images générales — et cela se voit. Son API AnalyzeDocument expose des indicateurs de fonctionnalités distincts pour les tableaux, les formulaires, les requêtes et les signatures, vous permettant de ne payer que pour la profondeur d'extraction dont vous avez besoin. La fonctionnalité Tableaux renvoie une structure native de lignes et de colonnes avec un niveau de confiance par cellule ; la fonctionnalité Formulaires extrait des paires clé-valeur sans aucune configuration de modèle.
Tarification. Le DetectDocumentText de base coûte 1,50 $ pour 1 000 pages (premier million) et 0,60 $ au-delà. Les tableaux ajoutent 15 $ pour 1 000 pages ; les formulaires ajoutent 50 $ pour 1 000 pages ; les requêtes ajoutent 15 $ pour 1 000 pages. Pour le traitement des factures, l'API AnalyzeExpense coûte 8 à 10 $ pour 1 000 pages — conçue spécifiquement pour les documents financiers et généralement plus précise que l'analyse générique des formulaires. L'offre gratuite comprend 1 000 pages de DetectDocumentText par mois pendant les trois premiers mois.
Support SDK. Python, Node.js, Java, Go, .NET, PHP, Ruby — tous les SDK AWS propriétaires. Les API de pagination et asynchrones de Textract sont bien documentées avec des exemples fonctionnels dans chaque langage.
Qualité de sortie. La sortie de tableaux de Textract est la référence du secteur pour l'extraction structurée. La réponse JSON préserve les fusions de lignes, les fusions de colonnes, les cellules fusionnées et la confiance par cellule. L'extraction de formulaires renvoie des paires clé-valeur avec des cadres de délimitation et des relations. Les requêtes prennent en charge les questions en langage naturel sur les documents — une capacité unique pour l'extraction de champs ad hoc.
Idéal pour les piles natives AWS, tout projet nécessitant une extraction de tableaux ou de formulaires haute fidélité, et les équipes souhaitant combiner l'OCR avec Lambda, les déclencheurs d'événements S3 ou Step Functions pour les pipelines de traitement de documents.
Moins adapté pour l'OCR général de texte de scène (l'API Vision est meilleure) ou les équipes souhaitant des coûts prévisibles sans niveaux de tarification basés sur les fonctionnalités.
Azure Document Intelligence
Azure Document Intelligence (anciennement Azure Form Recognizer) offre l'intégration la plus étroite avec l'écosystème Microsoft — Logic Apps, Power Automate, Power BI et SharePoint. Ses modèles prédéfinis couvrent les factures, les reçus, les pièces d'identité, les cartes d'assurance maladie, les formulaires W-2, les formulaires fiscaux 1098 et les contrats. Le modèle Layout extrait les tableaux et le texte en préservant la structure.
Tarification. Le modèle Read (OCR de base + mise en page) coûte 1,50 $ par 1 000 pages, avec 500 pages gratuites par mois. L'analyse de documents prédéfinis coûte environ 10 $ par 1 000 pages. L'extraction personnalisée commence à 30 $ par 1 000 pages pour l'entraînement et l'inférence. Les 500 pages gratuites par mois de l'offre gratuite sont moins généreuses que les 1 000 de Google, mais suffisantes pour le prototypage.
Support SDK. Python, Node.js, Java, .NET (C#) et Go — un support propriétaire solide. Le SDK .NET est particulièrement bien entretenu, reflétant la base de clients .NET d'entreprise d'Azure.
Qualité de sortie. Le modèle Layout renvoie les tableaux, les marques de sélection (cases à cocher) et la structure des paragraphes avec des boîtes englobantes et des scores de confiance. Les modèles prédéfinis ajoutent l'extraction de champs spécifiques aux documents (par exemple, les lignes de facture, le nom du commerçant sur les reçus). La sortie JSON est bien structurée mais moins granulaire par cellule que Textract pour les scénarios de tableaux complexes.
Idéal pour les organisations déjà sur Microsoft 365 ou Azure, les scénarios nécessitant des workflows Power Automate, et les équipes qui valorisent la documentation de conformité prédéfinie (SOC 2, HIPAA, RGPD).
Moins adapté pour l'OCR de base à volume élevé où OCR.space ou Tesseract seraient moins chers, ou les équipes qui préfèrent la maturité des SDK de Google ou d'AWS.
Tesseract (Open Source Auto-hébergé)
Tesseract, développé à l'origine par HP et maintenant maintenu par Google, reste le point de départ par défaut pour les développeurs qui veulent un contrôle total sur leur pipeline OCR. Il prend en charge plus de 100 langues, fonctionne sur n'importe quelle plateforme et ne coûte rien au-delà du calcul. Mais « gratuit » ne signifie pas « bon marché » — le temps d'ingénierie nécessaire pour industrialiser Tesseract peut dépasser le coût d'un abonnement API cloud en quelques semaines.
Tarification. Gratuit. Le seul coût est l'infrastructure : une VM ou un conteneur modeste. Pour le traitement à volume élevé (1M+ pages/mois), Tesseract auto-hébergé sur une instance CPU atteint généralement le seuil de rentabilité avec les API cloud entre 100 000 et 130 000 pages par mois, selon la complexité des documents.
Support SDK. Python (pytesseract), C++ (natif), Java (Tess4J), Node.js (tesseract.js). Le wrapper Python est le plus utilisé, avec une documentation communautaire et une couverture Stack Overflow étendues. Cependant, la maturité des SDK varie considérablement — tesseract.js fonctionne entièrement dans le navigateur mais est plus lent que la version native.
Qualité de sortie. Sur des documents imprimés propres avec une bonne résolution et des fonds uniformes, Tesseract atteint une précision au niveau du mot de 95 à 99 %. Sur les scans de faible qualité, les pages inclinées ou les documents avec des polices décoratives, la précision chute fortement. Il a un support natif minimal pour la structure des tableaux — la sortie est un texte plat avec un positionnement par espaces. La reconnaissance de l'écriture manuscrite n'est pas fiable sans entraînement supplémentaire du modèle. Les formats de sortie hocr et ALTO fournissent des boîtes englobantes mais aucune compréhension sémantique des champs.
Idéal pour les équipes qui ont besoin de la souveraineté des données (aucune donnée ne quitte le serveur), d'un traitement à volume élevé où le coût de l'infrastructure est inférieur aux frais d'API par page, et des développeurs à l'aise avec le réglage des pipelines de prétraitement (redressement, binarisation, segmentation de page).
Pas idéal pour les équipes qui ont besoin d'une extraction prête pour la production en quelques jours plutôt qu'en quelques semaines, les documents avec des mises en page complexes ou une écriture manuscrite, ou tout scénario où la charge de maintenance doit être minimale.
Pour une comparaison plus approfondie entre Tesseract et les approches d'extraction modernes, consultez notre article sur OCR vs Extraction par IA.
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDK est présent dans le secteur de l'OCR depuis plus de trois décennies, et son Cloud OCR SDK reflète cette maturité. Il prend en charge plus de 200 langues de reconnaissance (dont 126 langues manuscrites), préserve la mise en page du document avec une grande fidélité et gère l'extraction par zones ainsi que l'OCR pleine page. La force d'ABBYY réside dans sa cohérence face à des qualités d'entrée variées — là où Tesseract pourrait avoir du mal avec un scan légèrement incliné, le moteur de prétraitement d'ABBYY compense.
Tarification. Cloud OCR SDK commence à 99 $ par mois pour 5 000 pages. Les déploiements d'entreprise (1M+ pages/an) négocient généralement des tarifs par page dans la fourchette de 0,02 $ à 0,10 $ avec des engagements annuels commençant autour de 15 000 $. Il n'y a pas de niveau gratuit permanent, seulement des essais. Pour les petites équipes, cela rend ABBYY nettement plus cher que les API des grands fournisseurs de cloud.
Support SDK. Python, Java, .NET (C#) et C++ — solide mais plus restreint que le trio du cloud. L'API REST est entièrement documentée et des exemples de code sont disponibles pour tous les langages pris en charge.
Qualité de sortie. La préservation de la mise en page d'ABBYY est parmi les meilleures de l'industrie — il reconstruit la structure du document original, y compris les colonnes, les tableaux, les en-têtes et les pieds de page. Sa sortie XML (via le moteur FineReader) est le format le plus riche disponible pour le traitement aval des documents. La reconnaissance de l'écriture manuscrite dans 126 langues est un différenciateur que seules quelques API égalent.
Idéal pour les projets de numérisation de documents d'entreprise où la fidélité de la mise en page est essentielle, les secteurs réglementés (finance, santé, gouvernement) qui ont besoin d'options de déploiement sur site, et l'OCR multilingue à grande échelle couvrant à la fois l'impression et l'écriture manuscrite.
Pas idéal pour les startups ou les petites équipes avec des budgets limités, le prototypage rapide, ou les projets où les coûts par page doivent rester inférieurs à 0,01 $.
Mindee
Mindee est l'une des API OCR les plus conviviales pour les développeurs actuellement disponibles. Sa documentation est claire, ses réponses API sont cohérentes, et ses modèles pré-entraînés (factures, reçus, passeports, permis de conduire, CV, etc.) fonctionnent directement sans étape d'entraînement. Mindee fait un choix de conception délibéré : au lieu de proposer un endpoint OCR générique et de vous laisser la logique d'extraction, il renvoie un JSON au niveau des champs qui correspond directement à votre modèle de données.
Tarifs. Le plan Développeur est gratuit pour 250 pages par mois (aucune carte de crédit requise). Les plans payants commencent à 44 €/mois (environ 47 $) pour 500 pages facturées annuellement, avec des pages supplémentaires à 0,05 € chacune. Le plan Pro (179 €/mois) inclut 2 500 pages à 0,04 € par page supplémentaire. Les tarifs Entreprise descendent vers 0,01 € par page à volume élevé. C'est l'une des structures tarifaires les plus transparentes du secteur des API OCR — pas de paliers cachés ni de coûts de fonctionnalités surprises.
Support SDK. Python, Node.js, Java, Go, Ruby, PHP et .NET — la couverture SDK la plus large en dehors des trois grands fournisseurs cloud. Tous les SDK sont générés automatiquement à partir de la spécification OpenAPI, ce qui signifie qu'ils restent à jour avec l'API. Sur Reddit r/programming et r/MachineLearning, le SDK Python de Mindee est fréquemment cité comme le plus intuitif pour le prototypage rapide.
Qualité de sortie. L'extraction au niveau des champs de Mindee renvoie un JSON structuré avec des scores de confiance par champ. Pour les factures, cela signifie des tableaux de lignes avec descriptions, quantités, prix unitaires et totaux — pas de texte brut que vous devez analyser vous-même. Le compromis est que Mindee est optimisé pour des types de documents spécifiques plutôt que pour des documents arbitraires ; pour un formulaire générique avec des champs personnalisés, vous devriez entraîner un modèle personnalisé.
Idéal pour les développeurs qui veulent un JSON au niveau des champs directement (sans post-traitement regex), les équipes qui valorisent la qualité de la documentation et la maturité des SDK, et les projets qui traitent des types de documents standard (factures, reçus, pièces d'identité, passeports, CV).
Moins adapté pour les mises en page de documents arbitraires sans modèles prédéfinis, l'OCR de texte de scène (panneaux de rue, tableaux blancs), ou les cas d'utilisation où un déploiement sur site est obligatoire.
Nanonets
Nanonets se positionne entre l'API OCR et la plateforme de workflow IA. Son principal différenciateur est l'entraînement de modèles personnalisés — vous téléchargez des documents d'exemple et Nanonets apprend à extraire les champs qui vous intéressent, sans écrire de règles d'extraction. Pour les équipes qui traitent des documents non standard, cette approche basée sur l'entraînement offre souvent une meilleure précision que les modèles génériques pré-entraînés.
Tarifs. Nanonets commence à 499 $ par mois pour jusqu'à 10 000 pages — un bond significatif par rapport aux tarifs des API cloud. L'extraction supplémentaire coûte environ 0,30 $ par page, plus des frais distincts pour le formatage, les recherches et les intégrations premium. Les avis de développeurs sur G2 et Reddit citent fréquemment l'imprévisibilité des coûts comme une préoccupation à mesure que le volume augmente. L'offre gratuite comprend 500 pages avec une carte de crédit.
Support SDK. Python, Node.js, Java et Go — ces quatre langages couvrent la plupart des cas d'utilisation. Le SDK Python est le plus complet, avec des exemples pour le traitement par lots, l'entraînement de modèles personnalisés et l'automatisation des workflows.
Qualité de sortie. Pour les documents qui correspondent à votre ensemble d'entraînement, Nanonets atteint une précision élevée au niveau des champs. Son récent modèle Nanonets OCR-3 (sorti en avril 2026) a obtenu un score de 93,1 sur le benchmark olmOCR et de 90,5 sur OmniDocBench, le plaçant dans le haut du classement des modèles OCR commerciaux. La sortie JSON inclut la confiance par champ et les boîtes englobantes.
Idéal pour les équipes qui doivent extraire des champs personnalisés de documents non standard, les organisations qui bénéficient du moteur de workflow intégré (approbations, validations, notifications Slack) et les entreprises de taille intermédiaire qui souhaitent une plateforme combinant OCR et workflow.
Moins adapté pour les équipes avec un budget serré (les tarifs augmentent rapidement), l'extraction de texte simple où Tesseract ou OCR.space suffiraient, ou les projets nécessitant des intégrations natives avec les fournisseurs cloud.
Veryfi
Veryfi est spécialisé dans l'OCR de documents financiers — reçus, factures, relevés bancaires, chèques et formulaires W-2. Contrairement aux API OCR généralistes qui renvoient du texte brut et vous laissent identifier les champs, Veryfi renvoie du JSON prêt pour la comptabilité : nom du marchand, date, total, taxes, lignes d'articles, type de paiement et catégorie. Cette spécialisation en fait le chemin le plus rapide entre le reçu scanné et l'écriture comptable.
Tarifs. Veryfi propose un niveau gratuit de 100 documents au total (pas par mois). Le plan Starter exige un engagement minimum de 500 $/mois, ce qui couvre environ 5 000 reçus ou 3 125 factures à 0,08 $ par reçu et 0,16 $ par facture. Cette structure tarifaire convient bien au traitement à volume élevé, mais crée une barrière d'entrée élevée pour les projets plus petits. Les plans Growth et Enterprise sont proposés sur devis personnalisé.
Support SDK. Python, Node.js, Java, Go, C# et PHP — une couverture solide des langages backend. Les SDK incluent une prise en charge intégrée du téléchargement de fichiers depuis des URL, des fichiers locaux et des images encodées en base64. Veryfi propose également des SDK mobiles pour la capture de documents sur iOS et Android.
Qualité de sortie. L'extraction de documents financiers de Veryfi est parmi les plus précises de son créneau. Son API LLM multimodale (AnyDocs) étend la même approche à des types de documents arbitraires. La réponse prend en charge plus de 38 langues, plus de 91 devises, des catégories et des lignes d'articles normalisées. Sur Reddit, dans les communautés r/bookkeeping et r/accounting, Veryfi est fréquemment cité comme l'API de référence pour les flux de travail axés sur les reçus.
Idéal pour les applications de gestion des dépenses, les produits fintech qui traitent des reçus et des factures à grande échelle, et les cabinets comptables qui créent des pipelines automatisés d'ingestion de données.
Moins adapté pour les besoins d'OCR à usage général (c'est excessif pour une simple extraction de texte), les évaluations à petite échelle (le minimum de 500 $ est difficile à justifier pour un prototype) ou les types de documents non financiers.
OCR.space
OCR.space est la meilleure API OCR gratuite pour les projets à volume élevé et à budget limité. Son offre gratuite — 25 000 requêtes par mois sans carte de crédit — est inégalée par toute autre API commerciale. Vous sacrifiez un peu de précision et de fonctionnalités par rapport au trio cloud, mais pour des documents imprimés propres où une précision de 90 à 95 % est acceptable, OCR.space est difficile à battre en termes de coût.
Tarifs. L'offre gratuite comprend 25 000 requêtes par mois (limite de 500/jour) avec une taille de fichier maximale de 1 Mo. Le plan PRO coûte 29,99 $/mois pour 300 000 requêtes, une taille de fichier de 5 Mo et un traitement plus rapide. Le plan PRO PDF (59,99 $/mois) ajoute la prise en charge des PDF multipages (jusqu'à 999 pages). Les plans Entreprise commencent à 999 $/mois pour des serveurs dédiés. Comparé aux API cloud à 1,50 $ pour 1 000 pages, l'offre gratuite d'OCR.space est en pratique illimitée pour les projets à faible volume.
Support SDK. OCR.space ne fournit pas de SDK spécifiques à un langage — la communication se fait via son API REST. Cependant, des wrappers maintenus par la communauté existent pour Python, JavaScript, PHP et Java. L'API renvoie du JSON avec des boîtes englobantes par mot et des scores de confiance.
Qualité de sortie. Sur du texte imprimé propre et à contraste élevé, OCR.space atteint environ 90 à 95 % de précision des caractères — suffisant pour des PDF consultables et l'extraction de données à partir de formulaires simples. La précision diminue avec les petites polices, les mises en page inhabituelles, l'écriture manuscrite ou les images basse résolution. Il n'existe pas d'extraction de tableaux native ; les données de tableaux sont renvoyées sous forme de texte avec des coordonnées de position mais sans structure de lignes/colonnes.
Idéal pour le prototypage et les MVP où le budget est la contrainte principale, les outils internes qui traitent des documents imprimés propres, et les développeurs qui ont besoin d'une API sans engagement pour tester les modèles d'intégration OCR avant de s'engager auprès d'un fournisseur payant.
Pas idéal pour les systèmes de production exigeant une précision de 99 % ou plus, les mises en page complexes (tableaux, formulaires), la reconnaissance de l'écriture manuscrite, ou tout scénario où la précision par document a un impact direct sur les résultats commerciaux.
Base64.ai
Base64.ai est une API OCR peu connue mais techniquement impressionnante, qui se positionne comme « une seule API pour tout document ». Elle prend en charge plus de 100 types de documents — des dossiers médicaux et formulaires d'assurance aux passeports, contrats et factures — avec des modèles de deep learning entraînés sur chaque type. Sa renommée repose sur la gestion des cas limites : pages pivotées, documents pliés, annotations manuscrites et pages à mise en page mixte.
Tarification. Base64.ai utilise une tarification personnalisée par page selon le type de document et le volume, sans niveau standard publiquement répertorié. Les utilisateurs potentiels contactent les ventes pour obtenir un devis, ce qui rend difficile l'évaluation du coût sans un projet pilote. Attendez-vous à des prix entre les API de niveau entreprise (niveau ABBYY) et les hyperscalers cloud.
Support SDK. API REST avec wrappers communautaires pour Python et JavaScript. L'intégration principale se fait via des requêtes HTTP directes avec des payloads JSON. Base64.ai s'intègre également avec Zapier et Slack pour l'automatisation des workflows.
Qualité de sortie. La qualité d'extraction de Base64.ai est solide pour les types de documents pris en charge, notamment les documents d'identité, les formulaires financiers et les dossiers médicaux. La réponse JSON inclut la confiance par champ, les boîtes englobantes et les étiquettes de classification de documents. Pour l'écriture manuscrite sur formulaires, elle surpasse Tesseract ou OCR.space mais reste derrière la reconnaissance d'écriture dédiée d'ABBYY.
Idéal pour les secteurs à forte densité documentaire (assurance, santé, juridique) qui traitent divers types de documents via une seule intégration, les équipes qui ont besoin d'un gestionnaire de compte dédié pour la configuration, et les scénarios où la classification de documents + l'extraction dans une seule API réduit la complexité architecturale.
Moins adapté pour les équipes soucieuses du budget (pas de tarification en libre-service), le prototypage rapide sans conversation commerciale, ou les projets nécessitant une infrastructure native du fournisseur cloud.
Mentions honorables : d'autres API à connaître
Au-delà des dix API présentées ci-dessus, plusieurs autres services méritent une brève mention pour des cas d'usage spécifiques :
LlamaParse est conçu spécifiquement pour les pipelines RAG et les agents documentaires. Il préserve la structure sémantique et génère du markdown, ce qui en fait un choix pertinent pour les ingénieurs IA qui construisent des systèmes de génération augmentée par récupération. La tarification commence avec un niveau gratuit de 1 000 pages par jour, puis $0.003 par page.
Clarifai propose une plateforme IA complète avec des capacités OCR via ses modèles de compréhension documentaire. Son plan à l'utilisation (maximum $100/mois par défaut) et son plan développeur à $1/mois (première année) en font l'une des options les plus abordables pour les équipes qui ont également besoin de reconnaissance d'images et d'entraînement de modèles sur la même plateforme.
Rossum est une plateforme IDP d'entreprise optimisée pour le traitement des factures à grande échelle. La tarification commence à $18,000/an, ce qui la place résolument dans la catégorie entreprise, aux côtés d'ABBYY. La force de Rossum réside dans son moteur de validation basé sur l'IA et ses intégrations ERP (SAP, Coupa, Workday), mais pour la plupart des cas d'usage développeur, le coût d'entrée est prohibitif.
Ces plateformes n'ont pas été incluses dans la comparaison principale car leur public cible (créateurs de pipelines RAG, utilisateurs de plateformes IA complètes, équipes AP d'entreprise) est plus restreint que le périmètre OCR généraliste pour développeurs de ce guide.
Quelle API correspond à votre cas d'usage ?
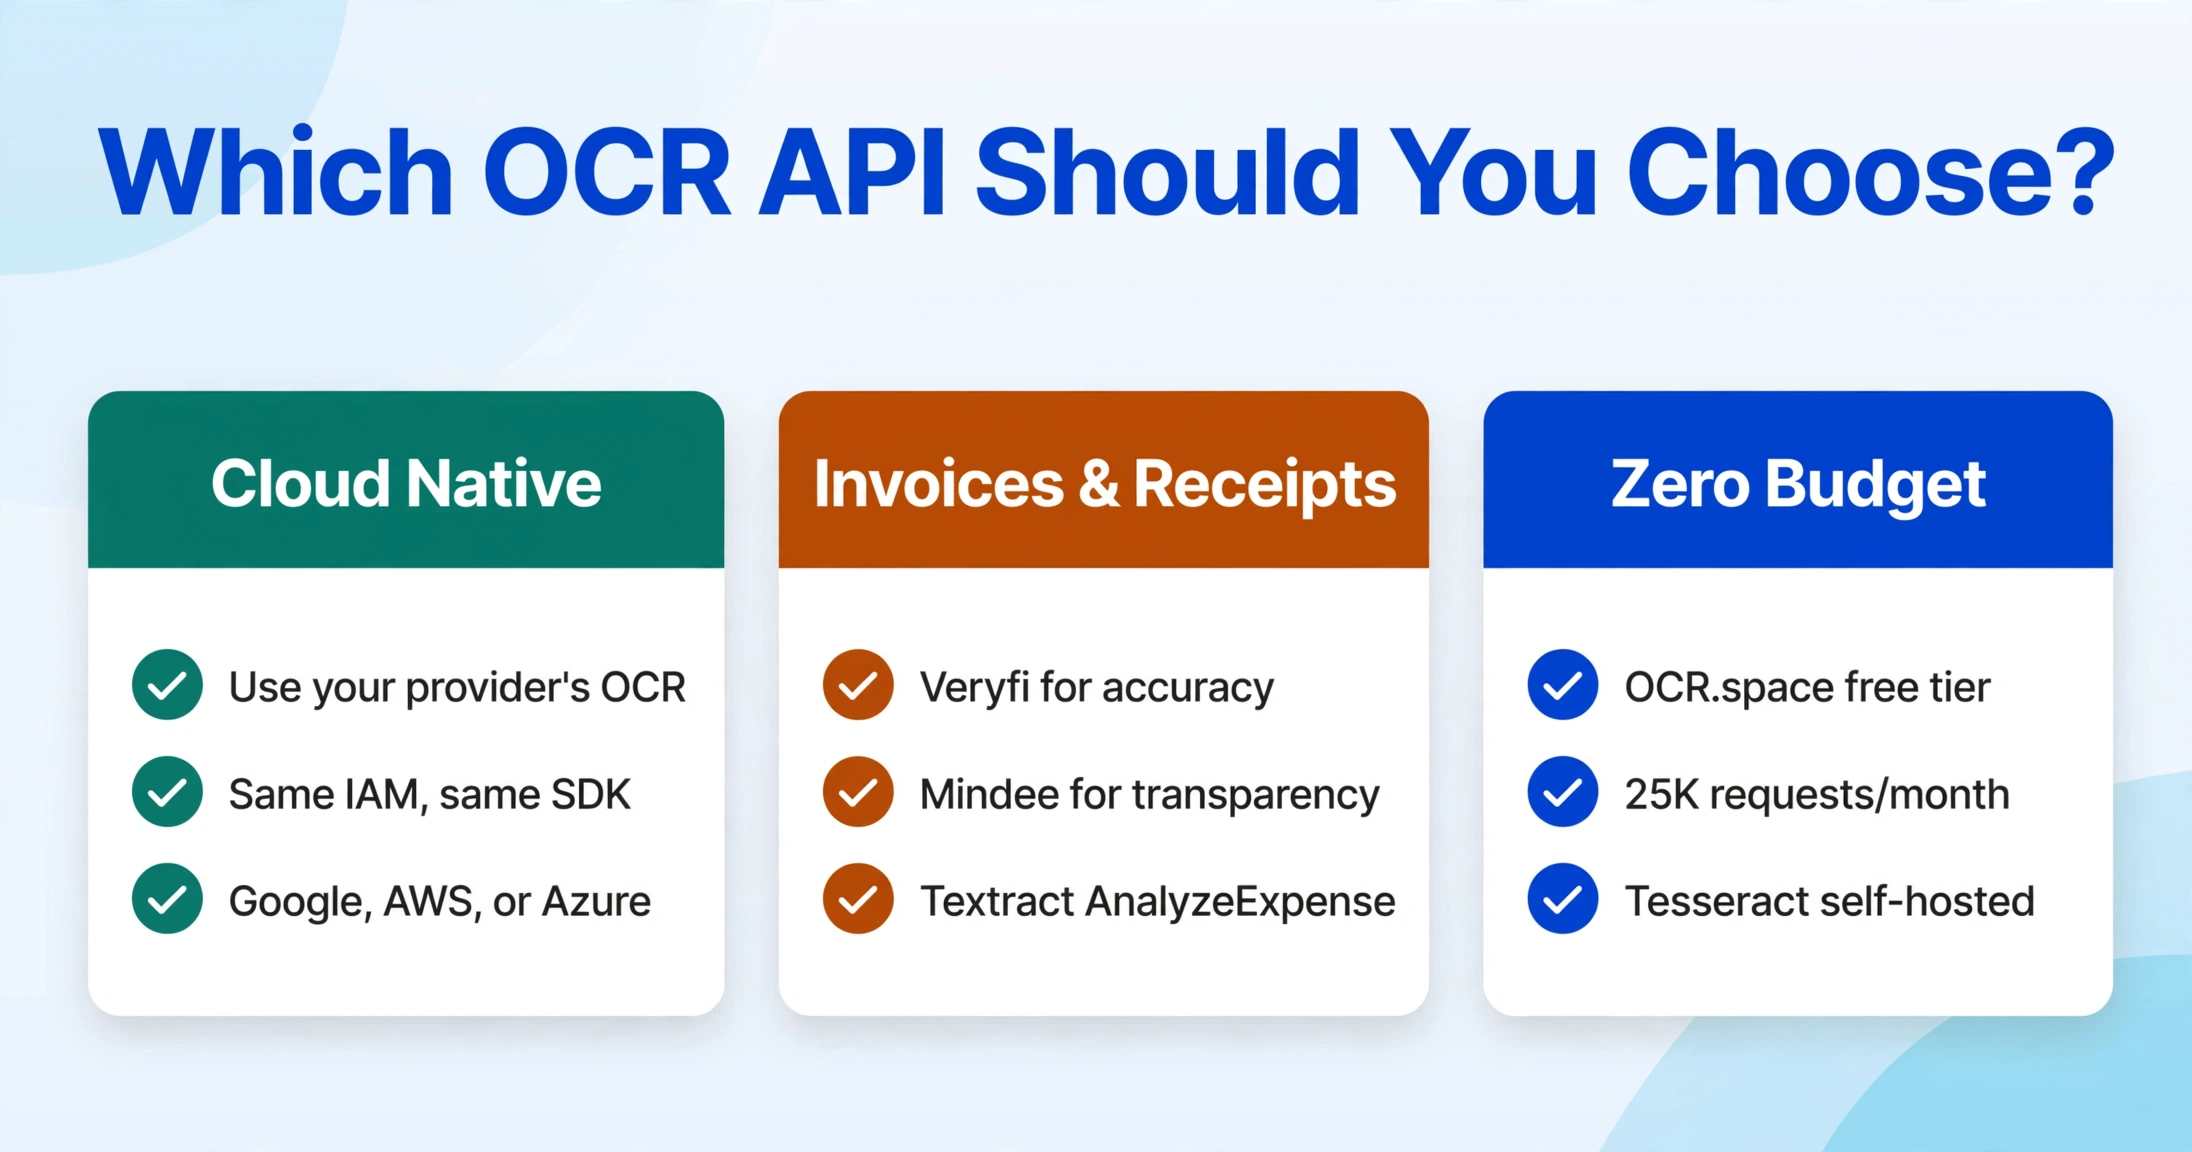
La réponse dépend de vos types de documents, de votre budget, de votre calendrier et de votre écosystème. Il n'existe pas de « meilleure API OCR » unique — le bon choix est celui qui minimise le coût total d'intégration, d'exploitation et de maintenance pour votre scénario spécifique. Voici six situations courantes et les API les plus adaptées :
Vous développez une fonctionnalité OCR générale et utilisez déjà Google Cloud, AWS ou Azure
Utilisez l'API OCR de votre fournisseur cloud. Les économies d'intégration à elles seules (même IAM, même SDK, même réseau) compensent les cas limites de précision. Google Cloud Vision pour le texte de scène et l'OCR de documents ; AWS Textract si vous avez besoin de formulaires et de tableaux ; Azure Document Intelligence si vous êtes dans l'écosystème Microsoft.
Vous traitez des factures et des reçus à grande échelle
Veryfi est conçu spécifiquement pour cela et offre la meilleure précision sur les documents financiers. Mindee est une excellente deuxième option avec une meilleure transparence des prix et sans minimum de 500 $/mois. L'API AnalyzeExpense d'AWS Textract (8–10 $/1K pages) est une alternative viable si vous êtes déjà sur AWS.
Vous avez besoin d'une extraction de tableaux et de formulaires haute fidélité
La fonctionnalité Tables d'AWS Textract reste la référence absolue pour la structure native de tableaux en JSON. Le modèle Layout d'Azure Document Intelligence est juste derrière, avec une meilleure extraction des cases à cocher et des marques de sélection. Pour la conformité en entreprise et la préservation de la mise en page, le SDK d'ABBYY est l'option la plus éprouvée.
Votre budget est proche de zéro et vos documents sont des pages imprimées propres
L'offre gratuite d'OCR.space (25 000 requêtes/mois) est la meilleure option. Si vous avez besoin d'une meilleure précision et pouvez investir du temps d'ingénierie, Tesseract avec un prétraitement approprié surpassera OCR.space en précision, au prix d'un effort de mise en place. Pour une comparaison des coûts entre OCR auto-hébergé et cloud, consultez notre guide des outils OCR open source.
Vous avez besoin d'une extraction de champs personnalisés à partir de documents non standard
Nanonets propose le pipeline de formation de modèles personnalisés le plus accessible — téléchargez des échantillons, définissez des champs et entraînez sans coder. Les modèles personnalisés de Mindee suivent un flux de travail similaire avec un prix d'entrée plus bas. Le Custom Extractor de Google Document AI et l'extraction personnalisée d'Azure fonctionnent tous deux, mais exigent une meilleure connaissance des plateformes cloud.
Vous souhaitez extraire des documents sans écrire de code d'intégration
Si votre équipe n'a pas la capacité de gérer les intégrations d'API, l'authentification, la gestion des erreurs et l'analyse des résultats, un outil sans code comme ImageToTable.ai offre la même capacité d'extraction via une interface web ou un module complémentaire Google Sheets — sans clé API, sans SDK, sans pipeline de déploiement. Téléchargez des fichiers ou des PDF, définissez vos colonnes et obtenez des données structurées en quelques secondes. Le compromis est le débit : les API excellent à l'échelle de l'automatisation, mais pour des ensembles de documents ponctuels ou des équipes sans ressources d'ingénierie dédiées, l'approche sans code offre un délai de rentabilisation plus rapide. Pour comprendre en quoi cette approche diffère de l'OCR traditionnel, lisez Qu'est-ce que l'OCR IA ?
Questions fréquemment posées
Quelle API OCR est la meilleure pour les développeurs créant une application de production ?
Mindee offre le meilleur équilibre entre expérience développeur, qualité de documentation, couverture SDK (7 langages) et tarification transparente pour des charges de production inférieures à 10 000 pages par mois. Pour les piles natives AWS, Textract est le choix logique. Pour les piles natives Google Cloud, Cloud Vision + Document AI. La « meilleure » API dépend davantage de votre infrastructure existante que de la précision brute de l'OCR, car toutes les grandes API cloud offrent une précision supérieure à 97 % sur des documents propres.
Quelle est l'API OCR la moins chère pour un traitement à volume élevé ?
Pour l'auto-hébergement, Tesseract est gratuit mais nécessite du temps d'ingénierie pour la mise en production. Pour une API gérée à grande échelle, le DetectDocumentText d'AWS Textract à 1,50 $/1K pages (et 0,60 $/1K au-delà de 1M pages) figure parmi les tarifs par page les plus bas. Le plan PRO d'OCR.space à 29,99 $/mois pour 300 000 requêtes est le meilleur rapport qualité-prix pour les volumes faibles à moyens. À très haut volume (1M+ pages/mois), négocier des tarifs personnalisés avec un grand fournisseur permet généralement d'obtenir le coût par page le plus bas.
Les API OCR peuvent-elles gérer l'écriture manuscrite ?
Oui, mais la qualité varie considérablement. ABBYY Cloud OCR SDK possède la reconnaissance d'écriture imprimée la plus aboutie, prenant en charge 126 langues manuscrites dans son mode ICR basé sur des zones. La prise en charge de l'écriture manuscrite de Google Cloud Vision couvre raisonnablement bien l'écriture imprimée. Pour l'écriture cursive ou les documents mixtes, les approches plus récentes basées sur des modèles vision-langage (Gemini, GPT-5, Mistral OCR 3 accessibles via des API cloud) surpassent souvent les moteurs OCR traditionnels — mais à un coût par page plus élevé. Consultez notre guide OCR pour l'écriture manuscrite pour une comparaison plus approfondie.
L'API OCR préserve-t-elle la structure des tableaux ?
AWS Textract renvoie un JSON de tableau natif avec lignes et colonnes, accompagné de scores de confiance par cellule — c'est la sortie de tableau la plus conviviale pour les développeurs. Le modèle Layout d'Azure Document Intelligence préserve également la structure des tableaux avec des boîtes englobantes. Document AI de Google Cloud Vision renvoie des blocs de tableau mais nécessite plus de post-traitement pour une reconstruction structurelle fiable. Tesseract et OCR.space renvoient du texte avec des données de position mais sans inférence de structure de tableau.
Quelles API OCR prennent en charge le plus de langages de programmation ?
Google Cloud Vision, AWS Textract et Mindee proposent tous des SDK propriétaires pour Python, Node.js, Java, Go et au moins trois langages supplémentaires. Le SDK .NET d'Azure Document Intelligence est particulièrement solide. Pour la prise en charge des langages de niche (PHP, Ruby), Google et AWS offrent la couverture la plus large sur l'ensemble de leurs SDK.
Quels niveaux gratuits d'API OCR sont disponibles en 2026 ?
OCR.space offre le niveau gratuit le plus généreux avec 25 000 requêtes/mois. Google Cloud Vision propose 1 000 unités/mois gratuitement. AWS Textract offre 1 000 pages/mois pendant les 3 premiers mois. Azure Document Intelligence donne 500 pages/mois. Le plan Développeur de Mindee inclut 250 pages/mois gratuites sans carte de crédit requise. Veryfi inclut 100 documents gratuits (non récurrents). Tesseract est gratuit mais auto-hébergé.
Quelles API prennent en charge le traitement synchrone et asynchrone ?
Google Cloud Vision, AWS Textract et Azure Document Intelligence prennent tous en charge les modes synchrone (page unique, latence inférieure à la seconde) et asynchrone (lot multipage). Mindee, Veryfi et Nanonets utilisent par défaut le traitement synchrone avec des options asynchrones disponibles pour les charges de travail par lots. OCR.space est uniquement synchrone. Pour les applications interactives, assurez-vous que l'API choisie offre des réponses synchrones en moins de 2 secondes.
Puis-je exécuter des API OCR sur site ou dans un cloud privé ?
Tesseract et d'autres moteurs open source (PaddleOCR, EasyOCR) fonctionnent partout. ABBYY propose un déploiement sur site pour sa plateforme FlexiCapture. AWS Textract, Google Cloud Vision et Azure Document Intelligence sont exclusivement cloud, bien qu'Azure fournisse des déploiements de conteneurs connectés pour certaines fonctionnalités de Document Intelligence. Pour les données sensibles (PII, PHI), Tesseract avec prétraitement local suivi d'un appel API cloud (avec masquage des données) est un modèle hybride courant.
Et si je ne souhaite pas du tout intégrer d'API OCR ?
Les API OCR sont le bon choix lorsque vous avez besoin d'un accès programmatique à grande échelle. Mais si vous traitez des documents occasionnellement — ou si votre équipe n'a pas la capacité d'ingénierie pour l'intégration d'API — les outils d'extraction sans code offrent un chemin plus rapide vers des données structurées. ImageToTable.ai vous permet de télécharger des documents, de nommer vos colonnes et d'obtenir une sortie de tableau structurée sans écrire de code. Le module complémentaire Google Sheets va plus loin : téléchargez directement depuis votre feuille de calcul et obtenez des données ajoutées à la feuille active — sans clé API, sans SDK, sans serveur à gérer. C'est un compromis différent d'une API OCR (moins d'automatisation, zéro configuration), mais pour le bon cas d'usage, c'est la réponse la plus rapide.
Quelle API OCR prend en charge le plus de langues ?
ABBYY Cloud OCR SDK est en tête avec plus de 200 langues imprimées et 126 langues manuscrites. Google Cloud Vision prend en charge plus de 200 langues via son pipeline Document AI. Tesseract prend en charge plus de 100 langues avec des packs linguistiques disponibles pour la plupart des écritures. Azure Document Intelligence et AWS Textract prennent en charge environ 100 langues chacun. Pour les langues d'Asie de l'Est (chinois, japonais, coréen), Google Cloud Vision et ABBYY offrent généralement la plus grande précision. Pour les langues européennes, toutes les principales API cloud offrent des performances similaires.
Existe-t-il des benchmarks indépendants comparant la précision des API OCR ?
Plusieurs benchmarks indépendants suivent la précision des modèles OCR. Le benchmark olmOCR de l'Allen Institute for AI évalue la compréhension des documents et la préservation de la structure. OmniDocBench couvre la qualité d'extraction de documents multi-formats. Le classement IDP suit la précision d'extraction pour les factures, reçus et documents d'identité. Début 2026, Nanonets OCR-3 a obtenu un score de 93,1 sur olmOCR, tandis que GPT-5.2 et Gemini 3 Pro mènent les approches basées sur VLM en termes de précision combinée et de compréhension des formulaires. Ces benchmarks sont mis à jour fréquemment — consultez la source pour les derniers classements.