Beste OCR-API
2026: 10 Entwickler-APIs im Vergleich nach Genauigkeit & Preis
Dieser Vergleich bewertet 10 OCR-APIs anhand von sechs Kriterien – Genauigkeit bei gedrucktem und handschriftlichem Text, Preis pro Seite in mehreren Volumenstufen, SDK-Sprachunterstützung, Qualität des Ausgabeformats, Latenzprofil und Integration in Cloud-Ökosysteme –, um Ihnen eine fundierte Entscheidung für Ihr nächstes Projekt zu ermöglichen. Jede API wurde anhand öffentlich dokumentierter Spezifikationen, offizieller Preisseiten und Feedback aus der Entwickler-Community bewertet. Hinweis: Dieser Artikel enthält neben neun APIs auch ein No-Code-Tool als Kontext. Alle Preisdaten wurden Stand Juni 2026 anhand offizieller Quellen verifiziert. Links zu Drittanbieterdiensten verwenden nofollow.
Wichtigste Erkenntnisse
- Ein Listenpreis von $1,50 pro 1.000 Seiten verdeckt einen 33-fachen Kostenmultiplikator – aktivieren Sie die Formularerkennung in Textract und Ihre Rechnung springt auf $51,50 pro 1.000 Seiten, bevor Sie auch nur eine einzige Tabelle verarbeitet haben.
- Jede große OCR-API liefert 97–99 % Genauigkeit bei sauberen Dokumenten – sich über Benchmark-Ergebnisse Gedanken zu machen, verschwendet die eine Ressource, die Sie nicht zurückkaufen können: die Entwicklerwochen, die Ihr Team für SDK-Integration, IAM-Konfiguration und Pipeline-Aufbau aufwenden wird.
- „Die beste OCR-API“ ist die falsche Frage – beginnen Sie mit der Cloud, für die Sie bereits zahlen, dem SDK, das Ihr Team kennt, und den Dokumenttypen, die Sie tatsächlich erhalten, und wählen Sie dann die API, die den Integrationsaufwand minimiert.
Schnellvergleich: 10 OCR-APIs auf einen Blick
Die folgende Tabelle fasst jede API nach ihrer wichtigsten Stärke, ihrem Einstiegspreis, ihrer Dokumenttyp-Spezialisierung und den Ökosystemen zusammen, in die sie sich natürlich integriert. Nutzen Sie sie als erste Filterung und lesen Sie dann den vollständigen Abschnitt für die API, die Sie favorisieren.
| API | Am besten geeignet für | Einstiegspreis | Dokumente | Cloud-Ökosystem |
|---|---|---|---|---|
| Google Cloud Vision | Allgemeine OCR + Szenentext | Kostenlos: 1K/Monat; danach $1.50/1K | Beliebig (Bilder, PDFs) | Google Cloud (Doc AI, Storage, BigQuery) |
| AWS Textract | Formulare, Tabellen, strukturierte Dokumente | Kostenlos: 1K/Monat (3 Monate); danach $1.50/1K | Formulare, Tabellen, Rechnungen, Belege, Ausweise | AWS (S3, Lambda, Comprehend, SQS) |
| Azure Document Intelligence | Vorgefertigte Modelle + Microsoft-Stack | Kostenlos: 500/Monat; danach $1.50/1K Read | Rechnungen, Belege, Ausweise, Gesundheitskarten, Verträge | Azure (Logic Apps, Power Automate, Purview) |
| Tesseract | Kostenlose selbstgehostete OCR | Kostenlos (nur Rechenkosten) | Saubere gedruckte Dokumente | Selbstgehostet (Linux, Windows, macOS) |
| ABBYY Cloud OCR SDK | Hochpräzise OCR für Unternehmen | $99/Monat (5K Seiten) | Beliebig (200+ Sprachen, Handschrift) | Azure-gehostet, On-Premises verfügbar |
| Mindee | Entwicklererlebnis + vortrainierte Modelle | Kostenlos: 250/Monat; ab €44/Monat (500 Credits) | Rechnungen, Belege, Ausweise, Pässe, Lebensläufe | Standalone-API (keine Ökosystem-Bindung) |
| Nanonets | Benutzerdefiniertes Modelltraining + Workflows | $499/Monat (10K Seiten) | Benutzerdefinierte Dokumenttypen, Rechnungen, Belege | Standalone + Integrationen (Zapier, QuickBooks) |
| Veryfi | Belege, Rechnungen, Finanzdokumente | Kostenlos: 100 Dokumente; min. $500/Monat (Starter) | Belege, Rechnungen, Kontoauszüge, Schecks | Standalone + QuickBooks, Xero-Integrationen |
| OCR.space | Kostenlose Budget-OCR bei hohem Volumen | Kostenlos: 25K Anfragen/Monat; $30/Monat (PRO) | Saubere Textdokumente, mehrseitige PDFs | Standalone-API (ohne Schnickschnack) |
| Base64.ai | Beliebiger Dokumenttyp, eine API | Individuelle Preisgestaltung (pro Seite) | 100+ Dokumenttypen, Handschrift, Tabellen | Standalone-API + Slack, Zapier |
So haben wir diese APIs ausgewählt und bewertet
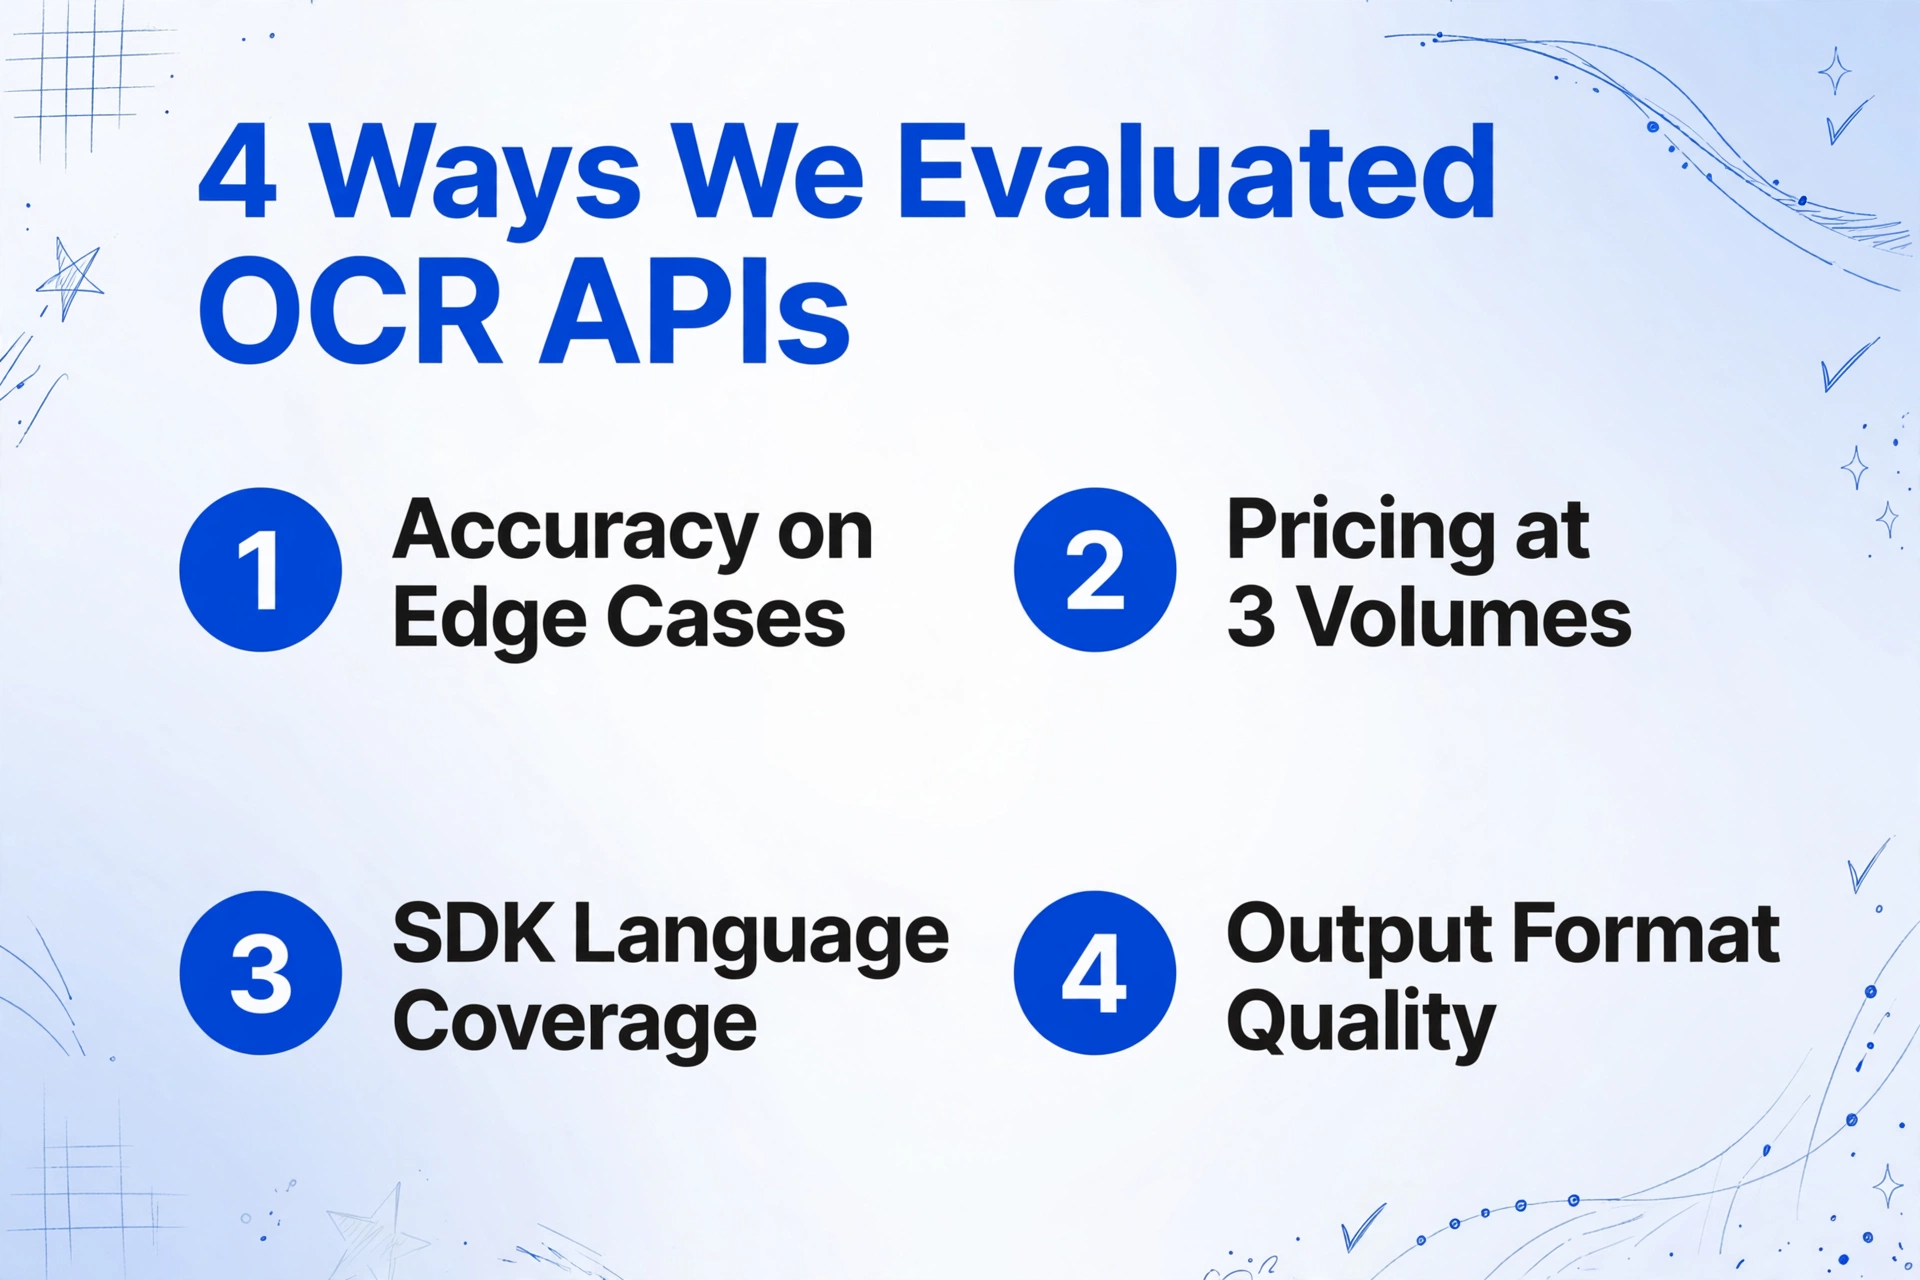
Jede unten aufgeführte Bewertungsdimension wurde anhand der offiziellen Dokumentation, veröffentlichter Preisseiten und Entwickler-SDK-Repositories verifiziert. Wo unabhängige Benchmarks existierten (olmOCR-Benchmark, OmniDocBench, IDP-Leaderboard), wurden diese mit praxisnahen Entwicklerberichten aus Stack-Overflow- und Reddit-Communities abgeglichen.
1. Genauigkeit – gedruckter Text, Handschrift, Tabellen und Formulare
Bei gedrucktem Text auf sauberen Dokumenten liefern alle großen Cloud-APIs unter normalen Bedingungen eine Genauigkeit von 97–99 %. Die Unterschiede zeigen sich bei Handschrift, Scans in geringer Qualität, komplexen Tabellen und mehrsprachigen Dokumenten. Wir haben die angegebenen Genauigkeitsbereiche jeder API für diese Randfälle bewertet und die Bestätigung der realen Leistung durch die Community abgewogen.
2. Preisgestaltung – pro Seite, pro 1.000 Seiten und versteckte Kosten
Die Preisgestaltung von OCR-APIs wirkt auf den ersten Blick täuschend einfach: Die meisten Anbieter nennen einen Richtpreis von $1.50 pro 1.000 Seiten. Die tatsächlichen Kosten hängen davon ab, welchen API-Endpunkt Sie verwenden (Basistext vs. Formularanalyse vs. benutzerdefinierte Abfragen) und ob Sie innerhalb der ersten Preisstufe bleiben. Wir haben die Gesamtkosten auf drei Volumenstufen berechnet: 1.000 Seiten, 10.000 Seiten und 100.000 Seiten pro Monat.
3. SDK- und Sprachunterstützung
Ein gutes SDK macht den Unterschied zwischen einer Integration an einem Tag und einer einwöchigen Tortur. Wir haben die Verfügbarkeit offizieller SDKs für Python, Node.js, Java, Go, .NET, Ruby und PHP geprüft – die sieben Sprachen, die die überwiegende Mehrheit der Backend- und Datenverarbeitungsanwendungsfälle abdecken.
4. Qualität des Ausgabeformats
Rohtext ist die Grundvoraussetzung. Der entscheidende Faktor ist, ob die API Begrenzungsrahmen-Koordinaten pro Wort oder Zeile zurückgibt, die hierarchische Tabellenstruktur beibehält, Schlüssel-Wert-Paare aus Formularen extrahiert und Konfidenzwerte ausgibt. Wir haben jede API anhand des Umfangs ihrer JSON-Antwort bewertet.
5. Latenz und Durchsatz
Synchrone Antworten unter zwei Sekunden sind für interaktive Anwendungen unerlässlich. Der Batch-Durchsatz (Seiten pro Minute bei Skalierung) ist für Hintergrundverarbeitungspipelines wichtig. Wir haben die dokumentierten Latenzeigenschaften jeder API notiert.
6. Cloud-Ökosystem und native Integrationen
Eine API, die direkt eine Verbindung zu S3, Cloud Storage oder Blob Storage herstellt – und extrahierte Daten in ein Data Warehouse oder ERP einspeist – spart Wochen an Pipeline-Entwicklung. Wir haben die Integrationstiefe jeder API mit ihrer übergeordneten Cloud-Plattform und Drittanbieterdiensten bewertet.
Google Cloud Vision API
Google Cloud Vision ist die breiteste OCR-API auf dem Markt – nicht weil sie für jeden Dokumenttyp die genaueste ist, sondern weil sie alles von Straßenschildern bis zu dichten Vertragsseiten über einen einzigen Endpunkt verarbeitet. Sie unterteilt OCR in zwei Aufrufe: TEXT_DETECTION für Szenentext (Schilder, Etiketten, Fotos) und DOCUMENT_TEXT_DETECTION für dichte Dokumentseiten, wobei letzteres über die Document-AI-Pipeline von Google optimiert wird.
Preise. Die ersten 1.000 Einheiten pro Monat und Funktion sind kostenlos. Danach kostet die Texterkennung $1.50 pro 1.000 Bilder bis zu 5 Millionen und sinkt darüber hinaus auf $0.60. Die Dokumenttexterkennung folgt derselben Stufe. Über Document AI kosten spezialisierte Prozessoren (Rechnungs-Parser, Spesen-Parser) $0.10 pro 10 Seiten – deutlich günstiger als die Formularanalyse von Textract für Finanzdokumente.
SDK-Unterstützung. Python, Node.js, Java, Go, C#, PHP und Ruby – alle First-Party, alle gepflegt. Die Client-Bibliotheken von Google gehören zu den ausgereiftesten im Cloud-OCR-Bereich.
Ausgabequalität. Die JSON-Antwort enthält Begrenzungsrahmen-Koordinaten pro Wort, Konfidenzwerte und Layout-Blöcke auf Seitenebene. Document-AI-Prozessoren fügen Schlüssel-Wert-Paare und Tabellenstrukturen hinzu, obwohl die Tabellenrekonstruktion im Vergleich zur nativen Tabellenausgabe von Textract eine Nachbearbeitung erfordert.
Am besten geeignet für Teams, die bereits Google Cloud nutzen, Anwendungen, die sowohl Szenentext-OCR als auch Dokument-OCR über ein SDK benötigen, und Projekte, die später von Vertex-AI- oder BigQuery-Integrationen profitieren.
Nicht ideal für umfangreiche Tabellenextraktion in großem Maßstab (Textract ist günstiger und strukturierter) oder Workflows, die cloud-agnostisch bleiben müssen.
AWS Textract
Amazon Textract wurde speziell für das Verständnis von Dokumenten entwickelt und nicht für die allgemeine Bildanalyse – und das zeigt sich. Die AnalyzeDocument-API bietet separate Feature-Flags für Tabellen, Formulare, Abfragen und Signaturen, sodass Sie nur für die Extraktionstiefe zahlen, die Sie benötigen. Das Tabellen-Feature liefert native Zeilen- und Spaltenstruktur mit Konfidenzwerten pro Zelle; das Formular-Feature extrahiert Schlüssel-Wert-Paare ohne jegliche Vorlagenkonfiguration.
Preise. Basic DetectDocumentText kostet $1.50 pro 1.000 Seiten (erste 1M) und $0.60 darüber hinaus. Tabellen kosten zusätzlich $15 pro 1.000 Seiten; Formulare $50 pro 1.000 Seiten; Abfragen $15 pro 1.000 Seiten. Für die Rechnungsverarbeitung kostet die AnalyzeExpense-API $8–10 pro 1.000 Seiten – speziell für Finanzdokumente entwickelt und in der Regel genauer als die allgemeine Formularanalyse. Die kostenlose Stufe umfasst 1.000 Seiten DetectDocumentText pro Monat für die ersten drei Monate.
SDK-Unterstützung. Python, Node.js, Java, Go, .NET, PHP, Ruby – alle First-Party-AWS-SDKs. Die Paginierungs- und Async-APIs von Textract sind gut dokumentiert mit funktionierenden Beispielen in jeder Sprache.
Ausgabequalität. Die Tabellenausgabe von Textract ist der Branchenmaßstab für strukturierte Extraktion. Die JSON-Antwort bewahrt Zeilenspannen, Spaltenspannen, verbundene Zellen und Konfidenzwerte pro Zelle. Die Formularextraktion liefert Schlüssel-Wert-Paare mit Begrenzungsrahmen und Beziehungen. Abfragen unterstützen natürlichsprachliche Fragen an Dokumente – eine einzigartige Fähigkeit für Ad-hoc-Feldextraktion.
Am besten geeignet für AWS-native Stacks, Projekte, die hochpräzise Tabellen- oder Formularextraktion benötigen, und Teams, die OCR mit Lambda, S3-Event-Triggern oder Step Functions für Dokumentverarbeitungspipelines kombinieren möchten.
Nicht ideal für allgemeine Szenentext-OCR (Vision API ist besser) oder Teams, die vorhersehbare Kosten ohne feature-basierte Preisstufen wünschen.
Azure Document Intelligence
Azure Document Intelligence (ehemals Azure Form Recognizer) bietet die engste Integration in das Microsoft-Ökosystem – Logic Apps, Power Automate, Power BI und SharePoint. Die vorgefertigten Modelle decken Rechnungen, Belege, Ausweisdokumente, Krankenversicherungskarten, W-2-Formulare, 1098-Steuerformulare und Verträge ab. Das Layout-Modell extrahiert Tabellen und Text unter Beibehaltung der Struktur.
Preise. Das Read-Modell (grundlegende OCR + Layout) kostet $1,50 pro 1.000 Seiten, mit 500 kostenlosen Seiten pro Monat. Die Analyse vorgefertigter Dokumente kostet etwa $10 pro 1.000 Seiten. Die benutzerdefinierte Extraktion beginnt bei $30 pro 1.000 Seiten für Training und Inferenz. Die 500 kostenlosen Seiten pro Monat im kostenlosen Tarif sind weniger großzügig als die 1.000 von Google, aber für Prototypen ausreichend.
SDK-Unterstützung. Python, Node.js, Java, .NET (C#) und Go – starke First-Party-Unterstützung. Das .NET-SDK ist besonders gut gepflegt, was die Enterprise-.NET-Kundenbasis von Azure widerspiegelt.
Ausgabequalität. Das Layout-Modell liefert Tabellen, Auswahlmarkierungen (Kontrollkästchen) und Absatzstrukturen mit Begrenzungsrahmen und Konfidenzwerten. Vorgefertigte Modelle ergänzen die dokumentspezifische Feldextraktion (z.B. Rechnungspositionen, Händlername auf Belegen). Die JSON-Ausgabe ist gut strukturiert, aber bei komplexen Tabellenszenarien weniger detailliert pro Zelle als Textract.
Am besten geeignet für Organisationen, die bereits Microsoft 365 oder Azure nutzen, Szenarien mit Power-Automate-Workflows und Teams, die vorgefertigte Compliance-Dokumentation (SOC 2, HIPAA, GDPR) schätzen.
Nicht ideal für hohe OCR-Grundvolumina, bei denen OCR.space oder Tesseract günstiger wären, oder Teams, die die SDK-Reife von Google oder AWS bevorzugen.
Tesseract (Self-Hosted Open Source)
Tesseract, ursprünglich von HP entwickelt und heute von Google gepflegt, bleibt der Standardausgangspunkt für Entwickler, die die volle Kontrolle über ihre OCR-Pipeline wünschen. Es unterstützt über 100 Sprachen, läuft auf jeder Plattform und kostet nichts außer Rechenleistung. Aber „kostenlos“ ist nicht dasselbe wie „günstig“ – der Engineering-Aufwand, um Tesseract produktionsreif zu machen, kann die Kosten eines Cloud-API-Abonnements innerhalb weniger Wochen übersteigen.
Preise. Kostenlos. Die einzigen Kosten sind die Infrastruktur: eine bescheidene VM oder ein Container. Für die Verarbeitung großer Mengen (über 1 Mio. Seiten/Monat) amortisiert sich selbst gehostetes Tesseract auf einer CPU-Instanz in der Regel zwischen 100.000 und 130.000 Seiten pro Monat, je nach Dokumentkomplexität.
SDK-Unterstützung. Python (pytesseract), C++ (nativ), Java (Tess4J), Node.js (tesseract.js). Der Python-Wrapper ist am weitesten verbreitet, mit umfangreicher Community-Dokumentation und Stack-Overflow-Abdeckung. Die SDK-Reife variiert jedoch erheblich – tesseract.js läuft vollständig im Browser, ist aber langsamer als die native Version.
Ausgabequalität. Bei sauberen gedruckten Dokumenten mit guter Auflösung und einheitlichem Hintergrund erreicht Tesseract eine Wortgenauigkeit von 95–99 %. Bei minderwertigen Scans, schiefen Seiten oder Dokumenten mit dekorativen Schriftarten sinkt die Genauigkeit stark. Die native Unterstützung für Tabellenstrukturen ist minimal – die Ausgabe ist flacher Text mit Leerzeichenpositionierung. Handschrifterkennung ist ohne zusätzliches Modelltraining nicht zuverlässig. Die Ausgabeformate hocr und ALTO liefern Begrenzungsrahmen, aber kein semantisches Verständnis der Felder.
Am besten geeignet für Teams, die Datenhoheit benötigen (keine Daten verlassen den Server), Hochvolumenverarbeitung, bei der die Infrastrukturkosten niedriger sind als API-Seitenpreise, und Entwickler, die sich mit der Feinabstimmung von Vorverarbeitungspipelines (Deskew, Binarisierung, Seitenaufteilung) auskennen.
Nicht ideal für Teams, die produktionsreife Extraktion in Tagen statt Wochen benötigen, Dokumente mit komplexen Layouts oder Handschrift, oder jedes Szenario, in dem der Wartungsaufwand minimal sein soll.
Für einen tieferen Vergleich zwischen Tesseract und modernen Extraktionsansätzen, lesen Sie unseren Artikel über OCR vs. KI-Extraktion.
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDK ist seit über drei Jahrzehnten im OCR-Geschäft tätig, und sein Cloud OCR SDK spiegelt diese Reife wider. Es unterstützt über 200 Erkennungssprachen (einschließlich 126 handschriftlicher Sprachen), bewahrt das Dokumentlayout mit hoher Genauigkeit und handhabt zonenbasierte Extraktion neben OCR für ganze Seiten. ABBYYs Stärke ist die Konsistenz bei unterschiedlicher Eingabequalität – wo Tesseract bei einem leicht schief gescannten Dokument Probleme haben könnte, gleicht ABBYYs Vorverarbeitungs-Engine dies aus.
Preise. Cloud OCR SDK beginnt bei $99 pro Monat für 5.000 Seiten. Enterprise-Bereitstellungen (1M+ Seiten/Jahr) verhandeln in der Regel Seitenpreise im Bereich von $0,02–$0,10 mit Jahresverträgen ab etwa $15.000. Es gibt keine dauerhaft kostenlose Stufe, nur Testversionen. Für kleine Teams macht dies ABBYY deutlich teurer als Cloud-Hyperscaler-APIs.
SDK-Unterstützung. Python, Java, .NET (C#) und C++ – solide, aber enger als das Cloud-Trio. Die REST API ist vollständig dokumentiert, und Codebeispiele sind für alle unterstützten Sprachen verfügbar.
Ausgabequalität. ABBYYs Layout-Erhalt gehört zu den besten der Branche – es rekonstruiert die ursprüngliche Dokumentstruktur einschließlich Spalten, Tabellen, Kopf- und Fußzeilen. Seine XML-Ausgabe (über die FineReader-Engine) ist das reichhaltigste Format für die nachgelagerte Dokumentverarbeitung. Handschrifterkennung in 126 Sprachen ist ein Unterscheidungsmerkmal, das nur eine Handvoll APIs erreicht.
Am besten geeignet für Enterprise-Dokumentdigitalisierungsprojekte, bei denen Layouttreue entscheidend ist, regulierte Branchen (Finanzen, Gesundheitswesen, Behörden), die On-Premises-Bereitstellungsoptionen benötigen, und mehrsprachige OCR im großen Maßstab für Druck und Handschrift.
Nicht ideal für Startups oder kleine Teams mit begrenztem Budget, schnelles Prototyping oder Projekte, bei denen die Kosten pro Seite unter $0,01 bleiben müssen.
Mindee
Mindee ist eine der entwicklerfreundlichsten OCR-APIs auf dem Markt. Die Dokumentation ist klar, die API-Antworten sind konsistent, und die vortrainierten Modelle (Rechnungen, Belege, Reisepässe, Führerscheine, Lebensläufe und mehr) funktionieren ohne Trainingsschritt sofort. Mindee trifft eine bewusste Designentscheidung: Statt einen generischen OCR-Endpunkt anzubieten und die Extraktionslogik Ihnen zu überlassen, liefert es feldbezogenes JSON, das direkt auf Ihr Datenmodell abgebildet werden kann.
Preise. Der Developer-Plan ist kostenlos für 250 Seiten pro Monat (keine Kreditkarte erforderlich). Kostenpflichtige Pläne starten bei €44/Monat (ca. $47) für 500 Seiten bei jährlicher Abrechnung, mit zusätzlichen Seiten für €0,05 pro Seite. Der Pro-Plan (€179/Monat) umfasst 2.500 Seiten bei €0,04 pro zusätzlicher Seite. Enterprise-Preise sinken bei hohem Volumen auf etwa €0,01 pro Seite. Dies ist eine der transparentesten Preisstrukturen im OCR-API-Bereich – keine versteckten Stufen oder überraschenden Feature-Kosten.
SDK-Unterstützung. Python, Node.js, Java, Go, Ruby, PHP und .NET – die breiteste SDK-Abdeckung außerhalb der drei großen Cloud-Anbieter. Alle SDKs werden automatisch aus der OpenAPI-Spezifikation generiert, was bedeutet, dass sie mit der API aktuell bleiben. Auf Reddit r/programming und r/MachineLearning wird das Python-SDK von Mindee häufig als das intuitivste für schnelles Prototyping genannt.
Ausgabequalität. Mindees feldbezogene Extraktion liefert strukturiertes JSON mit Konfidenzwerten pro Feld. Bei Rechnungen bedeutet das Positionsarrays mit Beschreibungen, Mengen, Einzelpreisen und Summen – nicht Rohtext, den Sie selbst parsen müssen. Der Kompromiss ist, dass Mindee für bestimmte Dokumenttypen optimiert ist und nicht für beliebige Dokumente; für ein generisches Formular mit benutzerdefinierten Feldern müssten Sie ein eigenes Modell trainieren.
Am besten geeignet für Entwickler, die feldbezogenes JSON sofort benötigen (ohne Regex-Nachbearbeitung), Teams, die Wert auf Dokumentationsqualität und SDK-Reife legen, und Projekte, die Standarddokumenttypen verarbeiten (Rechnungen, Belege, Ausweise, Reisepässe, Lebensläufe).
Nicht ideal für beliebige Dokumentlayouts ohne vordefinierte Modelle, Szenentext-OCR (Straßenschilder, Whiteboards) oder Anwendungsfälle, bei denen eine lokale Bereitstellung zwingend erforderlich ist.
Nanonets
Nanonets positioniert sich zwischen OCR API und KI-Workflow-Plattform. Das Hauptunterscheidungsmerkmal ist das Training benutzerdefinierter Modelle – Sie laden Beispieldokumente hoch und Nanonets lernt, die für Sie relevanten Felder zu extrahieren, ohne Extraktionsregeln schreiben zu müssen. Für Teams, die nicht standardisierte Dokumente verarbeiten, liefert dieser trainingsbasierte Ansatz oft bessere Genauigkeit als generische vortrainierte Modelle.
Preise. Nanonets startet bei 499 $ pro Monat für bis zu 10.000 Seiten – ein deutlicher Sprung gegenüber den Preisen der Cloud-APIs. Zusätzliche Extraktion kostet ca. 0,30 $ pro Seite, plus separate Gebühren für Formatierung, Lookups und Premium-Integrationen. Entwicklerbewertungen auf G2 und Reddit nennen häufig die schwer kalkulierbaren Kosten als Bedenken, wenn das Volumen steigt. Der kostenlose Tarif bietet 500 Seiten mit Kreditkarte.
SDK-Unterstützung. Python, Node.js, Java und Go – diese vier decken die meisten Anwendungsfälle ab. Das Python-SDK ist am funktionsreichsten, mit Beispielen für Batch-Verarbeitung, Training benutzerdefinierter Modelle und Workflow-Automatisierung.
Ausgabequalität. Für Dokumente, die zu Ihrem Trainingssatz passen, erreicht Nanonets eine hohe Feldgenauigkeit. Das aktuelle Nanonets OCR-3-Modell (veröffentlicht April 2026) erzielte 93,1 im olmOCR-Benchmark und 90,5 in OmniDocBench und liegt damit in der Spitzengruppe der kommerziellen OCR-Modelle. Die JSON-Ausgabe enthält Konfidenzwerte und Begrenzungsrahmen pro Feld.
Am besten geeignet für Teams, die benutzerdefinierte Felder aus nicht standardisierten Dokumenten extrahieren müssen, Organisationen, die von der integrierten Workflow-Engine profitieren (Genehmigungen, Validierungen, Slack-Benachrichtigungen), und mittelständische Unternehmen, die OCR plus Workflow in einer Plattform möchten.
Weniger geeignet für Teams mit knappem Budget (die Preise steigen schnell), einfache Textextraktion, bei der Tesseract oder OCR.space ausreichen würden, oder Projekte, die native Integrationen des Cloud-Anbieters benötigen.
Veryfi
Veryfi ist auf die OCR-Erfassung von Finanzdokumenten spezialisiert – Quittungen, Rechnungen, Kontoauszüge, Schecks und W-2-Formulare. Im Gegensatz zu allgemeinen OCR-APIs, die Rohtext zurückgeben und die Feldidentifizierung Ihnen überlassen, liefert Veryfi buchhalterfertiges JSON: Händlername, Datum, Gesamtsumme, Steuern, Positionen, Zahlungsart und Kategorie. Diese Spezialisierung macht es zum schnellsten Weg vom gescannten Beleg zum Buchhaltungseintrag.
Preise. Veryfi bietet eine kostenlose Stufe mit insgesamt 100 Dokumenten (nicht pro Monat). Der Starter-Plan erfordert eine Mindestverpflichtung von 500 $/Monat, wofür Sie etwa 5.000 Belege oder 3.125 Rechnungen zu 0,08 $ pro Beleg und 0,16 $ pro Rechnung erhalten. Diese Preisstruktur eignet sich gut für die Verarbeitung großer Mengen, stellt aber für kleinere Projekte eine hohe Einstiegshürde dar. Growth- und Enterprise-Pläne werden individuell angeboten.
SDK-Unterstützung. Python, Node.js, Java, Go, C# und PHP – solide Abdeckung gängiger Backend-Sprachen. Die SDKs unterstützen den Dateiupload von URLs, lokalen Dateien und base64-codierten Bildern. Veryfi bietet auch mobile SDKs für die Dokumenterfassung unter iOS und Android.
Ausgabequalität. Die Extraktion von Finanzdokumenten durch Veryfi gehört zu den genauesten in seiner Nische. Die multimodale LLM-API (AnyDocs) erweitert denselben Ansatz auf beliebige Dokumenttypen. Die Antwort unterstützt 38+ Sprachen, 91+ Währungen, Kategorien und normalisierte Positionen. In Reddit-Communities wie r/bookkeeping und r/accounting wird Veryfi häufig als die erste Wahl für belegintensive Workflows genannt.
Am besten geeignet für Spesenverwaltungsanwendungen, Fintech-Produkte, die Quittungen und Rechnungen in großem Umfang verarbeiten, sowie Buchhaltungsfirmen, die automatisierte Datenerfassungspipelines aufbauen.
Nicht ideal für allgemeine OCR-Anforderungen (für einfache Textextraktion ist es übertrieben), kleine Evaluierungen (die Mindestverpflichtung von $ 500 ist für Prototyping schwer zu rechtfertigen) oder nicht-finanzielle Dokumenttypen.
OCR.space
OCR.space ist die beste kostenlose OCR API für Projekte mit hohem Volumen und begrenztem Budget. Die kostenlose Stufe – 25.000 Anfragen pro Monat ohne Kreditkarte – ist von keiner anderen kommerziellen API übertroffen. Sie geben etwas Genauigkeit und Funktionen im Vergleich zu den Cloud-Anbietern auf, aber für saubere gedruckte Dokumente, bei denen 90–95 % Genauigkeit akzeptabel ist, ist OCR.space preislich kaum zu schlagen.
Preise. Die kostenlose Stufe umfasst 25.000 Anfragen pro Monat (500/Tag-Limit) mit einer Dateigrößenbegrenzung von 1 MB. Der PRO-Plan kostet 29,99 $/Monat für 300.000 Anfragen, 5 MB Dateigröße und schnellere Verarbeitung. Der PRO-PDF-Plan (59,99 $/Monat) fügt mehrseitige PDF-Unterstützung hinzu (bis zu 999 Seiten). Enterprise-Pläne beginnen bei 999 $/Monat für dedizierte Server. Im Vergleich zu Cloud-APIs mit 1,50 $ pro 1.000 Seiten ist die kostenlose Stufe von OCR.space für Projekte mit geringem Volumen praktisch unbegrenzt.
SDK-Unterstützung. OCR.space bietet keine sprachspezifischen SDKs – die Kommunikation erfolgt über die REST API. Es gibt jedoch von der Community gepflegte Wrapper für Python, JavaScript, PHP und Java. Die API gibt JSON mit Begrenzungsrahmen pro Wort und Konfidenzwerten zurück.
Ausgabequalität. Bei sauberem, kontrastreichem gedruckten Text erreicht OCR.space eine Zeichengenauigkeit von etwa 90–95 % – ausreichend für durchsuchbare PDFs und Datenextraktion aus einfachen Formularen. Die Genauigkeit sinkt bei kleinen Schriftarten, ungewöhnlichen Layouts, Handschrift oder Bildern mit niedriger Auflösung. Es gibt keine native Tabellenextraktion; Tabellendaten werden als Text mit Positionskoordinaten, aber ohne Zeilen-/Spaltenstruktur zurückgegeben.
Am besten geeignet für Prototyping und MVPs, bei denen das Budget die Hauptbeschränkung ist, interne Tools, die saubere gedruckte Dokumente verarbeiten, und Entwickler, die eine API ohne Verpflichtung benötigen, um OCR-Integrationsmuster zu testen, bevor sie sich für einen kostenpflichtigen Anbieter entscheiden.
Nicht ideal für Produktionssysteme, die eine Genauigkeit von 99 %+ erfordern, komplexe Layouts (Tabellen, Formulare), Handschrifterkennung oder jedes Szenario, in dem die Genauigkeit pro Dokument direkte Auswirkungen auf Geschäftsergebnisse hat.
Base64.ai
Base64.ai ist eine weniger bekannte, aber technisch beeindruckende OCR-API, die sich als „eine API für jedes Dokument“ positioniert. Sie unterstützt über 100 Dokumenttypen – von Krankenakten und Versicherungsformularen bis hin zu Reisepässen, Verträgen und Rechnungen – mit Deep-Learning-Modellen, die für jeden Typ trainiert wurden. Ihre Stärke liegt in der Verarbeitung von Sonderfällen: gedrehte Seiten, gefaltete Dokumente, handschriftliche Anmerkungen und Seiten mit gemischtem Layout.
Preise. Base64.ai verwendet individuelle Preise pro Seite, basierend auf Dokumenttyp und Volumen, ohne öffentlich gelisteten Standard-Tarif. Interessenten müssen den Vertrieb für ein Angebot kontaktieren, was die Kosteneinschätzung ohne Pilotprojekt erschwert. Die Preise liegen zwischen Enterprise-APIs (ABBYY-Tarif) und Cloud-Hyperscalern.
SDK-Unterstützung. REST-API mit Community-Wrappern für Python und JavaScript. Die Kernintegration erfolgt über direkte HTTP-Anfragen mit JSON-Payloads. Base64.ai lässt sich außerdem mit Zapier und Slack für Workflow-Automatisierung integrieren.
Ausgabequalität. Die Extraktionsqualität von Base64.ai ist über die unterstützten Dokumenttypen hinweg stark, insbesondere bei Ausweisdokumenten, Finanzformularen und Krankenakten. Die JSON-Antwort enthält Konfidenzwerte pro Feld, Begrenzungsrahmen und Dokumentklassifizierungs-Labels. Bei handschriftlichen Formularen schneidet es besser ab als Tesseract oder OCR.space, liegt jedoch hinter der dedizierten Handschrifterkennung von ABBYY.
Am besten geeignet für dokumentlastige Branchen (Versicherung, Gesundheitswesen, Recht), die verschiedene Dokumenttypen über eine einzige Integration verarbeiten, Teams, die einen dedizierten Account-Manager für die Einrichtung benötigen, und Szenarien, in denen Dokumentklassifizierung + Extraktion in einer API die Architekturkomplexität reduziert.
Nicht ideal für budgetbewusste Teams (kein Self-Service-Pricing), schnelles Prototyping ohne Vertriebsgespräch oder Projekte, die eine Cloud-Provider-native Infrastruktur benötigen.
Erwähnenswerte Alternativen: Weitere APIs, die Sie kennen sollten
Neben den zehn oben vorgestellten APIs gibt es einige weitere Dienste, die für bestimmte Anwendungsfälle eine kurze Erwähnung verdienen:
LlamaParse wurde speziell für RAG-Pipelines und Dokument-Agenten entwickelt. Es bewahrt die semantische Struktur und gibt Markdown aus, was es zu einer starken Wahl für KI-Entwickler macht, die Retrieval-Augmented-Generation-Systeme bauen. Die Preisgestaltung beginnt mit einem kostenlosen Tarif mit 1.000 Seiten pro Tag, danach $0.003 pro Seite.
Clarifai bietet eine Full-Stack-KI-Plattform mit OCR-Funktionen über seine Dokumentverständnismodelle. Der Pay-as-you-go-Plan (Standard: max. $100/Monat) und der Entwicklerplan für $1/Monat (erstes Jahr) machen es zu einer der erschwinglicheren Optionen für Teams, die auch Bilderkennung und Modelltraining auf derselben Plattform benötigen.
Rossum ist eine Enterprise-IDP-Plattform, die für die Rechnungsverarbeitung in großem Maßstab optimiert ist. Die Preise beginnen bei $18.000/Jahr, was sie klar im Enterprise-Bereich neben ABBYY positioniert. Rossums Stärke ist seine KI-gestützte Validierungs-Engine und die ERP-Integrationen (SAP, Coupa, Workday), aber für die meisten Entwickleranwendungsfälle ist der Einstiegspreis prohibitiv.
Diese Plattformen wurden nicht in den Hauptvergleich aufgenommen, weil ihre Zielgruppe (RAG-Pipeline-Entwickler, Full-Stack-KI-Plattformnutzer, Enterprise-AP-Teams) enger gefasst ist als der entwicklerorientierte, allgemeine OCR-Bereich dieses Leitfadens.
Welche API passt zu Ihrem Anwendungsfall?
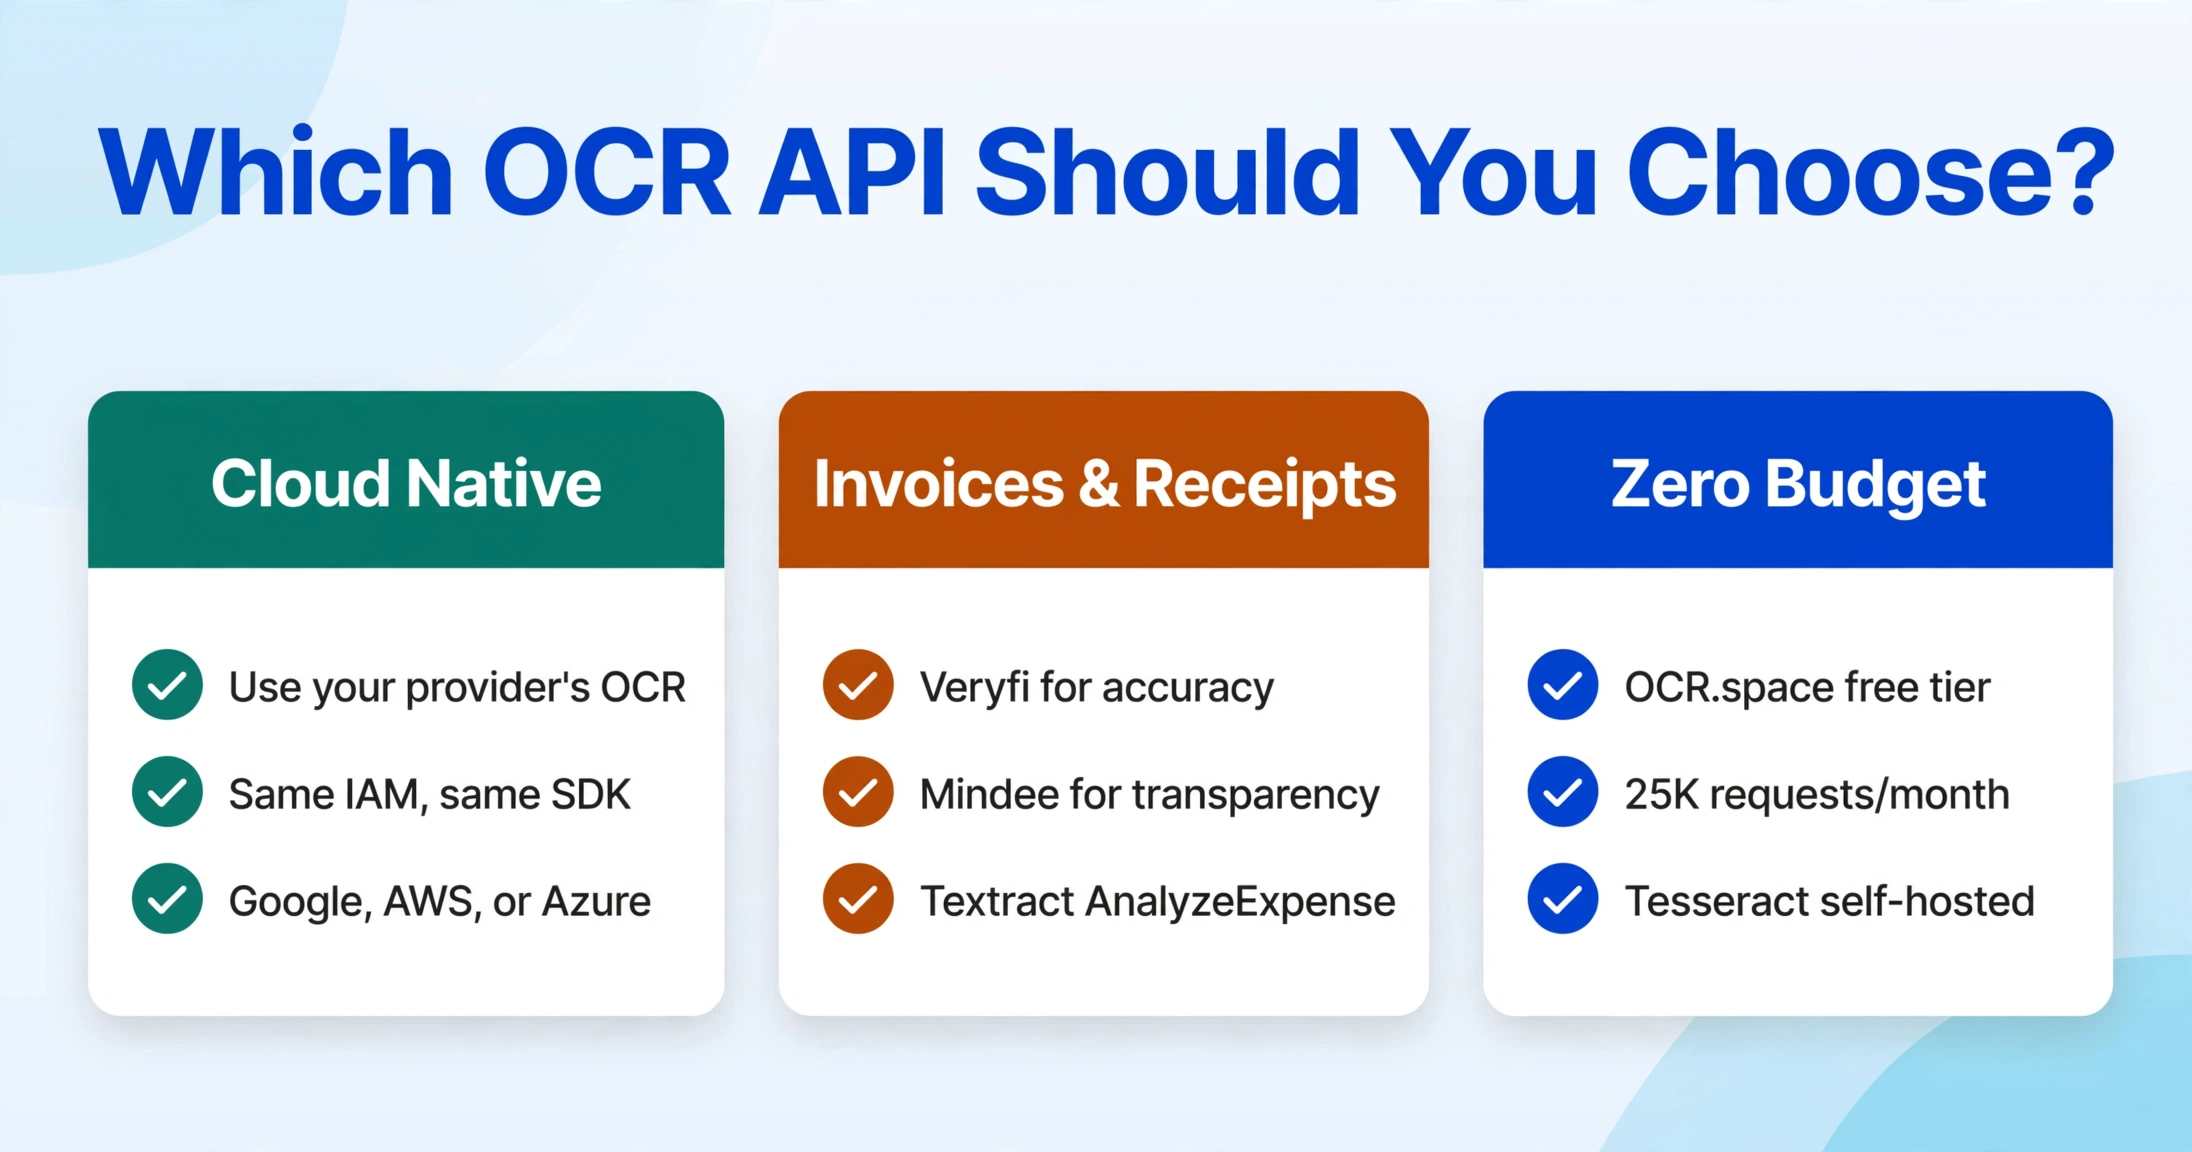
Die Antwort hängt von Ihren Dokumenttypen, Ihrem Budget, Ihrem Zeitplan und Ihrem Ökosystem ab. Es gibt keine einzelne „beste OCR-API“ – die richtige Wahl ist diejenige, die die Gesamtkosten für Integration, Betrieb und Wartung für Ihr spezifisches Szenario minimiert. Hier sind sechs häufige Situationen und die APIs, die am besten passen:
Sie entwickeln eine allgemeine OCR-Funktion und nutzen bereits Google Cloud, AWS oder Azure
Nutzen Sie die OCR API Ihres Cloud-Anbieters. Allein die Integrationskostenersparnis (gleiches IAM, gleiches SDK, gleiches Netzwerk) wiegt Genauigkeitsunterschiede auf. Google Cloud Vision für Szenentext + Dokumenten-OCR; AWS Textract, wenn Sie Formulare und Tabellen benötigen; Azure Document Intelligence, wenn Sie im Microsoft-Stack arbeiten.
Sie verarbeiten Rechnungen und Belege in großem Umfang
Veryfi ist genau dafür entwickelt und bietet die beste Genauigkeit bei Finanzdokumenten. Mindee ist eine starke zweite Option mit besserer Preistransparenz und ohne Mindestgebühr von $500/Monat. Die AnalyzeExpense API von AWS Textract ($8–10/1K Seiten) ist eine praktikable Alternative, wenn Sie bereits AWS nutzen.
Sie benötigen Tabellen- und Formularextraktion mit hoher Genauigkeit
Die Tables-Funktion von AWS Textract bleibt der Goldstandard für native Tabellenstrukturen in JSON. Das Layout-Modell von Azure Document Intelligence liegt dicht dahinter, mit besserer Erkennung von Kontrollkästchen/Auswahlmarkierungen. Für Enterprise-Compliance und Layout-Erhalt ist das SDK von ABBYY die bewährteste Option.
Ihr Budget ist nahezu null und die Dokumente sind saubere, gedruckte Seiten
Der kostenlose Tarif von OCR.space (25.000 Anfragen/Monat) ist die beste Option. Wenn Sie höhere Genauigkeit benötigen und Entwicklungszeit investieren können, schlägt Tesseract mit ordnungsgemäßer Vorverarbeitung OCR.space bei der Genauigkeit, erfordert aber mehr Einrichtungsaufwand. Für einen Vergleich der Wirtschaftlichkeit von selbst gehosteter vs. Cloud-OCR, siehe unseren Leitfaden zu Open-Source-OCR-Tools.
Sie benötigen benutzerdefinierte Feldextraktion aus nicht standardisierten Dokumenten
Nanonets bietet die zugänglichste Pipeline zum Training benutzerdefinierter Modelle – Beispiele hochladen, Felder definieren und ohne Code trainieren. Die benutzerdefinierten Modelle von Mindee folgen einem ähnlichen Workflow mit niedrigeren Einstiegspreisen. Der Custom Extractor von Google Document AI und die Custom Extraction von Azure funktionieren beide, erfordern jedoch mehr Vertrautheit mit Cloud-Plattformen.
Sie möchten Dokumente extrahieren, ohne Integrationscode zu schreiben
Wenn Ihr Team nicht über die Kapazitäten verfügt, um API-Integrationen, Authentifizierung, Fehlerbehandlung und Ergebnisparsing zu verwalten, bietet ein No-Code-Tool wie ImageToTable.ai dieselbe Extraktionsfunktion über eine Weboberfläche oder ein Google-Sheets-Add-on – ohne API-Schlüssel, ohne SDK, ohne Deployment-Pipeline. Laden Sie Dateien oder PDFs hoch, definieren Sie Ihre Spalten und erhalten Sie in Sekundenschnelle strukturierte Daten zurück. Der Kompromiss ist der Durchsatz: APIs gewinnen bei der Automatisierung im großen Maßstab, aber für Ad-hoc-Dokumentensätze oder Teams ohne dedizierte Engineering-Ressourcen bietet der No-Code-Ansatz eine schnellere Time-to-Value. Um zu verstehen, wie sich dieser Ansatz von herkömmlicher OCR unterscheidet, lesen Sie Was ist KI-OCR?
Häufig gestellte Fragen
Welche OCR API ist am besten für Entwickler, die eine Produktionsanwendung erstellen?
Mindee bietet die beste Balance aus Entwicklererfahrung, Dokumentationsqualität, SDK-Abdeckung (7 Sprachen) und transparenter Preisgestaltung für Produktionsworkloads unter 10.000 Seiten pro Monat. Für AWS-native Stacks ist Textract die logische Wahl. Für Google-Cloud-native Stacks: Cloud Vision + Document AI. Die „beste“ API hängt mehr von Ihrer bestehenden Infrastruktur ab als von der rohen OCR-Genauigkeit, da alle großen Cloud-APIs bei sauberen Dokumenten eine Genauigkeit von über 97 % liefern.
Was ist die günstigste OCR API für die Verarbeitung großer Mengen?
Für selbst gehostete Lösungen ist Tesseract kostenlos, erfordert jedoch Entwicklungszeit für die Produktionsreife. Für eine verwaltete API im großen Maßstab gehört AWS Textracts DetectDocumentText mit $1.50/1K Seiten (und $0.60/1K über 1M Seiten) zu den günstigsten Preisen pro Seite. Der PRO-Plan von OCR.space für 300.000 Anfragen bei $29.99/Monat bietet das beste Preis-Leistungs-Verhältnis bei niedrigem bis mittlerem Volumen. Bei sehr hohem Volumen (1M+ Seiten/Monat) führt die Verhandlung individueller Tarife mit jedem großen Anbieter in der Regel zu den niedrigsten Kosten pro Seite.
Können OCR APIs Handschrift verarbeiten?
Ja, aber die Qualität variiert erheblich. Das ABBYY Cloud OCR SDK bietet die ausgereifteste Handschrifterkennung und unterstützt 126 handschriftliche Sprachen im zonenbasierten ICR-Modus. Google Cloud Visions Handschriftunterstützung verarbeitet gedruckte Handschrift recht gut. Für Schreibschrift oder gemischte handgeschriebene Dokumente übertreffen neuere Ansätze mit Vision-Language-Modellen (Gemini, GPT-5, Mistral OCR 3 über Cloud-APIs) oft herkömmliche OCR-Engines – allerdings zu höheren Kosten pro Seite. Weitere Informationen finden Sie in unserem Leitfaden zur Handschrift-OCR für einen tieferen Vergleich.
Bewahrt die OCR API die Tabellenstruktur?
AWS Textract liefert natives Zeilen- und Spalten-Tabellen-JSON mit Konfidenzwerten für Zellen – dies ist die entwicklerfreundlichste Tabellenausgabe, die verfügbar ist. Das Layout-Modell von Azure Document Intelligence bewahrt ebenfalls die Tabellenstruktur mit Begrenzungsrahmen. Google Cloud Visions Document AI gibt Tabellenblöcke zurück, erfordert jedoch mehr Nachbearbeitung für eine zuverlässige strukturelle Rekonstruktion. Tesseract und OCR.space geben Text mit Positionsdaten zurück, jedoch ohne Ableitung der Tabellenstruktur.
Welche OCR-APIs unterstützen die meisten Programmiersprachen?
Google Cloud Vision, AWS Textract und Mindee bieten alle offizielle SDKs für Python, Node.js, Java, Go und mindestens drei weitere Sprachen. Das .NET-SDK von Azure Document Intelligence ist besonders stark. Für Nischensprachen (PHP, Ruby) haben Google und AWS die breiteste Abdeckung über alle ihre SDKs.
Welche kostenlosen OCR-API-Stufen gibt es 2026?
OCR.space bietet die großzügigste kostenlose Stufe mit 25.000 Anfragen/Monat. Google Cloud Vision bietet 1.000 Einheiten/Monat kostenlos. AWS Textract bietet 1.000 Seiten/Monat für die ersten 3 Monate. Azure Document Intelligence bietet 500 Seiten/Monat. Der Developer-Plan von Mindee umfasst 250 Seiten/Monat kostenlos ohne Kreditkarte. Veryfi umfasst 100 Dokumente kostenlos (nicht wiederkehrend). Tesseract ist kostenlos, aber selbst gehostet.
Welche APIs unterstützen synchrone vs. asynchrone Verarbeitung?
Google Cloud Vision, AWS Textract und Azure Document Intelligence unterstützen alle sowohl synchrone (einzelne Seite, Sub-Sekunden-Latenz) als auch asynchrone (mehrseitiger Batch) Modi. Mindee, Veryfi und Nanonets standardmäßig auf synchrone Verarbeitung mit asynchronen Optionen für Batch-Workloads. OCR.space ist nur synchron. Für interaktive Anwendungen stellen Sie sicher, dass die gewählte API synchrone Antworten unter 2 Sekunden bietet.
Kann ich OCR-APIs on-premises oder in einer privaten Cloud ausführen?
Tesseract und andere Open-Source-Engines (PaddleOCR, EasyOCR) laufen überall. ABBYY bietet On-Premises-Bereitstellung für seine FlexiCapture-Plattform. AWS Textract, Google Cloud Vision und Azure Document Intelligence sind nur cloudbasiert, obwohl Azure verbundene Container-Bereitstellungen für einige Document-Intelligence-Funktionen bietet. Für sensible Daten (PII, PHI) ist Tesseract mit lokaler Vorverarbeitung gefolgt von einem Cloud-API-Aufruf (mit Datenmaskierung) ein gängiges Hybridmuster.
Was, wenn ich überhaupt keine OCR-API integrieren möchte?
OCR-APIs sind die richtige Wahl, wenn Sie programmatischen Zugriff in großem Umfang benötigen. Aber wenn Sie Dokumente nur gelegentlich verarbeiten – oder wenn Ihr Team keine technischen Ressourcen für die API-Integration hat – bieten No-Code-Extraktionstools einen schnelleren Weg zu strukturierten Daten. ImageToTable.ai ermöglicht es Ihnen, Dokumente hochzuladen, Ihre Spalten zu benennen und strukturierte Tabellenausgaben zu erhalten, ohne Code zu schreiben. Das Google-Sheets-Add-on geht noch weiter: Laden Sie direkt aus Ihrer Tabelle hoch und lassen Sie Daten an das aktive Blatt anhängen – ohne API-Schlüssel, ohne SDK, ohne Serververwaltung. Es ist ein anderer Kompromiss als bei einer OCR-API (weniger Automatisierung, null Einrichtung), aber für den richtigen Anwendungsfall ist es die schnellere Antwort.
Welche OCR-API unterstützt die meisten Sprachen?
ABBYY Cloud OCR SDK führt mit über 200 Drucksprachen und 126 Handschriftsprachen. Google Cloud Vision unterstützt über 200 Sprachen über seine Document-AI-Pipeline. Tesseract unterstützt über 100 Sprachen, wobei Sprachpakete für die meisten Schriftsysteme verfügbar sind. Azure Document Intelligence und AWS Textract unterstützen jeweils etwa 100+ Sprachen. Für ostasiatische Sprachen (Chinesisch, Japanisch, Koreanisch) liefern Google Cloud Vision und ABBYY in der Regel die höchste Genauigkeit. Für europäische Sprachen schneiden alle großen Cloud-APIs ähnlich ab.
Gibt es unabhängige Benchmarks, die die Genauigkeit von OCR-APIs vergleichen?
Mehrere unabhängige Benchmarks verfolgen die Genauigkeit von OCR-Modellen. Der olmOCR-Benchmark des Allen Institute for AI bewertet Dokumentverständnis und Strukturerhaltung. OmniDocBench deckt die Qualität der Dokumentextraktion in mehreren Formaten ab. Das IDP Leaderboard verfolgt die Extraktionsgenauigkeit bei Rechnungen, Belegen und Ausweisdokumenten. Stand Anfang 2026 erreichte Nanonets OCR-3 93,1 bei olmOCR, während GPT-5.2 und Gemini 3 Pro bei kombinierter Genauigkeit und Formularverständnis bei VLM-basierten Ansätzen führen. Diese Benchmarks werden häufig aktualisiert – prüfen Sie die Quelle für die neuesten Rankings.