Melhor OCR API
2026: 10 APIs para Desenvolvedores Comparadas por Precisão e Preço
Esta comparação avalia 10 OCR APIs em seis dimensões — precisão em texto impresso e manuscrito, preço por página em vários níveis de volume, suporte a idiomas de SDK, qualidade do formato de saída, perfil de latência e integração com ecossistemas de nuvem — para ajudar você a tomar uma decisão informada para o seu próximo projeto. Cada API foi avaliada com base em especificações documentadas publicamente, páginas oficiais de preços e feedback da comunidade de desenvolvedores. Divulgação: Este artigo inclui uma ferramenta sem código junto com nove APIs para contexto. Todos os dados de preços foram verificados em fontes oficiais em junho de 2026. Links para serviços de terceiros usam nofollow.
Principais Conclusões
- Uma taxa inicial de $1,50 por 1.000 páginas esconde um multiplicador de custo de 33× — ative a extração de formulários no Textract e sua conta saltará para $51,50 por 1.000 páginas antes mesmo de processar uma única tabela.
- Toda OCR API importante entrega 97–99% de precisão em documentos limpos — obsessão por pontuações de benchmark desperdiça o único recurso que você não pode comprar de volta: as semanas de engenharia que sua equipe gastará com integração de SDK, configuração de IAM e encanamento de pipeline.
- "A melhor OCR API" é a pergunta errada — comece com a nuvem pela qual você já paga, o SDK que sua equipe conhece e os tipos de documento que você realmente recebe, depois escolha a API que minimiza o atrito de integração.
Comparação Rápida: 10 APIs de OCR em Resumo
A tabela abaixo resume cada API em seu principal diferencial, preço inicial, especialidade em tipos de documento e os ecossistemas com os quais se integra naturalmente. Use-a como um primeiro filtro e depois mergulhe na seção completa da API que mais lhe interessa.
| API | Melhor para | Preço inicial | Documentos | Ecossistema de nuvem |
|---|---|---|---|---|
| Google Cloud Vision | OCR geral + texto de cena | Grátis: 1K/mês; depois $1.50/1K | Qualquer (imagens, PDFs) | Google Cloud (Doc AI, Storage, BigQuery) |
| AWS Textract | Formulários, tabelas, documentos estruturados | Grátis: 1K/mês (3 meses); depois $1.50/1K | Formulários, tabelas, faturas, recibos, IDs | AWS (S3, Lambda, Comprehend, SQS) |
| Azure Document Intelligence | Modelos prontos + stack Microsoft | Grátis: 500/mês; depois $1.50/1K Read | Faturas, recibos, IDs, cartões de saúde, contratos | Azure (Logic Apps, Power Automate, Purview) |
| Tesseract | OCR gratuito auto-hospedado | Grátis (apenas custo de computação) | Documentos impressos limpos | Auto-hospedado (Linux, Windows, macOS) |
| ABBYY Cloud OCR SDK | OCR empresarial de alta precisão | $99/mês (5K páginas) | Qualquer (200+ idiomas, manuscritos) | Hospedado no Azure, on-prem disponível |
| Mindee | DX para desenvolvedores + modelos pré-treinados | Grátis: 250/mês; a partir de €44/mês (500 créditos) | Faturas, recibos, IDs, passaportes, currículos | API independente (sem dependência de ecossistema) |
| Nanonets | Treinamento de modelos personalizados + fluxos de trabalho | $499/mês (10K páginas) | Tipos de documentos personalizados, faturas, recibos | Independente + integrações (Zapier, QuickBooks) |
| Veryfi | Recibos, faturas, documentos financeiros | Grátis: 100 documentos; mínimo de $500/mês (Starter) | Recibos, faturas, extratos bancários, cheques | Independente + integrações QuickBooks, Xero |
| OCR.space | OCR gratuito e econômico em volume | Grátis: 25K req/mês; $30/mês (PRO) | Documentos de texto limpos, PDFs de várias páginas | API independente (sem frescuras) |
| Base64.ai | Qualquer tipo de documento, uma única API | Preço personalizado (pagamento por página) | 100+ tipos de documentos, manuscritos, tabelas | API independente + Slack, Zapier |
Como Selecionamos e Avaliamos Estas APIs
Cada dimensão de avaliação abaixo foi verificada com base em documentação oficial, páginas de preços publicadas e repositórios de SDK para desenvolvedores. Onde existiam benchmarks independentes (benchmark olmOCR, OmniDocBench, IDP Leaderboard), eles foram cruzados com relatos práticos de desenvolvedores das comunidades Stack Overflow e Reddit.
1. Precisão — texto impresso, manuscrito, tabelas e formulários
Para texto impresso em documentos limpos, todas as principais APIs em nuvem oferecem 97–99% de precisão em condições normais. A divergência aparece em manuscritos, digitalizações de baixa qualidade, tabelas complexas e documentos multilíngues. Avaliamos as faixas de precisão declaradas de cada API para esses casos extremos e ponderamos a validação da comunidade sobre o desempenho no mundo real.
2. Preços — por página, por 1.000 páginas e custos ocultos
O preço de APIs de OCR parece simples à primeira vista: a maioria dos provedores anuncia uma taxa inicial de $1.50 por 1.000 páginas. O custo real depende de qual endpoint da API você usa (texto básico vs. análise de formulários vs. consultas personalizadas) e se você permanece no primeiro nível de preço. Calculamos o custo total em três níveis de volume: 1.000 páginas, 10.000 páginas e 100.000 páginas por mês.
3. Suporte a SDK e linguagens
Um bom SDK significa a diferença entre uma integração de um dia e uma semana de trabalho. Verificamos a disponibilidade de SDKs oficiais para Python, Node.js, Java, Go, .NET, Ruby e PHP — as sete linguagens que cobrem a grande maioria dos casos de uso de backend e processamento de dados.
4. Qualidade do formato de saída
Texto bruto é o básico. O fator diferencial é se a API retorna coordenadas de caixa delimitadora por palavra ou linha, preserva a estrutura hierárquica de tabelas, extrai pares chave-valor de formulários e gera pontuações de confiança. Avaliamos cada API pela riqueza da resposta JSON.
5. Latência e throughput
Respostas síncronas em menos de dois segundos são essenciais para aplicações interativas. O throughput em lote (páginas por minuto em escala) importa para pipelines de processamento em segundo plano. Observamos as características de latência documentadas de cada API.
6. Ecossistema de nuvem e integrações nativas
Uma API que se conecta diretamente ao S3, Cloud Storage ou Blob Storage — e alimenta os dados extraídos em um data warehouse ou ERP — economiza semanas de engenharia de pipeline. Avaliamos a profundidade da integração de cada API com a plataforma de nuvem da sua empresa e serviços de terceiros.
Google Cloud Vision API
Google Cloud Vision é a OCR API mais abrangente do mercado — não porque é a mais precisa para cada tipo de documento, mas porque lida com tudo, de placas de rua a páginas densas de contratos, por meio de um único endpoint. Ela divide o OCR em duas chamadas: TEXT_DETECTION para texto de cena (placas, etiquetas, fotos) e DOCUMENT_TEXT_DETECTION para páginas densas de documentos, esta última otimizada pelo pipeline Document AI do Google.
Preços. As primeiras 1.000 unidades por mês por recurso são gratuitas. Depois disso, a detecção de texto custa $1.50 por 1.000 imagens até 5 milhões, caindo para $0.60 além disso. A detecção de texto de documentos segue o mesmo nível. Por meio do Document AI, processadores especializados (Invoice Parser, Expense Parser) cobram $0.10 por 10 páginas — notavelmente mais barato que a análise de formulários do Textract para documentos financeiros.
Suporte a SDK. Python, Node.js, Java, Go, C#, PHP e Ruby — todos oficiais, todos mantidos. As bibliotecas de cliente do Google estão entre as mais maduras no espaço de OCR em nuvem.
Qualidade da saída. A resposta JSON inclui caixas delimitadoras por palavra, pontuações de confiança e blocos de layout em nível de página. Os processadores do Document AI adicionam pares chave-valor e estruturas de tabela, embora a reconstrução de tabelas exija pós-processamento em comparação com a saída nativa de tabelas do Textract.
Ideal para equipes que já usam Google Cloud, aplicações que precisam de OCR de texto de cena e de documentos por meio de um único SDK, e projetos que se beneficiam de integrações com Vertex AI ou BigQuery no futuro.
Não é ideal para extração pesada de tabelas em escala (Textract é mais barato e mais estruturado) ou fluxos de trabalho que precisam permanecer agnósticos em relação à nuvem.
AWS Textract
Amazon Textract foi criado especificamente para compreensão de documentos, e não para análise geral de imagens — e isso fica evidente. Sua API AnalyzeDocument expõe flags de recursos separados para Tabelas, Formulários, Consultas e Assinaturas, permitindo que você pague apenas pela profundidade de extração necessária. O recurso de Tabelas retorna estrutura nativa de linhas e colunas com confiança por célula; o recurso de Formulários extrai pares chave-valor sem qualquer configuração de modelo.
Preços. O DetectDocumentText básico custa $1,50 por 1.000 páginas (primeiro 1M) e $0,60 além disso. Tabelas adicionam $15 por 1.000 páginas; Formulários adicionam $50 por 1.000 páginas; Consultas adicionam $15 por 1.000 páginas. Para processamento de faturas, a API AnalyzeExpense custa $8–10 por 1.000 páginas — projetada especificamente para documentos financeiros e geralmente mais precisa do que executar análise genérica de Formulários. O nível gratuito inclui 1.000 páginas de DetectDocumentText por mês durante os primeiros três meses.
Suporte a SDK. Python, Node.js, Java, Go, .NET, PHP, Ruby — todos os SDKs oficiais da AWS. As APIs de paginação e assíncronas do Textract são bem documentadas com exemplos funcionais em cada linguagem.
Qualidade da saída. A saída de tabelas do Textract é o benchmark do setor para extração estruturada. A resposta JSON preserva span de linhas, span de colunas, células mescladas e confiança por célula. A extração de Formulários retorna pares chave-valor com caixas delimitadoras e relacionamentos. As Consultas suportam perguntas em linguagem natural contra documentos — um recurso exclusivo para extração de campos ad-hoc.
Ideal para stacks nativas da AWS, qualquer projeto que precise de extração de tabelas ou formulários de alta fidelidade e equipes que queiram combinar OCR com Lambda, gatilhos de eventos S3 ou Step Functions para pipelines de processamento de documentos.
Não é ideal para OCR de texto em cenas gerais (a Vision API é melhor) ou equipes que queiram custos previsíveis sem níveis de preços baseados em recursos.
Azure Document Intelligence
Azure Document Intelligence (anteriormente Azure Form Recognizer) oferece a integração mais estreita com o ecossistema Microsoft — Logic Apps, Power Automate, Power BI e SharePoint. Seus modelos pré-criados cobrem faturas, recibos, documentos de identidade, cartões de seguro de saúde, formulários W-2, formulários de imposto 1098 e contratos. O modelo Layout extrai tabelas e texto com preservação da estrutura.
Preços. O modelo Read (OCR básico + layout) custa $1.50 por 1.000 páginas, com 500 páginas grátis por mês. A análise de documentos pré-criados custa aproximadamente $10 por 1.000 páginas. A extração personalizada começa em $30 por 1.000 páginas para treinamento e inferência. As 500 páginas grátis por mês do nível gratuito são menos generosas que as 1.000 do Google, mas adequadas para prototipagem.
Suporte a SDK. Python, Node.js, Java, .NET (C#) e Go — forte suporte de primeira parte. O SDK .NET é particularmente bem mantido, refletindo a base de clientes empresariais .NET da Azure.
Qualidade da saída. O modelo Layout retorna tabelas, marcas de seleção (caixas de seleção) e estrutura de parágrafos com caixas delimitadoras e pontuações de confiança. Os modelos pré-criados adicionam extração de campos específicos do documento (ex.: itens de linha de fatura, nome do comerciante no recibo). A saída JSON é bem estruturada, mas menos granular por célula que o Textract para cenários de tabelas complexas.
Ideal para organizações já no Microsoft 365 ou Azure, cenários que precisam de fluxos de trabalho Power Automate e equipes que valorizam documentação de conformidade pré-criada (SOC 2, HIPAA, GDPR).
Não é ideal para OCR básico de alto volume onde OCR.space ou Tesseract seriam mais baratos, ou equipes que preferem a maturidade do SDK do Google ou da AWS.
Tesseract (Open Source Auto-hospedado)
Tesseract, originalmente desenvolvido pela HP e agora mantido pelo Google, continua sendo o ponto de partida padrão para desenvolvedores que querem controle total sobre seu pipeline de OCR. Ele suporta mais de 100 idiomas, roda em qualquer plataforma e não custa nada além de computação. Mas "grátis" não é o mesmo que "barato" — o tempo de engenharia necessário para colocar o Tesseract em produção pode exceder o custo de uma assinatura de API em nuvem em poucas semanas.
Preços. Grátis. O único custo é a infraestrutura: uma VM modesta ou contêiner. Para processamento de alto volume (1M+ páginas/mês), o Tesseract auto-hospedado em uma instância de CPU normalmente se equipara às APIs em nuvem entre 100.000 e 130.000 páginas por mês, dependendo da complexidade do documento.
Suporte a SDK. Python (pytesseract), C++ (nativo), Java (Tess4J), Node.js (tesseract.js). O wrapper Python é o mais usado, com extensa documentação da comunidade e cobertura no Stack Overflow. No entanto, a maturidade do SDK varia significativamente — o tesseract.js roda inteiramente no navegador, mas é mais lento que a versão nativa.
Qualidade da saída. Em documentos impressos limpos, com boa resolução e fundos uniformes, o Tesseract atinge 95–99% de precisão em nível de palavra. Em digitalizações de baixa qualidade, páginas inclinadas ou documentos com fontes decorativas, a precisão cai drasticamente. Ele tem suporte nativo mínimo para estrutura de tabelas — a saída é texto plano com posicionamento por espaços. O reconhecimento de escrita manual não é confiável sem treinamento adicional do modelo. Os formatos de saída hocr e ALTO fornecem caixas delimitadoras, mas sem compreensão semântica dos campos.
Melhor para equipes que precisam de soberania de dados (nenhum dado sai do servidor), processamento em alto volume onde o custo de infraestrutura é menor que as taxas por página de APIs, e desenvolvedores que se sentem confortáveis ajustando pipelines de pré-processamento (deskew, binarização, segmentação de página).
Não é ideal para equipes que precisam de extração pronta para produção em dias em vez de semanas, documentos com layouts complexos ou escrita manual, ou qualquer cenário onde a carga de manutenção deva ser mínima.
Para uma comparação mais aprofundada entre Tesseract e abordagens modernas de extração, veja nosso artigo sobre OCR vs AI Extraction.
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDK está no mercado de OCR há mais de três décadas, e seu Cloud OCR SDK reflete essa maturidade. Ele suporta mais de 200 idiomas de reconhecimento (incluindo 126 idiomas manuscritos), preserva o layout do documento com alta fidelidade e lida com extração baseada em zonas além de OCR de página inteira. A força da ABBYY é a consistência em diversas qualidades de entrada — onde o Tesseract pode ter dificuldades com uma digitalização levemente inclinada, o mecanismo de pré-processamento da ABBYY compensa.
Preços. O Cloud OCR SDK começa em $99 por mês para 5.000 páginas. Implantações empresariais (1M+ páginas/ano) geralmente negociam taxas por página na faixa de $0.02–$0.10 com compromissos anuais a partir de cerca de $15.000. Não há nível gratuito permanente, apenas testes. Para equipes pequenas, isso torna a ABBYY significativamente mais cara que as APIs de hyperscalers em nuvem.
Suporte a SDK. Python, Java, .NET (C#) e C++ — sólido, mas mais limitado que o trio de nuvem. A REST API é totalmente documentada e exemplos de código estão disponíveis para todas as linguagens suportadas.
Qualidade de saída. A preservação de layout da ABBYY está entre as melhores do setor — ela reconstrói a estrutura original do documento, incluindo colunas, tabelas, cabeçalhos e rodapés. Sua saída XML (através do mecanismo FineReader) é o formato mais rico disponível para processamento downstream de documentos. O reconhecimento de escrita manual em 126 idiomas é um diferencial que apenas um punhado de APIs iguala.
Melhor para projetos empresariais de digitalização de documentos onde a fidelidade do layout é crítica, indústrias regulamentadas (finanças, saúde, governo) que precisam de opções de implantação on-premises, e OCR multilíngue em escala tanto para impressão quanto para escrita manual.
Não é ideal para startups ou equipes pequenas com orçamentos limitados, prototipagem rápida, ou projetos onde os custos por página devam permanecer abaixo de $0.01.
Mindee
Mindee é uma das OCR APIs mais amigáveis para desenvolvedores disponíveis hoje. Sua documentação é clara, suas respostas de API são consistentes e seus modelos pré-treinados (faturas, recibos, passaportes, carteiras de motorista, currículos e mais) funcionam prontos para uso, sem nenhuma etapa de treinamento. A Mindee faz uma escolha de design deliberada: em vez de oferecer um endpoint OCR genérico e deixar a lógica de extração com você, ela retorna JSON em nível de campo que mapeia diretamente para o seu modelo de dados.
Preços. O plano Developer é gratuito para 250 páginas por mês (sem necessidade de cartão de crédito). Os planos pagos começam em €44/mês (cerca de $47) para 500 páginas cobradas anualmente, com páginas adicionais a €0,05 cada. O plano Pro (€179/mês) inclui 2.500 páginas a €0,04 por página extra. O preço empresarial cai para cerca de €0,01 por página em alto volume. Esta é uma das estruturas de preços mais transparentes no espaço de OCR API — sem níveis ocultos ou custos surpresa de recursos.
Suporte a SDK. Python, Node.js, Java, Go, Ruby, PHP e .NET — a cobertura de SDK mais ampla fora dos três grandes provedores de nuvem. Todos os SDKs são gerados automaticamente a partir da especificação OpenAPI, o que significa que eles permanecem atualizados com a API. No Reddit r/programming e r/MachineLearning, o SDK Python da Mindee é frequentemente citado como o mais intuitivo para prototipagem rápida.
Qualidade da saída. A extração em nível de campo da Mindee retorna JSON estruturado com pontuações de confiança por campo. Para faturas, isso significa matrizes de itens de linha com descrições, quantidades, preços unitários e totais — não texto bruto que você precisa analisar. A compensação é que a Mindee é otimizada para tipos específicos de documentos, em vez de documentos arbitrários; para um formulário genérico com campos personalizados, você precisaria treinar um modelo personalizado.
Ideal para desenvolvedores que querem JSON em nível de campo pronto para uso (sem pós-processamento com regex), equipes que valorizam qualidade de documentação e maturidade de SDK, e projetos que processam tipos padrão de documentos (faturas, recibos, IDs, passaportes, currículos).
Não é ideal para layouts de documentos arbitrários sem modelos predefinidos, OCR de texto de cena (placas de rua, quadros brancos) ou casos de uso onde a implantação on-premises é obrigatória.
Nanonets
Nanonets se posiciona entre OCR API e plataforma de fluxo de trabalho com IA. Seu principal diferencial é o treinamento de modelos personalizados — você envia documentos de exemplo e o Nanonets aprende a extrair os campos que você precisa, sem escrever regras de extração. Para equipes que processam documentos não padronizados, essa abordagem baseada em treinamento geralmente oferece melhor precisão do que modelos pré-treinados genéricos.
Preços. O Nanonets começa em $499 por mês para até 10.000 páginas — um salto significativo em relação aos preços de APIs em nuvem. A extração adicional custa aproximadamente $0,30 por página, além de cobranças separadas para formatação, consultas e integrações premium. Avaliações de desenvolvedores no G2 e no Reddit frequentemente citam a imprevisibilidade dos custos como uma preocupação à medida que o volume aumenta. O plano gratuito oferece 500 páginas com cartão de crédito.
Suporte a SDK. Python, Node.js, Java e Go — essas quatro linguagens cobrem a maioria dos casos de uso. O SDK Python é o mais completo, com exemplos para processamento em lote, treinamento de modelos personalizados e automação de fluxos de trabalho.
Qualidade da saída. Para documentos que correspondem ao seu conjunto de treinamento, o Nanonets alcança alta precisão em nível de campo. Seu modelo recente Nanonets OCR-3 (lançado em abril de 2026) obteve 93,1 no benchmark olmOCR e 90,5 no OmniDocBench, colocando-o no topo dos modelos comerciais de OCR. A saída JSON inclui confiança por campo e caixas delimitadoras.
Ideal para equipes que precisam extrair campos personalizados de documentos não padronizados, organizações que se beneficiam do mecanismo de fluxo de trabalho integrado (aprovações, validações, notificações do Slack) e empresas de médio porte que desejam OCR mais fluxo de trabalho em uma única plataforma.
Não é ideal para equipes com orçamento apertado (os preços aumentam rapidamente), extração simples de texto onde o Tesseract ou o OCR.space seriam suficientes, ou projetos que precisam de integrações nativas de provedores de nuvem.
Veryfi
Veryfi é especializada em OCR de documentos financeiros — recibos, faturas, extratos bancários, cheques e formulários W-2. Diferente de APIs de OCR de uso geral que retornam texto bruto e deixam a identificação de campos por sua conta, a Veryfi retorna JSON pronto para contabilidade: nome do comerciante, data, total, impostos, itens de linha, forma de pagamento e categoria. Essa especialização faz dela o caminho mais rápido de um recibo escaneado para um lançamento contábil.
Preços. A Veryfi oferece um plano gratuito de 100 documentos no total (não por mês). O plano Starter exige um compromisso mínimo de $500/mês, que compra aproximadamente 5.000 recibos ou 3.125 faturas a $0,08 por recibo e $0,16 por fatura. Essa estrutura de preços funciona bem para processamento em alto volume, mas cria uma barreira de entrada alta para projetos menores. Os planos Growth e Enterprise têm preços sob consulta.
Suporte a SDK. Python, Node.js, Java, Go, C# e PHP — boa cobertura entre linguagens de backend. Os SDKs incluem suporte integrado para upload de arquivos via URLs, arquivos locais e imagens codificadas em base64. A Veryfi também oferece SDKs móveis para captura de documentos em iOS e Android.
Qualidade da saída. A extração de documentos financeiros da Veryfi está entre as mais precisas do seu nicho. Sua API de LLM multimodal (AnyDocs) estende a mesma abordagem a tipos arbitrários de documentos. A resposta inclui suporte a 38+ idiomas, 91+ moedas, categorias e itens de linha normalizados. No Reddit, em r/bookkeeping e r/accounting, a Veryfi é frequentemente mencionada como a API preferida para fluxos de trabalho com muitos recibos.
Ideal para aplicativos de gestão de despesas, produtos fintech que processam recibos e faturas em escala e escritórios de contabilidade que constroem pipelines automatizados de ingestão de dados.
Não é ideal para necessidades de OCR de uso geral (é exagero para extração simples de texto), avaliações em pequena escala (o mínimo de $500 é difícil de justificar para prototipagem) ou tipos de documentos não financeiros.
OCR.space
OCR.space é a melhor API de OCR gratuita para projetos de alto volume e orçamento limitado. Seu plano gratuito — 25.000 solicitações por mês, sem cartão de crédito — não tem igual entre as APIs comerciais. Você abre mão de alguma precisão e recursos em comparação ao trio de nuvem, mas para documentos impressos limpos, onde 90–95% de precisão é aceitável, o OCR.space é imbatível em custo.
Preços. O plano gratuito inclui 25.000 solicitações por mês (limite de 500/dia) com limite de tamanho de arquivo de 1 MB. O plano PRO custa US$ 29,99/mês para 300.000 solicitações, arquivos de até 5 MB e processamento mais rápido. O plano PRO PDF (US$ 59,99/mês) adiciona suporte a PDFs de várias páginas (até 999 páginas). Planos empresariais começam em US$ 999/mês para servidores dedicados. Em comparação com APIs de nuvem a US$ 1,50 por 1.000 páginas, o plano gratuito do OCR.space é praticamente ilimitado para projetos de baixo volume.
Suporte a SDK. O OCR.space não oferece SDKs específicos por linguagem — a comunicação é feita pela REST API. No entanto, existem wrappers mantidos pela comunidade para Python, JavaScript, PHP e Java. A API retorna JSON com caixas delimitadoras por palavra e pontuações de confiança.
Qualidade da saída. Em texto impresso limpo e de alto contraste, o OCR.space atinge aproximadamente 90–95% de precisão de caracteres — suficiente para PDFs pesquisáveis e extração de dados de formulários simples. A precisão cai em fontes pequenas, layouts incomuns, manuscritos ou imagens de baixa resolução. Não há extração nativa de tabelas; os dados de tabelas retornam como texto com coordenadas posicionais, mas sem estrutura de linhas/colunas.
Ideal para prototipagem e MVPs onde o orçamento é a principal restrição, ferramentas internas que processam documentos impressos limpos e desenvolvedores que precisam de uma API sem compromisso para testar padrões de integração de OCR antes de optar por um provedor pago.
Não é ideal para sistemas de produção que exigem precisão acima de 99%, layouts complexos (tabelas, formulários), reconhecimento de manuscritos ou qualquer cenário em que a precisão por documento impacte diretamente os resultados do negócio.
Base64.ai
Base64.ai é uma API de OCR menos conhecida, mas tecnicamente impressionante, que se posiciona como "uma API para qualquer documento". Ela suporta mais de 100 tipos de documentos — de registros médicos e formulários de seguro a passaportes, contratos e faturas — com modelos de aprendizado profundo treinados para cada tipo. Sua fama vem de lidar com casos extremos: páginas rotacionadas, documentos dobrados, anotações manuscritas e páginas com layout misto.
Preços. A Base64.ai usa preços personalizados por página com base no tipo de documento e volume, sem um nível padrão listado publicamente. Os clientes em potencial entram em contato com o setor de vendas para obter um orçamento, o que dificulta avaliar o custo sem um piloto. Espere preços entre APIs de nível empresarial (nível ABBYY) e os grandes provedores de nuvem.
Suporte a SDK. API REST com wrappers da comunidade para Python e JavaScript. A integração principal é feita por solicitações HTTP diretas com payloads JSON. A Base64.ai também se integra ao Zapier e ao Slack para automação de fluxos de trabalho.
Qualidade da saída. A qualidade de extração da Base64.ai é forte em todos os tipos de documento suportados, especialmente para documentos de identificação, formulários financeiros e registros médicos. A resposta JSON inclui confiança por campo, caixas delimitadoras e rótulos de classificação de documentos. Para manuscritos em formulários, ela tem desempenho melhor que o Tesseract ou o OCR.space, mas fica atrás do reconhecimento de escrita manual dedicado da ABBYY.
Ideal para setores com muitos documentos (seguros, saúde, jurídico) que processam diversos tipos de documentos por meio de uma única integração, equipes que precisam de um gerente de conta dedicado para a configuração e cenários em que a classificação de documentos + extração em uma única API reduz a complexidade da arquitetura.
Não é ideal para equipes com orçamento limitado (sem preços de autoatendimento), prototipagem rápida sem uma conversa com vendas ou projetos que precisam de infraestrutura nativa do provedor de nuvem.
Menções Honrosas: Outras APIs Que Vale a Pena Conhecer
Além das dez APIs abordadas acima, vários outros serviços merecem uma breve menção para casos de uso específicos:
LlamaParse é construído especificamente para pipelines de RAG e agentes de documentos. Ele preserva a estrutura semântica e gera markdown, sendo uma escolha forte para engenheiros de IA que criam sistemas de geração aumentada por recuperação. O preço começa com um plano gratuito de 1.000 páginas por dia e depois $0.003 por página.
Clarifai oferece uma plataforma de IA completa com recursos de OCR por meio de seus modelos de compreensão de documentos. Seu plano pré-pago (máximo de $100/mês padrão) e o plano para desenvolvedores a $1/mês (primeiro ano) fazem dela uma das opções mais acessíveis para equipes que também precisam de reconhecimento de imagem e treinamento de modelos na mesma plataforma.
Rossum é uma plataforma empresarial de IDP otimizada para processamento de faturas em escala. O preço começa em $18.000/ano, colocando-a firmemente no nível empresarial, junto com a ABBYY. O ponto forte da Rossum é seu mecanismo de validação com IA e integrações com ERP (SAP, Coupa, Workday), mas para a maioria dos casos de uso de desenvolvedores, o custo inicial é proibitivo.
Essas plataformas não foram incluídas na comparação principal porque seu público-alvo (criadores de pipelines de RAG, usuários de plataformas de IA completas, equipes empresariais de AP) é mais restrito do que o escopo de OCR geral para desenvolvedores deste guia.
Qual API é Ideal para o Seu Caso de Uso?
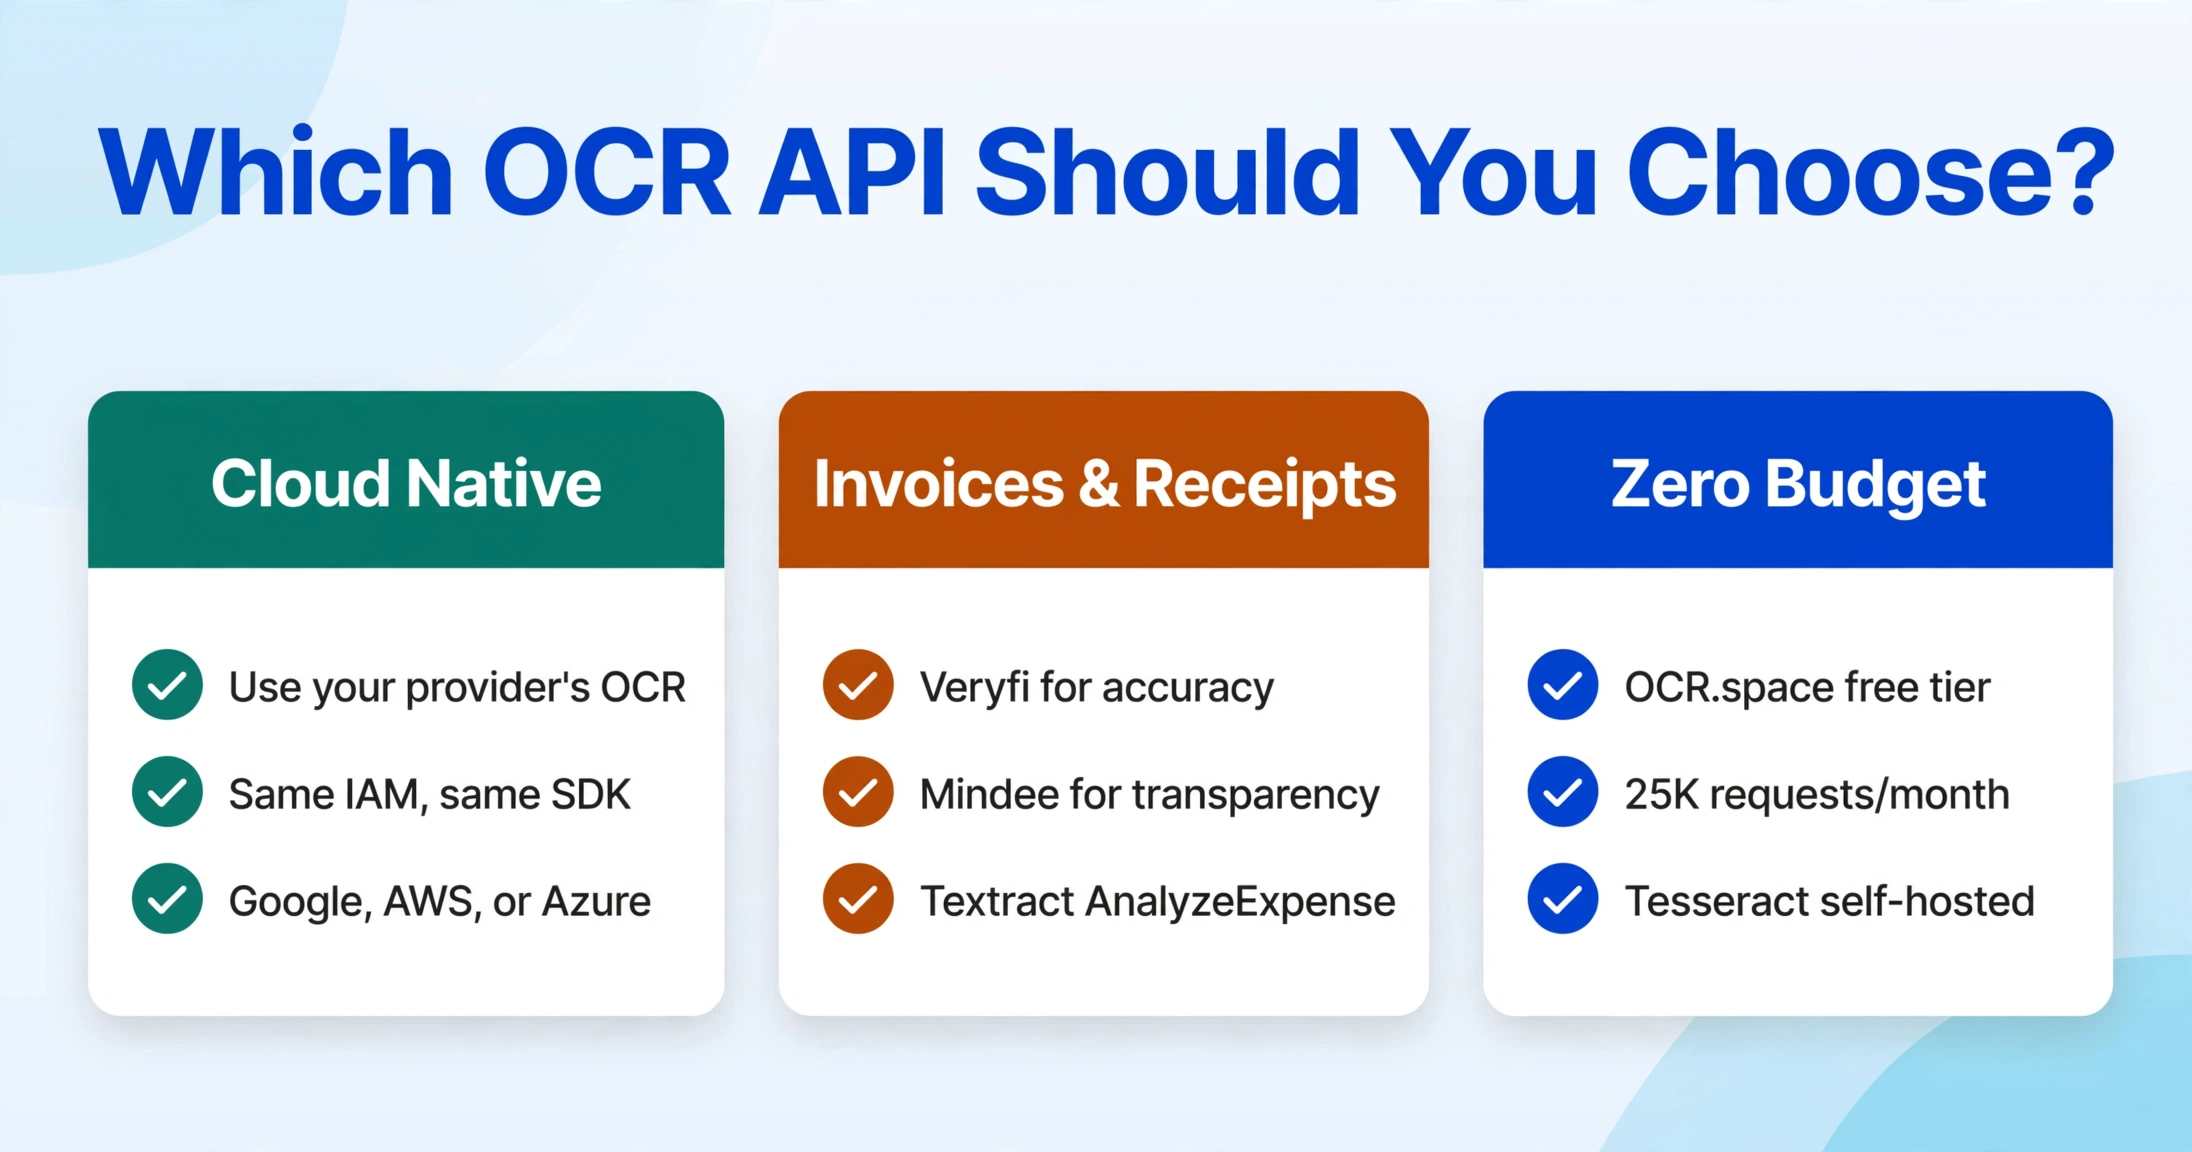
A resposta depende dos seus tipos de documento, orçamento, cronograma e ecossistema. Não existe uma única "melhor API de OCR" — a escolha certa é aquela que minimiza o custo total de integração, operação e manutenção para o seu cenário específico. Aqui estão seis situações comuns e as APIs que melhor se encaixam:
Você está criando um recurso geral de OCR e já usa Google Cloud, AWS ou Azure
Use a OCR API do seu provedor de nuvem. Só a economia com integração (mesmo IAM, mesmo SDK, mesma rede) já supera as diferenças de precisão. Google Cloud Vision para texto de cena + OCR de documentos; AWS Textract se você precisar de formulários e tabelas; Azure Document Intelligence se você estiver no ecossistema Microsoft.
Você processa faturas e recibos em escala
A Veryfi é feita sob medida para isso e tem a melhor precisão em documentos financeiros. A Mindee é uma forte segunda opção, com preços mais transparentes e sem o piso de $500/mês. A API AnalyzeExpense do AWS Textract ($8–10/1K páginas) é uma alternativa viável se você já usa AWS.
Você precisa de extração de tabelas e formulários com alta fidelidade
O recurso Tables do AWS Textract continua sendo o padrão ouro para estrutura nativa de tabelas em JSON. O modelo Layout do Azure Document Intelligence vem logo atrás, com melhor extração de caixas de seleção/marcações. Para conformidade empresarial + preservação de layout, o SDK da ABBYY é a opção mais comprovada.
Seu orçamento é quase zero e os documentos são páginas impressas limpas
O nível gratuito do OCR.space (25.000 requisições/mês) é a melhor opção. Se você precisar de mais precisão e puder investir tempo de engenharia, o Tesseract com pré-processamento adequado superará o OCR.space em precisão, ao custo do esforço de configuração. Para uma comparação da economia entre OCR auto-hospedado e em nuvem, veja nosso guia de ferramentas de OCR de código aberto.
Você precisa de extração de campos personalizados de documentos não padronizados
A Nanonets oferece o pipeline de treinamento de modelos personalizados mais acessível — envie amostras, defina campos e treine sem programar. Os modelos personalizados da Mindee seguem um fluxo de trabalho semelhante com preço de entrada menor. O Custom Extractor do Google Document AI e a Extração Personalizada do Azure funcionam, mas exigem mais familiaridade com plataformas de nuvem.
Você quer extração de documentos sem escrever nenhum código de integração
Se sua equipe não tem disponibilidade para gerenciar integrações de API, autenticação, tratamento de erros e análise de resultados, uma ferramenta sem código como o ImageToTable.ai oferece a mesma capacidade de extração por meio de uma interface web ou complemento do Google Sheets — sem chave de API, sem SDK, sem pipeline de implantação. Envie arquivos ou PDFs, defina suas colunas e receba dados estruturados em segundos. A contrapartida é a taxa de transferência: APIs vencem em escala de automação, mas para conjuntos de documentos ad hoc ou equipes sem recursos dedicados de engenharia, a abordagem sem código entrega mais rapidez para gerar valor. Para entender como essa abordagem difere do OCR tradicional, leia O que é IA de OCR?
Perguntas Frequentes
Qual OCR API é melhor para desenvolvedores que criam um aplicativo de produção?
A Mindee oferece o melhor equilíbrio entre experiência do desenvolvedor, qualidade da documentação, cobertura de SDK (7 idiomas) e preços transparentes para cargas de trabalho de produção abaixo de 10.000 páginas por mês. Para stacks nativas da AWS, a Textract é a escolha lógica. Para stacks nativas do Google Cloud, Cloud Vision + Document AI. A "melhor" API depende mais da sua infraestrutura existente do que da precisão bruta do OCR, porque todas as principais APIs em nuvem entregam precisão acima de 97% em documentos limpos.
Qual é a OCR API mais barata para processamento de alto volume?
Para autogerenciado, o Tesseract é gratuito, mas exige tempo de engenharia para produção. Para uma API gerenciada em escala, o DetectDocumentText da AWS Textract a $1,50/1K páginas (e $0,60/1K acima de 1M páginas) está entre as tarifas por página mais baratas. O plano PRO do OCR.space a $29,99/mês para 300.000 solicitações é o melhor custo-benefício em volume baixo a médio. Em volume muito alto (1M+ páginas/mês), negociar tarifas personalizadas com qualquer provedor importante geralmente resulta no menor custo por página.
As OCR APIs conseguem lidar com escrita manual?
Sim, mas a qualidade varia significativamente. O ABBYY Cloud OCR SDK tem o reconhecimento de escrita manual mais maduro, suportando 126 idiomas manuscritos no seu modo ICR baseado em zonas. O suporte a escrita manual do Google Cloud Vision cobre razoavelmente bem a escrita impressa. Para escrita cursiva ou documentos mistos, abordagens mais novas de modelo de visão-linguagem (Gemini, GPT-5, Mistral OCR 3 acessados por APIs em nuvem) geralmente superam os mecanismos tradicionais de OCR — mas com custo por página mais alto. Veja nosso guia de OCR para escrita manual para uma comparação mais detalhada.
A OCR API preserva a estrutura de tabelas?
A AWS Textract retorna JSON nativo de tabelas com linhas e colunas e pontuações de confiança por célula — esta é a saída de tabela mais amigável para desenvolvedores disponível. O modelo Layout do Azure Document Intelligence também preserva a estrutura de tabelas com caixas delimitadoras. O Document AI do Google Cloud Vision retorna blocos de tabela, mas exige mais pós-processamento para reconstrução estrutural confiável. O Tesseract e o OCR.space retornam texto com dados posicionais, mas sem inferência de estrutura de tabela.
Quais APIs de OCR oferecem suporte ao maior número de linguagens de programação?
Google Cloud Vision, AWS Textract e Mindee oferecem SDKs oficiais para Python, Node.js, Java, Go e pelo menos três outras linguagens. O SDK .NET do Azure Document Intelligence é particularmente robusto. Para suporte a linguagens de nicho (PHP, Ruby), Google e AWS têm a cobertura mais ampla em todos os seus SDKs.
Quais camadas gratuitas de OCR API estão disponíveis em 2026?
O OCR.space oferece a camada gratuita mais generosa, com 25.000 requisições/mês. O Google Cloud Vision oferece 1.000 unidades/mês grátis. O AWS Textract oferece 1.000 páginas/mês nos primeiros 3 meses. O Azure Document Intelligence oferece 500 páginas/mês. O plano Developer da Mindee inclui 250 páginas/mês grátis, sem necessidade de cartão de crédito. O Veryfi inclui 100 documentos grátis (não recorrentes). O Tesseract é gratuito, mas auto-hospedado.
Quais APIs suportam processamento síncrono versus assíncrono?
Google Cloud Vision, AWS Textract e Azure Document Intelligence suportam ambos os modos: síncrono (página única, latência de menos de um segundo) e assíncrono (lote de várias páginas). Mindee, Veryfi e Nanonets usam processamento síncrono por padrão, com opções assíncronas para cargas de trabalho em lote. O OCR.space é apenas síncrono. Para aplicações interativas, garanta que a API escolhida ofereça respostas síncronas em menos de 2 segundos.
Posso executar OCR APIs localmente ou em uma nuvem privada?
O Tesseract e outros motores de código aberto (PaddleOCR, EasyOCR) podem ser executados em qualquer lugar. A ABBYY oferece implantação local para sua plataforma FlexiCapture. AWS Textract, Google Cloud Vision e Azure Document Intelligence são somente em nuvem, embora o Azure forneça implantações de contêiner conectado para alguns recursos do Document Intelligence. Para dados sensíveis (PII, PHI), o Tesseract com pré-processamento local seguido por uma chamada de API em nuvem (com mascaramento de dados) é um padrão híbrido comum.
E se eu não quiser integrar uma OCR API de forma alguma?
OCR APIs são a escolha certa quando você precisa de acesso programático em escala. Mas se você processa documentos ocasionalmente — ou se sua equipe não tem capacidade de engenharia para integração de API — ferramentas de extração sem código oferecem um caminho mais rápido para dados estruturados. ImageToTable.ai permite que você envie documentos, nomeie suas colunas e obtenha saída de tabela estruturada sem escrever nenhum código. O complemento do Google Sheets vai além: envie diretamente da sua planilha e os dados serão adicionados à planilha ativa — sem chave de API, sem SDK, sem servidor para gerenciar. É uma troca diferente em relação a uma OCR API (menos automação, zero configuração), mas para o caso de uso certo, é a resposta mais rápida.
Qual OCR API oferece suporte ao maior número de idiomas?
O ABBYY Cloud OCR SDK lidera com mais de 200 idiomas impressos e 126 idiomas manuscritos. O Google Cloud Vision oferece suporte a mais de 200 idiomas por meio do pipeline do Document AI. O Tesseract oferece suporte a mais de 100 idiomas, com pacotes de idiomas disponíveis para a maioria dos sistemas de escrita. O Azure Document Intelligence e o AWS Textract oferecem suporte a aproximadamente 100+ idiomas cada. Para idiomas do Leste Asiático (chinês, japonês, coreano), o Google Cloud Vision e o ABBYY geralmente oferecem a maior precisão. Para idiomas europeus, todas as principais APIs em nuvem apresentam desempenho semelhante.
Existem benchmarks independentes que comparam a precisão das APIs de OCR?
Vários benchmarks independentes acompanham a precisão dos modelos de OCR. O benchmark olmOCR do Allen Institute for AI avalia a compreensão de documentos e a preservação da estrutura. O OmniDocBench cobre a qualidade da extração de documentos em vários formatos. O IDP Leaderboard acompanha a precisão da extração em tipos de documentos como faturas, recibos e documentos de identidade. No início de 2026, o Nanonets OCR-3 obteve 93,1 no olmOCR, enquanto o GPT-5.2 e o Gemini 3 Pro lideram as abordagens baseadas em VLM em precisão combinada e compreensão de formulários. Esses benchmarks são atualizados com frequência — consulte a fonte para obter as classificações mais recentes.