Mejores API de OCR
2026: 10 API para desarrolladores comparadas por precisión y precio
Esta comparativa evalúa 10 API de OCR en seis dimensiones: precisión en texto impreso y manuscrito, precio por página en varios niveles de volumen, soporte de idiomas del SDK, calidad del formato de salida, perfil de latencia e integración con el ecosistema en la nube, para ayudarle a tomar una decisión informada para su próximo proyecto. Cada API se evaluó según las especificaciones documentadas públicamente, las páginas de precios oficiales y los comentarios de la comunidad de desarrolladores. Divulgación: este artículo incluye una herramienta sin código junto a nueve API para contextualizar. Todos los datos de precios se verificaron con fuentes oficiales a junio de 2026. Los enlaces a servicios de terceros usan nofollow.
Conclusiones clave
- Una tarifa inicial de $1.50 por 1,000 páginas oculta un multiplicador de coste de 33×: active la extracción de formularios en Textract y su factura sube a $51.50 por 1,000 páginas antes de procesar una sola tabla.
- Toda API de OCR importante ofrece una precisión del 97–99% en documentos limpios: obsesionarse con las puntuaciones de referencia desperdicia el único recurso que no puede comprar: las semanas de ingeniería que su equipo dedicará a la integración del SDK, la configuración de IAM y el cableado del pipeline.
- "La mejor API de OCR" es la pregunta equivocada: empiece por la nube que ya paga, el SDK que su equipo conoce y los tipos de documento que realmente recibe, y luego elija la API que minimice la fricción de integración.
Comparación rápida: 10 API de OCR de un vistazo
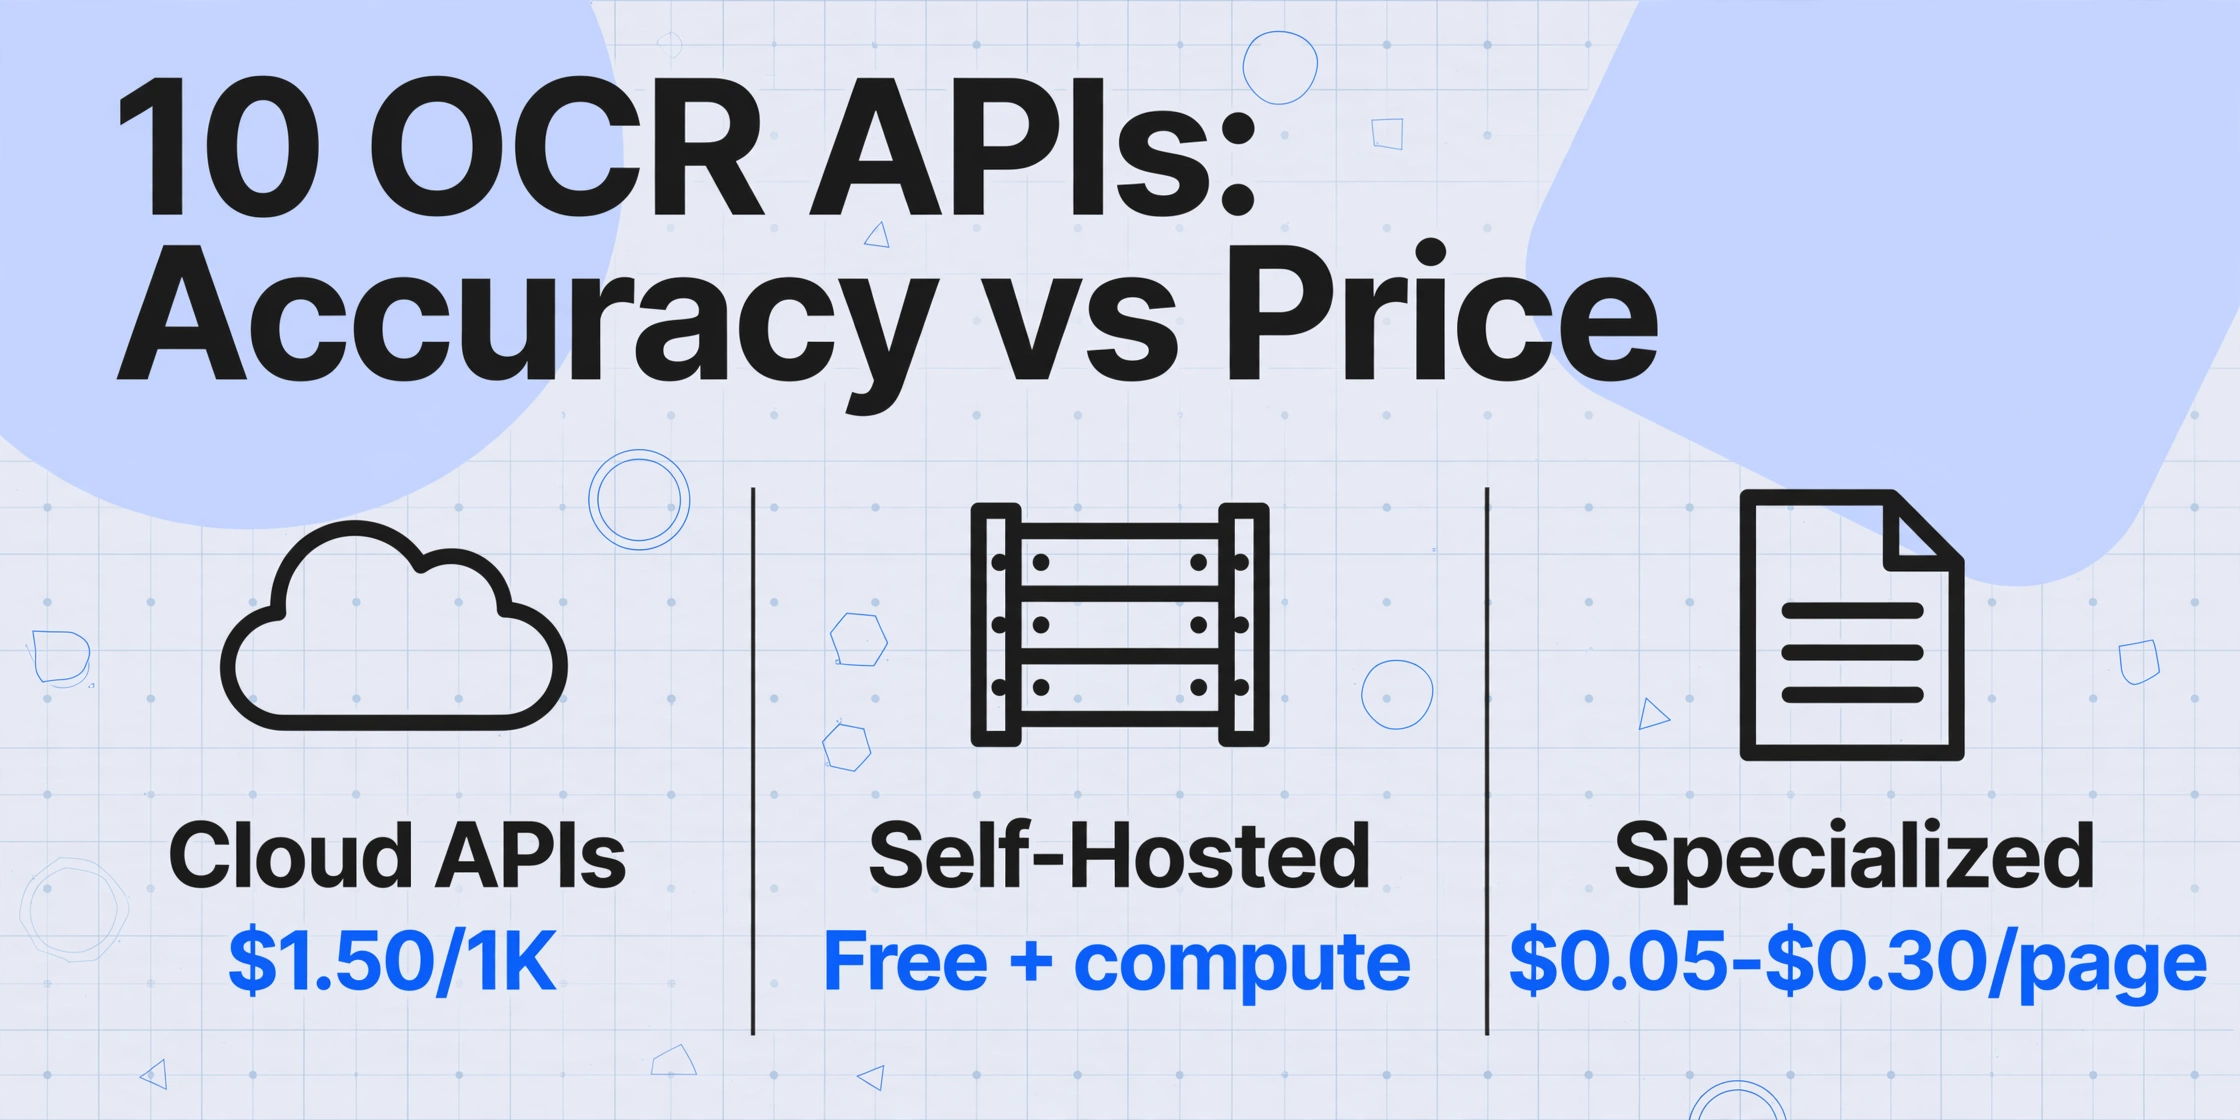
La tabla siguiente resume cada API según su fortaleza principal, precio inicial, especialidad en tipos de documentos y los ecosistemas con los que se integra de forma natural. Úsela como primer filtro y luego profundice en la sección completa de la API que le interese.
| API | Mejor para | Precio inicial | Documentos | Ecosistema en la nube |
|---|---|---|---|---|
| Google Cloud Vision | OCR general + texto de escenas | Gratis: 1K/mes; luego $1.50/1K | Cualquiera (imágenes, PDFs) | Google Cloud (Doc AI, Storage, BigQuery) |
| AWS Textract | Formularios, tablas, documentos estructurados | Gratis: 1K/mes (3 meses); luego $1.50/1K | Formularios, tablas, facturas, recibos, identificaciones | AWS (S3, Lambda, Comprehend, SQS) |
| Azure Document Intelligence | Modelos preentrenados + pila de Microsoft | Gratis: 500/mes; luego $1.50/1K Read | Facturas, recibos, identificaciones, tarjetas de salud, contratos | Azure (Logic Apps, Power Automate, Purview) |
| Tesseract | OCR autohospedado gratuito | Gratis (solo costo de cómputo) | Documentos impresos limpios | Autohospedado (Linux, Windows, macOS) |
| ABBYY Cloud OCR SDK | OCR empresarial de alta precisión | $99/mes (5K páginas) | Cualquiera (más de 200 idiomas, escritura a mano) | Alojado en Azure, disponible on-prem |
| Mindee | DX para desarrolladores + modelos preentrenados | Gratis: 250/mes; desde €44/mes (500 créditos) | Facturas, recibos, identificaciones, pasaportes, currículums | API independiente (sin bloqueo de ecosistema) |
| Nanonets | Entrenamiento de modelos personalizados + flujos de trabajo | $499/mes (10K páginas) | Tipos de documentos personalizados, facturas, recibos | Independiente + integraciones (Zapier, QuickBooks) |
| Veryfi | Recibos, facturas, documentos financieros | Gratis: 100 documentos; $500/mes mínimo (Starter) | Recibos, facturas, estados de cuenta bancarios, cheques | Independiente + integraciones con QuickBooks, Xero |
| OCR.space | OCR gratuito y económico a gran volumen | Gratis: 25K solicitudes/mes; $30/mes (PRO) | Documentos de texto limpios, PDFs de varias páginas | API independiente (sin extras) |
| Base64.ai | Cualquier tipo de documento, una sola API | Precio personalizado (pago por página) | Más de 100 tipos de documentos, escritura a mano, tablas | API independiente + Slack, Zapier |
Cómo seleccionamos y evaluamos estas APIs
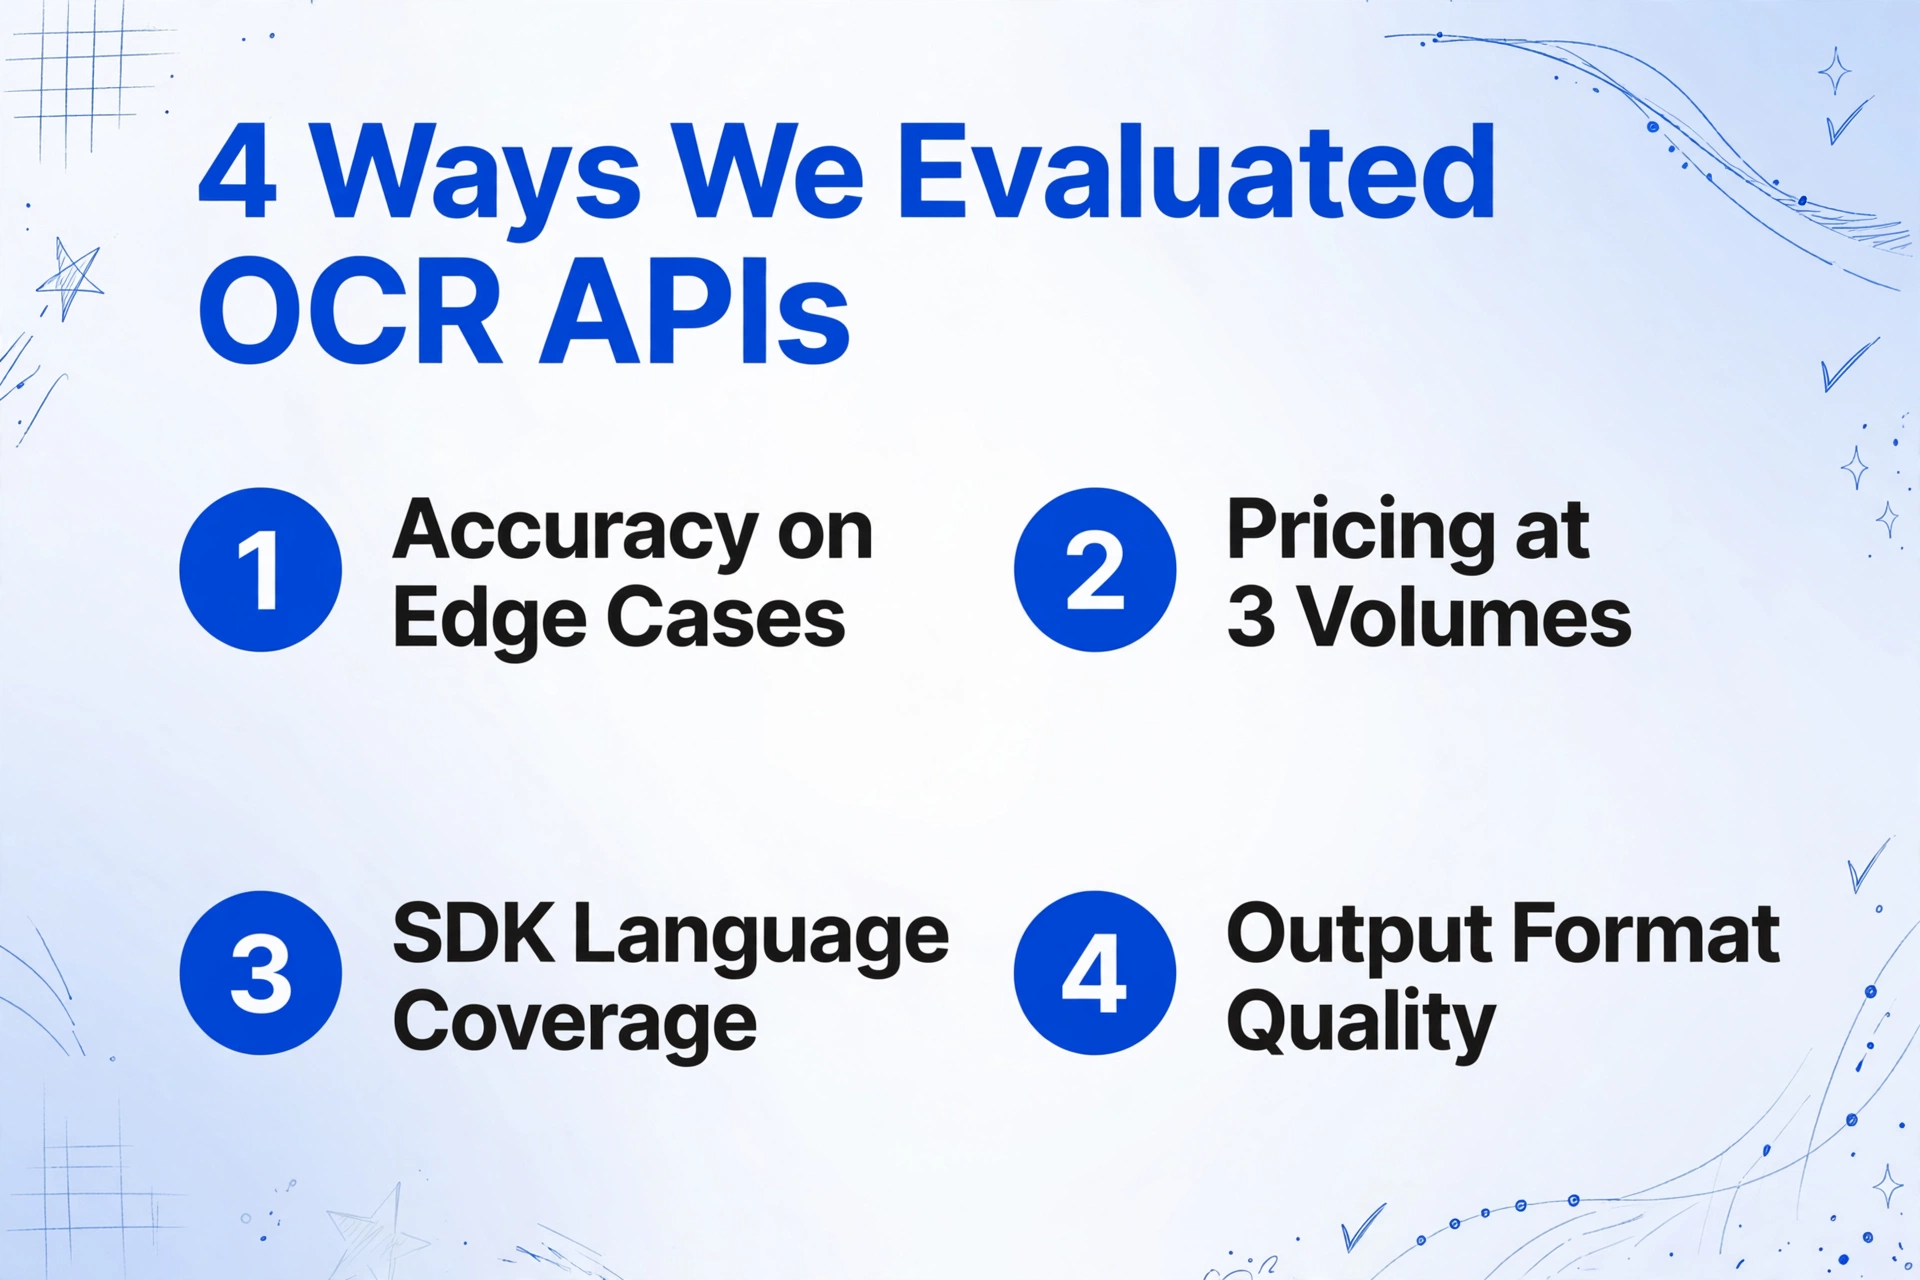
Cada dimensión de evaluación que se presenta a continuación se verificó contra la documentación oficial, las páginas de precios publicadas y los repositorios de SDK para desarrolladores. Cuando existían puntos de referencia independientes (olmOCR benchmark, OmniDocBench, IDP Leaderboard), se contrastaron con informes prácticos de desarrolladores en las comunidades de Stack Overflow y Reddit.
1. Precisión: texto impreso, escritura a mano, tablas y formularios
Para texto impreso en documentos limpios, todas las principales APIs en la nube ofrecen una precisión del 97–99 % en condiciones normales. La divergencia aparece en la escritura a mano, escaneos de baja calidad, tablas complejas y documentos multilingües. Evaluamos los rangos de precisión declarados de cada API para estos casos límite y sopesamos la validación comunitaria del rendimiento en el mundo real.
2. Precios: por página, por 1.000 páginas y costos ocultos
El precio de las APIs de OCR parece engañosamente simple a primera vista: la mayoría de los proveedores cotizan una tarifa principal de $1.50 por cada 1.000 páginas. El costo real depende del endpoint de la API que utilice (texto básico, análisis de formularios o consultas personalizadas) y de si se mantiene dentro del primer nivel de precios. Calculamos el costo total en tres niveles de volumen: 1.000 páginas, 10.000 páginas y 100.000 páginas al mes.
3. Compatibilidad con SDK y lenguajes
Un buen SDK marca la diferencia entre una integración de un día y una odisea de una semana. Verificamos la disponibilidad de SDK oficiales para Python, Node.js, Java, Go, .NET, Ruby y PHP: los siete lenguajes que cubren la gran mayoría de los casos de uso de backend y procesamiento de datos.
4. Calidad del formato de salida
El texto sin formato es lo básico. El factor diferenciador es si la API devuelve coordenadas de cuadros delimitadores por palabra o línea, preserva la estructura jerárquica de las tablas, extrae pares clave-valor de formularios y genera puntuaciones de confianza. Evaluamos cada API según la riqueza de su respuesta JSON.
5. Latencia y rendimiento
Las respuestas síncronas en menos de dos segundos son esenciales para aplicaciones interactivas. El rendimiento por lotes (páginas por minuto a escala) es importante para los pipelines de procesamiento en segundo plano. Observamos las características de latencia documentadas de cada API.
6. Ecosistema en la nube e integraciones nativas
Una API que se conecta directamente a S3, Cloud Storage o Blob Storage — y que alimenta los datos extraídos a un almacén de datos o ERP — ahorra semanas de ingeniería de pipelines. Evaluamos la profundidad de integración de cada API con su plataforma en la nube matriz y con servicios de terceros.
API de Google Cloud Vision
Google Cloud Vision es la API de OCR más amplia del mercado, no porque sea la más precisa para cada tipo de documento, sino porque maneja todo, desde señales de tráfico hasta páginas densas de contratos, a través de un único endpoint. Divide el OCR en dos llamadas: TEXT_DETECTION para texto de escena (señales, etiquetas, fotos) y DOCUMENT_TEXT_DETECTION para páginas densas de documentos, esta última optimizada mediante el pipeline de Document AI de Google.
Precios. Las primeras 1,000 unidades por mes por función son gratuitas. Después, la detección de texto cuesta $1.50 por cada 1,000 imágenes hasta 5 millones, y baja a $0.60 a partir de ahí. La detección de texto de documentos sigue el mismo nivel. A través de Document AI, los procesadores especializados (Invoice Parser, Expense Parser) cobran $0.10 por cada 10 páginas, notablemente más barato que el análisis de formularios de Textract para documentos financieros.
Compatibilidad con SDK. Python, Node.js, Java, Go, C#, PHP y Ruby, todos de primera parte y todos mantenidos. Las bibliotecas cliente de Google se encuentran entre las más maduras del espacio de OCR en la nube.
Calidad de salida. La respuesta JSON incluye cuadros delimitadores por palabra, puntuaciones de confianza y bloques de diseño a nivel de página. Los procesadores de Document AI añaden pares clave-valor y estructuras de tablas, aunque la reconstrucción de tablas requiere posprocesamiento en comparación con la salida de tablas nativa de Textract.
Ideal para equipos que ya están en Google Cloud, aplicaciones que necesitan tanto OCR de texto de escena como OCR de documentos a través de un solo SDK, y proyectos que se beneficien de integraciones con Vertex AI o BigQuery en el futuro.
No es ideal para extracción intensiva de tablas a gran escala (Textract es más barato y más estructurado) o flujos de trabajo que necesiten mantenerse independientes de la nube.
AWS Textract
Amazon Textract fue creado específicamente para la comprensión de documentos, más que para el análisis general de imágenes, y se nota. Su API AnalyzeDocument expone indicadores de funciones separados para Tablas, Formularios, Consultas y Firmas, lo que le permite pagar solo por la profundidad de extracción que necesite. La función de Tablas devuelve la estructura nativa de filas y columnas con confianza por celda; la función de Formularios extrae pares clave-valor sin configuración de plantilla.
Precios. El DetectDocumentText básico cuesta $1.50 por cada 1,000 páginas (primer millón) y $0.60 más allá. Las Tablas añaden $15 por cada 1,000 páginas; los Formularios añaden $50 por cada 1,000 páginas; las Consultas añaden $15 por cada 1,000 páginas. Para el procesamiento de facturas, la API AnalyzeExpense cuesta entre $8 y $10 por cada 1,000 páginas, diseñada específicamente para documentos financieros y, en general, más precisa que ejecutar un análisis genérico de Formularios. El nivel gratuito incluye 1,000 páginas de DetectDocumentText al mes durante los primeros tres meses.
Compatibilidad con SDK. Python, Node.js, Java, Go, .NET, PHP, Ruby: todos los SDK de AWS de primera parte. Las API de paginación y asíncronas de Textract están bien documentadas con ejemplos funcionales en cada lenguaje.
Calidad de salida. La salida de tablas de Textract es el referente de la industria para la extracción estructurada. La respuesta JSON conserva el intervalo de filas, el intervalo de columnas, las celdas combinadas y la confianza por celda. La extracción de Formularios devuelve pares clave-valor con cuadros delimitadores y relaciones. Las Consultas admiten preguntas en lenguaje natural sobre documentos, una capacidad única para la extracción de campos ad hoc.
Ideal para stacks nativos de AWS, cualquier proyecto que necesite extracción de tablas o formularios de alta fidelidad, y equipos que quieran combinar OCR con Lambda, disparadores de eventos S3 o Step Functions para pipelines de procesamiento de documentos.
No es ideal para OCR general de texto en escenas (la Vision API es mejor) o equipos que quieran costos predecibles sin niveles de precios basados en funciones.
Azure Document Intelligence
Azure Document Intelligence (antes Azure Form Recognizer) ofrece la integración más estrecha con el ecosistema de Microsoft: Logic Apps, Power Automate, Power BI y SharePoint. Sus modelos predefinidos cubren facturas, recibos, documentos de identidad, tarjetas de seguro médico, formularios W-2, formularios de impuestos 1098 y contratos. El modelo Layout extrae tablas y texto con preservación de la estructura.
Precios. El modelo Read (OCR básico + diseño) cuesta $1.50 por cada 1,000 páginas, con 500 páginas gratuitas al mes. El análisis de documentos predefinidos cuesta aproximadamente $10 por cada 1,000 páginas. La extracción personalizada comienza en $30 por cada 1,000 páginas para entrenamiento e inferencia. Las 500 páginas gratuitas mensuales del nivel gratuito son menos generosas que las 1,000 de Google, pero suficientes para prototipos.
Compatibilidad con SDK. Python, Node.js, Java, .NET (C#) y Go: una sólida compatibilidad de primera parte. El SDK de .NET está especialmente bien mantenido, lo que refleja la base de clientes empresariales de .NET de Azure.
Calidad de salida. El modelo Layout devuelve tablas, marcas de selección (casillas de verificación) y estructura de párrafos con cuadros delimitadores y puntuaciones de confianza. Los modelos predefinidos añaden extracción de campos específicos del documento (p. ej., partidas de factura, nombre del comercio en recibos). La salida JSON está bien estructurada, pero es menos granular por celda que Textract en escenarios de tablas complejas.
Ideal para organizaciones que ya usan Microsoft 365 o Azure, escenarios que necesitan flujos de Power Automate y equipos que valoran la documentación de cumplimiento predefinida (SOC 2, HIPAA, GDPR).
No es ideal para OCR básico de alto volumen donde OCR.space o Tesseract serían más económicos, o para equipos que prefieren la madurez del SDK de Google o AWS.
Tesseract (Código abierto autohospedado)
Tesseract, desarrollado originalmente por HP y ahora mantenido por Google, sigue siendo el punto de partida predeterminado para los desarrolladores que quieren control total sobre su canalización de OCR. Admite más de 100 idiomas, funciona en cualquier plataforma y no cuesta nada más allá del cómputo. Pero «gratis» no es lo mismo que «barato»: el tiempo de ingeniería necesario para poner Tesseract en producción puede superar el costo de una suscripción a una API en la nube en pocas semanas.
Precios. Gratis. El único costo es la infraestructura: una VM o un contenedor modesto. Para procesamiento de alto volumen (más de 1M de páginas al mes), Tesseract autohospedado en una instancia de CPU normalmente alcanza el punto de equilibrio con las API en la nube entre 100,000 y 130,000 páginas al mes, según la complejidad del documento.
Compatibilidad con SDK. Python (pytesseract), C++ (nativo), Java (Tess4J), Node.js (tesseract.js). El envoltorio de Python es el más utilizado, con amplia documentación comunitaria y cobertura en Stack Overflow. Sin embargo, la madurez del SDK varía significativamente: tesseract.js se ejecuta completamente en el navegador, pero es más lento que la compilación nativa.
Calidad de salida. En documentos impresos limpios con buena resolución y fondos uniformes, Tesseract alcanza una precisión a nivel de palabra del 95–99%. En escaneos de baja calidad, páginas inclinadas o documentos con fuentes decorativas, la precisión cae drásticamente. Tiene soporte nativo mínimo para estructura de tablas: la salida es texto plano con posicionamiento por espacios. El reconocimiento de escritura a mano no es fiable sin entrenamiento adicional del modelo. Los formatos de salida hocr y ALTO proporcionan cuadros delimitadores, pero sin comprensión semántica de los campos.
Ideal para equipos que necesitan soberanía de datos (ningún dato sale del servidor), procesamiento de alto volumen donde el costo de infraestructura es menor que las tarifas por página de las API, y desarrolladores que se sienten cómodos ajustando pipelines de preprocesamiento (enderezado, binarización, segmentación de páginas).
No es ideal para equipos que necesitan extracción lista para producción en días en lugar de semanas, documentos con diseños complejos o escritura a mano, o cualquier escenario donde la carga de mantenimiento deba ser mínima.
Para una comparación más profunda entre Tesseract y los enfoques modernos de extracción, consulte nuestro artículo sobre OCR vs AI Extraction.
ABBYY Cloud OCR SDK
ABBYY Cloud OCR SDK lleva más de tres décadas en el negocio de OCR, y su Cloud OCR SDK refleja esa madurez. Admite más de 200 idiomas de reconocimiento (incluidos 126 idiomas manuscritos), preserva el diseño del documento con alta fidelidad y maneja la extracción basada en zonas junto con OCR de página completa. La fortaleza de ABBYY es la consistencia en una calidad de entrada variada: donde Tesseract podría tener dificultades con un escaneo ligeramente inclinado, el motor de preprocesamiento de ABBYY lo compensa.
Precios. Cloud OCR SDK comienza en $99 por mes por 5,000 páginas. Las implementaciones empresariales (1M+ páginas/año) suelen negociar tarifas por página en el rango de $0.02–$0.10 con compromisos anuales a partir de aproximadamente $15,000. No hay un nivel gratuito permanente, solo pruebas. Para equipos pequeños, esto hace que ABBYY sea significativamente más caro que las API de los hiperescaladores en la nube.
Soporte de SDK. Python, Java, .NET (C#) y C++: sólido pero más limitado que el trío de la nube. La API REST está completamente documentada y hay ejemplos de código disponibles para todos los lenguajes compatibles.
Calidad de salida. La preservación del diseño de ABBYY está entre las mejores de la industria: reconstruye la estructura original del documento, incluidas columnas, tablas, encabezados y pies de página. Su salida XML (a través del motor FineReader) es el formato más rico disponible para el procesamiento posterior de documentos. El reconocimiento de escritura a mano en 126 idiomas es un diferenciador que solo un puñado de API iguala.
Ideal para proyectos empresariales de digitalización de documentos donde la fidelidad del diseño es crítica, industrias reguladas (finanzas, salud, gobierno) que necesitan opciones de implementación local, y OCR multilingüe a escala tanto en impresos como en escritura a mano.
No es ideal para startups o equipos pequeños con presupuestos limitados, prototipado rápido, o proyectos donde los costos por página deben mantenerse por debajo de $0.01.
Mindee
Mindee es una de las API de OCR más amigables para desarrolladores disponibles en la actualidad. Su documentación es clara, sus respuestas de API son consistentes y sus modelos preentrenados (facturas, recibos, pasaportes, licencias de conducir, currículums y más) funcionan de inmediato sin ningún paso de entrenamiento. Mindee toma una decisión de diseño deliberada: en lugar de ofrecer un endpoint de OCR genérico y dejar la lógica de extracción en sus manos, devuelve JSON a nivel de campo que se asigna directamente a su modelo de datos.
Precios. El plan Developer es gratuito para 250 páginas al mes (sin necesidad de tarjeta de crédito). Los planes de pago comienzan en €44/mes (aproximadamente $47) para 500 páginas facturadas anualmente, con páginas adicionales a €0.05 cada una. El plan Pro (€179/mes) incluye 2,500 páginas a €0.04 por página adicional. Los precios empresariales bajan hacia €0.01 por página en volúmenes altos. Esta es una de las estructuras de precios más transparentes en el espacio de las API de OCR: sin niveles ocultos ni costos sorpresa por funciones.
Soporte de SDK. Python, Node.js, Java, Go, Ruby, PHP y .NET: la cobertura de SDK más amplia fuera de los tres grandes proveedores de nube. Todos los SDK se generan automáticamente a partir de la especificación OpenAPI, lo que significa que se mantienen actualizados con la API. En Reddit r/programming y r/MachineLearning, el SDK de Python de Mindee se cita con frecuencia como el más intuitivo para la creación rápida de prototipos.
Calidad de salida. La extracción a nivel de campo de Mindee devuelve JSON estructurado con puntuaciones de confianza por campo. Para facturas, esto significa matrices de líneas de artículo con descripciones, cantidades, precios unitarios y totales, no texto sin procesar que deba analizar usted mismo. La desventaja es que Mindee está optimizado para tipos de documentos específicos en lugar de documentos arbitrarios; para un formulario genérico con campos personalizados, necesitaría entrenar un modelo personalizado.
Ideal para desarrolladores que quieren JSON a nivel de campo de inmediato (sin posprocesamiento con regex), equipos que valoran la calidad de la documentación y la madurez del SDK, y proyectos que procesan tipos de documentos estándar (facturas, recibos, identificaciones, pasaportes, currículums).
No es ideal para diseños de documentos arbitrarios sin modelos predefinidos, OCR de texto en escenas (señales de calle, pizarras blancas) o casos de uso donde la implementación local sea obligatoria.
Nanonets
Nanonets se posiciona entre la API de OCR y la plataforma de flujos de trabajo con IA. Su principal diferenciador es el entrenamiento de modelos personalizados: usted sube documentos de muestra y Nanonets aprende a extraer los campos que le interesan, sin necesidad de escribir reglas de extracción. Para equipos que procesan documentos no estándar, este enfoque basado en entrenamiento suele ofrecer mayor precisión que los modelos genéricos preentrenados.
Precios. Nanonets comienza en $499 al mes por hasta 10 000 páginas, un salto significativo frente a los precios de las API en la nube. La extracción adicional cuesta aproximadamente $0.30 por página, más cargos separados por formato, búsquedas e integraciones premium. Las reseñas de desarrolladores en G2 y Reddit mencionan con frecuencia la imprevisibilidad de los costos a medida que escala el volumen. El plan gratuito ofrece 500 páginas con tarjeta de crédito.
Compatibilidad con SDK. Python, Node.js, Java y Go: estos cuatro cubren la mayoría de los casos de uso. El SDK de Python es el más completo en funciones, con ejemplos de procesamiento por lotes, entrenamiento de modelos personalizados y automatización de flujos de trabajo.
Calidad de salida. Para documentos que coinciden con su conjunto de entrenamiento, Nanonets logra una alta precisión a nivel de campo. Su reciente modelo Nanonets OCR-3 (lanzado en abril de 2026) obtuvo 93.1 en el punto de referencia olmOCR y 90.5 en OmniDocBench, situándose en el nivel superior de los modelos comerciales de OCR. La salida JSON incluye confianza por campo y cuadros delimitadores.
Ideal para equipos que necesitan extraer campos personalizados de documentos no estándar, organizaciones que se benefician del motor de flujos de trabajo integrado (aprobaciones, validaciones, notificaciones de Slack) y empresas de mercado medio que desean OCR más flujos de trabajo en una sola plataforma.
No es ideal para equipos con presupuesto limitado (los precios escalan rápidamente), extracción de texto simple donde Tesseract u OCR.space serían suficientes, o proyectos que necesiten integraciones nativas con proveedores de nube.
Veryfi
Veryfi se especializa en OCR de documentos financieros: recibos, facturas, extractos bancarios, cheques y formularios W-2. A diferencia de las API de OCR de uso general que devuelven texto sin procesar y le dejan a usted la identificación de campos, Veryfi devuelve JSON listo para contabilidad: nombre del comerciante, fecha, total, impuestos, partidas, tipo de pago y categoría. Esta especialización lo convierte en la vía más rápida desde el recibo escaneado hasta el asiento contable.
Precios. Veryfi ofrece un nivel gratuito de 100 documentos en total (no por mes). El plan Starter requiere un compromiso mínimo de $500/mes, que cubre aproximadamente 5,000 recibos o 3,125 facturas a $0.08 por recibo y $0.16 por factura. Esta estructura de precios funciona bien para procesamiento de alto volumen, pero crea una barrera de entrada alta para proyectos más pequeños. Los planes Growth y Enterprise se cotizan de forma personalizada.
Soporte de SDK. Python, Node.js, Java, Go, C# y PHP: una cobertura sólida en lenguajes de backend. Los SDK incluyen soporte integrado para carga de archivos desde URL, archivos locales e imágenes codificadas en base64. Veryfi también ofrece SDK móviles para captura de documentos en iOS y Android.
Calidad de salida. La extracción de documentos financieros de Veryfi es de las más precisas en su nicho. Su API de LLM multimodal (AnyDocs) extiende el mismo enfoque a tipos de documentos arbitrarios. La respuesta incluye más de 38 idiomas, más de 91 monedas, categorías y partidas normalizadas. En Reddit r/bookkeeping y r/accounting, Veryfi se menciona con frecuencia como la API de referencia para flujos de trabajo con muchos recibos.
Ideal para aplicaciones de gestión de gastos, productos fintech que procesan recibos y facturas a escala, y firmas contables que crean canalizaciones automatizadas de ingesta de datos.
No es ideal para necesidades de OCR de uso general (es excesivo para extracción de texto simple), evaluaciones a pequeña escala (el mínimo de $500 es difícil de justificar para prototipos) o tipos de documentos no financieros.
OCR.space
OCR.space es la mejor API de OCR gratuita para proyectos de alto volumen con presupuesto limitado. Su nivel gratuito — 25,000 solicitudes al mes sin tarjeta de crédito — no tiene comparación con ninguna otra API comercial. Se sacrifica algo de precisión y funciones en comparación con el trío de la nube, pero para documentos impresos limpios donde una precisión del 90–95 % es aceptable, OCR.space es difícil de superar en cuanto a costo.
Precios. El nivel gratuito incluye 25,000 solicitudes al mes (límite de 500/día) con un límite de tamaño de archivo de 1 MB. El plan PRO cuesta $29.99/mes por 300,000 solicitudes, archivos de 5 MB y procesamiento más rápido. El plan PRO PDF ($59.99/mes) añade soporte para PDF de varias páginas (hasta 999 páginas). Los planes empresariales comienzan en $999/mes para servidores dedicados. En comparación con las API de la nube a $1.50 por cada 1,000 páginas, el nivel gratuito de OCR.space es prácticamente ilimitado para proyectos de bajo volumen.
Soporte de SDK. OCR.space no ofrece SDK específicos por idioma — la comunicación se realiza a través de su API REST. Sin embargo, existen envoltorios mantenidos por la comunidad para Python, JavaScript, PHP y Java. La API devuelve JSON con cuadros delimitadores por palabra y puntuaciones de confianza.
Calidad de salida. En texto impreso limpio y de alto contraste, OCR.space alcanza aproximadamente un 90–95 % de precisión de caracteres — suficiente para PDFs buscables y extracción de datos de formularios sencillos. La precisión disminuye con fuentes pequeñas, diseños inusuales, escritura a mano o imágenes de baja resolución. No hay extracción de tablas nativa; los datos de tablas se devuelven como texto con coordenadas posicionales pero sin estructura de filas/columnas.
Ideal para prototipos y MVP donde el presupuesto es la principal limitación, herramientas internas que procesan documentos impresos limpios y desarrolladores que necesitan una API sin compromiso para probar patrones de integración de OCR antes de comprometerse con un proveedor de pago.
No es ideal para sistemas de producción que requieren una precisión superior al 99 %, diseños complejos (tablas, formularios), reconocimiento de escritura a mano o cualquier escenario donde la precisión por documento afecte directamente los resultados comerciales.
Base64.ai
Base64.ai es una API de OCR poco conocida pero técnicamente impresionante que se posiciona como "una API para cualquier documento". Admite más de 100 tipos de documentos, desde registros médicos y formularios de seguros hasta pasaportes, contratos y facturas, con modelos de aprendizaje profundo entrenados para cada tipo. Su principal atractivo es manejar casos extremos: páginas rotadas, documentos doblados, anotaciones manuscritas y páginas con diseños mixtos.
Precios. Base64.ai utiliza precios personalizados por página según el tipo de documento y el volumen, sin una tarifa estándar pública. Los posibles clientes deben contactar con ventas para obtener un presupuesto, lo que dificulta evaluar el costo sin una prueba piloto. Espere precios entre las API de nivel empresarial (nivel ABBYY) y los hiperescaladores de la nube.
Soporte de SDK. API REST con envoltorios de la comunidad para Python y JavaScript. La integración principal se realiza mediante solicitudes HTTP directas con cargas JSON. Base64.ai también se integra con Zapier y Slack para la automatización de flujos de trabajo.
Calidad de salida. La calidad de extracción de Base64.ai es sólida en los tipos de documentos compatibles, especialmente para documentos de identidad, formularios financieros y registros médicos. La respuesta JSON incluye confianza por campo, cuadros delimitadores y etiquetas de clasificación de documentos. Para escritura a mano en formularios, rinde mejor que Tesseract u OCR.space, pero por detrás del reconocimiento de escritura dedicado de ABBYY.
Ideal para industrias con gran volumen de documentos (seguros, salud, legal) que procesan diversos tipos de documentos mediante una sola integración, equipos que necesitan un gestor de cuentas dedicado para la configuración, y escenarios donde la clasificación de documentos y la extracción en una sola API reducen la complejidad de la arquitectura.
No es ideal para equipos con presupuesto limitado (sin precios de autoservicio), creación rápida de prototipos sin una conversación comercial, o proyectos que necesiten infraestructura nativa del proveedor de la nube.
Menciones honoríficas: otras APIs que vale la pena conocer
Además de las diez APIs analizadas anteriormente, otros servicios merecen una breve mención para casos de uso específicos:
LlamaParse está diseñado específicamente para pipelines RAG y agentes de documentos. Preserva la estructura semántica y genera markdown, lo que lo convierte en una opción sólida para ingenieros de IA que crean sistemas de generación aumentada por recuperación. El precio comienza con un plan gratuito de 1,000 páginas por día y luego $0.003 por página.
Clarifai ofrece una plataforma de IA integral con capacidades de OCR a través de sus modelos de comprensión de documentos. Su plan de pago por uso (máximo $100/mes por defecto) y el plan para desarrolladores a $1/mes (primer año) lo convierten en una de las opciones más asequibles para equipos que también necesitan reconocimiento de imágenes y entrenamiento de modelos en la misma plataforma.
Rossum es una plataforma IDP empresarial optimizada para el procesamiento de facturas a gran escala. El precio comienza en $18,000/año, lo que lo sitúa firmemente en el nivel empresarial junto a ABBYY. La fortaleza de Rossum es su motor de validación impulsado por IA y sus integraciones con ERP (SAP, Coupa, Workday), pero para la mayoría de los casos de uso de desarrolladores, el costo de entrada es prohibitivo.
Estas plataformas no se incluyeron en la comparación principal porque su público objetivo (creadores de pipelines RAG, usuarios de plataformas de IA integrales, equipos de AP empresariales) es más reducido que el alcance general de OCR para desarrolladores de esta guía.
¿Qué API es la adecuada para tu caso de uso?
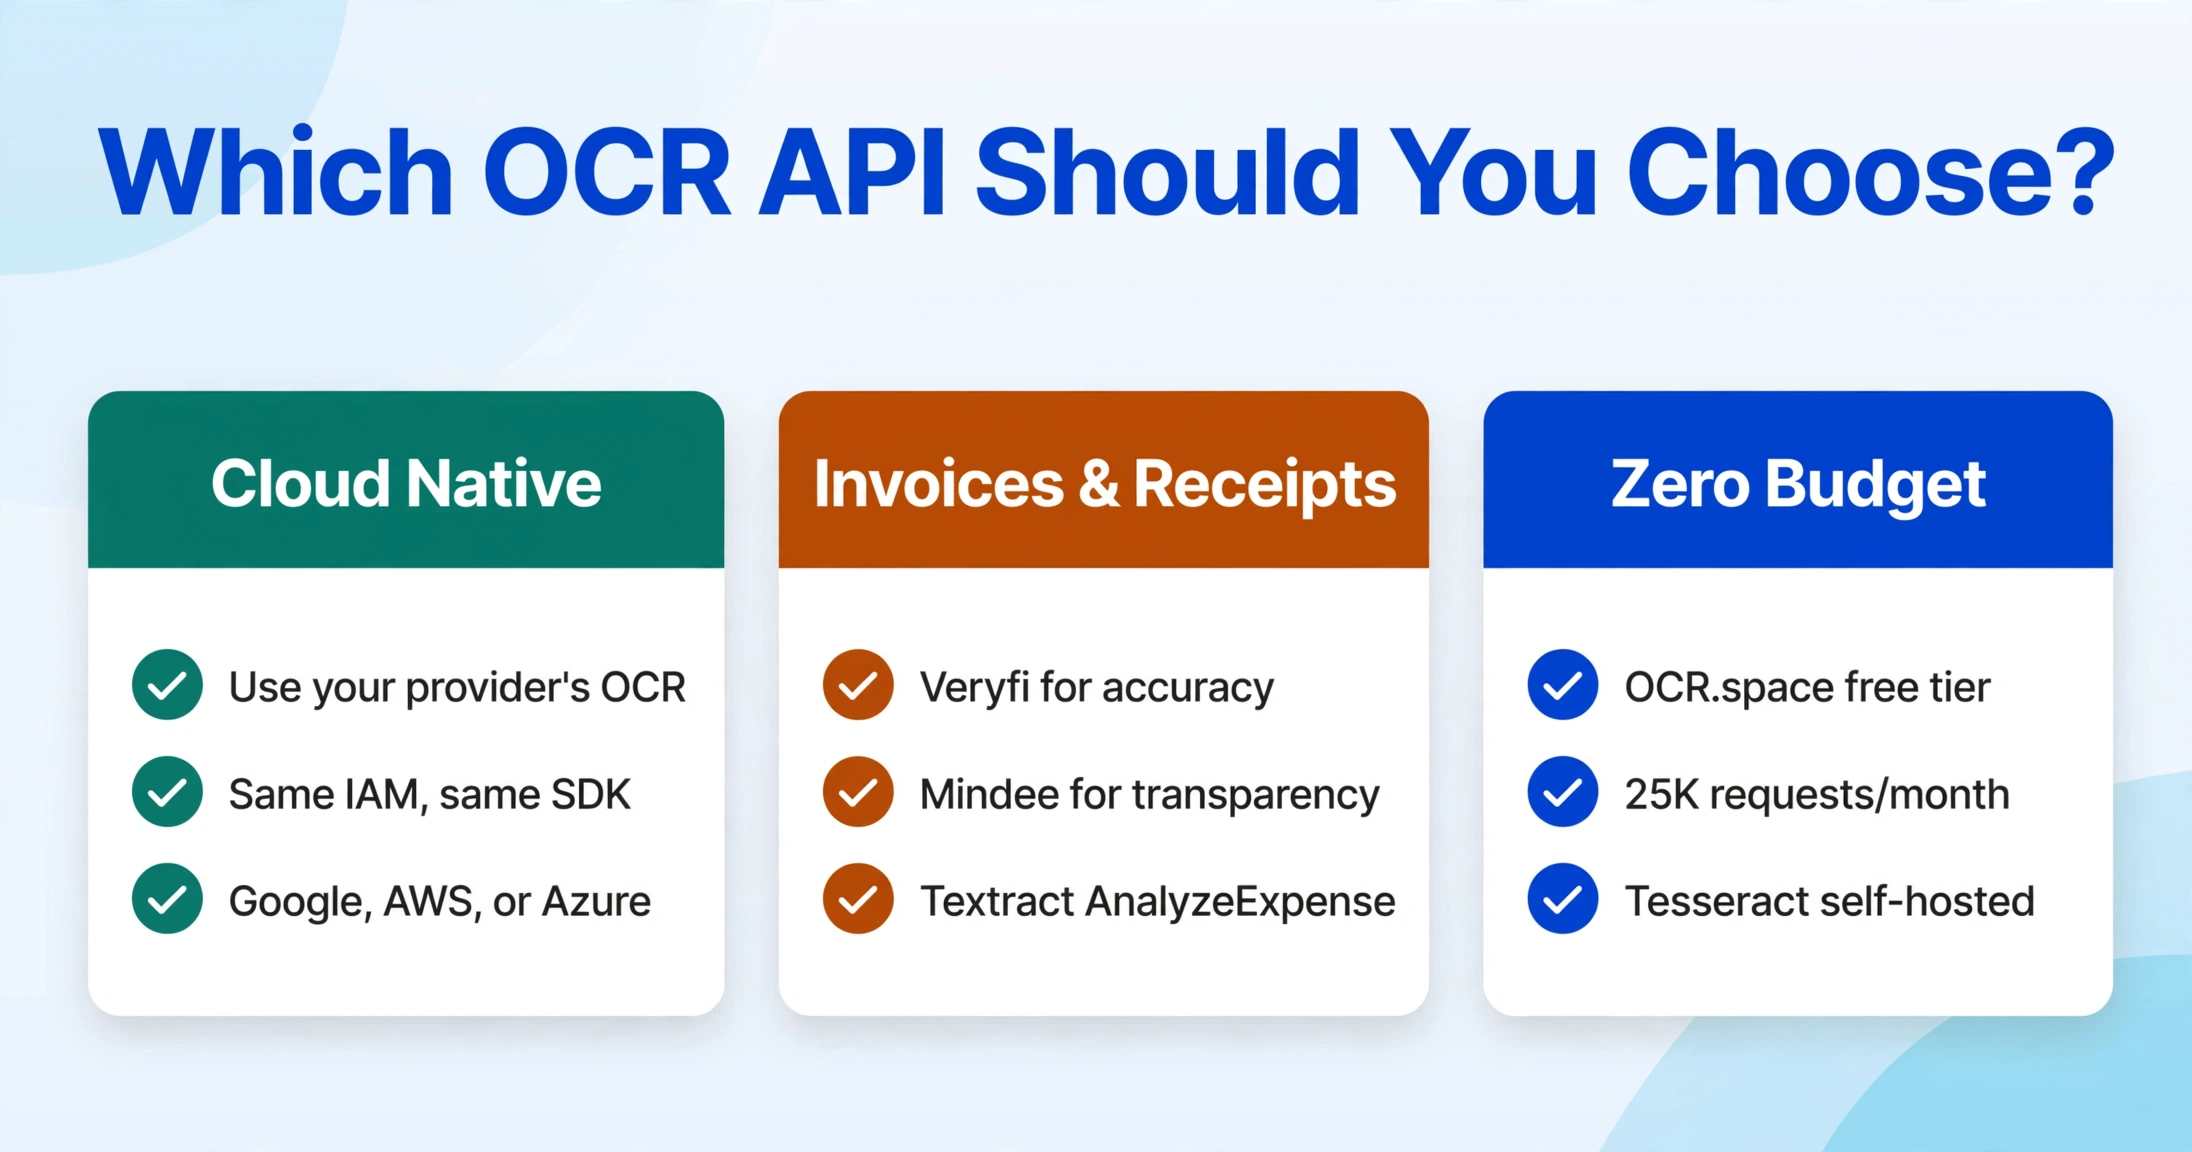
La respuesta depende de tus tipos de documentos, presupuesto, cronograma y ecosistema. No existe una única "mejor API de OCR": la opción correcta es la que minimiza el costo total de integración, operación y mantenimiento para tu escenario específico. Estas son seis situaciones comunes y las APIs que mejor se adaptan:
Está creando una función de OCR general y ya usa Google Cloud, AWS o Azure
Use la API de OCR de su proveedor de nube. El ahorro en costos de integración por sí solo (mismo IAM, mismo SDK, misma red) supera los casos límite de precisión. Google Cloud Vision para texto de escenas + OCR de documentos; AWS Textract si necesita formularios y tablas; Azure Document Intelligence si está en el ecosistema de Microsoft.
Procesa facturas y recibos a gran escala
Veryfi está diseñado específicamente para esto y tiene la mejor precisión en documentos financieros. Mindee es una sólida segunda opción con mejor transparencia de precios y sin un mínimo de $500/mes. La API AnalyzeExpense de AWS Textract ($8–10/1K páginas) es una alternativa viable si ya está en AWS.
Necesita extracción de tablas y formularios con alta fidelidad
La función Tables de AWS Textract sigue siendo el estándar de oro para la estructura nativa de tablas en JSON. El modelo Layout de Azure Document Intelligence le sigue de cerca, con mejor extracción de casillas y marcas de selección. Para cumplimiento empresarial y preservación del diseño, el SDK de ABBYY es la opción más probada.
Su presupuesto es casi cero y los documentos son páginas impresas limpias
El nivel gratuito de OCR.space (25,000 solicitudes/mes) es la mejor opción. Si necesita mayor precisión y puede invertir tiempo de ingeniería, Tesseract con un preprocesamiento adecuado superará a OCR.space en precisión a costa del esfuerzo de configuración. Para una comparación de la economía de OCR autohospedado vs. en la nube, consulte nuestra guía de herramientas de OCR de código abierto.
Necesita extracción de campos personalizados de documentos no estándar
Nanonets ofrece el flujo de entrenamiento de modelos personalizados más accesible: suba muestras, defina campos y entrene sin programar. Los modelos personalizados de Mindee siguen un flujo de trabajo similar con un precio de entrada más bajo. El Custom Extractor de Google Document AI y la Extracción personalizada de Azure funcionan, pero requieren más familiaridad con las plataformas en la nube.
Desea extraer documentos sin escribir ningún código de integración
Si su equipo no tiene la capacidad para gestionar integraciones de API, autenticación, manejo de errores y análisis de resultados, una herramienta sin código como ImageToTable.ai ofrece la misma capacidad de extracción a través de una interfaz web o un complemento de Google Sheets — sin clave de API, sin SDK, sin canalización de implementación. Suba archivos o PDF, defina sus columnas y obtenga datos estructurados en segundos. La desventaja es el rendimiento: las API ganan en escala de automatización, pero para conjuntos de documentos ad hoc o equipos sin recursos de ingeniería dedicados, el enfoque sin código ofrece un tiempo de obtención de valor más rápido. Para entender cómo este enfoque difiere de la OCR tradicional, lea ¿Qué es la IA OCR?
Preguntas Frecuentes
¿Qué OCR API es mejor para desarrolladores que crean una aplicación de producción?
Mindee ofrece el mejor equilibrio entre experiencia de desarrollo, calidad de documentación, cobertura de SDK (7 idiomas) y precios transparentes para cargas de trabajo de producción por debajo de 10,000 páginas al mes. Para stacks nativos de AWS, Textract es la opción lógica. Para stacks nativos de Google Cloud, Cloud Vision + Document AI. La "mejor" API depende más de su infraestructura existente que de la precisión bruta del OCR, porque todas las principales APIs de nube ofrecen más del 97% de precisión en documentos limpios.
¿Cuál es la OCR API más económica para procesamiento de alto volumen?
Para autogestionado, Tesseract es gratuito pero requiere tiempo de ingeniería para ponerlo en producción. Para una API gestionada a escala, DetectDocumentText de AWS Textract a $1.50/1K páginas (y $0.60/1K por encima de 1M páginas) se encuentra entre las tarifas por página más económicas. El plan PRO de OCR.space a $29.99/mes por 300,000 solicitudes es la mejor relación calidad-precio en volumen bajo a medio. A muy alto volumen (1M+ páginas/mes), negociar tarifas personalizadas con cualquier proveedor importante suele resultar en el menor costo por página.
¿Pueden las OCR APIs manejar escritura a mano?
Sí, pero la calidad varía significativamente. ABBYY Cloud OCR SDK tiene el reconocimiento de escritura a mano más maduro, soportando 126 idiomas manuscritos en su modo ICR basado en zonas. El soporte de escritura a mano de Google Cloud Vision maneja razonablemente bien la escritura impresa. Para escritura cursiva o documentos mixtos escritos a mano, los enfoques más nuevos de modelos de visión-lenguaje (Gemini, GPT-5, Mistral OCR 3 accesibles a través de APIs de nube) a menudo superan a los motores OCR tradicionales, pero a un costo por página más alto. Consulte nuestra guía de OCR para escritura a mano para una comparación más detallada.
¿La OCR API preserva la estructura de tablas?
AWS Textract devuelve JSON de tablas nativas con filas y columnas, con puntuaciones de confianza por celda: esta es la salida de tablas más amigable para desarrolladores disponible. El modelo Layout de Azure Document Intelligence también preserva la estructura de tablas con cuadros delimitadores. Document AI de Google Cloud Vision devuelve bloques de tablas pero requiere más posprocesamiento para una reconstrucción estructural confiable. Tesseract y OCR.space devuelven texto con datos posicionales pero sin inferencia de estructura de tablas.
¿Qué API de OCR admiten la mayor cantidad de lenguajes de programación?
Google Cloud Vision, AWS Textract y Mindee ofrecen SDK de primera parte para Python, Node.js, Java, Go y al menos tres lenguajes adicionales. El SDK de .NET de Azure Document Intelligence es particularmente sólido. Para soporte de lenguajes de nicho (PHP, Ruby), Google y AWS tienen la cobertura más amplia en todos sus SDK.
¿Qué niveles gratuitos de API de OCR están disponibles en 2026?
OCR.space ofrece el nivel gratuito más generoso con 25,000 solicitudes/mes. Google Cloud Vision ofrece 1,000 unidades/mes gratis. AWS Textract ofrece 1,000 páginas/mes durante los primeros 3 meses. Azure Document Intelligence ofrece 500 páginas/mes. El plan Developer de Mindee incluye 250 páginas/mes gratis sin necesidad de tarjeta de crédito. Veryfi incluye 100 documentos gratis (no recurrentes). Tesseract es gratuito pero autohospedado.
¿Qué API admiten procesamiento síncrono frente a asíncrono?
Google Cloud Vision, AWS Textract y Azure Document Intelligence admiten ambos modos: síncrono (página única, latencia de subsegundo) y asíncrono (lote de varias páginas). Mindee, Veryfi y Nanonets usan procesamiento síncrono por defecto con opciones asíncronas para cargas de trabajo por lotes. OCR.space es solo síncrono. Para aplicaciones interactivas, asegúrese de que la API elegida ofrezca respuestas síncronas en menos de 2 segundos.
¿Puedo ejecutar API de OCR en las instalaciones o en una nube privada?
Tesseract y otros motores de código abierto (PaddleOCR, EasyOCR) se ejecutan en cualquier lugar. ABBYY ofrece implementación en las instalaciones para su plataforma FlexiCapture. AWS Textract, Google Cloud Vision y Azure Document Intelligence son solo de nube, aunque Azure ofrece implementaciones de contenedores conectados para algunas funciones de Document Intelligence. Para datos sensibles (PII, PHI), Tesseract con preprocesamiento local seguido de una llamada a la API en la nube (con enmascaramiento de datos) es un patrón híbrido común.
¿Qué pasa si no quiero integrar una API de OCR en absoluto?
Las API de OCR son la opción correcta cuando necesita acceso programático a escala. Pero si procesa documentos ocasionalmente — o si su equipo no tiene capacidad de ingeniería para la integración de API — las herramientas de extracción sin código ofrecen un camino más rápido hacia datos estructurados. ImageToTable.ai le permite subir documentos, nombrar sus columnas y obtener resultados de tablas estructuradas sin escribir código. El complemento de Google Sheets lleva esto más allá: suba directamente desde su hoja de cálculo y obtenga datos añadidos a la hoja activa — sin clave de API, sin SDK, sin servidor que administrar. Es una compensación diferente a la de una API de OCR (menos automatización, cero configuración), pero para el caso de uso adecuado, es la respuesta más rápida.
¿Qué API de OCR admite más idiomas?
ABBYY Cloud OCR SDK lidera con más de 200 idiomas impresos y 126 idiomas manuscritos. Google Cloud Vision admite más de 200 idiomas a través de su canalización de Document AI. Tesseract admite más de 100 idiomas con paquetes de idiomas disponibles para la mayoría de las escrituras. Azure Document Intelligence y AWS Textract admiten aproximadamente más de 100 idiomas cada uno. Para idiomas de Asia Oriental (chino, japonés, coreano), Google Cloud Vision y ABBYY suelen ofrecer la mayor precisión. Para idiomas europeos, todas las principales API en la nube ofrecen un rendimiento similar.
¿Existen evaluaciones comparativas independientes sobre la precisión de las API de OCR?
Varias evaluaciones comparativas independientes rastrean la precisión de los modelos de OCR. La evaluación comparativa olmOCR del Instituto Allen para la IA evalúa la comprensión de documentos y la preservación de la estructura. OmniDocBench cubre la calidad de extracción de documentos en múltiples formatos. El IDP Leaderboard rastrea la precisión de extracción en facturas, recibos y documentos de identidad. A principios de 2026, el OCR-3 de Nanonets obtuvo 93.1 en olmOCR, mientras que GPT-5.2 y Gemini 3 Pro lideran los enfoques basados en VLM en precisión combinada y comprensión de formularios. Estas evaluaciones se actualizan con frecuencia; consulte la fuente para conocer las clasificaciones más recientes.