Los mejores convertidores de imagen a texto con IA en 2026:
7 herramientas comparadas
¿Puede un chatbot de IA general leer una imagen de forma confiable, o necesita una herramienta dedicada? Esa única pregunta es lo que separa a las siete herramientas de esta guía, y la mayoría de las listas de "mejor imagen a texto" nunca la responden. Ponen a Google Lens, ChatGPT y un sitio gratuito de OCR en línea en la misma clasificación de cinco estrellas, como si hicieran el mismo trabajo. No lo hacen. Una es una utilidad de teléfono para una captura rápida, otra es un modelo brillante pero no determinista, y otra está diseñada para leer el mismo tipo de documento cien veces y darle el mismo resultado exportable cada vez. Esta es una comparativa de asesor técnico de las tres categorías: cuánto cuesta cada herramienta, en qué es realmente buena y — la parte que más importa — dónde falla silenciosamente.
Conclusiones clave
- ChatGPT puede leer escritura a mano de una foto con alrededor del 85% de precisión sin configuración alguna, que es exactamente por lo que la gente dejó de abrir aplicaciones de OCR.
- El riesgo real no son los caracteres que omite, sino el valor incorrecto, limpio y seguro que inventa silenciosamente, y el diferente que le entrega en la siguiente ejecución.
- Una herramienta dedicada lee la imagen número mil igual que la primera y le entrega un archivo terminado y exportable, para que deje de revisar cien capturas a simple vista.
Qué significa realmente "imagen a texto" en 2026
"Imagen a texto" ahora abarca tres categorías fundamentalmente diferentes de herramientas, y elegir bien comienza por saber cuál necesita tu tarea. La frase solía significar una cosa: reconocimiento óptico de caracteres — software que observa una imagen de palabras y escribe los caracteres. Ese flujo de trabajo original de imagen a texto sigue siendo el núcleo de todas las herramientas a continuación. En 2026 abarca un espectro que va desde un botón gratuito en el teléfono hasta un modelo de lenguaje de gran escala que razona sobre lo que ve, y las diferencias de fiabilidad entre ellos son mayores de lo que sugieren las cifras de precisión.
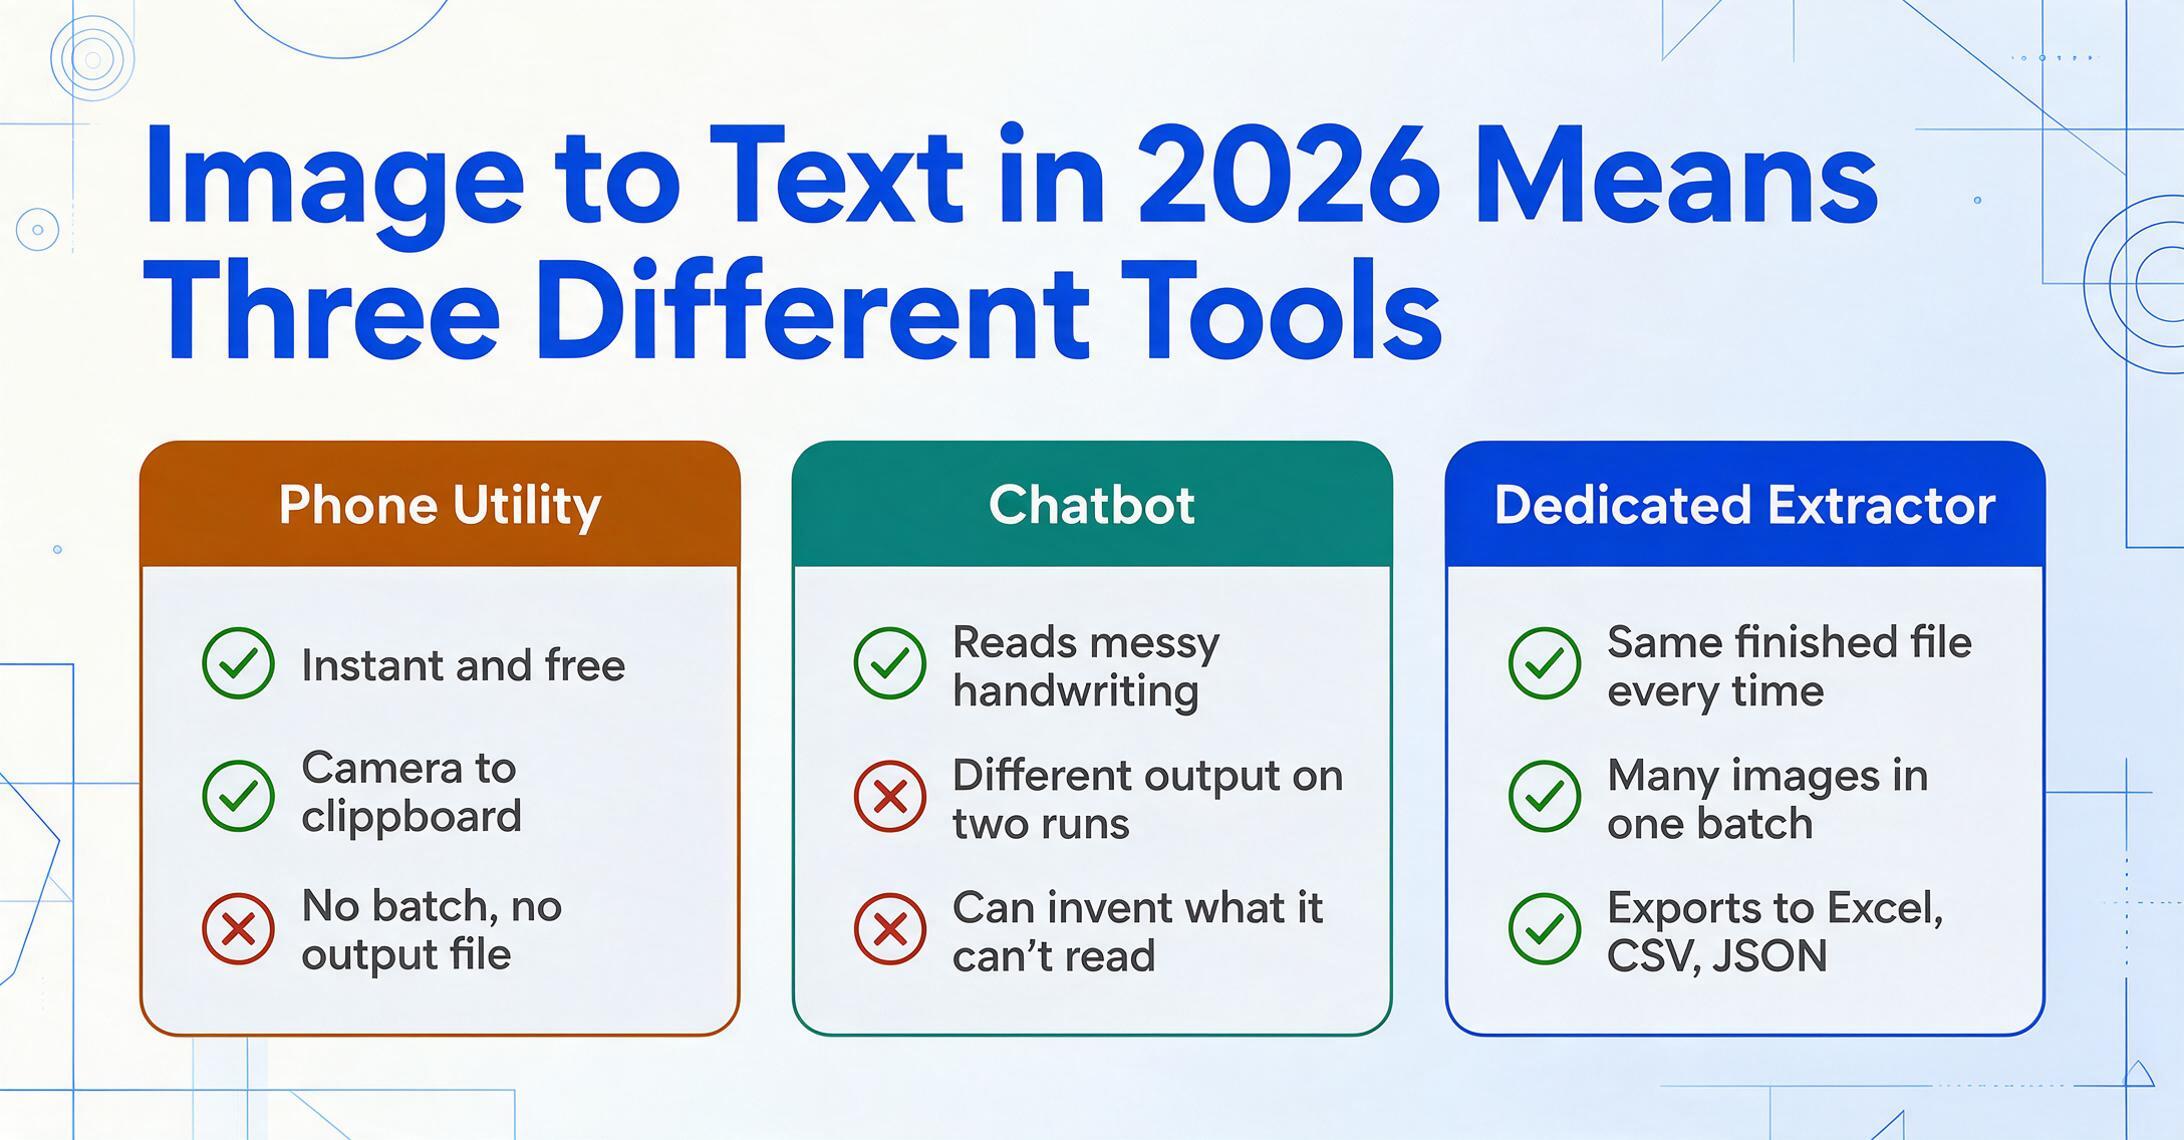
En el primer extremo se encuentran las herramientas OCR de utilidad y teléfono como Google Lens. Apuntas la cámara a un letrero o una página, y el texto se vuelve seleccionable en un segundo. Están diseñadas para capturas instantáneas y únicas: obtener una contraseña de Wi-Fi, copiar un párrafo, traducir un menú. Son gratuitas, rápidas y sin fricción, y no tienen concepto de un trabajo repetible: no hay cola de lote, ni archivo de salida consistente, ni forma de procesar cincuenta imágenes en un solo documento limpio.
En el medio están los LLM multimodales de propósito general — ChatGPT, Claude, Gemini. Pega una imagen en el chat y la leen, a menudo de forma impresionante, y también pueden explicar, resumir o reformatear lo que encuentran. El problema es que son no deterministas: la misma imagen y la misma instrucción pueden producir resultados ligeramente diferentes en dos ejecuciones, y el modelo a veces "rellenará" un valor que parezca plausible en lugar de admitir que un carácter es ilegible. No hay un pipeline integrado para alimentarle cien imágenes y fusionar los resultados en un solo archivo estructurado.
En el tercer extremo están las herramientas de extracción dedicadas diseñadas para producir resultados fiables, repetibles y exportables — Google Document AI y AWS Textract para desarrolladores, y aplicaciones no-code como ImageToTable.ai para todos los demás. El punto de estas herramientas no es que lean una sola imagen mejor que ChatGPT; es que leen la imagen milésima de la misma manera que la primera, te entregan un archivo final (TXT, Word, CSV, Excel) y lo hacen sin que tengas que supervisar cada ejecución.
La diferencia entre estas tres categorías no es la precisión — es la fiabilidad y la escala. Una utilidad de teléfono gana para una captura rápida, un chatbot gana para una consulta conversacional única, y una herramienta dedicada gana en el momento en que necesitas el mismo resultado, en un archivo exportable, repetido en muchas imágenes.
Esta guía trata sobre convertir una imagen en texto editable — transcripción y salida legible. Si lo que realmente necesitas es extraer datos en columnas de hoja de cálculo (los totales de una factura, las filas de una tabla), eso es un trabajo relacionado pero separado, y nuestro resumen de software de extracción de datos es un mejor punto de partida. Aquí, la pregunta es más simple: imagen adentro, palabras afuera — y a cuál de estas siete herramientas deberías confiarle esa tarea.
Cómo seleccionamos y probamos
Estas siete herramientas fueron elegidas para representar la verdadera variedad de formas en que las personas convierten imágenes en texto en 2026, no la lista más fácil de clasificar con claridad. Partimos de las herramientas que los compradores realmente usan y que el SERP muestra constantemente para "imagen a texto": la utilidad de teléfono (Google Lens), un servicio gratuito de OCR en línea representativo (OCR.space), los dos LLM generales que la gente usa cada vez más como OCR (ChatGPT, Claude), las API en la nube de nivel desarrollador (Google Document AI, AWS Textract) y un extractor dedicado no-code (nuestro propio ImageToTable.ai).
Cada herramienta se evaluó en cuatro aspectos: para qué sirve realmente (una captura única, una conversación o un trabajo repetible), el precio real (la cifra publicada más baja, no "desde"), la fiabilidad a escala (¿da el mismo resultado dos veces y puede alucinar?), y el ajuste honesto: los escenarios en los que realmente gana y aquellos en los que no. Cuando citamos datos de precisión o fallos, provienen de evaluaciones independientes y pruebas de profesionales, no de demostraciones de los proveedores. Los precios se tomaron de la página pública de precios de cada proveedor y están vigentes a fecha de Precios verificados en junio de 2026.
Una revelación desde el principio: ImageToTable.ai, el producto al que pertenece este sitio, es una de las siete herramientas analizadas. Lo hemos posicionado donde encaja honestamente (extracción no-code, repetible y exportable) y hemos nombrado los casos en los que Google Lens, ChatGPT o una API en la nube es la mejor opción. Para una captura rápida única, Lens nos supera por completo; fingir lo contrario haría que esta lista no valiera nada.
Las 7 mejores herramientas de imagen a texto de un vistazo
La tabla siguiente es la respuesta rápida, con el punto de entrada más barato de cada herramienta y la única limitación que más probablemente te afecte. "Precios verificados en junio de 2026".
| Herramienta | Precio inicial | Modelo de precios | Mejor para | Limitación principal | ¿Prueba gratuita? |
|---|---|---|---|---|---|
| Google Lens | Gratis | Gratis (app Google / Chrome / Fotos) | Captura única instantánea desde el teléfono | Sin lote, sin archivo de exportación, sin trabajo repetible | Gratis |
| OCR.space | Gratis | API gratuita + planes PRO de pago | OCR rápido o automatizado de texto plano | Solo texto plano; menos preciso con escritura a mano desordenada | Nivel gratuito |
| ChatGPT | Gratis / $20/mes (Plus) | Suscripción (consumidor) | Lectura conversacional única + razonamiento | No determinista; sin lote; puede inventar | Nivel gratuito |
| Claude | Gratis / $20/mes (Pro) | Suscripción (consumidor) | Lectura cuidadosa única de documentos largos | Mismas limitaciones de LLM; sin lote/esquema de exportación | Nivel gratuito |
| Google Document AI | $1.50 / 1,000 páginas | Por uso (por página) | OCR en la nube de alto volumen para desarrolladores | Configuración para desarrolladores; la salida en bruto necesita post-procesamiento | Nivel gratuito (GCP) |
| AWS Textract | $1.50 / 1,000 páginas | Por uso (por página) | OCR en la nube de alto volumen dentro de AWS | Solo para desarrolladores; formularios/tablas cuestan mucho más | Nivel gratuito (3 meses) |
| ImageToTable.ai | Gratis / $9/mes | Suscripción + créditos de pago por uso | Sin código, repetible, texto/datos exportables | Sin sincronización ERP nativa, sin SOC 2/HIPAA | Nivel gratuito |
Un patrón explica toda la tabla: el precio sigue a lo que rodea a la lectura, no a lo bien que la herramienta lee. Lens y OCR.space son gratuitos porque te dan texto crudo y se detienen: una herramienta gratuita de imagen a texto sin flujo de trabajo adicional. Los chatbots cuestan $20 al mes porque pagas por un modelo de razonamiento, no por un motor de OCR. Las API en la nube facturan por página porque son infraestructura sobre la que construyes. Y el extractor dedicado cobra una pequeña suscripción porque envuelve la lectura en un flujo de trabajo repetible y exportable. Iguala el envoltorio a tu tarea y la elección correcta se vuelve obvia.
OCR de utilidad gratuita para teléfono: Google Lens y OCR.space
Para una captura rápida y única, el OCR de utilidad gratuita no solo es "suficientemente bueno", sino que es la respuesta correcta, y nada en esta lista lo supera en velocidad. Estas herramientas existen para extraer texto de una pantalla o una página y llevarlo a tu portapapeles sin configuración alguna. En cuanto tu tarea se repite o necesita un archivo de salida estructurado, se quedan sin camino.
Google Lens
Google Lens es el OCR integrado en la aplicación de Google, Chrome y Google Photos: apunta tu cámara (o abre cualquier imagen), toca, y el texto se vuelve seleccionable, copiable y traducible en tiempo real. Es genuinamente excelente para lo que está diseñado: copiar un párrafo de un libro, extraer un número de serie de una etiqueta, leer un menú extranjero — y no cuesta nada.
Ideal para: capturas únicas e instantáneas desde tu teléfono, especialmente cuando la traducción es parte del trabajo. No es ideal para: cualquier flujo de trabajo repetible — no hay procesamiento por lotes, no hay forma de exportar un archivo limpio de resultados de muchas imágenes, y no hay control sobre la estructura de salida. Es una utilidad, no un pipeline de documentos. Abrir Google Lens →
OCR.space
OCR.space es un servicio de OCR en línea gratuito, sin registro, con una interfaz de programación pública, útil cuando quieres texto plano de una imagen o PDF subido — o quieres integrar OCR básico en un script. El nivel gratuito es generoso para uso ligero, y los niveles PRO de pago añaden límites más altos, archivos más grandes y mejores motores.
Ideal para: extracción rápida y gratuita de texto plano en el navegador, o OCR automatizado ligero a través de su interfaz de programación. No es ideal para: escritura a mano desordenada, diseños complejos, o cualquiera que necesite que el texto se reorganice en campos con nombre — devuelve un bloque plano de caracteres, y tú haces la limpieza. Para tener una idea de cómo una herramienta consciente del diseño maneja el mismo trabajo, consulta nuestra página de extracción de OCR con IA. Ver precios de OCR.space →
Ambas herramientas comparten el mismo techo: leen, y luego te devuelven el problema. Eso está bien para una imagen. Es la forma incorrecta para cincuenta — que es exactamente donde la gente empieza a recurrir a ChatGPT.
¿Pueden ChatGPT o Claude leer una imagen de forma fiable?
Sí — y no, y esa distinción es lo más importante de esta guía. Los modelos multimodales de propósito general leen imágenes notablemente bien para un caso puntual, pero son la herramienta equivocada para transcripciones repetibles y de alto riesgo, porque pueden inventar silenciosamente lo que no pueden leer.
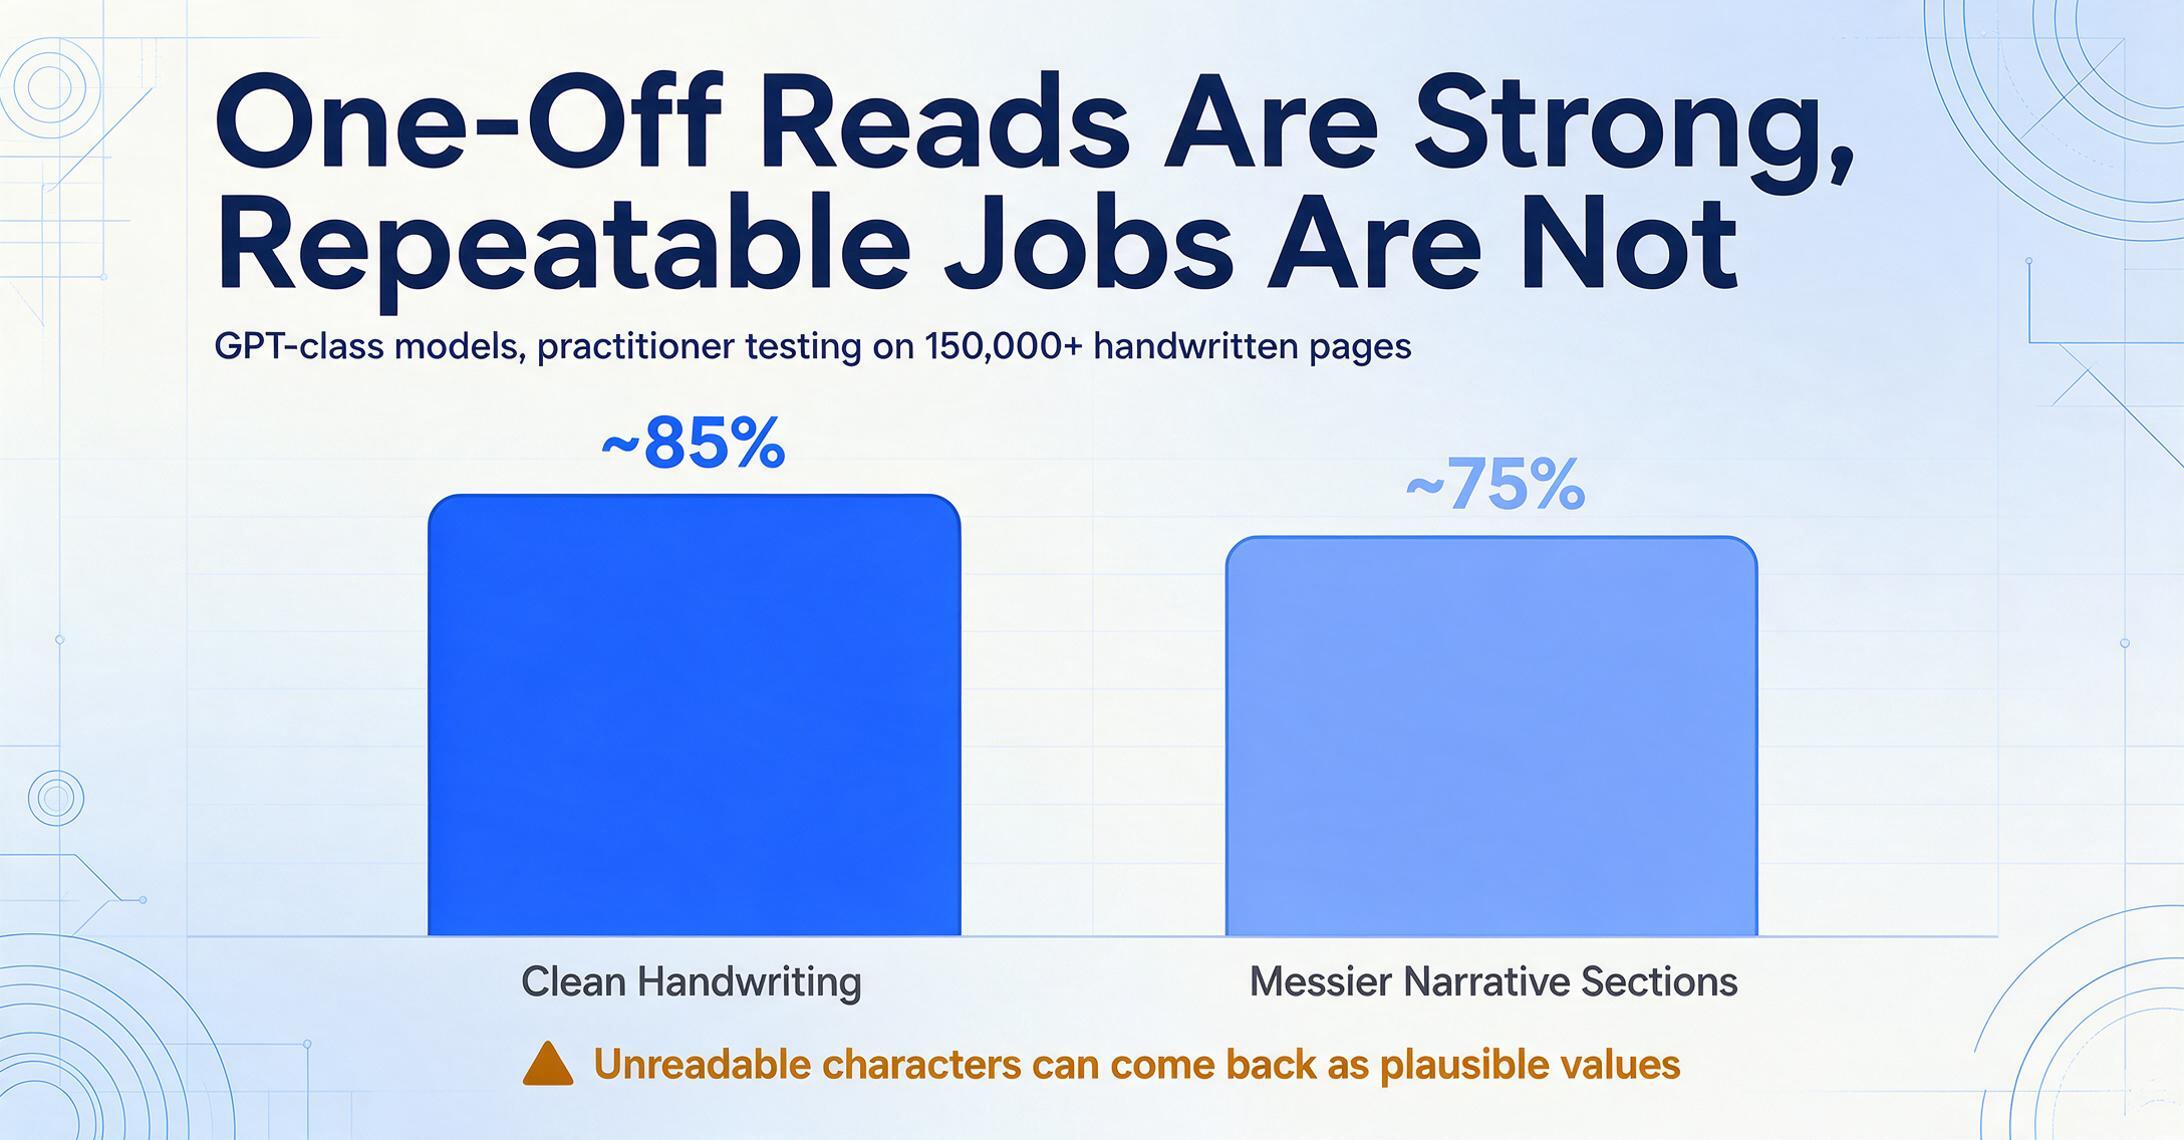
El "sí" es real. En r/OpenAI, la reacción recurrente a los modelos de visión es pura sorpresa de que un chatbot "pueda leer texto directamente de las imágenes", y la gente ahora pega rutinariamente una foto en ChatGPT y pide las palabras. Una revisión de 2025 de un profesional en r/computervision — de alguien que ha procesado más de 150.000 páginas manuscritas en producción — encontró que los modelos tipo GPT alcanzan "~85% de precisión en escritura a mano limpia", lo cual es sólido para una herramienta que no requiere configuración.
El "no" es igual de real, y es estructural. Esa misma revisión señaló que la precisión "cae a ~75% en secciones narrativas más desordenadas", y el problema más profundo no es el porcentaje — es el modo de fallo. Una evaluación comparativa de OCR de código abierto independiente que compara modelos de visión con OCR tradicional provocó una discusión de ingeniería ampliamente leída en la que un profesional lo expresó sin rodeos: los modelos de visión "son igualmente susceptibles al problema (no resuelto) de la alucinación", y "los modos de fallo son totalmente ilimitados (a diferencia del OCR normal)". El trabajo académico coincide — un artículo de NeurIPS 2025, "Seeing is Believing? Mitigating OCR Hallucinations in Multimodal LLMs," mide exactamente esto: bajo desenfoque, reflejos u oclusión parcial, un LLM puede emitir con confianza un valor plausible que nunca estuvo en la página.
Un motor de OCR tradicional que no puede leer un carácter devuelve basura que puedes detectar. Un modelo de lenguaje que no puede leer un carácter puede devolver una respuesta limpia, confiada y equivocada — y darte una ligeramente diferente en la siguiente ejecución. Esa falta de determinismo es por lo que los chatbots son excelentes para un documento y arriesgados para cien.
También hay una brecha de flujo de trabajo. Ni ChatGPT (Gratis, o Plus a $20/mes) ni Claude (Gratis, o Pro a $20/mes) tienen una forma integrada de procesar cincuenta imágenes de una sola vez y fusionarlas en un único archivo consistente, y el mismo prompt puede devolver diferentes órdenes de columnas o formatos entre ejecuciones. Para un caso puntual — leer este recibo, transcribir esta nota — son una opción legítima y rápida. Para un proceso, quieres la lectura del mismo modelo envuelta en salvaguardas. Profundizamos en los detalles en nuestra comparación de ChatGPT; la versión corta es: usa un chatbot para un documento, usa una herramienta especializada para un procedimiento. Ver precios de ChatGPT → Ver precios de Claude →
APIs de OCR en la nube para desarrolladores: Google Document AI y AWS Textract
Si dispone de recursos de ingeniería y un volumen alto y constante, las dos APIs de OCR de los hiperescaladores son la forma más económica y fiable de convertir imágenes en texto a gran escala. No son aplicaciones que se "usan", sino servicios sobre los que se construye, lo cual es a la vez su fortaleza y su barrera.
Google Document AI
Document AI de Google es una plataforma en la nube cuyo procesador Enterprise Document OCR cuesta $1.50 por cada 1,000 páginas (con descuento por encima de 5 millones de páginas al mes), con una sólida cobertura multilingüe y de escritura a mano, además de una capa de revisión con supervisión humana para trabajos de mayor riesgo. El resultado es fiable y determinista, a diferencia de lo que ocurre con el chat basado en LLM.
Ideal para: equipos de desarrollo que necesiten reconocimiento escalable basado en API para un volumen alto y constante, especialmente aquellos que ya usan Google Cloud. No es adecuado para: personas sin perfil técnico; no hay una aplicación de apuntar y hacer clic, y el OCR devuelve bloques de texto sin procesar que requieren un postprocesado antes de poder utilizarlos. Ver precios de Google Document AI →
AWS Textract
Textract es el servicio de OCR de documentos de Amazon, expuesto a través de varias APIs; su llamada base Detect Document Text cuesta $1.50 por cada 1,000 páginas, con un nivel gratuito que cubre 1,000 páginas al mes durante los primeros tres meses. Las funciones estructuradas (formularios, tablas) cuestan considerablemente más por página, por lo que resulta más económico cuando lo que se necesita principalmente es texto plano.
Ideal para: equipos que ya están dentro del ecosistema de AWS y quieren usar OCR como un componente básico en un flujo de trabajo más amplio. No es adecuado para: quienes no cuenten con desarrolladores, o para cargas de trabajo dominadas por formularios y tablas, donde el costo por página aumenta drásticamente. Desglosamos las ventajas y desventajas en nuestra comparativa de AWS Textract. Ver precios de AWS Textract →
Ambas APIs leen documentos de forma fiable y a un bajo costo por página, pero convertir su salida sin procesar en un archivo estructurado y terminado es un proyecto de desarrollo, no una función. Esa es exactamente la brecha que cierra la herramienta dedicada no-code.
Extracción dedicada y exportable: ImageToTable.ai
Cuando la conversión de imagen a texto se convierte en una tarea recurrente y no desea escribir código, un extractor no-code dedicado le ofrece la lectura del LLM envuelta en la fiabilidad y la exportación de las que carecen los chatbots. Aquí es donde se sitúa ImageToTable.ai — el producto detrás de este sitio, y una de las siete herramientas aquí presentes.
ImageToTable.ai está construido sobre un modelo de visión de gran escala, por lo que lee texto impreso, escritura a mano, cursiva, tablas y casillas de verificación con la misma comprensión contextual que hace que los LLM sean potentes con documentos desordenados. La diferencia está en lo que rodea a la lectura. Su modo A Word toma una imagen de documento y devuelve un archivo de Word editable con el diseño original conservado — útil cuando desea toda la página como texto editable, no solo un volcado de caracteres plano. Su modo A Tabla utiliza la Extracción de Columnas Personalizadas: usted escribe los campos que desea — "Fecha", "Total", "Referencia" — y la IA encuentra cada valor por significado, y luego genera una tabla consistente en Excel, CSV o JSON. En cualquier caso, obtiene un archivo terminado, siempre de la misma manera, y puede procesar muchas imágenes en un solo lote en lugar de un chat a la vez. El precio comienza con un nivel gratuito, luego $9/mes.
Ideal para: autónomos, equipos de operaciones, contables y pequeñas empresas que necesitan convertir imágenes en texto o datos editables y exportables de forma repetida — incluyendo escritura a mano y fotos de teléfono — sin programar, entrenar modelos ni supervisar cada ejecución. No es ideal para: una captura única rápida (Google Lens es más rápido y gratuito), una lectura conversacional donde también desee discutir el contenido (un chatbot encaja mejor), o empresas que necesiten sincronización nativa con ERP, implementación local o cumplimiento de SOC 2 / HIPAA. Puede ver el enfoque no-code en nuestra página de conversión de imagen a Word o en nuestra página de escritura a mano a texto, y se encuentra junto a otras opciones ligeras en nuestro resumen de IA documental no-code. Pruebe ImageToTable.ai gratis →
Cómo elegir: uso puntual, volumen, manuscritos o desarrolladores
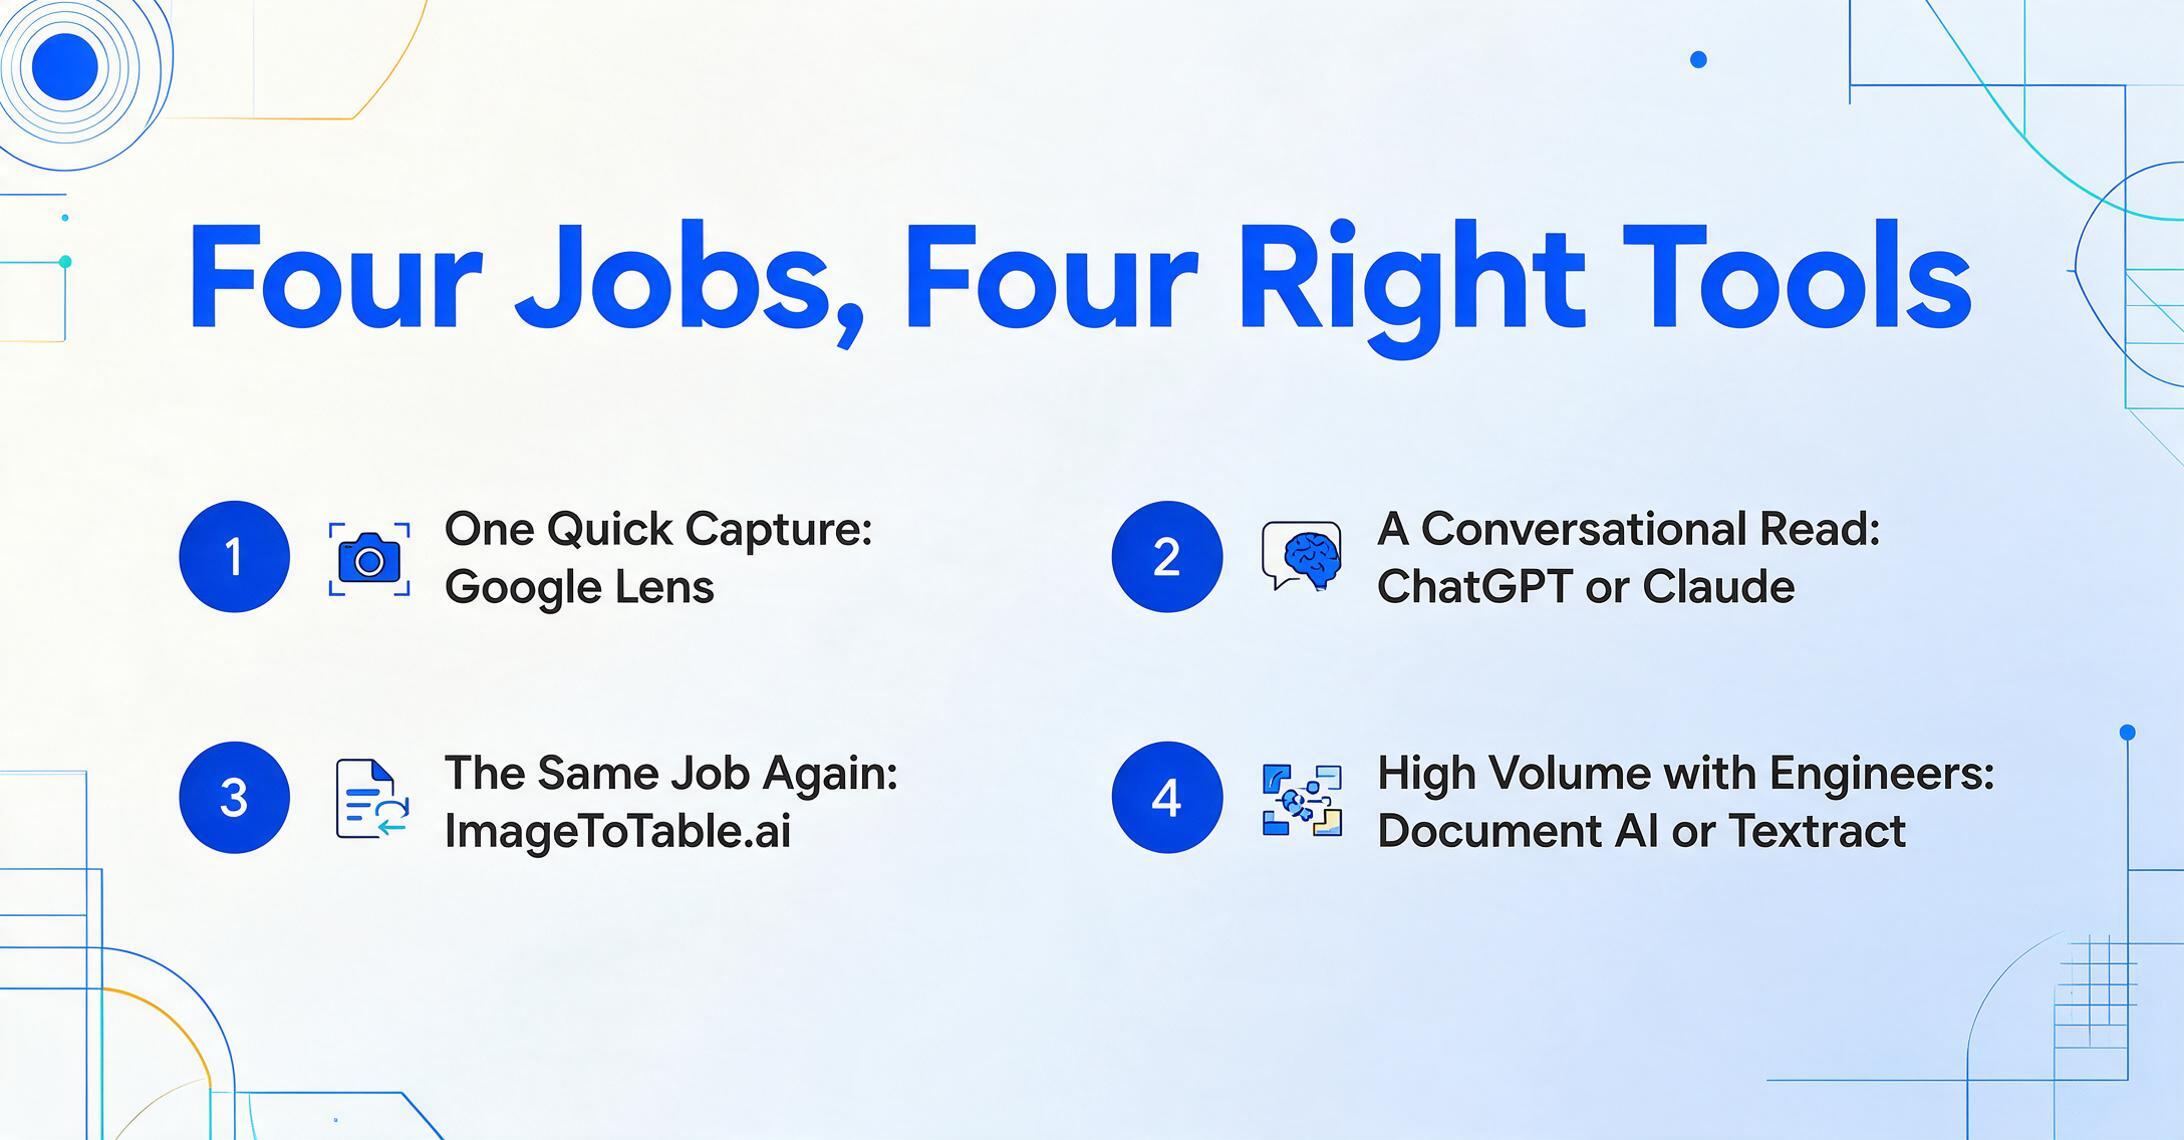
La herramienta de imagen a texto adecuada es aquella cuya forma coincide con su tarea, no la que tiene más estrellas. Aquí está la decisión en cuatro escenarios comunes.
Captura rápida única
Mejor opción: Google Lens (u OCR.space)
¿Necesita capturar un párrafo, un código o un menú? Use la utilidad gratuita del teléfono: es instantánea y no requiere configuración. Una herramienta de pago aquí es excesiva. Una captura de pantalla PNG que debe convertirse en un documento editable es otra tarea: convertir un PNG a Word requiere un reconocimiento del diseño que las utilidades no ofrecen.
Lectura conversacional o razonamiento
Mejor opción: ChatGPT o Claude
¿Quiere leer un documento y hacer preguntas sobre él? Un chatbot es ideal; solo verifique lo que sea importante y no confíe en él para obtener resultados idénticos dos veces.
Muchas imágenes, repetible, exportable
Mejor opción: ImageToTable.ai
¿Convertir el mismo tipo de documento una y otra vez en texto editable o una hoja de cálculo, sin código, con un archivo de salida consistente? Este es el punto óptimo no-code. Comience con el plan gratuito.
Alto volumen con ingenieros
Mejor opción: Google Document AI o AWS Textract
¿Volumen alto constante y un equipo de desarrollo para construir sobre ello? Las API en la nube son las más económicas por página. Elija según la nube en la que ya trabaje.
Si su tarea se superpone con el lado de datos estructurados — extraer campos y filas a una hoja de cálculo en lugar de solo transcribir texto — lea las guías complementarias que profundizan en ello: nuestro resumen de software de reconocimiento óptico de caracteres con IA y nuestro resumen de herramientas de extracción de datos de documentos.
Preguntas Frecuentes
¿Cuál es el mejor conversor gratuito de imagen a texto con IA?
Para un uso rápido, Google Lens es la mejor opción gratuita: viene integrado en la app de Google, Chrome y Google Fotos, lee texto de cualquier imagen al instante y no cuesta nada. Para OCR de texto plano gratuito en el navegador o mediante una API, OCR.space es una opción sólida. Si necesitas el texto de forma repetida y en un archivo exportable, ImageToTable.ai tiene un nivel gratuito que va más allá de un volcado de texto plano, ofreciendo Word editable o una hoja de cálculo estructurada.
¿Puedo usar ChatGPT para convertir una imagen a texto?
Para un documento puntual, sí: pega la imagen en ChatGPT (gratuito o Plus por $20/mes) o en Claude y pide el texto; por lo general lo lee bien, con alrededor de un 85% de precisión en escritura a mano limpia según pruebas independientes. El problema es la fiabilidad a gran escala: los modelos de lenguaje no son deterministas (la misma imagen puede dar resultados diferentes en distintas ejecuciones) y pueden "alucinar" un valor plausible cuando un carácter es ilegible, con modos de fallo difíciles de detectar. Usa un chatbot para algo puntual; usa una herramienta especializada cuando necesites el mismo resultado de forma repetida.
¿Son precisas las herramientas de IA para convertir imagen a texto con escritura a mano?
Las herramientas basadas en modelos de visión leen la escritura a mano mucho mejor que el OCR tradicional porque usan contexto, pero la precisión sigue bajando con escritura desordenada o cursiva: las pruebas muestran que los modelos líderes rondan el 85% en escritura limpia y caen a aproximadamente el 75% en secciones más desordenadas. Para trabajos con mucha escritura a mano, prueba primero tus documentos reales en un nivel gratuito y prefiere herramientas que te permitan revisar y corregir el resultado en lugar de las que devuelven un bloque de texto plano.
¿Cuál es la diferencia entre OCR y una herramienta de IA para convertir imagen a texto?
El OCR tradicional compara formas de píxeles con caracteres y genera texto sin entenderlo: es rápido y determinista, pero falla en escaneos de baja calidad, escritura a mano y diseños inusuales. Las herramientas de IA para convertir imagen a texto usan un modelo de lenguaje visual que lee la página en contexto, por lo que manejan mucho mejor imágenes del mundo real desordenadas. La desventaja es que los modelos de IA pueden ocasionalmente inventar información, por lo que las herramientas especializadas los envuelven en estructura y controles de exportación en lugar de dejarte con un resultado de chat en bruto.
¿Cómo convierto una imagen en texto editable que pueda editar en Word?
Utilidades gratuitas como Google Lens y OCR.space le dan texto plano copiable, pero no conservan el diseño. Para obtener un documento editable que mantenga el formato original, use una herramienta con modo de reconocimiento de diseño: el modo A Word de ImageToTable.ai lee una imagen de documento y exporta un archivo de Word editable con el diseño original intacto, de modo que los encabezados, párrafos y tablas queden en su lugar en lugar de un solo párrafo plano. Una página fotografiada también sigue ese camino: el flujo de trabajo de JPG a Word exporta un documento editable con encabezados y tablas en su lugar, no un solo bloque de texto.
¿Qué herramienta de imagen a texto es mejor para procesar muchas imágenes a la vez?
Las utilidades de teléfono y los chatbots no tienen un flujo de trabajo de lote real, así que para muchas imágenes necesita una API de nube para desarrolladores (Google Document AI o AWS Textract, si tiene ingenieros) o una herramienta no-code diseñada para lote. ImageToTable.ai procesa varias imágenes en una sola pasada y las fusiona en un único archivo exportable, que es la brecha que herramientas de una por una como Lens y ChatGPT no pueden cerrar.
La Conclusión
Lo más útil que puede sacar de esta comparación es que "imagen a texto" no es una sola categoría — son tres, y fallan de maneras distintas. Una utilidad de teléfono (Lens, OCR.space) es perfecta para una captura e inútil para cien. Un chatbot (ChatGPT, Claude) lee brillantemente para un caso puntual, pero es no determinista y puede inventar contenido, lo que lo hace arriesgado como proceso repetible. Una herramienta dedicada (las API de nube para desarrolladores, ImageToTable.ai para todos los demás) cambia un poco de flexibilidad de una sola toma por lo que las otras no tienen — el mismo resultado confiable y exportable, cada vez, en muchas imágenes.
No elija la herramienta que mejor lee una imagen. Elija la que se ajuste a su tarea: una utilidad para una captura, un chatbot para una conversación y un extractor dedicado para un proceso repetible y exportable.
Si su trabajo de imagen a texto ha pasado de "de vez en cuando" a "una y otra vez", esa es la señal para dejar la utilidad gratuita y la ventana de chat. Suba un puñado de sus propias imágenes, indique lo que quiere obtener y vea si un archivo terminado y consistente en segundos vale más que un portapapeles lleno de texto que tiene que revisar a mano.
Divulgación: Esta guía es publicada por ImageToTable.ai, que es una de las siete herramientas revisadas anteriormente. Hemos buscado una evaluación justa y técnica — incluyendo nombrar los escenarios donde Google Lens, ChatGPT, Claude o las API de OCR en la nube son la mejor opción. Los precios se tomaron de las páginas públicas de precios de cada proveedor y están vigentes a junio de 2026; verifique las cifras más recientes en el sitio de cada proveedor antes de comprar.