Beste KI-Bild-zu-Text-Konverter 2026:
7 Tools im Vergleich
Kann ein allgemeiner KI-Chatbot zuverlässig ein Bild lesen, oder brauchen Sie ein spezielles Tool? Genau diese Frage trennt die sieben Tools in diesem Leitfaden – und die meisten „Beste-Bild-zu-Text“-Listen beantworten sie nie. Sie setzen Google Lens, ChatGPT und eine kostenlose Online-OCR-Seite in dieselbe Fünf-Sterne-Wertung, als würden sie dieselbe Arbeit leisten. Tun sie nicht. Eines ist ein Telefon-Tool für schnelles Erfassen, eines ist ein brillantes, aber nicht-deterministisches Modell, und eines ist darauf ausgelegt, dieselbe Art von Dokument hundertmal zu lesen und Ihnen jedes Mal dasselbe exportierbare Ergebnis zu liefern. Dies ist ein technischer Beratervergleich aller drei Kategorien: Was jedes Tool kostet, worin es wirklich gut ist – und, der wichtigste Teil – wo es leise scheitert.
Die wichtigsten Erkenntnisse
- ChatGPT kann Handschrift von einem Foto mit etwa 85 % Genauigkeit und ohne Einrichtung lesen – genau deshalb haben die Leute aufgehört, OCR-Apps zu öffnen.
- Das eigentliche Risiko sind nicht die Zeichen, die übersehen werden – sondern der saubere, selbstbewusste, falsche Wert, der stillschweigend erfunden wird, und der beim nächsten Durchlauf anders ausfällt.
- Ein spezielles Tool liest das tausendste Bild genauso wie das erste und liefert eine fertige, exportierbare Datei – so müssen Sie nicht mehr hundert Aufnahmen manuell überprüfen.
Was „Bild zu Text“ im Jahr 2026 tatsächlich bedeutet
„Bild zu Text“ umfasst heute drei grundlegend verschiedene Kategorien von Tools, und die richtige Wahl beginnt damit, zu wissen, welche Ihr Task benötigt. Der Begriff bedeutete früher eine Sache: optische Zeichenerkennung (OCR) – Software, die ein Bild von Wörtern betrachtet und die Zeichen abtippt. Dieser ursprüngliche Bild-zu-Text-Workflow ist immer noch der Kern jedes unten aufgeführten Tools. Im Jahr 2026 erstreckt er sich von einer kostenlosen Telefon-Schaltfläche bis zu einem Vision-Language-Modell, das über das Gesehene nachdenkt, und die Zuverlässigkeitsabwägungen zwischen ihnen sind größer, als die Genauigkeitszahlen vermuten lassen.
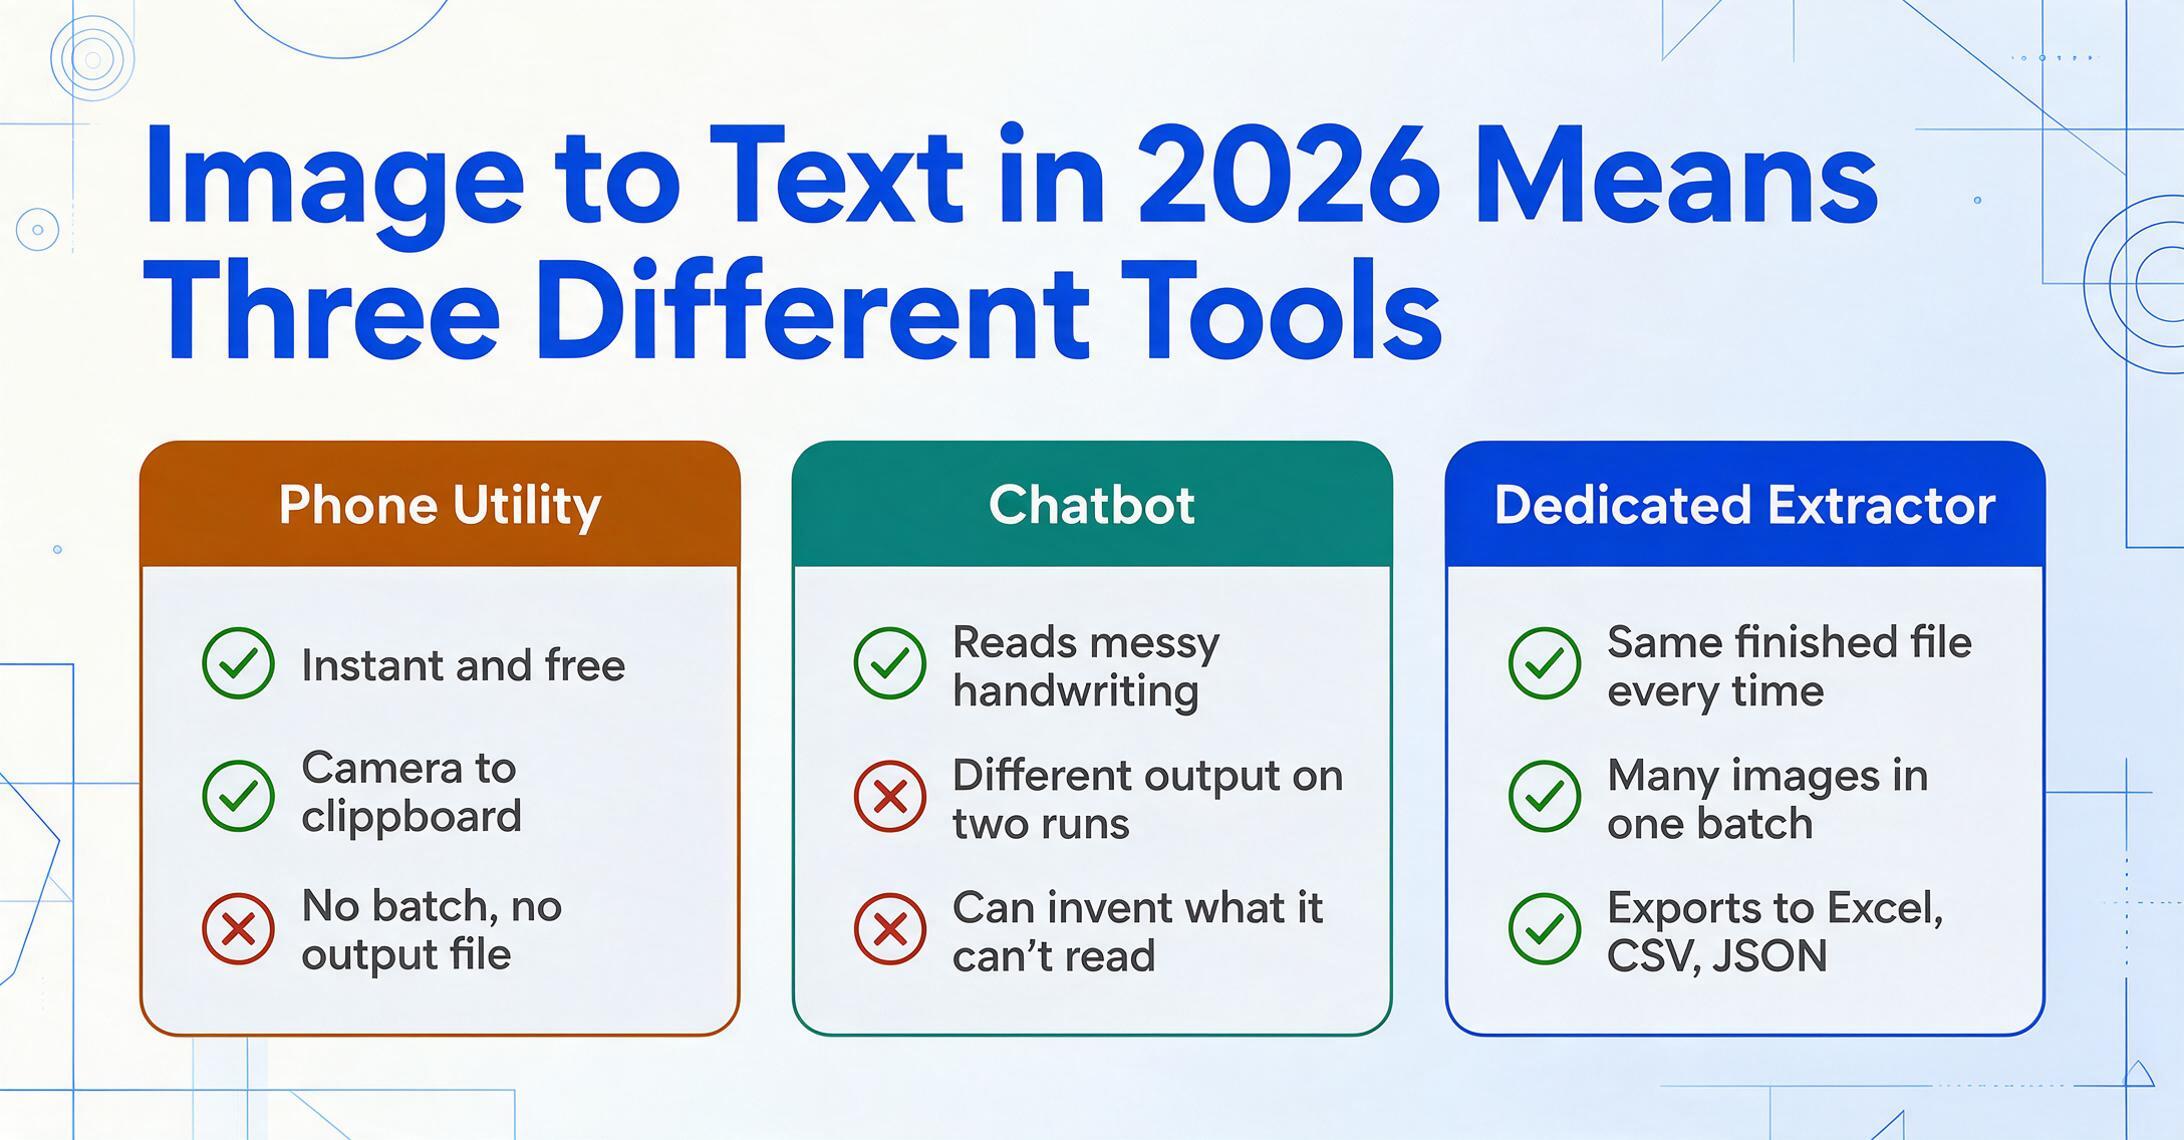
Am ersten Ende sitzen Telefon- und Dienstprogramm-OCR-Tools wie Google Lens. Sie richten Ihre Kamera auf ein Schild oder eine Seite, und der Text wird in einer Sekunde auswählbar. Diese sind für sofortige, einmalige Erfassungen gebaut – ein WLAN-Passwort schnappen, einen Absatz kopieren, eine Speisekarte übersetzen. Sie sind kostenlos, schnell und reibungslos, und sie haben kein Konzept für einen wiederholbaren Job: Es gibt keine Stapelverarbeitungswarteschlange, keine konsistente Ausgabedatei, keine Möglichkeit, fünfzig Bilder in einem sauberen Dokument zu verarbeiten.
In der Mitte sitzen Allzweck-Multimodal-LLMs – ChatGPT, Claude, Gemini. Fügen Sie ein Bild in den Chat ein, und sie lesen es, oft beeindruckend, und können auch erklären, zusammenfassen oder neu formatieren, was sie finden. Der Haken ist, dass sie nicht-deterministisch sind: Dasselbe Bild und dieselbe Eingabeaufforderung können bei zwei Läufen leicht unterschiedliche Ausgaben erzeugen, und das Modell „füllt“ manchmal einen plausibel aussehenden Wert ein, anstatt zuzugeben, dass ein Zeichen unlesbar ist. Es gibt keine eingebaute Pipeline, um hundert Bilder einzuspeisen und die Ergebnisse in einer strukturierten Datei zusammenzuführen.
Am dritten Ende sitzen dedizierte Extraktionstools, die gebaut sind, um zuverlässige, wiederholbare, exportierbare Ausgaben zu erzeugen – Google Document AI und AWS Textract für Entwickler und No-Code-Apps wie ImageToTable.ai für alle anderen. Der Punkt dieser Tools ist nicht, dass sie ein einzelnes Bild besser lesen als ChatGPT; es ist, dass sie das tausendste Bild genauso lesen wie das erste, Ihnen eine fertige Datei (TXT, Word, CSV, Excel) übergeben und das tun, ohne dass Sie jeden Lauf beaufsichtigen müssen.
Der Unterschied zwischen diesen drei Kategorien ist nicht Genauigkeit – es ist Zuverlässigkeit und Skalierung. Ein Telefon-Dienstprogramm gewinnt für eine schnelle Erfassung, ein Chatbot gewinnt für eine konversationelle Einmaligkeit, und ein dediziertes Tool gewinnt in dem Moment, in dem Sie dasselbe Ergebnis, in einer exportierbaren Datei, über viele Bilder hinweg wiederholt benötigen.
Dieser Leitfaden dreht sich darum, ein Bild in bearbeitbaren Text zu bringen – Transkription und lesbare Ausgabe. Wenn Sie tatsächlich die Daten in Tabellenkalkulationsspalten benötigen (die Summen einer Rechnung, die Zeilen einer Tabelle), ist das eine verwandte, aber separate Aufgabe, und unsere Übersicht über Datenextraktionssoftware ist der bessere Ausgangspunkt. Hier ist die Frage einfacher: Bild rein, Wörter raus – und welchem dieser sieben Tools Sie vertrauen sollten, um das zu tun.
So haben wir ausgewählt und getestet
Diese sieben Tools wurden ausgewählt, um die tatsächliche Bandbreite abzubilden, wie Menschen im Jahr 2026 Bilder in Text umwandeln – nicht unbedingt die einfachste Liste, um sie sauber zu ranken. Wir sind von den Tools ausgegangen, die Käufer tatsächlich nutzen und die die SERP für „Bild zu Text" durchgängig anzeigt: das Telefon-Tool (Google Lens), ein repräsentativer kostenloser Online-OCR-Dienst (OCR.space), die beiden allgemeinen LLMs, die zunehmend als OCR eingesetzt werden (ChatGPT, Claude), die Cloud-APIs für Entwickler (Google Document AI, AWS Textract) und ein No-Code-Spezialextraktor (unser eigenes ImageToTable.ai).
Jedes Tool wurde nach vier Kriterien bewertet: wofür es wirklich gedacht ist (ein einmaliger Abruf, ein Gespräch oder eine wiederholbare Aufgabe), reale Preise (der niedrigste veröffentlichte Preis, nicht „ab"), Zuverlässigkeit bei Volumen (liefert es zweimal dasselbe Ergebnis und kann es Dinge erfinden?) und ehrliche Eignung – die Szenarien, in denen es wirklich überzeugt, und die, in denen es das nicht tut. Wo wir Genauigkeits- oder Fehlerdaten anführen, stammen diese aus unabhängigen Benchmarks und Praxistests, nicht aus Hersteller-Demos. Die Preise wurden von den öffentlichen Preisseiten der Anbieter abgerufen und sind aktuell Stand Preise geprüft Juni 2026.
Ein Hinweis vorab: ImageToTable.ai – das Produkt, zu dem diese Website gehört – ist eines der sieben bewerteten Tools. Wir haben es dort positioniert, wo es ehrlich passt (No-Code, wiederholbare, exportierbare Extraktion) und die Fälle benannt, in denen Google Lens, ChatGPT oder eine Cloud-API die bessere Wahl ist. Für eine einzelne schnelle Erfassung schlägt uns Lens eindeutig; das Gegenteil zu behaupten, würde diese Liste wertlos machen.
Die 7 besten Bild-zu-Text-Tools auf einen Blick
Die Tabelle unten ist die schnelle Antwort, mit dem günstigsten Einstiegspunkt für jedes Tool und der einen Einschränkung, die Sie am ehesten treffen wird. „Preise geprüft Juni 2026."
| Tool | Einstiegspreis | Preismodell | Am besten geeignet für | Wichtigste Einschränkung | Kostenlose Testversion? |
|---|---|---|---|---|---|
| Google Lens | Kostenlos | Kostenlos (Google App / Chrome / Fotos) | Einmalige Soforterfassung per Handy | Kein Batch, keine Exportdatei, kein wiederholbarer Job | Kostenlos |
| OCR.space | Kostenlos | Kostenlose API + kostenpflichtige PRO-Stufen | Schnelle oder automatisierte Klartext-OCR | Nur Klartext; schwächer bei unleserlicher Handschrift | Kostenlose Stufe |
| ChatGPT | Kostenlos / 20 $/Monat (Plus) | Abonnement (Verbraucher) | Konversationelles einmaliges Lesen + Schlussfolgerung | Nicht deterministisch; kein Batch; kann erfinden | Kostenlose Stufe |
| Claude | Kostenlos / 20 $/Monat (Pro) | Abonnement (Verbraucher) | Sorgfältiges einmaliges Lesen langer Dokumente | Gleiche LLM-Einschränkungen; kein Batch/Export-Schema | Kostenlose Stufe |
| Google Document AI | 1,50 $ / 1.000 Seiten | Nutzungsabhängig (pro Seite) | Hochvolumige Cloud-OCR für Entwickler | Entwickler-Setup; Rohausgabe benötigt Nachbearbeitung | Kostenlose Stufe (GCP) |
| AWS Textract | 1,50 $ / 1.000 Seiten | Nutzungsabhängig (pro Seite) | Hochvolumige Cloud-OCR in AWS | Nur für Entwickler; Formulare/Tabellen kosten viel mehr | Kostenlose Stufe (3 Monate) |
| ImageToTable.ai | Kostenlos / 9 $/Monat | Abonnement + PAYG-Guthaben | Codefrei, wiederholbar, exportierbare Text-/Daten | Kein natives ERP-Sync, kein SOC 2/HIPAA | Kostenlose Stufe |
Ein Muster erklärt die gesamte Tabelle: Der Preis richtet sich nach dem, was das Lesen umgibt, nicht danach, wie gut das Tool liest. Lens und OCR.space sind kostenlos, weil sie Ihnen Rohtext liefern und dann aufhören – ein kostenloses Bild-zu-Text-Tool ohne Workflow darum herum. Die Chatbots kosten 20 $/Monat, weil Sie für ein Reasoning-Modell bezahlen, nicht für eine OCR-Engine. Die Cloud-APIs berechnen pro Seite, weil sie Infrastruktur sind, auf der Sie aufbauen. Und der spezielle Extraktor verlangt ein kleines Abonnement, weil er das Lesen in einen wiederholbaren, exportierbaren Workflow einbettet. Passen Sie den Rahmen an Ihre Aufgabe an, und die richtige Wahl wird offensichtlich.
Telefon & kostenlose Utility-OCR: Google Lens & OCR.space
Für eine einzelne schnelle Erfassung ist kostenlose Utility-OCR nicht nur „gut genug" – sie ist die richtige Antwort, und nichts auf dieser Liste schlägt sie an Geschwindigkeit. Diese Tools existieren, um Text von einem Bildschirm oder einer Seite in Ihre Zwischenablage zu bringen – ohne Einrichtung. Sobald Ihre Aufgabe sich wiederholt oder eine strukturierte Ausgabedatei erfordert, stoßen sie an ihre Grenzen.
Google Lens
Google Lens ist die in die Google-App, Chrome und Google Fotos integrierte OCR: Richten Sie Ihre Kamera (oder öffnen Sie ein beliebiges Bild), tippen Sie, und der Text wird in Echtzeit auswählbar, kopierbar und übersetzbar. Es ist wirklich hervorragend für das, wofür es gedacht ist – einen Absatz aus einem Buch kopieren, eine Seriennummer von einem Etikett ablesen, eine fremdsprachige Speisekarte lesen – und es kostet nichts.
Am besten geeignet für: sofortige Einzelerfassungen unterwegs vom Telefon, besonders wenn Übersetzung Teil der Aufgabe ist. Nicht ideal für: wiederkehrende Workflows – es gibt keine Stapelverarbeitung, keine Möglichkeit, eine saubere Datei mit Ergebnissen aus vielen Bildern zu exportieren, und keine Kontrolle über die Ausgabestruktur. Es ist ein Hilfsmittel, keine Dokument-Pipeline. Google Lens öffnen →
OCR.space
OCR.space ist ein kostenloser Online-OCR-Dienst ohne Anmeldung mit einer öffentlichen Programmierschnittstelle – praktisch, wenn Sie Klartext aus einem hochgeladenen Bild oder PDF extrahieren möchten – oder grundlegende OCR in ein Skript einbinden wollen. Der kostenlose Tarif ist für gelegentliche Nutzung großzügig, und kostenpflichtige PRO-Tarife bieten höhere Limits, größere Dateien und bessere Engines.
Am besten geeignet für: schnelle, kostenlose Klartext-Extraktion im Browser oder leichte automatisierte OCR über die API. Nicht ideal für: unleserliche Handschrift, komplexe Layouts oder alle, die den Text in benannte Felder umorganisiert benötigen – es liefert einen flachen Zeichenblock zurück, und die Bereinigung übernehmen Sie. Um zu sehen, wie ein layout-bewusstes Tool dieselbe Aufgabe bewältigt, besuchen Sie unsere KI-OCR-Extraktionsseite. OCR.space-Preise ansehen →
Beide Tools teilen dieselbe Grenze: Sie lesen und geben das Problem dann an Sie zurück. Das ist für ein Bild in Ordnung. Für fünfzig ist es die falsche Form – und genau hier beginnen die Leute, nach ChatGPT zu greifen.
Können ChatGPT oder Claude zuverlässig ein Bild lesen?
Ja – und nein, und dieser Unterschied ist das Wichtigste in diesem Leitfaden. Allgemeine multimodale Modelle lesen Bilder für einen einmaligen Einsatz bemerkenswert gut, aber sie sind das falsche Werkzeug für wiederholbare, kritische Transkriptionen, weil sie stillschweigend erfinden können, was sie nicht lesen können.
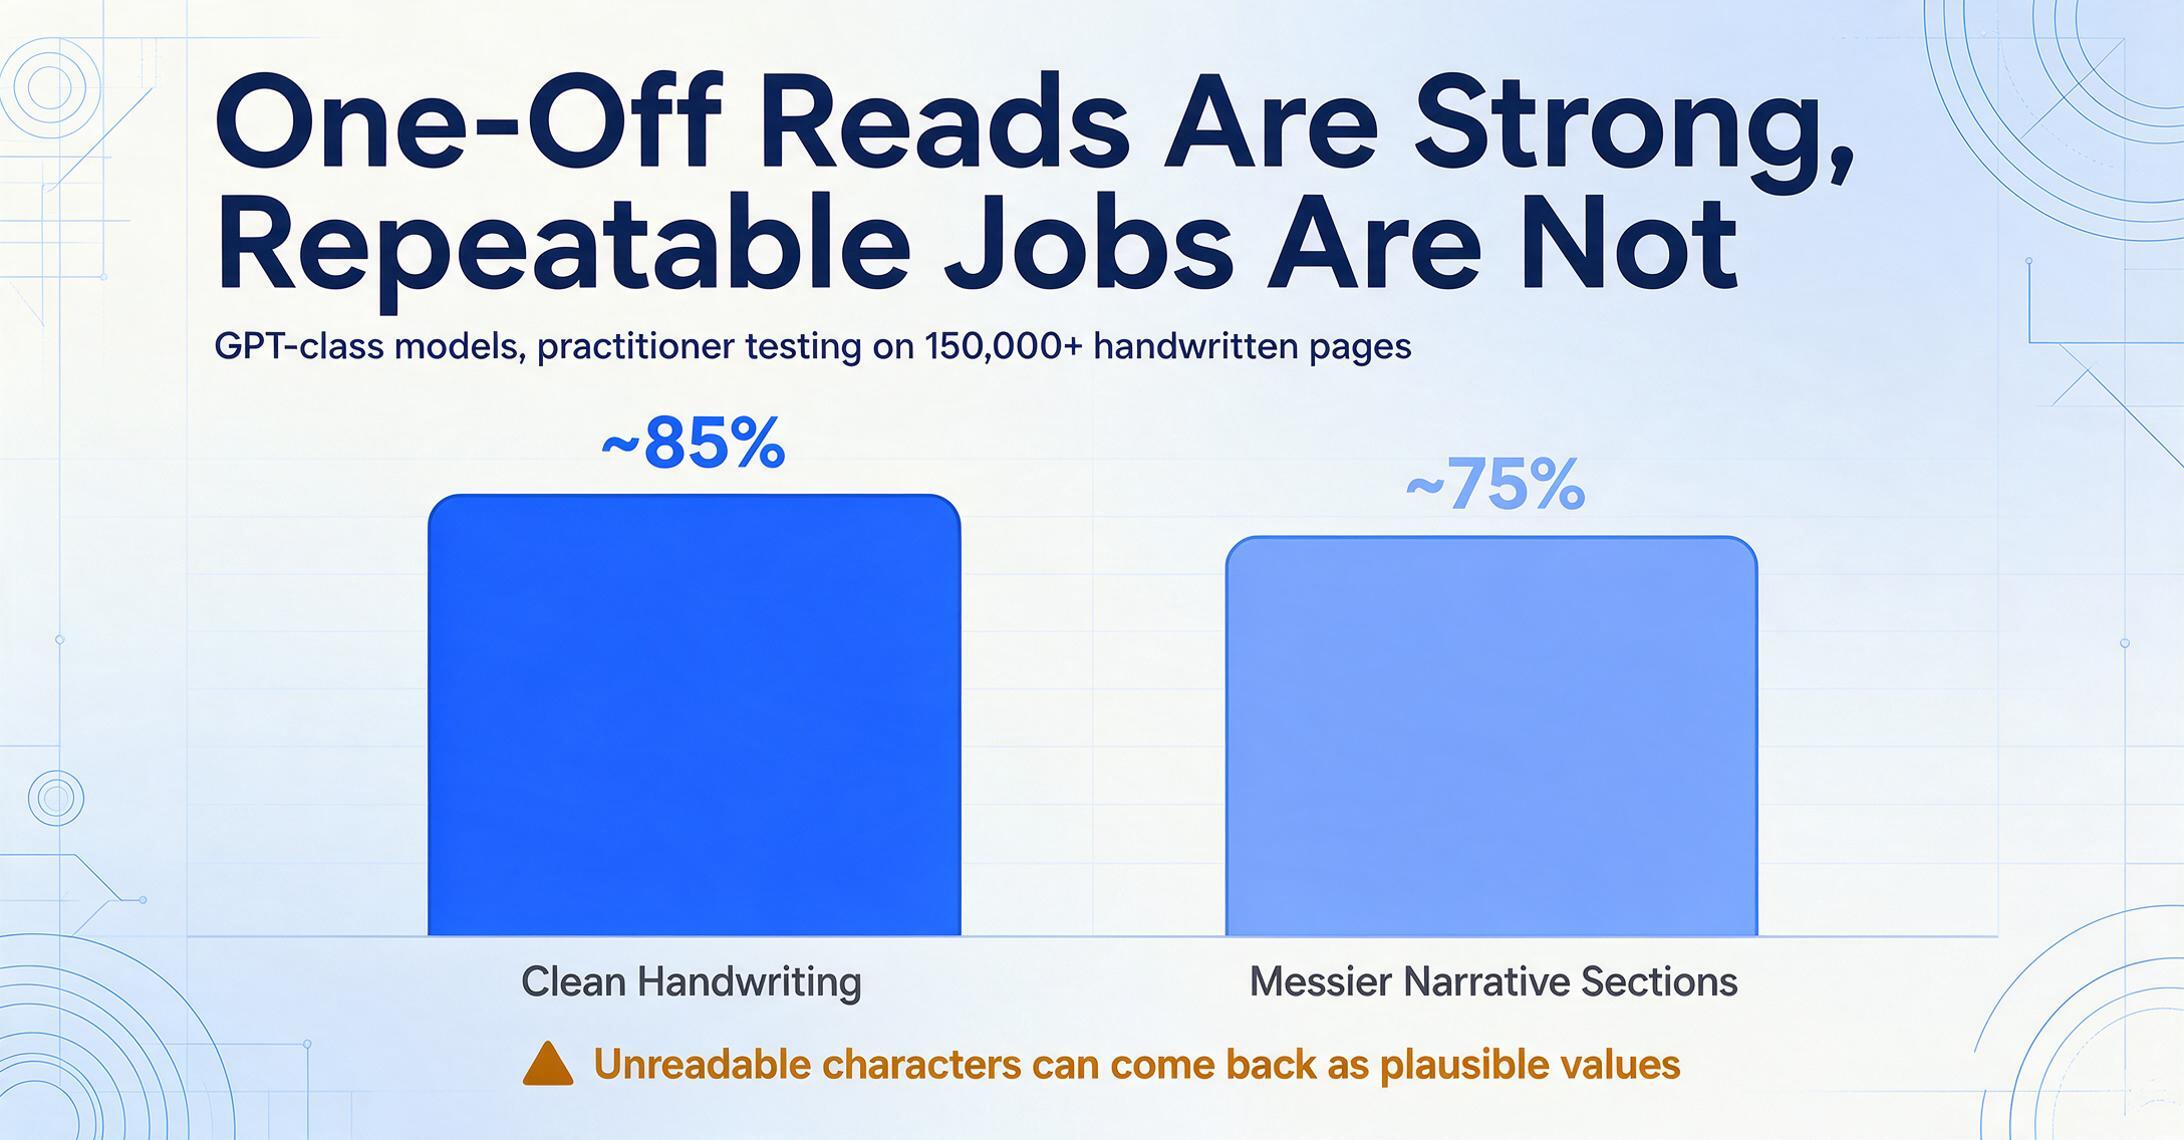
Das „Ja“ ist real. Auf r/OpenAI ist die wiederkehrende Reaktion auf Vision-Modelle schlichtes Erstaunen darüber, dass ein Chatbot „einfach direkt Text aus Bildern lesen kann“, und Menschen fügen jetzt routinemäßig ein Foto in ChatGPT ein und bitten um die Wörter. Eine Praxisbewertung 2025 auf r/computervision – von jemandem, der in der Produktion über 150.000 handgeschriebene Seiten verarbeitet hat – stellte fest, dass GPT-Klassenmodelle „~85 % Genauigkeit bei sauberer Handschrift“ erreichen, was für ein Werkzeug, das keine Einrichtung erfordert, stark ist.
Das „Nein“ ist ebenso real und struktureller Natur. Dieselbe Bewertung stellte fest, dass die Genauigkeit „bei unordentlicheren narrativen Abschnitten auf ~75 % sinkt“, und das tiefere Problem ist nicht der Prozentsatz – es ist die Art des Versagens. Ein unabhängiger Open-Source-OCR-Benchmark, der Vision-Modelle mit traditioneller OCR vergleicht, löste eine vielgelesene technische Diskussion aus, in der ein Praktiker es unverblümt ausdrückte: Vision-Modelle „sind genauso anfällig für das (ungelöste) Halluzinationsproblem“, und „die Fehlermodi sind völlig unbegrenzt (anders als bei regulärer OCR).“ Auch die Wissenschaft stimmt zu – ein NeurIPS-Papier von 2025, „Seeing is Believing? Mitigating OCR Hallucinations in Multimodal LLMs,“ misst genau dies: Bei Unschärfe, Blendung oder teilweiser Verdeckung kann ein LLM selbstbewusst einen plausiblen Wert ausgeben, der nie auf der Seite stand.
Eine herkömmliche OCR-Engine, die ein Zeichen nicht lesen kann, liefert Müll, den man erkennen kann. Ein Sprachmodell, das ein Zeichen nicht lesen kann, liefert möglicherweise eine saubere, selbstbewusste, falsche Antwort – und beim nächsten Lauf eine leicht andere. Diese Nicht-Determiniertheit ist der Grund, warum Chatbots für ein Dokument hervorragend und für hundert riskant sind.
Es gibt auch eine Workflow-Lücke. Weder ChatGPT (Free oder Plus für 20 $/Monat) noch Claude (Free oder Pro für 20 $/Monat) haben eine eingebaute Möglichkeit, fünfzig Bilder in einem Durchgang zu verarbeiten und in einer einzigen konsistenten Datei zusammenzuführen, und derselbe Prompt kann bei verschiedenen Läufen unterschiedliche Spaltenreihenfolgen oder Formate liefern. Für einen einmaligen Einsatz – dieses Kassenbon lesen, diese Notiz transkribieren – sind sie eine legitime, schnelle Wahl. Für einen Prozess möchten Sie das Lesen desselben Modells mit Schutzmechanismen versehen. Wir gehen in unserem ChatGPT-Vergleich ins Detail; die Kurzversion lautet: Verwenden Sie einen Chatbot für ein Dokument, verwenden Sie ein speziell entwickeltes Werkzeug für einen Prozess. ChatGPT-Preise ansehen → Claude-Preise ansehen →
Cloud-OCR-Programmierschnittstellen für Entwickler: Google Document AI & AWS Textract
Wenn Sie über technische Ressourcen und ein konstant hohes Volumen verfügen, sind die beiden Hyperscaler-OCR-APIs der günstigste zuverlässige Weg, Bilder in großem Umfang in Text umzuwandeln. Es sind keine Apps, die Sie „benutzen" – es sind Dienste, auf denen Sie aufbauen, was sowohl ihre Stärke als auch ihre Hürde ist.
Google Document AI
Google Document AI ist eine Cloud-Plattform, deren Enterprise Document OCR-Prozessor für 1,50 $ pro 1.000 Seiten arbeitet (bei über 5 Millionen Seiten/Monat sinkend), mit starker mehrsprachiger und handschriftlicher Abdeckung sowie einer Human-in-the-Loop-Überprüfungsebene für Aufgaben mit höherem Risiko. Die Ausgabe ist zuverlässig und deterministisch – anders als beim LLM-Chat.
Am besten geeignet für: Entwicklungsteams, die eine skalierbare, API-basierte Erkennung für hohes, konstantes Volumen benötigen – insbesondere solche, die bereits Google Cloud nutzen. Nicht ideal für: Nicht-Entwickler; es gibt keine Point-and-Click-App, und die OCR liefert rohe Textblöcke, die vor der Verwendung nachbearbeitet werden müssen. Google Document AI-Preise ansehen →
AWS Textract
Textract ist Amazons Dokumenten-OCR-Dienst, der über mehrere APIs zugänglich ist; sein Basisaufruf Detect Document Text kostet 1,50 $ pro 1.000 Seiten, mit einem kostenlosen Kontingent von 1.000 Seiten/Monat für die ersten drei Monate. Die strukturierten Funktionen (Formulare, Tabellen) kosten pro Seite erheblich mehr, daher ist es am günstigsten, wenn Sie hauptsächlich einfachen Text benötigen.
Am besten geeignet für: Teams, die bereits im AWS-Ökosystem arbeiten und OCR als Baustein in einer größeren Pipeline nutzen möchten. Nicht ideal für: alle ohne Entwickler oder Arbeitslasten, die von Formularen und Tabellen dominiert werden, bei denen die Kosten pro Seite stark ansteigen. Wir erläutern die Trade-offs in unserem AWS-Textract-Vergleich. AWS-Textract-Preise ansehen →
Beide APIs lesen Dokumente zuverlässig und zu niedrigen Kosten pro Seite – aber die Umwandlung ihrer Rohausgabe in eine fertige, strukturierte Datei ist ein Entwicklungsprojekt, kein Feature. Genau diese Lücke schließt das spezialisierte No-Code-Tool.
Dedizierte, exportierbare Extraktion: ImageToTable.ai
Wenn Bild-zu-Text zu einer wiederkehrenden Aufgabe wird und Sie keinen Code schreiben möchten, bietet Ihnen ein dedizierter No-Code-Extraktor die Leseleistung des LLM, eingebettet in die Zuverlässigkeit und den Export, die den Chatbots fehlen. Genau hier ist ImageToTable.ai – das Produkt hinter dieser Website und eines der sieben hier vorgestellten Tools – angesiedelt.
ImageToTable.ai basiert auf einem großen visuellen Modell. Es liest daher gedruckten Text, Handschrift, Schreibschrift, Tabellen und Kontrollkästchen mit demselben kontextuellen Verständnis, das LLMs bei unübersichtlichen Dokumenten stark macht. Der Unterschied liegt in dem, was das Lesen umgibt. Der Nach-Word-Modus nimmt ein Dokumentbild und liefert eine bearbeitbare Word-Datei mit erhaltener Original-Layout – nützlich, wenn Sie die ganze Seite als bearbeitbaren Text möchten, nicht nur einen flachen Zeichendump. Der Nach-Tabelle-Modus nutzt die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Felder ein – „Datum“, „Gesamtbetrag“, „Referenz“ – und die KI findet jeden Wert anhand der Bedeutung und gibt dann eine konsistente Tabelle an Excel, CSV oder JSON aus. In beiden Fällen erhalten Sie eine fertige Datei, jedes Mal auf dieselbe Weise, und Sie können viele Bilder in einem Batch verarbeiten statt eines Chats nach dem anderen. Die Preisgestaltung beginnt mit einem kostenlosen Tarif, dann $9/Monat.
Am besten geeignet für: Freiberufler, Operations-Teams, Buchhalter und kleine Unternehmen, die Bilder wiederholt in bearbeitbaren, exportierbaren Text oder Daten umwandeln müssen – einschließlich Handschrift und Handyfotos – ohne Programmieren, Modelltraining oder die Überwachung jedes Durchlaufs. Nicht ideal für: eine einzelne schnelle Erfassung (Google Lens ist schneller und kostenlos), eine konversationelle Lektüre, bei der Sie den Inhalt auch besprechen möchten (ein Chatbot passt besser), oder Unternehmen, die eine native ERP-Synchronisierung, lokale Bereitstellung oder SOC-2-/HIPAA-Konformität benötigen. Sie können den No-Code-Ansatz auf unserer Bild-zu-Word-Konvertierungsseite oder unserer Handschrift-zu-Text-Seite sehen, und er reiht sich neben andere leichte Optionen in unserer No-Code-Dokument-KI-Übersicht ein. ImageToTable.ai kostenlos testen →
So wählen Sie: einmalig, in großen Mengen, handschriftlich oder für Entwickler
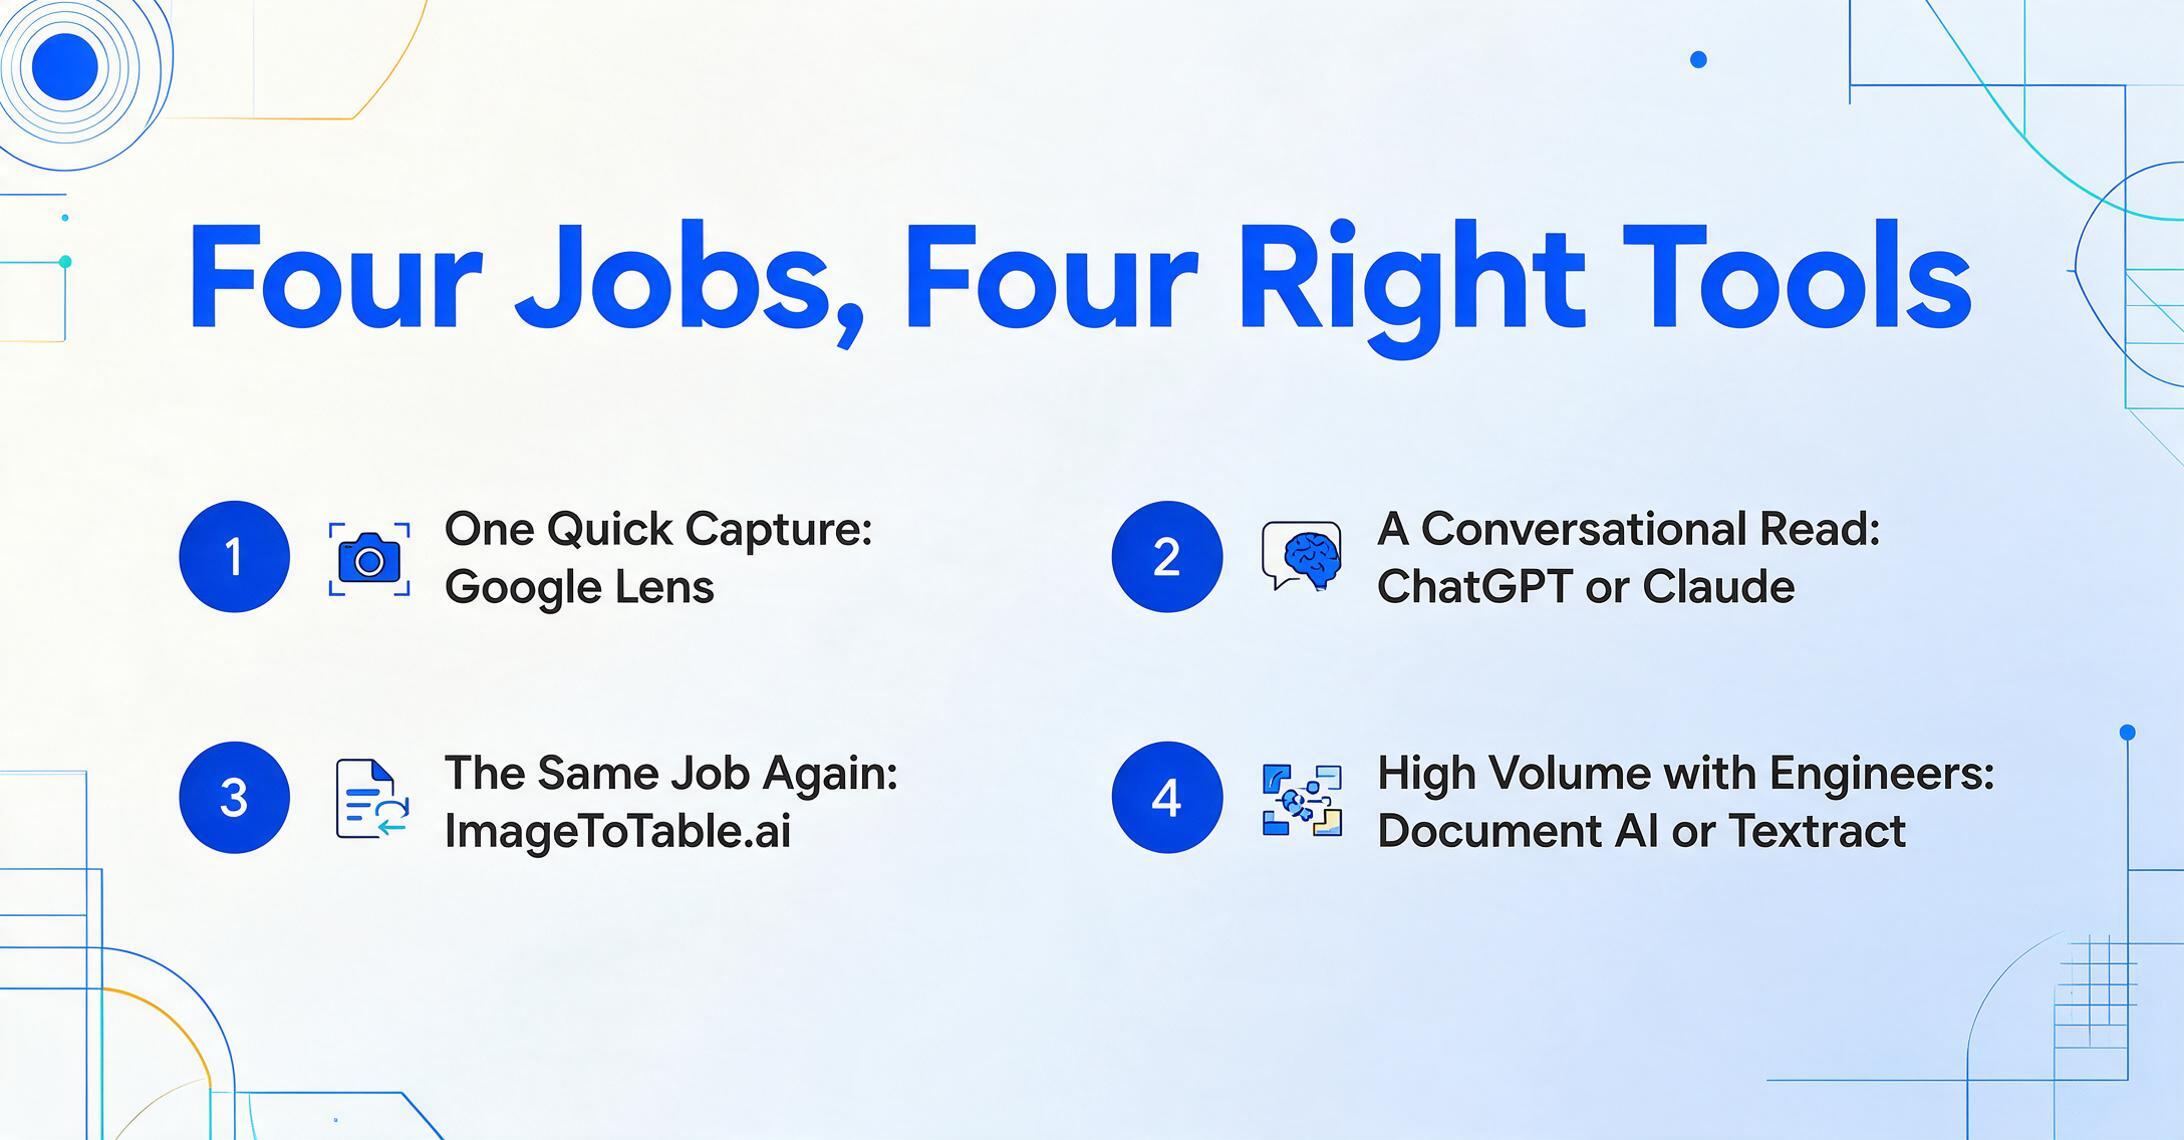
Das richtige Bild-zu-Text-Tool ist das, dessen Form zu Ihrer Aufgabe passt – nicht das mit den meisten Sternen. Hier ist die Entscheidung in vier häufigen Szenarien.
Eine schnelle Erfassung
Am besten geeignet: Google Lens (oder OCR.space)
Sie möchten einen Absatz, einen Code oder eine Speisekarte erfassen? Nutzen Sie das kostenlose Telefon-Tool – es ist sofort einsatzbereit und erfordert keine Einrichtung. Ein kostenpflichtiges Tool ist hier übertrieben. Ein PNG-Screenshot, der zu einem bearbeitbaren Dokument werden soll, ist eine andere Aufgabe – das Konvertieren eines PNG in Word erfordert Layout-Erkennung, die die Dienstprogramme nicht bieten.
Eine konversationelle Abfrage oder Analyse
Am besten geeignet: ChatGPT oder Claude
Sie möchten ein Dokument lesen und Fragen dazu stellen? Ein Chatbot ist ideal – überprüfen Sie nur alles, was wichtig ist, und verlassen Sie sich nicht darauf, dass er zweimal identische Ausgaben liefert.
Viele Bilder, wiederholbar, exportierbar
Am besten geeignet: ImageToTable.ai
Sie konvertieren immer wieder dieselbe Art von Dokument in bearbeitbaren Text oder eine Tabelle, ohne Code, mit einer konsistenten Ausgabedatei? Das ist der No-Code-ideale Anwendungsfall. Beginnen Sie mit dem kostenlosen Tarif.
Hohe Volumina mit Entwicklern
Am besten geeignet: Google Document AI oder AWS Textract
Konstant hohe Volumina und ein Entwicklerteam, das darauf aufbaut? Die Cloud-Programmierschnittstellen sind pro Seite am günstigsten. Wählen Sie danach, in welcher Cloud Sie bereits leben.
Wenn Ihre Aufgabe die strukturierte Datenseite betrifft – das Extrahieren von Feldern und Zeilen in eine Tabelle statt nur das Transkribieren von Text – lesen Sie die weiterführenden Anleitungen, die tiefer in diesen Bereich gehen: unsere Übersicht zu KI-OCR-Software und unsere Übersicht zu Dokumentdatenextraktionstools.
Häufig gestellte Fragen
Was ist der beste kostenlose KI-Bild-zu-Text-Konverter?
Für eine schnelle, einmalige Nutzung ist Google Lens die beste kostenlose Option – es ist in die Google App, Chrome und Google Fotos integriert, liest Text aus jedem Bild sofort und kostet nichts. Für kostenlose Text-OCR im Browser oder über eine API ist OCR.space eine solide Wahl. Wenn Sie den Text wiederholt und in einer exportierbaren Datei benötigen, bietet ImageToTable.ai einen kostenlosen Tarif, der über eine reine Textausgabe hinausgeht und bearbeitbare Word-Dokumente oder strukturierte Tabellen liefert.
Kann ich einfach ChatGPT verwenden, um ein Bild in Text umzuwandeln?
Für ein einzelnes Dokument: Ja – fügen Sie das Bild in ChatGPT (kostenlos oder Plus für 20 $/Monat) oder Claude ein und bitten Sie um den Text. In der Regel wird er gut gelesen, mit etwa 85 % Genauigkeit bei sauberer Handschrift, so unabhängige Praxistests. Der Haken liegt in der Zuverlässigkeit bei größeren Mengen: Sprachmodelle sind nicht deterministisch (das gleiche Bild kann bei verschiedenen Durchläufen unterschiedliche Ergebnisse liefern) und können einen plausiblen Wert „halluzinieren", wenn ein Zeichen unleserlich ist – Fehlermodi, die schwer zu erkennen sind. Verwenden Sie einen Chatbot für den Einzelfall; verwenden Sie ein spezielles Tool, wenn Sie das gleiche Ergebnis wiederholt benötigen.
Sind KI-Bild-zu-Text-Tools bei Handschrift genau?
Tools, die auf Vision-Modellen basieren, lesen Handschrift weitaus besser als herkömmliche OCR, da sie den Kontext nutzen. Die Genauigkeit sinkt jedoch bei unordentlicher oder kursiver Schrift – Praxistests zeigen bei führenden Modellen etwa 85 % bei sauberer Handschrift, die auf grob 75 % bei unordentlicheren Abschnitten fallen. Testen Sie bei handschriftlastiger Arbeit Ihre tatsächlichen Dokumente zuerst in einem kostenlosen Tarif und bevorzugen Sie Tools, mit denen Sie die Ausgabe überprüfen und korrigieren können, anstatt solche, die nur einen flachen Textblock zurückgeben.
Was ist der Unterschied zwischen OCR und einem KI-Bild-zu-Text-Tool?
Herkömmliche OCR gleicht Pixelformen mit Zeichen ab und gibt Text ohne Verständnis aus – schnell und deterministisch, scheitert aber bei schlechten Scans, Handschrift und ungewöhnlichen Layouts. KI-Bild-zu-Text-Tools verwenden ein visuelles Sprachmodell, das die Seite im Kontext liest und daher mit unordentlichen realen Bildern weitaus besser zurechtkommt. Der Nachteil ist, dass KI-Modelle gelegentlich etwas erfinden können. Deshalb verpacken spezielle Tools sie in Struktur- und Exportkontrollen, anstatt Sie mit roher Chat-Ausgabe allein zu lassen.
Wie konvertiere ich ein Bild in bearbeitbaren Text, den ich in Word bearbeiten kann?
Kostenlose Tools wie Google Lens und OCR.space liefern kopierbaren Klartext, erhalten aber nicht das Layout. Für ein bearbeitbares Dokument, das die ursprüngliche Formatierung beibehält, verwenden Sie ein Tool mit layoutbewusstem Modus: Der Nach-Word-Modus von ImageToTable.ai liest ein Dokumentbild und exportiert eine bearbeitbare Word-Datei mit intaktem Original-Layout, sodass Überschriften, Absätze und Tabellen an ihrem Platz landen, statt als ein einziger flacher Absatz. Auch eine fotografierte Seite nimmt diesen Weg: der JPG-zu-Word-Workflow exportiert ein bearbeitbares Dokument mit Überschriften und Tabellen an Ort und Stelle, nicht als einen einzigen Textblock.
Welches Bild-zu-Text-Tool eignet sich am besten für die Verarbeitung vieler Bilder auf einmal?
Telefon-Apps und Chatbots haben keinen echten Stapelverarbeitungs-Workflow. Für viele Bilder benötigen Sie daher entweder eine Cloud-Programmierschnittstelle für Entwickler (Google Document AI oder AWS Textract, falls Sie Ingenieure haben) oder ein No-Code-Tool, das für Stapelverarbeitung gebaut wurde. ImageToTable.ai verarbeitet mehrere Bilder in einem Durchgang und führt sie zu einer einzigen exportierbaren Datei zusammen – das ist die Lücke, die Einzelbild-Tools wie Lens und ChatGPT nicht schließen können.
Das Fazit
Das Wichtigste aus diesem Vergleich: „Bild zu Text" ist keine einzelne Kategorie – es sind drei, und sie scheitern auf unterschiedliche Weise. Eine Telefon-App (Lens, OCR.space) ist perfekt für eine einzelne Aufnahme und nutzlos für hundert. Ein Chatbot (ChatGPT, Claude) liest brillant für den einmaligen Gebrauch, ist aber nicht-deterministisch und kann Dinge erfinden, was ihn als wiederholbaren Prozess riskant macht. Ein dediziertes Tool (die Cloud-Programmierschnittstellen für Entwickler, ImageToTable.ai für alle anderen) tauscht etwas Einzelbild-Flexibilität gegen das ein, was den anderen fehlt – dasselbe zuverlässige, exportierbare Ergebnis, jedes Mal, über viele Bilder hinweg.
Wählen Sie nicht das Tool, das ein einzelnes Bild am besten liest. Wählen Sie das, dessen Form zu Ihrer Aufgabe passt: ein Tool für eine Aufnahme, ein Chatbot für ein Gespräch und einen dedizierten Extraktor für einen wiederholbaren, exportierbaren Prozess.
Wenn Ihre Bild-zu-Text-Arbeit von „ab und zu" zu „immer wieder" gewechselt ist, ist das das Signal, vom kostenlosen Tool und dem Chatfenster umzusteigen. Laden Sie eine Handvoll eigener Bilder hoch, benennen Sie, was Sie herausbekommen möchten, und sehen Sie, ob eine fertige, konsistente Datei in Sekunden mehr wert ist als eine Zwischenablage voller Text, den Sie von Hand erneut prüfen müssen.
Offenlegung: Dieser Leitfaden wird von ImageToTable.ai veröffentlicht, einem der sieben oben bewerteten Tools. Wir haben eine faire, technische Bewertung angestrebt – einschließlich der Benennung der Szenarien, in denen Google Lens, ChatGPT, Claude oder die Cloud-OCR-Programmierschnittstellen die bessere Wahl sind. Die Preise wurden den öffentlichen Preisseiten der jeweiligen Anbieter entnommen und sind Stand Juni 2026; prüfen Sie die aktuellsten Zahlen auf der Website jedes Anbieters vor dem Kauf.