OCR vs Visão de IA para Extração de Documentos
Qual Você Deve Escolher?
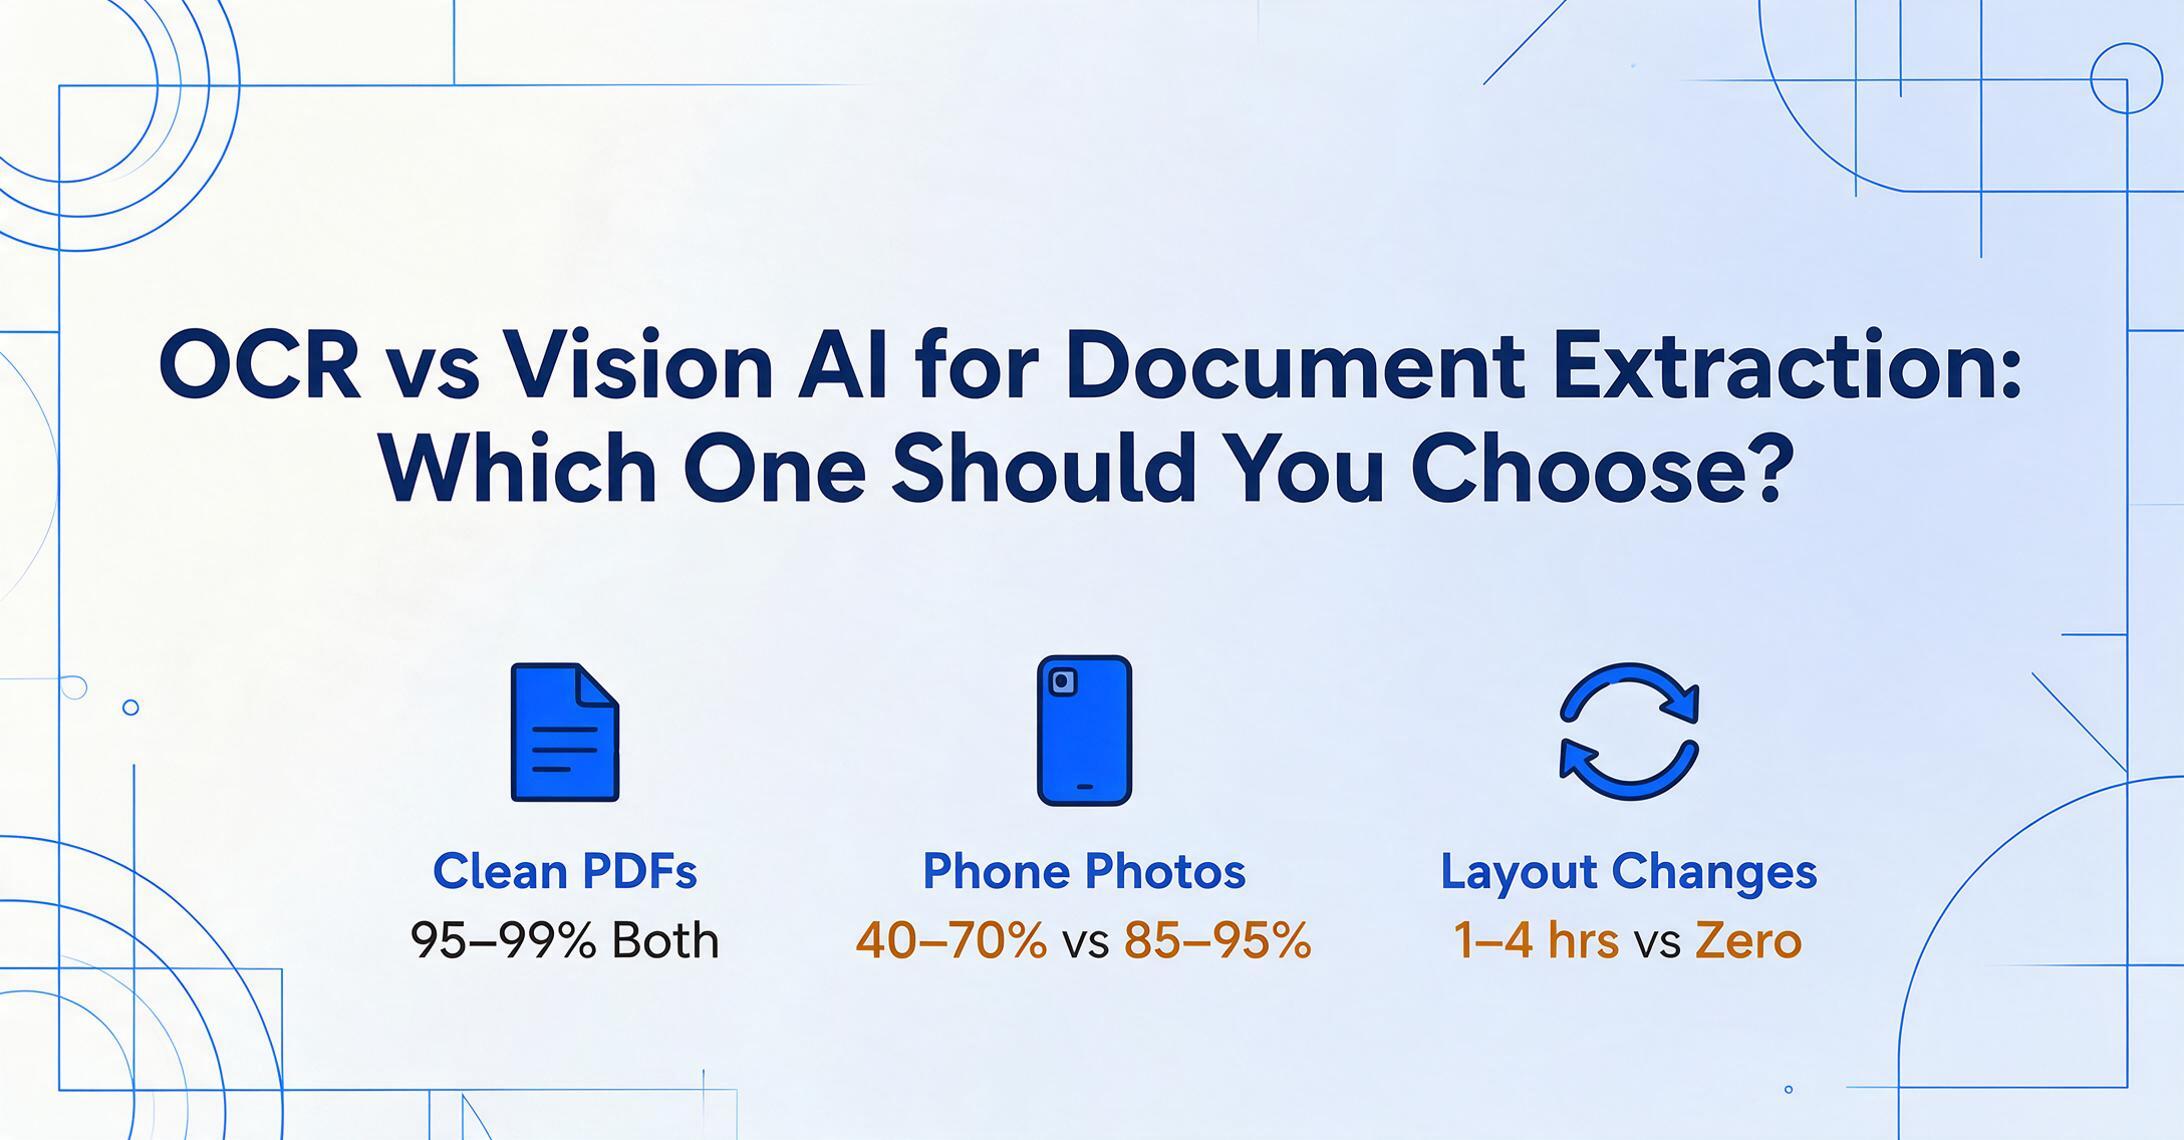
O OCR tradicional lê documentos caractere por caractere — ele vê texto. A Visão de IA lê documentos como uma pessoa — ela entende o que o texto significa e onde ele pertence. Essa distinção importa mais do que qualquer comparação de velocidade ou preço, porque determina o que quebra quando seus documentos mudam e o que continua funcionando sem que ninguém toque na configuração.
Principais Conclusões
- OCR a $0,01/página parece a escolha barata óbvia — até você considerar as 30–40 horas de manutenção de modelo que uma operação com 50 fornecedores consome silenciosamente todos os anos.
- O preço do software por página esconde três categorias de custo que nunca aparecem em nenhuma fatura: 1–4 horas de configuração de modelo por novo formato, 15–40 horas de manutenção reativa por ano a cada 50 remetentes e erros silenciosos que surgem durante a conciliação — semanas depois de a extração parecer correta.
- Pare de comparar preços de API por página. O único número que importa é o custo total por documento — e quando você adiciona o trabalho que a manutenção de modelo consome, a ferramenta "mais barata" geralmente é a mais cara.
Comparação Rápida: OCR vs Visão IA
Se você precisa de uma tabela para decidir se vale a pena continuar lendo, é esta. Cada dimensão é explicada em detalhes abaixo.
| Dimensão | OCR Tradicional / Ferramentas de Modelo | Visão IA |
|---|---|---|
| Como lê | Reconhecimento de caracteres + modelos de zona | Compreensão semântica da página |
| Precisão em digitalizações limpas | 95–99% | 95–99% |
| Precisão em fotos de celular | 40–70% | 85–95% |
| Precisão em escrita à mão | 50–70% | 85–93% |
| Tempo de configuração por formato | 1–4 horas (criação de modelo) | 0 — funciona no primeiro upload |
| Tolerância a mudanças de formato | Quebra — o modelo precisa ser reconstruído | Adapta-se automaticamente |
| Custo por página (somente software) | Menor ($0.01–0.03/página em escala) | Maior ($0.02–0.10/página) |
| Custos de manutenção ocultos | Significativos — manutenção de modelo por remetente | Quase zero |
Como Funcionam: Pixels vs Significado
O Reconhecimento Óptico de Caracteres foi projetado para resolver um problema específico: converter uma imagem de texto em caracteres legíveis por máquina. Ele identifica formatos de letras individuais pixel por pixel, os agrupa em palavras e gera um fluxo de texto organizado pela ordem de leitura. Um mecanismo de OCR tradicional pode informar que os caracteres "1.234,56" aparecem em uma página, mas não tem ideia se isso é um total de fatura, uma quantidade ou um número de referência. A saída é texto bruto que ainda precisa de interpretação humana.
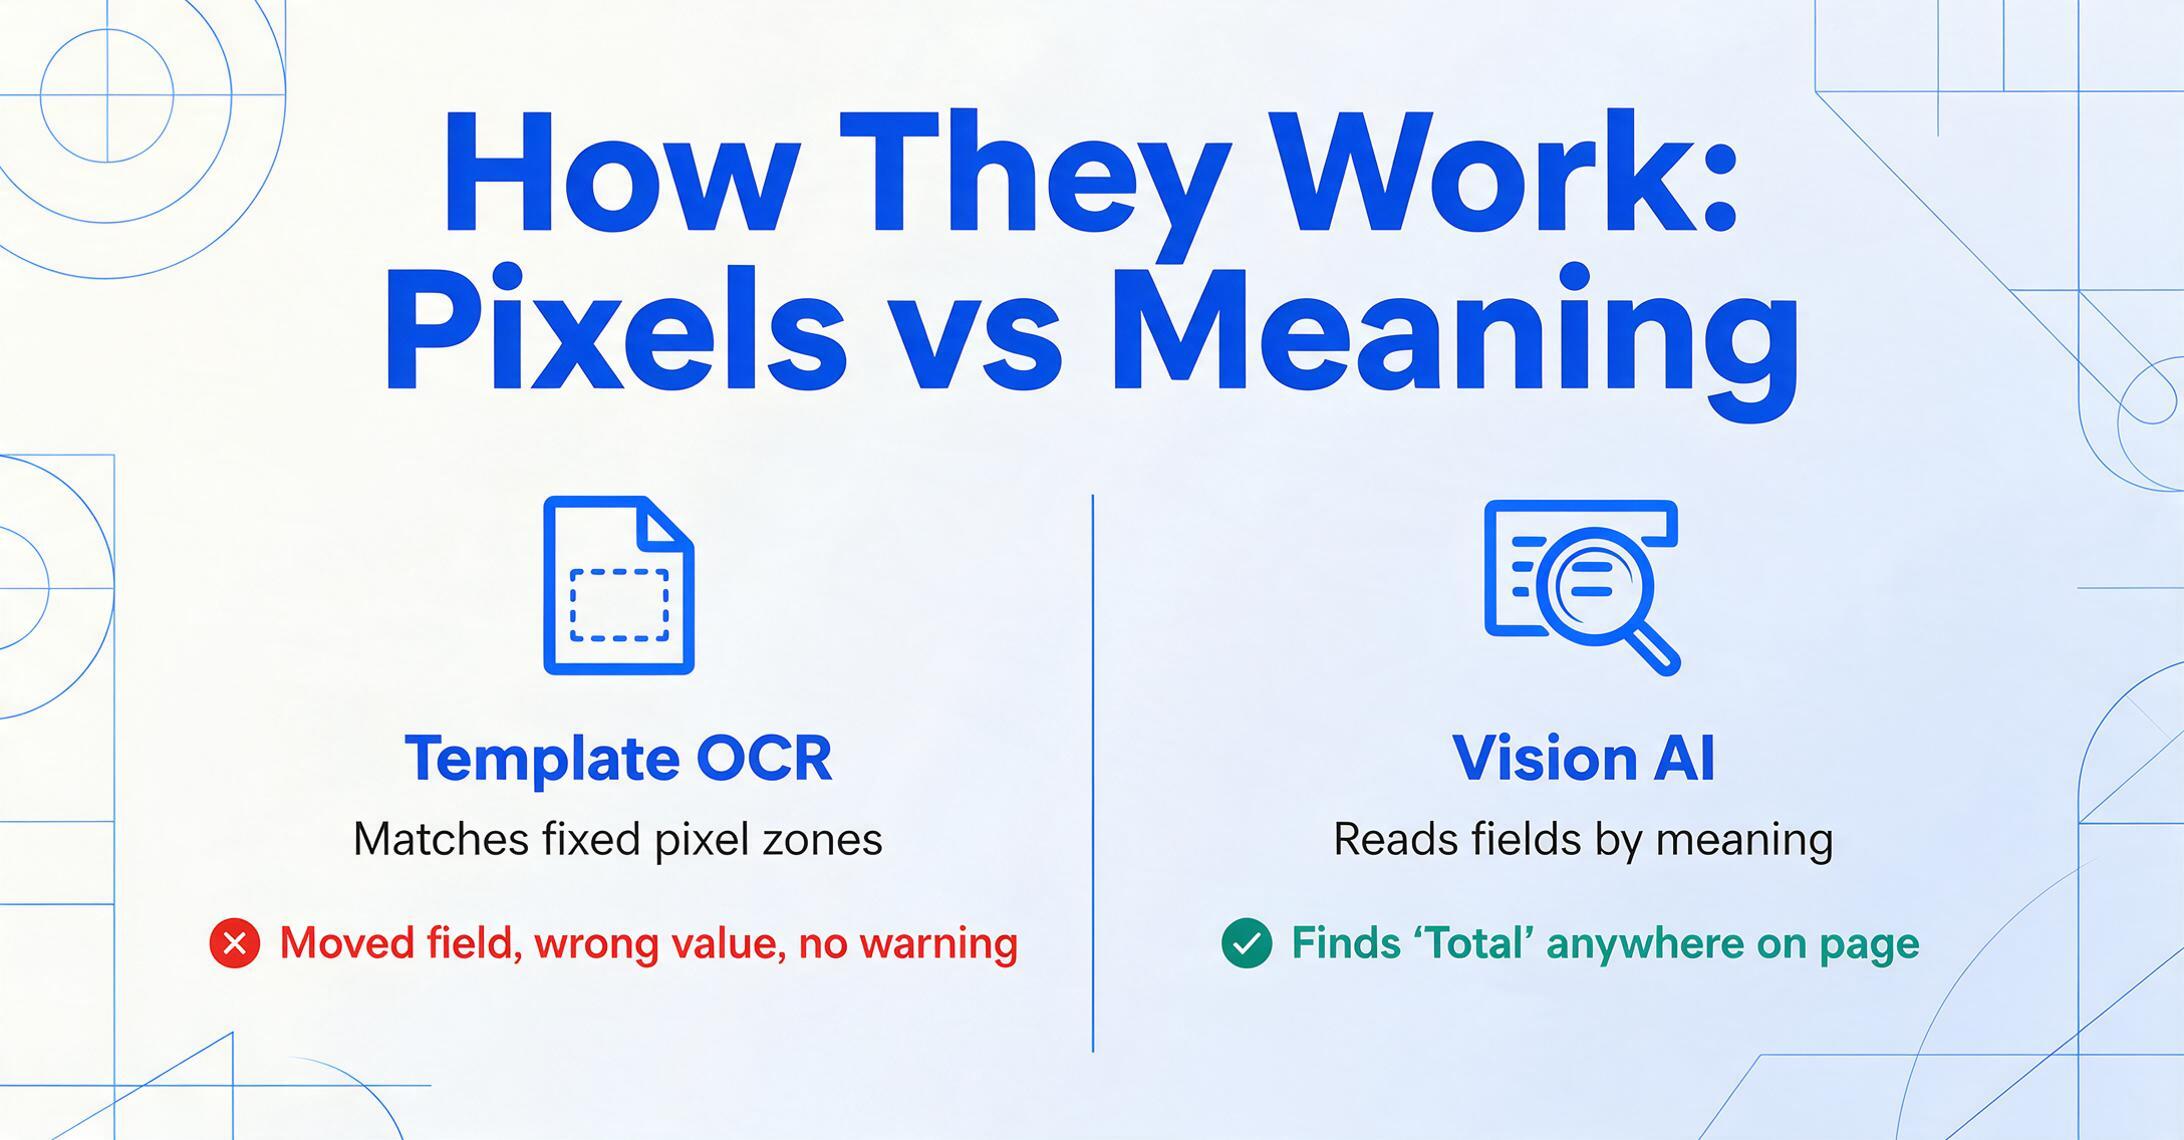
As ferramentas de OCR baseadas em modelos adicionam uma segunda camada sobre o reconhecimento de caracteres: você desenha zonas ao redor de cada campo em um documento de amostra. "O Número da Fatura está nas coordenadas de pixel (50, 120) a (200, 145)." Quando um novo documento chega com um layout idêntico, o modelo funciona. Quando um fornecedor move o campo do número da fatura — mesmo dois centímetros — o modelo extrai qualquer texto que agora esteja naquela zona de coordenadas. Ele não sabe que está errado. Os dados vão para sua planilha parecendo plausíveis, e o erro aparece mais tarde quando alguém concilia os números.
A Visão IA elimina completamente a etapa de zonas. Um modelo de linguagem visual processa o documento como uma imagem inteira, entende o papel de cada seção (cabeçalho vs tabela vs rodapé) e identifica campos por significado em vez de posição. Você digita os nomes das colunas que deseja — "Número da Fatura", "Data", "Total" — e a IA localiza valores correspondentes em qualquer lugar da página ao entender o que cada rótulo representa. "Nº da Fatura", "INV#", "Referência de Cobrança" e "Nossa Ref.:" são todos mapeados para a mesma coluna porque o modelo entende que são conceitos equivalentes no contexto de uma fatura comercial.
Para uma análise mais aprofundada de como essa abordagem semântica elimina a necessidade de modelos, veja nossa explicação sobre extração sem modelo.
Precisão: Onde a Lacuna se Abre e Onde se Fecha
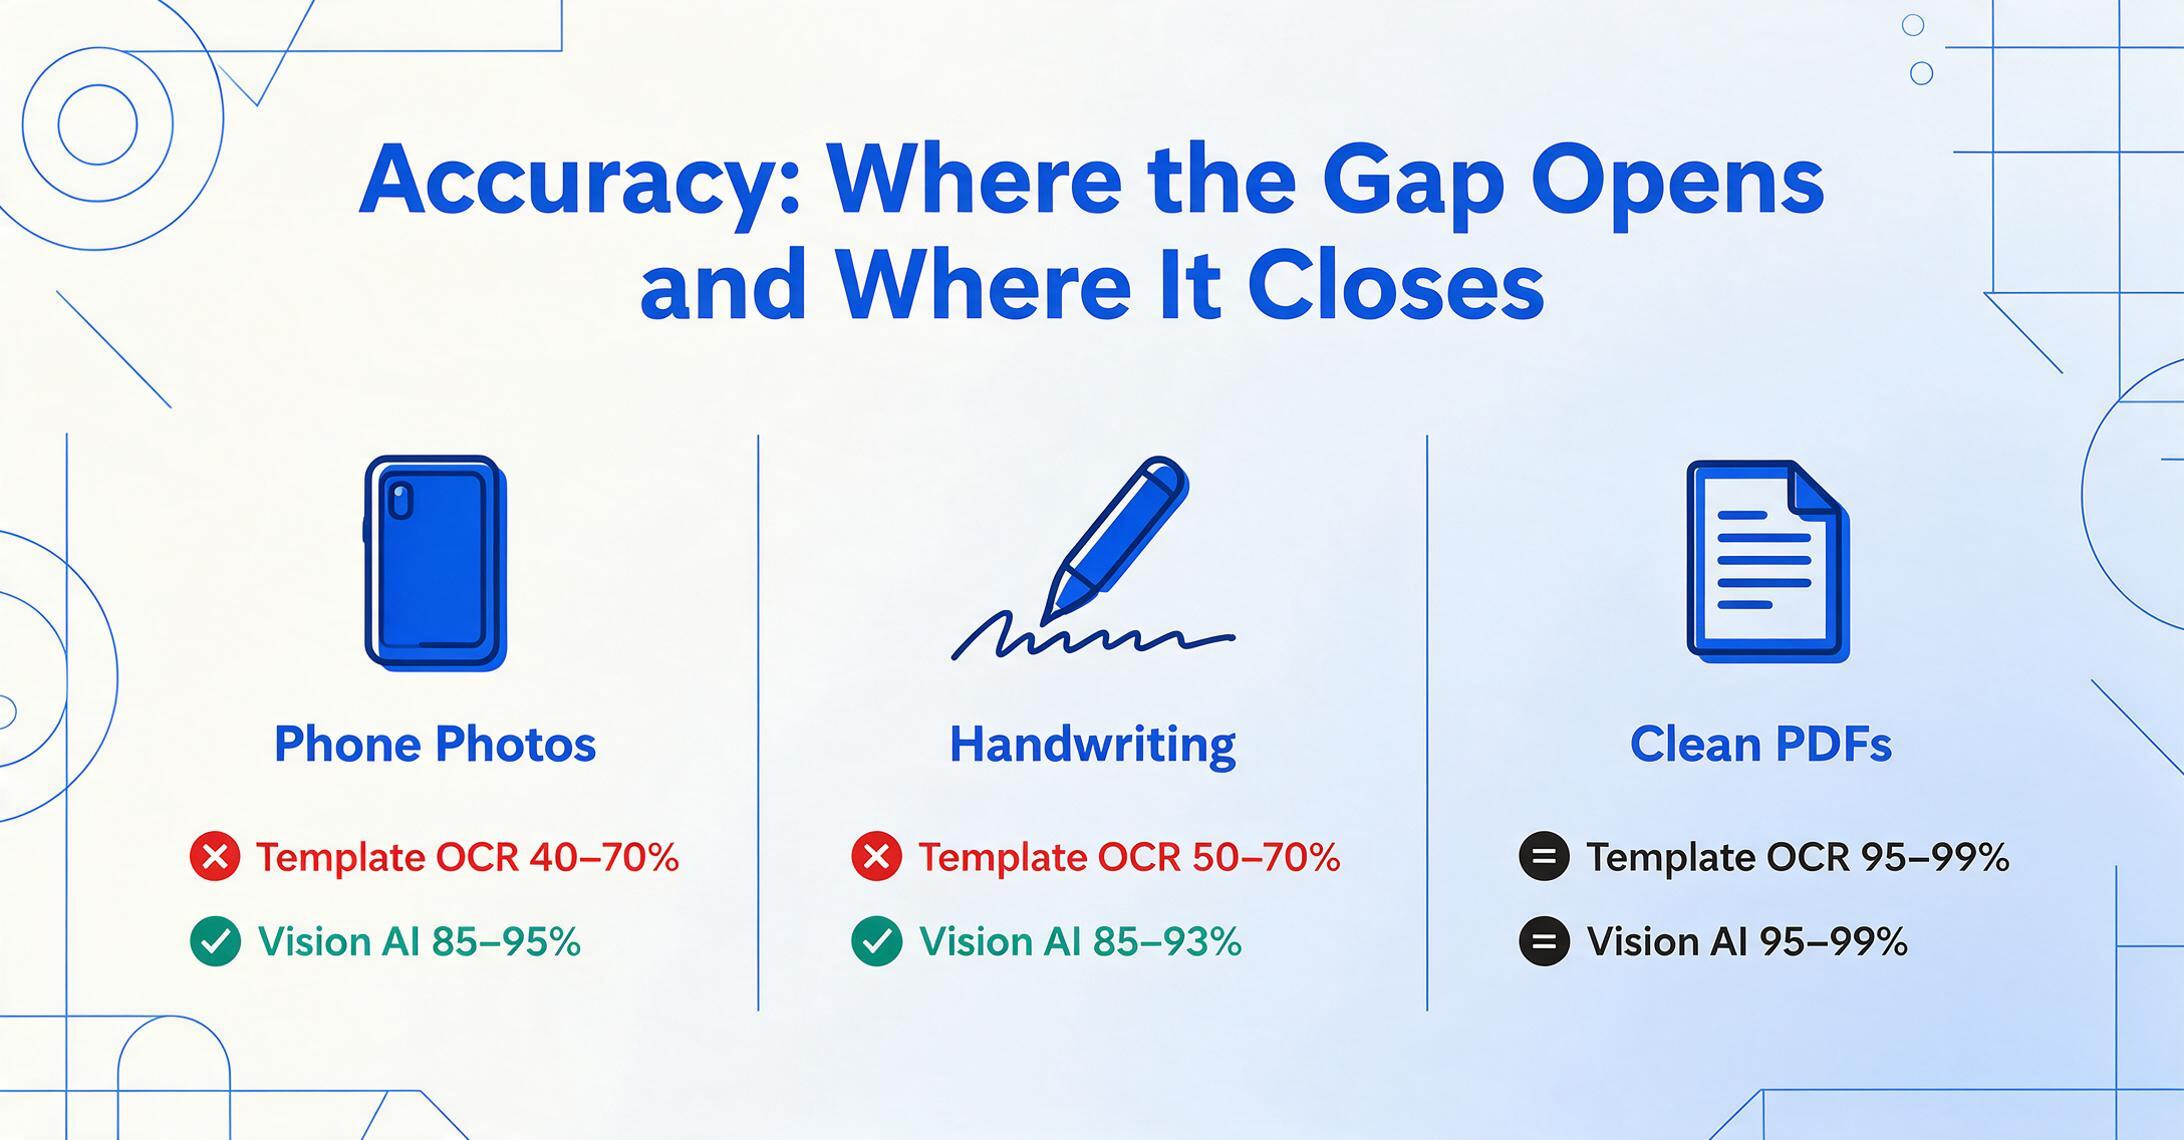
Em documentos impressos limpos — pense em um PDF gerado digitalmente por um sistema contábil moderno — ambas as abordagens apresentam bom desempenho. Os mecanismos de OCR alcançam 95–99% de precisão de caracteres, e os modelos de visão igualam ou superam ligeiramente essa faixa. Se todo documento que você processa é um PDF nítido e digitado, com formatação consistente, a precisão sozinha não vai direcionar sua decisão.
A lacuna aparece assim que a qualidade do documento ou a diversidade de layout aumenta:
- Fotos de celular. Uma foto de nota fiscal tirada em uma mesa tem iluminação irregular, distorção de perspectiva e, frequentemente, sombras. Mecanismos de OCR treinados em digitalizações planas veem uma queda significativa de precisão — resultados em nível de campo podem cair para 40–70%. A Visão IA, treinada em milhões de fotos do mundo real, mantém 85–95% de precisão porque lê contextualmente: mesmo quando caracteres individuais estão borrados, o modelo infere o valor correto a partir do texto ao redor e da estrutura do documento.
- Escrita manual. Este continua sendo o maior ponto fraco do OCR tradicional. A morfologia dos caracteres manuscritos varia tanto entre escritores que a correspondência de padrões baseada em modelos rotineiramente erra ou deixa de ler 30–50% dos caracteres. A Visão IA lida com escrita legível com 85–93% de precisão — não é perfeita, mas é utilizável o suficiente para que a transcrição manual continue necessária apenas nos casos mais difíceis.
- Tabelas complexas. Tabelas de itens com múltiplas colunas, células mescladas, cabeçalhos aninhados e contagens de linhas variáveis são outro ponto fraco do OCR. O OCR tradicional achata o conteúdo da tabela em um fluxo de texto linear — linhas viram parágrafos, colunas se mesclam, e o leitor precisa reconstruir mentalmente a grade. A Visão IA preserva a estrutura da tabela porque enxerga a grade como um objeto visual e extrai linhas e colunas por suas relações espaciais e semânticas.
Tolerância a mudanças de formato: o custo oculto
Um fornecedor redesenha o layout da nota fiscal. Um novo fornecedor envia ordens de compra em um formato que você nunca viu. Um cliente troca de software contábil e o aviso de remessa agora parece completamente diferente.
Para OCR baseado em modelos, cada um desses eventos é uma falha. O modelo foi criado para o layout antigo. O novo layout não corresponde às coordenadas armazenadas. A extração produz silenciosamente dados incorretos ou ausentes. Alguém precisa notar o problema, identificar qual modelo quebrou e reconstruí-lo — um processo que normalmente leva de 1 a 4 horas por formato, dependendo da complexidade do documento.
Para Visão IA, nada acontece — porque não há modelos para quebrar. A IA lê cada documento de forma independente, pelo significado semântico. Uma nota fiscal reformulada ainda tem número, data e total. Os nomes das colunas que você definiu uma vez continuam funcionando. Sem reconstrução de modelo, sem corrupção de dados, sem intervenção manual.
O impacto prático dessa diferença é fácil de subestimar quando você tem 5 fornecedores e difícil de ignorar quando você tem 50. Uma equipe financeira que processa notas fiscais de 50 fornecedores pode enfrentar de 15 a 20 mudanças de layout por ano em sua base de fornecedores. A 2 horas por reconstrução de modelo, isso representa de 30 a 40 horas de manutenção reativa — uma semana inteira de trabalho gasto para manter um sistema "automatizado" funcionando.
Tempo de configuração: horas por formato vs. zero
Uma ferramenta de OCR baseada em modelos exige um processo de configuração antes de extrair qualquer coisa útil de um novo tipo de documento. Você envia uma amostra, desenha zonas retangulares ao redor de cada campo (número da nota fiscal, data, total, itens de linha), rotula cada zona e às vezes define regras de parsing para tabelas multilinha. Para uma nota fiscal padrão, isso leva de 1 a 3 horas na primeira vez. Para um documento complexo, como um aviso de remessa ou um contrato de várias páginas, pode levar meio dia.
Visão IA exige zero configuração por formato. Você define os nomes das colunas uma vez — eles se tornam seu modelo de extração — e o modelo lê todos os tipos de documento que você enviar. Ao começar a processar uma nova categoria de documento (passando de notas fiscais para ordens de compra), você não cria um novo modelo; você simplesmente ajusta sua lista de colunas. O modelo faz o resto.
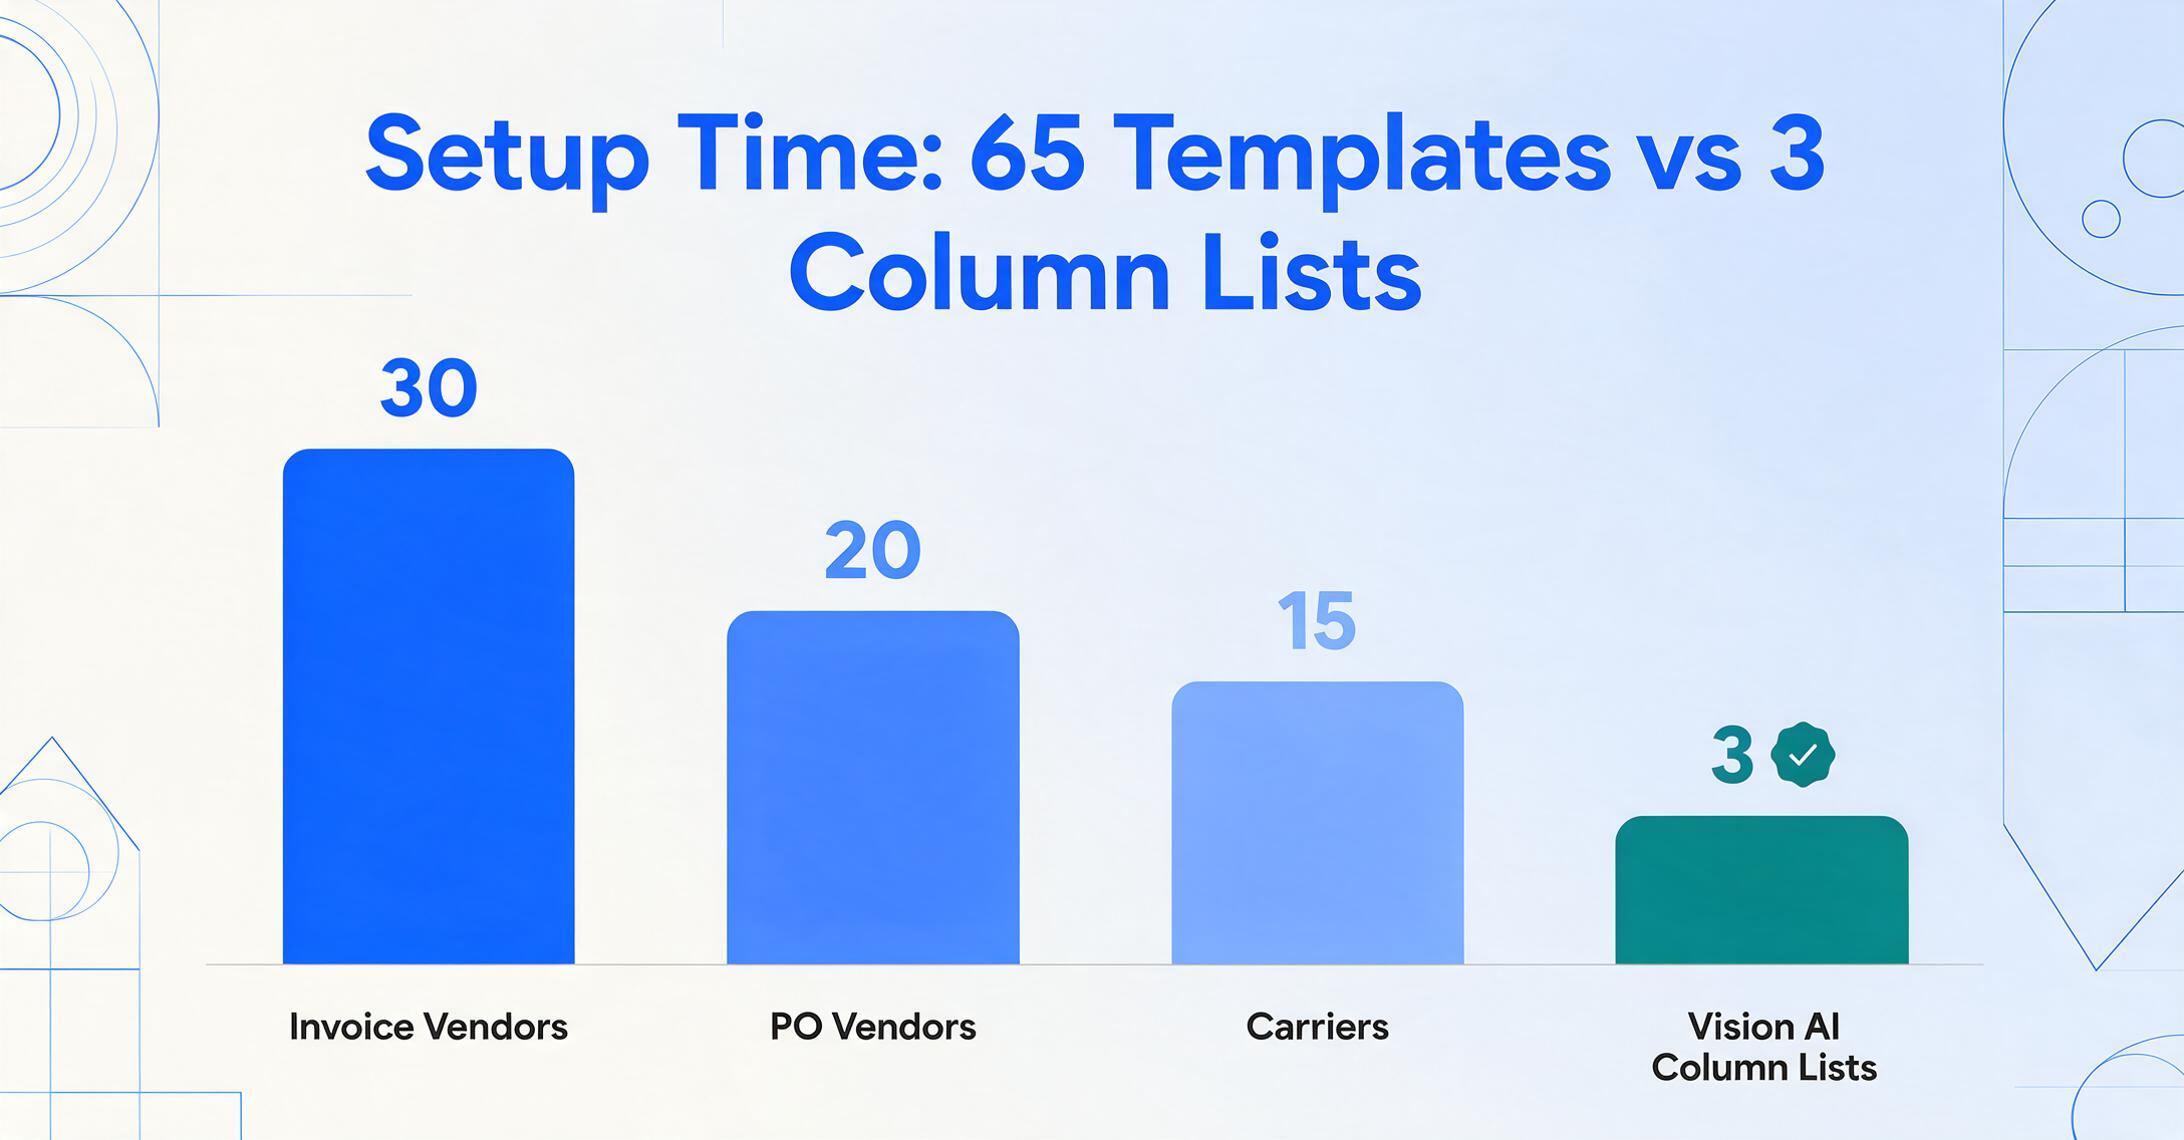
Essa diferença se acumula. Um sistema baseado em modelos que processa notas fiscais de 30 fornecedores, ordens de compra de 20 fornecedores e avisos de entrega de 15 transportadoras precisa de 65 modelos separados. Cada um exigiu tempo para ser criado e precisa de manutenção. Um sistema de Visão IA que processa a mesma variedade de documentos usa uma lista de colunas para cada tipo de documento — três listas em vez de 65 modelos. Para uma comparação detalhada de como isso se desenrola entre as ferramentas, consulte nosso guia de extração sem modelo.
Comparação de Custos: O Preço do Software é Apenas Metade da História
No nível de software, as ferramentas de OCR são mais baratas por página. Um mecanismo de OCR comercial processando altos volumes pode custar $0,01–0,03 por página. A extração com Visão IA normalmente custa $0,02–0,10 por página. Na superfície, o OCR parece a opção mais econômica.
O problema com essa comparação superficial é que ela ignora os custos de mão de obra somados ao software. Cada página que precisa de correção manual custa dinheiro — não em taxas de software, mas em tempo humano. E cada modelo que quebra custa dinheiro em retrabalho.
| Tipo de Custo | OCR / modelo | Visão IA |
|---|---|---|
| Software (1.000 páginas/mês) | $10–30 | $20–100 |
| Configuração de modelo (por formato) | 1–4 h × taxa horária da sua equipe | $0 |
| Manutenção de modelo (anual) | 15–40 h por 50 remetentes | $0 |
| Correção de erros (documentos variáveis) | 5–15 min por documento com problemas | 1–3 min para verificação pontual |
O ponto de equilíbrio muda dependendo da sua mistura de documentos. Se você processa 10.000 formulários W-2 idênticos por mês, a economia por página do OCR domina e a falta de variação de formato significa que os modelos nunca quebram. Se você processa 1.000 faturas de 100 fornecedores diferentes com layouts variados, a economia da Visão IA com a eliminação da manutenção de modelos e a redução da correção de erros cobre o custo mais alto por página várias vezes. Para uma análise completa de como os preços por página e por assinatura se comparam no mercado, veja nossa análise de preços.
Quando o OCR baseado em modelos faz mais sentido
O OCR baseado em modelos não está obsoleto. Ele continua sendo a escolha certa em vários cenários:
- Formulários idênticos em alto volume. Se você processa 50.000 formulários W-2, 20.000 pedidos de empréstimo padronizados ou 100.000 contas de serviços públicos — todos da mesma fonte com layout fixo — a vantagem de custo por página do OCR em escala é real. O custo de configuração do modelo é um investimento único amortizado em milhões de páginas.
- Apenas PDFs digitais limpos. Se seu pipeline de documentos consiste exclusivamente em PDFs gerados digitalmente com texto incorporado (sem digitalizações, sem fotos, sem manuscritos), a precisão do OCR é excelente e o custo de manutenção é baixo.
- Sensível a custos em escala massiva. Em volumes mensais acima de 50.000 páginas, a diferença entre $0,01/página e $0,05/página se torna milhares de dólares. Se seus documentos são uniformes e seu formato nunca muda, o custo menor por página é a decisão matemática correta.
- Requisitos de saída determinística. O OCR produz a mesma saída toda vez para a mesma entrada. Alguns ambientes regulados preferem essa previsibilidade mesmo que a precisão seja ligeiramente menor, porque o comportamento é consistente e auditável.
Quando a Visão IA faz mais sentido
A Visão IA vence na maioria dos cenários em que a variedade de documentos é a norma, não a exceção:
- Múltiplos fornecedores com formatos diferentes. Uma empresa que recebe faturas de 30, 50 ou 200 fornecedores não pode manter modelos para cada um. A Visão IA lida com todos os formatos com uma única definição de coluna. Este é o cenário em que os custos de manutenção de modelos passam de gerenciáveis a paralisantes, e onde ferramentas sem treinamento entregam seu valor mais claro.
- Documentos manuscritos. Anotações de campo, recibos de entrega assinados, listas de verificação de inspeção, planilhas de horas manuscritas — a precisão do OCR cai abaixo da usabilidade na maioria dos manuscritos. A Visão IA extrai manuscritos legíveis com níveis de precisão utilizáveis.
- Fotos de celular e capturas do mundo real. Se seus documentos vêm de celulares — fotos de recibos, imagens de quadros brancos, fotos de leituras de medidores — a distorção de perspectiva e a variação de iluminação que quebram o OCR são tratadas naturalmente pelos modelos de visão.
- Tipos de documentos mistos. Um fluxo de trabalho que inclui faturas, pedidos de compra, romaneios e notas de crédito em um único lote não exige quatro configurações de modelo separadas. A Visão IA se adapta a cada documento de forma independente.
- Mudanças frequentes de formato. Se suas fontes de documentos mudam seus layouts regularmente (comum com fornecedores de varejo, fornecedores sazonais ou clientes recém-integrados), a vantagem de zero manutenção da Visão IA domina o cálculo de custo.
O Veredito: Alinhe a Arquitetura ao Seu Mix de Documentos
A decisão entre OCR e Visão IA não é uma escolha de tecnologia — é um cálculo do mix de documentos. Faça a si mesmo três perguntas:
- Quantos formatos de documento diferentes eu processo? Um ou dois → OCR é suficiente. Mais de dez → o peso dos modelos começa a superar a economia por página.
- Com que frequência meus formatos de documento mudam? Nunca → OCR é estável. Várias vezes por ano → a manutenção de modelos se torna um centro de custos oculto.
- Qual é a qualidade dos meus documentos de origem? Apenas PDFs digitais limpos → OCR é preciso. Inclua fotos, digitalizações ou manuscritos → Visão IA é a escolha prática.
Não existe uma única resposta certa para todos os negócios. Uma seguradora de propriedades que processa 80.000 cartas de renovação idênticas anualmente deve manter o OCR. Um distribuidor de alimentos que recebe 3.000 notas fiscais de 200 fornecedores diferentes, cada uma com um layout distinto e qualidade de impressão variável, deve usar Visão IA. O erro é escolher OCR porque é mais barato por página sem considerar o que acontece quando um modelo falha às 17h durante o fechamento de fim de mês.
Perguntas Frequentes
OCR e Visão IA podem ser usados juntos no mesmo fluxo de trabalho?
Sim, e essa abordagem híbrida funciona bem na prática. O OCR cuida da extração em massa em documentos limpos e padronizados, enquanto a Visão IA é reservada para casos extremos: digitalizações de baixa qualidade, manuscritos ou formatos incomuns que o pipeline de OCR não consegue processar de forma confiável. Algumas plataformas de inteligência documental oferecem esse roteamento pronto, enviando os casos fáceis para o OCR rápido e escalando os difíceis para um modelo de visão.
A Visão IA pode alucinar dados como um chatbot?
Qualquer modelo de IA pode produzir saídas incorretas, mas a Visão IA criada para extração lida com isso de forma diferente de um chatbot de propósito geral. As ferramentas de extração restringem o modelo a retornar dados que existem no documento de origem — elas não pedem que ele gere conteúdo novo. Quando um campo solicitado está ausente no documento, a célula fica em branco em vez de ser preenchida com um valor inventado. Dito isso, uma verificação rápida de campos de alto valor é uma boa prática, independentemente da tecnologia usada.
A Visão IA precisa de conexão com a internet para funcionar?
A maioria das ferramentas de extração com Visão IA é baseada em nuvem e exige conexão com a internet para enviar imagens de documentos ao modelo e receber os resultados extraídos. Algumas ferramentas mais recentes oferecem processamento no dispositivo para extração básica, mas a compreensão semântica completa que diferencia a Visão IA do OCR normalmente exige inferência em nuvem. Se o seu fluxo de trabalho opera em um ambiente isolado ou com baixa conectividade, uma solução de OCR local pode ser sua única opção.
Quanto tempo leva para migrar de um sistema de OCR/modelos para a Visão IA?
A migração em si é rápida porque a Visão IA não exige migração de modelos. Você define os nomes das colunas uma vez (os mesmos campos que seu modelo extraía), envia um lote de teste, verifica a saída e já está operacional. A parte que consome tempo não é a ferramenta — é auditar seu inventário de modelos existente para confirmar quais realmente funcionavam e quais vinham produzindo dados incorretos silenciosamente.
Qual volume de documentos torna a Visão IA mais econômica que o OCR?
O ponto de equilíbrio depende da variedade de formatos, não apenas do volume. Para um pipeline de formato único e alto volume (50.000 formulários idênticos), o OCR é mais barato. Para um pipeline de múltiplos formatos (1.000 faturas de 50 fornecedores), a Visão IA costuma ser mais barata quando você considera a configuração de modelos, manutenção e tempo de correção de erros. A regra geral: se você cria mais de 5–10 modelos e mantém pelo menos alguns por ano, o modelo sem manutenção da Visão IA provavelmente economiza dinheiro mesmo em volume moderado.
Envie um documento que você processa regularmente. Defina os nomes das colunas que você precisa. Veja como o Vision AI lida com seu formato real — sem modelo, sem treinamento, sem compromisso.
Teste o Vision AI no Seu Documento