OCR vs Vision IA pour l'extraction de documents
Lequel choisir ?
L'OCR traditionnel lit les documents caractère par caractère — il voit du texte. La Vision IA lit les documents comme le ferait une personne — elle comprend ce que le texte signifie et où il se place. Cette distinction importe plus que toute comparaison de vitesse ou de prix, car elle détermine ce qui casse lorsque vos documents changent et ce qui continue de fonctionner sans que personne ne touche à la configuration.
Points clés à retenir
- L'OCR à 0,01 $/page semble être le choix économique évident — jusqu'à ce que vous preniez en compte les 30 à 40 heures de maintenance de modèles qu'une opération avec 50 fournisseurs consomme silencieusement chaque année.
- Le prix logiciel par page masque trois catégories de coûts qui n'apparaissent jamais sur aucune facture : 1 à 4 heures de configuration de modèle par nouveau format, 15 à 40 heures de maintenance réactive par an pour 50 expéditeurs, et des erreurs silencieuses qui surgissent lors du rapprochement — des semaines après que l'extraction semblait correcte.
- Arrêtez de comparer les prix d'API par page. Le seul chiffre qui compte est le coût total par document — et lorsque vous ajoutez la main-d'œuvre que l'entretien des modèles consomme, l'outil « moins cher » est généralement le plus coûteux.
Comparaison rapide : OCR vs Vision IA
Si vous avez besoin d'un tableau pour décider de continuer à lire, c'est celui-ci. Chaque dimension est expliquée en détail ci-dessous.
| Dimension | OCR traditionnel / Outils à modèles | Vision IA |
|---|---|---|
| Méthode de lecture | Reconnaissance de caractères + modèles de zones | Compréhension sémantique de la page |
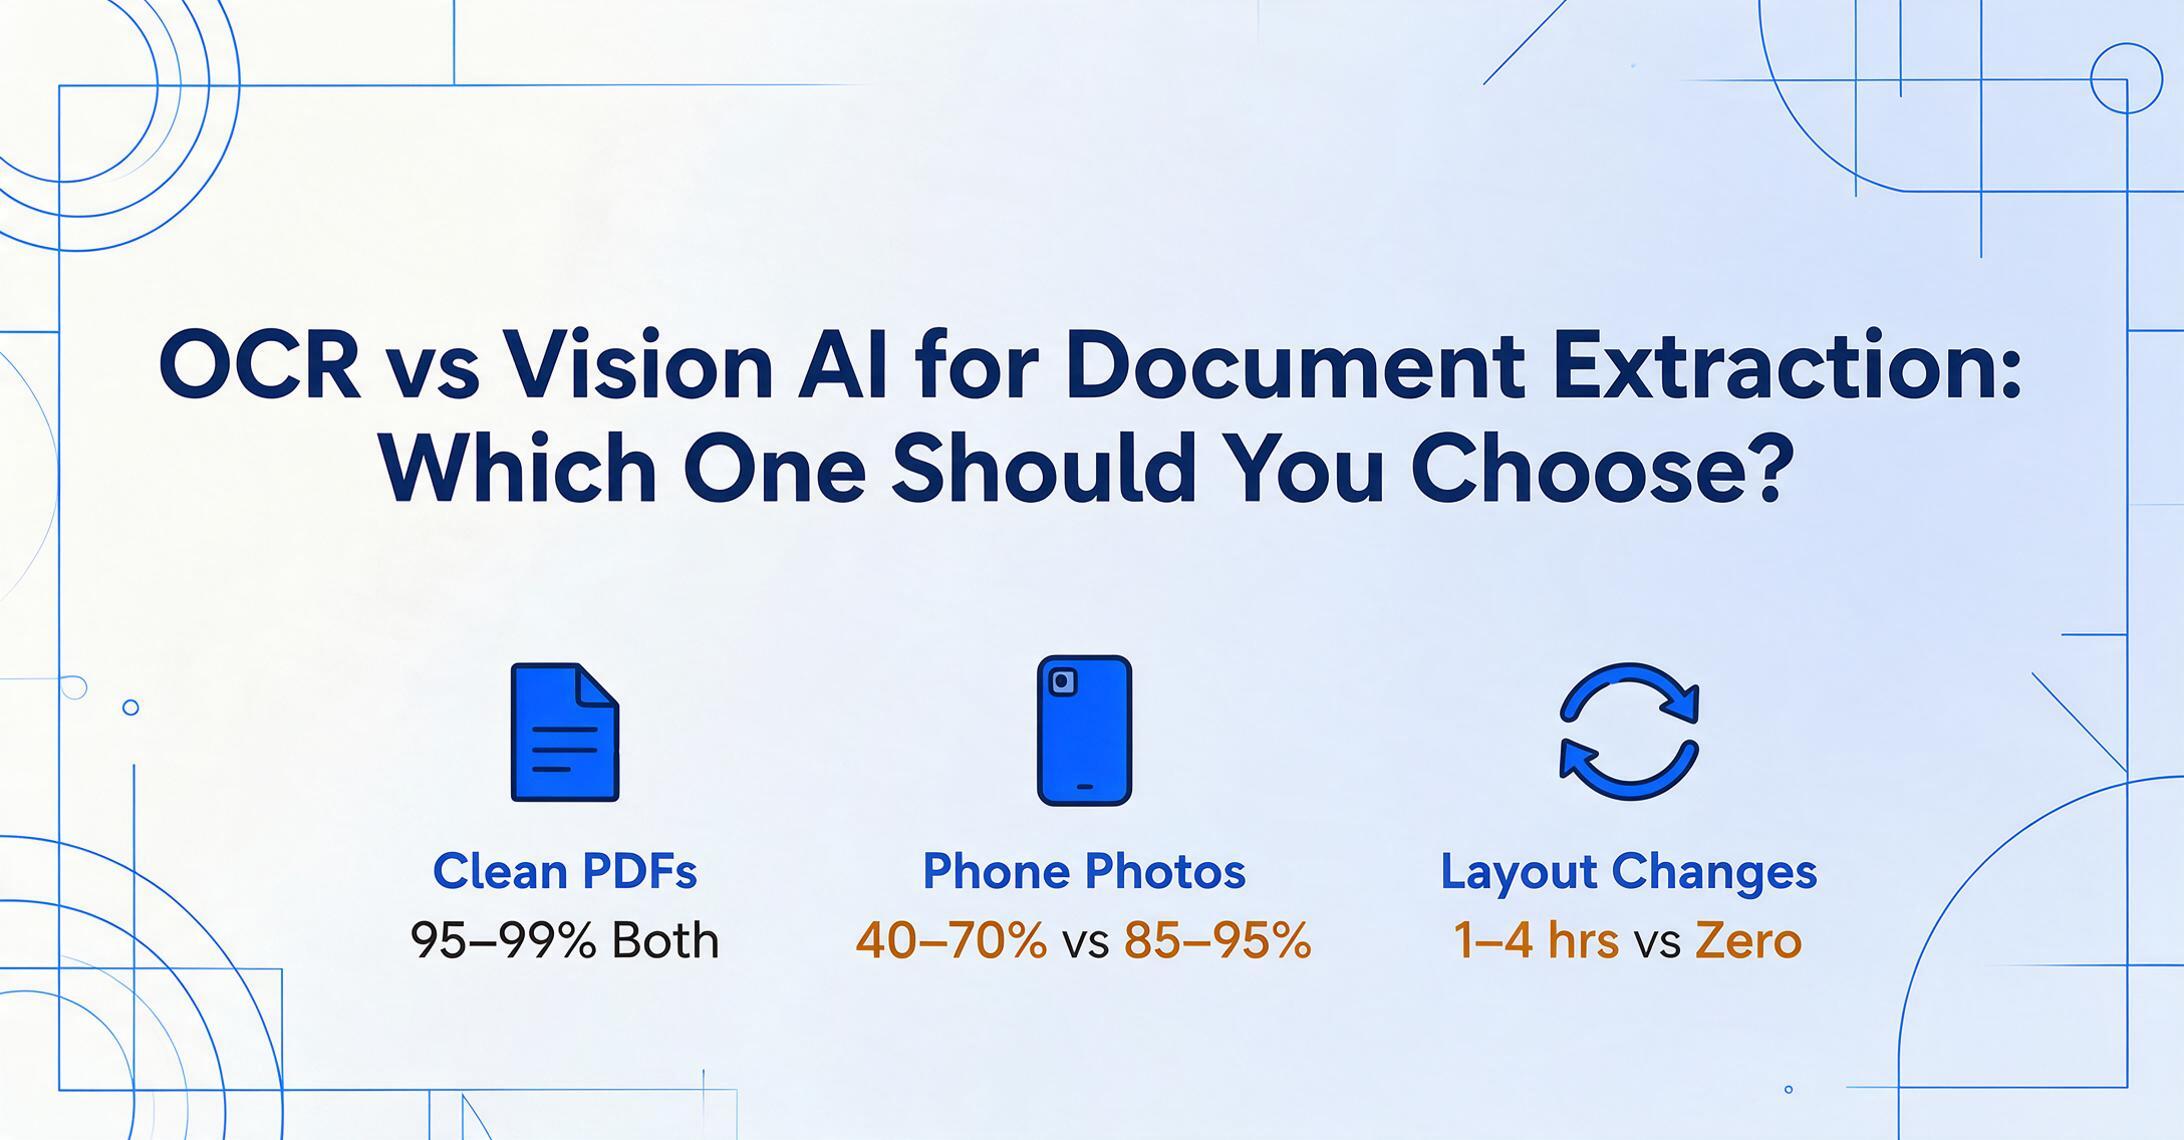
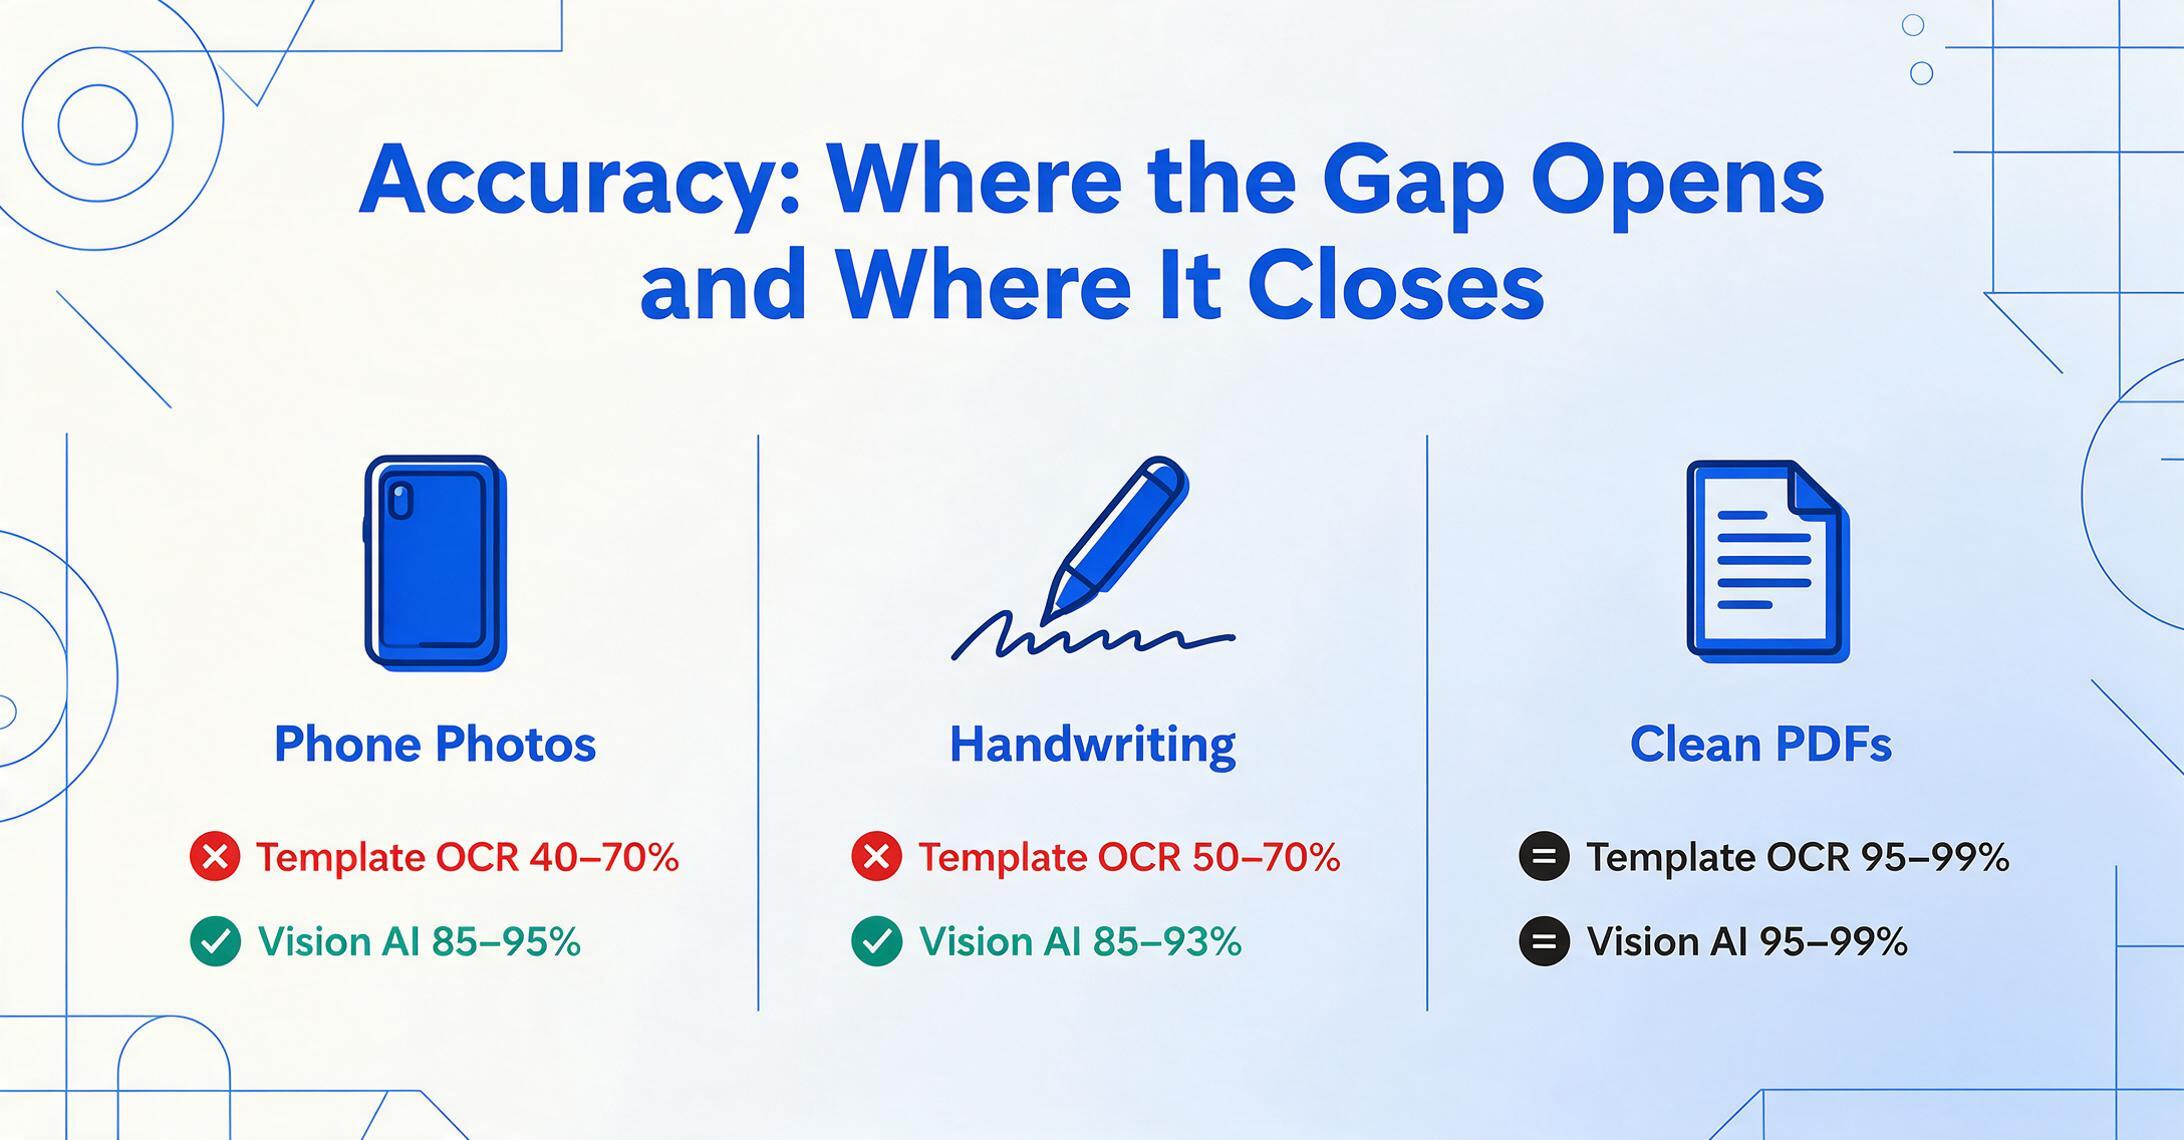
| Précision sur scans propres | 95–99 % | 95–99 % |
| Précision sur photos de téléphone | 40–70 % | 85–95 % |
| Précision sur écriture manuscrite | 50–70 % | 85–93 % |
| Temps de configuration par format | 1 à 4 heures (création de modèle) | 0 — fonctionne dès le premier téléchargement |
| Tolérance aux changements de format | Échoue — le modèle doit être reconstruit | S'adapte automatiquement |
| Coût par page (logiciel uniquement) | Inférieur (0,01–0,03 $/page à grande échelle) | Supérieur (0,02–0,10 $/page) |
| Coûts de maintenance cachés | Importants — maintenance du modèle par expéditeur | Quasi nuls |
Comment ils fonctionnent : pixels vs sens
La reconnaissance optique de caractères (OCR) a été conçue pour résoudre un problème précis : convertir une image de texte en caractères lisibles par machine. Elle identifie chaque forme de lettre pixel par pixel, les assemble en mots et produit un flux de texte organisé selon l'ordre de lecture. Un moteur OCR traditionnel peut vous dire que les caractères « 1 234,56 » apparaissent sur une page, mais il n'a aucune idée de s'il s'agit d'un total de facture, d'une quantité ou d'un numéro de référence. Le résultat est un texte brut qui nécessite encore une interprétation humaine.
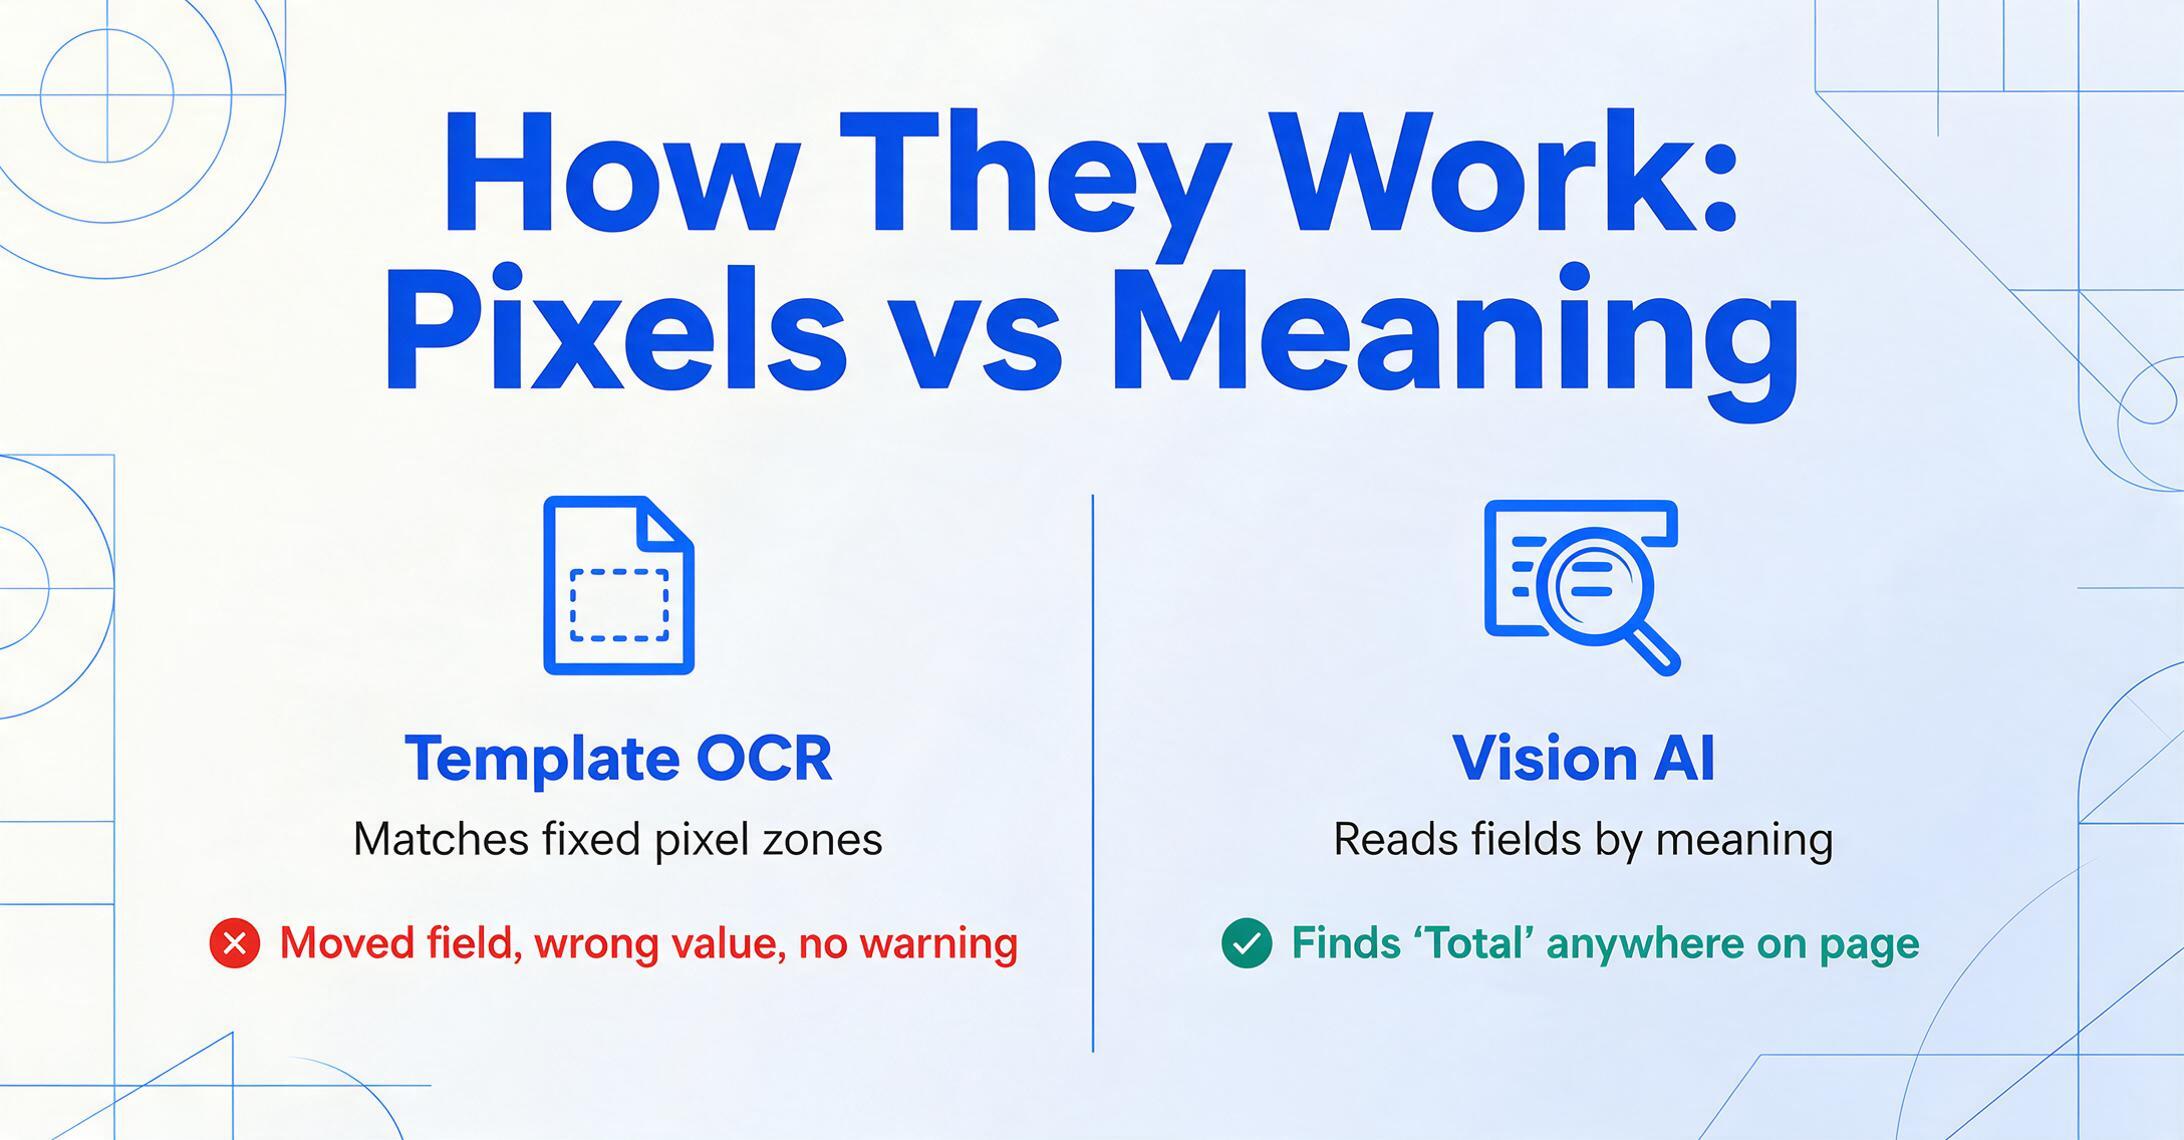
Les outils OCR basés sur des modèles ajoutent une deuxième couche par-dessus la reconnaissance de caractères : vous dessinez des zones autour de chaque champ sur un document type. « Le numéro de facture se trouve aux coordonnées de pixels (50, 120) à (200, 145). » Lorsqu'un nouveau document arrive avec une mise en page identique, le modèle fonctionne. Lorsqu'un fournisseur déplace le champ du numéro de facture — même de deux centimètres — le modèle extrait le texte qui se trouve désormais dans cette zone de coordonnées. Il ne sait pas que c'est faux. Les données arrivent dans votre feuille de calcul en semblant plausibles, et l'erreur apparaît plus tard lorsque quelqu'un rapproche les chiffres.
La Vision IA élimine complètement l'étape des zones. Un modèle de langage visuel traite le document comme une image entière, comprend le rôle de chaque section (en-tête vs tableau vs pied de page) et identifie les champs par leur sens plutôt que par leur position. Vous saisissez les noms de colonnes souhaités — « Numéro de facture », « Date », « Total » — et l'IA localise les valeurs correspondantes n'importe où sur la page en comprenant ce que chaque libellé représente. « N° de facture », « INV# », « Référence de facture » et « Notre réf. : » correspondent tous à la même colonne, car le modèle comprend qu'il s'agit de concepts équivalents dans le contexte d'une facture commerciale.
Pour un aperçu plus approfondi de la façon dont cette approche sémantique élimine entièrement le besoin de modèles, consultez notre explication de l'extraction sans modèle.
Précision : où l'écart se creuse et où il se referme
Sur des documents imprimés propres — pensez à un PDF généré numériquement par un système comptable moderne — les deux approches fonctionnent bien. Les moteurs OCR atteignent une précision de 95 à 99 % sur les caractères, et les modèles de vision égalent ou dépassent légèrement cette plage. Si chaque document que vous traitez est un PDF net et dactylographié avec un formatage cohérent, la précision seule ne guidera pas votre décision.
L'écart apparaît dès que la qualité des documents ou la diversité des mises en page augmente :
- Photos prises au téléphone. Une photo de facture prise sur un bureau présente un éclairage inégal, une distorsion de perspective et souvent des ombres. Les moteurs OCR entraînés sur des scans à plat subissent une baisse significative de précision — les résultats au niveau des champs peuvent chuter à 40–70 %. La Vision IA, entraînée sur des millions de photos réelles, maintient une précision de 85 à 95 % car elle lit de manière contextuelle : même lorsque les caractères individuels sont flous, le modèle déduit la valeur correcte à partir du texte environnant et de la structure du document.
- Écriture manuscrite. Cela reste la plus grande faiblesse de l'OCR traditionnel. La morphologie des caractères manuscrits varie tellement d'un scripteur à l'autre que la correspondance de motifs basée sur des modèles manque ou lit mal 30 à 50 % des caractères. La Vision IA traite l'écriture manuscrite lisible avec une précision de 85 à 93 % — pas parfaite, mais suffisamment utilisable pour que la transcription manuelle ne reste nécessaire que pour les cas les plus difficiles.
- Tableaux complexes. Les tableaux de lignes multi-colonnes avec cellules fusionnées, en-têtes imbriqués et nombres de lignes variables sont l'autre terrain d'échec de l'OCR. L'OCR traditionnel aplatit le contenu du tableau en un flux de texte linéaire — les lignes deviennent des paragraphes, les colonnes fusionnent, et le lecteur doit reconstruire mentalement la grille. La Vision IA préserve la structure du tableau car elle voit la grille comme un objet visuel et extrait les lignes et les colonnes selon leurs relations spatiales et sémantiques.
Tolérance aux changements de format : le coût caché
Un fournisseur redessine la mise en page de ses factures. Un nouveau fournisseur envoie des bons de commande dans un format que vous n'avez jamais vu. Un client change de logiciel comptable et ses avis de paiement ont désormais un aspect complètement différent.
Pour l'OCR basé sur des modèles, chacun de ces événements est un échec. Le modèle a été conçu pour l'ancienne mise en page. La nouvelle ne correspond pas aux coordonnées enregistrées. L'extraction produit silencieusement des données erronées ou manquantes. Quelqu'un doit remarquer le problème, identifier le modèle défectueux et le reconstruire — un processus qui prend généralement de 1 à 4 heures par format selon la complexité du document.
Pour la Vision IA, rien ne se passe — car il n'y a aucun modèle à casser. L'IA lit chaque document de manière indépendante, en se basant sur le sens sémantique. Une facture redessinée contient toujours un numéro de facture, une date et un total. Les noms de colonnes que vous avez définis une fois continuent de fonctionner. Pas de reconstruction de modèle, pas de corruption de données, pas d'intervention manuelle.
L'impact pratique de cette différence est facile à sous-estimer avec 5 fournisseurs, mais difficile à ignorer avec 50. Une équipe financière qui traite les factures de 50 fournisseurs peut constater 15 à 20 changements de mise en page par an sur l'ensemble de ses fournisseurs. À 2 heures par reconstruction de modèle, cela représente 30 à 40 heures de maintenance réactive — une semaine de travail entière consacrée à faire fonctionner un système « automatisé ».
Temps de configuration : des heures par format contre zéro
Un outil d'OCR basé sur des modèles nécessite une configuration avant de pouvoir extraire quoi que ce soit d'utile d'un nouveau type de document. Vous téléchargez un échantillon, dessinez des zones rectangulaires autour de chaque champ (numéro de facture, date, total, lignes d'articles), étiquetez chaque zone et définissez parfois des règles d'analyse pour les tableaux multilignes. Pour une facture standard, cela prend de 1 à 3 heures la première fois. Pour un document complexe comme un avis de paiement ou un contrat multipage, cela peut prendre une demi-journée.
La Vision IA ne nécessite aucune configuration par format. Vous définissez vos noms de colonnes une fois — ils deviennent votre modèle d'extraction — et le modèle lit chaque type de document que vous lui soumettez. Lorsque vous commencez à traiter une nouvelle catégorie de documents (en passant des factures aux bons de commande), vous ne créez pas un nouveau modèle ; vous ajustez simplement votre liste de colonnes. Le modèle fait le reste.
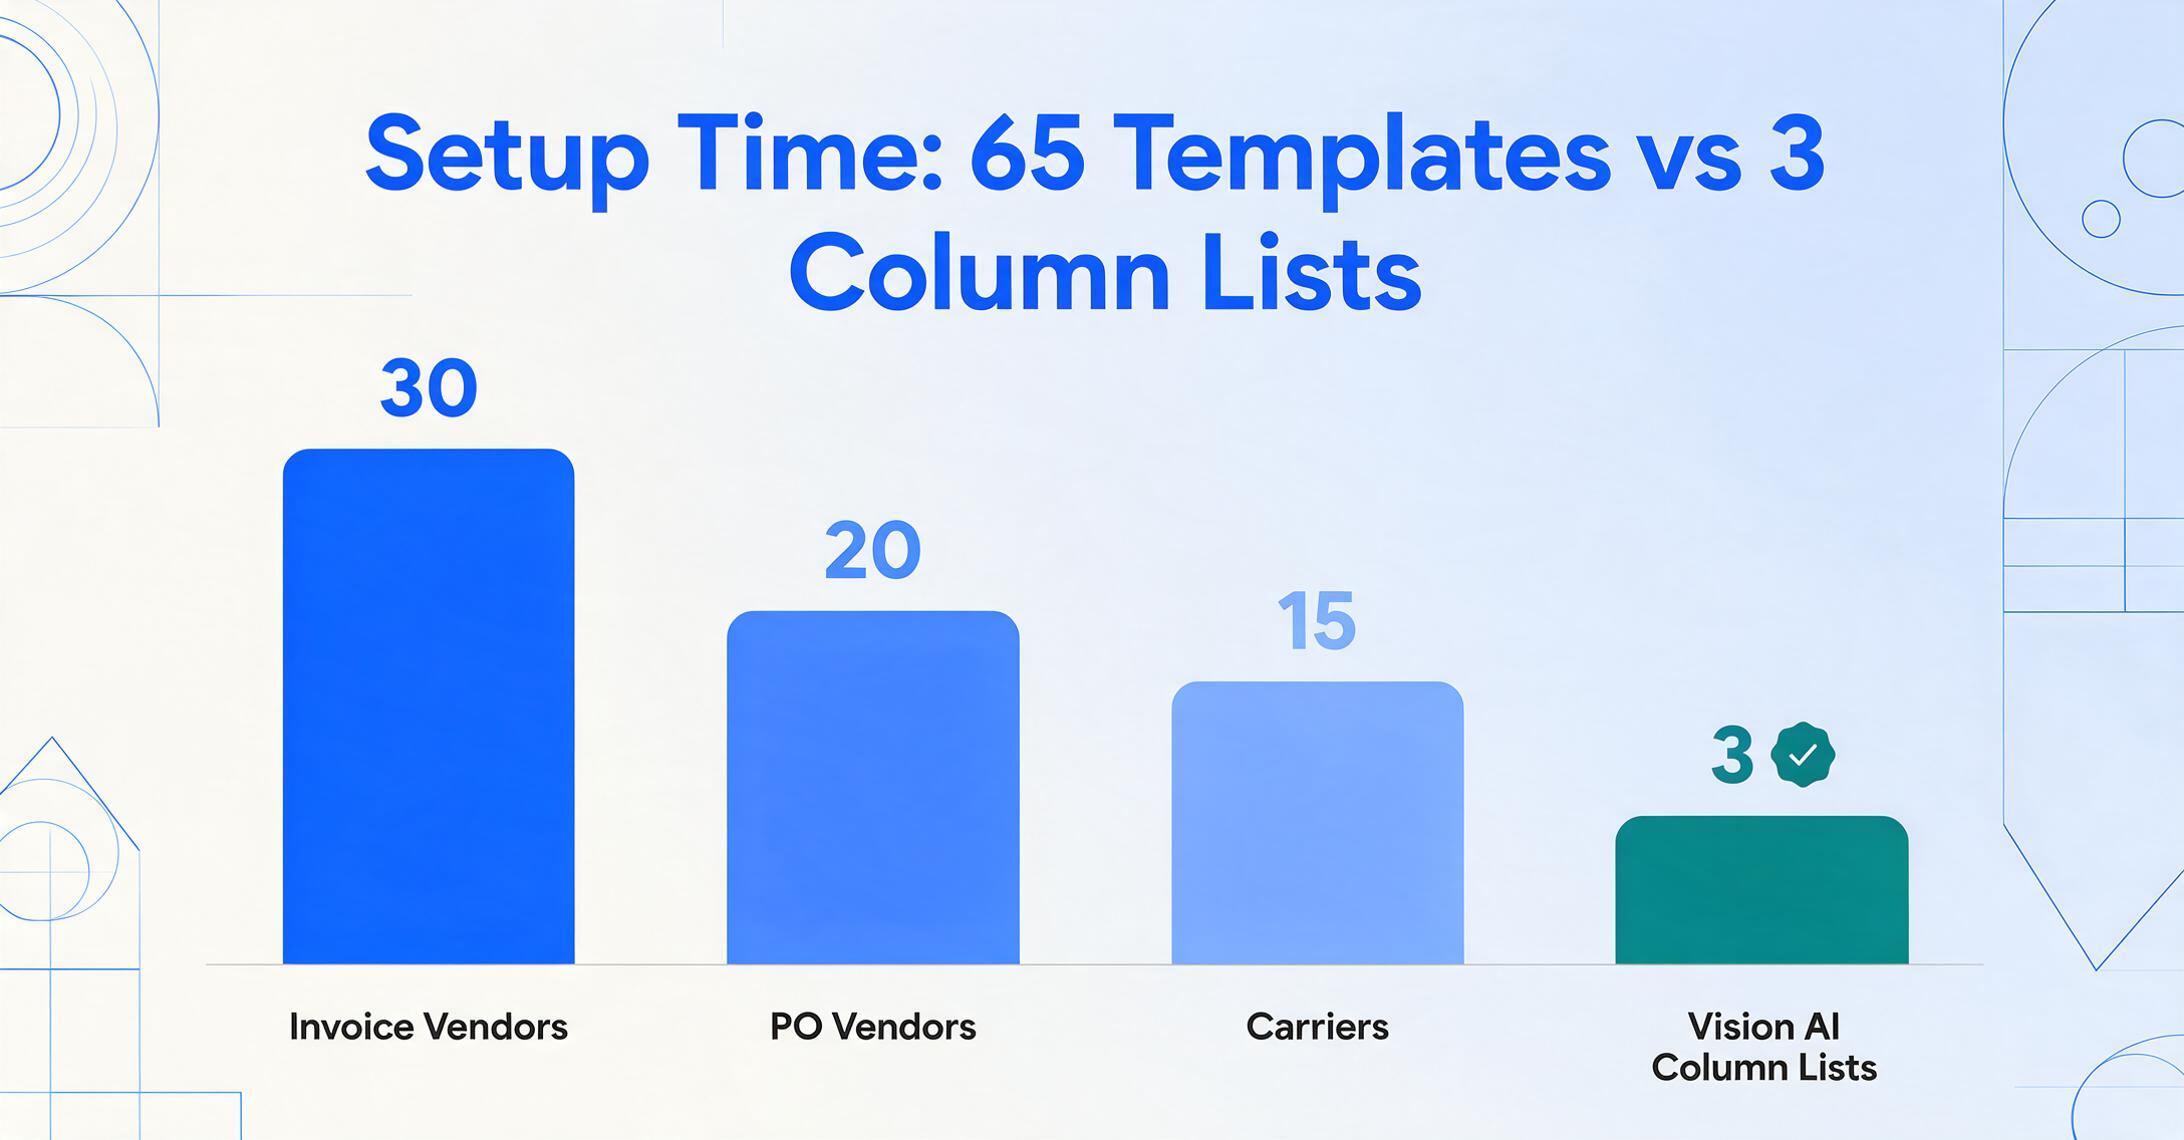
Cette différence s'accentue. Un système basé sur des modèles qui traite les factures de 30 fournisseurs, plus les bons de commande de 20 fournisseurs, plus les bons de livraison de 15 transporteurs, nécessite 65 modèles distincts. Chacun a pris du temps à créer et nécessite une maintenance. Un système de Vision IA traitant la même combinaison de documents utilise une liste de colonnes par type de document — trois listes au lieu de 65 modèles. Pour une comparaison détaillée de la façon dont cela se manifeste selon les outils, consultez notre guide sur l'extraction sans modèle.
Comparaison des coûts : le prix du logiciel ne représente que la moitié de l'histoire
Au niveau logiciel, les outils OCR sont moins chers par page. Un moteur OCR commercial traitant de gros volumes peut coûter 0,01 à 0,03 $ par page. L'extraction par vision IA coûte généralement 0,02 à 0,10 $ par page. En apparence, l'OCR semble être le choix économique.
Le problème de cette comparaison superficielle est qu'elle ignore les coûts de main-d'œuvre qui s'ajoutent au logiciel. Chaque page nécessitant une correction manuelle coûte de l'argent — non pas en frais de logiciel, mais en temps humain. Et chaque modèle qui casse coûte de l'argent en retravail.
| Type de coût | OCR / modèle | Vision IA |
|---|---|---|
| Logiciel (1 000 pages/mois) | 10–30 $ | 20–100 $ |
| Configuration du modèle (par format) | 1 à 4 h × taux horaire de votre équipe | 0 $ |
| Maintenance du modèle (annuelle) | 15 à 40 h pour 50 expéditeurs | 0 $ |
| Correction des erreurs (documents variables) | 5 à 15 min par document avec problèmes | 1 à 3 min pour une vérification ponctuelle |
Le seuil de rentabilité varie selon votre combinaison de documents. Si vous traitez 10 000 formulaires W-2 identiques par mois, les économies par page de l'OCR dominent et l'absence de variation de format signifie que les modèles ne cassent jamais. Si vous traitez 1 000 factures provenant de 100 fournisseurs différents avec des mises en page variées, les économies de la vision IA grâce à l'élimination de la maintenance des modèles et à la réduction des corrections d'erreurs couvrent plusieurs fois le coût par page plus élevé. Pour une analyse complète de la comparaison entre la tarification par page et par abonnement sur le marché, consultez notre analyse des prix.
Quand l'OCR basé sur des modèles est plus pertinent
L'OCR basé sur des modèles n'est pas obsolète. Il reste le bon choix dans plusieurs scénarios :
- Formulaires identiques à volume élevé. Si vous traitez 50 000 formulaires W-2, 20 000 demandes de prêt standardisées ou 100 000 factures de services publics — toutes provenant de la même source avec une mise en page fixe — l'avantage du coût par page de l'OCR à grande échelle est réel. Le coût de configuration du modèle est un investissement ponctuel amorti sur des millions de pages.
- PDF numériques propres uniquement. Si votre pipeline de documents se compose exclusivement de PDF générés numériquement avec texte intégré (pas de scans, pas de photos, pas d'écriture manuscrite), la précision de l'OCR est excellente et la charge de maintenance est faible.
- Sensible aux coûts à très grande échelle. À des volumes mensuels supérieurs à 50 000 pages, la différence entre $0,01/page et $0,05/page devient des milliers de dollars. Si vos documents sont uniformes et que votre format ne change jamais, le coût par page inférieur est le bon choix mathématique.
- Exigences de sortie déterministes. L'OCR produit la même sortie à chaque fois pour la même entrée. Certains environnements réglementés préfèrent cette prédictibilité même si la précision est légèrement inférieure, car le comportement est cohérent et auditable.
Quand la Vision IA est plus pertinente
La Vision IA l'emporte dans la majorité des scénarios où la variété des documents est la norme plutôt que l'exception :
- Plusieurs fournisseurs avec des formats différents. Une entreprise qui reçoit des factures de 30, 50 ou 200 fournisseurs ne peut pas maintenir des modèles pour chacun. La Vision IA gère tous les formats avec une seule définition de colonne. C'est le scénario où les coûts de maintenance des modèles passent de gérables à paralysants, et où les outils sans formation apportent leur valeur la plus claire.
- Documents manuscrits. Notes de terrain, reçus de livraison signés, listes de contrôle d'inspection, feuilles de temps manuscrites — la précision de l'OCR tombe sous le seuil d'utilisabilité sur la plupart des écritures manuscrites. La Vision IA extrait l'écriture manuscrite lisible à des niveaux de précision utilisables.
- Photos de téléphone et captures du monde réel. Si vos documents proviennent de téléphones mobiles — photos de reçus, photos de tableaux blancs, instantanés de relevés de compteurs — la distorsion de perspective et les variations d'éclairage qui cassent l'OCR sont gérées naturellement par les modèles de vision.
- Types de documents mixtes. Un flux de travail qui inclut des factures, des bons de commande, des bordereaux d'expédition et des avoirs dans un seul lot ne nécessite pas quatre configurations de modèles distinctes. La Vision IA s'adapte à chaque document indépendamment.
- Changements de format fréquents. Si vos sources de documents modifient régulièrement leurs mises en page (courant chez les fournisseurs de détail, les vendeurs saisonniers ou les clients récemment intégrés), l'avantage de zéro maintenance de la Vision IA domine le calcul des coûts.
Le verdict : adaptez l'architecture à votre mix de documents
Le choix entre OCR et Vision IA n'est pas une question de technologie — c'est un calcul basé sur votre mix de documents. Posez-vous trois questions :
- Combien de formats de documents différents traitez-vous ? Un ou deux → l'OCR suffit. Plus de dix → la charge liée aux modèles commence à dépasser les économies par page.
- À quelle fréquence vos formats de documents changent-ils ? Jamais → l'OCR est stable. Plusieurs fois par an → la maintenance des modèles devient un coût caché.
- Quelle est la qualité de vos documents sources ? Uniquement des PDF numériques propres → l'OCR est précis. Avec des photos, des scans ou de l'écriture manuscrite → la Vision IA est le choix pratique.
Il n'existe pas de réponse unique pour toutes les entreprises. Un assureur traitant 80 000 lettres de renouvellement identiques par an devrait rester sur l'OCR. Un distributeur alimentaire recevant 3 000 factures de 200 fournisseurs différents, chacune avec une mise en page et une qualité d'impression variables, devrait utiliser la Vision IA. L'erreur est de choisir l'OCR parce qu'il est moins cher par page sans tenir compte de ce qui se passe quand un modèle casse à 17 h lors d'une clôture de fin de mois.
Questions fréquentes
L'OCR et la Vision IA peuvent-ils être utilisés ensemble dans le même flux de travail ?
Oui, et cette approche hybride fonctionne bien en pratique. L'OCR gère l'extraction en masse sur des documents propres et standardisés, tandis que la Vision IA est réservée aux cas limites : scans de mauvaise qualité, écriture manuscrite ou formats inhabituels que le pipeline OCR ne peut pas analyser de manière fiable. Certaines plateformes d'intelligence documentaire proposent ce routage prêt à l'emploi, envoyant les cas simples à l'OCR rapide et escaladant les cas difficiles vers un modèle de vision.
La Vision IA peut-elle halluciner des données comme le ferait un chatbot ?
Tout modèle d'IA peut produire des résultats incorrects, mais la Vision IA conçue pour l'extraction gère cela différemment d'un chatbot généraliste. Les outils d'extraction contraignent le modèle à renvoyer des données qui existent dans le document source — ils ne lui demandent pas de générer du nouveau contenu. Lorsqu'un champ demandé est absent du document, la cellule reste vide plutôt que d'être remplie avec une valeur inventée. Cela dit, une vérification rapide des champs à forte valeur reste une bonne pratique, quelle que soit la technologie utilisée.
La Vision IA a-t-elle besoin d'une connexion Internet pour fonctionner ?
La plupart des outils d'extraction par Vision IA sont basés sur le cloud et nécessitent une connexion Internet pour envoyer les images de documents au modèle et recevoir les résultats extraits. Certains outils plus récents proposent un traitement sur l'appareil pour l'extraction de base, mais la compréhension sémantique complète qui distingue la Vision IA de l'OCR nécessite généralement une inférence cloud. Si votre flux de travail opère dans un environnement isolé ou à faible connectivité, une solution OCR sur site peut être votre seule option.
Combien de temps faut-il pour passer d'un système OCR/modèle à la Vision IA ?
La transition elle-même est rapide car la Vision IA ne nécessite pas de migration de modèles. Vous définissez une fois vos noms de colonnes (les mêmes champs que votre modèle extrayait), téléchargez un lot de test, vérifiez la sortie, et vous êtes opérationnel. La partie chronophage n'est pas l'outil — c'est l'audit de votre inventaire de modèles existant pour confirmer lesquels fonctionnaient réellement et lesquels produisaient silencieusement des données incorrectes.
Quel volume de documents rend la Vision IA rentable par rapport à l'OCR ?
Le seuil de rentabilité dépend de la variété des formats, pas seulement du volume. Pour un pipeline mono-format à volume élevé (50 000 formulaires identiques), l'OCR est moins cher. Pour un pipeline multi-formats (1 000 factures de 50 fournisseurs), la Vision IA est généralement moins chère une fois que l'on prend en compte la configuration des modèles, la maintenance et le temps de correction des erreurs. La règle générale : si vous créez plus de 5 à 10 modèles et en maintenez au moins quelques-uns par an, le modèle sans maintenance de la Vision IA vous fera probablement économiser de l'argent même à volume modéré.
Téléchargez un document que vous traitez régulièrement. Définissez les noms de colonnes dont vous avez besoin. Découvrez comment Vision IA gère votre format réel — sans modèle, sans formation, sans engagement.
Essayez Vision IA sur votre document