OCR vs. Vision-AI für die Dokumentextraktion
Welche sollten Sie wählen?
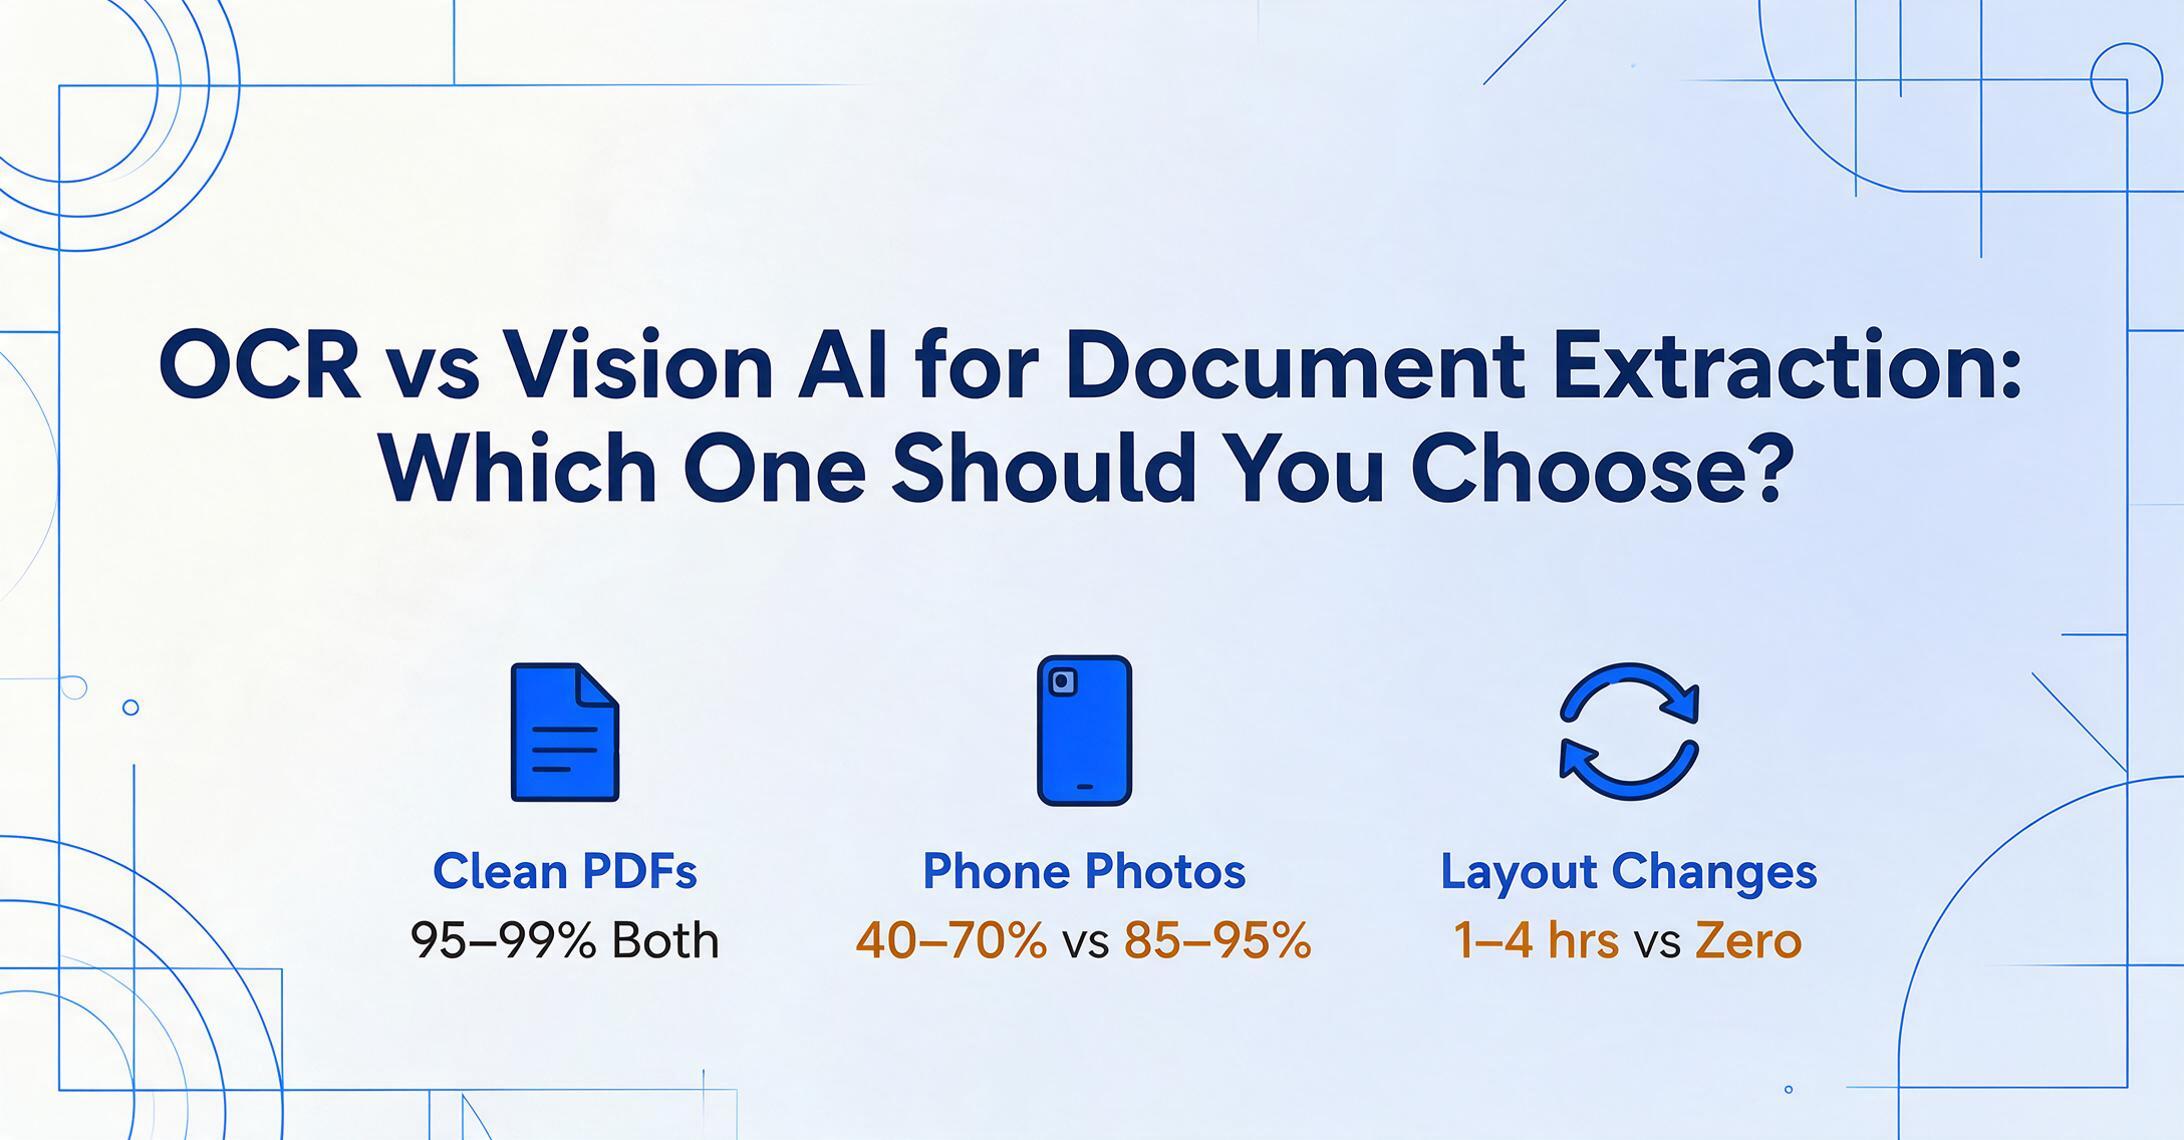
Traditionelles OCR liest Dokumente Zeichen für Zeichen – es sieht Text. Vision-AI liest Dokumente so, wie ein Mensch es tut – es versteht, was der Text bedeutet und wohin er gehört. Dieser Unterschied ist wichtiger als jeder Geschwindigkeits- oder Preisvergleich, denn er bestimmt, was kaputtgeht, wenn sich Ihre Dokumente ändern, und was weiterhin funktioniert, ohne dass jemand das Setup anfasst.
Wichtigste Erkenntnisse
- OCR für 0,01 $/Seite wirkt wie die offensichtlich günstige Wahl – bis Sie die 30–40 Stunden Vorlagenwartung einrechnen, die ein Betrieb mit 50 Lieferanten jedes Jahr stillschweigend verbraucht.
- Der Softwarepreis pro Seite versteckt drei Kostenblöcke, die auf keiner Rechnung erscheinen: 1–4 Stunden Vorlageneinrichtung pro neuem Format, 15–40 Stunden reaktive Wartung pro Jahr pro 50 Absender und stille Fehler, die erst beim Abgleich auftauchen – Wochen, nachdem die Extraktion in Ordnung aussah.
- Hören Sie auf, API-Preise pro Seite zu vergleichen. Die einzige Zahl, die zählt, sind die Gesamtkosten pro Dokument – und wenn Sie die Arbeit hinzurechnen, die die Vorlagenpflege verschlingt, ist das „günstigere“ Tool meist das teurere.
Schnellvergleich: OCR vs. Vision-AI
Wenn Sie eine Tabelle brauchen, um zu entscheiden, ob Sie weiterlesen sollten, dann ist dies die richtige. Jede Dimension wird unten im Detail erklärt.
| Dimension | Traditionelles OCR / Template-Tools | Vision-AI |
|---|---|---|
| Wie es liest | Zeichenerkennung + Zonen-Templates | Semantisches Seitenverständnis |
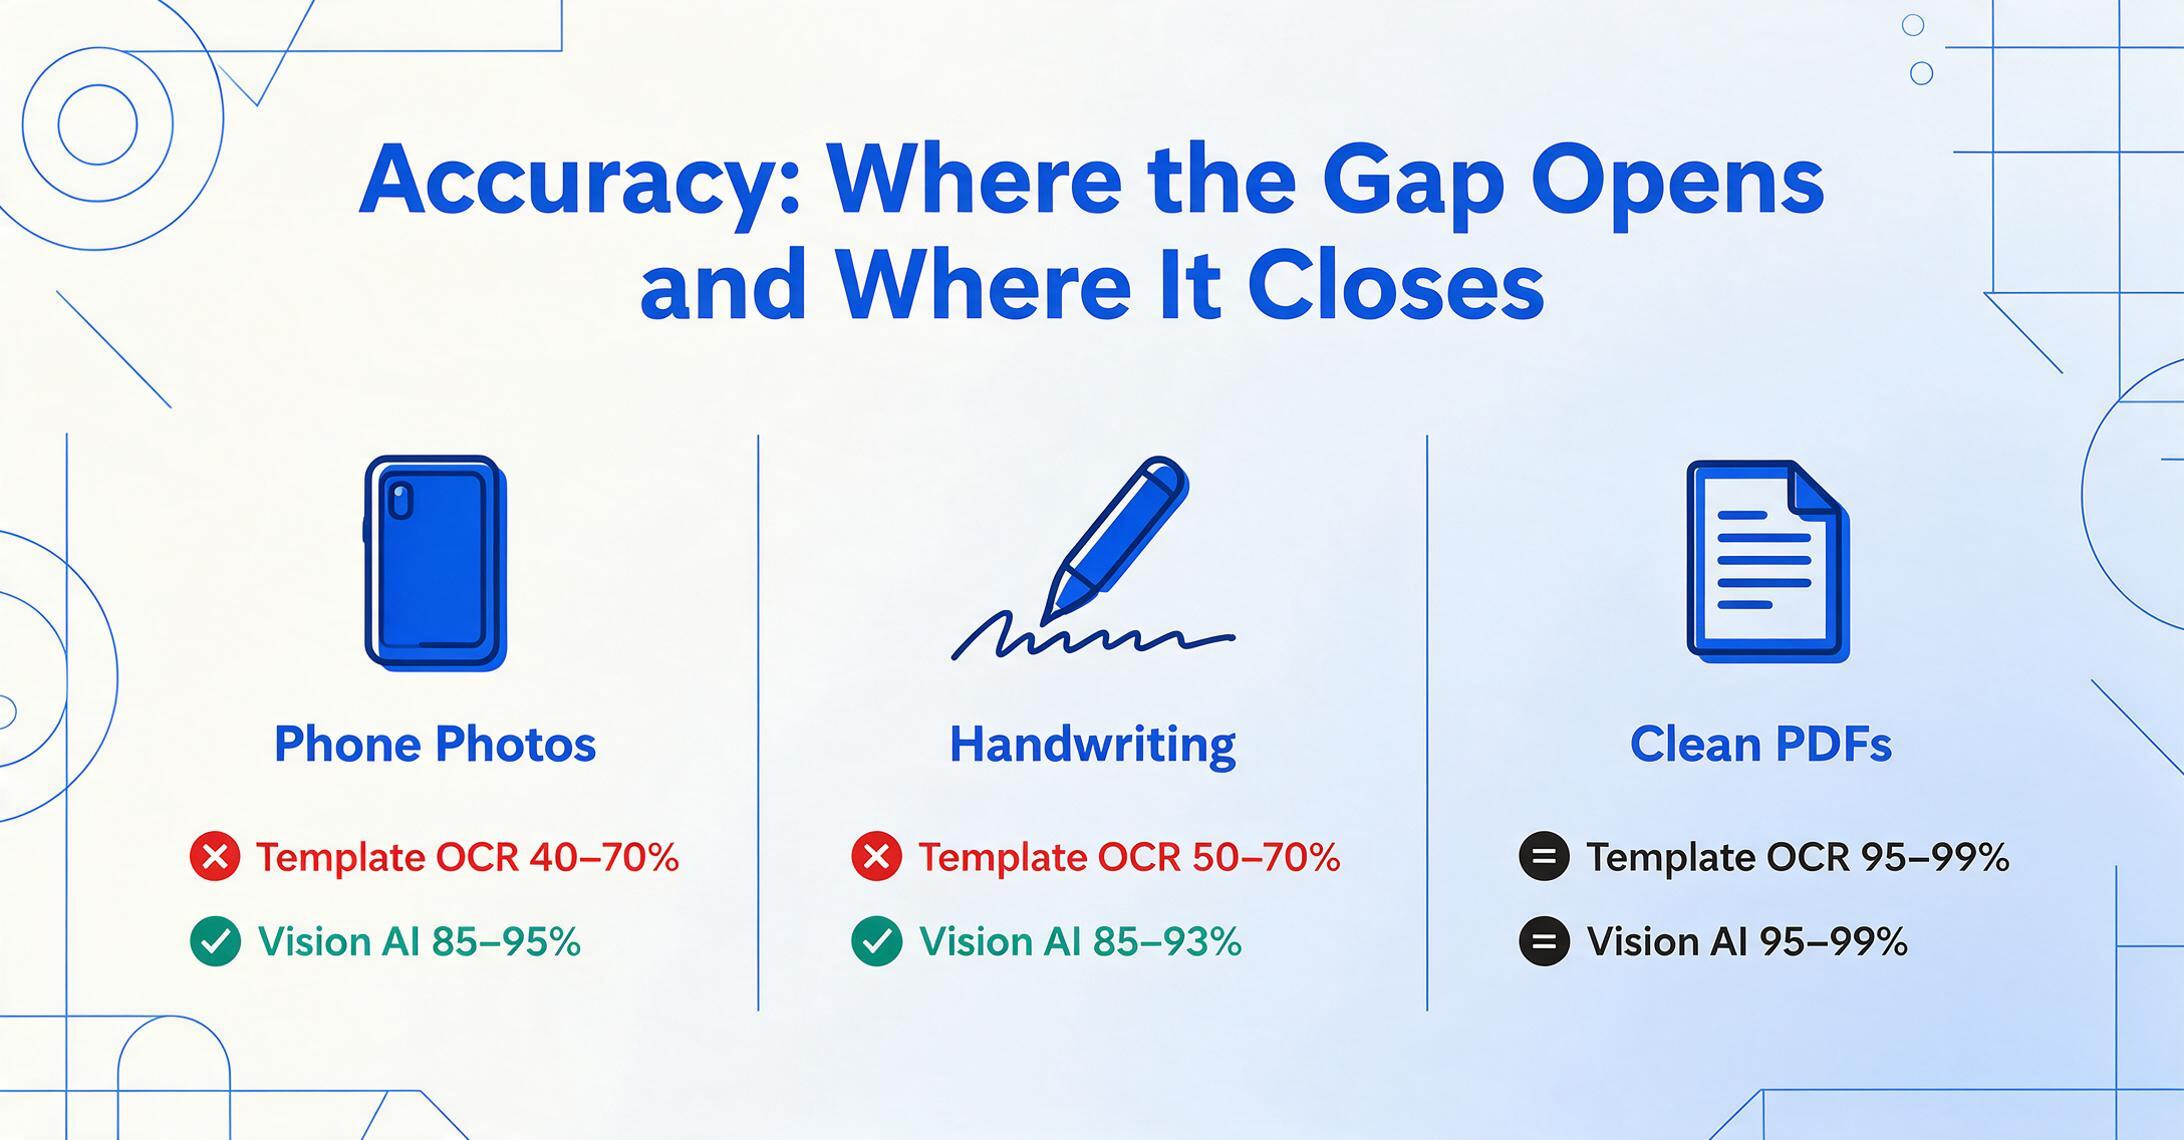
| Genauigkeit bei sauberen Scans | 95–99 % | 95–99 % |
| Genauigkeit bei Handyfotos | 40–70 % | 85–95 % |
| Genauigkeit bei Handschrift | 50–70 % | 85–93 % |
| Einrichtungszeit pro Format | 1–4 Stunden (Template-Erstellung) | 0 – funktioniert beim ersten Upload |
| Formatänderungstoleranz | Bricht – Template muss neu erstellt werden | Passt sich automatisch an |
| Kosten pro Seite (nur Software) | Niedriger ($0,01–0,03/Seite bei Skalierung) | Höher ($0,02–0,10/Seite) |
| Versteckte Wartungskosten | Erheblich – Template-Pflege pro Absender | Nahezu null |
So funktionieren sie: Pixel vs. Bedeutung
Optical Character Recognition wurde entwickelt, um ein enges Problem zu lösen: ein Textbild in maschinenlesbare Zeichen umzuwandeln. Es erkennt einzelne Buchstabenformen Pixel für Pixel, setzt sie zu Wörtern zusammen und gibt einen Textstrom aus, der nach Lesereihenfolge organisiert ist. Eine herkömmliche OCR-Engine kann Ihnen sagen, dass die Zeichen „1.234,56" auf einer Seite erscheinen, aber sie hat keine Ahnung, ob es sich um eine Rechnungssumme, eine Menge oder eine Referenznummer handelt. Die Ausgabe ist Rohtext, der noch der menschlichen Interpretation bedarf.
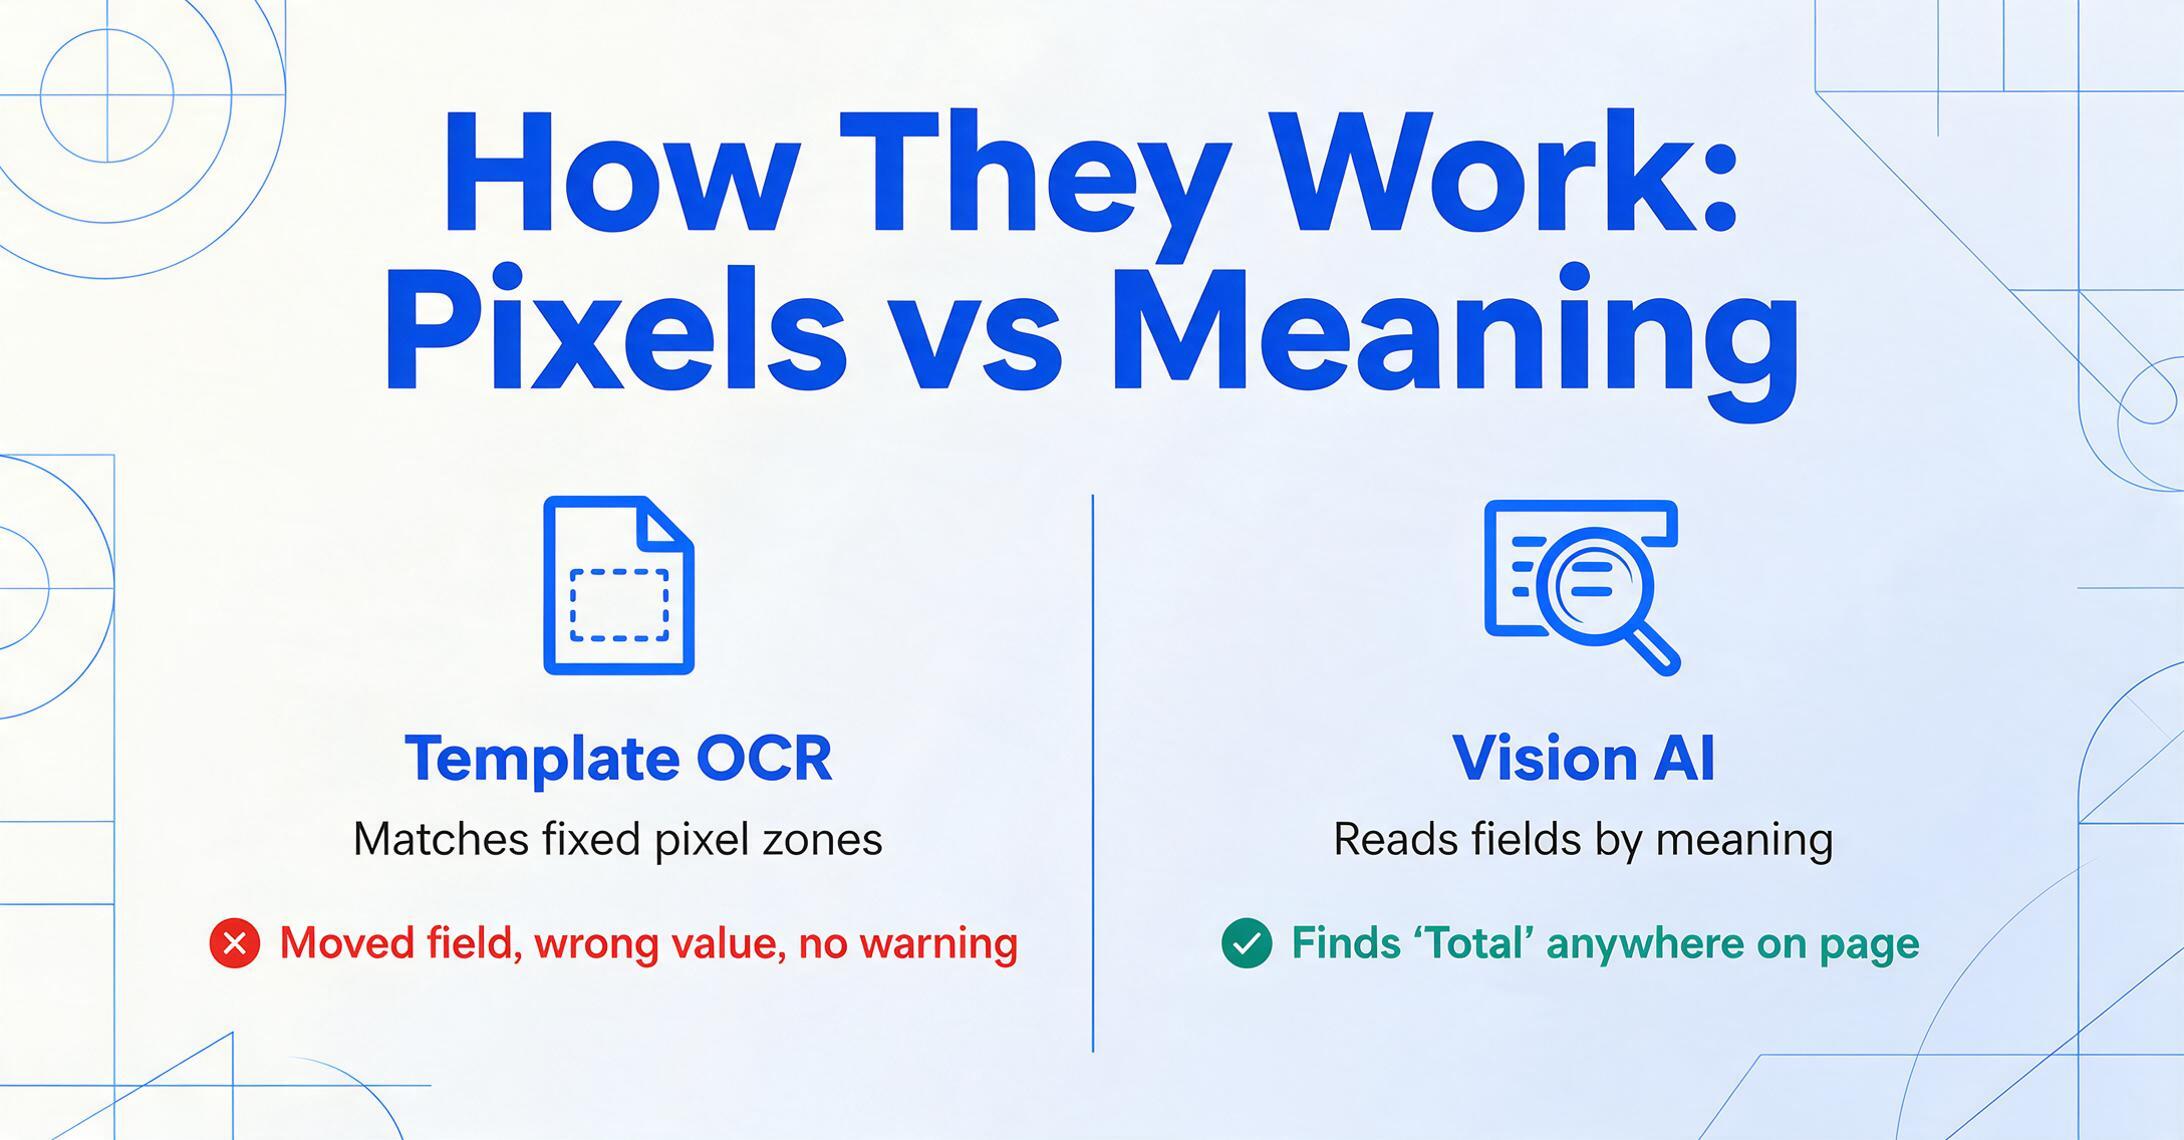
Template-basiertes OCR fügt der Zeichenerkennung eine zweite Ebene hinzu: Sie zeichnen Zonen um jedes Feld auf einem Beispieldokument. „Die Rechnungsnummer befindet sich bei den Pixelkoordinaten (50, 120) bis (200, 145)." Wenn ein neues Dokument mit identischem Layout eintrifft, funktioniert die Vorlage. Wenn ein Anbieter das Rechnungsnummernfeld verschiebt – selbst um zwei Zentimeter – extrahiert die Vorlage den Text, der sich nun in dieser Koordinatenzone befindet. Sie weiß nicht, dass er falsch ist. Die Daten gelangen plausibel aussehend in Ihre Tabelle, und der Fehler tritt erst später zutage, wenn jemand die Zahlen abgleicht.
Vision-AI eliminiert den Zonenschritt vollständig. Ein Vision-Sprachmodell verarbeitet das Dokument als Ganzes, versteht die Rolle jedes Abschnitts (Kopfzeile vs. Tabelle vs. Fußzeile) und identifiziert Felder nach Bedeutung statt nach Position. Sie geben die gewünschten Spaltennamen ein – „Rechnungsnummer", „Datum", „Gesamtsumme" – und die KI findet passende Werte überall auf der Seite, indem sie versteht, was jedes Label repräsentiert. „Rechnungs-Nr.", „RG-Nr.", „Bill Reference" und „Unser Zeichen:" werden derselben Spalte zugeordnet, weil das Modell versteht, dass es sich im Kontext einer Handelsrechnung um gleichwertige Konzepte handelt.
Für einen tieferen Einblick, wie dieser semantische Ansatz Vorlagen vollständig überflüssig macht, siehe unsere Erläuterung zur Extraktion ohne Vorlage.
Genauigkeit: Wo die Lücke entsteht und wo sie sich schließt
Bei sauberen gedruckten Dokumenten – denken Sie an ein digital erzeugtes PDF aus einem modernen Buchhaltungssystem – schneiden beide Ansätze gut ab. OCR-Engines erreichen eine Zeichengenauigkeit von 95–99 %, und Vision-Modelle erreichen diesen Bereich oder übertreffen ihn leicht. Wenn jedes Dokument, das Sie verarbeiten, ein gestochen scharfes, getipptes PDF mit konsistentem Format ist, wird die Genauigkeit allein Ihre Entscheidung nicht bestimmen.
Die Lücke entsteht, sobald die Dokumentqualität oder die Layoutvielfalt zunimmt:
- Handyfotos. Ein Foto einer Rechnung, das an einem Schreibtisch aufgenommen wurde, weist ungleichmäßige Beleuchtung, perspektivische Verzerrung und oft Schatten auf. OCR-Engines, die mit Flachbettscans trainiert wurden, erleben einen erheblichen Genauigkeitsabfall – die Ergebnisse auf Feldebene können auf 40–70 % sinken. Vision-AI, trainiert mit Millionen von realen Fotos, hält eine Genauigkeit von 85–95 % aufrecht, weil sie kontextuell liest: Selbst wenn einzelne Zeichen unscharf sind, leitet das Modell den korrekten Wert aus dem umgebenden Text und der Dokumentstruktur ab.
- Handschrift. Dies bleibt die größte Schwachstelle der traditionellen OCR. Die Morphologie handgeschriebener Zeichen variiert so stark zwischen den Schreibern, dass Template-basiertes OCR routinemäßig 30–50 % der Zeichen verfehlt oder falsch liest. Vision-AI verarbeitet lesbare Handschrift mit einer Genauigkeit von 85–93 % – nicht perfekt, aber brauchbar genug, sodass eine manuelle Transkription nur noch in den schwierigsten Fällen notwendig ist.
- Komplexe Tabellen. Mehrspaltige Positionslistentabellen mit zusammengeführten Zellen, verschachtelten Kopfzeilen und variierenden Zeilenzahlen sind das andere Schwachgebiet der OCR. Traditionelle OCR flacht Tabelleninhalte in einen linearen Textstrom ab – Zeilen werden zu Absätzen, Spalten verschmelzen, und der Leser muss das Raster gedanklich rekonstruieren. Vision-AI erhält die Tabellenstruktur, weil sie das Raster als visuelles Objekt sieht und Zeilen und Spalten anhand ihrer räumlichen und semantischen Beziehungen extrahiert.
Formatänderungstoleranz: Der versteckte Kostenfaktor
Ein Anbieter gestaltet sein Rechnungslayout neu. Ein neuer Lieferant sendet Bestellungen in einem Format, das Sie noch nie gesehen haben. Ein Kunde wechselt die Buchhaltungssoftware, und seine Zahlungsavis sehen jetzt völlig anders aus.
Für Template-basiertes OCR ist jedes dieser Ereignisse ein Fehlschlag. Das Template wurde für das alte Layout erstellt. Das neue Layout entspricht nicht den gespeicherten Koordinaten. Die Extraktion erzeugt stillschweigend falsche oder fehlende Daten. Jemand muss das Problem bemerken, herausfinden, welches Template defekt ist, und es neu aufbauen – ein Prozess, der je nach Dokumentkomplexität typischerweise 1 bis 4 Stunden pro Format dauert.
Für Vision-AI passiert nichts – weil es keine Templates gibt, die brechen könnten. Die KI liest jedes Dokument unabhängig anhand der semantischen Bedeutung. Eine neu gestaltete Rechnung hat immer noch eine Rechnungsnummer, ein Datum und eine Summe. Die Spaltennamen, die Sie einmal definiert haben, funktionieren weiterhin. Kein Template-Neuaufbau, keine Datenkorruption, kein manueller Eingriff.
Die praktische Auswirkung dieses Unterschieds ist leicht zu unterschätzen, wenn Sie 5 Lieferanten haben, und schwer zu ignorieren, wenn Sie 50 haben. Ein Finanzteam, das Rechnungen von 50 Lieferanten verarbeitet, könnte 15–20 Layoutänderungen pro Jahr über seine Lieferantenbasis hinweg sehen. Bei 2 Stunden pro Template-Neuaufbau sind das 30–40 Stunden reaktive Wartung – eine ganze Arbeitswoche, die damit verbracht wird, ein „automatisiertes" System am Laufen zu halten.
Einrichtungszeit: Stunden pro Format vs. Null
Ein Template-basiertes OCR-Tool erfordert einen Einrichtungsprozess, bevor es nützliche Daten aus einem neuen Dokumenttyp extrahieren kann. Sie laden eine Stichprobe hoch, zeichnen rechteckige Zonen um jedes Feld (Rechnungsnummer, Datum, Summe, Positionszeilen), beschriften jede Zone und definieren manchmal Parsing-Regeln für mehrzeilige Tabellen. Bei einer Standardrechnung dauert dies beim ersten Mal 1 bis 3 Stunden. Bei einem komplexen Dokument wie einem Zahlungsavis oder einem mehrseitigen Vertrag kann es einen halben Tag dauern.
Vision-AI erfordert null Einrichtung pro Format. Sie definieren Ihre Spaltennamen einmal – sie werden zu Ihrer Extraktionsvorlage – und das Modell liest jeden Dokumenttyp, den Sie ihm vorlegen. Wenn Sie eine neue Dokumentkategorie verarbeiten (z. B. von Rechnungen zu Bestellungen wechseln), erstellen Sie kein neues Template; Sie passen einfach Ihre Spaltenliste an. Das Modell erledigt den Rest.
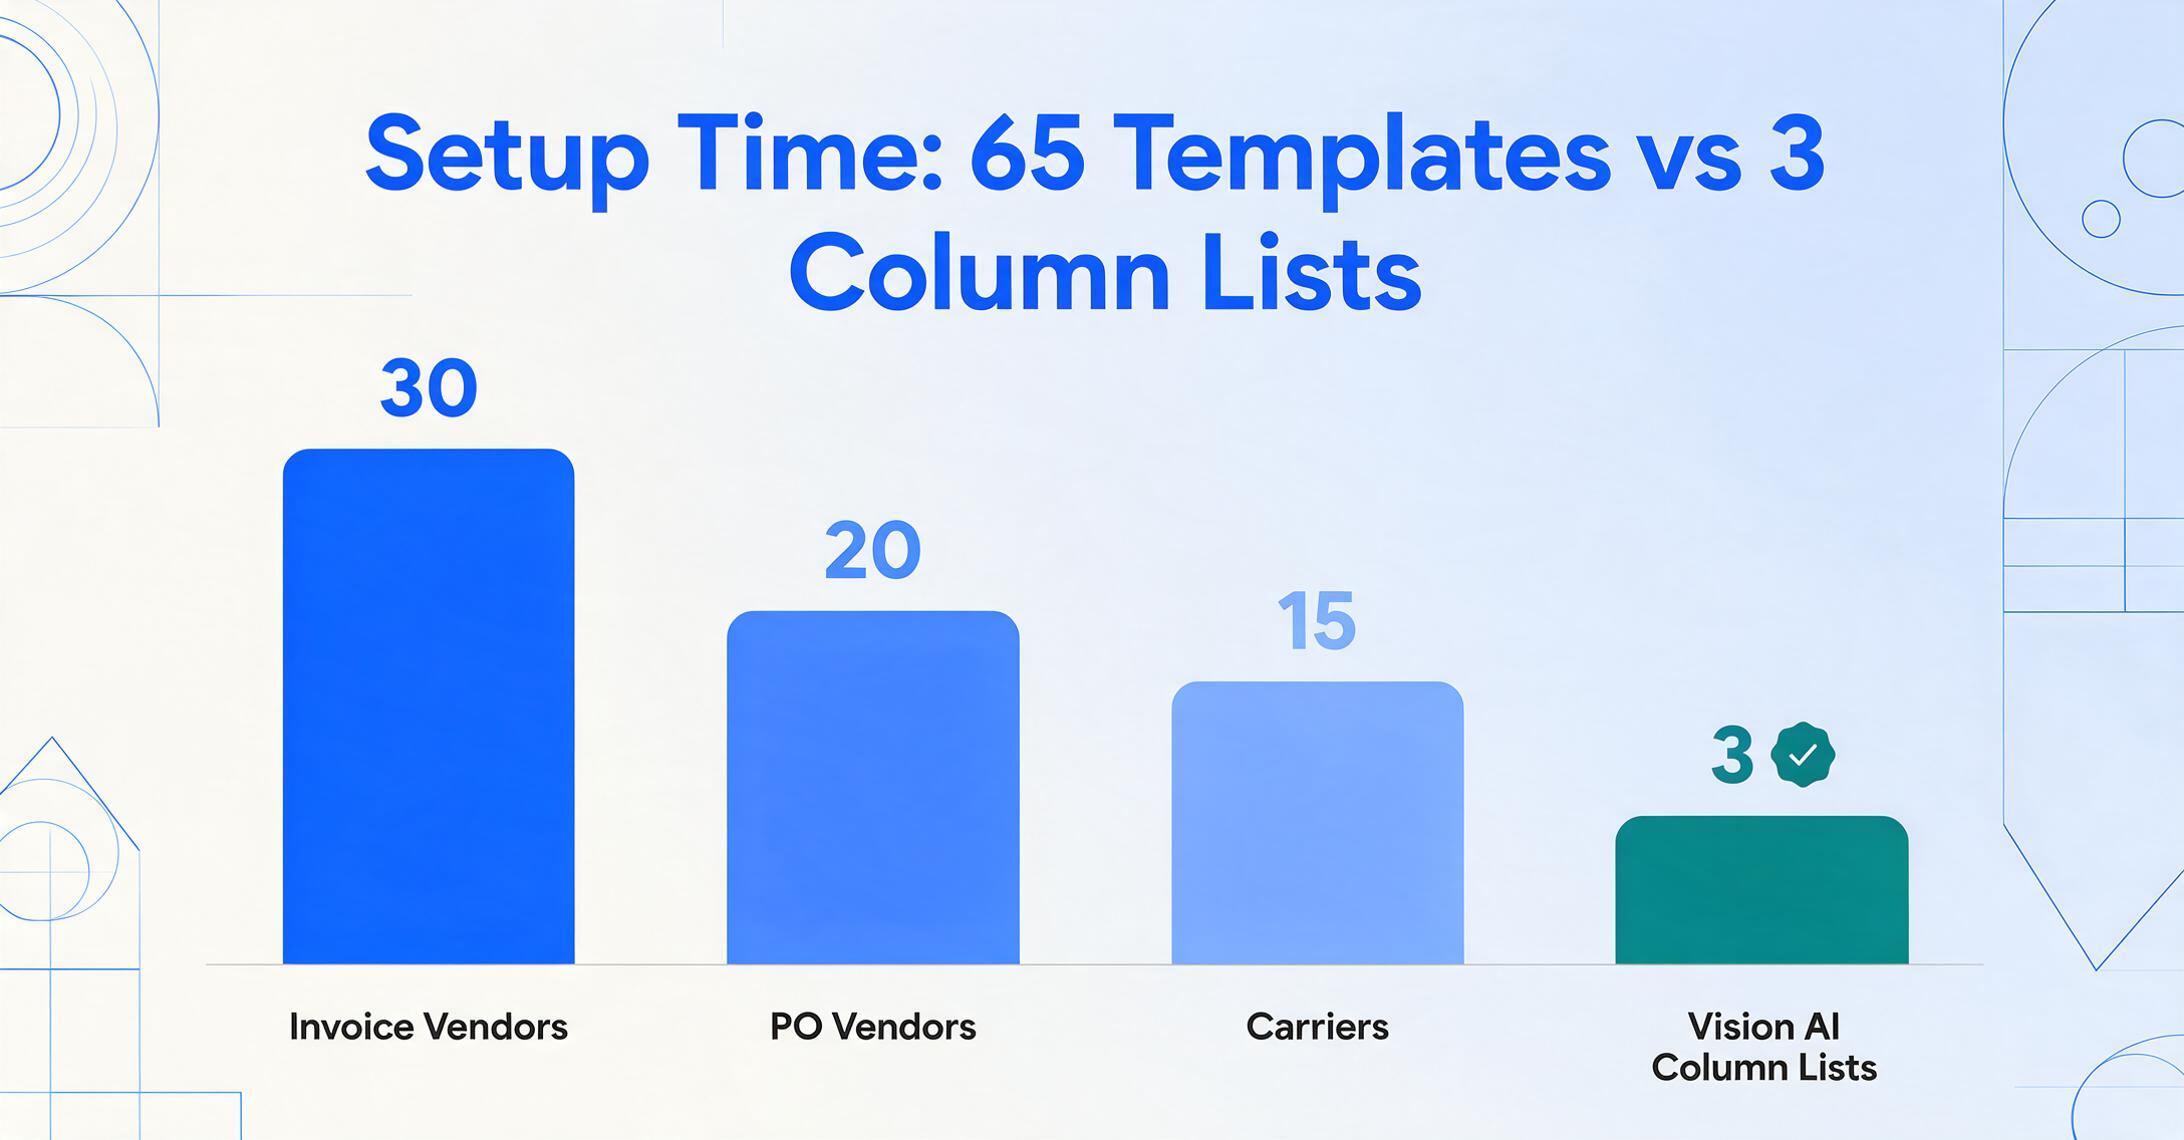
Dieser Unterschied potenziert sich. Ein Template-basiertes System, das Rechnungen von 30 Lieferanten, Bestellungen von 20 Lieferanten und Lieferscheine von 15 Spediteuren verarbeitet, benötigt 65 separate Templates. Jedes davon hat Zeit für die Erstellung gekostet und muss gewartet werden. Ein Vision-AI-System, das denselben Dokumentmix verarbeitet, verwendet eine Spaltenliste pro Dokumenttyp – drei Listen statt 65 Templates. Für einen detaillierten Vergleich, wie sich dies über verschiedene Tools auswirkt, siehe unseren Leitfaden zur Extraktion ohne Vorlage.
Kostenvergleich: Der Softwarepreis ist nur die halbe Geschichte
Auf Softwareebene sind OCR-Tools pro Seite günstiger. Eine kommerzielle OCR-Engine kann bei hohen Volumina $0,01–0,03 pro Seite kosten. Vision-AI-Extraktion liegt typischerweise bei $0,02–0,10 pro Seite. Oberflächlich betrachtet sieht OCR wie die budgetfreundliche Wahl aus.
Das Problem bei diesem oberflächlichen Vergleich ist, dass er die Arbeitskosten ignoriert, die zusätzlich zur Software anfallen. Jede Seite, die manuell korrigiert werden muss, kostet Geld – nicht in Softwaregebühren, sondern in menschlicher Zeit. Und jede Vorlage, die bricht, kostet Geld in Form von Nacharbeit.
| Kostenart | OCR / Vorlage | Vision-AI |
|---|---|---|
| Software (1.000 Seiten/Monat) | $10–30 | $20–100 |
| Vorlageneinrichtung (pro Format) | 1–4 Std. × Stundensatz Ihres Teams | $0 |
| Vorlagenwartung (jährlich) | 15–40 Std. pro 50 Absender | $0 |
| Fehlerkorrektur (variable Dokumente) | 5–15 Min. pro Dokument mit Problemen | 1–3 Min. für Stichprobenprüfung |
Der Break-even-Punkt verschiebt sich je nach Dokumentenmix. Wenn Sie 10.000 identische W-2-Formulare pro Monat verarbeiten, dominieren die OCR-Ersparnisse pro Seite und das Fehlen von Formatvariationen bedeutet, dass Vorlagen nie brechen. Wenn Sie 1.000 Rechnungen von 100 verschiedenen Lieferanten mit unterschiedlichen Layouts verarbeiten, decken die Vision-AI-Ersparnisse durch entfallene Vorlagenwartung und reduzierte Fehlerkorrektur die höheren Kosten pro Seite mehrfach ab. Eine vollständige Aufschlüsselung, wie sich Preise pro Seite und Abonnementpreise im Markt vergleichen, finden Sie in unserer Preisananalyse.
Wann Template-basiertes OCR mehr Sinn ergibt
Template-basiertes OCR ist nicht veraltet. Es gibt mehrere Szenarien, in denen es weiterhin die richtige Wahl ist:
- Große Mengen identischer Formulare. Wenn Sie 50.000 W-2-Formulare, 20.000 standardisierte Kreditanträge oder 100.000 Versorgungsrechnungen verarbeiten – alle aus derselben Quelle mit festem Layout – ist der Kostenvorteil pro Seite von OCR bei dieser Größenordnung real. Die Einrichtungskosten für die Vorlage sind eine einmalige Investition, die sich über Millionen von Seiten amortisiert.
- Nur saubere digitale PDFs. Wenn Ihre Dokumentenpipeline ausschließlich aus digital erzeugten PDFs mit eingebettetem Text besteht (keine Scans, keine Fotos, keine Handschrift), ist die OCR-Genauigkeit ausgezeichnet und der Wartungsaufwand gering.
- Kostensensitiv bei massivem Umfang. Bei monatlichen Volumina über 50.000 Seiten wird der Unterschied zwischen $0,01/Seite und $0,05/Seite zu Tausenden von Dollar. Wenn Ihre Dokumente einheitlich sind und sich Ihr Format nie ändert, ist der günstigere Preis pro Seite die richtige mathematische Entscheidung.
- Anforderungen an deterministische Ausgaben. OCR erzeugt für dieselbe Eingabe jedes Mal dieselbe Ausgabe. Einige regulierte Umgebungen bevorzugen diese Vorhersehbarkeit, selbst wenn die Genauigkeit etwas geringer ist, weil das Verhalten konsistent und prüfbar ist.
Wann Vision-AI mehr Sinn ergibt
Vision-AI gewinnt in den meisten Szenarien, in denen Dokumentvielfalt die Norm und nicht die Ausnahme ist:
- Mehrere Anbieter mit unterschiedlichen Formaten. Ein Unternehmen, das Rechnungen von 30, 50 oder 200 Lieferanten erhält, kann nicht für jeden eine Vorlage pflegen. Vision-AI verarbeitet alle Formate mit einer einzigen Spaltendefinition. Dies ist das Szenario, in dem die Wartungskosten für Vorlagen von beherrschbar zu lähmend werden und in dem No-Training-Tools ihren größten Nutzen liefern.
- Handschriftliche Dokumente. Feldnotizen, unterschriebene Lieferscheine, Inspektionschecklisten, handschriftliche Stundenzettel – die Genauigkeit von OCR fällt bei den meisten Handschriften unter die Nutzbarkeitsgrenze. Vision-AI extrahiert lesbare Handschrift mit brauchbarer Genauigkeit.
- Handyfotos und reale Aufnahmen. Wenn Ihre Dokumente von Mobiltelefonen stammen – Fotos von Belegen, Bilder von Whiteboards, Schnappschüsse von Zählerständen – werden die Perspektivverzerrungen und Lichtschwankungen, die OCR scheitern lassen, von Vision-Modellen natürlich verarbeitet.
- Gemischte Dokumenttypen. Ein Workflow, der Rechnungen, Bestellungen, Lieferscheine und Gutschriften in einem einzigen Batch umfasst, erfordert keine vier separaten Vorlagenkonfigurationen. Vision-AI passt sich jedem Dokument unabhängig an.
- Häufige Formatänderungen. Wenn Ihre Dokumentquellen ihre Layouts regelmäßig ändern (häufig bei Einzelhandelslieferanten, saisonalen Anbietern oder neu eingebundenen Kunden), dominiert der Wartungsvorteil von Vision-AI die Kostenberechnung.
Das Urteil: Passen Sie die Architektur an Ihren Dokumentenmix an
Die Entscheidung zwischen OCR und Vision-AI ist keine Technologiefrage – sie ist eine Frage der Dokumentenmischung. Stellen Sie sich drei Fragen:
- Wie viele verschiedene Dokumentformate verarbeite ich? Ein oder zwei → OCR ist ausreichend. Mehr als zehn → der Vorlagenaufwand beginnt, die Ersparnis pro Seite zu überwiegen.
- Wie oft ändern sich meine Dokumentformate? Nie → OCR ist stabil. Mehrmals pro Jahr → die Vorlagenwartung wird zu einem versteckten Kostenfaktor.
- Wie ist die Qualität meiner Quelldokumente? Nur saubere digitale PDFs → OCR ist genau. Fotos, Scans oder handschriftliche Notizen → Vision-AI ist die praktische Wahl.
Es gibt keine einzige richtige Antwort für jedes Unternehmen. Ein Sachversicherer, der jährlich 80.000 identische Verlängerungsschreiben verarbeitet, sollte bei OCR bleiben. Ein Lebensmittelhändler, der 3.000 Rechnungen von 200 verschiedenen Lieferanten erhält, jeweils mit unterschiedlichem Layout und unterschiedlicher Druckqualität, sollte auf Vision-AI setzen. Der Fehler liegt darin, OCR zu wählen, weil es pro Seite günstiger ist, ohne zu berücksichtigen, was passiert, wenn eine Vorlage um 17 Uhr beim Monatsabschluss bricht.
Häufig gestellte Fragen
Können OCR und Vision-AI im selben Workflow zusammen verwendet werden?
Ja, und dieser hybride Ansatz funktioniert in der Praxis gut. OCR übernimmt die Massenextraktion bei sauberen, standardisierten Dokumenten, während Vision-AI für Randfälle reserviert ist: schlechte Scan-Qualität, Handschrift oder ungewöhnliche Formate, die die OCR-Pipeline nicht zuverlässig verarbeiten kann. Einige Plattformen für Dokumentenintelligenz bieten dieses Routing standardmäßig an: einfache Fälle gehen an schnelles OCR, schwierige werden an ein Vision-Modell eskaliert.
Halluziniert Vision-AI Daten wie ein Chatbot?
Jedes KI-Modell kann falsche Ausgaben produzieren, aber für die Extraktion entwickelte Vision-AI geht damit anders um als ein allgemeiner Chatbot. Extraktionstools zwingen das Modell, nur Daten zurückzugeben, die im Quelldokument vorhanden sind – sie fordern es nicht auf, neue Inhalte zu generieren. Wenn ein angefragtes Feld im Dokument fehlt, bleibt die Zelle leer, statt mit einem erfundenen Wert gefüllt zu werden. Dennoch ist eine kurze Stichprobenprüfung wichtiger Felder unabhängig von der verwendeten Technologie empfehlenswert.
Benötigt Vision-AI eine Internetverbindung?
Die meisten Vision-AI-Extraktionstools sind cloudbasiert und benötigen eine Internetverbindung, um Dokumentbilder an das Modell zu senden und extrahierte Ergebnisse zu empfangen. Einige neuere Tools bieten On-Device-Verarbeitung für die Basisextraktion an, aber das vollständige semantische Verständnis, das Vision-AI von OCR unterscheidet, erfordert in der Regel Cloud-Inferenz. Wenn Ihr Workflow in einer abgeschotteten Umgebung oder mit geringer Konnektivität arbeitet, ist eine On-Premise-OCR-Lösung möglicherweise Ihre einzige Option.
Wie lange dauert der Wechsel von einem OCR-/Template-System zu Vision-AI?
Der Wechsel selbst ist schnell, da Vision-AI keine Template-Migration erfordert. Sie definieren Ihre Spaltennamen einmal (dieselben Felder, die Ihr Template extrahiert hat), laden eine Testcharge hoch, prüfen die Ausgabe und sind einsatzbereit. Der zeitaufwendige Teil ist nicht das Tool – sondern die Prüfung Ihres bestehenden Template-Bestands, um zu bestätigen, welche tatsächlich funktioniert haben und welche stillschweigend falsche Daten produziert haben.
Ab welchem Dokumentvolumen ist Vision-AI im Vergleich zu OCR kosteneffektiv?
Der Break-even hängt von der Formatvielfalt ab, nicht nur vom Volumen. Für eine Pipeline mit einem einzigen Format und hohem Volumen (50.000 identische Formulare) ist OCR günstiger. Für eine Pipeline mit mehreren Formaten (1.000 Rechnungen von 50 Lieferanten) ist Vision-AI in der Regel günstiger, sobald Sie Template-Einrichtung, Wartung und Korrekturzeit einrechnen. Die Faustregel: Wenn Sie mehr als 5–10 Templates erstellen und mindestens einige pro Jahr pflegen, spart Ihnen das wartungsfreie Vision-AI-Modell wahrscheinlich Geld – selbst bei moderatem Volumen.
Laden Sie ein Dokument hoch, das Sie regelmäßig verarbeiten. Definieren Sie die benötigten Spaltennamen. Sehen Sie, wie Vision-AI Ihr tatsächliches Format verarbeitet – ohne Vorlage, ohne Training, ohne Verpflichtung.
Vision-AI mit Ihrem Dokument testen