Por qué el OCR tradicional falla con la escritura manuscrita
Y cómo los modelos de visión por IA lo resuelven
Un usuario de Reddit en r/OpenAI descubrió algo que lo sorprendió: "ChatGPT hace un trabajo increíble con este tipo de cosas. Lo uso todo el tiempo para convertir escritura a texto e incluso para traducir dicha escritura." No estaba usando una herramienta especializada en reconocimiento de escritura manuscrita. Estaba usando un modelo de lenguaje de propósito general — subiendo una foto de texto manuscrito y obteniendo una transcripción limpia. En r/computervision, los usuarios realizan revisiones anuales de herramientas de OCR para escritura manuscrita y llegan constantemente a la misma conclusión: el reconocimiento especializado de escritura manuscrita supera al OCR general, pero los modelos de IA que comprenden el contexto están cerrando la brecha rápidamente. Este artículo explica por qué el OCR estándar falla con la escritura manuscrita, qué cambia cuando la visión por IA entra en escena, y dónde están todavía los límites honestos.
Conclusiones Clave
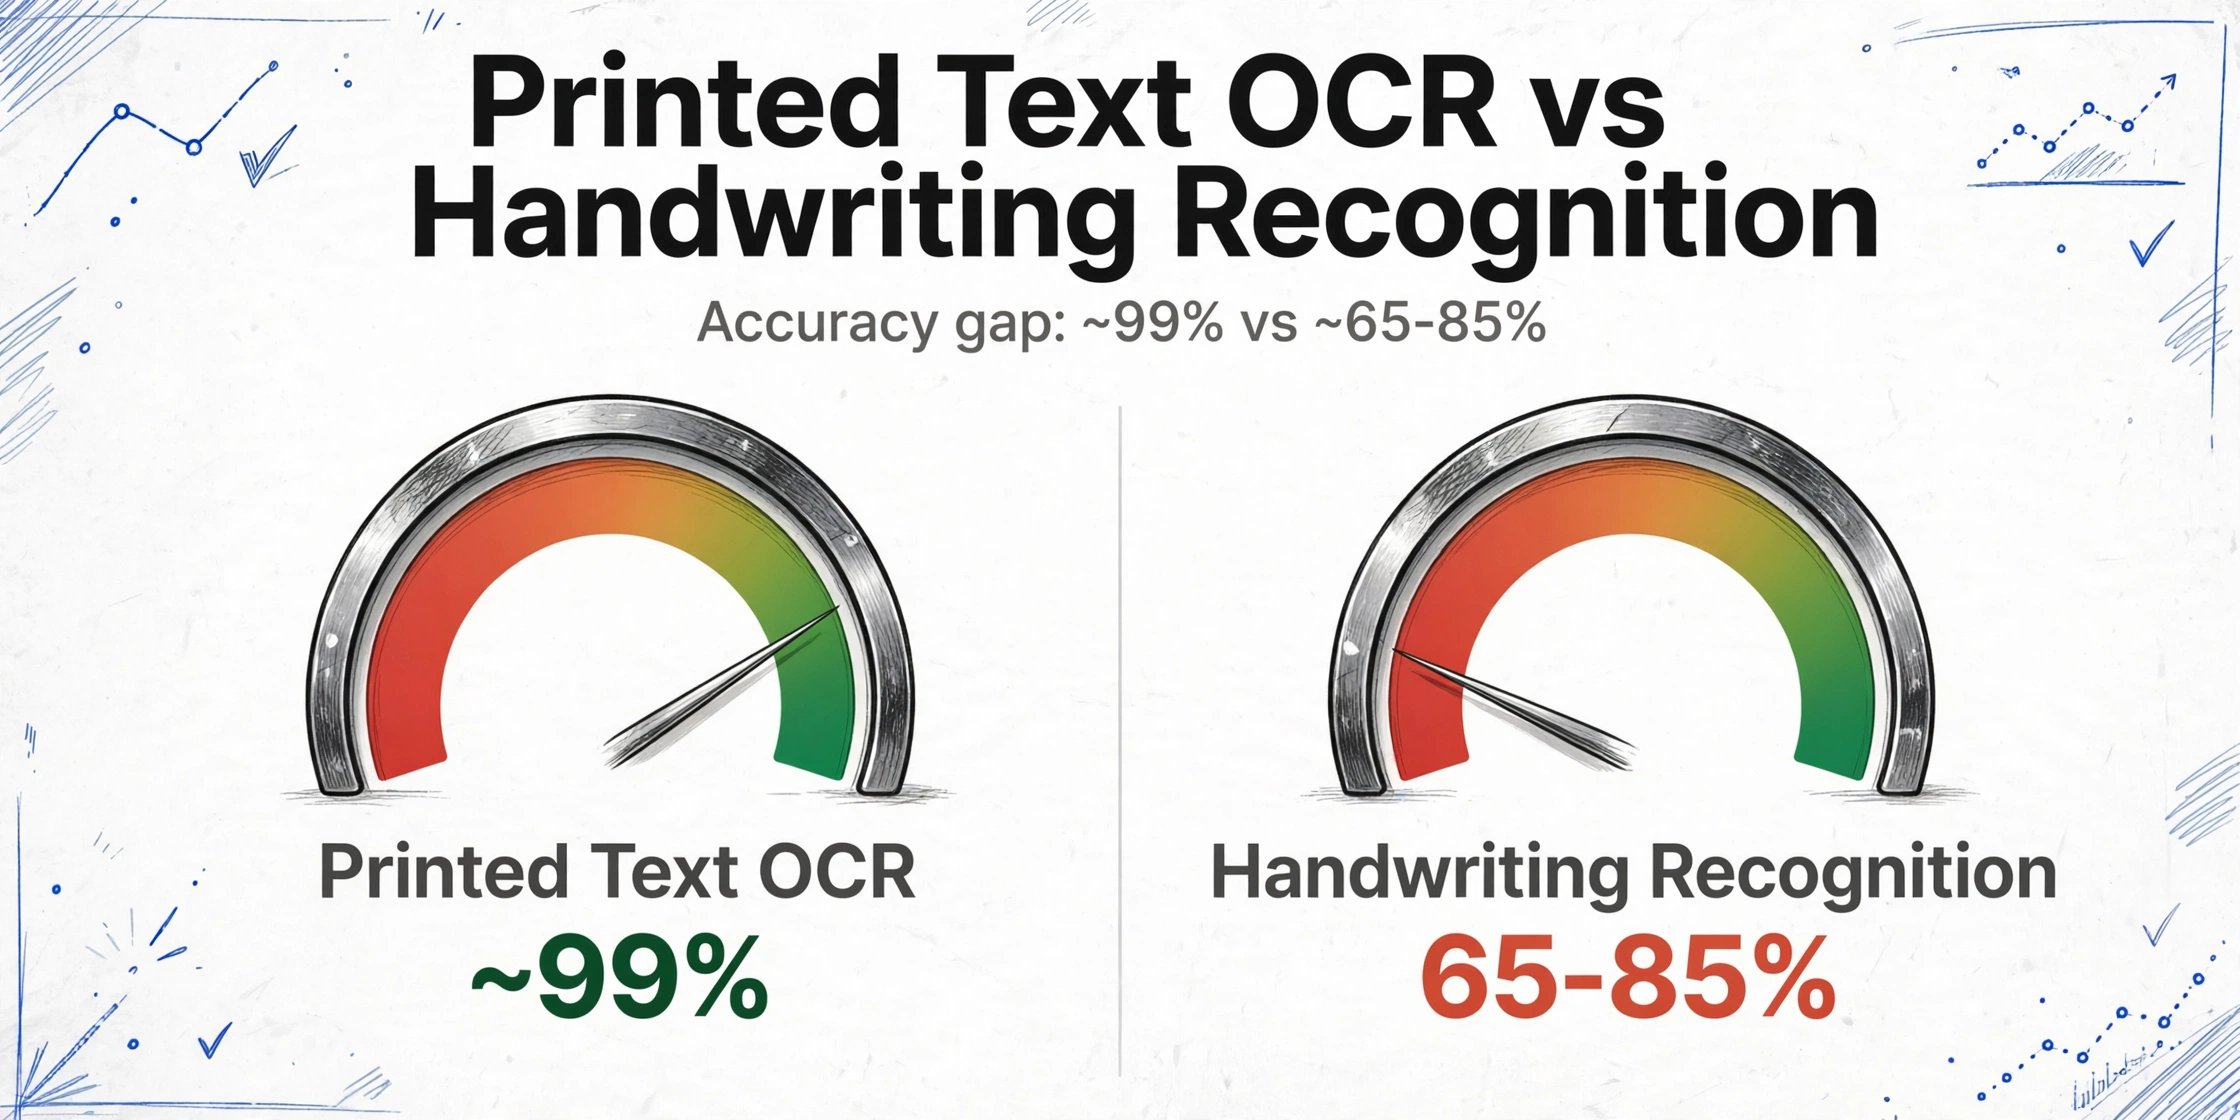
- La precisión del 99% en texto impreso frente al 65–85% en escritura manuscrita no es una falla de calidad — es un error de categoría: el OCR (Reconocimiento Óptico de Caracteres) fue diseñado para comparar imágenes de caracteres con una biblioteca de fuentes, y la escritura humana no tiene una fuente contra la cual comparar.
- A diferencia del OCR, la visión por IA lee el formulario completo — etiquetas, diseño y escritura manuscrita — como una sola imagen interconectada, usando el contexto como lo haría usted: si un garabato está en un campo de fecha entre "1" y "/", debe ser un dígito, no una marca aleatoria.
- Con ImageToTable.ai, el empleado que vuelve a escribir 30 formularios manuscritos en dos horas se convierte en un revisor que verifica los campos marcados en 10 minutos — porque la extracción de nombres de columnas ancla la IA en el significado antes de que siquiera lea su escritura manuscrita.
Escritura manuscrita: la última frontera sin conquistar del OCR
El reconocimiento de texto impreso es un problema resuelto. El OCR moderno alcanza una precisión casi perfecta en tipografías limpias, y la extracción basada en plantillas maneja formularios estructurados con diseños predecibles. El mercado global de reconocimiento de escritura manuscrita —valorado en $1.28 mil millones en 2024 y proyectado a alcanzar $3.29 mil millones para 2032— existe precisamente porque la solución para texto impreso no se transfiere. La escritura manuscrita es el formato de entrada que mantiene vivo el papel en industrias que de otro modo se habrían digitalizado hace décadas.
La atención médica depende de notas clínicas y recetas manuscritas. Las aseguradoras procesan formularios de reclamos manuscritos —un operador de manufactura pregunta claramente: "¿Quién usa papel para capturar datos importantes? Específicamente: formularios llenados por una persona con lápiz y papel. Máquinas que no se conectan a ningún sistema." Las empresas de logística manejan confirmaciones de entrega con firmas y notas manuscritas. Los técnicos de servicio en campo llenan órdenes de trabajo en papel porque escribir en un teléfono con guantes bajo la lluvia es peor que un portapapeles y un bolígrafo. Los datos existen en papel. Llevarlos a un sistema requiere que una persona los transcriba o que una IA pueda leerlos.
Una revisión de 2025 sobre herramientas de OCR para escritura manuscrita en r/computervision resumió el estado del arte: "Las soluciones especializadas de OCR para escritura manuscrita superan consistentemente al OCR de propósito general en documentos manuscritos del mundo real." Esa es una buena noticia para las organizaciones con presupuesto y capacidad de integración para plataformas dedicadas de reconocimiento de escritura manuscrita. Es una mala noticia para el auxiliar contable que recibe una docena de recibos manuscritos cada viernes y necesita los datos en una hoja de cálculo para el lunes. Las herramientas especializadas existen. Las herramientas de propósito general no funcionan lo suficientemente bien. Y la brecha entre ambas es donde reside la mayoría de los datos manuscritos —sin procesar, sin buscar, transcritos manualmente.
El problema no es la letra "desordenada". Es que el OCR nunca entendió el lenguaje.
El OCR tradicional funciona comparando patrones visuales con una biblioteca de formas de caracteres conocidas. Muéstrele una "a" impresa y limpia en Helvetica, y la reconoce con alta confianza. Muéstrele la "a" manuscrita de diez personas diferentes — con distinta inclinación, distinto bucle, conectada a la siguiente letra, apretada en un campo de formulario estrecho — y el enfoque de coincidencia de patrones se desmorona. No existe una forma "correcta" para una "a" manuscrita. El motor de OCR no sabe que las diez variaciones representan la misma letra. Ve diez formas diferentes y adivina.
Este es el desajuste fundamental. El OCR fue diseñado para fuentes tipográficas — conjuntos de caracteres fijos donde cada "a" se parece a cualquier otra "a" en la misma tipografía. La escritura manuscrita no tiene tipografía. Tiene patrones motores individuales, velocidad de escritura, presión del bolígrafo, fricción de la superficie y el estado de ánimo del escritor a las 4:55 PM de un viernes. El grupo de variaciones es infinito. Un algoritmo de coincidencia de patrones que funciona con texto impreso se enfrenta a un problema combinatoriamente diferente con la escritura manuscrita.
La brecha entre la precisión del OCR de texto impreso (~99%) y la del reconocimiento de escritura manuscrita (~65-85% para los mejores modelos de IA actuales en escritura manuscrita desafiante, según la revisión comunitaria de r/computervision de 2025) no es una señal de que el reconocimiento de escritura manuscrita esté roto. Es una señal de que el problema es fundamentalmente más difícil. El reconocimiento de texto impreso es comparación de caracteres. El reconocimiento de escritura manuscrita es interpretación del comportamiento humano — y el comportamiento humano varía.
Lo que la IA de visión hace de manera diferente: lee el significado, no las formas
El cambio de la OCR tradicional a los modelos de visión a gran escala transforma el mecanismo de la coincidencia de caracteres a la comprensión contextual. Un modelo de visión no aísla cada letra y la compara con una biblioteca de formas. Observa la imagen completa — la disposición del formulario, el texto circundante, las etiquetas de los campos, el estilo de escritura manuscrita — e interpreta lo que significa el contenido.
Esta diferencia se hace más evidente en situaciones ambiguas. La OCR tradicional ve un garabato entre dos letras más claras y, o bien adivina un carácter, o bien devuelve un espacio en blanco con baja confianza. Un modelo de visión ve el mismo garabato y lo entiende por el contexto: este es un campo de fecha, el garabato está entre un "1" y una "/", así que probablemente sea un "5" o un "3" según la curva. No está comparando el garabato con la forma de un "5". Está comprendiendo que un formato de fecha que contiene "1?/??/2025" hace que "15" o "13" sean las lecturas más probables, y que "1&/??/2025" sea imposible.
Ese mismo usuario de Reddit en r/OpenAI que se sorprendió por la capacidad de reconocimiento de escritura manuscrita de ChatGPT estaba experimentando exactamente este mecanismo. ChatGPT no tiene un módulo de OCR para escritura manuscrita. Tiene un modelo de visión que observa imágenes y entiende lo que se representa: texto, objetos, contexto, relaciones. Cuando lee escritura manuscrita, está haciendo lo mismo que cuando describe una fotografía: interpretar información visual basándose en lo que tiene sentido en el mundo. La escritura manuscrita es solo otro elemento visual que comprender.
La diferencia en una frase: La OCR pregunta "¿coincide esta forma con el carácter 'a' de mi biblioteca?" La IA de visión pregunta "dado que este es un campo de nombre en un formulario médico, y la primera letra parece una A mayúscula, y el resto de la palabra tiene el patrón de forma de 'nderson' — el nombre es Anderson." Una es coincidencia de patrones. La otra es razonamiento.
Lo que la IA de escritura manuscrita puede manejar — y con lo que todavía tiene dificultades
El enfoque de visión por IA no hace que el reconocimiento de escritura manuscrita sea perfecto. Eleva el techo de precisión y cambia los tipos de errores que ocurren — pero todavía hay límites reales. Ser honestos al respecto importa más que afirmar que el problema está resuelto.
| Tipo de escritura manuscrita | Fiabilidad de la IA | Por qué |
|---|---|---|
| Letra de molde clara (todo en mayúsculas, letras separadas) | Alta — precisión casi de imprenta | Variación limitada; cada letra es distinta y estandarizada |
| Mezcla de molde/cursiva (la escritura manuscrita más común en el mundo real) | Buena — el contexto ayuda a resolver letras ambiguas | La mayoría de las letras son reconocibles; el contexto resuelve el resto |
| Cursiva ligera (letras conectadas, trazos claros) | Moderada — legible pero con errores en pares de letras ambiguos | Las conexiones entre letras crean ambigüedad (rn vs. m, cl vs. d) |
| Cursiva densa / caligráfica (fluida, estilizada) | Baja — tasa de error significativa | Las formas de las letras se alejan demasiado de los patrones reconocibles; el contexto no puede compensar cada carácter |
| Escritura borrosa, desvanecida o diminuta | Baja — similar a la dificultad humana | La degradación física de la superficie de escritura oscurece los datos |
| Escritura en formularios (campos etiquetados, casillas de verificación) | Buena — la estructura del formulario proporciona un contexto sólido | Las etiquetas guían la extracción; la IA sabe "este campo es una fecha" antes de leer la escritura |
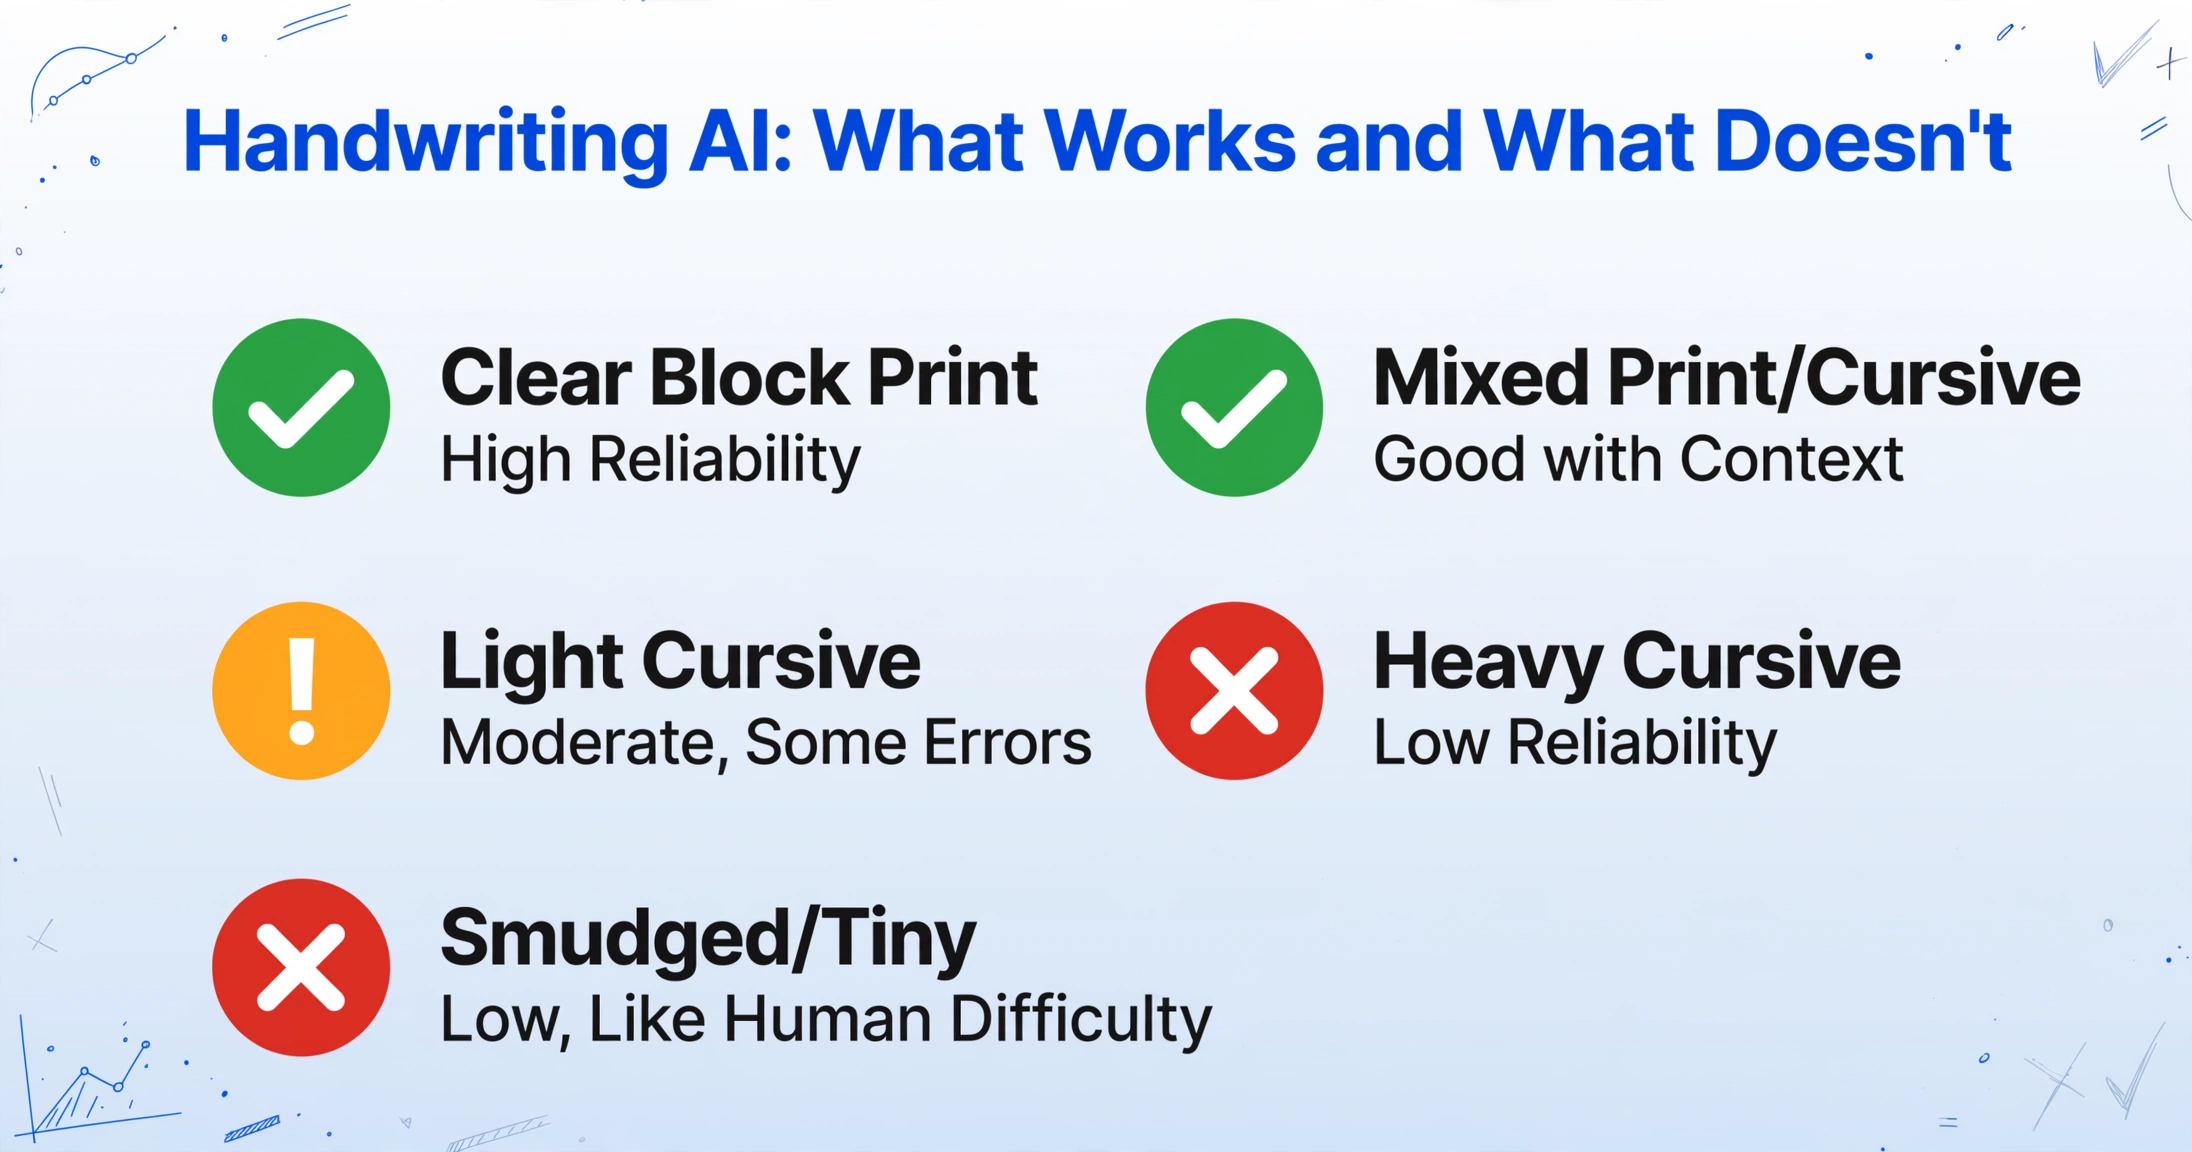
La conclusión no es "la IA de escritura manuscrita funciona" o "la IA de escritura manuscrita no funciona". Es "la IA de escritura manuscrita funciona bien para la escritura que los humanos también pueden leer de manera confiable — y tiene dificultades con la misma escritura con la que los humanos tienen dificultades". El piso de precisión de la IA se sitúa alrededor del punto donde un lector humano cuidadoso también se detendría y entrecerraría los ojos. Esa es una capacidad significativa para los flujos de trabajo empresariales: cubre la mayoría de los datos manuscritos que actualmente se reescriben manualmente, mientras reconoce que los casos más difíciles todavía necesitan revisión humana.
Para una visión general completa que cubra todo, desde conceptos básicos hasta flujos de trabajo de producción, consulte nuestra guía definitiva para la conversión de escritura manuscrita a texto con IA. Si trabaja con formularios que contienen casillas de verificación y campos de selección, aprenda cómo la IA lee formularios manuscritos y convierte selecciones de casillas en datos de Excel estructurado.
Del formulario manuscrito al Excel estructurado — tres pasos
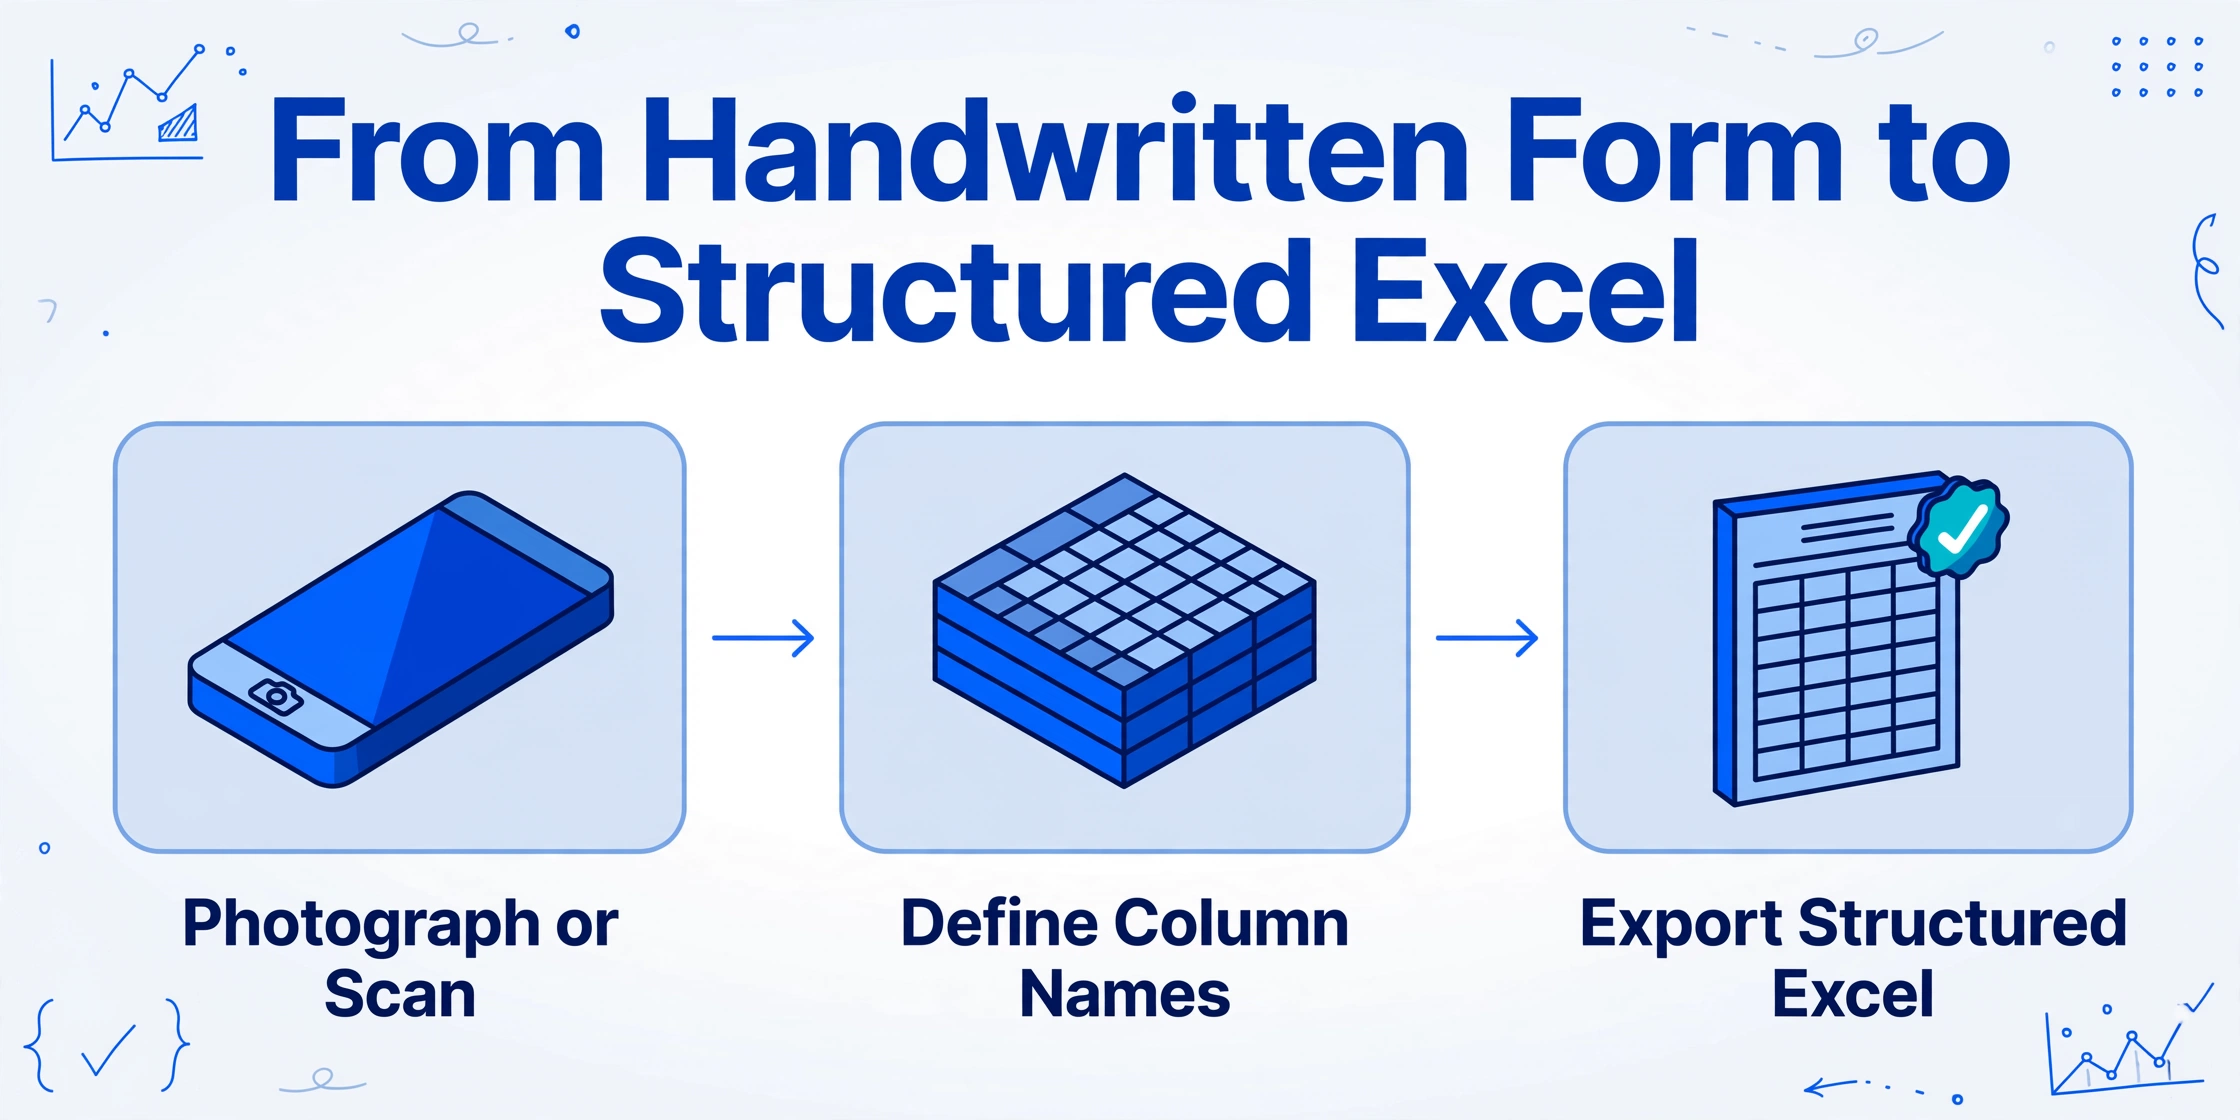
El mismo mecanismo de extracción de nombres de columnas que maneja documentos impresos se aplica a formularios manuscritos, con la ventaja añadida de que las etiquetas del formulario proporcionan un contexto sólido para la interpretación de la IA. Cuando el nombre de la columna es "Nombre del paciente" y el formulario tiene un campo etiquetado como "Nombre", la IA sabe qué tipo de contenido buscar antes incluso de empezar a leer la escritura. La etiqueta ancla la extracción en el significado, y la escritura se convierte en una señal más dentro de un contexto ya estructurado.
Una clínica médica que recibe 30 formularios manuscritos de admisión de pacientes al día definiría columnas como "Nombre del paciente, Fecha de nacimiento, ID de seguro, Queja principal, Médico remitente". Cada formulario se fotografía. El lote se sube. La IA extrae los valores manuscritos en 30 filas de datos estructurados. El empleado que solía pasar dos horas escribiendo estos formularios ahora dedica 10 minutos a verificar el resultado de la IA y a corregir manualmente el 5-10% de los campos donde la escritura era genuinamente ambigua. Lea cómo funciona la extracción de nombres de columnas en todos los tipos de documentos →
Expectativa práctica de precisión: En formularios manuscritos limpios y estructurados con legibilidad razonable, espere que aproximadamente el 85-95% de los campos se extraigan correctamente en la primera pasada. El 5-15% restante necesitará corrección manual, pero verificar y corregir es una fracción del tiempo que se dedicaría a volver a escribir todo desde cero. Por cada hora de escritura manual ahorrada, espere de 5 a 10 minutos de trabajo de verificación.
Demo en vivo: suba un documento manuscrito y vea el resultado
Pruebe la extracción con cualquier documento que contenga escritura manuscrita: un formulario, una nota, un recibo con anotaciones a mano.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas frecuentes
¿Por qué ChatGPT lee tan bien la escritura manuscrita y el OCR de mi escáner no?
ChatGPT utiliza un modelo de visión a gran escala: "ve" la imagen completa y la comprende contextualmente, de la misma manera en que comprende una fotografía. El OCR integrado de su escáner utiliza coincidencia de patrones: aísla cada carácter y compara su forma con una biblioteca de fuentes impresas. La escritura manuscrita no coincide con ninguna fuente, por lo que la comparación a nivel de carácter falla. El OCR del escáner no es una tecnología peor: es la tecnología equivocada para el problema. Si ha usado ChatGPT para leer escritura manuscrita con éxito, ya ha experimentado la diferencia entre la coincidencia de patrones y la comprensión visual.
¿Cuál es la diferencia entre el reconocimiento de escritura manuscrita y la verificación de firmas?
El reconocimiento de escritura manuscrita extrae el contenido textual de las palabras escritas a mano — "¿qué dice esto?" La verificación de firmas confirma la identidad del firmante — "¿esta es realmente la firma de Juan?" Estas son tareas de IA diferentes. El sistema descrito en este artículo maneja la primera: leer texto manuscrito para la extracción de datos. No realiza análisis forense de firmas. Para flujos de trabajo documentales que requieren ambas cosas (por ejemplo, "extraer los datos del formulario Y verificar la firma al final"), la extracción y la verificación son procesos separados.
¿Funciona esto con escritura manuscrita en idiomas distintos del inglés?
El modelo de visión a gran escala admite varios idiomas, incluidos alfabetos con caracteres no latinos. La escritura manuscrita en chino, japonés, árabe, cirílico y devanagari está dentro de la capacidad del modelo. La precisión varía según el idioma y la complejidad del alfabeto: los idiomas con formas de caracteres más distintivas generalmente producen mejores resultados. Los formularios con idiomas mixtos (por ejemplo, un formulario médico con etiquetas en inglés y respuestas manuscritas en español) se manejan en una sola pasada de extracción.
¿Cómo se compara la extracción de escritura manuscrita con la contratación de un servicio de entrada de datos?
Un servicio de entrada de datos cobra por pulsación de tecla o por formulario, con tiempos de entrega medidos en horas o días. La extracción con IA procesa un lote de formularios en minutos a una fracción del costo por formulario — pero produce un resultado que puede necesitar verificación humana para el 5-15% de los campos. La comparación práctica: para 100 formularios, un servicio de entrada de datos cuesta $X y toma Y horas con precisión casi perfecta. La extracción con IA cuesta una fracción de $X y toma menos de 10 minutos, con la contrapartida de que dedicará 15-30 minutos a verificar los campos inciertos. Para la mayoría de las operaciones, el ahorro de tiempo justifica el pequeño esfuerzo de verificación. Para formularios donde la precisión del 100% es innegociable y no se acepta ningún paso de revisión humana, un servicio de entrada de datos sigue siendo la opción más segura.
¿Puede distinguir entre escritura manuscrita y texto impreso en la misma página?
Sí. La IA reconoce ambos formatos y los extrae en la misma salida estructurada. Un formulario con etiquetas impresas, campos mecanografiados, y anotaciones manuscritas en los márgenes será procesado en una sola pasada — el texto impreso recibe extracción estándar, el contenido manuscrito recibe interpretación contextual. El mecanismo de nombres de columnas guía qué valores extraer, independientemente del formato.
Para un flujo de trabajo especializado de conversión de escritura manuscrita a texto con IA, use nuestra herramienta dedicada que lee campos manuscritos, casillas de verificación, y anotaciones en salida de Excel estructurado — sin necesidad de plantillas.