なぜ従来のOCRは手書き文字で失敗するのか
そしてAIビジョンモデルがそれを解決する方法
Redditのr/OpenAIで、あるユーザーが驚くべき発見をしました。「ChatGPTはこういったことを驚くほど上手にやってくれます。手書き文字をテキストに変換したり、さらには翻訳までしてくれるので、いつも使っています」と述べています。彼らは専門の手書き文字認識ツールを使っていたわけではありません。一般的な言語モデルを使用して、手書き文字の写真をアップロードし、きれいな文字起こしを得ていたのです。r/computervisionでは、ユーザーが毎年手書きOCRツールのレビューを実施しており、一貫して同じ結論に達しています:専門の手書き文字認識は一般的なOCRよりも優れているが、文脈を理解するAIモデルが急速にその差を縮めているのです。この記事では、標準的なOCRが手書き文字でつまずく理由、ビジョンAIが登場することで何が変わるのか、そして正直な限界がどこにあるのかを説明します。
重要なポイント
- プリント文字99%の精度と手書き文字65〜85%の精度の差は、品質の失敗ではなく、カテゴリの誤りです。OCR(光学文字認識)は、文字のイメージをフォントライブラリと照合するように設計されており、人間の手書き文字には照合するフォントが存在しません。
- OCRとは異なり、ビジョンAIはフォーム全体(ラベル、レイアウト、手書き文字)を相互に関連する1つの画像として読み取り、あなたと同じように文脈を利用します。日付フィールドの「1」と「/」の間に落書きがあれば、それはランダムなマークではなく数字でなければならないと判断します。
- ImageToTable.aiを使用すると、30枚の手書きフォームを2時間かけて打ち直していた担当者は、フラグが立てられたフィールドを10分で検証するレビュアーになります。なぜなら、列名抽出が手書き文字を読む前にAIを意味に基づいて固定するからです。
手書き文字 — OCRが最後に攻略できていない壁
印刷文字の認識は解決済みの問題です。最新のOCRは、きれいな書体に対してほぼ完璧な精度を達成しており、テンプレートベースの抽出は、レイアウトが予測可能な構造化フォームを処理します。世界の手書き文字認識市場 — 2024年に12.8億ドルと評価され、2032年までに32.9億ドルに達すると予測されています — は、まさに印刷文字のソリューションがそのまま適用できないために存在しています。手書き文字は、そうでなければ数十年前にデジタル化されていたであろう業界で、紙を使い続けさせる入力形式です。
医療現場は、手書きの診療記録や処方箋に依存しています。保険業界は手書きの請求書を処理します — 製造現場の担当者は率直に問いかけます:「重要なデータを紙で記録しているのは誰ですか?具体的には、ペンと紙で人間が記入するフォームです。どのシステムにも接続されていない機械です。」物流企業は、手書きの署名とメモが付いた配達確認書を扱います。現場サービス技術者は、雨の中で手袋をしたままスマホでタイピングするよりも、クリップボードとペンの方がましだから、紙の作業指示書に記入します。データは紙の上に存在します。それをシステムに入力するには、誰かが打ち直すか、それを読み取れるAIが必要です。
r/computervisionの2025年の手書きOCRツールのレビューは、現状を次のように要約しています:「専用の手書きOCRソリューションは、実際の手書き文書において、汎用OCRを一貫して上回ります。」これは、専用の手書き文字認識プラットフォームに予算と統合能力を持つ組織にとっては良い知らせです。しかし、毎週金曜日に手書きの領収書を12枚受け取り、月曜日までにデータをスプレッドシートに入力する必要がある経理担当者にとっては、悪い知らせです。専用ツールは存在します。汎用ツールは十分に機能しません。そして、その間のギャップに、ほとんどの手書きデータが眠っています — 未処理のまま、検索もできず、手作業で打ち直されています。
問題は「読みにくい」手書きではない。OCRが言語を理解したことがないことだ。
従来のOCRは、既知の文字形状のライブラリと視覚パターンを照合することで機能します。Helveticaで印刷されたきれいな「a」を見せれば、高い信頼度で一致します。10人の異なる人が書いた手書きの「a」— 角度が異なり、ループが異なり、次の文字につながり、狭いフォーム欄に押し込まれている — を見せると、パターンマッチングのアプローチは崩れます。手書きの「a」に「正しい」形状はありません。OCRエンジンは、10個のバリエーションすべてが同じ文字を表していることを知りません。10個の異なる形状を見て推測するだけです。
これが根本的なミスマッチです。OCRはフォント用に設計されました — 同じ書体ではすべての「a」が他のすべての「a」と同じように見える、固定された文字セットです。手書きには書体がありません。個人の運動パターン、筆記速度、ペンの圧力、表面の摩擦、そして金曜日の午後4時55分の書き手の気分があります。バリエーションのプールは無限です。印刷物で機能するパターンマッチングアルゴリズムは、手書きでは組み合わせ的に異なる問題に直面します。
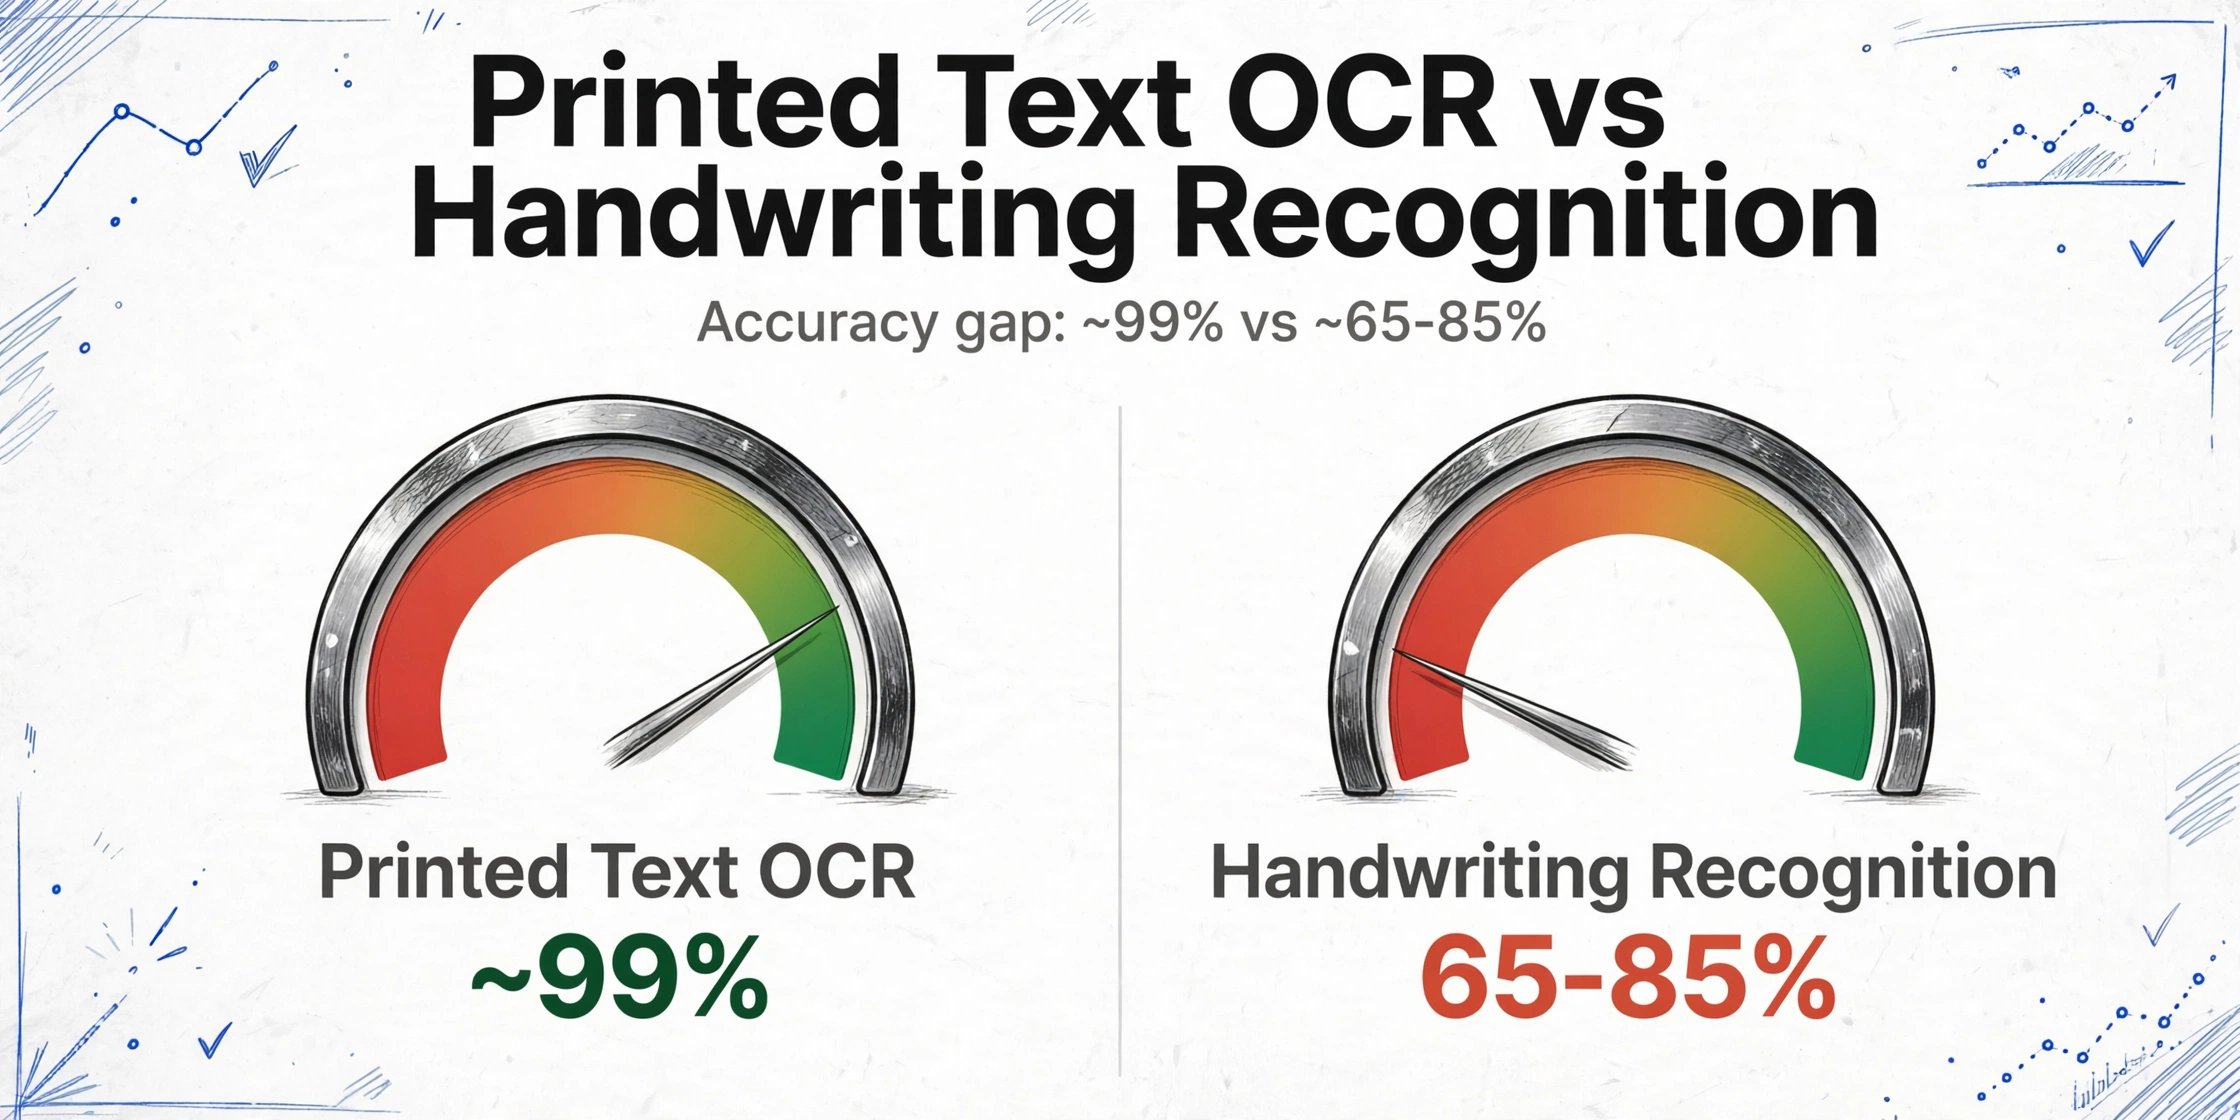
印刷テキストのOCR精度(約99%)と手書き文字認識の精度(挑戦的な手書きに対する現在の最良のAIモデルでは約65〜85%、2025年のr/computervisionコミュニティレビューによる)の差は、手書き文字認識が壊れているという兆候ではありません。問題が根本的により難しいという兆候です。印刷物の認識は文字の照合です。手書き文字認識は人間の行動の解釈です — そして人間の行動は変化します。
ビジョンAIの違い — 形ではなく意味を読む
従来のOCRからビジョン大規模モデルへの移行は、文字マッチングから文脈理解への仕組みの変化をもたらします。ビジョンモデルは、個々の文字を切り出して形状ライブラリと比較するのではありません。フォームのレイアウト、周囲のテキスト、項目ラベル、手書きスタイルなど、画像全体を見て、コンテンツの意味を解釈します。
この違いは、曖昧な状況で最も明確に現れます。従来のOCRは、2つの明確な文字の間にある走り書きを見て、文字を推測するか、信頼度の低い空白を返します。ビジョンモデルは同じ走り書きを見て、文脈から理解します。これは日付フィールドで、走り書きは「1」と「/」の間にあり、曲線によって「5」か「3」の可能性が高いと判断します。走り書きを「5」の形状にマッチングさせているのではありません。「1?/??/2025」という日付形式を考慮すると、「15」または「13」が最も可能性の高い読み方であり、「1&/??/2025」はあり得ないと理解しているのです。
r/OpenAIでChatGPTの手書き文字認識能力に驚いていたRedditユーザーも、まさにこの仕組みを体験していました。ChatGPTには手書き文字用のOCRモジュールはありません。画像を見て、何が描かれているかを理解するビジョンモデルを備えています。テキスト、オブジェクト、文脈、関係性などです。手書き文字を読むときも、写真を説明するときと同じことをしています。つまり、世界の中で意味が通るものに基づいて視覚情報を解釈しているのです。手書き文字は、理解すべきもう1つの視覚要素に過ぎません。
1文で表す違い: OCRは「この形は私のライブラリの文字『a』と一致するか?」と問います。ビジョンAIは「医療フォームの名前フィールドで、最初の文字が大文字のAのように見え、残りの単語が『nderson』の形パターンを持つなら、名前はAndersonだ」と問います。一方はパターンマッチングであり、もう一方は推論です。
手書きAIが対応できることと、まだ苦手とすること
ビジョンAIのアプローチは、手書き文字認識を完璧にするわけではありません。精度の上限を引き上げ、発生するエラーの種類を変えるものですが、それでも実際の限界は存在します。問題が解決されたと主張するよりも、その限界を正直に伝えることの方が重要です。
| 手書きの種類 | AIの信頼性 | 理由 |
|---|---|---|
| 明瞭なブロック体(全て大文字、文字が分離している) | 高い — 印刷物に近い精度 | バリエーションが限定的で、各文字が明確かつ標準化されている |
| ブロック体と筆記体の混在(最も一般的な実践的な手書き) | 良好 — 文脈が曖昧な文字の解消に役立つ | ほとんどの文字は認識可能で、文脈が残りを解決する |
| 軽い筆記体(文字がつながっているが、明確なストローク) | 中程度 — 読めるが、曖昧な文字の組み合わせでエラーが発生 | 文字のつながりが曖昧さを生む(rn と m、cl と d など) |
| 強い筆記体/スクリプト(流れるような装飾的な文字) | 低い — エラー率が高い | 文字の形状が認識可能なパターンから大きく逸脱しており、文脈だけでは全ての文字を補えない |
| 汚れている、かすれている、または極小の手書き | 低い — 人間が読む場合と同程度の難しさ | 筆記面の物理的な劣化がデータを不明瞭にする |
| フォーム上の手書き(ラベル付きフィールド、チェックボックス) | 良好 — フォーム構造が強力な文脈を提供 | ラベルが抽出をガイドし、AIは手書きを読む前に「このフィールドは日付である」と認識する |
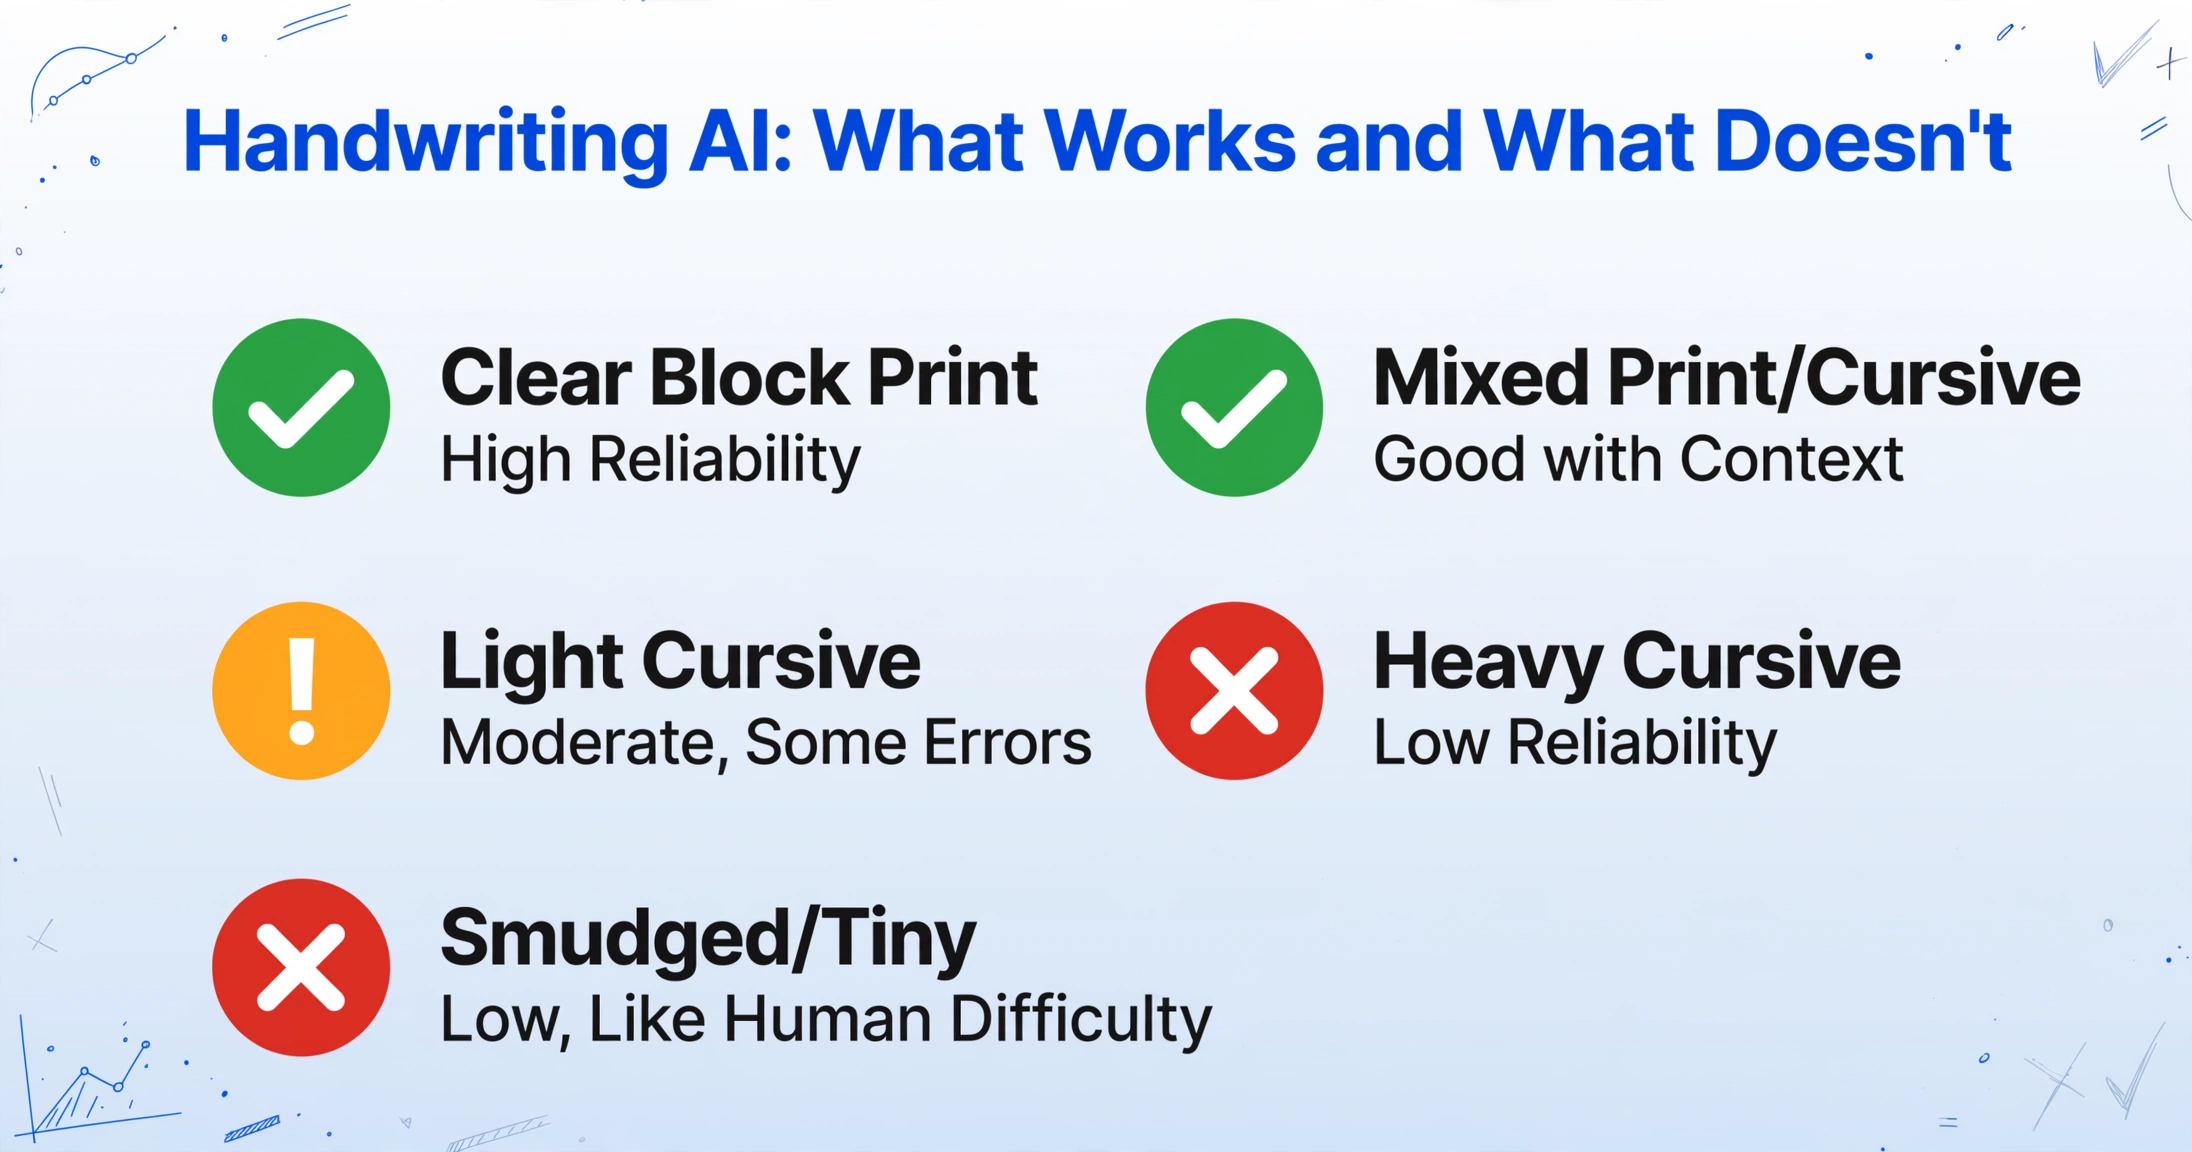
ここでの結論は「手書きAIは機能する」でも「手書きAIは機能しない」でもありません。「手書きAIは、人間が確実に読める手書きにはよく機能し、人間が苦労する手書きには同様に苦労する」ということです。AIの精度の下限は、注意深い人間の読者が速度を落として目を凝らすポイントとほぼ同じ位置にあります。これはビジネスワークフローにとって有意義な能力です。現在手動で再入力されている手書きデータの大部分をカバーしつつ、最も難しいケースは依然として人間のレビューが必要であることを認識しています。
基本概念から本番ワークフローまでを網羅した完全な概要については、AI手書き文字テキスト変換の究極ガイドをご覧ください。チェックボックスや選択フィールドを含むフォームを扱う場合は、AIが手書きフォームを読み取り、チェックボックスの選択を構造化されたExcelデータに変換する方法をご覧ください。
手書きフォームから構造化されたExcelへ — 3つのステップ
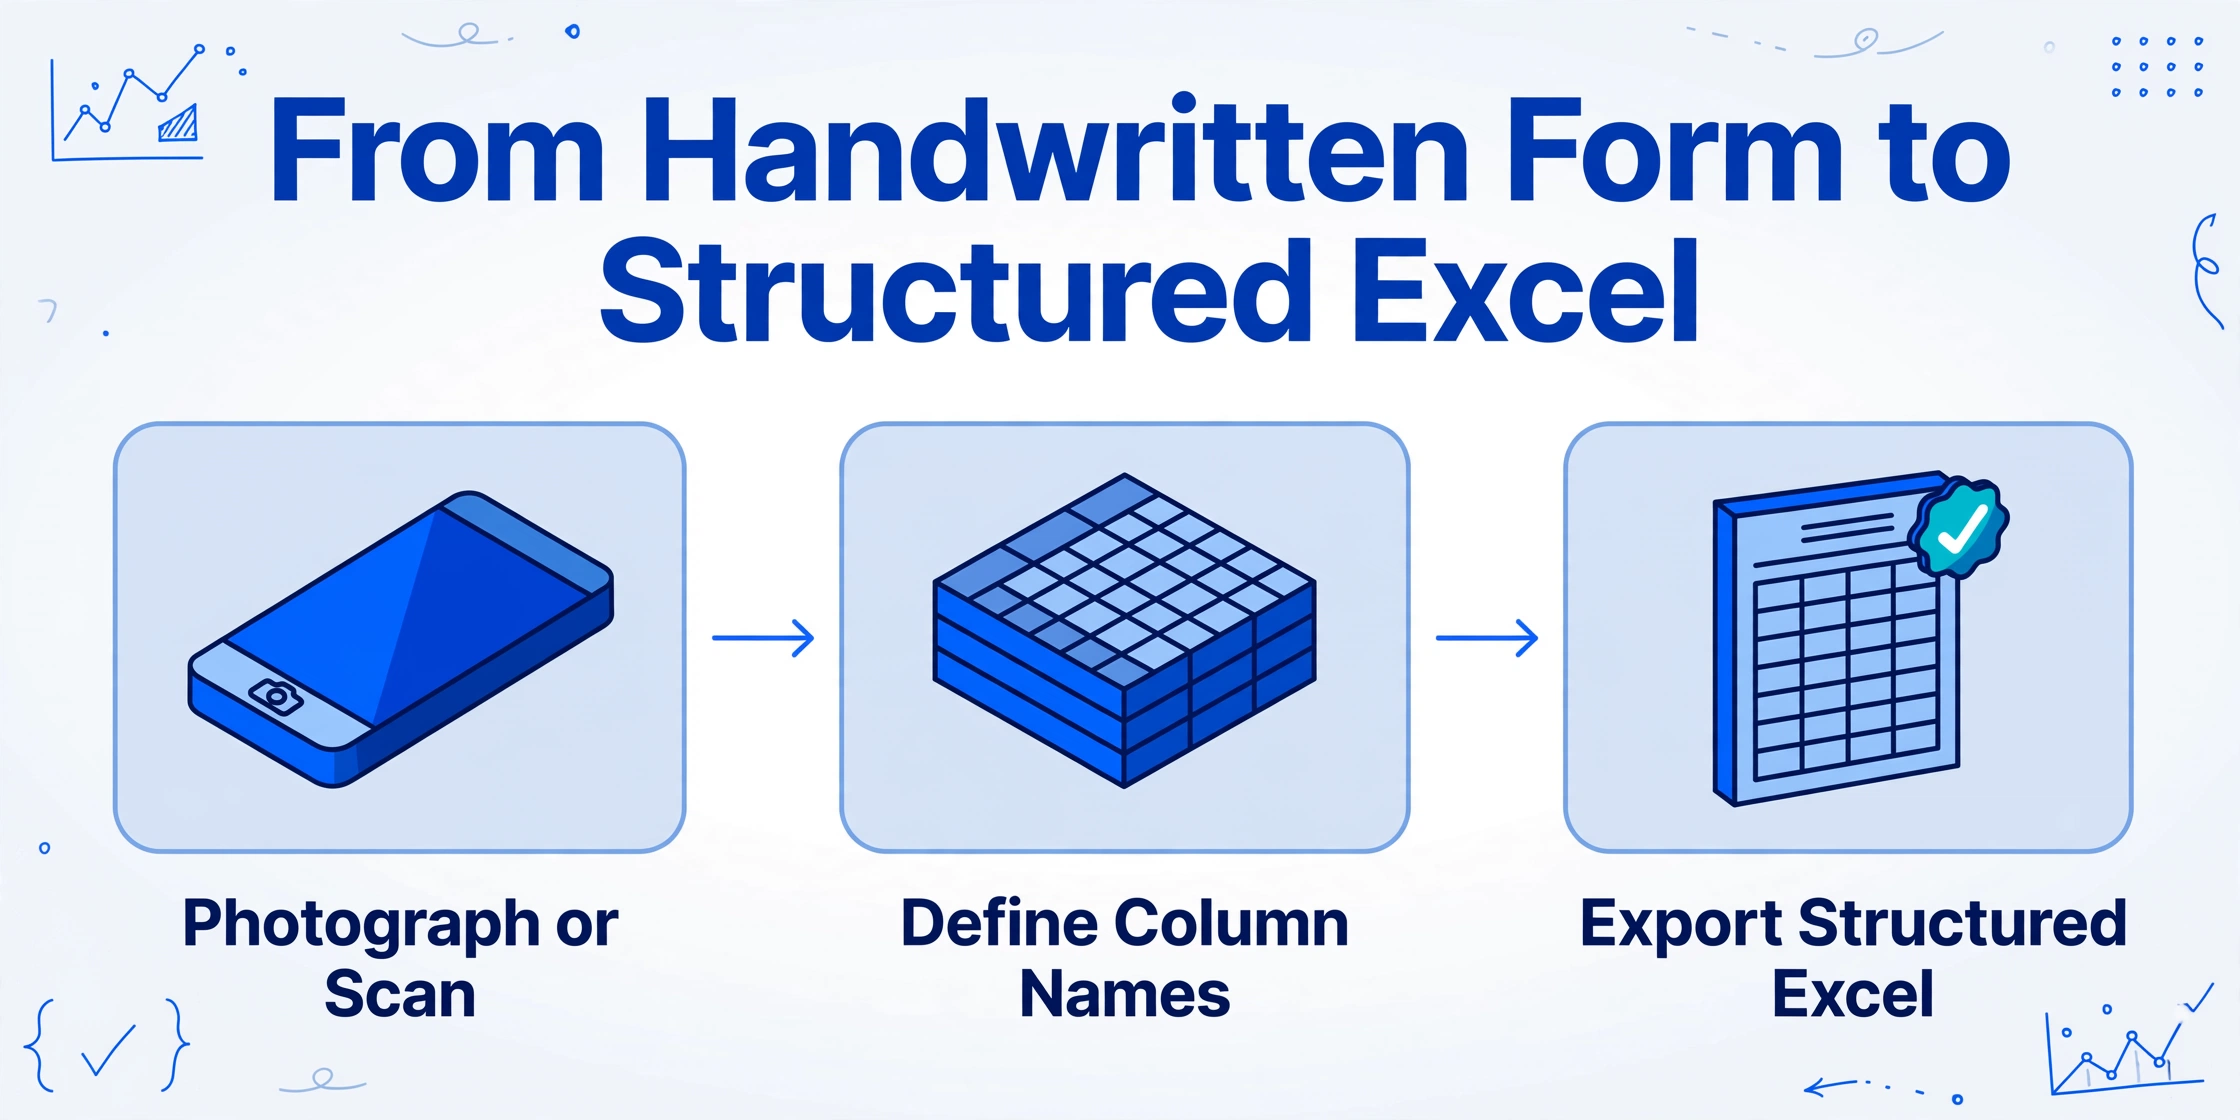
印刷されたドキュメントを処理するのと同じ列名抽出メカニズムが手書きフォームにも適用されます。さらに、フォームのラベルがAIの解釈に強い文脈を提供するという利点があります。列名が「Patient Name」で、フォームに「Name」というラベルのフィールドがある場合、AIは手書きを読み始める前に、どのような内容を探すべきかを把握します。ラベルが抽出の意味を固定し、手書きはすでに構造化された文脈の中のもう一つのシグナルになります。
1日30枚の手書きの患者受付フォームを受け取る医療クリニックでは、「Patient Name、DOB、Insurance ID、Chief Complaint、Referring Physician」のような列を定義します。各フォームは撮影され、バッチがアップロードされます。AIは手書きの値を抽出して、30行の構造化データに変換します。以前はこれらのフォームの入力に2時間費やしていた事務員は、今ではAIの出力を検証し、手書きが本当に曖昧だった5〜10%のフィールドを手動で修正するのに10分しか費やしません。すべてのドキュメントタイプでの列名抽出の仕組みを読む →
実際の精度の期待値: 読みやすく構造化された手書きフォームでは、最初のパスで約85〜95%のフィールドが正しく抽出されることが期待できます。残りの5〜15%は手動での修正が必要ですが、検証と修正は、すべてを最初から打ち直す時間のほんの一部です。手動入力の1時間ごとに、5〜10分の検証作業が必要になると見込んでください。
ライブデモ: 手書き文書をアップロードして出力結果を確認
手書きを含むあらゆる文書(フォーム、メモ、手書きの記入がある領収書など)で抽出をテストできます。
ファイルは安全に処理され、保存されることはありません。
よくある質問
ChatGPTは手書きを上手に読めるのに、スキャナーのOCRはなぜ読めないのですか?
ChatGPTはビジョン大規模モデルを使用しており、写真を理解するのと同じように、画像全体を「見て」文脈的に理解します。スキャナー内蔵のOCRはパターンマッチングを使用しており、各文字を分離して、その形状を印刷フォントのライブラリと比較します。手書きはどのフォントにも一致しないため、文字レベルの比較は失敗します。スキャナーのOCRが劣った技術というわけではなく、問題に対して間違った技術なのです。ChatGPTで手書きを読むことに成功したことがあれば、パターンマッチングと視覚的理解の違いをすでに体験していることになります。
手書き文字認識と署名検証の違いは何ですか?
手書き文字認識は、手書きの単語のテキスト内容を抽出します。「これは何と書いてあるか?」という問いです。署名検証は、署名者の身元を確認します。「これは本当にジョンの署名か?」という問いです。これらは異なるAIタスクです。この記事で説明するシステムは前者を扱います。つまり、データ抽出のための手書きテキストの読み取りです。法廷で使えるような署名分析は行いません。両方が必要な文書ワークフロー(例:「フォームのデータを抽出し、かつ下部の署名を検証する」)では、抽出と検証は別々のプロセスです。
英語以外の言語の手書き文字でも機能しますか?
ビジョン大規模モデルは、非ラテン文字を含む複数の言語に対応しています。中国語、日本語、アラビア語、キリル文字、デーヴァナーガリー文字の手書き文字はすべてモデルの能力の範囲内です。精度は言語と文字の複雑さによって異なります。文字の形がより明確に区別できる言語ほど、一般的に良い結果が得られます。複数言語が混在するフォーム(例:英語のラベルとスペイン語の手書き回答がある医療フォーム)も、1回の抽出パスで処理されます。
手書き文字抽出は、データ入力サービスを雇うのと比べてどうですか?
データ入力サービスは、キーストロークまたはフォームごとに料金がかかり、納期は数時間から数日です。AI抽出は、フォームのバッチを数分で処理し、フォームあたりのコストはほんの一部ですが、結果の5〜15%のフィールドについては人間による検証が必要になる場合があります。実際の比較:100枚のフォームの場合、データ入力サービスは$Xの費用とY時間かかり、精度はほぼ完璧です。AI抽出は$Xのほんの一部の費用で10分未満で完了しますが、不確実なフィールドの検証に15〜30分を費やすというトレードオフがあります。ほとんどの運用では、時間の節約が小さな検証作業を正当化します。100%の精度が絶対条件で、人間によるレビューステップが許容されないフォームの場合、データ入力サービスの方が安全な選択肢であり続けます。
同じページ内の手書き文字と印刷テキストを区別できますか?
はい。AIは両方の形式を認識し、同じ構造化された出力に抽出します。印刷されたラベル、入力済みのフィールド、欄外の手書き注釈があるフォームも1回の処理で完了します。印刷テキストは標準的な抽出が行われ、手書きコンテンツは文脈に基づく解釈が行われます。列名の仕組みが、形式に関係なく抽出する値をガイドします。
専用のAI手書き文字テキスト変換ワークフローには、手書きフィールド、チェックボックス、注釈を構造化されたExcel出力に読み取る専用ツールをご利用ください。テンプレートは不要です。