Por que o OCR tradicional falha em escrita manual
E como os modelos de visão por IA acertam
Um usuário do Reddit no r/OpenAI descobriu algo que o surpreendeu: "O ChatGPT faz um trabalho incrível nesses tipos de tarefas. Uso o tempo todo para converter escrita em texto e até traduzir essa escrita." Ele não estava usando uma ferramenta especializada de reconhecimento de escrita manual. Estava usando um modelo de linguagem de propósito geral — enviando uma foto de texto manuscrito e recebendo uma transcrição limpa. No r/computervision, usuários fazem revisões anuais de ferramentas de OCR de escrita manual e chegam consistentemente à mesma conclusão: o reconhecimento especializado de escrita manual supera o OCR geral, mas os modelos de IA que entendem contexto estão fechando rápido essa lacuna. Este artigo explica por que o OCR padrão tropeça na escrita manual, o que muda quando a visão por IA entra em cena e onde ainda estão os limites honestos.
Principais Conclusões
- Precisão de 99% em impressos versus 65–85% em escrita manual não é uma falha de qualidade — é um erro de categoria: o OCR (Reconhecimento Óptico de Caracteres) foi projetado para comparar imagens de caracteres com uma biblioteca de fontes, e a escrita manual humana não tem uma fonte para comparar.
- Ao contrário do OCR, a visão por IA lê o formulário inteiro — rótulos, layout e escrita manual — como uma imagem interconectada, usando contexto como você faria: se um rabisco está em um campo de data entre "1" e "/", deve ser um dígito, não uma marca aleatória.
- Com o ImageToTable.ai, o funcionário que redigita 30 formulários manuscritos em duas horas vira um revisor que verifica campos sinalizados em 10 minutos — porque a extração de nomes de colunas ancora a IA no significado antes mesmo de ela ler sua escrita manual.
Escrita Manual — A Última Fronteira Invicta do OCR
O reconhecimento de texto impresso é um problema resolvido. O OCR moderno alcança precisão quase perfeita em tipografias limpas, e a extração baseada em modelos lida com formulários estruturados de layouts previsíveis. O mercado global de reconhecimento de escrita manual — avaliado em US$ 1,28 bilhão em 2024 e projetado para chegar a US$ 3,29 bilhões até 2032 — existe justamente porque a solução de texto impresso não se transfere. A escrita manual é o formato de entrada que mantém o papel vivo em indústrias que, de outra forma, teriam digitalizado há décadas.
A área da saúde funciona com notas clínicas e receitas escritas à mão. Seguradoras processam formulários de sinistros manuscritos — um operador de manufatura pergunta diretamente: "Quem usa papel para capturar dados importantes? Especificamente: formulários preenchidos por um humano com caneta e papel. Máquinas que não se conectam a nenhum sistema." Empresas de logística lidam com confirmações de entrega com assinaturas e anotações manuscritas. Técnicos de campo preenchem ordens de serviço em papel porque digitar no celular com luvas na chuva é pior do que prancheta e caneta. Os dados existem no papel. Colocá-los em um sistema exige ou uma pessoa redigitando ou uma IA que consiga lê-los.
Uma análise de 2025 das ferramentas de OCR para escrita manual no r/computervision resumiu o estado da arte: "Soluções especializadas de OCR para escrita manual superam consistentemente o OCR de uso geral em documentos manuscritos do mundo real." Essa é uma boa notícia para organizações com orçamento e capacidade de integração para plataformas dedicadas de reconhecimento de escrita manual. É uma má notícia para o auxiliar de contabilidade que recebe uma dúzia de recibos manuscritos toda sexta-feira e precisa dos dados em uma planilha até segunda. As ferramentas especializadas existem. As ferramentas de uso geral não funcionam bem o suficiente. E a lacuna entre elas é onde está a maior parte dos dados manuscritos — não processados, não pesquisáveis, redigitados manualmente.
O problema não é a letra "ilegível". É que o OCR nunca entendeu a linguagem.
O OCR tradicional funciona comparando padrões visuais com uma biblioteca de formatos de caracteres conhecidos. Mostre a ele um "a" impresso e limpo em Helvetica, e ele faz a correspondência com alta confiança. Mostre a ele o "a" manuscrito de dez pessoas diferentes — com ângulos diferentes, laços diferentes, conectado à próxima letra, espremido em um campo de formulário apertado — e a abordagem de correspondência de padrões falha. Não existe um formato "correto" para um "a" manuscrito. O mecanismo de OCR não sabe que todas as dez variações representam a mesma letra. Ele vê dez formatos diferentes e adivinha.
Essa é a incompatibilidade fundamental. O OCR foi projetado para fontes — conjuntos fixos de caracteres em que cada "a" se parece com todos os outros "a" na mesma tipografia. A escrita manual não tem tipografia. Ela tem padrões motores individuais, velocidade de escrita, pressão da caneta, atrito da superfície e o humor de quem escreve às 16h55 de uma sexta-feira. O conjunto de variações é infinito. Um algoritmo de correspondência de padrões que funciona com texto impresso enfrenta um problema combinatoriamente diferente com a escrita manual.
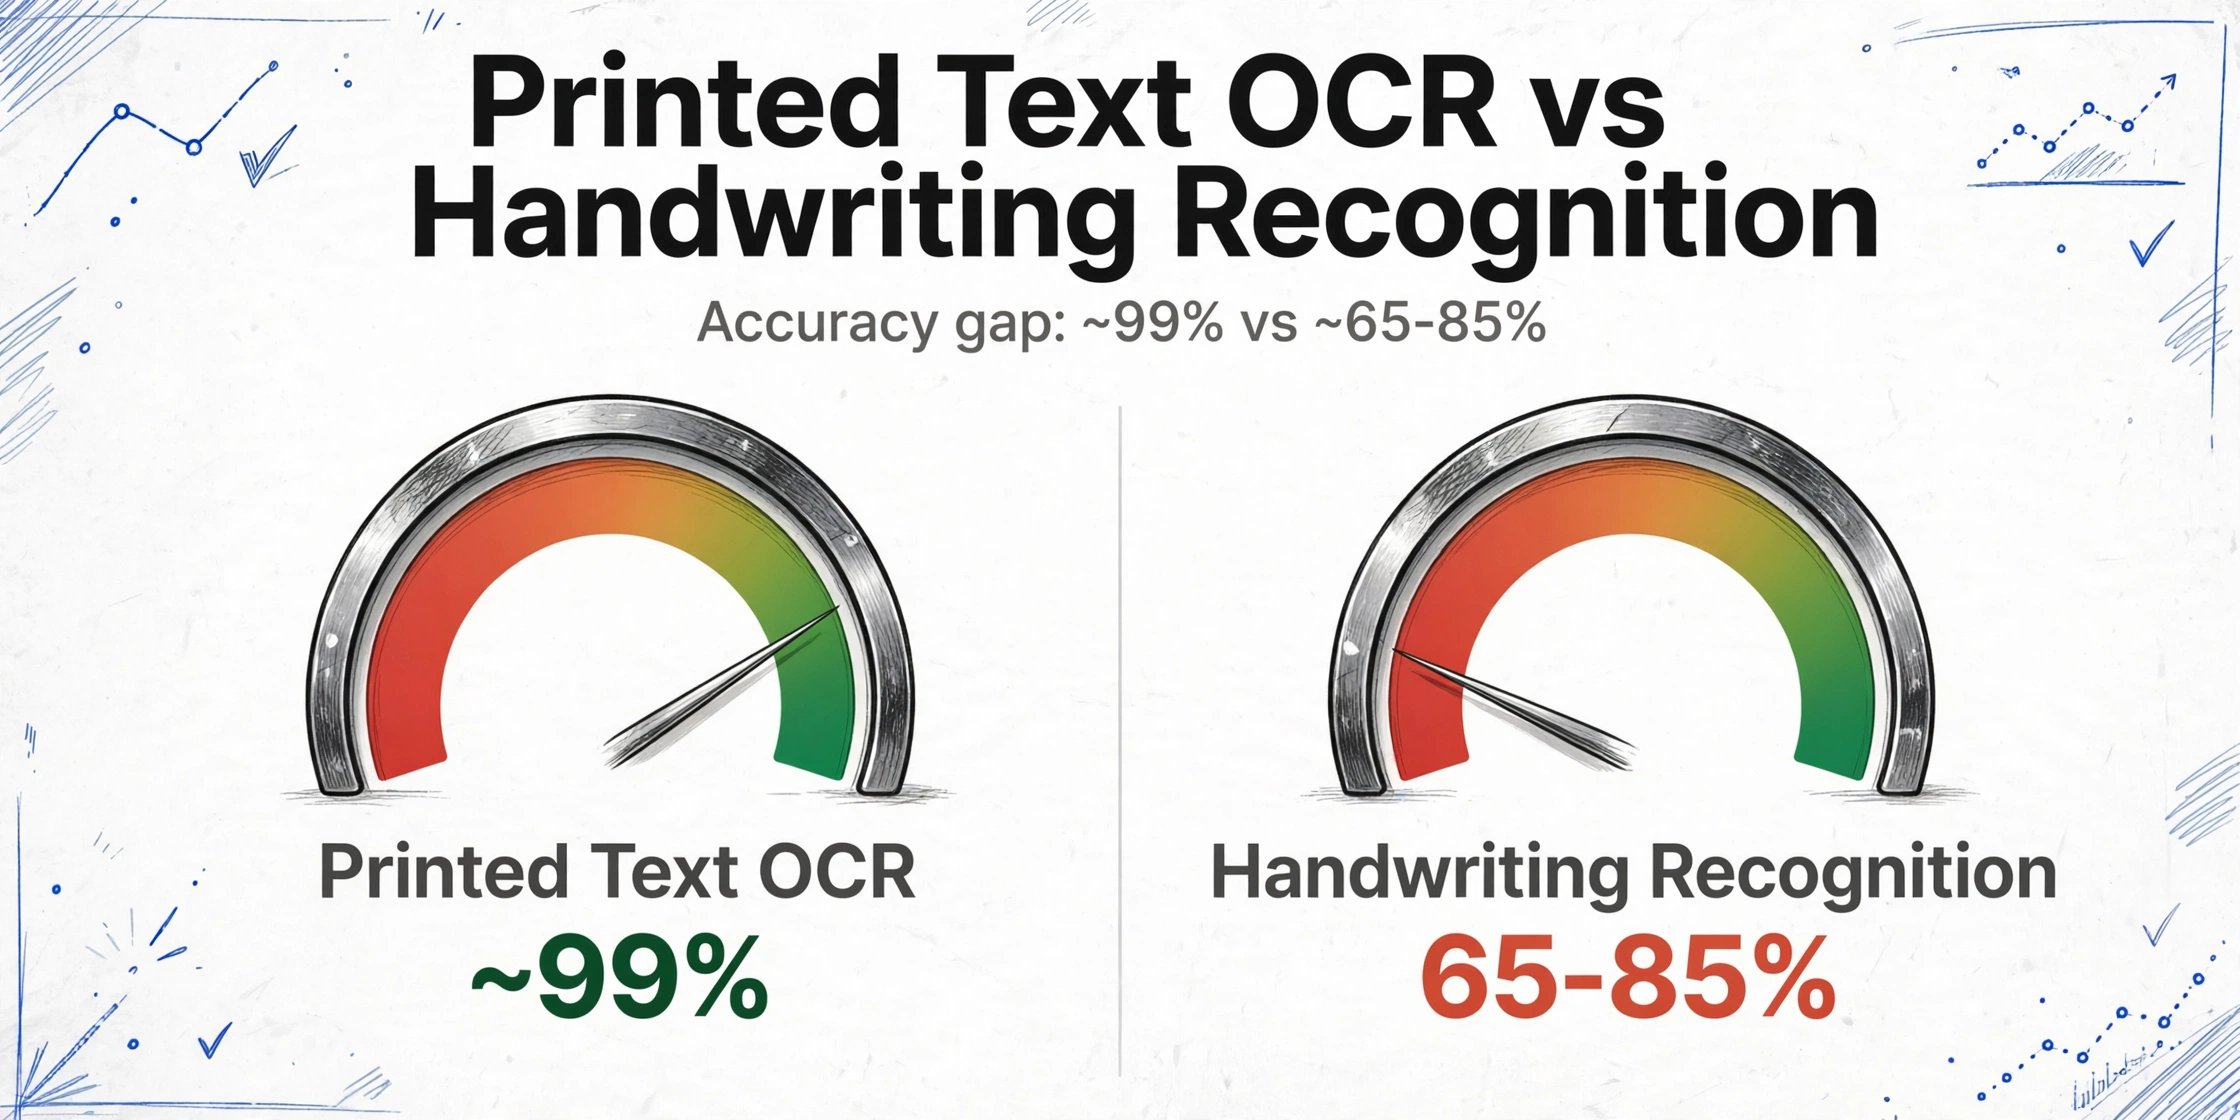
A diferença entre a precisão do OCR para texto impresso (~99%) e a precisão do reconhecimento de escrita manual (~65-85% para os melhores modelos de IA atuais em escrita manual desafiadora, segundo a revisão da comunidade r/computervision de 2025) não é um sinal de que o reconhecimento de escrita manual está quebrado. É um sinal de que o problema é fundamentalmente mais difícil. O reconhecimento de texto impresso é correspondência de caracteres. O reconhecimento de escrita manual é interpretação do comportamento humano — e o comportamento humano varia.
O que a Visão por IA Faz de Diferente — Ela Lê Significado, Não Formas
A mudança do OCR tradicional para modelos de visão de grande escala altera o mecanismo de correspondência de caracteres para compreensão contextual. Um modelo de visão não isola cada letra e a compara com uma biblioteca de formas. Ele observa a imagem inteira — o layout do formulário, o texto ao redor, os rótulos dos campos, o estilo da escrita manual — e interpreta o que o conteúdo significa.
Essa diferença fica mais evidente em situações ambíguas. O OCR tradicional vê um rabisco entre duas letras mais claras e ou adivinha um caractere ou retorna um espaço em branco com baixa confiança. Um modelo de visão vê o mesmo rabisco e entende pelo contexto: este é um campo de data, o rabisco está entre um "1" e uma "/", então provavelmente é um "5" ou um "3", dependendo da curva. Não é uma correspondência do rabisco com a forma de um "5". É entender que um formato de data contendo "1?/??/2025" torna "15" ou "13" a leitura mais provável, e "1&/??/2025" impossível.
Esse mesmo usuário do Reddit no r/OpenAI que ficou surpreso com a capacidade de reconhecimento de escrita manual do ChatGPT estava experimentando exatamente esse mecanismo. O ChatGPT não tem um módulo de OCR para escrita manual. Ele tem um modelo de visão que observa imagens e entende o que está representado — texto, objetos, contexto, relações. Quando lê escrita manual, está fazendo a mesma coisa que faz ao descrever uma fotografia: interpretar informações visuais com base no que faz sentido no mundo. A escrita manual é apenas mais um elemento visual a ser compreendido.
A diferença em uma frase: O OCR pergunta "essa forma corresponde ao caractere 'a' na minha biblioteca?" A Visão por IA pergunta "já que este é um campo de nome em um formulário médico, e a primeira letra parece um A maiúsculo, e o resto da palavra tem o padrão de forma de 'nderson' — o nome é Anderson." Um é correspondência de padrões. O outro é raciocínio.
O que a IA de escrita manual consegue fazer — e com o que ainda tem dificultades
A abordagem de visão por IA não torna o reconhecimento de escrita manual perfeito. Eleva o teto de precisão e muda os tipos de erros que ocorrem — mas ainda há limites reais. Ser honesto sobre eles importa mais que afirmar que o problema está resolvido.
| Tipo de escrita manual | Confiabilidade da IA | Por quê |
|---|---|---|
| Letra de imprenta clara (toda em maiúsculas, letras separadas) | Alta — precisão quase de impressão | Variação limitada; cada letra é distinta e padronizada |
| Imprenta/cursiva mistas (escritura manual real mais comum) | Boa — o contexto ajuda a resolver letras ambíguas | A maioria das letras é reconhecível; o contexto resolve o resto |
| Cursiva leve (letras conectadas, trazos claros) | Moderada — legible, mas com erros em pares de letras ambíguos | As conexões entre letras crian ambigüedad (rn vs. m, cl vs. d) |
| Cursiva pesada / script (fluida, estilizada) | Baixa — taxa de erro significativa | As formas das letras se afastan demasiado dos padrões reconhecibles; o contexto não pode compensar cada carácter |
| Escritura manual borrosa, desvanecida ou muito pequena | Baixa — similar à dificuldade humana | A degradação física da superfície de escrita obscurece os dados |
| Escritura manual em formulários (campos etiquetados, caixas de seleção) | Boa — a estrutura do formulário fornece contexto forte | Os rótulos guían a extração; a IA sabe "este campo é uma data" antes de ler a escrita manual |
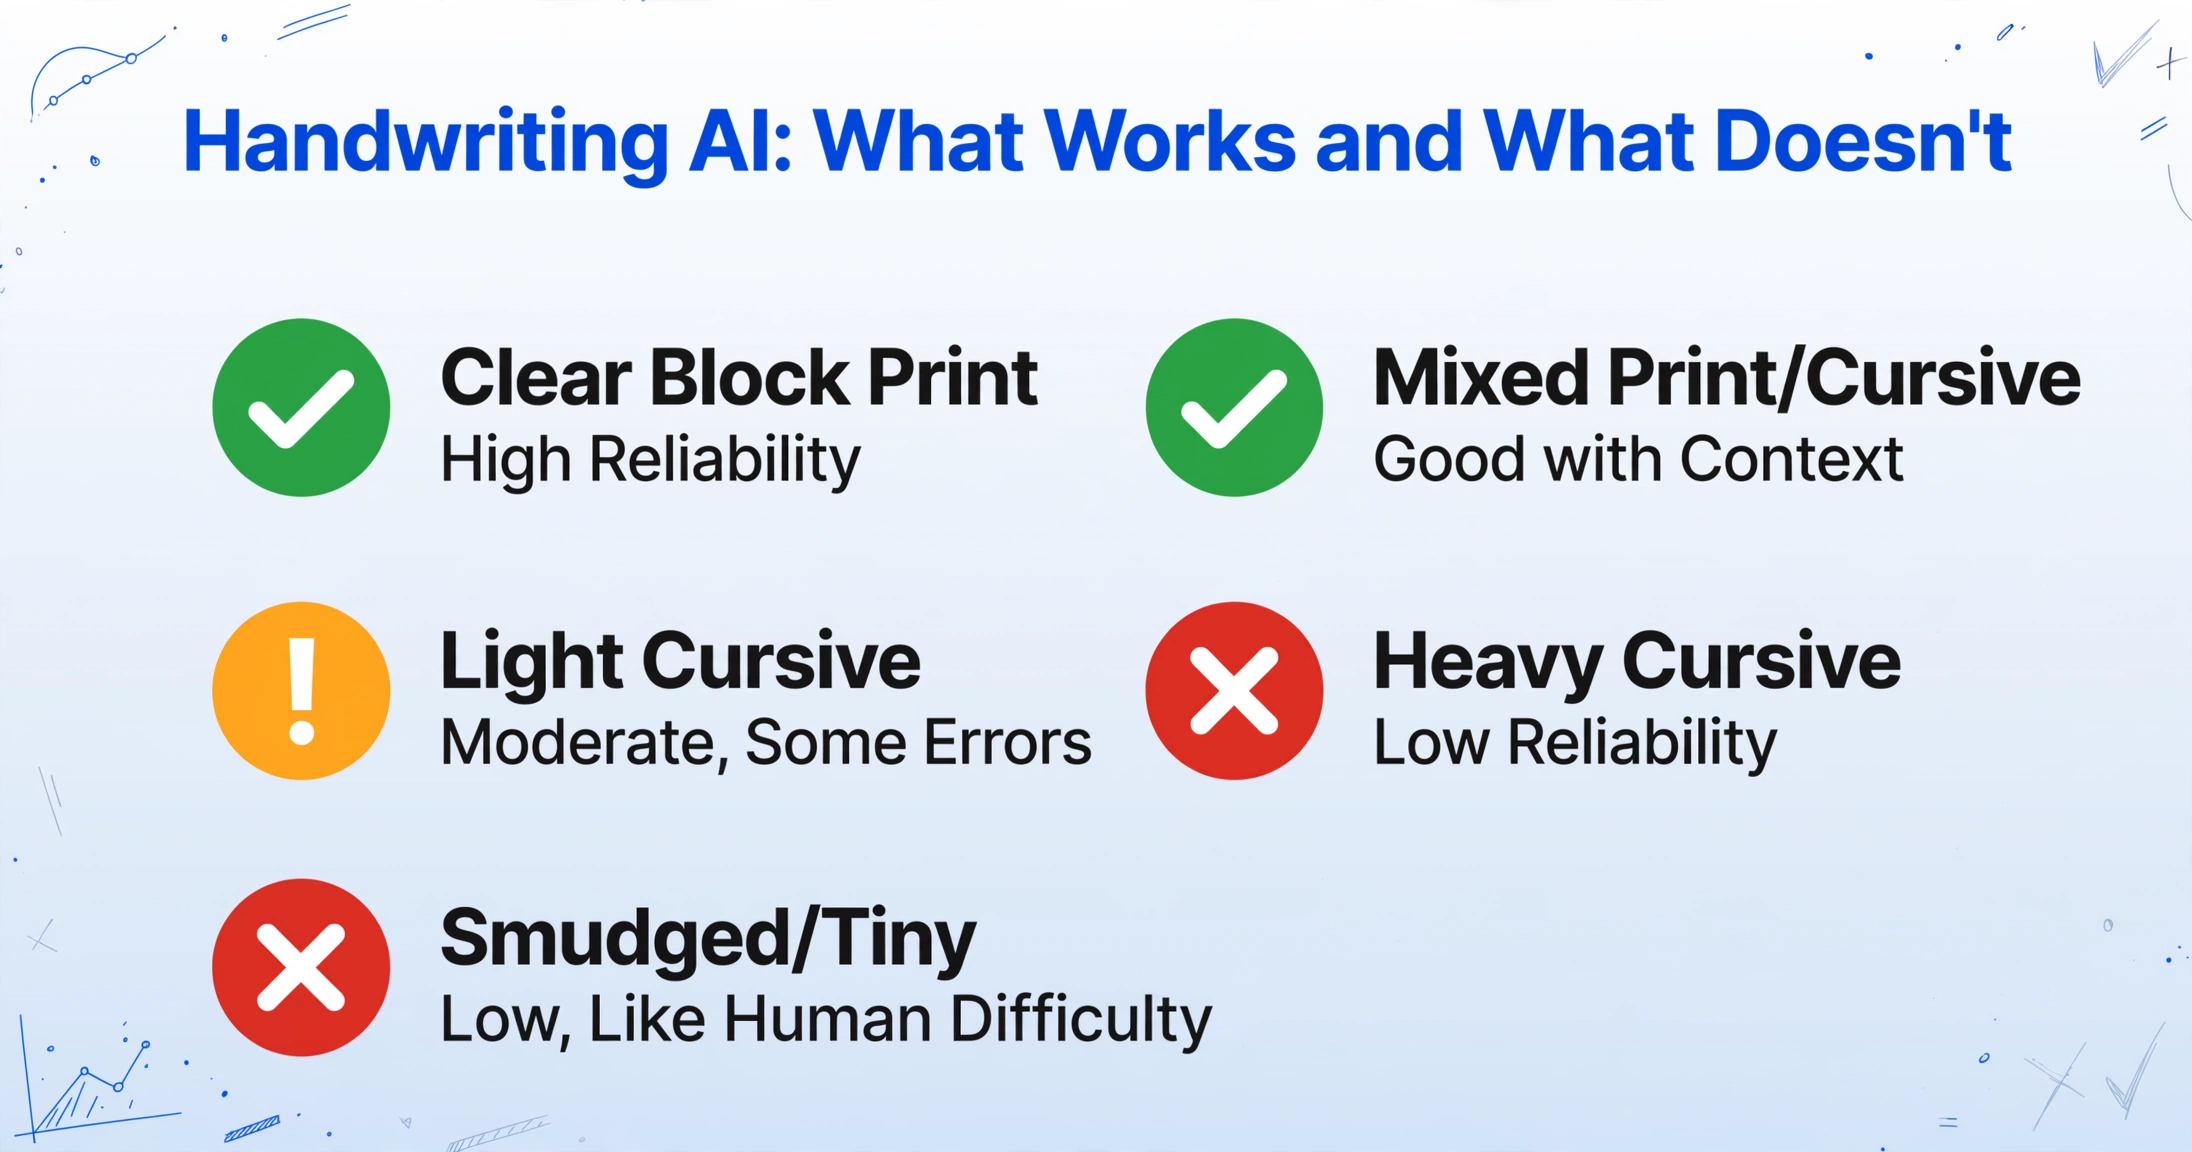
A conclusão não é "a IA de escrita manual funciona" ou "a IA de escrita manual não funciona". É "a IA de escrita manual funciona bem para a escrita que os humanos também podem ler de forma confiable — e tem dificultades com a mesma escrita com a que os humanos têm dificultades". O piso de precisão da IA está em torno do ponto onde um lector humano cuidadoso também se detendría e entrecerraría los ojos. Isso é uma capacidade significativa para fluxos de trabalho empresariales: cobre a maioria dos dados manuscritos que actualmente se reescriben manualmente, enquanto reconoce que os casos más difíciles ainda precisan revisión humana.
Para uma visión completa que cubre desde conceptos básicos até fluxos de trabalho de producción, consulte nosso guía definitiva para conversión de escritura manual a texto com IA. Se você trabalha com formulários que contienen caixas de seleção e campos de selección, aprenda como a IA lee formularios manuscritos e convierte selecciones de caixas de seleção em dados Excel estruturados.
Do Formulário Manuscrito ao Excel Estruturado — Três Etapas
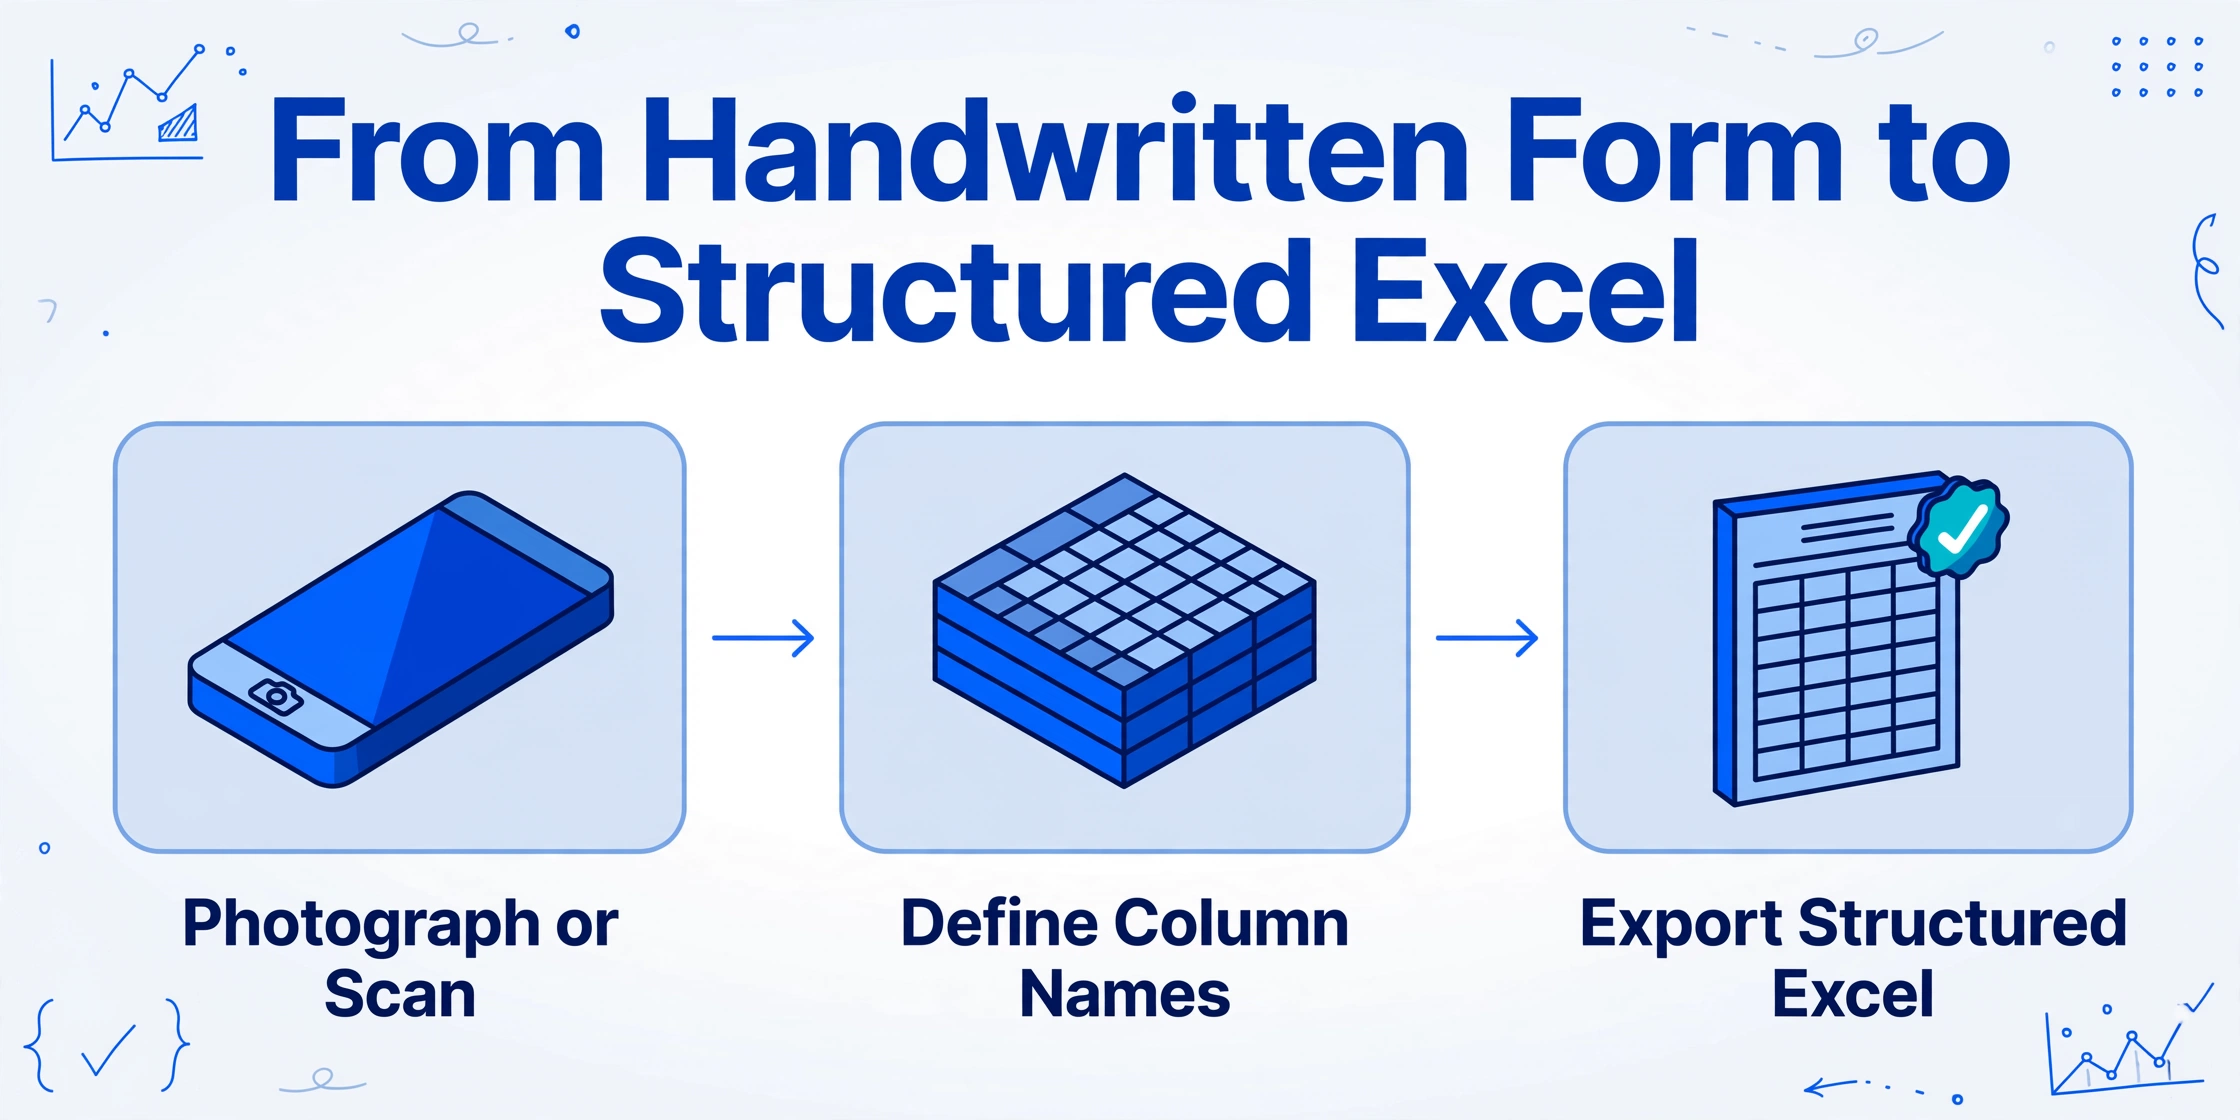
O mesmo mecanismo de extração de nomes de colunas que lida com documentos impressos se aplica a formulários manuscritos — com a vantagem adicional de que os rótulos dos formulários fornecem um contexto forte para a interpretação da IA. Quando o nome da coluna é "Patient Name" e o formulário tem um campo rotulado como "Name", a IA sabe que tipo de conteúdo procurar antes mesmo de começar a ler a caligrafia. O rótulo ancora a extração em significado, e a caligrafia se torna mais um sinal em um contexto já estruturado.
Uma clínica médica que recebe 30 formulários de admissão de pacientes manuscritos por dia definiria colunas como "Patient Name, DOB, Insurance ID, Chief Complaint, Referring Physician". Cada formulário é fotografado. O lote é enviado. A IA extrai os valores manuscritos em 30 linhas de dados estruturados. O funcionário que costumava gastar duas horas digitando esses formulários agora gasta 10 minutos verificando a saída da IA e corrigindo manualmente os 5-10% dos campos onde a caligrafia era genuinamente ambígua. Leia como a extração de nomes de colunas funciona em todos os tipos de documento →
Expectativa prática de precisão: Em formulários manuscritos limpos e estruturados com legibilidade razoável, espere que ~85-95% dos campos sejam extraídos corretamente na primeira passagem. Os 5-15% restantes precisarão de correção manual — mas verificar e corrigir é uma fração do tempo gasto redigitando tudo do zero. Para cada hora de digitação manual economizada, espere 5-10 minutos de trabalho de verificação.
Demonstração ao Vivo: Envie um Documento Manuscrito e Veja o Resultado
Teste a extração com qualquer documento que contenha escrita manual — um formulário, uma anotação, um recibo com entradas manuscritas.
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
Por que o ChatGPT lê escrita manual tão bem, mas o OCR do meu scanner não consegue?
O ChatGPT usa um modelo de visão de grande escala — ele "vê" a imagem inteira e a compreende contextualmente, da mesma forma que entende uma fotografia. O OCR integrado do seu scanner usa correspondência de padrões: ele isola cada caractere e compara sua forma a uma biblioteca de fontes impressas. A escrita manual não corresponde a nenhuma fonte, então a comparação em nível de caractere falha. O OCR do scanner não é uma tecnologia pior — é a tecnologia errada para o problema. Se você já usou o ChatGPT para ler escrita manual com sucesso, já experimentou a diferença entre correspondência de padrões e compreensão visual.
Qual é a diferença entre reconhecimento de escrita manual e verificação de assinatura?
O reconhecimento de escrita manual extrai o conteúdo textual de palavras escritas à mão — "o que isto diz?" A verificação de assinatura confirma a identidade do signatário — "esta é realmente a assinatura de João?" Estas são tarefas de IA diferentes. O sistema descrito neste artigo lida com a primeira: ler texto manuscrito para extração de dados. Ele não realiza análise forense de assinaturas. Para fluxos de trabalho documentais que exigem ambas (por exemplo, "extrair os dados do formulário E verificar a assinatura na parte inferior"), a extração e a verificação são processos separados.
Isso funciona com escrita manual em outros idiomas além do inglês?
O modelo de visão de grande escala suporta vários idiomas, incluindo escritas com caracteres não latinos. Escrita manual em chinês, japonês, árabe, cirílico e devanágari está dentro da capacidade do modelo. A precisão varia conforme o idioma e a complexidade da escrita — idiomas com formatos de caracteres mais distintos geralmente produzem melhores resultados. Formulários com idiomas mistos (por exemplo, um formulário médico com rótulos em inglês e respostas manuscritas em espanhol) são processados em uma única passagem de extração.
Como a extração de escrita manual se compara à contratação de um serviço de entrada de dados?
Um serviço de entrada de dados cobra por toque de tecla ou por formulário, com prazo de entrega medido em horas ou dias. A extração por IA processa um lote de formulários em minutos a uma fração do custo por formulário — mas produz um resultado que pode precisar de verificação humana em 5-15% dos campos. A comparação prática: para 100 formulários, um serviço de entrada de dados custa $X e leva Y horas com precisão quase perfeita. A extração por IA custa uma fração de $X e leva menos de 10 minutos, com a contrapartida de que você gastará 15-30 minutos verificando os campos incertos. Para a maioria das operações, a economia de tempo justifica o pequeno esforço de verificação. Para formulários onde 100% de precisão é inegociável e nenhuma etapa de revisão humana é aceitável, um serviço de entrada de dados continua sendo a opção mais segura.
Ele consegue distinguir entre escrita manual e texto impresso na mesma página?
Sim. A IA reconhece ambos os formatos e os extrai para a mesma saída estruturada. Um formulário com rótulos impressos, campos digitados e anotações manuscritas nas margens será processado em uma única passada — o texto impresso recebe extração padrão, o conteúdo manuscrito recebe interpretação contextual. O mecanismo de nomes de colunas orienta quais valores extrair, independentemente do formato.
Para um fluxo de trabalho dedicado de conversão de escrita manual para texto com IA, use nossa ferramenta específica que lê campos manuscritos, caixas de seleção e anotações, gerando saída em Excel estruturado — sem necessidade de modelos.