Warum herkömmliche OCR bei Handschrift versagt
Und wie KI-Visionmodelle es richtig machen
Ein Reddit-Nutzer auf r/OpenAI entdeckte etwas Überraschendes: „ChatGPT leistet bei solchen Dingen erstaunliche Arbeit. Ich nutze es ständig, um Handgeschriebenes in Text umzuwandeln und sogar um diese Texte zu übersetzen." Sie nutzten kein spezialisiertes Handschriftenerkennungstool, sondern ein allgemeines Sprachmodell – sie luden ein Foto mit handgeschriebenem Text hoch und erhielten eine saubere Transkription. Auf r/computervision führen Nutzer jährliche Überprüfungen von Handschrift-OCR-Tools durch und kommen stets zum selben Ergebnis: Spezialisierte Handschriftenerkennung übertrifft allgemeine OCR, aber KI-Modelle, die Kontext verstehen, holen schnell auf. Dieser Artikel erklärt, warum Standard-OCR bei Handschrift scheitert, was sich ändert, wenn Vision-KI ins Spiel kommt, und wo die ehrlichen Grenzen noch liegen.
Die wichtigsten Erkenntnisse
- 99 % Genauigkeit bei Druckschrift gegenüber 65–85 % bei Handschrift sind kein Qualitätsmangel – es ist ein Kategorienfehler: OCR (Optische Zeichenerkennung) wurde entwickelt, um Zeichenbilder mit einer Schriftartenbibliothek abzugleichen, und menschliche Handschrift hat keine Schriftart zum Abgleichen.
- Anders als OCR liest Vision-KI das gesamte Formular – Beschriftungen, Layout und Handschrift – als ein zusammenhängendes Bild und nutzt dabei Kontext, wie Sie es tun würden: Wenn sich eine Kritzelei in einem Datumsfeld zwischen „1" und „/" befindet, muss es eine Ziffer sein, kein willkürliches Zeichen.
- Mit ImageToTable.ai wird aus dem Sachbearbeiter, der 30 handschriftliche Formulare in zwei Stunden abtippt, ein Prüfer, der markierte Felder in 10 Minuten verifiziert – denn die Spaltennamen-Extraktion verankert die KI in der Bedeutung, bevor sie Ihre Handschrift überhaupt liest.
Handschrift — die letzte uneroberte Mauer der OCR
Die Erkennung von gedrucktem Text ist ein gelöstes Problem. Moderne OCR erreicht bei sauberen Schriftarten eine nahezu perfekte Genauigkeit, und die extraktionsbasierte Verarbeitung von Vorlagen bewältigt strukturierte Formulare mit vorhersehbaren Layouts. Der globale Markt für Handschriftenerkennung — 2024 auf 1,28 Milliarden US-Dollar geschätzt und bis 2032 voraussichtlich auf 3,29 Milliarden US-Dollar anwachsend — existiert genau deshalb, weil sich die Lösung für gedruckten Text nicht übertragen lässt. Handschrift ist das Eingabeformat, das Papier in Branchen am Leben hält, die ansonsten schon vor Jahrzehnten digitalisiert hätten.
Das Gesundheitswesen basiert auf handschriftlichen klinischen Notizen und Rezepten. Versicherungen verarbeiten handschriftliche Antragsformulare — ein Mitarbeiter in der Fertigung fragt ganz direkt: „Wer nutzt Papier, um wichtige Daten zu erfassen? Konkret: Formulare, die von einem Menschen mit Stift und Papier ausgefüllt werden. Maschinen, die mit keinem System verbunden sind." Logistikunternehmen bearbeiten Zustellbestätigungen mit handschriftlichen Unterschriften und Notizen. Außendiensttechniker füllen Papierarbeitsaufträge aus, weil das Tippen auf dem Telefon mit Handschuhen im Regen schlimmer ist als Klemmbrett und Stift. Die Daten existieren auf Papier. Um sie in ein System zu bringen, braucht es entweder eine Person, die sie abtippt, oder eine KI, die sie lesen kann.
Ein Review von Handschrift-OCR-Tools aus dem Jahr 2025 auf r/computervision fasste den Stand der Technik zusammen: „Spezialisierte Handschrift-OCR-Lösungen übertreffen allgemeine OCR bei realen handschriftlichen Dokumenten durchweg." Das sind gute Nachrichten für Organisationen mit Budget und Integrationskapazität für dedizierte Plattformen zur Handschriftenerkennung. Schlechte Nachrichten sind es für den Buchhalter, der jeden Freitag ein Dutzend handschriftlicher Belege erhält und die Daten bis Montag in einer Tabellenkalkulation braucht. Die spezialisierten Tools existieren. Die allgemeinen Tools funktionieren nicht gut genug. Und in der Lücke dazwischen liegen die meisten handschriftlichen Daten — unverarbeitet, nicht durchsuchbar, manuell abgetippt.
Das Problem ist nicht „unleserliche" Handschrift. Es ist, dass OCR Sprache nie verstanden hat.
Traditionelle OCR funktioniert, indem sie visuelle Muster mit einer Bibliothek bekannter Zeichenformen abgleicht. Zeigen Sie ihr ein sauberes, gedrucktes „a" in Helvetica, und sie gleicht es mit hoher Sicherheit ab. Zeigen Sie ihr zehn verschiedene handschriftliche „a" von zehn verschiedenen Personen – unterschiedlich geneigt, unterschiedlich geschlungen, mit dem nächsten Buchstaben verbunden, in ein enges Formularfeld gequetscht – und der Mustererkennungsansatz scheitert. Es gibt keine „korrekte" Form für ein handschriftliches „a". Die OCR-Engine weiß nicht, dass alle zehn Variationen denselben Buchstaben darstellen. Sie sieht zehn verschiedene Formen und rät.
Das ist die grundlegende Diskrepanz. OCR wurde für Schriftarten entwickelt – feste Zeichensätze, bei denen jedes „a" wie jedes andere „a" in derselben Schriftart aussieht. Handschrift hat keine Schriftart. Sie hat individuelle motorische Muster, Schreibgeschwindigkeit, Stiftdruck, Oberflächenreibung und die Stimmung des Schreibers um 16:55 Uhr an einem Freitag. Die Variationsbreite ist unendlich. Ein Mustererkennungsalgorithmus, der bei Druck funktioniert, steht bei Handschrift vor einem kombinatorisch anderen Problem.
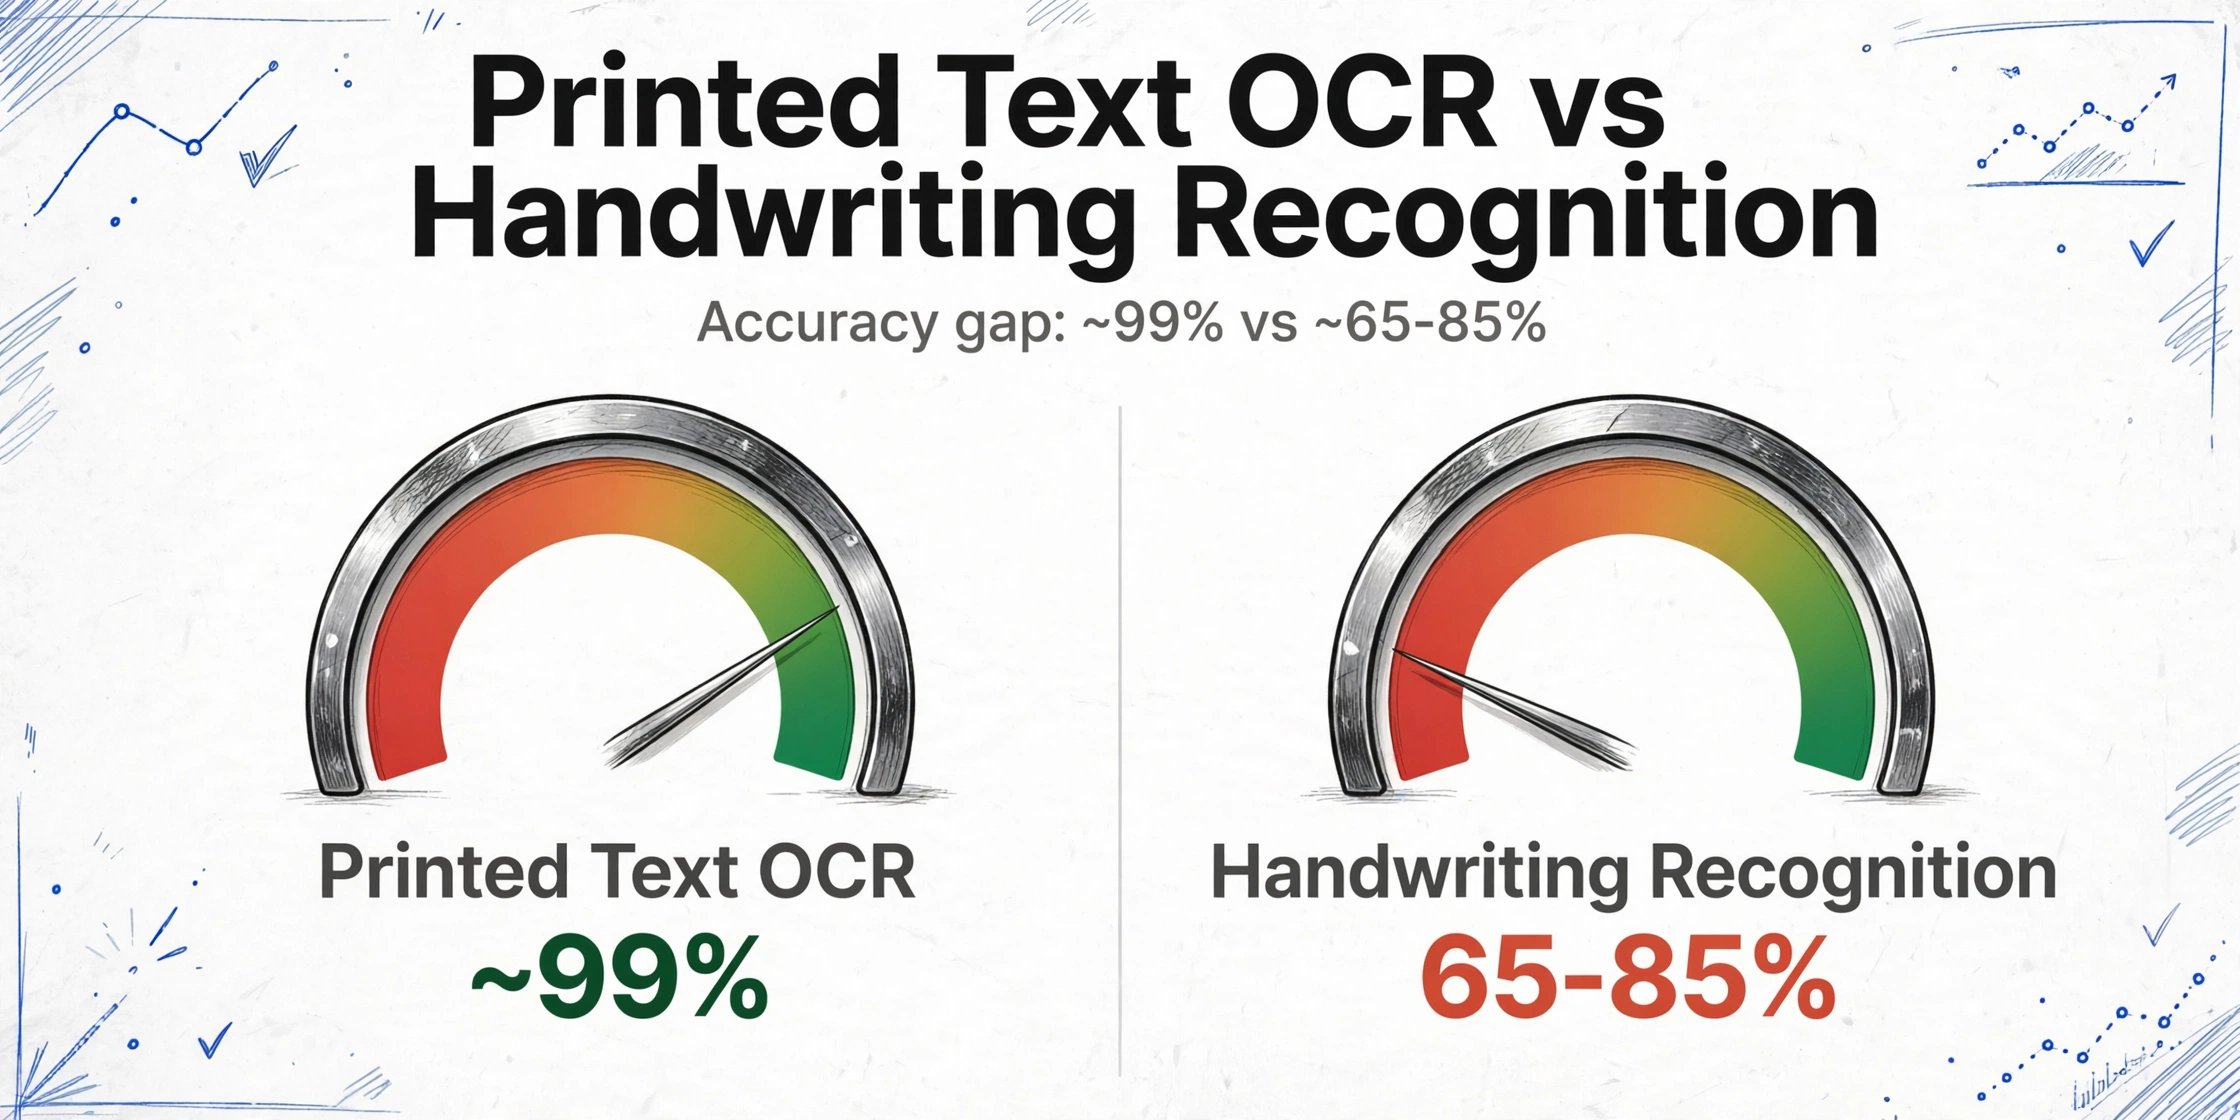
Die Lücke zwischen der Genauigkeit von OCR für gedruckten Text (~99 %) und der Handschriftenerkennung (~65–85 % für die besten aktuellen KI-Modelle bei anspruchsvoller Handschrift, laut der Community-Überprüfung von r/computervision 2025) ist kein Zeichen dafür, dass die Handschriftenerkennung defekt ist. Es ist ein Zeichen dafür, dass das Problem grundlegend schwieriger ist. Druckerkennung ist Zeichenabgleich. Handschriftenerkennung ist die Interpretation menschlichen Verhaltens – und menschliches Verhalten variiert.
Was Vision-KI anders macht – sie liest Bedeutung, nicht Formen
Der Wandel von traditioneller OCR zu Vision-Großmodellen verändert den Mechanismus von Zeichenabgleich zu kontextuellem Verständnis. Ein Visionmodell isoliert nicht jeden Buchstaben und vergleicht ihn mit einer Formbibliothek. Es betrachtet das gesamte Bild – das Formularlayout, den umgebenden Text, die Feldbeschriftungen, den handschriftlichen Stil – und interpretiert, was der Inhalt bedeutet.
Dieser Unterschied zeigt sich am deutlichsten in mehrdeutigen Situationen. Traditionelle OCR sieht ein Gekritzel zwischen zwei klareren Buchstaben und rät entweder ein Zeichen oder liefert eine leere Stelle mit geringer Konfidenz. Ein Visionmodell sieht dasselbe Gekritzel und versteht aus dem Kontext: Dies ist ein Datumsfeld, das Gekritzel befindet sich zwischen einer „1" und einem „/", also ist es wahrscheinlich eine „5" oder eine „3", je nach Kurve. Es gleicht das Gekritzel nicht mit einer „5"-Form ab. Es versteht, dass ein Datumsformat mit „1?/??/2025" „15" oder „13" als wahrscheinlichste Lesart nahelegt und „1&/??/2025" unmöglich macht.
Derselbe Reddit-Nutzer auf r/OpenAI, der von der Handschriftenerkennung von ChatGPT überrascht war, erlebte genau diesen Mechanismus. ChatGPT hat kein Handschrift-OCR-Modul. Es hat ein Visionmodell, das Bilder betrachtet und versteht, was dargestellt ist – Text, Objekte, Kontext, Beziehungen. Wenn es Handschrift liest, tut es dasselbe, wie wenn es ein Foto beschreibt: visuelle Informationen interpretieren, basierend darauf, was in der Welt Sinn ergibt. Die Handschrift ist nur ein weiteres visuelles Element, das es zu verstehen gilt.
Der Unterschied in einem Satz: OCR fragt: „Passt diese Form zum Zeichen ‚a' in meiner Bibliothek?" Vision-KI fragt: „Da dies ein Namensfeld auf einem medizinischen Formular ist, der erste Buchstabe wie ein großes A aussieht und der Rest des Wortes das Formmuster von ‚nderson' hat – der Name ist Anderson." Das eine ist Mustererkennung. Das andere ist Denken.
Was Handschrift-KI leisten kann – und wo sie weiterhin an ihre Grenzen stößt
Der KI-Vision-Ansatz macht die Handschriftenerkennung nicht perfekt. Er verschiebt die Genauigkeitsgrenze und verändert die Art der auftretenden Fehler – aber es gibt weiterhin echte Grenzen. Ehrlich darüber zu sein, ist wichtiger, als zu behaupten, das Problem sei gelöst.
| Handschrifttyp | KI-Zuverlässigkeit | Warum |
|---|---|---|
| Deutliche Druckschrift (Großbuchstaben, getrennte Buchstaben) | Hoch – fast druckgenau | Geringe Variation; jeder Buchstabe ist klar und standardisiert |
| Gemischte Druck-/Schreibschrift (häufigste Handschrift im Alltag) | Gut – Kontext hilft bei mehrdeutigen Buchstaben | Die meisten Buchstaben sind erkennbar; der Kontext klärt den Rest |
| Leichte Schreibschrift (verbundene Buchstaben, klare Striche) | Mäßig – lesbar, aber mit Fehlern bei mehrdeutigen Buchstabenpaaren | Buchstabenverbindungen erzeugen Mehrdeutigkeit (rn vs. m, cl vs. d) |
| Starke Schreibschrift / Schnörkelschrift (fließend, stilisiert) | Niedrig – erhebliche Fehlerquote | Buchstabenformen weichen zu stark von erkennbaren Mustern ab; der Kontext kann nicht jedes Zeichen kompensieren |
| Verschmierte, verblasste oder winzige Handschrift | Niedrig – ähnlich wie bei menschlichen Schwierigkeiten | Physische Beeinträchtigung der Schreibfläche verschleiert die Daten |
| Handschrift auf Formularen (beschriftete Felder, Kontrollkästchen) | Gut – die Formularstruktur bietet starken Kontext | Beschriftungen leiten die Extraktion; die KI weiß, „dieses Feld ist ein Datum“, bevor sie die Handschrift liest |
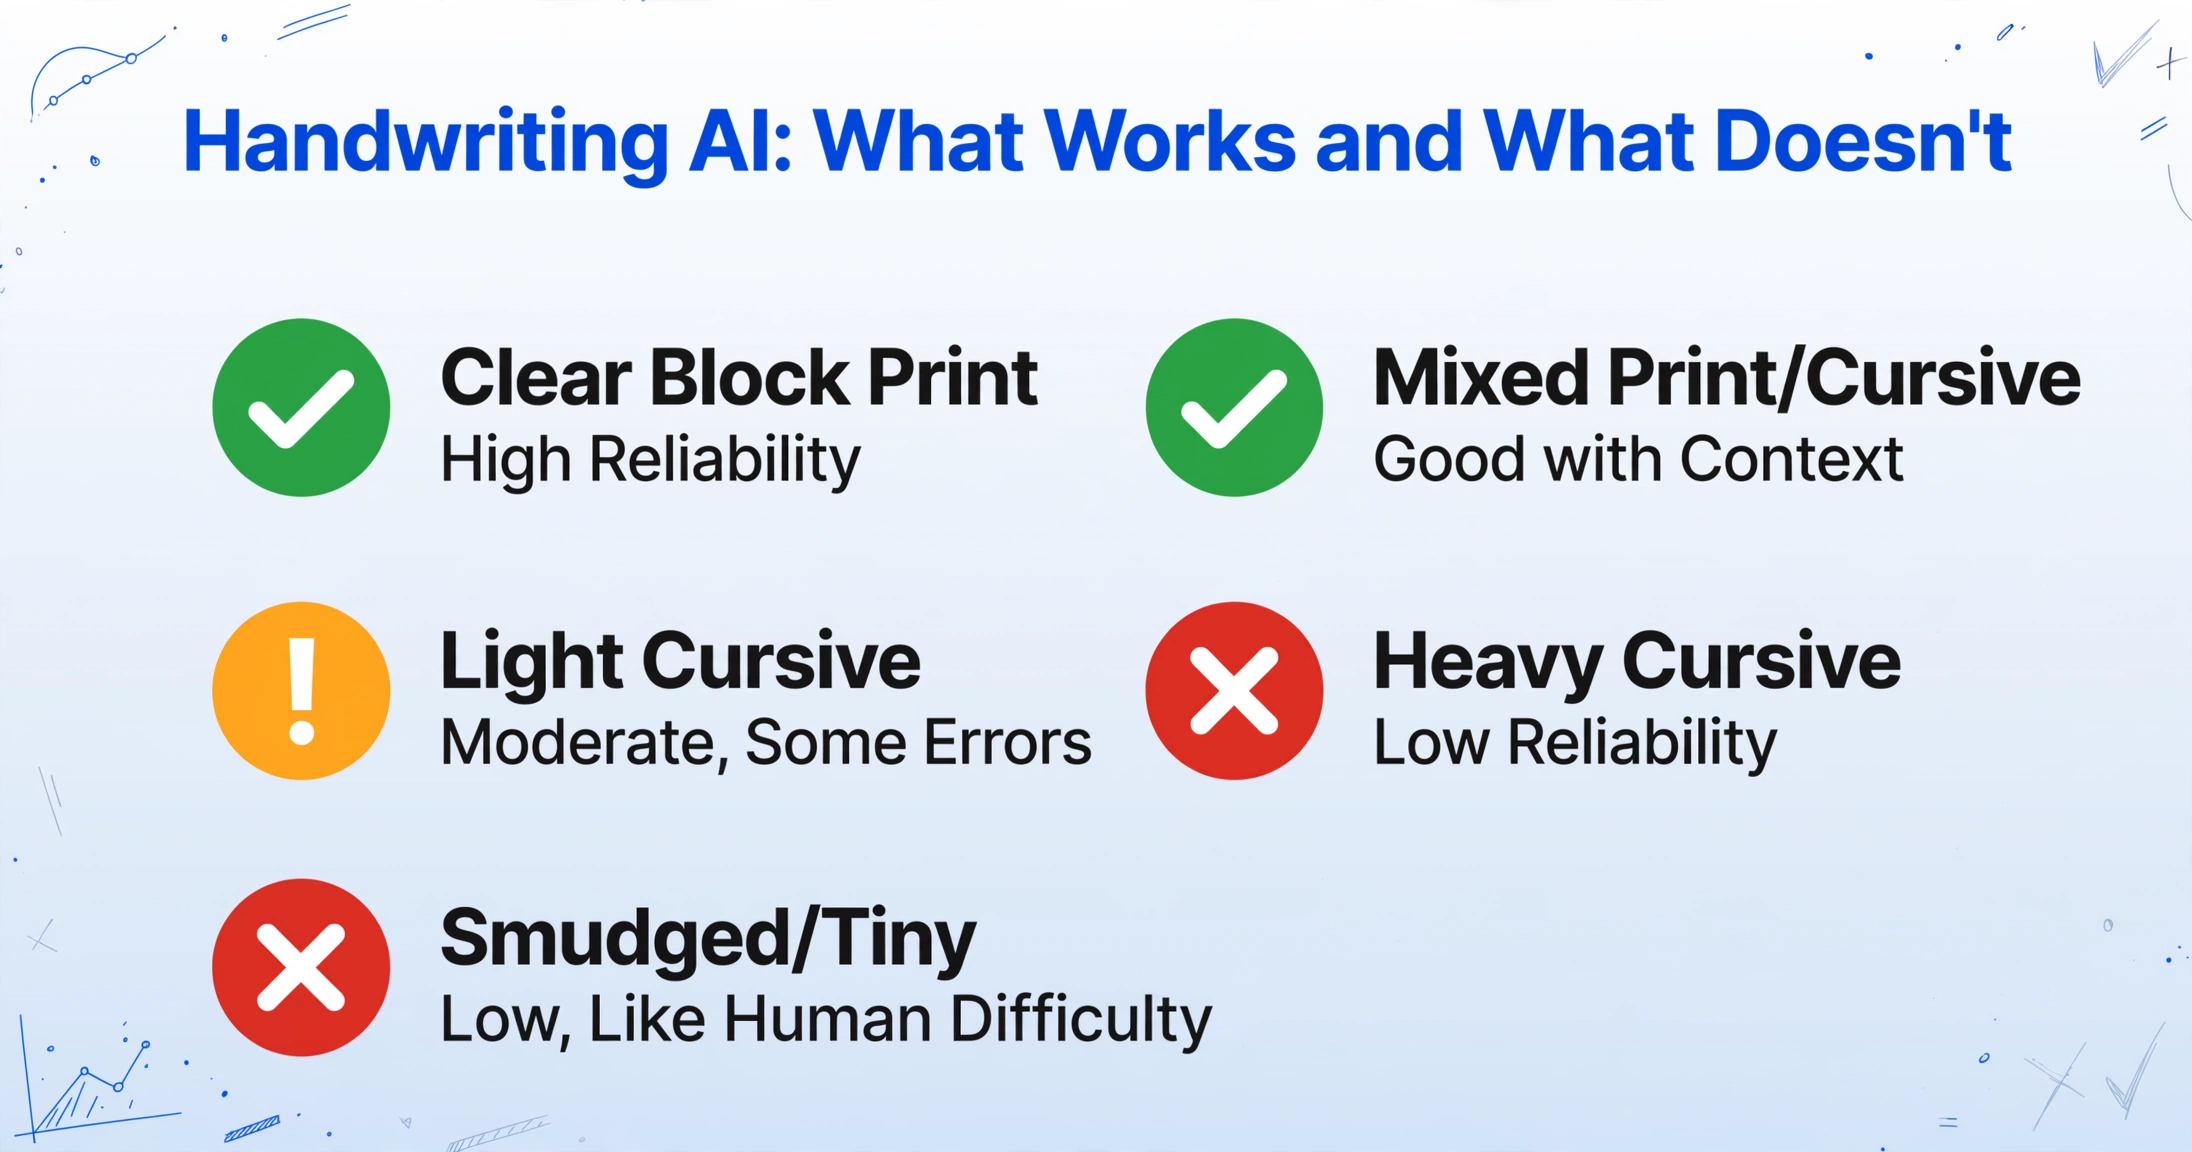
Die Schlussfolgerung ist nicht „Handschrift-KI funktioniert“ oder „Handschrift-KI funktioniert nicht“. Es ist: „Handschrift-KI funktioniert gut bei Handschrift, die auch Menschen zuverlässig lesen können – und hat Schwierigkeiten bei derselben Handschrift, mit der auch Menschen kämpfen.“ Die Genauigkeitsgrenze der KI liegt etwa dort, wo auch ein sorgfältiger menschlicher Leser langsamer werden und blinzeln würde. Das ist eine bedeutende Fähigkeit für Geschäftsabläufe: Sie deckt den Großteil handschriftlicher Daten ab, die derzeit manuell abgetippt werden, während sie anerkennt, dass die schwierigsten Fälle weiterhin menschliche Überprüfung benötigen.
Für einen vollständigen Überblick, der alles von Grundkonzepten bis zu Produktionsabläufen abdeckt, lesen Sie unseren ultimativen Leitfaden zur KI-Handschrift-zu-Text-Konvertierung. Wenn Sie mit Formularen arbeiten, die Kontrollkästchen und Auswahlfelder enthalten, erfahren Sie, wie KI handschriftliche Formulare liest und Kontrollkästchen-Auswahlen in strukturierte Excel-Daten umwandelt.
Vom handschriftlichen Formular zur strukturierten Excel — in drei Schritten
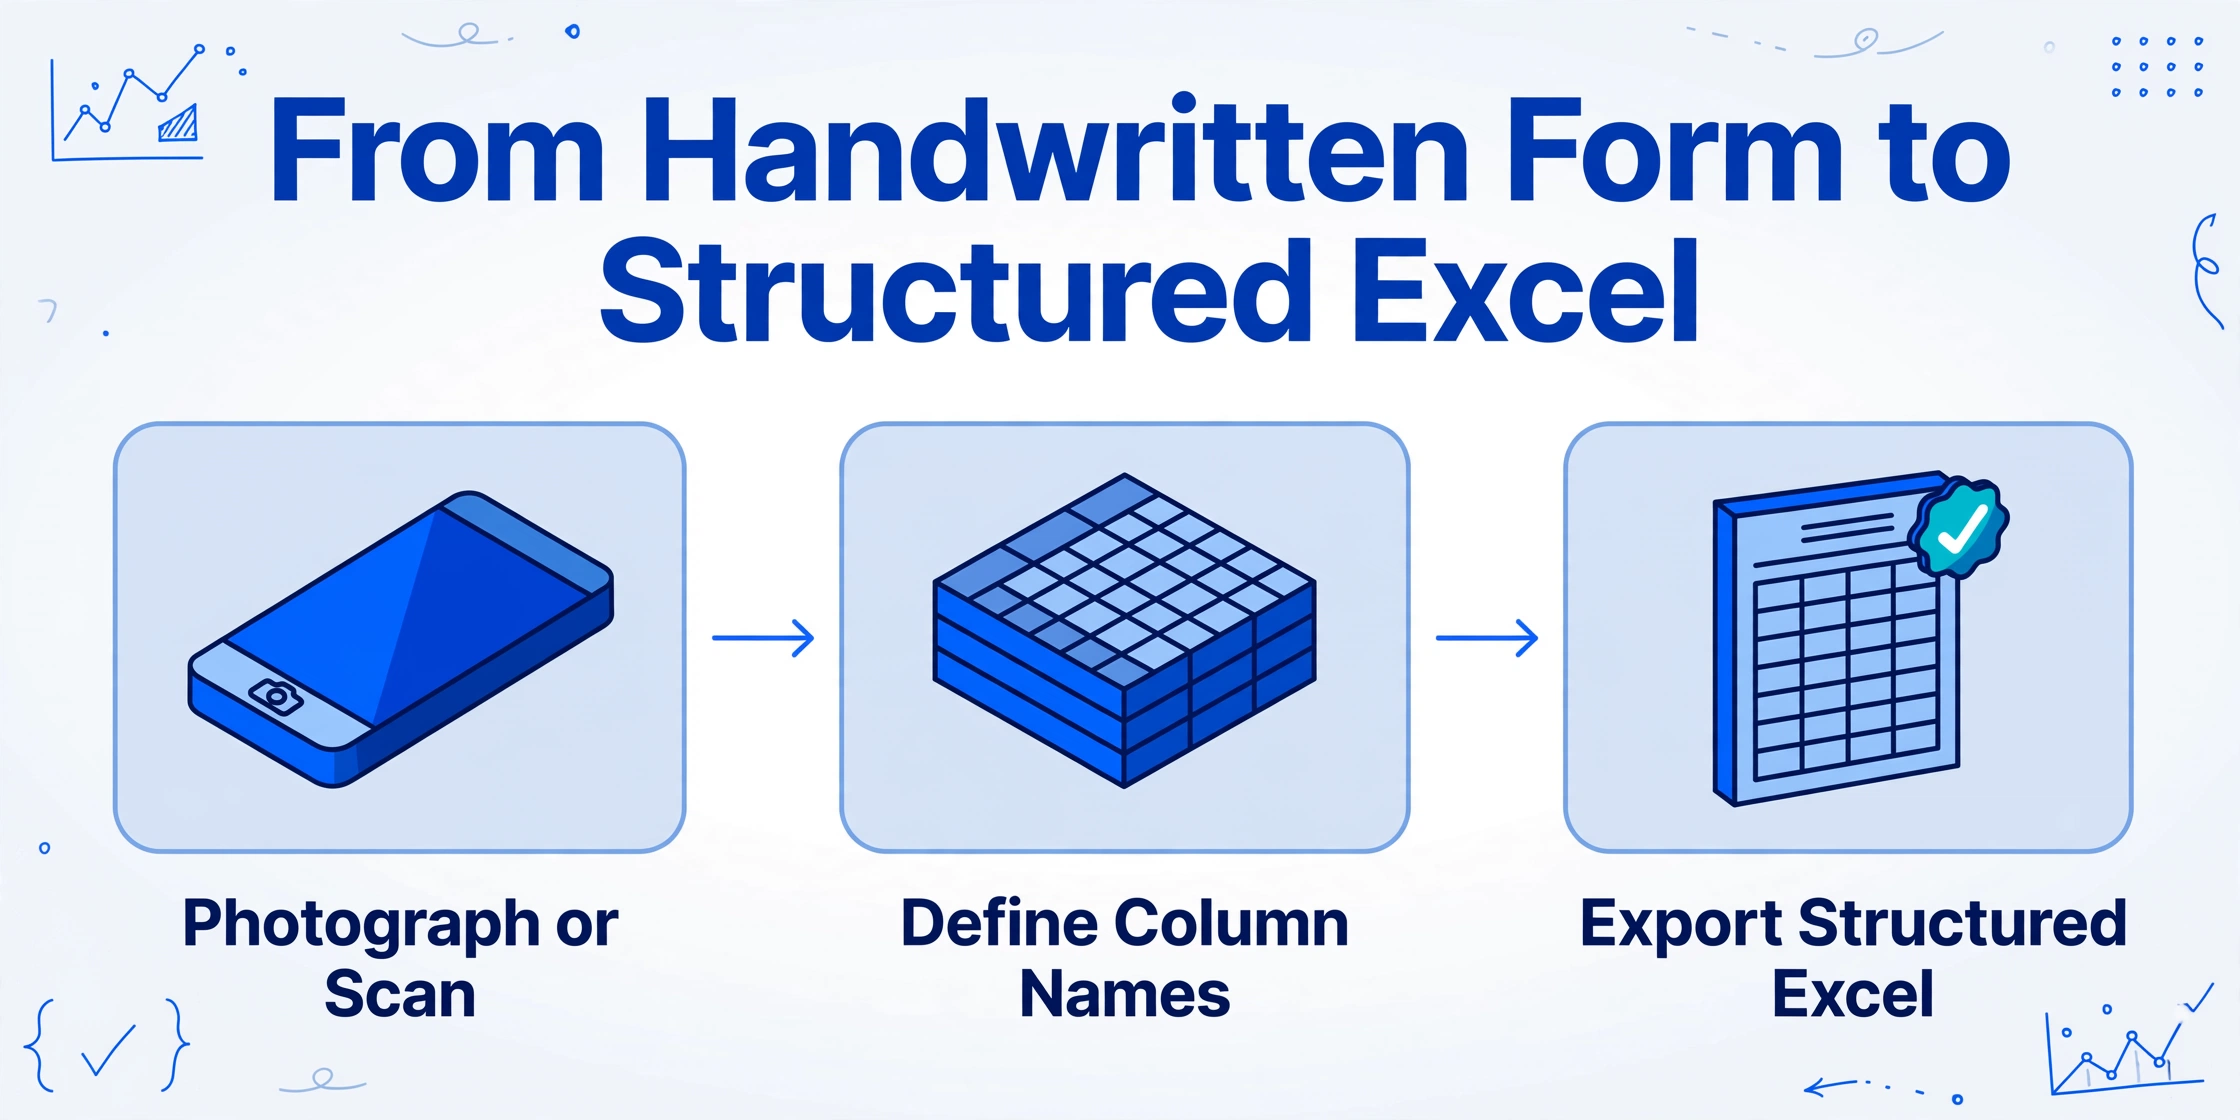
Derselbe Mechanismus zur Spaltennamen-Extraktion, der auch bei gedruckten Dokumenten zum Einsatz kommt, gilt für handschriftliche Formulare — mit dem zusätzlichen Vorteil, dass Formularbeschriftungen dem KI-Modell einen starken Kontext für die Interpretation liefern. Wenn die Spalte „Patient Name" heißt und das Formular ein Feld mit der Beschriftung „Name" aufweist, weiß die KI, nach welcher Art von Inhalt sie suchen muss, bevor sie überhaupt mit dem Lesen der Handschrift beginnt. Die Beschriftung verankert die Extraktion in der Bedeutung, und die Handschrift wird zu einem weiteren Signal in einem bereits strukturierten Kontext.
Eine Arztpraxis, die täglich 30 handschriftliche Patientenaufnahmeformulare erhält, würde Spalten wie „Patient Name, DOB, Insurance ID, Chief Complaint, Referring Physician" definieren. Jedes Formular wird fotografiert. Der Batch wird hochgeladen. Die KI extrahiert die handschriftlichen Werte in 30 Zeilen strukturierter Daten. Der Angestellte, der früher zwei Stunden mit dem Abtippen dieser Formulare verbrachte, benötigt nun 10 Minuten, um die Ausgabe der KI zu überprüfen und die 5-10 % der Felder manuell zu korrigieren, bei denen die Handschrift wirklich mehrdeutig war. Erfahren Sie, wie die Spaltennamen-Extraktion bei allen Dokumenttypen funktioniert →
Realistische Genauigkeitserwartung: Bei sauberen, strukturierten handschriftlichen Formularen mit angemessener Lesbarkeit können Sie davon ausgehen, dass beim ersten Durchlauf etwa 85-95 % der Felder korrekt extrahiert werden. Die restlichen 5-15 % müssen manuell korrigiert werden — aber das Überprüfen und Korrigieren dauert nur einen Bruchteil der Zeit, die das vollständige Neuabtippen in Anspruch nehmen würde. Für jede eingesparte Stunde manueller Eingabe sollten Sie mit 5-10 Minuten Überprüfungsaufwand rechnen.
Live-Demo: Laden Sie ein handschriftliches Dokument hoch und sehen Sie das Ergebnis
Testen Sie die Extraktion mit einem beliebigen Dokument mit Handschrift – einem Formular, einer Notiz, einer Quittung mit handschriftlichen Einträgen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Warum kann ChatGPT Handschrift so gut lesen, aber die OCR meines Scanners nicht?
ChatGPT verwendet ein Vision-Großmodell – es „sieht" das gesamte Bild und versteht es kontextuell, genauso wie es ein Foto versteht. Die integrierte OCR Ihres Scanners verwendet Mustererkennung: Sie isoliert jedes Zeichen und vergleicht seine Form mit einer Bibliothek gedruckter Schriftarten. Handschrift entspricht keiner Schriftart, daher schlägt der Vergleich auf Zeichenebene fehl. Die OCR des Scanners ist keine schlechtere Technologie – sie ist die falsche Technologie für das Problem. Wenn Sie ChatGPT bereits erfolgreich zum Lesen von Handschrift verwendet haben, haben Sie den Unterschied zwischen Mustererkennung und visuellem Verständnis bereits erlebt.
Was ist der Unterschied zwischen Handschriftenerkennung und Signaturverifizierung?
Die Handschriftenerkennung extrahiert den textlichen Inhalt handschriftlicher Wörter – „Was steht hier?" Die Signaturverifizierung bestätigt die Identität des Unterzeichners – „Ist das wirklich Johns Unterschrift?" Dies sind unterschiedliche KI-Aufgaben. Das in diesem Artikel beschriebene System übernimmt die erste: das Lesen handschriftlicher Texte zur Datenextraktion. Es führt keine forensische Signaturanalyse durch. Für Dokumenten-Workflows, die beides erfordern (z. B. „Formulardaten extrahieren UND die Unterschrift unten verifizieren"), sind Extraktion und Verifizierung getrennte Prozesse.
Funktioniert das auch mit Handschrift in anderen Sprachen als Englisch?
Das Vision-Großmodell unterstützt mehrere Sprachen, einschließlich Schriften mit nicht-lateinischen Zeichen. Chinesische, japanische, arabische, kyrillische und Devanagari-Handschrift liegen alle im Leistungsbereich des Modells. Die Genauigkeit variiert je nach Sprache und Schriftkomplexität – Sprachen mit ausgeprägteren Zeichenformen liefern im Allgemeinen bessere Ergebnisse. Gemischtsprachige Formulare (z. B. ein medizinisches Formular mit englischen Beschriftungen und spanischen handschriftlichen Antworten) werden in einem einzigen Extraktionsdurchgang verarbeitet.
Wie schneidet die Handschrift-Extraktion im Vergleich zur Beauftragung eines Datenerfassungsdienstes ab?
Ein Datenerfassungsdienst berechnet pro Tastendruck oder pro Formular, mit Bearbeitungszeiten in Stunden oder Tagen. KI-Extraktion verarbeitet einen Stapel von Formularen in Minuten zu einem Bruchteil der Kosten pro Formular – erzeugt jedoch ein Ergebnis, das für 5–15 % der Felder eine menschliche Überprüfung erfordern kann. Der praktische Vergleich: Für 100 Formulare kostet ein Datenerfassungsdienst X € und benötigt Y Stunden bei nahezu perfekter Genauigkeit. KI-Extraktion kostet einen Bruchteil von X € und dauert unter 10 Minuten, mit dem Kompromiss, dass Sie 15–30 Minuten für die Überprüfung der unsicheren Felder aufwenden. Für die meisten Betriebe rechtfertigt die Zeitersparnis den geringen Überprüfungsaufwand. Für Formulare, bei denen 100 % Genauigkeit nicht verhandelbar ist und kein menschlicher Überprüfungsschritt akzeptabel ist, bleibt ein Datenerfassungsdienst die sicherere Wahl.
Kann es Handschrift und gedruckten Text auf derselben Seite unterscheiden?
Ja. Die KI erkennt beide Formate und extrahiert sie in dieselbe strukturierte Ausgabe. Ein Formular mit gedruckten Beschriftungen, getippten Feldern und handschriftlichen Anmerkungen am Rand wird in einem Durchgang verarbeitet – der gedruckte Text wird standardmäßig extrahiert, der handschriftliche Inhalt kontextuell interpretiert. Der Mechanismus der Spaltennamen gibt vor, welche Werte extrahiert werden sollen, unabhängig vom Format.
Für einen speziell entwickelten KI-Workflow zur Umwandlung von Handschrift in Text verwenden Sie unser dediziertes Tool, das handschriftliche Felder, Kontrollkästchen und Anmerkungen in eine strukturierte Excel-Ausgabe liest – ohne Vorlage.