Pourquoi l'OCR traditionnel échoue sur l'écriture manuscrite
Et comment les modèles de vision par IA réussissent là où il échoue
Un utilisateur de Reddit sur r/OpenAI a découvert quelque chose qui l'a surpris : « ChatGPT fait un travail incroyable sur ce genre de choses. Je l'utilise tout le temps pour convertir de l'écriture en texte et même pour traduire cette écriture. » Il n'utilisait pas un outil spécialisé de reconnaissance de l'écriture manuscrite. Il utilisait un modèle de langage généraliste — téléchargeant une photo de texte manuscrit et obtenant une transcription propre. Sur r/computervision, les utilisateurs font des bilans annuels des outils d'OCR pour l'écriture manuscrite et arrivent toujours à la même conclusion : la reconnaissance spécialisée de l'écriture manuscrite surpasse l'OCR général, mais les modèles d'IA qui comprennent le contexte comblent rapidement l'écart. Cet article explique pourquoi l'OCR standard trébuche sur l'écriture manuscrite, ce qui change quand la vision par IA entre en jeu, et où se situent encore les limites honnêtes.
Points clés à retenir
- Une précision de 99 % sur le texte imprimé contre 65 à 85 % sur l'écriture manuscrite n'est pas un échec de qualité — c'est une erreur de catégorie : l'OCR (reconnaissance optique de caractères) a été conçu pour faire correspondre des images de caractères à une bibliothèque de polices, et l'écriture manuscrite humaine n'a aucune police à laquelle se référer.
- Contrairement à l'OCR, la vision par IA lit tout le formulaire — étiquettes, mise en page et écriture manuscrite — comme une image interconnectée, utilisant le contexte comme vous le feriez : si un gribouillis se trouve dans un champ de date entre « 1 » et « / », ce doit être un chiffre, pas une marque aléatoire.
- Avec ImageToTable.ai, l'employé qui ressaisit 30 formulaires manuscrits en deux heures devient un réviseur qui vérifie les champs signalés en 10 minutes — car l'extraction des noms de colonnes ancre l'IA dans le sens avant même qu'elle ne lise votre écriture manuscrite.
Écriture manuscrite — la dernière muraille que l'OCR n'a pas conquise
La reconnaissance de texte imprimé est un problème résolu. L'OCR moderne atteint une précision quasi parfaite sur les polices propres, et l'extraction basée sur des modèles gère les formulaires structurés aux mises en page prévisibles. Le marché mondial de la reconnaissance de l'écriture manuscrite — évalué à 1,28 milliard de dollars en 2024 et projeté à 3,29 milliards de dollars d'ici 2032 — existe précisément parce que la solution pour le texte imprimé ne s'y transpose pas. L'écriture manuscrite est le format de saisie qui maintient le papier en vie dans des secteurs qui, autrement, auraient numérisé depuis des décennies.
Le secteur de la santé repose sur des notes cliniques et des ordonnances manuscrites. Les assurances traitent des formulaires de réclamation manuscrits — un opérateur de fabrication demande sans détour : « Qui utilise le papier pour capturer des données importantes ? Précisément : des formulaires remplis à la main par un humain avec un stylo et du papier. Des machines qui ne se connectent à aucun système. » Les entreprises de logistique gèrent des confirmations de livraison avec des signatures et des notes manuscrites. Les techniciens de terrain remplissent des bons de travail papier parce que taper sur un téléphone avec des mains gantées sous la pluie est pire qu'un presse-papiers et un stylo. Les données existent sur papier. Les intégrer dans un système exige soit qu'une personne les ressaisisse, soit une IA capable de les lire.
Une revue 2025 des outils d'OCR manuscrite sur r/computervision a résumé l'état de l'art : « Les solutions d'OCR manuscrite spécialisées surpassent systématiquement l'OCR à usage général sur les documents manuscrits réels. » C'est une bonne nouvelle pour les organisations disposant du budget et de la capacité d'intégration pour des plateformes dédiées à la reconnaissance de l'écriture manuscrite. C'est une mauvaise nouvelle pour le comptable qui reçoit une douzaine de reçus manuscrits chaque vendredi et doit avoir les données dans un tableur d'ici lundi. Les outils spécialisés existent. Les outils à usage général ne fonctionnent pas assez bien. Et l'écart entre les deux est là où se trouve la plupart des données manuscrites — non traitées, non consultables, ressaisies manuellement.
Le problème n'est pas une écriture manuscrite « désordonnée ». C'est que l'OCR n'a jamais compris le langage.
L'OCR traditionnel fonctionne en faisant correspondre des motifs visuels à une bibliothèque de formes de caractères connues. Montrez-lui un « a » imprimé propre en Helvetica, et il le reconnaît avec une grande confiance. Montrez-lui dix « a » manuscrits de dix personnes différentes — inclinés différemment, bouclés différemment, reliés à la lettre suivante, compressés dans un champ de formulaire étroit — et l'approche par appariement de motifs s'effondre. Il n'existe pas de forme « correcte » pour un « a » manuscrit. Le moteur d'OCR ne sait pas que les dix variations représentent la même lettre. Il voit dix formes différentes et devine.
C'est là le décalage fondamental. L'OCR a été conçu pour les polices de caractères — des ensembles de caractères fixes où chaque « a » ressemble à tous les autres « a » de la même police. L'écriture manuscrite n'a pas de police. Elle a des schémas moteurs individuels, la vitesse d'écriture, la pression du stylo, la friction de la surface et l'humeur du scripteur à 16 h 55 un vendredi. Le réservoir de variations est infini. Un algorithme d'appariement de motifs qui fonctionne sur l'impression rencontre un problème combinatoirement différent avec l'écriture manuscrite.
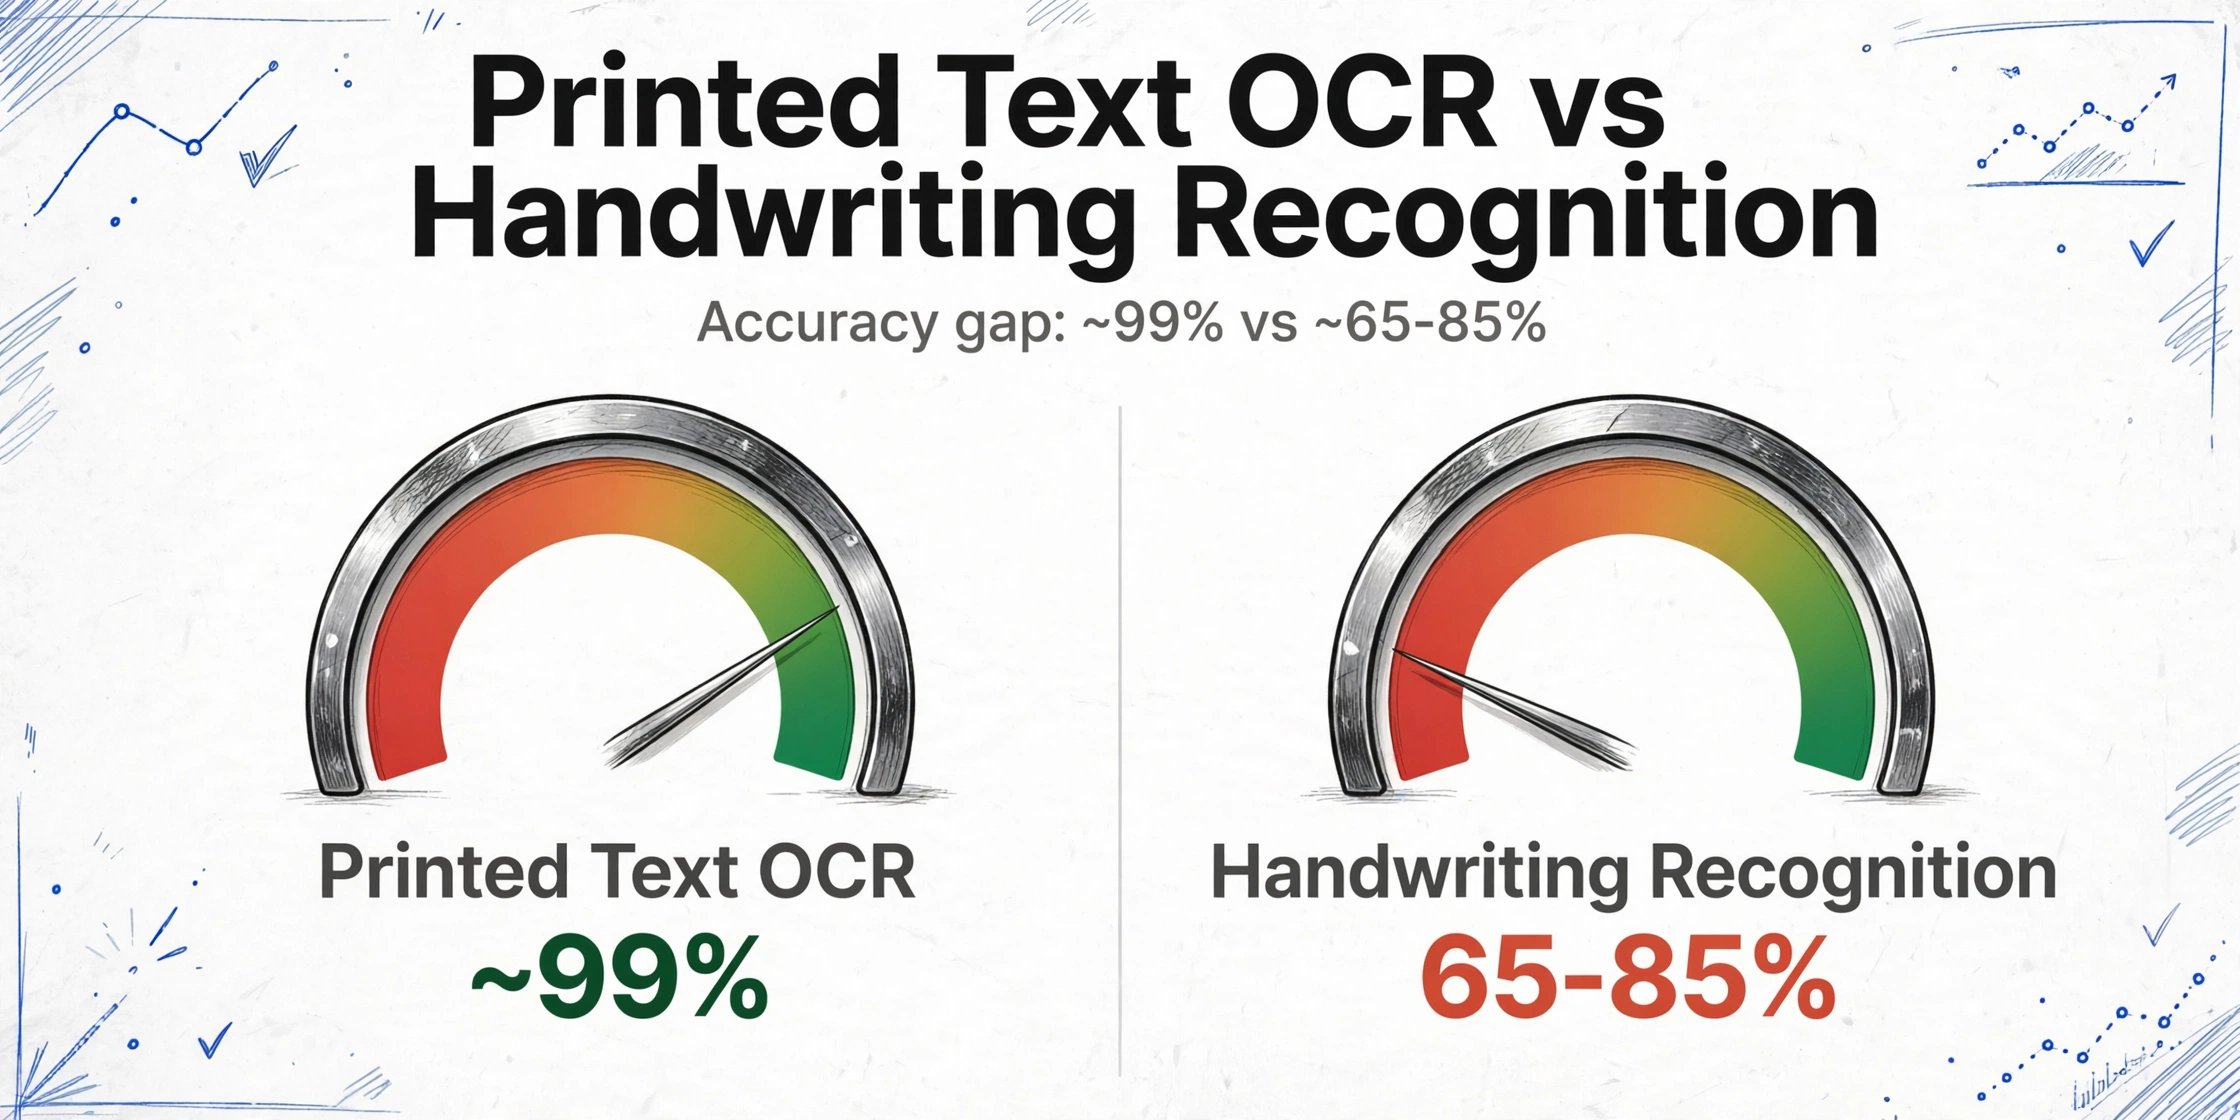
L'écart entre la précision de l'OCR pour le texte imprimé (~99 %) et celle de la reconnaissance de l'écriture manuscrite (~65-85 % pour les meilleurs modèles d'IA actuels sur une écriture manuscrite difficile, selon l'examen communautaire r/computervision 2025) n'est pas un signe que la reconnaissance de l'écriture manuscrite est défaillante. C'est un signe que le problème est fondamentalement plus difficile. La reconnaissance de l'impression est une correspondance de caractères. La reconnaissance de l'écriture manuscrite est une interprétation du comportement humain — et le comportement humain varie.
Ce que la vision par IA fait différemment — elle lit le sens, pas les formes
Le passage de l'OCR traditionnel aux grands modèles de vision change le mécanisme : de la correspondance de caractères à la compréhension contextuelle. Un modèle de vision n'isole pas chaque lettre pour la comparer à une bibliothèque de formes. Il examine l'image entière — la mise en page du formulaire, le texte environnant, les étiquettes de champs, le style d'écriture manuscrite — et interprète le sens du contenu.
Cette différence apparaît le plus clairement dans les situations ambiguës. L'OCR traditionnel voit un gribouillis entre deux lettres plus nettes et soit devine un caractère, soit renvoie un blanc à faible confiance. Un modèle de vision voit le même gribouillis et comprend grâce au contexte : c'est un champ de date, le gribouillis se trouve entre un « 1 » et un « / », donc c'est probablement un « 5 » ou un « 3 » selon la courbe. Il ne fait pas correspondre le gribouillis à la forme d'un « 5 ». Il comprend qu'un format de date contenant « 1?/??/2025 » rend « 15 » ou « 13 » la lecture la plus probable, et « 1&/??/2025 » impossible.
Cet utilisateur de Reddit sur r/OpenAI, surpris par la capacité de reconnaissance de l'écriture manuscrite de ChatGPT, expérimentait exactement ce mécanisme. ChatGPT n'a pas de module OCR pour l'écriture manuscrite. Il a un modèle de vision qui regarde les images et comprend ce qui y est représenté — texte, objets, contexte, relations. Quand il lit une écriture manuscrite, il fait la même chose que lorsqu'il décrit une photographie : interpréter l'information visuelle en fonction de ce qui a du sens dans le monde. L'écriture manuscrite n'est qu'un élément visuel supplémentaire à comprendre.
La différence en une phrase : l'OCR demande « est-ce que cette forme correspond au caractère "a" de ma bibliothèque ? » La vision par IA demande « étant donné que c'est un champ de nom sur un formulaire médical, que la première lettre ressemble à un A majuscule, et que le reste du mot a le motif de forme de "nderson" — le nom est Anderson. » L'un fait de l'appariement de motifs. L'autre fait du raisonnement.
Ce que l'IA de reconnaissance d'écriture manuscrite peut gérer — et ce qui lui pose encore problème
L'approche de vision par IA ne rend pas la reconnaissance de l'écriture manuscrite parfaite. Elle déplace le plafond de précision et change les types d'erreurs qui se produisent — mais il existe encore de vraies limites. Être honnête à ce sujet importe plus que de prétendre que le problème est résolu.
| Type d'écriture manuscrite | Fiabilité de l'IA | Pourquoi |
|---|---|---|
| Lettres majuscules claires (toutes en capitales, lettres séparées) | Élevée — précision proche de l'impression | Variation limitée ; chaque lettre est distincte et standardisée |
| Écriture mixte scripte/cursive (la plus courante dans la réalité) | Bonne — le contexte aide à résoudre les lettres ambiguës | La plupart des lettres sont reconnaissables ; le contexte résout le reste |
| Cursive légère (lettres liées, traits clairs) | Modérée — lisible mais avec des erreurs sur les paires de lettres ambiguës | Les liaisons entre lettres créent de l'ambiguïté (rn vs m, cl vs d) |
| Cursive appuyée / scripte (fluide, stylisée) | Faible — taux d'erreur significatif | Les formes des lettres s'éloignent trop des motifs reconnaissables ; le contexte ne peut pas compenser chaque caractère |
| Écriture maculée, décolorée ou minuscule | Faible — similaire à la difficulté humaine | La dégradation physique de la surface d'écriture masque les données |
| Écriture manuscrite sur formulaires (champs étiquetés, cases à cocher) | Bonne — la structure du formulaire fournit un contexte fort | Les étiquettes guident l'extraction ; l'IA sait que « ce champ est une date » avant même de lire l'écriture manuscrite |
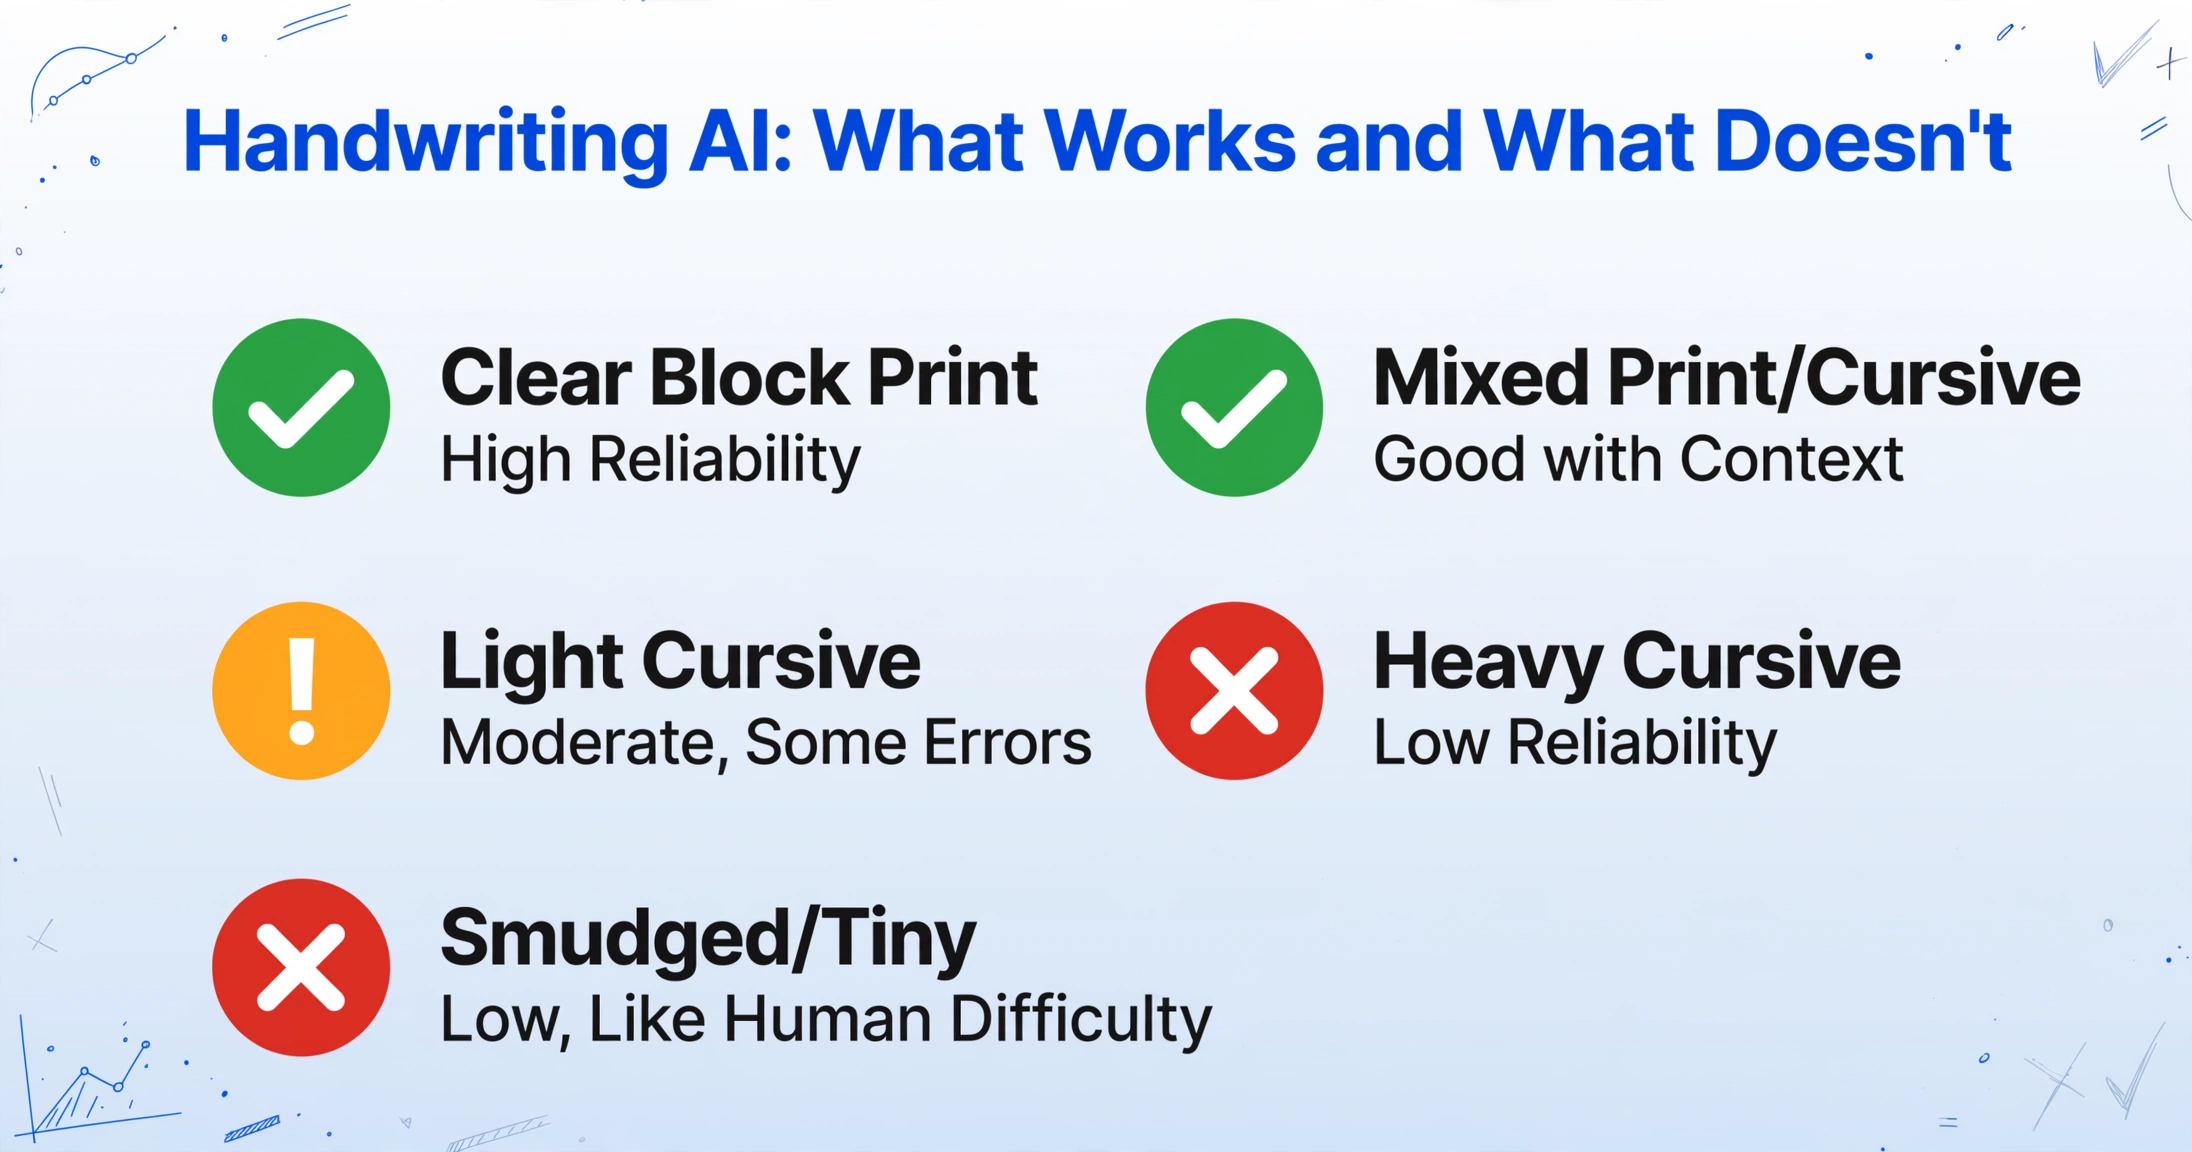
La conclusion n'est pas « l'IA de reconnaissance d'écriture manuscrite fonctionne » ou « l'IA de reconnaissance d'écriture manuscrite ne fonctionne pas ». C'est plutôt : « l'IA de reconnaissance d'écriture manuscrite fonctionne bien pour l'écriture que les humains peuvent aussi lire de manière fiable — et elle bute sur la même écriture qui pose problème aux humains. » Le plancher de précision de l'IA se situe autour du point où un lecteur humain attentif ralentirait et plisserait les yeux. C'est une capacité significative pour les flux de travail professionnels : elle couvre la majorité des données manuscrites qui sont actuellement ressaisies manuellement, tout en reconnaissant que les cas les plus difficiles nécessitent encore une relecture humaine.
Pour une vue d'ensemble complète couvrant tout, des concepts de base aux flux de travail de production, consultez notre guide ultime de la conversion de l'écriture manuscrite en texte par IA. Si vous travaillez avec des formulaires contenant des cases à cocher et des champs de sélection, découvrez comment l'IA lit les formulaires manuscrits et convertit les sélections de cases à cocher en données Excel structurées.
Du formulaire manuscrit à l'Excel structuré — trois étapes
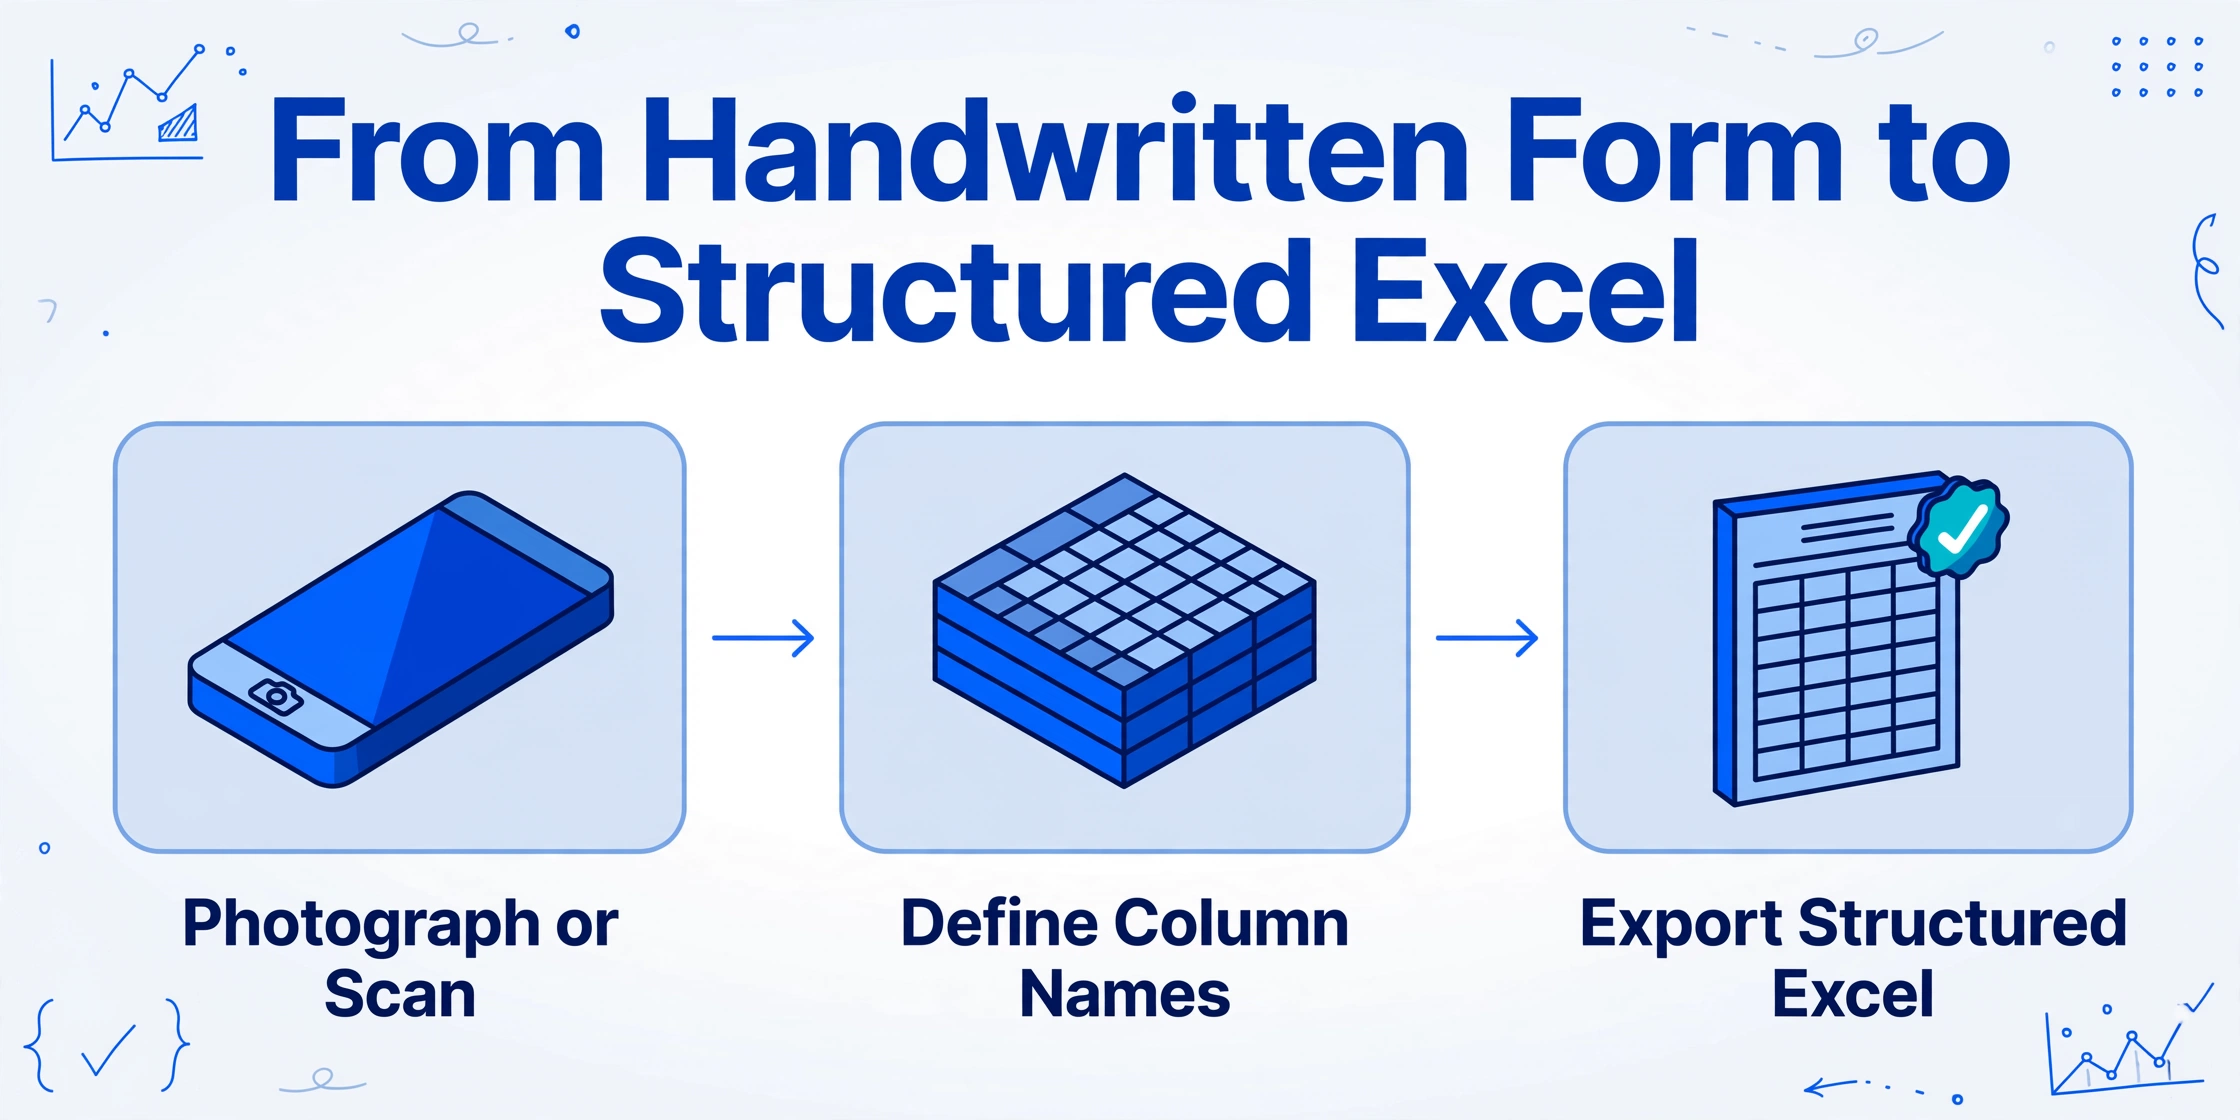
Le même mécanisme d'extraction des noms de colonnes qui traite les documents imprimés s'applique aux formulaires manuscrits — avec l'avantage supplémentaire que les libellés des formulaires fournissent un fort contexte pour l'interprétation de l'IA. Lorsque le nom de colonne est « Patient Name » et que le formulaire comporte un champ intitulé « Name », l'IA sait quel type de contenu rechercher avant même de commencer à lire l'écriture manuscrite. Le libellé ancre l'extraction dans le sens, et l'écriture manuscrite devient un signal supplémentaire dans un contexte déjà structuré.
Une clinique médicale recevant 30 formulaires d'admission manuscrits par jour définirait des colonnes comme « Patient Name, DOB, Insurance ID, Chief Complaint, Referring Physician ». Chaque formulaire est photographié. Le lot est téléchargé. L'IA extrait les valeurs manuscrites en 30 lignes de données structurées. L'employé qui passait auparavant deux heures à saisir ces formulaires consacre désormais 10 minutes à vérifier la sortie de l'IA et à corriger manuellement les 5 à 10 % de champs où l'écriture était véritablement ambiguë. Découvrez comment fonctionne l'extraction des noms de colonnes pour tous les types de documents →
Attente réaliste en matière de précision : Sur des formulaires manuscrits propres et structurés, avec une lisibilité raisonnable, attendez-vous à ce qu'environ 85 à 95 % des champs soient extraits correctement au premier passage. Les 5 à 15 % restants nécessiteront une correction manuelle — mais vérifier et corriger ne représente qu'une fraction du temps passé à ressaisir l'ensemble. Pour chaque heure de saisie manuelle économisée, prévoyez 5 à 10 minutes de travail de vérification.
Démo en direct : importez un document manuscrit et voyez le résultat
Testez l'extraction avec n'importe quel document contenant de l'écriture manuscrite — un formulaire, une note, un reçu avec des mentions manuscrites.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Questions fréquentes
Pourquoi ChatGPT lit-il si bien l'écriture manuscrite alors que l'OCR de mon scanner n'y arrive pas ?
ChatGPT utilise un grand modèle de vision — il « voit » l'image entière et la comprend contextuellement, de la même manière qu'il comprend une photographie. L'OCR intégré de votre scanner utilise l'appariement de motifs : il isole chaque caractère et compare sa forme à une bibliothèque de polices imprimées. L'écriture manuscrite ne correspond à aucune police, donc la comparaison au niveau des caractères échoue. L'OCR de votre scanner n'est pas une technologie inférieure — c'est la mauvaise technologie pour ce problème. Si vous avez déjà utilisé ChatGPT pour lire de l'écriture manuscrite avec succès, vous avez déjà expérimenté la différence entre l'appariement de motifs et la compréhension visuelle.
Quelle est la différence entre la reconnaissance de l'écriture manuscrite et la vérification de signature ?
La reconnaissance de l'écriture manuscrite extrait le contenu textuel des mots manuscrits — « qu'est-ce que cela dit ? » La vérification de signature confirme l'identité du signataire — « est-ce vraiment la signature de John ? » Ce sont des tâches d'IA différentes. Le système décrit dans cet article traite la première : lire le texte manuscrit pour l'extraction de données. Il n'effectue pas d'analyse forensique de signature. Pour les flux de travail documentaires qui nécessitent les deux (par exemple, « extraire les données du formulaire ET vérifier la signature en bas »), l'extraction et la vérification sont des processus distincts.
Cela fonctionne-t-il avec l'écriture manuscrite dans d'autres langues que l'anglais ?
Le grand modèle de vision prend en charge plusieurs langues, y compris les écritures avec des caractères non latins. L'écriture manuscrite en chinois, japonais, arabe, cyrillique et devanagari est à la portée du modèle. La précision varie selon la langue et la complexité de l'écriture — les langues avec des formes de caractères plus distinctes donnent généralement de meilleurs résultats. Les formulaires multilingues (par exemple, un formulaire médical avec des étiquettes en anglais et des réponses manuscrites en espagnol) sont traités en une seule passe d'extraction.
Comment l'extraction de l'écriture manuscrite se compare-t-elle à l'embauche d'un service de saisie de données ?
Un service de saisie de données facture par frappe ou par formulaire, avec un délai d'exécution mesuré en heures ou en jours. L'extraction par IA traite un lot de formulaires en quelques minutes pour une fraction du coût par formulaire — mais produit un résultat qui peut nécessiter une vérification humaine pour 5 à 15 % des champs. La comparaison pratique : pour 100 formulaires, un service de saisie de données coûte X $ et prend Y heures avec une précision quasi parfaite. L'extraction par IA coûte une fraction de X $ et prend moins de 10 minutes, avec pour contrepartie que vous passerez 15 à 30 minutes à vérifier les champs incertains. Pour la plupart des opérations, le gain de temps justifie le petit effort de vérification. Pour les formulaires où une précision de 100 % est non négociable et où aucune étape de relecture humaine n'est acceptable, un service de saisie de données reste le choix le plus sûr.
Peut-il distinguer l'écriture manuscrite du texte imprimé sur une même page ?
Oui. L'IA reconnaît les deux formats et les extrait dans une même sortie structurée. Un formulaire avec des étiquettes imprimées, des champs dactylographiés et des annotations manuscrites dans les marges sera traité en une seule passe — le texte imprimé bénéficie d'une extraction standard, le contenu manuscrit d'une interprétation contextuelle. Le mécanisme des noms de colonnes guide l'extraction des valeurs, quel que soit le format.
Pour un flux de travail dédié de conversion d'écriture manuscrite en texte par IA, utilisez notre outil spécialisé qui lit les champs manuscrits, les cases à cocher et les annotations pour produire une sortie Excel structurée — sans modèle requis.