O que é entrada de dados por IA?
Dados estruturados, não apenas texto de OCR
Pegue uma fatura. Passe-a pelo OCR. Você obtém isto: Fatura #INV-2024-0891 Data: 15 de março de 2024 Total: $4.230,50 Fornecedor: Acme Corp. Uma parede de texto. Para colocar esses dados em uma planilha, você ainda precisa destacar cada campo, copiá-lo e colá-lo na célula certa — o OCR não te poupou da entrada de dados. Ele apenas moveu o texto do papel para a tela. Agora passe a mesma fatura pela entrada de dados por IA. Você obtém quatro colunas — Número da Fatura, Data, Total, Fornecedor — cada uma com o valor correto, prontas para uso. Mesmo documento. Resultado completamente diferente. Isso não é uma melhoria menor em relação ao OCR. É uma categoria diferente de ferramenta, e entender o porquê é o assunto deste artigo.
Principais Conclusões
- O OCR digitaliza o texto, mas nunca toca no trabalho real de entrada de dados — cada campo ainda fica em um bloco de texto indiferenciado, esperando você copiar e colar cada valor na célula certa da planilha manualmente.
- O OCR lê caracteres um a um, sem nenhum entendimento do que significam, por isso não consegue distinguir um valor em dólares na linha do Total do mesmo número em um item de linha — e por isso a busca manual por campos ainda consome mais de 40 horas por mês depois da "automação".
- ImageToTable.ai fecha essa lacuna lendo a página inteira de uma vez, reconhecendo que um valor rotulado como "Fatura #" pertence a uma coluna e um valor chamado "Total" pertence a outra — em qualquer layout, sem modelos ou treinamento.
O que a entrada de dados por IA realmente significa
Entrada de dados por IA é um software que lê um documento, entende o que cada informação significa e a coloca na coluna correta de uma planilha — automaticamente. Diferente do OCR, que converte imagens de texto em caracteres de texto digital, a entrada de dados por IA produz saída estruturada: linhas e colunas onde Número da Fatura está na coluna Número da Fatura, Data está na coluna Data e Total está na coluna Total, em todos os documentos de um lote.
O mecanismo que torna isso possível é a Extração de Colunas Personalizadas: em vez de programar regras de extração ou desenhar caixas ao redor de campos em um modelo, você digita os nomes das colunas que deseja — "Número da Fatura", "Data de Vencimento", "Nome do Fornecedor", "Total da Linha" — e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa semanticamente, não combinando uma posição fixa. Os nomes das colunas que você digita se tornam os cabeçalhos da sua planilha final. Essa é a mudança fundamental: você descreve a saída, não a entrada.
Essa distinção importa porque muda quem pode usar a ferramenta. A extração baseada em modelos exige que alguém crie e mantenha modelos para cada layout de documento que chega. A Extração de Colunas Personalizadas funciona da mesma forma, seja processando 50 faturas de um fornecedor ou 50 faturas de 50 fornecedores diferentes com layouts completamente distintos.
Insight central: O OCR digitaliza caracteres. A entrada de dados por IA estrutura informações. Um produz texto com o qual você ainda precisa trabalhar. O outro produz uma planilha que você já pode usar.
Por que o OCR sozinho nunca foi entrada de dados
Para entender o que a entrada de dados por IA faz de diferente, ajuda ver a lacuna que o OCR sempre deixou. Aqui está uma fatura real, processada das duas formas.
Saída do OCR — o que você obtém de uma ferramenta OCR tradicional apontada para uma fatura padrão de fornecedor:
INVOICE
Acme Industrial Supply
451 Commerce Drive, Suite 200
Chicago, IL 60607
Invoice #INV-2024-0891
Date: March 15, 2024
Due Date: April 14, 2024
PO Number: PO-77231
Item | Qty | Unit Price | Total
Hex Bolt M10 | 200 | $2.40 | $480.00
Steel Washer M10 | 500 | $0.15 | $75.00
Threaded Rod 1m | 50 | $12.80 | $640.00
Subtotal: $1,195.00
Tax (8.75%): $104.56
Shipping: $45.00
Total: $1,344.56
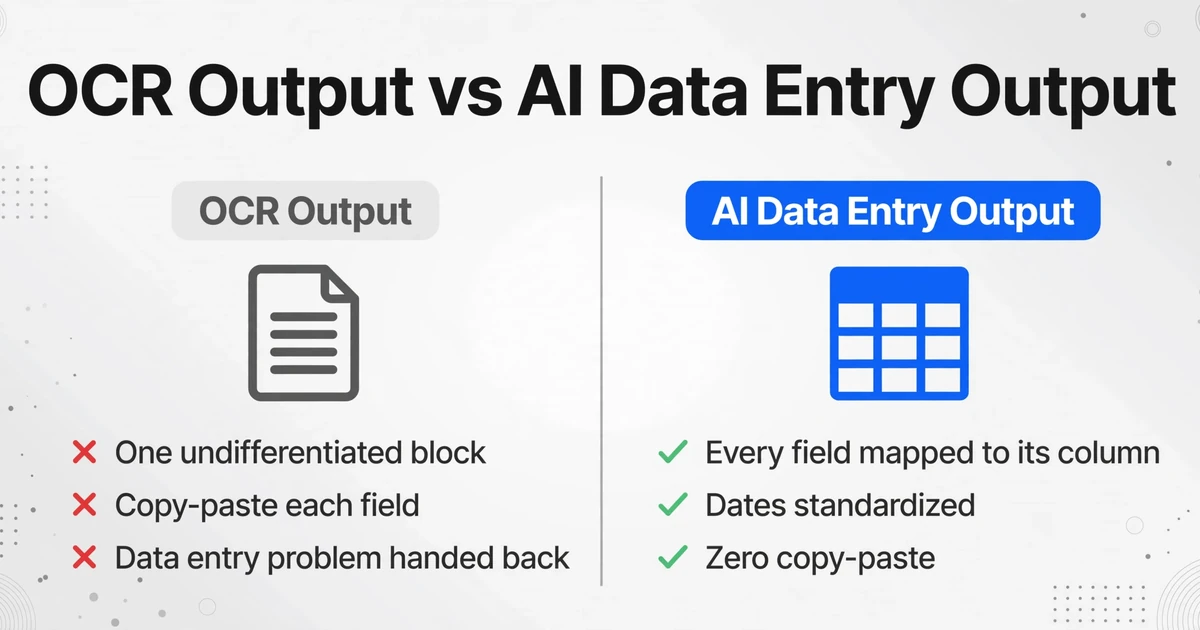
Tudo está lá. Os caracteres estão corretos. Mas é um bloco indiferenciado. Para colocar "Número da Fatura" na sua planilha, você encontra a linha que começa com "Invoice #", seleciona o identificador, copia, alterna para a planilha, cola. Depois encontra a data. Depois o número do pedido. Depois cada item da linha. O OCR lhe deu o texto, mas devolveu o problema da entrada de dados para você.
Saída da entrada de dados por IA — o que você obtém com a extração alimentada por IA com a mesma fatura:
| Número da Fatura | Data | Vencimento | Número do Pedido | Nome do Fornecedor | Subtotal | Impostos | Frete | Total |
|---|---|---|---|---|---|---|---|---|
| INV-2024-0891 | 2024-03-15 | 2024-04-14 | PO-77231 | Acme Industrial Supply | $1,195.00 | $104.56 | $45.00 | $1,344.56 |
Cada campo mapeado para sua coluna correta. Itens de linha extraídos em suas próprias linhas. Datas padronizadas em um formato consistente. Zero copiar e colar. Zero busca manual de campos. A diferença não é sobre velocidade — embora a IA seja significativamente mais rápida — é sobre a saída já estar estruturada. A saída do OCR exige uma segunda etapa (entrada manual de dados) antes de ser útil. A saída da entrada de dados por IA é útil imediatamente.
A pesquisa de 2025 da EY descobriu que uma única tarefa manual de entrada de dados de RH agora custa às organizações em média $4.86 — acima dos $4.39 em 2018, e com tendência de alta a cada ano. Em milhares de documentos, a lacuna entre "o OCR digitalizou o texto" e "a IA estruturou os dados" se acumula em custos operacionais reais.
Como a IA Lê Documentos: Visão e Linguagem
O OCR funciona caractere por caractere. Ele analisa um padrão de pixels escuros e claros, compara com uma biblioteca de formas conhecidas e gera a letra mais próxima. É por isso que o OCR pode produzir "rn" quando deveria ler "m" — ele toma decisões no nível do caractere, sem noção da palavra, muito menos da estrutura do documento. Quando o OCR encontra uma tabela com células mescladas, ele lê linha por linha e perde completamente as relações entre colunas.
A entrada de dados por IA usa modelos de visão e linguagem (VLMs) — uma classe de IA que processa documentos da mesma forma que um humano: olhando a página inteira de uma vez. Um VLM analisa simultaneamente três camadas de informação:
Layout visual.
Onde cada elemento está posicionado? Está em um cabeçalho, uma tabela, um rodapé? Este texto está em negrito, recuado ou dentro de uma caixa com borda? O modelo entende a estrutura do documento — não apenas como os pixels se parecem, mas como a página está organizada.
Conteúdo do texto.
O que o texto diz? O modelo lê caracteres, palavras e números — mas, ao contrário do OCR, ele os lê no contexto de sua posição na página e de sua relação com elementos próximos.
Significado semântico.
O que cada dado representa? Um número no canto superior direito ao lado da palavra "Invoice #" é um número de fatura. Um número em negrito no canto inferior direito ao lado de "Total" é o valor devido. O modelo conecta a posição visual ao papel semântico — ele não apenas lê "INV-2024-0891", mas entende que este é o identificador da fatura.
Essas três camadas — layout, conteúdo e significado — são processadas juntas, não sequencialmente. Quando a IA vê um valor em dólar na linha "Total" no rodapé de uma fatura, ela não precisa decidir "isto é texto ou número?" e depois "o que este número significa?" como etapas separadas. Ela entende o quadro completo de uma vez: este é um valor monetário, está posicionado no final do documento, está rotulado como "Total" e provavelmente é a soma de todos os itens acima. A saída é um valor com um rótulo semântico, não apenas uma sequência de dígitos.
É isso que as pessoas querem dizer quando afirmam que a IA "entende contexto." Não é mágica — são modelos treinados em milhões de documentos que aprendem que, quando um número aparece abaixo de uma coluna de valores e ao lado da palavra "Total", esse número tem um significado específico que um número no meio de uma tabela de itens não tem.
Três Maneiras de a IA Extrair Dados de um Documento
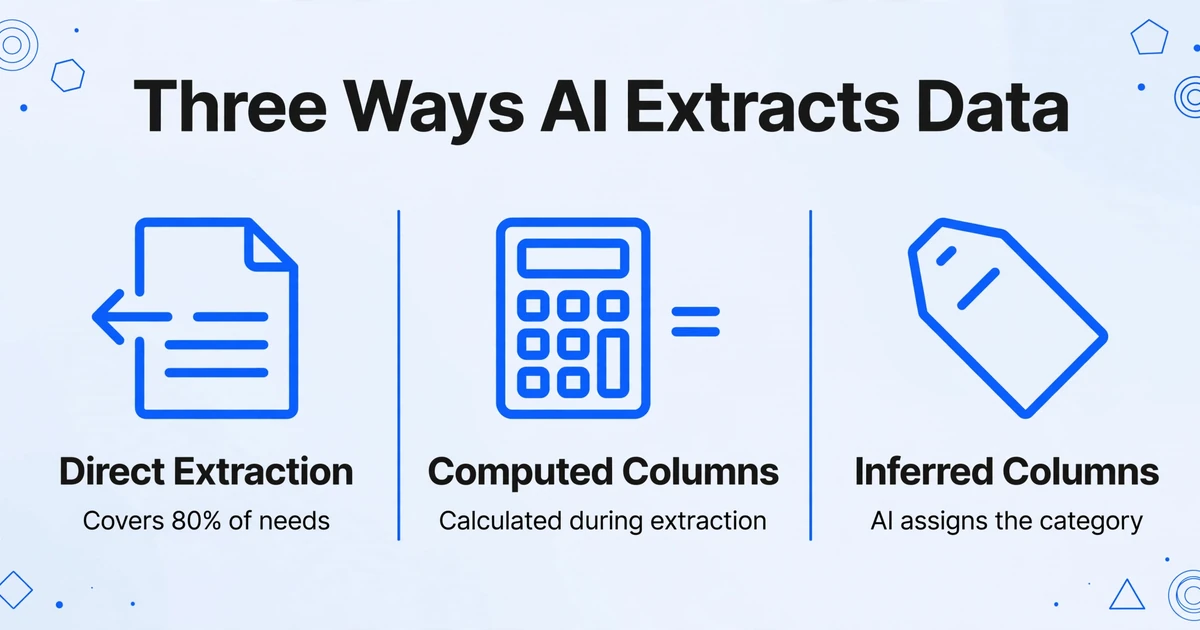
Nem toda extração é igual. A entrada de dados por IA opera em três modos distintos, cada um resolvendo um problema diferente. Entender qual modo se aplica a cada campo é o que separa uma extração funcional de uma que produz resultados incompletos.
Extração Direta — Quando os Dados Estão Impressos na Página
Este é o modo mais direto: o campo que você quer está visivelmente presente no documento. Uma fatura tem uma data impressa. Um recibo tem um total. Um pedido de compra tem o nome do fornecedor. A IA localiza o valor entendendo seu papel semântico e o coloca na coluna correta.
A extração direta cobre cerca de 80% do que a maioria das pessoas precisa do processamento de documentos. Ela lida com texto impresso, tabelas com colunas claras e campos em posições previsíveis — mesmo quando essas posições variam entre layouts. Como a IA não está correspondendo a uma coordenada fixa, uma data no canto superior direito de uma fatura e uma data no canto inferior esquerdo de outra fatura são mapeadas corretamente para a coluna "Data".
Colunas calculadas — Quando a Resposta Não Está Escrita, Mas os Ingredientes Estão
Às vezes, o número que você precisa não está impresso em nenhum lugar do documento — mas os componentes para calculá-lo estão. É aqui que entram as Colunas calculadas. Em vez de extrair um valor, a IA realiza um cálculo durante a extração e coloca o resultado na sua planilha.
Por exemplo, um pedido de compra pode listar uma quantidade de 200 e um preço unitário de $2.40, mas em nenhum lugar imprime "Total da Linha: $480.00". Com Colunas calculadas, você define uma coluna chamada Total da Linha (Qtd × Preço Unitário). A IA extrai os dois valores de origem, realiza a multiplicação e gera $480.00 — tudo em uma única passada. Nenhum trabalho de fórmula pós-extração no Excel é necessário.
As Colunas calculadas suportam aritmética em nível de linha, agregação entre linhas (somando todos os itens de linha em uma seção), lógica condicional (sinalizando quando os totais calculados não correspondem ao total impresso) e referências a parâmetros fixos (incorporando uma taxa de imposto que se aplica a todos os documentos em um lote). O cálculo acontece durante a extração, então sua saída são respostas prontas para uso — não dados brutos que você ainda precisa processar.
Colunas inferidas — quando a IA preenche o que não está lá
O terceiro modo resolve um problema que o OCR e as ferramentas baseadas em modelos não conseguem tocar: e se a informação que você precisa não estiver escrita no documento? Colunas inferidas permitem que a IA leia um documento e faça um julgamento sobre qual categoria, tag ou rótulo se aplica — e então preencha isso na sua planilha.
Um caso clássico é a categorização de despesas. Um recibo de restaurante não diz "Categoria: Refeições". Mas você precisa classificar as despesas para a declaração de impostos. Com Colunas inferidas, você define uma coluna chamada Categoria (opções: Refeições/Transporte/Escritório/Outros). A IA lê cada recibo — um recibo de almoço de um restaurante de sushi, um recibo de posto de gasolina, um recibo da Staples — e determina a categoria correta para cada um. O resultado é uma planilha onde cada linha já tem sua categoria atribuída. Extração e classificação acontecem em uma única passagem.
Colunas inferidas funcionam da mesma forma em qualquer tipo de documento: sinalizando pedidos urgentes em notas de entrega, detectando o tipo de moeda em faturas internacionais, identificando o subtipo de documento em certificados de seguro. A IA lê o conteúdo do documento e faz uma inferência estruturada — algo que o OCR, que não tem compreensão semântica, não consegue fazer.
O que isso significa no uso diário
Os três modos de extração convergem em uma única mudança operacional: você não precisa mais ensinar a ferramenta como seus documentos se parecem. Você descreve o que quer extrair deles.
Em um fluxo de trabalho de OCR baseado em modelos, adicionar o formato de fatura de um novo fornecedor significa abrir o editor de modelos, desenhar zonas ao redor de cada campo, testar contra uma amostra e torcer para que as zonas não mudem na próxima fatura. Multiplique isso por 20 fornecedores e você gastará mais tempo mantendo modelos do que teria gasto com entrada manual. Com entrada de dados por IA, você digita os nomes das suas colunas uma vez. Elas funcionam em todos os layouts que a IA encontrar — porque a IA está entendendo o documento, não medindo coordenadas.
O processamento em lote leva isso adiante. Envie 50 faturas de 15 fornecedores diferentes. Digite os nomes das suas colunas uma vez. A IA processa todas as 50, identifica cada campo em cada variação de layout e exporta uma única planilha com 50 linhas — uma por fatura — com cada campo na coluna certa. O que costumava ser uma tarde de entrada manual vira alguns minutos de upload e revisão.
Os arquivos são processados com segurança e não são armazenados.
Para uma visão mais ampla de como a extração por IA se compara às abordagens tradicionais de processamento de documentos, nossa introdução ao software de extração de dados cobre todo o panorama da categoria. E se você está avaliando ferramentas, o framework de avaliação apresenta os critérios que separam a extração de nível de produção de demonstrações que funcionam apenas com um documento de exemplo.
O Que a Entrada de Dados por IA Faz Bem
A entrada de dados por IA lida com qualquer documento em que existam informações estruturadas em um layout visual. Os casos de uso mais comuns se concentram em alguns tipos de documentos de alto volume.
Processamento de faturas. O caso de uso principal. Faturas de fornecedores diferentes têm layouts radicalmente distintos, mas compartilham a mesma estrutura semântica: nome do fornecedor, número da fatura, data, itens de linha, totais. A IA lê entre layouts, tornando prático extrair campos de faturas para o Excel sem criar um modelo para cada fornecedor. A Gartner projeta que, até 2030, até 80% das faturas B2B no mundo serão processadas automaticamente — uma previsão que pressupõe exatamente o tipo de extração independente de layout descrito aqui.
Digitalização de recibos. Recibos são o tipo de documento mais difícil para OCR baseado em modelos: cada loja imprime um formato diferente, muitos são impressos termicamente e desbotados, e frequentemente chegam como fotos de celular em ângulos estranhos. A entrada de dados por IA converte recibos em linhas estruturadas de planilha ao entender o layout do recibo visualmente — identificando o nome do comerciante, data, total e itens de linha, independentemente do formato.
Conciliação de extratos bancários. Extratos bancários apresentam um desafio particular: PDFs de várias páginas com tabelas de transações que se estendem por colunas entre quebras de página, colunas de débito e crédito que às vezes se sobrepõem, e saldos acumulados que precisam manter integridade. A entrada de dados por IA converte extratos bancários para Excel preservando a estrutura das transações — cada linha é uma transação, cada coluna é um campo — para que a conciliação possa acontecer na sua planilha, em vez de cruzar um extrato impresso com uma tela.
Processamento de formulários. Formulários em papel — inscrições de emprego, formulários de admissão de pacientes, respostas de pesquisas — chegam em lotes com perguntas consistentes, mas caligrafia, caixas de seleção e padrões de preenchimento extremamente inconsistentes. A IA lê a estrutura do formulário e extrai cada campo para uma coluna, digitalizando dados de formulários sem configuração por formulário.
Documentos manuscritos. A entrada de dados por IA moderna lida com caligrafia legível — formulários impressos preenchidos à mão, notas de entrega com assinaturas e quantidades manuscritas, folhas de ponto com horas escritas à mão. A precisão em manuscritos é menor do que em texto impresso (mais sobre isso na seção de limitações), mas para formulários estruturados em que o conteúdo manuscrito é limitado a campos conhecidos, os resultados são prontos para produção em muitos casos de uso. Nosso guia de reconhecimento de caligrafia para extração de dados cobre os detalhes.
O Que a Entrada de Dados por IA Ainda Enfrenta
A entrada de dados por IA não está resolvida. Existem tipos de documentos e condições em que a precisão cai abaixo do aceitável para automação sem intervenção. Ser claro sobre essas limitações é importante — é a diferença entre configurar um fluxo de trabalho que funciona e um que cria um novo problema de limpeza.
Qualidade de digitalização extremamente ruim. Documentos severamente desbotados, fotografados com pouca luz e desfoque de movimento, ou digitalizados em resolução muito baixa (abaixo de 150 DPI) degradam a precisão da extração. A IA consegue compensar problemas moderados de qualidade — leve desfoque, inclinação, iluminação inconsistente — mas quando os caracteres se tornam genuinamente ambíguos para um leitor humano, a IA também terá dificuldades. A pontuação de confiança (em que a IA sinaliza campos de baixa certeza para revisão humana) mitiga isso, mas não elimina.
Sobreposição de texto manuscrito. Quando a caligrafia é clara e separada, a IA moderna lida bem. Quando os caracteres se sobrepõem — uma correção escrita às pressas espremida entre duas linhas, um risco com novo texto escrito por cima — a precisão cai drasticamente. O modelo precisa decidir onde um caractere termina e outro começa, e em algum nível de sobreposição, essa decisão se torna um palpite até para um humano.
Documentos em que os dados são puramente visuais ou gráficos. Se um documento comunica informações exclusivamente por diagramas, gráficos sem tabelas de dados, ou mapas codificados por cores sem rótulos de texto, a entrada de dados por IA não tem o que extrair. A IA lê texto e layout — ela não interpreta a altura de um gráfico de barras em um valor numérico nem decodifica uma legenda de cores em categorias. Para documentos que misturam texto e visuais (um relatório com tabela de dados e gráfico), a tabela é extraível; o gráfico geralmente não é.
Caligrafia cursiva extrema e não padronizada. Caligrafia caprichada em um formulário estruturado é gerenciável. Cursiva rápida com formatos de letras altamente estilizados — o tipo encontrado em algumas receitas médicas ou livros-razão manuscritos antigos — continua sendo um desafio. A lacuna está diminuindo à medida que os modelos melhoram, mas em meados de 2026, cursiva altamente estilizada ainda produz resultados não confiáveis que exigem verificação humana.
Tabelas de várias páginas com lógica de expansão complexa. Quando uma tabela se estende por três páginas com células mescladas, linhas divididas e subtotais que referenciam valores de uma página anterior, até a IA pode perder o fio. VLMs modernos lidam bem com continuidade simples entre páginas, mas lógica de expansão complexa — em que a descrição de um item de linha se estende por duas páginas e sua quantidade está em uma terceira — ainda produz erros em uma porcentagem significativa dos casos.
O resumo honesto: a entrada de dados por IA lida com os 80% dos documentos que são limpos, legíveis e estruturalmente claros com alta precisão (até 99% para dados de tabelas impressas). Ela lida com os próximos 15% — problemas moderados de qualidade, caligrafia leve, tabelas simples de várias páginas — com precisão que ainda é utilizável, mas pode precisar de verificação por amostragem. Os últimos 5% — caligrafia sobreposta, digitalizações severamente degradadas, documentos puramente gráficos — ainda precisam de atenção humana. Nossa comparação de precisão entre ferramentas de extração fornece benchmarks detalhados para tipos específicos de documentos.
Perguntas Frequentes
A entrada de dados por IA é a mesma coisa que OCR?
Não. O OCR converte imagens de texto em caracteres de texto digital — ele lê letras. A entrada de dados por IA entende o que essas letras significam no contexto e as coloca em colunas estruturadas. O OCR fornece um arquivo de texto. A entrada de dados por IA fornece uma planilha. O OCR é um componente que os sistemas de entrada de dados por IA podem usar, mas, por si só, o OCR não realiza estruturação ou compreensão.
Preciso treinar a IA com meus documentos?
Não. Ferramentas modernas de entrada de dados por IA que usam modelos de visão e linguagem funcionam imediatamente em documentos que nunca viram antes. Você não envia amostras de treinamento, rotula campos ou configura modelos. Você digita os nomes das colunas desejadas, envia seus documentos, e a IA extrai os dados compreendendo o documento visual e semanticamente — não por correspondência a um padrão aprendido de exemplos anteriores. Para comparação, abordagens mais antigas de aprendizado de máquina exigiam centenas de documentos rotulados por formato; ferramentas mais novas baseadas em VLM não exigem nenhum.
Quais formatos de documento a entrada de dados por IA suporta?
PDFs (nativos e digitalizados), JPEG, PNG, WebP, AVIF e capturas de tela de páginas da web. A IA processa qualquer imagem ou documento que você enviar — não precisa que a origem seja um arquivo digital limpo. Uma foto de um recibo tirada no celular funciona da mesma forma que um PDF gerado por um software de contabilidade. Para uma comparação detalhada do suporte de formatos entre ferramentas, consulte nosso framework de avaliação.
Qual é a precisão da entrada de dados por IA em comparação com a entrada manual?
Para dados de tabelas impressas, a extração por IA atinge até 99% de precisão. A precisão da entrada manual de dados normalmente varia de 96 a 98% e diminui com fadiga, pressão de volume e formatos de documentos desconhecidos. Em 1.000 documentos por mês, a diferença é de aproximadamente 10 a 40 erros versus menos de 10 (IA). Uma única página que leva 3 minutos para ser inserida manualmente é processada em 5 a 10 segundos com IA — um ganho de eficiência de mais de 18 vezes. No entanto, a precisão depende muito da qualidade do documento: uma digitalização limpa e bem iluminada de uma fatura impressa alcançará precisão quase perfeita; uma foto desbotada e de baixa resolução de um recibo manuscrito terá precisão menor.
A entrada de dados por IA consegue ler escrita à mão?
Sim, mas com ressalvas. Escrita legível em formulários estruturados (um formulário impresso preenchido à mão) é bem tratada pela IA moderna — a estrutura do formulário fornece contexto que ajuda o modelo a interpretar o conteúdo manuscrito. Notas manuscritas de forma livre, cursiva rápida e escrita sobreposta produzem resultados menos confiáveis. Se o seu caso de uso envolve documentos com muita escrita à mão, espere verificar os resultados em vez de processá-los diretamente. Para mais detalhes, consulte nosso guia de reconhecimento de escrita à mão.
Quanto custa a entrada de dados por IA em comparação com o OCR tradicional?
As ferramentas de entrada de dados por IA geralmente são baseadas em assinatura, com planos de preço por página ou por documento. Ferramentas de OCR tradicionais costumam ser mais baratas no nível básico, mas exigem investimento adicional em configuração de modelos, manutenção e no trabalho manual de estruturar o texto bruto que produzem. A diferença de custo raramente está apenas no preço do software — está no custo operacional total, incluindo o tempo gasto no tratamento dos dados após a extração. Nosso comparativo de custos entre OCR gratuito e extração por IA e a visão geral do cenário de preços de 2026 abordam isso em detalhes.
O que acontece com meus documentos após o processamento?
Isso varia conforme o provedor. Ferramentas confiáveis processam os documentos, extraem os dados e descartam os arquivos originais — elas não armazenam nem treinam com seus documentos. Sempre verifique a política de tratamento de dados do provedor antes de enviar documentos confidenciais. Procure compromissos explícitos sobre exclusão de arquivos, não treinamento com dados do usuário e criptografia em trânsito e em repouso.
A entrada de dados por IA muda o que é possível no processamento de documentos — não ao fazer a mesma coisa mais rápido, mas ao fazer algo completamente diferente. A questão não é se é melhor que o OCR. É se os documentos que você processa diariamente são estruturados o suficiente para a IA lidar com eles, e se o tempo que você economizaria vale mais do que o custo da ferramenta. A única forma de saber é testar com seus próprios documentos.