Como Testar a Precisão da Extração de Documentos na Prática
Um Guia Prático para Quem Está Avaliando Ferramentas de AI OCR
Toda ferramenta de extração de documentos no mercado diz a mesma coisa: "99% de precisão." A afirmação aparece nas páginas de vendas dos fornecedores, em apresentações comerciais e em tabelas de comparação de produtos. É um número sem uma definição acordada por trás — 99% do quê, medido como, em quais documentos, sob quais condições? Este guia substitui esse único número de marketing por uma estrutura que você pode usar você mesmo. Veja o que a precisão realmente significa em quatro níveis diferentes, quais métricas preveem resultados reais de negócios e um protocolo passo a passo para executar seu próprio teste de precisão — usando conjuntos de dados públicos gratuitos ou seus próprios documentos — antes de se comprometer com qualquer ferramenta.
Principais Conclusões
- Quando um fornecedor afirma "99% de precisão", pergunte 99% do quê — taxas em nível de caractere, campo, documento e processamento direto contam quatro histórias diferentes sobre a mesma ferramenta.
- Com 97% de precisão de campo em uma fatura de 15 campos, mais de um em cada três documentos contém pelo menos um erro — a lacuna que a maioria das equipes descobre apenas depois que a ferramenta é implantada.
- A média do setor para processamento direto é de 32% — a extração de AI de melhor desempenho chega a 60–80%, eliminando aproximadamente metade do esforço de revisão manual.
- Testar 10 faturas limpas produz números de precisão que não preveem nada — uma estimativa estável requer 100+ documentos em sua mistura real de fornecedores, incluindo os de pior qualidade.
- Pontue cabeçalhos, itens de linha e totais calculados separadamente — calcular a média deles juntos esconde 85% de precisão em itens de linha atrás de 99% de precisão em cabeçalhos, o que parece bom em um scorecard, mas é diferente nas operações diárias.
Por que "99% de precisão" é um número sem sentido por si só
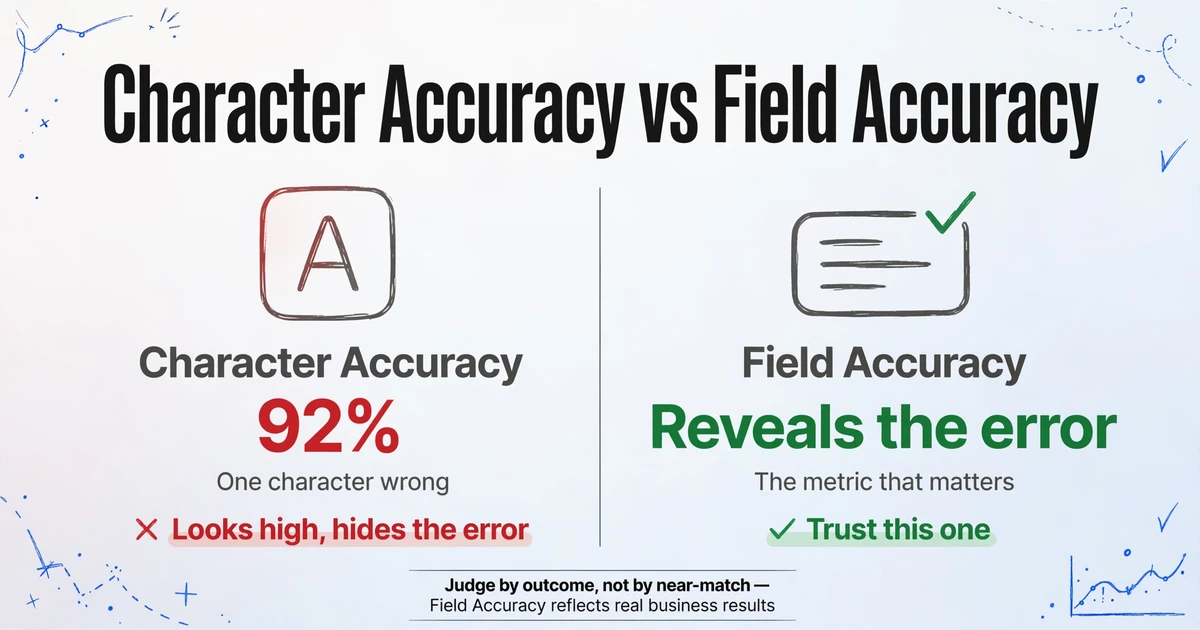
"Precisão" na extração de documentos não é um número — são quatro números diferentes que contam quatro histórias diferentes sobre a mesma ferramenta. A maioria dos fornecedores escolhe aquele que faz seu produto parecer melhor. Entender qual deles está sendo mostrado é o primeiro passo para avaliar qualquer afirmação com honestidade.
Nível 1 — Precisão de caracteres (CER). Qual porcentagem de caracteres individuais foi lida corretamente? Se um documento contém 500 caracteres e a ferramenta lê 495 deles corretamente, a precisão de caracteres é de 99%. OCR tradicional em texto impresso limpo varia de 85–97%; modelos modernos de visão de IA alcançam 98–99,5%. Esta é a métrica mais fácil de atingir e a base da maioria das afirmações dos fornecedores — mas é quase inútil para decisões de negócios. Considere um exemplo do mundo real:
Um número de fatura "INV-20260412" é lido como "INV-2O260412" — um caractere errado, 92% de precisão de caracteres neste campo, parece razoável. Mas o valor do campo está completamente errado para correspondência de AP. A precisão de caracteres disse que a ferramenta acertou na maior parte; o resultado de negócios diz que ela errou completamente.
Nível 2 — Precisão de campos. Um campo está correto apenas quando cada caractere naquele campo está correto. Um caractere errado = o campo inteiro falha. Esta é a métrica que importa para operações. A extração tradicional baseada em modelos alcança 70–90% de precisão de campos em conjuntos variados de documentos porque variações de formato quebram os modelos. A extração baseada em IA alcança 95–99,5% de precisão de campos em documentos comerciais padrão. Com 98% de precisão de caracteres, um número de fatura de 10 caracteres estará errado aproximadamente 18% das vezes — a precisão de caracteres mascara falhas no nível de campo.
Nível 3 — Precisão de documentos. Um documento conta como correto apenas quando cada campo naquele documento está correto. Se você extrai 15 campos por fatura e sua precisão de campos é de 97%, a probabilidade de que todos os 15 campos estejam corretos em qualquer fatura é de 0,97^15 = aproximadamente 63%. Isso significa que 37% das suas faturas — mais de uma em três — têm pelo menos um erro de campo. Uma taxa de precisão de campos de 97% parece impressionante; uma taxa de precisão de documentos de 63% revela quanta revisão humana ainda é necessária.
Nível 4 — STP (Straight-Through Processing). A porcentagem de documentos que exigem zero intervenção humana — sem correções, sem sinalizações de revisão, sem intervenção manual. Este é o número que se traduz diretamente em custo de mão de obra. O relatório de métricas de AP de 2025 da Ardent Partners coloca a taxa média de STP da indústria em 32,6%, a Best-in-Class em 49,2%, e implementações líderes de IA em 60–80%. A diferença entre 32% e 80% de STP representa aproximadamente metade do esforço de revisão manual eliminado por completo. Esse é o número que aparece no quadro de funcionários e nas horas extras do seu departamento — por isso é o nível que importa e o que os fornecedores quase nunca publicam.
Quando um fornecedor diz "99% de precisão", pergunte: 99% de quê? Caracteres, campos, documentos ou STP (Straight-Through Processing)? A resposta diz se o número significa algo ou nada.
Os Únicos Três Números Que Sua Empresa Realmente Precisa
Esqueça a alegação de marketing. Ao avaliar uma ferramenta de extração de documentos para operações reais, três métricas dizem quase tudo que você precisa saber — e nenhuma delas é o número na página inicial do fornecedor.
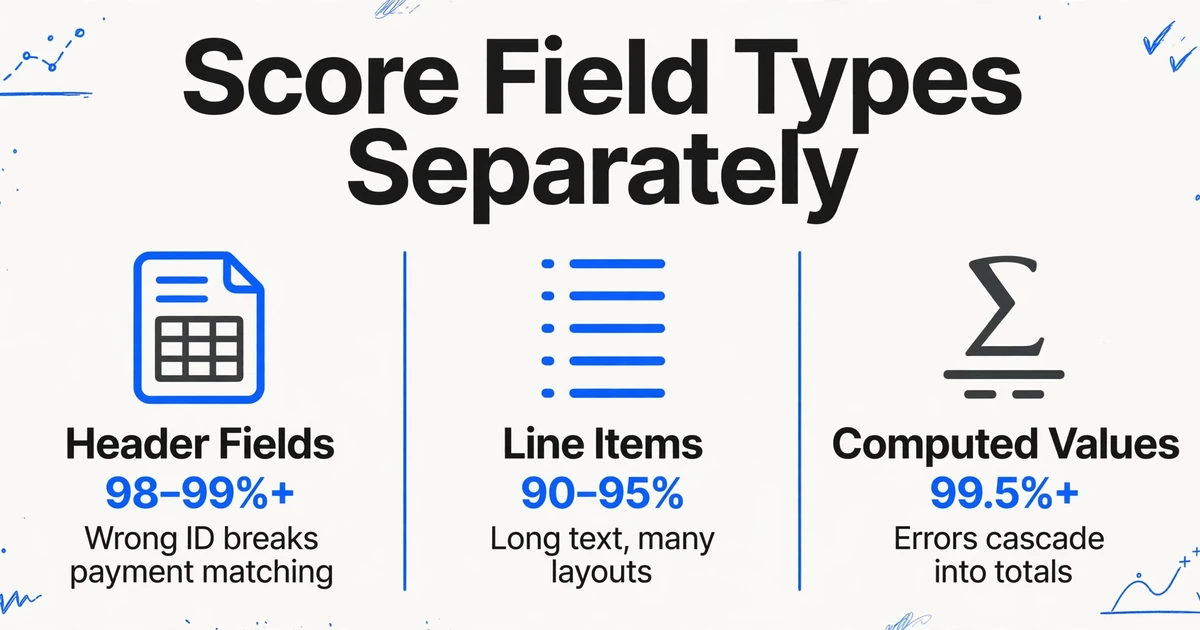
Precisão de campo: quantas correções por dia. Para campos de cabeçalho — números de fatura, datas, nomes de fornecedores, totais — ferramentas de IA devem atingir 98–99%+ em documentos limpos. Para itens de linha — descrições de produtos, preços unitários, quantidades — 90–95% é uma expectativa mais realista, pois itens de linha envolvem mais texto, mais variação e mais complexidade de formatação. A pergunta prática não é "qual é o percentual de precisão de campo" — é "quantas correções minha equipe fará por dia no nosso volume?"
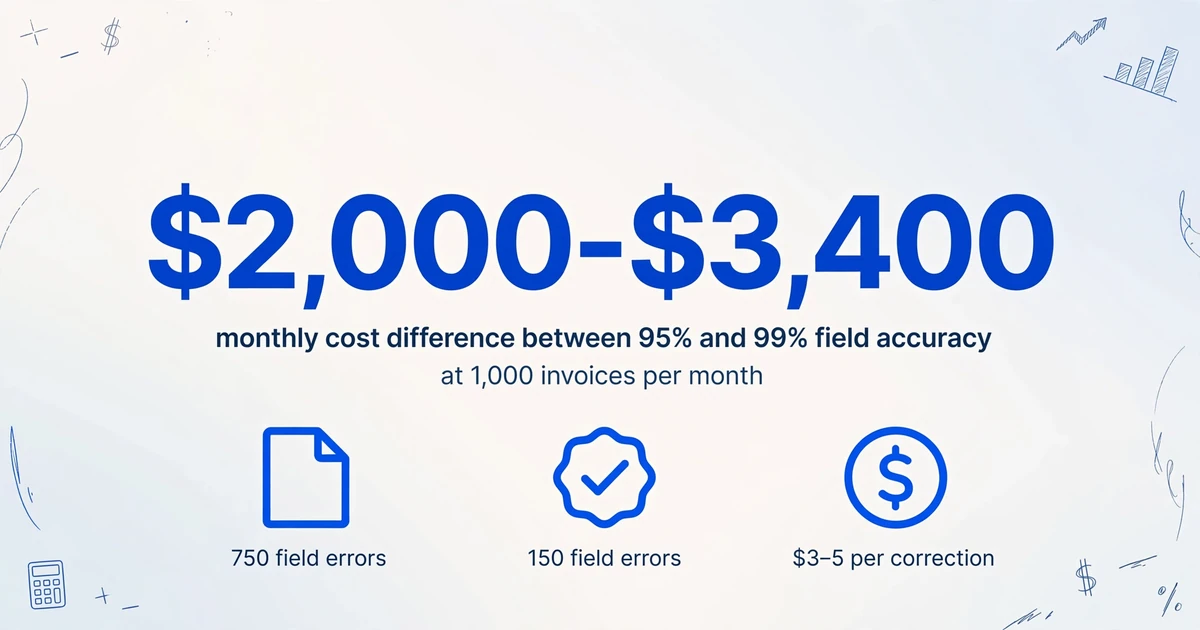
Precisão de documento: quantas faturas precisam de qualquer toque humano. Isso é a precisão de campo composta em todos os campos de um documento. Em 1.000 faturas por mês com 15 campos cada, a diferença entre 95% e 99% de precisão de campo é a diferença entre 750 erros de campo por mês e 150 erros de campo por mês. Cada correção custa cerca de $3–5 em mão de obra (localizar o erro, verificar o documento de origem, corrigir a célula). Isso é uma diferença mensal de $2.000–$3.400 — em uma métrica, em um departamento.
Taxa de STP: quantos passam sem intervenção. Benchmarks do setor da Ardent Partners colocam o cenário de custos em contexto: a organização média gasta $9,40 para processar uma única fatura de ponta a ponta, com tempo médio de processamento de 9,15 dias e taxa de exceção de 14%. Organizações Best-in-Class gastam $2,78 por fatura, processam em 3,1 dias e atingem taxa de exceção próxima de 5%. A diferença entre média e best-in-class não são pessoas melhores — são taxas de STP mais altas possibilitadas por automação que não exige que humanos toquem na maioria dos documentos.
Essas três métricas se conectam diretamente ao custo de uma forma que uma única alegação de "99%" nunca consegue. A precisão de campo prevê a carga diária de correções. A precisão de documento prevê quantas faturas precisam de revisão. A taxa de STP prevê quanto trabalho você pode eliminar completamente. Se um fornecedor não pode ou não quer fornecer números nesses três níveis — medidos em um conjunto de testes que você reconheceria como realista — a alegação de precisão na página inicial deles está respondendo a uma pergunta que sua empresa não está fazendo.
O que testar — e por que você não deve testar tudo igualmente
O instinto natural é testar todos os campos e calcular a média dos resultados. Isso produz um número que parece limpo, mas esconde a diferença entre campos fáceis e difíceis — que é exatamente a diferença que determina se a ferramenta funciona para o seu fluxo de trabalho.
Nem todos os campos são igualmente difíceis de extrair, e nem todas as falhas de campo têm o mesmo custo para o negócio. Um número de fatura errado significa que o pagamento não pode ser correspondido — custo alto. Um nome de fornecedor levemente truncado ("Acme Industrial Suppl" vs "Acme Industrial Supplies Inc") significa que alguém olha para ele por meio segundo — custo insignificante. Tratar ambos como erros iguais no seu cálculo de precisão infla o problema nos nomes de fornecedores e o esconde nos números de fatura.
Divida seu teste em três categorias e pontue cada uma separadamente:
Campos de cabeçalho — número da fatura, data, nome do fornecedor, referência de PO, valor total, moeda. Esses campos geralmente são bem rotulados, posicionados de forma consistente perto do topo do documento e usam formatos padronizados. Ferramentas de IA devem atingir 98–99%+ de precisão de campo nesses itens. Se uma ferramenta não atingir 95% nos campos de cabeçalho, ela não está pronta para o seu fluxo de trabalho de produção, independentemente do que mais ela faça bem.
Itens de linha — descrições de produtos, quantidades, preços unitários, totais de linha. Esses são mais difíceis porque as tabelas de itens de linha variam drasticamente em estrutura, os rótulos das colunas diferem por fornecedor e as descrições de produtos podem ser longas strings de texto livre. Ferramentas de IA normalmente atingem 90–95% de precisão de campo em itens de linha. Uma ferramenta com 92% de precisão em itens de linha, processando 1.000 faturas por mês com uma média de 3 itens de linha por fatura, significa cerca de 240 correções de campo em itens de linha por mês — cerca de 12 por dia útil. Considere isso no seu modelo de equipe.
Valores calculados ou derivados — subtotais que devem ser iguais à soma dos itens de linha, valores de impostos que devem corresponder à taxa declarada, totais que devem reconciliar entre seções. Esses são os campos onde erros de extração se acumulam em discrepâncias financeiras. Teste-os separadamente e defina um padrão mais alto: valores totais devem ter 99,5%+ de precisão, porque uma fatura de $1.590,00 registrada como $15.900,00 é um erro muito mais caro do que um nome de produto com erro de digitação.
O que você não quer é um único número de "92% de precisão geral" que calcula a média de 99% de precisão em cabeçalhos com 85% de precisão em itens de linha. Essa média não diz nada útil; os 85% em itens de linha são o que você sentirá nas operações diárias, e isso fica escondido dentro do número composto. Pontue cada categoria de forma independente e compare as ferramentas categoria por categoria — não geral por geral.
Montando seu conjunto de teste: quantos documentos, qual variedade e onde encontrá-los
Um conjunto de teste que não reflete a sua mistura real de documentos produz números de precisão que não preveem a sua experiência real. O erro mais comum em testes de precisão — testar em um punhado de faturas limpas e familiares e assumir que os resultados se generalizam — é como as equipes acabam decepcionadas em produção.
Quantos documentos você precisa depende de quão uniforme é a sua população de documentos. Se todas as suas faturas vêm de um único fornecedor que nunca muda o formato — documentos homogêneos — de 30 a 50 documentos já dá uma estimativa estável. Sua precisão de extração não varia muito de documento para documento porque o layout é consistente. Se você recebe faturas de dezenas de fornecedores em vários formatos — documentos heterogêneos — você precisa de pelo menos 100 documentos. Cada tipo de layout distinto adicional que você quer que os resultados representem adiciona cerca de 20 a 30 documentos a mais à amostra necessária. Abaixo desses limites, sua medição de precisão quantifica variação aleatória, não o desempenho da ferramenta.
Onde encontrar documentos de teste. O melhor conjunto de teste é o seu próprio: pegue suas 50 a 100 faturas mais recentes, exporte-as do seu e-mail ou sistema de AP e anote-as. Mas se você está avaliando ferramentas antes de ter volume — ou quer uma linha de base padronizada que permita comparar ferramentas com os mesmos documentos — três conjuntos de dados públicos estão disponíveis gratuitamente:
- ICDAR SROIE (2019) — 1.000 recibos digitalizados com rótulos de verdade para quatro campos: nome da empresa, endereço, data e total. Amplamente usado como referência em pesquisa acadêmica de OCR. Bom para testar extração de recibos; menos útil para faturas com itens de linha e detalhamento de impostos.
- Middlesex Invoice Document Dataset (MIDD, 2021) — 630 PDFs de faturas em quatro modelos de layout com 11 campos rotulados cada. Mais próximo de fluxos de trabalho reais de AP do que o SROIE porque são faturas reais, não recibos, e incluem dados de itens de linha. Publicado no periódico MDPI Data com documentação completa da metodologia de anotação.
- Innovatiana Historical Invoice Dataset — aproximadamente 1.560 imagens de faturas antigas com verdade de campo em XML, lançadas sob CC0 Public Domain. Os documentos são históricos em vez de contemporâneos (layouts mais antigos, qualidade de digitalização variável), o que os torna úteis para testar como as ferramentas lidam com entrada degradada — mas menos representativos de faturas PDF digitais modernas.
Conjuntos de dados públicos são um ponto de partida útil, mas têm uma limitação: eles não representam sua mistura específica de fornecedores. As faturas que sua empresa recebe — dos seus fornecedores reais, com a terminologia e convenções de formatação do seu setor — não se parecerão exatamente com documentos de referência acadêmica. Use conjuntos de dados públicos para reduzir sua lista para duas ou três ferramentas e, em seguida, faça uma segunda rodada de testes com 30 a 50 das suas próprias faturas reais antes de tomar uma decisão final.
Executando o Teste: Um Protocolo Simples em Quatro Etapas
Você não precisa de código, integração com API ou formação em ciência de dados. Uma planilha, uma regra de pontuação consistente e a disciplina para testar tipos de campos separadamente são suficientes para produzir números em que você pode confiar. Aqui está o protocolo.
Etapa 1 — Anote a verdade absoluta. Crie uma planilha simples com uma linha por documento e uma coluna por campo que você está testando. Para cada documento, insira manualmente o valor correto para cada campo — essa é a sua verdade absoluta. Seja preciso: se o total da fatura é $1.590,00, escreva "$1.590,00", não "1590" ou "~$1600". Inconsistência na definição da sua verdade absoluta invalida todas as comparações posteriores. Para itens de linha, anote cada linha separadamente ou escolha um subconjunto representativo (as três primeiras linhas de cada fatura, por exemplo) em vez de tentar anotar todas as linhas de todos os documentos — o último caso é o tipo de trabalho manual que você está tentando eliminar.
Etapa 2 — Compare o extraído com o esperado usando regras de normalização consistentes. Antes de pontuar um único campo, escreva suas regras de normalização. Defina o que conta como correspondência. Um conjunto inicial razoável:
• Datas: normalize para AAAA-MM-DD, aceite qualquer formato de entrada desde que a data esteja correta ("01/15/2026" corresponde a "15 de jan. de 2026").
• Valores monetários: remova símbolos de moeda, aceite equivalência numérica ($1.590,00 corresponde a 1590.00).
• Espaços em branco: remova espaços no início/fim; "Acme Corp" corresponde a " Acme Corp ".
• Maiúsculas/minúsculas: correspondência sem diferenciar maiúsculas de minúsculas para campos de texto; "ACME CORP" corresponde a "Acme Corp."
• Nomes parciais de fornecedores: você precisará de um julgamento aqui. "Acme Industrial Supplies Inc" e "Acme Industrial Suppl" — isso é uma correspondência? Defina sua regra antes de pontuar. A maioria das equipes aceita nomes truncados que identificam inequivocamente o fornecedor; rejeite qualquer coisa ambígua.
A regra crítica: aplique a mesma normalização a todas as ferramentas que você testar. Se você for flexível com a interpretação de datas de uma ferramenta e rígido com a de outra, sua comparação é inválida. Mesmas regras, mesmo conjunto de testes, mesma verdade absoluta — cada variação que você introduz torna os resultados menos comparáveis.
Etapa 3 — Pontue por tipo de campo separadamente. Para cada documento, marque cada campo como correto (1) ou incorreto (0). Calcule a precisão por tipo de campo: precisão do cabeçalho = extrações corretas do cabeçalho ÷ total de campos de cabeçalho testados. Precisão dos itens de linha = extrações corretas de itens de linha ÷ total de campos de itens de linha testados. Precisão dos totais = extrações corretas de totais ÷ total de campos de totais testados. Relate três porcentagens separadas, não um número composto. Uma ferramenta com 99% de precisão no cabeçalho e 85% nos itens de linha é uma ferramenta diferente — para a experiência diária da sua equipe — daquela com 95% de precisão no cabeçalho e 93% nos itens de linha, mesmo que suas pontuações compostas sejam semelhantes.
Etapa 4 — Procure padrões nas falhas antes de olhar as pontuações agregadas. Não pare em "92% de precisão nos itens de linha." Veja quais documentos falharam, quais campos falharam e se há um padrão. Padrões comuns que importam: as faturas de um fornecedor falham consistentemente (a ferramenta tem dificuldade com esse layout específico) → você precisará de uma solução alternativa para esse fornecedor. Fotos de documentos em papel tiradas por celular falham mais do que PDFs digitais (a qualidade da imagem degrada a extração) → os recibos de despesas da sua equipe de campo terão precisão menor do que faturas enviadas por e-mail. Campos de data falham em taxas mais altas perto das fronteiras de mês/ano (os modelos confundem data de emissão vs. data de vencimento em faturas do mesmo mês) → seu lote de fechamento de fim de mês precisará de revisão extra. Se um tipo de campo falha consistentemente independentemente do fornecedor — digamos, valores de impostos estão errados 30% das vezes — isso é uma limitação da ferramenta, não um problema do documento.
Padrões de falhas são mais acionáveis do que pontuações agregadas. Uma pontuação geral de 94% que esconde uma taxa de falha de 60% em um tipo de campo crítico é pior do que uma pontuação geral de 89% em que os erros estão distribuídos uniformemente entre campos de baixo impacto. O padrão mostra o que a ferramenta pode e não pode fazer; a pontuação agregada obscurece isso.
O resultado de um bom teste de precisão não é um único número. É um detalhamento campo por campo que mostra exatamente onde a ferramenta funciona, onde não funciona e como será a carga diária de correção da sua equipe.
Três Erros em Testes de Precisão Que Tornam Seus Resultados Inúteis
A maioria dos testes de precisão produz resultados enganosos não porque a medição é difícil, mas porque o design do teste assume condições que não se sustentam em produção. Aqui estão os três erros que mais comumente transformam um resultado promissor de teste em uma implantação decepcionante.
Erro 1: Testar apenas PDFs digitais limpos quando sua mistura real inclui fotos de celular e digitalizações. Um PDF gerado digitalmente — texto nítido, contraste perfeito, sem rotação — é o input mais fácil possível para qualquer ferramenta de extração. Uma foto de uma nota fiscal em papel tirada com celular sob iluminação de escritório — leve ângulo, alguma sombra, menor contraste — é o input que sua equipe de campo ou funcionários remotos realmente enviam. Se seu conjunto de teste tem 100 PDFs limpos e seu input de produção é 60% PDFs limpos e 40% fotos de celular, seu teste superestima a precisão por uma margem que pode ser grande. Os dados da IBM sobre entrada manual de dados encontram taxas de erro de até 4% em contextos de cadeia de suprimentos; a automação STP pode reduzir isso para aproximadamente 1%, mas apenas se a qualidade do input corresponder ao que a ferramenta foi testada. Monte seu conjunto de teste para corresponder à sua mistura real de inputs — incluindo uma parcela representativa dos documentos de pior qualidade que você realmente recebe.
Erro 2: Normalizar de forma inconsistente entre ferramentas. Se você aceita "01/15/2026" como correspondente a "Jan 15, 2026" para a Ferramenta A, mas exige correspondência exata de string para a Ferramenta B, seu teste não compara a precisão das ferramentas — compara sua generosidade na pontuação. A correção é simples, mas raramente feita: escreva suas regras de normalização em um documento compartilhado antes de executar qualquer extração e aplique as mesmas regras à saída de cada ferramenta. Mesmo pequenas inconsistências se acumulam: se suas regras de normalização diferem em cinco campos em 100 documentos, são 500 decisões de pontuação em que o viés (mesmo não intencional) pode inclinar os resultados. Mesmas regras, mesma verdade básica, mesmo conjunto de teste. Trave todos os três antes de extrair um único documento.
Erro 3: Testar poucos documentos. Dez notas fiscais de dois fornecedores produzem um número de precisão que diz como a ferramenta se comporta naquelas dez notas específicas daqueles dois fornecedores específicos — e nada mais. O intervalo de confiança em uma amostra tão pequena é amplo o suficiente para tornar o resultado sem sentido. Vinte notas de dez fornecedores é melhor, mas ainda ruidoso: um fornecedor particularmente difícil que representa 3 dos seus 20 documentos de teste pode alterar a precisão agregada em vários pontos percentuais. As regras de tamanho de amostra da seção quatro não são arbitrárias. Abaixo de 30 documentos para um conjunto homogêneo ou 100 documentos para um conjunto heterogêneo, sua medição de precisão está medindo ruído de amostra mais do que desempenho da ferramenta.
Um quarto erro, mais sutil, merece destaque mesmo não se encaixando no protocolo de teste em si: testar apenas em documentos onde você já sabe qual é a saída esperada da ferramenta. Esse é o problema do "documento que parece a demonstração". Os documentos de demonstração dos fornecedores são selecionados para parecerem bons — layouts limpos, formatos padrão, campos claramente rotulados. Sua pior fatura — aquela do fornecedor que usa um layout paisagem de três colunas com anotações manuscritas na margem — é a que determina se sua equipe confia na ferramenta ou a ignora. Inclua seus piores documentos no conjunto de teste. Uma ferramenta que os processa de forma aceitável e seus documentos limpos perfeitamente é mais útil do que uma que é marginalmente melhor em documentos limpos e falha nos difíceis.
Interpretando Seus Resultados: O Que É Bom o Suficiente para o Seu Caso de Uso
Você tem os números. Agora precisa decidir se eles justificam a troca do seu processo atual. A resposta depende do que você está usando para a extração — a mesma precisão que é inaceitável para relatórios financeiros pode ser perfeitamente adequada para substituir a entrada de dados. Veja como interpretar os resultados por caso de uso.
Substituição pura de entrada de dados: você está substituindo uma pessoa que digita campos de fatura em uma planilha. Nesse caso, 95%+ de precisão de campo nos campos de cabeçalho é aceitável — você ainda acerta 19 de 20 campos automaticamente, e a carga de correção no 20º é trivial comparada a digitar todos os 20. A precisão de itens de linha de 90%+ é viável porque a alternativa é digitar cada descrição de produto, quantidade e preço unitário manualmente. O benchmark aqui é seu processo atual — entrada manual com sua própria taxa de erro de 1–4%. A extração por IA com 95%+ é melhor que a entrada manual tanto em velocidade quanto em precisão.
Correspondência de PO e automação de AP: você precisa que valores de fatura, números de PO e nomes de fornecedores correspondam exatamente aos pedidos de compra no seu ERP. Os campos de valor precisam de 99%+ de precisão porque um valor incompatível quebra a correspondência e exige investigação humana. Os campos de cabeçalho precisam de 98%+ porque um número de PO errado envia a fatura para a fila de aprovação errada. Com 95% de precisão de campo em 1.000 faturas por mês, você está olhando para cerca de 50 incompatibilidades relacionadas a valores mensalmente — cada uma exigindo investigação manual. A economia muda em 99%+, onde esse número cai para 10 ou menos.
Relatórios financeiros e conformidade: a precisão dos itens de linha se torna a métrica crítica porque os itens de linha alimentam a alocação de custos, relatórios fiscais e trilhas de auditoria. Uma precisão de 92% nos itens de linha em 1.000 faturas com média de 3 itens de linha cada significa cerca de 240 erros de itens de linha por mês — cerca de 12 por dia útil. Para o fechamento mensal, esses erros precisam ser encontrados e corrigidos antes que os números sejam reportados. Se a precisão dos itens de linha estiver abaixo de 95% e sua equipe for responsável por relatórios financeiros baseados nos dados extraídos, reserve um orçamento para uma etapa de verificação.
Fluxos de trabalho mistos (o caso mais comum): a maioria das equipes não se encaixa claramente em uma categoria. Você pode precisar de 99%+ em valores e números de PO para correspondência de AP, mas 90%+ em descrições de produtos é suficiente porque as descrições são para referência interna, não para conciliação. É por isso que testar cada tipo de campo separadamente importa: você pode aceitar menor precisão em campos de baixo impacto enquanto mantém o padrão em campos de alto impacto. Uma ferramenta com 85% de precisão em descrições de produtos e 99,5% de precisão em valores pode ser mais adequada do que uma com 92% em tudo — mas você só pode fazer essa escolha se os avaliou separadamente.
Os dados de custo da Ardent Partners oferecem uma verificação útil da realidade: com um custo médio de processamento de US$ 9,40 por fatura, até melhorias modestas no STP geram ganhos significativos. Passar de 32% de STP (média do setor) para 50% de STP em 1.000 faturas por mês significa 180 faturas a menos exigindo intervenção manual — e, com 5 a 8 minutos de revisão manual por fatura, isso representa de 15 a 24 horas de trabalho recuperadas todos os meses. A porcentagem de precisão que possibilita essa melhoria no STP depende da complexidade dos seus documentos e da sua tolerância a erros, não de um benchmark genérico. Execute o teste nos seus próprios documentos e calcule a recuperação de trabalho com base no seu volume real e na sua tolerância real a erros. Esse número — não a alegação de nenhum fornecedor — é o seu ROI.
FAQ
Só tenho 20 notas fiscais próprias. Isso é suficiente para testar?
Vinte notas de um único fornecedor ou formato dá uma noção direcional — o suficiente para detectar problemas gritantes — mas não uma estimativa estável de precisão. O intervalo de confiança em uma amostra tão pequena é amplo: uma precisão medida de 95% pode significar que a precisão real está entre 85% e 99%. No mínimo, complemente suas 20 notas com um dos conjuntos de dados públicos (SROIE ou MIDD) para chegar a 50+ documentos. Melhor ainda: colete 50 notas próprias — mesmo de apenas 3 a 5 fornecedores — antes de confiar nos resultados. O limite do tamanho da amostra é a diferença entre "esta ferramenta parece ok" e "eu sei qual será a carga de correção da minha equipe."
Devo testar documentos manuscritos separadamente?
Sim. A caligrafia introduz um perfil de erro diferente — confusão de caracteres (1 vs. 7, 0 vs. O), espaçamento inconsistente e legibilidade variável entre escritores — que não se aplica a texto impresso. Uma ferramenta que atinge 98% de precisão de campos em notas impressas pode cair para 70–80% em formulários manuscritos. Se documentos manuscritos fazem parte do seu mix real de documentos (recibos de entrega, formulários de inspeção de campo, ordens de compra manuscritas), monte um subconjunto de teste separado para eles e avalie-o de forma independente. Calcular a média entre a precisão de manuscritos e impressos esconde a degradação — você quer saber se a ferramenta é utilizável em caligrafia, não se a média fica aceitável.
E quanto a notas fiscais em outros idiomas?
A maioria dos modelos de visão de IA (GPT-4o, Claude, Gemini) lida com os principais idiomas — espanhol, francês, alemão, japonês, chinês — tão bem quanto lida com inglês, porque os dados de treinamento subjacentes são multilíngues. Nomes de campos em diferentes idiomas ("Numéro de facture," "Rechnungsnummer," "請求書番号") são reconhecidos como equivalentes a "Invoice Number" pela compreensão semântica do modelo. Onde a precisão degrada é em idiomas com menos dados de treinamento e em documentos cujas convenções de layout diferem significativamente dos formatos de nota ocidentais — alguns formatos de nota asiáticos, por exemplo, usam fluxo de texto vertical ou estruturas de tabela que diferem do layout da esquerda para a direita, de cima para baixo, no qual os modelos são predominantemente treinados. Se o seu mix de documentos inclui uma parcela significativa de notas em outros idiomas, inclua uma amostra representativa no seu conjunto de teste em vez de assumir que os resultados em inglês se transferem.
Preciso testar novamente após atualizações da ferramenta?
Para ferramentas tradicionais de OCR e baseadas em modelos, as atualizações geralmente não mudam o comportamento de extração em modelos existentes, então não é necessário testar novamente. Para ferramentas baseadas em IA, atualizações do modelo subjacente podem mudar o comportamento de extração — às vezes melhorando a precisão, ocasionalmente introduzindo regressões em casos extremos. Um re-teste leve em um subconjunto de 10 documentos após grandes atualizações de modelo é uma prática razoável se o seu fluxo de trabalho depende de alta precisão para fins financeiros ou de conformidade. Você não precisa refazer o protocolo completo de 100 documentos a cada vez; uma verificação rápida nos seus documentos mais representativos e nos mais problemáticos detectará regressões que importam.
Como comparo duas ferramentas de forma justa?
Mesmo conjunto de testes, mesmas anotações de referência, mesmas regras de normalização, mesma metodologia de pontuação. Se você testar a Ferramenta A nas primeiras 50 faturas da sua pasta e a Ferramenta B nas 50 seguintes, você não comparou ferramentas — você comparou dois conjuntos de testes diferentes. Crie um conjunto de testes anotado, execute ambas as ferramentas nele e pontue ambas usando regras idênticas. Se a Ferramenta A suportar um recurso que a Ferramenta B não suporta (como normalização automática de datas), aplique a regra de normalização que você definiu antes de testar — não dê crédito à Ferramenta A por um recurso afrouxando o padrão de pontuação. O objetivo é uma comparação da precisão de extração sob condições iguais, não uma comparação de recursos de pós-processamento.
E se a ferramenta tiver um recurso de pontuação de confiança?
Pontuações de confiança — em que a ferramenta sinaliza extrações de baixa confiança para revisão humana — podem reduzir significativamente a carga de correção manual se as pontuações forem confiáveis. Uma ferramenta que atinge 95% de precisão de campos, mas sinaliza corretamente 80% dos seus erros com pontuações de baixa confiança, efetivamente transforma uma taxa de erro de 5% em uma taxa de erro não detectado de 1% (os 20% de erros que ela não sinalizou). Teste as pontuações de confiança como parte da sua avaliação: para os campos que a ferramenta sinalizou como baixa confiança, qual foi a taxa de erro real? Para os campos que ela sinalizou como alta confiança, algum estava errado? Um sistema de pontuação de confiança mal calibrado — sinalizando extrações corretas como baixa confiança (falsos positivos que desperdiçam tempo de revisão) ou deixando passar erros reais (falsos negativos que permitem a passagem de dados ruins) — é pior do que nenhum sistema de confiança, porque cria uma falsa sensação de segurança.
O melhor número de precisão é aquele que você mesmo mediu — nos seus documentos, com as suas definições de campos, avaliado de acordo com a sua tolerância a erros. Toda ferramenta deste mercado consegue encontrar uma forma de alegar 99% de alguma coisa. A questão não é o que elas alegam. É o que você consegue verificar, nos documentos que realmente chegam à sua caixa de entrada, para os campos que a sua equipe realmente precisa.
Se você está avaliando ferramentas de extração e quer colocar este protocolo em prática, o ImageToTable.ai opera com um LLM visual que extrai por semântica de campos, e não por coordenadas de modelo — ou seja, você define os campos desejados uma única vez e a mesma extração funciona em qualquer layout de fornecedor. A comparação entre AI e OCR tradicional aborda a diferença arquitetural que torna isso possível, o guia de conceitos de extração de documentos explica como a extração semântica em nível de campo difere do OCR em nível de caractere na prática, e a extração de colunas personalizadas mostra como definir quais campos testar em primeiro lugar. Execute o protocolo de teste, avalie cada tipo de campo separadamente e veja se os números correspondem às alegações.
Envie seus próprios documentos e teste a extração em nível de campo você mesmo — sem configuração, sem modelos e sem dados de treinamento.
Experimente o ImageToTable.ai Grátis