文書抽出精度の実際のテスト方法
AI OCRツールを評価するすべての人のための実践ガイド
市場のあらゆる文書抽出ツールが同じことを言っています。「精度99%」と。その主張はベンダーのランディングページ、営業資料、製品比較表に登場します。しかし、この数字には合意された定義がありません。何の99%なのか、どのように測定したのか、どの文書で、どのような条件下での数値なのか。このガイドでは、その単一のマーケティング用数字を、ユーザー自身が使えるフレームワークに置き換えます。精度が4つの異なるレベルで実際に何を意味するのか、どの指標が実際のビジネス成果を予測するのか、そしてツールを導入する前に無料の公開データセットまたは自社の文書を使って独自の精度テストを実施するためのステップバイステップのプロトコルを解説します。
重要ポイント
- ベンダーが「精度99%」と主張する場合、何の99%なのかを尋ねてください。文字レベル、フィールドレベル、文書レベル、ストレートスループロセッシング率は、同じツールについて4つの異なる物語を語ります。
- 15フィールドの請求書でフィールド精度が97%の場合、3件に1件以上の文書に少なくとも1つのエラーが含まれます。これは、ほとんどのチームがツールを導入した後に初めて気づくギャップです。
- 業界平均のストレートスループロセッシング率は32%です。最高水準のAI抽出では60〜80%に達し、手動レビューの労力の約半分を完全に削減します。
- クリーンな請求書10件のテストでは、何も予測できない精度数値しか得られません。安定した推定値には、実際のベンダー構成全体から、品質が最悪のものも含めて100件以上の文書が必要です。
- ヘッダー、明細項目、計算済み合計を別々にスコアリングしてください。これらを平均すると、スコアカードでは良好に見える99%のヘッダー精度の背後に、85%の明細項目精度が隠れてしまいます。日常業務ではその違いを実感することになります。
「99%の精度」が単独では意味をなさない理由
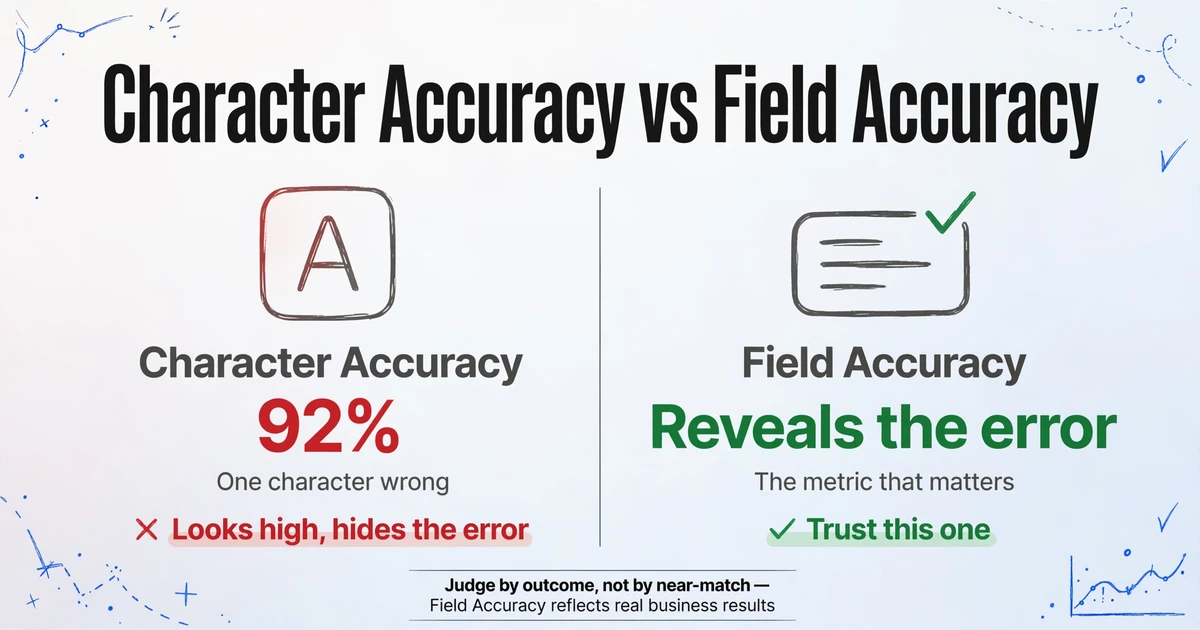
文書抽出における「精度」は単一の数値ではありません。同じツールについて異なる4つの物語を語る、4つの異なる数値なのです。ほとんどのベンダーは自社製品を最も良く見せられる指標を選びます。どの指標を見せられているのかを理解することが、あらゆる主張を正直に評価するための第一歩です。
レベル1 — 文字精度(CER)。 個々の文字が正しく読み取られた割合はどのくらいでしょうか。文書に500文字が含まれ、ツールがそのうち495文字を正しく読み取った場合、文字精度は99%です。きれいな印刷テキストに対する従来のOCRは85〜97%の範囲で、最新のAIビジョンモデルは98〜99.5%に達します。これは最も達成しやすく、ほとんどのベンダーが主張の根拠とする指標ですが、ビジネス上の意思決定にはほぼ役に立ちません。実際の例を考えてみましょう。
請求書番号「INV-20260412」が「INV-2O260412」と読み取られた場合、このフィールドの文字精度は92%で、一見妥当に思えます。しかし、AP照合にとってフィールド値は完全に間違っています。文字精度はツールがほぼ正しく読み取ったと伝えますが、ビジネス上の結果は完全に間違っていると示しています。
レベル2 — フィールド精度。 フィールド内のすべての文字が正しい場合のみ、そのフィールドは正しいとみなされます。1文字の誤り = フィールド全体の失敗です。これは運用にとって重要な指標です。従来のテンプレートベースの抽出は、さまざまな文書セットで70〜90%のフィールド精度を達成しますが、これはフォーマットのバリエーションがテンプレートを壊すためです。AIベースの抽出は、標準的なビジネス文書で95〜99.5%のフィールド精度を達成します。文字精度が98%の場合、10文字の請求書番号は約18%の確率で誤りが発生します。文字精度はフィールドレベルの失敗を隠してしまうのです。
レベル3 — 文書精度。 文書内のすべてのフィールドが正しい場合のみ、その文書は正しいとみなされます。請求書ごとに15フィールドを抽出し、フィールド精度が97%の場合、特定の請求書で15フィールドすべてが正しい確率は0.97^15 = 約63%です。つまり、請求書の37% — 3通に1通以上 — に少なくとも1つのフィールドエラーがあることになります。97%のフィールド精度は印象的に聞こえますが、63%の文書精度は、どれだけの人的レビューがまだ必要かを明らかにします。
レベル4 — STP(ストレートスループロセッシング)。 修正、レビューフラグ、手動介入を一切必要としない文書の割合です。これは人件費に直接結びつく数値です。Ardent Partnersの2025年AP指標レポートは、業界平均のSTP率を32.6%、ベストインクラスを49.2%、主要なAI導入事例を60〜80%としています。32%と80%のSTPの差は、手動レビュー作業の約半分が完全に排除されることを意味します。これは部門の人員数や残業時間に表れる数値であり、だからこそ重要なレベルであり、ベンダーがほとんど公表しないレベルなのです。
ベンダーが「99%の精度」と言ったら、こう尋ねてください。「何に対する99%ですか?文字、フィールド、文書、それともSTPですか?」その答えが、その数値に意味があるのか、それとも何も意味しないのかを教えてくれます。
ビジネスに本当に必要な3つの数字だけ
マーケティングの主張は忘れてください。実際の運用でドキュメント抽出ツールを評価する際、3つの指標がほぼすべてを物語ります。そして、そのどれもがベンダーのホームページに載っている数字ではありません。
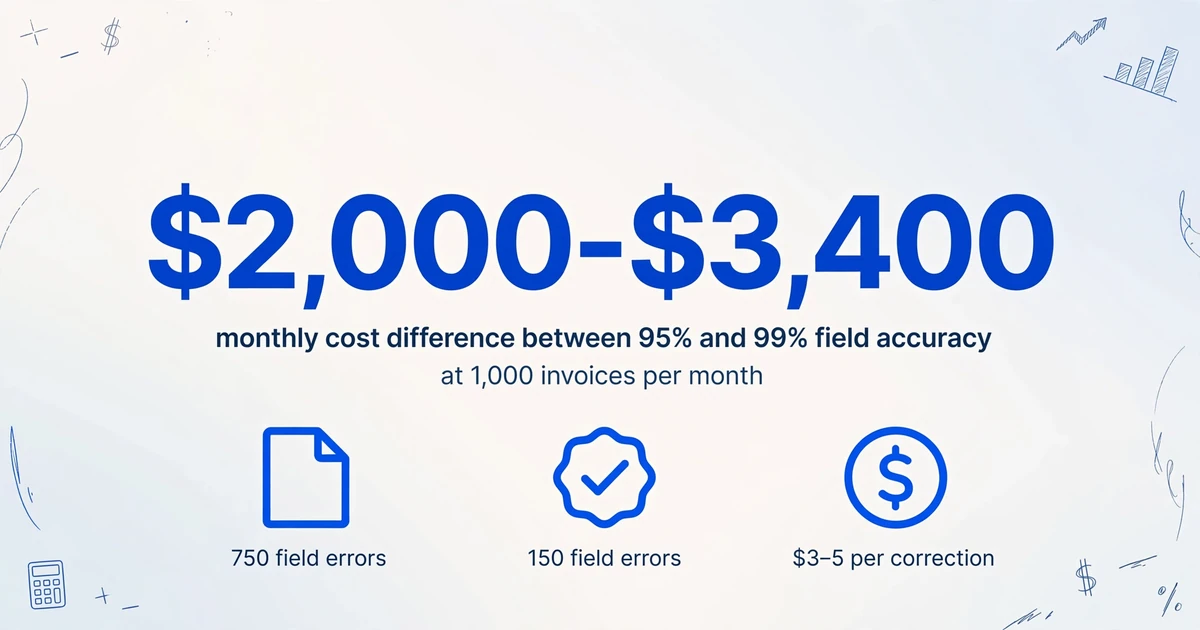
フィールド精度:1日あたりの修正回数。ヘッダーフィールド(請求書番号、日付、ベンダー名、合計金額)については、AIツールはクリーンなドキュメントで98〜99%以上の精度を達成すべきです。明細項目(製品説明、単価、数量)については、90〜95%がより現実的な期待値です。明細項目はテキストが多く、バリエーションやフォーマットの複雑さも増すためです。実際に重要な質問は「フィールド精度のパーセンテージはいくらか」ではなく、「このボリュームでチームが1日あたり何回修正するか」です。
ドキュメント精度:人間のタッチが必要な請求書の数。これは、ドキュメント上のすべてのフィールドにわたってフィールド精度を複合したものです。月1,000件の請求書、各15フィールドの場合、フィールド精度95%と99%の差は、月750件のフィールドエラーと月150件のフィールドエラーの差になります。各修正には約3〜5ドルの人件費がかかります(エラーの特定、ソースドキュメントの確認、セルの修正)。これは1つの指標、1つの部門だけで、月2,000〜3,400ドルの差になります。
STP率:無人のまま処理される割合。Ardent Partnersの業界ベンチマークがコストの全体像を明確にします。平均的な組織は1件の請求書をエンドツーエンドで処理するのに9.40ドルを費やし、平均処理時間は9.15日、例外率は14%です。ベストインクラスの組織は1件あたり2.78ドル、処理時間は3.1日、例外率は5%に近い水準です。平均とベストインクラスの差は、より優秀な人材ではなく、ほとんどのドキュメントに人間が触れる必要のない自動化によって実現される、より高いSTP率です。
これら3つの指標は、単一の「99%」という主張では決して表現できない方法でコストに直接結びつきます。フィールド精度は毎日の修正作業量を予測します。ドキュメント精度はレビューが必要な請求書の数を予測します。STP率は完全に排除できる人件費を予測します。ベンダーがこれら3つのレベルで数字を提供できない、または提供しようとしない場合(現実的だと認識できるテストセットで測定されたもの)、ランディングページの精度主張は、あなたのビジネスが尋ねていない質問に答えていることになります。
テスト対象 — そして、すべてを均等にテストすべきでない理由
自然な衝動として、すべてのフィールドをテストして結果を平均したくなります。しかし、それで得られる数字はきれいに見えますが、簡単なフィールドと難しいフィールドの違いを隠してしまいます。その違いこそが、ツールがユーザーのワークフローに適合するかどうかを左右するのです。
すべてのフィールドが同じ難易度で抽出できるわけではなく、すべてのフィールドの失敗が同じビジネスコストを伴うわけでもありません。請求書番号の誤りは支払いを照合できなくなるため、コストが高くなります。ベンダー名のわずかな省略(「Acme Industrial Suppl」と「Acme Industrial Supplies Inc」)は、誰かが一瞬目を凝らすだけで済むため、コストは無視できます。両方を精度計算で同等のエラーとして扱うと、ベンダー名の問題を過大評価し、請求書番号の問題を過小評価することになります。
テストを3つのカテゴリに分け、それぞれを個別に評価してください。
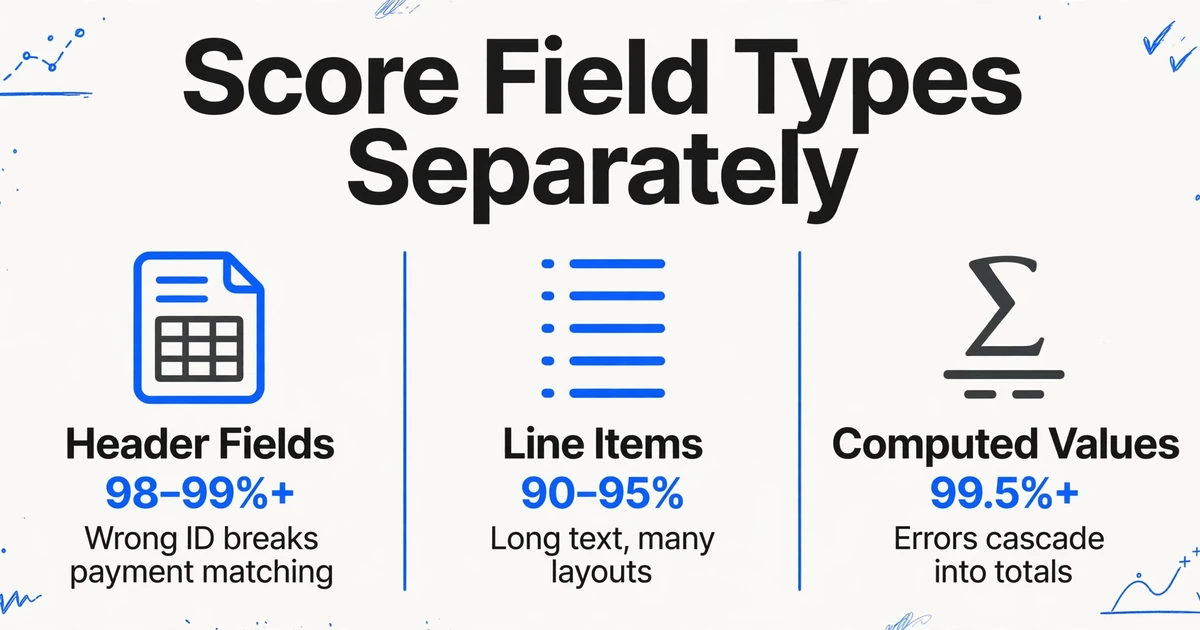
ヘッダーフィールド — 請求書番号、日付、ベンダー名、PO参照、合計金額、通貨。これらは通常、適切にラベル付けされ、ドキュメントの上部付近に一貫して配置され、標準化された形式を使用しています。AIツールはこれらのフィールドで98〜99%以上の精度を達成する必要があります。ヘッダーフィールドで95%に達しないツールは、他の機能が優れていても、本番ワークフローにはまだ適していません。
明細行 — 製品説明、数量、単価、行合計。これらは、明細行テーブルの構造が大幅に異なり、列ラベルがベンダーごとに異なり、製品説明が長い自由テキスト文字列になる可能性があるため、より困難です。AIツールは通常、明細行で90〜95%のフィールド精度を達成します。月1,000件の請求書で明細行の精度が92%、1件あたり平均3つの明細行がある場合、月に約240件の明細行フィールドの修正が必要になり、1営業日あたり約12件になります。これを人員計画に組み込んでください。
計算値または導出値 — 明細行の合計と等しくなるべき小計、記載された税率と一致するべき税額、セクション間で整合するべき合計。これらは、抽出エラーが財務上の不一致に連鎖するフィールドです。これらは個別にテストし、より高い基準を設定してください。合計金額は99.5%以上の精度が必要です。$1,590.00の請求書が$15,900.00として記録されると、製品名のスペルミスよりもはるかに高額なエラーになるからです。
避けるべきなのは、99%のヘッダー精度と85%の明細行精度を平均した「総合精度92%」という単一の数字です。その平均は何の役にも立ちません。日常業務で実感するのは明細行の85%であり、それは複合的な数字の中に隠れています。各カテゴリを独立して評価し、ツールをカテゴリごとに比較してください。全体対全体ではなく。
テストセットの構築:文書数、多様性、入手先
実際の文書構成と異なるテストセットでは、実際の運用を反映しない精度数値が算出されます。最も一般的な精度テストの誤りは、数枚のきれいで馴染みのある請求書でテストし、その結果が一般化すると想定することです。これが、本番環境でチームが失望する原因となります。
必要な文書数は、文書母集団の均一性に依存します。すべての請求書が単一のベンダーから届き、フォーマットが変わらない場合(均一文書)、30〜50枚で安定した推定値が得られます。レイアウトが一貫しているため、抽出精度は文書ごとに大きく変動しません。複数のフォーマットにわたる数十のベンダーから請求書を受け取る場合(異種文書)、少なくとも100枚が必要です。結果に反映させたい追加のレイアウトタイプごとに、必要なサンプルに約20〜30枚を追加します。これらの閾値を下回ると、精度測定はツールの性能ではなくランダムな変動を定量化することになります。
テスト文書の入手先。最良のテストセットは自社のものです。直近の50〜100枚の請求書を取得し、メールやAPシステムからエクスポートして注釈を付けます。ただし、ボリュームができる前にツールを評価する場合や、同じ文書でツールを比較できる標準化されたベースラインが必要な場合は、3つの公開データセットが無料で利用できます:
- ICDAR SROIE(2019) — 会社名、住所、日付、合計の4フィールドにグラウンドトゥルースラベルが付いた1,000枚のスキャン領収書。学術的なOCR研究でベンチマークとして広く使用されています。領収書の抽出テストに適していますが、明細項目や税額内訳のある請求書にはあまり役立ちません。
- Middlesex Invoice Document Dataset(MIDD、2021) — 4つのレイアウトテンプレートにわたる630枚の請求書PDFで、各11のラベル付きフィールドがあります。実際の請求書であり領収書ではないため、明細項目データを含み、SROIEよりも実際のAPワークフローに近いものです。注釈方法論の完全なドキュメントとともにMDPI Dataジャーナルで公開されています。
- Innovatiana Historical Invoice Dataset — CC0パブリックドメインでリリースされた、XMLグラウンドトゥルース付きの約1,560枚の古い請求書画像。文書は現代のものではなく歴史的なもの(古いレイアウト、さまざまなスキャン品質)であり、ツールが劣化した入力をどう処理するかをストレステストするのに役立ちますが、現代のデジタルPDF請求書を代表するものではありません。
公開データセットは有用な出発点ですが、特定のベンダー構成を代表しないという制限があります。実際のサプライヤーから、実際の業界の用語やフォーマット慣行で受け取る請求書は、学術的なベンチマーク文書と正確には一致しません。公開データセットを使用して候補を2〜3つのツールに絞り込み、最終決定の前に自社の実際の請求書30〜50枚で2回目のテストを実行してください。
テストの実行:シンプルな4ステップのプロトコル
コード、API連携、データサイエンスの知識は必要ありません。スプレッドシート、一貫した採点ルール、そしてフィールドタイプを分けてテストする規律があれば、信頼できる数値を得られます。以下がそのプロトコルです。
ステップ1 — 正解データ(グラウンドトゥルース)を注釈する。文書ごとに1行、テストするフィールドごとに1列のシンプルなスプレッドシートを作成します。各文書について、各フィールドの正しい値を手動で入力します — これが正解データです。正確に行いましょう:請求書の合計が$1,590.00の場合、「$1,590.00」と書き、「1590」や「約$1600」とは書きません。正解データの定義に一貫性がないと、その後のすべての比較が無効になります。明細項目については、各行を個別に注釈するか、代表的なサブセット(例:各請求書の最初の3つの明細項目)を選びましょう。すべての文書のすべての行を注釈しようとするのは、まさに排除したい手作業です。
ステップ2 — 一貫した正規化ルールを使用して抽出値と期待値を比較する。1つのフィールドを採点する前に、正規化ルールを書き留めます。一致とみなす条件を定義します。合理的な初期セット:
• 日付:YYYY-MM-DDに正規化し、日付が正しければ入力形式は問わない(「01/15/2026」は「Jan 15, 2026」と一致)。
• 通貨額:通貨記号を削除し、数値の等価性を受け入れる($1,590.00は1590.00と一致)。
• 空白:先頭・末尾のスペースを削除する。「Acme Corp」は「 Acme Corp 」と一致。
• 大文字小文字:テキストフィールドでは大文字小文字を区別しない。「ACME CORP」は「Acme Corp」と一致。
• ベンダー名の部分一致:ここは判断が必要です。「Acme Industrial Supplies Inc」と「Acme Industrial Suppl」— これは一致とみなしますか?採点前にルールを定義してください。ほとんどのチームは、ベンダーを明確に識別できる省略名を受け入れ、曖昧なものは拒否します。
重要なルール:テストするすべてのツールに同じ正規化を適用します。あるツールの日付解析に寛容で、別のツールに厳格である場合、比較は無効です。同じルール、同じテストセット、同じ正解データ — 導入するすべてのバリエーションが結果の比較可能性を低下させます。
ステップ3 — フィールドタイプごとに個別に採点する。各文書について、各フィールドを正解(1)または不正解(0)としてマークします。フィールドタイプごとに精度を計算します:ヘッダー精度 = 正しいヘッダー抽出数 ÷ テストしたヘッダーフィールド総数。明細項目精度 = 正しい明細項目抽出数 ÷ テストした明細項目フィールド総数。合計精度 = 正しい合計抽出数 ÷ テストした合計フィールド総数。1つの複合数値ではなく、3つの別々のパーセンテージを報告します。ヘッダー精度99%・明細項目精度85%のツールは、ヘッダー精度95%・明細項目精度93%のツールとは、チームの日常的な体験において異なるツールです。複合スコアが類似していてもです。
ステップ4 — 全体スコアを見る前に、失敗のパターンを探す。「明細項目精度92%」で止まらないでください。どの文書が失敗したか、どのフィールドが失敗したか、パターンがあるかを確認します。重要な一般的なパターン:特定のベンダーの請求書が一貫して失敗する(ツールがその特定のレイアウトに苦戦している)→ そのベンダーには回避策が必要です。紙文書のスマホ写真はデジタルPDFよりも失敗が多い(画像品質が抽出を低下させる)→ 現場チームの経費精算書は、メールで送られた請求書よりも精度が低くなります。日付フィールドは月・年の境界付近で高い失敗率を示す(モデルが同月の請求書で発行日と支払期日を混同する)→ 月末締めのバッチでは追加のレビューが必要です。ベンダーに関係なく1つのフィールドタイプが一貫して失敗する場合 — たとえば税額が30%の確率で間違っている場合 — それは文書の問題ではなく、ツールの制限です。
失敗のパターンは、総合スコアよりも有益です。ある重要なフィールドタイプで60%の失敗率を隠した94%の総合スコアは、エラーが重要度の低いフィールドに均等に分散している89%の総合スコアよりも悪いと言えます。パターンはツールの得意不得意を示しますが、総合スコアはそれを隠してしまいます。
優れた精度テストの成果物は、単一の数値ではありません。フィールドタイプごとの内訳であり、ツールがどこで機能し、どこで機能しないか、そしてチームの日常的な修正作業量が実際にどのようになるかを正確に示します。
精度テストで結果を無意味にする3つの間違い
ほとんどの精度テストが誤解を招く結果を生むのは、測定自体が難しいからではなく、テスト設計が本番環境では成立しない条件を前提としているからです。ここでは、有望なテスト結果を期待外れの本番導入に変えてしまう、最も一般的な3つの間違いを紹介します。
間違い1: 実際の構成にスマホ撮影やスキャンが含まれているのに、クリーンなデジタルPDFのみでテストする。 デジタル生成のPDF(鮮明なテキスト、完璧なコントラスト、回転なし)は、あらゆる抽出ツールにとって最も簡単な入力です。オフィスの照明下でスマホで撮影した紙の請求書(わずかな傾き、影、低コントラスト)は、現場チームやリモート従業員が実際に提出する入力です。テストセットがクリーンなPDF100件で、本番入力がクリーンなPDF60%とスマホ撮影40%の場合、テストは精度を大幅に過大評価します。IBMの手動データ入力に関するデータでは、サプライチェーン環境でのエラー率は最大4%とされています。STP自動化によりこれを約1%に削減できますが、それは入力品質がテスト時の条件と一致している場合に限ります。実際の入力構成に合わせてテストセットを構築し、実際に受け取る最悪品質の文書も代表的な割合で含めてください。
間違い2: ツール間で正規化の基準が一貫していない。 ツールAでは「01/15/2026」が「Jan 15, 2026」と一致すると見なす一方、ツールBでは完全な文字列一致を要求する場合、テストはツールの精度を比較しているのではなく、採点の寛大さを比較していることになります。修正方法は簡単ですが、ほとんど実行されていません。抽出を実行する前に正規化ルールを共有ドキュメントに書き、すべてのツールの出力に同じルールを適用してください。小さな不整合でも積み重なります。100件の文書の5つのフィールドで正規化ルールが異なる場合、500件の採点判断でバイアス(意図的でなくても)が結果を歪める可能性があります。同じルール、同じ正解データ、同じテストセット。1件の文書を抽出する前に、この3つをすべて固定してください。
間違い3: テストする文書数が少なすぎる。 2社からの10件の請求書から得られる精度数値は、その2社の特定の10件の請求書に対するツールの性能を示すだけで、それ以外の何も示しません。これほど少ないサンプルの信頼区間は広すぎて、結果を無意味にしてしまいます。10社からの20件の請求書は改善されますが、それでもノイズが大きいです。20件のテスト文書のうち3件を占める特に難しい1社が、総合精度を数パーセントポイント変動させる可能性があります。セクション4のサンプルサイズのルールは恣意的ではありません。均質なセットで30件未満、または異質なセットで100件未満の場合、精度測定はツールの性能よりもサンプルのノイズを測定していることになります。
4つ目の、より微妙なミスも指摘しておく価値があります。たとえテストプロトコル自体には当てはまらないとしてもです。それは、ツールの期待出力をすでに把握している文書だけでテストすることです。これは「デモ文書と同じような文書」問題です。ベンダーのデモ文書は見栄えが良くなるように選ばれています。きれいなレイアウト、標準的な形式、明確にラベル付けされたフィールド。あなたの最悪の請求書、つまり3列の横向きレイアウトで欄外に手書きのメモがあるベンダーの請求書こそが、チームがツールを信頼するか、それとも迂回するかを左右します。テストセットには最悪の文書を含めてください。難しい文書をまずまず処理し、きれいな文書を完璧に処理するツールは、きれいな文書でわずかに優れているものの難しい文書で崩れてしまうツールよりも有用です。
結果の解釈:ユースケースにとって十分な精度とは
数値は出ました。次に、それらが現在のプロセスからの移行を正当化するかどうかを判断する必要があります。答えは、抽出を何に使うかによって異なります。財務報告には受け入れられない精度でも、データ入力の置き換えにはまったく問題ない場合があります。ユースケース別の結果の解釈方法は次のとおりです。
純粋なデータ入力の置き換え:請求書のフィールドをスプレッドシートに入力する担当者の代わりをする場合です。このユースケースでは、ヘッダーフィールドの95%以上のフィールド精度で許容範囲です。20フィールド中19フィールドは自動で正しく取得でき、20番目の修正作業は20個すべてを手入力するのに比べれば取るに足らないからです。明細項目の精度が90%以上あれば実用的です。なぜなら、代替手段はすべての製品説明、数量、単価を手で入力することだからです。ここでのベンチマークは現在のプロセス、つまりそれ自体に1〜4%のエラー率がある手動入力です。95%以上のAI抽出は、速度と精度の両方で手動入力よりも優れています。
PO照合とAP自動化:請求金額、PO番号、ベンダー名がERP内の発注書と正確に一致する必要があります。金額フィールドは99%以上の精度が必要です。不一致の金額は照合を壊し、人間による調査が必要になるからです。ヘッダーフィールドは98%以上が必要です。誤ったPO番号は請求書を誤った承認キューに送ってしまうからです。月1,000件の請求書でフィールド精度95%の場合、月に約50件の金額関連の不一致が発生し、それぞれ手動調査が必要になります。経済性は99%以上で変わり、その数は10件以下に減少します。
財務報告とコンプライアンス:明細項目の精度が重要な指標になります。明細項目は原価配分、税務報告、監査証跡に反映されるからです。平均3明細の請求書1,000件で明細精度92%の場合、月に約240件の明細エラー、つまり1営業日あたり約12件のエラーが発生します。月末締めでは、数値を報告する前にこれらのエラーを発見して修正する必要があります。明細精度が95%未満で、抽出データに基づく財務報告にチームが責任を負う場合は、検証ステップの予算を組みましょう。
混合ワークフロー(最も一般的なケース):ほとんどのチームは単一のカテゴリーにきれいに分類されません。AP照合には金額とPO番号で99%以上が必要かもしれませんが、製品説明は社内参照用であり照合用ではないため、90%以上で問題ない場合もあります。これが、フィールドタイプごとに個別にテストすることが重要である理由です。影響の少ないフィールドでは低い精度を受け入れつつ、影響の大きいフィールドでは基準を維持できます。製品説明で85%の精度、金額で99.5%の精度のツールは、全体で92%のツールよりも適しているかもしれません。ただし、その判断ができるのは、個別にスコアリングした場合だけです。
Ardent Partnersのコストデータは有益な現実確認となります。請求書1件あたりの平均処理コストが$9.40であることを踏まえると、わずかなSTP改善でも意味のある複合効果が生まれます。月間1,000件の請求書でSTPを32%(業界平均)から50%に引き上げると、手動処理が必要な請求書が180件減少します。請求書1件あたりの手動レビューに5〜8分かかる場合、毎月15〜24時間の労働時間が削減されます。そのSTP改善を実現する精度は、一般的なベンチマークではなく、ドキュメントの複雑さとエラー許容度によって決まります。ご自身のドキュメントでテストを実行し、実際のボリュームと実際のエラー許容度で労働時間の削減効果を計算してください。その数値こそが、ベンダーの主張ではなく、あなたのROIです。
よくある質問
自分の請求書が20枚しかありません。テストには十分ですか?
単一のベンダーまたは形式からの20枚の請求書では、方向性は掴めます(明らかな問題を検出するには十分)が、安定した精度の推定にはなりません。その程度のサンプルサイズでは信頼区間が広く、測定精度が95%でも、実際の精度は85%から99%の範囲に収まる可能性があります。最低限、公開データセット(SROIEまたはMIDD)を追加して50枚以上に増やしましょう。理想的には、結果を信頼する前に、自社の請求書を50枚(3〜5社のベンダーからでも可)集めることです。サンプルサイズの閾値が、「このツールは問題なさそう」と「チームの修正作業量が正確に見積もれる」の違いを生みます。
手書き文書は別途テストすべきですか?
はい。手書き文字は、印刷テキストにはない異なるエラープロファイル(文字の混同(1と7、0とO)、不規則な間隔、筆記者による可読性のばらつき)を引き起こします。印刷された請求書でフィールド精度98%を達成するツールでも、手書きフォームでは70〜80%に低下する可能性があります。手書き文書が実際の文書構成に含まれる場合(納品書、現場点検フォーム、手書きの発注書など)、それら専用のテストサブセットを作成し、独立して評価してください。手書きと印刷の精度を平均すると劣化が隠れてしまいます。重要なのは、ツールが手書きで使えるかどうかであり、平均的に許容範囲かどうかではありません。
英語以外の請求書はどうですか?
ほとんどのAIビジョンモデル(GPT-4o、Claude、Gemini)は、トレーニングデータが多言語であるため、英語と同様に主要言語(スペイン語、フランス語、ドイツ語、日本語、中国語)を処理できます。異なる言語のフィールド名(「Numéro de facture」「Rechnungsnummer」「請求書番号」)は、モデルの意味理解により「Invoice Number」と同等として認識されます。精度が低下するのは、トレーニングデータが少ない言語や、レイアウトの慣習が西洋の請求書形式と大きく異なる文書です。例えば、一部のアジアの請求書形式では、モデルが主にトレーニングされている左から右、上から下のレイアウトとは異なる縦書きや表構造を使用します。文書構成に英語以外の請求書がかなりの割合を占める場合は、英語の結果がそのまま適用されると想定せず、テストセットに代表的なサンプルを含めてください。
ツールが更新されたら再テストが必要ですか?
従来のOCRやテンプレートベースのツールでは、更新によって既存テンプレートの抽出動作が変わることは通常ないため、再テストは不要です。AIベースのツールでは、基盤となるモデルの更新により抽出動作が変わる可能性があり、精度が向上することもあれば、エッジケースで回帰が発生することもあります。財務やコンプライアンス目的で高い精度に依存している場合は、主要なモデル更新後に10文書のサブセットで軽量な再テストを行うのが合理的です。毎回100文書の完全なプロトコルを再実行する必要はなく、最も代表的で問題の多い文書を素早くチェックすれば、重要な回帰を検出できます。
2つのツールを公平に比較するにはどうすればよいですか?
同じテストセット、同じ正解アノテーション、同じ正規化ルール、同じスコアリング方法を使用します。フォルダ内の最初の50件の請求書でツールAをテストし、次の50件でツールBをテストした場合、それはツールの比較ではなく、2つの異なるテストセットの比較です。注釈付きのテストセットを1つ作成し、両方のツールをそれに対して実行し、同一のルールでスコアリングしてください。ツールAにツールBにはない機能(自動日付正規化など)がある場合は、テスト前に定義した正規化ルールを適用してください。スコアリング基準を緩めてツールAに機能の分の加点をしないでください。目標は、同等の条件下での抽出精度の比較であり、後処理機能の比較ではありません。
ツールに信頼度スコア機能がある場合はどうすればよいですか?
信頼度スコア(ツールが低信頼度の抽出結果を人間によるレビュー用にフラグ付けする機能)は、スコアが信頼できる場合、手動修正の負担を大幅に軽減できます。フィールド精度95%を達成し、エラーの80%を低信頼度スコアで正しくフラグ付けするツールは、5%のエラー率を実質的に1%の未検出エラー率(フラグ付けされなかった20%のエラー)に変えます。評価の一環として信頼度スコアをテストしてください:ツールが低信頼度としてフラグ付けしたフィールドの実際のエラー率はどのくらいでしたか?高信頼度としてフラグ付けしたフィールドに誤りはありましたか?校正が不十分な信頼度スコアシステム(正しい抽出結果を低信頼度としてフラグ付けする誤検知でレビュー時間を浪費する、または実際のエラーを見逃す見逃しで不正なデータを通してしまう)は、誤った安心感を生み出すため、信頼度システムがない状態よりも悪いです。
最良の精度数値とは、ご自身で測定したものです。ご自身のドキュメント、ご自身のフィールド定義、ご自身のエラー許容度に基づいて評価した数値です。この市場のあらゆるツールが、何らかの形で99%を主張できます。問題は彼らの主張ではなく、実際に受信トレイに届くドキュメントと、チームが実際に必要とするフィールドに対して、何を検証できるかです。
抽出ツールを評価中で、このプロトコルを実践したい場合は、ImageToTable.aiが視覚LLMを採用しており、テンプレート座標ではなくフィールドの意味に基づいて抽出を行います。つまり、必要なフィールドを一度定義すれば、どのベンダーのレイアウトでも同じ抽出が機能します。AIと従来のOCRの比較では、これを可能にするアーキテクチャ上の違いを解説し、ドキュメント抽出の概念ガイドでは、フィールドレベルの意味抽出が文字レベルのOCRと実際にどう異なるかを説明し、カスタム列抽出では、テスト対象のフィールドを最初にどう定義するかを示しています。テストプロトコルを実行し、フィールドタイプごとにスコアリングして、数値が主張と一致するかどうかを確認してください。
ご自身のドキュメントをアップロードして、フィールドレベルの抽出を自分でテストしてください。セットアップ不要、テンプレート不要、トレーニングデータ不要です。
ImageToTable.aiを無料で試す