So testen Sie die Genauigkeit der Dokumentextraktion tatsächlich
Ein praktischer Leitfaden für alle, die AI-OCR-Tools bewerten
Jedes Dokumentextraktionstool auf dem Markt sagt dasselbe: „99 % Genauigkeit." Diese Behauptung findet sich auf den Landingpages der Anbieter, in Verkaufspräsentationen und in Produktvergleichstabellen. Es ist eine Zahl ohne vereinbarte Definition dahinter – 99 % wovon, wie gemessen, auf welchen Dokumenten, unter welchen Bedingungen? Dieser Leitfaden ersetzt diese einzelne Marketingzahl durch einen Rahmen, den Sie selbst anwenden können. Hier erfahren Sie, was Genauigkeit auf vier verschiedenen Ebenen tatsächlich bedeutet, welche Kennzahlen reale Geschäftsergebnisse vorhersagen, und ein Schritt-für-Schritt-Protokoll für Ihren eigenen Genauigkeitstest – mit kostenlosen öffentlichen Datensätzen oder Ihren eigenen Dokumenten – bevor Sie sich für ein Tool entscheiden.
Die wichtigsten Erkenntnisse
- Wenn ein Anbieter „99 % Genauigkeit" behauptet, fragen Sie: 99 % wovon – Zeichen-, Feld-, Dokument- und Straight-Through-Processing-Raten erzählen vier verschiedene Geschichten über dasselbe Tool.
- Bei 97 % Feldgenauigkeit bei einer Rechnung mit 15 Feldern enthält mehr als jedes dritte Dokument mindestens einen Fehler – die Lücke, die die meisten Teams erst nach der Einführung des Tools entdecken.
- Die branchenübliche Straight-Through-Processing-Quote liegt bei 32 % – Best-in-Class-AI-Extraktion erreicht 60–80 % und eliminiert damit etwa die Hälfte des manuellen Prüfaufwands vollständig.
- Das Testen von 10 sauberen Rechnungen erzeugt Genauigkeitszahlen, die nichts vorhersagen – eine stabile Schätzung erfordert 100+ Dokumente aus Ihrer tatsächlichen Lieferantenmischung, einschließlich derjenigen mit der schlechtesten Qualität.
- Bewerten Sie Kopfzeilen, Positionszeilen und berechnete Summen getrennt – die Mittelung verbirgt 85 % Positionsgenauigkeit hinter 99 % Kopfzeilengenauigkeit, die auf einer Scorecard gut aussieht, sich im täglichen Betrieb aber anders anfühlt.
Warum „99 % Genauigkeit“ für sich allein eine bedeutungslose Zahl ist
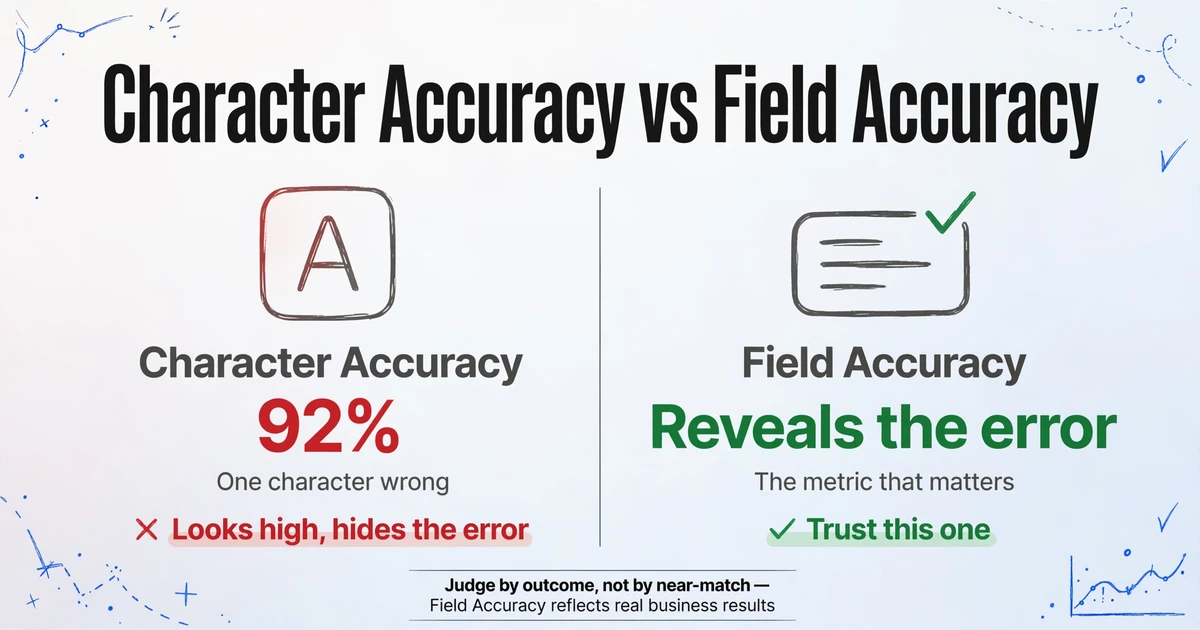
„Genauigkeit“ bei der Dokumentextraktion ist nicht eine Zahl – es sind vier verschiedene Zahlen, die vier verschiedene Geschichten über dasselbe Tool erzählen. Die meisten Anbieter wählen diejenige aus, die ihr Produkt am besten dastehen lässt. Zu verstehen, welche Ihnen gezeigt wird, ist der erste Schritt, um jede Behauptung ehrlich zu bewerten.
Stufe 1 – Zeichengenauigkeit (CER). Wie viel Prozent der einzelnen Zeichen wurden korrekt gelesen? Wenn ein Dokument 500 Zeichen enthält und das Tool 495 davon korrekt liest, beträgt die Zeichengenauigkeit 99 %. Traditionelle OCR auf sauberem gedrucktem Text liegt zwischen 85–97 %; moderne KI-Vision-Modelle erreichen 98–99,5 %. Dies ist die am einfachsten zu erreichende Kennzahl und die, auf der die meisten Anbieterangaben basieren – aber für Geschäftsentscheidungen ist sie fast nutzlos. Betrachten Sie ein Beispiel aus der Praxis:
Eine Rechnungsnummer „INV-20260412“ wird als „INV-2O260412“ gelesen – ein Zeichen falsch, 92 % Zeichengenauigkeit bei diesem Feld, klingt anständig. Aber der Feldwert ist für den AP-Abgleich völlig falsch. Die Zeichengenauigkeit sagte Ihnen, dass das Tool es größtenteils richtig gemacht hat; das Geschäftsergebnis sagt, dass es es völlig falsch gemacht hat.
Stufe 2 – Feldgenauigkeit. Ein Feld ist nur dann korrekt, wenn jedes Zeichen in diesem Feld korrekt ist. Ein falsches Zeichen = das gesamte Feld ist falsch. Dies ist die Kennzahl, die für den Betrieb zählt. Traditionelle vorlagenbasierte Extraktion erreicht 70–90 % Feldgenauigkeit über verschiedene Dokumentensätze hinweg, weil Formatvariationen die Vorlagen brechen. KI-basierte Extraktion erreicht 95–99,5 % Feldgenauigkeit bei Standard-Geschäftsdokumenten. Bei 98 % Zeichengenauigkeit wird eine 10-stellige Rechnungsnummer in etwa 18 % der Fälle falsch sein – Zeichengenauigkeit verschleiert Feldversagen.
Stufe 3 – Dokumentgenauigkeit. Ein Dokument zählt nur dann als korrekt, wenn jedes Feld auf diesem Dokument korrekt ist. Wenn Sie 15 Felder pro Rechnung extrahieren und Ihre Feldgenauigkeit 97 % beträgt, ist die Wahrscheinlichkeit, dass alle 15 Felder bei einer bestimmten Rechnung korrekt sind, 0,97^15 = ungefähr 63 %. Das bedeutet, dass 37 % Ihrer Rechnungen – über eine von drei – mindestens einen Feld Fehler aufweisen. Eine Feldgenauigkeit von 97 % klingt beeindruckend; eine Dokumentgenauigkeit von 63 % zeigt, wie viel menschliche Überprüfung noch nötig ist.
Stufe 4 – STP (Straight-Through Processing). Der Prozentsatz der Dokumente, die keinen menschlichen Eingriff erfordern – keine Korrekturen, keine Prüfmarkierungen, kein manuelles Eingreifen. Dies ist die Zahl, die direkt den Arbeitskosten entspricht. Der AP-Metriken-Bericht 2025 von Ardent Partners beziffert die Branchendurchschnitts-STP-Rate auf 32,6 %, Best-in-Class auf 49,2 % und führende KI-Implementierungen auf 60–80 %. Die Lücke zwischen 32 % und 80 % STP entspricht ungefähr der Hälfte des manuellen Prüfaufwands, der vollständig entfällt. Das ist die Zahl, die sich in der Personalstärke und den Überstunden Ihrer Abteilung niederschlägt – und genau deshalb ist sie die Ebene, die zählt, und diejenige, die Anbieter fast nie veröffentlichen.
Wenn ein Anbieter „99 % genau“ sagt, fragen Sie: 99 % wovon? Zeichen, Felder, Dokumente oder Straight-Through Processing? Die Antwort sagt Ihnen, ob die Zahl etwas bedeutet oder nichts.
Die einzigen drei Kennzahlen, die Ihr Unternehmen wirklich braucht
Vergessen Sie die Marketing-Versprechen. Wenn Sie ein Dokumentextraktionstool für den echten Betrieb bewerten, verraten Ihnen drei Kennzahlen fast alles, was Sie wissen müssen – und keine davon ist die Zahl auf der Startseite des Anbieters.
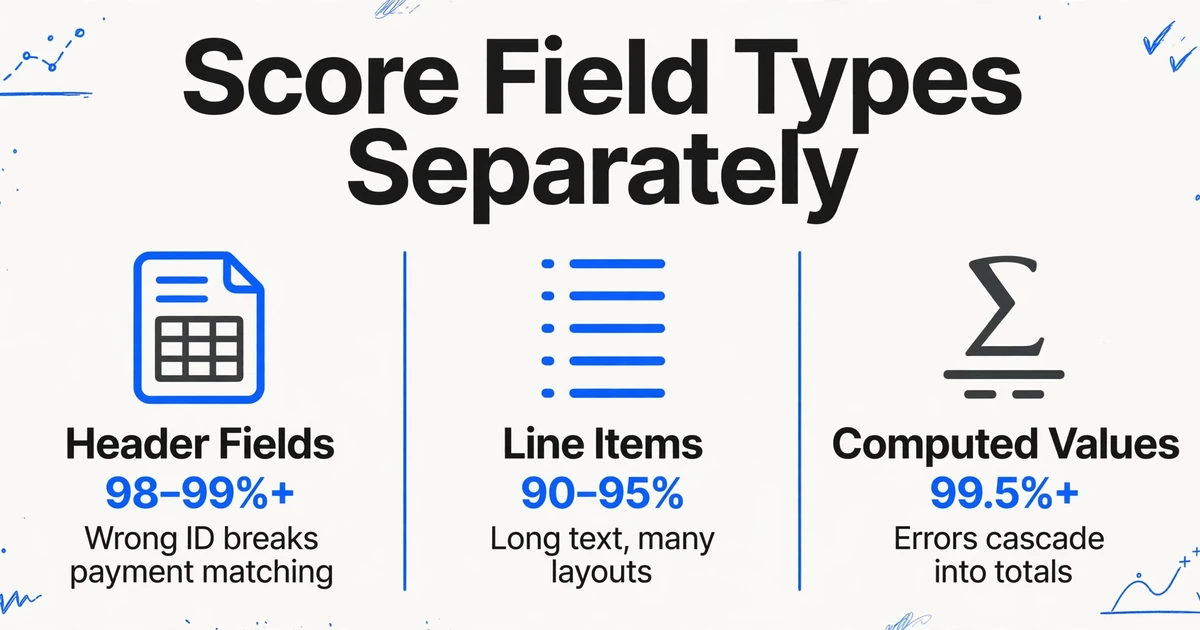
Feldergenauigkeit: wie viele Korrekturen pro Tag. Bei Kopffeldern – Rechnungsnummern, Daten, Lieferantennamen, Summen – sollten AI-Tools bei sauberen Dokumenten 98–99 %+ erreichen. Bei Positionen – Produktbeschreibungen, Einzelpreise, Mengen – sind 90–95 % eine realistischere Erwartung, da Positionen mehr Text, mehr Variation und mehr Formatierungskomplexität beinhalten. Die praktische Frage ist nicht „Wie hoch ist der Prozentsatz der Feldergenauigkeit?“, sondern „Wie viele Korrekturen muss mein Team bei unserem Volumen pro Tag vornehmen?“
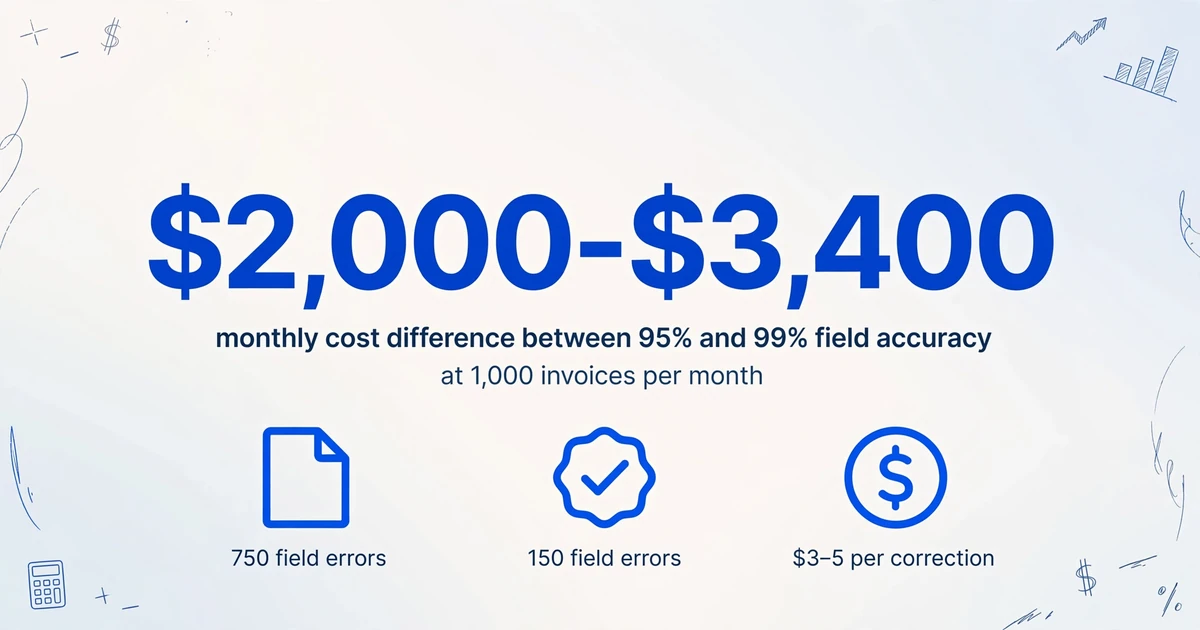
Dokumentgenauigkeit: wie viele Rechnungen benötigen menschliches Eingreifen. Dies ist die Feldergenauigkeit, die über alle Felder eines Dokuments hinweg zusammengerechnet wird. Bei 1.000 Rechnungen pro Monat mit jeweils 15 Feldern ist der Unterschied zwischen 95 % und 99 % Feldergenauigkeit der Unterschied zwischen 750 Feld Fehlern pro Monat und 150 Feld Fehlern pro Monat. Jede Korrektur kostet etwa 3–5 $ an Arbeitszeit (Fehler lokalisieren, Quelldokument prüfen, Zelle korrigieren). Das ist eine monatliche Differenz von 2.000–3.400 $ – bei einer Kennzahl, in einer Abteilung.
STP-Quote: wie viele Dokumente fließen unberührt durch. Branchen-Benchmarks von Ardent Partners setzen das Kostenbild in den Kontext: Die durchschnittliche Organisation gibt 9,40 $ aus, um eine einzelne Rechnung end-to-end zu verarbeiten, mit einer durchschnittlichen Verarbeitungszeit von 9,15 Tagen und einer Ausnahmerate von 14 %. Best-in-Class-Organisationen geben 2,78 $ pro Rechnung aus, verarbeiten in 3,1 Tagen und erreichen eine Ausnahmerate von etwa 5 %. Der Unterschied zwischen Durchschnitt und Best-in-Class sind nicht bessere Mitarbeiter – es sind höhere STP-Quoten, die durch Automatisierung ermöglicht werden, die kein menschliches Eingreifen bei den meisten Dokumenten erfordert.
Diese drei Kennzahlen verbinden sich auf eine Weise direkt mit Kosten, die eine einzelne „99 %“-Behauptung nie kann. Die Feldergenauigkeit sagt den täglichen Korrekturaufwand voraus. Die Dokumentgenauigkeit sagt voraus, wie viele Rechnungen eine Prüfung benötigen. Die STP-Quote sagt voraus, wie viel Arbeit Sie vollständig eliminieren können. Wenn ein Anbieter keine Zahlen auf diesen drei Ebenen liefern kann oder will – gemessen an einem Testsatz, den Sie als realistisch anerkennen würden – dann beantwortet die Genauigkeitsbehauptung auf seiner Landingpage eine Frage, die Ihr Unternehmen nicht stellt.
Was Sie testen sollten – und warum Sie nicht alles gleich stark testen sollten
Der natürliche Instinkt ist, alle Felder zu testen und die Ergebnisse zu mitteln. Das ergibt eine Zahl, die sauber aussieht, aber den Unterschied zwischen einfachen und schwierigen Feldern verdeckt – genau den Unterschied, der darüber entscheidet, ob das Tool für Ihren Workflow funktioniert.
Nicht alle Felder sind gleich schwierig zu extrahieren, und nicht alle Feldausfälle verursachen die gleichen Kosten im Geschäft. Eine falsche Rechnungsnummer bedeutet, dass die Zahlung nicht zugeordnet werden kann – hohe Kosten. Ein leicht abgeschnittener Lieferantenname („Acme Industrial Suppl" vs. „Acme Industrial Supplies Inc") bedeutet, dass jemand eine halbe Sekunde darauf schaut – vernachlässigbare Kosten. Beides als gleichwertige Fehler in Ihrer Genauigkeitsberechnung zu behandeln, bläht das Problem bei Lieferantennamen auf und versteckt es bei Rechnungsnummern.
Teilen Sie Ihren Test in drei Kategorien und bewerten Sie jede separat:
Kopfzeilenfelder – Rechnungsnummer, Datum, Lieferantenname, PO-Referenz, Gesamtbetrag, Währung. Diese sind typischerweise gut beschriftet, konsistent oben im Dokument positioniert und verwenden standardisierte Formate. KI-Tools sollten hier eine Feldgenauigkeit von 98–99 %+ erreichen. Wenn ein Tool bei Kopfzeilenfeldern nicht 95 % erreicht, ist es unabhängig von seinen sonstigen Stärken nicht bereit für Ihren Produktionsworkflow.
Positionen – Produktbeschreibungen, Mengen, Einzelpreise, Positionssummen. Diese sind schwieriger, weil sich Positionstabellen im Aufbau stark unterscheiden, Spaltenbeschriftungen je nach Lieferant variieren und Produktbeschreibungen lange Freitexte sein können. KI-Tools erreichen bei Positionen typischerweise eine Feldgenauigkeit von 90–95 %. Ein Tool, das bei Positionen 92 % erreicht, bei 1.000 Rechnungen pro Monat und durchschnittlich 3 Positionen pro Rechnung, bedeutet etwa 240 Korrekturen an Positionsfeldern pro Monat – etwa 12 pro Arbeitstag. Rechnen Sie das in Ihr Personalkonzept ein.
Berechnete oder abgeleitete Werte – Zwischensummen, die der Summe der Positionen entsprechen sollten, Steuerbeträge, die dem angegebenen Satz entsprechen sollten, und Summen, die über Abschnitte hinweg übereinstimmen sollten. Dies sind die Felder, bei denen Extraktionsfehler in finanzielle Abweichungen kaskadieren. Testen Sie sie separat und setzen Sie die Messlatte höher: Gesamtbeträge sollten zu 99,5 %+ korrekt sein, denn eine mit 1.590,00 $ erfasste Rechnung, die als 15.900,00 $ verbucht wird, ist ein viel teurerer Fehler als ein falsch geschriebener Produktname.
Was Sie nicht wollen, ist eine einzelne Zahl „92 % Gesamtgenauigkeit", die 99 % Kopfzeilengenauigkeit mit 85 % Positionsgenauigkeit mittelt. Dieser Durchschnitt sagt Ihnen nichts Nützliches; die 85 % bei Positionen sind das, was Sie im täglichen Betrieb spüren, und sie stecken versteckt in der zusammengesetzten Zahl. Bewerten Sie jede Kategorie unabhängig und vergleichen Sie Tools Kategorie für Kategorie – nicht Gesamtwert gegen Gesamtwert.
Aufbau Ihres Testsatzes: Wie viele Dokumente, welche Vielfalt und wo Sie sie finden
Ein Testsatz, der nicht Ihrer tatsächlichen Dokumentmischung entspricht, erzeugt Genauigkeitszahlen, die Ihre tatsächliche Erfahrung nicht vorhersagen. Der häufigste Fehler beim Testen der Genauigkeit – das Testen an einer Handvoll sauberer, vertrauter Rechnungen und die Annahme, dass die Ergebnisse verallgemeinerbar sind – führt dazu, dass Teams in der Produktion enttäuscht werden.
Wie viele Dokumente Sie benötigen, hängt davon ab, wie einheitlich Ihre Dokumentpopulation ist. Wenn alle Ihre Rechnungen von einem einzigen Anbieter stammen, der sein Format nie ändert – homogene Dokumente –, geben 30 bis 50 Dokumente eine stabile Schätzung. Ihre Extraktionsgenauigkeit wird von Dokument zu Dokument kaum variieren, da das Layout konsistent ist. Wenn Sie Rechnungen von Dutzenden Anbietern in mehreren Formaten erhalten – heterogene Dokumente –, benötigen Sie mindestens 100 Dokumente. Jeder zusätzliche unterschiedliche Layouttyp, den die Ergebnisse repräsentieren sollen, fügt der erforderlichen Stichprobe etwa 20 bis 30 weitere Dokumente hinzu. Unterhalb dieser Schwellenwerte quantifiziert Ihre Genauigkeitsmessung zufällige Variation, nicht die Werkzeugleistung.
Wo Sie Testdokumente finden. Der beste Testsatz ist Ihr eigener: Nehmen Sie Ihre letzten 50 bis 100 Rechnungen, exportieren Sie sie aus Ihrem E-Mail- oder AP-System und annotieren Sie sie. Wenn Sie jedoch Werkzeuge bewerten, bevor Sie Volumen haben – oder eine standardisierte Basislinie wünschen, die es Ihnen ermöglicht, Werkzeuge anhand derselben Dokumente zu vergleichen –, stehen drei öffentliche Datensätze kostenlos zur Verfügung:
- ICDAR SROIE (2019) – 1.000 gescannte Belege mit Ground-Truth-Labels für vier Felder: Firmenname, Adresse, Datum und Gesamtsumme. Weithin als Benchmark in der akademischen OCR-Forschung verwendet. Gut zum Testen der Belegextraktion; weniger nützlich für Rechnungen mit Positionen und Steueraufschlüsselungen.
- Middlesex Invoice Document Dataset (MIDD, 2021) – 630 Rechnungs-PDFs in vier Layoutvorlagen mit jeweils 11 beschrifteten Feldern. Näher an realen AP-Workflows als SROIE, da es sich um echte Rechnungen handelt, nicht um Belege, und Positionsdaten enthält. Veröffentlicht im MDPI Data Journal mit vollständiger Dokumentation der Annotationsmethodik.
- Innovatiana Historical Invoice Dataset – etwa 1.560 alte Rechnungsbilder mit XML-Ground-Truth, veröffentlicht unter CC0 Public Domain. Die Dokumente sind historisch und nicht zeitgenössisch (ältere Layouts, unterschiedliche Scanqualität), was sie nützlich macht, um zu testen, wie Werkzeuge mit degradierter Eingabe umgehen – aber weniger repräsentativ für moderne digitale PDF-Rechnungen.
Öffentliche Datensätze sind ein nützlicher Ausgangspunkt, haben jedoch eine Einschränkung: Sie repräsentieren nicht Ihre spezifische Anbietermischung. Die Rechnungen, die Ihr Unternehmen erhält – von Ihren tatsächlichen Lieferanten, mit der Terminologie und den Formatierungskonventionen Ihrer Branche – werden nicht genau wie akademische Benchmark-Dokumente aussehen. Verwenden Sie öffentliche Datensätze, um Ihre Shortlist auf zwei oder drei Werkzeuge einzugrenzen, und führen Sie dann eine zweite Testrunde mit 30 bis 50 Ihrer eigenen echten Rechnungen durch, bevor Sie eine endgültige Entscheidung treffen.
Den Test durchführen: Ein einfaches Vier-Schritte-Protokoll
Sie benötigen keinen Code, keine API-Integration und keinen Datenwissenschafts-Hintergrund. Eine Tabellenkalkulation, eine konsistente Bewertungsregel und die Disziplin, Feldtypen getrennt zu testen, reichen aus, um Zahlen zu erhalten, denen Sie vertrauen können. Hier ist das Protokoll.
Schritt 1 — Ground Truth annotieren. Erstellen Sie eine einfache Tabellenkalkulation mit einer Zeile pro Dokument und einer Spalte pro Feld, das Sie testen. Tragen Sie für jedes Dokument manuell den korrekten Wert für jedes Feld ein – das ist Ihre Ground Truth. Seien Sie präzise: Wenn die Rechnungssumme $1.590,00 beträgt, schreiben Sie „$1.590,00" und nicht „1590" oder „~$1600". Eine inkonsistente Definition Ihrer Ground Truth macht jeden nachfolgenden Vergleich ungültig. Für Positionspositionen annotieren Sie jede Zeile separat oder wählen Sie eine repräsentative Teilmenge (z. B. die ersten drei Positionen jeder Rechnung), anstatt jede Zeile jedes Dokuments zu annotieren – Letzteres ist die Art von manueller Arbeit, die Sie eliminieren möchten.
Schritt 2 — Extrahierte mit erwarteten Werten unter Verwendung konsistenter Normalisierungsregeln vergleichen. Bevor Sie ein einziges Feld bewerten, schreiben Sie Ihre Normalisierungsregeln auf. Definieren Sie, was als Übereinstimmung gilt. Ein vernünftiger Ausgangspunkt:
• Daten: auf JJJJ-MM-TT normalisieren, jedes Eingabeformat akzeptieren, solange das Datum korrekt ist („01/15/2026" entspricht „15. Jan. 2026").
• Währungsbeträge: Währungssymbole entfernen, numerische Gleichwertigkeit akzeptieren ($1.590,00 entspricht 1590,00).
• Leerzeichen: Führende und abschließende Leerzeichen entfernen; „Acme Corp" entspricht „ Acme Corp ".
• Groß-/Kleinschreibung: Groß-/Kleinschreibung bei Textfeldern ignorieren; „ACME CORP" entspricht „Acme Corp".
• Teilweise Lieferantennamen: Hier ist eine Ermessensentscheidung erforderlich. „Acme Industrial Supplies Inc" und „Acme Industrial Suppl" – ist das eine Übereinstimmung? Definieren Sie Ihre Regel vor der Bewertung. Die meisten Teams akzeptieren gekürzte Namen, die den Lieferanten eindeutig identifizieren; lehnen Sie alles Mehrdeutige ab.
Die entscheidende Regel: Wenden Sie dieselbe Normalisierung auf jedes getestete Tool an. Wenn Sie bei der Datumsanalyse des einen Tools nachsichtig und bei einem anderen streng sind, ist Ihr Vergleich ungültig. Gleiche Regeln, gleicher Testsatz, gleiche Ground Truth – jede von Ihnen eingeführte Variation macht die Ergebnisse weniger vergleichbar.
Schritt 3 — Nach Feldtyp getrennt bewerten. Markieren Sie für jedes Dokument jedes Feld als korrekt (1) oder falsch (0). Berechnen Sie die Genauigkeit pro Feldtyp: Kopfzeilengenauigkeit = korrekte Kopfzeilenextraktionen ÷ insgesamt getestete Kopfzeilenfelder. Positionsgenauigkeit = korrekte Positionszeilenextraktionen ÷ insgesamt getestete Positionsfelder. Summengenauigkeit = korrekte Summenextraktionen ÷ insgesamt getestete Summenfelder. Berichten Sie drei separate Prozentsätze, nicht eine zusammengesetzte Zahl. Ein Tool mit 99 % Kopfzeilengenauigkeit und 85 % Positionsgenauigkeit ist – für die tägliche Erfahrung Ihres Teams – ein anderes Tool als eines mit 95 % Kopfzeilengenauigkeit und 93 % Positionsgenauigkeit, selbst wenn ihre zusammengesetzten Werte ähnlich sind.
Schritt 4 — Vor den Gesamtwerten nach Mustern in Fehlern suchen. Bleiben Sie nicht bei „92 % Positionsgenauigkeit" stehen. Schauen Sie, welche Dokumente fehlschlugen, welche Felder fehlschlugen und ob es ein Muster gibt. Häufige Muster, die wichtig sind: Rechnungen eines Lieferanten schlagen konsequent fehl (das Tool hat Probleme mit diesem spezifischen Layout) → Sie benötigen eine Problemumgehung für diesen Lieferanten. Handyfotos von Papierdokumenten schlagen häufiger fehl als digitale PDFs (Bildqualität verschlechtert die Extraktion) → die Spesenbelege Ihres Außendienstteams werden eine geringere Genauigkeit aufweisen als per E-Mail gesendete Rechnungen. Datumsfelder schlagen in der Nähe von Monats-/Jahresgrenzen häufiger fehl (Modelle verwechseln Rechnungsdatum vs. Fälligkeitsdatum bei Rechnungen desselben Monats) → Ihre Monatsabschluss-Batchdatei benötigt zusätzliche Überprüfung. Wenn ein Feldtyp unabhängig vom Lieferanten konsequent fehlschlägt – sagen wir, Steuerbeträge sind in 30 % der Fälle falsch – ist das eine Tool-Einschränkung, kein Dokumentproblem.
Muster in Fehlern sind aussagekräftiger als Gesamtergebnisse. Eine Gesamtpunktzahl von 94 %, die eine Fehlerquote von 60 % bei einem kritischen Feldtyp verbirgt, ist schlechter als eine Gesamtpunktzahl von 89 %, bei der die Fehler gleichmäßig über wenig kritische Felder verteilt sind. Das Muster zeigt Ihnen, was das Tool kann und was nicht; die Gesamtpunktzahl verschleiert es.
Das Ergebnis eines guten Genauigkeitstests ist keine einzelne Zahl. Es ist eine Aufschlüsselung nach Feldtyp, die Ihnen genau zeigt, wo das Tool funktioniert, wo nicht und wie die tägliche Korrekturarbeit Ihres Teams tatsächlich aussehen wird.
Drei Fehler beim Genauigkeitstest, die Ihre Ergebnisse unbrauchbar machen
Die meisten Genauigkeitstests liefern irreführende Ergebnisse, nicht weil die Messung schwierig ist, sondern weil das Testdesign Bedingungen voraussetzt, die in der Produktion nicht gelten. Hier sind die drei Fehler, die ein vielversprechendes Testergebnis am häufigsten in eine enttäuschende Produktionsbereitstellung verwandeln.
Fehler 1: Nur saubere, digitale PDFs testen, wenn Ihr realer Mix Handyfotos und Scans enthält. Ein digital erzeugtes PDF – klare Schrift, perfekter Kontrast, keine Drehung – ist der einfachste mögliche Input für jedes Extraktionstool. Ein Foto einer Papierrechnung, das mit einem Handy unter Bürobeleuchtung aufgenommen wurde – leichter Winkel, etwas Schatten, geringerer Kontrast – ist der Input, den Ihr Außendienst oder Ihre Remote-Mitarbeiter tatsächlich einreichen. Wenn Ihr Testsatz aus 100 sauberen PDFs besteht und Ihr Produktionsinput zu 60 % aus sauberen PDFs und zu 40 % aus Handyfotos, überschätzt Ihr Test die Genauigkeit um einen Betrag, der groß sein kann. IBMs Daten zur manuellen Dateneingabe finden Fehlerraten von bis zu 4 % in Lieferkettenkontexten; STP (Straight-Through Processing) kann das auf etwa 1 % reduzieren, aber nur, wenn die Eingabequalität dem entspricht, womit das Tool getestet wurde. Bauen Sie Ihren Testsatz so auf, dass er Ihrem realen Inputmix entspricht – einschließlich eines repräsentativen Anteils der Dokumente mit der schlechtesten Qualität, die Sie tatsächlich erhalten.
Fehler 2: Inkonsistentes Normalisieren über Tools hinweg. Wenn Sie „01/15/2026" als Übereinstimmung mit „Jan 15, 2026" für Tool A akzeptieren, aber für Tool B eine exakte String-Übereinstimmung verlangen, vergleicht Ihr Test nicht die Tool-Genauigkeit – er vergleicht Ihre Bewertungsgroßzügigkeit. Die Lösung ist einfach, wird aber selten durchgeführt: Schreiben Sie Ihre Normalisierungsregeln in einem gemeinsamen Dokument, bevor Sie Extraktionen durchführen, und wenden Sie dieselben Regeln auf die Ausgabe jedes Tools an. Selbst kleine Inkonsistenzen summieren sich: Wenn sich Ihre Normalisierungsregeln bei fünf Feldern über 100 Dokumente unterscheiden, sind das 500 Bewertungsentscheidungen, bei denen Voreingenommenheit (auch unbeabsichtigt) die Ergebnisse kippen kann. Gleiche Regeln, gleiche Ground Truth, gleicher Testsatz. Legen Sie alle drei fest, bevor Sie ein einziges Dokument extrahieren.
Fehler 3: Zu wenige Dokumente testen. Zehn Rechnungen von zwei Lieferanten ergeben eine Genauigkeitszahl, die Ihnen sagt, wie das Tool bei diesen zehn spezifischen Rechnungen von diesen zwei spezifischen Lieferanten abschneidet – und sonst nichts. Das Konfidenzintervall bei einer so kleinen Stichprobe ist breit genug, um das Ergebnis bedeutungslos zu machen. Zwanzig Rechnungen von zehn Lieferanten sind besser, aber immer noch verrauscht: Ein besonders kniffliger Lieferant, der 3 Ihrer 20 Testdokumente ausmacht, kann die Gesamtgenauigkeit um mehrere Prozentpunkte schwanken lassen. Die Stichprobengrößenregeln aus Abschnitt vier sind nicht willkürlich. Unter 30 Dokumenten für einen homogenen Satz oder 100 Dokumenten für einen heterogenen Satz misst Ihre Genauigkeitsmessung eher Stichprobenrauschen als Tool-Leistung.
Ein vierter, subtilerer Fehler ist es wert, erwähnt zu werden, auch wenn er nicht direkt zum Testprotokoll gehört: ausschließlich auf Dokumenten zu testen, bei denen Sie das erwartete Ergebnis des Tools bereits kennen. Das ist das Problem des „Dokuments, das wie die Demo aussieht". Die Demodokumente der Anbieter sind so ausgewählt, dass sie gut aussehen – saubere Layouts, Standardformate, klar beschriftete Felder. Ihre schlechteste Rechnung – die von dem Lieferanten, der ein dreispaltiges Querformat mit handschriftlichen Notizen am Rand verwendet – ist diejenige, die darüber entscheidet, ob Ihr Team dem Tool vertraut oder es umgeht. Nehmen Sie Ihre schlechtesten Dokumente in den Testsatz auf. Ein Tool, das diese einigermaßen und Ihre sauberen Dokumente perfekt verarbeitet, ist nützlicher als eines, das bei sauberen Dokumenten geringfügig besser ist und bei schwierigen versagt.
Interpretation Ihrer Ergebnisse: Was für Ihren Anwendungsfall gut genug ist
Sie haben Zahlen. Jetzt müssen Sie entscheiden, ob sie einen Wechsel von Ihrem aktuellen Prozess rechtfertigen. Die Antwort hängt davon ab, wofür Sie die Extraktion nutzen – dieselbe Genauigkeit, die für die Finanzberichterstattung inakzeptabel ist, kann für die Ersetzung der Dateneingabe völlig ausreichend sein. So interpretieren Sie Ergebnisse nach Anwendungsfall.
Reine Ersetzung der Dateneingabe: Sie ersetzen eine Person, die Rechnungsfelder in eine Tabellenkalkulation tippt. In diesem Anwendungsfall ist eine Feldgenauigkeit von 95 %+ bei Kopffeldern akzeptabel – Sie erhalten immer noch 19 von 20 Feldern automatisch korrekt, und der Korrekturaufwand für das 20. Feld ist im Vergleich zum Abtippen aller 20 Felder trivial. Eine Positionsgenauigkeit von 90 %+ ist praktikabel, da die Alternative darin besteht, jede Produktbeschreibung, Menge und jeden Einzelpreis von Hand einzugeben. Der Maßstab hier ist Ihr aktueller Prozess – manuelle Eingabe mit einer eigenen Fehlerquote von 1–4 %. KI-Extraktion mit 95 %+ ist der manuellen Eingabe sowohl bei Geschwindigkeit als auch bei Genauigkeit überlegen.
PO-Abgleich und AP-Automatisierung: Sie benötigen Rechnungsbeträge, PO-Nummern und Lieferantennamen, die exakt mit Bestellungen in Ihrem ERP übereinstimmen. Betragsfelder benötigen eine Genauigkeit von 99 %+, da ein abweichender Betrag den Abgleich unterbricht und eine manuelle Prüfung erfordert. Kopffelder benötigen 98 %+, da eine falsche PO-Nummer die Rechnung an die falsche Genehmigungswarteschlange sendet. Bei 95 % Feldgenauigkeit bei 1.000 Rechnungen pro Monat sprechen wir von etwa 50 betragsbezogenen Abweichungen monatlich – jede einzelne eine manuelle Untersuchung. Die Wirtschaftlichkeit verschiebt sich bei 99 %+, wo diese Zahl auf 10 oder weniger sinkt.
Finanzberichterstattung und Compliance: Die Positionsgenauigkeit wird zur kritischen Kennzahl, da Positionen in die Kostenverteilung, Steuerberichterstattung und Prüfpfade einfließen. Eine Positionsgenauigkeit von 92 % bei 1.000 Rechnungen mit durchschnittlich 3 Positionen bedeutet etwa 240 Positionsfehler pro Monat – etwa 12 pro Arbeitstag. Für den Monatsabschluss müssen diese Fehler gefunden und korrigiert werden, bevor Zahlen gemeldet werden. Wenn die Positionsgenauigkeit unter 95 % liegt und Ihr Team für die Finanzberichterstattung auf Basis extrahierter Daten verantwortlich ist, planen Sie einen Verifizierungsschritt ein.
Gemischte Workflows (der häufigste Fall): Die meisten Teams fallen nicht eindeutig in eine Kategorie. Sie benötigen möglicherweise 99 %+ bei Beträgen und PO-Nummern für den AP-Abgleich, aber 90 %+ bei Produktbeschreibungen ist in Ordnung, da Beschreibungen für interne Referenzen dienen, nicht für den Abgleich. Deshalb ist es wichtig, jeden Feldtyp separat zu testen: Sie können geringere Genauigkeit bei Feldern mit geringer Auswirkung akzeptieren, während Sie bei Feldern mit hoher Auswirkung die Linie halten. Ein Tool, das bei Produktbeschreibungen zu 85 % und bei Beträgen zu 99,5 % genau ist, könnte besser passen als eines, das durchgängig 92 % erreicht – aber diese Entscheidung können Sie nur treffen, wenn Sie sie separat bewertet haben.
Die Kostendaten von Ardent Partners liefern einen nützlichen Realitätscheck: Bei durchschnittlichen Prozesskosten von 9,40 $ pro Rechnung wirken sich selbst bescheidene STP-Verbesserungen spürbar aus. Eine Steigerung von 32 % STP (Branchendurchschnitt) auf 50 % STP bei 1.000 Rechnungen pro Monat bedeutet 180 Rechnungen weniger, die manuell bearbeitet werden müssen – und bei 5 bis 8 Minuten manueller Prüfung pro Rechnung entspricht das 15 bis 24 Stunden eingesparter Arbeitszeit pro Monat. Die Genauigkeitsrate, die diese STP-Verbesserung ermöglicht, hängt von der Komplexität Ihrer Dokumente und Ihrer Fehlertoleranz ab, nicht von einem generischen Benchmark. Führen Sie den Test mit Ihren eigenen Dokumenten durch und berechnen Sie die Arbeitsersparnis anhand Ihres tatsächlichen Volumens und Ihrer tatsächlichen Fehlertoleranz. Diese Zahl – nicht die Behauptung eines Anbieters – ist Ihr ROI.
FAQ
Ich habe nur 20 eigene Rechnungen. Reicht das zum Testen?
Zwanzig Rechnungen von einem einzigen Anbieter oder Format geben Ihnen eine Richtung — genug, um offensichtliche Probleme zu erkennen — aber keine stabile Genauigkeitsschätzung. Das Konfidenzintervall bei einer so kleinen Stichprobe ist breit: Eine gemessene Genauigkeit von 95 % könnte bedeuten, dass die tatsächliche Genauigkeit irgendwo zwischen 85 % und 99 % liegt. Ergänzen Sie Ihre 20 Rechnungen mindestens um einen der öffentlichen Datensätze (SROIE oder MIDD), um auf 50+ Dokumente zu kommen. Besser: Sammeln Sie 50 eigene Rechnungen — selbst von nur 3 bis 5 Anbietern — bevor Sie den Ergebnissen vertrauen. Die Stichprobengröße ist der Unterschied zwischen „dieses Tool scheint in Ordnung" und „ich weiß, wie hoch der Korrekturaufwand meines Teams sein wird."
Sollte ich handschriftliche Dokumente separat testen?
Ja. Handschrift bringt ein anderes Fehlerprofil mit sich — Zeichenverwechslungen (1 vs. 7, 0 vs. O), inkonsistente Abstände und unterschiedliche Lesbarkeit je nach Schreiber — das bei gedrucktem Text nicht zutrifft. Ein Tool, das bei gedruckten Rechnungen eine Feldgenauigkeit von 98 % erreicht, kann bei handschriftlichen Formularen auf 70–80 % fallen. Wenn handschriftliche Dokumente Teil Ihres tatsächlichen Dokumentmixes sind (Lieferscheine, Feldinspektionsformulare, handschriftliche Bestellungen), erstellen Sie ein separates Test-Subset dafür und bewerten Sie es unabhängig. Die Durchschnittsbildung von handschriftlicher und gedruckter Genauigkeit verschleiert die Verschlechterung — Sie möchten wissen, ob das Tool für Handschrift überhaupt brauchbar ist, nicht ob es im Durchschnitt akzeptabel ist.
Was ist mit nicht-englischen Rechnungen?
Die meisten KI-Vision-Modelle (GPT-4o, Claude, Gemini) verarbeiten gängige Sprachen — Spanisch, Französisch, Deutsch, Japanisch, Chinesisch — genauso gut wie Englisch, da die zugrunde liegenden Trainingsdaten mehrsprachig sind. Feldnamen in verschiedenen Sprachen („Numéro de facture", „Rechnungsnummer", „請求書番号") werden vom semantischen Verständnis des Modells als Äquivalente zu „Invoice Number" erkannt. Die Genauigkeit nimmt bei Sprachen mit kleineren Trainingsdaten-Fußabdrücken ab und bei Dokumenten, deren Layout-Konventionen erheblich von westlichen Rechnungsformaten abweichen — einige asiatische Rechnungsformate verwenden beispielsweise vertikalen Textfluss oder Tabellenstrukturen, die sich vom links-nach-rechts-, oben-nach-unten-Layout unterscheiden, auf das die Modelle überwiegend trainiert sind. Wenn Ihr Dokumentmix einen erheblichen Anteil nicht-englischer Rechnungen enthält, nehmen Sie eine repräsentative Stichprobe in Ihren Testsatz auf, anstatt anzunehmen, dass englischsprachige Ergebnisse übertragbar sind.
Muss ich nach Tool-Updates erneut testen?
Bei traditionellen OCR- und vorlagenbasierten Tools ändern Updates in der Regel nicht das Extraktionsverhalten bei bestehenden Vorlagen, daher ist ein erneuter Test nicht notwendig. Bei KI-basierten Tools können zugrunde liegende Modell-Updates das Extraktionsverhalten ändern — manchmal mit verbesserter Genauigkeit, gelegentlich mit Regressionen bei Randfällen. Ein leichter Retest mit einem 10-Dokument-Subset nach größeren Modell-Updates ist eine sinnvolle Praxis, wenn Ihr Workflow für Finanz- oder Compliance-Zwecke auf hohe Genauigkeit angewiesen ist. Sie müssen nicht jedes Mal das vollständige 100-Dokument-Protokoll erneut ausführen; ein schneller Check Ihrer repräsentativsten und problematischsten Dokumente erkennt relevante Regressionen.
Wie vergleiche ich zwei Tools fair?
Gleicher Testsatz, gleiche Ground-Truth-Annotationen, gleiche Normalisierungsregeln, gleiche Bewertungsmethodik. Wenn Sie Tool A mit den ersten 50 Rechnungen in Ihrem Ordner testen und Tool B mit den zweiten 50, haben Sie keine Tools verglichen — Sie haben zwei verschiedene Testsätze verglichen. Erstellen Sie einen annotierten Testsatz, führen Sie beide Tools damit aus und bewerten Sie beide mit identischen Regeln. Wenn Tool A eine Funktion unterstützt, die Tool B nicht hat (wie automatische Datumsnormalisierung), wenden Sie die von Ihnen definierte Normalisierungsregel vor dem Test an — geben Sie Tool A keine Anerkennung für eine Funktion, indem Sie den Bewertungsstandard lockern. Das Ziel ist ein Vergleich der Extraktionsgenauigkeit unter gleichen Bedingungen, nicht ein Vergleich von Nachbearbeitungsfunktionen.
Was, wenn das Tool eine Konfidenzscore-Funktion hat?
Konfidenzscores — bei denen das Tool Extraktionen mit niedriger Konfidenz zur manuellen Prüfung kennzeichnet — können den manuellen Korrekturaufwand erheblich reduzieren, wenn die Scores zuverlässig sind. Ein Tool, das 95 % Feldgenauigkeit erreicht, aber 80 % seiner Fehler korrekt mit niedrigen Konfidenzscores kennzeichnet, verwandelt eine Fehlerquote von 5 % effektiv in eine unentdeckte Fehlerquote von 1 % (die 20 % der Fehler, die es nicht gekennzeichnet hat). Testen Sie Konfidenzscores als Teil Ihrer Bewertung: Wie hoch war die tatsächliche Fehlerquote bei den Feldern, die das Tool als niedrig konfident eingestuft hat? Waren bei den Feldern, die es als hoch konfident eingestuft hat, welche falsch? Ein schlecht kalibriertes Konfidenzscore-System — das korrekte Extraktionen als niedrig konfident kennzeichnet (falsch positive, die Prüfzeit verschwenden) oder tatsächliche Fehler übersieht (falsch negative, die schlechte Daten durchlassen) — ist schlechter als gar kein Konfidenzsystem, weil es ein falsches Sicherheitsgefühl erzeugt.
Die beste Genauigkeitszahl ist die, die Sie selbst gemessen haben – mit Ihren Dokumenten, Ihren Felddefinitionen und bewertet anhand Ihrer Fehlertoleranz. Jedes Tool auf diesem Markt findet einen Weg, 99 % von irgendetwas zu behaupten. Die Frage ist nicht, was sie behaupten. Sondern was Sie verifizieren können – an den Dokumenten, die tatsächlich in Ihrem Posteingang landen, für die Felder, die Ihr Team tatsächlich benötigt.
Wenn Sie Extraktionstools evaluieren und dieses Protokoll in die Praxis umsetzen möchten: ImageToTable.ai läuft auf einem visuellen LLM, das nach Feldsemantik statt nach Vorlagenkoordinaten extrahiert – das heißt, Sie definieren die gewünschten Felder einmal und dieselbe Extraktion funktioniert über jedes beliebige Anbieter-Layout. Der AI- vs. traditioneller-OCR-Vergleich behandelt den architektonischen Unterschied, der dies ermöglicht, der Leitfaden zu Dokumentextraktionskonzepten erklärt, wie sich feldebene semantische Extraktion in der Praxis von zeichenebener OCR unterscheidet, und Benutzerdefinierte Spaltenextraktion zeigt, wie Sie festlegen, welche Felder Sie zuerst testen möchten. Führen Sie das Testprotokoll durch, bewerten Sie jeden Feldtyp separat und prüfen Sie, ob die Zahlen den Behauptungen entsprechen.
Laden Sie Ihre eigenen Dokumente hoch und testen Sie die Extraktion auf Feldebene selbst – ohne Einrichtung, ohne Vorlagen, ohne Trainingsdaten.
ImageToTable.ai kostenlos testen