Comment tester réellement la précision de l'extraction de documents
Un guide pratique pour évaluer les outils AI OCR
Chaque outil d'extraction de documents sur le marché dit la même chose : « précision de 99 % ». Cette affirmation apparaît sur les pages d'accueil des fournisseurs, dans les présentations commerciales et dans les tableaux comparatifs de produits. C'est un chiffre sans définition convenue derrière lui — 99 % de quoi, mesuré comment, sur quels documents, dans quelles conditions ? Ce guide remplace ce chiffre marketing unique par un cadre que vous pouvez utiliser vous-même. Voici ce que la précision signifie réellement à quatre niveaux différents, quels indicateurs prédisent les résultats commerciaux réels, et un protocole étape par étape pour mener votre propre test de précision — en utilisant des jeux de données publics gratuits ou vos propres documents — avant de vous engager avec un outil.
Points clés à retenir
- Lorsqu'un fournisseur revendique « 99 % de précision », demandez 99 % de quoi — les taux au niveau des caractères, des champs, des documents et du traitement direct racontent quatre histoires différentes sur le même outil.
- Avec une précision de 97 % au niveau des champs sur une facture à 15 champs, plus d'un document sur trois contient au moins une erreur — l'écart que la plupart des équipes découvrent seulement après le déploiement de l'outil.
- La moyenne sectorielle du traitement direct est de 32 % — l'extraction AI de pointe atteint 60 à 80 %, éliminant environ la moitié de l'effort de vérification manuelle.
- Tester 10 factures propres produit des chiffres de précision qui ne prédisent rien — une estimation stable nécessite 100+ documents couvrant votre mix réel de fournisseurs, y compris les documents de la plus mauvaise qualité.
- Évaluez séparément les en-têtes, les lignes d'article et les totaux calculés — les moyenner ensemble masque une précision de 85 % sur les lignes d'article derrière une précision de 99 % sur les en-têtes qui semble bonne sur un tableau de bord mais se ressent différemment dans les opérations quotidiennes.
Pourquoi « 99 % de précision » est un chiffre dénué de sens en soi
La « précision » dans l'extraction de documents n'est pas un seul chiffre — c'est quatre chiffres différents qui racontent quatre histoires différentes sur le même outil. La plupart des fournisseurs choisissent celui qui fait le mieux paraître leur produit. Comprendre lequel on vous montre est la première étape pour évaluer honnêtement toute affirmation.
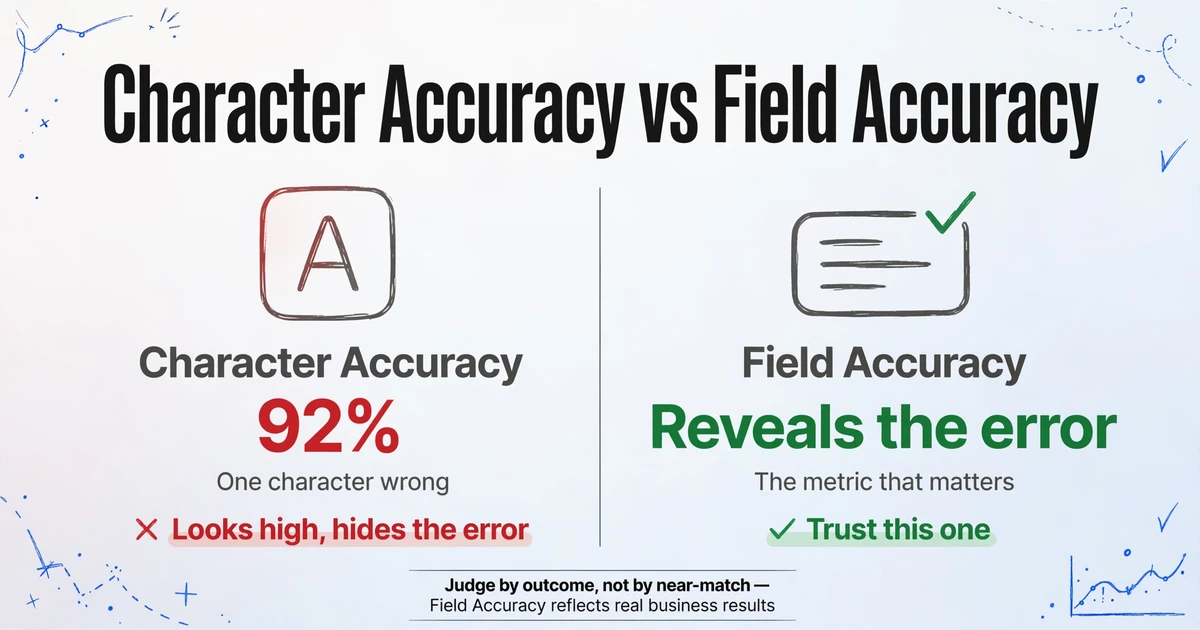
Niveau 1 — Précision des caractères (CER). Quel pourcentage de caractères individuels a été lu correctement ? Si un document contient 500 caractères et que l'outil en lit correctement 495, la précision des caractères est de 99 %. L'OCR traditionnel sur du texte imprimé propre atteint 85–97 % ; les modèles de vision IA modernes atteignent 98–99,5 %. C'est la métrique la plus facile à atteindre et celle sur laquelle reposent la plupart des affirmations des fournisseurs — mais elle est presque inutile pour les décisions commerciales. Prenons un exemple concret :
Un numéro de facture « INV-20260412 » est lu comme « INV-2O260412 » — un caractère erroné, 92 % de précision des caractères sur ce champ, cela semble correct. Mais la valeur du champ est complètement fausse pour le rapprochement AP. La précision des caractères vous a dit que l'outil avait en grande partie bien fait ; le résultat commercial dit qu'il s'est entièrement trompé.
Niveau 2 — Précision des champs. Un champ est correct uniquement lorsque chaque caractère de ce champ est correct. Un caractère erroné = tout le champ échoue. C'est la métrique qui compte pour les opérations. L'extraction traditionnelle basée sur des modèles atteint 70–90 % de précision des champs sur des ensembles de documents variés, car les variations de format cassent les modèles. L'extraction basée sur l'IA atteint 95–99,5 % de précision des champs sur les documents commerciaux standard. À 98 % de précision des caractères, un numéro de facture de 10 caractères sera erroné environ 18 % du temps — la précision des caractères masque l'échec au niveau des champs.
Niveau 3 — Précision des documents. Un document est considéré comme correct uniquement lorsque chaque champ de ce document est correct. Si vous extrayez 15 champs par facture et que votre précision des champs est de 97 %, la probabilité que les 15 champs soient corrects sur une facture donnée est de 0,97^15 = environ 63 %. Cela signifie que 37 % de vos factures — plus d'une sur trois — comportent au moins une erreur de champ. Un taux de précision des champs de 97 % semble impressionnant ; un taux de précision des documents de 63 % révèle l'ampleur de la relecture humaine encore nécessaire.
Niveau 4 — Traitement direct (STP). Le pourcentage de documents qui ne nécessitent aucune intervention humaine — aucune correction, aucun signalement de relecture, aucune intervention manuelle. C'est le chiffre qui correspond directement au coût de la main-d'œuvre. Le rapport 2025 sur les métriques AP d'Ardent Partners situe le taux STP moyen du secteur à 32,6 %, celui des meilleurs de leur catégorie à 49,2 %, et les implémentations IA de pointe à 60–80 %. L'écart entre 32 % et 80 % de STP représente environ la moitié de l'effort de relecture manuelle entièrement éliminé. C'est le chiffre qui se reflète dans les effectifs et les heures supplémentaires de votre service — c'est pourquoi c'est le niveau qui compte et celui que les fournisseurs ne publient presque jamais.
Lorsqu'un fournisseur affirme « 99 % de précision », demandez : 99 % de quoi ? Des caractères, des champs, des documents ou du traitement direct ? La réponse vous indique si le chiffre signifie quelque chose ou rien du tout.
Les trois seuls chiffres dont votre entreprise a réellement besoin
Oubliez l'argument marketing. Lorsque vous évaluez un outil d'extraction de documents pour des opérations réelles, trois indicateurs vous en disent presque tout ce que vous devez savoir — et aucun d'eux n'est le chiffre affiché sur la page d'accueil du fournisseur.
Précision des champs : combien de corrections par jour. Pour les champs d'en-tête — numéros de facture, dates, noms de fournisseurs, totaux — les outils d'IA devraient atteindre 98–99 % et plus sur des documents propres. Pour les lignes d'articles — descriptions de produits, prix unitaires, quantités — 90–95 % est une attente plus réaliste, car les lignes d'articles impliquent plus de texte, plus de variation et plus de complexité de mise en forme. La question pratique n'est pas « quel est le pourcentage de précision des champs » — c'est « combien de corrections mon équipe devra-t-elle faire par jour à notre volume ? »
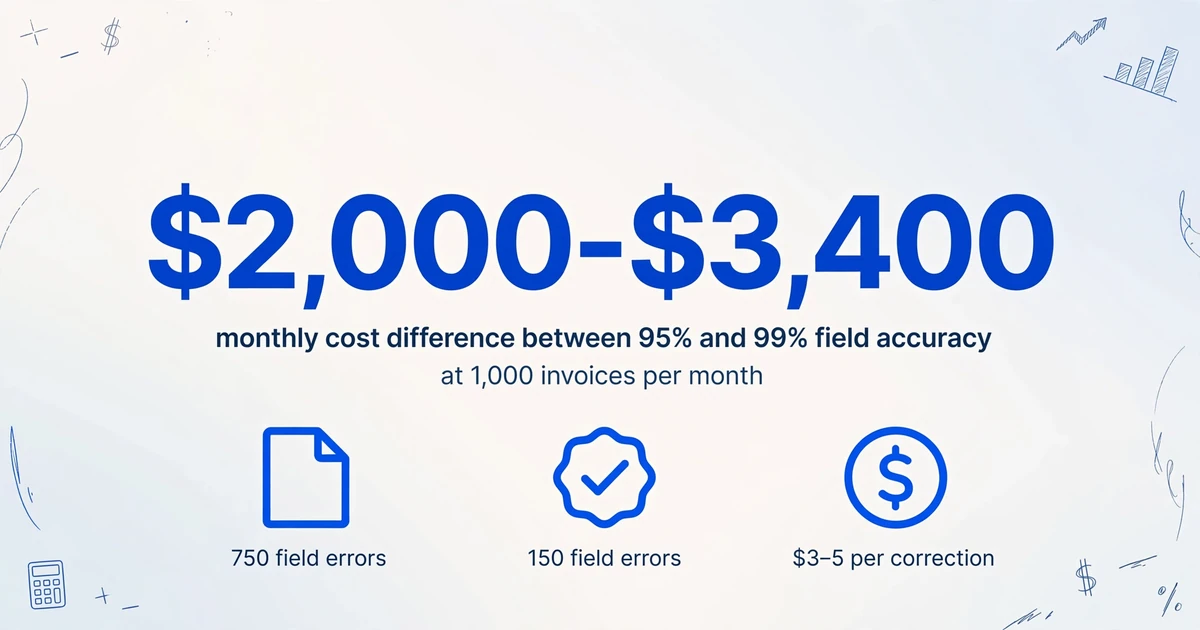
Précision des documents : combien de factures nécessitent une intervention humaine. C'est la précision des champs cumulée sur tous les champs d'un document. À 1 000 factures par mois avec 15 champs chacune, la différence entre 95 % et 99 % de précision des champs est la différence entre 750 erreurs de champ par mois et 150 erreurs de champ par mois. Chaque correction coûte environ 3 à 5 $ en main-d'œuvre (localiser l'erreur, vérifier le document source, corriger la cellule). Cela représente une différence mensuelle de 2 000 à 3 400 $ — sur un seul indicateur, dans un seul service.
Taux de STP : combien de documents passent sans intervention. Les références sectorielles d'Ardent Partners contextualisent la question des coûts : l'organisation moyenne dépense 9,40 $ pour traiter une seule facture de bout en bout, avec un temps de traitement moyen de 9,15 jours et un taux d'exception de 14 %. Les organisations de premier plan dépensent 2,78 $ par facture, traitent en 3,1 jours et atteignent un taux d'exception plus proche de 5 %. La différence entre la moyenne et le meilleur de la catégorie ne réside pas dans de meilleures équipes — c'est un taux de STP plus élevé grâce à une automatisation qui ne nécessite pas d'intervention humaine sur la plupart des documents.
Ces trois indicateurs sont directement liés aux coûts d'une manière qu'une simple affirmation de « 99 % » ne peut jamais l'être. La précision des champs prédit la charge de travail quotidienne de correction. La précision des documents prédit combien de factures nécessitent une vérification. Le taux de STP prédit combien de main-d'œuvre vous pouvez éliminer entièrement. Si un fournisseur ne peut pas ou ne veut pas fournir de chiffres à ces trois niveaux — mesurés sur un ensemble de test que vous reconnaîtriez comme réaliste — l'affirmation de précision sur sa page d'accueil répond à une question que votre entreprise ne se pose pas.
Que tester — et pourquoi vous ne devriez pas tout tester de la même manière
L'instinct naturel est de tester tous les champs et de faire la moyenne des résultats. Cela produit un chiffre qui semble propre mais qui masque la différence entre les champs faciles et les champs difficiles — précisément la différence qui détermine si l'outil fonctionne pour votre flux de travail.
Tous les champs ne sont pas également difficiles à extraire, et toutes les erreurs de champ n'ont pas le même coût métier. Un mauvais numéro de facture signifie que le paiement ne peut pas être rapproché — coût élevé. Un nom de fournisseur légèrement tronqué (« Acme Industrial Suppl » vs « Acme Industrial Supplies Inc ») signifie que quelqu'un y jette un œil pendant une demi-seconde — coût négligeable. Traiter les deux comme des erreurs égales dans votre calcul de précision gonfle le problème sur les noms de fournisseurs et le masque sur les numéros de facture.
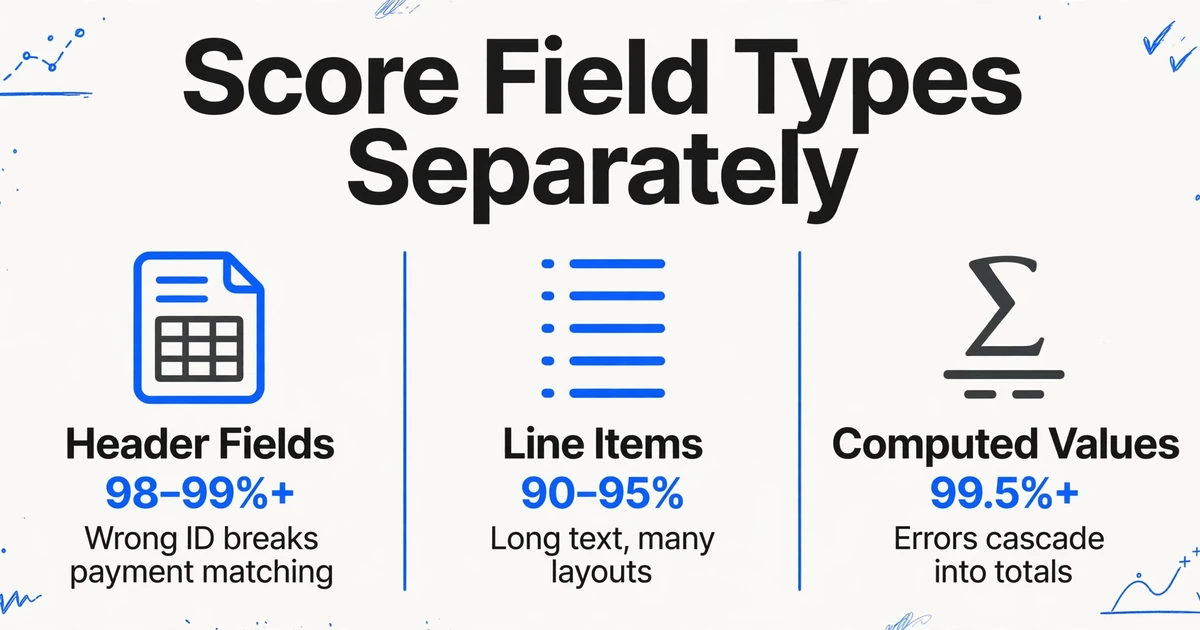
Divisez votre test en trois catégories et notez chacune séparément :
Champs d'en-tête — numéro de facture, date, nom du fournisseur, référence de bon de commande, montant total, devise. Ceux-ci sont généralement bien étiquetés, positionnés de manière cohérente en haut du document, et utilisent des formats standardisés. Les outils d'IA devraient atteindre une précision de 98–99 %+ sur ces champs. Si un outil ne peut pas atteindre 95 % sur les champs d'en-tête, il n'est pas prêt pour votre flux de travail de production, peu importe ce qu'il fait bien par ailleurs.
Lignes d'articles — descriptions de produits, quantités, prix unitaires, totaux de ligne. Ceux-ci sont plus difficiles car les tableaux de lignes d'articles varient considérablement en structure, les étiquettes de colonnes diffèrent selon le fournisseur, et les descriptions de produits peuvent être de longues chaînes de texte libre. Les outils d'IA atteignent généralement une précision de 90–95 % sur les lignes d'articles. Un outil obtenant 92 % sur les lignes d'articles à 1 000 factures par mois avec une moyenne de 3 lignes par facture signifie environ 240 corrections de champs de lignes par mois — environ 12 par jour ouvré. Intégrez cela dans votre modèle de dotation.
Valeurs calculées ou dérivées — sous-totaux qui devraient égaler la somme des lignes d'articles, montants de taxe qui devraient correspondre au taux indiqué, totaux qui devraient se concilier entre les sections. Ce sont les champs où les erreurs d'extraction se répercutent en écarts financiers. Testez-les séparément et fixez un seuil plus élevé : les montants totaux devraient être précis à 99,5 %+ car une facture de 1 590,00 $ enregistrée comme 15 900,00 $ est une erreur bien plus coûteuse qu'un nom de produit mal orthographié.
Ce que vous ne voulez pas, c'est un seul chiffre de « précision globale de 92 % » qui fait la moyenne d'une précision de 99 % sur les en-têtes avec une précision de 85 % sur les lignes d'articles. Cette moyenne ne vous dit rien d'utile ; les 85 % sur les lignes d'articles, c'est ce que vous ressentirez dans les opérations quotidiennes, et c'est caché dans le chiffre composite. Notez chaque catégorie indépendamment et comparez les outils catégorie par catégorie — pas globalement contre globalement.
Construire votre jeu de test : combien de documents, quelle variété, et où les trouver
Un jeu de test qui ne ressemble pas à votre mix documentaire réel produit des chiffres de précision qui ne prédisent pas votre expérience réelle. L'erreur la plus courante lors des tests de précision — tester sur une poignée de factures propres et familières en supposant que les résultats se généralisent — est ce qui conduit les équipes à être déçues en production.
Le nombre de documents dont vous avez besoin dépend de l'uniformité de votre population documentaire. Si toutes vos factures proviennent d'un seul fournisseur qui ne change jamais de format — documents homogènes — 30 à 50 documents suffisent pour obtenir une estimation stable. Votre précision d'extraction ne variera pas beaucoup d'un document à l'autre car la mise en page est cohérente. Si vous recevez des factures de dizaines de fournisseurs dans plusieurs formats — documents hétérogènes — vous avez besoin d'au moins 100 documents. Chaque type de mise en page distinct supplémentaire que vous souhaitez représenter ajoute environ 20 à 30 documents à l'échantillon requis. En dessous de ces seuils, votre mesure de précision quantifie la variation aléatoire, pas la performance de l'outil.
Où trouver des documents de test. Le meilleur jeu de test est le vôtre : prenez vos 50 à 100 factures les plus récentes, exportez-les depuis votre messagerie ou votre système AP, et annotez-les. Mais si vous évaluez des outils avant d'avoir du volume — ou si vous voulez une base standardisée qui vous permet de comparer des outils sur les mêmes documents — trois ensembles de données publics sont disponibles gratuitement :
- ICDAR SROIE (2019) — 1 000 reçus scannés avec des étiquettes de vérité terrain pour quatre champs : nom de l'entreprise, adresse, date et total. Largement utilisé comme référence dans la recherche académique en OCR. Utile pour tester l'extraction de reçus ; moins utile pour les factures avec lignes d'articles et ventilations fiscales.
- Middlesex Invoice Document Dataset (MIDD, 2021) — 630 PDF de factures répartis sur quatre modèles de mise en page avec 11 champs étiquetés chacun. Plus proche des flux AP réels que SROIE car ce sont de vraies factures, pas des reçus, et cela inclut les données de lignes d'articles. Publié dans la revue MDPI Data avec une documentation complète de la méthodologie d'annotation.
- Innovatiana Historical Invoice Dataset — environ 1 560 images de factures anciennes avec vérité terrain XML, publiées sous licence CC0 Public Domain. Les documents sont historiques plutôt que contemporains (mises en page plus anciennes, qualité de scan variable), ce qui les rend utiles pour tester la résistance des outils face à des entrées dégradées — mais moins représentatifs des factures PDF numériques modernes.
Les ensembles de données publics sont un point de départ utile, mais ils ont une limite : ils ne représentent pas votre mix de fournisseurs spécifique. Les factures que votre entreprise reçoit — de vos fournisseurs réels, avec la terminologie et les conventions de formatage de votre secteur — ne ressembleront pas exactement aux documents de référence académiques. Utilisez les ensembles de données publics pour réduire votre liste à deux ou trois outils, puis effectuez une deuxième série de tests sur 30 à 50 de vos propres factures réelles avant de prendre une décision finale.
Exécution du test : un protocole simple en quatre étapes
Vous n'avez besoin ni de code, ni d'intégration API, ni de compétences en science des données. Un tableur, une règle de notation cohérente et la discipline de tester les types de champs séparément suffisent pour produire des chiffres fiables. Voici le protocole.
Étape 1 — Annoter la vérité terrain. Créez un tableur simple avec une ligne par document et une colonne par champ testé. Pour chaque document, saisissez manuellement la valeur correcte de chaque champ — c'est votre vérité terrain. Soyez précis : si le total de la facture est de 1 590,00 $, écrivez « 1 590,00 $ » et non « 1590 » ou « ~1600 $ ». Une incohérence dans la définition de votre vérité terrain invalide toutes les comparaisons en aval. Pour les lignes d'articles, annotez chaque ligne séparément ou choisissez un sous-ensemble représentatif (les trois premières lignes d'articles de chaque facture, par exemple) plutôt que d'essayer d'annoter chaque ligne de chaque document — ce dernier cas est le genre de travail manuel que vous cherchez à éliminer.
Étape 2 — Comparer les extractions aux valeurs attendues à l'aide de règles de normalisation cohérentes. Avant de noter un seul champ, écrivez vos règles de normalisation. Définissez ce qui constitue une correspondance. Un ensemble de départ raisonnable :
• Dates : normalisez au format AAAA-MM-JJ, acceptez tout format de saisie tant que la date est correcte (« 15/01/2026 » correspond à « 15 janv. 2026 »).
• Montants en devise : supprimez les symboles de devise, acceptez l'équivalence numérique (1 590,00 $ correspond à 1590,00).
• Espaces : supprimez les espaces de début et de fin ; « Acme Corp » correspond à « Acme Corp ».
• Casse : correspondance insensible à la casse pour les champs texte ; « ACME CORP » correspond à « Acme Corp ».
• Noms de fournisseurs partiels : vous devrez faire preuve de discernement ici. « Acme Industrial Supplies Inc » et « Acme Industrial Suppl » — est-ce une correspondance ? Définissez votre règle avant de noter. La plupart des équipes acceptent les noms tronqués qui identifient sans ambiguïté le fournisseur ; rejetez tout ce qui est ambigu.
La règle essentielle : appliquez la même normalisation à chaque outil testé. Si vous êtes indulgent avec l'analyse des dates d'un outil et strict avec celle d'un autre, votre comparaison est invalide. Mêmes règles, même ensemble de tests, même vérité terrain — chaque variation que vous introduisez rend les résultats moins comparables.
Étape 3 — Noter chaque type de champ séparément. Pour chaque document, marquez chaque champ comme correct (1) ou incorrect (0). Calculez la précision par type de champ : précision des en-têtes = extractions d'en-têtes correctes ÷ total des champs d'en-têtes testés. Précision des lignes d'articles = extractions de lignes d'articles correctes ÷ total des champs de lignes d'articles testés. Précision des totaux = extractions de totaux correctes ÷ total des champs de totaux testés. Rapportez trois pourcentages distincts, et non un seul chiffre composite. Un outil avec 99 % de précision sur les en-têtes et 85 % sur les lignes d'articles est un outil différent — pour l'expérience quotidienne de votre équipe — qu'un outil avec 95 % de précision sur les en-têtes et 93 % sur les lignes d'articles, même si leurs scores composites sont similaires.
Étape 4 — Rechercher des schémas dans les échecs avant d'examiner les scores agrégés. Ne vous arrêtez pas à « 92 % de précision sur les lignes d'articles ». Examinez quels documents ont échoué, quels champs ont échoué et s'il existe un schéma. Les schémas courants qui comptent : les factures d'un fournisseur échouent systématiquement (l'outil a du mal avec cette mise en page spécifique) → vous aurez besoin d'une solution de contournement pour ce fournisseur. Les photos de documents papier prises au téléphone échouent plus que les PDF numériques (la qualité d'image dégrade l'extraction) → les reçus de frais de votre équipe terrain auront une précision inférieure à celle des factures envoyées par e-mail. Les champs de date échouent à des taux plus élevés près des frontières mois/année (les modèles confondent la date d'émission et la date d'échéance sur les factures du même mois) → votre lot de clôture de fin de mois nécessitera une vérification supplémentaire. Si un type de champ échoue systématiquement quel que soit le fournisseur — disons que les montants de taxe sont erronés 30 % du temps — c'est une limitation de l'outil, pas un problème de document.
Les schémas d'échec sont plus exploitables que les scores agrégés. Un score global de 94 % qui masque un taux d'échec de 60 % sur un type de champ critique est pire qu'un score global de 89 % où les erreurs sont réparties uniformément sur des champs à faible impact. Le schéma vous indique ce que l'outil peut et ne peut pas faire ; le score agrégé l'obscurcit.
Le résultat d'un bon test de précision n'est pas un chiffre unique. C'est une ventilation champ par champ qui vous indique précisément où l'outil fonctionne, où il ne fonctionne pas, et à quoi ressemblera réellement la charge de correction quotidienne de votre équipe.
Trois erreurs de test de précision qui rendent vos résultats inutiles
La plupart des tests de précision produisent des résultats trompeurs non pas parce que la mesure est difficile, mais parce que la conception du test suppose des conditions qui ne tiennent pas en production. Voici les trois erreurs qui transforment le plus souvent un résultat de test prometteur en un déploiement de production décevant.
Erreur 1 : Tester uniquement des PDF numériques propres alors que votre mix réel inclut des photos de téléphone et des scans. Un PDF généré numériquement — texte net, contraste parfait, aucune rotation — est l'entrée la plus facile possible pour tout outil d'extraction. Une photo de facture papier prise avec un téléphone sous un éclairage de bureau — léger angle, ombres, contraste réduit — est l'entrée que votre équipe terrain ou vos employés à distance soumettent réellement. Si votre ensemble de test est composé de 100 PDF propres et que votre entrée en production est composée de 60 % de PDF propres et 40 % de photos de téléphone, votre test surestime la précision d'une marge potentiellement importante. Les données d'IBM sur la saisie manuelle de données révèlent des taux d'erreur allant jusqu'à 4 % dans les contextes de chaîne d'approvisionnement ; l'automatisation STP (Straight-Through Processing) peut réduire ce taux à environ 1 %, mais uniquement si la qualité des entrées correspond à ce sur quoi l'outil a été testé. Construisez votre ensemble de test pour correspondre à votre mix d'entrées réel — y compris une part représentative des documents de la plus mauvaise qualité que vous recevez réellement.
Erreur 2 : Normaliser de manière incohérente entre les outils. Si vous acceptez « 01/15/2026 » comme correspondant à « 15 janv. 2026 » pour l'outil A mais exigez une correspondance de chaîne exacte pour l'outil B, votre test ne compare pas la précision des outils — il compare votre générosité de notation. La solution est simple mais rarement appliquée : rédigez vos règles de normalisation dans un document partagé avant d'exécuter toute extraction, et appliquez les mêmes règles à la sortie de chaque outil. Même de petites incohérences s'accumulent : si vos règles de normalisation diffèrent sur cinq champs sur 100 documents, cela représente 500 décisions de notation où un biais (même involontaire) peut faire pencher les résultats. Mêmes règles, même vérité terrain, même ensemble de test. Verrouillez les trois avant d'extraire un seul document.
Erreur 3 : Tester trop peu de documents. Dix factures de deux fournisseurs produisent un chiffre de précision qui vous indique comment l'outil performe sur ces dix factures spécifiques de ces deux fournisseurs spécifiques — et rien d'autre. L'intervalle de confiance sur un échantillon aussi petit est suffisamment large pour rendre le résultat dénué de sens. Vingt factures de dix fournisseurs, c'est mieux mais encore bruité : un fournisseur particulièrement délicat qui représente 3 de vos 20 documents de test peut faire varier la précision agrégée de plusieurs points de pourcentage. Les règles de taille d'échantillon de la section quatre ne sont pas arbitraires. En dessous de 30 documents pour un ensemble homogène ou de 100 documents pour un ensemble hétérogène, votre mesure de précision mesure davantage le bruit d'échantillonnage que la performance de l'outil.
Une quatrième erreur, plus subtile, mérite d'être signalée même si elle ne relève pas du protocole de test en lui-même : tester uniquement sur des documents dont vous connaissez déjà le résultat attendu de l'outil. C'est le problème du « document qui ressemble à la démo ». Les documents de démonstration des fournisseurs sont choisis pour être flatteurs — mises en page propres, formats standard, champs clairement étiquetés. Votre pire facture — celle du fournisseur qui utilise une mise en page paysage à trois colonnes avec des annotations manuscrites dans la marge — est celle qui détermine si votre équipe fait confiance à l'outil ou le contourne. Incluez vos pires documents dans le jeu de test. Un outil qui les traite convenablement et vos documents propres parfaitement est plus utile qu'un autre à peine meilleur sur les documents propres mais qui échoue sur les documents difficiles.
Interpréter vos résultats : ce qui est suffisant pour votre cas d'usage
Vous avez des chiffres. Vous devez maintenant décider s'ils justifient de remplacer votre processus actuel. La réponse dépend de l'usage que vous faites de l'extraction — la même précision qui est inacceptable pour un reporting financier peut être parfaitement adaptée au remplacement de la saisie manuelle. Voici comment interpréter les résultats selon le cas d'usage.
Remplacement pur de la saisie manuelle : vous remplacez une personne qui saisit les champs de factures dans un tableur. Dans ce cas, une précision de 95 %+ sur les champs d'en-tête est acceptable — vous obtenez tout de même 19 champs sur 20 corrects automatiquement, et la charge de correction sur le 20ᵉ est négligeable par rapport à la saisie des 20. Une précision de 90 %+ sur les lignes d'article est viable, car l'alternative est de saisir manuellement chaque description de produit, quantité et prix unitaire. La référence ici est votre processus actuel — la saisie manuelle avec son propre taux d'erreur de 1 à 4 %. L'extraction par IA à 95 %+ est supérieure à la saisie manuelle, tant en vitesse qu'en précision.
Correspondance des bons de commande et automatisation de l'AP (Accounts Payable) : vous avez besoin que les montants de factures, les numéros de PO (Purchase Order) et les noms de fournisseurs correspondent exactement aux bons de commande dans votre ERP. Les champs de montant nécessitent une précision de 99 %+, car un montant non concordant casse la correspondance et exige une vérification humaine. Les champs d'en-tête nécessitent 98 %+, car un mauvais numéro de PO envoie la facture à la mauvaise file d'approbation. À 95 % de précision sur 1 000 factures par mois, vous envisagez environ 50 non-concordances liées aux montants chaque mois — chacune nécessitant une investigation manuelle. L'économie change à 99 %+, où ce nombre tombe à 10 ou moins.
Reporting financier et conformité : la précision des lignes d'article devient la métrique critique, car les lignes d'article alimentent l'allocation des coûts, le reporting fiscal et les pistes d'audit. Une précision de 92 % sur les lignes d'article pour 1 000 factures avec une moyenne de 3 lignes chacune signifie environ 240 erreurs de lignes par mois — environ 12 par jour ouvré. Pour la clôture mensuelle, ces erreurs doivent être détectées et corrigées avant que les chiffres ne soient rapportés. Si la précision des lignes d'article est inférieure à 95 % et que votre équipe est responsable du reporting financier basé sur les données extraites, prévoyez une étape de vérification.
Flux de travail mixtes (le cas le plus courant) : la plupart des équipes ne relèvent pas d'une seule catégorie. Vous pourriez avoir besoin de 99 %+ sur les montants et les numéros de PO pour la correspondance AP, mais 90 %+ sur les descriptions de produits suffit, car ces descriptions servent de référence interne, pas de rapprochement. C'est pourquoi tester chaque type de champ séparément est important : vous pouvez accepter une précision moindre sur les champs à faible impact tout en maintenant l'exigence sur ceux à fort impact. Un outil précis à 85 % sur les descriptions de produits et à 99,5 % sur les montants peut être un meilleur choix qu'un autre à 92 % sur l'ensemble — mais vous ne pouvez le déterminer que si vous les avez évalués séparément.
Les données de coûts d'Ardent Partners offrent une vérification utile : à 9,40 $ de coût moyen par facture, même des améliorations modestes du STP génèrent des gains significatifs. Passer de 32 % de STP (moyenne du secteur) à 50 % de STP sur 1 000 factures par mois signifie 180 factures en moins nécessitant une intervention manuelle — et à 5 à 8 minutes de relecture manuelle par facture, cela représente 15 à 24 heures de travail récupérées chaque mois. Le taux de précision qui débloque cette amélioration du STP dépend de la complexité de vos documents et de votre tolérance aux erreurs, et non d'un critère générique. Testez sur vos propres documents et calculez le gain de temps à votre volume réel et avec votre tolérance réelle aux erreurs. Ce chiffre — et non les affirmations d'un fournisseur — constitue votre retour sur investissement.
FAQ
Je n'ai que 20 de mes propres factures. Est-ce suffisant pour tester ?
Vingt factures d'un même fournisseur ou d'un même format vous donnent une idée directionnelle — assez pour repérer les problèmes flagrants — mais pas une estimation stable de la précision. L'intervalle de confiance sur un échantillon aussi petit est large : une précision mesurée de 95 % pourrait signifier une précision réelle comprise entre 85 % et 99 %. Au minimum, complétez vos 20 factures avec l'un des jeux de données publics (SROIE ou MIDD) pour atteindre 50+ documents. Mieux : collectez 50 de vos propres factures — même auprès de 3 à 5 fournisseurs seulement — avant de vous fier aux résultats. Le seuil de taille d'échantillon fait la différence entre « cet outil semble correct » et « je sais quelle sera la charge de correction de mon équipe ».
Dois-je tester les documents manuscrits séparément ?
Oui. L'écriture manuscrite introduit un profil d'erreurs différent — confusion de caractères (1 vs 7, 0 vs O), espacement incohérent et lisibilité variable selon les scripteurs — qui ne s'applique pas au texte imprimé. Un outil qui atteint 98 % de précision sur les champs de factures imprimées peut chuter à 70–80 % sur des formulaires manuscrits. Si les documents manuscrits font partie de votre mix documentaire réel (reçus de livraison, formulaires d'inspection sur le terrain, bons de commande manuscrits), créez un sous-ensemble de test distinct pour eux et évaluez-le indépendamment. Moyenner la précision manuscrite et imprimée masque la dégradation — vous voulez savoir si l'outil est utilisable sur l'écriture manuscrite, pas s'il atteint une moyenne acceptable.
Qu'en est-il des factures non anglaises ?
La plupart des modèles de vision IA (GPT-4o, Claude, Gemini) gèrent les langues principales — espagnol, français, allemand, japonais, chinois — aussi bien que l'anglais, car les données d'entraînement sous-jacentes sont multilingues. Les noms de champs dans différentes langues (« Numéro de facture », « Rechnungsnummer », « 請求書番号 ») sont reconnus comme équivalents à « Invoice Number » grâce à la compréhension sémantique du modèle. La précision se dégrade sur les langues avec moins de données d'entraînement et sur les documents dont les conventions de mise en page diffèrent considérablement des formats de factures occidentaux — certains formats de factures asiatiques, par exemple, utilisent un flux de texte vertical ou des structures de tableau qui diffèrent de la mise en page de gauche à droite et de haut en bas sur laquelle les modèles sont principalement entraînés. Si votre mix documentaire comprend une part importante de factures non anglaises, incluez un échantillon représentatif dans votre jeu de test plutôt que de supposer que les résultats en anglais se transfèrent.
Dois-je re-tester après les mises à jour de l'outil ?
Pour les outils traditionnels basés sur l'OCR et les modèles, les mises à jour ne changent généralement pas le comportement d'extraction sur les modèles existants, donc un re-test n'est pas nécessaire. Pour les outils basés sur l'IA, les mises à jour du modèle sous-jacent peuvent changer le comportement d'extraction — améliorant parfois la précision, introduisant occasionnellement des régressions sur des cas limites. Un re-test léger sur un sous-ensemble de 10 documents après les mises à jour majeures du modèle est une pratique raisonnable si votre flux de travail dépend d'une haute précision à des fins financières ou de conformité. Vous n'avez pas besoin de relancer le protocole complet de 100 documents à chaque fois ; une vérification rapide sur vos documents les plus représentatifs et les plus problématiques suffira à détecter les régressions importantes.
Comment comparer deux outils équitablement ?
Même jeu de test, mêmes annotations de vérité terrain, mêmes règles de normalisation, même méthodologie de notation. Si vous testez l'outil A sur les 50 premières factures de votre dossier et l'outil B sur les 50 suivantes, vous n'avez pas comparé des outils — vous avez comparé deux jeux de test différents. Créez un jeu de test annoté unique, exécutez les deux outils dessus et notez les deux avec des règles identiques. Si l'outil A prend en charge une fonctionnalité que l'outil B n'a pas (comme la normalisation automatique des dates), appliquez la règle de normalisation que vous avez définie avant le test — n'attribuez pas de crédit à l'outil A pour une fonctionnalité en assouplissant le standard de notation. L'objectif est une comparaison de la précision d'extraction dans des conditions égales, pas une comparaison des fonctionnalités de post-traitement.
Et si l'outil dispose d'une fonctionnalité de score de confiance ?
Les scores de confiance — où l'outil signale les extractions à faible confiance pour révision humaine — peuvent réduire considérablement la charge de correction manuelle si les scores sont fiables. Un outil qui atteint 95 % de précision sur les champs mais signale correctement 80 % de ses erreurs avec des scores de confiance faibles transforme efficacement un taux d'erreur de 5 % en un taux d'erreur non détecté de 1 % (les 20 % d'erreurs non signalées). Testez les scores de confiance dans le cadre de votre évaluation : pour les champs que l'outil a signalés comme à faible confiance, quel était le taux d'erreur réel ? Pour les champs signalés comme à haute confiance, certains étaient-ils incorrects ? Un système de score de confiance mal calibré — signalant des extractions correctes comme à faible confiance (faux positifs qui font perdre du temps en révision) ou manquant des erreurs réelles (faux négatifs qui laissent passer des données erronées) — est pire qu'aucun système de confiance, car il crée un faux sentiment de sécurité.
Le meilleur taux de précision est celui que vous avez mesuré vous-même — sur vos documents, avec vos définitions de champs, évalué selon votre tolérance aux erreurs. Chaque outil sur ce marché peut trouver un moyen de revendiquer 99 % de quelque chose. La question n'est pas ce qu'ils affirment, mais ce que vous pouvez vérifier, sur les documents qui arrivent réellement dans votre boîte de réception, pour les champs dont votre équipe a réellement besoin.
Si vous évaluez des outils d'extraction et souhaitez mettre ce protocole en pratique, ImageToTable.ai fonctionne avec un LLM visuel qui extrait selon la sémantique des champs plutôt que selon des coordonnées de modèle — ce qui signifie que vous définissez les champs souhaités une seule fois et que la même extraction fonctionne sur la mise en page de n'importe quel fournisseur. La comparaison entre AI et OCR traditionnel couvre la différence architecturale qui rend cela possible, le guide des concepts d'extraction de documents explique en pratique en quoi l'extraction sémantique au niveau des champs diffère de l'OCR au niveau des caractères, et l'extraction de colonnes personnalisées montre comment définir les champs à tester en premier lieu. Exécutez le protocole de test, évaluez chaque type de champ séparément et vérifiez si les chiffres correspondent aux affirmations.
Téléchargez vos propres documents et testez l'extraction au niveau des champs vous-même — aucune configuration, aucun modèle, aucune donnée d'entraînement requise.
Essayez ImageToTable.ai gratuitement