Cómo probar realmente la precisión de la extracción de documentos
Una guía práctica para cualquiera que evalúe herramientas de AI OCR
Toda herramienta de extracción de documentos en el mercado dice lo mismo: "99% de precisión". La afirmación aparece en las páginas de aterrizaje de los proveedores, en las presentaciones de ventas y en las tablas comparativas de productos. Es un número sin una definición acordada detrás: ¿99% de qué, medido cómo, sobre qué documentos, bajo qué condiciones? Esta guía reemplaza ese único número de marketing con un marco que usted mismo puede usar. Esto es lo que la precisión realmente significa en cuatro niveles diferentes, qué métricas predicen resultados comerciales reales y un protocolo paso a paso para realizar su propia prueba de precisión, usando conjuntos de datos públicos gratuitos o sus propios documentos, antes de comprometerse con cualquier herramienta.
Conclusiones clave
- Cuando un proveedor afirma "99% de precisión", pregunte ¿99% de qué? — las tasas a nivel de carácter, de campo, de documento y de procesamiento directo cuentan cuatro historias diferentes sobre la misma herramienta.
- Con un 97% de precisión de campo en una factura de 15 campos, más de uno de cada tres documentos contiene al menos un error — la brecha que la mayoría de los equipos descubren solo después de implementar la herramienta.
- El promedio de la industria para el procesamiento directo es del 32% — la extracción con IA de primer nivel alcanza el 60–80%, eliminando aproximadamente la mitad del esfuerzo de revisión manual por completo.
- Probar 10 facturas limpias produce números de precisión que no predicen nada — una estimación estable requiere 100+ documentos de su mezcla real de proveedores, incluidos los de peor calidad.
- Puntúe los encabezados, las líneas de detalle y los totales calculados por separado — promediarlos juntos oculta una precisión del 85% en líneas de detalle detrás de un 99% en encabezados que se ve bien en un marcador pero se siente diferente en las operaciones diarias.
Por qué "99% de precisión" es un número sin sentido por sí solo
La "precisión" en la extracción de documentos no es un solo número: son cuatro números distintos que cuentan cuatro historias diferentes sobre la misma herramienta. La mayoría de los proveedores eligen el que hace que su producto luzca mejor. Entender cuál le están mostrando es el primer paso para evaluar cualquier afirmación con honestidad.
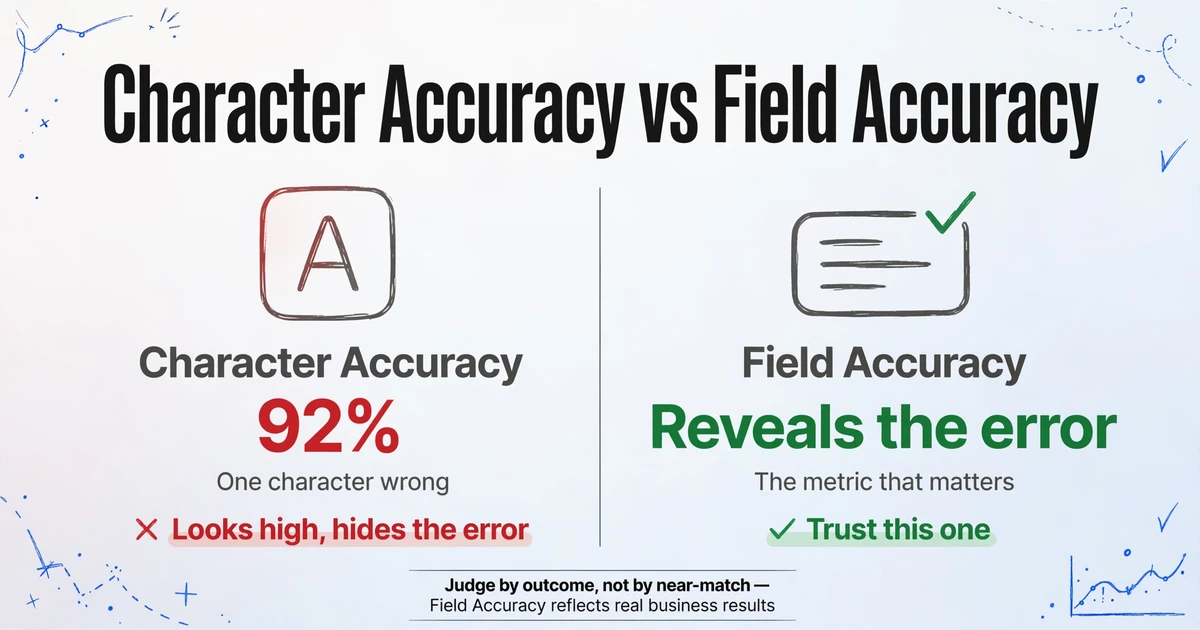
Nivel 1 — Precisión de caracteres (CER). ¿Qué porcentaje de caracteres individuales se leyó correctamente? Si un documento contiene 500 caracteres y la herramienta lee 495 correctamente, la precisión de caracteres es del 99%. El OCR tradicional en texto impreso limpio oscila entre 85 y 97%; los modelos modernos de visión con IA alcanzan el 98–99.5%. Esta es la métrica más fácil de lograr y en la que se basan la mayoría de las afirmaciones de los proveedores, pero es casi inútil para decisiones empresariales. Considere un ejemplo del mundo real:
Un número de factura "INV-20260412" se lee como "INV-2O260412" — un carácter incorrecto, 92% de precisión de caracteres en este campo, suena aceptable. Pero el valor del campo es completamente incorrecto para la conciliación en AP. La precisión de caracteres le dijo que la herramienta acertó en su mayoría; el resultado empresarial dice que falló por completo.
Nivel 2 — Precisión de campos. Un campo es correcto solo cuando cada carácter de ese campo es correcto. Un carácter incorrecto = todo el campo falla. Esta es la métrica que importa para las operaciones. La extracción tradicional basada en plantillas logra una precisión de campos del 70–90% en conjuntos de documentos variados porque las variaciones de formato rompen las plantillas. La extracción basada en IA logra una precisión de campos del 95–99.5% en documentos comerciales estándar. Con un 98% de precisión de caracteres, un número de factura de 10 caracteres será incorrecto aproximadamente el 18% de las veces — la precisión de caracteres enmascara el fallo a nivel de campo.
Nivel 3 — Precisión de documentos. Un documento se considera correcto solo cuando todos los campos de ese documento son correctos. Si extrae 15 campos por factura y su precisión de campos es del 97%, la probabilidad de que los 15 campos sean correctos en una factura determinada es 0.97^15 = aproximadamente 63%. Eso significa que el 37% de sus facturas — más de una de cada tres — tienen al menos un error de campo. Una tasa de precisión de campos del 97% suena impresionante; una tasa de precisión de documentos del 63% revela cuánta revisión humana se necesita todavía.
Nivel 4 — STP (Straight-Through Processing). El porcentaje de documentos que requieren cero intervención humana — sin correcciones, sin alertas de revisión, sin intervención manual. Este es el número que se traduce directamente en costo laboral. El informe de métricas de AP 2025 de Ardent Partners sitúa la tasa promedio de STP de la industria en 32.6%, la de los mejores en 49.2%, y las implementaciones líderes de IA en 60–80%. La brecha entre 32% y 80% de STP representa aproximadamente la mitad del esfuerzo de revisión manual eliminado por completo. Ese es el número que se refleja en la dotación de personal y las horas extra de su departamento — por eso es el nivel que importa y el que los proveedores casi nunca publican.
Cuando un proveedor dice "99% de precisión", pregunte: ¿99% de qué? ¿Caracteres, campos, documentos o STP? La respuesta le dirá si el número significa algo o nada.
Los Únicos Tres Números Que Su Negocio Realmente Necesita
Olvide la afirmación de marketing. Al evaluar una herramienta de extracción de documentos para operaciones reales, tres métricas le dicen casi todo lo que necesita saber — y ninguna de ellas es el número en la página principal del proveedor.
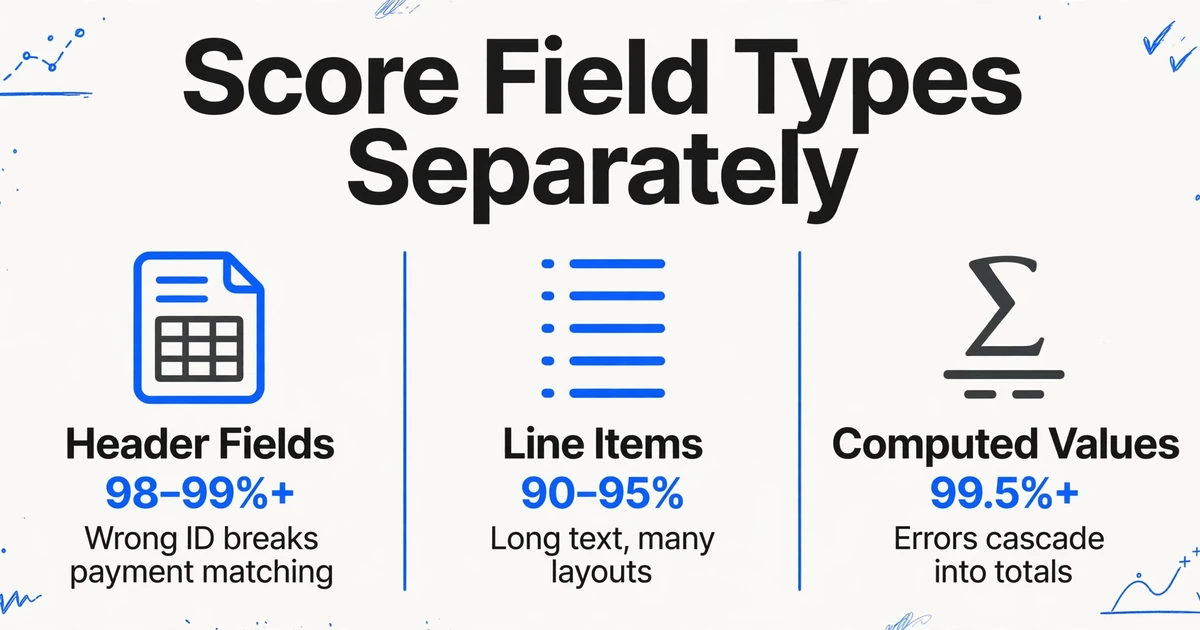
Precisión de campos: cuántas correcciones por día. Para campos de encabezado — números de factura, fechas, nombres de proveedores, totales — las herramientas de IA deberían alcanzar 98–99%+ en documentos limpios. Para líneas de detalle — descripciones de productos, precios unitarios, cantidades — 90–95% es una expectativa más realista porque las líneas de detalle implican más texto, más variación y más complejidad de formato. La pregunta práctica no es "cuál es el porcentaje de precisión de campos" — es "cuántas correcciones hará mi equipo por día a nuestro volumen?"
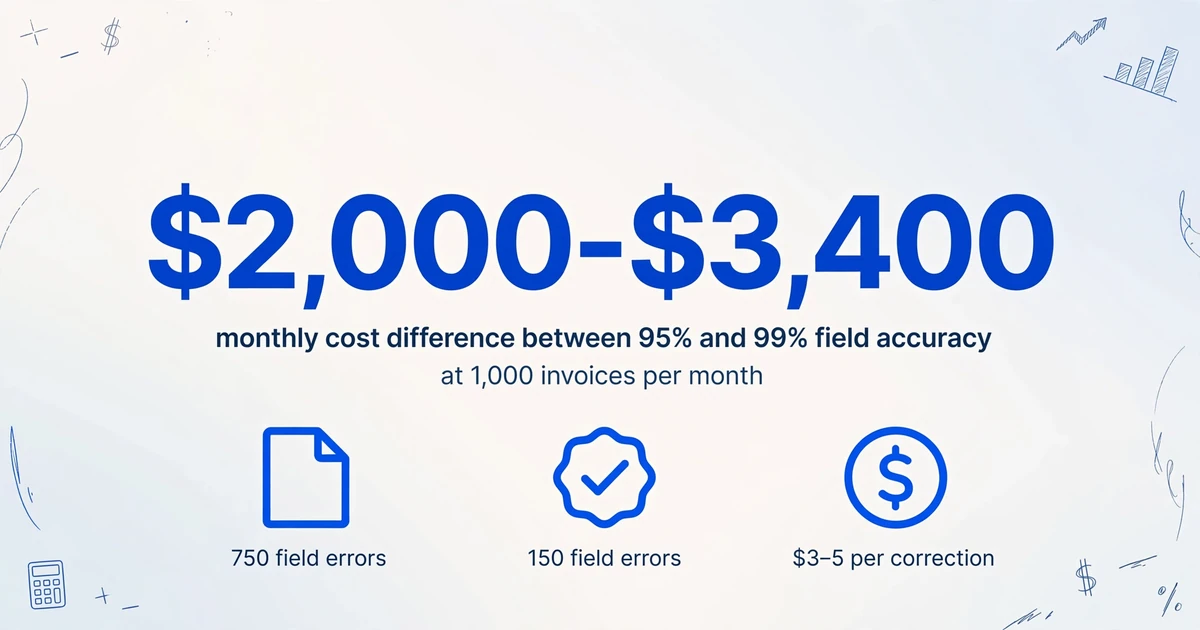
Precisión de documentos: cuántas facturas necesitan intervención humana. Esto es la precisión de campos combinada en todos los campos de un documento. A 1,000 facturas por mes con 15 campos cada una, la diferencia entre 95% y 99% de precisión de campos es la diferencia entre 750 errores de campo por mes y 150 errores de campo por mes. Cada corrección cuesta aproximadamente $3–5 en mano de obra (localizar el error, verificar el documento fuente, corregir la celda). Eso es una diferencia mensual de $2,000–$3,400 — en una métrica, en un departamento.
Tasa de STP: cuántas pasan sin intervención. Los puntos de referencia de la industria de Ardent Partners ponen el panorama de costos en contexto: la organización promedio gasta $9.40 para procesar una sola factura de principio a fin, con un tiempo de procesamiento promedio de 9.15 días y una tasa de excepción del 14%. Las organizaciones de clase mundial gastan $2.78 por factura, procesan en 3.1 días y alcanzan una tasa de excepción cercana al 5%. La diferencia entre promedio y clase mundial no son mejores personas — es una tasa de STP más alta habilitada por automatización que no requiere que los humanos toquen la mayoría de los documentos.
Estas tres métricas se conectan directamente con el costo de una manera que una sola afirmación de "99%" nunca podría. La precisión de campos predice la carga de trabajo diaria de correcciones. La precisión de documentos predice cuántas facturas necesitan revisión. La tasa de STP predice cuánta mano de obra puede eliminar por completo. Si un proveedor no puede o no quiere proporcionar números en estos tres niveles — medidos en un conjunto de pruebas que usted reconocería como realista — la afirmación de precisión en su página de aterrizaje está respondiendo una pregunta que su negocio no está haciendo.
Qué probar — y por qué no debería probarlo todo por igual
El instinto natural es probar todos los campos y promediar los resultados. Eso produce un número que parece limpio pero oculta la diferencia entre campos fáciles y difíciles — que es exactamente la diferencia que determina si la herramienta funciona para su flujo de trabajo.
No todos los campos son igualmente difíciles de extraer, y no todos los fallos de campo tienen el mismo costo empresarial. Un número de factura incorrecto significa que el pago no se puede emparejar — costo alto. Un nombre de proveedor ligeramente truncado ("Acme Industrial Suppl" vs "Acme Industrial Supplies Inc") significa que alguien lo examina por medio segundo — costo insignificante. Tratar ambos como errores iguales en su cálculo de precisión infla el problema en los nombres de proveedores y lo oculta en los números de factura.
Divida su prueba en tres categorías y puntúe cada una por separado:
Campos de encabezado — número de factura, fecha, nombre del proveedor, referencia de PO, monto total, moneda. Estos suelen estar bien etiquetados, posicionados de manera consistente cerca de la parte superior del documento, y usan formatos estandarizados. Las herramientas de AI deberían alcanzar 98–99%+ de precisión de campo en estos. Si una herramienta no alcanza el 95% en campos de encabezado, no está lista para su flujo de trabajo de producción sin importar qué más haga bien.
Partidas individuales — descripciones de productos, cantidades, precios unitarios, totales de línea. Estos son más difíciles porque las tablas de partidas varían drásticamente en estructura, las etiquetas de columna difieren según el proveedor, y las descripciones de productos pueden ser cadenas largas de texto libre. Las herramientas de AI típicamente logran 90–95% de precisión de campo en partidas individuales. Una herramienta con 92% en partidas individuales a 1,000 facturas por mes con un promedio de 3 partidas por factura significa aproximadamente 240 correcciones de campo de partidas por mes — unas 12 por día laboral. Incorpore eso en su modelo de personal.
Valores calculados o derivados — subtotales que deberían igualar la suma de las partidas, montos de impuestos que deberían coincidir con la tasa declarada, totales que deberían conciliar entre secciones. Estos son los campos donde los errores de extracción se propagan en discrepancias financieras. Pruébelos por separado y establezca un estándar más alto: los montos totales deberían ser 99.5%+ precisos porque una factura de $1,590.00 registrada como $15,900.00 es un error mucho más costoso que un nombre de producto mal escrito.
Lo que no quiere es un solo número de "92% de precisión general" que promedie 99% de precisión en encabezados con 85% en partidas individuales. Ese promedio no le dice nada útil; el 85% en partidas individuales es lo que sentirá en las operaciones diarias, y está oculto dentro del número compuesto. Puntúe cada categoría de forma independiente y compare herramientas categoría por categoría — no general por general.
Cómo crear su conjunto de pruebas: cuántos documentos, qué variedad y dónde encontrarlos
Un conjunto de pruebas que no refleje su mezcla real de documentos produce cifras de precisión que no predicen su experiencia real. El error más común al probar la precisión — probar con un puñado de facturas limpias y conocidas y asumir que los resultados se generalizan — es la razón por la que muchos equipos terminan decepcionados en producción.
Cuántos documentos necesita depende de lo uniforme que sea su población de documentos. Si todas sus facturas provienen de un solo proveedor que nunca cambia su formato — documentos homogéneos — de 30 a 50 documentos le dan una estimación estable. Su precisión de extracción no variará mucho de un documento a otro porque el diseño es consistente. Si recibe facturas de docenas de proveedores en múltiples formatos — documentos heterogéneos — necesita al menos 100 documentos. Cada tipo de diseño adicional que quiera que los resultados representen añade aproximadamente de 20 a 30 documentos más a la muestra requerida. Por debajo de estos umbrales, su medición de precisión cuantifica la variación aleatoria, no el rendimiento de la herramienta.
Dónde encontrar documentos de prueba. El mejor conjunto de pruebas es el suyo propio: tome sus 50 a 100 facturas más recientes, expórtelas desde su correo electrónico o sistema de AP, y anótelas. Pero si está evaluando herramientas antes de tener volumen — o quiere una línea base estandarizada que le permita comparar herramientas con los mismos documentos — hay tres conjuntos de datos públicos disponibles de forma gratuita:
- ICDAR SROIE (2019) — 1,000 recibos escaneados con etiquetas de verdad absoluta para cuatro campos: nombre de la empresa, dirección, fecha y total. Ampliamente utilizado como referencia en la investigación académica de OCR. Bueno para probar la extracción de recibos; menos útil para facturas con partidas y desgloses de impuestos.
- Middlesex Invoice Document Dataset (MIDD, 2021) — 630 PDF de facturas en cuatro plantillas de diseño con 11 campos etiquetados cada uno. Más cercano a los flujos de trabajo reales de AP que SROIE porque son facturas reales, no recibos, e incluye datos de partidas. Publicado en la revista MDPI Data con documentación completa de la metodología de anotación.
- Innovatiana Historical Invoice Dataset — aproximadamente 1,560 imágenes de facturas antiguas con verdad absoluta en XML, publicadas bajo CC0 Public Domain. Los documentos son históricos en lugar de contemporáneos (diseños más antiguos, calidad de escaneo variable), lo que los hace útiles para probar cómo las herramientas manejan entradas degradadas — pero menos representativos de las facturas PDF digitales modernas.
Los conjuntos de datos públicos son un punto de partida útil, pero tienen una limitación: no representan su mezcla específica de proveedores. Las facturas que su empresa recibe — de sus proveedores reales, con la terminología y las convenciones de formato de su industria — no se verán exactamente como los documentos de referencia académicos. Use los conjuntos de datos públicos para reducir su lista a dos o tres herramientas, y luego realice una segunda ronda de pruebas con 30 a 50 de sus propias facturas reales antes de tomar una decisión final.
Cómo Ejecutar la Prueba: Un Protocolo Sencillo de Cuatro Pasos
No necesitas código, una integración de API ni conocimientos de ciencia de datos. Una hoja de cálculo, una regla de puntuación consistente y la disciplina de probar los tipos de campos por separado son suficientes para obtener números en los que puedas confiar. Aquí está el protocolo.
Paso 1 — Anote la verdad fundamental. Cree una hoja de cálculo sencilla con una fila por documento y una columna por campo que esté probando. Para cada documento, ingrese manualmente el valor correcto para cada campo — esta es su verdad fundamental. Sea preciso: si el total de la factura es $1,590.00, escriba "$1,590.00" y no "1590" o "~$1600." La inconsistencia en la definición de su verdad fundamental invalida cada comparación posterior. Para los artículos de línea, anote cada línea por separado o elija un subconjunto representativo (los primeros tres artículos de línea de cada factura, por ejemplo) en lugar de intentar anotar cada línea de cada documento — esto último es el tipo de trabajo manual que está tratando de eliminar.
Paso 2 — Compare lo extraído con lo esperado usando reglas de normalización consistentes. Antes de puntuar un solo campo, escriba sus reglas de normalización. Defina qué cuenta como una coincidencia. Un conjunto inicial razonable:
• Fechas: normalice a AAAA-MM-DD, acepte cualquier formato de entrada siempre que la fecha sea correcta ("01/15/2026" coincide con "15 ene 2026").
• Montos en moneda: elimine los símbolos de moneda, acepte la equivalencia numérica ($1,590.00 coincide con 1590.00).
• Espacios en blanco: elimine los espacios iniciales y finales; "Acme Corp" coincide con " Acme Corp ".
• Mayúsculas y minúsculas: coincidencia sin distinción de mayúsculas para campos de texto; "ACME CORP" coincide con "Acme Corp."
• Nombres de proveedores parciales: aquí necesitará un criterio. "Acme Industrial Supplies Inc" y "Acme Industrial Suppl" — ¿es una coincidencia? Defina su regla antes de puntuar. La mayoría de los equipos aceptan nombres truncados que identifiquen inequívocamente al proveedor; rechace cualquier cosa ambigua.
La regla crítica: aplique la misma normalización a cada herramienta que pruebe. Si es indulgente con el análisis de fechas de una herramienta y estricto con el de otra, su comparación no es válida. Mismas reglas, mismo conjunto de pruebas, misma verdad fundamental — cada variación que introduzca hace que los resultados sean menos comparables.
Paso 3 — Puntúe por tipo de campo por separado. Para cada documento, marque cada campo como correcto (1) o incorrecto (0). Calcule la precisión por tipo de campo: precisión de encabezado = extracciones de encabezado correctas ÷ total de campos de encabezado probados. Precisión de artículos de línea = extracciones de artículos de línea correctas ÷ total de campos de artículos de línea probados. Precisión de totales = extracciones de totales correctas ÷ total de campos de totales probados. Reporte tres porcentajes separados, no un número compuesto. Una herramienta con 99% de precisión de encabezado y 85% de precisión de artículos de línea es una herramienta diferente — para la experiencia diaria de su equipo — que una con 95% de precisión de encabezado y 93% de precisión de artículos de línea, incluso si sus puntuaciones compuestas son similares.
Paso 4 — Busque patrones en los fallos antes de mirar las puntuaciones agregadas. No se detenga en "92% de precisión de artículos de línea." Mire qué documentos fallaron, qué campos fallaron y si hay un patrón. Patrones comunes que importan: las facturas de un proveedor fallan consistentemente (la herramienta tiene dificultades con ese diseño específico) → necesitará una solución alternativa para ese proveedor. Las fotos de teléfono de documentos en papel fallan más que los PDF digitales (la calidad de imagen degrada la extracción) → los recibos de gastos de su equipo de campo tendrán menor precisión que las facturas enviadas por correo electrónico. Los campos de fecha fallan a tasas más altas cerca de los límites de mes/año (los modelos confunden la fecha de emisión con la fecha de vencimiento en facturas del mismo mes) → su lote de cierre de fin de mes necesitará revisión adicional. Si un tipo de campo falla consistentemente independientemente del proveedor — por ejemplo, los montos de impuestos son incorrectos el 30% de las veces — eso es una limitación de la herramienta, no un problema del documento.
Los patrones en los fallos son más accionables que las puntuaciones agregadas. Una puntuación general del 94% que oculta una tasa de fallo del 60% en un tipo de campo crítico es peor que una puntuación general del 89% donde los errores se distribuyen uniformemente entre campos de bajo impacto. El patrón te dice qué puede y qué no puede hacer la herramienta; la puntuación agregada lo oculta.
El resultado de una buena prueba de precisión no es un solo número. Es un desglose por tipo de campo que te dice exactamente dónde funciona la herramienta, dónde no, y cómo será realmente la carga de trabajo diaria de corrección de tu equipo.
Tres errores en las pruebas de precisión que invalidan tus resultados
La mayoría de las pruebas de precisión producen resultados engañosos no porque la medición sea difícil, sino porque el diseño de la prueba asume condiciones que no se cumplen en producción. Estos son los tres errores que con mayor frecuencia convierten un resultado prometedor en una implementación decepcionante.
Error 1: Probar solo PDFs digitales limpios cuando tu mezcla real incluye fotos de teléfono y escaneos. Un PDF generado digitalmente — texto nítido, contraste perfecto, sin rotación — es la entrada más fácil posible para cualquier herramienta de extracción. Una foto de una factura en papel tomada con un teléfono bajo iluminación de oficina — ligero ángulo, algo de sombra, menor contraste — es la entrada que tu equipo de campo o empleados remotos realmente envían. Si tu conjunto de prueba es 100 PDFs limpios y tu entrada de producción es 60% PDFs limpios y 40% fotos de teléfono, tu prueba sobreestima la precisión por un margen que podría ser grande. Los datos de IBM sobre entrada manual de datos encuentran tasas de error de hasta el 4% en contextos de cadena de suministro; la automatización STP puede reducirlo a aproximadamente el 1%, pero solo si la calidad de entrada coincide con lo que se probó en la herramienta. Construye tu conjunto de prueba para que coincida con tu mezcla real de entradas — incluyendo una proporción representativa de los documentos de peor calidad que realmente recibes.
Error 2: Normalizar de forma inconsistente entre herramientas. Si aceptas "01/15/2026" como equivalente a "Jan 15, 2026" para la Herramienta A pero exiges una coincidencia exacta de cadena para la Herramienta B, tu prueba no compara la precisión de las herramientas — compara tu generosidad al puntuar. La solución es simple pero rara vez se hace: escribe tus reglas de normalización en un documento compartido antes de ejecutar cualquier extracción, y aplica las mismas reglas a la salida de cada herramienta. Incluso las pequeñas inconsistencias se acumulan: si tus reglas de normalización difieren en cinco campos en 100 documentos, eso son 500 decisiones de puntuación donde el sesgo (incluso involuntario) puede inclinar los resultados. Mismas reglas, misma verdad de referencia, mismo conjunto de prueba. Bloquea los tres antes de extraer un solo documento.
Error 3: Probar muy pocos documentos. Diez facturas de dos proveedores producen un número de precisión que te dice cómo funciona la herramienta en esas diez facturas específicas de esos dos proveedores específicos — y nada más. El intervalo de confianza en una muestra tan pequeña es lo suficientemente amplio como para hacer que el resultado carezca de significado. Veinte facturas de diez proveedores es mejor pero aún ruidoso: un proveedor particularmente difícil que representa 3 de tus 20 documentos de prueba puede mover la precisión agregada en varios puntos porcentuales. Las reglas de tamaño de muestra de la sección cuatro no son arbitrarias. Por debajo de 30 documentos para un conjunto homogéneo o 100 documentos para un conjunto heterogéneo, tu medición de precisión está midiendo el ruido de la muestra más que el rendimiento de la herramienta.
Un cuarto error, más sutil, merece señalarse incluso si no encaja en el propio protocolo de pruebas: probar solo con documentos donde ya se conoce el resultado esperado de la herramienta. Es el problema del "documento que parece el demo". Los documentos de demostración de los proveedores se eligen para que luzcan bien: diseños limpios, formatos estándar, campos claramente etiquetados. Su peor factura —la del proveedor que usa un diseño apaisado de tres columnas con notas manuscritas al margen— es la que determina si su equipo confía en la herramienta o la evita. Incluya sus peores documentos en el conjunto de pruebas. Una herramienta que los maneja aceptablemente y sus documentos limpios a la perfección es más útil que otra ligeramente mejor en documentos limpios pero que falla con los difíciles.
Interpretación de sus resultados: qué es suficiente para su caso de uso
Ya tiene los números. Ahora debe decidir si justifican cambiar su proceso actual. La respuesta depende de para qué use la extracción: la misma precisión que resulta inaceptable para informes financieros puede ser perfectamente adecuada para sustituir la captura de datos. Así se interpretan los resultados según el caso de uso.
Sustitución pura de captura de datos: está reemplazando a una persona que teclea campos de facturas en una hoja de cálculo. En este caso, una precisión de campo del 95%+ en los campos de cabecera es aceptable: sigue obteniendo 19 de cada 20 campos correctos automáticamente, y la carga de corrección del vigésimo es trivial comparada con teclear los 20. Una precisión del 90%+ en líneas de detalle es viable porque la alternativa es teclear cada descripción de producto, cantidad y precio unitario a mano. El punto de referencia aquí es su proceso actual: la captura manual con su propia tasa de error del 1–4%. La extracción con IA al 95%+ supera a la captura manual tanto en velocidad como en precisión.
Conciliación de PO y automatización de AP: necesita que los importes de factura, números de PO y nombres de proveedor coincidan exactamente con las órdenes de compra en su ERP. Los campos de importe requieren una precisión del 99%+ porque un importe que no coincide rompe la conciliación y exige investigación humana. Los campos de cabecera necesitan un 98%+ porque un número de PO incorrecto envía la factura a la cola de aprobación equivocada. Con una precisión de campo del 95% en 1.000 facturas al mes, hablamos de unas 50 discrepancias de importe mensuales, cada una con su investigación manual. La economía cambia al 99%+, donde esa cifra baja a 10 o menos.
Informes financieros y cumplimiento: la precisión en líneas de detalle se convierte en la métrica crítica porque alimentan la asignación de costos, los informes fiscales y las pistas de auditoría. Una precisión del 92% en líneas de detalle sobre 1.000 facturas con un promedio de 3 líneas cada una implica unos 240 errores de línea al mes, unos 12 por día laborable. Para el cierre mensual, esos errores deben detectarse y corregirse antes de reportar las cifras. Si la precisión en líneas de detalle está por debajo del 95% y su equipo es responsable de informes financieros basados en los datos extraídos, presupueste un paso de verificación.
Flujos de trabajo mixtos (el caso más común): la mayoría de los equipos no encajan claramente en una sola categoría. Puede necesitar un 99%+ en importes y números de PO para la conciliación de AP, pero un 90%+ en descripciones de producto es suficiente porque son para referencia interna, no para conciliación. Por eso importa probar cada tipo de campo por separado: puede aceptar menor precisión en campos de bajo impacto mientras mantiene el estándar en los de alto impacto. Una herramienta con un 85% de precisión en descripciones de producto y un 99,5% en importes puede encajar mejor que otra con un 92% general, pero solo puede tomar esa decisión si las evaluó por separado.
Los datos de costos de Ardent Partners ofrecen una verificación útil de la realidad: con un costo promedio de proceso de $9.40 por factura, incluso mejoras modestas en STP se acumulan de manera significativa. Pasar del 32% de STP (promedio de la industria) al 50% de STP en 1,000 facturas al mes significa 180 facturas menos que requieren intervención manual — y a 5–8 minutos de revisión manual por factura, eso equivale a 15 a 24 horas de trabajo recuperadas cada mes. El porcentaje de precisión que desbloquea esa mejora de STP depende de la complejidad de sus documentos y de su tolerancia al error, no de un punto de referencia genérico. Ejecute la prueba en sus propios documentos y calcule la recuperación de trabajo según su volumen real y su tolerancia real al error. Ese número — no la afirmación de ningún proveedor — es su ROI.
Preguntas frecuentes
Solo tengo 20 facturas propias. ¿Es suficiente para probar?
Veinte facturas de un solo proveedor o formato le dan una idea general — suficiente para detectar problemas evidentes — pero no una estimación estable de precisión. El intervalo de confianza en una muestra tan pequeña es amplio: una precisión medida del 95% podría significar que la precisión real está entre el 85% y el 99%. Como mínimo, complemente sus 20 facturas con uno de los conjuntos de datos públicos (SROIE o MIDD) para llegar a más de 50 documentos. Mejor aún: recopile 50 facturas propias — incluso de solo 3 a 5 proveedores — antes de confiar en los resultados. El umbral del tamaño de muestra es la diferencia entre "esta herramienta parece funcionar" y "sé cuál será la carga de corrección de mi equipo".
¿Debo probar los documentos manuscritos por separado?
Sí. La escritura manual introduce un perfil de error diferente — confusión de caracteres (1 vs. 7, 0 vs. O), espaciado inconsistente y legibilidad variable entre escritores — que no aplica al texto impreso. Una herramienta que logra un 98% de precisión de campos en facturas impresas puede caer al 70–80% en formularios manuscritos. Si los documentos manuscritos forman parte de su mezcla real de documentos (recibos de entrega, formularios de inspección de campo, órdenes de compra manuscritas), cree un subconjunto de prueba separado para ellos y evalúelo de forma independiente. Promediar la precisión manuscrita e impresa oculta la degradación — usted quiere saber si la herramienta es utilizable con escritura manual en absoluto, no si el promedio resulta aceptable.
¿Qué pasa con las facturas en otros idiomas?
La mayoría de los modelos de visión de IA (GPT-4o, Claude, Gemini) manejan los idiomas principales — español, francés, alemán, japonés, chino — tan bien como el inglés, porque los datos de entrenamiento subyacentes son multilingües. Los nombres de campos en diferentes idiomas ("Numéro de facture", "Rechnungsnummer", "請求書番号") se reconocen como equivalentes a "Invoice Number" gracias a la comprensión semántica del modelo. Donde la precisión se degrada es en idiomas con menos datos de entrenamiento y en documentos cuyas convenciones de diseño difieren significativamente de los formatos de factura occidentales — algunos formatos de factura asiáticos, por ejemplo, usan flujo de texto vertical o estructuras de tabla que difieren del diseño de izquierda a derecha y de arriba a abajo con el que los modelos están predominantemente entrenados. Si su mezcla de documentos incluye una proporción significativa de facturas en otros idiomas, incluya una muestra representativa en su conjunto de prueba en lugar de asumir que los resultados en inglés se transfieren.
¿Necesito volver a probar después de que la herramienta se actualice?
Para las herramientas tradicionales de OCR y basadas en plantillas, las actualizaciones generalmente no cambian el comportamiento de extracción en plantillas existentes, por lo que no es necesario volver a probar. Para las herramientas basadas en IA, las actualizaciones del modelo subyacente pueden cambiar el comportamiento de extracción — a veces mejorando la precisión, ocasionalmente introduciendo regresiones en casos límite. Una nueva prueba ligera en un subconjunto de 10 documentos después de actualizaciones importantes del modelo es una práctica razonable si su flujo de trabajo depende de alta precisión para fines financieros o de cumplimiento. No necesita volver a ejecutar el protocolo completo de 100 documentos cada vez; una verificación rápida en sus documentos más representativos y en los más problemáticos detectará las regresiones que importan.
¿Cómo comparo dos herramientas de manera justa?
Mismo conjunto de pruebas, mismas anotaciones de referencia, mismas reglas de normalización, misma metodología de puntuación. Si prueba la Herramienta A con las primeras 50 facturas de su carpeta y la Herramienta B con las segundas 50, no ha comparado herramientas — ha comparado dos conjuntos de pruebas diferentes. Cree un conjunto de pruebas anotado, ejecute ambas herramientas con él y puntúe ambas con reglas idénticas. Si la Herramienta A admite una función que la Herramienta B no (como la normalización automática de fechas), aplique la regla de normalización que definió antes de probar — no le dé crédito a la Herramienta A por una función relajando el estándar de puntuación. El objetivo es una comparación de la precisión de extracción en condiciones iguales, no una comparación de funciones de posprocesamiento.
¿Qué pasa si la herramienta tiene una función de puntuación de confianza?
Las puntuaciones de confianza — donde la herramienta marca extracciones de baja confianza para revisión humana — pueden reducir significativamente la carga de corrección manual si las puntuaciones son fiables. Una herramienta que logra una precisión de campo del 95% pero marca correctamente el 80% de sus errores con puntuaciones de confianza bajas convierte efectivamente una tasa de error del 5% en una tasa de error no detectado del 1% (el 20% de errores que no marcó). Pruebe las puntuaciones de confianza como parte de su evaluación: para los campos que la herramienta marcó como de baja confianza, ¿cuál fue la tasa de error real? Para los campos que marcó como de alta confianza, ¿alguno estaba equivocado? Un sistema de puntuación de confianza mal calibrado — que marque extracciones correctas como de baja confianza (falsos positivos que desperdician tiempo de revisión) o que pase por alto errores reales (falsos negativos que dejan pasar datos incorrectos) — es peor que no tener ningún sistema de confianza porque crea una falsa sensación de seguridad.
El mejor número de precisión es el que usted mismo midió — en sus documentos, con sus definiciones de campos, evaluado según su tolerancia al error. Cada herramienta en este mercado puede encontrar una manera de afirmar un 99% de algo. La pregunta no es lo que afirman. Es lo que usted puede verificar, en los documentos que realmente llegan a su bandeja de entrada, para los campos que su equipo realmente necesita.
Si está evaluando herramientas de extracción y desea poner este protocolo en práctica, ImageToTable.ai funciona con un LLM visual que extrae por semántica de campos en lugar de coordenadas de plantilla — lo que significa que usted define los campos que desea una sola vez y la misma extracción funciona con cualquier diseño de proveedor. La comparación entre AI y OCR tradicional cubre la diferencia arquitectónica que hace esto posible, la guía de conceptos de extracción de documentos explica cómo la extracción semántica a nivel de campo difiere del OCR a nivel de caracteres en la práctica, y la extracción de columnas personalizadas muestra cómo definir qué campos probar en primer lugar. Ejecute el protocolo de prueba, puntúe cada tipo de campo por separado y compruebe si los números coinciden con las afirmaciones.
Sube tus propios documentos y prueba la extracción a nivel de campo tú mismo — sin configuración, sin plantillas, sin datos de entrenamiento requeridos.
Prueba ImageToTable.ai Gratis