AIデータ入力とは?
OCRテキストではなく構造化データ
請求書を1枚用意して、OCRにかけてみましょう。得られるのはこれです:請求書番号 INV-2024-0891 日付:2024年3月15日 合計:$4,230.50 取引先:Acme Corp。テキストの壁です。このデータをスプレッドシートに入れるには、各フィールドを選択してコピーし、正しいセルに貼り付ける作業がまだ必要です。OCRはデータ入力の手間を省いてくれません。紙の上のテキストを画面に移しただけです。次に、同じ請求書をAIデータ入力にかけてみましょう。請求書番号、日付、合計、取引先という4つの列が得られ、それぞれに正しい値が入っていて、すぐに使えます。同じ文書でも、結果はまったく異なります。これはOCRからの小幅なアップグレードではありません。別のカテゴリのツールであり、その理由を理解することがこの記事の目的です。
重要なポイント
- OCRはテキストをデジタル化しますが、実際のデータ入力作業には一切関与しません。各フィールドは未分類のテキストブロック内に残り、各値を手作業でコピーして正しいスプレッドシートのセルに貼り付ける必要があります。
- OCRは文字を1つずつ読み取るだけで、その意味をまったく理解しません。そのため、合計行の金額と明細行の同じ数字を区別できず、「自動化」後も手動でのフィールド探しに毎月40時間以上を費やすことになります。
- ImageToTable.aiは、ページ全体を一度に読み取り、「請求書番号」とラベル付けされた値は1つの列に、「合計」と呼ばれる値は別の列に属することを認識することで、このギャップを解消します。テンプレートやトレーニングなしで、あらゆるレイアウトに対応します。
AIデータ入力の実際の意味
AIデータ入力とは、ドキュメントを読み取り、各情報の意味を理解し、スプレッドシートの正しい列に自動的に配置するソフトウェアです。OCRがテキストの画像をデジタル文字に変換するのとは異なり、AIデータ入力は構造化データを生成します。つまり、請求書番号は請求書番号の列に、日付は日付の列に、合計は合計の列に、バッチ内のすべてのドキュメントにわたって行と列として配置されます。
これを可能にする仕組みがカスタム列抽出です。抽出ルールをプログラミングしたり、テンプレート上のフィールドにボックスを描いたりする代わりに、必要な列名(「請求書番号」「支払期日」「取引先名」「行合計」など)を入力するだけで、AIが固定位置の一致ではなく意味的に理解して、ページ上のどこからでも各値を特定します。入力した列名が最終的なスプレッドシートのヘッダーになります。これが根本的な変化です。入力ではなく出力を記述するのです。
この違いは、ツールを使える人を変えるため重要です。テンプレートベースの抽出では、入ってくるすべてのドキュメントレイアウトに対してテンプレートを構築・維持する担当者が必要です。カスタム列抽出は、1社からの50枚の請求書を処理する場合も、完全に異なるレイアウトの50社からの50枚の請求書を処理する場合も、同じように機能します。
核心的な洞察:OCRは文字をデジタル化します。AIデータ入力は情報を構造化します。前者はまだ手作業が必要なテキストを生成し、後者はすぐに使えるスプレッドシートを生成します。
OCRだけではデータ入力にならなかった理由
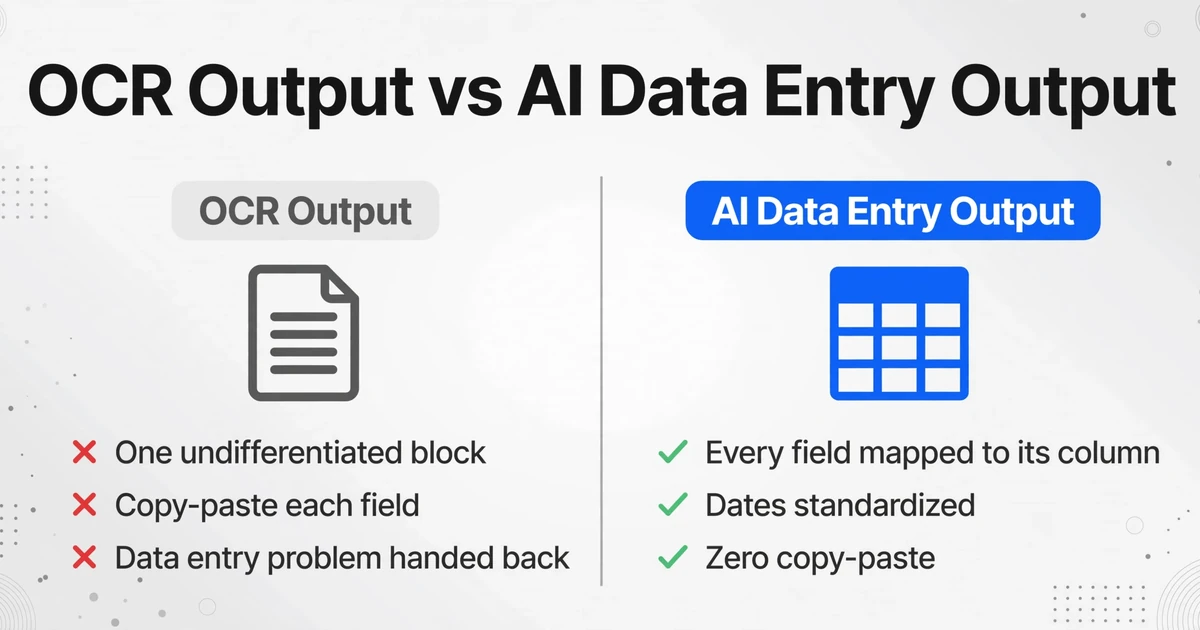
AIデータ入力が何を変えるのかを理解するには、OCRが常に残してきたギャップを見ることが役立ちます。以下は、実際の請求書を両方の方法で処理した例です。
OCR出力 — 従来のOCRツールを標準的なベンダー請求書に向けた場合に得られるもの:
INVOICE
Acme Industrial Supply
451 Commerce Drive, Suite 200
Chicago, IL 60607
Invoice #INV-2024-0891
Date: March 15, 2024
Due Date: April 14, 2024
PO Number: PO-77231
Item | Qty | Unit Price | Total
Hex Bolt M10 | 200 | $2.40 | $480.00
Steel Washer M10 | 500 | $0.15 | $75.00
Threaded Rod 1m | 50 | $12.80 | $640.00
Subtotal: $1,195.00
Tax (8.75%): $104.56
Shipping: $45.00
Total: $1,344.56
すべてがそこにあります。文字は正しいです。しかし、それは1つの未分化なブロックです。「請求書番号」をスプレッドシートに入れるには、「Invoice #」で始まる行を見つけ、識別子を選択し、コピーし、スプレッドシートに切り替えて貼り付けます。次に日付、次にPO番号、次に各明細項目。OCRはテキストを提供しましたが、データ入力の問題をそのまま返してきたのです。
AIデータ入力出力 — 同じ請求書でAI搭載の抽出を使用した場合に得られるもの:
| 請求書番号 | 日付 | 支払期限 | 注文番号 | 仕入先名 | 小計 | 税 | 送料 | 合計 |
|---|---|---|---|---|---|---|---|---|
| INV-2024-0891 | 2024-03-15 | 2024-04-14 | PO-77231 | Acme Industrial Supply | $1,195.00 | $104.56 | $45.00 | $1,344.56 |
すべてのフィールドが正しい列にマッピングされます。明細項目はそれぞれの行に抽出されます。日付は統一された形式に標準化されます。コピー&ペーストはゼロ。手動でのフィールド探しもゼロ。その違いは速度の問題ではありません(AIの方が大幅に速いですが)— 出力がすでに構造化されているかどうかです。OCR出力は、役立つようになるまでに第二のステップ(手動データ入力)が必要です。AIデータ入力の出力はすぐに利用できます。
EYの2025年の調査によると、単一の手動HRデータ入力タスクは現在、組織に平均$4.86のコストがかかります — 2018年の$4.39から上昇し、毎年増加傾向にあります。何千もの文書にわたって、「OCRがテキストをデジタル化した」と「AIがデータを構造化した」の差は、実際の運用コストとして累積します。
AIが文書を読む仕組み:ビジョンと言語の融合
OCRは文字単位で動作します。暗いピクセルと明るいピクセルのパターンを調べ、既知の形状のライブラリと照合して、最も近い文字を出力します。これが、OCRが「m」と読むべきところを「rn」と出力することがある理由です — 文字レベルで判断しており、単語や文書構造を認識していません。結合セルを含むテーブルに遭遇すると、OCRは行ごとに読み取り、列の関係を完全に失います。
AIデータ入力はビジョン言語モデル(VLM)を使用します — 人間と同じように文書を処理するAIの一種で、ページ全体を一度に見ます。VLMは同時に3つの情報レイヤーを分析します:
視覚的なレイアウト。
各要素はどこに配置されていますか?ヘッダー、テーブル、フッターのどこにありますか?このテキストは太字、インデント、または枠線付きのボックス内にありますか?モデルは文書構造を理解します。ピクセルがどう見えるかだけでなく、ページがどう構成されているかを理解します。
テキスト内容。
テキストは何を言っていますか?モデルは文字、単語、数字を読み取りますが、OCRとは異なり、ページ上の位置と周囲の要素との関係という文脈で読み取ります。
意味的な解釈。
各データは何を表していますか?右上隅の「Invoice #」という単語の隣にある数字は請求書番号です。右下隅の「Total」の隣にある太字の数字は支払い金額です。モデルは視覚的な位置を意味的な役割に結び付けます。「INV-2024-0891」と読むだけでなく、これが請求書識別子であることを理解します。
これら3つのレイヤー(レイアウト、内容、意味)は順番にではなく、まとめて処理されます。AIが請求書の下部にある「Total」行の金額を見たとき、「これはテキストか数字か?」そして「この数字は何を意味するのか?」を別々のステップで判断する必要はありません。全体像を一度に理解します。これは金額であり、文書の末尾に配置され、「Total」とラベル付けされ、おそらく上記のすべての明細項目の合計であると理解します。出力は数字の文字列ではなく、意味的なラベルが付いた値です。
これが、AIが「文脈を理解する」と言うときの意味です。魔法ではありません。何百万もの文書でトレーニングされたモデルが、数字が数字の列の下にあり「Total」という単語の隣にある場合、その数字には明細テーブルの途中にある数字とは異なる特定の意味があることを学習しているのです。
文書からAIがデータを抽出する3つの方法
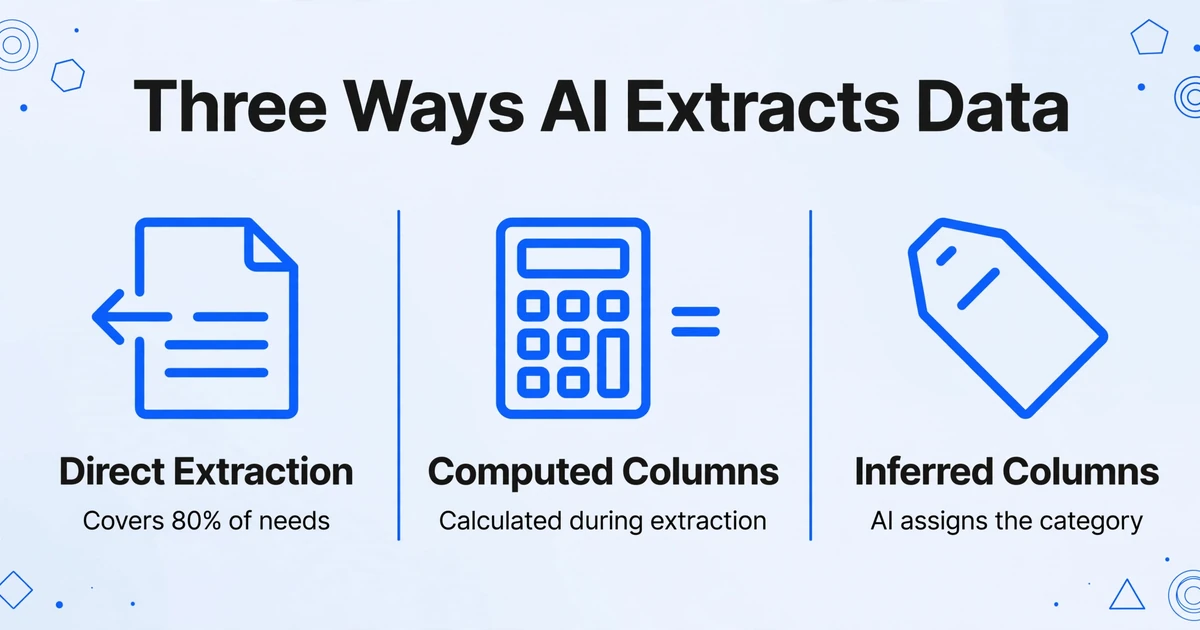
すべての抽出が同じというわけではありません。AIデータ入力は、それぞれ異なる問題を解決する3つの明確なモードで動作します。どのモードがどのフィールドに適用されるかを理解することが、正常に機能する抽出と、不完全な結果を生む抽出を分ける鍵となります。
直接抽出 — データがページに印刷されている場合
これは最も単純なモードです。必要なフィールドが文書に明確に存在します。請求書には日付が印刷されています。領収書には合計金額があります。注文書にはベンダー名があります。AIはその意味的な役割を理解して値を特定し、正しい列に配置します。
直接抽出は、文書処理でほとんどの人が必要とするものの約80%をカバーします。印刷されたテキスト、明確な列を持つテーブル、予測可能な位置にあるフィールドを処理します。レイアウトによって位置が異なる場合でも対応可能です。AIは固定座標を照合しているわけではないため、ある請求書の右上にある日付と、別の請求書の左下にある日付の両方が、「日付」列に正しくマッピングされます。
計算列 — 答えは書かれていないが、材料は揃っている場合
必要な数値が文書のどこにも印刷されていない場合もあります。しかし、それを計算するための構成要素は存在します。ここで計算列が登場します。値を抽出する代わりに、AIは抽出中に計算を実行し、その結果をスプレッドシートに出力します。
例えば、注文書に数量200、単価$2.40と記載されているが、「行合計: $480.00」とはどこにも印刷されていない場合を考えます。計算列を使用すると、行合計 (数量 × 単価)という列を定義します。AIは2つのソース値を抽出し、乗算を実行して、$480.00を出力します。すべて1回のパスで完了します。抽出後のExcelでの数式作業は不要です。
計算列は、行レベルの算術演算、行をまたいだ集計(セクション内のすべての明細項目の合計)、条件付きロジック(計算された合計が印刷された合計と一致しない場合のフラグ付け)、固定パラメータ参照(バッチ内のすべての文書に適用される税率の埋め込み)をサポートします。計算は抽出中に実行されるため、出力はすぐに使用できる答えであり、まだ処理が必要な生データではありません。
推論カラム — AIが不足情報を補完する仕組み
3つ目のモードは、OCRやテンプレートベースのツールでは対応できない問題に取り組みます。それは、必要な情報が文書に一切記載されていない場合です。推論カラムは、AIが文書を読み取り、どのカテゴリ、タグ、ラベルが該当するかを判断し、その結果をスプレッドシートに自動入力します。
典型的な例は経費のカテゴリ分類です。レストランの領収書に「カテゴリ:食事」と記載されることはありません。しかし、税務申告のために経費を分類する必要があります。推論カラムを使えば、カテゴリ(選択肢:食事/交通/オフィス/その他)というカラムを定義するだけです。AIが各領収書(寿司店のランチ領収書、ガソリンスタンドの領収書、ステープルズの領収書)を読み取り、それぞれに正しいカテゴリを割り当てます。出力されるスプレッドシートには、各行にカテゴリがすでに割り当てられています。抽出と分類が1回の処理で完了します。
推論カラムはあらゆる文書タイプで同様に機能します。配送伝票からの緊急注文の識別、国際的な請求書からの通貨タイプの検出、保険証書からの文書サブタイプの特定などです。AIが文書の内容を読み取り、構造化された推論を行います。これは、意味を理解できないOCRには不可能なことです。
日常利用における意味
3つの抽出モードは、単一の運用上の変化に集約されます。それは、ツールに文書の見た目を教える必要がなくなることです。必要な出力を記述するだけでよいのです。
テンプレートベースのOCRワークフローでは、新しいベンダーの請求書形式を追加する際、テンプレートエディタを開き、各フィールドの周囲にゾーンを描画し、サンプルでテストし、次の請求書でゾーンがずれないことを祈る必要があります。これを20社のベンダーで繰り返すと、手動入力にかかる時間よりもテンプレートのメンテナンスに多くの時間を費やすことになります。AIデータ入力では、カラム名を一度入力するだけです。AIが遭遇するあらゆるレイアウトで機能します。AIが文書を理解しているのであって、座標を測定しているわけではないからです。
バッチ処理はこれをさらに進めます。15社の異なるベンダーからの50枚の請求書をアップロードします。カラム名を一度入力します。AIが50枚すべてを処理し、あらゆるレイアウトのバリエーションから各フィールドを特定し、50行(請求書ごとに1行)の単一のスプレッドシートをエクスポートします。各フィールドは正しいカラムに配置されます。かつて午後いっぱいかかっていた手動入力が、アップロードと確認の数分に短縮されます。
ファイルは安全に処理され、保存されません。
AI抽出が従来の文書処理アプローチとどう違うのかをもっと広い視点で知りたい方は、データ抽出ソフトウェアの紹介でカテゴリー全体を概観できます。また、ツールを評価するなら、評価フレームワークで、本番運用に耐える抽出と、サンプル文書1枚で動くデモを分ける基準を確認できます。
AIデータ入力が得意なこと
AIデータ入力は、視覚的なレイアウトの中に構造化情報が存在するあらゆる文書を処理できます。最も一般的な用途は、大量に発生するいくつかの文書タイプに集中しています。
請求書処理。代表的なユースケースです。請求書はベンダーごとにレイアウトがまったく異なりますが、意味的な構造(ベンダー名、請求書番号、日付、明細項目、合計)は共通しています。AIはレイアウトを横断して読み取るため、サプライヤーごとにテンプレートを作成せずに請求書フィールドをExcelに抽出することが実用的になります。Gartnerは、2030年までに世界のB2B請求書の最大80%が自動処理されると予測していますが、これはまさにここで説明したレイアウト非依存の抽出を前提とした予測です。
レシートスキャン。レシートはテンプレートベースのOCRにとって最も難しい文書タイプです。店ごとにフォーマットが異なり、感熱紙で印刷されてかすれているものも多く、斜めに撮影されたスマホ写真で届くこともよくあります。AIデータ入力は、レシートのレイアウトを視覚的に理解し、フォーマットに関係なく店名、日付、合計、明細項目を識別して、レシートを構造化されたスプレッドシートの行に変換します。
銀行明細書の照合。銀行明細書には特有の課題があります。ページをまたいで列にまたがる取引テーブルを持つ複数ページのPDF、時には重なる借方・貸方の列、整合性を保つ必要のある累計残高などです。AIデータ入力は、取引構造を保持したまま銀行明細書をExcelに変換します。各行が取引、各列がフィールドとなるため、紙の明細書と画面を照合するのではなく、スプレッドシート上で照合ができます。
フォーム処理。紙のフォーム(求職申込書、患者受付票、アンケート回答)は、同じ質問が繰り返される一方で、手書き、チェックボックス、記入パターンが大きく異なる状態でバッチで届きます。AIはフォーム構造を読み取り、各フィールドを列に抽出して、フォームデータをデジタル化します。フォームごとの設定は不要です。
手書き文書。最新のAIデータ入力は、読みやすい手書き文字(手書きで記入された印刷フォーム、手書きの署名と数量が含まれる納品書、手書きの時間が記入されたタイムシートなど)を処理できます。手書きの精度は印刷テキストよりも低くなりますが(詳細は制限事項のセクションで説明)、手書き内容が既知のフィールドに限定されている構造化フォームでは、多くのユースケースで実用レベルの結果が得られます。詳細はデータ抽出のための手書き文字認識ガイドをご覧ください。
AIデータ入力がまだ苦手とする分野
AIデータ入力はまだ完全には解決されていません。文書の種類や条件によっては、完全自動化に許容できる精度を下回る場合があります。これらの限界を明確にすることは重要です。うまく機能するワークフローを構築するか、新たなクリーンアップ問題を生み出すかの違いになります。
極端に品質の悪いスキャン。著しく色あせた文書、暗い場所での手ブレ撮影、または非常に低解像度(150 DPI未満)でスキャンされた文書は、抽出精度を低下させます。AIは中程度の品質問題(軽度のブレ、傾き、照明の不均一さ)には対応できますが、文字が人間の読者にとっても本当に曖昧になる場合、AIも苦労します。信頼度スコアリング(AIが低確信度のフィールドを人間のレビュー用にフラグ付けする機能)はこれを軽減しますが、完全には排除できません。
重なり合う手書きテキスト。手書きが明確で分離されている場合、最新のAIはうまく処理します。文字が重なる場合(2行の間に押し込まれた急いで書かれた修正、取り消し線の上に新しいテキストが書かれたもの)、精度は急激に低下します。モデルは1つの文字が終わり、別の文字が始まる場所を判断する必要があり、ある程度の重なりレベルでは、その判断は人間にとっても推測になります。
データが純粋に視覚的または図形的な文書。文書が図、データテーブルのないチャート、テキストラベルのない色分けされた地図のみで情報を伝える場合、AIデータ入力が抽出できるものはありません。AIはテキストとレイアウトを読み取りますが、棒グラフの高さを数値に解釈したり、色の凡例をカテゴリにデコードしたりはしません。テキストとビジュアルが混在する文書(データテーブルとチャートの両方を持つレポート)の場合、テーブルは抽出可能ですが、チャートは一般的に抽出できません。
極端な筆記体と非標準的な手書き。構造化されたフォームにきれいな手書きは管理可能です。高度に様式化された文字形状を持つ速い筆記体(一部の医療処方箋や古い手書きの台帳に見られる種類)は、依然として課題が残ります。モデルの改善によりギャップは縮まっていますが、2026年半ば時点で、高度に様式化された筆記体は依然として信頼性の低い結果を生み出し、人間による検証が必要です。
複雑なスパンロジックを持つ複数ページのテーブル。テーブルが3ページにまたがり、結合セル、分割行、前のページの値を参照する小計がある場合、AIでも見失うことがあります。最新のVLMは単純な複数ページの連続性をうまく処理しますが、複雑なスパンロジック(1つの明細項目の説明が2ページにまたがり、その数量が3ページ目にある場合)では、依然として有意な割合でエラーが発生します。
正直なまとめ:AIデータ入力は、クリーンで読みやすく、構造的に明確な文書の80%を高い精度(印刷されたテーブルデータで最大99%)で処理します。次の15%(中程度の品質問題、薄い手書き、単純な複数ページのテーブル)は、まだ使用可能ですがスポットチェックが必要な精度で処理します。最後の5%(重なり合う手書き、深刻に劣化したスキャン、純粋に図形的な文書)は、依然として人間の注意が必要です。当社の抽出ツール間の精度比較では、特定の文書タイプの詳細なベンチマークを提供しています。
よくある質問
AIデータ入力はOCRと同じですか?
いいえ。OCRはテキストの画像をデジタルテキスト文字に変換するもので、文字を読み取ります。AIデータ入力は、それらの文字が文脈上で何を意味するかを理解し、構造化された列に配置します。OCRはテキストファイルを提供します。AIデータ入力はスプレッドシートを提供します。OCRはAIデータ入力システムが使用する可能性のある1つのコンポーネントですが、それ単独では構造化や理解を行いません。
AIを自分の文書でトレーニングする必要がありますか?
いいえ。ビジョン言語モデルを使用する最新のAIデータ入力ツールは、これまで見たことのない文書でもそのまま動作します。トレーニングサンプルをアップロードしたり、フィールドにラベルを付けたり、テンプレートを設定したりする必要はありません。列名を入力し、文書をアップロードするだけで、AIは文書を視覚的かつ意味的に理解してデータを抽出します。以前の例から学習したパターンに一致させるのではありません。比較として、従来の機械学習アプローチではフォーマットごとに数百のラベル付き文書が必要でしたが、新しいVLMベースのツールではゼロで済みます。
AIデータ入力はどの文書形式に対応していますか?
PDF(ネイティブおよびスキャン)、JPEG、PNG、WebP、AVIF、およびWebページのスクリーンショットに対応しています。AIはアップロードされた画像や文書を処理します。ソースがクリーンなデジタルファイルである必要はありません。スマートフォンで撮影したレシートの写真も、会計ソフトウェアで生成されたPDFと同じように機能します。ツール間の形式サポートの詳細な比較については、評価フレームワークをご覧ください。
AIデータ入力の精度は手動入力と比べてどうですか?
印刷された表データの場合、AI抽出は最大99%の精度を達成します。手動データ入力の精度は通常96〜98%で、疲労、量のプレッシャー、不慣れな文書形式によって低下します。月1,000文書の場合、その差はおよそ10〜40エラー(手動)対10未満(AI)です。手動で3分かかる1ページが、AIでは5〜10秒で処理されます。これは18倍以上の効率向上です。ただし、精度は文書の品質に大きく依存します。印刷された請求書のクリーンで明るいスキャンはほぼ完璧な精度を達成しますが、手書きのレシートの色あせた低解像度の写真では精度が低くなります。
AIデータ入力は手書き文字を読めますか?
はい、ただし条件付きです。構造化されたフォーム(手書きで記入された印刷フォーム)上の読みやすい手書き文字は、最新のAIでうまく処理されます。フォームの構造がコンテキストを提供し、モデルが手書きコンテンツを解釈するのに役立ちます。自由形式の手書きメモ、速い筆記体、重なり合う手書き文字では、結果の信頼性が低くなります。手書き文書が多いユースケースの場合は、そのまま処理するのではなく、結果を検証することを想定してください。詳細については、手書き認識ガイドをご覧ください。
AIデータ入力のコストは従来のOCRと比べてどのくらいですか?
AIデータ入力ツールは通常、サブスクリプション制で、ページ単位またはドキュメント単位の料金プランがあります。従来のOCRツールは基本レベルでは安価なことが多いですが、テンプレート設定、メンテナンス、そして出力された生テキストを構造化する手作業に追加の投資が必要です。コストの差はソフトウェア価格だけの問題ではありません。抽出後のデータ処理にかかる時間を含む総運用コストの問題です。当社の無料OCRとAI抽出のコスト比較および2026年の価格動向の概要で詳しく説明しています。
処理後、私のドキュメントはどうなりますか?
これはプロバイダーによって異なります。信頼できるツールはドキュメントを処理し、データを抽出した後、元のファイルを破棄します。ドキュメントを保存したり、トレーニングに使用したりすることはありません。機密ドキュメントをアップロードする前に、必ずプロバイダーのデータ取り扱いポリシーを確認してください。ファイル削除、ユーザーデータのトレーニング不使用、転送中および保存中の暗号化に関する明示的なコミットメントを探してください。
AIデータ入力は、ドキュメント処理の可能性を変えます。同じことを速く行うのではなく、まったく異なることを行うのです。問題はOCRより優れているかどうかではありません。毎日処理するドキュメントがAIで処理できるほど構造化されているか、そして節約できる時間がツールのコストよりも価値があるかどうかです。それを知る唯一の方法は、自分のドキュメントで試してみることです。