ノーコードAIデータ入力:
モデル学習なしで文書データを抽出
AIによる文書抽出と聞いて、多くの人が同じことを想像します。つまり、インターフェースの裏側で誰かが何千枚ものラベル付き請求書をモデルに学習させ、デプロイに数週間かかり、機械学習エンジニアのセットアップが必要だった、と。その認識は約2年前まで正しかったのです。しかし、この分野は今、二つの道に分かれています。ひとつは今もなお、アノテーション済みの学習データ、モデルの学習サイクル、技術チームを必要とする道。もうひとつは、必要な列名を入力して文書をアップロードするだけで済む道です。この記事で扱うのは後者です。何がそれを可能にしたのか、日常的にどう機能するのか、そしてどこで限界が来るのかを解説します。
重要ポイント
- AI文書抽出には開発者と500件のラベル付き学習サンプルが必要だという思い込みは、2023年までは正しかった。しかし技術は進化しており、その思い込みはまだ追いついていません。
- AIはあなたの文書から学習するのではありません。事前学習の段階で数百万の文書を見ているため、請求書番号がどのようなものかをすでに知っています。つまり、位置ではなく意味に基づいて抽出するのです。
- ImageToTable.aiは、数週間のモデル学習を「スプレッドシートにどの列が欲しいか」というひとつの質問に置き換え、開始したその日に構造化データを届けます。
従来の方法:文書抽出に開発者とトレーニングデータが必要だった理由
「ゼロトレーニング」の意味を理解するには、トレーニングに以前どれだけのコストがかかっていたかを理解することが役立ちます。視覚言語モデルが登場する前、文書抽出は2層構造で動作していました。画像をテキストに変換するOCRと、テキストをフィールドにマッピングする機械学習分類器です。OCR層が文字認識を担当し、ML層がそれ以外のすべてを担当していました。そして、それが高コストな部分でした。
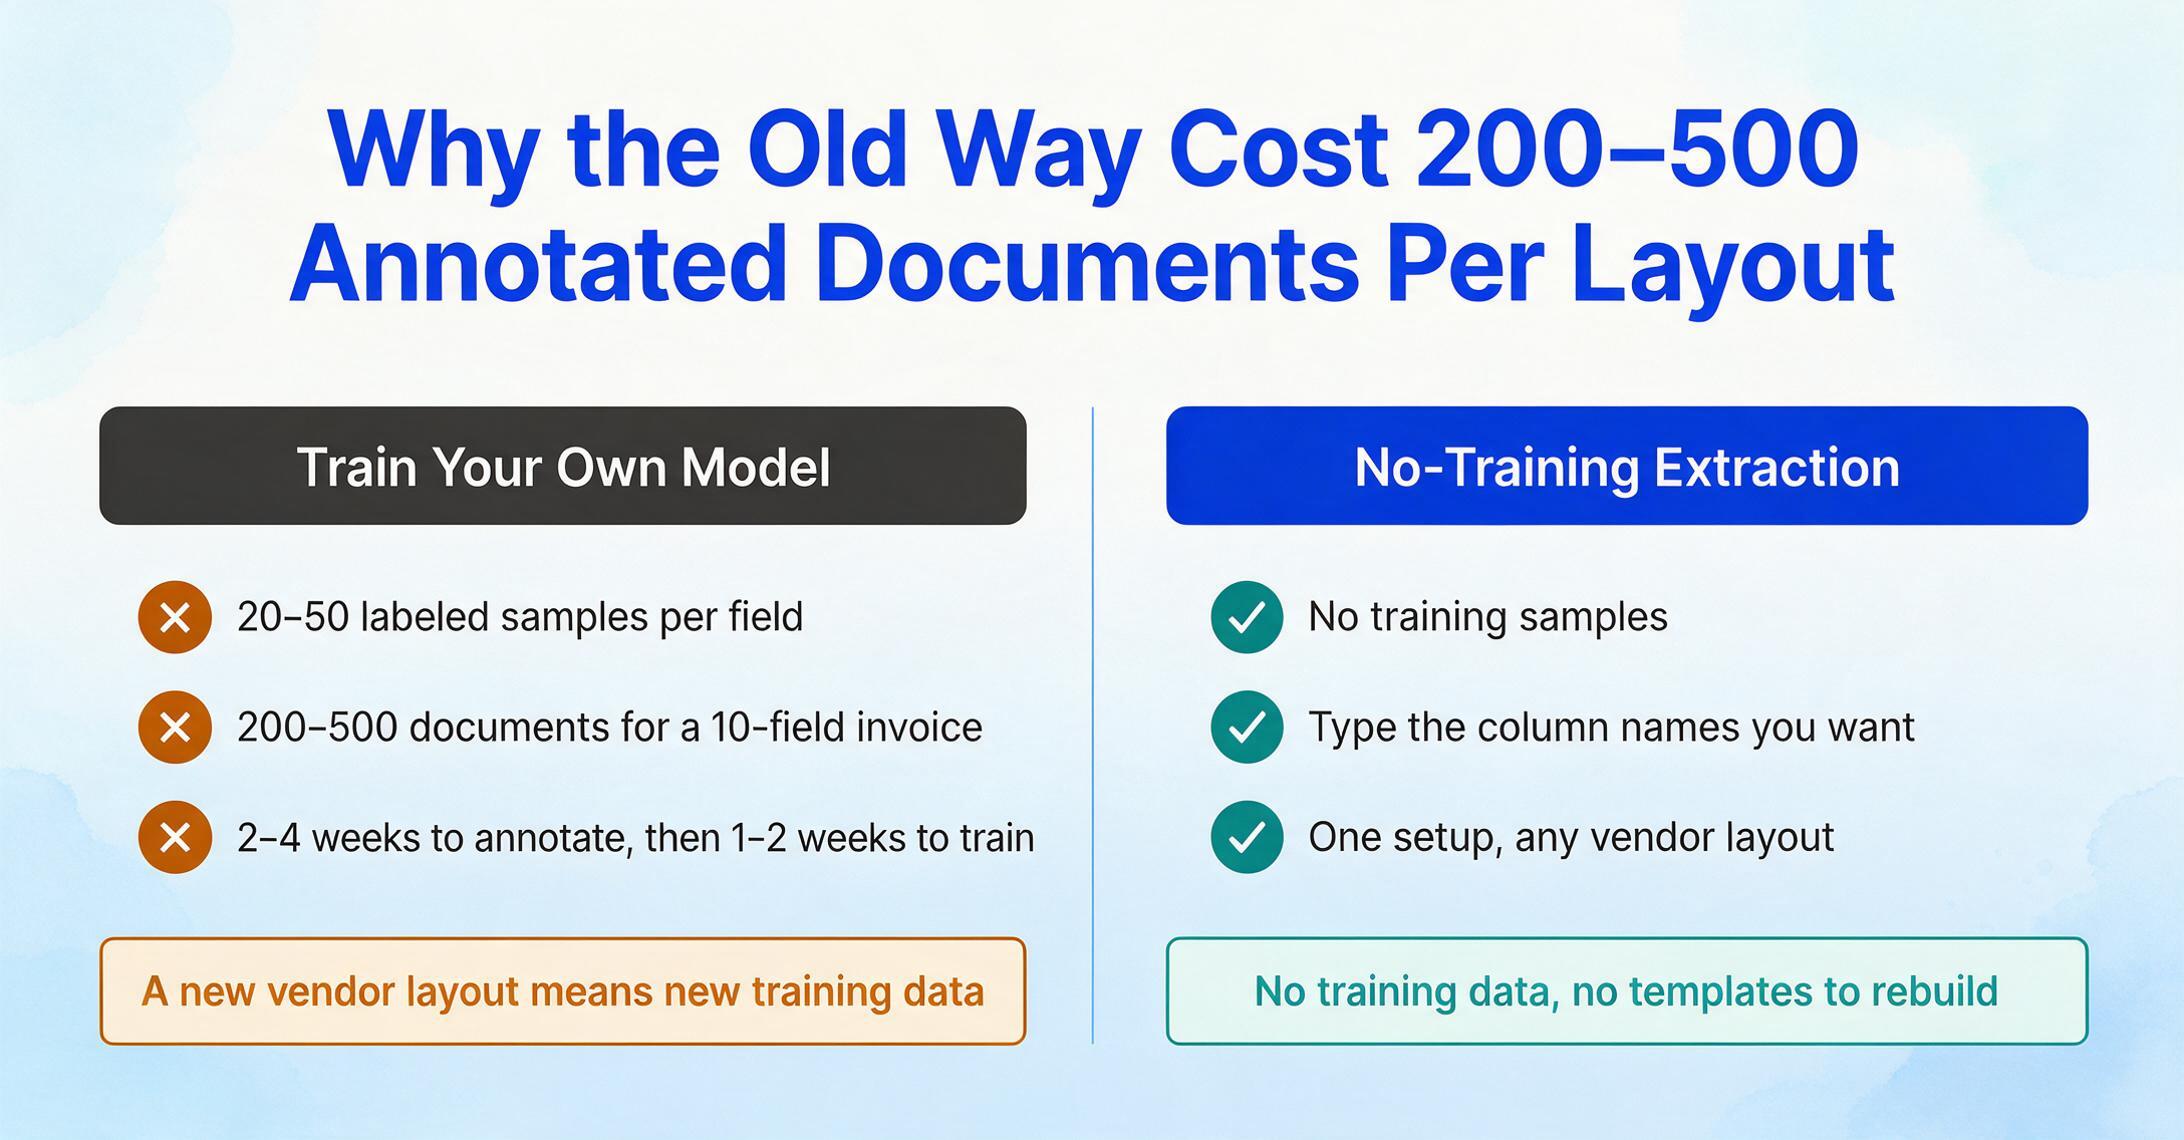
文書抽出用の従来のMLモデルをトレーニングするには、ラベル付きサンプルをモデルに与える必要がありました。つまり、人間が手動でどのテキストが請求書番号で、どれが日付で、どれが合計金額かをマークした何百もの文書です。UiPathの公式ドキュメントでは、通常フィールドごとに20〜50個のラベル付きサンプルを指定しています。つまり、10フィールドの請求書テンプレートでは、モデルが本番レベルの精度に達するまでに200〜500件の注釈付き文書が必要になります。明細行テーブルなどの列フィールドの場合、要件は列ごとに50〜200文書に跳ね上がります。しかも、それは1つの文書レイアウトに対するものです。異なる請求書形式の新しいベンダーが現れれば、新しいトレーニングデータが必要になるか、最適化されていないレイアウトにまたがって引き伸ばされたモデルの精度低下を受け入れることになります。
タイムライン:トレーニングサンプルの収集と注釈付けに2〜4週間、モデルのトレーニングと評価にさらに1〜2週間、そして新しい文書レイアウトが発生するたびに再トレーニングを引き起こす継続的なメンテナンスサイクル。必要なチーム:文書ドメインを理解しているデータ注釈者、トレーニングパイプラインを構成する機械学習エンジニア、そして結果のモデルを本番システムに統合する開発者。最初の実用的な抽出までの総時間:通常3〜6週間。総コスト:ソフトウェアのサブスクリプションではなく、エンジニアの給与で測定されます。
これが、2023年以前に評価した人にとって「AI文書抽出」が意味していた世界です。そして、「これには開発者が必要だ」という前提が今も続いている理由です。その前提は時代遅れですが、根拠がないわけではありません。
転換点:AIがトレーニング不要で書類を読み取る仕組み
書類からのデータ抽出の経済性を変えた技術は、視覚言語モデル(VLM)です。これは、人間と同じように書類を処理するAIの一種で、ページ全体を見て各情報の意味を理解します。ラベル付きサンプルからパターンを学習するのではありません。
VLMはあなたの請求書から学習するわけではありません。VLMは、請求書、領収書、銀行取引明細書、契約書、フォーム、レポートなど、さまざまなレイアウト、言語、品質レベルの何百万もの書類で事前トレーニングされています。この事前トレーニングを通じて、モデルは視覚パターンと意味的な役割を関連付けることを学習しました。例えば、書類の右下隅にある「合計」という単語の横の太字の数字は支払額です。ページ上部近くに「請求日:MM/DD/YYYY」の形式で記載された日付は請求日です。「数量」というラベルの列の横に「単価」があれば、それは数量を意味し、その後の数字に単価を掛けたものが明細行の合計です。モデルは、特定の請求書で何を探すべきかを指示されたのではなく、何百万もの書類にわたってこれらの関連性を何百万回も見ることで学習しました。
これが「ゼロトレーニング」の実際の意味です。モデルはすでに請求書、領収書、銀行取引明細書、注文書、契約書、その他数十種類の書類を理解しています。それはあなたがトレーニングしたからではなく、視覚的な書類理解において大規模な事前トレーニングを受けているからです。最初の請求書をアップロードするとき、モデルは学習しているのではありません。すでに知っていることを、見たことのない書類に適用しているのです。同じメカニズムは、スマートフォンのカメラで撮影したくしゃくしゃの領収書の写真、15年前の複合機からスキャンしたPDF、SAPで生成されたデジタル請求書でも機能します。視覚的な品質は異なりますが、根底にある意味構造は同じです。
核心的な違い:従来のMLはパターンマッチングで抽出します。「このベンダーの請求書では、請求書番号は常に座標(x,y)にある」と学習し、レイアウトが変わると機能しなくなります。VLMは意味理解によって抽出します。ページ上のどこに表示されていても、文脈の中で請求書番号がどのようなものかを理解しているため、請求書番号を特定できます。
この違いが、ノーコードツールが初日からセットアップ不要で機能する理由を説明しています。レイアウトごとのトレーニングが必要な場合、ツールが有用な結果を出す前に、開発者がトレーニングパイプラインを構築し、ドメインの専門家がサンプルに注釈を付ける必要があります。VLMは意味的に抽出を処理するため、必要な入力は抽出したいものだけです。そしてそれは、あなたがすでに知っていることです。
FirstsourceのVLMベースの書類処理に関する調査では、従来のOCRパイプラインは、OCR→レイアウト分析→フィールドマッピングの各段階で障害が連鎖するため、情報抽出において15~20%のエラー率を生み出すことがわかりました。VLMは、視覚的レイアウト、テキストコンテンツ、意味的意味を単一の統合ステップとして処理することで、このギャップを埋めます。連鎖的な障害も、劣化する中間出力も、ベンダーが請求書のヘッダーを再設計したときに維持するテンプレートもありません。
技術アーキテクチャの違いについてさらに詳しく知りたい方は、AIデータ入力の紹介で、VLMがOCRとメカニズムレベルでどのように異なるかを説明しています。
列名から構造化データへ:ノーコード抽出が実際に機能する仕組み
モデルのトレーニングや統合コードの作成が不要なら、実際に何をするのでしょうか?そのワークフローは、単一の設計上の決定を中心に構築されています。つまり、入力(テンプレート、領域、ルール)を設定する代わりに、出力を記述するのです。具体的には次のような流れになります。
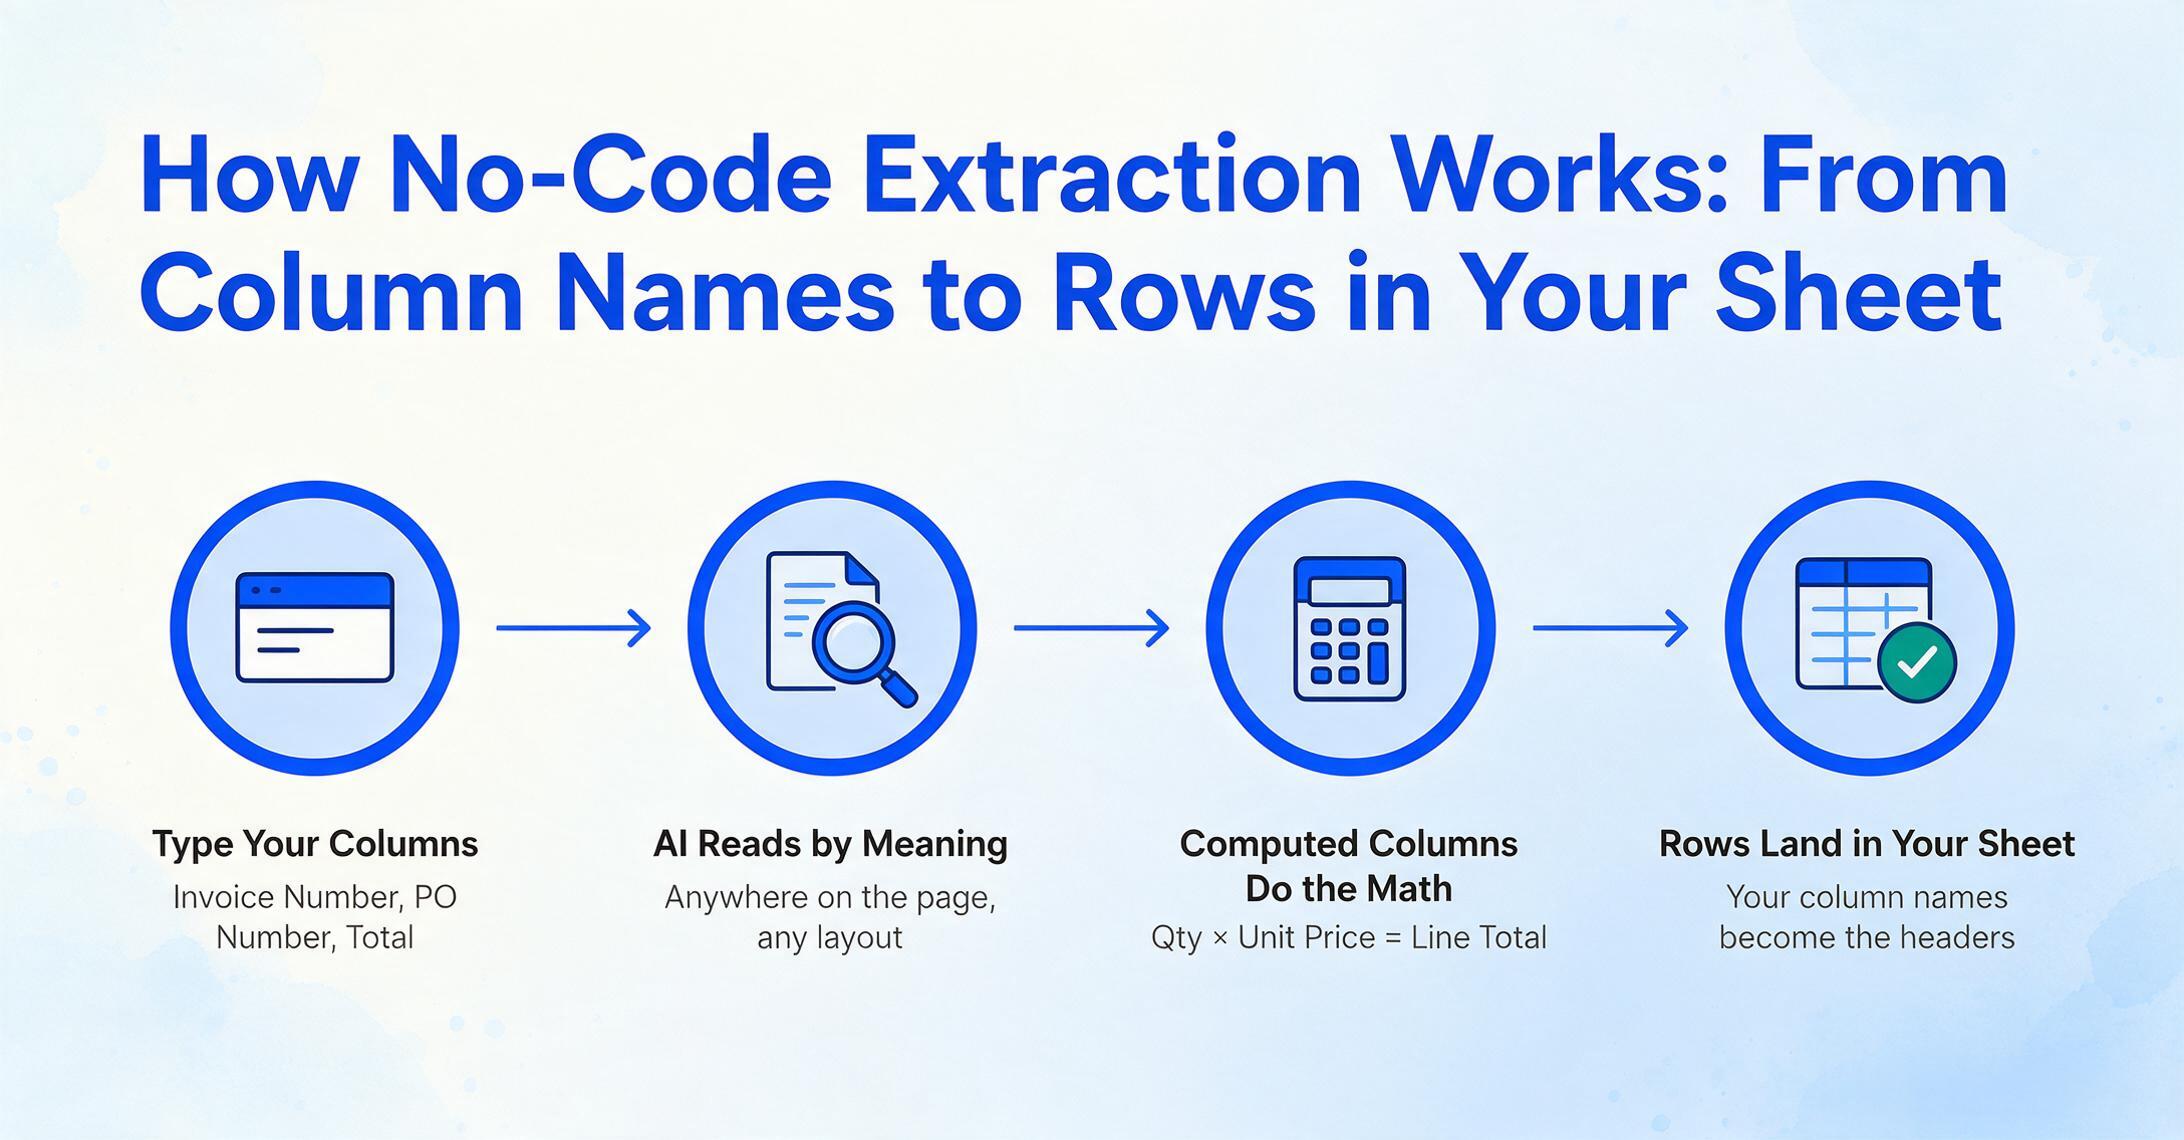
中核となる仕組みはカスタム列抽出です。テキスト入力欄に必要なフィールド名(「請求書番号」「仕入先名」「注文番号」「合計」「支払期日」など)を入力すると、AIが文書上のどこにあっても各値を意味的に理解して特定します。入力した列名は、最終的なスプレッドシートの見出しそのものになります。つまり、取り込みたいデータ構造を記述しているのであって、投入する文書を設定しているわけではありません。
これこそが、ノーコード抽出を機能させる根本的な逆転の発想です。テンプレートベースのツールでは文書にマークアップする必要があります。「ここに請求書番号のボックスを描き、そこに日付のボックスを描く」という具合です。ツールを1つのレイアウトに合わせて設定しているのです。一方、列ベースの抽出では、欲しいものを記述します。「請求書番号、日付、合計をください」というように。AIがマッピングを処理します。どのレイアウト、どのベンダー、どの形式でも対応します。
印刷されたフィールドの直接抽出に加えて、ノーコードAIは、数式やスクリプトに触れることなく作業範囲を広げられる2つの追加モードをサポートしています。
計算列は、抽出中に計算を実行し、後で処理する必要のある生データではなく、結果を出力します。注文書には数量と単価が記載されていますが、行合計は印刷されていません。行合計(数量 × 単価)という列を定義すると、AIが両方のソース値を抽出し、乗算して、結果をスプレッドシートに書き込みます。1回のパスで完了します。抽出後のExcel数式は不要です。同じ仕組みで、セクション内の全項目の合計などの行集計、計算値と印刷値の不一致をフラグする条件ロジック、文書に記載されていない税率を適用する固定パラメータ参照も処理できます。
推論列は、AIが文書に適用されるカテゴリ、タグ、ラベルを判断し、それをスプレッドシートに入力します。レストランの領収書には「カテゴリ:食事」とは記載されていません。しかし、経理処理には経費カテゴリが必要です。カテゴリ(選択肢:食事/交通/オフィス/その他)という列を定義します。AIが各領収書(ランチの領収書、ガソリンスタンドの領収書、オフィス用品の領収書)を読み取り、正しいカテゴリを判断します。抽出と分類がバッチ全体で同時に実行されます。推論列は、納品書からの至急注文のフラグ付け、国際請求書からの通貨の検出、保険証書からの文書サブタイプの識別など、あらゆる文書タイプで同様に機能します。
これら3つのモード(直接抽出、計算、推論)は、単一の運用上の現実に収束します。必要なものを入力し、持っているものをアップロードし、構造化されたスプレッドシートを受け取るだけです。トレーニングデータも、テンプレートエディタも、コードも不要です。
バッチ処理はこれをボリュームに拡張します。15社の異なるサプライヤーから50枚の請求書をアップロードします。列名を一度入力します。AIが50枚すべてを処理し、各レイアウトのバリエーションにわたって各フィールドを識別し、1枚のスプレッドシートに50行(文書ごとに1行)をエクスポートします。すべてのフィールドが正しい列に配置されます。手作業で午後を費やしていた作業が、アップロードと確認の数分に短縮されます。
ファイルは安全に処理され、保存されることはありません。
Google スプレッドシートアドオン:スプレッドシート内で完結するノーコード抽出
ウェブベースのワークフローが「開発者が必要」から「ブラウザがあればいい」へとハードルを下げるなら、Google スプレッドシートアドオンはさらにその先へと下げます。「すでに使っているツールから離れる必要がない」というレベルへです。
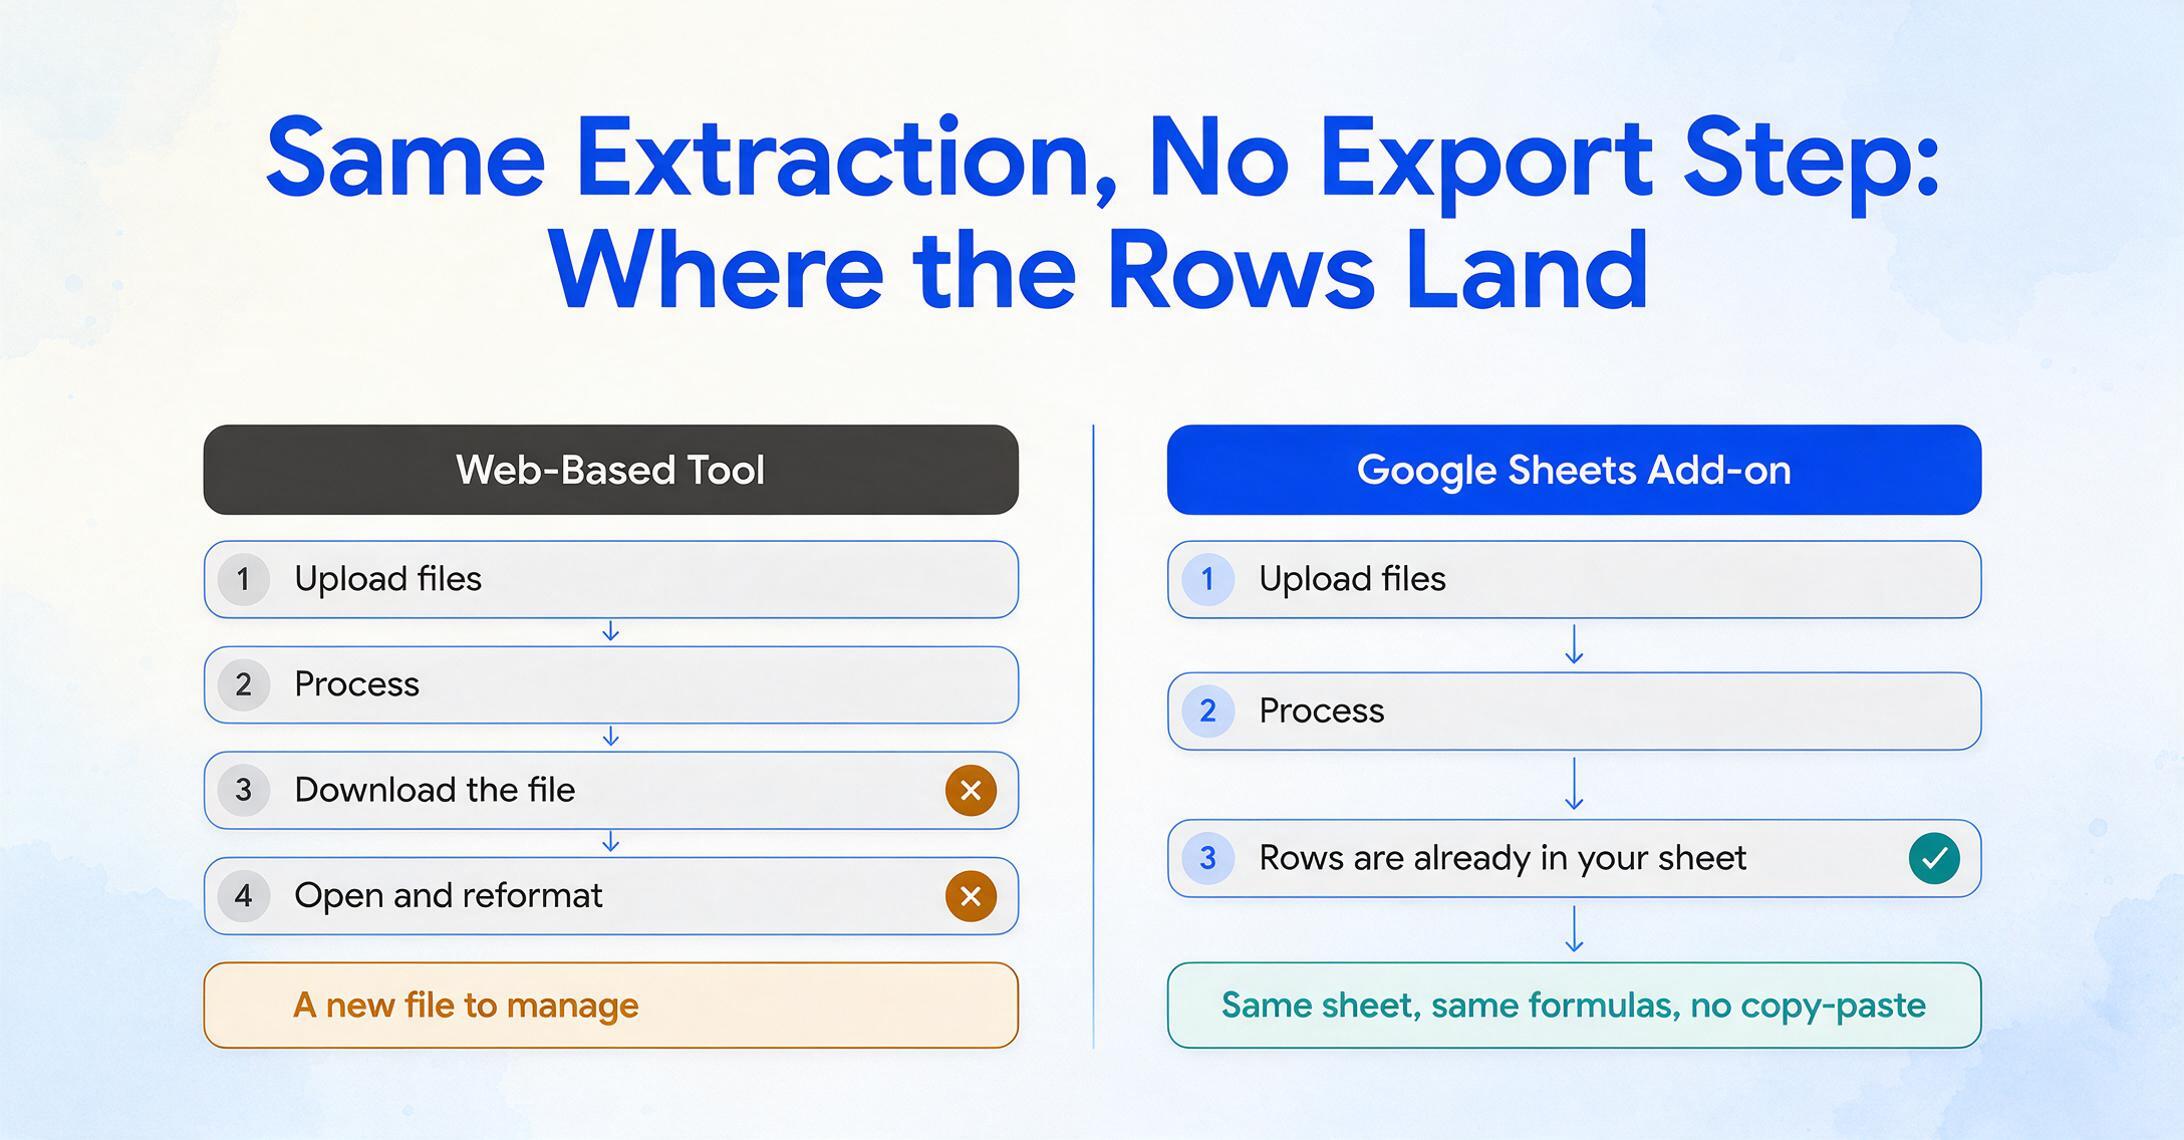
ImageToTable.aiのGoogle スプレッドシートアドオンは、スプレッドシート内に常駐するサイドバーです。開いて、画像やPDFをアップロードし、列名を入力すると、抽出されたデータがアクティブなシートに直接追加されます。構造化された行、正しい列、コピー&ペーストは不要です。ワークフロー全体がスプレッドシート内で完結します:請求書データの抽出、レシート詳細の抽出、または銀行明細書の取引の抽出を、ツールを切り替えたり、ファイルをダウンロードしたり、出力を再フォーマットしたりすることなく、作業中のスプレッドシートに直接行えます。
これは、ノーコードワークフローにおける最後の摩擦点である「エクスポート」のステップを排除するため重要です。Webベースのツールでは、アップロード → 処理 → ダウンロード → ファイルを開く、という流れになります。Sheetsアドオンなら、アップロード → 処理 → データはすでにスプレッドシート内にあります — 使用中のシートに、既存の数式、グラフ、参照と並んで表示されます。チームで仕入先請求書を共有のAPスプレッドシートに処理する場合、抽出ステップで新しいファイルを管理する必要がなく、全員がすでに開いているファイルに行が追加されるだけです。
このアドオンはアカウントモードで動作します。APIキーを一度バインドすれば、Webダッシュボードと同期します — 同じ履歴、同じ保存済み列テンプレート、同じ使用状況トラッキング。別途設定は不要、新しいログインも不要です。抽出エンジンはWeb版と同一で、インターフェースのみが異なります。
このアドオンは、Webツール単独では実現できないワークフローも可能にします:コレクションリンク。共有可能なリンクを生成して、クライアント、仕入先、チームメンバーに送信します。相手はリンクを開き、短い確認コードを入力して、直接ドキュメントをアップロードするだけ — 登録もログインも、新しいツールの学習も不要です。ファイルは自動的に処理キューに追加されます。Sheetsアドオンと組み合わせることで、完全なノーコードパイプラインが実現します:誰かがドキュメントをアップロードし、あなたはスプレッドシートを開くだけで、抽出されたデータが処理キューに待機しており、ワンクリックでシートに追加できます。このワークフローの詳細は、チームが従業員の経費精算レシートを共有のGoogle スプレッドシートに収集する方法をご覧ください。従業員ごとの設定は一切不要です。
最も恩恵を受ける人 — そして追加の検討が必要な人
ノーコードAI抽出は、すべての人に平等に役立つわけではありません。特定のプロファイル向けに最適化されており、自分がそのプロファイルに当てはまるかどうかを知ることが、機能リストよりも有用です。
オペレーション部門と経理チームは自然な適合先です。毎日ドキュメントを処理し、各ドキュメントタイプから必要なデータを正確に把握しており、すでにスプレッドシートで作業しています。手動入力からノーコード抽出への移行は数分で完了します — インターフェースが、すでに頭の中で行っていること(「この請求書の山から請求書番号、日付、合計金額が必要」)を尋ね、物理的な部分(各値の検索、正しいセルへの入力)を自動化するからです。経理ワークフローへの影響は即時的です。なぜなら、ボトルネックである手動フィールド転記をツールが置き換えるからです。
自社の簿記を担当する小規模事業主は、ノーコード抽出から大きな恩恵を受けます。専任のAP担当者を雇うほどの量はなく、カスタム自動化のための開発者を雇う予算もありません。月に20〜50件の請求書を手動で処理するのは遅く、エラーが発生しやすいものです。ノーコードAIで処理すれば10分未満です。コスト計算はエンタープライズとは異なります — チームの置き換えではなく、毎月手動データ入力に費やしていた午後を取り戻すことです。
ドキュメント収集プロセスを運営するすべての人 — クライアントからの署名済みフォーム収集、従業員からの経費レシート収集、現場スタッフからの検査レポート受領など — は、コレクションリンクとノーコード抽出の組み合わせから恩恵を受けます。収集側では、参加者が何かをインストールしたりアカウントを作成したりする必要がなくなります。抽出側では、収集者が各提出物を手動で転記する必要がなくなります。これらを組み合わせることで、「ドキュメント収集 → データ入力 → ファイル化」が「リンク共有 → スプレッドシート確認 → 完了」に変わります。
APIを必要とするチームは、アーキテクチャの分岐点の反対側にいます。抽出したデータが、人のレビューなしでデータベース、ERP、または別のアプリケーションに自動的に流れ込む必要がある場合、APIファーストのアプローチが適しています。判断基準は明確です。データが人間がレビューするスプレッドシートに格納されるなら、ノーコードで対応できます。データがプログラムによって下流のビジネスロジックをトリガーするなら、APIが必要です。当社のAPIとノーコードのアーキテクチャ比較では、チームに適した経路を決定する4つの質問について説明しています。
高度に専門化された文書を扱う組織 — 独自の社内フォーム、独自のレイアウト規則を持つ業界固有の規制文書、トレーニングデータが限られているニッチな言語の文書 — は、ゼロトレーニングの精度が必要なレベルに達しない場合があります。これはアプローチの失敗ではなく、事前トレーニングの適用範囲の結果です。VLMは、何百万もの例を見た文書タイプで最も良いパフォーマンスを発揮します。1つの企業内にのみ存在する文書タイプの場合、そのような露出は存在せず、カスタムトレーニング(またはそれをサポートするツール)が選択肢になります。
ゼロトレーニングAI抽出が(まだ)できないこと
ノーコード抽出の限界を明確にすることは、誠実な評価とセールストークを区別するものです。ここで、その限界をご紹介します。
非常に専門的または独自の文書タイプ。何百万もの請求書、領収書、銀行明細書でトレーニングされたVLMは、それらの文書タイプについて深い意味的理解を持っています。1つの企業によって設計され、他では使用されておらず、特異な方法でフォーマットされた独自の社内フォーム — モデルはそのようなものを見たことがありません。それでも抽出を試み、いくつかのフィールド(日付、金額、名前 — 既知のものに似ているもの)は正しく取得できるかもしれませんが、精度は標準的な文書タイプよりも著しく低くなります。ワークフローが業界全体に相当するもののないカスタム文書形式に依存している場合は、文書ごとにより多くのフィールドを検証する必要があると予想してください。
ページ間の依存関係を持つ複雑な複数ページレイアウト。結合セル、分割行、前のページの値を参照する累計を持つ3ページにまたがるテーブル — これは依然としてVLMにとって困難です。モデルはページを個別に処理し、「この明細項目は2ページ目で始まり、ページ区切りをまたいで3ページ目に続く」という実行中のメモリを維持しません。単純な複数ページの連続性(あるページから次のページへきれいに続く取引テーブル)は適切に処理されます。複雑なスパニングロジック — 単一のデータポイントが非連続ページの値の集計に依存する場合 — は、かなりの割合のケースでエラーを生成し、人間のレビューが必要です。
純粋にグラフィカルな情報。文書がテキストラベルなしでチャート、図、または色分けされたビジュアルのみでデータを伝達する場合、AIが抽出するものはありません。棒グラフの高さは、ラベル付きの軸がなければ数値に変換されません。テキストラベルのない青の色合いに意味を割り当てる色凡例は解析できません。テキストとビジュアルを混在させた文書(データテーブルとチャートの両方を持つレポート)は、テーブル部分のみ機能します。
著しく劣化した入力品質。印刷された請求書のクリーンな300 DPIスキャンは、99%の精度に近づきます。低照度で斜めから撮影された色あせた感熱紙レシートの写真 — 精度は低下します。VLMは中程度の品質の問題(わずかなぼやけ、傾き、不均一な照明)を補正しますが、文字が人間の読者にとっても本当に曖昧になると、AIも苦労します。信頼度スコアリング — ツールが不確実なフィールドを手動レビュー用にフラグ付けする機能 — はこれを軽減しますが、排除はしません。
正直な内訳はこうです。ノーコードAIは、クリーンで読みやすく、構造が明確な文書の80%を高い精度で処理します。次の15% — 中程度の品質の問題、一般的でないレイアウト、軽い手書き — は、実用的ではあるものの完璧ではない精度で処理します。最後の5% — 劣化の激しいスキャン、重なり合う手書き、純粋にグラフィックな文書、業界に同等物のない独自形式 — は、依然として人間の注意が必要です。文書タイプ別の抽出精度に影響する要素の詳細な内訳については、実用的な精度ガイドで重要な変数について説明しています。
よくある質問
ノーコードAI抽出は、トレーニングやセットアップなしで本当に機能しますか?
はい、一般的な文書タイプ — 請求書、領収書、銀行取引明細書、発注書、契約書、および標準的なレイアウトのほとんどのビジネス文書 — については機能します。AIはこれらの文書を数百万件事前学習しており、その意味構造をすぐに理解します。必要な列名を入力し、ファイルをアップロードすれば、AIがデータを見つけ出します。トレーニングサンプルも、テンプレート設定も、抽出したい内容を説明する以外のセットアップも不要です。業界に同等物のない高度に特化した、または独自の文書形式については、精度の低下が予想されます — モデルは事前学習中にその形式の例を十分に見ていないため、その形式に対する強い意味理解を持っていないからです。
これはテンプレートを使用する従来のOCRとどう違うのですか?
テンプレートを使用する従来のOCRでは、入力を設定する必要があります。サンプル文書の各フィールドの周囲にゾーンを描画し、そのゾーンが次の文書のレイアウトと一致することを期待します。ベンダーが請求書の形式を変更すると、テンプレートは壊れて再構築が必要になります。ノーコードAI抽出はその逆の方法で機能します。出力(必要な列)を設定すると、AIはフィールドがどこにあるかではなく、何を意味するかを理解して、フィールドを列にマッピングします。ある請求書の右上隅にある日付も、別の請求書の左下隅にある日付も、両方とも「日付」列に格納されます — AIがそれらを位置ではなく意味的に日付として識別するためです。これはまた、ベンダーごとの請求書形式に個別のテンプレートが不要になることも意味します。1つの列設定がすべてのレイアウトで機能します。
ノーコード抽出とAPIの使用の違いは何ですか?
ノーコード抽出は、視覚的なインターフェース — 文書をアップロードし、列を定義し、結果をダウンロードするWebアプリやGoogle スプレッドシートのアドオン — を通じて行われます。これは、主な仕事が会計、運用、または物流であり、ソフトウェア開発ではない人々向けに設計されています。APIベースの抽出は、文書処理をより大規模な自動化パイプラインに組み込みたい開発者向けに設計されています。文書はプログラムで到着し、抽出はRESTエンドポイントを介して行われ、構造化データは人間の介入なしにデータベースや他のアプリケーションに流れ込みます。同じ基盤となるAIエンジンが両方を支えています。違いはインターフェースと、それが可能にするワークフローです。この2つのどちらかを選択するチーム向けに、APIとノーコードの比較では、ボリューム、チームスキル、データの宛先に基づく意思決定フレームワークを提供しています。
コードなしで複数の文書を一度に処理できますか?
はい。バッチ処理はノーコードワークフローの核となる機能です。10件、50件、200件と、どのような数の文書でもアップロードし、列名を一度定義すれば、AIがすべての文書を処理して、各行が1つの文書、各列が1つの抽出フィールドに対応する単一のスプレッドシートを出力します。バッチ処理ではレイアウトの違いに関係なく文書間で結果が統合されるため、15社の異なるベンダーからの50件の請求書が、すべて同じ出力テーブルの行として、同じ列にフィールドが揃って出力されます。
手書きの文書でも処理できますか?
構造化されたフォーム上の読みやすい手書き文字(手書きで記入された印刷フォーム、手書きの数量が記された納品書など)は、最新のAIで問題なく処理できます。フォームの構造がコンテキストを提供し、モデルが手書きコンテンツを解釈するのに役立ちます。自由形式の手書きメモ、高度に様式化された文字を含む速記筆記体、重なり合う手書き文字は、信頼性の低い結果になります。文書の大部分が手書きの場合は、そのまま処理するのではなく、より多くのフィールドを検証する必要があることを想定してください。
ノーコードAI抽出のコストは、手動データ入力と比べてどのくらいですか?
ノーコードAI抽出ツールは通常、ページ数または文書数に基づく価格帯のサブスクリプション型です。手動データ入力のコストは労働力で測定されます。1ページあたり平均3分かかる場合、月200件の文書を処理するには約10時間、つまり1人の週労働時間の約4分の1を消費します。控えめな賃金率でも、エラー修正時間を除いて、人件費だけで月に数百ドルになります。ノーコード抽出ツールのサブスクリプション費用は、通常そのほんの一部です。当社のコスト比較分析では、さまざまな処理量レベルと文書タイプにわたる計算の内訳を詳しく説明しています。
対応している文書形式と言語は何ですか?
PDF(ネイティブデジタルとスキャンの両方)、JPEG、PNG、WebP、AVIF、およびWebページのスクリーンショットに対応しています。AIはアップロードされた形式を問わず処理します。スマートフォンで撮影したレシートの写真も、会計ソフトウェアで生成されたPDFも同様に機能します。言語サポートは、英語、日本語、ドイツ語、フランス語、スペイン語、ポルトガル語、韓国語、中国語などをカバーしています。抽出品質は、モデルのトレーニングデータに豊富に含まれる言語で最も高くなりますが、VLMの言語横断的な転移学習により、単一言語コーパスでトレーニングされた従来のOCRよりも、あまり一般的でない言語をうまく処理できます。
ノーコードAI抽出は、誰が文書自動化を利用できるかを変えます。テクノロジーを単純化するのではなく、複雑さをセットアップから事前トレーニングへと移行させるのです。モデルは、ツールを開く前に、請求書がどのようなものかを学習するという困難な作業をすでに完了しています。あなたに残されているのは、文書から何を抽出したいかを説明することだけです。毎日文書を処理しているあなたなら、すでにそれを知っているはずです。