Saisie de données IA sans code :
Extraire des données de documents sans entraîner de modèle
La plupart des gens qui entendent parler d'extraction de documents par IA supposent la même chose : que quelque part derrière l'interface, quelqu'un a entraîné un modèle sur des milliers de factures étiquetées, que son déploiement a pris des semaines et qu'il a fallu un ingénieur en apprentissage automatique pour le configurer. Cette hypothèse était correcte — jusqu'à il y a environ deux ans. La catégorie s'est scindée en deux. Une voie exige encore des données d'entraînement annotées, des cycles d'entraînement de modèles et des équipes techniques. L'autre voie vous demande simplement de saisir les noms de colonnes souhaités et d'importer vos documents. Cet article porte sur la deuxième voie — ce qui la rend possible, comment elle fonctionne au quotidien et où elle cesse de suffire.
Points clés à retenir
- Vous pensez que l'extraction de documents par IA exige un développeur et 500 échantillons d'entraînement étiquetés — c'était vrai jusqu'en 2023, mais la technologie a évolué et cette hypothèse n'a pas suivi.
- L'IA n'apprend pas à partir de vos documents — elle sait déjà à quoi ressemble un numéro de facture grâce aux millions de documents vus lors du pré-entraînement, ce qui lui permet d'extraire par le sens plutôt que par la position.
- ImageToTable.ai remplace des semaines d'entraînement de modèle par une seule question — quelles colonnes souhaitez-vous dans votre feuille de calcul — et y place des données structurées dès le jour où vous commencez.
L'ancienne méthode : pourquoi l'extraction de documents exigeait des développeurs et des données d'entraînement
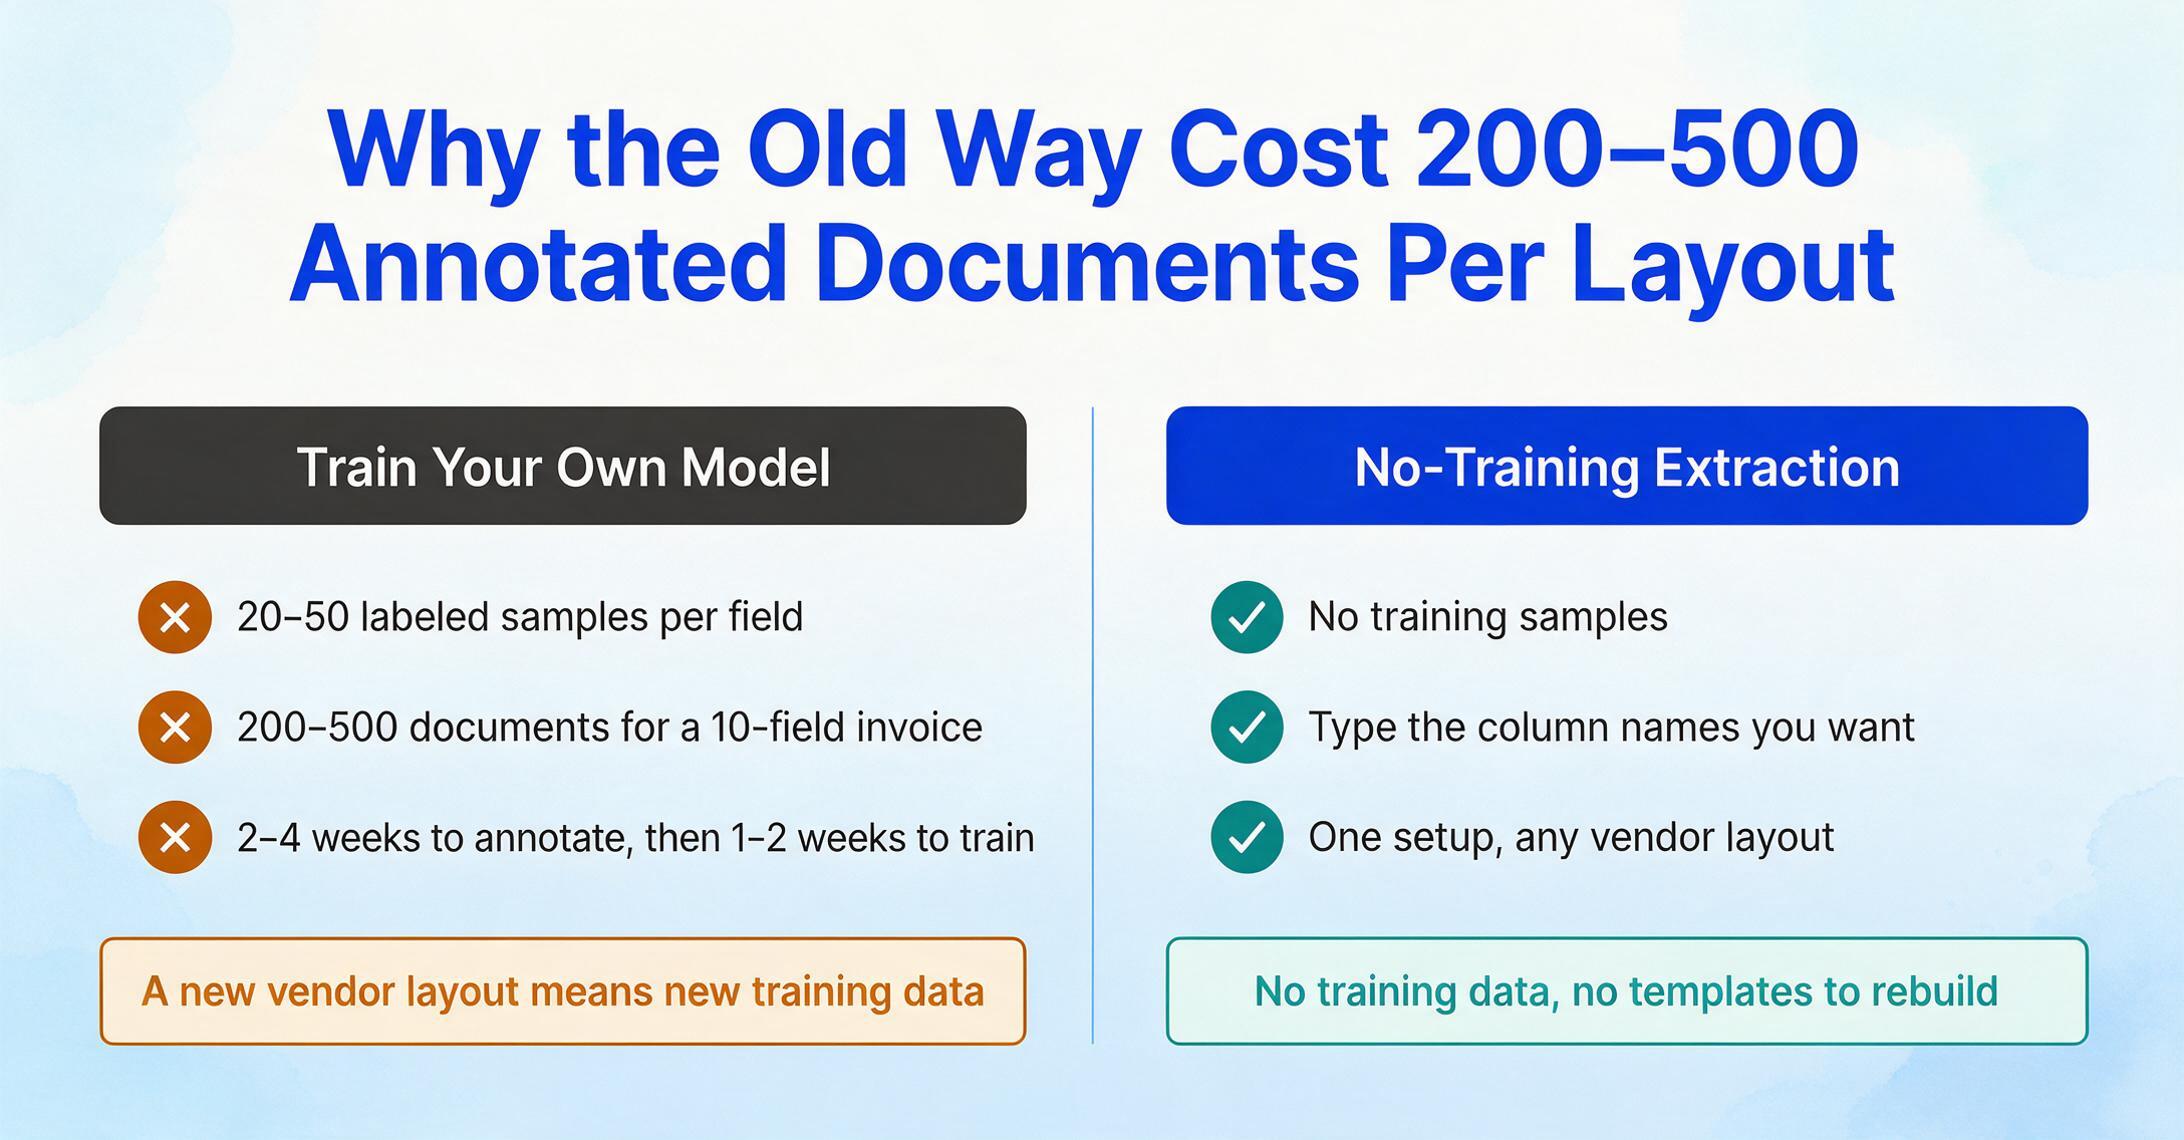
Pour comprendre ce que signifie « zéro entraînement », il faut comprendre ce que coûtait l'entraînement auparavant. Avant les modèles de vision-langage, l'extraction de documents reposait sur une architecture à deux couches : l'OCR pour convertir les images en texte, et des classifieurs de machine learning pour mapper le texte vers les champs. La couche OCR gérait la reconnaissance des caractères. La couche ML gérait tout le reste — et c'était la partie coûteuse.
Entraîner un modèle ML traditionnel pour l'extraction de documents impliquait de lui fournir des exemples annotés : des centaines de documents où un humain avait manuellement indiqué quel texte correspondait au numéro de facture, à la date, au total. La documentation d'UiPath précise 20 à 50 échantillons annotés par champ standard — ainsi, un modèle de facture à 10 champs nécessite 200 à 500 documents annotés avant d'atteindre une précision de niveau production. Pour les champs de colonnes comme les tableaux de lignes, l'exigence passe à 50 à 200 documents par colonne. Et cela pour une seule mise en page de document. Un nouveau fournisseur avec un format de facture différent signifie de nouvelles données d'entraînement, ou accepter une précision moindre d'un modèle étendu à des mises en page pour lesquelles il n'était pas optimisé.
Le calendrier : 2 à 4 semaines pour collecter et annoter les échantillons d'entraînement, encore 1 à 2 semaines pour l'entraînement et l'évaluation du modèle, et un cycle de maintenance continu où chaque nouvelle mise en page de document déclenche un ré-entraînement. L'équipe nécessaire : un annotateur de données qui comprenait le domaine documentaire, un ingénieur machine learning pour configurer le pipeline d'entraînement, et un développeur pour intégrer le modèle résultant dans un système de production. Délai total avant la première extraction utile : généralement 3 à 6 semaines. Coût total : mesuré en salaires d'ingénieurs, pas en abonnement logiciel.
C'est le monde que « l'extraction de documents par IA » signifiait pour quiconque l'évaluait avant 2023 — et c'est la raison pour laquelle l'hypothèse « cela nécessite des développeurs » persiste. Cette hypothèse est dépassée, pas infondée.
Le changement : comment l’IA lit les documents aujourd’hui sans aucun apprentissage
La technologie qui a changé l’économie de l’extraction documentaire est le modèle de langage visuel (VLM) — une classe d’IA qui traite les documents comme le ferait un humain : en regardant la page entière et en comprenant ce que chaque information signifie, sans chercher à faire correspondre des motifs appris à partir d’exemples étiquetés.
Un VLM n’apprend pas à partir de vos factures. Il a été pré-entraîné sur des millions de documents — factures, reçus, relevés bancaires, contrats, formulaires, rapports — avec des mises en page, des langues et des niveaux de qualité variés. Pendant ce pré-entraînement, le modèle a appris à associer des motifs visuels à des rôles sémantiques : un nombre en gras dans le coin inférieur droit d’un document à côté du mot « Total » est le montant dû. Une date en haut de la page formatée « Date de facture : JJ/MM/AAAA » est la date de facturation. Une colonne intitulée « Qté » à côté de « Prix unitaire » indique la quantité — et le nombre qui la suit multiplié par le prix unitaire est le total de la ligne. Le modèle a appris ces associations en les voyant des millions de fois sur des millions de documents, et non en recevant des instructions sur ce qu’il doit chercher sur votre facture spécifique.
C’est ce que signifie réellement « zéro entraînement ». Le modèle comprend déjà les factures, les reçus, les relevés bancaires, les bons de commande, les contrats et des dizaines d’autres types de documents — non pas parce que vous l’avez entraîné, mais parce qu’il a été pré-entraîné à la compréhension visuelle de documents à grande échelle. Lorsque vous téléchargez votre première facture, le modèle n’apprend pas. Il applique ce qu’il sait déjà à un document qu’il n’a jamais vu. Le même mécanisme fonctionne sur une photo d’un reçu froissé prise avec un appareil photo, un PDF scanné provenant d’une imprimante multifonction vieille de 15 ans, et une facture numérique générée par SAP — qualité visuelle différente, même structure sémantique sous-jacente.
La différence fondamentale : Le ML traditionnel extrait par correspondance de motifs — il apprend « sur la facture de ce fournisseur, le numéro de facture est toujours aux coordonnées (x,y) » et échoue lorsque la mise en page change. Les VLM extraient par compréhension sémantique — ils identifient le numéro de facture parce qu’ils comprennent à quoi ressemble un numéro de facture en contexte, peu importe où il apparaît sur la page.
Cette distinction explique pourquoi les outils sans code peuvent fonctionner dès le premier jour sans aucune configuration. Si l’extraction nécessitait un apprentissage par mise en page, vous auriez besoin d’un développeur pour créer des pipelines d’entraînement et d’un expert du domaine pour annoter des échantillons avant que l’outil ne produise quoi que ce soit d’utile. Parce que les VLM gèrent l’extraction de manière sémantique, la seule entrée nécessaire est ce que vous voulez extraire — et c’est quelque chose que vous savez déjà.
La recherche de Firstsource sur le traitement documentaire basé sur les VLM a révélé que les pipelines OCR traditionnels produisent des taux d’erreur de 15 à 20 % dans l’extraction d’informations en raison des défaillances en cascade des étapes séparées OCR → analyse de mise en page → correspondance de champs. Les VLM comblent cet écart en traitant la mise en page visuelle, le contenu textuel et la signification sémantique comme une seule étape unifiée — pas de défaillances en cascade, pas de sorties intermédiaires à dégrader, pas de modèles à maintenir lorsqu’un fournisseur repense l’en-tête de sa facture.
Pour une comparaison plus approfondie des différences d’architecture technique, notre introduction à la saisie de données par IA explique comment les VLM diffèrent de l’OCR au niveau mécanique.
Des noms de colonnes aux données structurées : comment fonctionne l'extraction sans code en pratique
Si vous n'avez pas besoin d'entraîner un modèle ni d'écrire du code d'intégration, que faites-vous exactement ? Le flux de travail repose sur une seule décision de conception : au lieu de configurer l'entrée (modèles, zones, règles), vous décrivez la sortie. Voici à quoi cela ressemble.
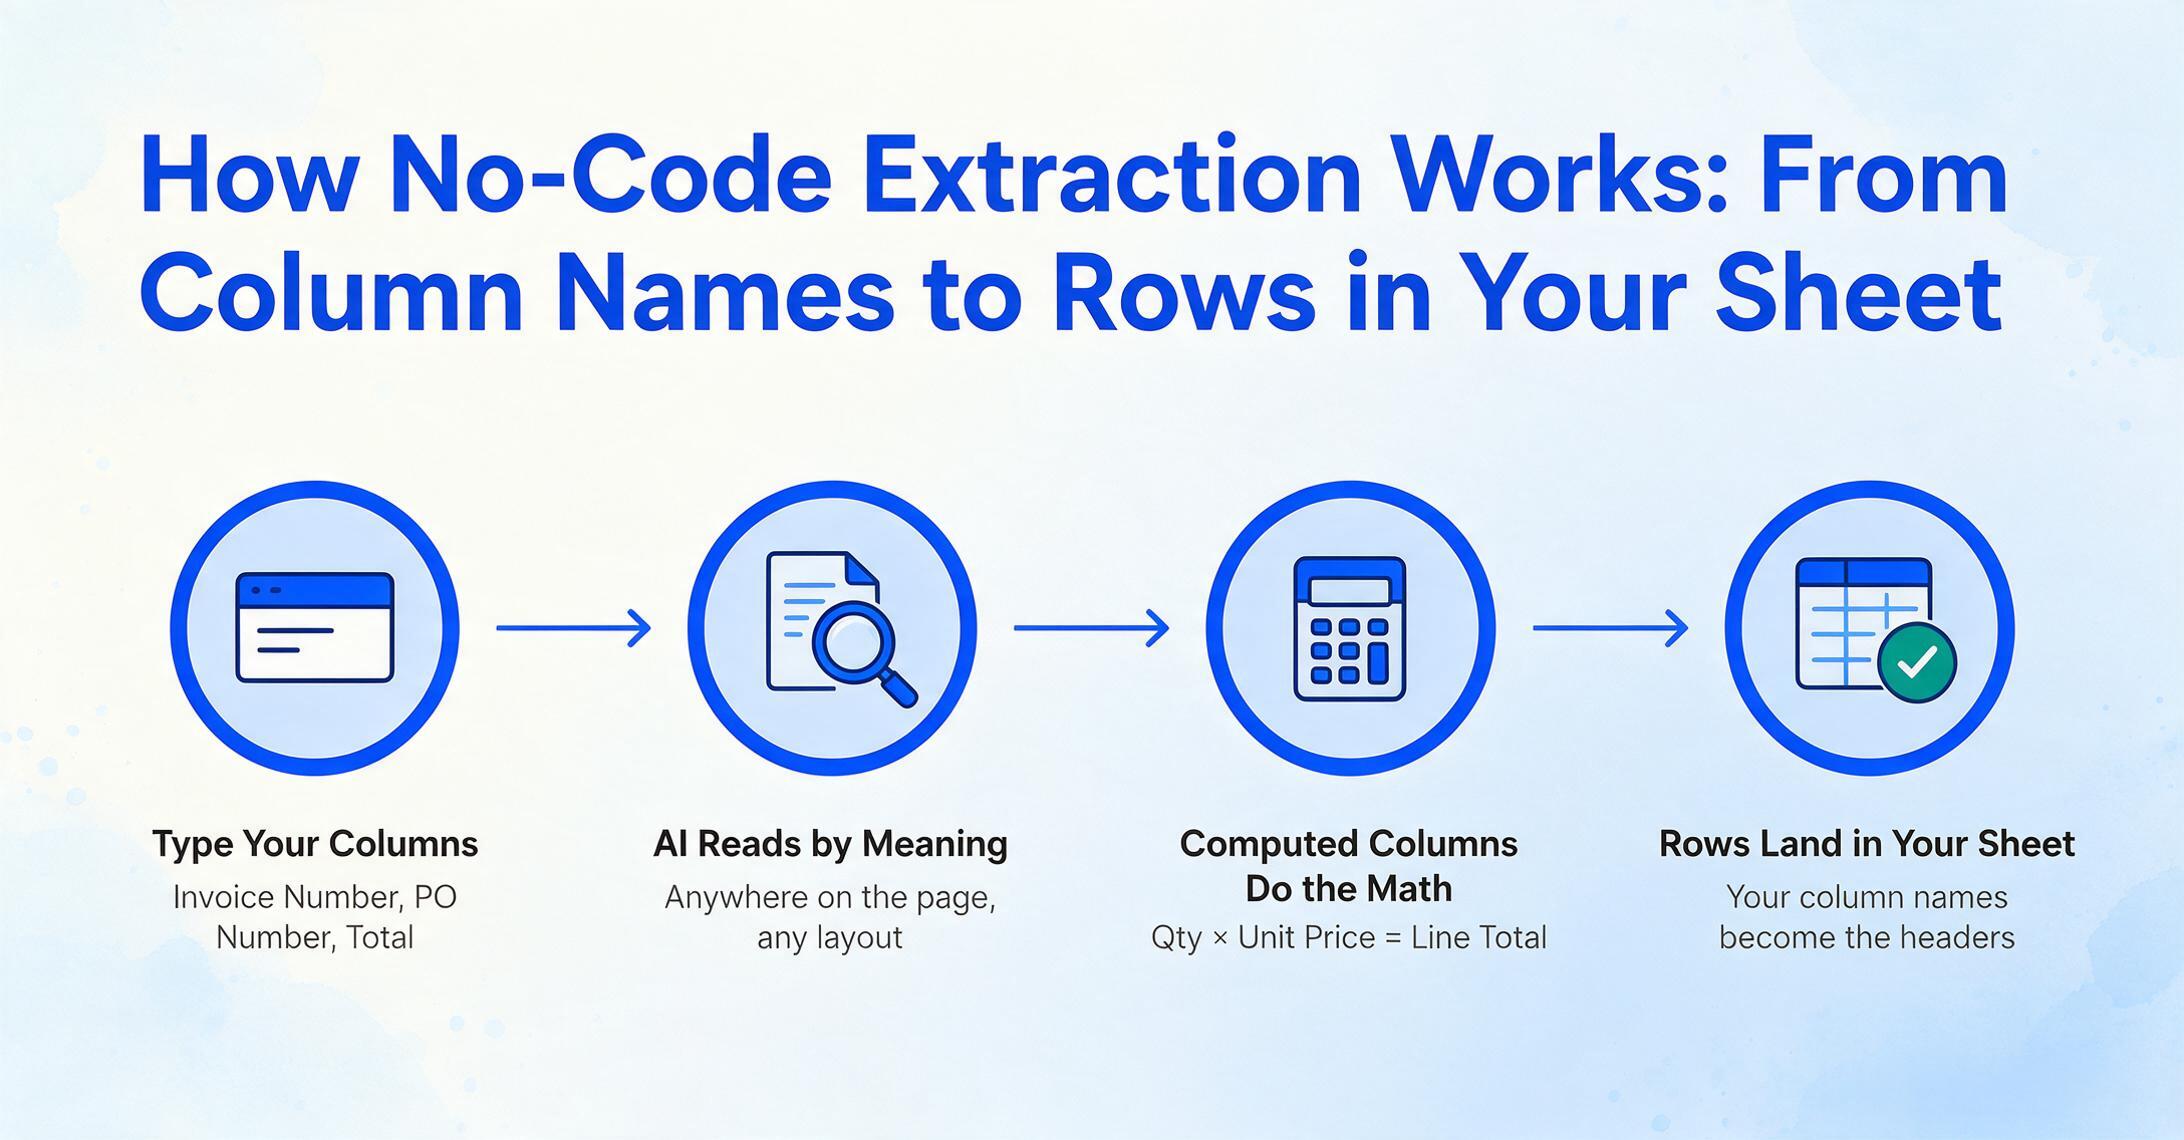
Le mécanisme central est l'Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités dans une zone de texte — « Numéro de facture », « Nom du fournisseur », « Numéro de bon de commande », « Total », « Date d'échéance » — et l'IA localise chaque valeur n'importe où sur le document en comprenant sa signification sémantique, et non son emplacement. Les noms de colonnes que vous saisissez deviennent les en-têtes exacts de votre feuille de calcul finale. Vous décrivez la structure de données que vous souhaitez recevoir, et non le document que vous fournissez.
C'est l'inversion fondamentale qui rend l'extraction sans code possible. Les outils basés sur des modèles vous demandent d'annoter le document : « tracez un cadre autour du numéro de facture ici, tracez un cadre autour de la date là. » Vous configurez l'outil pour comprendre une seule mise en page. L'extraction basée sur les colonnes vous demande de décrire ce que vous voulez : « donnez-moi le numéro de facture, la date et le total. » L'IA gère la correspondance — quelle que soit la mise en page, quel que soit le fournisseur, quel que soit le format.
Au-delà de l'extraction directe des champs imprimés, l'IA sans code prend en charge deux modes supplémentaires qui étendent ce que vous pouvez faire sans toucher à une formule ni écrire de script :
colonne calculée effectuent des calculs pendant l'extraction et génèrent le résultat — et non des données brutes que vous devrez traiter ultérieurement. Un bon de commande indique la Qté et le Prix unitaire mais n'imprime pas le total de la ligne. Définissez une colonne appelée Total de la ligne (Qté × Prix unitaire) et l'IA extrait les deux valeurs sources, les multiplie et écrit le résultat dans votre feuille de calcul — en une seule passe. Aucune formule Excel post-extraction. Le même mécanisme gère l'agrégation sur plusieurs lignes (somme de tous les articles d'une section), la logique conditionnelle (signalement des écarts entre les totaux calculés et imprimés) et les références à des paramètres fixes (application d'un taux de taxe absent du document).
colonne inférée permettent à l'IA de déterminer quelle catégorie, étiquette ou libellé s'applique à un document — et de le remplir dans votre feuille de calcul. Un reçu de restaurant ne mentionne pas « Catégorie : Repas ». Mais vous avez besoin de catégories de dépenses pour la comptabilité. Définissez une colonne appelée Catégorie (options : Repas/Transport/Bureau/Autre). L'IA lit chaque reçu — un reçu de déjeuner, un reçu de station-service, un reçu de fournitures de bureau — et détermine la catégorie correcte. L'extraction et la classification se produisent simultanément, sur l'ensemble d'un lot. Les colonnes inférées fonctionnent de la même manière sur tout type de document : signalement des commandes urgentes à partir des bons de livraison, détection de la devise à partir des factures internationales, identification des sous-types de documents à partir des certificats d'assurance.
Ces trois modes — extraction directe, calcul et inférence — convergent vers une réalité opérationnelle unique : vous saisissez ce que vous voulez, vous téléversez ce que vous avez, et vous recevez une feuille de calcul structurée. Aucune donnée d'entraînement. Aucun éditeur de modèle. Aucun code.
Le traitement par lots étend cette logique au volume. Téléversez 50 factures provenant de 15 fournisseurs différents. Saisissez vos noms de colonnes une seule fois. L'IA traite les 50 documents, identifie chaque champ dans chaque variante de mise en page, et exporte une feuille de calcul unique avec 50 lignes — une par document — où chaque champ atterrit dans la bonne colonne. Ce qui prenait un après-midi de saisie manuelle ne prend plus que quelques minutes de téléversement et de vérification.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le module complémentaire Google Sheets : extraction sans code, directement dans votre feuille de calcul
Si le flux de travail web abaisse la barrière de « il vous faut un développeur » à « il vous faut un navigateur », le module complémentaire Google Sheets l'abaisse encore davantage : à « vous n'avez pas besoin de quitter l'outil dans lequel vous travaillez déjà ».
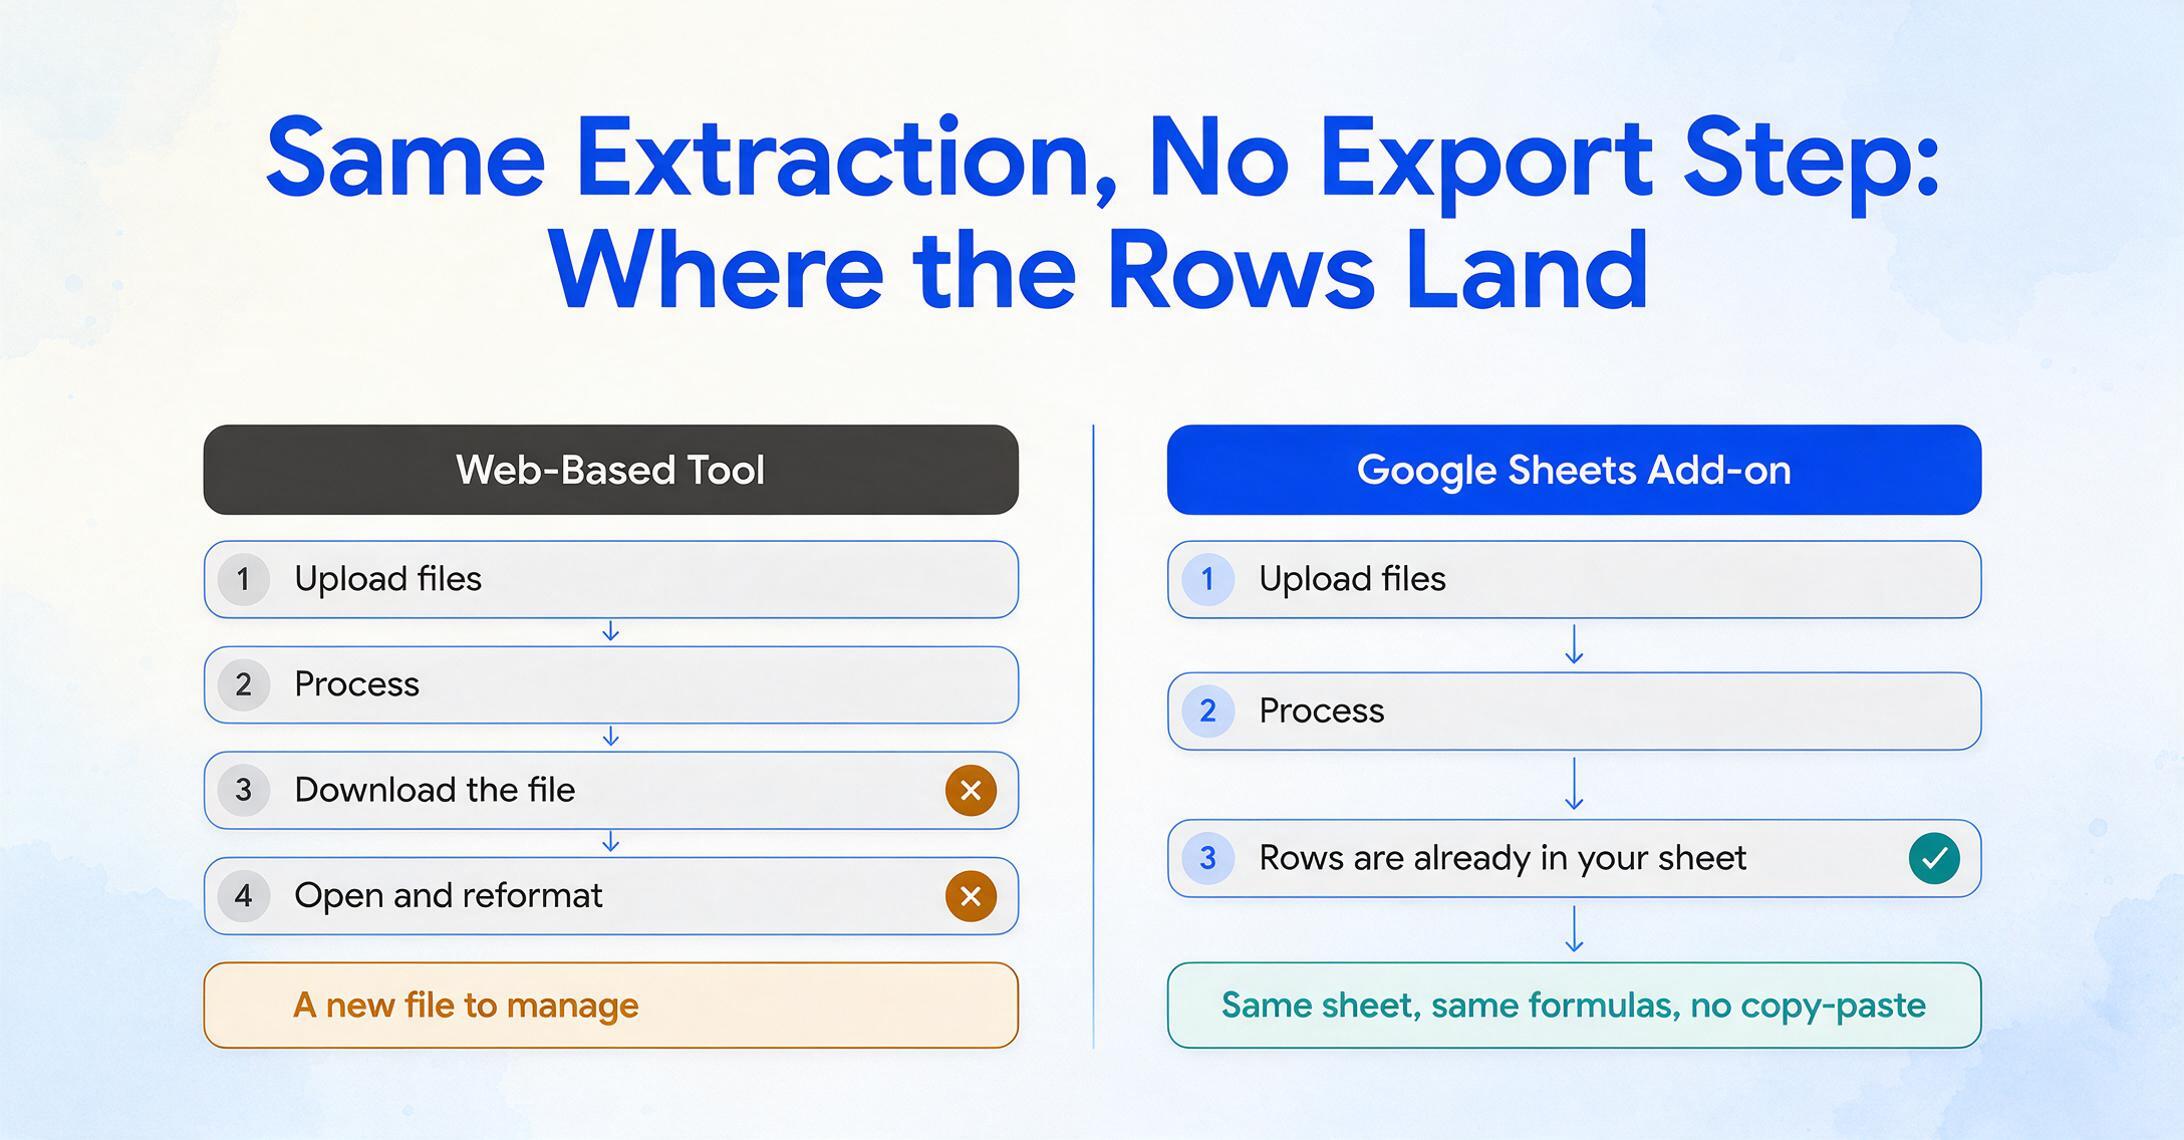
Le module complémentaire Google Sheets d'ImageToTable.ai est un panneau latéral qui vit à l'intérieur de votre feuille de calcul. Ouvrez-le, téléversez des images ou des PDF, saisissez vos noms de colonnes, et les données extraites s'ajoutent directement à la feuille active — lignes structurées, colonnes correctes, aucun copier-coller. L'ensemble du flux de travail se déroule dans Sheets : extrayez les données de factures, les détails de reçus, ou les transactions de relevés bancaires directement dans votre feuille de calcul de travail sans changer d'outil, télécharger des fichiers ou reformater la sortie.
Cela compte, car cela supprime le dernier point de friction dans un flux de travail sans code : l'étape d'exportation. Dans un outil web, vous téléversez → traitez → téléchargez → ouvrez le fichier. Avec le module complémentaire Sheets, téléversement → traitement → les données sont déjà dans votre feuille de calcul — dans la feuille que vous utilisez activement, aux côtés de vos formules, graphiques et références existants. Pour une équipe traitant des factures fournisseurs dans une feuille de calcul AP partagée, cela signifie que l'étape d'extraction ne crée pas un nouveau fichier à gérer — elle ajoute des lignes au fichier que tout le monde a déjà ouvert.
Le module complémentaire fonctionne en mode compte : liez votre clé API une fois, et il se synchronise avec votre tableau de bord web — même historique, mêmes modèles de colonnes enregistrés, même suivi d'utilisation. Aucune configuration séparée. Aucune nouvelle connexion. Le moteur d'extraction est identique à la version web ; seule l'interface change.
Le module complémentaire permet également un flux de travail qu'aucun outil web ne peut réaliser seul : Lien de collecte. Vous générez un lien partageable et l'envoyez à vos clients, fournisseurs ou membres de l'équipe. Ils l'ouvrent, saisissent un court code de vérification et téléversent des documents directement — sans inscription, sans connexion, sans outil à apprendre. Les fichiers arrivent automatiquement dans votre file de traitement. Combiné au module complémentaire Sheets, cela crée un pipeline entièrement sans code : quelqu'un d'autre téléverse les documents, vous ouvrez votre feuille de calcul, et les données extraites attendent dans votre file de traitement — prêtes à être ajoutées à votre feuille en un clic. Pour un aperçu plus approfondi de ce flux de travail, découvrez comment les équipes collectent les reçus de dépenses des employés dans une Google Sheet partagée sans aucune configuration par employé.
Qui y gagne le plus — et qui pourrait avoir besoin de plus
L'extraction IA sans code ne sert pas tout le monde de la même manière. Elle est optimisée pour un profil spécifique, et savoir si vous correspondez à ce profil est plus utile qu'une liste de fonctionnalités.
Les équipes des opérations et de la comptabilité sont les candidates naturelles. Elles traitent des documents quotidiennement, savent exactement quelles données elles ont besoin de chaque type de document, et travaillent déjà dans des feuilles de calcul. Le passage de la saisie manuelle à l'extraction sans code se mesure en minutes — car l'interface leur demande de faire ce qu'elles font déjà mentalement (« J'ai besoin du numéro de facture, de la date, du total de cette pile de factures ») et automatise la partie physique (trouver chaque valeur, la saisir dans la bonne cellule). L'impact sur les flux de travail comptables est immédiat car le goulot d'étranglement — la transcription manuelle des champs — est ce que l'outil remplace.
Les propriétaires de petites entreprises qui gèrent leur propre comptabilité tirent un bénéfice disproportionné de l'extraction sans code. Ils n'ont pas le volume pour justifier un commis AP dédié ni le budget pour embaucher un développeur pour une automatisation personnalisée. Traiter 20 à 50 factures par mois manuellement est lent et sujet aux erreurs ; les traiter avec l'IA sans code prend moins de 10 minutes. Le calcul des coûts est différent de celui des grandes entreprises — il ne s'agit pas de remplacer une équipe, mais de récupérer un après-midi chaque mois qui était consacré à la saisie manuelle des données.
Toute personne gérant un processus de collecte de documents — recueillir des formulaires signés de clients, collecter des reçus de dépenses d'employés, recevoir des rapports d'inspection du personnel terrain — bénéficie de la combinaison du Lien de collecte et de l'extraction sans code. Le volet collecte élimine le besoin pour les participants d'installer quoi que ce soit ou de créer des comptes. Le volet extraction élimine le besoin pour le collecteur de transcrire manuellement chaque soumission. Ensemble, ils transforment « collecter des documents → saisir des données → classer » en « partager un lien → examiner la feuille de calcul → terminé. »
Les équipes qui ont besoin d'une API se trouvent de l'autre côté de la fracture architecturale. Si les données extraites doivent circuler automatiquement vers une base de données, un ERP ou une autre application sans validation humaine, une approche axée sur l'API est la solution adaptée. Le cadre de décision est simple : si les données aboutissent dans un tableur qu'un humain examine, le no-code suffit. Si les données déclenchent programmatiquement une logique métier en aval, vous avez besoin d'une API. Notre comparaison des architectures API vs no-code passe en revue les quatre questions qui déterminent la solution adaptée à votre équipe.
Les organisations disposant de documents hautement spécialisés — formulaires internes propriétaires, déclarations réglementaires spécifiques à un secteur avec des conventions de mise en page uniques, documents dans des langues de niche avec des données d'entraînement limitées — peuvent constater que la précision sans entraînement est inférieure à leurs besoins. Ce n'est pas un échec de l'approche ; c'est une conséquence de la couverture du pré-entraînement. Les VLM donnent les meilleurs résultats sur les types de documents dont ils ont vu des millions d'exemples. Pour un type de document qui n'existe qu'au sein d'une seule entreprise, cette exposition n'existe pas — et l'entraînement personnalisé (ou un outil qui le prend en charge) devient l'option.
Ce que l'extraction IA sans entraînement ne peut pas faire (pour l'instant)
Être clair sur les limites de l'extraction no-code est ce qui distingue une évaluation honnête d'un argumentaire commercial. Voici où elle montre ses limites.
Types de documents extrêmement spécialisés ou propriétaires. Un VLM entraîné sur des millions de factures, reçus et relevés bancaires possède une compréhension sémantique approfondie de ces types de documents. Un formulaire interne propriétaire conçu par une seule entreprise, utilisé nulle part ailleurs et formaté de manière idiosyncrasique — le modèle n'a jamais rien vu de tel. Il tentera quand même l'extraction, et il pourra obtenir certains champs corrects (dates, montants, noms — des éléments qui ressemblent à ce qu'il connaît), mais la précision sera nettement inférieure à celle des types de documents standard. Si votre flux de travail repose sur un format de document personnalisé sans équivalent à l'échelle du secteur, prévoyez de vérifier davantage de champs par document.
Mises en page multipages complexes avec dépendances entre pages. Un tableau qui s'étend sur trois pages avec des cellules fusionnées, des lignes fractionnées et des totaux cumulés qui référencent des valeurs d'une page précédente — cela reste un défi pour les VLM. Le modèle traite les pages indépendamment et ne conserve pas une mémoire continue du type « cet élément de ligne a commencé page 2 et se poursuit au-delà du saut de page jusqu'à la page 3 ». La continuité multipage simple (un tableau de transactions qui se poursuit proprement d'une page à l'autre) est bien gérée. La logique de chevauchement complexe — où un point de données unique dépend de l'agrégation de valeurs sur des pages non contiguës — produit des erreurs dans un pourcentage significatif de cas et nécessite une validation humaine.
Informations purement graphiques. Si un document communique des données exclusivement par des graphiques, des diagrammes ou des visuels codés par couleur sans étiquettes textuelles, il n'y a rien à extraire pour l'IA. La hauteur d'un graphique à barres ne se traduit pas en valeur numérique sans axe étiqueté. Une légende de couleurs qui attribue un sens à des nuances de bleu sans étiquettes textuelles n'est pas interprétable. Les documents qui mélangent texte et visuels — un rapport contenant à la fois un tableau de données et un graphique — fonctionnent uniquement pour la partie tableau.
Qualité d'entrée gravement dégradée. Un scan propre à 300 DPI d'une facture imprimée approchera une précision de 99 %. Une photo d'un reçu thermique délavé prise en angle dans une lumière faible — la précision chute. Le VLM compense les problèmes de qualité modérés (léger flou, inclinaison, éclairage inégal), mais lorsque les caractères deviennent véritablement ambigus pour un lecteur humain, l'IA aura également du mal. Le score de confiance — où l'outil signale les champs à faible certitude pour une validation manuelle — atténue ce problème mais ne l'élimine pas.
La répartition honnête : l'IA sans code traite avec une grande précision les 80 % de documents propres, lisibles et structurellement clairs. Elle traite les 15 % suivants — problèmes de qualité modérés, mises en page inhabituelles, écriture manuscrite légère — avec une précision utilisable mais imparfaite. Les 5 % restants — scans fortement dégradés, écriture manuscrite superposée, documents purement graphiques, formulaires propriétaires sans équivalent sectoriel — nécessitent encore une intervention humaine. Pour une analyse détaillée des facteurs qui affectent la précision d'extraction selon les types de documents, notre guide pratique de la précision couvre les variables qui comptent.
Questions fréquentes
L'extraction IA sans code fonctionne-t-elle vraiment sans formation ni configuration préalable ?
Oui, pour les types de documents courants — factures, reçus, relevés bancaires, bons de commande, contrats et la plupart des documents professionnels aux mises en page standard. L'IA a été pré-entraînée sur des millions de ces documents et comprend leur structure sémantique dès le départ. Vous saisissez les noms de colonnes souhaités, vous téléversez vos fichiers, et l'IA trouve les données. Aucun échantillon d'entraînement, aucune configuration de modèle, aucune configuration préalable au-delà de la description de ce que vous souhaitez extraire. Pour les formats de documents hautement spécialisés ou propriétaires sans équivalent sectoriel, attendez-vous à une précision moindre — le modèle n'a pas vu suffisamment d'exemples de ce format lors du pré-entraînement pour en avoir une compréhension sémantique solide.
En quoi cela diffère-t-il de l'OCR traditionnel avec modèles ?
L'OCR traditionnel avec modèles exige de configurer l'entrée : délimiter des zones autour de chaque champ sur un document échantillon, puis espérer que ces zones correspondent à la mise en page du document suivant. Lorsqu'un fournisseur modifie le format de sa facture, le modèle casse et doit être reconstruit. L'extraction IA sans code fonctionne à l'inverse : vous configurez la sortie (les colonnes souhaitées), et l'IA fait correspondre les champs aux colonnes en comprenant leur signification, et non leur position. Une date en haut à droite d'une facture et en bas à gauche d'une autre aboutit toutes deux dans la colonne « Date » — car l'IA les identifie comme des dates sémantiquement, et non par leur position. Cela signifie également que vous n'avez pas besoin de modèles séparés pour le format de facture de chaque fournisseur. Une seule configuration de colonnes fonctionne pour toutes les mises en page.
Quelle est la différence entre l'extraction sans code et l'utilisation d'une API ?
L'extraction sans code se fait via une interface visuelle — une application web ou un module complémentaire Google Sheets où vous téléversez des documents, définissez des colonnes et téléchargez les résultats. Elle est conçue pour les personnes dont le métier principal est la comptabilité, les opérations ou la logistique — et non le développement logiciel. L'extraction par API est conçue pour les développeurs qui souhaitent intégrer le traitement de documents dans un pipeline automatisé plus vaste : les documents arrivent par programmation, l'extraction se fait via des points de terminaison REST, et les données structurées circulent vers des bases de données ou d'autres applications sans intervention humaine. Le même moteur d'IA sous-jacent alimente les deux. La différence réside dans l'interface et le flux de travail qu'elle permet. Pour les équipes qui hésitent entre les deux, notre comparaison API vs sans code fournit un cadre de décision basé sur le volume, les compétences de l'équipe et la destination des données.
Puis-je traiter plusieurs documents à la fois sans coder ?
Oui. Le traitement par lots est un élément central du flux de travail sans code. Importez autant de documents que vous voulez — 10, 50, 200 — définissez vos noms de colonnes une seule fois, et l'IA les traite tous, en exportant une seule feuille de calcul où chaque ligne correspond à un document et chaque colonne à un champ extrait. Le traitement par lots fusionne les résultats de tous les documents, quelles que soient les différences de mise en page : 50 factures provenant de 15 fournisseurs différents produisent ainsi des lignes dans le même tableau de sortie, avec les champs dans les mêmes colonnes.
Fonctionne-t-il avec des documents manuscrits ?
Une écriture lisible sur des formulaires structurés — un formulaire imprimé rempli à la main, un bon de livraison avec des quantités manuscrites — est bien gérée par l'IA moderne. La structure du formulaire fournit un contexte qui aide le modèle à interpréter le contenu manuscrit. Les notes manuscrites en texte libre, l'écriture cursive rapide avec des formes de lettres très stylisées et les écritures qui se chevauchent produisent des résultats moins fiables. Si vos documents sont principalement manuscrits, prévoyez de vérifier davantage de champs plutôt que de les traiter directement.
Combien coûte l'extraction IA sans code par rapport à la saisie manuelle des données ?
Les outils d'extraction IA sans code sont généralement proposés par abonnement, avec des paliers de prix basés sur le nombre de pages ou de documents. Les coûts de la saisie manuelle se mesurent en temps de travail : à raison de 3 minutes par page en moyenne, le traitement de 200 documents par mois représente environ 10 heures — soit près d'un quart de la semaine de travail d'une personne. À des taux de salaire prudents, cela représente plusieurs centaines de dollars par mois en main-d'œuvre seule, sans compter le temps de correction des erreurs. Le coût d'abonnement d'un outil d'extraction sans code ne représente généralement qu'une fraction de ce montant. Notre analyse comparative des coûts détaille le calcul pour différents volumes et types de documents.
Quels formats de documents et quelles langues sont pris en charge ?
PDF (natifs numériques et scannés), JPEG, PNG, WebP, AVIF et captures d'écran de pages web. L'IA traite quel que soit le format que vous importez — une photo de reçu prise avec un téléphone fonctionne de la même manière qu'un PDF généré par un logiciel de comptabilité. La prise en charge des langues couvre l'anglais, le japonais, l'allemand, le français, l'espagnol, le portugais, le coréen et le chinois, entre autres. La qualité d'extraction est la plus élevée pour les langues bien représentées dans les données d'entraînement du modèle, bien que le transfert interlingue du VLM lui permette de mieux gérer les langues moins courantes que l'OCR traditionnel entraîné sur des corpus monolingues.
L'extraction IA sans code change qui peut utiliser l'automatisation documentaire — non pas en simplifiant la technologie, mais en déplaçant la complexité de la configuration vers le pré-entraînement. Le modèle a fait le travail difficile d'apprendre à quoi ressemble une facture avant même que vous n'ouvriez l'outil. Ce qui vous reste, c'est à décrire ce que vous voulez obtenir de vos documents — ce que, si vous êtes la personne qui les traite au quotidien, vous savez déjà.