No-Code-KI-Datenerfassung:
Dokumentdaten ohne Modelltraining extrahieren
Die meisten Menschen, die von KI-Dokumentextraktion hören, gehen von derselben Annahme aus: dass irgendwo hinter der Oberfläche jemand ein Modell mit Tausenden gelabelten Rechnungen trainiert hat, dass die Bereitstellung Wochen gedauert hat und dass ein Machine-Learning-Ingenieur für die Einrichtung nötig war. Diese Annahme war früher richtig – bis vor etwa zwei Jahren. Die Kategorie hat sich gespalten. Ein Weg erfordert weiterhin annotierte Trainingsdaten, Modelltrainingszyklen und technische Teams. Der andere Weg erfordert, dass Sie die gewünschten Spaltennamen eingeben und Ihre Dokumente hochladen. Dieser Artikel befasst sich mit dem zweiten Weg – was ihn möglich macht, wie er im Alltag funktioniert und wo er nicht mehr ausreicht.
Wichtige Erkenntnisse
- Sie gehen davon aus, dass KI-Dokumentextraktion einen Entwickler und 500 gelabelte Trainingsbeispiele erfordert – das stimmte bis 2023, aber die Technologie hat sich weiterentwickelt und die Annahme hat noch nicht Schritt gehalten.
- Die KI lernt nicht aus Ihren Dokumenten – sie weiß bereits, wie eine Rechnungsnummer aussieht, da sie während des Vortrainings Millionen von Dokumenten gesehen hat, was bedeutet, dass sie nach Bedeutung statt nach Position extrahiert.
- ImageToTable.ai ersetzt Wochen des Modelltrainings durch eine einzige Frage – welche Spalten möchten Sie in Ihrer Tabellenkalkulation – und liefert strukturierte Daten noch am selben Tag, an dem Sie beginnen.
Der alte Weg: Warum Dokumentextraktion früher Entwickler und Trainingsdaten erforderte
Um zu verstehen, was „ohne Training“ bedeutet, hilft es zu wissen, was Training früher kostete. Vor Vision-Language-Modellen lief die Dokumentextraktion auf einem zweischichtigen Stack: OCR zur Umwandlung von Bildern in Text und Machine-Learning-Klassifikatoren zur Zuordnung von Text zu Feldern. Die OCR-Schicht übernahm die Zeichenerkennung. Die ML-Schicht übernahm alles andere – und das war der teure Teil.
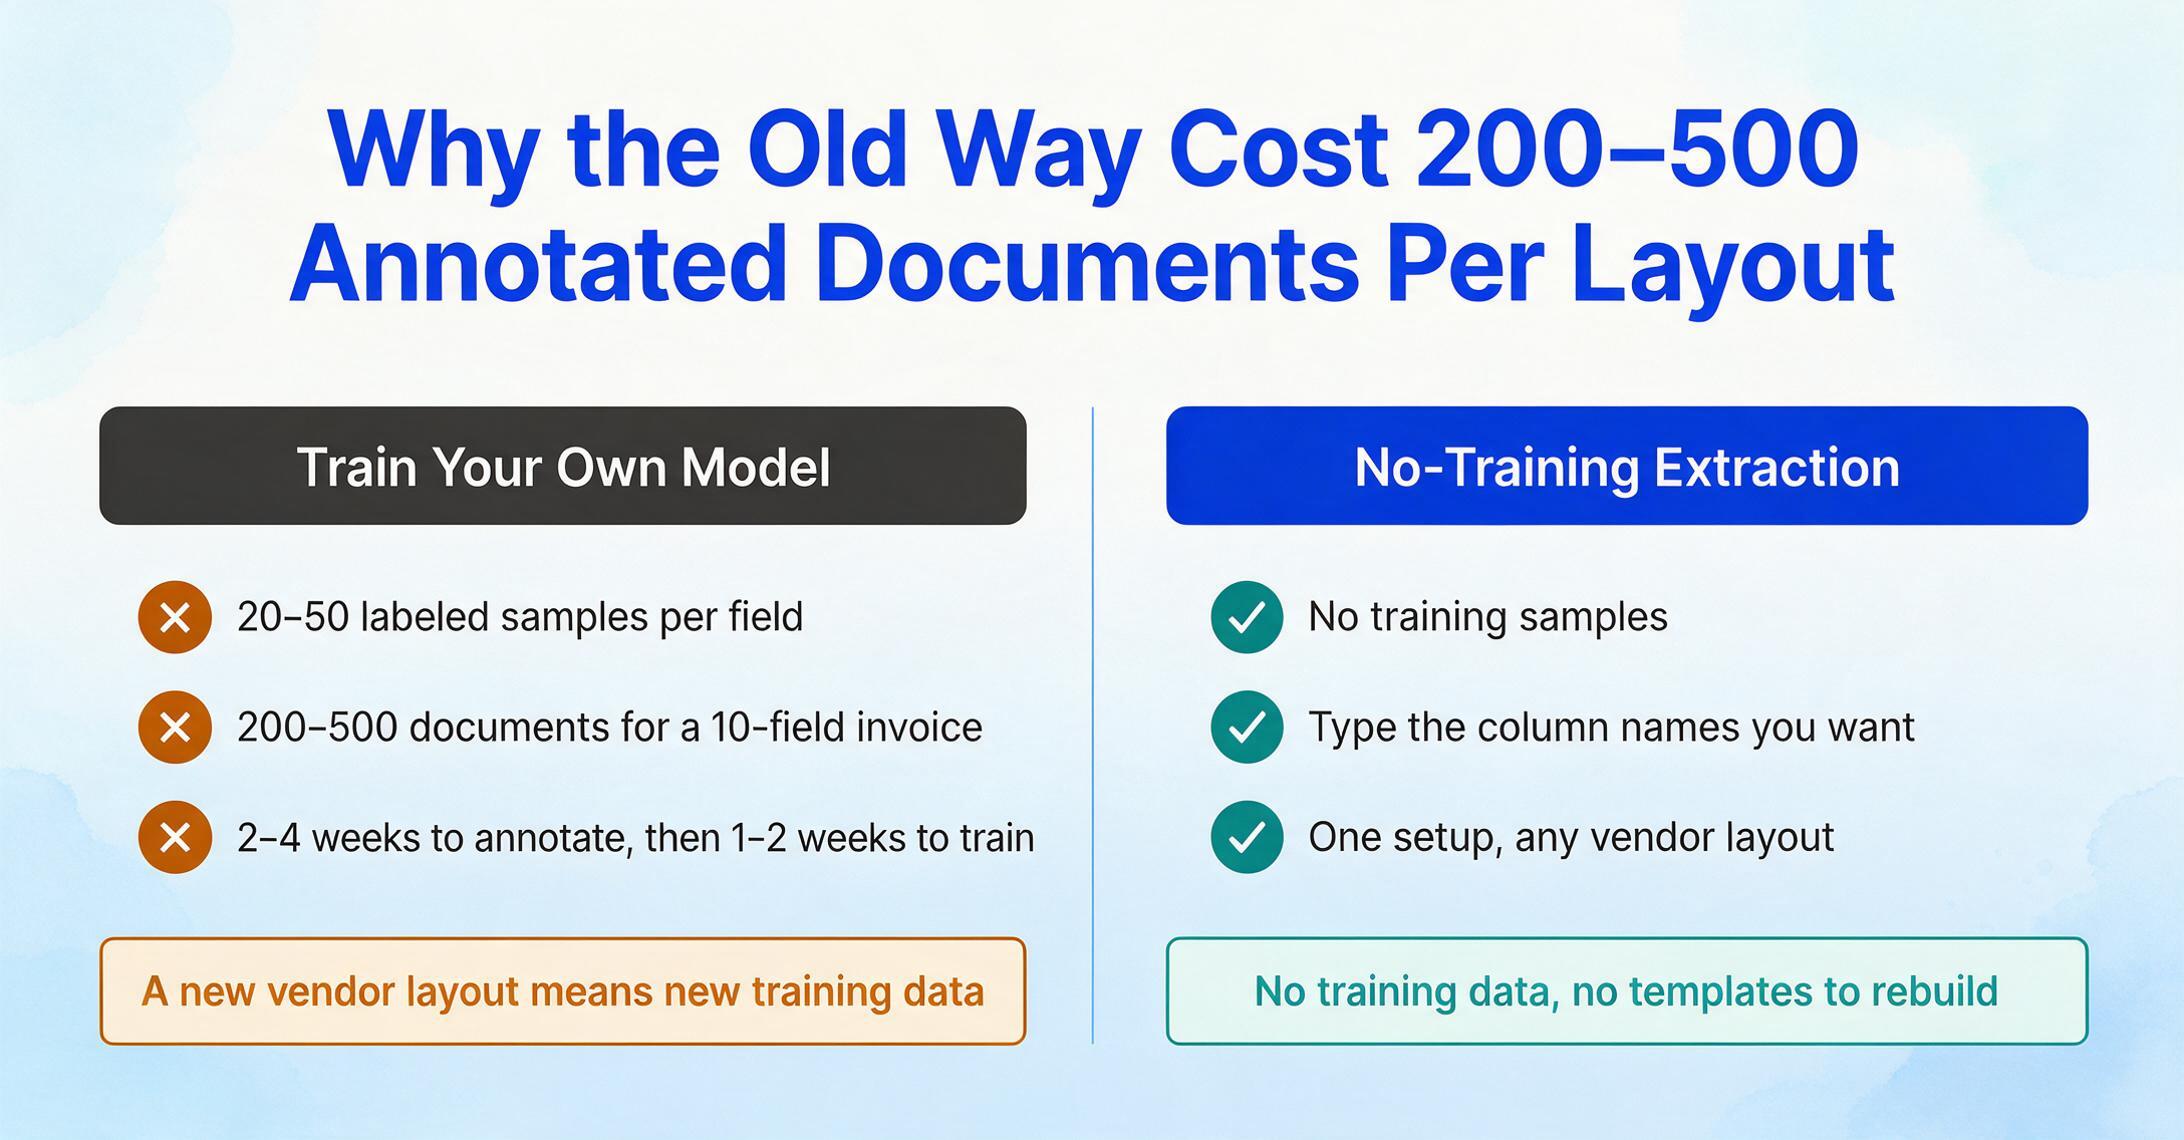
Das Training eines traditionellen ML-Modells für die Dokumentextraktion bedeutete, es mit beschrifteten Beispielen zu füttern: Hunderte von Dokumenten, bei denen ein Mensch manuell markiert hatte, welcher Text die Rechnungsnummer war, welcher das Datum, welcher die Summe. UiPaths eigene Dokumentation spezifiziert 20 bis 50 beschriftete Stichproben pro regulärem Feld – eine Rechnungsvorlage mit 10 Feldern erfordert also 200 bis 500 annotierte Dokumente, bevor das Modell eine produktionsreife Genauigkeit erreicht. Für Spaltenfelder wie Positionszeilentabellen steigt die Anforderung auf 50 bis 200 Dokumente pro Spalte. Und das gilt für ein einziges Dokumentlayout. Ein neuer Anbieter mit einem anderen Rechnungsformat bedeutet neue Trainingsdaten – oder man akzeptiert geringere Genauigkeit von einem Modell, das über Layouts gestreckt wird, für die es nicht optimiert wurde.
Der Zeitplan: 2 bis 4 Wochen zum Sammeln und Annotieren von Trainingsstichproben, weitere 1 bis 2 Wochen für Modelltraining und -bewertung, plus ein laufender Wartungszyklus, bei dem neue Dokumentlayouts ein erneutes Training auslösen. Das Team benötigte: einen Datenannotator, der die Dokumentdomäne verstand, einen Machine-Learning-Ingenieur zur Konfiguration der Trainingspipeline und einen Entwickler zur Integration des resultierenden Modells in ein Produktionssystem. Gesamtzeit bis zur ersten nutzbaren Extraktion: typischerweise 3 bis 6 Wochen. Gesamtkosten: gemessen in Ingenieursgehältern, nicht in Software-Abonnements.
Das ist die Welt, die „KI-Dokumentextraktion“ für jeden bedeutete, der sie vor 2023 evaluierte – und es ist der Grund, warum die Annahme „das braucht Entwickler“ fortbesteht. Die Annahme ist veraltet, aber nicht unbegründet.
Der Wandel: Wie KI Dokumente heute ohne Training liest
Die Technologie, die die Wirtschaftlichkeit der Dokumentenextraktion verändert hat, ist das Vision Language Model (VLM) – eine KI-Klasse, die Dokumente wie ein Mensch verarbeitet: durch Betrachten der gesamten Seite und Verstehen der Bedeutung jeder Information, nicht durch Musterabgleich aus beschrifteten Beispielen.
Ein VLM lernt nicht aus Ihren Rechnungen. Es wurde mit Millionen von Dokumenten vortrainiert – Rechnungen, Quittungen, Kontoauszüge, Verträge, Formulare, Berichte – über verschiedene Layouts, Sprachen und Qualitätsstufen hinweg. Während des Vortrainings lernte das Modell, visuelle Muster mit semantischen Rollen zu verknüpfen: Eine fette Zahl unten rechts neben dem Wort „Gesamtbetrag“ ist der Rechnungsbetrag. Ein Datum oben auf der Seite im Format „Rechnungsdatum: TT.MM.JJJJ“ ist das Rechnungsdatum. Eine Spalte mit der Bezeichnung „Menge“ neben „Einzelpreis“ bedeutet die Stückzahl – und die Zahl danach multipliziert mit dem Einzelpreis ist der Zeilenbetrag. Das Modell lernte diese Zusammenhänge, indem es sie millionenfach in Millionen von Dokumenten sah, nicht indem ihm gesagt wurde, wonach es auf Ihrer speziellen Rechnung suchen soll.
Das bedeutet „Null Training“ tatsächlich. Das Modell versteht bereits Rechnungen, Quittungen, Kontoauszüge, Bestellungen, Verträge und Dutzende anderer Dokumenttypen – nicht weil Sie es trainiert haben, sondern weil es massiv im visuellen Dokumentenverständnis vortrainiert wurde. Wenn Sie Ihre erste Rechnung hochladen, lernt das Modell nicht. Es wendet an, was es bereits weiß, auf ein Dokument, das es noch nie gesehen hat. Derselbe Mechanismus funktioniert bei einem Foto einer zerknitterten Quittung von einer Handykamera, einem gescannten PDF von einem 15 Jahre alten Multifunktionsdrucker und einer digitalen Rechnung aus SAP – unterschiedliche visuelle Qualität, gleiche zugrunde liegende semantische Struktur.
Der Kernunterschied: Traditionelles ML extrahiert durch Musterabgleich – es lernt „bei dieser Rechnung des Lieferanten ist die Rechnungsnummer immer an Koordinate (x,y)“ und versagt bei Layoutänderungen. VLMs extrahieren durch semantisches Verständnis – sie identifizieren die Rechnungsnummer, weil sie verstehen, wie eine Rechnungsnummer im Kontext aussieht, unabhängig davon, wo sie auf der Seite erscheint.
Diese Unterscheidung erklärt, warum No-Code-Tools ab dem ersten Tag ohne Einrichtung funktionieren. Wenn Extraktion ein Layout-Training erfordern würde, bräuchten Sie einen Entwickler für Trainingspipelines und einen Fachexperten zur Annotation von Beispielen, bevor das Tool etwas Nützliches liefert. Da VLMs semantisch extrahieren, ist die einzige benötigte Eingabe was extrahiert werden soll – und das wissen Sie bereits.
Firstsources Forschung zu VLM-basierter Dokumentenverarbeitung ergab, dass traditionelle OCR-Pipelines aufgrund der kaskadierenden Fehler separater OCR → Layoutanalyse → Feldextraktionsschritte Fehlerraten von 15-20 % bei der Informationsextraktion aufweisen. VLMs schließen diese Lücke, indem sie visuelles Layout, Textinhalt und semantische Bedeutung als einen einzigen, einheitlichen Schritt verarbeiten – keine kaskadierenden Fehler, keine Zwischenergebnisse, die sich verschlechtern, keine Vorlagen, die gewartet werden müssen, wenn ein Lieferant seinen Rechnungskopf neu gestaltet.
Für einen tieferen Vergleich der technischen Architekturunterschiede behandelt unsere Einführung in die KI-Dateneingabe, wie sich VLMs auf Mechanismenebene von OCR unterscheiden.
Von Spaltennamen zu strukturierten Daten: So funktioniert No-Code-Extraktion in der Praxis
Wenn Sie kein Modell trainieren oder Integrationscode schreiben müssen, was tun Sie dann? Der Workflow basiert auf einer einzigen Designentscheidung: Statt die Eingabe zu konfigurieren (Vorlagen, Zonen, Regeln), beschreiben Sie die Ausgabe. So sieht das aus.
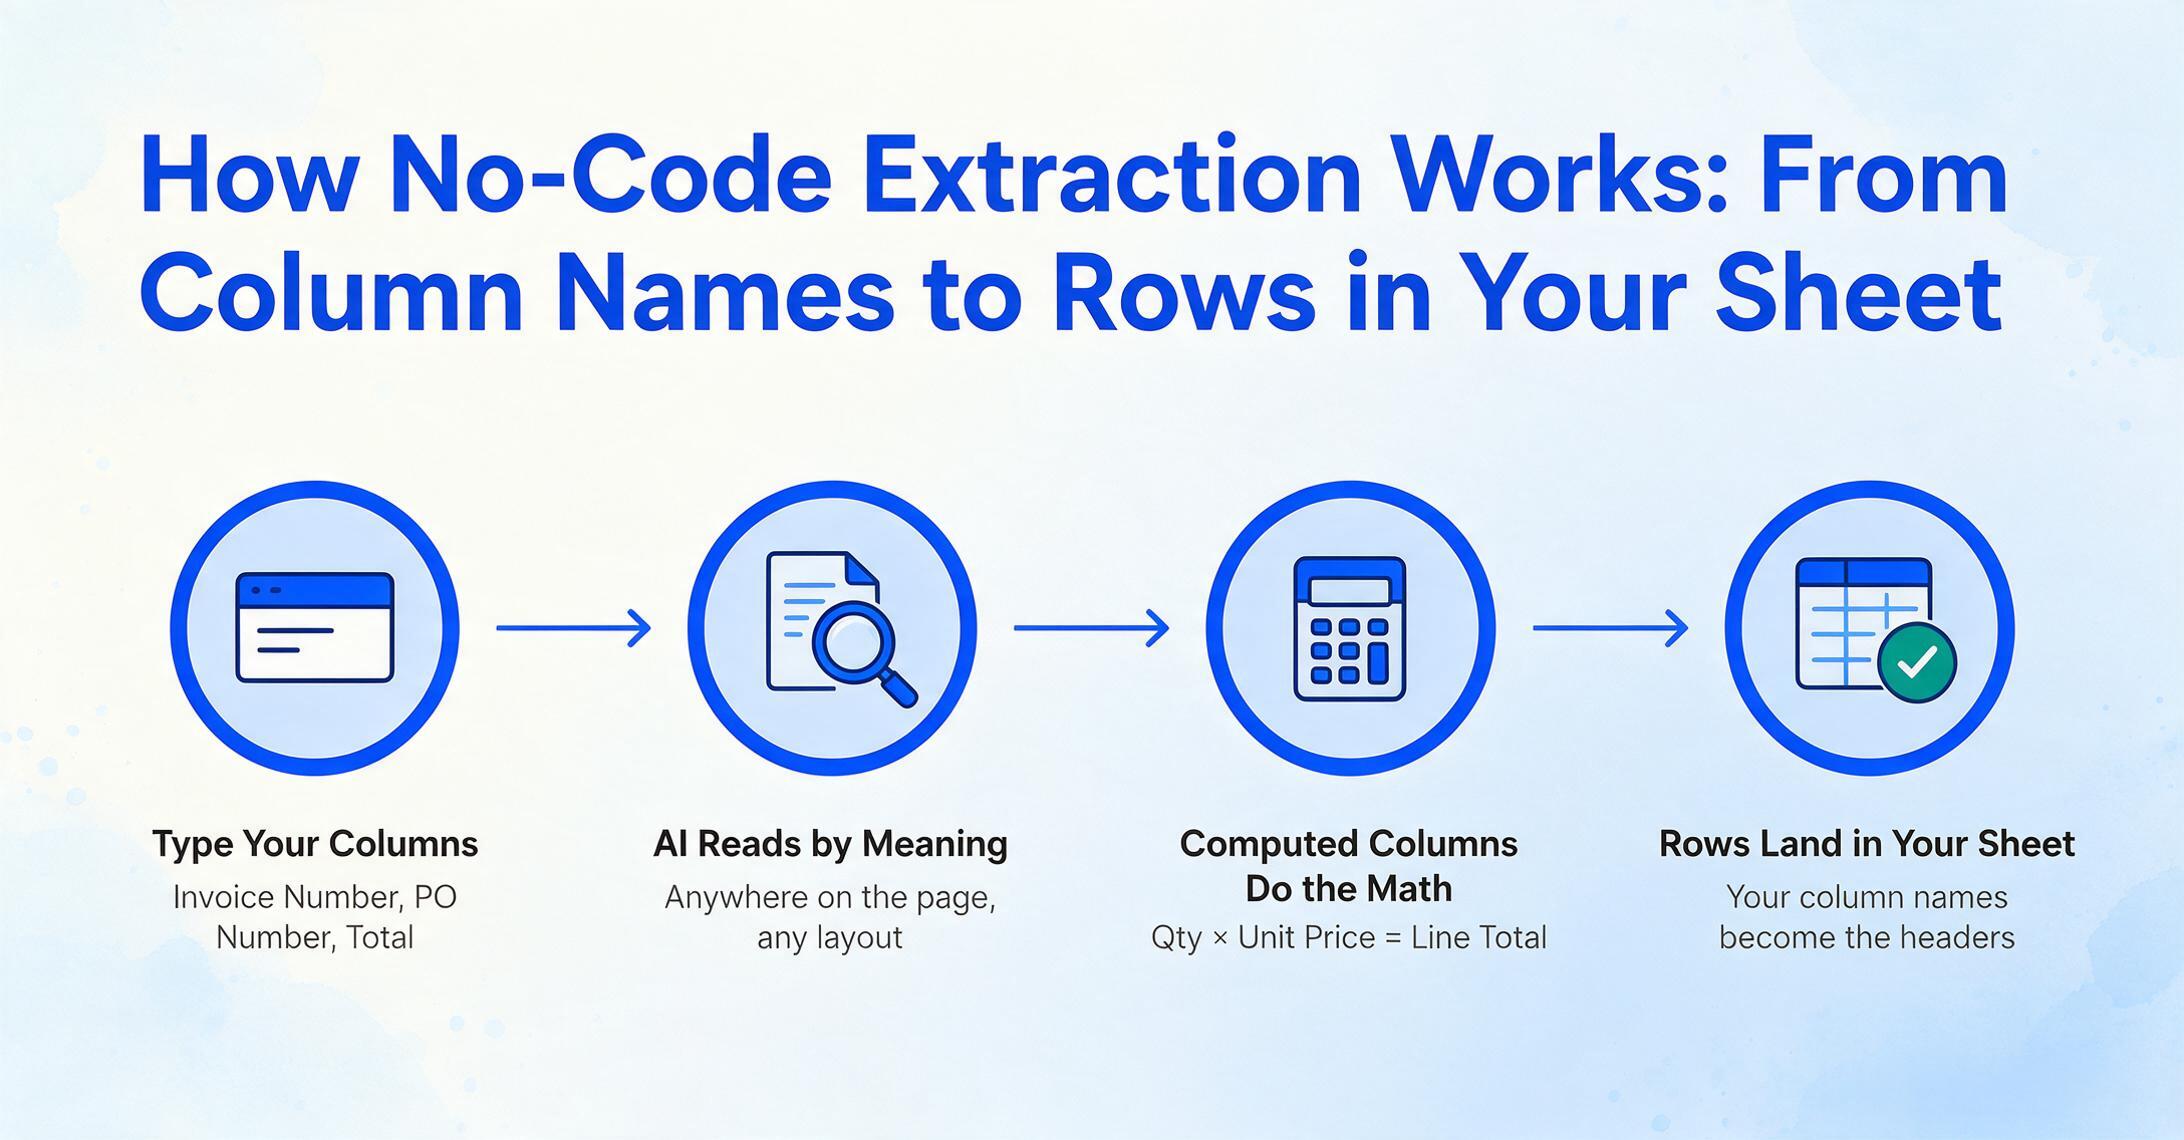
Der Kernmechanismus ist die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Feldnamen in ein Textfeld ein – „Rechnungsnummer", „Lieferantenname", „Bestellnummer", „Gesamtsumme", „Fälligkeitsdatum" – und die KI lokalisiert jeden Wert an beliebiger Stelle im Dokument, indem sie dessen semantische Bedeutung versteht, nicht dessen Position. Die von Ihnen eingegebenen Spaltennamen werden zu den exakten Kopfzeilen Ihrer finalen Tabelle. Sie beschreiben die Datenstruktur, die Sie erhalten möchten, nicht das Dokument, das Sie einspeisen.
Das ist die grundlegende Umkehrung, die No-Code-Extraktion ermöglicht. Vorlagenbasierte Tools verlangen, dass Sie das Dokument markieren: „Zeichnen Sie hier ein Feld um die Rechnungsnummer, dort ein Feld um das Datum." Sie konfigurieren das Tool so, dass es ein Layout versteht. Spaltenbasierte Extraktion verlangt, dass Sie beschreiben, was Sie möchten: „Geben Sie mir die Rechnungsnummer, das Datum und die Gesamtsumme." Die KI übernimmt die Zuordnung – über jedes Layout, von jedem Anbieter, in jedem Format.
Über die direkte Extraktion gedruckter Felder hinaus unterstützt No-Code-KI zwei weitere Modi, die erweitern, was Sie tun können, ohne eine Formel anzufassen oder ein Skript zu schreiben:
Berechnete Spalten führen Berechnungen während der Extraktion durch und geben das Ergebnis aus – nicht Rohdaten, die Sie später verarbeiten müssen. Ein Auftrag listet Menge und Einzelpreis auf, druckt aber keine Positionssumme. Definieren Sie eine Spalte namens Positionssumme (Menge × Einzelpreis) und die KI extrahiert beide Quellwerte, multipliziert sie und schreibt das Ergebnis in einem Durchgang in Ihre Tabelle. Keine Excel-Formeln nach der Extraktion. Derselbe Mechanismus übernimmt zeilenübergreifende Aggregationen (Summieren aller Positionen in einem Abschnitt), bedingte Logik (Kennzeichnen von Abweichungen zwischen berechneten und gedruckten Summen) und feste Parameterreferenzen (Anwenden eines Steuersatzes, der gar nicht auf dem Dokument steht).
Abgeleitete Spalten ermöglichen es der KI, eine Einschätzung darüber zu treffen, welche Kategorie, welches Tag oder welche Kennzeichnung auf ein Dokument zutrifft – und diese in Ihre Tabelle einzutragen. Eine Quittung aus einem Restaurant sagt nicht „Kategorie: Verpflegung". Aber Sie benötigen Ausgabenkategorien für die Buchhaltung. Definieren Sie eine Spalte namens Kategorie (Optionen: Verpflegung/Transport/Büro/Sonstiges). Die KI liest jede Quittung – eine Mittagsquittung, eine Tankstellenquittung, eine Büromaterialquittung – und bestimmt die richtige Kategorie. Extraktion und Klassifizierung erfolgen gleichzeitig über einen gesamten Batch. Abgeleitete Spalten funktionieren bei jedem Dokumenttyp gleich: Kennzeichnen von Eilaufträgen aus Lieferscheinen, Erkennen der Währung aus internationalen Rechnungen, Identifizieren von Dokumentuntertypen aus Versicherungszertifikaten.
Diese drei Modi — direkte Extraktion, Berechnung und Inferenz — laufen auf eine einzige operative Realität hinaus: Sie geben ein, was Sie möchten, laden hoch, was Sie haben, und erhalten eine strukturierte Tabelle. Keine Trainingsdaten. Kein Vorlagen-Editor. Kein Code.
Die Batch-Verarbeitung erweitert dies auf große Mengen. Laden Sie 50 Rechnungen von 15 verschiedenen Lieferanten hoch. Geben Sie Ihre Spaltennamen einmal ein. Die KI verarbeitet alle 50, identifiziert jedes Feld in jeder Layout-Variation und exportiert eine einzige Tabelle mit 50 Zeilen — eine pro Dokument —, in der jedes Feld in der richtigen Spalte landet. Was einen Nachmittag manueller Eingabe dauerte, dauert jetzt nur wenige Minuten für Upload und Prüfung.
Dateien werden sicher verarbeitet und nicht gespeichert.
Das Google Sheets-Add-on: No-Code-Extraktion direkt in Ihrer Tabelle
Wenn der webbasierte Workflow die Hürde von „Sie brauchen einen Entwickler" auf „Sie brauchen einen Browser" senkt, senkt das Google Sheets-Add-on sie weiter: auf „Sie müssen das Tool, in dem Sie bereits arbeiten, nicht verlassen."
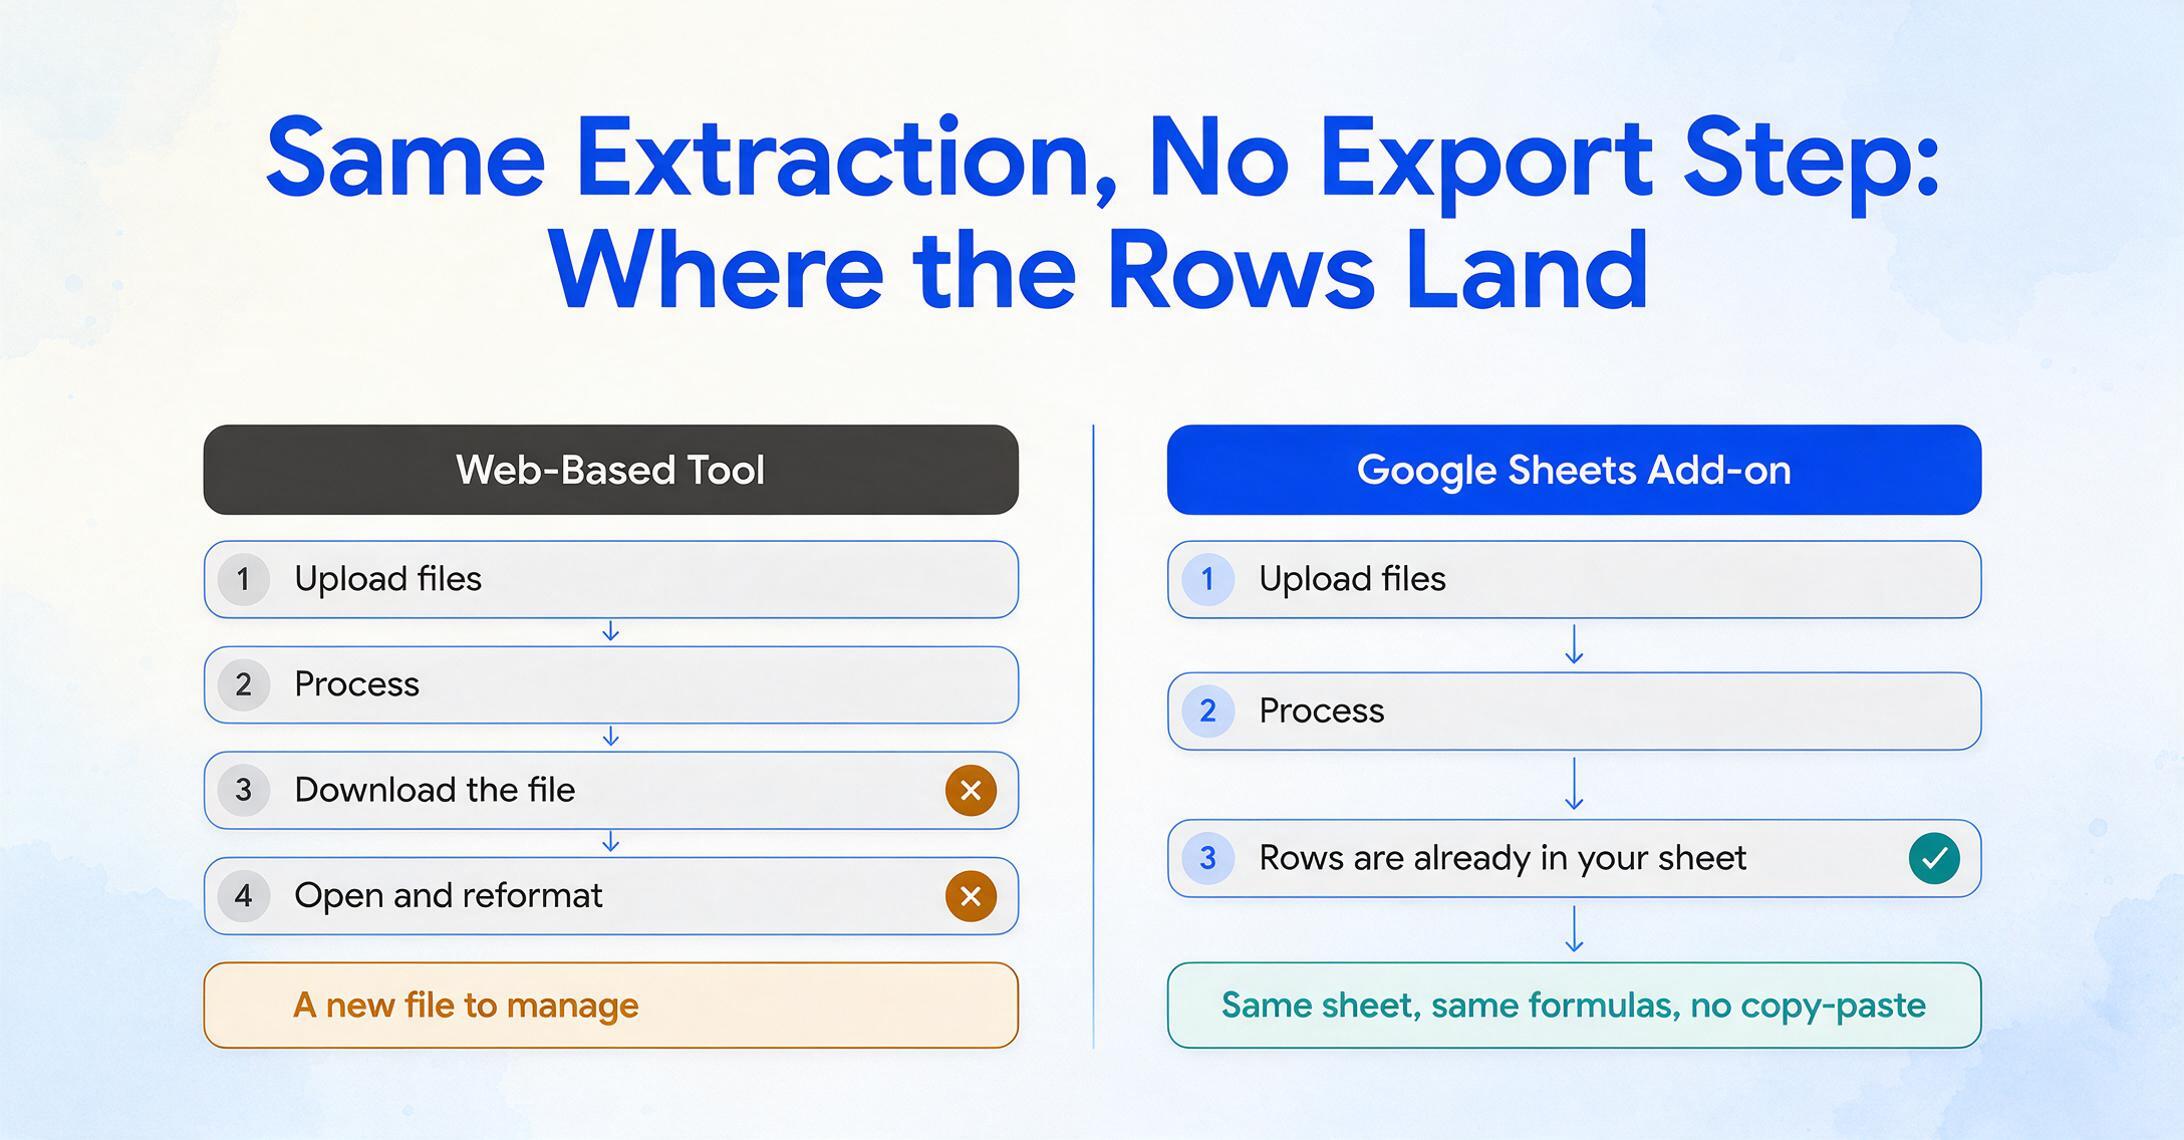
Das ImageToTable.ai Google Sheets-Add-on ist eine Seitenleiste, die in Ihrer Tabelle lebt. Öffnen Sie sie, laden Sie Bilder oder PDFs hoch, geben Sie Ihre Spaltennamen ein, und extrahierte Daten werden direkt an das aktive Blatt angehängt — strukturierte Zeilen, korrekte Spalten, kein Kopieren und Einfügen. Der gesamte Workflow findet in Sheets statt: Rechnungsdaten extrahieren, Belegdetails oder Kontoauszugtransaktionen direkt in Ihre Arbeitstabelle, ohne Tools zu wechseln, Dateien herunterzuladen oder Ausgaben neu zu formatieren.
Das ist wichtig, weil es den letzten Reibungspunkt in einem No-Code-Workflow beseitigt: den Export-Schritt. In einem webbasierten Tool laden Sie hoch → verarbeiten → laden herunter → öffnen die Datei. Mit dem Sheets-Add-on laden Sie hoch → verarbeiten → die Daten sind bereits in Ihrer Tabelle — in dem Blatt, das Sie aktiv nutzen, zusammen mit Ihren vorhandenen Formeln, Diagrammen und Verweisen. Für ein Team, das Lieferantenrechnungen in eine gemeinsame AP-Tabelle verarbeitet, bedeutet dies, dass der Extraktionsschritt keine neue Datei erzeugt, die verwaltet werden muss — er fügt Zeilen zu der Datei hinzu, die alle bereits geöffnet haben.
Das Add-on arbeitet im Kontomodius: Binden Sie Ihren API-Schlüssel einmal an, und es synchronisiert sich mit Ihrem Web-Dashboard — gleicher Verlauf, gleiche gespeicherte Spaltenvorlagen, gleiche Nutzungsverfolgung. Keine separate Einrichtung. Kein neuer Login. Die Extraktions-Engine ist identisch mit der Webversion; nur die Oberfläche ändert sich.
Das Add-on ermöglicht außerdem einen Workflow, den kein Webtool allein bewältigen kann: Sammellink. Sie generieren einen teilbaren Link und senden ihn an Kunden, Lieferanten oder Teammitglieder. Diese öffnen ihn, geben einen kurzen Verifizierungscode ein und laden Dokumente direkt hoch — ohne Registrierung, ohne Login, ohne zu erlernendes Tool. Dateien landen automatisch in Ihrer Verarbeitungswarteschlange. In Kombination mit dem Sheets-Add-on entsteht so eine vollständig No-Code-Pipeline: Jemand anderes lädt die Dokumente hoch, Sie öffnen Ihre Tabelle, und die extrahierten Daten warten in Ihrer Verarbeitungswarteschlange — bereit, mit einem Klick an Ihre Tabelle angehängt zu werden. Für einen tieferen Einblick in diesen Workflow sehen Sie, wie Teams Mitarbeiter-Spesenbelege in einer gemeinsamen Google-Tabelle sammeln — ohne Einrichtung pro Mitarbeiter.
Wer am meisten profitiert — und wer möglicherweise mehr benötigt
No-Code-KI-Extraktion dient nicht allen gleichermaßen. Sie ist für ein bestimmtes Profil optimiert, und zu wissen, ob Sie in dieses Profil passen, ist nützlicher als eine Funktionsliste.
Betriebs- und Buchhaltungsteams sind die natürliche Zielgruppe. Sie verarbeiten täglich Dokumente, wissen genau, welche Daten sie aus jedem Dokumenttyp benötigen, und arbeiten bereits mit Tabellen. Der Sprung von manueller Eingabe zu No-Code-Extraktion dauert nur Minuten — denn die Oberfläche fordert sie auf, das zu tun, was sie bereits mental tun („Ich benötige Rechnungsnummer, Datum, Gesamtsumme aus diesem Stapel Rechnungen") und automatisiert den physischen Teil (jeden Wert finden, in die richtige Zelle tippen). Die Auswirkungen auf Buchhaltungsworkflows sind sofort spürbar, denn der Engpass — die manuelle Feldtranskription — ist genau das, was das Tool ersetzt.
Kleinunternehmer, die ihre eigene Buchhaltung führen, profitieren überproportional von der No-Code-Extraktion. Ihnen fehlt das Volumen, um einen eigenen AP-Sachbearbeiter zu rechtfertigen, und das Budget, um einen Entwickler für individuelle Automatisierung zu engagieren. Die manuelle Verarbeitung von 20 bis 50 Rechnungen pro Monat ist langsam und fehleranfällig; mit No-Code-KI dauert sie unter 10 Minuten. Die Kostenrechnung unterscheidet sich von der eines Unternehmens — es geht nicht darum, ein Team zu ersetzen, sondern darum, jeden Monat einen Nachmittag zurückzugewinnen, der bisher für manuelle Dateneingabe aufgewendet wurde.
Jeder, der einen Dokumentensammlungsprozess betreibt — das Sammeln unterschriebener Formulare von Kunden, das Erfassen von Spesenbelegen von Mitarbeitern, das Empfangen von Inspektionsberichten von Außendienstmitarbeitern — profitiert von der Kombination aus Sammellink und No-Code-Extraktion. Die Sammlungsseite macht Installationen oder Kontenerstellungen für Teilnehmer überflüssig. Die Extraktionsseite macht die manuelle Transkription jeder Einreichung durch den Sammler überflüssig. Zusammen verwandeln sie „Dokumente sammeln → Daten eingeben → ablegen" in „Link teilen → Tabelle prüfen → fertig."
Teams, die eine API benötigen, stehen auf der anderen Seite der Architekturgrenze. Wenn extrahierte Daten automatisch in eine Datenbank, ein ERP oder eine andere Anwendung fließen müssen, ohne dass eine menschliche Prüfung erfolgt, ist ein API-First-Ansatz die richtige Wahl. Der Entscheidungsrahmen ist einfach: Wenn Daten in einer Tabellenkalkulation landen, die ein Mensch prüft, ist No-Code ausreichend. Wenn Daten nachgelagerte Geschäftslogik programmatisch auslösen, benötigen Sie eine API. Unser Vergleich von API- vs. No-Code-Architekturen führt Sie durch die vier Fragen, die bestimmen, welcher Weg zu Ihrem Team passt.
Organisationen mit hochspezialisierten Dokumenten – proprietäre interne Formulare, branchenspezifische regulatorische Einreichungen mit einzigartigen Layout-Konventionen, Dokumente in Nischensprachen mit begrenzten Trainingsdaten – können feststellen, dass die Genauigkeit ohne Training geringer ist als benötigt. Das ist kein Versagen des Ansatzes, sondern eine Folge der Abdeckung durch das Vortraining. VLMs funktionieren am besten bei Dokumenttypen, von denen sie Millionen von Beispielen gesehen haben. Für einen Dokumenttyp, der nur innerhalb eines Unternehmens existiert, gibt es diese Abdeckung nicht – und individuelles Training (oder ein Tool, das dies unterstützt) wird zur Option.
Was Zero-Training-KI-Extraktion (noch) nicht kann
Sich über die Grenzen der No-Code-Extraktion im Klaren zu sein, unterscheidet eine ehrliche Bewertung von einem Verkaufsgespräch. Hier zeigt sich, wo die Grenzen liegen.
Extrem spezialisierte oder proprietäre Dokumenttypen. Ein VLM, das mit Millionen von Rechnungen, Belegen und Kontoauszügen trainiert wurde, hat ein tiefes semantisches Verständnis dieser Dokumenttypen. Ein proprietäres internes Formular, das von einem Unternehmen entworfen wurde, sonst nirgendwo verwendet wird und in einer eigenwilligen Weise formatiert ist – das Modell hat noch nie etwas Vergleichbares gesehen. Es wird dennoch versuchen, die Extraktion durchzuführen, und möglicherweise einige Felder korrekt erfassen (Daten, Beträge, Namen – Dinge, die wie bekannte Elemente aussehen), aber die Genauigkeit wird deutlich geringer sein als bei Standard-Dokumenttypen. Wenn Ihr Workflow auf einem individuellen Dokumentformat ohne branchenweites Äquivalent basiert, sollten Sie damit rechnen, mehr Felder pro Dokument zu prüfen.
Komplexe mehrseitige Layouts mit seitenübergreifenden Abhängigkeiten. Eine Tabelle, die sich über drei Seiten erstreckt, mit verbundenen Zellen, geteilten Zeilen und laufenden Summen, die auf Werte von einer vorherigen Seite verweisen – das stellt VLMs weiterhin vor Herausforderungen. Das Modell verarbeitet Seiten unabhängig und führt keine laufende Erinnerung darüber, dass „dieser Positionseintrag auf Seite 2 begann und sich über den Seitenumbruch auf Seite 3 fortsetzt". Einfache mehrseitige Kontinuität (eine Transaktionstabelle, die sauber von einer Seite zur nächsten fortgesetzt wird) wird gut verarbeitet. Komplexe übergreifende Logik – bei der ein einzelner Datenpunkt von der Aggregation von Werten über nicht zusammenhängende Seiten abhängt – führt in einem erheblichen Prozentsatz der Fälle zu Fehlern und erfordert eine menschliche Prüfung.
Rein grafische Informationen. Wenn ein Dokument Daten ausschließlich über Diagramme, Grafiken oder farbcodierte Visualisierungen ohne Textbeschriftungen kommuniziert, gibt es für die KI nichts zu extrahieren. Die Höhe eines Balkendiagramms lässt sich ohne beschriftete Achse nicht in einen numerischen Wert übersetzen. Eine Farblegende, die Schattierungen von Blau ohne Textbeschriftungen Bedeutung zuweist, ist nicht parsebar. Dokumente, die Text und Visualisierungen mischen – ein Bericht mit sowohl einer Datentabelle als auch einem Diagramm – funktionieren nur für den Tabellenteil.
Stark beeinträchtigte Eingabequalität. Ein sauberer 300-DPI-Scan einer gedruckten Rechnung erreicht nahezu 99 % Genauigkeit. Ein Foto eines verblassten Thermo-Belegs, das in einem Winkel bei schlechtem Licht aufgenommen wurde – die Genauigkeit sinkt. Das VLM gleicht moderate Qualitätsprobleme aus (leichte Unschärfe, Neigung, ungleichmäßige Beleuchtung), aber wenn Zeichen für einen menschlichen Leser wirklich mehrdeutig werden, hat auch die KI Schwierigkeiten. Konfidenz-Scoring – bei dem das Tool Felder mit geringer Sicherheit zur manuellen Prüfung kennzeichnet – mildert dies ab, beseitigt es jedoch nicht.
Die ehrliche Verteilung: No-Code-KI verarbeitet die 80 % der Dokumente, die sauber, lesbar und strukturell klar sind, mit hoher Genauigkeit. Sie verarbeitet die nächsten 15 % – mäßige Qualitätsprobleme, ungewöhnliche Layouts, leichte Handschrift – mit brauchbarer, aber nicht perfekter Genauigkeit. Die letzten 5 % – stark degradierte Scans, überlappende Handschrift, rein grafische Dokumente, proprietäre Formulare ohne Branchenäquivalent – erfordern weiterhin menschliche Aufmerksamkeit. Eine detaillierte Aufschlüsselung der Faktoren, die die Extraktionsgenauigkeit bei verschiedenen Dokumenttypen beeinflussen, finden Sie in unserem praktischen Genauigkeitsleitfaden.
Häufig gestellte Fragen
Funktioniert No-Code-KI-Extraktion wirklich ohne Training oder Einrichtung?
Ja, für gängige Dokumenttypen – Rechnungen, Belege, Kontoauszüge, Bestellungen, Verträge und die meisten Geschäftsdokumente mit Standardlayouts. Die KI wurde mit Millionen dieser Dokumente vortrainiert und versteht deren semantische Struktur sofort. Sie geben die gewünschten Spaltennamen ein, laden Ihre Dateien hoch, und die KI findet die Daten. Keine Trainingsbeispiele, keine Vorlagenkonfiguration, keine Einrichtung über die Beschreibung dessen, was extrahiert werden soll. Bei hochspezialisierten oder proprietären Dokumentformaten ohne Branchenäquivalent ist mit geringerer Genauigkeit zu rechnen – das Modell hat während des Vortrainings nicht genügend Beispiele dieses Formats gesehen, um ein starkes semantisches Verständnis dafür zu haben.
Wie unterscheidet sich das von herkömmlicher OCR mit Vorlagen?
Herkömmliche OCR mit Vorlagen erfordert, dass Sie die Eingabe konfigurieren: Zeichnen Sie Zonen um jedes Feld auf einem Beispieldokument und hoffen Sie dann, dass diese Zonen mit dem Layout des nächsten Dokuments übereinstimmen. Wenn ein Anbieter sein Rechnungsformat ändert, bricht die Vorlage und muss neu erstellt werden. No-Code-KI-Extraktion funktioniert umgekehrt: Sie konfigurieren die Ausgabe (welche Spalten Sie möchten), und die KI ordnet Felder Spalten zu, indem sie versteht, was sie bedeuten, nicht wo sie stehen. Ein Datum in der oberen rechten Ecke einer Rechnung und in der unteren linken Ecke einer anderen landet jeweils in der Spalte „Datum“ – weil die KI sie semantisch als Daten identifiziert, nicht anhand der Position. Das bedeutet auch, dass Sie keine separaten Vorlagen für jedes Anbieterformat benötigen. Eine Spalteneinrichtung funktioniert über alle Layouts hinweg.
Was ist der Unterschied zwischen No-Code-Extraktion und der Nutzung einer API?
No-Code-Extraktion erfolgt über eine visuelle Oberfläche – eine Web-App oder ein Google Sheets-Add-on, in dem Sie Dokumente hochladen, Spalten definieren und Ergebnisse herunterladen. Sie ist für Personen konzipiert, deren Hauptaufgabe Buchhaltung, Betrieb oder Logistik ist – nicht Softwareentwicklung. API-basierte Extraktion ist für Entwickler konzipiert, die Dokumentverarbeitung in eine größere automatisierte Pipeline einbetten möchten: Dokumente treffen programmatisch ein, Extraktion erfolgt über REST-Endpunkte, und strukturierte Daten fließen ohne menschliches Eingreifen in Datenbanken oder andere Anwendungen. Dieselbe zugrunde liegende KI-Engine treibt beides an. Der Unterschied liegt in der Oberfläche und dem Workflow, den sie ermöglicht. Für Teams, die zwischen beiden entscheiden, bietet unser API-vs.-No-Code-Vergleich einen Entscheidungsrahmen basierend auf Volumen, Teamfähigkeiten und Datenziel.
Kann ich mehrere Dokumente gleichzeitig ohne Code verarbeiten?
Ja. Die Batch-Verarbeitung ist ein Kernbestandteil des No-Code-Workflows. Laden Sie beliebig viele Dokumente hoch – 10, 50, 200 – definieren Sie Ihre Spaltennamen einmal, und die KI verarbeitet alle Dokumente und exportiert eine einzige Tabelle, in der jede Zeile ein Dokument und jede Spalte ein extrahiertes Feld ist. Der Batch führt Ergebnisse über Dokumente hinweg zusammen, unabhängig von Layout-Unterschieden. So erzeugen 50 Rechnungen von 15 verschiedenen Anbietern Zeilen in derselben Ausgabetabelle mit Feldern in denselben Spalten.
Funktioniert das auch mit handschriftlichen Dokumenten?
Leserliche Handschrift auf strukturierten Formularen – ein ausgedrucktes Formular, das von Hand ausgefüllt wurde, ein Lieferschein mit handschriftlichen Mengenangaben – wird von moderner KI gut verarbeitet. Die Struktur des Formulars liefert Kontext, der dem Modell hilft, handschriftliche Inhalte zu interpretieren. Freie handschriftliche Notizen, schnelle Schreibschrift mit stark stilisierten Buchstabenformen und überlappende Handschrift führen zu weniger zuverlässigen Ergebnissen. Wenn Ihre Dokumente überwiegend handschriftlich sind, sollten Sie damit rechnen, mehr Felder zu überprüfen, anstatt sie direkt durchzuverarbeiten.
Was kostet die No-Code-KI-Extraktion im Vergleich zur manuellen Dateneingabe?
No-Code-KI-Extraktionstools sind in der Regel abonnementbasiert mit Preisstufen nach Seiten oder Dokumenten. Die Kosten für manuelle Dateneingabe werden in Arbeitszeit gemessen: Bei durchschnittlich 3 Minuten pro Seite benötigt die Verarbeitung von 200 Dokumenten pro Monat etwa 10 Stunden – also etwa ein Viertel der Wochenarbeitszeit einer Person. Bei konservativen Lohnsätzen sind das allein mehrere hundert Dollar pro Monat an Arbeitskosten, ohne die Zeit für die Fehlerkorrektur. Die Abonnementkosten eines No-Code-Extraktionstools sind in der Regel nur ein Bruchteil davon. Unsere Kostenvergleichsanalyse schlüsselt die Rechnung für verschiedene Volumenstufen und Dokumenttypen auf.
Welche Dokumentformate und Sprachen werden unterstützt?
PDFs (sowohl nativ digitale als auch gescannte), JPEG, PNG, WebP, AVIF und Webseiten-Screenshots. Die KI verarbeitet jedes Format, das Sie hochladen – ein Foto einer Quittung, das mit dem Handy aufgenommen wurde, funktioniert genauso wie ein PDF, das von einer Buchhaltungssoftware erzeugt wurde. Die Sprachunterstützung umfasst unter anderem Englisch, Japanisch, Deutsch, Französisch, Spanisch, Portugiesisch, Koreanisch und Chinesisch. Die Extraktionsqualität ist am höchsten für Sprachen, die in den Trainingsdaten des Modells gut repräsentiert sind, wobei der sprachübergreifende Transfer des VLM bedeutet, dass es weniger verbreitete Sprachen besser verarbeitet als herkömmliche OCR, die mit einsprachigen Korpora trainiert wurde.
No-Code-KI-Extraktion verändert, wer Dokumentautomatisierung nutzen kann – nicht indem sie die Technologie einfacher macht, sondern indem sie die Komplexität vom Setup in das Pre-Training verlagert. Das Modell hat die harte Arbeit, zu lernen, wie eine Rechnung aussieht, bereits erledigt, bevor Sie das Tool überhaupt geöffnet haben. Was Ihnen bleibt, ist zu beschreiben, was Sie aus Ihren Dokumenten herausholen möchten – was Sie, wenn Sie die Person sind, die sie täglich verarbeitet, bereits wissen.