Entrada de datos con IA sin código:
Extraiga datos de documentos sin entrenar un modelo
La mayoría de las personas que escuchan sobre la extracción de documentos con IA asumen lo mismo: que en algún lugar detrás de la interfaz, alguien entrenó un modelo con miles de facturas etiquetadas, que tomó semanas implementarlo y que requirió un ingeniero de aprendizaje automático para configurarlo. Esa suposición solía ser correcta, hasta hace unos dos años. La categoría se ha dividido. Un camino aún exige datos de entrenamiento anotados, ciclos de entrenamiento de modelos y equipos técnicos. El otro camino solo requiere que usted escriba los nombres de las columnas que desea y suba sus documentos. Este artículo trata sobre el segundo camino: qué lo hace posible, cómo funciona en el día a día y dónde deja de ser suficiente.
Conclusiones clave
- Usted asume que la extracción de documentos con IA exige un desarrollador y 500 muestras de entrenamiento etiquetadas; eso era cierto hasta 2023, pero la tecnología cambió y la suposición aún no se ha actualizado.
- La IA no aprende de sus documentos: ya sabe cómo se ve un número de factura por haber visto millones de documentos durante el preentrenamiento, lo que significa que extrae por significado en lugar de por posición.
- ImageToTable.ai reemplaza semanas de entrenamiento de modelos con una sola pregunta — qué columnas desea en su hoja de cálculo — y coloca datos estructurados allí el mismo día en que usted comienza.
El método antiguo: por qué la extracción de documentos solía requerir desarrolladores y datos de entrenamiento
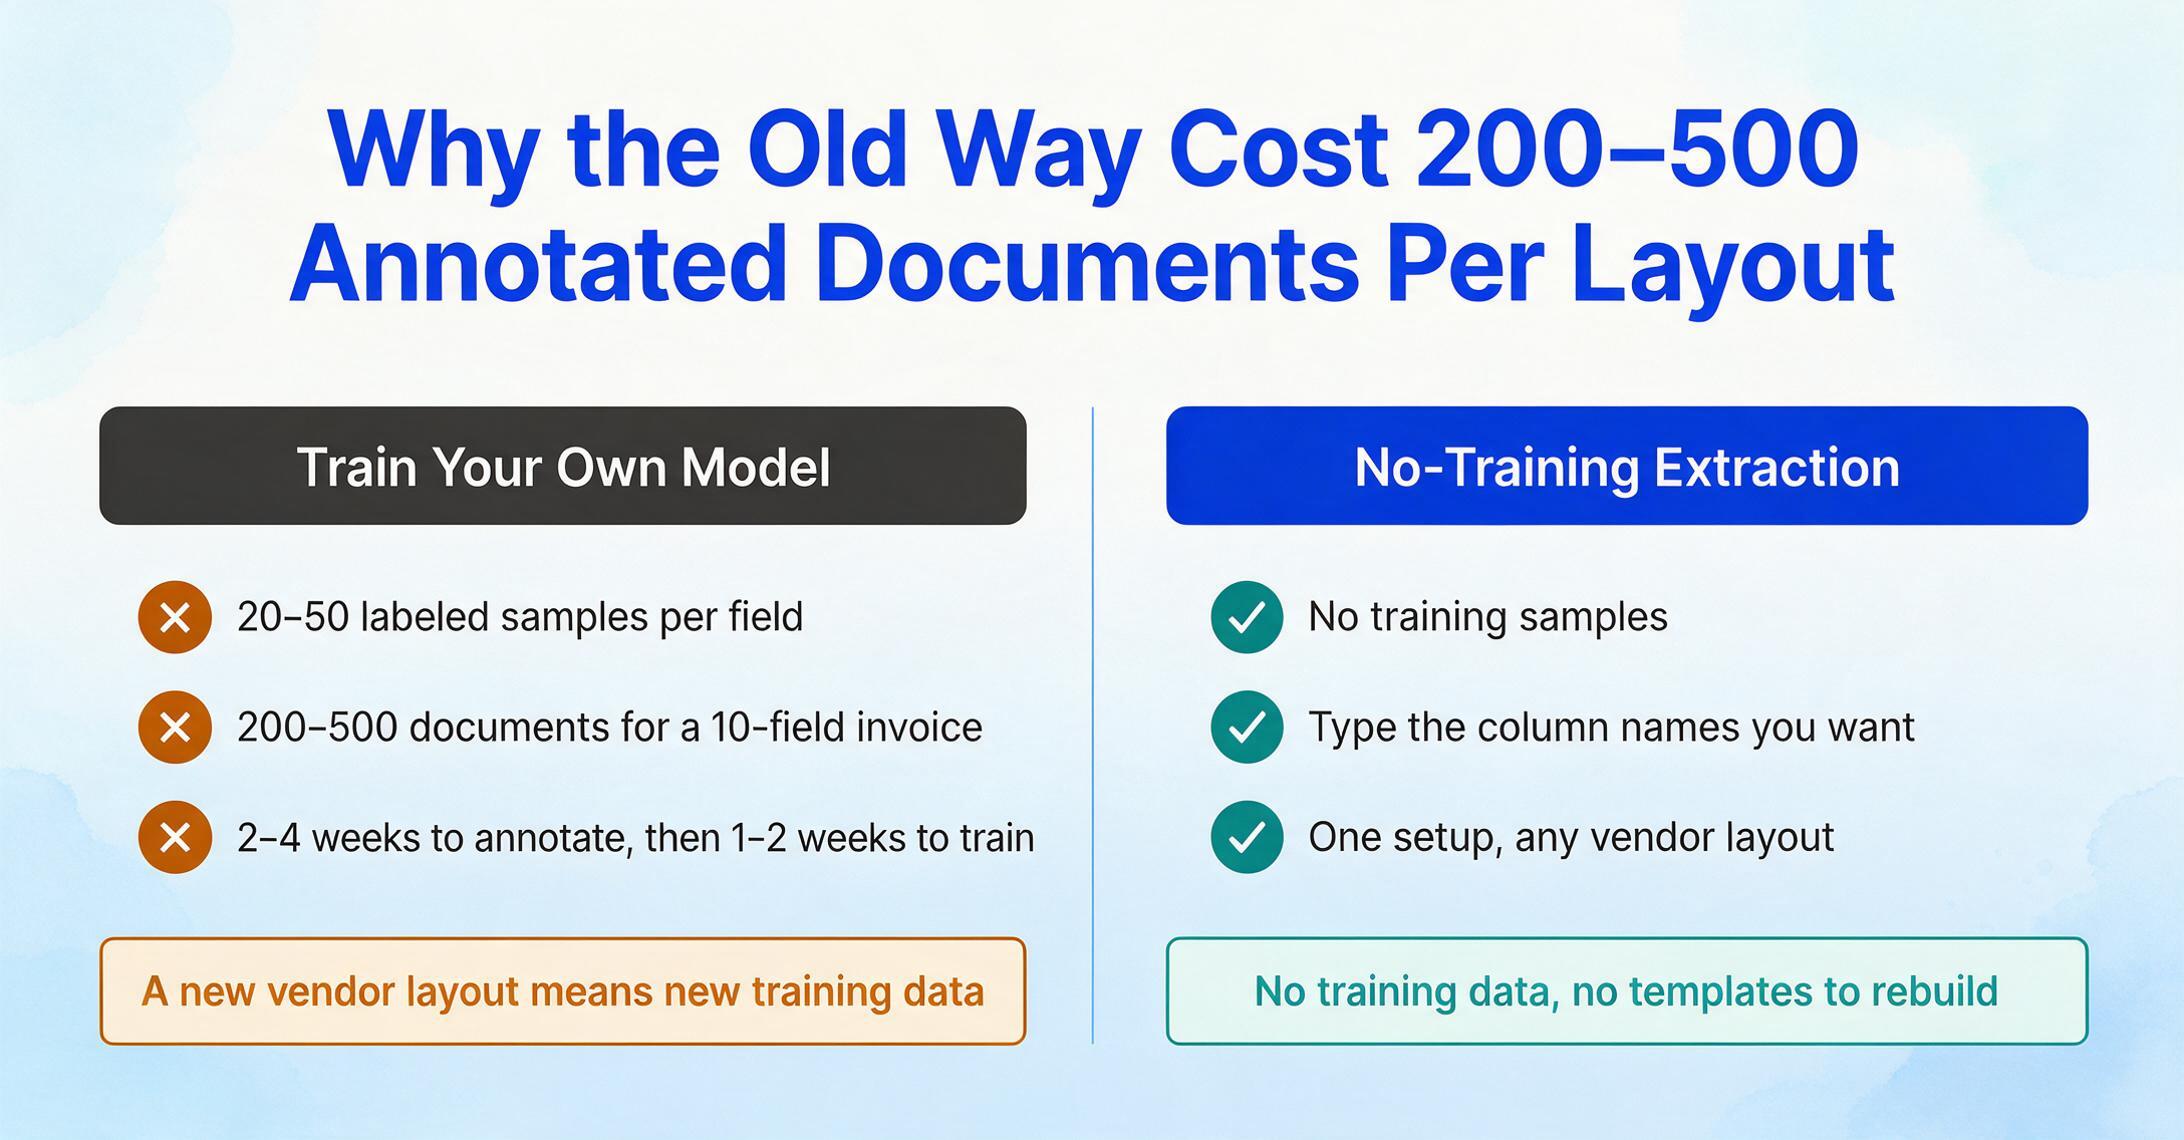
Para entender qué significa "cero entrenamiento", conviene entender cuánto costaba el entrenamiento antes. Antes de los modelos de lenguaje visual, la extracción de documentos funcionaba con una arquitectura de dos capas: OCR para convertir imágenes en texto y clasificadores de aprendizaje automático para asignar texto a campos. La capa de OCR se encargaba del reconocimiento de caracteres. La capa de ML se encargaba de todo lo demás, y era la parte costosa.
Entrenar un modelo de ML tradicional para extracción de documentos implicaba alimentarlo con ejemplos etiquetados: cientos de documentos donde una persona había marcado manualmente qué fragmento de texto era el número de factura, cuál era la fecha, cuál era el total. La propia documentación de UiPath especifica de 20 a 50 muestras etiquetadas por campo habitual, por lo que una plantilla de factura con 10 campos requiere de 200 a 500 documentos anotados antes de que el modelo alcance una precisión de nivel de producción. Para campos de columna como tablas de líneas de detalle, el requisito aumenta a de 50 a 200 documentos por columna. Y eso para un solo formato de documento. Un nuevo proveedor con un formato de factura diferente implica nuevos datos de entrenamiento, o aceptar una precisión menor de un modelo estirado entre formatos para los que no fue optimizado.
El cronograma: de 2 a 4 semanas para recopilar y anotar muestras de entrenamiento, otras 1 a 2 semanas para el entrenamiento y la evaluación del modelo, y un ciclo de mantenimiento continuo donde los nuevos formatos de documento activan un reentrenamiento. El equipo necesario: un anotador de datos que comprendiera el dominio documental, un ingeniero de aprendizaje automático para configurar el pipeline de entrenamiento y un desarrollador para integrar el modelo resultante en un sistema de producción. Tiempo total hasta la primera extracción útil: normalmente de 3 a 6 semanas. Costo total: medido en salario de ingeniería, no en suscripción de software.
Este es el mundo que significaba "extracción de documentos con IA" para cualquiera que la evaluara antes de 2023, y es la razón por la que persiste la suposición de que "esto requiere desarrolladores". La suposición está desactualizada, no es infundada.
El cambio: Cómo la IA lee documentos hoy sin entrenamiento previo
La tecnología que cambió la economía de la extracción de documentos es el modelo de lenguaje visual (VLM, por sus siglas en inglés) — una clase de IA que procesa documentos como lo haría un humano: observando la página completa y comprendiendo qué significa cada información, no buscando patrones aprendidos de ejemplos etiquetados.
Un VLM no aprende de tus facturas. Fue preentrenado con millones de documentos — facturas, recibos, estados de cuenta, contratos, formularios, informes — de distintos diseños, idiomas y calidades. Durante el preentrenamiento, el modelo aprendió a asociar patrones visuales con roles semánticos: un número en negrita en la esquina inferior derecha junto a la palabra "Total" es el monto adeudado. Una fecha cerca del inicio con el formato "Fecha de factura: DD/MM/AAAA" es la fecha de la factura. Una columna etiquetada "Cant." junto a "Precio unitario" indica la cantidad — y el número siguiente multiplicado por el precio unitario es el total del renglón. El modelo aprendió estas asociaciones al verlas millones de veces en millones de documentos, no porque se le dijera qué buscar en tu factura específica.
Esto es lo que realmente significa "cero entrenamiento". El modelo ya entiende facturas, recibos, estados de cuenta, órdenes de compra, contratos y decenas de otros tipos de documentos — no porque tú lo hayas entrenado, sino porque fue preentrenado a gran escala en comprensión visual de documentos. Cuando subes tu primera factura, el modelo no está aprendiendo. Está aplicando lo que ya sabe a un documento que nunca ha visto. El mismo mecanismo funciona con la foto de un recibo arrugado tomada con un teléfono, un PDF escaneado de una impresora multifunción de hace 15 años y una factura digital generada por SAP — diferente calidad visual, misma estructura semántica subyacente.
La diferencia clave: El ML tradicional extrae por coincidencia de patrones — aprende "en la factura de este proveedor, el número de factura siempre está en las coordenadas (x,y)" y falla cuando el diseño cambia. Los VLM extraen por comprensión semántica — identifican el número de factura porque entienden cómo se ve en contexto, sin importar dónde aparezca en la página.
Esta distinción explica por qué las herramientas sin código funcionan desde el primer día sin configuración. Si la extracción requiriera entrenamiento por diseño, necesitarías un desarrollador para crear pipelines de entrenamiento y un experto en el dominio para anotar muestras antes de que la herramienta produjera algo útil. Como los VLM manejan la extracción semánticamente, el único insumo necesario es qué quieres extraer — y eso ya lo sabes.
La investigación de Firstsource sobre procesamiento de documentos con VLM encontró que los pipelines tradicionales de OCR producen tasas de error del 15-20% en la extracción de información debido a fallos en cascada de las etapas separadas de OCR → análisis de diseño → mapeo de campos. Los VLM cierran esta brecha al procesar el diseño visual, el contenido textual y el significado semántico como un solo paso unificado — sin fallos en cascada, sin resultados intermedios que degraden, sin plantillas que mantener cuando un proveedor rediseña el encabezado de su factura.
Para una comparación más profunda de las diferencias técnicas de arquitectura, nuestra introducción a la entrada de datos con IA cubre cómo los VLM difieren del OCR a nivel de mecanismo.
De Nombres de Columnas a Datos Estructurados: Cómo Funciona la Extracción No-Code en la Práctica
Si no necesita entrenar un modelo ni escribir código de integración, ¿qué hace usted? El flujo de trabajo se basa en una única decisión de diseño: en lugar de configurar la entrada (plantillas, zonas, reglas), usted describe la salida. Esto es lo que parece.
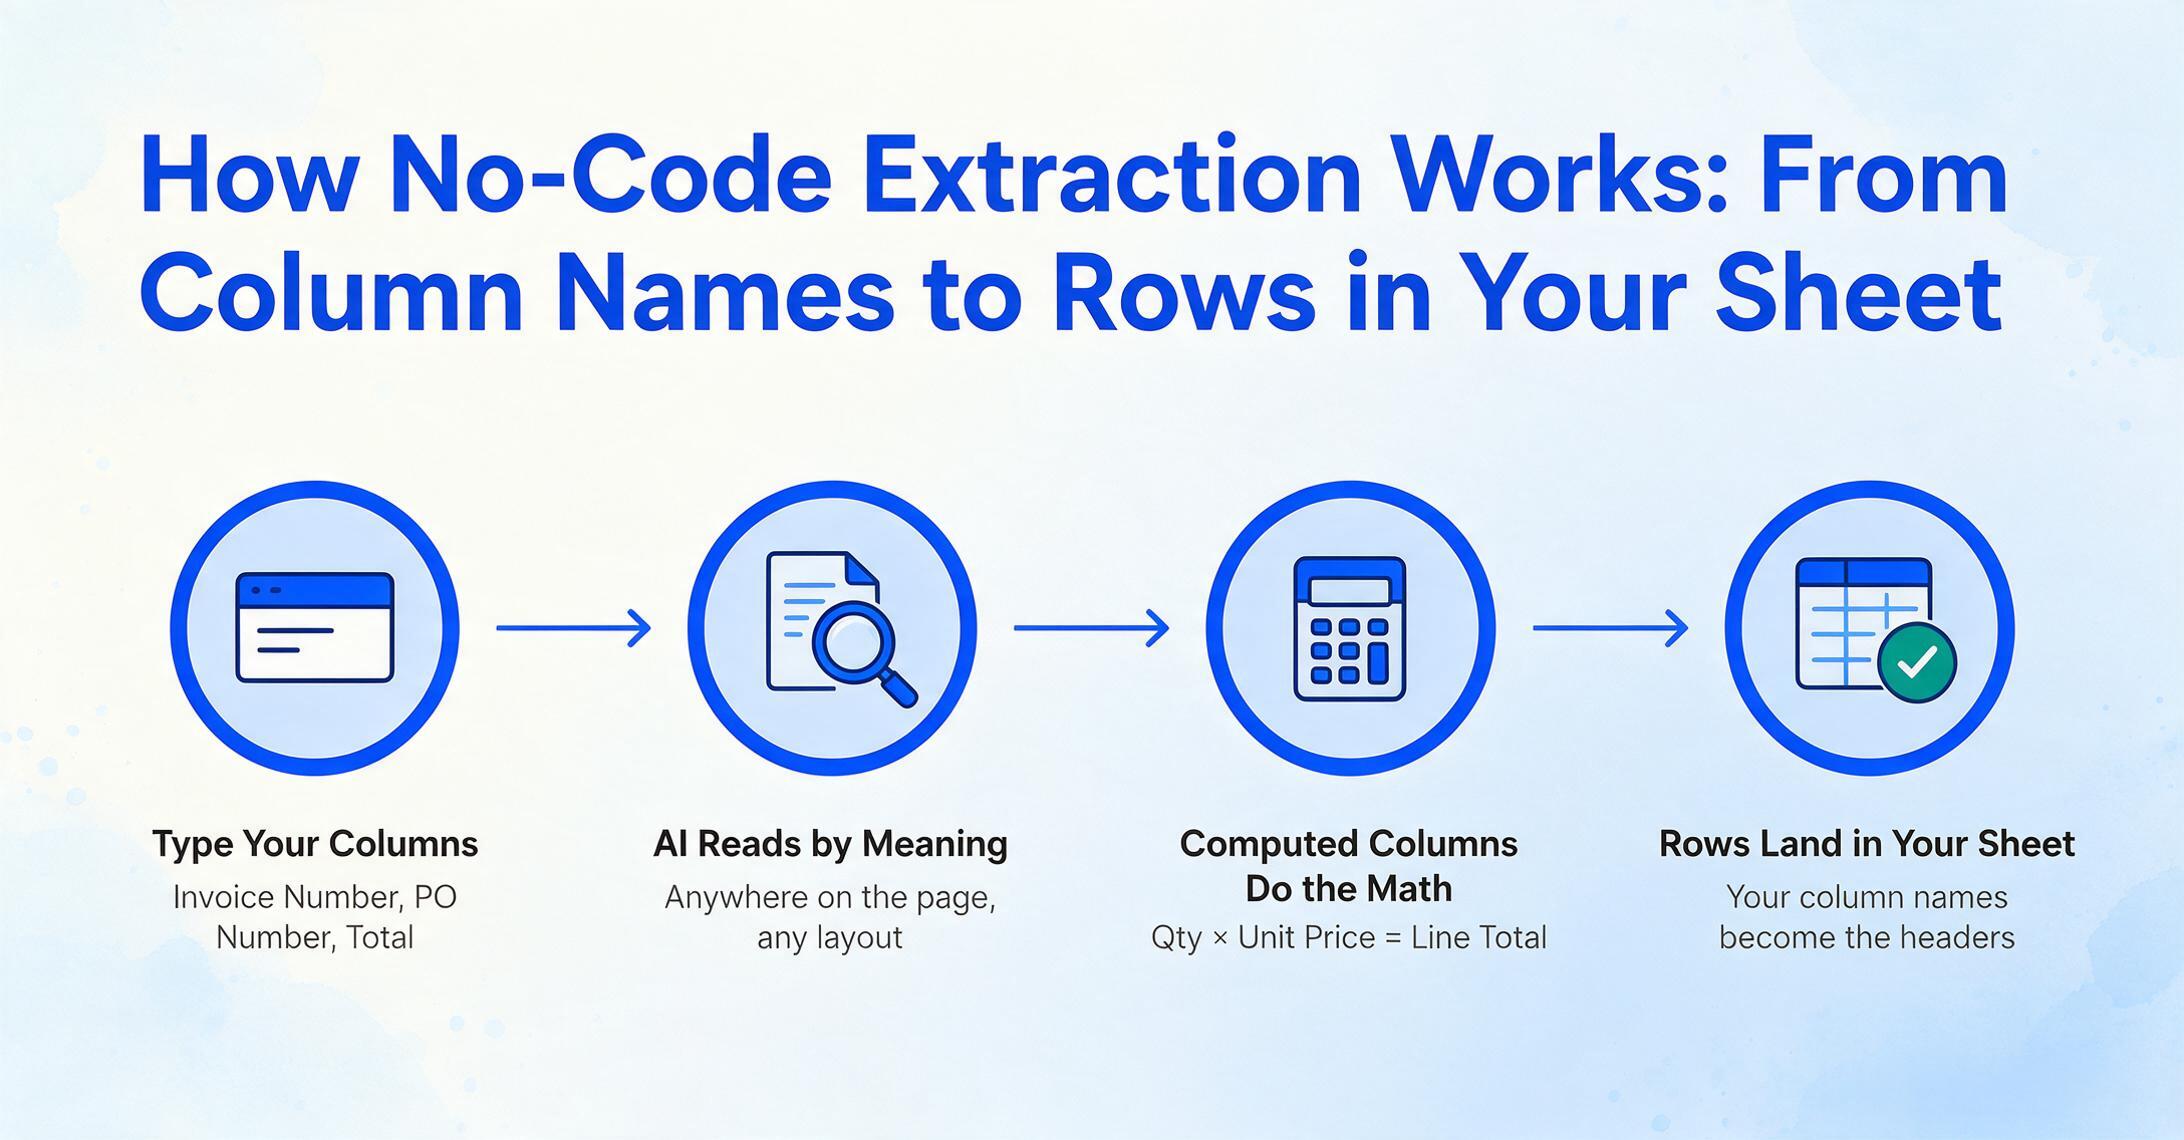
El mecanismo central es la Extracción de Columnas Personalizadas: usted escribe los nombres de los campos que desea en una entrada de texto — "Número de Factura", "Nombre del Proveedor", "Número de PO", "Total", "Fecha de Vencimiento" — y la IA localiza cada valor en cualquier parte del documento al comprender lo que significa semánticamente, no dónde se encuentra. Los nombres de columna que usted escribe se convierten en los encabezados exactos de su hoja de cálculo final. Usted está describiendo la estructura de datos que desea recibir, no el documento que está ingresando.
Esta es la inversión fundamental que hace que la extracción no-code funcione. Las herramientas basadas en plantillas le piden que marque el documento: "dibuje un cuadro alrededor del número de factura aquí, dibuje un cuadro alrededor de la fecha allí". Usted está configurando la herramienta para que comprenda un diseño. La extracción basada en columnas le pide que describa lo que desea: "déme el número de factura, la fecha y el total". La IA maneja el mapeo — en cualquier diseño, de cualquier proveedor, en cualquier formato.
Más allá de la extracción directa de campos impresos, la IA no-code admite dos modos adicionales que amplían lo que puede hacer sin tocar una fórmula ni escribir un script:
columna calculada realizan cálculos durante la extracción y generan el resultado — no datos sin procesar que deba procesar después. Una orden de compra enumera Cantidad y Precio Unitario, pero no imprime el total de línea. Defina una columna llamada Total de Línea (Cant. × Precio Unitario) y la IA extrae ambos valores de origen, los multiplica y escribe el resultado en su hoja de cálculo — en una sola pasada. Sin fórmulas de Excel posteriores a la extracción. El mismo mecanismo maneja la agregación entre filas (sumando todos los elementos de una sección), la lógica condicional (señalando discrepancias entre totales calculados e impresos) y las referencias a parámetros fijos (aplicando una tasa de impuesto que no está en el documento en absoluto).
columna inferida permiten que la IA emita un juicio sobre qué categoría, etiqueta o rótulo aplica a un documento — y lo complete en su hoja de cálculo. Un recibo de un restaurante no dice "Categoría: Comidas". Pero usted necesita categorías de gastos para la contabilidad. Defina una columna llamada Categoría (opciones: Comidas/Transporte/Oficina/Otros). La IA lee cada recibo — un recibo de almuerzo, un recibo de gasolinera, un recibo de suministros de oficina — y determina la categoría correcta. La extracción y la clasificación ocurren simultáneamente, en todo un lote. Las columnas inferidas funcionan de la misma manera en cualquier tipo de documento: señalando pedidos urgentes a partir de notas de entrega, detectando la moneda a partir de facturas internacionales, identificando subtipos de documentos a partir de certificados de seguro.
Estos tres modos — extracción directa, cálculo e inferencia — convergen en una única realidad operativa: usted escribe lo que quiere, sube lo que tiene y recibe una hoja de cálculo estructurada. Sin datos de entrenamiento. Sin editor de plantillas. Sin código.
El procesamiento por lotes amplía esto al volumen. Suba 50 facturas de 15 proveedores diferentes. Escriba los nombres de sus columnas una vez. La IA procesa las 50, identifica cada campo en cada variación de diseño y exporta una sola hoja de cálculo con 50 filas — una por documento — donde cada campo cae en la columna correcta. Lo que tomaba una tarde de entrada manual toma unos minutos de carga y revisión.
Los archivos se procesan de forma segura y no se almacenan.
El Complemento de Google Sheets: Extracción sin Código, Dentro de su Hoja de Cálculo
Si el flujo de trabajo basado en web reduce la barrera de «necesita un desarrollador» a «necesita un navegador», el complemento de Google Sheets la reduce aún más: a «no necesita salir de la herramienta en la que ya trabaja».
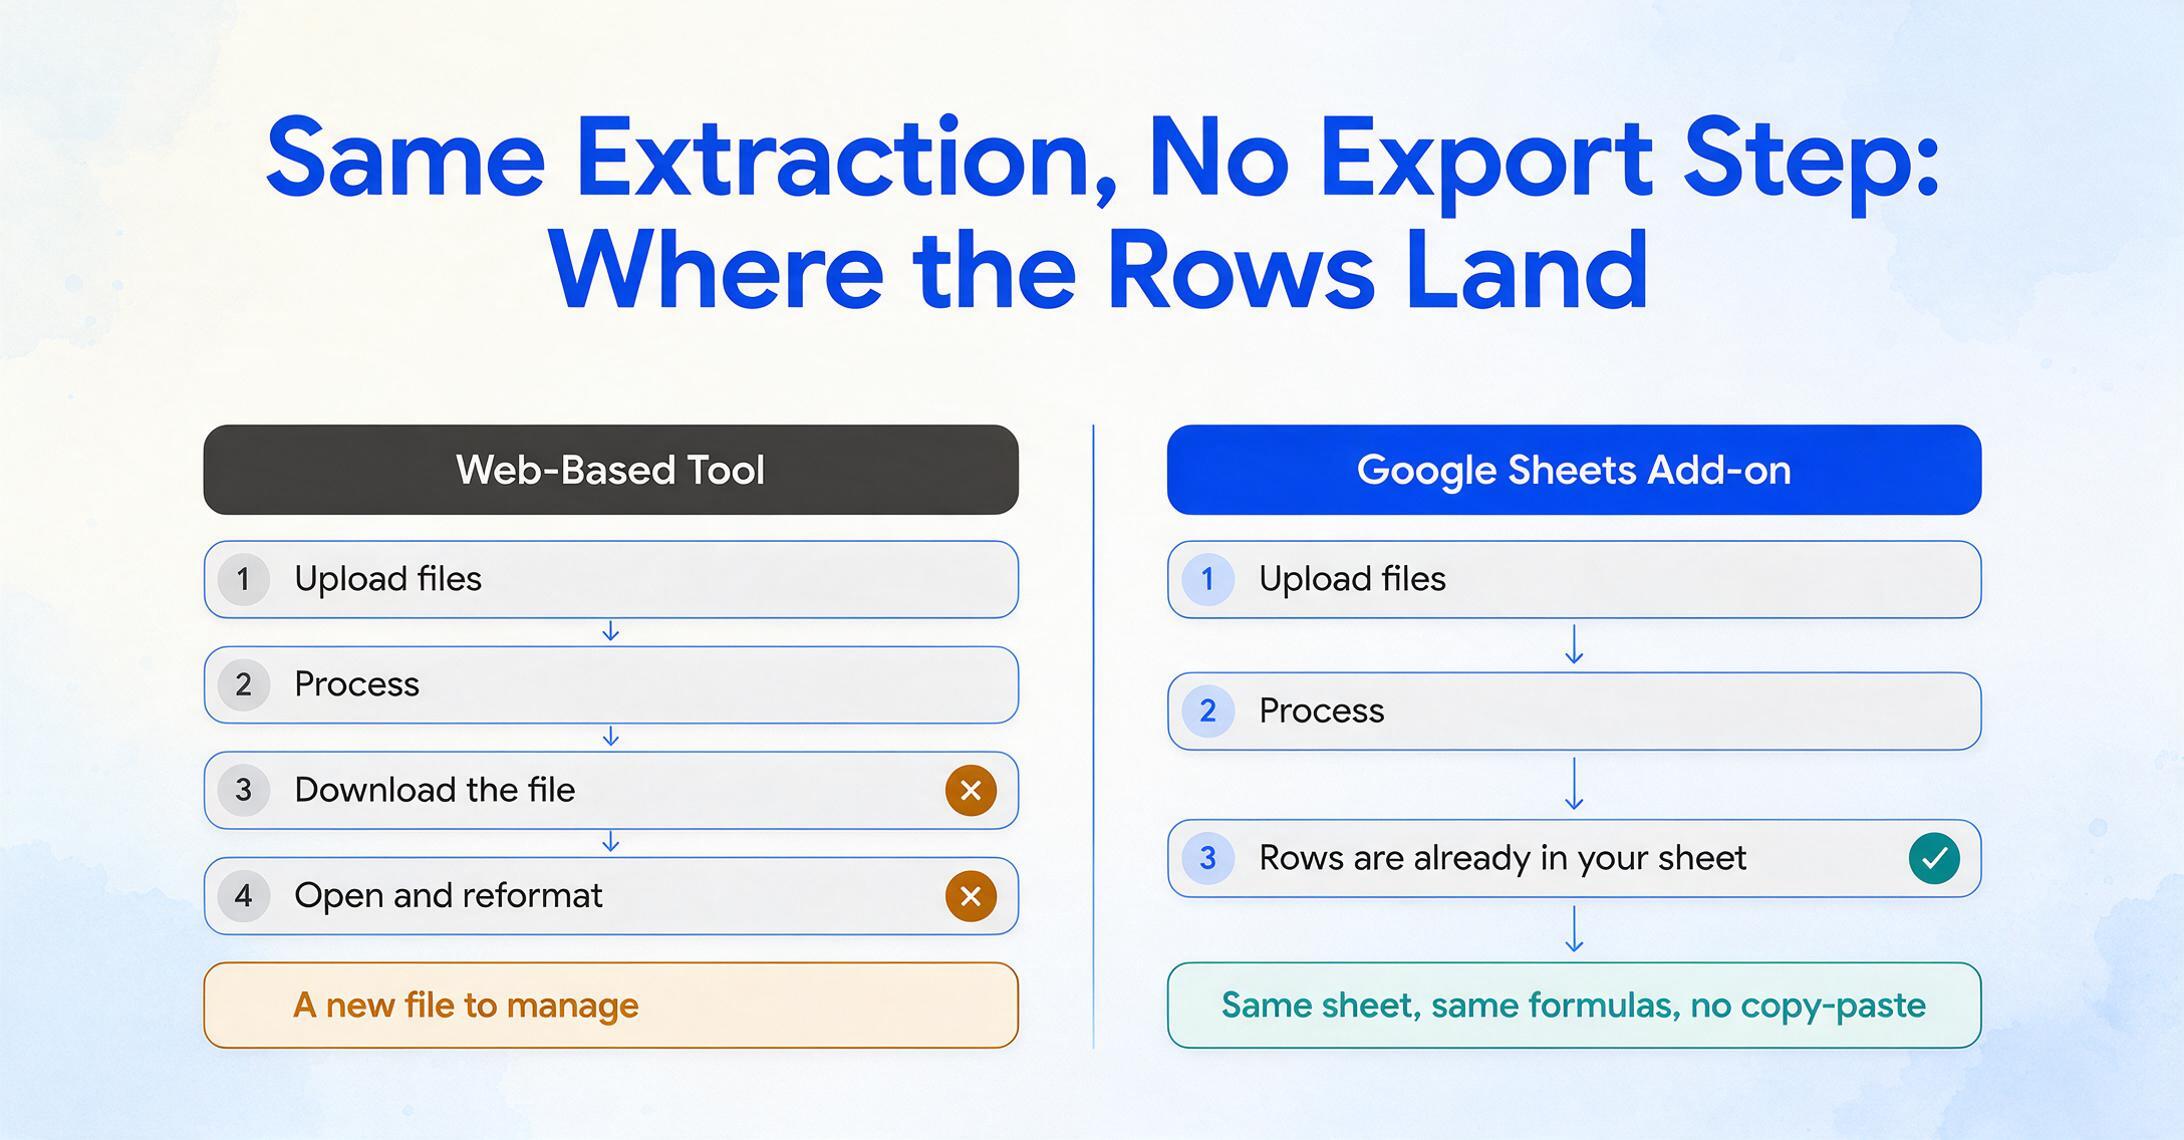
El complemento de Google Sheets de ImageToTable.ai es un panel lateral que vive dentro de su hoja de cálculo. Ábralo, suba imágenes o PDFs, escriba los nombres de sus columnas, y los datos extraídos se añaden directamente a la hoja activa — filas estructuradas, columnas correctas, sin copiar y pegar. Todo el flujo de trabajo ocurre dentro de Sheets: extraiga datos de facturas, detalles de recibos o transacciones de estados de cuenta bancarios directamente en su hoja de cálculo de trabajo sin cambiar de herramientas, descargar archivos ni reformatear la salida.
Esto importa porque elimina el último punto de fricción en un flujo de trabajo sin código: el paso de exportación. En una herramienta web, usted sube → procesa → descarga → abre el archivo. Con el complemento de Sheets, sube → procesa → los datos ya están en su hoja de cálculo, en la hoja que está usando activamente, junto con sus fórmulas, gráficos y referencias existentes. Para un equipo que procesa facturas de proveedores en una hoja de cálculo de AP compartida, esto significa que el paso de extracción no crea un archivo nuevo que gestionar: añade filas al archivo que todos ya tienen abierto.
El complemento funciona en modo de cuenta: vincule su clave de API una vez y se sincroniza con su panel web: mismo historial, mismas plantillas de columnas guardadas, mismo seguimiento de uso. Sin configuración adicional. Sin nuevo inicio de sesión. El motor de extracción es idéntico al de la versión web; la interfaz es lo único que cambia.
El complemento también permite un flujo de trabajo que ninguna herramienta web puede hacer por sí sola: Enlace de Recopilación. Usted genera un enlace compartible y lo envía a clientes, proveedores o miembros del equipo. Ellos lo abren, ingresan un código de verificación breve y suben documentos directamente, sin registro, sin inicio de sesión, sin herramienta que aprender. Los archivos llegan automáticamente a su cola de procesamiento. Combinado con el complemento de Sheets, esto crea un flujo de trabajo totalmente sin código: otra persona sube los documentos, usted abre su hoja de cálculo y los datos extraídos esperan en su cola de procesamiento, listos para añadirse a su hoja con un clic. Para un análisis más profundo de este flujo, vea cómo los equipos recopilan recibos de gastos de empleados en una Google Sheet compartida sin configuración por empleado.
Quiénes se benefician más — y quiénes podrían necesitar más
La extracción de IA sin código no sirve a todos por igual. Está optimizada para un perfil específico, y saber si usted encaja en ese perfil es más útil que una lista de funciones.
Los equipos de operaciones y contabilidad son los más adecuados. Procesan documentos a diario, saben exactamente qué datos necesitan de cada tipo de documento y ya trabajan con hojas de cálculo. El salto de la entrada manual a la extracción sin código se mide en minutos, porque la interfaz les pide que hagan lo que ya hacen mentalmente («Necesito número de factura, fecha y total de esta pila de facturas») y automatiza la parte física (encontrar cada valor y escribirlo en la celda correcta). El impacto en los flujos de trabajo contables es inmediato porque el cuello de botella —la transcripción manual de campos— es lo que la herramienta reemplaza.
Los propietarios de pequeñas empresas que gestionan su propia contabilidad obtienen un beneficio desproporcionado de la extracción sin código. No tienen el volumen para justificar un empleado de AP dedicado ni el presupuesto para contratar a un desarrollador para automatización personalizada. Procesar de 20 a 50 facturas al mes manualmente es lento y propenso a errores; procesarlas con IA sin código toma menos de 10 minutos. La matemática de costos es diferente a la empresarial: no se trata de reemplazar un equipo, sino de recuperar una tarde cada mes que se dedicaba a la entrada manual de datos.
Cualquiera que gestione un proceso de recopilación de documentos —recopilar formularios firmados de clientes, recibos de gastos de empleados o informes de inspección del personal de campo— se beneficia de la combinación de Enlace de Recopilación y extracción sin código. El lado de la recopilación elimina la necesidad de que los participantes instalen algo o creen cuentas. El lado de la extracción elimina la necesidad de que el recopilador transcriba manualmente cada envío. Juntos convierten «recopilar documentos → ingresar datos → archivar» en «compartir enlace → revisar hoja de cálculo → listo».
Los equipos que necesitan una API se encuentran al otro lado de la división arquitectónica. Si los datos extraídos deben fluir automáticamente hacia una base de datos, un ERP u otra aplicación sin revisión humana, un enfoque basado en API es la opción adecuada. El marco de decisión es sencillo: si los datos llegan a una hoja de cálculo que una persona revisa, la solución sin código es suficiente. Si los datos activan lógica empresarial de forma programática, necesita una API. Nuestra comparación de arquitecturas API vs. sin código analiza las cuatro preguntas que determinan qué camino se adapta a su equipo.
Organizaciones con documentos altamente especializados — formularios internos propietarios, presentaciones regulatorias específicas de la industria con convenciones de diseño únicas, documentos en idiomas de nicho con datos de entrenamiento limitados — pueden encontrar que la precisión sin entrenamiento es menor de lo que necesitan. Esto no es un fallo del enfoque; es una consecuencia de la cobertura del preentrenamiento. Los VLM funcionan mejor en tipos de documentos de los que han visto millones de ejemplos. Para un tipo de documento que existe solo dentro de una empresa, esa exposición no existe — y el entrenamiento personalizado (o una herramienta que lo admita) se convierte en la opción.
Lo que la Extracción de IA sin Entrenamiento No Puede Hacer (Aún)
Ser claro sobre los límites de la extracción sin código es lo que separa una evaluación honesta de un discurso de ventas. Aquí es donde se queda corta.
Tipos de documentos extremadamente especializados o propietarios. Un VLM entrenado con millones de facturas, recibos y estados de cuenta bancarios tiene un profundo entendimiento semántico de esos tipos de documentos. Un formulario interno propietario diseñado por una empresa, no utilizado en ningún otro lugar y con un formato idiosincrásico — el modelo nunca ha visto algo similar. Aun así intentará la extracción, y puede acertar algunos campos (fechas, montos, nombres — cosas que se parecen a lo que conoce), pero la precisión será notablemente menor que en los tipos de documentos estándar. Si su flujo de trabajo se centra en un formato de documento personalizado sin equivalente en la industria, espere verificar más campos por documento.
Diseños complejos de varias páginas con dependencias entre páginas. Una tabla que se extiende a lo largo de tres páginas con celdas combinadas, filas divididas y totales acumulados que hacen referencia a valores de una página anterior — esto aún supone un desafío para los VLM. El modelo procesa las páginas de forma independiente y no mantiene una memoria continua de "esta línea comenzó en la página 2 y continúa a través del salto de página hasta la página 3". La continuidad simple entre páginas (una tabla de transacciones que continúa limpiamente de una página a la siguiente) se maneja bien. La lógica de extensión compleja — donde un solo dato depende de agregar valores en páginas no contiguas — produce errores en un porcentaje significativo de casos y requiere revisión humana.
Información puramente gráfica. Si un documento comunica datos exclusivamente a través de gráficos, diagramas o elementos visuales codificados por color sin etiquetas de texto, no hay nada que la IA pueda extraer. La altura de un gráfico de barras no se traduce a un valor numérico sin un eje etiquetado. Una leyenda de colores que asigna significado a tonos de azul sin etiquetas de texto no es interpretable. Los documentos que combinan texto y elementos visuales — un informe con una tabla de datos y un gráfico — funcionan solo para la parte de la tabla.
Calidad de entrada severamente degradada. Un escaneo limpio a 300 DPI de una factura impresa se acercará al 99% de precisión. Una foto de un recibo térmico desvanecido tomada en ángulo con poca luz — la precisión disminuye. El VLM compensa problemas de calidad moderados (ligero desenfoque, inclinación, iluminación desigual), pero cuando los caracteres se vuelven genuinamente ambiguos para un lector humano, la IA también tendrá dificultades. La puntuación de confianza — donde la herramienta marca campos de baja certeza para revisión manual — mitiga esto pero no lo elimina.
La distribución honesta: la IA sin código maneja el 80% de los documentos que son limpios, legibles y estructuralmente claros con alta precisión. Maneja el siguiente 15% — problemas de calidad moderados, diseños poco comunes, escritura a mano ligera — con precisión utilizable pero no perfecta. El último 5% — escaneos muy degradados, escritura a mano superpuesta, documentos puramente gráficos, formularios propietarios sin equivalente en la industria — aún requiere atención humana. Para un desglose detallado de lo que afecta la precisión de extracción en diferentes tipos de documentos, nuestra guía práctica de precisión cubre las variables que importan.
Preguntas Frecuentes
¿La extracción con IA sin código realmente funciona sin entrenamiento ni configuración?
Sí, para tipos de documentos comunes — facturas, recibos, estados de cuenta bancarios, órdenes de compra, contratos y la mayoría de documentos comerciales con diseños estándar. La IA fue preentrenada con millones de estos documentos y comprende su estructura semántica de fábrica. Usted escribe los nombres de las columnas que desea, sube sus archivos y la IA encuentra los datos. Sin muestras de entrenamiento, sin configuración de plantillas, sin preparación más allá de describir lo que desea extraer. Para formatos de documentos altamente especializados o propietarios sin equivalente en la industria, espere menor precisión — el modelo no ha visto suficientes ejemplos de ese formato durante el preentrenamiento para tener una comprensión semántica sólida del mismo.
¿En qué se diferencia esto del OCR tradicional con plantillas?
El OCR tradicional con plantillas requiere que usted configure la entrada: dibuje zonas alrededor de cada campo en un documento de muestra y luego espere que esas zonas coincidan con el diseño del siguiente documento. Cuando un proveedor cambia el formato de su factura, la plantilla se rompe y necesita reconstruirse. La extracción con IA sin código funciona al revés: usted configura la salida (qué columnas desea) y la IA asigna campos a columnas comprendiendo qué significan, no dónde están ubicados. Una fecha en la esquina superior derecha de una factura y en la inferior izquierda de otra ambas llegan a la columna «Fecha» — porque la IA las identifica como fechas semánticamente, no por posición. Esto también significa que no necesita plantillas separadas para el formato de factura de cada proveedor. Una sola configuración de columnas funciona en todos los diseños.
¿Cuál es la diferencia entre la extracción sin código y el uso de una API?
La extracción sin código se realiza a través de una interfaz visual — una aplicación web o un complemento de Google Sheets donde usted sube documentos, define columnas y descarga resultados. Está diseñada para personas cuyo trabajo principal es contabilidad, operaciones o logística — no desarrollo de software. La extracción basada en API está diseñada para desarrolladores que desean integrar el procesamiento de documentos en un pipeline automatizado más amplio: los documentos llegan programáticamente, la extracción se realiza mediante endpoints REST y los datos estructurados fluyen hacia bases de datos u otras aplicaciones sin intervención humana. El mismo motor de IA subyacente impulsa ambas. La diferencia es la interfaz y el flujo de trabajo que permite. Para equipos que deciden entre las dos opciones, nuestra comparación entre API y sin código proporciona un marco de decisión basado en volumen, habilidades del equipo y destino de los datos.
¿Puedo procesar varios documentos a la vez sin código?
Sí. El procesamiento por lotes es una parte fundamental del flujo de trabajo sin código. Suba cualquier cantidad de documentos (10, 50, 200), defina los nombres de sus columnas una vez, y la IA los procesa todos, exportando una sola hoja de cálculo donde cada fila es un documento y cada columna es un campo extraído. El lote combina los resultados de todos los documentos sin importar las diferencias de formato, de modo que 50 facturas de 15 proveedores distintos generan filas en la misma tabla de salida con los campos en las mismas columnas.
¿Funciona con documentos manuscritos?
La escritura legible en formularios estructurados —un formulario impreso llenado a mano, un albarán con cantidades manuscritas— se maneja bien con la IA moderna. La estructura del formulario proporciona contexto que ayuda al modelo a interpretar el contenido manuscrito. Las notas manuscritas de forma libre, la escritura cursiva rápida con letras muy estilizadas y la escritura superpuesta producen resultados menos fiables. Si sus documentos son predominantemente manuscritos, espere verificar más campos en lugar de procesarlos directamente.
¿Cuánto cuesta la extracción con IA sin código en comparación con la entrada manual de datos?
Las herramientas de extracción con IA sin código suelen tener suscripciones con niveles de precios por página o por documento. Los costos de la entrada manual de datos se miden en mano de obra: con un promedio de 3 minutos por página, procesar 200 documentos al mes consume aproximadamente 10 horas, es decir, alrededor de una cuarta parte de la semana laboral de una persona. Con tasas salariales conservadoras, eso equivale a varios cientos de dólares al mes solo en mano de obra, sin contar el tiempo de corrección de errores. El costo de la suscripción de una herramienta de extracción sin código suele ser una fracción de eso. Nuestro análisis comparativo de costos desglosa los cálculos en diferentes niveles de volumen y tipos de documentos.
¿Qué formatos de documento e idiomas se admiten?
PDF (tanto digitales nativos como escaneados), JPEG, PNG, WebP, AVIF y capturas de pantalla de páginas web. La IA procesa cualquier formato que usted suba: una foto de un recibo tomada con el teléfono funciona igual que un PDF generado por un software de contabilidad. La cobertura de idiomas incluye inglés, japonés, alemán, francés, español, portugués, coreano y chino, entre otros. La calidad de extracción es mayor en los idiomas bien representados en los datos de entrenamiento del modelo, aunque la transferencia interlingüística del VLM hace que maneje idiomas menos comunes mejor que el OCR tradicional entrenado con corpus de un solo idioma.
La extracción con IA sin código cambia quién puede usar la automatización de documentos —no haciendo la tecnología más simple, sino trasladando la complejidad de la configuración al preentrenamiento. El modelo hizo el trabajo difícil de aprender cómo es una factura antes de que usted abriera la herramienta. Lo que queda para usted es describir lo que quiere obtener de sus documentos —lo cual, si es la persona que los procesa todos los días, ya sabe.