Inserção de Dados por IA Sem Código:
Extraiga Dados de Documentos Sem Treinar um Modelo
A maioria das pessoas que ouye sobre extração de documentos por IA presume a mesma coisa: que em algum lugar por trás da interface, alguém treinou um modelo com milhares de faturas rotuladas, que levou semanas para implantar e que exigiu um engeniero de machine learning para configurar. Essa suposição era correta — até cerca de dois anos atrás. A categoria se dividiu. Um caminho ainda exige dados de treinamento anotados, ciclos de treinamento de modelos e equipes técnicas. O outro caminho exige que você digite os nomes das colunas que deseja e envie seus documentos. Este artigo trata do segundo caminho — o que o torna possível, como funciona no dia a dia e onde deixa de ser suficiente.
Principais Conclusões
- Você presume que a extração de documentos por IA exige um desenvolvedor e 500 muestras de treinamento rotuladas — isso era verdade até 2023, mas a tecnologia mudou e a suposição ainda não se atualizó.
- A IA não aprende de seus documentos — ela já sabe como é um número de fatura por ter visto milhões de documentos durante o pré-treinamento, o que significa que extrae pelo significado em vez da posição.
- ImageToTable.ai substituye semanas de treinamento de modelos por uma única pregunta — que colunas você deseja em sua planilha — e coloca dados estruturados lá no mesmo dia em que você começa.
A forma antigua: por qué a extração de documentos exigía desenvolvedores e dados de treinamento
Para entender o que significa "zero treinamento", ajuda saber o que o treinamento costava antes. Antes dos modelos de linguagem visual, a extração de documentos funcionava em uma arquitetura de duas camadas: OCR para converter imagens em texto e classificadores de aprendizado automático para mapear texto em campos. A camada OCR cuidava do reconhecimento de caracteres. A camada de ML cuidava de todo o resto — e era a parte cara.
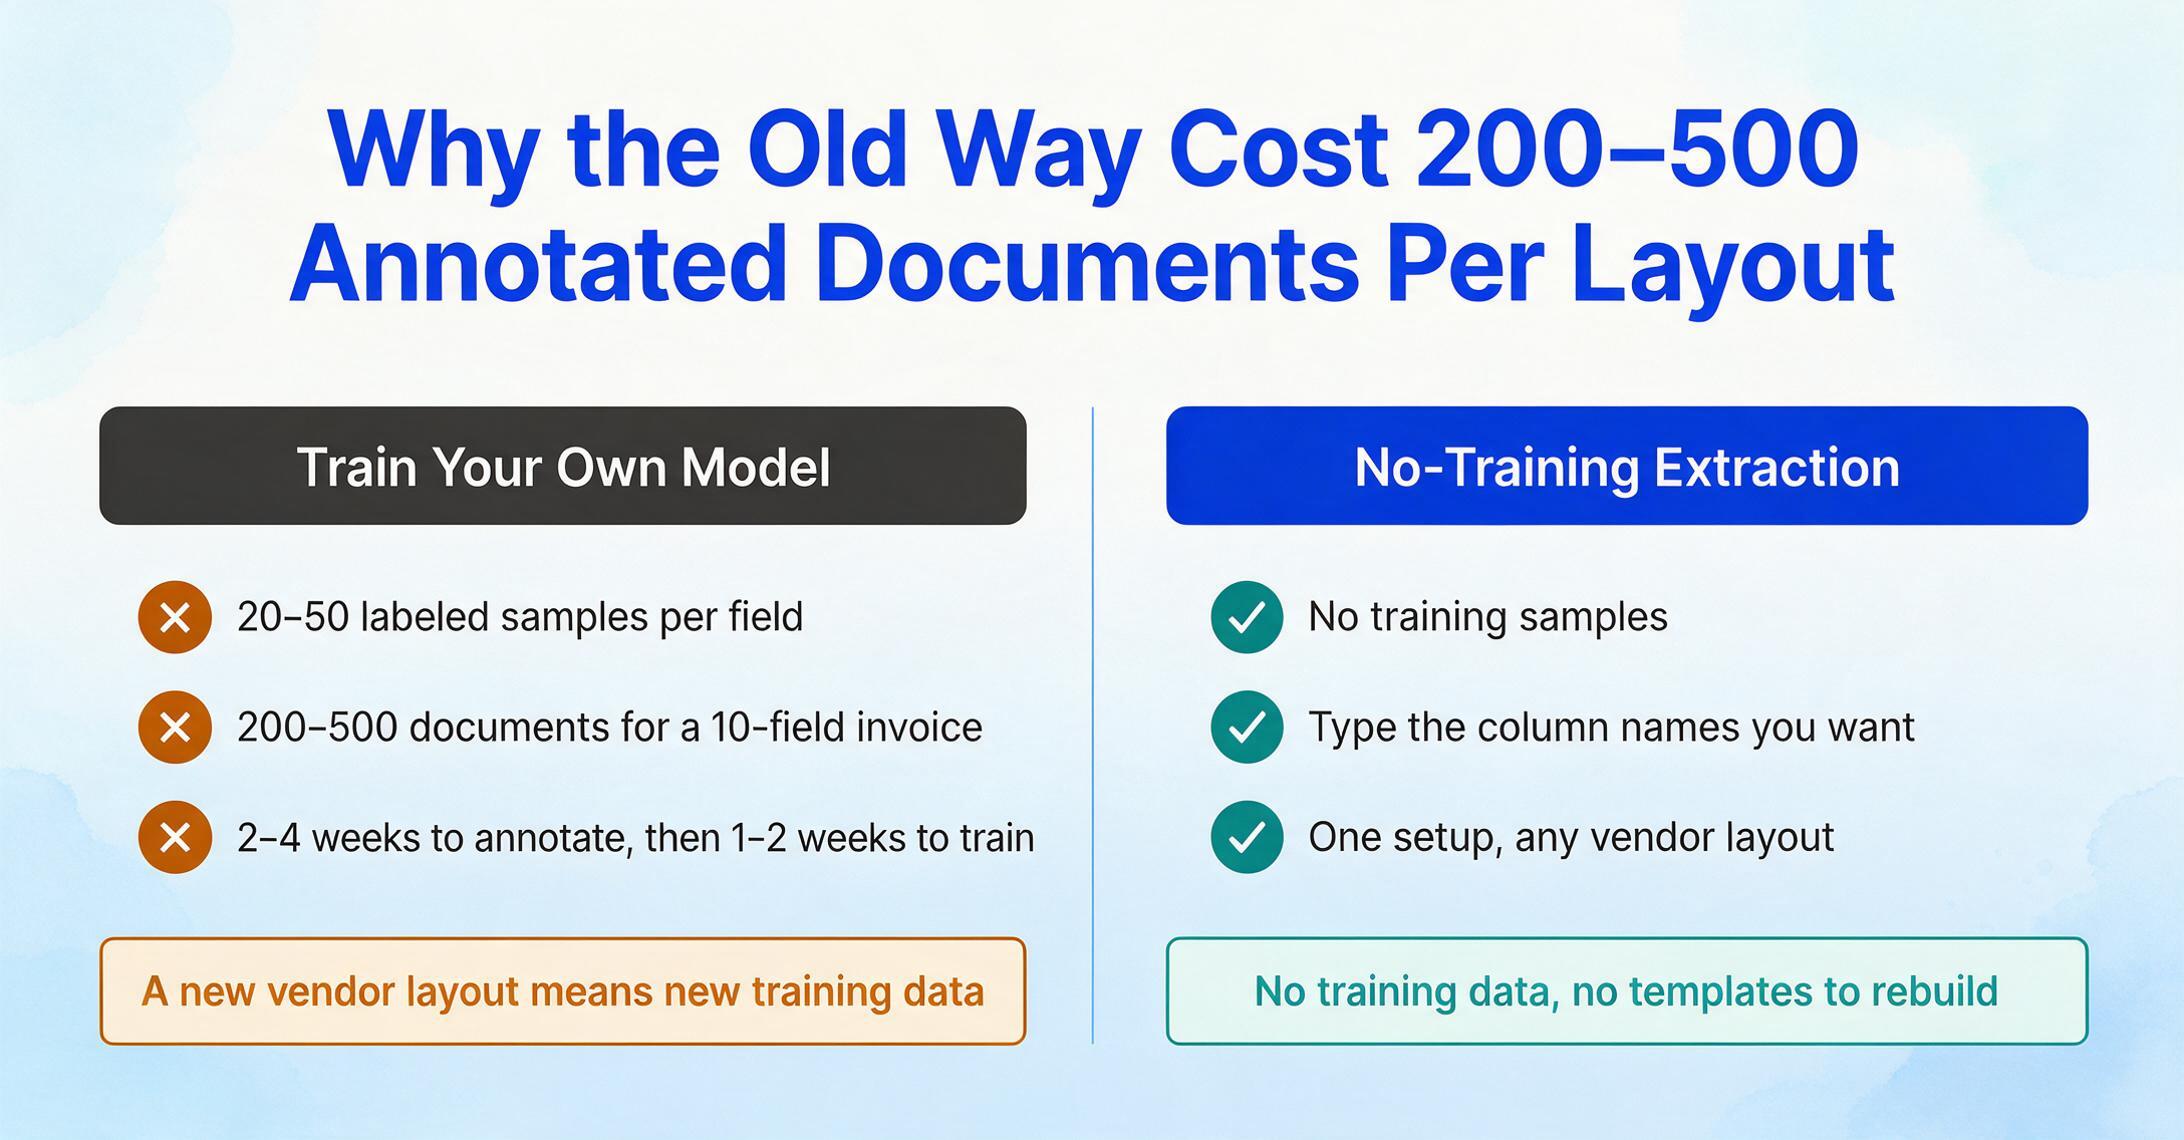
Treinar um modelo de ML tradicional para extração de documentos significava alimentá-lo com exemplos rotulados: centenas de documentos onde um humano havia marcado manualmente qual texto era o número de fatura, qual era a data, qual era o total. A própria documentação da UiPath especifica 20 a 50 exemplos rotulados por campo regular — portanto, um modelo de fatura com 10 campos exige de 200 a 500 documentos anotados antes de que o modelo alcance precisão de nível de produção. Para campos de columna como tabelas de itens de linha, o requisito salta a 50 a 200 documentos por columna. E isso é para um único layout de documento. Um novo fornecedor com um formato de fatura diferente significa novos dados de treinamento, ou aceitar menor precisão de um modelo estirado entre layouts para os quais não foi otimizado.
O cronograma: de 2 a 4 semanas para coletar e anotar exemplos de treinamento, outras 1 a 2 semanas para treinamento e avaliação do modelo, e um ciclo de manutenção contínua onde novos layouts de documento disparam re-treinamento. A equipe necessária: um anotador de dados que entendesse o domínio do documento, um engeniero de aprendizado automático para configurar o pipeline de treinamento, e um desenvolvedor para integrar o modelo resultante em um sistema de produção. Tempo total até a primeira extração útil: normalmente de 3 a 6 semanas. Custo total: medido em salário de engeniería, não em assinatura de software.
Este é o mundo que "extração de documentos com IA" significava para qualquer pessoa que a avaliara antes de 2023 — e é a razão pela qual a suposição "isto exige desenvolvedores" persiste. A suposição está desatualizada, não infundada.
A Mudança: Como a IA Lê Documentos Hoje Sem Qualquer Treinamento
A tecnologia que mudou a economia da extração de documentos é o modelo de linguagem visual (VLM) — uma classe de IA que processa documentos como um humano: olhando a página inteira e entendendo o que cada informação significa, não combinando padrões aprendidos de exemplos rotulados.
Um VLM não aprende com suas faturas. Ele foi pré-treinado em milhões de documentos — faturas, recibos, extratos bancários, contratos, formulários, relatórios — em diversos layouts, idiomas e níveis de qualidade. Durante o pré-treinamento, o modelo aprendeu a associar padrões visuais a papéis semânticos: um número em negrito no canto inferior direito de um documento ao lado da palavra "Total" é o valor devido. Uma data perto do topo da página formatada como "Data da Fatura: DD/MM/AAAA" é a data da fatura. Uma coluna chamada "Qtd" ao lado de "Preço Unitário" significa a quantidade — e o número após ela multiplicado pelo preço unitário é o total da linha. O modelo aprendeu essas associações vendo-as milhões de vezes em milhões de documentos, não por ser instruído sobre o que procurar em sua fatura específica.
É isso que "treinamento zero" realmente significa. O modelo já entende faturas, recibos, extratos bancários, ordens de compra, contratos e dezenas de outros tipos de documento — não porque você o treinou, mas porque foi pré-treinado em compreensão visual de documentos em escala massiva. Quando você envia sua primeira fatura, o modelo não está aprendendo. Ele está aplicando o que já sabe a um documento que nunca viu antes. O mesmo mecanismo funciona em uma foto de um recibo amassado tirada com câmera de celular, um PDF escaneado de uma impressora multifuncional de 15 anos atrás e uma fatura digital gerada pelo SAP — qualidade visual diferente, mesma estrutura semântica subjacente.
A diferença central: O ML tradicional extrai por correspondência de padrões — ele aprende "nesta fatura do fornecedor, o número da fatura está sempre nas coordenadas (x,y)" e quebra quando o layout muda. Os VLMs extraem por compreensão semântica — eles identificam o número da fatura porque entendem como um número de fatura se parece em contexto, independentemente de onde aparece na página.
Essa distinção explica por que ferramentas sem código podem funcionar no primeiro dia sem configuração. Se a extração exigisse treinamento por layout, você precisaria de um desenvolvedor para construir pipelines de treinamento e um especialista no domínio para anotar amostras antes que a ferramenta produzisse algo útil. Como os VLMs lidam com a extração semanticamente, a única entrada necessária é o que você quer extrair — e isso é algo que você já sabe.
A pesquisa da Firstsource sobre processamento de documentos baseado em VLM descobriu que pipelines tradicionais de OCR produzem taxas de erro de 15-20% na extração de informações devido às falhas em cascata das etapas separadas de OCR → análise de layout → mapeamento de campos. Os VLMs fecham essa lacuna processando layout visual, conteúdo textual e significado semântico como uma única etapa unificada — sem falhas em cascata, sem saídas intermediárias para degradar, sem modelos para manter quando um fornecedor redesenha o cabeçalho de sua fatura.
Para uma comparação mais aprofundada das diferenças de arquitetura técnica, nossa introdução à entrada de dados por IA aborda como os VLMs diferem do OCR no nível do mecanismo.
De Nomes de Colunas a Dados Estruturados: Como a Extração Sem Código Funciona na Prática
Se você não precisa treinar um modelo ou escrever código de integração, o que você faz? O fluxo de trabalho é construído em torno de uma única decisão de design: em vez de configurar a entrada (modelos, zonas, regras), você descreve a saída. É assim que funciona.
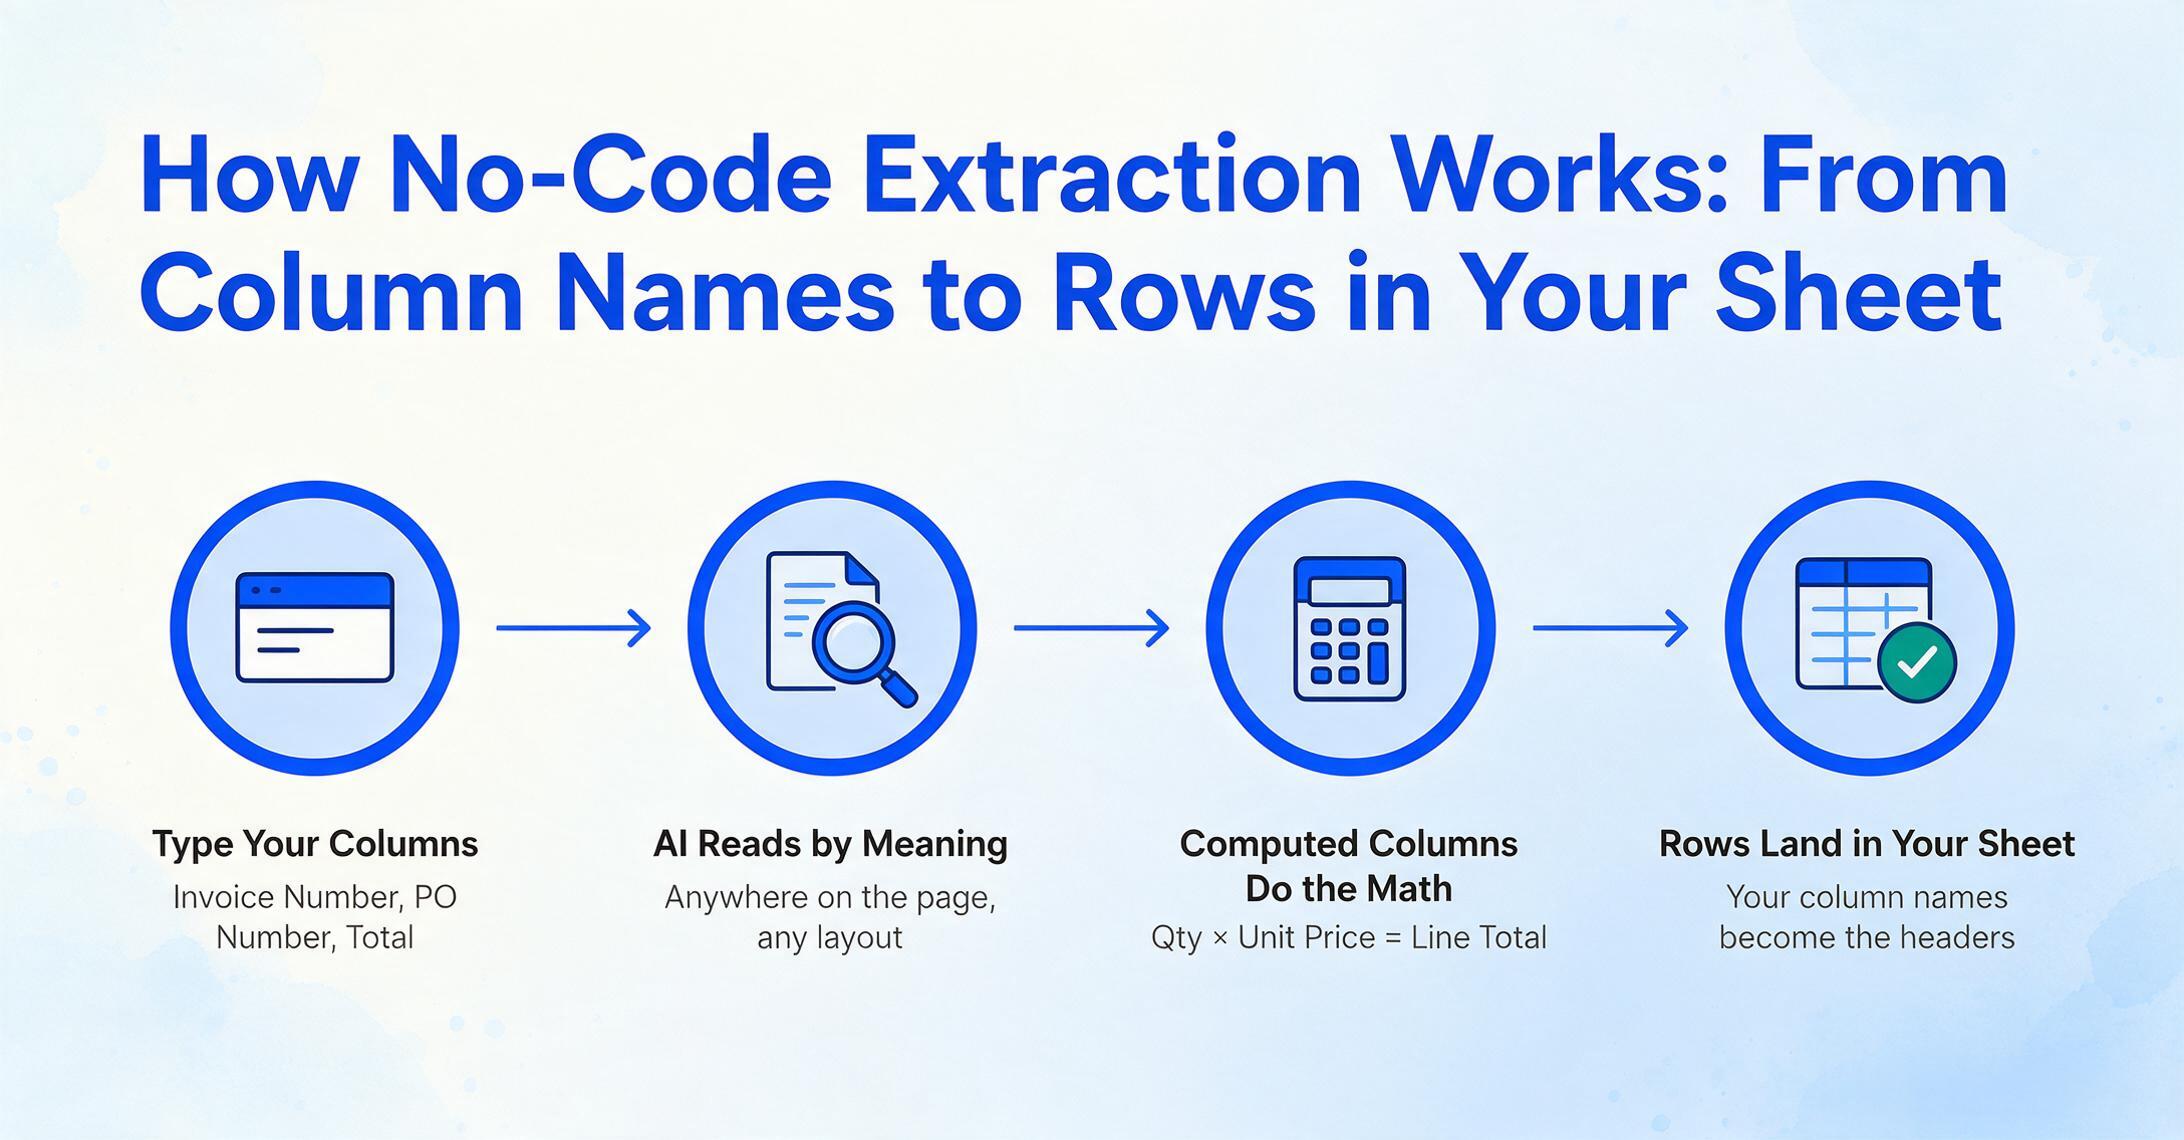
O mecanismo central é a Extração de Colunas Personalizadas: você digita os nomes dos campos desejados em uma entrada de texto — "Número da Fatura", "Nome do Fornecedor", "Número do Pedido", "Total", "Data de Vencimento" — e a IA localiza cada valor em qualquer lugar do documento entendendo o que ele significa semanticamente, não onde está posicionado. Os nomes de colunas que você digita se tornam os cabeçalhos exatos da sua planilha final. Você está descrevendo a estrutura de dados que deseja receber, não o documento que está enviando.
Esta é a inversão fundamental que torna a extração sem código viável. Ferramentas baseadas em modelos pedem que você marque o documento: "desenhe uma caixa ao redor do número da fatura aqui, desenhe uma caixa ao redor da data ali." Você está configurando a ferramenta para entender um layout. A extração baseada em colunas pede que você descreva o que deseja: "me dê o número da fatura, a data e o total." A IA cuida do mapeamento — em qualquer layout, de qualquer fornecedor, em qualquer formato.
Além da extração direta de campos impressos, a IA sem código oferece dois modos adicionais que ampliam o que você pode fazer sem tocar em uma fórmula ou escrever um script:
coluna calculada realiza cálculos durante a extração e gera o resultado — não dados brutos que você precisa processar depois. Um pedido de compra lista Qtd e Preço Unitário, mas não imprime o total da linha. Defina uma coluna chamada Total da Linha (Qtd × Preço Unitário) e a IA extrai ambos os valores de origem, multiplica-os e escreve o resultado na sua planilha — em uma única passada. Sem fórmulas de Excel pós-extração. O mesmo mecanismo lida com agregação entre linhas (somando todos os itens de uma seção), lógica condicional (sinalizando discrepâncias entre totais calculados e impressos) e referências a parâmetros fixos (aplicando uma taxa de imposto que não está no documento).
coluna inferida permite que a IA faça um julgamento sobre qual categoria, tag ou rótulo se aplica a um documento — e preencha isso na sua planilha. Um recibo de restaurante não diz "Categoria: Refeições". Mas você precisa de categorias de despesas para a contabilidade. Defina uma coluna chamada Categoria (opções: Refeições/Transporte/Escritório/Outro). A IA lê cada recibo — um recibo de almoço, um recibo de posto de gasolina, um recibo de material de escritório — e determina a categoria correta. Extração e classificação acontecem simultaneamente, em todo um lote. As colunas inferidas funcionam da mesma forma em qualquer tipo de documento: sinalizando pedidos urgentes em notas de entrega, detectando moeda em faturas internacionais, identificando subtipos de documentos em certificados de seguro.
Esses três modos — extração direta, cálculo e inferência — convergem para uma única realidade operacional: você digita o que quer, envia o que tem e recebe uma planilha estruturada. Sem dados de treinamento. Sem editor de modelos. Sem código.
O processamento em lote estende isso para volume. Envie 50 faturas de 15 fornecedores diferentes. Digite os nomes das colunas uma vez. A IA processa todas as 50, identifica cada campo em cada variação de layout e exporta uma única planilha com 50 linhas — uma por documento — onde cada campo cai na coluna certa. O que levava uma tarde de entrada manual leva alguns minutos de upload e revisão.
Os arquivos são processados com segurança e não são armazenados.
O Complemento do Google Sheets: Extração Sem Código, Dentro da Sua Planilha
Se o fluxo baseado na web reduz a barreira de "você precisa de um desenvolvedor" para "você precisa de um navegador", o complemento do Google Sheets a reduz ainda mais: para "você não precisa sair da ferramenta em que já trabalha".
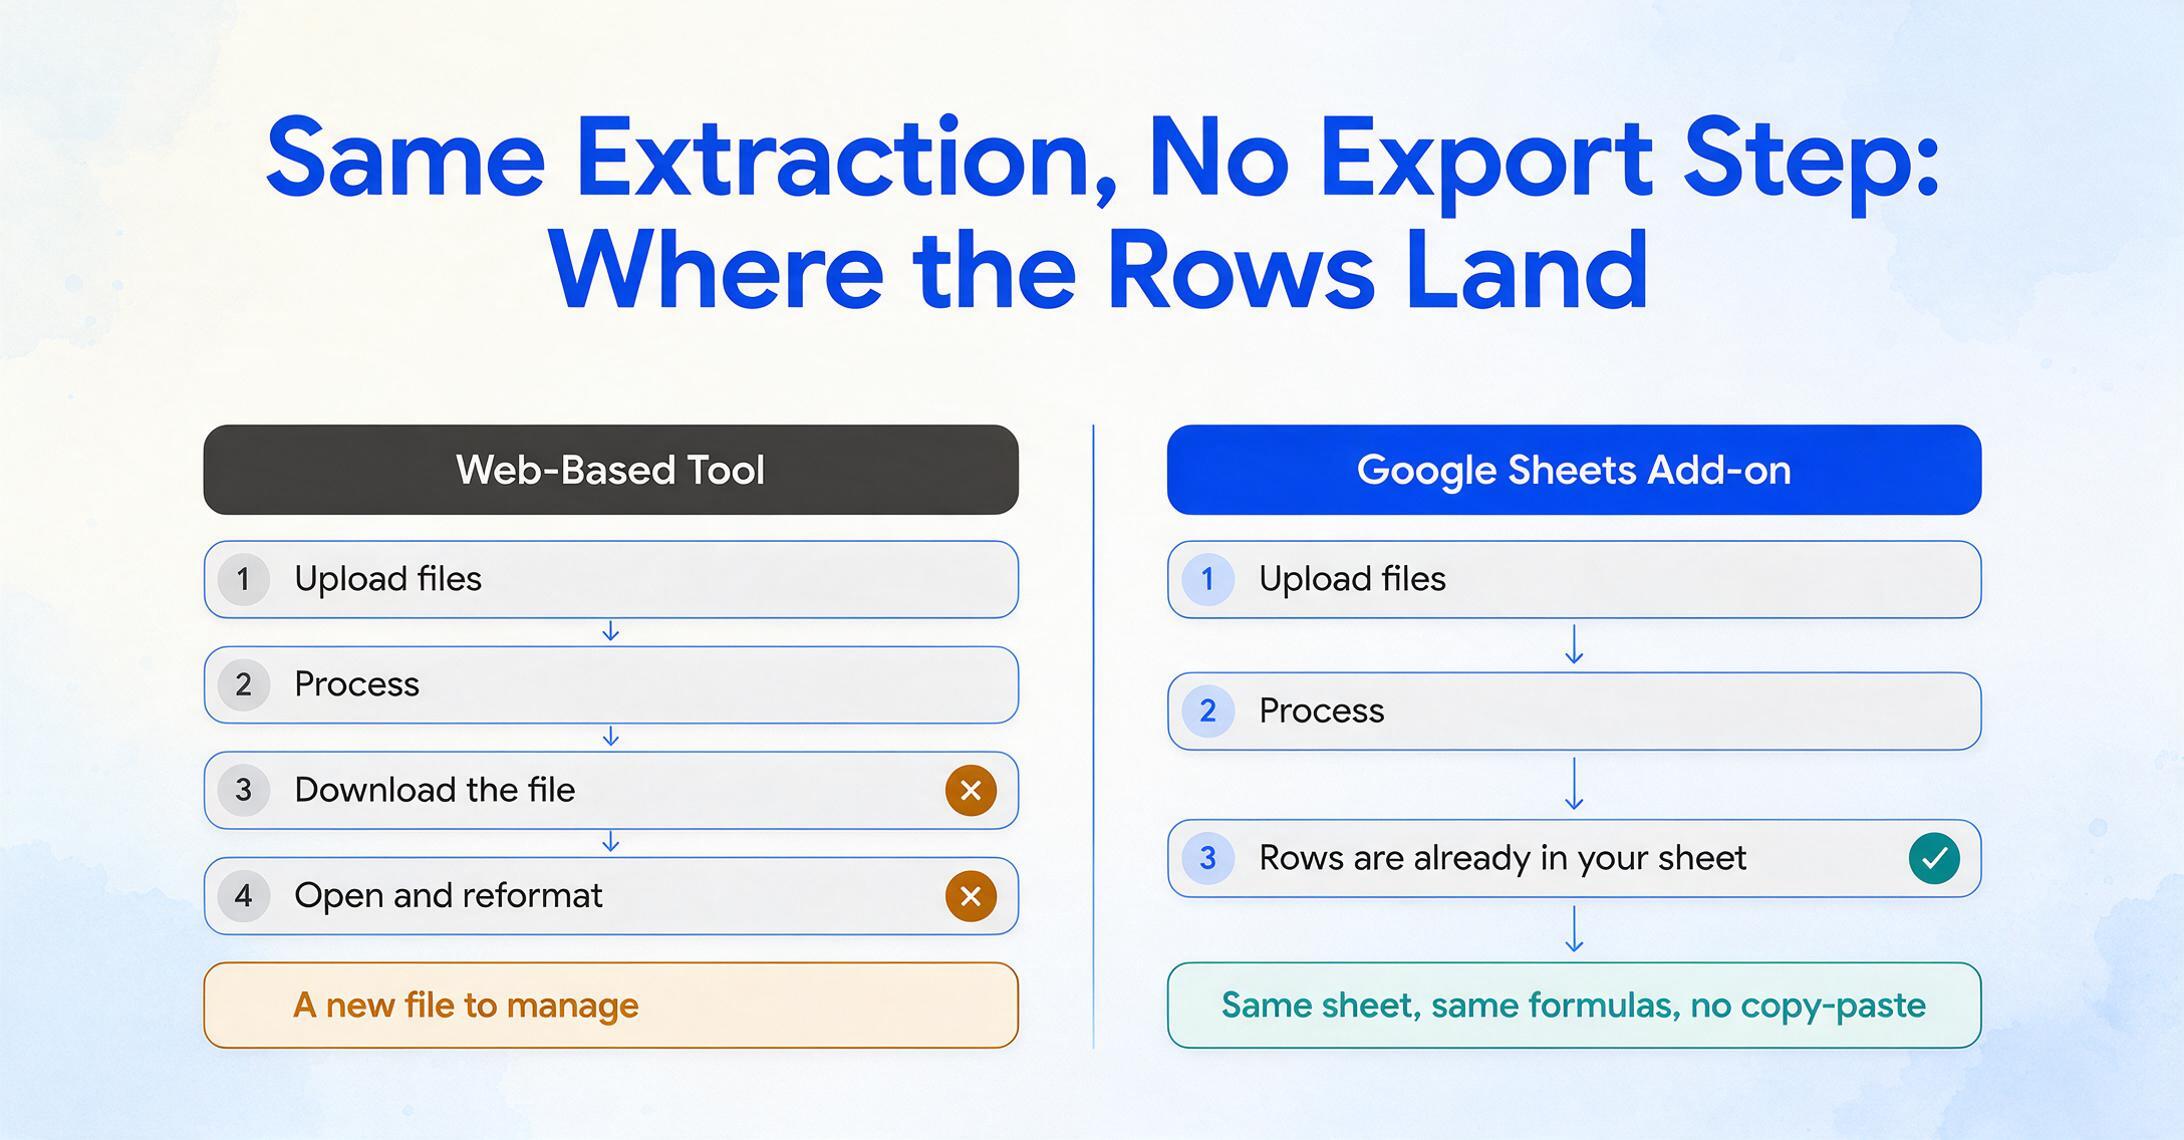
O complemento do Google Sheets do ImageToTable.ai é uma barra lateral que fica dentro da sua planilha. Abra-a, envie imagens ou PDFs, digite os nomes das colunas e os dados extraídos são adicionados diretamente à planilha ativa — linhas estruturadas, colunas corretas, sem copiar e colar. Todo o fluxo de trabalho acontece dentro do Sheets: extraia dados de faturas, detalhes de recibos ou transações de extratos bancários diretamente na sua planilha de trabalho, sem alternar ferramentas, baixar arquivos ou reformatar a saída.
Isso importa porque elimina o último ponto de atrito em um fluxo de trabalho sem código: a etapa de exportação. Em uma ferramenta baseada na web, você envia → processa → baixa → abre o arquivo. Com o complemento do Sheets, enviar → processar → os dados já estão na sua planilha — na folha que você está usando ativamente, junto com suas fórmulas, gráficos e referências existentes. Para uma equipe que processa faturas de fornecedores em uma planilha de contas a pagar compartilhada, isso significa que a etapa de extração não cria um novo arquivo para gerenciar — ela adiciona linhas ao arquivo que todos já têm aberto.
O complemento opera em modo de conta: vincule sua chave de API uma vez, e ele sincroniza com seu painel web — mesmo histórico, mesmos modelos de colunas salvos, mesmo rastreamento de uso. Sem configuração separada. Sem novo login. O mecanismo de extração é idêntico ao da versão web; a interface é a única coisa que muda.
O complemento também permite um fluxo de trabalho que nenhuma ferramenta web consegue fazer sozinha: Link de Coleta. Você gera um link compartilhável e o envia para clientes, fornecedores ou membros da equipe. Eles abrem, inserem um código de verificação curto e enviam documentos diretamente — sem registro, sem login, sem ferramenta para aprender. Os arquivos caem automaticamente na sua fila de processamento. Combinado com o complemento do Sheets, isso cria um pipeline totalmente sem código: outra pessoa envia os documentos, você abre sua planilha, e os dados extraídos já estão esperando na sua fila de processamento — prontos para serem anexados à sua planilha com um clique. Para um olhar mais aprofundado sobre esse fluxo, veja como equipes coletam recibos de despesas de funcionários em um Google Sheet compartilhado com zero configuração por funcionário.
Quem Ganha Mais — E Quem Pode Precisar de Mais
A extração de IA sem código não atende a todos igualmente. Ela é otimizada para um perfil específico, e saber se você se encaixa nesse perfil é mais útil do que uma lista de recursos.
Equipes de operações e contabilidade são o ajuste natural. Elas processam documentos diariamente, sabem exatamente quais dados precisam de cada tipo de documento e já trabalham com planilhas. O salto da entrada manual para a extração sem código é medido em minutos — porque a interface pede que elas façam o que já fazem mentalmente ("preciso de Número da Fatura, Data, Total desta pilha de faturas") e automatiza a parte física (encontrar cada valor, digitá-lo na célula certa). O impacto nos fluxos de trabalho contábeis é imediato porque o gargalo — a transcrição manual de campos — é o que a ferramenta substitui.
Pequenos empresários que cuidam da própria contabilidade obtêm um benefício desproporcional da extração sem código. Eles não têm volume para justificar um funcionário dedicado de contas a pagar nem orçamento para contratar um desenvolvedor para automação personalizada. Processar de 20 a 50 faturas por mês manualmente é lento e propenso a erros; processá-las com IA sem código leva menos de 10 minutos. A matemática de custo é diferente da empresarial — não se trata de substituir uma equipe, mas de recuperar uma tarde todo mês que era gasta com entrada manual de dados.
Qualquer pessoa que gerencia um processo de coleta de documentos — reunindo formulários assinados de clientes, coletando recibos de despesas de funcionários, recebendo relatórios de inspeção de equipe de campo — se beneficia da combinação de Link de Coleta e extração sem código. O lado da coleta elimina a necessidade de os participantes instalarem qualquer coisa ou criarem contas. O lado da extração elimina a necessidade de o coletor transcrever manualmente cada envio. Juntos, eles transformam "coletar documentos → inserir dados → arquivar" em "compartilhar link → revisar planilha → pronto."
Equipes que precisam de uma API estão do outro lado da divisão de arquitetura. Se os dados extraídos precisam fluir automaticamente para um banco de dados, ERP ou outro aplicativo sem revisão humana, uma abordagem com foco em API é a escolha certa. O quadro de decisão é direto: se os dados chegam a uma planilha que um humano revisa, a solução no-code cobre. Se os dados acionam lógica de negócios downstream programaticamente, você precisa de uma API. Nossa comparação entre arquiteturas de API e no-code aborda as quatro perguntas que determinam qual caminho se adequa à sua equipe.
Organizações com documentos altamente especializados — formulários internos proprietários, arquivamentos regulatórios específicos do setor com convenções de layout únicas, documentos em idiomas de nicho com dados de treinamento limitados — podem descobrir que a precisão sem treinamento é menor do que precisam. Isso não é uma falha da abordagem; é uma consequência da cobertura do pré-treinamento. VLMs têm melhor desempenho em tipos de documentos dos quais viram milhões de exemplos. Para um tipo de documento que existe apenas dentro de uma empresa, essa exposição não existe — e o treinamento personalizado (ou uma ferramenta que o suporte) torna-se a opção.
O que a Extração de IA sem Treinamento Não Consegue Fazer (Ainda)
Ser claro sobre os limites da extração no-code é o que separa uma avaliação honesta de um discurso de vendas. Aqui está onde ela fica aquém.
Tipos de documentos extremamente especializados ou proprietários. Um VLM treinado em milhões de faturas, recibos e extratos bancários tem compreensão semântica profunda desses tipos de documentos. Um formulário interno proprietário criado por uma empresa, usado em nenhum outro lugar e formatado de maneira idiossincrática — o modelo nunca viu nada parecido. Ele ainda tentará a extração, e pode acertar alguns campos (datas, valores, nomes — coisas que parecem com o que ele conhece), mas a precisão será visivelmente menor do que em tipos de documentos padrão. Se seu fluxo de trabalho se concentra em um formato de documento personalizado sem equivalente no setor, espere verificar mais campos por documento.
Layouts complexos de várias páginas com dependências entre páginas. Uma tabela que se estende por três páginas com células mescladas, linhas divididas e totais acumulados que referenciam valores de uma página anterior — isso ainda desafia VLMs. O modelo processa páginas de forma independente e não mantém uma memória contínua de "este item de linha começou na página 2 e continua através da quebra de página até a página 3." Continuidade simples entre páginas (uma tabela de transações que continua limpa de uma página para a próxima) é bem tratada. Lógica complexa de extensão — onde um único dado depende da agregação de valores em páginas não contíguas — produz erros em uma porcentagem significativa de casos e precisa de revisão humana.
Informações puramente gráficas. Se um documento comunica dados exclusivamente por meio de gráficos, diagramas ou visuais codificados por cores sem rótulos de texto, não há nada para a IA extrair. A altura de um gráfico de barras não se traduz em um valor numérico sem um eixo rotulado. Uma legenda de cores que atribui significado a tons de azul sem rótulos de texto não é analisável. Documentos que misturam texto e visuais — um relatório com uma tabela de dados e um gráfico — funcionam apenas para a parte da tabela.
Qualidade de entrada severamente degradada. Um scan limpo de 300 DPI de uma fatura impressa se aproximará de 99% de precisão. Uma foto de um recibo térmico desbotado tirada em ângulo com pouca luz — a precisão cai. O VLM compensa problemas moderados de qualidade (leve desfoque, inclinação, iluminação irregular), mas quando os caracteres se tornam genuinamente ambíguos para um leitor humano, a IA também terá dificuldades. A pontuação de confiança — onde a ferramenta sinaliza campos de baixa certeza para revisão manual — mitiga isso, mas não elimina.
A distribuição honesta: a IA sem código lida com os 80% dos documentos que são limpos, legíveis e estruturalmente claros com alta precisão. Ela lida com os próximos 15% — problemas moderados de qualidade, layouts incomuns, caligrafia leve — com precisão utilizável, mas não perfeita. Os últimos 5% — digitalizações altamente degradadas, caligrafia sobreposta, documentos puramente gráficos, formulários proprietários sem equivalente no setor — ainda precisam de atenção humana. Para um detalhamento do que afeta a precisão da extração em diferentes tipos de documento, nosso guia prático de precisão cobre as variáveis que importam.
Perguntas Frequentes
A extração por IA sem código realmente funciona sem treinamento ou configuração?
Sim, para tipos de documentos comuns — faturas, recibos, extratos bancários, ordens de compra, contratos e a maioria dos documentos empresariais com layouts padrão. A IA foi pré-treinada em milhões desses documentos e entende sua estrutura semântica imediatamente. Você digita os nomes das colunas que deseja, envia seus arquivos e a IA encontra os dados. Sem amostras de treinamento, sem configuração de modelo, sem configuração além de descrever o que você quer extrair. Para formatos de documentos altamente especializados ou proprietários, sem equivalente no setor, espere menor precisão — o modelo não viu exemplos suficientes desse formato durante o pré-treinamento para ter uma compreensão semântica forte dele.
Como isso é diferente do OCR tradicional com modelos?
O OCR tradicional com modelos exige que você configure a entrada: desenhe zonas ao redor de cada campo em um documento de amostra e depois espere que essas zonas se alinhem com o layout do próximo documento. Quando um fornecedor muda o formato da fatura, o modelo quebra e precisa ser reconstruído. A extração por IA sem código funciona ao contrário: você configura a saída (quais colunas deseja), e a IA mapeia campos para colunas entendendo o que eles significam, não onde estão. Uma data no canto superior direito de uma fatura e no canto inferior esquerdo de outra ambas caem na coluna "Data" — porque a IA as identifica como datas semanticamente, não por posição. Isso também significa que você não precisa de modelos separados para o formato de fatura de cada fornecedor. Uma configuração de colunas funciona em todos os layouts.
Qual é a diferença entre extração sem código e usar uma API?
A extração sem código acontece por meio de uma interface visual — um aplicativo web ou complemento do Google Sheets onde você envia documentos, define colunas e baixa resultados. Ela é projetada para pessoas cuja função principal é contabilidade, operações ou logística — não desenvolvimento de software. A extração baseada em API é projetada para desenvolvedores que querem incorporar o processamento de documentos em um pipeline automatizado maior: os documentos chegam programaticamente, a extração acontece via endpoints REST e os dados estruturados fluem para bancos de dados ou outros aplicativos sem intervenção humana. O mesmo mecanismo de IA subjacente alimenta ambos. A diferença é a interface e o fluxo de trabalho que ela permite. Para equipes decidindo entre os dois, nossa comparação entre API e sem código fornece uma estrutura de decisão baseada em volume, habilidades da equipe e destino dos dados.
Posso processar vários documentos de uma vez sem código?
Sim. O processamento em lote é uma parte essencial do fluxo de trabalho sem código. Envie qualquer número de documentos — 10, 50, 200 — defina os nomes das colunas uma vez, e a IA processa todos eles, exportando uma única planilha onde cada linha é um documento e cada coluna é um campo extraído. O lote combina resultados de documentos independentemente das diferenças de layout, então 50 faturas de 15 fornecedores diferentes produzem linhas na mesma tabela de saída, com campos nas mesmas colunas.
Funciona com documentos manuscritos?
Caligrafia legível em formulários estruturados — um formulário impresso preenchido à mão, uma nota de entrega com quantidades manuscritas — é bem tratada pela IA moderna. A estrutura do formulário fornece contexto que ajuda o modelo a interpretar o conteúdo manuscrito. Notas manuscritas livres, cursiva rápida com letras altamente estilizadas e escrita sobreposta produzem resultados menos confiáveis. Se seus documentos são predominantemente manuscritos, espere verificar mais campos em vez de processá-los diretamente.
Quanto custa a extração de IA sem código em comparação com a entrada manual de dados?
Ferramentas de extração de IA sem código geralmente são baseadas em assinatura, com níveis de preço por página ou documento. Os custos de entrada manual de dados são medidos em mão de obra: a uma média de 3 minutos por página, processar 200 documentos por mês consome cerca de 10 horas — ou cerca de um quarto da semana de trabalho de uma pessoa. Com taxas salariais conservadoras, isso representa várias centenas de dólares por mês apenas em mão de obra, sem contar o tempo de correção de erros. O custo da assinatura de uma ferramenta de extração sem código é tipicamente uma fração disso. Nossa análise de comparação de custos detalha os números em diferentes níveis de volume e tipos de documento.
Quais formatos de documento e idiomas são suportados?
PDFs (tanto digitais nativos quanto digitalizados), JPEG, PNG, WebP, AVIF e capturas de tela de páginas da web. A IA processa qualquer formato que você enviar — uma foto de um recibo tirada com o celular funciona da mesma forma que um PDF gerado por software de contabilidade. O suporte a idiomas inclui inglês, japonês, alemão, francês, espanhol, português, coreano e chinês, entre outros. A qualidade da extração é maior para idiomas bem representados nos dados de treinamento do modelo, embora a transferência entre idiomas do VLM signifique que ele lida com idiomas menos comuns melhor do que o OCR tradicional treinado em corpora de um único idioma.
A extração de IA sem código muda quem pode usar a automação de documentos — não ao tornar a tecnologia mais simples, mas ao mover a complexidade da configuração para o pré-treinamento. O modelo fez o trabalho difícil de aprender como é uma fatura antes mesmo de você abrir a ferramenta. O que resta para você é descrever o que deseja extrair dos seus documentos — o que, se você é a pessoa que os processa todos os dias, você já sabe.