Qu'est-ce que la saisie de données par IA ?
Des données structurées, pas seulement du texte OCR
Prenez une facture. Passez-la dans un OCR. Vous obtenez ceci : Facture #INV-2024-0891 Date : 15 mars 2024 Total : 4 230,50 $ Fournisseur : Acme Corp. Un mur de texte. Pour intégrer ces données dans une feuille de calcul, vous devez encore surligner chaque champ, le copier et le coller dans la bonne cellule — l'OCR ne vous a pas épargné la saisie de données. Il a simplement déplacé le texte du papier à l'écran. Maintenant, passez la même facture dans une saisie de données par IA. Vous obtenez quatre colonnes — Numéro de facture, Date, Total, Fournisseur — chacune avec la bonne valeur, prête à l'emploi. Même document. Résultat complètement différent. Ce n'est pas une amélioration mineure par rapport à l'OCR. C'est une catégorie d'outil différente, et comprendre pourquoi est l'objet de cet article.
Points clés à retenir
- L'OCR numérise le texte mais ne touche jamais au travail réel de saisie de données — chaque champ reste dans un bloc de texte indifférencié, attendant que vous copiiez-colliez chaque valeur dans la bonne cellule de la feuille de calcul à la main.
- L'OCR lit les caractères un par un sans aucune compréhension de leur signification, c'est pourquoi il ne peut pas distinguer un montant en dollars dans la ligne Total du même nombre dans un poste de ligne — et pourquoi la recherche manuelle de champs consomme encore plus de 40 heures par mois après « l'automatisation ».
- ImageToTable.ai comble cette lacune en lisant toute la page d'un coup, en reconnaissant qu'une valeur étiquetée « Facture # » appartient à une colonne et qu'une valeur appelée « Total » appartient à une autre — quelle que soit la mise en page, sans modèles ni formation.
Ce que signifie réellement la saisie de données par IA
La saisie de données par IA est un logiciel qui lit un document, comprend ce que signifie chaque information et la place dans la colonne correcte d'un tableur — automatiquement. Contrairement à l'OCR, qui convertit des images de texte en caractères numériques, la saisie de données par IA produit une sortie structurée : des lignes et des colonnes où le numéro de facture se trouve dans la colonne Numéro de facture, la date dans la colonne Date et le total dans la colonne Total, pour chaque document d'un lot.
Le mécanisme qui rend cela possible est l'Extraction de colonnes personnalisées : au lieu de programmer des règles d'extraction ou de dessiner des cadres autour des champs sur un modèle, vous saisissez les noms de colonnes souhaités — « Numéro de facture », « Date d'échéance », « Nom du fournisseur », « Total ligne » — et l'IA localise chaque valeur n'importe où sur la page en comprenant sa signification sémantique, et non en correspondant à une position fixe. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre tableur final. C'est le changement fondamental : vous décrivez la sortie, pas l'entrée.
Cette distinction est importante car elle change qui peut utiliser l'outil. L'extraction basée sur des modèles exige que quelqu'un crée et maintienne des modèles pour chaque mise en page de document reçue. L'Extraction de colonnes personnalisées fonctionne de la même manière, que vous traitiez 50 factures d'un fournisseur ou 50 factures de 50 fournisseurs différents avec des mises en page complètement différentes.
Idée clé : L'OCR numérise les caractères. La saisie de données par IA structure les informations. L'une produit un texte avec lequel vous devez encore travailler. L'autre produit un tableur que vous pouvez déjà utiliser.
Pourquoi l'OCR seul n'a jamais été de la saisie de données
Pour comprendre ce que la saisie de données par IA fait différemment, il est utile de voir le fossé que l'OCR a toujours laissé derrière lui. Voici une facture réelle, traitée des deux manières.
Sortie OCR — ce que vous obtenez d'un outil OCR traditionnel pointé sur une facture fournisseur standard :
INVOICE
Acme Industrial Supply
451 Commerce Drive, Suite 200
Chicago, IL 60607
Invoice #INV-2024-0891
Date: March 15, 2024
Due Date: April 14, 2024
PO Number: PO-77231
Item | Qty | Unit Price | Total
Hex Bolt M10 | 200 | $2.40 | $480.00
Steel Washer M10 | 500 | $0.15 | $75.00
Threaded Rod 1m | 50 | $12.80 | $640.00
Subtotal: $1,195.00
Tax (8.75%): $104.56
Shipping: $45.00
Total: $1,344.56
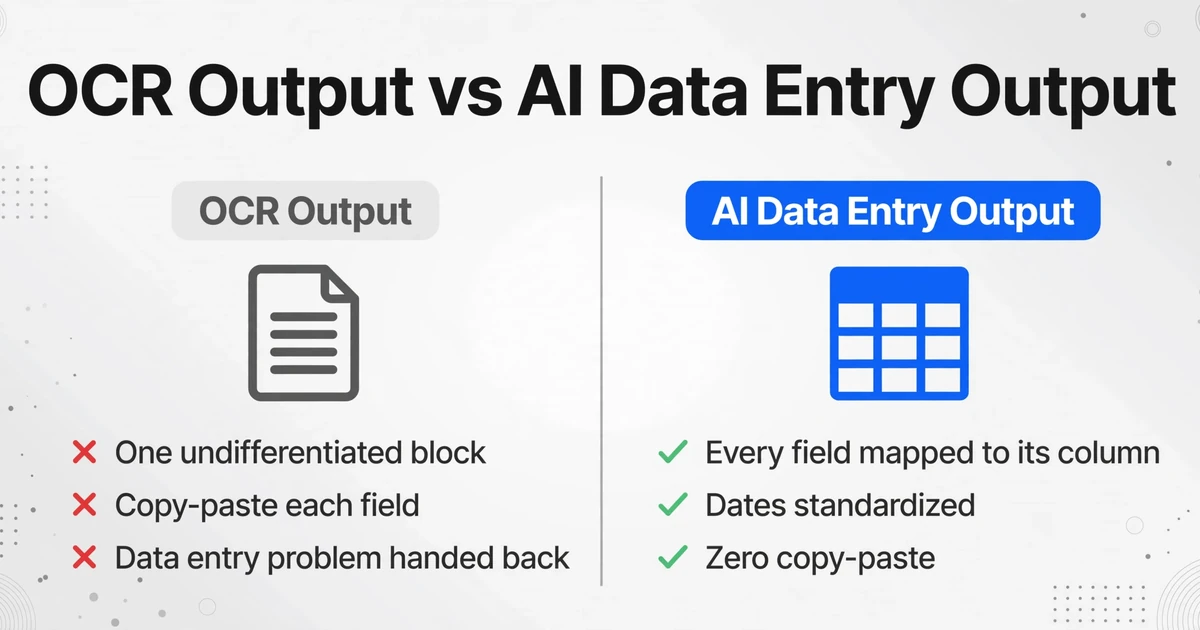
Tout y est. Les caractères sont corrects. Mais c'est un bloc indifférencié. Pour mettre « Numéro de facture » dans votre tableur, vous trouvez la ligne qui commence par « Invoice # », sélectionnez l'identifiant, copiez-le, passez à votre tableur, collez-le. Puis trouvez la date. Puis le numéro de bon de commande. Puis chaque ligne d'article. L'OCR vous a donné le texte, mais il vous a rendu le problème de la saisie de données.
Sortie de saisie de données par IA — ce que vous obtenez avec une extraction basée sur l'IA avec la même facture :
| Numéro de facture | Date | Date d'échéance | N° de bon de commande | Nom du fournisseur | Sous-total | Taxe | Expédition | Total |
|---|---|---|---|---|---|---|---|---|
| INV-2024-0891 | 2024-03-15 | 2024-04-14 | PO-77231 | Acme Industrial Supply | $1,195.00 | $104.56 | $45.00 | $1,344.56 |
Chaque champ est mappé à sa colonne correcte. Les éléments de ligne sont extraits dans leurs propres lignes. Les dates sont normalisées dans un format cohérent. Zéro copier-coller. Zéro recherche manuelle de champ. La différence ne tient pas à la vitesse — même si l'IA est nettement plus rapide — mais au fait que le résultat est déjà structuré. La sortie OCR nécessite une deuxième étape (saisie manuelle des données) avant d'être exploitable. La sortie de la saisie de données par IA est exploitable immédiatement.
La recherche 2025 d'EY a révélé qu'une seule tâche manuelle de saisie de données RH coûte désormais en moyenne $4.86 aux organisations — contre $4.39 en 2018, et ce chiffre augmente chaque année. Sur des milliers de documents, l'écart entre « l'OCR a numérisé le texte » et « l'IA a structuré les données » se cumule en coûts opérationnels réels.
Comment l'IA lit les documents : la vision rencontre le langage
L'OCR fonctionne caractère par caractère. Il examine un motif de pixels sombres et clairs, le compare à une bibliothèque de formes connues et renvoie la lettre la plus proche. C'est pourquoi l'OCR peut produire « rn » alors qu'il devait lire « m » — il prend des décisions au niveau du caractère, sans conscience du mot, encore moins de la structure du document. Lorsque l'OCR rencontre un tableau avec des cellules fusionnées, il lit ligne par ligne et perd entièrement les relations entre colonnes.
La saisie de données par IA utilise des modèles de vision et de langage (VLM) — une classe d'IA qui traite les documents comme le ferait un humain : en regardant la page entière d'un coup. Un VLM analyse simultanément trois niveaux d'information :
Disposition visuelle.
Où se trouve chaque élément ? Est-il dans un en-tête, un tableau, un pied de page ? Ce texte est-il en gras, en retrait ou dans un encadré ? Le modèle comprend la structure du document — pas seulement l'apparence des pixels, mais aussi l'organisation de la page.
Contenu textuel.
Que dit le texte ? Le modèle lit les caractères, les mots et les nombres — mais contrairement à l'OCR, il les lit dans le contexte de leur position sur la page et de leur relation avec les éléments voisins.
Signification sémantique.
Que représente chaque donnée ? Un nombre dans le coin supérieur droit, à côté du mot « N° de facture », est un numéro de facture. Un nombre en gras dans le coin inférieur droit, à côté de « Total », est le montant dû. Le modèle relie la position visuelle au rôle sémantique — il ne se contente pas de lire « INV-2024-0891 », il comprend qu'il s'agit de l'identifiant de la facture.
Ces trois niveaux — disposition, contenu et signification — sont traités ensemble, et non séquentiellement. Lorsque l'IA voit un montant en dollars dans la ligne « Total » en bas d'une facture, elle n'a pas à décider « est-ce du texte ou un nombre ? » puis « que signifie ce nombre ? » comme étapes distinctes. Elle comprend l'ensemble d'un coup : il s'agit d'une valeur monétaire, positionnée à la fin du document, étiquetée « Total », et il s'agit probablement de la somme de toutes les lignes ci-dessus. Le résultat est une valeur avec une étiquette sémantique, pas seulement une chaîne de chiffres.
C'est ce que les gens veulent dire lorsqu'ils affirment que l'IA « comprend le contexte ». Ce n'est pas de la magie — ce sont des modèles entraînés sur des millions de documents qui apprennent que lorsqu'un nombre apparaît sous une colonne de chiffres et à côté du mot « Total », ce nombre a une signification spécifique qu'un nombre au milieu d'un tableau de lignes n'a pas.
Trois façons dont l'IA extrait des données d'un document
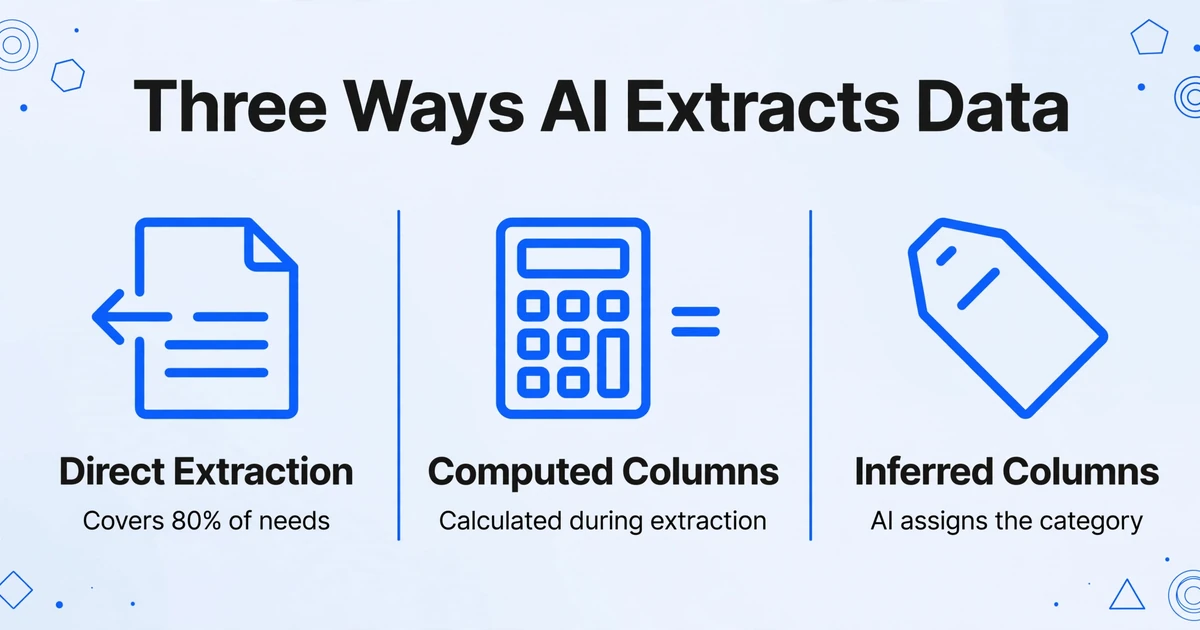
Toute extraction n'est pas identique. La saisie de données par IA fonctionne selon trois modes distincts, chacun résolvant un problème différent. Comprendre quel mode s'applique à quel champ est ce qui distingue une extraction fonctionnelle d'une extraction qui produit des résultats incomplets.
Extraction directe — lorsque les données sont imprimées sur la page
C'est le mode le plus simple : le champ souhaité est visiblement présent sur le document. Une facture comporte une date imprimée. Un reçu comporte un total. Un bon de commande comporte un nom de fournisseur. L'IA localise la valeur en comprenant son rôle sémantique et la place dans la colonne appropriée.
L'extraction directe couvre environ 80 % des besoins courants en traitement de documents. Elle gère le texte imprimé, les tableaux avec des colonnes claires et les champs dans des positions prévisibles — même lorsque ces positions varient selon les mises en page. Comme l'IA ne correspond pas à une coordonnée fixe, une date en haut à droite d'une facture et une date en bas à gauche d'une autre facture sont toutes deux correctement mappées dans la colonne « Date ».
Colonnes calculées — lorsque la réponse n'est pas écrite, mais que les ingrédients le sont
Parfois, le nombre dont vous avez besoin n'est imprimé nulle part sur le document — mais les composants pour le calculer y sont. C'est là que les Colonnes calculées entrent en jeu. Au lieu d'extraire une valeur, l'IA effectue un calcul pendant l'extraction et place le résultat dans votre feuille de calcul.
Par exemple, un bon de commande peut indiquer une quantité de 200 et un prix unitaire de 2,40 $, mais nulle part il n'imprime « Total ligne : 480,00 $ ». Avec les Colonnes calculées, vous définissez une colonne appelée Total ligne (Qté × Prix unitaire). L'IA extrait les deux valeurs sources, effectue la multiplication et produit 480,00 $ — le tout en une seule passe. Aucune formule post-extraction dans Excel n'est requise.
Les Colonnes calculées prennent en charge l'arithmétique au niveau des lignes, l'agrégation entre lignes (somme de tous les articles d'une section), la logique conditionnelle (signalement lorsque les totaux calculés ne correspondent pas au total imprimé) et les références à des paramètres fixes (intégration d'un taux de taxe applicable à tous les documents d'un lot). Le calcul se produit pendant l'extraction, de sorte que votre sortie est constituée de réponses prêtes à l'emploi — et non de données brutes que vous devez encore traiter.
Colonnes déduites — quand l'IA remplit ce qui n'est pas là
Le troisième mode s'attaque à un problème que l'OCR et les outils basés sur des modèles ne peuvent pas résoudre : que faire si l'information dont vous avez besoin n'est pas écrite sur le document ? Les Colonnes déduites permettent à l'IA de lire un document et de déterminer quelle catégorie, étiquette ou libellé s'applique — puis de remplir cette information dans votre feuille de calcul.
Un cas classique est la catégorisation des dépenses. Un reçu de restaurant ne mentionne pas « Catégorie : Repas ». Mais vous devez trier vos dépenses pour votre déclaration fiscale. Avec les Colonnes déduites, vous définissez une colonne appelée Catégorie (options : Repas/Transport/Bureau/Autre). L'IA lit chaque reçu — un reçu de déjeuner dans un restaurant de sushis, un reçu de station-service, un reçu de Staples — et détermine la catégorie correcte pour chacun. Le résultat est une feuille de calcul où chaque ligne a déjà sa catégorie assignée. L'extraction et la classification se font en une seule passe.
Les Colonnes déduites fonctionnent de la même manière sur tout type de document : signaler les commandes urgentes à partir de bons de livraison, détecter le type de devise sur des factures internationales, identifier le sous-type de document à partir de certificats d'assurance. L'IA lit le contenu du document et fait une inférence structurée — ce que l'OCR, qui n'a aucune compréhension sémantique, ne peut pas faire.
Ce que cela signifie au quotidien
Les trois modes d'extraction convergent vers un seul changement opérationnel : vous n'avez plus besoin d'apprendre à l'outil à quoi ressemblent vos documents. Vous décrivez ce que vous voulez en tirer.
Dans un flux de travail OCR basé sur des modèles, ajouter le format de facture d'un nouveau fournisseur signifie ouvrir l'éditeur de modèles, dessiner des zones autour de chaque champ, le tester sur un échantillon, et espérer que les zones ne bougent pas sur la prochaine facture. Multipliez cela par 20 fournisseurs et vous passez plus de temps à maintenir les modèles que vous n'en auriez passé à la saisie manuelle. Avec la saisie de données par IA, vous tapez vos noms de colonnes une seule fois. Ils fonctionnent sur toutes les mises en page que l'IA rencontre — parce que l'IA comprend le document, elle ne mesure pas des coordonnées.
Le traitement par lots va plus loin. Téléversez 50 factures de 15 fournisseurs différents. Tapez vos noms de colonnes une seule fois. L'IA traite les 50, identifie chaque champ dans chaque variante de mise en page, et exporte une seule feuille de calcul avec 50 lignes — une par facture — avec chaque champ dans la bonne colonne. Ce qui prenait un après-midi de saisie manuelle devient quelques minutes de téléversement et de vérification.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Pour une vue d'ensemble de la comparaison entre l'extraction par IA et les approches traditionnelles de traitement documentaire, notre introduction aux logiciels d'extraction de données couvre l'ensemble du paysage de cette catégorie. Et si vous évaluez des outils, le cadre d'évaluation passe en revue les critères qui distinguent une extraction de qualité professionnelle des démos qui fonctionnent sur un seul document d'exemple.
Ce que la saisie de données par IA fait bien
La saisie de données par IA traite tout document où des informations structurées existent dans une mise en page visuelle. Les applications les plus courantes se regroupent autour de quelques types de documents à volume élevé.
Traitement des factures. Le cas d'utilisation phare. Les factures de différents fournisseurs ont des mises en page radicalement différentes, mais partagent la même structure sémantique : nom du fournisseur, numéro de facture, date, lignes d'articles, totaux. L'IA lit à travers les mises en page, ce qui rend pratique l'extraction des champs de facture vers Excel sans créer de modèle pour chaque fournisseur. Gartner prévoit que d'ici 2030, jusqu'à 80 % des factures B2B dans le monde seront traitées automatiquement — une prédiction qui repose précisément sur le type d'extraction indépendante de la mise en page décrit ici.
Numérisation des reçus. Les reçus sont le type de document le plus difficile pour l'OCR basé sur des modèles : chaque magasin imprime un format différent, beaucoup sont imprimés thermiquement et décolorés, et ils arrivent souvent sous forme de photos de téléphone prises à des angles bizarres. La saisie de données par IA convertit les reçus en lignes structurées de feuille de calcul en comprenant visuellement la mise en page du reçu — identifiant le nom du marchand, la date, le total et les lignes d'articles, quel que soit le format.
Rapprochement des relevés bancaires. Les relevés bancaires présentent un défi particulier : des PDF multipages avec des tableaux de transactions qui s'étendent sur plusieurs colonnes à travers les sauts de page, des colonnes de débit et de crédit qui se chevauchent parfois, et des soldes courants qui doivent rester cohérents. La saisie de données par IA convertit les relevés bancaires en Excel tout en préservant la structure des transactions — chaque ligne est une transaction, chaque colonne est un champ — afin que le rapprochement puisse se faire dans votre feuille de calcul plutôt qu'en recoupant un relevé papier avec un écran.
Traitement des formulaires. Les formulaires papier — candidatures, formulaires d'admission des patients, réponses à des sondages — arrivent par lots avec des questions cohérentes mais une écriture, des cases à cocher et des schémas de remplissage extrêmement variables. L'IA lit la structure du formulaire et extrait chaque champ dans une colonne, numérisant les données des formulaires sans configuration par formulaire.
Documents manuscrits. La saisie de données par IA moderne gère l'écriture manuscrite lisible — formulaires imprimés remplis à la main, bons de livraison avec signatures et quantités manuscrites, feuilles de temps avec heures écrites à la main. La précision sur l'écriture manuscrite est inférieure à celle sur le texte imprimé (plus de détails dans la section sur les limites), mais pour les formulaires structurés où le contenu manuscrit est limité à des champs connus, les résultats sont prêts pour la production dans de nombreux cas d'utilisation. Notre guide sur la reconnaissance de l'écriture manuscrite pour l'extraction de données couvre les détails.
Ce que la saisie de données par IA ne maîtrise pas encore
La saisie de données par IA n'est pas un problème résolu. Certains types de documents et certaines conditions font chuter la précision en dessous de ce qui est acceptable pour une automatisation sans intervention. Il est important d'être clair sur ces limites — c'est ce qui distingue un flux de travail efficace d'un flux qui crée un nouveau problème de nettoyage.
Qualité de numérisation extrêmement médiocre. Les documents fortement délavés, photographiés en basse lumière avec un flou de mouvement, ou numérisés à très basse résolution (moins de 150 DPI) dégradent la précision de l'extraction. L'IA peut compenser les problèmes de qualité modérés — léger flou, inclinaison, éclairage incohérent — mais lorsque les caractères deviennent véritablement ambigus pour un lecteur humain, l'IA aura également du mal. Le score de confiance (où l'IA signale les champs à faible certitude pour examen humain) atténue ce problème mais ne l'élimine pas.
Texte manuscrit qui se chevauche. Lorsque l'écriture manuscrite est claire et séparée, l'IA moderne la gère bien. Lorsque les caractères se chevauchent — une correction écrite à la hâte entre deux lignes, un texte barré avec un nouveau texte écrit par-dessus — la précision chute fortement. Le modèle doit décider où un caractère se termine et où un autre commence, et à un certain niveau de chevauchement, cette décision devient une supposition même pour un humain.
Documents où les données sont purement visuelles ou graphiques. Si un document communique des informations exclusivement par des diagrammes, des graphiques sans tableaux de données, ou des cartes à code couleur sans étiquettes de texte, la saisie de données par IA n'a rien à extraire. L'IA lit le texte et la mise en page — elle n'interprète pas la hauteur d'un graphique à barres en valeur numérique ni ne décode une légende de couleurs en catégories. Pour les documents qui mélangent texte et visuels (un rapport avec à la fois un tableau de données et un graphique), le tableau est extractible ; le graphique ne l'est généralement pas.
Écriture cursive extrême et écriture manuscrite non standard. Une écriture soignée sur un formulaire structuré est gérable. La cursive rapide avec des formes de lettres très stylisées — comme celles que l'on trouve dans certaines ordonnances médicales ou de vieux registres manuscrits — reste difficile. L'écart se réduit à mesure que les modèles s'améliorent, mais à la mi-2026, la cursive très stylisée produit encore des résultats peu fiables qui nécessitent une vérification humaine.
Tableaux multipages avec logique de chevauchement complexe. Lorsqu'un tableau s'étend sur trois pages avec des cellules fusionnées, des lignes divisées et des sous-totaux qui référencent des valeurs d'une page précédente, même l'IA peut perdre le fil. Les modèles de vision et de langage (VLM) modernes gèrent bien la continuité multipage simple, mais la logique de chevauchement complexe — où la description d'un article s'étend sur deux pages et sa quantité se trouve sur une troisième — produit encore des erreurs dans un pourcentage significatif de cas.
Le résumé honnête : la saisie de données par IA traite les 80 % de documents propres, lisibles et structurellement clairs avec une grande précision (jusqu'à 99 % pour les données de tableaux imprimés). Elle traite les 15 % suivants — problèmes de qualité modérés, écriture manuscrite légère, tableaux multipages simples — avec une précision encore utilisable mais qui peut nécessiter une vérification ponctuelle. Les 5 % restants — l'écriture manuscrite qui se chevauche, les numérisations gravement dégradées, les documents purement graphiques — nécessitent encore une attention humaine. Notre comparaison de précision entre les outils d'extraction fournit des références détaillées pour des types de documents spécifiques.
Questions fréquentes
La saisie de données par IA est-elle la même chose que l'OCR ?
Non. L'OCR convertit des images de texte en caractères numériques — il lit les lettres. La saisie de données par IA comprend ce que ces lettres signifient dans leur contexte et les place dans des colonnes structurées. L'OCR vous donne un fichier texte. La saisie de données par IA vous donne une feuille de calcul. L'OCR est un composant que les systèmes de saisie de données par IA peuvent utiliser, mais à lui seul, l'OCR n'effectue ni structuration ni compréhension.
Dois-je entraîner l'IA sur mes documents ?
Non. Les outils modernes de saisie de données par IA utilisant des modèles de vision et de langage fonctionnent immédiatement sur des documents qu'ils n'ont jamais vus. Vous ne téléversez pas d'échantillons d'entraînement, vous n'étiquetez pas de champs et vous ne configurez pas de modèles. Vous saisissez les noms de colonnes souhaités, téléversez vos documents, et l'IA extrait les données en comprenant le document visuellement et sémantiquement — pas en faisant correspondre un modèle appris à partir d'exemples précédents. À titre de comparaison, les anciennes approches d'apprentissage automatique exigeaient des centaines de documents étiquetés par format ; les outils plus récents basés sur les VLM n'en exigent aucun.
Quels formats de documents la saisie de données par IA prend-elle en charge ?
PDF (natifs et numérisés), JPEG, PNG, WebP, AVIF et captures d'écran de pages web. L'IA traite toute image ou tout document que vous téléversez — la source n'a pas besoin d'être un fichier numérique propre. Une photo de reçu prise avec un téléphone fonctionne de la même manière qu'un PDF généré par un logiciel de comptabilité. Pour une comparaison détaillée de la prise en charge des formats entre les outils, consultez notre cadre d'évaluation.
Quelle est la précision de la saisie de données par IA par rapport à la saisie manuelle ?
Pour les données de tableaux imprimés, l'extraction par IA atteint jusqu'à 99 % de précision. La précision de la saisie manuelle se situe généralement entre 96 et 98 % et se dégrade avec la fatigue, la pression du volume et les formats de documents inconnus. Pour 1 000 documents par mois, la différence est d'environ 10 à 40 erreurs (manuelles) contre moins de 10 (IA). Une page qui prend 3 minutes à saisir manuellement est traitée en 5 à 10 secondes avec l'IA — un gain d'efficacité de plus de 18 fois. Cependant, la précision dépend fortement de la qualité du document : un scan propre et bien éclairé d'une facture imprimée atteindra une précision quasi parfaite ; une photo délavée et en basse résolution d'un reçu manuscrit sera moins précise.
La saisie de données par IA peut-elle lire l'écriture manuscrite ?
Oui, mais avec des réserves. L'écriture manuscrite lisible sur des formulaires structurés (un formulaire imprimé rempli à la main) est bien gérée par l'IA moderne — la structure du formulaire fournit un contexte qui aide le modèle à interpréter le contenu manuscrit. Les notes manuscrites libres, l'écriture cursive rapide et l'écriture manuscrite qui se chevauchent produisent des résultats moins fiables. Si votre cas d'utilisation implique des documents fortement manuscrits, prévoyez de vérifier les résultats plutôt que de les traiter directement. Pour plus de détails, consultez notre guide de reconnaissance de l'écriture manuscrite.
Combien coûte la saisie de données par IA par rapport à l'OCR traditionnel ?
Les outils de saisie de données par IA sont généralement proposés par abonnement avec des paliers de tarification par page ou par document. Les outils OCR traditionnels sont souvent moins chers au niveau de base, mais nécessitent un investissement supplémentaire dans la configuration des modèles, la maintenance et le travail manuel de structuration du texte brut qu'ils produisent. La différence de coût ne réside rarement dans le prix du logiciel seul — il s'agit du coût opérationnel total, y compris le temps consacré au traitement des données après extraction. Notre comparaison des coûts entre l'OCR gratuit et l'extraction par IA et l'aperçu du paysage tarifaire 2026 couvrent ce sujet en détail.
Que deviennent mes documents après le traitement ?
Cela varie selon le fournisseur. Les outils réputés traitent les documents, extraient les données et suppriment les fichiers d'origine — ils ne stockent pas vos documents et ne les utilisent pas pour l'entraînement. Vérifiez toujours la politique de traitement des données du fournisseur avant de téléverser des documents sensibles. Recherchez des engagements explicites concernant la suppression des fichiers, l'absence d'entraînement sur les données utilisateur et le chiffrement en transit et au repos.
La saisie de données par IA change ce qui est possible en matière de traitement de documents — non pas en faisant la même chose plus rapidement, mais en faisant quelque chose de complètement différent. La question n'est pas de savoir si c'est mieux que l'OCR. C'est de savoir si les documents que vous traitez chaque jour sont suffisamment structurés pour que l'IA puisse les gérer, et si le temps que vous économiseriez vaut plus que le coût de l'outil. La seule façon de le savoir est de l'essayer sur vos propres documents.