KI-Handschrifterkennung vs. traditionelle OCR: Warum die Lücke größer ist, als die meisten Teams erwarten
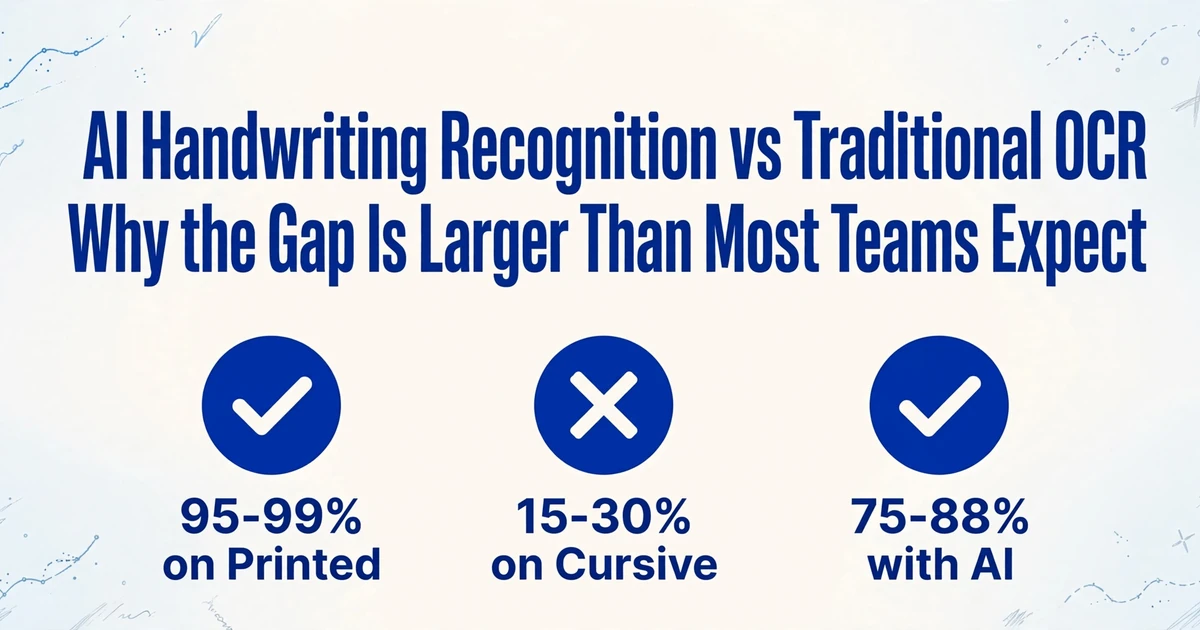
Traditionelle OCR scheitert katastrophal bei Handschrift — Tesseract erreicht 24 % Genauigkeit bei handschriftlichen Formularen, während KI-Extraktion 95 %+ erreicht. Hier erfahren Sie, warum die Lücke strukturell bedingt ist.
Einordnung: Diese Seite ist der direkte Vergleich von KI vs. traditioneller OCR bei Handschrift — Genauigkeit, Geschwindigkeit, Kosten und Halluzination. Eine Definition davon, was KI-Handschrifterkennung ist, finden Sie unter was KI-Handschrifterkennung ist; Genauigkeitszahlen nach Handschrifttyp finden Sie unter kann KI Handschrift aus Fotos lesen.
Was traditionelle OCR richtig macht — und wo sie an ihre Grenzen stößt
Traditionelle optische Zeichenerkennung (OCR) funktioniert, indem sie Pixelmuster auf einer Seite untersucht, sie mit bekannten Zeichenformen abgleicht und eine Textzeichenfolge ausgibt. Bei sauberen, maschinengedruckten Dokumenten, die mit 300 DPI gescannt wurden, liefert sie gute Ergebnisse — oft über 95 % Zeichengenauigkeit. Eine frisch gedruckte Rechnung, ein PDF-Formular, ein getippter Vertrag: Das sind die Eingaben, für die OCR entwickelt wurde, und sie bleiben ihr bester Anwendungsfall.
Doch Zeichengenauigkeit ist nicht dasselbe wie Datengenauigkeit. Zu wissen, dass die Zeichen „1,234.56" irgendwo auf einer Seite vorkommen, sagt nichts darüber aus, ob es sich um einen Rechnungsbetrag, eine Menge oder eine Referenznummer handelt. Diese Interpretation erfordert weiterhin einen Menschen — oder eine Ebene von Regeln, die Sie zusätzlich zur OCR-Ausgabe aufbauen und pflegen müssen. Bei maschinengedrucktem Text ist diese Lücke mit Nachbearbeitungsskripten und Feldpositionierungsvorlagen beherrschbar. Bei Handschrift weitet sich die Lücke zu einem Abgrund.
Das grundlegende Problem ist architektonischer Natur. Traditionelle OCR arbeitet von unten nach oben: Sie liest zuerst einzelne Zeichen, versucht sie dann zu Wörtern und schließlich zu Zeilen zusammenzusetzen. Sie hat kein Konzept davon, worum es im Dokument geht. Wenn jedes Zeichen klar und vorhersehbar ist, funktioniert das. Wenn Zeichen sich verbinden, in ihrer Größe variieren, unvorhersehbar geneigt sind oder ineinander verlaufen — wie es bei Handschrift der Fall ist — bricht der Bottom-up-Ansatz zusammen, bevor er die Wortebene erreicht.
Die drei Stellen, an denen traditionelle OCR bei Handschrift versagt
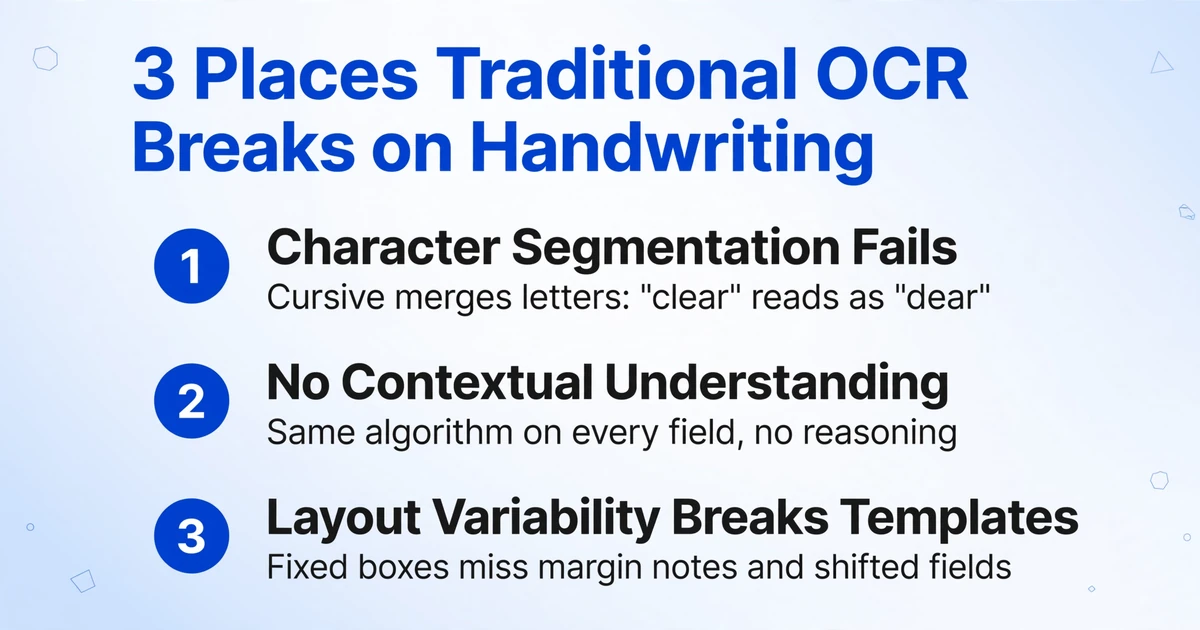
Die Handschrift jedes Menschen ist ein einzigartiger Datensatz. Strichbreite, Neigungswinkel, Buchstabenverbindung, Grundlinienabweichung — diese variieren nicht nur zwischen Personen, sondern auch innerhalb der Schrift einer einzelnen Person an verschiedenen Tagen, mit verschiedenen Stiften und auf verschiedenen Oberflächen. Traditionelle OCR stößt auf drei spezifische Fehlermodi, die sich gegenseitig verstärken.
Zeichensegmentierung scheitert, bevor die Zeichenerkennung beginnt
OCR geht davon aus, dass jedes Zeichen eine trennbare Bounding Box einnimmt. Handschrift in Schreibschrift verletzt diese Annahme vollständig. Zeichen gehen ineinander über, ohne klare Grenze. Die Engine führt entweder mehrere Buchstaben zu einem Klumpen zusammen (liest „clear" als „dear") oder teilt einen einzelnen Buchstaben auf zwei Boxen auf (liest „m" als „rn"). Unabhängige Benchmarks aus Produktivumgebungen zeigen, dass Tesseract — die am weitesten verbreitete Open-Source-OCR-Engine — bei allgemeiner Schreibschrift eine Wortgenauigkeit von 45–50 % erreicht. Das bedeutet: Von je zwei in Schreibschrift geschriebenen Wörtern wird eines falsch gelesen. Bei einem Formular mit 50 Feldern und gemischtem Druck- und Schreibschrifttext enthalten rund 25 Felder Fehler, bevor überhaupt eine menschliche Prüfung beginnt.
Kein Kontextverständnis bedeutet null Fehlerkorrektur
Wenn ein Mensch ein verschmiertes Wort auf einem Lieferformular liest, grenzen die umgebenden Felder — Datum, Adresse, Artikelliste — ein, was dieser Fleck vernünftigerweise sein könnte. Eine Zahl in einem Feld „Gesamt" kann kein Name sein. Ein Datum in einem Feld „Geburtsdatum" kann nicht im nächsten Jahr liegen. Traditionelle OCR hat nichts von dieser Logik. Sie wendet denselben Zeichenabgleich-Algorithmus auf jede Position der Seite an, unabhängig davon, was dort stehen sollte. Eine verschmierte „5" in einer Preisspalte wird als „S" klassifiziert, weil das Pixelmuster mehrdeutig ist — und die Engine kann nicht kennzeichnen, dass „S" in einem Währungsfeld keinen Sinn ergibt.
Layout-Variabilität bringt vorlagenabhängige Pipelines zum Scheitern
Viele Produktiv-OCR-Setups setzen auf Vorlagen: Sie definieren feste Koordinaten für jedes Feld, und die Engine liest die Zeichen, die in diesen Boxen erscheinen. Das funktioniert bei standardisierten Formularen aus einer einzigen Quelle. Es scheitert in dem Moment, in dem ein Lieferant sein Formularlayout ändert, ein Feld um einen halben Zoll verrutscht oder jemand eine Notiz an den Rand statt in die vorgesehene Box schreibt. Handschriftliche Dokumente verstärken dieses Problem — Schreibende laufen routinemäßig aus Boxen heraus, fügen Anmerkungen am Rand hinzu oder nutzen Pfeile, um Informationen umzuplatzieren. Eine Vorlage für „Name: [____________]" kann „Name: [John S—— siehe beigefügten Ausweis]" nicht verarbeiten. Die OCR-Ausgabe für dieses Feld wird entweder abgeschnitten, verstümmelt oder leer sein, und der restliche Workflow kann nicht erkennen, welcher Fall vorliegt.
Wie KI-Handschrifterkennung anders denkt
Vision Language Models (VLMs) — die Klasse der KI, zu der Modelle wie GPT-4o, Claude und Gemini gehören — verarbeiten Dokumente von oben nach unten statt von unten nach oben. Sie beginnen nicht damit, einzelne Buchstabenformen zu suchen. Sie betrachten das gesamte Seitenbild, verstehen dessen Struktur und Zweck und entschlüsseln den Text in diesem Kontext. Das kommt dem menschlichen Lesen näher: Sie untersuchen nicht jeden Federstrich isoliert; Sie erkennen das Wort „Total“, weil Sie erwarten, dass unten auf einer Rechnung eine Summe steht, und Sie interpretieren die Zahl daneben als Währung, weil der Kontext es verlangt.
Die praktische Konsequenz ist, dass VLM-basierte Extraktion Mehrdeutigkeiten so behandelt wie ein Mensch — indem sie abgleicht, was auf der Seite steht, mit dem, was auf der Seite stehen sollte. Ein Zeichen, das wie „5“ oder „S“ aussehen könnte, wird zu „5“, wenn es in einem numerischen Feld erscheint. Ein Datum wie „Jan 5 25“ wird zu „2025-01-05“ normalisiert, weil das Modell Datumsformate versteht. Diese kontextuelle Disambiguierung ist keine geringfügige Verbesserung gegenüber zeichenbasierter OCR — sie ist der Unterschied zwischen nutzbarer Ausgabe und einer Ausgabe, die einen zweiten manuellen Durchgang erfordert.
In der Praxis lassen Sie mit Tools, die auf diesem Ansatz basieren, eine Benutzerdefinierte Spaltenextraktion definieren: Sie geben die gewünschten Feldnamen ein — „Rechnungsnummer“, „Fälligkeitsdatum“, „Gesamtbetrag“ — und die KI findet jeden Wert überall auf der Seite, indem sie versteht, was die Feldbezeichnung bedeutet, nicht wo sie steht. Keine Vorlagenkoordinaten, keine Einrichtung pro Anbieter, keine Neukonfiguration, wenn sich ein Formularlayout ändert. Dieselbe Definition funktioniert über verschiedene Dokumente aus verschiedenen Quellen hinweg, weil die KI nach Bedeutung sucht, nicht nach Position.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Genauigkeitslücke: Zahlen, die für sich sprechen
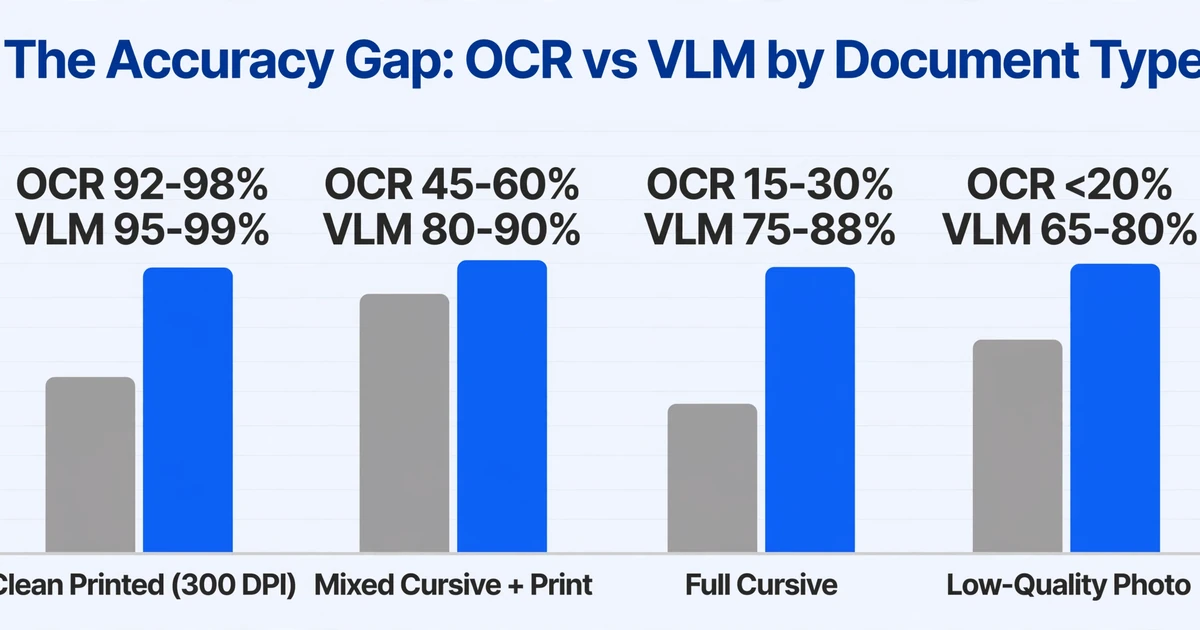
Zahlen machen den Unterschied greifbar. Mehrere unabhängige Benchmarks aus den Jahren 2025–2026 zeigen ein konsistentes Muster: Bei gedrucktem Text ist die Lücke zwischen traditioneller OCR und VLM-basierter Extraktion gering (3–7 Prozentpunkte). Bei Handschrift explodiert sie.
| Dokumenttyp | Genauigkeit traditioneller OCR | Genauigkeit VLM-basierter Extraktion | Lücke |
|---|---|---|---|
| Sauberer gedruckter Text (300 DPI) | 92–98% | 95–99% | 3–7 pp |
| Druckschrift-Handschrift (begrenzte Felder) | 70–85% | 85–93% | 8–15 pp |
| Gemischte Schreibschrift + Druckschrift | 45–60% | 80–90% | 25–35 pp |
| Reine Schreibschrift / unleserliche Handschrift | 15–30% | 75–88% | 50–65 pp |
| Fotos von geringer Qualität (Handy, ungleichmäßige Beleuchtung) | <20% | 65–80% | 45–65 pp |
Zwei Hinweise dazu, was gemessen wird. Erstens: Die VLM-Spalte zeigt die Feldgenauigkeit — ob jeder extrahierte Wert in der richtigen Spalte Ihrer Tabelle landet — nicht die reine Zeichenerkennung. Die Feldgenauigkeit liegt höher als die reine Zeichenfehlerrate (CER), weil der Dokumentkontext mehrdeutige Zeichen auflöst: Eine verschmierte Ziffer in einem Feld „Summe“ wird als 5 gelesen, nicht als S. Zweitens: Die Spalte der traditionellen OCR zeigt die reine Erkennung auf denselben Dokumenten — genau deshalb fällt die Lücke so groß aus, wie sie ist. Zu den reinen Zeichengenauigkeits-Metriken beim IAM-Benchmark lesen Sie unseren Deep Dive dazu, wie Handschrifterkennung funktioniert.
Das Muster ist nicht subtil. Bei der saubersten Handschrift (Blockschrift in begrenzten Feldern) ist die Lücke überschaubar — traditionelle OCR mag mit etwas Nachbearbeitung „gut genug" sein. Doch je weiter die Handschrift verfällt — von Blockschrift zu gemischter Kursivschrift, von begrenzten Feldern zu freien Feldern, von gescannten Seiten zu Handyfotos —, stürzt die Genauigkeit traditioneller OCR ab, während die VLM-basierte Extraktion allmählich nachlässt. Derselbe Benchmark aus 2026 testete die handschriftspezifische Engine von Google Document AI bei Kursivschrift: ~63 % Wortgenauigkeit. Amazon Textract schnitt mit ~89,5 % bei denselben Eingaben besser ab, doch beide erforderten separate Vorverarbeitungs-Pipelines für Schrägstellungskorrektur, Kontrastverbesserung und Rauschunterdrückung — Arbeit, die VLM-basierte Systeme zur Inferenzzeit ohne zusätzliche Einrichtung erledigen (Suparse, 2026).
Für einen realen Workflow, der 100 gemischte Dokumente pro Woche verarbeitet — zur Hälfte gedruckt, zur Hälfte handschriftlich —, summiert sich der Unterschied auf etwa 4–6 Stunden manuelle Korrektur pro Woche bei traditioneller OCR gegenüber 30–45 Minuten bei VLM-basierter Extraktion. Diese Lücke ist keine Frage des Komforts. Sie entscheidet darüber, ob eine handschriftinklusive Automatisierung ohne einen dedizierten menschlichen Prüfschritt laufen kann.
Wo der Vergleich kompliziert wird: Geschwindigkeit, Kosten und Halluzination
Wäre der Genauigkeitsvergleich die ganze Geschichte, wäre die Entscheidung einfach. Doch die VLM-basierte Extraktion bringt drei Kompromisse mit sich, die eine pauschale Empfehlung unehrlich machen würden.
Geschwindigkeit
Traditionelle OCR ist schnell — eine einzelne Seite wird auf Standardhardware in unter 2 Sekunden verarbeitet. VLMs sind langsamer, weil sie umfangreichere Schlussfolgerungen ziehen. Ein typischer VLM-Aufruf für die Extraktion auf Seitenebene dauert 5–12 Sekunden, je nach Dokumentkomplexität und Modellgröße. Bei einem Batch von 500 Seiten ist das der Unterschied zwischen 15 Minuten und über einer Stunde. Wenn Ihr Workflow volumenempfindlich ist und Ihre Dokumente durchgängig sauberer gedruckter Text sind, bleibt traditionelle OCR die schnellere Option — und ist möglicherweise alles, was Sie brauchen.
Kosten
Traditionelle OCR ist günstig. Tesseract ist kostenlos und Open Source. Cloud-OCR-APIs verlangen etwa $0.001–0.005 pro Seite. VLM-basierte Extraktion kostet mehr pro Seite, weil die Berechnung aufwendiger ist — aber der Vergleich ist irreführend, wenn Sie beim API-Preis pro Seite stehen bleiben. Ein Reddit-Nutzer, der über 150.000 Seiten in der Produktion verarbeitet hat, stellte fest, dass der Kostenvorteil traditioneller OCR pro Seite verschwand, sobald man die Kosten für manuelle Korrektur einbezog: „Traditionelle OCR-Plattformen erscheinen kosteneffizient (~$0.001-0.005 pro Seite), aber ihre schlechte Handschrifterkennung (~45-50%) macht sie unbrauchbar für Geschäftsworkflows mit erheblichem handschriftlichem Inhalt. Die Zeit, die für die manuelle Korrektur von Fehlern aufgewendet wird, macht die tatsächlichen Kosten weit höher als bei spezialisierten Lösungen" (r/computervision, 2025). Die tatsächliche Kostengleichung lautet: Extraktionskosten pro Seite + Korrekturkosten pro Fehler × Fehlerrate. Bei gedruckten Dokumenten dominieren die Kosten pro Seite. Bei handschriftlichen Dokumenten dominieren die Korrekturkosten — und hier ändert die höhere Genauigkeit von VLMs die Rechnung.
Halluzination
Hier ist, was die meisten Vergleichsartikel auslassen: VLMs können halluzinieren. Weil sie darüber nachdenken, was auf einer Seite stehen sollte, fügen sie gelegentlich Informationen ein, die nicht vorhanden sind — ein plausibel aussehendes Datum, wo das Feld leer gelassen wurde, oder einen geschätzten Betrag, wo die Handschrift wirklich unleserlich war. Traditionelle OCR hat den umgekehrten Fehlermodus (sie gibt nichts oder Unsinn zurück), was ihre Fehler leichter erkennbar macht. Eine VLM-Halluzination ist gefährlicher, weil sie korrekt aussieht. Der Unterschied zwischen selbstsicher falscher Tesseract-Ausgabe („OOO OOO") und selbstsicher falscher VLM-Ausgabe besteht darin, dass die VLM-Version wie echte Daten aussieht — und möglicherweise die automatisierte Validierung umgeht. Bei Feldern, bei denen Fehler teuer sind (Zahlungsbeträge, Vertragsdaten, Compliance-Daten), bleiben Konfidenzbewertung und Human-in-the-Loop-Überprüfung notwendig, unabhängig davon, welche Technologie Sie wählen (F22 Labs, 2026).
Zentrale Erkenntnis: Traditionelle OCR scheitert, indem sie falsche Zeichen zurückgibt. VLM-basierte Extraktion kann scheitern, indem sie glaubwürdige Erfindungen zurückgibt. Der erste Fehlermodus ist verrauscht, aber erkennbar. Der zweite ist still und gefährlich. Keine der beiden Technologien beseitigt die Notwendigkeit der Validierung bei Feldern mit hohem Risiko — sie erfordern nur unterschiedliche Validierungsstrategien.
Der hybride Ansatz: Wann Sie was einsetzen
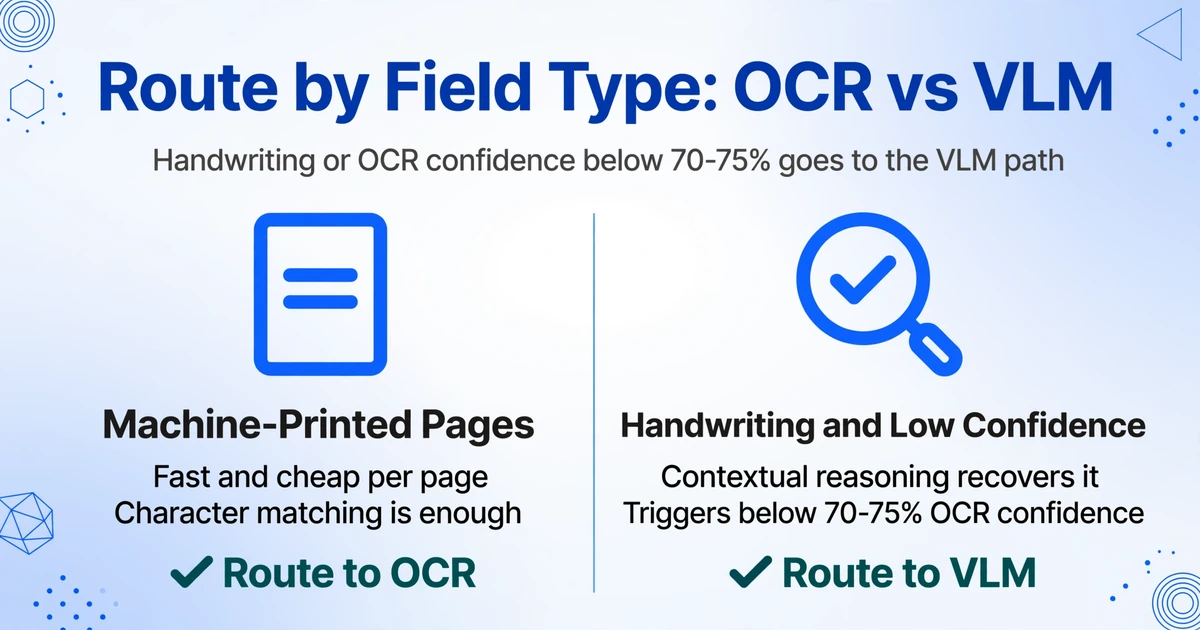
Die praktische Antwort für die meisten Teams lautet nicht „alles auf KI umstellen" oder „bei OCR bleiben". Es ist eine hybride Pipeline, die jedes Dokument anhand seiner Merkmale an die richtige Engine weiterleitet.
Für Dokumente, die zu 100% maschinengedruckt, konsistent formatiert und mit 300+ DPI gescannt sind, ist traditionelle OCR schneller, günstiger und ausreichend. Die Ausgabe muss möglicherweise per Feldposition nachbearbeitet werden, aber die Zeichengenauigkeit ist hoch genug, dass die Nachbearbeitungsregeln stabil bleiben.
Bei Dokumenten, die irgendeine Handschrift enthalten — und sei es nur ein einzelnes Feld — verschiebt sich die hybride Strategie. Nutzen Sie traditionelle OCR für die gedruckten Abschnitte und leiten Sie die handschriftlichen Felder an ein VLM weiter. So nutzen Sie den Geschwindigkeitsvorteil von OCR für den Großteil der Seite und setzen kontextuelle KI für die Teile ein, die OCR nicht bewältigen kann. Die Routing-Logik ist einfach: Fällt die OCR-Konfidenz für ein Feld unter eine Schwelle (typischerweise 70–75%), wird dieses Feld erneut über den VLM-Pfad verarbeitet. Eine Mindestzeichenzahl (mindestens 40 Zeichen pro Seite) dient als zweite Hürde, um Seiten abzufangen, bei denen OCR hohe Konfidenz für vier korrekt gelesene Zeichen meldet, aber den Rest der Seite völlig übersehen hat.
Der Schwellenwert-Ansatz kontrolliert auch die Kosten — Sie zahlen nur für die VLM-Verarbeitung der Felder, bei denen sie einen Unterschied macht. Bei einem Workflow, in dem 30% der Dokumente Handschrift enthalten und jedes Dokument durchschnittlich 15 Felder hat, bedeutet das, dass etwa 5 Felder pro Dokument über den VLM-Pfad laufen, nicht die gesamte Seite. In großem Maßstab macht dieser Unterschied etwas aus.
Was das für Ihren Dokumenten-Workflow bedeutet
Die Entscheidung zwischen traditioneller OCR und KI-Handschrifterkennung ist keine Technologieentscheidung — sie ist eine Workflow-Design-Entscheidung. Wenn Ihre Dokumentenerfassung zu 100 % gedruckt und vorlagenbasiert ist, funktioniert traditionelle OCR und wird weiterhin funktionieren. Wenn ein relevanter Anteil Ihrer Dokumente Handschrift enthält — Liefernachweise mit Fahrernotizen, Prüfberichte mit Feldbeobachtungen, medizinische Aufnahmeformulare mit Patientenunterschriften, Finanzanträge mit handschriftlichen Erklärungen —, dann verliert eine Pipeline, die nur auf traditioneller OCR basiert, bei jedem Batch still und leise Daten.
Der häufigste Fehlschluss ist die Annahme, dass „OCR das erledigt“, weil die Marketingseite des Tools Handschriftunterstützung auflistet. Die Lücke zwischen der aufgeführten Fähigkeit und der realen Leistung auf Ihren tatsächlichen Dokumenten — nicht den bereinigten Demo-Beispielen des Anbieters — entscheidet darüber, ob Automatisierung funktioniert oder mehr Arbeit erzeugt, als sie spart. Tests mit Ihren eigenen Dokumenten, insbesondere den unordentlichsten 10 % Ihrer Erfassung, sind der einzige Weg herauszufinden, welcher Ansatz — reine OCR, reine VLM oder hybrid — unter Produktionslast standhält.
FAQ
Kann traditionelle OCR überhaupt kursive Handschrift lesen?
Ja, aber unzuverlässig. Selbst mit LSTM-basierten Engines wie Tesseract 4.x fällt die Genauigkeit bei kursiver Schrift auf Wortebene typischerweise unter 50 %. Die Zeichen in verbundener Schreibschrift sind für Bottom-up-Mustererkennung zu mehrdeutig. Traditionelle OCR wurde für diese Eingabeklasse nicht entwickelt, und keine Parameteroptimierung ändert die zugrunde liegende architektonische Einschränkung.
Ist KI-Handschrifterkennung genau genug, um manuelle Dateneingabe zu ersetzen?
Für viele Workflows ja — mit Einschränkungen. Bei Druckschrift in festgelegten Formularfeldern erreicht KI-Extraktion 85–93 % Feldgenauigkeit, was manuelle Eingabe zur Ausnahme statt zur Regel macht. Bei unordentlicher Kursivschrift oder beeinträchtigten Handyfotos sinkt die Genauigkeit auf 65–80 % — immer noch eine dramatische Verbesserung gegenüber den unter 20 % traditioneller OCR, aber nicht hoch genug für Straight-Through-Processing ohne Prüfschritt bei kritischen Feldern. Der praktische Optimalpunkt ist Extraktion mit konfidenzbasierter Weiterleitung: Felder mit hoher Konfidenz laufen automatisch durch, Felder mit niedriger Konfidenz werden zur menschlichen Prüfung markiert. Einen tieferen Einblick, wie die Genauigkeit je nach Eingabequalität und Felddesign variiert, finden Sie in unserem Leitfaden zur Genauigkeitsverbesserung.
Wie sieht es mit der Geschwindigkeit aus – ist KI-Extraktion langsamer als OCR?
Pro Seite ja – typischerweise 5–12 Sekunden für VLM-basierte Extraktion gegenüber unter 2 Sekunden für traditionelle OCR. Doch der faire Vergleich schließt die Zeit ein, die Sie sparen, weil Sie OCR-Fehler in handschriftlichen Feldern nicht manuell korrigieren müssen. Bei einem Batch mit 100 Seiten und 40 % handschriftlichem Inhalt dauert die VLM-Extraktion ~10 Minuten Verarbeitungszeit + 30 Minuten Prüfung. Traditionelle OCR benötigt ~3 Minuten Verarbeitungszeit + 3–5 Stunden Korrektur. Die gesamte Workflow-Zeit spricht für VLM bei jedem Batch mit Handschrift.
Kann ich traditionelle OCR und KI-Extraktion in derselben Pipeline nutzen?
Ja – und genau so sehen die meisten Produktivumgebungen aus. Nutzen Sie traditionelle OCR für maschinengedruckte Seiten mit einer Konfidenz über einem Schwellenwert von 75 % und einer Mindestanzahl an Zeichen. Leiten Sie alles unterhalb dieses Schwellenwerts – plus jedes als handschriftlich markierte Dokument – über den VLM-Pfad. Diese hybride Architektur nutzt die Kosten- und Geschwindigkeitsvorteile von OCR dort, wo sie funktioniert, und deckt gleichzeitig die Handschrift-Lücken ab, die OCR nicht schließen kann.
Halluzinieren KI-Extraktionstools Daten, die nicht auf der Seite stehen?
Das können sie. VLM-basierte Systeme erzeugen manchmal plausibel wirkende Daten für Felder, die tatsächlich leer oder unleserlich waren. Das ist der wichtigste Unterschied zum Fehlermodus traditioneller OCR: Traditionelle OCR liefert offensichtlich falschen Unsinn; eine VLM-Halluzination kann korrekt aussehen und unbemerkt die Validierung passieren. Bei jedem Feld, bei dem ein Fehler teuer ist – Zahlungsbeträge, rechtliche Daten, Patientenkennungen – bleiben Konfidenzbewertung und menschliche Prüfung notwendig, unabhängig davon, welche Extraktionstechnologie Sie verwenden.
Der einzige Benchmark, der zählt
Benchmarks und Vergleichstabellen sagen Ihnen, was im Durchschnitt gilt. Sie sagen Ihnen nicht, was für Ihre Dokumente gilt – die mit der Handschrift Ihrer Lieferanten, den Abkürzungen Ihrer Außendienstmitarbeiter, Ihren jahrzehntealten gescannten Formularen. Die Lücke zwischen traditioneller OCR und KI-Handschrifterkennung wird in Prozentpunkten gemessen, aber ob diese Punkte zählen, hängt ganz davon ab, was passiert, wenn ein Feld in Ihrem Workflow falsch gelesen wird. Ein falsch gelesener Rechnungsbetrag ist ein Zahlungsfehler. Ein falsch gelesenes Prüfergebnis ist ein Compliance-Verstoß. Eine falsch gelesene Patientenakte ist ein Sicherheitsproblem.
Testen Sie mit Ihren eigenen Dokumenten. Nicht mit den saubersten – sondern mit den acht Formularen, die mit Kaffeeflecken und Randnotizen zusammengeheftet sind. Diese entscheiden, ob Ihre Extraktions-Pipeline funktioniert oder nur so aussieht, bis jemand einen Fehler findet.